

Red neuronal en la práctica: Perceptrón
 55
 0

Introducción
En el artículo anterior, Red neuronal en la práctica: Gradiente, hablamos un poco de cómo surgió el gradiente a partir del uso de una derivada de la función de costo.
Aunque dividir este contenido en partes no es una de las tareas más sencillas, ya que se trata de un tema que exige familiarizarse con una enorme cantidad de elementos y conceptos, muchos de ellos completamente abstractos y otros bastante complicados porque utilizan los mismos términos en contextos diferentes, he intentado presentar el material de la forma más fácil de comprender posible.
Entre estos conceptos se encuentra el uso de los términos BACK PROPAGATION y FORWARD PROPAGATION, que normalmente se utilizan de forma indiscriminada, sin explicarlos debidamente. Para entender correctamente todo lo que se hace dentro del código de una red de perceptrones, necesitamos comprender cómo fueron surgiendo estos conceptos.
Por ahora no entraremos en ciertos detalles. Sin embargo, necesitamos entender cómo surgió el término red neuronal. Para ello, debemos comprender su fundamento, conocido como perceptrón, que es el tema principal de este artículo.
Perceptrón
Cuando se habla de perceptrón, muchos empiezan inmediatamente a pensar en inteligencia artificial. En realidad, el término fue propuesto por McCulloch y Pitts, y Frank Rosenblatt lo implementó en 1958, cuando trabajaba en el Laboratorio Aeronáutico de Cornell. Rosenblatt se inspiró en una neurona biológica y en lo que esta es capaz de hacer. Básicamente, un perceptrón constaría de una o más entradas.
Un sistema de procesamiento y una salida como resultado de dicho procesamiento. La primera implementación práctica, sin embargo, se realizó en un IBM 704, donde Rosenblatt intentó crear mediante software un sistema capaz de realizar reconocimiento facial. Lo curioso fue la frase utilizada al referirse a aquel perceptrón: «El perceptrón es el embrión de una computadora electrónica que la Marina espera que sea capaz de caminar, hablar, ver, escribir, reproducirse y ser consciente de su propia existencia». Esta gente es un chiste. Me imagino cuánto dinero debieron de recibir para la investigación después de aquella demostración.
Debido a dificultades técnicas, el sistema no funcionó como se esperaba y demostró ser capaz de trabajar únicamente con patrones lineales. Por esta razón, no podía reconocer patrones distintos como se pretendía. Esto hizo que el interés por la investigación en inteligencia artificial desapareciera durante un tiempo.
Un perceptrón utiliza diversas entradas. Con los pesos y el sesgo, puede realizar sumas y multiplicaciones ponderadas. El nombre resultó bastante interesante, ya que la función que se crearía sería capaz de realizar precisamente este mismo tipo de tarea. Es decir, si proporcionamos a una función varios valores como entradas y esta dispone de conocimientos previamente adquiridos, puede realizar el mismo tipo de tarea.
Esta misma función podía realizar todas las sumas y multiplicaciones necesarias, generando así cierto tipo de patrón de identidad. De este modo, al pasar la salida por una función, que pasó a definirse como función de activación, precisamente para diferenciar la función de salida de la función interna del perceptrón, terminábamos generando una salida que podía enviarse a nuevos perceptrones o mostrarse a nosotros, los humanos.
En un artículo futuro mostraré cómo se llegó a lo que sería la idea inicial de la función del perceptrón, que consiste precisamente en esa cadena de sumas y multiplicaciones ponderadas. Pero esto quedará para más adelante, ya que implica comprender conceptos que, para muchos, quizá no resulte interesante abordar aquí y ahora.
Así que volvamos al tema y observemos el perceptrón desde una perspectiva más moderna. Para simplificar, nos centraremos por ahora en un único perceptrón. Aunque en artículos anteriores ya hemos comenzado a conectar perceptrones en cadena, precisamente para simular puertas lógicas, aquí el objetivo será llevarte hacia un modelado algo más elaborado.
Básicamente, un perceptrón utiliza una expresión matemática que vimos en el artículo anterior. Esta puede volver a verse a continuación.
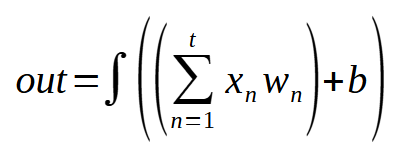
 //+------------------------------------------------------------------+
        inline double Perceptron(const double &inputs[])
        {
            double value = m_Infos.Bias;

            for (uint c = 0; c < m_Infos.nInputs; c++)
                value += (inputs[c] * m_Infos.Weight[c]);

            return fnActivation(true, value);
        }
//+------------------------------------------------------------------+
Este fragmento contiene prácticamente todo lo que se ha implementado hasta ahora en la clase C_Neuron, con una única excepción: la función fnActivation, que todavía no se ha implementado definitivamente. Aparte de este detalle, puedes ver claramente que simplemente estamos realizando sumas y multiplicaciones. Nada más.
A diferencia de lo que pudo parecer en el artículo anterior, un perceptrón no es más que una serie de sumas y multiplicaciones simples. Sin embargo, una vez que definimos las constantes dentro de la expresión matemática, podemos obtener una respuesta que puede resultar interesante. Estas constantes, que corresponden a los valores de los pesos y del sesgo, se ajustan mediante lo que se conoce como entrenamiento. Por tanto, el objetivo principal de toda red consiste precisamente en ajustar dichas constantes, y este es el propósito de la función que llamamos perceptrón.
Bien, ahora que entendemos esto, podemos ver la función que todavía falta en el código, es decir, fnActivation, que se muestra a continuación.
//+------------------------------------------------------------------+
        inline double fnActivation(const bool isFx, const double value)
        {
            switch (m_Infos.Activate)
            {
                case Sigmoid:
                        return (isFx ? 1 / (1 + MathExp(-value)) : MathExp(-value) / MathPow(1 + MathExp(-value), 2));
                case Tangh:
                        return (isFx ? (2 / (1 + MathExp(-2 * value))) - 1 : (4 / MathPow(MathExp(-value) + MathExp(value), 2)));
                case ReLU:
                        return (isFx ? MathMax(0, value) : (value <= 0 ? 0 : 1));
                case eLU:
                        return (isFx ? (value <= 0 ? (m_Infos.Alpha * (MathExp(value) - 1)) : value) : (value <= 0 ? (m_Infos.Alpha * MathExp(value)) : 1));
                case SoftSign:
                        return (isFx ? value / (1 + MathAbs(value)) : value / MathPow(1 + MathAbs(value), 2));
                case SoftPlus:
                        return (isFx ? MathLog(1 + MathExp(value)) : 1 / (1 + MathExp(-value)));
                case Identity:
                default:
                        return (isFx ? value : 1);
            }
        }
//+------------------------------------------------------------------+
Ahora tenemos una idea general de lo que sería el perceptrón completo y de lo que puede hacer. Esto se debe a que las funciones de activación que se muestran aquí son las mismas que se presentaron y comentaron en un artículo en el que las explicamos gráficamente. Pero observa algo: aunque tenemos todas aquellas funciones mostradas anteriormente, puedes ver que el perceptrón no utiliza las derivadas. Esto se debe a que en ningún momento el parámetro isFx es falso. Entonces, ¿por qué derivamos aquí? Bien, el motivo es el gradiente. Pero, antes de hablar de esto, quiero que entiendas una cosa.
Función de activación en mínimos cuadrados
Para entender cómo funcionan realmente las cosas, necesitamos verlas en su forma más simple. Como nuestra clase C_Neuron ya contiene cierta funcionalidad, vamos a centrar nuestra atención en el código completo de la clase. De esta forma será más sencillo explicarlo y, sobre todo, entender lo que ocurre. El código en sí puede verse a continuación.
//+------------------------------------------------------------------+
#property copyright "Daniel Jose"
//+------------------------------------------------------------------+
#define macroRandom (rand() / (double)SHORT_MAX)
//+------------------------------------------------------------------+
class C_Neuron
{
    protected:
//+------------------------------------------------------------------+
        enum eFnActivate {
                            Identity,
                            Sigmoid,
                            Tangh,
                            SoftSign,
                            ReLU,
                            eLU,
                            SoftPlus,
                        };
//+------------------------------------------------------------------+
    private:
//+------------------------------------------------------------------+
        struct  stInfos
        {
            bool    IsFx;
            uint    nInputs;
            double  Bias,
                    Weight[],
                    Alpha;
            eFnActivate Activate;
        }m_Infos;
//+------------------------------------------------------------------+
        struct stErr
        {
            double  weight[],
                    eMaxWeight,
                    bias;
        }m_Error;
//+------------------------------------------------------------------+
        inline double fnActivation(const bool isFx, const double value)
        {
            switch (m_Infos.Activate)
            {
                case Sigmoid:
                        return (isFx ? 1 / (1 + MathExp(-value)) : MathExp(-value) / MathPow(1 + MathExp(-value), 2));
                case Tangh:
                        return (isFx ? (2 / (1 + MathExp(-2 * value))) - 1 : (4 / MathPow(MathExp(-value) + MathExp(value), 2)));
                case ReLU:
                        return (isFx ? MathMax(0, value) : (value <= 0 ? 0 : 1));
                case eLU:
                        return (isFx ? (value <= 0 ? (m_Infos.Alpha * (MathExp(value) - 1)) : value) : (value <= 0 ? (m_Infos.Alpha * MathExp(value)) : 1));
                case SoftSign:
                        return (isFx ? value / (1 + MathAbs(value)) : value / MathPow(1 + MathAbs(value), 2));
                case SoftPlus:
                        return (isFx ? MathLog(1 + MathExp(value)) : 1 / (1 + MathExp(-value)));
                case Identity:
                default:
                        return (isFx ? value : 1);
            }
        }
//+------------------------------------------------------------------+
        inline double Cost_FX(const double &train[])
        {
            double x, err;

            err = 0;
            for (uint c0 = 0; c0 < train.Size(); c0++)
            {
                x = 0;
                for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, c0++)
                   x += (train[c0] * m_Infos.Weight[c1]);
                err += MathPow((x + m_Infos.Bias) - train[c0], 2);
            }

            return err;
        }
//+------------------------------------------------------------------+
        inline double Learning_FX(const double &train[], const double epsilon,  const double LearningRate, const ulong limit)
        {
            double  err,
                    memT,
                    err_w[];
            ulong   count;

            Print("Cost being calculated by the Minimum Square...");
            ArrayResize(err_w, m_Infos.nInputs);
            for (count = 0; (count < limit) && ((err = Cost_FX(train)) > epsilon); count++)
            {
                for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++)
                {
                    memT = m_Infos.Weight[c];
                    m_Infos.Weight[c] += LearningRate;
                    err_w[c] = Cost_FX(train) - err;
                    m_Infos.Weight[c] = memT;
                }
                memT = m_Infos.Bias;
                m_Infos.Bias += LearningRate;
                m_Infos.Bias = memT - (Cost_FX(train) - err);
                for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++)
                    m_Infos.Weight[c] -= err_w[c];
            }
            PrintFormat("Total interactions: %I64u", count);
            ArrayFree(err_w);

            return err;
        }
//+------------------------------------------------------------------+
        inline double Cost_DX(const double &train[])
        {
            double  x1, t;

            ZeroMemory(m_Error);
            for (uint c0 = 0, cw = 0; c0 < train.Size(); c0++, cw = c0)
            {
                x1 = 0;
                for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, c0++)
                   x1 += (train[c0] * m_Infos.Weight[c1]);
                t = 2 * ((x1 + m_Infos.Bias) - train[c0]);
                for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, cw++)
                {
                    m_Error.weight[c1] += (t * train[cw]);
                    m_Error.eMaxWeight = (MathAbs(m_Error.weight[c1]) >  MathAbs(m_Error.eMaxWeight) ? m_Error.weight[c1] : m_Error.eMaxWeight);
                }
                m_Error.bias += t;
            }
            return (MathAbs(m_Error.bias) > MathAbs(m_Error.eMaxWeight) ? m_Error.bias : m_Error.eMaxWeight);
        }
//+------------------------------------------------------------------+
        inline double Learning_DX(const double &train[], const double epsilon, const double LearningRate, const ulong limit)
        {
            ulong   count;
            double  eRet;

            Print("Cost being calculated by the Gradient...");
            for (count = 0; (count < limit) && (MathAbs(eRet = Cost_DX(train)) > epsilon); count++)
            {
                m_Infos.Bias -= (m_Error.bias * LearningRate);
                for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++)
                    m_Infos.Weight[c] -= (m_Error.weight[c] * LearningRate);
            }
            PrintFormat("Total interactions: %I64u", count);

            return eRet;
        }
//+------------------------------------------------------------------+
    public :
//+------------------------------------------------------------------+
        C_Neuron(uint nInputs = 1, eFnActivate fn = Identity, bool isFx = false, double alpha = 0.75, double H = 1.0, double L = 0.0)
        {
            MathSrand(512);
            ZeroMemory(m_Infos);
            m_Infos.Activate = fn;
            m_Infos.IsFx = isFx;
            m_Infos.Alpha = alpha;
            m_Infos.Bias = (double)macroRandom;
            ArrayResize(m_Infos.Weight, m_Infos.nInputs = nInputs);
            ArrayResize(m_Error.weight, m_Infos.nInputs);
            for(uint c = 0; c < m_Infos.nInputs; c++)
                m_Infos.Weight[c] = ((double)macroRandom * (H - L)) + L;
        }
//+------------------------------------------------------------------+
        ~C_Neuron()
        {
            ArrayFree(m_Infos.Weight);
            ArrayFree(m_Error.weight);
        }
//+------------------------------------------------------------------+
        void View_Variables(void)
        {
            Print("Bias: ", m_Infos.Bias);
            for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++)
                PrintFormat("Weight[%d]: %.16f", c, m_Infos.Weight[c]);
        }
//+------------------------------------------------------------------+
        inline double Learning(const double &train[], const double epsilon = 1e-3, const double LearningRate = 1e-2, const ulong limit = ULONG_MAX)
        {
           return (m_Infos.IsFx ? Learning_FX(train, epsilon, LearningRate, limit) : Learning_DX(train, epsilon, LearningRate, limit));
        }
 //+------------------------------------------------------------------+
        inline double Perceptron(const double &inputs[])
        {
            double value = m_Infos.Bias;

            for (uint c = 0; c < m_Infos.nInputs; c++)
                value += (inputs[c] * m_Infos.Weight[c]);

            return fnActivation(true, value);
        }
//+------------------------------------------------------------------+
};
//+------------------------------------------------------------------+
#undef macroRandom
//+------------------------------------------------------------------+
Sé que puede parecer una tontería mostrar todo el código, pero quiero enseñarte algo. En el archivo adjunto tendrás un código ya terminado. Sin embargo, ver cómo era antes resulta tan importante o, en algunos casos, incluso más importante que ver el código final. Presta atención para entender cómo habrá que modificarlo. Esto te ayudará a comprender por qué adoptará un determinado comportamiento más adelante.
Aquí, solo el perceptrón utiliza la función de activación. Ni la función de costo que utiliza mínimos cuadrados ni la que utiliza el gradiente están siendo llamadas.
Ahora presta atención: antes de modificar esta clase C_Neuron, vamos a crear otra clase. Esta servirá para reducir el código durante las pruebas, concentrándolo todo en un único archivo de encabezado. La clase que vamos a crear se muestra íntegramente a continuación.
//+------------------------------------------------------------------+
#property copyright "Daniel Jose"
//+------------------------------------------------------------------+
#include <Neural Network\C_Neuron.mqh>
//+------------------------------------------------------------------+
class C_Check_Neuron : private C_Neuron
{
//+------------------------------------------------------------------+
    private :
//+------------------------------------------------------------------+
    public  :
//+------------------------------------------------------------------+
        C_Check_Neuron(uint nInputs = 1, eFnActivate fn = Identity, bool isFx = false)
            :C_Neuron(nInputs, fn, isFx)
        {}
//+------------------------------------------------------------------+
        void View_Training_Data(const double &arr[], uint nColumns)
        {
            string sz0;
            uint nLines = arr.Size() / nColumns;

            Print("Training matrix.");
            Print("--------------------");
            for (uchar i = 0; i < nLines; i++)
            {
                sz0 = "";
                for (uchar j = 0; j < nColumns; j++)
                    sz0 += StringFormat("%f  ", arr[(i * nColumns) + j]);
                Print(sz0);
            }
            Print("--------------------");
        }
//+------------------------------------------------------------------+
        void Performs_Training(const double &arr[], double epsilon, double LearningRate, ulong limit)
        {
            ulong it0, it1;

            it0 = GetTickCount();
            Print("Margin of error achieved: ", Learning(arr, epsilon, LearningRate, limit));
            it1 = GetTickCount();
            Print("Total time(in Seconds): ", (it1 - it0) / 1000.0);
        }
//+------------------------------------------------------------------+
        void Check_Training(const double &arr[], uint nColumns)
        {
            string  sz0;
            double  mem[];
            uint    nLines = arr.Size() / nColumns;

            Print("********** RESULT *************");
            ArrayResize(mem, nColumns);
            for (uchar i = 0; i < nLines; i++)
            {
                sz0 = "";
                for (uchar j = 0; j < nColumns - 1; j++)
                    sz0 += StringFormat("%f  ", mem[j] = arr[(i * nColumns) + j]);
                sz0 += StringFormat("%f", Perceptron(mem));
                Print(sz0);
            }
            Print("--------------------");
            ArrayFree(mem);
            View_Variables();
        }
//+------------------------------------------------------------------+
};
//+------------------------------------------------------------------+
Esta clase C_Check_Neuron nos permitirá imprimir, entrenar y comprobar lo que está ocurriendo. Como solo contiene lo esencial que utilizaremos más adelante, resulta más sencillo entender las cosas sin perdernos en medio de la explicación. Ahora veamos el primero de los códigos que utilizaremos para probar el perceptrón. El código se muestra a continuación.
//+------------------------------------------------------------------+
#property copyright "Daniel Jose"
#property script_show_inputs
#property description   "Script to compare execution speed\n" \
                        "Here we are using only the CPU.\n" \
                        "However, the results are still very interesting."
//+------------------------------------------------------------------+
#include <Neural Network\C_Check_Neuron.mqh>
//+------------------------------------------------------------------+
enum eFactorization {
                        Minimum_Square,
                        Gradient_Descent,
                    };
//+------------------------------------------------------------------+
input eFactorization        user00 = Minimum_Square;        //Type of factorization
input double                user01 = 1e-3;                  //Estimated error
input double                user02 = 1e-3;                  //Learning Rate
input C_Neuron::eFnActivate user03 = C_Neuron::Identity;    //Activation function
//+------------------------------------------------------------------+
double Train[] {
                0, 0,
                1, 2,
                2, 4,
                3, 6,
                4, 8
               };
//+------------------------------------------------------------------+
#define nColumns    2
#define nLines      Train.Size() / nColumns
//+------------------------------------------------------------------+
void OnStart()
{
    C_Check_Neuron *neuron;

    Print("************************************");
    Print("Simple Neuron in Class...");
    Print("************************************");
    Print("Parameters:");
    Print("Type of factorization: ", EnumToString(user00));
    Print("Estimated error: ", user01);
    Print("Learning Rate:", user02);
    Print("Activation function: ", EnumToString(user03));
    Print("************************************");


    neuron = new C_Check_Neuron(nColumns - 1, user03, user00 == Minimum_Square);

    (*neuron).View_Training_Data(Train, nColumns);
    (*neuron).Performs_Training(Train, user01, user02, ULONG_MAX);
    (*neuron).Check_Training(Train, nColumns);

    delete neuron;
}
//+------------------------------------------------------------------+
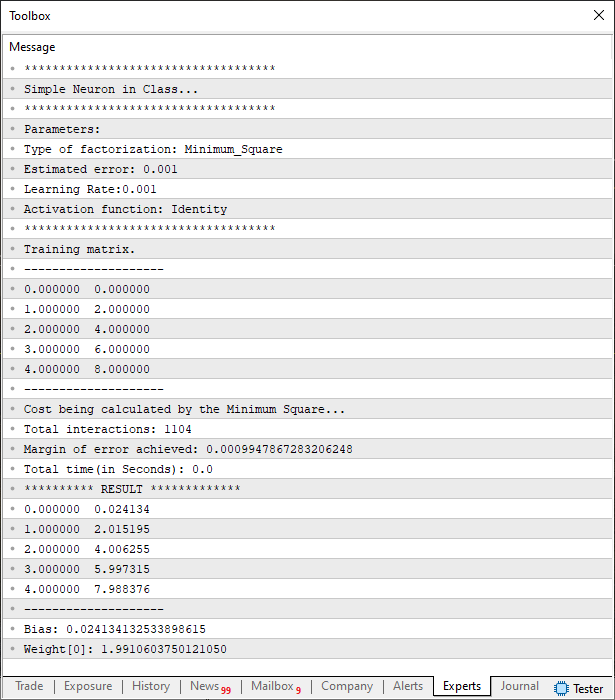
Como la mayor parte de la complejidad se ha trasladado al interior de la clase C_Check_Neuron, el código mostrado anteriormente permite realizar todas las pruebas y, al mismo tiempo, imprimir diversos datos necesarios para saber qué está haciendo el perceptrón. Hasta el punto de que podemos analizar si realmente se produjo o no una convergencia hacia un punto conocido como punto de costo mínimo. Al ejecutar exactamente el código anterior, podrás ver algo similar a lo que se muestra en la imagen siguiente.
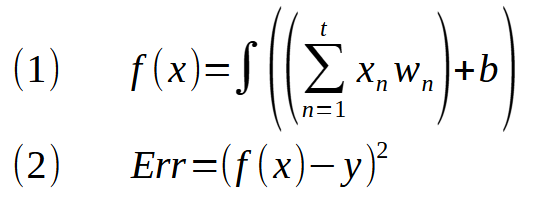
Y aquí tenemos la función de activación aplicada a los mínimos cuadrados. Recuerda que el símbolo de integración representa, en realidad, la función de activación incluida como factor en la expresión. Ahora quiero que compares esta expresión (1) con la expresión del perceptrón. Observa que son idénticas. Entonces te preguntarás: ¿Cómo es posible? ¿Existe algún motivo especial para que esto ocurra? Sí, amigo mío. El sistema basado en redes de perceptrones fue concebido para resolver principalmente regresiones lineales y sigue orientado a ello. Si no sabes de qué estoy hablando, consulta mis primeros artículos sobre este tema.
Allí expliqué cómo surgió esta idea. Pero el punto aquí no es la ecuación (1), sino la ecuación (2). La expresión (1) representa el FORWARD PROPAGATION. En cambio, la expresión (2) corresponde precisamente al BACK PROPAGATION que se aplicará al perceptrón. Observa que no hay demasiada diferencia con respecto a lo mostrado anteriormente. Sin embargo, si lo ves en el código, especialmente por la forma en que yo lo escribo, dará la impresión de que todo funciona de una manera distinta de la que estoy mostrando en las expresiones matemáticas. Por esta razón, muestro las expresiones para que puedas comprender correctamente de dónde procede cada fragmento de código. Ahora, al trasladar esto a código, incorporamos el siguiente fragmento al código de la clase C_Neuron.
//+------------------------------------------------------------------+
        inline double Cost_FX(const double &train[])
        {
            double x, err;

            err = 0;
            for (uint c0 = 0; c0 < train.Size(); c0++)
            {
                x = 0;
                for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, c0++)
                   x += (train[c0] * m_Infos.Weight[c1]);
                err += MathPow(fnActivation(true, x + m_Infos.Bias) - train[c0], 2);
            }

            return err;
        }
//+------------------------------------------------------------------+
La diferencia es muy sutil, por lo que hay que prestar atención para advertir el momento en que se empieza a llamar a la función de activación. De hecho, al volver a ejecutar el código de prueba, verás la imagen que se muestra a continuación.
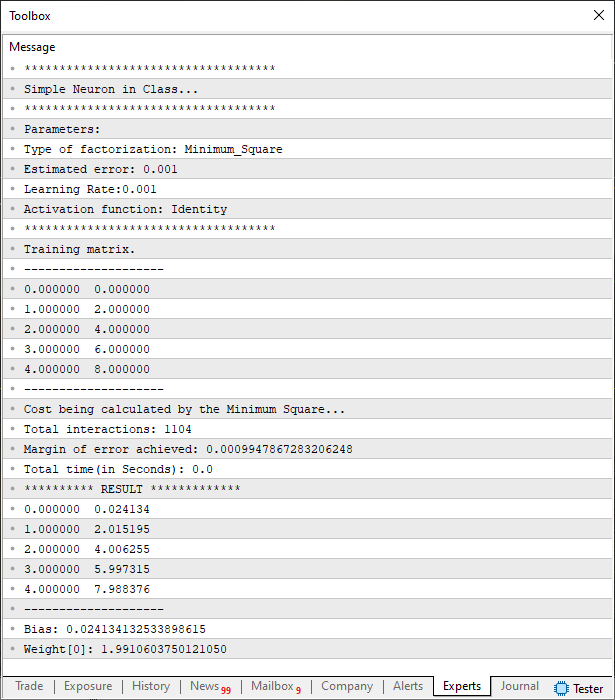
Parece una copia de lo que se hacía antes, pero no lo es: son momentos distintos de ejecución del mismo código. Una vez con la función de activación y otra sin ella. Pero presta todavía más atención al hecho de que estamos utilizando la función de activación identidad. Esto se debe a que, en este caso, estamos trabajando realmente con una regresión lineal. No tendría ningún sentido utilizar otra función de activación.
Muy bien, pero ¿puede este mismo perceptrón manejar un número diferente de entradas? Podemos comprobarlo fácilmente. Para ello, utilizaremos el código que se muestra a continuación.
//+------------------------------------------------------------------+
#property copyright "Daniel Jose"
#property script_show_inputs
#property description   "Script to compare execution speed\n" \
                        "Here we are using only the CPU.\n" \
                        "However, the results are still very interesting."
//+------------------------------------------------------------------+
#include <Neural Network\C_Check_Neuron.mqh>
//+------------------------------------------------------------------+
enum eFactorization {
                        Minimum_Square,
                        Gradient_Descent,
                    };
//+------------------------------------------------------------------+
input eFactorization        user00 = Minimum_Square;        //Type of factorization
input double                user01 = 1e-3;                  //Estimated error
input double                user02 = 1e-3;                  //Learning Rate
input C_Neuron::eFnActivate user03 = C_Neuron::Identity;    //Activation function
//+------------------------------------------------------------------+
//Training expression: f(x) = (w0 * 1.8) + (w1 * 2.15) + 2.1
//+------------------------------------------------------------------+
double Train[] {
                  1,    3,  10.35,
                1.5,  3.25, 11.7875,
                1.75, 3.94, 13.721,
                2.85, 3.46, 14.669
               };
//+------------------------------------------------------------------+
#define nColumns    3
#define nLines      Train.Size() / nColumns
//+------------------------------------------------------------------+
void OnStart()
{
    C_Check_Neuron *neuron;

    Print("************************************");
    Print("Simple Neuron in Class...");
    Print("************************************");
    Print("Parameters:");
    Print("Type of factorization: ", EnumToString(user00));
    Print("Estimated error: ", user01);
    Print("Learning Rate:", user02);
    Print("Activation function: ", EnumToString(user03));
    Print("************************************");


    neuron = new C_Check_Neuron(nColumns - 1, user03, user00 == Minimum_Square);

    (*neuron).View_Training_Data(Train, nColumns);
    (*neuron).Performs_Training(Train, user01, user02, ULONG_MAX);
    (*neuron).Check_Training(Train, nColumns);

    delete neuron;
}
//+------------------------------------------------------------------+
Al ejecutar este código, verás el siguiente resultado en el terminal.
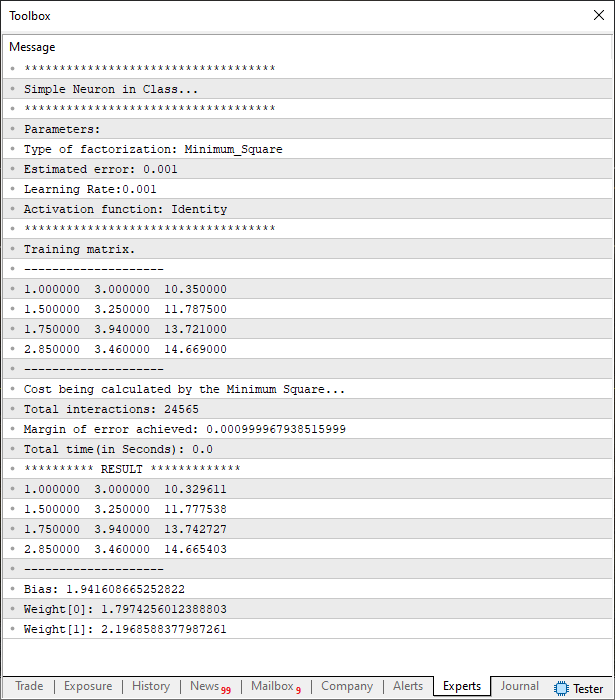
No sé si estás siguiendo bien el razonamiento. Pero observa que, entre este código y el anterior, ambos destinados a probar el perceptrón, solo fue necesario realizar unos pocos cambios. En particular, los cambios se hicieron en la definición que indica cuántas columnas tenemos en el array de entrenamiento, así como en los datos utilizados durante el entrenamiento. Por tanto, si quieres utilizar datos completamente diferentes, no tendrás dificultades para experimentar con este perceptrón. Pero, como ya se mencionó, hay algunas precauciones que debemos tomar. Quizá la más importante sea el valor indicado en el campo de la tasa de aprendizaje.
No debes utilizar valores demasiado altos, ya que esto acaba volviendo un poco loco al perceptrón. Tampoco debes utilizar valores demasiado pequeños, pues hacen que el perceptrón tarde mucho en converger hasta situar el error por debajo del valor estimado como objetivo. Es decir, la moderación es la clave.
Cuando digo que el perceptrón se vuelve un poco loco, me refiero a un efecto matemático. No es porque el programa contenga algún fallo que lo haga entrar en un bucle demasiado largo, sino por una cuestión matemática relacionada con la convergencia de los valores. Para entenderlo, observa la imagen siguiente.
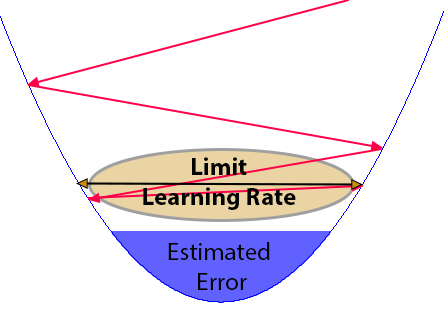
Esta imagen, que a primera vista puede parecer confusa, muestra precisamente el problema de utilizar un valor inadecuado para la tasa de aprendizaje. Normalmente, me gusta definir este valor de modo que sea igual o ligeramente inferior al error estimado, precisamente para evitar la situación que se muestra en la imagen anterior.
A medida que el perceptrón va convergiendo para alcanzar el error estimado, como muestran las líneas rojas, en algún momento puede llegar a un valle cuya distancia entre los extremos sea muy cercana al valor de la tasa de aprendizaje. Aunque el valor del error estimado esté correctamente definido, la distancia entre las laderas del valle hace que el perceptrón deje de converger, de modo que no alcanza el error definido previamente y nunca termina. Esto ocurre porque la tasa de aprendizaje puede hacer que el perceptrón vaya de un lado a otro sin conseguir siquiera seguir descendiendo. Quizá este sea el peor escenario al que podemos enfrentarnos, ya que puedes pensar que la aplicación se ha bloqueado. De ahí la necesidad de disponer de algún mecanismo que permita salir de una situación tan incómoda.
Uno de los mecanismos adoptados consiste en ajustar el valor máximo de interacciones con los datos de entrenamiento. Personalmente, me gusta dejarlo en ULONG_MAX. Sin embargo, puede ocurrir que esto haga que el entrenamiento tarde demasiado. Por tanto, al ajustar la tasa de aprendizaje conviene tener en cuenta el error estimado e incluso, quizá, el número máximo de interacciones del perceptrón con los datos de entrenamiento. Estos ajustes pueden hacerse sin necesidad de modificar nada del código presentado aquí; basta con ajustar el código de la aplicación final.
Si todo esto te ha parecido interesante y has conseguido entender cómo se utiliza la función de activación cuando elegimos el método de mínimos cuadrados, ha llegado el momento de ver algo todavía más interesante. Ahora veremos qué ocurre cuando seleccionamos el gradiente. Pero, para separar ambas cuestiones, vamos a verlo en un nuevo tema.
Función de activación en el gradiente
Ahora la cosa se pondrá mucho más divertida. Lo que vimos en el tema anterior es un juego de niños. Pero lo que veremos aquí podría resumirse así: ahora sí se arma el lío. Aquí es donde los niños empiezan a llorar porque no saben cómo salir del apuro y esperan que venga un adulto a rescatarlos.
Bromas aparte, aplicar la función de activación al gradiente no es tan sencillo como aplicarla a la función de costo de mínimos cuadrados. Esto se debe precisamente a que el gradiente es una derivada de la función de mínimos cuadrados. Sin embargo, hay un detalle, y esta es la razón por la que muchos se confunden cuando intentan entender el gradiente. Sobre todo cuando parten de una idea equivocada sin haber entendido antes cómo funciona el método de mínimos cuadrados.
A diferencia de lo que ocurre con los mínimos cuadrados, cuyas expresiones son prácticamente iguales a la que vimos en el perceptrón, con el gradiente tenemos dos expresiones. Una para la salida de los datos y otra para la retropropagación. Por eso muchos acaban confundiéndose. Pero no hay motivo para alarmarse ni entrar en pánico. Intenta entender lo que voy a explicar. Verás que, en la práctica, las cosas son mucho más sencillas de lo que parecen. En el artículo anterior mostré la siguiente expresión:
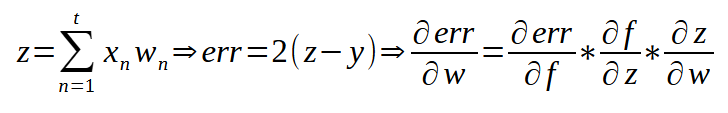
Es decir, el error es, en realidad, un conjunto de derivadas cuando nuestro objetivo es utilizar el gradiente. Por tanto, lo único que necesitamos hacer es multiplicar el valor del gradiente por la derivada de la función de activación para comenzar a corregir el error. Así de sencillo. En el código, puedes verlo aplicado en el siguiente fragmento.
//+------------------------------------------------------------------+
        inline double Cost_DX(const double &train[])
        {
            double  x1, t;

            ZeroMemory(m_Error);
            for (uint c0 = 0, cw = 0; c0 < train.Size(); c0++, cw = c0)
            {
                x1 = 0;
                for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, c0++)
                   x1 += (train[c0] * m_Infos.Weight[c1]);
                t = 2 * ((x1 + m_Infos.Bias) - train[c0]) * fnActivation(false, x1 + m_Infos.Bias);
                for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, cw++)
                {
                    m_Error.weight[c1] += (t * train[cw]);
                    m_Error.eMaxWeight = (MathAbs(m_Error.weight[c1]) >  MathAbs(m_Error.eMaxWeight) ? m_Error.weight[c1] : m_Error.eMaxWeight);
                }
                m_Error.bias += t;
            }
            return (MathAbs(m_Error.bias) > MathAbs(m_Error.eMaxWeight) ? m_Error.bias : m_Error.eMaxWeight);
        }
//+------------------------------------------------------------------+
¿Pero eso es todo? Sí, querido lector, eso es todo lo que necesitamos hacer. Ahora tenemos un perceptrón que utiliza el gradiente y que también es capaz de utilizar los mínimos cuadrados. A grandes rasgos, podemos decir que el perceptrón está completo. Es decir, tenemos entradas, una función de costo, una función de activación, retropropagación y una salida. Todo esto ya está implementado en nuestro perceptrón, mediante la clase C_Neuron. Toda esa complicación que muchos generan en torno al tema solo sirve para hacer que parezca más difícil de lo que realmente es.
Resumen
Quizá todavía seas algo escéptico sobre si realmente necesitamos utilizar la derivada de la función de activación cuando usamos el gradiente. Para comprender por qué es necesaria, tendremos que abordar los aspectos matemáticos. Por tanto, el resto de este artículo estará dedicado a explicar cómo llegamos a esta conclusión y por qué necesitamos utilizar derivadas. Puedes saltarte el resto del artículo si así lo deseas. Pero te aseguro que será un buen repaso de todo lo que hemos visto hasta aquí. Y esto te ayudará a entender los siguientes pasos.
Muy bien, lo primero que debemos hacer es retroceder algunos pasos y volver al origen del gradiente. Ya lo expliqué anteriormente, pero aquí reforzaremos lo visto y profundizaremos un poco más. Todo comienza con la función afín. Su expresión es la que se muestra en la imagen siguiente.

El <a> es la pendiente y el <b> es el punto de intersección. El valor de <x>, por su parte, es el valor de entrada. Tanto <a> como <b> son constantes. Esta expresión, escrita como un polinomio, da lugar a otra muy parecida. Y, al resolver el polinomio generado, obtenemos lo que se conoce como regresión lineal. El detalle es que, muchas veces, los valores utilizados no caen exactamente sobre la recta definida por la función afín. Esta diferencia entre el valor estimado y el valor obtenido mediante la función afín se conoce como error. Entonces, con un poco de ingenio matemático, podemos generar algunas funciones que intenten hacer que este error tienda a cero. Esto nos lleva a la expresión que se muestra a continuación.
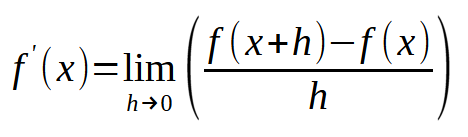
Esta expresión constituye la base general para crear una regresión lineal, donde tenemos una base de datos con diversos valores y queremos que la función afín obtenida tenga el menor error posible. Para ello, hacemos que el valor de <h> tienda a cero. Sin embargo, aquí hay un detalle. Esta expresión no nos permite corregir los valores de <a> y <b> de la función afín a partir del error que se está generando. Para ello, realizamos algunas manipulaciones matemáticas y llegamos a la siguiente expresión.
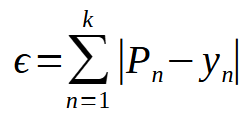
Esta es la expresión original para calcular el error. El valor <P> es el valor que calculamos a partir de la función afín. Por su parte, <y> es el valor estimado o el resultado esperado. Observa que estamos utilizando el valor absoluto. Esto evita que los valores negativos anulen los positivos, dando así la falsa impresión de que los valores de <a> y <b> son correctos cuando, en realidad, siguen siendo erróneos. Sin embargo, la expresión mostrada anteriormente no hace que avancemos con suficiente rapidez hacia el menor error posible. Para conseguirlo, sustituimos el valor absoluto por una potencia de dos, con lo que obtenemos la siguiente expresión.
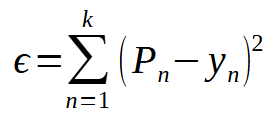
Observa que es prácticamente igual a la expresión anterior. Pero el hecho de utilizar una potencia en lugar del valor absoluto hace que este error pase de tener un gráfico como este:
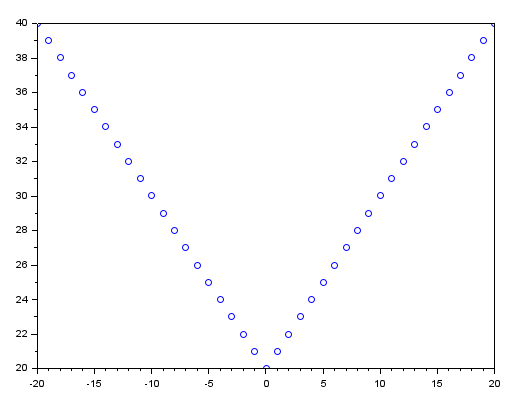
A uno como este:
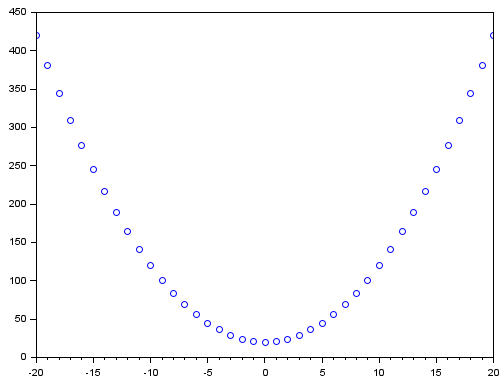
Aunque no lo parezca, esto supone una gran diferencia en la velocidad de disminución. Tanto es así que, si utilizas una potencia aún mayor, verás que la velocidad aumentará todavía más. Solo debes tener cuidado de utilizar potencias pares, ya que las potencias impares permiten obtener valores negativos en la salida. Y esto nos devuelve al problema de no poder sumar valores positivos y negativos en el error final.
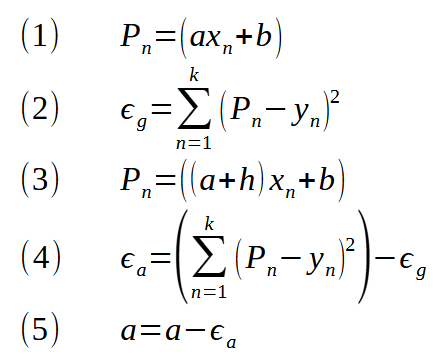
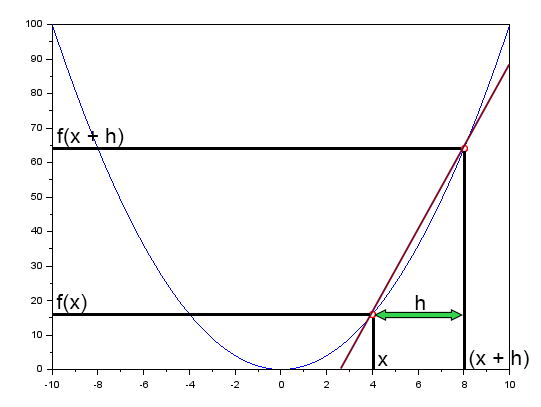
Esta recta roja no es tangente; es una secante y, a medida que h se aproxima a cero, esta misma recta tiende a convertirse en una recta tangente cuando <h> sea igual a cero. Bien, entonces, ¿de dónde viene la idea de la recta tangente? Pues precisamente del gradiente, y no del uso de otra cosa. Pero tranquilo, si acabas de llegar, verás cómo ocurre esto. Volviendo al tema, la expresión mostrada anteriormente define una recta que representa una regresión lineal; por eso no podemos representar otros tipos de distribución de datos. De ahí la necesidad de utilizar lo que se conoce como función de activación. Esto se entenderá mejor más adelante. Por ahora, solo necesitas comprender que, sin la función de activación, estaríamos representando una regresión lineal, lo que limita bastante las posibilidades.
Sin embargo, a medida que aumenta el número de entradas, también aumenta muy rápidamente el número de veces que necesitamos ejecutar los pasos del tres al cinco. Para solucionar esto, tomamos la expresión de mínimos cuadrados y la derivamos, creando así una nueva expresión. Esta expresión se muestra a continuación.
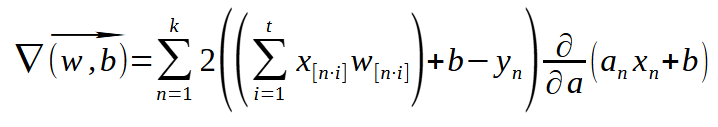
Sé que la expresión anterior puede parecer intimidante. Pero representa todos aquellos pasos destinados a determinar el valor necesario para corregir el error. Como puedes observar, el gradiente es, en realidad, un vector. Este vector es ortogonal a la recta tangente en un punto determinado de la curva. A diferencia de lo que utilizábamos antes, este gradiente sí puede utilizar la recta tangente para buscar el valor de error mínimo. Así, como derivamos la expresión de mínimos cuadrados y en dicha expresión está incorporada la función de activación, al calcular el valor del gradiente también tendremos que derivar la función de activación. Por esta razón utilizamos las derivadas de las funciones de activación. Pero únicamente durante la fase de retropropagación, ya que en esta fase intentamos hacer que la salida del perceptrón pase a considerarse una entrada.
Una última observación. Puede que hayas notado que aquí no he utilizado los conocidos valores <w> y <b>, sino <a> y <b>. Lo hice intencionadamente para mostrar que, al final, todo se reduce a la expresión original, que es la función afín, sometida únicamente a una serie de manipulaciones hasta convertirse en una función de gradiente.
Consideraciones finales
En este artículo has aprendido cómo y por qué el perceptrón fue dejando de utilizar el método de mínimos cuadrados para ajustar el error de sus constantes internas y pasó a utilizar el gradiente para ello. Lo hicimos mediante una transición relativamente suave y sencilla, en la que empezaste a comprender que un perceptrón no es más que un conjunto de funciones y expresiones matemáticas cuyo objetivo es permitirnos generar una regresión lineal más adecuada para una base de datos.
Así que estudia con calma los códigos incluidos en el archivo adjunto, ya que esto te ayudará a entender lo que haremos en los próximos artículos. Estamos llegando a un momento crucial, en el que comenzarás a notar que hay ciertos detalles que deben tenerse en cuenta durante el entrenamiento de un sistema de perceptrones.
| Archivo MQ5 | Descripción |
|---|---|
| Scripts\Example A | Demostración básica |
| Scripts\Example B | Demostración básica |
Traducción del portugués realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/pt/articles/13884
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Del nivel básico al intermedio: Objetos y subventanas (II)
 Automatización de estrategias de trading en MQL5 (Parte 26): Desarrollo de un sistema de promediado basado en Pin Bar para la gestión de múltiples posiciones
 Del nivel básico al intermedio: Objetos y subventanas (III)
 Automatización de estrategias de trading en MQL5 (Parte 25): Sistema de líneas de tendencia con ajuste por mínimos cuadrados y generación dinámica de señales

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso