

Red neuronal en la práctica: Cuándo usar una neurona artificial y entender su función en MQL5
 21
 0

Introducción
En el artículo anterior Red neuronal en la práctica: Descenso de Gradiente Estocástico, hicimos una modificación para crear una pequeña neurona que utiliza descenso de gradiente. Esta pasó a incorporar algunos cambios cuyo objetivo era facilitar la explicación de ciertos aspectos sobre cómo funciona una neurona. El objetivo principal era aclarar un concepto que genera mucha confusión y del que a menudo se habla sin comprenderlo. A partir de ahora, comenzaremos a entender por qué las funciones de activación son necesarias en algunos casos y en otros no. También veremos por qué una red neuronal no siempre es la mejor opción. Pero, sobre todo, entenderemos por qué existen diferentes arquitecturas de redes neuronales y cómo puedes dimensionar adecuadamente una red neuronal. Y, por supuesto, abordaremos otras cuestiones en los próximos artículos.
Sé que esta introducción puede parecer bastante interesante y, al mismo tiempo, algo ambiciosa para un solo artículo. Explicar tantas cosas en un único artículo sería impracticable, ya que tendría un número considerable de páginas. Veamos entonces por qué, después de haber mostrado tantas cosas anteriormente, solo ahora digo que vamos a comenzar a analizar estos detalles sobre las redes neuronales. El motivo es sencillo: antes era necesario mostrar toda una serie de conceptos para que tú, mi querido lector, pudieras finalmente entender de qué vamos a tratar realmente.
Básicamente, podría decir que este sería el artículo cero, el punto en el que realmente comenzaremos a hablar en serio sobre el tema. Esto se debe a que, a estas alturas, si has leído los demás artículos, probado sus códigos e intentado modificar el conjunto de entrenamiento de las neuronas, o comparado los primeros artículos con los últimos, probablemente ya habrás notado la lógica de lo que explicaré a continuación.
Si has llegado directamente a este artículo, no tienes conocimientos sobre redes neuronales y tienes muchas dudas sobre el tema, te sugiero que empieces por los artículos anteriores para comprender lo que se explicará de aquí en adelante. Dicho esto, podemos comenzar.
¿Realmente necesito crear una neurona?
Con todo lo que los medios, los influencers, etc. llevan diciendo desde hace algún tiempo, da la impresión de que no podremos vivir sin redes neuronales. Como si fueran la octava maravilla del mundo moderno. La realidad no es exactamente así. El estudio de las redes neuronales, como habrás visto en los artículos anteriores, constituye un campo de investigación bastante interesante. En términos generales, sin embargo, tienen limitaciones y pueden fallar. No pueden manejar determinados tipos de problemas y no son tan versátiles como muchos afirman.
En muchos casos, un programa diseñado para resolver un problema concreto será considerablemente más eficiente que cualquier red neuronal que podamos construir. Esto se debe a varios factores. Si tú, mi querido lector, decides utilizar una red neuronal para una tarea, tendrás que entrenarla para que pueda realizarla. Además, puede ocurrir que ni siquiera consiga interpretar los datos con los que intentas entrenarla.
Hasta ahora no había mencionado este punto. Aunque no siempre es necesario, la mayoría de las veces tendrás que normalizar los valores que utilizará la red neuronal. Más adelante veremos por qué, pero conviene que lo tengas presente. A veces tendrás que normalizar los valores de entrada o ajustarlos a un intervalo determinado. Si no lo haces, la red neuronal no conseguirá converger ni producir una representación adecuada de los datos de entrenamiento.
Incluso si consigues que la red neuronal funcione, tendrás que considerar otro aspecto: el costo de procesamiento. No es fácil explicar esta cuestión porque intervienen varios aspectos que todavía no he explicado en estos artículos. Sin embargo, con lo que ya hemos visto podemos considerar algunos factores para que tú, mi querido lector, entiendas por qué una red neuronal no siempre es la mejor opción.
Para comprobarlo, hagamos la siguiente prueba. Tomemos la neurona del artículo anterior y proporcionémosle algunos datos que utilizamos al principio de esta serie. El nuevo código de la neurona quedará así:
001. //+------------------------------------------------------------------+
002. #property copyright "Daniel Jose"
003. //+------------------------------------------------------------------+
004. #include <Canvas\Canvas.mqh>
005. //+------------------------------------------------------------------+
006. #define PrintEx(A)  Print(#A, " => ", A)
007. #define macroRandom (rand() / (double)SHORT_MAX)
008. #define _SizeLine   300
009. #define nColuns     2
010. //+------------------------------------------------------------------+
011. CCanvas canvas;
012. //+------------------------------------------------------------------+
013. double Train[][nColuns] {
014.                             {-100, -150},
015.                             { -80,  -50},
016.                             {  30,   80},
017.                             { 100,  120},
018.                   };
019. //+------------------------------------------------------------------+
020. const double epsilon = 1e-3;
021. //+------------------------------------------------------------------+
022. struct stErr
023. {
024.     double  Weight,
025.             Bias;
026. };
027. //+------------------------------------------------------------------+
028. stErr Cost(const double w, const double b, const uint p1 = 0, const uint p2 = Train.Size() / nColuns)
029. {
030.     double x, y, t;
031.     stErr err;
032.
033.     ZeroMemory(err);
034.     for (uint c = p1; c < p2; c++)
035.     {
036.         x = Train[c][0];
037.         y = Train[c][1];
038.         t = 2 * ((x * w + b) - y);
039.         err.Weight += (t * x);
040.         err.Bias += t;
041.     }
042.
043.     return err;
044. }
045. //+------------------------------------------------------------------+
046. void PlotText(const int x, const int y, const uchar line, const string sz0)
047. {
048.     uint w, h;
049.
050.     TextGetSize(sz0, w, h);
051.     canvas.TextOut(x - (w / 2), y + _SizeLine + (line * h) + 5, sz0, ColorToARGB(clrBlack));
052. }
053. //+------------------------------------------------------------------+
054. inline double CallZoom(void)
055. {
056.     double d1 = 0;
057.
058.     for (uint c = 0; c < Train.Size() / nColuns; c++)
059.     {
060.         d1 = MathMax(d1, MathAbs(Train[c][0]));
061.         d1 = MathMax(d1, MathAbs(Train[c][1]));
062.     }
063.
064.     return _SizeLine / d1;
065. }
066. //+------------------------------------------------------------------+
067. void Plot_Train2D(const int x, const int y, const double weight, double bias)
068. {
069.     int vx, vy;
070.     double zoom;
071.     uint n = Train.Size() / nColuns;
072.
073.     zoom = CallZoom();
074.     canvas.LineVertical(x, y - _SizeLine, y + _SizeLine, ColorToARGB(clrRoyalBlue, 255));
075.     canvas.LineHorizontal(x - _SizeLine, x + _SizeLine, y, ColorToARGB(clrRoyalBlue, 255));
076.     for (uint c = 0; c < n; c++)
077.     {
078.         vx = (int)(Train[c][0] * zoom);
079.         vy = (int)(Train[c][1] * zoom);
080.        canvas.FillCircle(x + vx, y - vy, 5, ColorToARGB(clrRed, 255));
081.     }
082.     canvas.LineAA(
083.                 x + (int)(Train[0][0] * zoom),
084.                 y - (int)((Train[0][0] * weight + bias) * zoom),
085.                 x + (int)(Train[n - 1][0] * zoom),
086.                 y - (int)((Train[n - 1][0] * weight + bias) * zoom),
087.                 ColorToARGB(clrForestGreen));
088.     PlotText(x, y, 1, StringFormat("Zoom: %.2fx", zoom));
089.     PlotText(x, y, 2, StringFormat("f(x) = %.4fx %c %.4f", weight, (bias < 0 ? '-' : '+'), MathAbs(bias)));
090. }
091. //+------------------------------------------------------------------+
092. void OnStart()
093. {
094.     double weight, bias;
095.     int    x, y;
096.     ulong  it0, it1, count;
097.     stErr  err;
098.
099.     Print("************************************");
100.     Print("Stochastic Gradient Descent Neuron...");
101.     Print("************************************");
102.     MathSrand(512);
103.     weight = (double)macroRandom;
104.     bias = (double)macroRandom;
105.
106.     it0 = GetTickCount();
107.     for(count = 0; count < 5; count++)
108.     {
109.         err = Cost(weight, bias);
110.         if ((MathAbs(err.Weight) <= epsilon) && (MathAbs(err.Bias) <= epsilon))
111.             break;
112.         weight -= (err.Weight * epsilon);
113.         bias -= (err.Bias * epsilon);
114.         PrintFormat("%I64u > w0: %.4f %.4f || b: %.4f %.4f", count, weight, err.Weight, bias, err.Bias);
115.     }
116.     it1 = GetTickCount();
117.     Print("Time: ", (it1 - it0) / 1000.0, " seconds.");
118.     PrintEx(count);
119.     PrintEx(weight);
120.     PrintEx(bias);
121.     PrintEx(err.Weight);
122.     PrintEx(err.Bias);
123.     Print("Press ESC to close....");
124.     Print("************************************");
125.
126.    x = (int)ChartGetInteger(0, CHART_WIDTH_IN_PIXELS, 0);
127.    y = (int)ChartGetInteger(0, CHART_HEIGHT_IN_PIXELS, 0);
128.    canvas.CreateBitmapLabel("BL", 0, 0, x, y, COLOR_FORMAT_ARGB_NORMALIZE);
129.    canvas.Erase(ColorToARGB(clrWhite, 255));
130.     x /= 2;
131.     y /= 2;
132.
133.     Plot_Train2D(x, y, weight, bias);
134.
135.    canvas.Update(true);
136.
137.     while(!IsStopped())
138.         if (TerminalInfoInteger(TERMINAL_KEYSTATE_ESCAPE) !=0)
139.             break;
140.
141.     canvas.Destroy();
142. }
143. //+------------------------------------------------------------------+
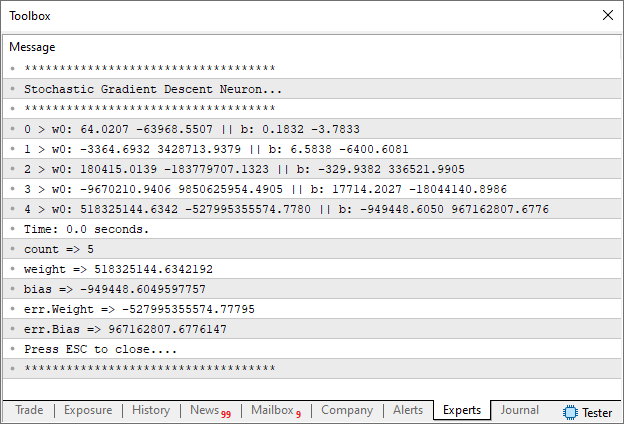
Al compilar y ejecutar este código, verás lo siguiente en el terminal:
En el gráfico en el que ejecutes el script, verás esta imagen:
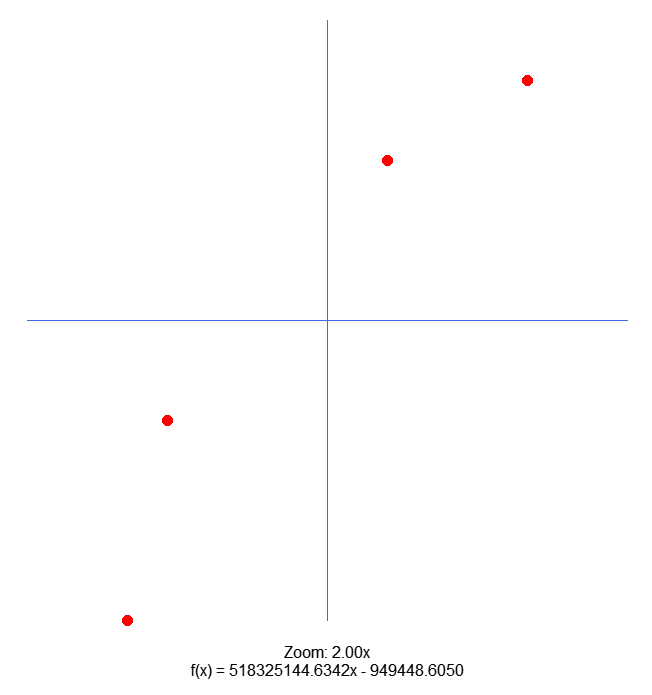
Bien, quizá ahora te estés preguntando: «¿Qué ha pasado aquí? No entiendo absolutamente nada». Pues, mi querido lector, ni tú entiendes lo que ha ocurrido ni la neurona artificial logra interpretar los datos: la neurona no consiguió converger hacia una solución. Tal vez pienses: «Un momento, estás haciendo trampa. Esto tiene que ser una trampa. ¿Cómo es posible que la neurona no haya podido interpretar los datos de entrenamiento?». Y haces bien en cuestionarlo. No debemos creer algo solo porque alguien nos lo haya mostrado o nos lo haya dicho. Debemos comprobarlo por nosotros mismos para ver si es cierto, aunque siempre con cautela. Así que veamos qué ocurrió para que aparecieran los resultados de las imágenes anteriores.
Primero, examinemos el código. Observa que en la línea 13 cambié los valores de entrenamiento. Más adelante volveré sobre este punto. Pasemos ahora a la siguiente modificación: en la línea 107, redujimos de ULONG_MAX a cinco el número de iteraciones del bucle for. Fue una decisión prudente, al igual que añadir la línea 114 para comprobar qué estaba haciendo la neurona internamente. Y, por mucho que algunos digan lo contrario, NO, NUNCA DEBES DEJAR QUE UN CÓDIGO GENERE RESULTADOS SIN SABER QUÉ ESTÁ GENERANDO. Hace algún tiempo oí a alguien decir que pronto no sabríamos qué estaba aprendiendo la red. Es la mayor tontería que he oído. Sin duda, esa persona no es programadora: se limita a teclear código.
Pero volvamos al tema. Limitamos el bucle a solo cinco iteraciones para ver si la neurona empezaba a converger hacia una solución. Al observar los resultados, queda claro que no va a hacerlo. De hecho, los valores del error aumentan exponencialmente, lo que indica que la neurona no sabe qué está haciendo ni qué debería hacer con los datos. Recuerda que esos fueron los únicos cambios en el código. Puedes tomar el código adjunto al artículo anterior y probarlo. Verás que el original encuentra una solución, pero que, tras introducir estos cambios, la neurona queda más perdida que una cucaracha después de un zapatazo. ¿Por qué ocurrió esto? ¿Acaso los datos no tienen sentido? Veamos de dónde salieron esos datos de entrenamiento.
Si consultas el artículo Red neuronal en la práctica: Mínimos cuadrados, verás que se utilizan esos mismos datos. Allí, al igual que en otros artículos en los que no utilizábamos neuronas, sí conseguíamos encontrar una solución. Aquí, en cambio, la neurona no lo consigue. Antes de explicar por qué, veamos la ecuación obtenida con otros métodos:

No tienes por qué creerme sin comprobarlo. En dos artículos mostré cómo utilizar la pseudoinversa; el segundo es Red neuronal en la práctica: Pseudoinversa (II). Puedes probarlo tú mismo y verás que funciona. Entonces, ¿qué falla aquí? ¿Estamos ante el mismo problema que encontramos al utilizar una neurona para representar puertas lógicas? ¿O ante un caso similar al de la puerta XOR? No se trata de ninguno de los dos. Para aclararlo, pasemos a un nuevo tema.
La esencia de una neurona artificial
Desde que empezamos a esbozar una neurona, he mostrado cómo funciona y por qué hace lo que hace. Si todavía no lo entiendes, lee con calma los artículos anteriores, porque aquí profundizaremos un poco más en el tema.
Voy a repetir algo que ya he mencionado: EL APRENDIZAJE DE TODA NEURONA SE BASA EN LA RECTA SECANTE. A muchos les gusta hablar de la recta tangente cuando tratan el aprendizaje automático. Pero, a mi juicio, una de dos: o confunden los conceptos o no saben de qué están hablando. La neurona original, de la que derivan las demás, se construyó a partir de la siguiente función:

Esta función representa precisamente la función de costo. Independientemente del método utilizado, todo se reduce a ella. Sin embargo, no representa la recta tangente, sino la secante. Si tenemos esto presente y recordamos que una recta puede expresarse mediante la siguiente ecuación:

Podemos empezar a entender por qué una red neuronal, o incluso una sola neurona, se construye de esa manera. Quizá algunos estén pensando: «Este tipo no sabe de qué habla. Claro que la neurona no podía interpretar los datos de entrenamiento: le falta una función de activación para aprender a representarlos. Además, no forma parte de una red ni utiliza retropropagación». Bien, si pensaste eso o te hiciste esa pregunta, te sugiero, con todo respeto, que dejes de leer este artículo y cualquier otro que escriba sobre el tema. Ninguno te aportará nada si ya tienes una idea preconcebida al respecto. Hasta luego y que te vaya bien.
En fin, sigamos. El objetivo de toda neurona es trazar una recta secante con un valor de h lo más cercano posible a cero. Ese valor de h es el error que consideramos aceptable. En mis códigos, ese mismo valor de error también se utiliza como tasa de aprendizaje: determina qué proporción del error utilizará la neurona para calcular el siguiente paso e intentar reducirlo. En una neurona que utiliza la regresión lineal, o una función derivada de ella, el coeficiente angular de la ecuación se considera el peso, mientras que el valor donde la recta corta el eje vertical se considera el sesgo. Si buscas una representación de una neurona, normalmente encontrarás algo parecido a la siguiente imagen.
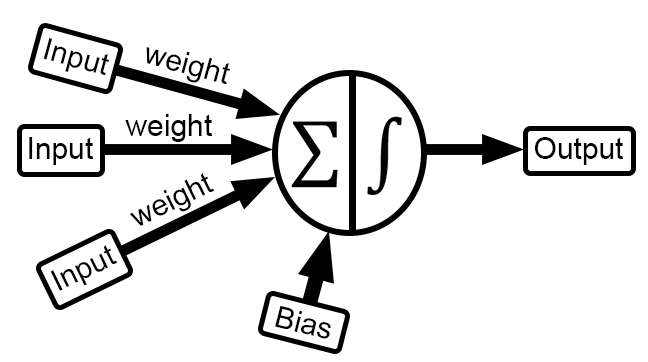
Pero ¿qué representa esta imagen? Para algunos, algo mágico; para otros, un resumen de lo que hay que implementar; y para otros, absolutamente nada. Veamos qué hemos implementado en nuestro código. Para ello, debemos modificar la imagen anterior hasta obtener la siguiente.
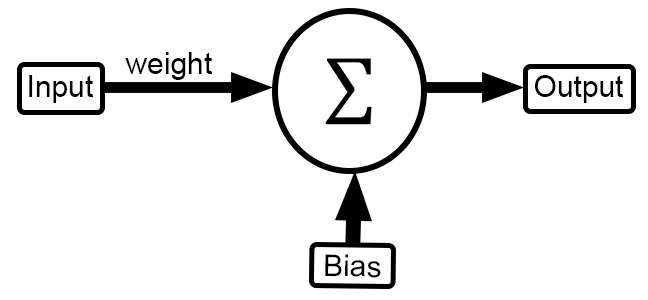
Bien, se parece bastante a la imagen anterior. Pero ¿cómo podemos saber si esa semejanza es real o si se trata de alguna trampa? Para comprobarlo, hay que examinar el código y, en particular, lo que ocurre en el siguiente fragmento.
                                   .
                                   .
                                   .
012. //+------------------------------------------------------------------+
013. double Train[][nColuns] {
014.                             {-100, -150},
015.                             { -80,  -50},
016.                             {  30,   80},
017.                             { 100,  120},
018.                   };
019. //+------------------------------------------------------------------+
020. const double epsilon = 1e-3;
021. //+------------------------------------------------------------------+
022. struct stErr
023. {
024.     double  Weight,
025.             Bias;
026. };
027. //+------------------------------------------------------------------+
028. stErr Cost(const double w, const double b, const uint p1 = 0, const uint p2 = Train.Size() / nColuns)
029. {
030.     double x, y, t;
031.     stErr err;
032.
033.     ZeroMemory(err);
034.     for (uint c = p1; c < p2; c++)
035.     {
036.         x = Train[c][0];
037.         y = Train[c][1];
038.         t = 2 * ((x * w + b) - y);
039.         err.Weight += (t * x);
040.         err.Bias += t;
041.     }
042.
043.     return err;
044. }
045. //+------------------------------------------------------------------+
                                   .
                                   .
                                   .
091. //+------------------------------------------------------------------+
092. void OnStart()
093. {
094.     double weight, bias;
095.     int    x, y;
096.     ulong  it0, it1, count;
097.     stErr  err;
098.
099.     Print("************************************");
100.     Print("Stochastic Gradient Descent Neuron...");
101.     Print("************************************");
102.     MathSrand(512);
103.     weight = (double)macroRandom;
104.     bias = (double)macroRandom;
105.
106.     it0 = GetTickCount();
107.     for(count = 0; count < 5; count++)
108.     {
109.         err = Cost(weight, bias);
110.         if ((MathAbs(err.Weight) <= epsilon) && (MathAbs(err.Bias) <= epsilon))
111.             break;
112.         weight -= (err.Weight * epsilon);
113.         bias -= (err.Bias * epsilon);
114.         PrintFormat("%I64u > w0: %.4f %.4f || b: %.4f %.4f", count, weight, err.Weight, bias, err.Bias);
115.     }
116.     it1 = GetTickCount();
Es cierto que nuestra función de costo puede parecer un tanto extraña, pues en realidad es la primera derivada de la función original. Por eso no se parece a la ecuación de una recta. Sin embargo, al examinar el código verás que en la línea 13 tenemos el input y, en la línea 94, el weight y el bias. Estos últimos reciben valores arbitrarios en las líneas 103 y 104, respectivamente. Aun así, los valores no son completamente aleatorios, ya que en la línea 102 establecemos el nivel inicial de esos valores. Esto se debe al propósito didáctico del código.
En una implementación real, el código de la línea 102 sería ligeramente distinto: tomaría como referencia el reloj o un contador del equipo para que los valores fueran aleatorios en cada ejecución. Al llegar a la línea 116, obtendríamos el output. Pero esto puede resultar confuso, porque la función de costo no corresponde a una regresión lineal, como cabría esperar si realmente estuviéramos utilizando una recta secante.
Si es así, podemos volver al artículo ##>>Red neuronal en la práctica: La primera neurona<<https://www.mql5.com/es/articles/13745##. Allí el código implementa una regresión lineal, como puedes comprobar en el siguiente fragmento, que reproduce el código de ese artículo.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. #define macroRandom (rand() / (double)SHORT_MAX)
05. //+------------------------------------------------------------------+
06. double Train[][2] {
07.                     {0, 0},
08.                     {1, 2},
09.                     {2, 4},
10.                     {3, 6},
11.                     {4, 8},
12.                   };
13. //+------------------------------------------------------------------+
14. const uint nTrain = Train.Size() / 2;
15. const double eps = 1e-3;
16. //+------------------------------------------------------------------+
17. double Cost(const double w, const double b)
18. {
19.     double err, fx, a;
20.
21.     err = 0;
22.     for (uint c = 0; c < nTrain; c++)
23.     {
24.         a = Train[c][0];
25.         fx =  a * w + b;
26.         err += MathPow(fx - Train[c][1], 2);
27.     }
28.
29.     return err / nTrain;
30. }
31. //+------------------------------------------------------------------+
32. void OnStart()
33. {
34.     double weight, ew, eb, e1, bias;
35.     int f = FileOpen("Cost.csv", FILE_COMMON | FILE_WRITE | FILE_CSV);
36.
37.     Print("The first neuron...");
38.     MathSrand(512);
39.     weight = (double)macroRandom;
40.     bias = (double)macroRandom;
41.
42.     for(ulong c = 0; (c < ULONG_MAX) && ((e1 = Cost(weight, bias)) > eps); c++)
43.     {
44.         ew = (Cost(weight + eps, bias) - e1) / eps;
45.         eb = (Cost(weight, bias + eps) - e1) / eps;
46.         weight -= (ew * eps);
47.         bias -= (eb * eps);
48.         if (f != INVALID_HANDLE)
49.             FileWriteString(f, StringFormat("%I64u;%f;%f;%f;%f;%f\n", c, weight, ew, bias, eb, e1));
50.     }
51.     if (f != INVALID_HANDLE)
52.         FileClose(f);
53.     Print("Weight: ", weight, "  Bias: ", bias);
54.     Print("Error Weight: ", ew);
55.     Print("Error Bias: ", eb);
56.     Print("Error: ", e1);
57. }
58. //+------------------------------------------------------------------+
En efecto, el código anterior implementa una regresión lineal y, esta vez, la función de costo es una recta. Puedes comprobarlo en la línea 25: es la misma ecuación que mostré al comienzo de este apartado. Sin embargo, aunque aquí la regresión lineal sea evidente, esta neurona tampoco consigue modelar los datos utilizados en programas anteriores. ¿Por qué? Por la función de costo. Ahí está el problema. «¡Un momento! ¿Me estás diciendo que la función de costo impide que la neurona aprenda a representar los datos?». Sí, exactamente, mi querido lector. La función de costo impide que la neurona aprenda a representar ciertos tipos de datos y, por tanto, que converja hacia una solución. Quizá esto parezca una afirmación completamente absurda, pero mi experiencia me permite afirmarlo.
Tal vez ahora estés pensando: «Pero estas neuronas no utilizan retropropagación. Solo realizan propagación hacia adelante. Por eso no consiguen aprender a representar los datos». Bien, mi querido lector, ahora sí me atrapaste. Pasemos a otro tema para entenderlo mejor.
Retropropagación: ¿qué es eso?
Una de las cosas que más me hacen reír son los términos utilizados en redes neuronales. La mayoría aparecieron hace relativamente poco. Cuando empecé a estudiar el tema, durante mis primeros estudios de C/C++, esos términos no existían o, si existían, los utilizaba muy poca gente. En cualquier caso, muchos de los términos empleados al hablar de redes neuronales no son más que disparates: palabras inventadas para confundir a quienes empiezan y dar la impresión de que el tema es mucho más complicado de lo que realmente es.
La llamada retropropagación, para la que aún no contamos con un término en portugués, no es más que lo que ocurre dentro del bucle for de la función OnStart. Puede que esto haya sonado un poco abstracto. Veámoslo en los códigos del apartado anterior. Para facilitarlo, reproduzco el fragmento de código en el que se produce esa retropropagación. En el código de la neurona basada en descenso de gradiente, puedes verlo en el siguiente fragmento.
107.     for(count = 0; count < 5; count++)
108.     {
109.         err = Cost(weight, bias);
110.         if ((MathAbs(err.Weight) <= epsilon) && (MathAbs(err.Bias) <= epsilon))
111.             break;
112.         weight -= (err.Weight * epsilon);
113.         bias -= (err.Bias * epsilon);
114.         PrintFormat("%I64u > w0: %.4f %.4f || b: %.4f %.4f", count, weight, err.Weight, bias, err.Bias);
115.     }
«¿Pero dónde? No lo veo». Fíjate en las líneas 112 y 113: ahí se produce la retropropagación en la neurona basada en descenso de gradiente. En la neurona de regresión, ocurre en el fragmento siguiente.
42.     for(ulong c = 0; (c < ULONG_MAX) && ((e1 = Cost(weight, bias)) > eps); c++)
43.     {
44.         ew = (Cost(weight + eps, bias) - e1) / eps;
45.         eb = (Cost(weight, bias + eps) - e1) / eps;
46.         weight -= (ew * eps);
47.         bias -= (eb * eps);
48.         if (f != INVALID_HANDLE)
49.             FileWriteString(f, StringFormat("%I64u;%f;%f;%f;%f;%f\n", c, weight, ew, bias, eb, e1));
50.     }
En este caso, mira las líneas 46 y 47. ¿Lo ves, mi querido lector? Estamos utilizando retropropagación. Por mucho que algunos compliquen el término, se trata de algo bastante sencillo: ayuda al código a intentar converger. No tiene nada de mágico. Sin ella, la neurona no podría seguir intentando reducir el error observado.
Así pues, la retropropagación no es la razón por la que la neurona no consigue aprender a representar los datos. El límite está en que no puede manejar todos los escenarios posibles. Quizá a estas alturas estés algo inquieto: parece que estoy destruyendo tus sueños e ilusiones al mostrar que cada uno de los elementos que muchos consideran indispensables para que una neurona aprenda no funcionan como dicen. Pero todavía queda una esperanza: la función de activación. Como las neuronas que hemos visto aquí no la tienen, tal vez sea lo que les falta para converger hacia una respuesta.
Vaya, mi querido lector, eso sí que es aferrarse a una esperanza: pensar que las cosas aún pueden mejorar y que tu sueño quizá se haga realidad. Al fin y al cabo, existen programas capaces de reconocer escritura, habla e imágenes, entre otras cosas. Pero ahora me pregunto: ¿cómo voy a ser tan cruel? No me gusta ser el villano de esta historia, aunque tampoco quiero dar una idea falsa. Si tengo que decirlo, mejor hacerlo de una vez. Si voy a destruir tus sueños, que sea ya.
Lamento decirte, mi querido lector, que la función de activación tampoco es mágica. No hará que una neurona conquiste el mundo ni que tus sueños se hagan realidad. Cumple otro propósito, pero explicarlo ahora sería complicado. Antes tendremos que crear algunos elementos e implementar varios fragmentos de código para que puedas comprender, en la práctica, qué hace la función de activación.
Y, a diferencia de quienes se limitan a recomendar «usa esta función o aquella», las funciones de activación deben elegirse con cuidado para que la neurona o la red neuronal funcionen correctamente. En realidad, las funciones de activación adquieren mayor relevancia únicamente cuando utilizamos una red neuronal o determinados tipos de datos para el entrenamiento. Lo vimos por primera vez cuando mostré cómo utilizar una neurona para representar puertas lógicas. Aunque probáramos un sistema de regresión o cualquier otra implementación, sin una función de activación la neurona acabaría estancándose. Una vez allí, dejaría de aprender y, por tanto, no lograría converger hacia una representación más adecuada de los datos de entrenamiento.
En cualquier caso, no tienes por qué preocuparte, mi querido lector. Pronto veremos en la práctica cómo funciona la función de activación y entenderás mejor cómo elegirla. Quizá tardes un poco en dominar el tema, pero estoy buscando una forma didáctica de explicarlo. No quiero limitarme a mostrar cálculos o fórmulas: quiero que comprendas por qué y cuándo utilizar una función de activación. También hay otro aspecto que exige atención, aunque en muchos casos no llega a ser un problema: los datos de entrada. A veces, la neurona sencillamente no consigue interpretar la información que recibe. Ese no es el caso que hemos visto en este artículo; me refiero a una dificultad de otra naturaleza. Voy a explicarla brevemente, aunque se entenderá mejor más adelante.
Supongamos que quieres entrenar una red neuronal para el reconocimiento facial. Quieres que pueda indicar si se trata de un hombre, una mujer, una persona mayor, un niño, un animal o cualquier otra cosa; por ejemplo, qué expresión tiene el rostro en ese momento. Lo que importa aquí es que la red debe reconocer algo en el rostro del individuo. ¿Cómo se hace? En teoría, es sencillo: le indicas a un programa que busque una región determinada de la imagen y luego examinas ciertos puntos dentro de ella.
Lo importante es que las distancias entre esos puntos se envían a la red neuronal. La red no sabe qué se está analizando: podría ser cualquier cosa. Lo único que recibe son las distancias entre los puntos proporcionados por otro programa. Tras procesar esos datos, devuelve un resultado expresado en porcentaje. Ese resultado nunca será del 100 %, porque la red no busca que los valores coincidan exactamente con los que produce la ecuación, sino indicar hasta qué punto esos valores se acercan o se alejan de los que reconoce, tomando como referencia una ecuación calculada previamente.
Aquí muchos se confunden y creen que la red neuronal reconoce al individuo o su expresión. Pero no: lo que hace es utilizar una ecuación o un polinomio cargado previamente. Después, calcula el margen de error entre los valores de entrada y los que se obtendrían al evaluar ese polinomio.
Consideraciones finales
Lo que hemos visto en este artículo puede parecer confuso, disperso y sin un hilo conductor. Pero quiero recordarte, mi querido lector, que el propósito de estos artículos es presentar el tema con la mayor claridad posible. Sin trucos, sin cajas negras ni métodos oscuros. Cualquier programador puede reproducir todo lo que estoy mostrando. Aquí no hay secretos. Y, pese a lo que afirman muchos influencers, las redes neuronales no son un tema sencillo ni admiten un enfoque único: cada caso es distinto. En muchos casos, se recurre a una programación más directa para obtener un polinomio que represente los datos. Una vez hecho esto, podemos decir que cualquier predicción basada en ese polinomio puede constituir una forma de interacción con una inteligencia artificial. Pero no siempre es así. Recuerda los artículos en los que hablé sobre la inteligencia artificial y sobre cómo ciertas cosas pueden parecer inteligentes o dar la impresión de contar con algún mecanismo inteligente.
En cualquier caso, a estas alturas ya deberías estar algo más prevenido ante lo que se afirma sobre el tema y preparado para entender algunos aspectos de las redes neuronales y la inteligencia artificial. Todavía nos queda mucho por explorar: hasta ahora apenas hemos vislumbrado algunas posibilidades de implementación. En los próximos artículos veremos otros aspectos que te ayudarán a comprender mejor el tema. También veremos implementaciones que, por extraño que parezca, no se asemejan a una neurona ni a ninguna arquitectura de red neuronal. Aun así, pueden comportarse como tales y dar la impresión de que aprenden o crean una representación que pueda utilizarse en una inteligencia artificial o una red neuronal.
Si te interesa lo que expliqué en el apartado anterior sobre reconocimiento de imágenes, en particular cómo una imagen puede representarse mediante un polinomio, dejaré dos enlaces en las referencias. Son materiales publicados en 2013 que, pese al tiempo transcurrido, siguen siendo pertinentes. Incluiré también un sitio para quienes quieran estudiar las matemáticas con mayor profundidad: sus contenidos están organizados para facilitar la búsqueda de temas concretos.
Material de referencia
Traducción del portugués realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/pt/articles/13865
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Probador de estrategias para Python-MetaTrader 5 (Parte 01): Simulador de operaciones
 Del nivel básico al intermedio: Subventanas (I)
 Del nivel básico al intermedio: Subventanas (II)
 Desarrollo de asesores expertos autooptimizables en MQL5 (Parte 11): Una introducción sencilla a los fundamentos del álgebra lineal

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso