

Red neuronal en la práctica: Iniciando la cadena
 23
 2

Introducción
En el artículo anterior, Red neuronal en la práctica: Una cuestión de escala, se explicó algo bastante extraño que debe comprenderse muy bien, ya que ese tipo de situación puede afectar a un sistema que se está entrenando e impedir por completo el entrenamiento. Y lo más extraño es que el perceptrón, utilizando la función de mínimos cuadrados, puede converger reduciendo su error. Lo mismo puede no ocurrir al utilizar el gradiente, aunque se mantengan los mismos datos de entrenamiento.
En este artículo seguiremos tratando ese mismo asunto, aunque desde un enfoque algo diferente, ya que aquí analizaremos qué ocurre cuando utilizamos una pequeña secuencia de perceptrones conectados en serie. O, dicho de forma resumida, qué sucede cuando cambiamos la escala de los datos y hacemos que la salida de un perceptrón se utilice como entrada de un nuevo perceptrón.
Un pequeño rasguño en el ego
Antes de empezar a centrarnos realmente en la parte del código, quiero hablar de algo que puede ayudarte a entender una cuestión un tanto extraña que, en principio, no parece tener mucho sentido.
Lo mencionado en la introducción puede parecer algo fuera de contexto: en determinados escenarios, un sistema de perceptrones puede converger mediante la corrección por mínimos cuadrados y, sin embargo, no conseguir reducir su error utilizando el gradiente. Esto se debe precisamente a que todo el mundo dice que el gradiente es mejor que la corrección mediante mínimos cuadrados.
Quien estudia y se dedica a la programación sabe que, a veces, algo que parece peor puede sorprender en determinadas situaciones concretas. Un caso típico es la ordenación de datos. Si buscas algoritmos de ordenación, verás que muchos mencionan QuickSort como el mejor algoritmo que existe para ordenar y Bubble Sort como el peor, precisamente por la forma en que funciona la ordenación. Por tanto, parecería obvio y razonable que, siempre que fuera necesario ordenar datos, QuickSort fuese la opción más adecuada. Y es aquí donde la cosa empieza a ponerse extraña. Hay casos en los que, si utilizas QuickSort, obtendrás un rendimiento peor que si utilizaras Bubble Sort. ¿Cómo puede ser? Esto no tiene el menor sentido. Pues bien, mi amigo lector, la verdad es que aquello que gusta a todo el mundo no siempre es realmente la mejor opción.
Este tipo de situación que vimos en el artículo anterior y en la que profundizaremos aquí puede resultar un tanto incómoda si se analiza sin demasiado cuidado. La elección del mecanismo que deberá utilizarse para corregir el error de la red, o incluso de un solo perceptrón, debe hacerse teniendo en cuenta no solo el ahorro en términos de procesamiento, sino también la capacidad del propio mecanismo para permitir que el error converja hacia un nivel más bajo. Un sistema implementado para manejar un determinado tipo de situación puede fracasar estrepitosamente cuando se utiliza en una situación completamente diferente. Por esta razón, al conectar los perceptrones, debemos prestar atención al tipo de problema con el que vamos a trabajar, ya que no existe ninguna fórmula que debas utilizar siempre para cualquier tipo de situación.
Como estamos llegando al límite de lo que puede hacerse utilizando un solo perceptrón, quizá buena parte de lo que se explicará aquí empiece a resultar un tanto incómodo para algunos. Esto se debe a que necesitamos empezar a pensar en la topología de la red, momento en el que el asunto deja de ser una simple curiosidad y se convierte en algo un poco más serio.
Normalmente, y no hay nada de malo en ello, muchos simplemente prefieren utilizar algún framework para no tener que pensar en la topología de una red de perceptrones. Sin embargo, utilizar este tipo de herramientas y componentes no nos ayuda a entender cómo funcionan realmente las cosas. Solo las simplifica, ocultando buena parte de lo que realmente necesitarías saber antes de afirmar que sabes implementar una red de perceptrones y entiendes cómo funciona para resolver tareas diversas.
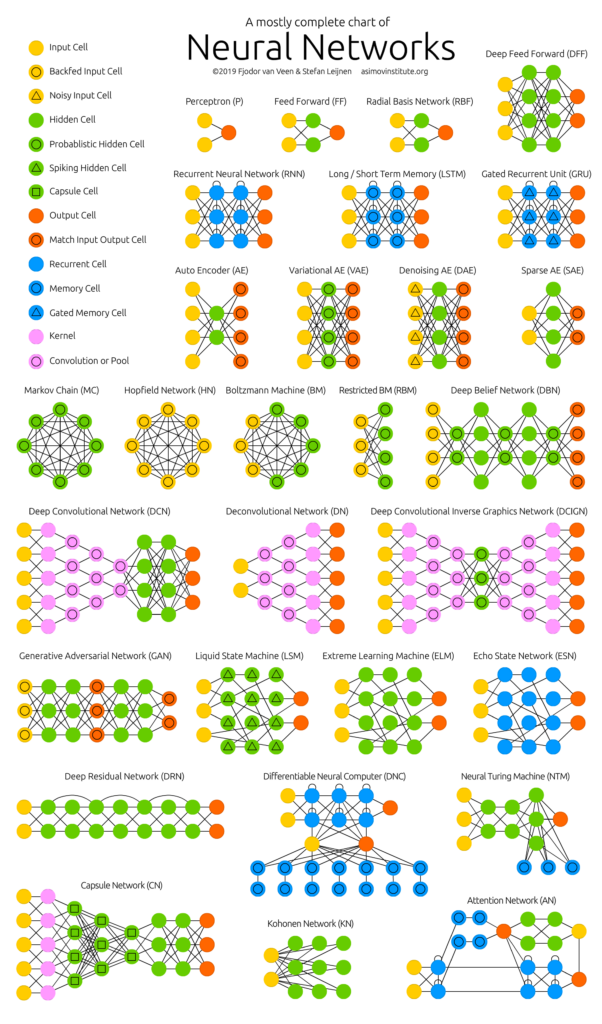
Imagen 01
Esta imagen muestra las principales formas de conexión entre perceptrones en diferentes configuraciones. Muchos de ustedes seguramente ya habrán oído hablar de redes con capas ocultas y cosas por el estilo. Pero estoy seguro de que no sabían que existen diferencias entre ellas. Incluso existen redes que no tienen capas ocultas o cuyos puntos de entrada o salida de datos no están claramente definidos. Esto contrasta con la idea habitual de que una red tiene un punto de entrada y un punto de salida. El detalle importante es que rara vez se menciona que esos puntos no siempre están perfectamente definidos, ya que dependen de la topología adoptada.
Aquí, en estos artículos, como estamos centrados en la parte didáctica, siempre he utilizado modelos en los que tenemos una entrada y una salida bien definidas. En el caso de la entrada, podemos tener varias, como se ha venido mostrando. En cuanto a la salida, hasta ahora solo hemos tenido una única salida. Pero esto no significa que las cosas vayan a ser siempre así ni que tengan que serlo. De hecho, es más habitual que una red tenga varias salidas que una sola. Pero, para tener más de una salida, es muy probable que estemos utilizando más de un perceptrón. Sin embargo, esto no es, en ningún caso, una regla. No te preocupes por ello ahora. En otro momento lo veremos con más calma.
Muy bien, como ya tenemos un solo perceptrón funcionando y ya sabemos cómo introducir los datos para conseguir cierto aprendizaje, podemos dar algunos pasos más. Es cierto que todavía no he explicado el motivo de las funciones de activación. Pero hay una razón para ello. Solo tiene sentido explicar las funciones de activación cuando empezamos a trabajar con más de un perceptrón o cuando necesitamos generar un tipo específico de salida. Pero, como aquí no voy a trabajar con salidas específicas, necesitamos al menos definir una topología sencilla, o arquitectura de red, para poder entender qué significa utilizar una u otra función de activación. El simple hecho de decir: «Voy a utilizar esta función porque parece mejor», o «Voy a utilizar aquella otra porque todo el mundo dice que da buenos resultados», no es más que una tontería. La elección correcta depende de diversos factores. Sin embargo, para entender esos factores, antes necesitamos una topología algo más avanzada. No basta con utilizar un único perceptrón. Necesitamos más perceptrones.
Un nuevo comienzo
Mucha gente piensa que, para que exista una red, hacen falta cientos, miles o quizá millones de perceptrones conectados de alguna manera. Pero, en la práctica, las cosas no funcionan exactamente así. Lo que realmente necesitamos es que cada perceptrón pueda trabajar junto con otros perceptrones. No importa si trabajan de manera síncrona o asíncrona. En paralelo o de forma secuencial. Eso importa poco. Lo que realmente necesitamos es que varios perceptrones individuales trabajen como si fueran un único perceptrón potente. Piensa en ello como en un trabajo de hormiga. Una sola hormiga no puede mover una montaña. Pero un hormiguero enorme puede mover prácticamente cualquier cosa.
Siempre que se les dé tiempo suficiente para hacer su trabajo. Individualmente, cada hormiga puede mover una pequeña piedra. Pero, cuando todas se unen, la cosa adquiere otra dimensión. Sin embargo, si no están organizadas, al final no conseguirán construir la montaña. Incluso pueden reducir la montaña a un montón de piedrecillas. Pero no pasarán de ahí. En cambio, si cada una puede comunicar a las demás el trabajo que ya se ha realizado, al final alcanzarán el objetivo. Y esto es precisamente lo que debemos empezar a hacer a partir de ahora.
Cuando trasladamos esta idea, mencionada anteriormente, al desarrollo de una red, empezamos a hacernos una idea de cómo crear un conjunto de perceptrones y conseguir que cada uno de ellos, de forma individual, alcance cierto grado de convergencia. Pero ¿qué ocurre si los conectamos? Es decir, si la salida de un perceptrón se conecta a la entrada de otro, ¿qué ocurrirá realmente? Pues bien, aquí es donde empieza lo interesante y donde comenzamos a utilizar redes en la práctica.
Hagamos lo siguiente: a partir del código que vimos en el artículo anterior, vamos a crear una pequeña cadena con dos perceptrones, donde la salida de uno estará conectada a la entrada del otro. Al final, queremos que ambos perceptrones consigan aprender sobre un tema. Para que esto resulte más plausible y fácil de entender, vamos a empezar viendo un ejemplo de código. Para comenzar, utilizaremos el código que se muestra a continuación en su totalidad.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. #property script_show_inputs
04. #property description "Experiencing a simple chain of neurons"
05. //+------------------------------------------------------------------+
06. #include <Neural Network\C_Neuron.mqh>
07. //+------------------------------------------------------------------+
08. enum eFactorization {
09.                         Minimum_Square,
10.                         Gradient_Descent,
11.                     };
12. //+------------------------------------------------------------------+
13. input eFactorization        user00 = Minimum_Square;        //Type of factorization
14. input double                user01 = 1e-6;                  //Estimated error
15. input double                user02 = 1e-6;                  //Learning Rate
16. input C_Neuron::eFnActivate user03 = C_Neuron::Identity;    //Activation function
17. //+------------------------------------------------------------------+
18. //Training expression: f(x) = (w0 * 2)
19. //+------------------------------------------------------------------+
20. double Train[] {
21.                 0, 0,
22.                 1, 2,
23.                 2, 4,
24.                 3, 6
25.                };
26. //+------------------------------------------------------------------+
27. #define nColumns    2
28. #define nLines      Train.Size() / nColumns
29. //+------------------------------------------------------------------+
30. void SimpleChain(void)
31. {
32.     C_Neuron *neuron;
33.
34.     neuron = new C_Neuron(nColumns - 1, user03, user00 == Minimum_Square);
35.
36.     (*neuron).Learning(Train, 1.0, user01, user02, ULONG_MAX);
37.     (*neuron).View_Variables();
38.
39.     delete neuron;
40. }
41. //+------------------------------------------------------------------+
42. void OnStart()
43. {
44.     Print("************************************");
45.     Print("A simple chain of neurons...");
46.     Print("************************************");
47.     Print("Parameters:");
48.     Print("Type of factorization: ", EnumToString(user00));
49.     Print("Estimated error: ", user01);
50.     Print("Learning Rate:", user02);
51.     Print("Activation function: ", EnumToString(user03));
52.     Print("************************************");
53.
54.     SimpleChain();
55. }
56. //+------------------------------------------------------------------+
Código 01
Este es un código bastante sencillo y todos los que siguen estos artículos ya deberían ser capaces de entender lo que ocurre. Por tanto, no veo necesario comentar su funcionamiento. Aun así, y solo por curiosidad, veamos el resultado que obtendremos.
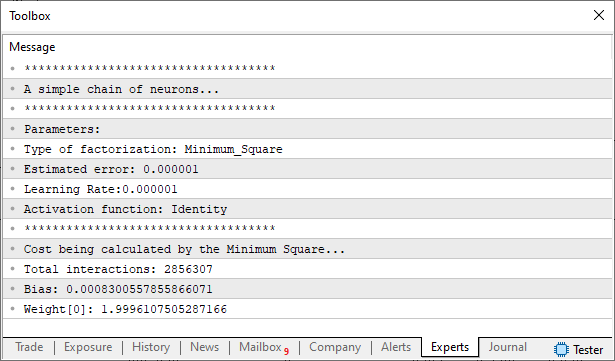
Imagen 02
Definitivamente, ninguna sorpresa. Ahora vamos a cambiar un poco las cosas para poder controlar el número de perceptrones que estarán conectados en cadena. De este modo, la salida de uno será la entrada del siguiente. Al final, el objetivo será crear algo parecido a lo que podemos ver a continuación.
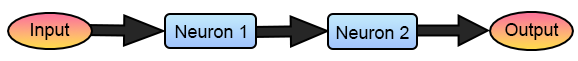
Image 03
Observa que estamos conectando solo dos perceptrones, que sería el caso más sencillo de todos. Pero veamos cómo queda esto en el código. Inicialmente, modificamos el código para obtener algo como lo que se muestra a continuación.
18. //+------------------------------------------------------------------+
19. void SimpleChain(const uchar nNeurons, const ulong Limit)
20. {
21.     C_Neuron *neuron[];
22.     double err, tmp[], v0[nColumns - 1];
23.
24.     if (!nNeurons)
25.         return;
26.
27.     ArrayResize(neuron, nNeurons);
28.     for (uchar c = 0; c < nNeurons; c++)
29.         neuron[c] = new C_Neuron(nColumns - 1, user03, user00 == Minimum_Square);
30.
31.     ArrayResize(tmp, Train.Size());
32.     for (ulong count = 0; count < Limit; count++)
33.     {
34.         ArrayCopy(tmp, Train);
35.         for (uchar c = 0; c < nNeurons; c++)
36.         {
37.             if ((err = (*neuron[c]).Learning(tmp, 1.0, user01, user02, 1)) < user01)
38.                 break;
39.             for (uchar nl = 0; nl < nLines; nl++)
40.             {
41.                 v0[0] = tmp[nl * nColumns];
42.                 tmp[nl * nColumns] = (*neuron[c]).Perceptron(v0);
43.             }
44.         }
45.     }
46.
47.     for (uchar c = 0; c < nNeurons; c++)
48.     {
49.         PrintFormat("====== information of neuron number #%02d ======", c);
50.         (*neuron[c]).View_Variables();
51.     }
52.
53.     for (uchar c = 0; c < nNeurons; c++)
54.         delete neuron[c];
55.
56.     ArrayFree(tmp);
57.     ArrayFree(neuron);
58. }
59. //+------------------------------------------------------------------+
60. void OnStart()
61. {
62.     Print("************************************");
63.     Print("A simple chain of neurons...");
64.     Print("************************************");
65.     Print("Parameters:");
66.     Print("Type of factorization: ", EnumToString(user00));
67.     Print("Estimated error: ", user01);
68.     Print("Learning Rate:", user02);
69.     Print("Activation function: ", EnumToString(user03));
70.     Print("************************************");
71.
72.     SimpleChain(1, 10);
73. }
74. //+------------------------------------------------------------------+
Fragmento 01
Obviamente, lo que hemos hecho no generará un código ideal, ya que tendremos mensajes procedentes de la clase C_Neuron que no nos interesan, como puede verse en la siguiente imagen.
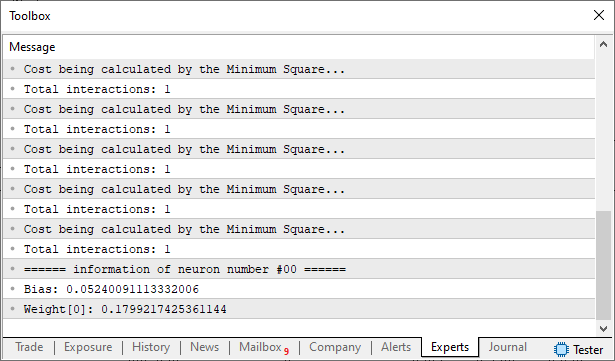
Imagen 04
Bien, podemos limpiar el código eliminando esos mensajes. Pero tengo una idea mejor: quiero mostrarte cómo hacer ciertas cosas sin tener que modificar el código constantemente. Basta con indicarle al compilador qué debe incluir y qué no en el código final. Así que presta atención, porque ahora aprenderás algo que muchos no utilizan porque no saben muy bien cómo funciona.
Uso de directivas de compilación
Una de las características que MQL5 hereda de C/C++ y que resulta muy útil es el uso de directivas de compilación. Pero ¿qué son exactamente estas directivas? Pues bien, sirven para generar un código con determinadas características. Así, sin modificar realmente el código original, tú, como programador, puedes indicarle al compilador cómo debe construirse el código. Y puedes generar versiones completamente diferentes del código sin siquiera modificar el código fuente original, utilizando únicamente las directivas de compilación adecuadas.
Quizá la directiva que más me hayas visto utilizar hasta ahora sea #define, que crea una definición, ya sea una macro o un nombre para una constante. Pero esta misma directiva, cuando se utiliza junto con otras, permite elaborar un código C/C++ mucho más sofisticado. Es cierto que en MQL5 no disponemos de toda la potencia que encontramos en C/C++, pero, aun así, es suficiente para hacer mucho más escribiendo mucho menos código.
Lo que vamos a hacer ahora es precisamente utilizar estas directivas para incluir o excluir determinadas partes del código. Este tipo de cosas puede resultar bastante confuso para muchos de ustedes. Por eso, antes de intentar realizar grandes cambios en el código, te recomiendo que pruebes cada cosa a medida que se vaya explicando. De este modo, podrás entender cómo funciona realmente todo y por qué funcionan las directivas.
076. //+------------------------------------------------------------------+
077.         inline double Learning_FX(const double &train[], const double epsilon,  const double LearningRate, const ulong limit)
078.         {
079.             double  err,
080.                     memT,
081.                     err_w[];
082.             ulong   count;
083.
084. #ifndef def_NO_MSG
085.             Print("Cost being calculated by the Minimum Square...");
086. #endif
087.             ArrayResize(err_w, m_Infos.nInputs);
088.             for (count = 0; (count < limit) && ((err = Cost_FX(train)) > epsilon); count++)
089.             {
090.                 for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++)
091.                 {
092.                     memT = m_Infos.Weight[c];
093.                     m_Infos.Weight[c] += LearningRate;
094.                     err_w[c] = Cost_FX(train) - err;
095.                     m_Infos.Weight[c] = memT;
096.                 }
097.                 memT = m_Infos.Bias;
098.                 m_Infos.Bias += LearningRate;
099.                 m_Infos.Bias = memT - (Cost_FX(train) - err);
100.                 for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++)
101.                     m_Infos.Weight[c] -= err_w[c];
102.             }
103. #ifndef def_NO_MSG
104.             PrintFormat("Total interactions: %I64u", count);
105. #endif
106.             ArrayFree(err_w);
107.
108.             return err;
109.         }
110. //+------------------------------------------------------------------+
                                   .
                                   .
                                   .
131. //+------------------------------------------------------------------+
132.         inline double Learning_DX(const double &train[], const double epsilon, const double LearningRate, const ulong limit)
133.         {
134.             ulong   count;
135.             double  eRet;
136.
137. #ifndef def_NO_MSG
138.             Print("Cost being calculated by the Gradient...");
139. #endif
140.             for (count = 0; (count < limit) && (MathAbs(eRet = Cost_DX(train)) > epsilon); count++)
141.             {
142.                 m_Infos.Bias -= (m_Error.bias * LearningRate);
143.                 for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++)
144.                     m_Infos.Weight[c] -= (m_Error.weight[c] * LearningRate);
145.             }
146. #ifndef def_NO_MSG
147.             PrintFormat("Total interactions: %I64u", count);
148. #endif
149.
150.             return eRet;
151.         }
152. //+------------------------------------------------------------------+
Fragmento 02
Lo que tenemos aquí es algo sencillamente fantástico. Observa las líneas ochenta y cuatro, ciento tres, ciento treinta y siete y ciento cuarenta y seis. En ellas se utiliza la directiva #ifndef. Esta directiva le indica al compilador que, si def_NO_MSG no está definida, los fragmentos comprendidos entre #ifndef y #endif DEBEN COMPILARSE. Si def_NO_MSG ya está definida cuando se evalúa #ifndef, esos mismos fragmentos NO DEBEN formar parte del código final.
De acuerdo. Pero ¿en qué nos ayudará realmente esto? No te preocupes, mi querido lector, enseguida lo entenderás. Ahora podrías definir la macro en el archivo de cabecera de la clase o, como suele ser más habitual entre programadores con más experiencia, definirla en el archivo principal. Y aquí está el truco. Puedes añadir la definición en cualquier momento; dependiendo del punto en que la definas, el código tendrá un comportamiento u otro. Para que resulte más fácil de entender, veamos un ejemplo mucho más sencillo. No tienes que preocuparte. En el anexo tendrás estos códigos para examinarlos y probarlos localmente y así entender cómo funcionan las directivas.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void Demo_Directives(const string msg)
05. {
06. #ifdef def_DEMO
07.     Print("Demonstrated Directive #1: ",msg);
08. #else
09.     Print("Demonstrated Directive #2: ",msg);
10. #endif
11. }
12. //+------------------------------------------------------------------+
Código 02
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. #define def_DEMO
05. //+------------------------------------------------------------------+
06. #include <Tutor\Tutor.mqh>
07. //+------------------------------------------------------------------+
08. void OnStart(void)
09. {
10.     Print("Experimenting with compilation guidelines");
11.     Demo_Directives("Checking...");
12. }
13. //+------------------------------------------------------------------+
Código 03
Ahora viene la parte divertida. Observa que, en la línea cuatro del script, existe una definición. Como la definición aparece antes de #include, la macro ya estará definida cuando el preprocesador procese el archivo incluido. Así, al procesar el archivo de cabecera, la condición de la línea seis será verdadera, ya que la macro se ha definido ANTES. Por tanto, la línea siete del archivo de cabecera será la que realmente se compile.
Si la macro no se hubiera definido, o se hubiera definido después de la directiva #include, la condición de la línea seis se evaluaría como falsa. En cambio, se tomaría la rama indicada a partir de la línea ocho. De este modo, el código que se compilaría sería el de la línea nueve. Y esto haría que apareciera un mensaje completamente diferente en el terminal de MetaTrader 5. Puedes verlo en la siguiente imagen.
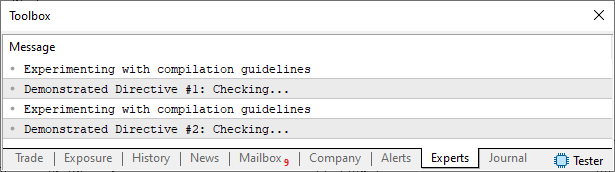
Imagen 05
Creo que ya resulta sencillo entender lo que ocurre. Si la macro está definida cuando se evalúa #ifdef, se compilará el bloque correspondiente; si no lo está, se compilará el bloque comprendido entre #else y #endif. Y esto es precisamente lo que vamos a utilizar aquí para eliminar aquellos mensajes de la clase C_Neuron. Si definimos def_NO_MSG, significa que no queremos mensajes. Si def_NO_MSG no se define, los mensajes se mostrarán. Por este detalle, entre otros que quizá muestre en algún momento, debes tener cuidado de no mantener definiciones innecesarias activas entre archivos diferentes. De lo contrario, acabarás teniendo dificultades para mantener el código a medida que vaya creciendo.
Una vez entendido esto, podemos volver a nuestro código principal. Ya hemos modificado el archivo de cabecera C_Neuron. Lo único que necesitamos es definir def_NO_MSG antes de la directiva #include para impedir que se compilen los mensajes. Así, el código que utilizaremos se muestra en el siguiente fragmento.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. #property script_show_inputs
04. #property description "Experiencing a simple chain of neurons"
05. //+------------------------------------------------------------------+
06. #define def_NO_MSG
07. //+------------------------------------------------------------------+
08. #include <Neural Network\C_Neuron.mqh>
09. //+------------------------------------------------------------------+
Fragmento 03
Y, como por arte de magia, ahora obtenemos el resultado que se muestra a continuación. Con un detalle: si necesitas utilizar la clase C_Neuron y volver a mostrar los mensajes, no tendrás que volver a escribir el código correspondiente. Lo único que tendrás que hacer es no definir def_NO_MSG. Así de sencillo.
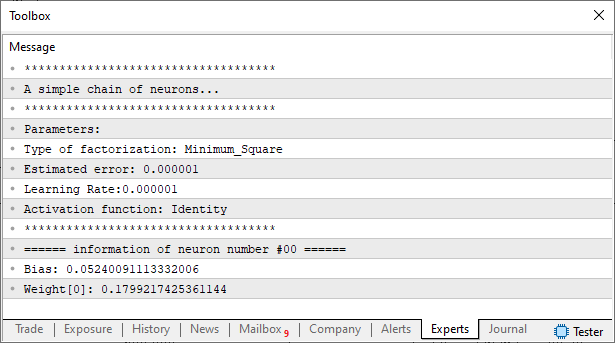
Imagen 06
De acuerdo. Ahora ya tenemos algo con lo que experimentar. Pero seguramente habrás notado que estoy utilizando un solo perceptrón y diez iteraciones. Así que, para empezar a utilizar más perceptrones, necesitamos hacer algunos cambios adicionales. Para evitar confusiones, vamos a iniciar un nuevo tema.
Una cadena de perceptrones
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. #property description "Experiencing a simple chain of neurons"
04. //+------------------------------------------------------------------+
05. #define def_NO_MSG
06. #define def_ERROR_MAX 1e-3
07. //+------------------------------------------------------------------+
08. #include <Neural Network\C_Neuron.mqh>
09. //+------------------------------------------------------------------+
10. //Training expression: f(x) = (w0 * 2)
11. //+------------------------------------------------------------------+
12. double Train[] {
13.                 10, 20
14.                };
15. //+------------------------------------------------------------------+
16. #define nColumns    2
17. #define nLines      Train.Size() / nColumns
18. //+------------------------------------------------------------------+
19. void SimpleChain(const uchar nNeurons, const ulong Limit)
20. {
21.     C_Neuron *neuron[];
22.     double err, tmp[], in, out;
23.
24.     if ((!nNeurons) || (Train.Size() > 2))
25.         return;
26.
27.     ArrayResize(neuron, nNeurons);
28.     for (uchar c = 0; c < nNeurons; c++)
29.         neuron[c] = new C_Neuron(nColumns - 1, C_Neuron::Identity, true);
30.
31.     ArrayResize(tmp, Train.Size());
32.     in = out = Train[0];
33.     for (ulong count = 0; count < Limit; count++)
34.     {
35.         PrintFormat("====== Interaction #%02d ======", count);
36.         for (uchar c = 0; c < nNeurons; c++)
37.         {
38.             tmp[0] = (c > 0 ? out : in);
39.             if ((err = (*neuron[c]).Learning(tmp, 1.0, def_ERROR_MAX, def_ERROR_MAX, 1)) < def_ERROR_MAX)
40.                 break;
41.             PrintFormat("Input value in the neuron #%02d: %.8f [%.16f]", c, tmp[0], err);
42.             out = (*neuron[c]).Perceptron(tmp);
43.         }
44.     }
45.
46.     PrintFormat("Final exit: %.8f || Expected: %.8f", out, Train[1]);
47.
48.     for (uchar c = 0; c < nNeurons; c++)
49.         delete neuron[c];
50.
51.     ArrayFree(tmp);
52.     ArrayFree(neuron);
53. }
54. //+------------------------------------------------------------------+
55. void OnStart()
56. {
57.     Print("************************************");
58.     Print("A simple chain of neurons...");
59.     Print("************************************");
60.
61.     SimpleChain(2, 1);
62. }
63. //+------------------------------------------------------------------+
Código 04
Como resultado, obtenemos la siguiente imagen:
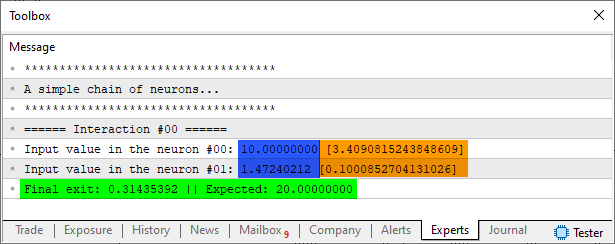
Imagen 07
Lo que hace la línea cinco se explicó en el tema anterior. La línea seis, por su parte, evita que tengamos que estar ajustando las cosas constantemente. Así que, para mantener un mismo criterio durante la explicación, no podrás cambiar la configuración hasta que entiendas lo que está ocurriendo. Limítate a utilizar lo que aparece en el código. En la línea doce tenemos nuestro nuevo array de entrenamiento. Observa que lo he reducido a una sola línea. Más adelante, en la línea sesenta y uno, indicamos cuántos perceptrones y cuántas iteraciones se utilizarán. En este caso utilizaremos dos perceptrones, donde la salida de uno estará conectada a la entrada del otro, pero, atención, realizaremos una sola iteración. Con esto llegamos a la línea diecinueve. Y ahora viene la parte que realmente necesitas entender.
En la línea veintisiete asignamos memoria para todos los perceptrones que vamos a utilizar. En la línea veintiocho entramos en un bucle que creará los perceptrones. No importa cuántos queramos crear. Todos se crearán de la misma manera, utilizando los mismos valores, y estos valores son los más básicos posibles para que todo resulte muy fácil de entender.
En la línea treinta y uno asignamos memoria para el array de entrenamiento. Pero ¿por qué asignar memoria si ya tenemos definido el array? En realidad, el array definido en la línea doce sirve únicamente como entrada y salida. No sirve para lo que se hará dentro de la red, y sí, has leído bien, mi querido lector. Ahora ya no estaremos trabajando con un perceptrón. Estaremos utilizando nuestra primera red. Y ahora viene la parte que puede generar mucha confusión. En la línea treinta y dos obtenemos el valor de entrada. Recuerda que queremos una sola entrada, es decir, el sistema más sencillo posible. En la línea treinta y tres entramos en el bucle de iteración. En la línea treinta y seis entramos en otro bucle, cuya función es realizar la FORWARD PROPAGATION, es decir, la propagación hacia delante.
Presta atención: en la línea treinta y ocho tomamos el valor de la variable out, siempre que no estemos al principio de la red, y lo asignamos al array de entrenamiento local. Si estamos al principio de la red, es decir, en el primer perceptrón, se utiliza el valor de la variable in. A continuación, en la línea treinta y nueve, ejecutamos el entrenamiento del perceptrón. En la línea cuarenta y uno imprimimos los valores utilizados durante el entrenamiento. En la línea cuarenta y dos realizamos la propagación hacia delante. De este modo, si el bucle de la línea treinta y seis vuelve a ejecutarse, la salida de un perceptrón se utilizará como entrada del siguiente. Al final, la línea cuarenta y seis imprime los resultados. Y el resto del código sirve para destruir nuestra SKYNET.
De acuerdo. Ahora viene la parte complicada. Observa que estamos utilizando la función de mínimos cuadrados. No estamos utilizando ninguna función especial de activación. Todos los perceptrones son iguales. Pero observa la imagen con el resultado. Quiero que mires esta imagen y me digas: ¿estamos realizando la retropropagación? ¿SÍ o NO? Si la respuesta es sí, te pregunto: ¿dónde se está realizando? Si tu respuesta es no, entonces ¿por qué los perceptrones están mostrando un valor de error?
SimpleChain(2, 2);
El resultado se muestra a continuación.
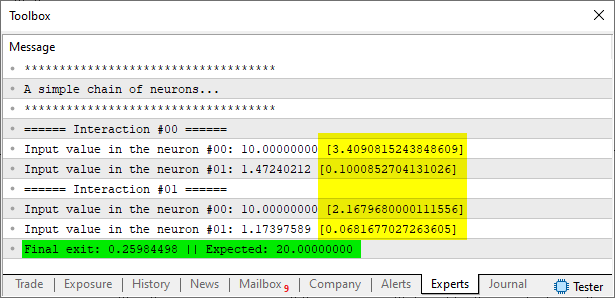
Imagen 08
Observa que el valor de error indicado, que aparece en amarillo, ha disminuido. Esto significa que la retropropagación está teniendo lugar. Pero presta atención al hecho de que el valor final ha empeorado con respecto al obtenido anteriormente. Esto significa que está ocurriendo algo extraño. Tenemos retropropagación, pero la red neuronal no consigue converger hacia la respuesta esperada. ¿Qué estamos haciendo mal?
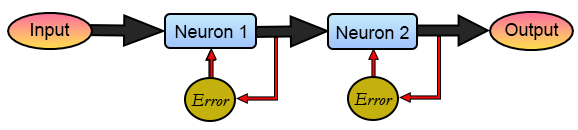
Imagen 09
Es decir, cada uno de los perceptrones está afectando al siguiente. Pero la retropropagación solo se está produciendo en las conexiones indicadas por las flechas rojas; es decir, los perceptrones están trabajando de manera independiente y no existe comunicación entre ellos. Así, el perceptrón uno intenta ajustarse, pero el perceptrón dos se lo impide. Al mismo tiempo, el perceptrón dos intenta encontrar una dirección de ajuste, pero el perceptrón uno lo desvía de ella. Al final, el error individual de cada perceptrón disminuye. Pero el error general aumenta. Y este es el problema que necesitamos resolver.
Consideraciones finales
El objetivo de este artículo ha sido empezar a mostrar cómo, muchas veces, la forma habitual de explicar cómo funcionan las redes de perceptrones no es la más adecuada. Porque, a diferencia de lo que muchos podrían imaginar, conectar la salida de un perceptrón a la entrada de otro no basta para crear una red perfectamente funcional.
Además, a diferencia de lo que muchos piensan o imaginan que sería la forma más adecuada de construir una red de perceptrones, hemos visto que existen distintas configuraciones, cada una orientada a un objetivo concreto. Sin embargo, la elección de la topología adecuada y la definición de los puntos de entrada y salida de la red cambian radicalmente el tipo de procesamiento que se espera de la red. Pero, independientemente de la topología que utilicemos, la forma de crear un perceptrón sigue siendo la misma o, al menos, debería serlo.
Muy bien, hemos visto que, al intentar conectar perceptrones en serie para alcanzar un determinado resultado, el conjunto no consiguió funcionar correctamente y, por tanto, no pudo converger hacia la solución estimada. Con esto, te dejo una pregunta: ¿cómo implementarías el perceptrón para poder conectar varios de ellos en una configuración determinada, por ejemplo, en serie, como hemos hecho aquí? La idea es que trabajen como una única entidad. Sé que puede parecer algo complicado. Sin embargo, el objetivo es crear un perceptrón que, sin ninguna otra modificación, pueda conectarse con un número arbitrario de otros perceptrones para resolver algún problema, sin que tengamos que preocuparnos por la cantidad de perceptrones que existen entre el punto de entrada y el punto definido como salida.
| Archivo MQ5 | Descripción |
|---|---|
| Scripts\Example A | Demostración básica |
| Scripts\Tutor | Demostración básica |
Traducción del portugués realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/pt/articles/13952
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Utilizando redes neuronales en MetaTrader
 Automatización de estrategias de trading en MQL5 (Parte 27): Creando un patrón armónico «Crab» de acción del precio con señales visuales
 Particularidades del trabajo con números del tipo double en MQL4
 Del nivel básico al intermedio: Objetos y subventanas (III)

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso
Daniel, todo bien, lo más importante del artículo está justo en medio, casi de pasada:
«No existe en absoluto una especie de receta infalible».
Esta frase resume lo que la mayoría nunca quiere oír. Es mucho más cómodo creer que existe una arquitectura correcta, un optimizador adecuado, un número adecuado de capas… y que basta con copiar y ejecutar.
El trabajo de comprender la topología de verdad es lento, incómodo y está lleno de intentos que no funcionan. Pero es precisamente esa incomodidad la que separa a quienes utilizan la inteligencia artificial de quienes entienden lo que están haciendo.
Gracias por no tomar el atajo en la explicación.
Daniel, no pasa nada, lo más importante del artículo está justo en el medio, casi de pasada:
«No existe en absoluto una especie de receta para hacer un pastel».
Esta frase resume lo que la mayoría nunca quiere oír. Es mucho más cómodo creer que existe una arquitectura correcta, un optimizador adecuado, un número adecuado de capas… y que basta con copiar y ponerlo en marcha.
El trabajo de comprender la topología de verdad es lento, incómodo y está lleno de intentos que no funcionan. Pero es precisamente esa incomodidad la que distingue a quienes utilizan la inteligencia artificial de quienes entienden lo que están haciendo.
Gracias por no tomar el atajo en la explicación.
Te agradezco tus palabras. Y, de hecho, en los artículos que aún tengo pensado publicar —si no surgen más contratiempos, ya que todos están listos, pero… bueno, dejémoslo así—, demostraré que no siempre algo funcionará solo porque alguien haya dicho que hay que hacerlo de una forma u otra.
A menudo hay que adaptar la propia topología, la red o incluso el método de entrenamiento para conseguir el resultado deseado.