

Red neuronal en la práctica: Gradiente
 17
 0

Introducción
En el artículo anterior , implementamos una aplicación cuyo propósito era permitirnos estudiar el comportamiento de las derivadas junto con las funciones de activación. Entender lo explicado allí te ayudará a comprender lo que veremos aquí.
En este artículo intentaré explicar cómo y por qué el gradiente comenzó a utilizarse durante el entrenamiento de una red de perceptrones. Al principio, las matemáticas del gradiente pueden resultar algo confusas y difíciles de entender. No obstante, utilizaré una metodología mucho más sencilla para que puedas entender de una vez por todas cómo funciona el gradiente en la práctica. Así que dejemos de lado las distracciones y centrémonos en lo que se explicará en este artículo, ya que entender el funcionamiento del gradiente es fundamental para comprender otros temas que veremos más adelante.¿Por qué el gradiente?
Como no sé realmente qué nivel de familiaridad tiene cada uno con la parte matemática, intentaré avanzar con calma en este punto. La programación en sí es la parte fácil. Lo difícil es entender y, sobre todo, explicar la parte matemática. Muchos podrían decir que la matemática, que básicamente constituye la parte teórica de lo que vamos a implementar, incluso podría ignorarse y que deberíamos pasar directamente al código.
Personalmente, considero que si se mostrara únicamente el código, en algún momento acabarías completamente bloqueado. Ya lo he dicho y lo repito: NO EXISTE UN MODELO ESTÁNDAR PARA CREAR REDES NEURONALES. Cada caso es diferente. Entender cómo funciona cada parte de un perceptrón es fundamental para que puedas comprenderlo y establecer las conexiones necesarias a la hora de decidir qué operaciones utilizar. No caigas en el error de pensar que una determinada implementación podrá resolver cualquier tipo de problema. Aunque intentes entrenarla para crear un modelo que represente un determinado conjunto de datos, no siempre podrás utilizar la misma implementación con un conjunto de datos completamente distinto, ya que rara vez funcionará correctamente.
En otro artículo abordé el tema del gradiente. Sin embargo, considero que allí quedó muy mal explicado en varios aspectos. Tal vez esa sea la razón por la que tanta gente se confunde con este tema. Aquí voy a explicarlo de una forma mucho más sencilla, porque pronto entraremos en un asunto bastante más complejo. Por ahora, no incorporaremos las funciones de activación a la clase C_Neuron. Esto se debe a que no quiero complicar las cosas innecesariamente antes de tiempo.
Bien, el gradiente es una forma mucho más sencilla y cómoda de representar una derivada. O, mejor dicho, de utilizar realmente la recta tangente cuando trabajamos con varias variables. De esta manera, podemos utilizar un método de cálculo más eficiente para lograr la convergencia en muchas situaciones.
Lo primero que hay que entender es que todo gradiente es, en realidad, un vector. ¿Y qué significa esto en la práctica? La primera consecuencia es que, al ser un vector, apunta en una determinada dirección. En este caso, apunta en la dirección de máximo incremento. Sin embargo, si lo utilizamos en sentido contrario, podremos avanzar en la dirección de menor incremento o, en nuestro caso, de menor costo. De ahí que, para diferenciarlo de otros tipos de vectores, lo llamemos gradiente descendente.
El segundo punto, y aquí es donde muchos empiezan a confundirse, es que el gradiente es un vector ortogonal. Por esta razón, es literalmente perpendicular a otra recta que pasa por el punto de origen del vector. Esa recta sí es la recta tangente. Presta atención a esto, porque será importante más adelante. Esto es diferente de lo que ocurre con el mínimo cuadrado, donde realmente se genera una recta secante. Muchos afirman erróneamente que el perceptrón utiliza la recta tangente. Sin embargo, cuando examinamos los cálculos que se realizan, vemos que en realidad se trata de la recta secante. Así que ten cuidado al indicar qué tipo de recta estás utilizando en los cálculos trigonométricos. Hay otros aspectos relacionados con los vectores, pero, para los objetivos de estos artículos, lo que acabamos de mencionar será más que suficiente para explicar todo el contenido.
Por tanto, como el gradiente es un vector, resulta considerablemente más práctico en distintos escenarios. Aquí, sin embargo, nos centraremos en el aspecto más básico, al menos por ahora. De lo contrario, empezaríamos a hablar de temas que no están relacionados con el asunto principal.
Bien, el código que vamos a modificar o, mejor dicho, al que vamos a añadir nuevas funcionalidades, se vio en el artículo . Allí solo incorporamos el código del mínimo cuadrado. Este utiliza la función que se muestra a continuación.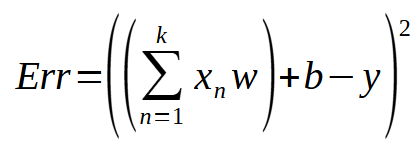
Esta expresión es exactamente la que utilizamos para calcular el error de cada una de las líneas de entrenamiento mediante el mínimo cuadrado. Aquí, < t > representa el número de entradas del perceptrón. < w > representa cada uno de los pesos. < b > representa el sesgo, mientras que < y > representa el valor estimado como resultado durante el entrenamiento. Muy bien. La pregunta es: ¿cómo podemos convertir esta misma expresión en un gradiente? La respuesta es: utilizando un concepto matemático: las derivadas.
Si observas esta expresión matemática y tienes unos conocimientos mínimos de matemáticas, notarás que existe otra muy parecida, conocida, en el cálculo de derivadas, como regla de la cadena. Esta expresión se muestra a continuación.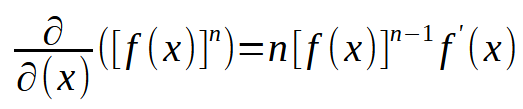
Al observar esta expresión, probablemente estés sintiendo cierto escalofrío, porque parece bastante complicada. En realidad, es muy sencilla y nos indica exactamente qué debemos hacer. El valor de x es la expresión que queremos derivar. El n es el exponente, que en este caso es dos. Por tanto, el dos pasa a multiplicar. El nuevo exponente es el anterior menos uno. Y esta nueva expresión se multiplica por la derivada de primer orden de la expresión original. Así de simple. Sin embargo, como nuestra expresión original contiene al menos dos variables, el peso y el sesgo, vamos a escribir la nueva expresión utilizando ya la notación del gradiente. De este modo, la expresión queda como se muestra a continuación.
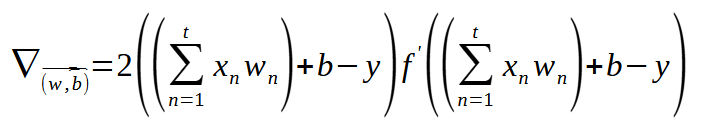
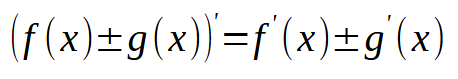
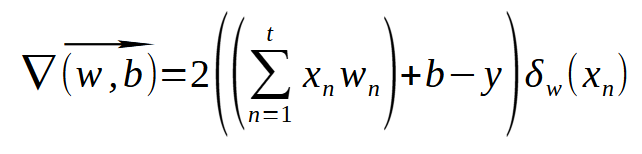
Esta es la expresión que tendremos que utilizar. Tal vez no esté escrita de la manera matemáticamente correcta. Pero no estoy aquí para explicar matemáticas ni cómo deben escribirse las expresiones matemáticas. Estoy aquí para mostrar cómo convertir expresiones matemáticas en código utilizable. Y aunque la expresión anterior no sea completamente correcta en cuanto a la notación matemática, es lo bastante adecuada para explicar lo que tendremos que implementar.
Esto se debe a que aquí estoy mostrando tanto el cálculo del sesgo como el cálculo de los pesos cuando tenemos varias entradas en un perceptrón. Quizá sería mejor escribir buena parte de esta expresión en forma matricial y utilizar una notación algo diferente para la derivada parcial situada al final. Sin embargo, como mencioné hace un momento, no me interesa ser completamente riguroso en cuanto a la forma de escribir la expresión matemática, siempre que el código esté correctamente escrito. Al fin y al cabo, no queremos terminar con algo que se comporte de manera extraña o impredecible.
Muy bien, con esto llegamos a un punto clave. Ya podemos echar un vistazo rápido a cómo quedó la clase C_Neuron, con el gradiente correctamente calculado y listo para utilizarse. El código que se muestra a continuación refleja lo que hace la expresión anterior cuando la implementamos en código. Naturalmente, aquí estamos mostrando el código completo. Pero no te preocupes, centraré la explicación únicamente en la parte correspondiente al gradiente. Eso lo veremos en el siguiente tema.//+------------------------------------------------------------------+ #property copyright "Daniel Jose" //+------------------------------------------------------------------+ #define macroRandom (rand() / (double)SHORT_MAX) //+------------------------------------------------------------------+ class C_Neuron { private: //+------------------------------------------------------------------+ struct stInfos { bool IsFx; uint nInputs; double Bias, Weight[]; }m_Infos; //+------------------------------------------------------------------+ struct stErr { double weight[], eMaxWeight, bias; }m_Error; //+------------------------------------------------------------------+ inline double Cost_FX(const double &train[]) { double x, err; err = 0; for (uint c0 = 0; c0 < train.Size(); c0++) { x = 0; for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, c0++) x += (train[c0] * m_Infos.Weight[c1]); err += MathPow((x + m_Infos.Bias) - train[c0], 2); } return err; } //+------------------------------------------------------------------+ inline double Learning_FX(const double &train[], const double epsilon, const double LearningRate, const ulong limit) { double err, memT, err_w[]; ulong count; Print("Cost being calculated by the Minimum Square..."); ArrayResize(err_w, m_Infos.nInputs); for (count = 0; (count < limit) && ((err = Cost_FX(train)) > epsilon); count++) { for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++) { memT = m_Infos.Weight[c]; m_Infos.Weight[c] += LearningRate; err_w[c] = Cost_FX(train) - err; m_Infos.Weight[c] = memT; } memT = m_Infos.Bias; m_Infos.Bias += LearningRate; m_Infos.Bias = memT - (Cost_FX(train) - err); for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++) m_Infos.Weight[c] -= err_w[c]; } PrintFormat("Total interactions: %I64u", count); ArrayFree(err_w); return err; } //+------------------------------------------------------------------+ inline double Cost_DX(const double &train[]) { double x1, t; ZeroMemory(m_Error); for (uint c0 = 0, cw = 0; c0 < train.Size(); c0++, cw = c0) { x1 = 0; for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, c0++) x1 += (train[c0] * m_Infos.Weight[c1]); t = 2 * ((x1 + m_Infos.Bias) - train[c0]); for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, cw++) { m_Error.weight[c1] += (t * train[cw]); m_Error.eMaxWeight = (MathAbs(m_Error.weight[c1]) > MathAbs(m_Error.eMaxWeight) ? m_Error.weight[c1] : m_Error.eMaxWeight); } m_Error.bias += t; } return (MathAbs(m_Error.bias) > MathAbs(m_Error.eMaxWeight) ? m_Error.bias : m_Error.eMaxWeight); } //+------------------------------------------------------------------+ inline double Learning_DX(const double &train[], const double epsilon, const double LearningRate, const ulong limit) { ulong count; double eRet; Print("Cost being calculated by the Gradient..."); for (count = 0; (count < limit) && (MathAbs(eRet = Cost_DX(train)) > epsilon); count++) { m_Infos.Bias -= (m_Error.bias * LearningRate); for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++) m_Infos.Weight[c] -= (m_Error.weight[c] * LearningRate); } PrintFormat("Total interactions: %I64u", count); return eRet; } //+------------------------------------------------------------------+ public : //+------------------------------------------------------------------+ C_Neuron(const uint nInputs = 1, const bool isFx = false, double H = 1.0, double L = 0.0) { MathSrand(512); ZeroMemory(m_Infos); m_Infos.IsFx = isFx; m_Infos.Bias = (double)macroRandom; ArrayResize(m_Infos.Weight, m_Infos.nInputs = nInputs); ArrayResize(m_Error.weight, m_Infos.nInputs); for(uint c = 0; c < m_Infos.nInputs; c++) m_Infos.Weight[c] = ((double)macroRandom * (H - L)) + L; } //+------------------------------------------------------------------+ ~C_Neuron() { ArrayFree(m_Infos.Weight); ArrayFree(m_Error.weight); } //+------------------------------------------------------------------+ void View_Variables(void) { Print("Bias: ", m_Infos.Bias); for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++) PrintFormat("Weight[%d]: %.16f", c, m_Infos.Weight[c]); } //+------------------------------------------------------------------+ inline double Learning(const double &train[], const double epsilon = 1e-3, const double LearningRate = 1e-2, const ulong limit = ULONG_MAX) { return (m_Infos.IsFx ? Learning_FX(train, epsilon, LearningRate, limit) : Learning_DX(train, epsilon, LearningRate, limit)); } //+------------------------------------------------------------------+ }; //+------------------------------------------------------------------+ #undef macroRandom //+------------------------------------------------------------------+
Observa cómo este código es diferente del que vimos en el artículo donde apareció originalmente. La razón es que ahora tenemos una implementación completamente nueva, cuyo objetivo principal es implementar el gradiente y, al mismo tiempo, conservar la función de costo de mínimo cuadrado. Ambas opciones pueden seleccionarse dentro del perceptrón durante la ejecución del constructor. Ten en cuenta que, una vez realizada la elección en el constructor, no será necesario volver a indicarle al perceptrón si debe utilizar el gradiente o el mínimo cuadrado para calcular el costo.
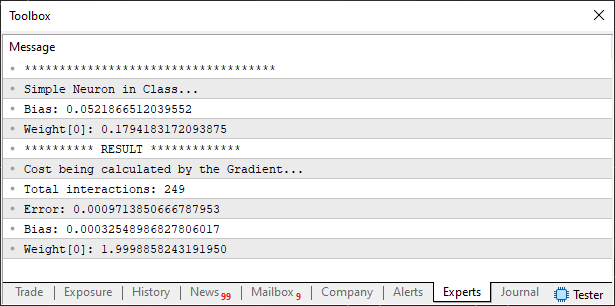
Presta atención también a que se ha añadido una nueva variable a la función Learning. Esta nueva variable será bastante útil más adelante. Por ahora, veamos si este perceptrón funciona correctamente. Para ello utilizamos el código del script que se muestra a continuación.//+------------------------------------------------------------------+ #property copyright "Daniel Jose" //+------------------------------------------------------------------+ #include <Neural Network\C_Neuron.mqh> //+------------------------------------------------------------------+ double Train[] { 0, 0, 1, 2, 2, 4, 3, 6, 4, 8 }; //+------------------------------------------------------------------+ void OnStart() { C_Neuron *neuron; Print("************************************"); Print("Simple Neuron in Class..."); neuron = new C_Neuron(1); (*neuron).View_Variables(); Print("********** RESULT *************"); Print("Error: ", (*neuron).Learning(Train)); (*neuron).View_Variables(); delete neuron; } //+------------------------------------------------------------------+
Al ejecutar este script en MetaTrader 5, verás exactamente lo que se muestra en la siguiente imagen:
//+------------------------------------------------------------------+
#property copyright "Daniel Jose"
//+------------------------------------------------------------------+
#include <Neural Network\C_Neuron.mqh>
//+------------------------------------------------------------------+
double Train[] {
                  1,    3,  10.35,
                1.5,  3.25, 11.7875,
                1.75, 3.94, 13.721,
                2.85, 3.46, 14.669
               };
//+------------------------------------------------------------------+
void OnStart()
{
    C_Neuron *neuron;

    Print("************************************");
    Print("Simple Neuron in Class...");

    neuron = new C_Neuron(2);

    (*neuron).View_Variables();
    Print("********** RESULT *************");
    Print("Error: ", (*neuron).Learning(Train));
    (*neuron).View_Variables();

    delete neuron;
}
//+------------------------------------------------------------------+
Ahora tenemos dos entradas para que la neurona busque una solución. El resultado que se mostrará en MetaTrader 5 puede verse en la siguiente imagen.
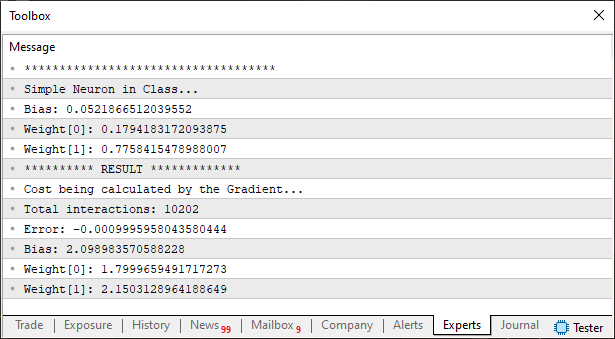
Y, una vez más, el resultado es extremadamente cercano a los valores correctos. Esto demuestra que nuestro gradiente funciona correctamente y permite que el perceptrón converja hacia una respuesta adecuada.
No te preocupes por crear estos códigos. En el archivo adjunto los encontrarás completos. Incluso podrás crear nuevos datos para utilizarlos durante el entrenamiento. Sin embargo, aunque hasta aquí todo parezca perfecto, todavía no he explicado cómo funciona el código, a pesar de haber mostrado las expresiones que le dieron origen. Como quiero explicar con calma el código del gradiente, vamos a pasar a un nuevo tema para hacerlo adecuadamente.
Entendiendo el código del gradiente
Para no resultar tediosos ni repetitivos, vamos a reproducir aquí únicamente la parte del código que realmente necesitamos. De este modo, nos centraremos en el fragmento que se muestra a continuación. La numeración de las líneas se utiliza únicamente para explicar el fragmento y, por tanto, no corresponde a la numeración real del archivo.01. //+------------------------------------------------------------------+ 02. inline double Cost_DX(const double &train[]) 03. { 04. double x1, t; 05. 06. ZeroMemory(m_Error); 07. for (uint c0 = 0, cw = 0; c0 < train.Size(); c0++, cw = c0) 08. { 09. x1 = 0; 10. for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, c0++) 11. x1 += (train[c0] * m_Infos.Weight[c1]); 12. t = 2 * ((x1 + m_Infos.Bias) - train[c0]); 13. for(uint c1 = 0; c1 < m_Infos.nInputs; c1++, cw++) 14. { 15. m_Error.weight[c1] += (t * train[cw]); 16. m_Error.eMaxWeight = (MathAbs(m_Error.weight[c1]) > MathAbs(m_Error.eMaxWeight) ? m_Error.weight[c1] : m_Error.eMaxWeight); 17. } 18. m_Error.bias += t; 19. } 20. return (MathAbs(m_Error.bias) > MathAbs(m_Error.eMaxWeight) ? m_Error.bias : m_Error.eMaxWeight); 21. } 22. //+------------------------------------------------------------------+ 23. inline double Learning_DX(const double &train[], const double epsilon, const double LearningRate, const ulong limit) 24. { 25. ulong count; 26. double eRet; 27. 28. Print("Cost being calculated by the Gradient..."); 29. for (count = 0; (count < limit) && (MathAbs(eRet = Cost_DX(train)) > epsilon); count++) 30. { 31. m_Infos.Bias -= (m_Error.bias * LearningRate); 32. for (uint c = 0, m = m_Infos.Weight.Size(); c < m; c++) 33. m_Infos.Weight[c] -= (m_Error.weight[c] * LearningRate); 34. } 35. PrintFormat("Total interactions: %I64u", count); 36. 37. return eRet; 38. } 39. //+------------------------------------------------------------------+
Este fragmento contiene todo lo expresado en la última fórmula matemática que vimos en el tema anterior. Esa fórmula tiene como objetivo describir el gradiente que necesitamos implementar en código. Puede parecer absurdo lo que estamos haciendo aquí. Sin embargo, por complicada que parezca la expresión matemática, escribir el código es mucho más sencillo de lo que parece, siempre que respetes exactamente lo que expresa dicha fórmula.
El gradiente comienza básicamente en la línea veintitrés. Una vez que se llama, entramos en un bucle en la línea veintinueve, cuyo objetivo es realizar una serie de iteraciones con la función de la línea dos. En cada iteración comprobamos si el error de la función de costo es menor que el valor previsto. Si es así, terminamos y devolvemos el error final en la línea treinta y siete. Si el error sigue siendo mayor que el previsto, pasamos a la fase de corrección de los valores, tanto de los pesos como del sesgo. Para ello utilizamos un factor de ajuste que aquí llamamos LearningRate. Estos ajustes, realizados en la línea treinta y uno para el sesgo y mediante el bucle de la línea treinta y dos para los pesos, generan una retropropagación dentro del perceptrón. Más adelante veremos con mayor detalle la retropropagación. Por ahora, nos quedaremos con esto.
Bien, ¿y cómo sabe el perceptrón cuánto debe desplazarse en función de LearningRate? Para determinarlo, el perceptrón utiliza la función de costo, definida en la línea dos. Veamos entonces esta función para entender cómo sabe el perceptrón cuánto debe desplazarse. Lo primero que hacemos es poner a cero todo el contenido de la memoria donde se encuentra la estructura que almacena los errores internos del perceptrón. Esto se hace en la línea seis. Una vez hecho esto, entramos en un bucle en la línea siete, cuyo objetivo es recorrer todas las líneas del array de entrenamiento.
Al observar el código, notarás que existe una variable llamada cw. Su propósito es conservar la posición inicial para otro bucle interno. Lo que hacemos realmente dentro de este primer bucle es calcular el error entre la salida calculada por el perceptrón y el valor esperado como salida. Presta atención a esto, porque más adelante volveremos sobre esta misma cuestión en otro artículo. Allí necesitaremos que hayas entendido que, en este punto, estamos estimando el error del perceptrón. Así que no olvides este detalle.
Bien, en la línea diez entramos en un bucle que recorrerá todas las entradas de una sola línea del array de entrenamiento. En esta primera etapa calculamos el valor de x1, que es nuestra variable de acumulación. Una vez calculada la suma de los productos entre cada valor de entrada y su peso correspondiente, en la línea doce realizamos la primera parte del cálculo del gradiente. Presta atención al siguiente detalle, que puede verse en la expresión del gradiente. El cálculo del gradiente para el sesgo y para los pesos comparte una etapa común.
Esta etapa es la que se ejecuta en la línea doce. Una vez hecho esto, podemos realizar la segunda y última etapa del cálculo del gradiente, que consiste precisamente en calcular la derivada parcial. Como el valor del sesgo es una constante, su derivada es igual a uno. Por tanto, en este caso no necesitamos hacer nada con el valor calculado en la línea doce. Podemos simplemente sumar el valor calculado para el error de la línea de entrenamiento al valor que ya se encuentra acumulado para el sesgo. Esto se hace en la línea dieciocho. Sin embargo, aunque la derivada del sesgo sea constante, no ocurre lo mismo con el peso. Si observamos la derivada parcial con respecto al peso, veremos que corresponde precisamente al valor de entrada asociado a ese peso concreto.
Por esta razón, necesitamos realizar un nuevo cálculo que vuelva a recorrer toda la línea de entrenamiento. Esta vez multiplicaremos el resultado obtenido en la línea doce por la entrada correspondiente de la línea de entrenamiento. Esto se hace mediante el bucle de la línea trece. Como ya hemos avanzado una determinada cantidad de posiciones dentro del array, necesitamos la variable auxiliar creada en la línea siete para poder recorrerlo nuevamente de forma correcta. El error correspondiente a cada peso se almacena en otro array. Esto será importante más adelante, cuando en la línea treinta y tres ajustemos los valores de los pesos en función del error almacenado para cada uno.
Hay un detalle importante aquí. Puedes observar que dentro del bucle de la línea trece se realizan dos operaciones. La primera es la que acabamos de mencionar: acumular por separado el error correspondiente a cada peso. La segunda consiste en buscar el mayor error entre todos los que se están calculando. La razón para separar ambas tareas, es decir, mantener el error de cada peso de forma independiente y, al mismo tiempo, localizar el mayor error calculado, es evitar que el entrenamiento termine prematuramente y también impedir que todos los pesos se ajusten con la misma magnitud. Si no haces esta distinción, estarás modificando la ecuación utilizada para calcular el gradiente.
Este cambio puede resultar beneficioso en situaciones muy específicas, ya que permitiría calcular el gradiente con mayor rapidez. Sin embargo, como ya se ha mencionado, esto solo se aplica a casos muy concretos. Y como aquí no estamos desarrollando una solución específica, queremos que el gradiente se calcule y se ajuste de la forma más general posible. De ahí la separación entre el mayor error y los errores correspondientes a cada uno de los pesos.
Muy bien, después de todo esto todavía tenemos una última comprobación antes de devolver el resultado al autor de llamada. Esta comprobación, realizada en la línea veinte, garantiza que el error del sesgo, si es mayor que el error de los pesos, sea el valor que se devuelva al autor de llamada. En muchas situaciones, el error del sesgo será menor que el error de los pesos. Sin embargo, cuando no sea así, queremos evitar que el entrenamiento finalice. Por esta razón se realiza la comprobación de la línea veinte.
Y así es como se construye el gradiente en un perceptrón para que pueda admitir cualquier número de entradas, utilizando la misma expresión matemática que vimos en el tema anterior. Aunque pueda parecer bastante confusa y compleja, al implementarla en código resulta mucho más sencilla y fácil de comprender de lo que muchos podrían imaginar. Todo esto permite que nuestro perceptrón sea capaz de ejecutar tareas independientemente del tipo de problema que se le plantee. Esto sí es algo bonito y divertido de programar. Sin embargo, todavía no hemos terminado. Aún nos falta incorporar la función de activación tanto al gradiente como a la función de costo de mínimo cuadrado. Esta es la parte realmente interesante de implementar. Pero antes necesitamos entender cómo se desarrollarán los cálculos, porque escribir el código puede resultar incluso algo aburrido. La parte matemática, en cambio... Ah, esa sí es realmente interesante. Así que, para separar ambas cosas, vamos a pasar a un nuevo tema.
Un poco de matemáticas no le hace daño a nadie
La parte divertida no consiste en crear una forma de añadir individualmente cada una de las funciones de activación. Eso definitivamente no tiene ninguna gracia. Llega a ser tedioso de lo sencillo y repetitivo que resulta. Aquí vamos a hacer algo un poco más elaborado. Vamos a desarrollar una forma de utilizar cualquier función de activación que necesitemos o queramos, con solo añadirla a la biblioteca de funciones de activación. Eso sí va a ser divertido de desarrollar.
Antes de empezar, déjame hacer una pequeña aclaración sobre lo que ya hemos creado y lo que vamos a crear. La clase C_Neuron no está pensada, en ningún caso, para utilizar el mínimo cuadrado como función de costo definitiva. Esto se debe a que, una vez que las funciones de activación estén correctamente implementadas en el gradiente, este será mucho más adecuado en términos generales, ya que resulta considerablemente más rápido a medida que aumenta el número de entradas del perceptrón. Es decir, si necesitas utilizar diez mil entradas en un perceptrón, puedo garantizarte que durante el entrenamiento el gradiente será mucho más rápido que el mínimo cuadrado. Una vez finalizado el entrenamiento, ya no necesitaremos ninguna función de costo en la implementación final. Solo necesitaremos las funciones de activación, los pesos y el sesgo de cada uno de los perceptrones implicados, además de la forma en que estarán conectados. Pero este tema se explicará con más detalle en otro artículo.
La forma en que añadiremos la función de activación al perceptrón nos obligará a utilizar un cálculo algo diferente según empleemos el mínimo cuadrado o el gradiente. Esto tiene una razón concreta: la retropropagación. Cuando implementemos esta retropropagación dentro de una red, no quiero tener problemas al transferir los datos entre los perceptrones. Por eso, el enfoque que utilizaremos será bastante diferente de lo que muchos podrían estar esperando. Por ahora, centrémonos en la retropropagación dentro del propio perceptrón y dejemos de lado las conexiones entre los perceptrones de la red. Para entenderlo, observa la siguiente imagen.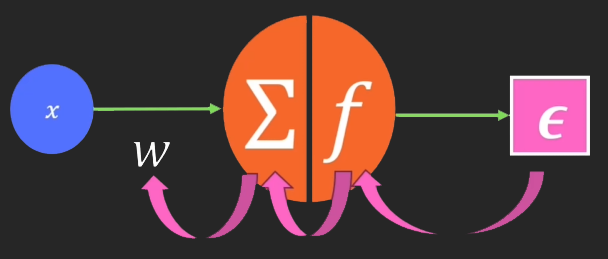
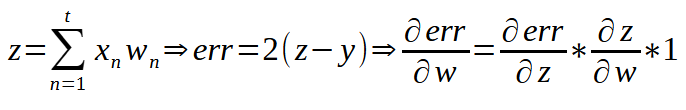
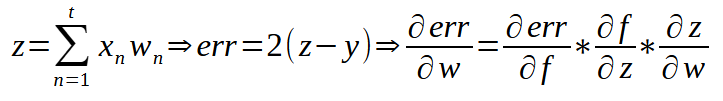
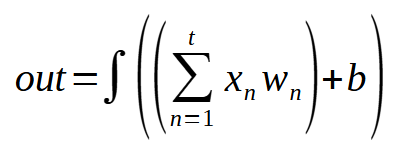
Esta sí es la expresión que realmente utilizamos, tanto cuando ya disponemos de un modelo entrenado como mientras estamos entrenando uno. Un detalle: el signo de integral que ves en esta expresión no significa que vayamos a calcular una integral. Está ahí únicamente para representar la función de activación. Al observar la expresión, podemos ver claramente que no se realiza ningún cálculo complejo. Todo se basa en sumas y multiplicaciones, además, por supuesto, de una de las funciones de activación explicadas en un artículo anterior. Esta función deberá definirse al crear el perceptrón para que todo funcione correctamente.
Ahora viene la parte curiosa. Probablemente ya estés pensando: ¿Entonces el perceptrón tiene dos salidas en lugar de una? ¿Eso es lo que acabamos de crear? Sí, eso es exactamente lo que ocurrirá. Sin embargo, todavía no hemos creado estas dos salidas. Es cierto que la retropropagación ya puede considerarse una salida, pero tal como está ahora no cuenta. Una de las salidas se conoce como FORWARD PROPAGATION, mientras que la otra se denomina BACK PROPAGATION. Ambas deben existir para que el perceptrón nos resulte realmente útil.
Como el concepto es muy sencillo y aparentemente obvio, rara vez se habla de FORWARD PROPAGATION. En cambio, se habla mucho de BACK PROPAGATION, incluso cuando la explicación queda algo incompleta.
Consideraciones finales
En este artículo expliqué con algo más de detalle cómo y por qué surgió el uso del gradiente en las redes de perceptrones. También comenzamos a explorar otra cuestión: FORWARD PROPAGATION y BACK PROPAGATION, aunque todavía no hemos incorporado las funciones de activación al perceptrón para poder ver este mecanismo en funcionamiento. Lo explicado aquí facilitará la exposición de los próximos artículos y, en consecuencia, su comprensión.
Aunque todo pueda parecer todavía un poco lejano, estamos avanzando en la dirección correcta. Por eso, te pido que estudies este material con calma, ya que comprender lo explicado aquí es fundamental para entender lo que veremos próximamente.| Archivo MQ5 | Descripción |
|---|---|
| Scripts\Example A | Demostración básica |
| Scripts\Example B | Demostración básica |
Traducción del portugués realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/pt/articles/13936
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Del nivel básico al intermedio: Recursos
 Del básico al intermedio: Objetos y subventanas (I)
 Particularidades del trabajo con números del tipo double en MQL4
 Red neuronal en la práctica: Funciones de activación

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso