

Red neuronal en la práctica: Nacimiento de C_Neuron
 18
 0

Introducción
En el artículo anterior, Red neuronal en la práctica: Cuándo usar una neurona artificial y entender su función en MQL5, mencioné y demostré con claridad que una neurona no siempre puede manejar determinadas situaciones. Tú también puedes comprobarlo con los códigos del archivo adjunto. Aunque la creencia generalizada sostiene justo lo contrario de lo que podemos observar, los experimentos no dejan lugar a dudas. Usar neuronas, o incluso una red neuronal, no siempre será la mejor opción.
Sin embargo, hay muchísimas situaciones en las que una neurona, o incluso una red neuronal, es la solución ideal para obtener, de forma rápida y eficaz, una representación adecuada de un conjunto de datos o registros. A menudo, basta con usar una base de datos que ya contenga todos los datos que necesitamos o con los que queremos trabajar. Otras veces, los datos se suministrarán en tiempo real. Dejaremos para más adelante este segundo modelo, en el que se suministran datos a la red neuronal en tiempo real.
Esto se debe a que quiero mostrar una aplicación bastante interesante que te permitirá, mi querido lector, comprender cómo el sistema, o la red neuronal, aprenderá a manejar una situación muy concreta. Sin duda, despertará tu curiosidad y tu interés por profundizar cada vez más en el tema. Por ahora, vamos a centrarnos en el presente.
Bien, si estás siguiendo estos artículos sobre redes neuronales, habrás notado que muchas veces hemos utilizado una sola entrada para facilitar la programación y la explicación de los códigos. En aplicaciones reales, rara vez usamos una sola entrada. Lo habitual es que la neurona tenga al menos dos entradas, sobre todo si queremos implementar una pequeña red neuronal. Incluso en la fase inicial, mi querido lector, habrás notado que fue necesario usar más de una entrada cuando creamos una neurona para representar puertas lógicas. Durante ese proceso, tuvimos que utilizar una pequeña red neuronal para representar una puerta XOR y su inversa.
Muy bien, a estas alturas ya debes de estar pensando: añadir nuevas entradas es relativamente sencillo. Solo necesitamos indicárselo a la neurona, añadir un peso para esa entrada y listo. Claro que no debemos olvidarnos de modificar la función de costo. De lo contrario, la nueva entrada no servirá de nada. En eso tienes razón, mi querido lector. Ahora bien, hay una pequeña complicación. Añadir unas pocas entradas es muy sencillo, al igual que eliminarlas.
Conviene pensar en algunos detalles al respecto. No querrás tener que escribir o modificar código continuamente solo para añadir o eliminar entradas de la neurona. Y, peor aún, si necesitas una red neuronal, no querrás programarla a mano. Es mucho más sencillo y adecuado indicar cómo debe ser su arquitectura y dejar que el código la implemente por nosotros. Más adelante veremos cómo hacerlo. Volvamos al caso de las entradas.
Otra cuestión: supongamos que un problema requiere mil entradas. Empiezas a añadir código para crear esas mil entradas. En un momento dado, alguien viene y te dice: "Oye, acabamos de darnos cuenta de que harán falta diez mil entradas". Te entran ganas de llorar, pero aceptas la tarea. Cuando ya tienes casi diez mil entradas creadas, aparece otra persona y te dice: nos hemos dado cuenta de que no hacen falta diez mil entradas; podemos usar solo dos mil. Entonces te entran ganas de agarrar un garrote y darle una lección a alguien.
No es raro que a un principiante le tomen el pelo de esta manera. Si no fuera tan principiante, tendría algo más de picardía y sabría cómo resolver la situación para reducir su esfuerzo. Esa es precisamente la propuesta inicial de este artículo: mostrar cómo crear una implementación que nos permita controlar el número de entradas de una forma muy, pero que muy sencilla. Así que vamos a remangarnos y pasar al código.
El nacimiento de la clase C_Neuron
Antes de empezar, debemos aclarar un detalle, mi querido lector: la clase que vamos a crear para representar una neurona será, por ahora, muy sencilla y directa. No incluiremos nada que no sea estrictamente necesario. El código será lo más sencillo y didáctico posible, aunque no sea eficiente en cuanto al tiempo de cálculo. Entiende este tiempo de cálculo como el tiempo de ejecución.
El objetivo aquí no es crear un código eficiente, sino uno funcional que cualquiera pueda comprender perfectamente. Incluso alguien que esté empezando a programar en MQL5 y tenga interés por las redes neuronales podrá entenderlo, ya que usaremos MQL5 puro. Tal vez incorpore algo de SQL en el futuro, pero intentaré ceñirme al máximo a MQL5 puro y simple.
Una vez aclarado esto y explicado lo que veremos, podemos empezar. Lo haremos con la implementación más sencilla de todas, la que usa mínimos cuadrados como función de costo. De nuevo, la idea es ser didácticos, no eficientes. Antes de ver el código, observemos lo siguiente:

Quizá estemos resultando algo repetitivos, pero así son las redes neuronales. Dejando eso a un lado, fíjate en un detalle curioso de la ecuación anterior. Al observarla y entender lo que hace, enseguida te das cuenta de que debemos multiplicar cada entrada por un peso, sumarlo todo y restar esa suma del valor correcto. Si elevamos el resultado al cuadrado, obtenemos el error final de la posición evaluada. Un detalle: hay otras funciones para calcular el error, pero usaremos esta porque es la más sencilla de derivar.
Muy bien, ahora vamos a aislar la entrada, representada como < X >, y el peso, representado como < W >. Así obtenemos lo que se muestra a continuación.

Mmm, interesante. ¿Qué significa esto? Mi querido lector, al hacerlo así, estamos indicando que el valor de < k > es el número de entradas que tendrá la neurona. Si algún entrenamiento requiere mil entradas, solo tenemos que asignar a k el valor mil. Así de sencillo. De esta forma, tendríamos algo equivalente a lo siguiente.
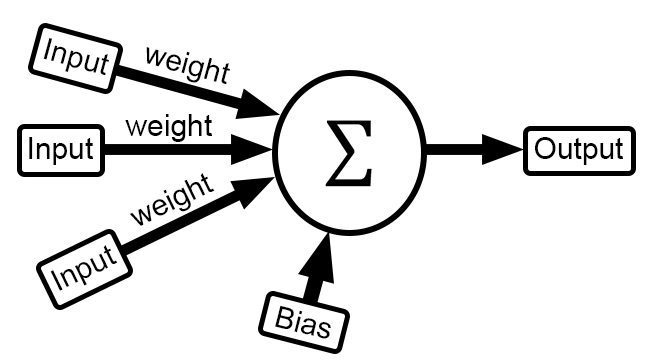
Ahora viene la parte realmente interesante, directamente relacionada con lo que necesitamos hacer en el código. Al observar la suma de los productos de cada entrada x por su peso w, quizá no te des cuenta de que se trata de una operación matricial. ¿Cómo? No lo entiendo. Tranquilo, mi querido lector, vamos a transformar la notación del sumatorio en algo más claro para que puedas entenderlo. Lo vemos en la siguiente imagen.

Ahora sí tenemos algo realmente bonito ante nosotros. Aunque implementar en código el contenido del lado izquierdo resulta complicado, implementar el del lado derecho es muy fácil. Esto se debe a que podemos usar arrays. Así podemos cambiar el número de entradas de la neurona de forma muy sencilla y rápida. ¡Esto está genial! ¿Cómo se traduce al código? Mi querido lector, a continuación puedes ver cómo queda dentro del código de la clase.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. #define macroRandom (rand() / (double)SHORT_MAX)
05. //+------------------------------------------------------------------+
06. class C_Neuron
07. {
08.     private:
09.         uint    m_Inputs;
10.         double  m_bias,
11.                 m_weight[];
12. //+------------------------------------------------------------------+
13.         inline double Cost(const double &train[])
14.         {
15.             double x, err;
16.
17.             err = 0;
18.             for (uint c0 = 0; c0 < train.Size(); c0++)
19.             {
20.                 x = 0;
21.                 for(uint c1 = 0; c1 < m_Inputs; c1++, c0++)
22.                    x += (train[c0] * m_weight[c1]);
23.                 err += MathPow((x + m_bias) - train[c0], 2);
24.             }
25.
26.             return err;
27.         }
28. //+------------------------------------------------------------------+
29.     public :
30. //+------------------------------------------------------------------+
31.         C_Neuron(const uint nInputs = 1, double H = 1.0, double L = 0.0)
32.         {
33.             MathSrand(512);
34.             m_Inputs = nInputs;
35.             ArrayResize(m_weight, m_Inputs);
36.             for(uint c = 0; c < m_Inputs; c++)
37.                 m_weight[c] = ((double)macroRandom * (H - L)) + L;
38.             m_bias = (double)macroRandom;
39.         }
40. //+------------------------------------------------------------------+
41.         ~C_Neuron()
42.         {
43.             ArrayFree(m_weight);
44.         }
45. //+------------------------------------------------------------------+
46.         void View_Variables(void)
47.         {
48.             Print("Bias: ", m_bias);
49.             for (uint c = 0, m = m_weight.Size(); c < m; c++)
50.                 PrintFormat("Weight[%d]: %.16f", c, m_weight[c]);
51.         }
52. //+------------------------------------------------------------------+
53.         inline double Learning(const double &train[], const double epsilon = 1e-3, const ulong limit = ULONG_MAX)
54.         {
55.             double  err,
56.                     mem_b,
57.                     err_w[],
58.                     mem_w[];
59.
60.             ArrayResize(err_w, m_Inputs);
61.             ArrayResize(mem_w, m_Inputs);
62.             for (ulong count = 0; (count < limit) && ((err = Cost(train)) > epsilon); count++)
63.             {
64.                 ArrayCopy(mem_w, m_weight);
65.                 for (uint c = 0, m = m_weight.Size(); c < m; c++)
66.                 {
67.                     m_weight[c] += epsilon;
68.                     err_w[c] = Cost(train) - err;
69.                     m_weight[c] = mem_w[c];
70.                 }
71.                 mem_b = m_bias;
72.                 m_bias += epsilon;
73.                 m_bias = mem_b - (Cost(train) - err);
74.                 for (uint c = 0, m = m_weight.Size(); c < m; c++)
75.                     m_weight[c] -= err_w[c];
76.             }
77.             ArrayFree(err_w);
78.             ArrayFree(mem_w);
79.
80.             return err;
81.         }
82. //+------------------------------------------------------------------+
83. };
84. //+------------------------------------------------------------------+
85. #undef macroRandom
86. //+------------------------------------------------------------------+
Debido a algunas diferencias entre C/C++ y MQL5, el código ha quedado algo distinto de la versión que, en mi opinión, resultaría más legible. Aun así, no es complicado de entender. Aquí hemos implementado lo más básico: esta neurona utilizará mínimos cuadrados como función de costo y podrá tener tantas entradas como sean necesarias. Hay un pequeño detalle que marcará la diferencia en la forma de trabajar con esta clase. Lo veremos un poco más adelante.
Empecemos por entender el código que hemos implementado. Primero, el constructor de la clase, que se encuentra en la línea 31. Fíjate en que es sencillo, claro y directo. Mediante sus argumentos podemos indicar a la clase cuántas entradas tendrá la neurona. También podemos indicar los límites superior e inferior de los valores pseudoaleatorios que se asignarán durante la inicialización.
Como ves, ahora empezamos a abordar el asunto con más profundidad. En la línea 33 indicamos cómo se inicializará el generador de números pseudoaleatorios. Como nuestro propósito es didáctico, utilizaremos un valor fijo. En situaciones reales, esta línea 33 sería ligeramente diferente. De hecho, sería la única línea de todo el código de la clase que habría que modificar.
Bien, en los siguientes pasos inicializaremos los valores internos de la clase. Empezamos por guardar el número de entradas en la línea 34. Después, en la línea 35, reservamos memoria suficiente para el array de pesos, uno por cada entrada. Para inicializar estos pesos usamos el bucle de la línea 36. Por último, en la línea 38, inicializamos el sesgo. Con esto, nuestra neurona estará lista para el entrenamiento.
Muy bien, en la línea 41 tenemos el destructor, cuyo único objetivo es liberar la memoria reservada para almacenar los pesos. Como nuestra neurona puede tener varias entradas y quizá queramos ver su contenido, en la línea 46 tenemos un procedimiento muy sencillo, pero muy útil. Su única finalidad es imprimir los valores de todas las variables de la neurona en el terminal de MetaTrader 5. En la línea 48 indicamos que se imprima el valor del sesgo. En la línea 49, que se impriman todos los pesos. Es decir, no necesitamos volver a indicar cuántas entradas debe mostrarnos la neurona. Como sabe cuántas tiene, nos las mostrará todas. Algo directo, sencillo y práctico.
Ahora viene la parte tan esperada: las funciones que se utilizan para entrenar la neurona. Primero usaremos la función de mínimos cuadrados. Como exige más potencia de cálculo, pronto la sustituiremos por otro tipo, muy probablemente por alguna basada en gradientes. Lo dejaremos para otro momento. Primero veamos cómo funciona la de mínimos cuadrados.
Lo primero que debes entender es lo siguiente, mi querido lector: no importa dónde vayas a usar esta neurona. Si puede interpretar los datos de entrenamiento, podrás utilizarla sin necesidad de entender qué tipo de función se emplea para el aprendizaje. Esto quizá suene algo abstracto. Como estamos usando una clase, podemos modificar cualquier cosa dentro de ella sin tener que comunicar esos cambios internos al código que la utiliza. Así podemos disponer de una función de costo más eficiente sin que la aplicación que usa la clase tenga que saberlo. Esto es muy conveniente, ya que podemos pasar a un método de entrenamiento basado en gradientes sin comunicar nada a la aplicación que utiliza la clase.
Para ello necesitamos una interfaz adecuada. Por esta razón, la única función que utilizaremos para el entrenamiento es la que se declara en la línea 53. Fíjate en que es bastante sencilla y requiere pocos argumentos. El primero contiene los datos de entrenamiento. El segundo indica el valor objetivo del error para dar por finalizado el entrenamiento. El último indica cuántas iteraciones se permiten. Este argumento nos permite probar el entrenamiento para comprobar si converge hacia una solución. Como se mostró en los otros artículos, puede ocurrir que la neurona, o más bien la función que buscamos, no logre converger.
Dentro de esta función de la línea 53, declaramos algunas variables internas en la línea 55. En las líneas 60 y 61 reservamos memoria para usarla temporalmente. En la línea 62 entramos en el bucle que se repetirá un número determinado de veces. Ya explicamos este bucle en otros artículos, aunque su contenido es algo diferente. Observa que en la línea 64 copiamos los pesos a una zona temporal de memoria. Esto no es muy eficiente, pero de momento servirá para nuestro propósito.
En la línea 65 entramos en un nuevo bucle interno, cuyo objetivo es recorrer las entradas una por una y calcular sus valores de error. Los nuevos valores de error de cada entrada se guardan temporalmente en memoria, como se ve en la línea 68. Una vez calculados los errores de todas las entradas a partir de la variación deseada, debemos ajustar el valor de error del sesgo. Esto se hace en la línea 73. Por fin podemos corregir cada peso a partir del error calculado anteriormente, mediante el bucle de la línea 74.
Una vez ejecutado todo esto, el código vuelve a la línea 62, donde comienza una nueva iteración. Permanecerá en este bucle hasta alcanzar el límite de iteraciones indicado o el error esperado. Cuando se cumpla cualquiera de las dos condiciones, el bucle terminará y se ejecutarán las líneas 77 y 78 para liberar la memoria reservada. Como a veces resulta útil, en la línea 80 devolveremos el valor de error alcanzado durante el entrenamiento. Así podremos comprobar si está dentro de lo esperado cuando probemos el entrenamiento con un número reducido de iteraciones.
Bien, pasemos a la línea 13. Como puedes ver, en esta función de entrenamiento llamamos varias veces a la función que calcula el costo. Esta función, como se observa en la línea 13, recibe un único argumento. Al ser un array, podemos pasar mucha más información que con otro tipo de estructura. Aquí debemos tomar una pequeña precaución. Presta atención, mi querido lector, porque, si no entiendes lo que voy a explicar, tendrás problemas al intentar entrenar la neurona con más o menos entradas.
Vayamos con calma. En la línea 18 iniciamos un bucle que recorrerá todo el array. Como puedes observar, este recorrido se hace sin distinguir los datos. Es decir, la función no comprobará en ningún momento si el valor corresponde a una entrada o al valor esperado. Ahora bien, si haces las cosas correctamente, no tendrás problemas. Veamos cómo evitarlos al trabajar con este array.
Al crear la neurona, le indicamos cuántas entradas debe tener. Cuando se ejecute el bucle de la línea 21, la función de costo tomará cada valor del array de entrenamiento y lo multiplicará por el peso de la entrada correspondiente. Esta es la parte del cálculo matricial. Multiplicamos los valores y sumamos cada producto al resultado anterior. Tanto el array de entrenamiento como el de pesos son unidimensionales. El producto escalar de las entradas por sus pesos produce un valor escalar. A este valor se le suma después el sesgo y se resta el resultado del valor esperado.
Una vez calculado este resultado, lo elevamos al cuadrado y lo sumamos a los valores anteriores. Así obtenemos la suma de los errores al cuadrado. Esto que acabo de explicar se hace en la línea 23. Al terminar de recorrer los valores de entrenamiento, devolvemos el error total calculado en la línea 26.
Si observas esta función de costo y prestas atención a lo que ocurre en los bucles, quizá te parezca algo extraña y pienses que no va a funcionar. Comprobémoslo con el código que se muestra a continuación.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. #include <Neural Network\C_Neuron.mqh>
05. //+------------------------------------------------------------------+
06. double Train[] {
07.                 0, 0,
08.                 1, 2,
09.                 2, 4,
10.                 3, 6,
11.                 4, 8
12.                };
13. //+------------------------------------------------------------------+
14. void OnStart()
15. {
16.     C_Neuron *neuron;
17.
18.     Print("************************************");
19.     Print("Simple Neuron in Class...");
20.
21.     neuron = new C_Neuron(1);
22.
23.     (*neuron).View_Variables();
24.     Print("********** RESULT *************");
25.     Print("Error: ", (*neuron).Learning(Train));
26.     (*neuron).View_Variables();
27.
28.     delete neuron;
29. }
30. //+------------------------------------------------------------------+
El resultado de la ejecución se muestra en la siguiente imagen.
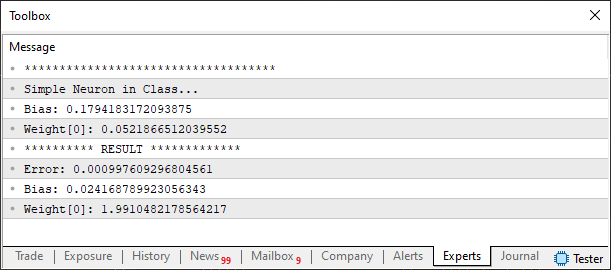
Fíjate en que el resultado está dentro de lo esperado, lo que demuestra que la neurona funciona perfectamente. Un momento: ¿cómo funciona el código que acabamos de ver? Parece algo extraño. Mi querido lector, como mencioné, todo lo que hagamos aquí se planteará de la forma más didáctica posible. En este código hay dos puntos a los que debes prestar atención cuando uses la clase de la neurona. El primero son los datos de entrenamiento, que debes preparar teniendo en cuenta el número de entradas de la neurona. Ambas cosas están estrechamente relacionadas. Si cambias una sin tener en cuenta la otra, cometerás un error o tendrás una neurona completamente desorientada, sin saber qué hacer con los datos.
Presta atención. En la línea seis se declaran los datos de entrenamiento. Aquí están preparados para una neurona con una sola entrada. Por esta razón, en la línea 21 indicamos que la neurona tendrá una entrada. Volvamos a los datos de entrenamiento. Fíjate en que he dispuesto el array de modo que parezca una matriz de dos columnas y varias filas. Para mantener los datos ordenados, te aconsejo disponer el array de entrenamiento de la misma manera.
Es decir, debes colocar tantas columnas como entradas tenga la neurona, más una última columna que corresponda al valor esperado, o estimado si el valor no es exacto. Para dejarlo más claro: si quieres que la neurona tenga dos entradas, debes disponer el array en tres columnas. La tercera contendrá el valor que permitirá a la neurona evaluar cuánto se equivoca. Así podrá ajustar el valor de la función de costo y, de esta manera, entrenarse.
Por ahora conviene trabajar con esta neurona con cierta calma, ya que puede llegar a un punto de estancamiento que le impida avanzar en el entrenamiento. Esto se debe a que carece de una función de activación.
Puedes ver cómo ocurre en el artículo ##>>Red neuronal en la práctica: La práctica lleva a la perfección<<https://www.mql5.com/es/articles/13748##, donde mostré que podíamos usar una neurona para representar una puerta lógica. Como no tenía una función de activación, de vez en cuando la neurona llegaba a un punto de estancamiento en el que la tasa de aprendizaje disminuía mucho o, sencillamente, dejaba de aprender.
Recuerda que apenas estamos comenzando una nueva etapa en la que explicaré varias cosas. Por ahora ya tenemos un punto de partida para estudiar. Aun así, puedes usar esta neurona para resolver algunos tipos de polinomios sencillos. Por ejemplo, si modificas el código para utilizar otro conjunto de datos de entrenamiento, verás que sigue generando datos bastante aceptables, aunque no sean exactos. Todo dependerá de si la ecuación utilizada para generar los datos puede representarse mediante una recta o una función afín. Por ejemplo, modifiquemos el código como se muestra a continuación.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. #include <Neural Network\C_Neuron.mqh>
05. //+------------------------------------------------------------------+
06. double Train[] {
07.                   1,    3,  10.35  ,
08.                 1.5,  3.25, 11.7875,
09.                 1.75, 3.94, 13.721 ,
10.                 2.85, 3.46, 14.669 ,
11.                };
12. //+------------------------------------------------------------------+
13. void OnStart()
14. {
15.     C_Neuron *neuron;
16.
17.     Print("************************************");
18.     Print("Simple Neuron in Class...");
19.
20.     neuron = new C_Neuron(2);
21.
22.     (*neuron).View_Variables();
23.     Print("********** RESULT *************");
24.     Print("Error: ", (*neuron).Learning(Train));
25.     (*neuron).View_Variables();
26.
27.     delete neuron;
28. }
29. //+------------------------------------------------------------------+
Ahora vemos algo un poco diferente. En la línea seis tenemos nuevos datos de entrenamiento, preparados para utilizar dos entradas en la neurona, en lugar de una. Al ejecutar este nuevo código, obtenemos el resultado que se muestra en la siguiente imagen.
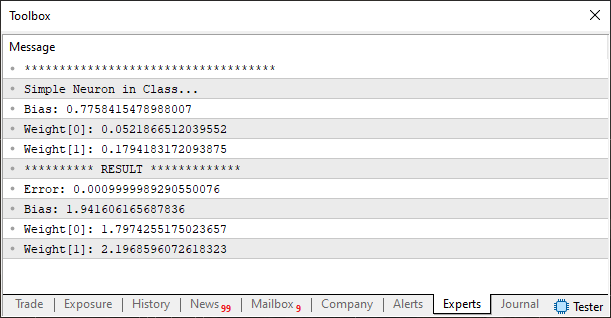
Sencillo, ¿verdad? Mi querido lector, recuerda lo que dijimos antes: debemos preparar y revisar el array de entrenamiento teniendo en cuenta que cada columna representa una entrada. La última columna contendrá los valores que permitirán a la neurona evaluar su error con los valores de sus parámetros internos, los pesos y el sesgo, inicializados de forma pseudoaleatoria. Por eso, en este segundo ejemplo de entrenamiento, los datos se distribuyen en tres columnas. En consecuencia, debemos cambiar de uno a dos el valor de la línea 20. De este modo, la neurona podrá interpretar dos valores como entradas y utilizar el tercero como resultado estimado para ajustar el error en cada iteración.
Como todo el código se ha diseñado para que no tengamos que modificarlo, la neurona reservará automáticamente espacio suficiente para analizar dos entradas. Con esto, por fin tenemos una implementación que nos evita escribir o modificar código cada vez que necesitamos cambiar el número de entradas de la neurona.
Consideraciones finales
En este artículo empezamos a dejar atrás la forma de programar que veníamos usando, en la que cada cambio, ajuste o carga que se imponía a la neurona nos obligaba a modificar el código. A partir de ahora, empezamos a encapsular la implementación para poder utilizarla, mejorarla y modificarla sin grandes dificultades. A medida que se añadan nuevas funciones a la neurona, cualquier código que use la clase se beneficiará de esos cambios.
Por ahora hemos creado la implementación más sencilla de todas: la neurona sigue utilizando una función de costo basada en mínimos cuadrados y todavía no tiene una función de activación. Además, nos falta otro elemento que implementaremos más adelante: un mecanismo de retropropagación que permita transmitir el error entre varias neuronas conectadas. El mecanismo actual está limitado a una sola neurona. Para entrenamientos más complejos, debemos mejorarlo de manera que podamos conectar las neuronas en cascada. Dicho de otra forma, mi querido lector, necesitamos crear un mecanismo de retropropagación que pueda transmitir el error cuando las neuronas se conecten una detrás de otra. Con el mecanismo actual, si intentas hacer esto y creas una pequeña red neuronal, llegará un momento en que se estancará y no podrá seguir aprendiendo.
Como dije antes, veremos cómo hacerlo más adelante. Hasta entonces, empieza a estudiar y experimentar con el código de este artículo. En el archivo adjunto encontrarás las dos neuronas que hemos visto aquí, así como la clase inicial. Nos vemos en el próximo artículo.
| Archivo MQ5 | Descripción |
|---|---|
| Scripts\Example A | Demostración básica |
| Scripts\Example B | Demostración básica |
Traducción del portugués realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/pt/articles/13873
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Del básico al intermedio: Subventanas (III)
 Dominando los registros (Parte 10): Cómo evitar la repetición de registros implementando un sistema de supresión
 Arbitraje estadístico mediante acciones cointegradas (Parte 2): Asesor Experto, pruebas retrospectivas y optimización
 Del nivel básico al intermedio: Subventanas (II)

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso