

Gauß-Prozesse im maschinellen Lernen (Teil 1): Klassifikationsmodell in MQL5
 175
 3

Einführung
Wir setzen unsere Einführung in Gauß-Prozesse (GP) als Modell des maschinellen Lernens fort. Im vorherigen Artikel haben wir das Regressionsproblem im Detail untersucht, bei dem das Hauptziel die Vorhersage kontinuierlicher Werte war. Heute müssen wir uns mit einem weitaus komplexeren Thema befassen – der Klassifikation. Die zentrale Schwierigkeit besteht darin, dass sich die Inferenz bei der Klassifikation mit Gauß-Prozessen nicht in geschlossener Form lösen lässt, was die Verwendung von Näherungsverfahren wie der Laplace-Approximation erfordert.
Um dieses komplexe Problem effektiv zu lösen, werden wir eine modulare Bibliothek für Gauß-Prozesse in MQL5 entwickeln. Dieser Ansatz ermöglicht es uns, den Code zu strukturieren, indem das GP-Modell in unabhängige Komponenten unterteilt wird, und bietet eine solide Grundlage für weitere Verbesserungen und Erweiterungen. Diese Bibliothek wird zu einem universellen Werkzeug für Regressions- und Klassifikationsaufgaben.
Im ersten Teil des Artikels werden wir die Theorie der GP-Klassifikation im Detail untersuchen, einschließlich der Mathematik, die den Näherungsverfahren zugrunde liegt. Wir werden auch die Hauptklasse der Bibliothek vorstellen – GaussianProcess, die alle Komponenten des Modells vereint, sowie die Klasse GPOptimizationObjective, die für die Integration mit der Alglib-Optimierungsbibliothek verantwortlich ist.
Klassifikation
Klassifikation ist eine Aufgabe des maschinellen Lernens, bei der einem Objekt eine von vordefinierten Kategorien zugewiesen wird. Im Finanzwesen kann Klassifikation beispielsweise dabei helfen, auf der Grundlage historischer Daten vorherzusagen, ob ein Aktienkurs steigen oder fallen wird.
In diesem Artikel konzentrieren wir uns auf die binäre Klassifikation, bei der ein Objekt zu einer von zwei Klassen gehört, wie zum Beispiel „Anstieg“ (+1) oder „Rückgang“ (-1). Im Gegensatz zu Methoden wie Support Vector Machines (SVM) oder Entscheidungsbäumen, die nur ein Klassenlabel erzeugen, ermöglichen GPs eine probabilistische Vorhersage. Ein Modell könnte zum Beispiel sagen, dass eine 75-%ige Wahrscheinlichkeit besteht, dass eine Aktie steigt. Solche Informationen sind besonders wertvoll im Handel, wo der Grad der Sicherheit einer Vorhersage hilft, fundierte Entscheidungen zu treffen, was es ermöglicht, unzuverlässige Signale herauszufiltern.
Leider ist die Lösung eines Klassifikationsproblems mit GP wesentlich komplexer als bei der Regression. Dies hängt mit der Art der verwendeten Likelihood zusammen:
- In der Regression wird typischerweise die Gauß-Likelihood verwendet. Die Kombination aus dem GP (als A-priori-Verteilung der Funktion) und der Gauß-Likelihood ermöglicht es uns, die A-posteriori-Verteilung analytisch zu erhalten, was alle Berechnungen vereinfacht.
- Für die Klassifikation, bei der die Zielwerte diskrete Klassenlabels sind, ist die Gauß-Likelihood nicht geeignet. Stattdessen kann man beispielsweise die Logit-Likelihood verwenden. Dies führt dazu, dass die A-posteriori-Verteilung ebenfalls keine Gauß-Verteilung ist und keine Lösung in geschlossener Form besitzt.
Infolgedessen müssen wir auf komplexe Methoden der approximativen Inferenz zurückgreifen. Die Grundidee dieser Methoden besteht darin, die tatsächliche nichtgaußsche A-posteriori-Verteilung durch eine Gauß-Verteilung zu approximieren, die um ihren Modus zentriert ist. In diesem Artikel konzentrieren wir uns auf die Laplace-Approximation, da sie einer der einfachsten und effektivsten Ansätze ist, um eine Gauß-Approximation der A-posteriori-Verteilung zu erhalten.
Bei der binären Klassifikation ist die zugrunde liegende Idee der GP-basierten Vorhersage recht einfach. Wir beginnen mit einer A-priori-Verteilung der latenten Funktionen f(x). Stellen Sie sich vor, dass der GP nicht nur eine Funktion erzeugt, sondern eine unendliche Menge möglicher Funktionen, von denen jede eine potenzielle „latente“ Abhängigkeit in den Daten darstellt. Dann wird jede dieser potenziellen Realisierungen der latenten Funktion f(x) durch die logistische Funktion (Sigmoidfunktion) transformiert. Das Sigmoid transformiert jede reelle Zahl (den Wert von f(x)) in eine Wahrscheinlichkeit zwischen 0 und 1 und ergibt so unsere A-priori-Wahrscheinlichkeit π(x) für die Zugehörigkeit zur Klasse +1.
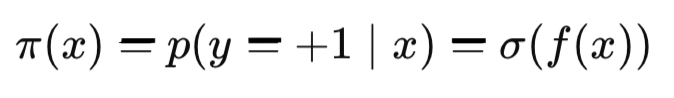
Es ist wichtig zu beachten, dass π eine deterministische Funktion von f ist, aber da f selbst stochastisch ist (zufällig, eine Stichprobe aus dem GP), wird auch die Funktion π stochastisch. Dieses Konzept wird in Abb. 1 und 2 für einen eindimensionalen Eingaberaum X anschaulich dargestellt.
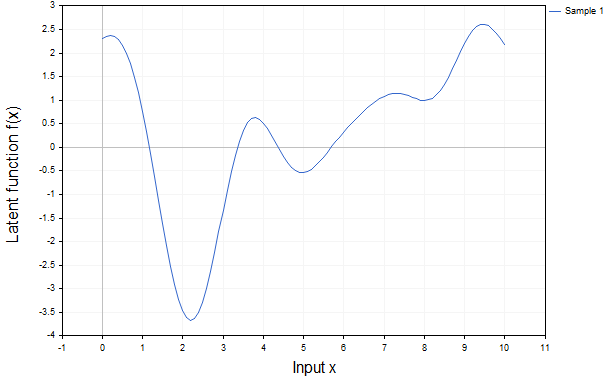
Abb. 1. Realisierung der latenten f(x)-Funktion
Abbildung 1 zeigt nur eine mögliche Realisierung der latenten Funktion und demonstriert das typische Verhalten der Funktion, das den gegebenen Kernel-Hyperparametern entspricht.
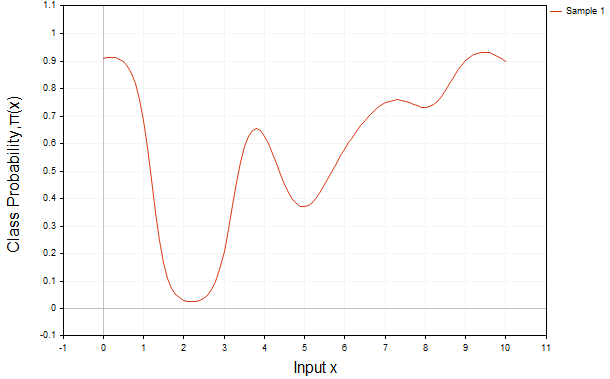
Abb. 2. Dieselbe Funktion transformiert unter Verwendung des Sigmoids
Abb. 2 zeigt das Ergebnis der Anwendung der logistischen (Sigmoid-)Funktion auf dieselbe Funktion f(x):

Somit erhalten wir eine A-priori-Wahrscheinlichkeitsverteilung der Klassenzugehörigkeit π(x)=σ(f(x)), die zu diesem Zeitpunkt die Trainingsdaten y noch nicht berücksichtigt. Ohne Beobachtungen von y bleibt diese A-priori-Verteilung lediglich unsere anfängliche Hypothese, die nicht durch empirische Belege gestützt wird; ohne sie fehlen dem Modell Informationen darüber, welche seiner anfänglichen Annahmen korrekt waren und welche einer Überarbeitung bedürfen.
Natürlich beeinflusst die Wahl der A-priori-Annahmen die endgültigen A-posteriori-Ergebnisse erheblich. Dies ist ein Hauptmerkmal des Bayes-Ansatzes, da die Eigenschaften der A-priori-Verteilung von Funktionen und damit das endgültige Modell von der Entscheidung des Forschers über den Kerneltyp abhängen.
Inferenz
Um fundierte Vorhersagen treffen zu können, müssen wir also die tatsächlichen Trainingsdaten y berücksichtigen. Hier kommt die Inferenz ins Spiel. Ihr Hauptziel ist es, unsere A-priori-Annahmen in A-posteriori-Schätzungen umzuwandeln, also Annahmen, die an die beobachteten Daten angepasst sind. Bei der Klassifikation unterteilt sich dieser Prozess natürlicherweise in zwei aufeinanderfolgende Schritte.
Schritt 1: Prädiktive Verteilung der latenten Funktion f∗
Im ersten Schritt berechnen wir p(f*|X, y, x*), die A-posteriori-Verteilung der latenten Funktion f* für einen neuen Testpunkt x* unter Berücksichtigung der beobachteten Trainingsdaten (X, y). Dies wird durch das folgende Integral definiert:
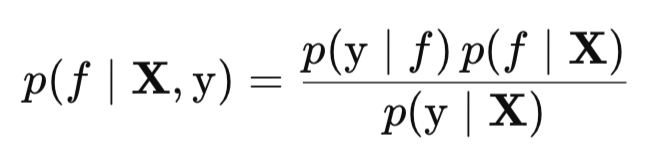
wobei:
- p(f*∣X, x*, f) ist die bedingte Verteilung der latenten Funktion f* an einem neuen Testpunkt x* unter Berücksichtigung der latenten Funktionen f an den Trainingspunkten X. Diese Verteilung ist immer normalverteilt, da der GP definitionsgemäß eine gemeinsame Gauß-Verteilung aufweist,
- p(f|X, y) ist die A-posteriori-Verteilung der latenten Funktionen f auf den Trainingsdaten. Aufgrund der nichtlinearen Likelihood-Funktion (Sigmoid) ist sie nicht-gaußsch.
Es ist wichtig zu beachten, dass dieses Integral keine geschlossene Lösung hat, da p(f|X, y) nicht gaußverteilt ist. Dies bedeutet, dass wir zu ihrer Berechnung Näherungsverfahren einsetzen müssen.
Schritt 2: Endgültige prädiktive Wahrscheinlichkeit π*
Im zweiten Schritt verwenden wir diese prädiktive Verteilung, um eine endgültige Wahrscheinlichkeitsaussage π* zu bilden – die Wahrscheinlichkeit, dass ein Testpunkt x* zur positiven Klasse (y* = +1) gehört:
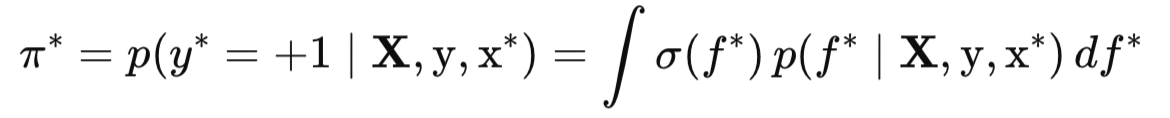
Hierbei ist σ(f*) die logistische (Sigmoid-)Funktion, die den Wert der latenten Funktion f* in eine Wahrscheinlichkeit zwischen 0 und 1 transformiert. Das Integral selbst bedeutet, dass wir diese Wahrscheinlichkeiten über alle möglichen Werte von f* mitteln, gewichtet mit ihrer prädiktiven A-posteriori-Verteilung. Im Wesentlichen ist dieses eindimensionale Integral der mathematische Erwartungswert der Funktion σ(f*) bezüglich der Verteilung p(f*|X, y, x*).
Auch hier hat dieses Integral für die Logit-Likelihood keine Lösung in geschlossener Form. Daher werden wir auch hier Näherungsverfahren benötigen. Vorwegnehmend sei gesagt, dass unsere GP-Bibliothek drei solcher Näherungen implementiert, wodurch Sie die geeignete Methode je nach Anforderungen an Genauigkeit und Rechenaufwand auswählen können:
- Probit-Approximation,
- Numerische Integration,
- Monte-Carlo-Methode.
Diese beiden gerade beschriebenen Schritte – die Berechnung der A-posteriori-Verteilung der latenten Funktion und die anschließende Integration zur Ermittlung der prädiktiven Wahrscheinlichkeit – stellen den allgemeinen Rahmen für die Bayes-Inferenz in GP dar. Dies sind die beiden Integrale, die wir berechnen müssen, um die gewünschte Vorhersage zu erhalten, und beide erfordern die Verwendung von Näherungsverfahren.
Laplace-Approximation
Wie wir bereits festgestellt haben, beinhaltet die Bayes-Inferenz für die Klassifikation Integrale, die nicht in geschlossener Form lösbar sind. Die Laplace-Approximation löst dieses Problem, indem sie die nicht-gaußsche Verteilung p(f∣X, y) durch die Gauß-Verteilung q(f∣X, y) approximiert. Da die bedingte Verteilung p(f*∣X, x*, f) ebenfalls eine Gauß-Verteilung ist, wird auch die resultierende prädiktive Verteilung p(f*∣X, y, x*) gaußsch. Dies ermöglicht es uns, analytische Formeln für den Mittelwert und die Varianz von f* abzuleiten, was weitere Berechnungen erheblich vereinfacht. Die Eleganz und rechnerische Effizienz der Laplace-Approximation liegt somit in ihrer Fähigkeit, die Berechnung der A-posteriori-Verteilung und der Vorhersagen auf Operationen mit Gauß-Verteilungen zu reduzieren.
Es ist wichtig zu verstehen, dass die Laplace-Approximation ein Kompromiss ist. Sie macht ein analytisch nicht lösbares Problem rechnerisch lösbar, jedoch auf Kosten einer genauen Darstellung der wahren Form der A-posteriori-Verteilung. Die Qualität dieser Normalapproximation hängt direkt davon ab, wie nahe die wahre Verteilung von p(f∣X, y) an einer Gauß-Verteilung liegt. Je näher sie liegt, desto genauer wird die Approximation sein, und umgekehrt.
Wenn wir an der wahren Verteilung von p(f*∣X, y, x*) interessiert sind und nicht an deren Approximation, dann werden hierfür üblicherweise MCMC-Methoden (Markov Chain Monte Carlo) verwendet. Obwohl die MCMC-Methode genauere Schätzungen liefern kann, ist sie rechnerisch sehr aufwendig und schwierig zu implementieren. MCMC kann als Goldstandard für den Vergleich mit approximativen Inferenzmethoden verwendet werden.
Schauen wir uns nun genauer an, was die Laplace-Approximation ist. Diese Approximation basiert auf dem Modus (Maximum) der wahren A-posteriori-Verteilung p(f∣X, y). Sie verwendet eine Taylor-Entwicklung zweiter Ordnung des Logarithmus der A-posteriori-Dichte um diesen Modus. Mathematisch approximieren wir den Logarithmus der A-posteriori-Dichte wie folgt:
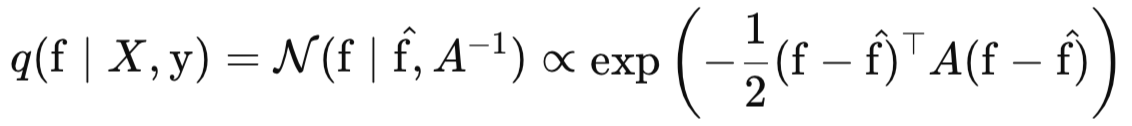
wobei:
- q(f∣X, y) ist eine Gauß-Approximation für die A-posteriori-Verteilung p(f∣X, y),
- f_hat = argmax(f) p(f|X, y) — Modus der A-posteriori-Verteilung,
- A = −∇∇ log p(f|X, y)|f=f_hat - Hesse-Matrix des negativen Logarithmus der A-posteriori-Verteilung am Moduspunkt.
Zunächst müssen wir zur Durchführung der Laplace-Approximation den wahrscheinlichsten Wert der latenten Funktion f finden, das heißt den Modus f_hat. Um die A-posteriori-Verteilung p(f∣X, y) zu erhalten, verwenden wir die Bayes-Regel. Wir wissen bereits, dass diese Regel die A-posteriori-Verteilung mit der Likelihood p(y∣f), der A-priori-Verteilung p(f∣X) und der marginalen Likelihood p(y∣X) wie folgt in Beziehung setzt:
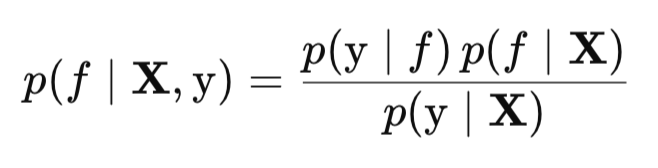
Um p(f∣X, y) in Bezug auf f zu maximieren, müssen wir die Normierungskonstante p(y∣X) nicht kennen, da sie nicht von f abhängt und daher die Position des Maximums nicht beeinflusst. Daher können wir mit einer unnormierten A-posteriori-Verteilung arbeiten, die proportional zum Produkt aus Likelihood und A-priori-Verteilung p(y∣f)p(f∣X) ist.
Um die Berechnungen zu vereinfachen und numerische Probleme mit sehr kleinen Wahrscheinlichkeitswerten zu vermeiden, bilden wir den Logarithmus dieser unnormierten A-posteriori-Verteilung. Aufgrund der Eigenschaft von Logarithmen wird aus dem Produkt von Wahrscheinlichkeiten die Summe ihrer Logarithmen:
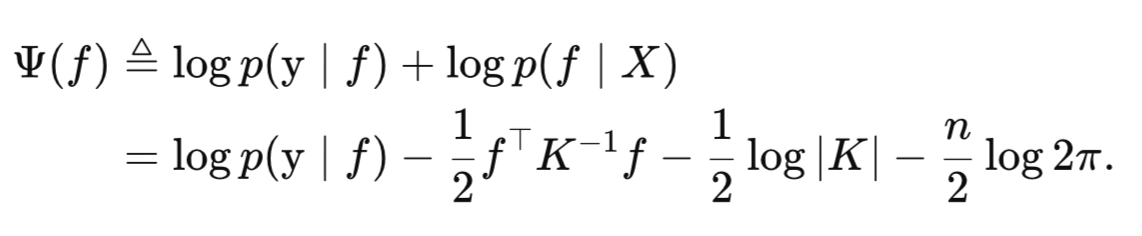
Ψ(f) ist die Zielfunktion, die wir mithilfe des Newton-Verfahrens maximieren werden, um den Modus der latenten Funktion zu finden. Das Newton-Verfahren erfordert die Berechnung der ersten und zweiten Ableitungen von Ψ(f) in Bezug auf f.
Durch Differenzieren dieser Gleichung in Bezug auf f erhalten wir:

wobei:
- W = −∇∇ log p(y|f) – die negative Hesse-Matrix der Log-Likelihood, bei der es sich um eine Diagonalmatrix handelt.
Sobald wir den Gradienten und die Hesse-Matrix berechnet haben, finden wir den Modus iterativ mithilfe des Newton-Verfahrens:
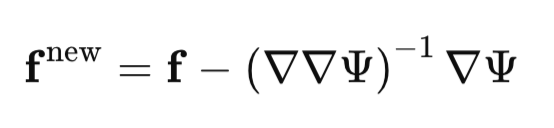
In jeder Iteration aktualisiert das Newton-Verfahren unsere aktuelle Modusschätzung in der durch den Gradienten und die Hesse-Matrix bestimmten Richtung, bis Konvergenz erreicht ist.
Sobald der Modus ermittelt wurde, können wir die Kovarianzmatrix der approximierten Gauß-Verteilung berechnen. Diese Matrix entspricht der negativen inversen Hesse-Matrix von Ψ(f), berechnet am Moduspunkt f_hat.
Somit lautet die Kovarianzmatrix Σ unserer Gauß-Approximation:
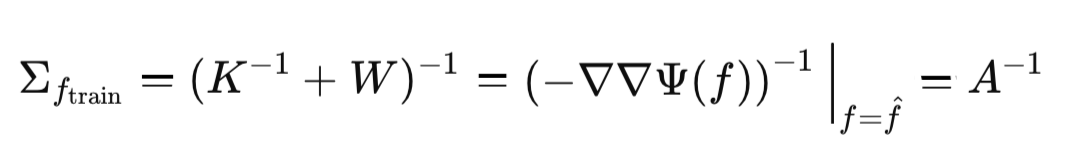
Damit ist die Beschreibung des ersten Schritts der Laplace-Approximation abgeschlossen – das Finden einer Gauß-Verteilungs-Approximation der A-posteriori-Verteilung.
Vorhersage bei der Laplace-Approximation
Sobald wir q(f∣X, y) erhalten haben, können wir mit dem zweiten Schritt der Inferenz fortfahren – der Vorhersage für neue Testpunkte x∗. In diesem Stadium möchten wir die prädiktive Verteilung p(f∗∣X, y, x∗) finden. Aufgrund der Laplace-Approximation, die p(f∣X, y) zu einer Gauß-Verteilung machte (in der Form q(f∣X, y)), und der Tatsache, dass p(f∗∣X, x∗, f) ebenfalls eine Gauß-Verteilung ist, wird die resultierende prädiktive Verteilung p(f∗∣X, y, x∗) ebenfalls zu einer Gauß-Verteilung. Dies ermöglicht es uns, ihren A-posteriori-Mittelwert und ihre Varianz analytisch zu erhalten.
Der Mittelwert der latenten Funktion f* für einen neuen Testpunkt x* (mu_f_star) wird wie folgt berechnet:
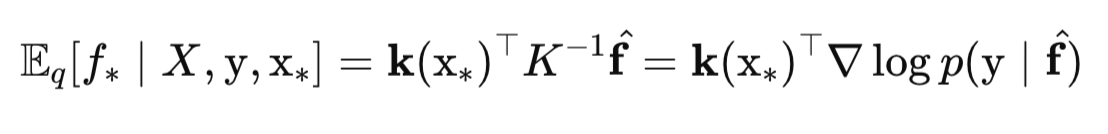
Die Varianz der latenten Funktion Var(f*) für einen neuen Testpunkt x* (Sigma_f_star) wird wie folgt berechnet:
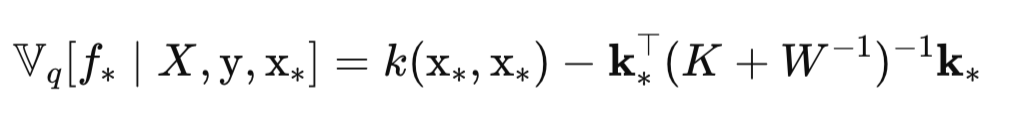
Nachdem wir nun den Mittelwert und die Varianz der prädiktiven Verteilung haben, können wir endlich die gewünschte Wahrscheinlichkeit der Zugehörigkeit zur Klasse π∗ berechnen:
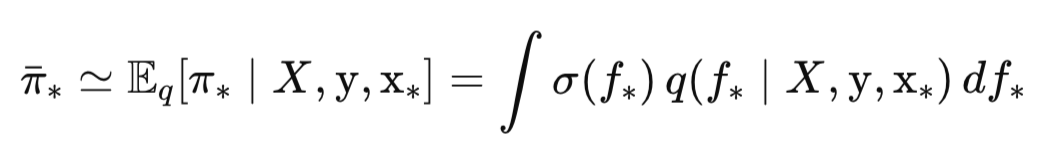
Diese Formel bildet die zentrale Grundlage der Wahrscheinlichkeitsaussage im Laplace-basierten GP-Klassifikator.
Sie haben vielleicht bemerkt, dass wir die Klassenwahrscheinlichkeiten nicht einfach als σ(E[f∗]) berechnen, also indem wir den A-posteriori-Mittelwert von f∗ direkt in die Sigmoid-Funktion einsetzen. Dieser Ansatz, bekannt als MAP-Vorhersage (Maximum A Posteriori Prediction), hat sicherlich seine Daseinsberechtigung.
Indem wir jedoch die MAP-Vorhersage σ(E[f∗]) berechnen, ignorieren wir die Unsicherheit in f*. Wir nehmen einfach die zentrale Schätzung f* (den Mittelwert) und wandeln sie in eine Wahrscheinlichkeit um. Wenn wir E[σ(f*)] berechnen (was einer Integration entspricht), berücksichtigen wir die gesamte Form der Verteilung von f*. Dies liefert uns eine genauere und aussagekräftigere prädiktive Wahrscheinlichkeit, insbesondere wenn eine signifikante Unsicherheit in f* besteht (d. h. eine große Varianz von V[f*]) oder wenn die Verteilung von f* asymmetrisch ist. Dieser Ansatz wird als gemittelte prädiktive Wahrscheinlichkeit bezeichnet.
Das Verständnis dieses Unterschieds hat wichtige praktische Auswirkungen:
- Wenn Ihr einziges Ziel darin besteht, ein binäres Klassenlabel zu erhalten (z. B. „kaufen“ oder „verkaufen“, +1 oder -1), dann kann die Verwendung der einfacheren MAP-Vorhersage ausreichen, da sie dasselbe Label liefert wie die gemittelte prädiktive Wahrscheinlichkeit.
- Wenn Sie sich jedoch für die Wahrscheinlichkeiten selbst interessieren, dann sind die gemittelten prädiktiven Wahrscheinlichkeiten (E[σ(f*)]) dennoch genauer, da sie die Unsicherheit des Modells vollständig berücksichtigen.
Im Handel ist eine einfache binäre Klassenbezeichnung („kaufen“ oder „verkaufen“) nicht ausreichend. Wir benötigen die feine Abstufung der Sicherheit, die Wahrscheinlichkeiten bieten. Der Wahrscheinlichkeitswert ermöglicht es uns, Handelssignale zu filtern. Ein Signal mit einer Erfolgswahrscheinlichkeit von 0,51 (was nur geringfügig besser ist als zufälliges Raten) hat einen weitaus geringeren Wert als ein Signal mit einer Wahrscheinlichkeit von 0,60. Dies ermöglicht es dem Händler, Schwellenwerte für das Eingehen eines Handels festzulegen. Zum Beispiel können wir entscheiden, dass Trades nur eröffnet werden, wenn die Erfolgswahrscheinlichkeit höher als 0,55 oder 0,60 ist, wodurch die Anzahl der falschen Signale reduziert wird.
Marginale Likelihood bei der Laplace-Approximation
Nachdem wir nun den Inferenzmechanismus in GP für die Klassifikation verstehen, stellt sich die Frage: Wie stimmen wir unser Modell für optimale Vorhersagen ab? Die Antwort liegt in der marginalen Likelihood (LML). Dies ist die Zielfunktion, die wir zur Optimierung der Hyperparameter θ unseres Modells verwenden. Ohne ihre Berechnung ist es unmöglich, die besten Parameter zu finden, die unsere Daten erklären:
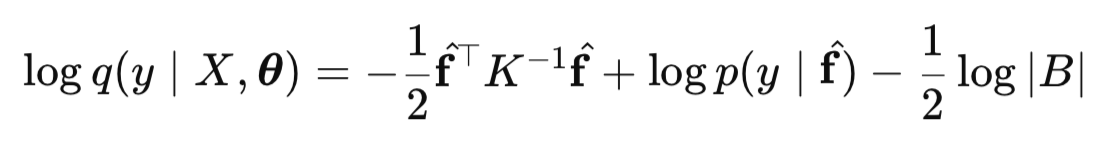
wobei, B
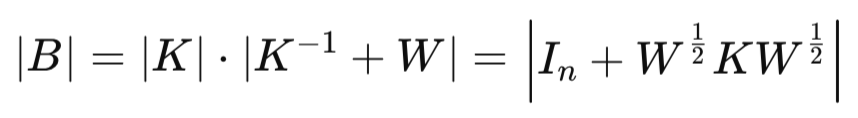
Nachdem die zu optimierende Zielfunktion definiert wurde, ist der nächste wichtige Schritt die Berechnung ihrer partiellen Ableitungen in Bezug auf die Hyperparameter θ. Dies ist notwendig, da wir die Optimierung mithilfe analytischer Gradienten durchführen werden. Dieser Ansatz beschleunigt Berechnungen im Vergleich zu numerischen Methoden um ein Vielfaches. Analytische Gradienten ermöglichen es dem Optimierer, sich effizienter und genauer in Richtung des Minimums der NLML-Zielfunktion zu bewegen.
Der LML-Gradient besteht aus einem expliziten und einem impliziten Teil:
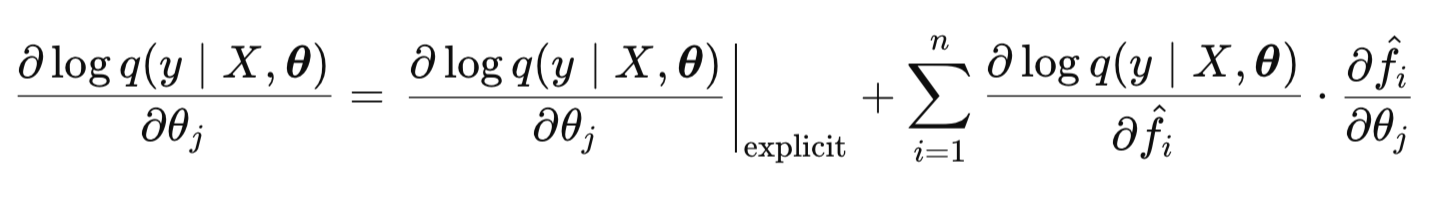
Formel zur Berechnung des expliziten Teils:
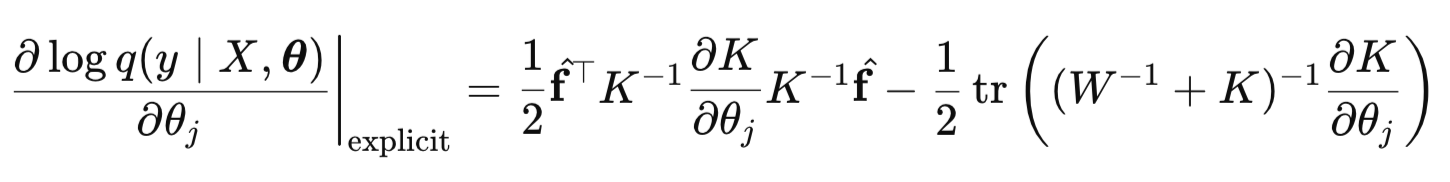
Hier besteht das Hauptproblem darin, die Ableitung der Kernel-Matrix K in Bezug auf jeden Hyperparameter zu berechnen. Wir werden uns im zweiten Teil des Artikels mit der Realisierung der Ableitungen für die ausgewählte Kernel-Funktion befassen.
Der implizite Teil besteht aus zwei Faktoren. Der erste Faktor im impliziten Teil wird mithilfe der folgenden Formel gefunden:

Um diese Formel zu berechnen, müssen wir die dritte Ableitung des Logarithmus der Likelihood berechnen.
Der zweite Multiplikator des impliziten Teils wird wie folgt berechnet:
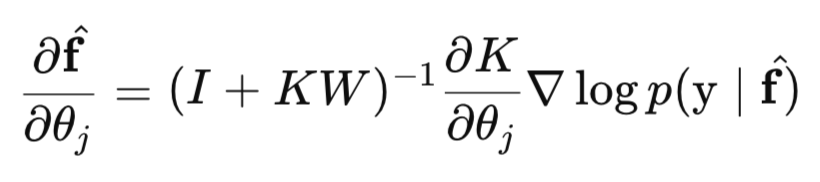
Abschließend halten wir fest, dass die NLML nicht nur zur Schätzung von Hyperparametern benötigt wird, sondern auch zum Vergleich verschiedener Modelle (zum Beispiel mit unterschiedlichen Kernel-Typen). Modelle mit einem niedrigeren NLML-Wert gelten als besser, da dies eine höhere marginale Likelihood bedeutet, was wiederum heißt, dass das Modell die beobachteten Daten besser erklärt.
Darüber hinaus berücksichtigen GPs durch die Verwendung der marginalen Likelihood zur Optimierung von Hyperparametern automatisch den Kompromiss zwischen Datenanpassung und Modellkomplexität. Die NLML bestraft auf natürliche Weise übermäßig komplexe Modelle und verhindert so Overfitting. Dank dessen sind keine expliziten Abbruchkriterien erforderlich, um Overfitting zu verhindern, wie dies beispielsweise beim Training neuronaler Netze der Fall ist. Die NLML-Optimierung selbst strebt danach, das optimale Gleichgewicht zu finden. Dies ist einer der Hauptvorteile des Bayesschen Ansatzes bei Gauß-Prozessen.
Gauß-Prozess-Bibliothek
Nachdem wir nun alle notwendigen theoretischen Konzepte behandelt haben, kommen wir zur praktischen Umsetzung. Unser Hauptziel ist es, eine universelle GP-Bibliothek in MQL5 zu erstellen, die als zuverlässiges Werkzeug für Vorhersageaufgaben dienen wird. Diese Bibliothek wird eine modulare Architektur aufweisen, bei der das GP-Modell in unabhängige, austauschbare Komponenten unterteilt ist, was eine einfache Erweiterung ihrer Fähigkeiten ermöglicht und die Wartung erleichtert. Sie wird unter Berücksichtigung der folgenden funktionalen Hauptmerkmale entwickelt:
- Flexibilität bei der Kernelauswahl: die Möglichkeit, bestehende Kovarianzfunktionen einfach einzubinden sowie deren Kombinationen (SumKernel, ProductKernel) zu erstellen, um komplexere Abhängigkeiten zu modellieren;
- Unterstützung für verschiedene Likelihood-Funktionen;
- Unterstützung für verschiedene Methoden zur Inferenz der A-posteriori-Verteilung für Klassifikations- und Regressionsprobleme;
- Multifunktionalität: Die Bibliothek muss universell einsetzbar sein, was die Lösung sowohl von Regressions- als auch von binären Klassifikationsproblemen ermöglicht;
- Hyperparameteroptimierung: Verwendung analytischer Gradienten zur Verbesserung der Geschwindigkeit und Genauigkeit des Trainingsprozesses. Die Integration mit der Alglib-Bibliothek soll eine effiziente Optimierung der Modell-Hyperparameter gewährleisten.
Schauen wir uns die Struktur der Bibliothek genauer an. Sie besteht aus sechs Hauptkomponenten, von denen jede eine spezifische Funktionalität implementiert:
- Die Klasse GaussianProcess ist das zentrale Element der Bibliothek und verwaltet den gesamten Lebenszyklus eines GP-Modells – von der Initialisierung und Hyperparameteroptimierung bis hin zur Durchführung von Vorhersagen auf neuen Daten.
- Klasse GPOptimizationObjective: Diese Hilfsklasse dient als „Brücke“ zwischen unserer Bibliothek und der Alglib-Optimierungsbibliothek. Sie passt die Zielfunktion und ihren Gradienten an das von Alglib geforderte Format an (durch Vererbung von CNDimensional_Grad).
- Schnittstelle IKernel: Definiert eine Reihe von Methoden für verschiedene Kovarianzfunktionen (Kernel). Sie umfasst Implementierungen wie RBFKernel, LinearKernel, PeriodicKernel sowie deren Kombinationen (SumKernel, ProductKernel).
- Schnittstelle ILikelihood: Definiert eine Reihe von Methoden für Likelihood-Funktionen. Zu den Realisierungen gehören GaussianLikelihood für Regression und LogitLikelihood für binäre Klassifikation.
- Schnittstelle IInference: Stellt Methoden zur Inferenz der A-posteriori-Verteilung der latenten GP-Funktion bereit. Derzeit sind ExactInference und LaplaceInference implementiert.
- Hilfsstrukturen und Dienstprogramme (StructUtils.mqh): Eine Reihe allgemeiner Aufzählungen, Datenstrukturen (für Inferenz- und Vorhersageergebnisse) sowie Funktionen, die für die Arbeit mit Daten, Matrizen und Diagrammen zur Visualisierung der Ergebnisse erforderlich sind.
Dank dieser modularen Struktur und der klar definierten Schnittstellen können wir problemlos neue Kernel, Inferenzmethoden und Likelihood-Funktionen hinzufügen, was eine einfache zukünftige Entwicklung der Bibliothek ermöglicht.
Klasse GaussianProcess
Die Klasse GaussianProcess ist die zentrale Klasse der Bibliothek. Sie kapselt die gesamte Logik, die zum Erstellen, Trainieren und Vorhersagen eines GP-Modells erforderlich ist. Die Klasse GaussianProcess wurde nach dem Kompositionsprinzip entworfen und enthält keine direkte Funktionalität für Kernel, Likelihood oder Inferenz. Stattdessen integriert sie diese Komponenten über drei Hauptschnittstellen:
- kernel (IKernel),
- Likelihood-Funktion (ILikelihood),
- Inferenzmethode (IInference).
Dies ermöglicht es, das GP-Modell flexibel an verschiedene Vorhersageaufgaben anzupassen, ohne die zugrunde liegende Klasse GaussianProcess zu ändern.
//+------------------------------------------------------------------+ //| Gaussian process class | //+------------------------------------------------------------------+ class GaussianProcess { private: IKernel* m_kernel; // pointer to the selected kernel ILikelihood* m_likelihood; // pointer to the selected likelihood function IInference* m_inference; // pointer to the selected inference method matrix m_X_train; // Training input data Nxd vector m_y_train; // Training target data Nx1 GPInferenceResult m_last_inference_result; // Structure storing the latest inference results int m_last_termination_type; // Optimization operation completion code int m_last_iterations_count; // Number of iterations performed by the optimizer double m_last_nlml_value; // Final NLML value after optimization private: // Auxiliary function for numerical integration double CalculateNumericalProbability(double mu_f_star, double sigma_f_star_diag, LogitLikelihood *likelihood); public: // Class constructor GaussianProcess(IKernel* kernel, ILikelihood* likelihood, IInference* inference, const matrix &X_train, const vector &y_train); // Static method for creating a GaussianProcess object with input parameters validation static GaussianProcess* Create(IKernel* kernel, ILikelihood* likelihood, IInference* inference, const matrix &X_train, const vector &y_train); // Destructor ~GaussianProcess(); // --- Methods for getting the model state --- // Return the results of the last inference operation GPInferenceResult GetLastInferenceResult() const; // Return the completion type of the last hyperparameter optimization int GetLastTerminationType() const; // Return the number of iterations performed during the last hyperparameter optimization int GetLastIterationsCount() const; // Return the negative logarithm of the marginal likelihood after optimization double GetLastNLML() const; // Return the pointer to the kernel in use IKernel* GetKernel() const; // Return the current values of all hyperparameters being optimized. vector GetCurrentHyperparameters(); // --- Training and configuration methods --- // Run the full model training process, including hyperparameter optimization bool Fit(); // Perform a single inference step without hyperparameter optimization bool PerformInference(); // Set the training data for the model void SetTrainingData(const matrix& X, const vector& y); // Set the given hyperparameters for the kernel and likelihood function void SetHyperparameters(const vector ¶ms); // Method called by the optimizer to calculate the objective function (NLML) double CalculateNLMLObjective(const vector &hyperparameters); // --- The method performs a prediction for new test data // The predictmode parameter determines the method for calculating probabilities for classification (PROBIT, NUM_INTEGR, MONTE_CARLO) bool Predict(const matrix &X_test, GPPredictionResult &result, PredictMode mode = PROBIT); // --- Auxiliary methods --- // Static method for generating samples from prior GP static bool SamplePriorGP(const matrix &x, IKernel* kernel, int num_samples, matrix &f_samples, bool plot_samples = false, int plot_display_seconds = 10); //--- Method for logging the final values of hyperparameters void PrintOptimizedKernelParameters(); };
Betrachten wir die wichtigsten Methoden der Klasse:
Es gibt zwei Hauptwege, eine Instanz einer Klasse zu erstellen:
- Methode Create: Verwenden Sie diese Methode, um ein GaussianProcess-Objekt sicher zu erstellen. Diese Methode führt die notwendigen Prüfungen der Eingabedaten (X_train, y_train, Schnittstellenzeiger) durch und gibt einen Zeiger auf das Objekt oder bei einem Fehler NULL zurück.
//+------------------------------------------------------------------+
//| Create method                                                    |
//+------------------------------------------------------------------+
GaussianProcess* GaussianProcess::Create(IKernel* kernel, ILikelihood* likelihood, IInference* inference,
const matrix &X_train, const vector &y_train)
{
    // 1. Check for NULL pointers
    if (kernel == NULL || likelihood == NULL || inference == NULL) {
        Print("ERROR: Kernel, Likelihood, or Inference pointer is NULL");
        return NULL;
    }
    // 2. Check the validity of X_train and y_train inputs
    if (X_train.Rows() == 0 || y_train.Size() == 0 || X_train.Rows() != y_train.Size()) {
    Print("ERROR: Invalid training data dimensions");
    return NULL;
    }
    // 3. Check the compatibility of 'likelihood' and 'inference'
    string likelihood_name = likelihood.GetName();
    string inference_name  = inference.GetName();
    if (inference_name == "ExactInference" && likelihood_name != "GaussianLikelihood") {
        Print("ERROR: ExactInference supports only GaussianLikelihood!");
        delete kernel; delete likelihood; delete inference;
        return NULL;
    }
    // 4. If all checks are passed, create the object
    GaussianProcess* gp_model = new GaussianProcess(kernel, likelihood, inference,X_train, y_train);
    if (gp_model == NULL) {
        Print("ERROR: Failed to create GaussianProcess object");
        delete kernel; delete likelihood; delete inference;
        return NULL;
    }
    return gp_model;
}
- Der Konstruktor der Klasse: Bietet eine direkte Möglichkeit der Initialisierung ohne Datenüberprüfungen. Wenn Sie von Ihren Daten überzeugt sind, können Sie ein Objekt mithilfe des Konstruktors erstellen.
//+------------------------------------------------------------------+
//| GaussianProcess class constructor                                |
//+------------------------------------------------------------------+
GaussianProcess::GaussianProcess(IKernel* kernel, ILikelihood* likelihood, IInference* inference,
const matrix &X_train, const vector &y_train) :
    m_kernel(kernel),
    m_likelihood(likelihood),
    m_inference(inference),
    m_X_train(X_train),
    m_y_train(y_train),
    m_last_termination_type(0),
    m_last_iterations_count(0),
    m_last_nlml_value(0.0){ }
- Fit()-Methode: startet den vollständigen Modelltrainingsprozess. Diese Methode optimiert die Kernel-Hyperparameter und die Likelihood-Funktion mithilfe des MinBleic-Optimierers, der die negative log-marginale Likelihood (NLML) minimiert.
//+------------------------------------------------------------------+
//| Method for training the model                                    |
//+------------------------------------------------------------------+
bool GaussianProcess::Fit()
{
    // Create the GPOptimizationObjective object passing it the pointer to the current GaussianProcess object
    // This pointer goes into the private field of the m_gp class, with which we call the method
    // CalculateNLMLObjective to get the NLML value for the current set of hyperparameters
    GPOptimizationObjective objective_func(GetPointer(this));
    CNDimensional_Rep frep;
    CObject Obj;
    vector initial_hyperparams = GetCurrentHyperparameters(); // Get the initial values of the hyperparameters
    double theta[];
    ArrayResize(theta, (int)initial_hyperparams.Size());
    VectorToArray(initial_hyperparams,theta);
    int num_params = (int)initial_hyperparams.Size();
    double s[];
    double bndl[];
    double bndu[];
    ArrayResize(s, num_params);
    ArrayResize(bndl, num_params);
    ArrayResize(bndu, num_params);

    int param_idx = 0;
    IKernel* kernels_to_process[]; // array of pointers to the IKernel interface

    // Logic for obtaining kernels to set boundaries
    // This block of code determines what type of kernel we are dealing with
    // and fills the kernels_to_process array with the corresponding pointers:
    if (dynamic_cast<SumKernel*>(m_kernel) != NULL) {          // Check if the current kernel m_kernel is a SumKernel object
        SumKernel* sum_k = dynamic_cast<SumKernel*>(m_kernel); // If yes, then we cast the m_kernel type to the SumKernel* type
        sum_k.GetKernels(kernels_to_process); // and call the GetKernels() method, which fills the kernels_to_process array with all the kernels included in the sum
    } else if (dynamic_cast<ProductKernel*>(m_kernel) != NULL) { // Similar logic if the kernel is a ProductKernel object
        ProductKernel* prod_k = dynamic_cast<ProductKernel*>(m_kernel);
        prod_k.GetKernels(kernels_to_process);
    } else {
        ArrayResize(kernels_to_process,1); // If the kernel is neither a sum nor a product (i.e. it is not a composite kernel),
        kernels_to_process[0] = m_kernel; // then the kernels_to_process array simply contains a pointer to m_kernel.
    }

   // This loop iterates over each base kernel found in the kernels_to_process array
   // and sets its hyperparameters to an initial scale s, a lower bound bndl, and an upper bound bndl
    for(int i = 0; i < ArraySize(kernels_to_process); i++) {
        IKernel* current_k = kernels_to_process[i];
            string kernel_name = current_k.GetName();
            if (kernel_name == "RBFKernel") {
                if (param_idx + 2 <= num_params) {
                    s[param_idx] = 1.0; bndl[param_idx] = 1e-3; bndu[param_idx] = 1e3; param_idx++;
                    s[param_idx] = 1.0; bndl[param_idx] = 1e-3; bndu[param_idx] = 1e3; param_idx++;
                }
            } else if (kernel_name == "LinearKernel") {
                if (param_idx + 1 <= num_params) {
                    s[param_idx] = 1.0; bndl[param_idx] = 1e-3; bndu[param_idx] = 1e3; param_idx++;
                }
            } else if (kernel_name == "PeriodicKernel") {
                if (param_idx + 3 <= num_params) {
                    s[param_idx] = 1.0; bndl[param_idx] = 1e-3; bndu[param_idx] = 1e3; param_idx++;
                    s[param_idx] = 1.0; bndl[param_idx] = 1e-3; bndu[param_idx] = 1e3; param_idx++;
                    s[param_idx] = 1.0; bndl[param_idx] = 1e-3; bndu[param_idx] = 1e3; param_idx++;
                }
            }
    }

// --- Add bounds and scales for likelihood parameters (if any) ---
// LogitLikelihood has no hyperparameters, so this block will be skipped for it
// GaussianLikelihood has 1 parameter (sigma)
if (m_likelihood.GetNumHyperparameters() > 0) {
    if (param_idx + m_likelihood.GetNumHyperparameters() <= num_params) {
        s[param_idx] = 1.0;           // Scale
        bndl[param_idx] = 1e-10;      // Lower bound
        bndu[param_idx] = 1e3;        // Upper bound
        param_idx++;
    }
}
    CMinBLEICStateShell state;
    CMinBLEICReportShell rep; // object that will contain a report on the optimization results
    //-----------------------  optimizer stopping criteria
    double epsg = 0.0001;     //Gradient precision (0 means gradient stopping is disabled)
    double epsf = 0.0000;     //Precision by function value
    double epsw = 0.0000;     //Accuracy by parameters
    //-------------------------
    double epso = 0.00001;    //Parameters for external convergence conditions in BLEIC
    double epsi = 0.00001;    //Parameters for internal convergence conditions in BLEIC
    CAlglib::MinBLEICCreate(theta, state);       // initialize the optimizer. It creates the initial state for MinBLEIC using the initial hyperparameter values from the theta array.
    CAlglib::MinBLEICSetBC(state, bndl, bndu);   // Set the lower (bndl) and upper (bndu) bounds for each parameter
    CAlglib::MinBLEICSetScale(state, s);         //Sets the scales (s) for each parameter. This can help the optimizer work more efficiently with parameters of different orders of magnitude.
    CAlglib::MinBLEICSetInnerCond(state,epsg,epsf,epsw);
    CAlglib::MinBLEICSetOuterCond(state, epso, epsi);
    CAlglib::MinBLEICOptimize(state, objective_func, frep, 0, Obj); // start the optimization
    CAlglib::MinBLEICResults(state, theta, rep); // optimization report

    m_last_termination_type = rep.GetTerminationType();
    m_last_iterations_count = rep.GetInnerIterationsCount();
    m_last_nlml_value = objective_func.GetNLML(); // Get the final NLML
//------------------------------------------------------------------------------------
//    TerminationType field contains completion code, which can be:
//-8     internal integrity control detected    infinite    or    NAN    values    in
//     function/gradient. Abnormal termination signalled.
//-3     inconsistent constraints. Feasible point is
//     either nonexistent or too hard to find. Try to
//     restart optimizer with better initial approximation
// 1     relative function improvement is no more than EpsF.
// 2     relative step is no more than EpsX.
// 4     gradient norm is no more than EpsG
// 5     MaxIts steps was taken
// 7     stopping conditions are too stringent,
//     further improvement is impossible,
//     X contains best point found so far.
// 8     terminated by user who called minbleicrequesttermination(). X contains
//     point which was "current accepted" when    termination    request    was
//     submitted.
//-------------------------------------------------------------------------------------
// Determine the success of optimization based on TerminationType
    bool success = true;
    if (m_last_termination_type < 0)
    {
        Print("Error: GP optimization failed. Completion type: ", m_last_termination_type);
        success = false;
    }
    // Update the model hyperparameters after optimization
    vector optimized_hyperparams;
    optimized_hyperparams.Assign(theta);
    SetHyperparameters(optimized_hyperparams);
    return success;
}
Innerhalb der Fit()-Methode bereiten wir alles Notwendige vor, damit der Optimierer effektiv arbeiten kann.
Es wird ein spezielles Objekt objective_func (GPOptimizationObjective) erstellt, das die NLML-Zielfunktion und ihren analytischen Gradienten in einem für Alglib verständlichen Format darstellt. Ein Zeiger auf das aktuelle GaussianProcess-Objekt wird an dessen Konstruktor übergeben (dies ist erforderlich, um die Methode CalculateNLMLObjective aufzurufen).
Als Nächstes erhalten wir die aktuellen Werte aller Modell-Hyperparameter im Hyperparameter-Array theta. Diese Werte (die aus dem Kernel und der Likelihood-Funktion stammen) dienen als Ausgangspunkt für die Suche nach dem Optimum. Für jeden Hyperparameter werden Skalierungen (s) sowie untere (bndl) und obere (bndu) Grenzen festgelegt. Grenzen verhindern die Suche nach Lösungen in schlecht gestellten oder sinnlosen Bereichen (z. B. negative Skalenlängen oder Varianzen). Die Skalierung wird vom Optimierer zur Normalisierung der Parameter verwendet, was die Stabilität und Konvergenzgeschwindigkeit verbessert, insbesondere wenn sich die Größenordnungen der Parameter stark unterscheiden. Standard s = 1.0
Als Nächstes deklarieren wir ein Array von kernels_to_process-Zeigern auf das Ikernel-Interface. Es wird verwendet, um eine Liste aller Basiskernel zu speichern, deren Hyperparameter optimiert werden müssen. Wenn wir einen einfachen Kernel haben (keinen zusammengesetzten), dann enthält dieses Array nur ein Element – einen Zeiger auf diesen Kernel. Wenn es sich um einen SumKernel oder ProductKernel handelt, werden Zeiger auf alle Kernel gespeichert, die Teil dieser Zusammensetzung sind.
Anschließend prüfen wir mithilfe des dynamic_cast-Operators, ob der aktuelle Kernel m_kernel (der ein Feld der GaussianProcess-Klasse ist und auf den vom Benutzer ausgewählten Kernel zeigt) eine Instanz von SumKernel oder ProductKernel ist. Wenn dies der Fall ist, erfolgt eine Typumwandlung in SumKernel oder ProductKernel und die Methode GetKernels() wird aufgerufen, die das Array kernels_to_process mit allen Kernel füllt, die in dieser Summen- oder Produktstruktur enthalten sind. Wenn der Kernel weder eine Summe noch ein Produkt ist (d. h., es ist ein regulärer Kernel, wie z. B. ein RBFKernel), dann enthält das Array kernels_to_process einfach einen Zeiger auf m_kernel selbst.
Danach durchlaufen wir jeden Basiskernel in kernels_to_process und setzen dessen Hyperparameter auf die Skalierung s sowie die Grenzen bndl und bndu.
Schließlich werden nach allen Kernel-Hyperparametern die Hyperparameter der Likelihood-Funktion verarbeitet. Die Gauß-Likelihood hat einen Parameter, während die Logit-Likelihood keine Parameter hat. Nachdem alle Parameter vorbereitet wurden, beginnt der Optimierungsprozess.
- Die Methode CalculateNLMLObjective() fungiert als Bindeglied zwischen der Hauptklasse GaussianProcess und dem externen Alglib-Optimierer. Dies ist genau die Zielfunktion, die der MinBleic-Optimierer ständig aufruft (über die Klasse GPOptimizationObjective), um die aktuellen Hyperparameterwerte zu bewerten. Ihre Hauptaufgabe besteht darin, den NLML-Wert für einen gegebenen Satz von Hyperparametern zurückzugeben.
//+-------------------------------------------------------------------+
//| Method that will be called by the optimizer to calculate NLML     |
//+-------------------------------------------------------------------+
double GaussianProcess::CalculateNLMLObjective(const vector &hyperparameters)
{
    //  Set all hyperparameters (kernels and likelihoods)
    SetHyperparameters(hyperparameters);
    //  Call the inference function, which will calculate NLML
    m_inference.Infer(m_X_train, m_y_train, m_kernel, m_likelihood,m_last_inference_result);
    if (!m_last_inference_result.success) {
        Print("Inference Error !");
        return DBL_MAX;
    }
    return m_last_inference_result.nlml_value;
}
Bei jeder Iteration schlägt der MinBleic-Optimierer einen neuen Satz von Hyperparametern vor. Das Erste, was CalculateNLMLObjective() tut, ist, diesen Hyperparametersatz zu übernehmen und die Methode SetHyperparameters() zu verwenden, um die entsprechenden Parameter innerhalb der Kernel- (m_kernel) und Likelihood-Funktionsobjekte (m_likelihood) zu aktualisieren. Dies ist sehr wichtig, da alle nachfolgenden NLML-Berechnungen auf diesen aktuellen Hyperparameterwerten basieren sollten.
Nachdem die Hyperparameter aktualisiert wurden, ruft die Methode Infer() auf dem Inferenzobjekt (m_inference) auf. Dies ist der Hauptschritt, bei dem alle komplexen mathematischen Berechnungen zur Schätzung der A-posteriori-Verteilung stattfinden.
Die Inferenzergebnisse, einschließlich des NLML-Werts und seiner Gradienten (die von der Grad-Funktion verwendet werden), werden im privaten Klassenfeld m_last_inference_result gespeichert.
Wenn die Inferenz erfolgreich ist, gibt die Methode NLML zurück.
- Die Methode GaussianProcess::SetHyperparameters(const vector ¶ms) ist für die Verteilung und Einstellung der optimierten Werte der Kernel-Hyperparameter und der Likelihood-Funktion verantwortlich.
//+------------------------------------------------------------------+ //| Method for setting hyperparameters | //+------------------------------------------------------------------+ void GaussianProcess::SetHyperparameters(const vector ¶ms) { //+------------------------------------------------------------------+ //This is a call of the polymorphic SetHyperparameters method on the object pointed to by m_kernel. //Since m_kernel is a pointer to a base type (IKernel*), calling SetHyperparameters //will be redirected to a concrete implementation of this method in the derived kernel class //m_kernel refers to. For example, if m_kernel actually points to an object //RBFKernel, RBFKernel::SetHyperparameters(params) is called. If this is SumKernel, //the SumKernel::SetHyperparameters(params) method is called, and so on. //+------------------------------------------------------------------+ int kernel_params_count = m_kernel.GetNumHyperparameters(); int likelihood_params_count = m_likelihood.GetNumHyperparameters(); // Set kernel parameters vector kernel_hps(kernel_params_count); for(int i = 0; i < kernel_params_count; i++) { kernel_hps[i] = params[i]; } m_kernel.SetHyperparameters(kernel_hps); // Set the likelihood parameters vector likelihood_hps(likelihood_params_count); for(int i = 0; i < likelihood_params_count; i++) { likelihood_hps[i] = params[kernel_params_count + i]; } m_likelihood.SetHyperparameters(likelihood_hps); }
Der Vektor params enthält alle Hyperparameter des GP-Modells in einer festen Reihenfolge: Zuerst kommen alle Hyperparameter des Kernels (oder der Kernel, falls es sich um einen zusammengesetzten Kernel handelt) und dann die Parameter der Likelihood-Funktion. Das Hauptmerkmal dieser Methode ist die Verwendung von Polymorphie. Derselbe Aufruf von m_kernel.SetHyperparameters() verhält sich je nach tatsächlichem Typ des Objekts, auf das m_kernel zur Laufzeit zeigt, unterschiedlich.
- Predict()-Methode. Dies ist im Wesentlichen das, wofür ein Modell gebaut wird: um Vorhersagen auf Basis neuer Daten zu treffen.
//+------------------------------------------------------------------+
//| Prediction method for regression and classification              |
//+------------------------------------------------------------------+
bool GaussianProcess::Predict(const matrix &X_test, GPPredictionResult &result,PredictMode predict_mode)
{
    // 1. Check that the model has been trained
    if (!m_last_inference_result.success) {
        Print("Error: Predict - Inference results not available");
        return false;
    }
    // 1.1 Check the match of the number of features
    if (X_test.Cols() != m_X_train.Cols()) {
        Print("Error: Predict - Number of features in X_test  must match X_train ");
        return false;
    }

    int N_train = (int)m_X_train.Rows();
    int N_test = (int)X_test.Rows();

    // 2. K_s and K_ss are calculated regardless of the type of inference/likelihood
    matrix K_s = m_kernel.Compute(m_X_train, X_test);
    matrix K_ss = m_kernel.Compute(X_test, X_test);

    // --- 3. Logic for calculating mu_f_star and Sigma_f_star (common for both types of problems) ---
    //------------------------- Algorithm 2.1 GPML----------------------------------------
    if (m_inference.GetName() == "ExactInference") {
        // For ExactInference
        matrix L_K_noisy = m_last_inference_result.L_K_noisy;
        vector alpha = m_last_inference_result.alpha;

        result.mu_f_star = K_s.Transpose() @ alpha;

        matrix V(N_train, N_test);
        if (!L_K_noisy.LinearEquationsSolution(K_s, V)) {
            Print("Error: Predict (Exact) - LinearEquationsSolution failed");
            return false;
        }
        result.Sigma_f_star = K_ss - V.Transpose() @ V;

    } else if (m_inference.GetName() == "LaplaceInference") {
    //------------------------- Algorithm 3.2 GPML ----------------------------------------
        matrix W = -1 * m_last_inference_result.H;
        matrix L_B = m_last_inference_result.L_B;
        matrix sW = m_last_inference_result.sW;
        vector f_hat = m_last_inference_result.mu_f_train;
        vector grad_f_hat = m_likelihood.LogLikelihoodGradient(f_hat, m_y_train);
        // Eq[f*∣X,y,x*]=k(x*)^T K^−1 f_hat = k(x*)^T ∇log p(y∣f_hat)
        result.mu_f_star = K_s.Transpose() @ grad_f_hat;

        matrix SwKs = sW @ K_s;
        matrix V(N_train, N_test);
        if (!L_B.LinearEquationsSolution(SwKs, V)) {
            Print("Error: Predict (Laplace) - LinearEquationsSolution failed");
            return false;
        }
        // Vq[f*|X, y,x*] = Kss - Ks^T(K + W^-1)^-1 Ks
        result.Sigma_f_star = K_ss - V.Transpose() @ V;
    }

    // --- 4. Likelihood-specific logic (Likelihood) ---
if (m_likelihood.GetName() == "GaussianLikelihood") {
    // --- 4.1. Regression (GaussianLikelihood) ---
    double noise_variance = 0.0;
    vector likelihood_params = m_likelihood.GetHyperparameters();
    if (likelihood_params.Size() > 0) {
        noise_variance = likelihood_params[0] * likelihood_params[0];
    }
    result.Sigma_y_star = result.Sigma_f_star + matrix::Identity(N_test, N_test) * noise_variance;
    result.mu_y_star = result.mu_f_star; // For Gaussian likelihood mu_y_star = mu_f_star

    } else if (m_likelihood.GetName() == "LogitLikelihood") {
        // --- 4.2. Classification (LogitLikelihood) ---
          // Make sure m_likelihood is a LogitLikelihood to access the sigmoid method
        LogitLikelihood *logit = dynamic_cast<LogitLikelihood*>(m_likelihood);
        if (logit == NULL) {
            Print("Error: Failed to cast m_likelihood to LogitLikelihood in Predict");
            return false;
        }

        result.predicted_probabilities.Resize(N_test);
        result.predicted_labels.Resize(N_test);
        double mc_samples_array[];

        for (int i = 0; i < N_test; i++) {
            double mu_f_star_i = result.mu_f_star[i];  //mean of the posterior distribution q(f*|X,y,x*)
            double sigma_f_star_diag_i = result.Sigma_f_star[i, i]; // variance of the posterior distribution q(f*|X,y,x*)
    //------------------- 1)Probit Approximation----------------------
            if (predict_mode == PROBIT) {
                double k_i = 1.0 / MathSqrt(1.0 + M_PI / 8.0 * sigma_f_star_diag_i);
                result.predicted_probabilities[i] = logit.sigmoid(mu_f_star_i * k_i);}
    // ----------------- 2) Numerical integration ---------------------------------------
            else if (predict_mode == NUM_INTEGR) {
                result.predicted_probabilities[i] = CalculateNumericalProbability(
                    mu_f_star_i,
                    sigma_f_star_diag_i,
                    logit
                );}
   // ----------------------3) Monte Carlo Method ---------------------------------------
            else if (predict_mode == MONTE_CARLO) {
                // Number of samples for Monte Carlo
                int num_samples = 10000;
                ArrayResize(mc_samples_array, num_samples);
                double std_dev_f_star_i = MathSqrt(sigma_f_star_diag_i);
                // Generate num_samples values from N(mu_f_star_i, std_dev_f_star_i)
                MathRandomNormal(mu_f_star_i, std_dev_f_star_i, num_samples, mc_samples_array);
                double sum_sigmoid_samples = 0.0;
                for (int s = 0; s < num_samples; s++) {
                    sum_sigmoid_samples += logit.sigmoid(mc_samples_array[s]);
                }
            //To get the expected probability p(y*=+1|X,y,x*)
            //we calculate the arithmetic mean of all obtained values σ(f_sample*).
            //By the law of large numbers, when num_samples is large enough,
            //this average will be a good approximation of the true value of the integral
                result.predicted_probabilities[i] = sum_sigmoid_samples / num_samples;
            }
            // Predicted labels (+1 or -1)
            result.predicted_labels[i] = (result.predicted_probabilities[i] >= 0.5) ? 1.0 : -1.0;
        }
    }
    return true;
    }
Die Vorhersageergebnisse (Mittelwert, Varianz, Wahrscheinlichkeiten, Klassenbezeichnungen) werden in der Struktur GPPredictionResult festgelegt.
Zunächst berechnen wir die Matrizen K* und K**. Diese Matrizen bilden die Grundlage für Vorhersagen in GP. Sie werden benötigt, um den Mittelwert und die Varianz der latenten Funktion f* an neuen Testpunkten zu berechnen. Die Logik hängt hier davon ab, welche Inferenzmethode (ExactInference oder LaplaceInference) während des Trainings verwendet wurde, da diese unterschiedliche Komponenten für die Vorhersageformeln bereitstellen (Algorithmus 2.1 für Exact, Algorithmus 3.2 für Laplace aus dem Buch GPML von Rasmussen und Williams).
Wenn ExactInference verwendet wurde, werden die vorab berechneten L_K_noisy und alpha verwendet. Wenn LaplaceInference verwendet wurde, werden W, L_B, sW und f_hat (Modus) extrahiert. In beiden Fällen ist das Ergebnis der Mittelwert (mu_f_star) und die Kovarianzmatrix (Sigma_f_star) der latenten Funktion für jeden Testpunkt.
Wie wir bereits im theoretischen Teil des Artikels besprochen haben, gibt es ein Problem bei der Berechnung des Integrals zur Ermittlung der Klassenwahrscheinlichkeit. Daher werden Approximationen verwendet:
- predict_mode == PROBIT (Probit-Approximation):
Dies ist eine häufig verwendete schnelle Approximation. Sie ersetzt die Sigmoidfunktion durch die kumulative Verteilungsfunktion der Gauß-Verteilung, die eine ähnliche Form aufweist. Dies ermöglicht es uns, das Integral analytisch zu berechnen.
- predict_mode == NUM_INTEGR (Numerische Integration):
In diesem Modus wird die Hilfsfunktion CalculateNumericalProbability aufgerufen. Sie approximiert das Integral numerisch, indem sie den Bereich von f* in diskrete Intervalle unterteilt und die Werte summiert. Dies kann genauer, aber langsamer sein.
- predict_mode == MONTE_CARLO (Monte-Carlo-Methode):
Dies ist eine stochastische Methode. Eine große Anzahl von Zufallsstichproben f* wird aus der A-posteriori-Verteilung q(f*∣X, y, x*) generiert. Für jede Stichprobe f* wird sigma(f*) berechnet.
Das arithmetische Mittel all dieser Werte sigma(f*) ist eine Annäherung an die gewünschte Wahrscheinlichkeit p(y*=+1|X, y, x*). Dies ist die rechenintensivste Methode. Um Stichproben aus einer Gauß-Verteilung zu generieren, wird die Standardbibliotheksfunktion MathRandomNormal verwendet.
Basierend auf den berechneten Wahrscheinlichkeiten wird für jede der oben genannten Approximationsmethoden eine Entscheidung über das vorhergesagte Klassenlabel getroffen. Wenn die Wahrscheinlichkeit der Zugehörigkeit zur Klasse +1 größer oder gleich 0,5 ist, dann wird +1 vorhergesagt, andernfalls -1.
Klasse GPOptimizationObjective
//+------------------------------------------------------------------+
//| Class for the Alglib optimizer objective function                |
//+------------------------------------------------------------------+
class GPOptimizationObjective : public CNDimensional_Grad
{
private:
    GaussianProcess* m_gp; // pointer to GaussianProcess object
    double nlml;           // Negative log-likelihood
public:
    // Constructor
    GPOptimizationObjective(GaussianProcess* gp_instance) : m_gp(gp_instance), nlml(0.0) {}
    double GetNLML() { return nlml; }
    ~GPOptimizationObjective() {}

    // Grad method that will be called by the optimizer
    virtual void Grad(CRowDouble &w, double &func,CRowDouble &grad, CObject &obj) override {
        // Convert CRowDouble to a vector for passing to GP
        vector hyperparameters(w.Size());
        for(int i = 0; i < (int)w.Size(); i++) {
           hyperparameters[i] = w[i];
        }

        // Call the GP method to calculate NLML
        func = m_gp.CalculateNLMLObjective(hyperparameters);
        nlml = func;

         GPInferenceResult current_result = m_gp.GetLastInferenceResult();
        if (!current_result.success ) {
            Print("Warning: GPOptimizationObjective::Grad - Gradient calculation failed");
            for(int i = 0; i < (int)w.Size(); i++) {
                grad.Set(i, DBL_MAX);
            }
            return;
        }
        // Fill grad with elements from current_result.nlml_gradient
        for(int i = 0; i < (int)w.Size(); i++) {
        grad.Set(i, current_result.nlml_gradient[i]);
        }
    }
};
Diese Klasse ist das Bindeglied zwischen unserer Klasse GaussianProcess und der externen Alglib-Optimierungsbibliothek (speziell dem MinBLEIC-Optimierer).
Alglib erfordert, dass die Zielfunktion, die es optimiert, einer bestimmten Schnittstelle entspricht. Genau dafür ist GPOptimizationObjective gedacht. Sie erbt von CNDimensional_Grad, der Alglib-Basisklasse, die diese Schnittstelle definiert. Diese Basisklasse stellt virtuelle Methoden bereit, die die Klasse GPOptimizationObjective implementieren sollte. Diese Methoden ermöglichen es Alglib-Optimierern, mit jeder Zielfunktion zu arbeiten, vorausgesetzt, sie liefert sowohl den Funktionswert als auch dessen Gradienten.
Das private Mitglied GaussianProcess* m_gp enthält einen Zeiger auf unser GaussianProcess-Objekt. Dies ermöglicht es der Klasse GPOptimizationObjective, die Methode CalculateNLMLObjective aufzurufen, um die notwendigen Berechnungen durchzuführen.
Die Methode Grad() ist der wichtigste Teil dieser Klasse. Sie überschreibt die virtuelle Methode von CNDimensional_Grad und wird bei jeder Iteration vom Alglib-Optimierer aufgerufen. Die Funktion Grad() empfängt den aktuellen Hyperparametervektor w von Alglib und sollte den Wert der Zielfunktion func sowie den Vektor grad ihrer Gradienten zurückgeben.
Schlussfolgerung
Fassen wir die Zwischenergebnisse zusammen.
Im ersten Teil des Artikels haben wir ein solides theoretisches Fundament für das Verständnis des GP-Klassifikationsmodells gelegt. Wir haben die Funktionsprinzipien von GP für die binäre Klassifikation und die Laplace-Approximationsmethode im Detail untersucht. Diese Methode ist von entscheidender Bedeutung, da sie das Klassifikationsproblem für die Anforderungen des Online-Handels praktisch handhabbar und rechnerisch effizient macht, im Gegensatz zur genauen, aber extrem aufwendigen MCMC-Methode.
Nachdem wir die theoretischen Konstrukte behandelt hatten, sind wir zur praktischen Umsetzung übergegangen und haben zwei Schlüsselklassen unserer GP-Bibliothek entworfen und beschrieben:
- GaussianProcess: die Hauptklasse, die die gesamte Logik für den Aufbau, das Training und die Vorhersage eines GP-Modells kapselt,
- GPOptimizationObjective: fungiert als Vermittler, der die Zielfunktion und deren Gradienten in dem von der Alglib-Bibliothek für die Hyperparameter-Optimierung geforderten Format aufbereitet.
Im zweiten Teil werden wir die Realisierung der Bibliothek abschließen, indem wir Folgendes bereitstellen:
- detaillierte Beschreibung und Implementierungscode der wichtigsten Schnittstellen: IKernel (für verschiedene Kernel), IInference (für Inferenzmethoden) und ILikelihood (für Likelihood-Funktionen);
- Beispiele für die Funktionsweise der Bibliothek anhand synthetischer Daten, um ihre Fähigkeiten klar zu demonstrieren;
- praktische Anwendung im Handel: Wir werden Indikatoren für Klassifikation und Regression auf Basis unserer Bibliothek entwickeln und zeigen, wie GPs für Handelsentscheidungen genutzt werden können.
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/18875
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.
 Neuronale Netze im Trading: Effektive Merkmalsextraktion zur präzisen Klassifizierung (letzter Teil)
 Implementierung eines Breakeven-Mechanismus in MQL5 (Teil 2): ATR- und RRR-basierter Breakeven
 Von der Grundstufe bis zur Mittelstufe: Direkter Dateizugriff (I)
 Marktsimulation: Positionsansicht (V)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.
Ich habe mich noch nicht im Detail damit befasst, aber anscheinend habe ich schon etwas übersehen.
В отличие от таких методов, как ... деревья решений, которые выдают только метку класса, ГП позволяют получить вероятностное предсказание.
Meiner Meinung nach geben Bäume die Klassenwahrscheinlichkeit hervorragend wieder.
Für eine Klassifizierung, bei der die Zielwerte diskrete Klassenbezeichnungen sind, eignet sich die Gaußsche Wahrscheinlichkeit nicht.
Anscheinend wandeln „baumartige“ Klassifikationsalgorithmen die Wahrscheinlichkeiten in kontinuierliche „Logodds“-Werte um, und dann läuft die Klassifikation faktisch auf eine Regressionsaufgabe über diese kontinuierlichen Logodds-Werte hinaus. Warum lässt sich dies nicht auf die Gaußsche Wahrscheinlichkeit anwenden, was auch immer das sein mag? Leider habe ich diesen Begriff nirgendwo außer im Python-Handbuch gefunden, aber ich kenne die Gauß-Verteilung, die Gauß-Mischung, die Maximum-Likelihood-Methode und die Expectation-Maximization-Methode ;-).
Ich habe mich noch nicht eingehend damit befasst, aber anscheinend habe ich schon etwas übersehen.
Meiner Meinung nach geben die Bäume die Wahrscheinlichkeit einer Klasse hervorragend wieder.
Anscheinend wandeln „baumartige“ Klassifikationsalgorithmen die Wahrscheinlichkeiten in kontinuierliche „Logodds“-Werte um, und dann läuft die Klassifikation faktisch auf eine Regressionsaufgabe über diese kontinuierlichen Logodds-Werte hinaus. Warum lässt sich das nicht auf die Gaußsche Wahrscheinlichkeit anwenden, was auch immer das sein mag? Leider habe ich diesen Begriff nirgendwo außer im Python-Handbuch gefunden, aber ich kenne die Gauß-Verteilung, Gauß-Mischverteilungen, die Maximum-Likelihood-Methode und die Erwartungsmaximierung ;-).
Guten Tag!
Tatsächlich habe ich mir scikit-learn angesehen: Die Entscheidungsbäume geben die Klassenwahrscheinlichkeit aus. Aus irgendeinem Grund dachte ich, dass nur Ensemble-Methoden Wahrscheinlichkeiten ausgeben. Nun ja, man lernt nie aus, wie man so schön sagt.
Nun zur Gaußschen Wahrscheinlichkeit und warum sie für die Klassifizierungsaufgabe nicht geeignet ist.
Die Gaußsche Wahrscheinlichkeit ist die Wahrscheinlichkeitsdichte der Normalverteilung unter der Bedingung des mathematischen Erwartungswerts und der Varianz. Die Rolle des mathematischen Erwartungswerts spielt bei uns in der Gaußschen Wahrscheinlichkeit die verborgene Funktion f, und die Varianz ist faktisch das tatsächliche Datenrauschen.
Worin besteht der Unterschied zwischen der Wahrscheinlichkeit und einer gewöhnlichen Wahrscheinlichkeitsdichte? Bei einer gewöhnlichen Wahrscheinlichkeitsdichte setzen wir bestimmte Werte y bei festen Parameterwerten ein und erhalten die Wahrscheinlichkeit für dieses y.
Bei der Wahrscheinlichkeit ist es umgekehrt. Unser y ist fest, während sich die Verteilungsparameter ändern. Das heißt, die Wahrscheinlichkeit ist eine Funktion der Parameter. Die Wahrscheinlichkeit sagt uns beispielsweise, dass bei den Parametern 0,2 und 1 die Wahrscheinlichkeit unserer beobachteten Verlaufskurve y = 0,06 beträgt. Und bei den Parametern 0,8 und 1,2 beträgt die Wahrscheinlichkeit, y = 0,12 zu beobachten. Das heißt, wir sehen, dass der zweite Parametersatz die empirischen Daten, mit denen wir es zu tun haben, plausibler beschreibt. Daher auch der Name „Plausibilität“.
Warum können wir nun nicht einfach „logodds“ nehmen und auf die Gaußsche Wahrscheinlichkeit anwenden? Die Gaußsche Wahrscheinlichkeit setzt voraus, dass die beobachteten Daten y einer Normalverteilung folgen. Das heißt, dass y kontinuierliche Werte sind.
Im GP-Modell zur Klassifizierung lässt sich die verborgene Funktion f(x) als „logodds“ interpretieren. Diese Funktion sagen wir jedoch voraus, anstatt sie zu beobachten. Wir beobachten hingegen diskrete Labels y. Die Gaußsche Wahrscheinlichkeit wird jedoch genau auf die beobachteten Daten angewendet. Unsere beobachteten Daten sind diskret. Daher folgen sie im binären Fall der Bernoulli-Verteilung.
Für die Klassifizierungsaufgabe muss die Wahrscheinlichkeit die Wahrscheinlichkeit der diskreten Labels beschreiben, weshalb es hier naheliegend ist, gerade die Logit-Wahrscheinlichkeit zu wählen.