从基础到中级:文件随机访问(一)
 49
 0

引言
在上一篇文章“从基础到中级:FileSave 与 FileLoad”中,我们介绍了 FileLoad 和 FileSave 库函数。尽管许多开发人员认为它们有些局限性,因为某些操作可能较为繁琐,但在生成日志文件方面,它们却非常有用。对于那些不熟悉它们的人来说,日志文件有助于我们了解代码在特定场景下的行为,对任何开发人员来说都是极其有用的工具。
即便如此,FileSave 和 FileLoad 函数主要针对的是按顺序访问文件数据的实现。这是这些函数运作方式的结果。开发人员经常需要对文件进行随机访问,尽管 FileLoad 和 FileSave 只能通过将整个文件加载到内存中并再次保存来间接实现这一功能。
因此,尽管可以模拟随机访问,但实际上它并不是以通常的方式执行的。在这种情况下,目标是以小块的形式仅加载文件中的必要部分。尽管如今内存价格低廉,配备足以容纳大型文件的内存并不困难,这似乎显得没有必要,但在许多其他场景中,当目标是以特定片段处理或访问文件时,这可能非常有用。
文件随机访问(第一部分)
如果你研究各种编程语言的文档,并查看它们的内置过程和函数,同时特别关注文件处理部分,你会发现它们通常提供的功能远超你在实际中可能需要的。有些语言,例如 C++,只有极少数的函数和过程用于处理文件。
然而,C++ 提供了可扩展的输入/输出(I/O)设施,这些设施也可以适应其他任务,从而基于 I/O 流操作符实现更具表现力的语法。我们将在以后的文章中讨论 MQL5 中的类似功能。现在,我们还是先从基础知识入手,因为过早地把事情复杂化是没有意义的。
如果您查阅 MQL5 文档,您会发现它包含许多不同的函数和过程,这些函数和过程既可以用于读取文件数据,也可以用于写入文件数据。最简单的函数是 FileLoad 和 FileSave,我们在上一篇文章中已经介绍和解释了这些函数。然而,正如本文引言中所述,这些函数并不适用于对文件内容的随机访问。因此,MQL5 文档还提供了其他几个专门用于随机访问文件内容的函数。
这就部分解释了为什么文档中描述了这么多不同的函数。然而,它并未解释如何使用这些函数,也没有解释我们如何处理用户定义的类型。是的,亲爱的读者,作为一名程序员,您并不局限于使用编程语言所定义的类型。优秀的编程语言,例如 MQL5,允许我们创建针对特定情况的自定义类型。您可能不完全理解我的意思,因为这看起来可能相当不寻常。
然而,在本系列文章中,当我们讨论 template 和 typename 时,我们正是这样做的:为特定问题创建量身定制的自定义类型。我们还可以使用联合体和结构体来为特定数据构建抽象层。
因此,我们将有意施加一些限制,以简化后续的讨论。由于我们的目标是尽可能清晰地演示某些操作,因此无需解释 MQL5 文档中描述的每个文件处理函数,我们可以专注于一种建模方法。
这里介绍的方法绝不应被视为唯一的解决方法。根据具体情况,使用 MQL5 标准库中的函数或过程无疑是解决某些类型任务的最好方式。这是因为,在这种情况下,过程会变得更加直接,而不是采用旨在实现另一种解决方案的间接变通方法。
尽管如此,我们将仅使用可用函数中的一小部分。然而,这并不妨碍您尝试其他函数或过程,以便更深入地了解MQL5标准库中的特定操作。因此,亲爱的读者,请尝试思考本文未展示的其他可能性。同样的结果往往可以通过多种方式实现,而某些方法对于一位程序员来说可能比对于另一位程序员更容易理解。那么,让我们从下面的代码开始:
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     int handle;
07.
08.     if ((handle = FileOpen("Hello.txt", FILE_WRITE)) == INVALID_HANDLE)
09.     {
10.         Print("Error...");
11.         return;
12.     };
13.     FileWrite(handle, "This file was created by a script written in MQL5.");
14.     FileWrite(handle, "New information is being added to the file.");
15.     FileWrite(handle, "Version FileWrite...");
16.     FileWrite(handle, "Checking writing values [", 1, "]-[", M_PI, "]");
17.
18.     FileClose(handle);
19.
20.     Print("Success");
21. }
22. //+------------------------------------------------------------------+
代码 01
当我们运行代码 01 时,我们会看到文件在相应的运行时沙箱文件夹中被创建。亲爱的读者,我相信你能够毫不费力地理解涉及的文件以及它将被创建的位置。然而,关于文件内容的一个细节尤为重要。这就是事情变得有趣的地方。
请注意以下内容:在代码 01 中,我们在第 08 行指定以写模式打开文件。如果操作成功,变量将接收一个有效的句柄,可用于处理文件。到目前为止,一切都很简单。事实上,这非常简单,为了表示文件操作已完成,我们使用第 18 行,该行关闭文件并释放句柄以供其他用途。然而,我们真正感兴趣的是第 13 行到第 16 行之间的代码。这些代码行将数据写入文件。
在探讨如何进行读取之前,我们先来研究一下写入操作,因为它的重要性远超初看上去的样子。
我们可以清楚地看到想要写入文件的内容,因为所有内容都非常简单且易于理解。即便如此,问题还是出现了:文件中实际存储的是什么?为了回答这个问题,我们可以查看下面的文件内容:
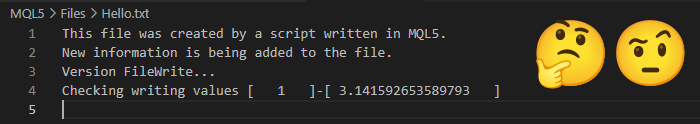
图 01
图 01 显示了将数据写入文件的结果。“等等,这内容看起来有点奇怪。”接下来,让我们看一下图 01 中所示的同一个文件,但采用二进制格式。您可以在下面看到:
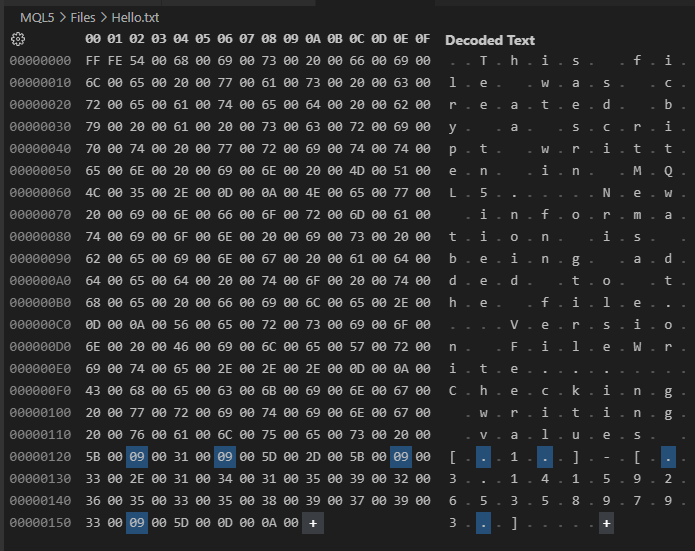
图 02
现在请注意,亲爱的读者:图 02 的内容与图 01 的内容完全相同。但是,在图 02 中,我们可以看到代码 01 写入的文件的每一个字节。图 02 揭示了一个重要细节,该细节将决定我们在使用随机访问读取文件时,获取的是正确值还是完全错误的值。
尽管我们在文件开头没有指定任何内容,如图 01 和代码 01 所示,但在图 02 所示的文件开头,我们看到了两个没有多大意义的奇怪字节。这些字节表示文件格式,与当前的讨论无关。同时,代码 01 清楚地表明,它们在任何地方都没有被明确指定。然而,这里还有其他字符也没有出现在代码 01 中。这些字符是回车符和换行符。
在图 02 中,一些字节被突出显示。为什么呢?它们作为制表符插入,用于分隔代码 01 第 16 行写入的各个值。理解这些制表符的含义至关重要。根据所写内容的类型,尤其是创建文件的目的,这些额外的字符可能会使以后无法正确读取文件。你可能不会预料到这些字符的存在,它们可能会破坏读取过程中使用的索引方案。
“好吧,我明白代码中的内容在写入文件时并不总是以完全相同的方式表示。但总是这样吗?”亲爱的读者,这取决于具体情况。请注意,如果我们将代码 01 更改为如下所示的代码,结果可能会完全不同:
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     int handle;
07.
08.     if ((handle = FileOpen("Hello.txt", FILE_WRITE | FILE_ANSI)) == INVALID_HANDLE)
09.     {
10.         Print("Error...");
11.         return;
12.     };
13.     FileWrite(handle, "This file was created by a script written in MQL5.");
14.     FileWrite(handle, "New information is being added to the file.");
15.     FileWrite(handle, "Version FileWrite...");
16.     FileWrite(handle, "Checking writing values [", 1, "]-[", M_PI, "]");
17.
18.     FileClose(handle);
19.
20.     Print("Success");
21. }
22. //+------------------------------------------------------------------+
代码 02
请注意:代码 01 和代码 02 之间的唯一区别就在于传递给 FileOpen 的附加标志。仅仅因为这一简单的改变,看看代码 02 创建文件时会发生什么。您可以通过比较下图 03 和图 02 来看出这一点:
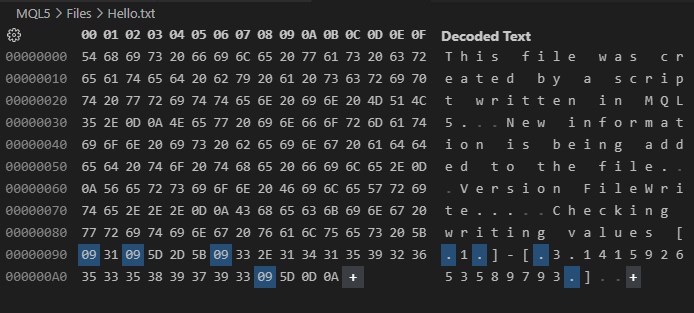
图 03
“哇!我原以为代码中的小改动不会对结果产生太大影响。”亲爱的读者,有些事情只有通过实践中的实验和观察才能真正理解。你刚才观察到的行为就是一个这样的例子。这就是为什么我建议对材料进行实验,并以稍微不同的方式应用它,但最重要的是,要检查当代码的某些元素发生变化时会发生什么。
继续这个话题,请注意,图 03 中显示的结果与我们查看代码 02 时预期的内容更为接近。即便如此,我们仍然能看到制表符、回车符和换行符的存在。为什么会这样?原因是文件不是以二进制模式写入的。
总之,我们会对代码做一些小的改动。这将使我们能够从文件中的特定位置读取内容,只是为了在继续学习二进制文件写入之前,先检查一个你需要了解的小细节。
如果不了解何时使用二进制模式,何时使用普通文本模式,那么在实际实现的不同阶段就很难做出正确的选择。
为了清楚地展示我想表达的内容,我们需要编写新的代码。这段代码如下所示。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     int handle;
07.
08.     if ((handle = FileOpen("Hello.txt", FILE_WRITE | FILE_READ | FILE_ANSI)) == INVALID_HANDLE)
09.     {
10.         Print("Error...");
11.         return;
12.     };
13.     FileWrite(handle, "This file was created by a script written in MQL5.");
14.     FileWrite(handle, "New information is being added to the file.");
15.     FileWrite(handle, "Version FileWrite...");
16.     FileWrite(handle, "Checking writing values [", 1, "]-[", M_PI, "]");
17.
18.     FileFlush(handle);
19.
20.     FileSeek(handle, 0, SEEK_SET);
21.     while (!FileIsEnding(handle))
22.         Print(FileReadString(handle));
23.
24.     FileClose(handle);
25. }
26. //+------------------------------------------------------------------+
代码 03
代码 03,除了像代码 02 那样允许我们写入文件外,还允许我们读取文件内容。要理解接下来会发生什么,我们首先需要了解运行代码 03 会得到什么结果。
本质上,运行后生成的文件内容与图 03 所示的内容相同。为了确保文件确实包含预期的信息,我们使用第 18 行代码将缓冲区数据刷新到磁盘。第 18 行代码所示的操作在某些时候可能是不必要的。根据操作系统处理磁盘读写操作的繁忙程度,第 13 行到第 16 行执行的写入操作可能会立即提交。然而,在某些情况下,情况可能并非如此。由于我不想关闭文件然后重新打开它来读取保存的数据,我们在第 18 行使用这个库函数来强制数据立即刷新到文件中。
完成此操作后,我们就可以相当确定文件包含图 03 所示的数据了。现在我们开始读取。由于文件指针现在位于文件末尾,我们需要将其移动到其他位置。在这种情况下,我们将指向文件的开头。为此,我们使用第 20 行代码,将读/写指针移动到文件的开头。亲爱的读者,请注意这一点。我们将进行的读取操作不是来自缓冲区的内容,而是来自磁盘上的文件本身。
同样的原理也适用于读写:我们可以使用第 21 行所示的读取函数,该函数会一直读取,直到到达文件末尾。此处我们真正感兴趣的是第 22 行的作用。在这一行中,我们指示应用程序将从文件读取的内容打印到 MetaTrader 5 终端。这是我们最感兴趣的部分。
注意:在我们的例子中,我们写了四行。如图 01 所示。因此,显然,当执行代码 03 的第 22 行时,我们预期终端输出会与图 01 相似。然而,如果我们查看 MetaTrader 5 终端,我们会看到类似于下图 04 的内容:
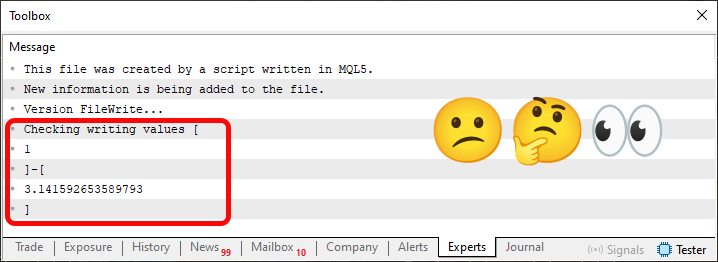
图 04
“嗯,奇怪。显然,前三行显示正确。但是,红色标记的区域显示的数据与预期不符。非常奇怪。”亲爱的读者,虽然看起来是这样,但这个结果实际上对我们的目的很有用。然而,我想提醒大家,我们在这里是以尽可能简单的方式进行的,目的是检验大多数开发人员自然会尝试的方法,但这些方法最终会导致与预期不同的结果。
这个意外结果是由制表符引起的。“但是,这怎么可能呢?”亲爱的读者,因为在此非二进制读取模式下,FileReadString 一遇到回车/换行序列或制表符就会停止。尽管文档中提到了使用 CSV 文件,但你只需查阅文档即可了解详细信息。但此处并非如此,因为文件内容并不打算表示 CSV 格式。
嗯,这里又有值得我们学习的地方。这是因为,在文件读取标志中,由于我们没有指定在读取过程中应如何解释数据,所以第 22 行的操作最终将制表符视为分隔符。因此,为了解决这个问题,我们需要再次更改代码,使用如下所示的版本。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     int handle;
07.
08.     if ((handle = FileOpen("Hello.txt", FILE_WRITE | FILE_READ | FILE_ANSI | FILE_TXT)) == INVALID_HANDLE)
09.     {
10.         Print("Error...");
11.         return;
12.     };
13.     FileWrite(handle, "This file was created by a script written in MQL5.");
14.     FileWrite(handle, "New information is being added to the file.");
15.     FileWrite(handle, "Version FileWrite...");
16.     FileWrite(handle, "Checking writing values [", 1, "]-[", M_PI, "]");
17.
18.     FileFlush(handle);
19.
20.     FileSeek(handle, 0, SEEK_SET);
21.     while (!FileIsEnding(handle))
22.         Print(FileReadString(handle));
23.
24.     FileClose(handle);
25. }
26. //+------------------------------------------------------------------+
代码 04
请注意,如前所述,我们只需要更改代码中的一处:这是第 08 行,您可以在代码 04 中看到它。即便如此,结果与图 04 所示结果仍有很大不同。在这种情况下,当执行代码 04 时,终端将显示以下内容:
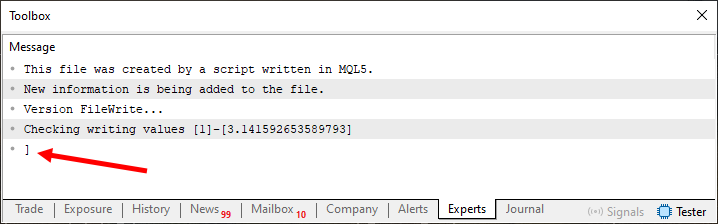
图 05
请注意,在这种情况下,输出结果与我们从写入语句中预期的结果非常接近。当然,我们存在一个小问题,这在图 05 中可以看到。但这是一个次要问题,因为目标可以认为是达到了。目标正是以一种方式读取文件,以获得与代码 04 中第 13 行和第 16 行之间显示的文本非常相似的文本。
非常好,既然已经完成并直观展示,我们可以继续进行二进制读写。这使我们能够继续对文件内容进行随机访问。然而,由于写入和读取的内容类似于普通文本,因此不太适合清晰简单地演示二进制操作和随机访问操作在实际中的执行方式。为了更好地理解这个主题,我们需要先将内容简化一些。这是通过以下代码实现的。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     int handle;
07.
08.     if ((handle = FileOpen("Hello World.txt", FILE_WRITE| FILE_READ | FILE_BIN)) == INVALID_HANDLE)
09.     {
10.         Print("Error...");
11.         return;
12.     };
13.     for (uchar c = 0; c < 10; c++)
14.         FileWriteInteger(handle, c, CHAR_VALUE);
15.
16.     FileFlush(handle);
17.
18.     FileSeek(handle, 0, SEEK_SET);
19.     Print("The byte value of the ", FileTell(handle), " position in the file is ", FileReadInteger(handle, CHAR_VALUE));
20.
21.     FileClose(handle);
22. }
23. //+------------------------------------------------------------------+
代码 05
执行代码 05 时,将创建一个包含 0 到 9 的值的文件,如第 14 行所示。但有一个小细节,你务必理解清楚,这一点极其重要。请注意,在写入时,我们指定所写入的值为 CHAR_VALUE 类型。理解这一点非常重要,因为默认情况下,此函数写入的是 INT_VALUE 类型的值。“但这为什么重要呢?”要理解这一点的重要性,你需要了解联合体(union)的工作原理。
本系列已发表两篇关于联合体的基础文章,其中之一为“从基础到中级:联合体(一)”。除了这些知识之外,你还需要了解如何使用数组。本系列的其他文章也对此进行了解释。鉴于您已掌握前几篇文章中描述的所有必要知识,我们可以尝试理解为什么执行代码 05 会得到如下所示的结果:
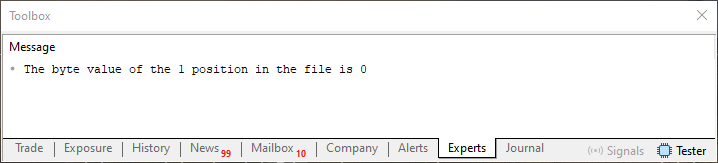
图 06
当执行代码 05 的第 19 行时,将显示类似于图 06 所示的内容。但是,打印到终端的这条消息是什么意思呢?如您所见,此消息显示了两个数值。第一个值表示文件中的当前位置。第二个值则指代该特定位置的内容。现在请注意,使用此读取功能时,文件应被视为一个数组;换言之,它是一个索引会自动递增的数组。我们还可以在此数组内指定索引,这是通过第 18 行代码来完成的。
正如数组中的计数从索引零开始一样,当我们在文件中访问数据时,索引也是从零开始的。然而,与在数组外指定索引的情况不同,在处理文件时,系统总是会将索引设置为有效位置。尝试代码 05 来理解这一点,将第 18 行函数中使用的零值替换为其他值。看看结果,这将帮助您理解数据访问是如何执行的。
但你还需要了解另一个方面。请注意,FileReadInteger 也使用了 CHAR_VALUE。这是因为我们只想读取一个字节。通常情况下,会读取四个字节,这四个字节将使文件中的索引或位置前进相同的四个字节。请仔细注意我提到的细节。这正是为什么理解联合体将极大地帮助你理解这种访问文件数据的方式。
在继续之前,请彻底测试代码 05,直到你完全理解它的工作原理,也就是说,直到你意识到文件只不过是存储在磁盘上的数组。一旦你理解了这一点,你就会更容易理解我们接下来要做什么。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     int handle;
07.
08.     if ((handle = FileOpen("Hello World.txt", FILE_WRITE| FILE_READ | FILE_BIN)) == INVALID_HANDLE)
09.     {
10.         Print("Error...");
11.         return;
12.     };
13.     for (uchar c = 0; c < 10; c++)
14.         FileWriteInteger(handle, c, CHAR_VALUE);
15.
16.     FileFlush(handle);
17.
18.     FileSeek(handle, 4, SEEK_SET);
19.     FileWriteInteger(handle, 45, CHAR_VALUE);
20.
21.     FileFlush(handle);
22.
23.     FileSeek(handle, 4, SEEK_SET);
24.     Print("The byte value of the ", FileTell(handle), " position in the file is ", FileReadInteger(handle, CHAR_VALUE));
25.
26.     FileClose(handle);
27. }
28. //+------------------------------------------------------------------+
代码 06
现在来看代码 06。你会发现,它与代码 05 非常相似。然而,在这里我们所做的工作稍微超出了代码 05 的范围,因为我们使用完全随机访问来写入文件。如果你还没有成功将数组的概念与文件的概念结合起来,那么这里有一个不太有趣的陷阱。代码 06 执行的操作是传统数组无法完成的,至少如果我们按照大多数情况下通常使用数组的方式操作的话。
在分析代码 06 之前,让我们先看一下它的运行结果:
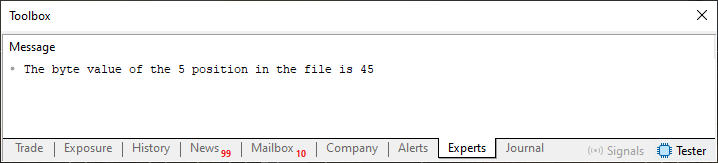
图 07
现在到了最有趣的部分:了解图 07 中的信息是如何获得的。首先,请注意代码 06 与代码 05 相比,唯一的变化是第 18 行和第 19 行。这两行代码用于更改文件中特定位置的值。这相当于给数组中的特定元素赋一个新值。到目前为止,一切都很容易理解,因为指定的位置在第 13 行循环所创建的内容范围内。
即使没有事先创建位置,你也可以做同样的事情,或者更准确地说,在为每个位置赋值之前,你不需要预先分配每个位置。请记住,我们这里处理的是文件。在这种情况下,你可以指定一个远远超出文件当前结尾的位置,操作仍然有效。
这听起来可能令人困惑。实际上,一切都很简单。将第 18 行传给 FileSeek 的位置值改为大于循环写入的字节数(10)的值,例如 14。别忘了将第 23 行的值也改为与第 18 行相同的值。运行此代码将产生如下所示的结果:
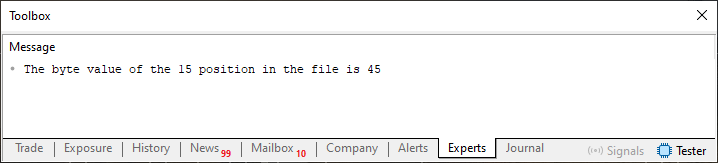
图 08
“真奇怪!我一直以为数据必须一个字节一个字节、一个位置一个位置地写入文件。那么,我们是否可以随意写入,而不管已经存在什么数据呢?”这确实很令人好奇。亲爱的读者,正是这样的情况让编程变得令人难忘且引人入胜,尽管对于刚开始接触编程的人来说,有时可能会感到有些困惑。
最后的思考
在本文中,我们首次探讨了文件内容的随机访问。当然,亲爱的读者,当我说这些时,我假设你可能还没有意识到文件处理涉及多少微妙之处。
由于本文主要关注的是在文件内任意位置写入内容,因此我们没有机会解释与文件内部数据索引相关的一些细节。鉴于这个问题非常重要,我们自然就有了下一篇文章的主题。所以,请使用附件中的源文件,尝试在实践中学习和巩固本文所展示的内容。我们下一篇文章见。
| MQ5 文件 | 描述 |
|---|---|
| 代码 01 | 文件访问演示 |
| 代码 02 | 文件访问演示 |
| 代码 03 | 文件访问演示 |
| 代码 04 | 文件访问演示 |
本文由MetaQuotes Ltd译自葡萄牙语
原文地址: https://www.mql5.com/pt/articles/16246
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。