

交易中的神经网络:异质性感知元参数学习(结论)
 25
 0

引言
算法交易领域很少会接纳过度复杂或毫无依据的简化方案。 任何模型——无论是高度复杂的神经网络集成,还是极简的自回归滤波器——最终都必须经得起时间和市场的考验。 正是基于这一视角,HimNet应运而生——它并非依靠大量可训练参数或新奇的计算方式来吸引眼球。 相反,它致力于提供稳定、可重复且具有经济意义的结果。
从一开始,HimNet就展现出三项特质,使其与许多其他方法区别开来。 首先,架构本身具有合理性:它不包含那些仅为营造分析深度假象而存在的冗余层。 这里的每个模块都有实际作用,也都有其存在的理由。 其次,是审慎的适应性:该框架并非盲目地顺应每次市场波动带来的噪音,而是实现了灵活性与稳定性之间的平衡。 第三,参数管理上的极简主义。HimNet的设计旨在将可训练系数的数量减少到必要的最低限度。 这有助于避免对历史数据过拟合,并在时间序列的较远期区段仍保持预测能力。
在我们之前的研究中,我们系统地探讨了该框架的内部机制。 从理论基础出发,我们详细探讨了生成嵌入的方法,并分析了循环组件与卷积组件如何相互补充。 HimNet架构就像一套协调运转的机械装置,其中的每一个齿轮——无论是切比雪夫多项式块还是GCRU机制——都各司其职。 这并非技术的堆砌,而是一种经过精心设计的方案,既能形成信息丰富的市场表示,又不会降低处理速度或使计算链过度复杂化。
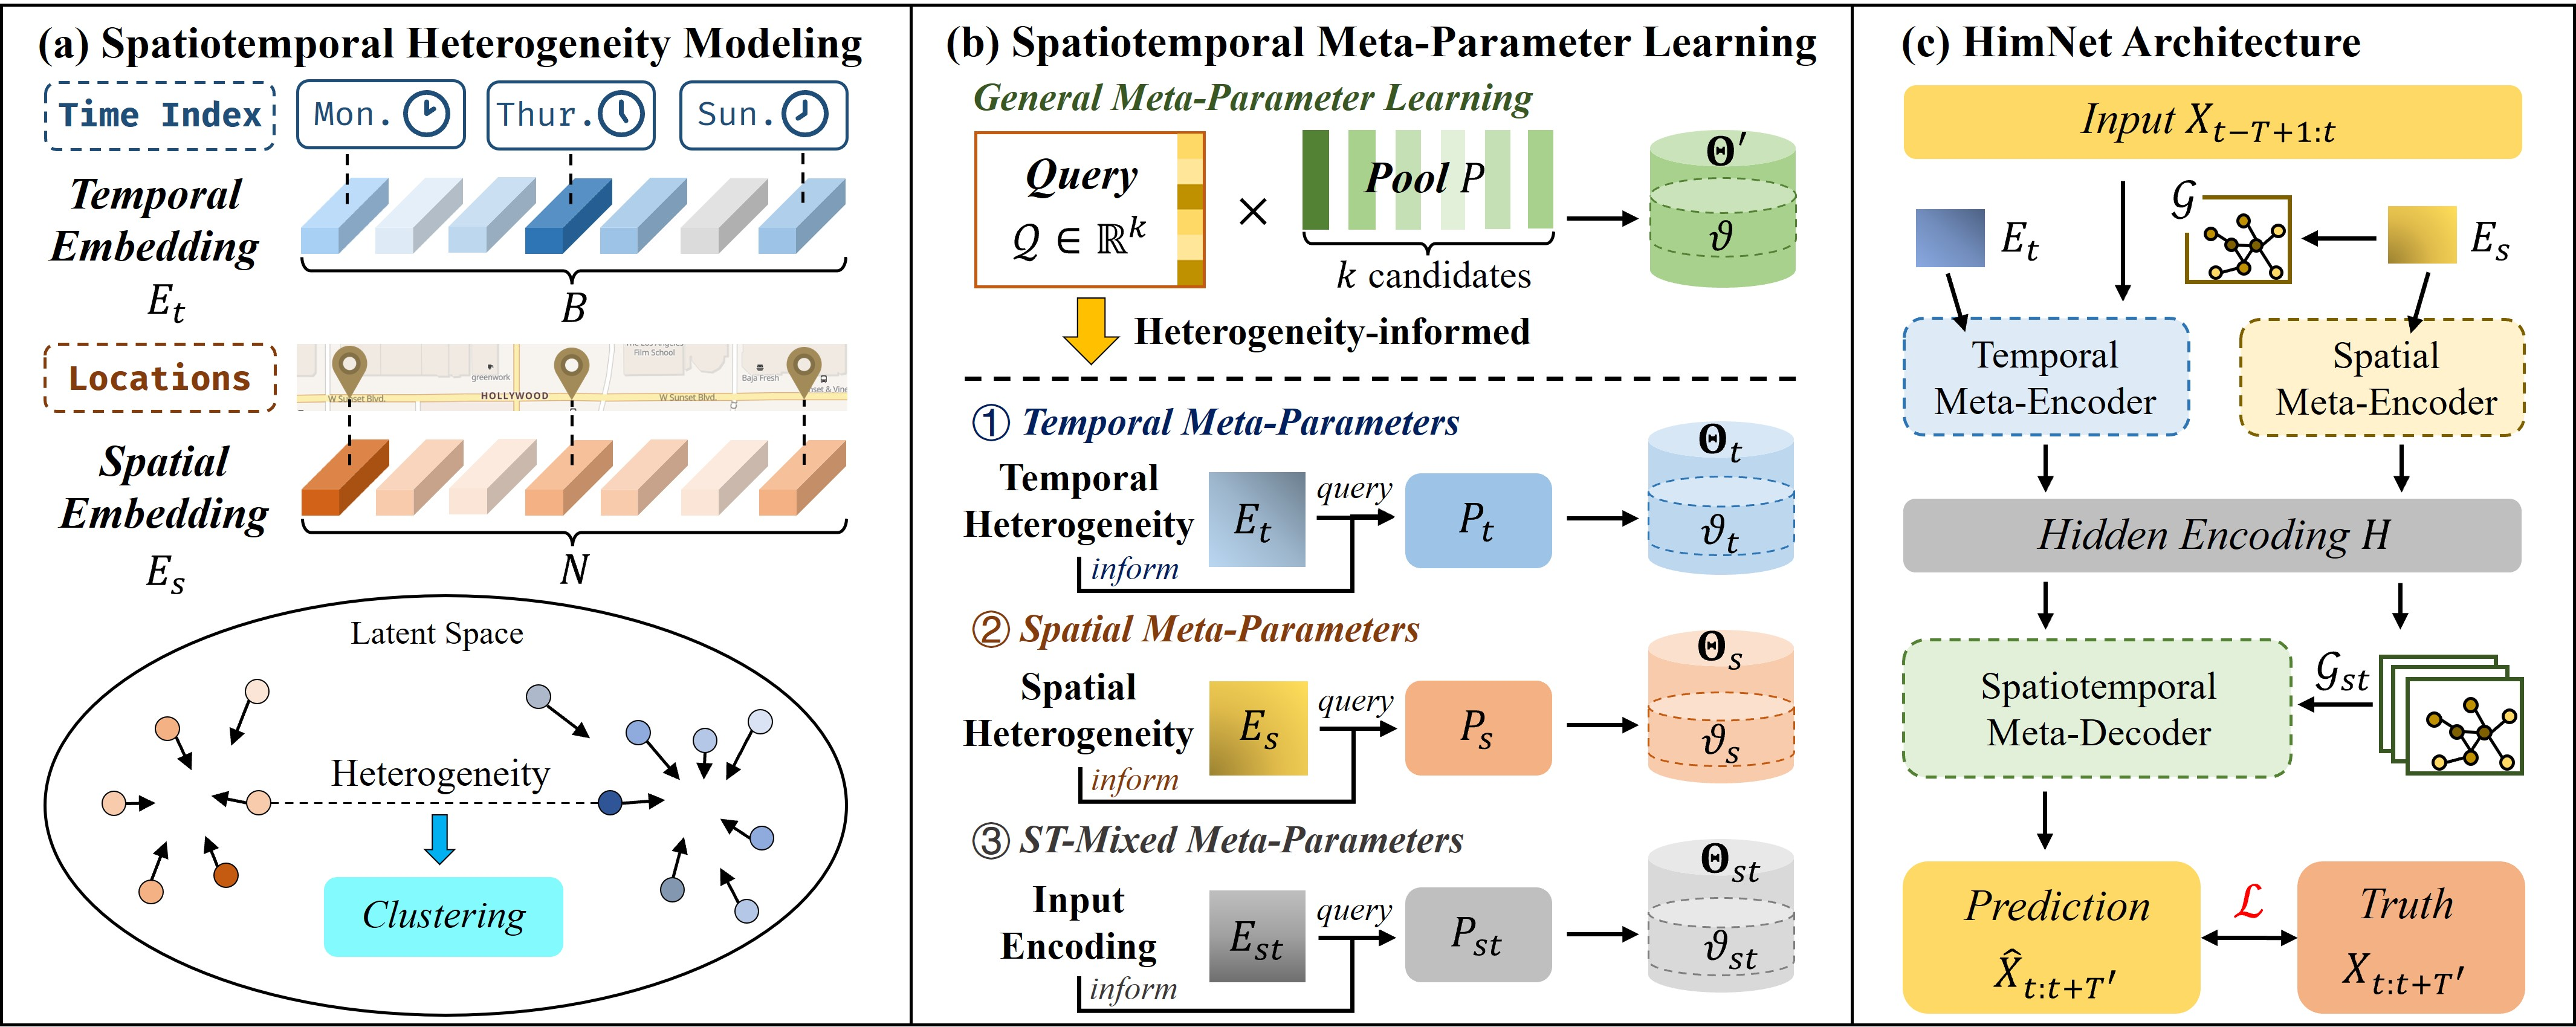
HimNet框架基于经典且在许多方面都经过时间考验的编码器–解码器架构。 该方案在处理复杂序列的任务中已被证明行之有效,在这些任务中,不仅需要捕捉市场的当前状态,还需从中提取稳定的模式以供进一步预测。 编码器和解码器基于相同的基础架构:两者都使用可训练的嵌入和图循环块(GCRU)。 然而,它们之间存在一个微妙但重要的区别——就在于嵌入的形成方式本身。
在编码器中,时间嵌入和空间嵌入直接从预定义集合中提取,并用作向元参数池发起的查询。 这使得编码器能够适应上下文。
另一方面,解码器则基于由编码器的输出合成的潜在表示,间接生成嵌入。 它将隐藏表示投影为时空嵌入,该嵌入用作对ST元参数模型的查询,从而使解码器能够生成权重。
我们已经完成了大量准备工作:实现了模型的基本组件,其中包括能够有效建模数据中时空依赖关系的图循环块。 现在是时候迈向层次结构的更高一级了——构建完整的编码器和解码器架构。 这一阶段将作为框架中各个组成部分与其实际应用之间的桥梁。 正是在这里,抽象的模块相互连接,数据流开始形成对未来市场状态的有意义的表示。
编码器
HimNet框架作者提出了一种双流数据处理机制,其中针对每种依赖关系(空间依赖和时间依赖)分别设置了一个独立的编码器。 这种方法可以避免将不同的信号结构混在一起,而是分别在并行分支中进行分析,从而确保对关键模式进行更准确、更清晰的识别。 根据前面介绍的思路,今天我们将从构建一个时间编码器开始。 毕竟,时间正是编织所有市场动态的那根主线。
时间编码器
CNeuronHimNetTempEncoder对象是该框架中的一种时间滤波器,旨在从报价序列和市场数据中提取隐藏的规律。 此外,它还能同时在多个尺度上实现这一点。
class CNeuronHimNetTempEncoder   : public CNeuronBaseOCL
  {
protected:
   uint              aTimeframes[2];
   CCircleParams     caEmbeddings[2];
   CNeuronBaseOCL    cConcatEmbeddings;
   CLayer            cGRCUs;
   CBufferFloat      bSupportAccum;

public:
                     CNeuronHimNetTempEncoder(void) {};
                    ~CNeuronHimNetTempEncoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint window_out, uint cheb_k,
                          uint layers, uint embed_dim, uint period1,
                          uint timeframe1, uint period2, uint timeframe2,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL,
                                 CChebPolinom *Support,
                                 int label);
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CChebPolinom *Support);
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL,
                                        CChebPolinom *Support);
   //---
   virtual int       Type(void)   const   {  return defNeuronHimNetTempEncoder;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual bool      Clear(void) override;
   //---
   virtual uint      GetCount(void) const;
   virtual uint      GetWindowIn(void) const;
   virtual uint      GetWindowOut(void) const;
   virtual uint      GetChebK(void) const;
//---
   virtual bool      SetGradient(CBufferFloat *buffer, bool delete_prev = true);
  };
关键要素是由caEmbeddings数组表示的两套嵌入字典。 每个嵌入字典存储的并非完整数据,而只是各个时间步的紧凑表示——这些嵌入用作对模型参数池的查询。 这意味着每个时间步实际上都会访问其自身的参数子空间,从中获取所需的值,从而配置后续的数据流。
需要强调的是,这两套嵌入字典以协调但又相互独立的方式运作——这使得模型能够同时关注两个时间尺度,并避免将短期噪声与长期惯性混为一谈。 在实现这些方法的过程中,我们将详细探讨这些查询如何与数据流交互,以及时间编码器的其他组件负责处理哪些任务。
所有内部对象都是静态声明的,因此构造函数和析构函数保持精简。 所有已声明的组件和继承对象的实际初始化工作都在Init方法中集中完成。
bool CNeuronHimNetTempEncoder::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                    uint units, uint window, uint window_out, uint cheb_k,
                                    uint layers, uint embed_dim, uint period1,
                                    uint timeframe1, uint period2, uint timeframe2,
                                    ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(layers <= 0)
      return false;
该算法从一个小型控制块开始——我们检查编码器中的内部层数。 如果layers参数的值小于或等于 0,则该方法会立即失败。 这可以避免无谓的配置:如果没有层,就没什么可学习的。
接下来,调用父类中同名的方法,并将该对象的基本参数传递给它。 在此步骤中,我们将定义编码器输出的张量形状,并预留必要的资源。 如果基本初始化失败,那么继续执行后续操作就没有意义了——该方法将返回false。
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, window_out * units, optimization_type, batch))
      return false;
接下来,准备好嵌入字典,并将时间步长立即存储到aTimeframes数组的相应元素中。
   int index = 0;
   if(!caEmbeddings[0].Init(0, index, OpenCL, embed_dim, period1, optimization, iBatch))
      return false;
   aTimeframes[0] = MathMax(1, timeframe1);
   index ++;
   if(!caEmbeddings[1].Init(0, index, OpenCL, embed_dim, period2, optimization, iBatch))
      return false;
   aTimeframes[1] = MathMax(1, timeframe2);
   if(!cConcatEmbeddings.Init(numOutputs, myIndex, open_cl, 2 * embed_dim, optimization_type, batch))
      return false;
每个嵌入字典都针对其自身的时间粒度进行了配置:嵌入大小和周期决定了将向参数池发送哪些具体的时间查询。 如果这些初始化操作中有任何一项失败,该方法将中止执行——绝不允许留下构建不完整的编码器。
定义好嵌入字典后,会创建cConcatEmbeddings对象,用于将这两个嵌入合并为一个向量。
接下来,开始构建GRCU层。 首先,我们清空cGRCUs容器,并显式绑定OpenCL上下文。
   cGRCUs.Clear();
   cGRCUs.SetOpenCL(OpenCL);
   index++;
   CNeuronHimNetGCRU *temp = new CNeuronHimNetGCRU();
   if(!temp ||
      !temp.Init(0, index, OpenCL, units, window, window_out, cheb_k, 2 * embed_dim, optimization, iBatch) ||
      !cGRCUs.Add(temp))
      return false;
接下来,创建第一个CNeuronHimNetGCRU对象,并使用第一层的参数对其进行初始化:对于该层,输入特征数设置为待分析时间序列的对应维度,输出维度则设置为潜在表示的维度。 这第一层就是堆栈的底层。
如果初始化成功,该层将被添加到cGRCUs容器中。 如果添加或初始化失败,则返回false。
对于后续的所有层,逻辑就稍微简单一些了。 在循环中创建了更多的CNeuronHimNetGCRU对象,但现在输入和输出张量的维度相同。 这是一种标准的方法:第一层扩展并汇总上下文,而后续层则对该上下文进行更深入的细化。 如果发生任何错误——无论是在创建、初始化还是添加过程中——我们都会通过从方法中返回false来妥善退出,以确保系统不会处于不一致的状态。
   for(uint i = 1; i < layers; i++)
     {
      index++;
      temp = new CNeuronHimNetGCRU();
      if(!temp ||
         !temp.Init(0, index, OpenCL, units, window_out, window_out, cheb_k, 2 * embed_dim, optimization, iBatch) ||
         !cGRCUs.Add(temp))
         return false;
     }
一旦GRCU堆栈构建完成,我们就初始化辅助缓冲区bSupportAccum,该缓冲区将用于累加从编码器各层获得的切比雪夫多项式的误差梯度。
   bSupportAccum.BufferFree();
   bSupportAccum.Clear();
   if(!bSupportAccum.BufferInit(units * units * cheb_k, 0) ||
      !bSupportAccum.BufferCreate(OpenCL))
      return false;
接下来是一个重要的实现步骤:编码器的输出即为cGRCUs容器中最后一个对象的输出。 为了避免不必要地复制大型张量,我们对激活函数以及指向结果和梯度缓冲区的指针进行了同步。 换句话说,编码器的激活方式与最后一层保持一致,其外部接口直接指向最后一个GRCU的内部缓冲区。 这大大节省了内存和时间。
   SetActivationFunction((ENUM_ACTIVATION)temp.Activation());
   if(!SetOutput(temp.getOutput(), true) ||
      !SetGradient(temp.getGradient(), true))
      return false;
//---
   return true;
  }
初始化对象后,我们开始实现时间编码器的核心功能:前向传播方法feedForward。
bool CNeuronHimNetTempEncoder::feedForward(CNeuronBaseOCL *NeuronOCL, CChebPolinom *Support, int label)
  {
   for(uint i = 0; i < caEmbeddings.Size(); i++)
     {
      int position = (label / int(aTimeframes[i])) % caEmbeddings[i].GetPeriod();
      if(!caEmbeddings[i].SetPosition(position) ||
         !caEmbeddings[i].FeedForward())
         return false;
     }
   if(!Concat(caEmbeddings[0].getOutput(), caEmbeddings[1].getOutput(),
              cConcatEmbeddings.getOutput(), 1, 1, caEmbeddings[0].Neurons()))
      return false;
该算法首先从嵌入字典中检索嵌入。 该操作以循环的形式组织,依次遍历数组中的字典。 对于每个字典,我们都会根据从外部程序接收的时间戳来计算当前位置。 然后,我们通过调用相应字典的FeedForward方法来生成一个特定的时间嵌入。
本质上,正是在这里,时间被转换为用于获取专用权重的地址。 用交易来打个比方:当进入特定时间窗口时,我们无需重新训练模型,只需使用不同的查询来选择相应的模型配置。
一旦获得了这两个嵌入,其结果就会被合并为一个张量。
接下来是关键部分:遍历GRCU容器。 局部变量inputs被初始化为指向源数据对象的指针。 在遍历cGRCUs容器中的元素时,我们会依次处理每一层,并调用其前向传播方法。
   CNeuronBaseOCL *inputs = NeuronOCL;
   CNeuronHimNetGCRU *current = NULL;
   for(int i = 0; i < cGRCUs.Total(); i++)
     {
      current = cGRCUs[i];
      if(!current ||
         !current. Feedforward(inputs, Support, cConcatEmbeddings.AsObject()))
         return false;
      inputs = current;
     }
//---
   return true;
  }
理解这一接口约定非常重要:第一个 GRCU接收待分析序列的原始数据以及一个共享嵌入查询。 它形成自身的隐藏表示。 随后,inputs中的指针被替换为当前对象——第一层的输出成为下一层的输入。 顺序变换堆栈的构建过程如下:第一层扩展上下文,而后续各层则对表示进行精炼和压缩。 在交易实践中,这类似于一轮初步分析,先收集所有细节,而后续各层则像经验更丰富的经理一样,对信息进行筛选、聚合,并为信号输出做好准备。
切比雪夫多项式缓冲区(Support)是图聚合(K跳)的核心。 将同一个对象传递给每一层,可确保整个堆栈对各序列之间的关系结构保持一致的视图,而每个GRCU则使用自身的元参数(由嵌入生成)来解释该Support。
既然我们已经讲完了前向传播,接下来就该转向反向传播了——在这一阶段,模型接受评估,我们会审慎地将误差归因并分配到模型的各个组成部分。 calcInputGradients方法正是将编码器输出处累积的误差通过GRCU堆栈和嵌入字典向后传播,从而调整每个组件行为的过程。
bool CNeuronHimNetTempEncoder::calcInputGradients(CNeuronBaseOCL *NeuronOCL, CChebPolinom *Support)
  {
   if(!NeuronOCL || !Support)
      return false;
首先,该方法通过防护性检查,确保传入的指针有效。 接下来,确定最后一层的输入源。 如果堆栈中包含多个层,则取倒数第二个GRCU;否则,取源数据对象。 我们从最后一个GRCU开始分配误差梯度——在初始化时,我们正是将这个对象的结果指定为编码器的外部输出。 这很合理:梯度首先到达堆栈顶部,然后从那里开始向下传播。
   CNeuronBaseOCL *inputs = (cGRCUs.Total() > 1 ? cGRCUs[-2] : NeuronOCL);
   CNeuronHimNetGCRU* current = cGRCUs[-1];
   if(!current ||
      !current.calcInputGradients(inputs, Support, cConcatEmbeddings.AsObject()))
      return false;
   if(!DeConcat(caEmbeddings[0].getGradient(), caEmbeddings[1].getGradient(),
                cConcatEmbeddings.getGradient(), 1, 1, caEmbeddings[0].Neurons()))
      return false;
主要的局部计算在这里进行:最后一个 GRCU将接收到的梯度分配给其输入、内部元参数以及切比雪夫多项式梯度缓冲区(Support)。 需要理解的是,在此阶段,Support充当共享的连接映射,堆栈中的每一层都可以向其中累加梯度贡献。 正因如此,我们需要一个累加机制。
下一步是将组合嵌入的梯度再次拆分为两部分——即两套嵌入字典的梯度。 我们将各分支对误差的贡献交还给相应分支,使嵌入字典随后能够据此调整对参数池的查询。
如果堆栈中包含多个层,就需要审慎累积Support的梯度。 首先,我们将指向当前梯度缓冲区的指针存储在局部变量temp中,这样就不会丢失包含先前累积值的上一个缓冲区。 接下来,我们将误差梯度暂时重定向到预先分配的bSupportAccum缓冲区中。
   if(cGRCUs.Total() > 1)
     {
      CBufferFloat *temp = Support.getGradient();
      if(!Support.SetGradient(GetPointer(bSupportAccum), false))
         return false;
      for(int i = cGRCUs.Total() - 2; i >= 0; i--)
        {
         current = cGRCUs[i];
         inputs = (i > 0 ? cGRCUs[i - 1] : NeuronOCL);
         if(!current ||
            !current.calcInputGradients(inputs, Support, cConcatEmbeddings.AsObject()))
            return false;
         if(!SumAndNormilize(temp, Support.getGradient(), temp, 1, false, 0, 0, 0, 1))
            return false;
         if(!DeConcat(caEmbeddings[0].getPrevOutput(), caEmbeddings[1].getPrevOutput(),
                      cConcatEmbeddings.getGradient(), 1, 1, caEmbeddings[0].Neurons()))
            return false;
         for(uint i = 0; i < caEmbeddings.Size(); i++)
            if(!SumAndNormilize(caEmbeddings[i].getGradient(), caEmbeddings[i].getPrevOutput(),
                                caEmbeddings[i].getGradient(), 1, false, 0, 0, 0, 1))
               return false;
        }
      if(!Support.SetGradient(temp, false))
         return false;
     }
//---
   return true;
  }
在一个按逆序遍历堆栈中对象的循环中,我们对每一层调用误差梯度传播方法。 接下来,我们将新的梯度贡献与temp缓冲区中已累积的梯度相加。 之后,我们将组合嵌入的梯度再次拆分为两个信息流。 最后,对于每个字典,我们将获得的值添加到迄今为止累积的值中。
遍历完所有层后,我们将指向数据缓冲区的指针重置为初始状态。 这一点很重要:只有这样,外部优化器才能获得正确的信号,从而更新图聚合所依赖的参数。
在成功完成所有迭代后,该方法返回true,这表明梯度已成功通过编码器的所有组件传播至源数据层。
在逐一收集完梯度之后,下一步就是更新参数。 updateInputWeights方法形式上简单,作用却很重要:它会依次将控制权传递给包含可训练权重的内部组件。 它按照计算序列的执行顺序来执行这一操作。
bool CNeuronHimNetTempEncoder::updateInputWeights(CNeuronBaseOCL *NeuronOCL, CChebPolinom *Support)
  {
   for(uint i = 0; i < caEmbeddings.Size(); i++)
      if(!caEmbeddings[i].UpdateInputWeights())
         return false;
首先,在循环中更新这两套嵌入字典。 每次调用UpdateInputWeights都会将上一步中累积的梯度应用到相应字典的参数上。
随后,该方法按照前向计算的顺序遍历GRCU堆栈:每一层负责在层内更新其嵌入和元参数池的参数。
   CNeuronBaseOCL* inputs = NeuronOCL;
   CNeuronHimNetGCRU* current = NULL;
   for(int i = 0; i < cGRCUs.Total(); i++)
     {
      current = cGRCUs[i];
      if(!current.updateInputWeights(inputs, Support, cConcatEmbeddings.AsObject()))
         return false;
      inputs = current;
     }
//---
   return true;
  }
该类的完整源代码(包括所有方法的实现)已附上;其中包含了上述讨论的所有细节。 至此,我们对时间编码器的分析就告一段落,可以继续介绍下一部分了。
空间编码器
在继续之前,让我们先讨论一下什么是空间编码器,以及它与时间编码器有何不同;毕竟,理解这一区别对于将其正确集成到整个HimNet架构中至关重要。
时间编码器处理一组嵌入字典,作为针对不同时间粒度参数池的查询。 相比之下,空间编码器并不需要为不同周期维护大量查询键——因为该问题中空间数据的结构是稳定的。 因此,我们不再使用字典,而是使用封装在cEmbedding对象中的单组可训练参数。 这使模型能够拥有一个统一、集中的市场空间表示,该表示在训练过程中不断优化,随后持续为GRCU提供上下文查询。
class CNeuronHimNetSpatEncoder   :     public CNeuronBaseOCL
  {
protected:
   CParams           cEmbedding;
   CLayer            cGRCUs;
   CBufferFloat      bSupportAccum;
   CBufferFloat      bEmbeddingAccum;

public:
                     CNeuronHimNetSpatEncoder(void) {};
                    ~CNeuronHimNetSpatEncoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint window_out, uint cheb_k,
                          uint layers, uint embed_dim,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL,
                                 CChebPolinom *Support);
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CChebPolinom *Support);
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL,
                                        CChebPolinom *Support);
   //---
   virtual int       Type(void)   const   {  return defNeuronHimNetSpatEncoder;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual bool      Clear(void) override;
   //---
   virtual uint      GetCount(void) const;
   virtual uint      GetWindowIn(void) const;
   virtual uint      GetWindowOut(void) const;
   virtual uint      GetChebK(void) const;
   //---
   virtual bool      SetGradient(CBufferFloat *buffer, bool delete_prev = true);
  };
从架构上看,CNeuronHimNetSpatEncoder对象与时间编码器非常相似。 它同样包含由图循环块cGRCUs组成的堆栈、类似的切比雪夫多项式梯度累加器,以及一套用于前向传播和反向传播的方法。 主要区别在于,我们不再使用两套嵌入字典,而是使用一个参数化的cEmbedding模块和一个额外的bEmbeddingAccum缓冲区。 该缓冲区用于累加堆栈中所有层对嵌入梯度的贡献。
由于空间编码器与时间编码器仅在细微之处有所不同,因此重点探讨其架构逻辑和数据流,有助于避免文本中出现不必要的重复。 附件中提供了该类及其所有方法的完整代码,读者可据此自行追踪其中的细微差异,并准确理解嵌入参数和梯度在GRCU层内的更新方式。
组合编码器
在此阶段,我们将转向一个关键模块,该模块将两个并行编码器的处理结果整合为一个统一、连贯的表示。 CNeuronHimNetEncoder类充当协调器,确保空间和时间表征的整合。 时间编码器捕捉随时间的变化,识别短期和长期趋势,而空间编码器则分析不同对象之间的关系。 这两个流的输出在类内部经过精心整合,形成了系统状态的完整潜在表示。
class CNeuronHimNetEncoder    :  public CNeuronBaseOCL
  {
protected:
   CParams                    cEmbedding;
   CNeuronTransposeOCL        cEmbeddingT;
   CNeuronBaseOCL             cSupport;
   CNeuronSoftMaxOCL          cNormSupport;
   CChebPolinom               cPolinomSupport;
   CNeuronHimNetTempEncoder   cTempEncoder;
   CNeuronHimNetSpatEncoder   cSpatEncoder;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *prevLayer) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronHimNetEncoder(void) {};
                    ~CNeuronHimNetEncoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint window_out, uint cheb_k,
                          uint layers, uint embed_dim, uint period1,
                          uint timeframe1, uint period2, uint timeframe2,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronHimNetEncoder;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      TrainMode(bool flag) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual bool      Clear(void) override;
   virtual bool      SetGradient(CBufferFloat *buffer, bool delete_prev = true);
  };
从架构上讲,该对象包含自身的一组可训练参数(cEmbedding),这些参数是生成切比雪夫多项式的基础。
与该框架之前的模块一样,该类的结构旨在最大限度地减少开销并消除不必要的动态操作。 此处的所有内部对象都是静态声明的,因此构造函数和析构函数保持为空。 它们的作用仅是在形式上定义对象的生命周期,而不干预资源分配逻辑。 准备组件所需的所有实际工作都集中在Init方法中,该方法起着类似指挥家的作用:它依次配置每个内部元素,在各编码器之间分配角色,并将它们链接成一条单一的计算链。
bool CNeuronHimNetEncoder::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                uint units, uint window, uint window_out, uint cheb_k,
                                uint layers, uint embed_dim, uint period1,
                                uint timeframe1, uint period2, uint timeframe2,
                                ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, window_out * units, optimization_type, batch))
      return false;
初始化首先将控制权传递给父类,该父类已包含用于创建基础接口的算法。 接下来,构建一系列相互关联的组件:可训练的嵌入参数、对其进行转置的层、用于创建对角相关矩阵的对象,以及对所得依赖关系进行归一化的组件。 此外,还创建一个用于生成图变换所需切比雪夫多项式的对象。
   int index = 0;
   if(!cEmbedding.Init(0, index, OpenCL, units * embed_dim, optimization, iBatch))
      return false;
   SetActivationFunction(TANH);
   index++;
   if(!cEmbeddingT.Init(0, index, OpenCL, units, embed_dim, optimization, iBatch))
      return false;
   index++;
   if(!cSupport.Init(0, index, OpenCL, units * units, optimization, iBatch))
      return false;
   cSupport.SetActivationFunction(None);
   index++;
   if(!cNormSupport.Init(0, index, OpenCL, cSupport.Neurons(), optimization, iBatch))
      return false;
   cNormSupport.SetHeads(units);
   cNormSupport.SetActivationFunction(None);
   index++;
   if(!cPolinomSupport.Init(0, index, OpenCL, units, cheb_k, optimization, iBatch))
      return false;
在计算管道中,为计算流程中的每个组件分配独立的索引,并在相应的位置明确设置激活函数。 对于嵌入生成对象,我们使用双曲正切函数,以便以归一化方式表示正相关和负相关关系。
特别注意了两个数据流的同步:时间数据流(cTempEncoder)和空间数据流(cSpatEncoder)。 前者负责识别时间模式,同时考虑多尺度周期和预测窗口;后者负责映射分析单元之间的关系。 最后,它们的梯度缓冲区被同步,这既避免了过多的数据重复,又确保了在反向传播过程中误差能够平稳传播。
   index++;
   if(!cTempEncoder.Init(0, index, OpenCL, units, window, window_out, cheb_k, layers, (embed_dim + 1) / 2,
                                           period1, timeframe1, period2, timeframe2, optimization, iBatch))
      return false;
   index++;
   if(!cSpatEncoder.Init(0, index, OpenCL, units, window, window_out, cheb_k, layers, embed_dim, optimization,
                                                                                                      iBatch))
      return false;
//---
   if(!SetGradient(cTempEncoder.getGradient(), true))
      return false;
//---
   return true;
  }
因此,Init方法作为整个模块的集成点,将分散的组件整合成一个统一的架构,以便在真实的金融数据上进行训练和部署。
完成对象的初始化后,我们将着手开发前向传播算法。
bool CNeuronHimNetEncoder::feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   if(!SecondInput)
      return false;
让我们从基础开始:先检查传入的、指向第二个信息流源数据对象的指针是否有效。 在此对象中,我们期望接收正在分析的序列的时间戳。 如果指针为空,我们将立即退出,以免损坏图和缓冲区。
接下来是一个重要的分支点。 在训练模式下,我们会从头开始重建自适应图。 首先,我们生成嵌入。 接下来,我们准备其转置表示。
   if(bTrain)
     {
      if(!cEmbedding.FeedForward())
         return false;
      if(!cEmbeddingT.FeedForward(cEmbedding.AsObject()))
         return false;
      if(!MatMul(cEmbedding.getOutput(), cEmbeddingT.getOutput(), cSupport.getOutput(),
                 cEmbeddingT.GetCount(), cEmbeddingT.GetWindow(), cEmbeddingT.GetCount(), 1, false))
         return false;
      if(!cNormSupport.FeedForward(cSupport.AsObject()))
         return false;
      if(!cPolinomSupport.FeedForward(cNormSupport.AsObject()))
         return false;
     }
MatMul 操作将生成的嵌入与其转置副本进行矩阵相乘,从而形成节点之间的原始相关矩阵。 在交易语境下,这意味着具有相似行为指纹的两个金融工具之间会有更紧密的关联。
我们使用SoftMax函数对原始图进行归一化处理,并应用稳定的后处理。 通过这一操作,我们得到了一个适用于图卷积、满足随机矩阵条件的邻接矩阵。
接下来,我们将构造切比雪夫多项式。 这正是我们的K跳聚合机制:它让我们能够累积距离不超过K条边的邻居的影响,而无需对拉普拉斯矩阵进行对角化——计算快速、数值稳定,且完全在GPU上完成。
在推理模式下,将跳过这部分计算。 我们直接使用训练期间已获得的嵌入和多项式,以免浪费哪怕纳秒级的时间,并保持确定性。
接下来是两个编码器。 首先,我们将待分析的多模态数据序列、一组切比雪夫多项式以及一个时间戳输入到时间流中。
   if(!cTempEncoder.feedForward(NeuronOCL, cPolinomSupport.AsObject(), int(SecondInput[0])))
      return false;
编码器将当下发生的事情与事情发生的确切时间融合在一起,从而在图的动态变化上叠加时间模式。
与此同时,我们启动空间编码器。
   if(!cSpatEncoder.feedForward(NeuronOCL, cPolinomSupport.AsObject()))
      return false;
它不需要时间标签——这里使用的是静态节点嵌入。 空间骨干网络负责构建稳定的市场地图。 这两条流使用相同的K跳基,但观察它的角度不同——一条从时间维度,另一条从空间维度。
最后一步是将这些结果审慎地整合起来。 我们将两个编码器的输出相加。
   if(!SumAndNormilize(cTempEncoder.getOutput(), cSpatEncoder.getOutput(), Output,
                       cTempEncoder.GetWindowOut(), false, 0, 0, 0, 1))
      return false;
//---
   return true;
  }
实际上,这形成了一个简单而可靠的集成模型:时间通道捕捉交易时段模式和日历效应,而空间通道则捕捉稳定的簇。 其结果是一种潜在表示,无论在平静的市场环境下,还是在新闻驱动的行情剧烈波动期间,其表现都同样稳定——由于信号来自两个相互协调的来源,该模型不会对单一类型的信号产生过拟合。
如果每个步骤都执行成功,则该方法返回true。 否则,我们将立即退出,且不在缓冲区中留下任何“脏”状态。 这种保守的流程控制在实际交易中尤为重要:当模型处理tick数据或1分钟K线时,根本无暇修复部分损坏的数据——预测要么准确且及时,要么就不应生成。
前向传播完成后,模型进入最关键的阶段之一——误差梯度的传播。 这一步将决定每个架构元素能多准确地解读反馈信号,并据此调整其权重。 该类中的calcInputGradients方法的设计旨在使该过程按顺序进行,避免不必要的计算开销,并将数据复制操作降至最低。
bool CNeuronHimNetEncoder::calcInputGradients(CNeuronBaseOCL *prevLayer)
  {
   if(!cTempEncoder.calcInputGradients(prevLayer, cPolinomSupport.AsObject()))
      return false;
首先,从时间编码器中提取梯度,并谨慎地将其传递到多项式缓冲区和上一层。
在此,我们将对空间编码器重复上述步骤,但首先需要确保已获取的数据得以保留。 这里所说的不仅是指内部组件,还包括源数据对象。 由于两个编码器在前向传播过程中处理的是同一组源数据,因此,我们首先保留已获得的梯度。
   CBufferFloat* temp = cPolinomSupport.getGradient();
   CBufferFloat* prev = prevLayer.getGradient();
   if(!cPolinomSupport.SetGradient(cPolinomSupport.getPrevOutput(), false) ||
      !prevLayer.SetGradient(prevLayer.getPrevOutput(), false) ||
      !cSpatEncoder.calcInputGradients(prevLayer, cPolinomSupport.AsObject()) ||
      !SumAndNormilize(temp, cPolinomSupport.getGradient(), temp,
                       cSpatEncoder.GetCount(), false, 0, 0, 0, 1) ||
      !SumAndNormilize(prev, prevLayer.getGradient(), prev,
                       cSpatEncoder.GetCount(), false, 0, 0, 0, 1) ||
      !cPolinomSupport.SetGradient(temp, false) ||
      !prevLayer.SetGradient(prev, false))
      return false;
   if(prevLayer.Activation() != None)
      if(!DeActivation(prevLayer.getOutput(), prev, prev, prevLayer.Activation()))
         return false;
我们审慎地将这两个信息流中的数据相加。
接下来,反向传播沿计算链继续向前面的层推进——我们需要将切比雪夫多项式的误差梯度向下传递至嵌入层,同时保持信息流的连续性。
//---
   if(!cNormSupport.CalcHiddenGradients(cPolinomSupport.AsObject()))
      return false;
   if(!cSupport.CalcHiddenGradients(cNormSupport.AsObject()))
      return false;
   if(!MatMulGrad(cEmbedding.getOutput(), cEmbedding.getPrevOutput(),
                  cEmbeddingT.getOutput(), cEmbeddingT.getGradient(),
                  cSupport.getGradient(),
                  cEmbeddingT.GetCount(), cEmbeddingT.GetWindow(), cEmbeddingT.GetCount(), 1, false))
      return false;
   if(!cEmbedding.CalcHiddenGradients(cEmbeddingT.AsObject()))
      return false;
   if(!SumAndNormilize(cEmbedding.getGradient(), cEmbedding.getPrevOutput(), cEmbedding.getGradient(),
                       cEmbeddingT.GetWindow(), false, 0, 0, 0, 1))
      return false;
   if(cEmbedding.Activation() != None)
      if(!DeActivation(cEmbedding.getOutput(), cEmbedding.getGradient(),
                       cEmbedding.getGradient(), cEmbedding.Activation()))
         return false;
//---
   return true;
  }
因此,该方法遵循一条精心设计的反馈路径,其中每一层都恰好接收到分配给它的那部分校正信号。 这可以降低梯度发散的风险,提高训练稳定性,并使优化过程更易于控制。
参数更新方法的实现极为简洁,而这正是它的优势所在。 它并不干预各个模块的计算过程,而是把相应工作交由对应组件完成。
bool CNeuronHimNetEncoder::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cEmbedding.UpdateInputWeights())
      return false;
   if(!cTempEncoder.updateInputWeights(NeuronOCL, cPolinomSupport.AsObject()))
      return false;
   if(!cSpatEncoder.updateInputWeights(NeuronOCL, cPolinomSupport.AsObject()))
      return false;
//---
   return true;
  }
对于想要深入了解细节的读者,该类及其所有方法的完整代码已包含在附件中——您可以根据自己的节奏进行学习。
解码器
在实现HimNet框架各项方法的收尾阶段,我们将转向最后一个同样重要的组件:解码器。 编码器作为信息收集者,将数据压缩并组织成一种紧凑的表示形式;而解码器则像一位技艺娴熟的修复师:它从潜空间中一层一层地重建原始表示,将数据恢复到人们熟悉的形式,但此时数据已得到丰富,并去除了多余的噪声。
class CNeuronHimNetDecoder    :  public CNeuronBaseOCL
  {
protected:
   CNeuronConvOCL             cProjection;
   CNeuronTransposeOCL        cProjectionT;
   CNeuronConvOCL             cEmbedding;
   CNeuronBaseOCL             cSupport;
   CNeuronSoftMaxOCL          cNormSupport;
   CChebPolinom               cPolinomSupport;
   CLayer                     cGRCUs;
   CBufferFloat               bSupportAccum;
   CBufferFloat               bEmbeddingAccum;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *prevLayer) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronHimNetDecoder(void) {};
                    ~CNeuronHimNetDecoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint window_out,
                          uint cheb_k, uint layers, uint embed_dim,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronHimNetDecoder;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual bool      Clear(void) override;
  };
从架构上来看,解码器延续了编码器的设计思路,并与之保持对称,使整个网络结构更加均衡且易于理解。 然而,编码器中的空间嵌入和时间嵌入可以分别生成并相互补充,而解码器与之不同,它使用单一的时空嵌入,该嵌入基于编码器输出的潜在表示生成。 同一潜在表示也是构建切比雪夫多项式的基础,这些多项式用于在重建时间序列时逼近复杂的动态变化。
在熟悉解码器的架构后,下一步就是依次初始化其所有内部组件。 Init方法首先将控制权传递给父类,由父类来初始化基础接口。
bool CNeuronHimNetDecoder::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                uint units, uint window, uint window_out,
                                uint cheb_k, uint layers, uint embed_dim,
                                ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, window_out * units, optimization_type, batch))
      return false;
接下来,创建源数据投影层cProjection以及对所得投影进行转置的对象cProjectionT。
   int index = 0;
   if(!cProjection.Init(0, index, OpenCL, window, window, embed_dim, units, 1, optimization, iBatch))
      return false;
   SetActivationFunction(TANH);
   index++;
   if(!cProjectionT.Init(0, index, OpenCL, units, embed_dim, optimization, iBatch))
      return false;
前者采用TANH激活函数,从而能够基于从编码器接收的潜在表示,正确构建时空表示。
接下来,创建嵌入生成层cEmbedding,其维度分别对应神经元数量和特征维度。 这些嵌入用于循环块中的后续计算。
   index++;
   if(!cEmbedding.Init(0, index, OpenCL, units, units, 1, 1, embed_dim, optimization, iBatch))
      return false;
   SetActivationFunction(SIGMOID);
   index++;
   if(!cSupport.Init(0, index, OpenCL, units * units, optimization, iBatch))
      return false;
   cSupport.SetActivationFunction(None);
   index++;
   if(!cNormSupport.Init(0, index, OpenCL, cSupport.Neurons(), optimization, iBatch))
      return false;
   cNormSupport.SetHeads(units);
   cNormSupport.SetActivationFunction(None);
   index++;
   if(!cPolinomSupport.Init(0, index, OpenCL, units, cheb_k, optimization, iBatch))
      return false;
cSupport和cNormSupport对象在为切比雪夫多项式准备数据时起着关键作用。 首先,cSupport生成一个对角相关矩阵,该矩阵反映了各种特征或时间流之间的关系。随后,cNormSupport将该矩阵中的值归一化到统一的尺度,以确保计算的稳定性和后续操作的正确性。 该归一化矩阵是cPolinomSupport模块的基础,该模块以此构建切比雪夫多项式,并将其用于GCRU图循环块的计算中。 这种方法既能对特征之间的复杂关系进行建模,又能确保计算过程的准确性和一致性。
下一步是创建一个cGRCUs容器,用于存放GCRU图循环块。 各个块依次添加到容器中:第一个块的特征空间大小设为与输入数据相匹配,而所有后续块均使用固定的张量大小。
//---
   cGRCUs.Clear();
   cGRCUs.SetOpenCL(OpenCL);
   index++;
   CNeuronHimNetGCRU *temp = new CNeuronHimNetGCRU();
   if(!temp ||
      !temp.Init(0, index, OpenCL, units, window, window_out, cheb_k, embed_dim, optimization, iBatch) ||
      !cGRCUs.Add(temp))
     {
      DeleteObj(temp);
      return false;
     }
   for(uint i = 1; i < layers; i++)
     {
      index++;
      temp = new CNeuronHimNetGCRU();
      if(!temp ||
         !temp.Init(0, index, OpenCL, units, window_out, window_out, cheb_k, 2 * embed_dim, optimization, iBatch) ||
         !cGRCUs.Add(temp))
        {
         DeleteObj(temp);
         return false;
        }
     }
所有模块都绑定到了OpenCL上下文中,从而加快了计算速度。
缓冲区bSupportAccum和bEmbeddingAccum被分配用于存储误差梯度的中间结果。
   bSupportAccum.BufferFree();
   bSupportAccum.Clear();
   if(!bSupportAccum.BufferInit(cPolinomSupport.Neurons(), 0) ||
      !bSupportAccum.BufferCreate(OpenCL))
      return false;
   bEmbeddingAccum.BufferFree();
   bEmbeddingAccum.Clear();
   if(!bEmbeddingAccum.BufferInit(cEmbedding.Neurons(), 0) ||
      !bEmbeddingAccum.BufferCreate(OpenCL))
      return false;
//---
   SetActivationFunction((ENUM_ACTIVATION)temp.Activation());
   if(!SetOutput(temp.getOutput(), true) ||
      !SetGradient(temp.getGradient(), true))
      return false;
//---
   return true;
  }
最后,将最后一个块的激活函数以及输出缓冲区和误差梯度的指针与整个解码器同步,完成初始化。 这样既避免了不必要的数据复制,又确保了模型已准备好进行训练和前向传播。 每个步骤都会经过彻底检查:如果发生任何错误,该方法将返回false,从而防止模型进入错误状态,并确保后续计算的稳定性。
在成功初始化解码器的所有组件后,我们将继续实现前向传播方法,这是信号处理的核心。 在此阶段,待分析的信息依次流经几个相互连接的模块,每个模块都执行特定的功能,从而确保模型能够准确且协调地运行。
bool CNeuronHimNetDecoder::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cProjection.FeedForward(NeuronOCL))
      return false;
   if(!cProjectionT.FeedForward(cProjection.AsObject()))
      return false;
   if(!MatMul(cProjection.getOutput(), cProjectionT.getOutput(), cSupport.getOutput(),
              cProjectionT.GetCount(), cProjectionT.GetWindow(), cProjectionT.GetCount(), 1, false))
      return false;
   if(!cNormSupport.FeedForward(cSupport.AsObject()))
      return false;
在初始阶段,信号由cProjection和cProjectionT模块进行处理,这些模块将源数据转换为指定维度的潜在表示。 所得张量经过矩阵乘法运算,从而得到一个对角相关矩阵。 接下来,使用SoftMax函数对该矩阵进行归一化处理。 这种归一化对于在cPolinomSupport模块中生成切比雪夫多项式至关重要,因为它能确保计算的稳定性,并保证每个元素对后续层的影响按正确比例进行缩放。
   if(!cPolinomSupport.FeedForward(cNormSupport.AsObject()))
      return false;
//---
   if(!cEmbedding.FeedForward(cProjectionT.AsObject()))
      return false;
接下来,在cEmbedding模块中生成嵌入,为数据的隐藏特征提供紧凑且信息丰富的表示。
数据准备就绪后,信号被发送至第一个GCRU块,该块位于cGRCUs容器中,负责对信息进行图循环处理。 后续的每个 GCRU 块都将前一个块的输出作为其输入,这使得解码器能够捕捉时间和空间上的依赖关系,并识别历史数据中的复杂模式。
   CNeuronHimNetGCRU* current = NULL;
   CNeuronBaseOCL* inputs = NeuronOCL;
   for(int i = 0; i < cGRCUs.Total(); i++)
     {
      current = cGRCUs[i];
      if(!current ||
         !current. Feedforward(NeuronOCL, cPolinomSupport.AsObject(), cEmbedding.AsObject()))
         return false;
      inputs = current;
     }
//---
   return true;
  }
经过这些连续的变换,解码器的最终输出便形成了。 这种方法既能确保模型运行的一致性,又能优化计算资源的利用,这在处理大量金融数据以及基于历史时间序列进行训练时尤为重要。
您可能已经注意到,解码器的运行算法十分自然地继承了上文所述编码器中展示的逻辑。 因此,我建议您自行详细研究反向传播方法。 附件中提供了包含所有方法的完整类代码。
测试
既然我们已经组装好了HimNet框架的所有关键组件,现在是时候进入最有趣的阶段了——对模型进行训练和测试。 我们的目标始终如一:打造一个能够独立分析市场并做出决策的交易系统。 在此方案中,HimNet充当环境状态编码器,为当前市场状况生成简洁且信息丰富的表示。 Actor依据这一表示选择行动,而Critic则评估动作的质量并提供反馈,使策略得以调整。
训练分为两个相辅相成的阶段,既能打下坚实的基础,又能提供在真实市场条件下运行所需的灵活性。 在第一阶段,即离线训练阶段,我们使用EURUSD货币对2024年全年的H1时间周期历史数据进行了充分训练。 这一时期涵盖了各种市场状况——平稳的横盘整理、稳定的趋势、波动率的急剧上升以及市场噪音加剧的时期——因此成为该模型的绝佳训练场。
第二阶段是在线微调。 该模型在MetaTrader 5策略测试器中按顺序处理K线流,该测试器能尽可能逼真地模拟真实交易。 这一阶段展现出的特性与离线训练截然不同:能够容忍噪声、对流动性变化作出适当反应,并能应对延迟和滑点。 我们细致地模拟了真实的交易执行条件,以确保模型在转入真实市场环境后,其行为仍保持可预测性。
最后也是最严格的验证阶段是在一个完全独立的样本上进行的——即2025年1月至3月的报价数据。 在此过程中,所有模型参数均保持冻结状态。 此类测试客观地反映了实际有效性:即算法在新条件下仍能保持稳定,且其行为具有可预测性。
测试结果如下所示。
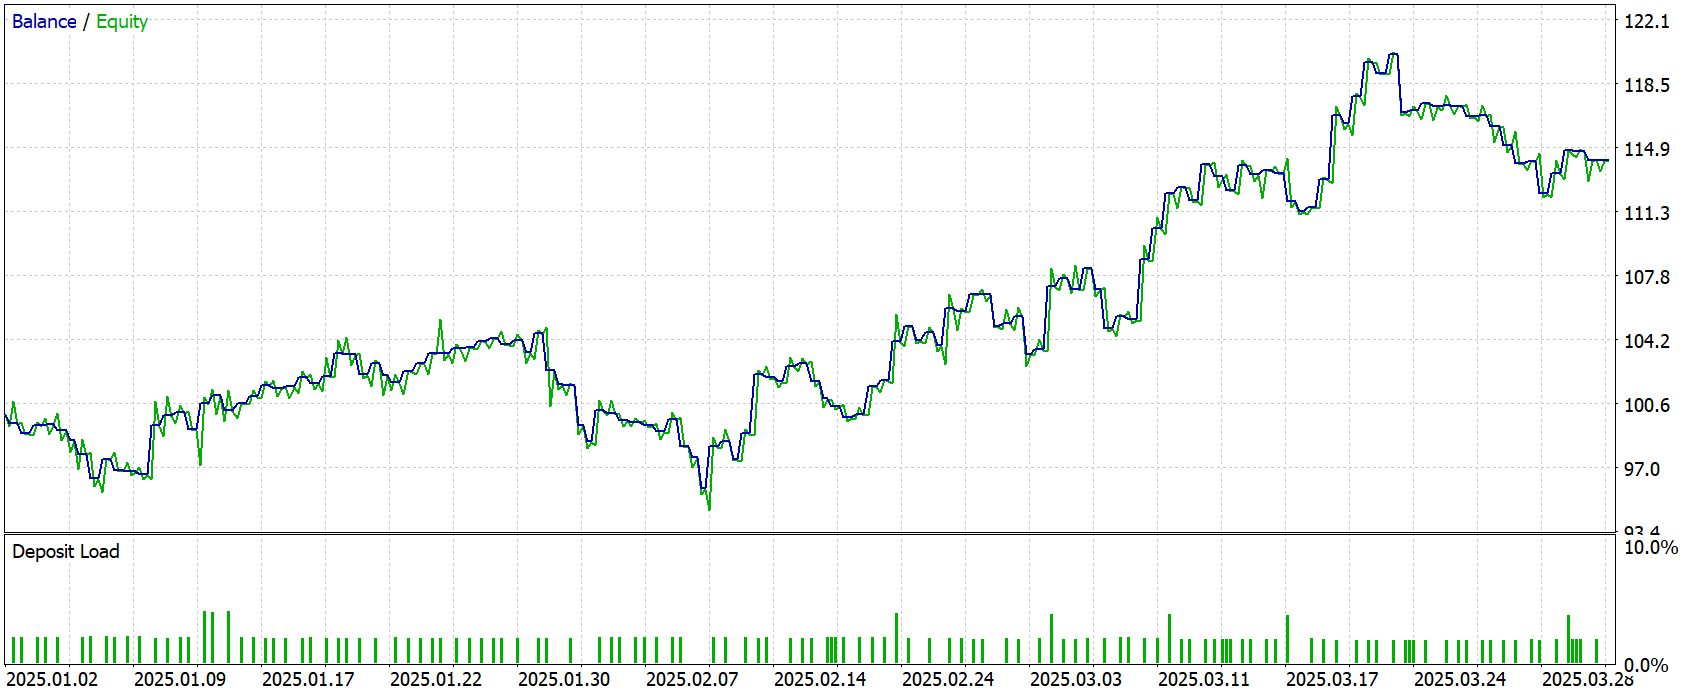
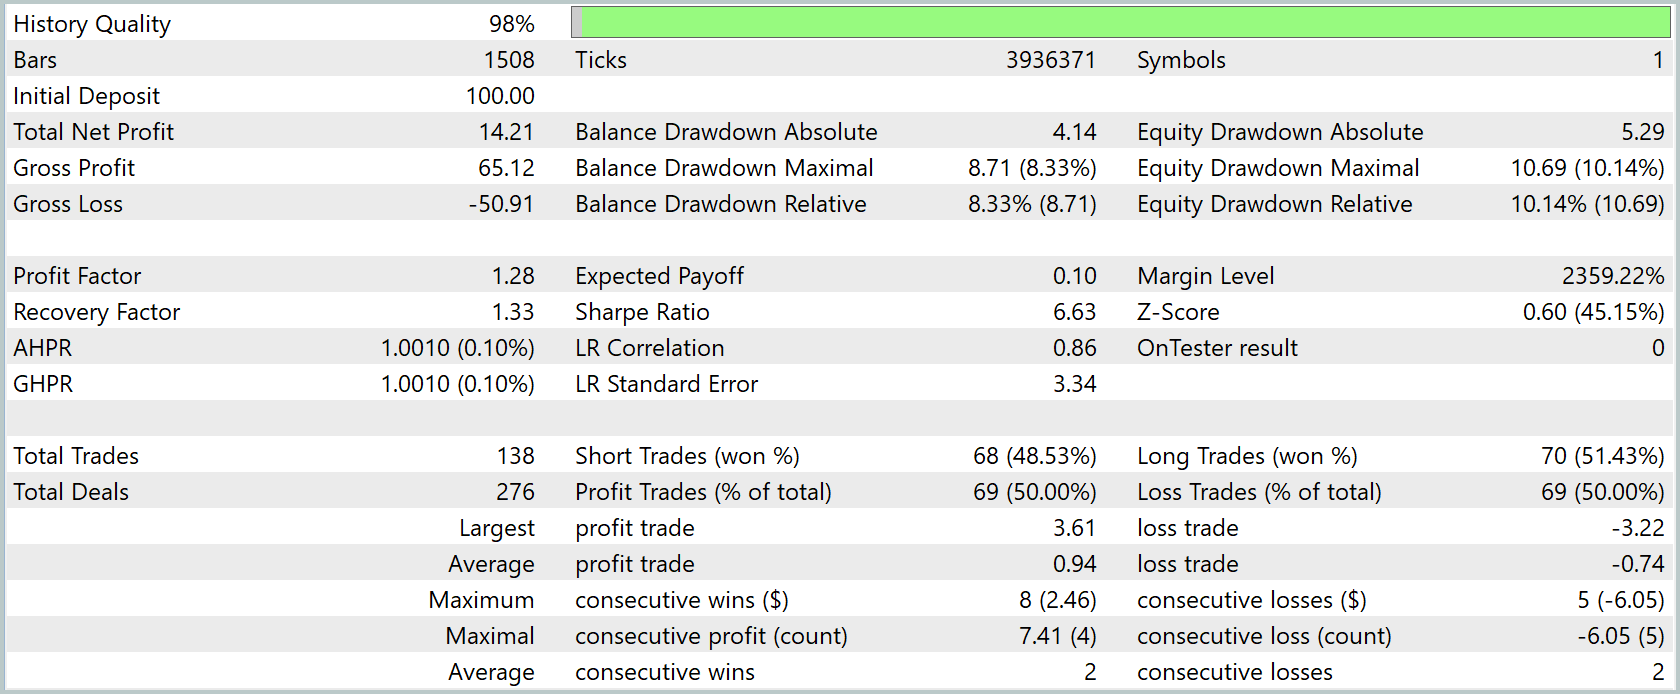
在为期三个月的测试期间,净利润达到了初始资本的14.21%。 总盈利与总亏损之比为1.28,即每亏损1美元对应约1.28美元的利润,而每笔交易的期望收益仅为0.10美元。 恢复因子为1.33,表明净利润总额超过了最大余额回撤。
回撤幅度似乎较为温和:按余额计算的绝对回撤为4.14美元,按净值计算的绝对回撤为5.29美元,而最大相对回撤率分别为8.33%和10.14%。 与此同时,利润曲线呈现出稳步增长的态势,时间趋势相关系数为0.86,也印证了这一点。
在整个测试过程中,该智能交易系统共执行了138笔交易,买入和卖出交易数量几乎各占一半,且无论买入还是卖出,盈利交易的占比均接近50%。 每笔盈利交易的平均利润为0.94美元,每笔亏损交易的平均亏损为0.74美元,最大单笔盈利达到3.61美元,最大单笔亏损为3.22美元。 平均而言,持仓时间略超过一小时,持仓时间范围在57分钟至两小时之间,这表明其交易风格明显属于短期日内交易。
综合来看,这些结果表明该策略虽然相当稳定,但盈利能力仅属中等。 其优势包括可控的回撤、买卖两个方向上表现一致,以及正的交易期望收益。 其不足在于盈利因子仅略高于1,安全余量有限,且单笔平均利润偏低,这可能使其在实盘账户中对点差和佣金较为敏感。
结论
本文完成了对HimNet框架所采用方法的MQL5实现工作。 该框架的主要优势在于其架构灵活性,以及能够适应与时间序列预测和分析相关的各种任务。
对未包含在训练集中的新报价进行的最终测试结果显示出积极的趋势。 该模型的账户余额稳步增长,表明其能够有效适应不断变化的市场环境。
链接
本文中使用的程序
| # | 名称 | 类型 | 描述 |
|---|---|---|---|
| 1 | Study.mq5 | 智能交易系统 | 用于模型离线训练的智能交易系统 |
| 2 | StudyOnline.mq5 | 智能交易系统 | 用于模型在线训练的智能交易系统 |
| 3 | Test.mq5 | 智能交易系统 | 用于模型测试的智能交易系统 |
| 4 | Trajectory.mqh | 类库 | 描述系统状态和模型架构的结构体 |
| 5 | NeuroNet.mqh | 类库 | 用于创建神经网络的类库 |
| 6 | NeuroNet.cl | 库 | OpenCL程序的代码库 |
本文由MetaQuotes Ltd译自俄文
原文地址: https://www.mql5.com/ru/articles/19286
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。



