

交易中的神经网络:以分解替代规模化 —— 模块构建
 101
 0

引言
在前一篇文章中,我们开始实现SSCNN框架作者提出的思路,实现自研版本。本文将继续推进,讲解框架核心组件的工程实现。然而,在深入代码与算法之前,先回顾SSCNN的优势与运行原理十分必要。理解底层原理之后,您不仅可以复现这套实现,还能结合真实交易场景灵活改造。
SSCNN(分段结构化卷积神经网络)架构是一款专门面向市场不稳定、信号碎片化场景的时间序列分析工具。其核心理念是不对单点数值单独运算,而是以完整数据段作为处理单元,让模型同时捕捉局部特征与大范围上下文依赖关系。SSCNN不再以线性视角看待时间序列,而是采用分层处理思路:每一个时间区间都放在周边上下文结构中分析,即便噪声水平很高,也能精准提取有效特征。
第一阶段会对数据做结构分解:将信号拆分为若干相对稳定的成分 —— 长期趋势、季节性变化、短期波动与残差噪声。这一步在金融时间序列场景尤为关键,趋势与短期异动承载着不同的分析价值。为每一个分量单独构建处理模型,以此提升分析质量,同时增强结果的可解释性。最终预测结果由各个子模型输出融合汇总得到。
SSCNN重点引入了基于注意力机制的归一化模块(AttnNorm)。该模块一方面稳定模型内部表征,另一方面让模型自适应聚焦信息价值最高的数据片段。在市场剧烈波动的环境下,信号容易被短期脉冲干扰,这种筛选能力保障预测的稳定性与精度。归一化计算会纳入分段上下文信息,同时训练注意力参数,让反向传播过程更有指向性且更高效。
SSCNN框架作者绘制的示意图如下。
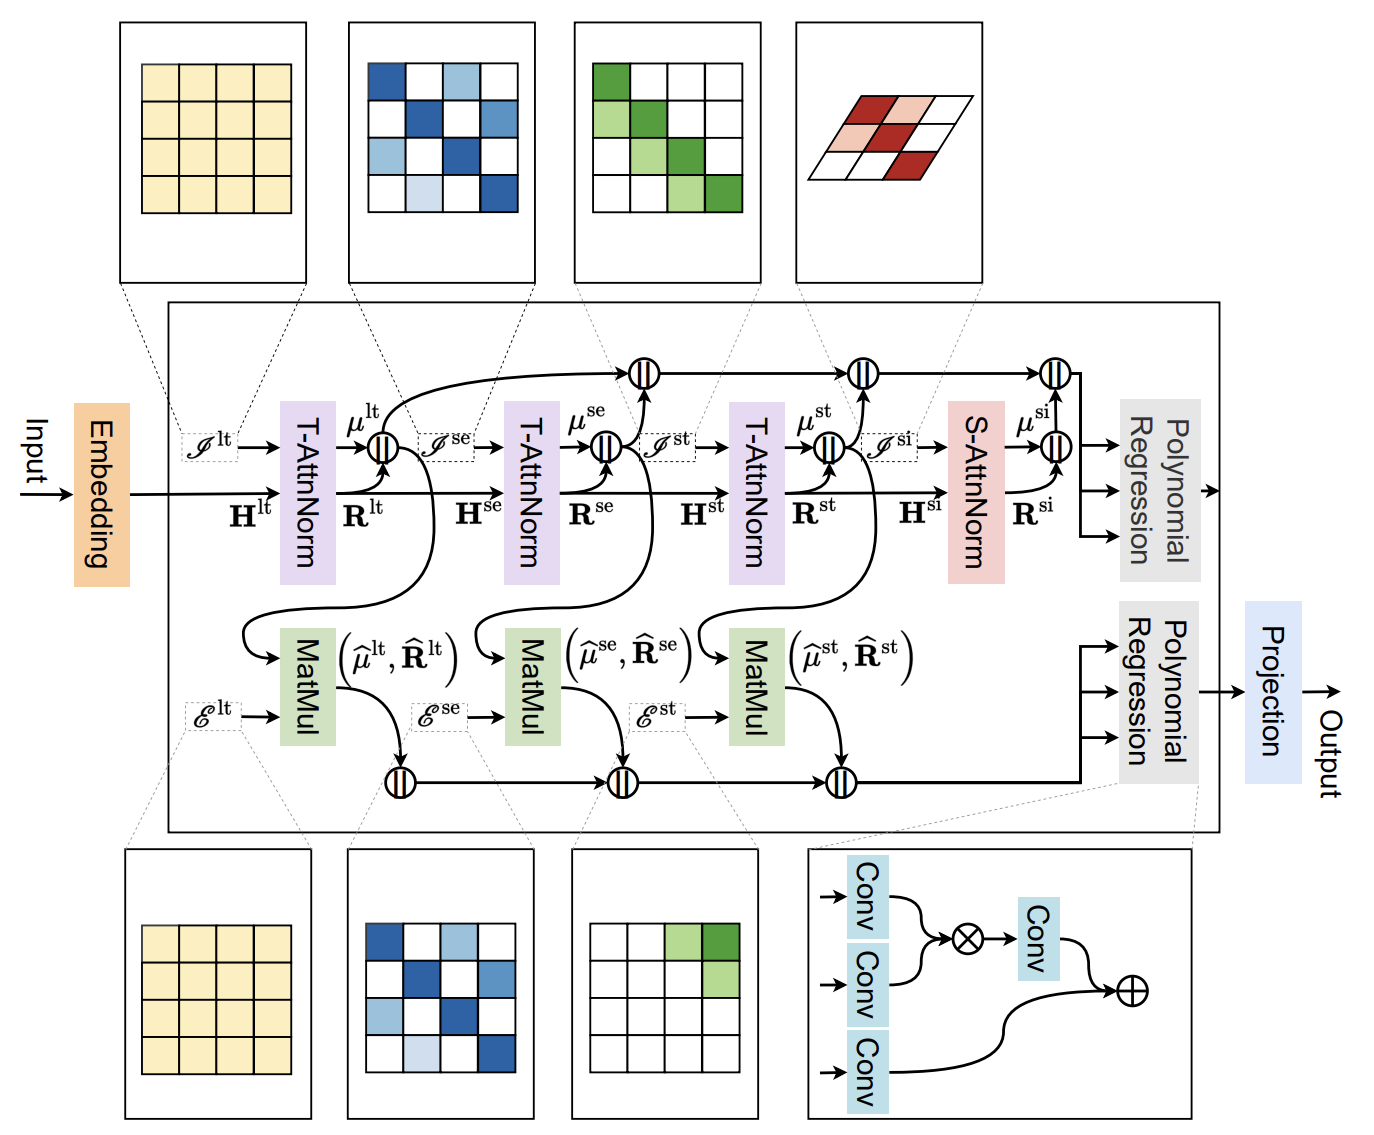
分量提取模块
在前一篇文章的实操部分,我们重点在OpenCL环境下实现了带注意力权重的归一化内核。这项工作为核心运算的高速并行执行打下基础:在数据段内结合注意力权重计算均值和标准差,并对输入信号直接执行归一化。全部运算在GPU上完成,保障方案具备高性能与可扩展性。
现在我们承接上文,重点讲解主程序如何与这些OpenCL内核交互。需要实现配套调度算法:缓冲区准备、调用参数配置、同步控制、传输数据完整性校验。这一步至关重要: SSCNN框架的效果,不只取决于内核数学逻辑是否准确,很大程度上也取决于CPU和GPU之间的数据交互是否规范和顺畅。
整个设计的核心对象是CNeuronAttentNorm。它负责协调注意力归一化层的高层业务逻辑与底层GPU计算。该对象继承自基类CNeuronBaseOCL,继承通用接口,能够灵活接入整体模型链路。该新对象的结构如下。
class CNeuronAttentNorm :  public CNeuronBaseOCL
  {
protected:
   uint                    iPeriod;
   uint                    iVariables;
   uint                    iCount;
   //---
   CParams                 cAttention;
   CNeuronSoftMaxOCL       cSoftMax;
   CNeuronBaseOCL          cMeans;
   CNeuronBaseOCL          cSTDevs;
   //---
   virtual bool      AttentNorm(CNeuronBaseOCL *NeuronOCL);
   virtual bool      AttentNormGrad(CNeuronBaseOCL *NeuronOCL);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronAttentNorm(void) :  iPeriod(0), iVariables(0), iCount(0) {};
                    ~CNeuronAttentNorm(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint period, uint variables,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronAttentNorm; }
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   //---
   CNeuronBaseOCL*   GetMeans(void) { return cMeans.AsObject(); }
   CNeuronBaseOCL*   GetSTDevs(void) { return cSTDevs.AsObject(); }
   virtual uint      GetPeriod(void) const { return iPeriod; }
   virtual uint      GetVariables(void) const { return iVariables; }
   virtual uint      GetUnits(void) const { return iCount; }
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override {  activation = None; }
  };
在该类结构中,核心内部参数包括iPeriod、iVariables和iCount:它们分别定义数据段长度、变量数量,以及一个序列中数据段的总数。这些参数决定待分析数组的结构。
需要重点关注cAttention对象,它存放注意力机制相关参数;还有cSoftMax组件,负责将注意力权重转换为归一化形式。这两个模块紧密配合:可训练的注意力参数先经过SoftMax变换,之后才用于计算均值与标准差。cMeans和cSTDevs对象用于保存这两项统计量。
CNeuronAttentNorm类的所有内部对象均为静态声明,作为内嵌成员分配内存,因此生命周期可控。这种设计让构造函数与析构函数可以留空。资源的分配与释放交由模型生命周期里的显式管理逻辑处理。所有内部成员以及继承而来组件的初始化统一在Init方法中完成,该方法接收运行时环境与层配置参数。
bool CNeuronAttentNorm::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                             uint units_count, uint period, uint variables,
                             ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, units_count * period * variables,
                                                                 optimization_type, batch))
      return false;
   CNeuronBaseOCL::SetActivationFunction(None);
首先,程序控制权会交给父类的同名方法,在该方法中初始化所有继承接口。随后我们显式将激活函数类型设置为None,因为该层本身不做任何非线性变换,仅基于注意力权重执行归一化。
接下来,保存层配置参数:单元块数量(units)、变量数量以及分段周期。这些参数后续用于管控内部归一化逻辑。
   iCount = units_count;
   iVariables = variables;
   iPeriod = period;
我们继续初始化新声明的对象。第一个是cAttention对象,负责生成注意力权重。初始化成功后,关闭其激活函数,保持输出为线性形式。
   if(!cAttention.Init(0, 0, OpenCL, iPeriod * iVariables, optimization, iBatch))
      return false;
   cAttention.SetActivationFunction(None);
   if(!cSoftMax.Init(0, 1, OpenCL, cAttention.Neurons(), optimization, iBatch))
      return false;
   cSoftMax.SetHeads(iVariables);
接下来配置cSoftMax组件,用于将注意力分值转换成概率分布。其维度与cAttention神经元数量保持一致。SetHeads方法用于设置注意力头(attention heads)数量:这里设置为与变量数量相等,使得每一个特征都可以独立处理。
之后创建cMeans对象,用来保存各个数据段的均值。维度大小等于单元块数量乘以变量数量。同样关闭激活函数,因为均值属于统计特征量。
//---
   if(!cMeans.Init(0, 2, OpenCL, iCount * iVariables, optimization, iBatch))
      return false;
   cMeans.SetActivationFunction(None);
   if(!cSTDevs.Init(0, 3, OpenCL, iCount * iVariables, optimization, iBatch))
      return false;
   cSTDevs.SetActivationFunction(None);
//---
   return true;
  }
cSTDevs模块用于存放归一化所需的标准差,配置方式和cMeans完全相同。
至此,Init方法为CNeuronAttentNorm层搭建了稳固的架构基础:把逻辑单元与计算组件整合为一套易于扩展的系统。每个对象各司其职,集中式初始化让我们可以在OpenCL环境下完整管控该层的参数与行为。
所有内部组件初始化完成后,核心步骤就是实现该层的前向传播。模型在这个阶段调用前面初始化好的结构(注意力权重、SoftMax变换、统计量对象),执行核心任务:结合每个元素的重要度对输入数据做归一化。该算法在feedForward方法中实现。
bool CNeuronAttentNorm::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(bTrain)
     {
      if(!cAttention.FeedForward())
         return false;
      if(!cSoftMax.FeedForward(cAttention.AsObject()))
         return false;
     }
//---
   return AttentNorm(NeuronOCL);
  }
该方法接收一个NeuronOCL对象指针作为入参,该对象代表上一层神经网络,存放待分析的数据。
如果模型处于训练模式(bTrain == true),第一步会在cAttention组件中执行前向传播,计算原始注意力分值。这些分值并不直接依赖输入数据的实时状态,而是在模型训练阶段生成。因此,在推理运行阶段,该模块的输出保持不变,无需在每次前向计算时重复执行冗余运算。
随后将注意力系数送入cSoftMax模块,被转换为归一化的概率分布。这一步至关重要:它保证单个数据段内所有注意力权重之和为1,以此保障后续计算的正确性。
无论当前是训练模式还是推理模式,feedForward方法的最后一步都会调用AttentNorm函数。该函数是同名OpenCL内核的封装层,负责所有底层准备工作:参数配置、将计算任务送入任务队列等待执行。该方法严格遵循这类调用的标准范式,大量复用前期实现的宏与通用模板。因此本文不再深入拆解AttentNorm的内部实现,只需要把它理解为模型业务逻辑与OpenCL计算环境之间一套规范且可靠的集成入口。
前向传播完成之后,紧接着是同等关键的环节:计算误差梯度,用于模型权重的更新。该逻辑在calcInputGradients方法中实现,遵循清晰的反向传播逻辑。
bool CNeuronAttentNorm::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!AttentNormGrad(NeuronOCL))
      return false;
   if(NeuronOCL.Activation() != None)
      if(!DeActivation(NeuronOCL.getOutput(), NeuronOCL.getGradient(),
                       NeuronOCL.getGradient(), NeuronOCL.Activation()))
         return false;
该方法首先调用AttentNormGrad,与AttentNorm相似,它是同名OpenCL内核的接口。其作用是从归一化后的输出信号中提取梯度,同时纳入注意力特征以及当前数据段参数。这一步十分关键:它为反向推导输入数据对均值、方差这类最终统计量的影响提供计算基础。
接下来进行判断:如果输入层配置了激活函数,则必须结合该非线性函数对得到的梯度做求导处理。这一步通过调用DeActivation函数实现,用来修正梯度,保证完全符合经典反向传播流程。
该方法的最后一步是沿着注意力链路反向传播梯度。具体调用 cAttention对象的 CalcHiddenGradients方法,将SoftMax模块输出的梯度作为参数传入。该流程保证梯度信息可以从输出层持续传递到模型的隐藏参数,并最终传递至输入端。
   if(!cAttention.CalcHiddenGradients(cSoftMax.AsObject()))
      return false;
//---
   return true;
  }
注意力归一化模块的参数更新由updateInputWeights方法完成,该方法根据累积梯度调整内部权重。这里的实现非常简洁:直接委托给负责生成注意力系数的cAttention对象的同名方法。这与SSCNN整体架构保持一致,模型内每个组件只承担属于自己的一部分计算任务。
bool CNeuronAttentNorm::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   return cAttention.UpdateInputWeights();
  }
这套设计让系统具备很高的模块化程度与灵活性:注意力机制被封装在独立对象内,既方便调试,也便于后续适配新场景。此外,这种直接委托调用的写法让代码更加简洁易读,组件也可以直接复用,无需重复编写。
至此,带注意力系数的归一化层相关方法已经探讨完毕。我们完整梳理了整条逻辑链路:从内部对象初始化,到前向传播、反向传播,包含梯度分发与权重更新。需要强调的是,所有核心计算与调度逻辑都封装在一套统一连贯的接口之中。
CNeuronAttentNorm类及其全部方法的完整源码见附件。
空间分量提取
接下来进入架构的下一个逻辑单元,我们会介绍一个用于在注意力归一化过程中提取空间分量的类 —— CNeuronSAttentNorm类,它拓展自CNeuronTransposeOCL。与之前的实现不同,它专门用于处理转置后的数据,从而在处理空间特征与上下文分布特征时更为灵活。
class CNeuronSAttentNorm :   public CNeuronTransposeOCL
  {
protected:
   CNeuronTransposeOCL     cTranspose;
   CNeuronBaseOCL          cAttention;
   CNeuronSoftMaxOCL       cSoftMax;
   CNeuronBaseOCL          cMeans;
   CNeuronBaseOCL          cSTDevs;
   CNeuronBaseOCL          cNorm;
   //---
   virtual bool      AttentNorm(CNeuronBaseOCL *NeuronOCL);
   virtual bool      AttentNormGrad(CNeuronBaseOCL *NeuronOCL);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSAttentNorm(void) {};
                    ~CNeuronSAttentNorm(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint variables,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronSAttentNorm; }
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   //---
   CNeuronBaseOCL*   GetMeans(void) { return cMeans.AsObject(); }
   CNeuronBaseOCL*   GetSTDevs(void) { return cSTDevs.AsObject(); }
   virtual uint      GetVariables(void) const { return iWindow; }
   virtual uint      GetUnits(void) const { return iCount; }
   //---
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override {  activation = None; }
  };
该类的结构本质上和前面介绍的CNeuronAttentNorm层互为镜像,但二者在注意力系数的生成方式上存在关键区别:归一化本身是沿窗口内的特征轴方向执行的。
和之前一样,CNeuronSAttentNorm对象在同名的Init方法中完成初始化,该方法负责对层内所有组件做正确配置,为前向传播与反向传播做好准备。
bool CNeuronSAttentNorm::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                              uint units_count, uint variables,
                              ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronTransposeOCL::Init(numOutputs, myIndex, open_cl, units_count, variables,
                                                            optimization_type, batch))
      return false;
   activation = None;
首先,该方法调用父类CNeuronTransposeOCL的同名初始化函数,完成当前层基础参数以及继承接口的配置。之后,显式将激活函数设置为None,因为该阶段不施加非线性激活变换。
接下来,依次初始化全部内部对象,每个对象在计算流程中承担特定职责。cTranspose对象负责对输入张量做转置,把时间切片转换为特征向量,供给后续注意力模块处理。
   if(!cTranspose.Init(0, 0, OpenCL, iWindow, iCount, optimization, iBatch))
      return false;
创建并配置cAttention对象;在本层中,它仅作为缓存,用于存放注意力系数。
   if(!cAttention.Init(0, 1, OpenCL, iWindow * iWindow, optimization, iBatch))
      return false;
   cAttention.SetActivationFunction(None);
   if(!cSoftMax.Init(0, 2, OpenCL, cAttention.Neurons(), optimization, iBatch))
      return false;
   cSoftMax.SetHeads(iWindow);
紧随其后的是配套的cSoftMax模块,它沿着指定维度(此处为特征维度)对权重做归一化。
初始化均值对象cMeans和标准差对象cSTDevs,后续数据缩放与对齐需要依靠这两个统计量。
   if(!cMeans.Init(0, 3, OpenCL, iCount, optimization, iBatch))
      return false;
   cMeans.SetActivationFunction(None);
   if(!cSTDevs.Init(0, 4, OpenCL, iCount, optimization, iBatch))
      return false;
   cSTDevs.SetActivationFunction(None);
最后配置cNorm对象,它是一块缓冲区,保存归一化之后的数据,等待再次转置恢复为时间序列形式。
   if(!cNorm.Init(0, 5, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cNorm.SetActivationFunction(None);
//---
   return true;
  }
初始化完成后,CNeuronSAttentNorm对象就具备完整运行能力,接下来进入核心环节 —— 前向传播。该方法是数据处理的核心,依靠层内各个计算单元逐步完成数据变换。
bool CNeuronSAttentNorm::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cTranspose.FeedForward(NeuronOCL))
      return false;
前向传播首先调用cTranspose中的FeedForward方法,完成输入张量的初次变换。这一步会重组数据结构,将时间窗口展开为空间表征形式。这为后续注意力矩阵计算做准备:矩阵内每一个特征都会和其余所有特征做相关性比对。
下一步,调用MatMul函数,将输入数据与其自身的转置矩阵相乘。由此生成注意力矩阵:矩阵每一行是一组注意力分值,表示其余各元素与当前特征的相关程度。运算结果存入cAttention对象,也就是未经归一化的原始注意力图。
   if(!MatMul(NeuronOCL.getOutput(), cTranspose.getOutput(), cAttention.getOutput(),
              iWindow, iCount, iWindow, 1, false))
      return false;
   if(!cSoftMax.FeedForward(cAttention.AsObject()))
      return false;
得到注意力矩阵之后,需要对其归一化。调用cSoftMax的FeedForward,把数值转换为概率权重,保证后续计算具备可解释性与数值稳定性。
生成的注意力权重传入AttentNorm方法,该方法承载本层的核心思路:基于算出的注意力系数,对输入数据做缩放与归一化。该步骤融合窗口内的均值和标准差统计信息,同时考量每个特征的重要度;即便数据噪声与偏差水平较高,模型依旧能够识别其中的结构性模式。
   if(!AttentNorm(cTranspose.AsObject()))
      return false;
//---
   return CNeuronTransposeOCL::feedForward(cNorm.AsObject());
  }
最后一步,将执行权交给基类CNeuronTransposeOCL的feedForward方法,在该方法中对归一化后的张量cNorm做处理。由此把输出结果还原为输入数据原本的表征形式。
介绍完前向传播,接下来讲解同等重要的环节 —— 反向传播。calcInputGradients方法负责计算梯度,训练阶段依靠这些梯度调整模型权重与参数。该方法按顺序逐步执行一系列运算,将误差信号从模型输出层回传至输入层,过程中兼顾所有内部变换,包括注意力机制与归一化操作。
bool CNeuronSAttentNorm::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
//---
   if(!CNeuronTransposeOCL::calcInputGradients(cNorm.AsObject()))
      return false;
流程首先做基础校验,检查待传入误差梯度的输入对象指针NeuronOCL是否有效。随后调用父类的calcInputGradients,传入对象改为cNorm,也就是注意力模块的归一化输出。这一步保证梯度可以沿着前向传播的最后一步链路正确回传。
下一步调用核心的AttentNormGrad方法,它是同名OpenCL内核的配套反向接口。此处需要完整纳入前面所有统计变换以及注意力权重的影响,确保误差传播逻辑自洽。
   if(!AttentNormGrad(cTranspose.AsObject()))
      return false;
之后,调用cAttention对象的CalcHiddenGradients方法,把误差从SoftMax的概率权重层反向传递到注意力系数。这一步十分关键:由于注意力权重本身由多个输入变量共同决定,求梯度时需要特殊处理。
   if(!cAttention.CalcHiddenGradients(cSoftMax.AsObject()))
      return false;
   if(!MatMulGrad(NeuronOCL.getOutput(), PrevOutput,
                  cTranspose.getOutput(), cTranspose.getPrevOutput(),
                  cAttention.getGradient(),
                  iWindow, iCount, iWindow, 1, false))
      return false;
接下来,调用MatMulGrad函数,它是前向传播矩阵乘法对应的反向运算。运算会用到原始输入数据以及它的转置副本,从而计算出梯度,同时保留窗口内各元素之间的内在关联。
然而,需要注意的是,在转置数据维度上,我们已经拿到归一化主数据流上的误差梯度。除此之外,还需要把梯度从转置对象回传到原始输入维度。因此,本阶段会把算出的误差梯度暂存至辅助数据缓冲区。
下一步,在转置对象层面,对两条信息链路得到的误差梯度做求和。
   if(!SumAndNormilize(cTranspose.getGradient(), cTranspose.getPrevOutput(), cTranspose.getGradient(),
                       iWindow, false, 0, 0, 0, 1))
      return false;
我们再把合并后的梯度传递到原始输入维度,同样对两条信息链路的梯度进行累加。
   if(!NeuronOCL.CalcHiddenGradients(cTranspose.AsObject()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), getPrevOutput(), NeuronOCL.getGradient(),
                       iCount, false, 0, 0, 0, 1))
      return false;
//---
   if(NeuronOCL.Activation() != None)
      if(!DeActivation(NeuronOCL.getOutput(), NeuronOCL.getGradient(),
                       NeuronOCL.getGradient(), NeuronOCL.Activation()))
         return false;
//---
   return true;
  }
最后,如果输入数据经过了激活函数处理,则会调用DeActivation方法求取该激活函数的导数。至此梯度传播链路闭合,保证误差信号完整反向流经所有变换阶段。
这里需要重点说明的是,这套用于提取空间分量、融合注意力与归一化的算法,不存在常规意义上的可训练参数 —— 也就是没有权重、偏置,也没有任何需要通过梯度下降优化的内部系数。全部计算仅依赖输入数据的实时取值、样本统计量,以及用于生成注意力分布的SoftMax函数。
因此,在此示例中,没有重写负责每轮传播后更新模型参数的updateInputWeights方法。本层直接沿用继承自父类的空桩实现。该方案契合项目整体架构:不会提升模型复杂度,无需额外计算,同时体现该层在整个神经网络体系中属于辅助结构性组件的定位。
该类及其全部方法的完整代码参见附件。它的结构体现出经过周密考量的架构设计,并且和前面已经实现的组件深度集成,便于在更复杂的神经网络架构中扩展与复用。
多项式回归模块
接下来需要实现的组件是多项式回归模块。SSCNN框架的作者对该模块架构做了大幅拓展,在加法连接之外新增了乘法交互项。这项扩展让模型能够表达输入分量之间更加复杂、表征能力更强的依赖关系。
为什么需要这样设计?金融时间序列几乎很少服从严格线性或者简单可加的变化模式。现实场景里,趋势、周期、季节性与噪声交织在一起,经常涌现复杂的非线性关联。传统多项式回归即便设置很高的自由度,往往依然缺乏足够的灵活性来精准刻画这类效应。
为了充分捕捉二阶乃至更高阶的交互作用,输入信号会并行走两条分支处理:
- 加法分支:由卷积层实现,用于捕捉独立特征之间的线性与弱非线性关系;
- 乘法分支:由一组卷积层构成。该分支实现了基于上下文的特征调制,可以刻画特征的非线性组合,以及各个分量之间的相互增强或抑制效应。
在我们的实现中更进一步,在乘法分支里引入了SwiGLU激活函数。这是一种现代且效果优异的非线性激活,能够提升模型的可训练容量,同时不会显著增加参数量。
CNeuronPolynomialRegression对象实现了扩展版多项式回归层,是一套基于OpenCL、面向时间序列预测的神经网络计算链路中的一环。它从基类CNeuronBaseOCL继承核心接口,无需额外适配即可和框架其余部分兼容。该层采用组合式设计原则:每一个内部子模块各司其职,子模块之间相互配合,构成一套复杂而灵活的输入信号处理系统。
class CNeuronPolynomialRegression   :  public CNeuronBaseOCL
  {
protected:
   CNeuronSwiGLUOCL     cProjection;
   CNeuronConvOCL       cConvolution;
   CNeuronConvOCL       cResidual;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronPolynomialRegression(void) {};
                    ~CNeuronPolynomialRegression(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint window, uint window_out,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronPolynomialRegression; }
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   //---
   virtual uint      GetWindowIn(void) const { return cProjection.GetWindow(); }
   virtual uint      GetWindowOut(void) const { return cResidual.GetFilters(); }
   virtual uint      GetUnits(void) const { return cProjection.GetUnits(); }
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { }
  };
该类包含三个核心组件:基于SwiGLU机制的cProjection投影模块,是第一个数据变换单元。它负责特征扩展,为后续处理做好准备。除此之外,还有两层卷积层,分别用于捕捉残差关系与乘法交互关系。这种划分方式可以融合特征间的加法关系以及多项式(二阶及更高阶)关系,在不过度复杂化模型结构的前提下,提升模型的表征能力。
该类的内部架构将所有组件声明为静态成员。也就是说,这些组件仅在初始化阶段创建一次,无需动态内存分配,也不用手动管理生命周期。该设计方案简化结构、降低开销,并且不需要显式定义类的构造函数与析构函数 —— 这两个方法直接留空,凸显该结构简洁、自包含的特点。
整套内部架构在Init方法中完成配置,该方法实质上负责初始化本层的计算图。
bool CNeuronPolynomialRegression::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                       uint units_count, uint window, uint window_out,
                                       ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, units_count * window_out,
                                                         optimization_type, batch))
      return false;
   activation = None;
第一步,调用父类的基础初始化方法。该调用完成内存分配与计算缓冲区绑定的基础工作。之后,显式将本层激活函数设置为None,因为激活逻辑已经内嵌在下层子模块的结构之中。
接下来,依次初始化层内各个组件。cProjection投影模块作为信号处理的第一阶段完成配置:接收输入数据,按照指定单元数量与窗口尺寸做特征扩充。其配置决定了本层的数据吞吐能力,同时为后续回归计算打下基础。
   if(!cProjection.Init(0, 0, OpenCL, window, window, window_out, units_count, 1,
                                                            optimization, iBatch))
      return false;
   if(!cConvolution.Init(0, 1, OpenCL, window_out, window_out, window_out, units_count,
                                                              1, optimization, iBatch))
      return false;
   cConvolution.SetActivationFunction(None);
之后,初始化cConvolution,该模块负责捕捉多项式关系。投影模块的输出送入该卷积模块,其维度和结果窗口保持一致。该组件关闭激活函数,这里使用纯卷积,不对信号做非线性畸变。
最后,初始化cResidual对象。它同样处理原始输入数据,但执行不带乘法交互的标准卷积,用于拟合线性分量。
   if(!cResidual.Init(0, 2, OpenCL, window, window, window_out, units_count, 1, optimization, iBatch))
      return false;
   cResidual.SetActivationFunction(None);
三个组件全部初始化成功后,同步层之间的梯度缓冲区。将cConvolution的梯度作为当前层以及cResidual的主梯度。以此保证模型参数调整方向统一,同时避免不必要的数据拷贝。
   if(!SetGradient(cConvolution.getGradient(), true))
      return false;
   if(!cResidual.SetGradient(getGradient(), true))
      return false;
//---
   return true;
  }
如果所有初始化步骤无报错,则方法返回true,代表本层就绪可用。整套配置逻辑高度集中,使组件行为可预测、可管控,且不易受系统其他部分错误的影响。
介绍完初始化方法后,我们来到计算的核心 —— feedForward方法实现的前向传播。
bool CNeuronPolynomialRegression::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cProjection.FeedForward(NeuronOCL))
      return false;
   if(!cConvolution.FeedForward(cProjection.AsObject()))
      return false;
首先,把输入数据交给投影模块cProjection,传入上一层神经网络对象指针。该阶段一旦出错,函数直接返回false。
执行成功后,SwiGLU变换的输出送入卷积模块cConvolution,用于生成二次交互分量;此处同样校验执行状态,出错则终止后续流程。
将原始输入数据同时送入线性模块cResidual,该模块负责保留信号里纯粹的线性分量。
   if(!cResidual.FeedForward(NeuronOCL))
      return false;
   if(!SumAndNormilize(cConvolution.getOutput(), cResidual.getOutput(),
                       Output, GetWindowOut(), true, 0, 0, 0, 1))
      return false;
//---
   return true;
  }
待三个组件全部完成数据处理后,输出送入SumAndNormilize函数:对两条分支逐元素相加,并按照窗口尺寸归一化。我们将最终结果存入对外接口的输出缓冲区。整个流程一气呵成,保障多项式层稳定且连贯运行。
前向传播执行完毕后,在calcInputGradients方法中启动反向传播。
bool CNeuronPolynomialRegression::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
立即校验输入数据对象指针的有效性。如果指针为空,直接返回false,不再执行后续逻辑。
接下来,将梯度从卷积模块反向传播回投影模块。if(!cProjection.CalcHiddenGradients(cConvolution.AsObject())) return false; //--- if(!NeuronOCL.CalcHiddenGradients(cProjection.AsObject())) return false;
紧接着直接调用输入对象的CalcHiddenGradients,把梯度回传到对应层级。
这部分完成后,开始沿第二条信息链路反向传播误差梯度。首先把当前缓冲区指针存入临时变量temp,防止已经累加好的梯度丢失。为处理残差(线性)分量,先替换输入对象的梯度缓冲区指针,之后再次调用CalcHiddenGradients,分发线性分支对应的误差梯度。
   CBufferFloat* temp = NeuronOCL.getGradient();
   if(!NeuronOCL.SetGradient(NeuronOCL.getPrevOutput(), false) ||
      !NeuronOCL.CalcHiddenGradients(cResidual.AsObject()) ||
      !SumAndNormilize(temp, NeuronOCL.getGradient(), temp,
                       GetWindowIn(), false, 0, 0, 0, 1) ||
      !NeuronOCL.SetGradient(temp, false))
      return false;
//---
   return true;
  }
之后对两条梯度流求和。合并后的梯度通过SetGradient重新赋值给当前神经元。所有操作无异常时返回true,整套梯度链路反向传播完成,保证多项式层权重可以正确更新。
梯度收集就绪后,进入updateInputWeights的权重更新阶段。各个组件依次执行:首先由cProjection投影模块更新内部参数,随后执行权交给cConvolution卷积模块。
bool CNeuronPolynomialRegression::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cProjection.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cConvolution.UpdateInputWeights(cProjection.AsObject()))
      return false;
   if(!cResidual.UpdateInputWeights(NeuronOCL))
      return false;
//---
   return true;
  }
最后,线性模块cResidual完成整条链路的更新,它依据输入数据以及前面得到的误差梯度更新自身权重。这三个阶段中任意一步失败,该方法会立刻返回false;而如果每一轮参数调整都无差错执行,updateInputWeights正常结束并返回true,保证 CNeuronPolynomialRegression的全部组件同步就绪,进入下一轮训练周期。
该类及其全部方法的完整代码参见附件。
今天,我们取得了阶段性突破:SSCNN框架的三个核心组件均已完成开发。不妨稍作停顿,让这些新知识与心得沉淀下来,以更清晰的思路迎接下一阶段。休整之后,我们将以全新的状态进入下一阶段。
在下一篇文章中,我们会把所有模块串联成一条完整计算链路,并开展实打实的实地测试 —— 在历史行情数据上运行算法,评估其稳定性与预测精度。在这个贴近真实场景的试验场上,我们将检验这套方案的有效性与设计水准。当然,我们也会从中总结结论,进一步提升SSCNN的可靠性与性能。
结论
从SSCNN框架的理论描述到代码实现,这一过程充分说明面向金融时序分析的模型开发,在各个层级上都离不开结构化设计与逻辑一致性。框架作者刻意摒弃了“一刀切”的缩放思路,转而采用分解与模块化的设计原则,即便市场噪声很强,这套思路仍能让模型保持良好的可解释性、自适应性与鲁棒性。
CNeuronAttentNorm架构正是这套思路的体现:它融合了语义信息丰富的注意力机制与归一化机制,并在GPU上实现,同时兼顾分段上下文与金融信号本身的特征。针对CPU与GPU之间的数据初始化、传输和同步逻辑做了专门设计,避免了OpenCL并行计算中常见的性能瓶颈。
尤其值得关注的是注意力参数的训练:它使模型能够有选择地聚焦信号中最关键的部分。这不仅是预测精度的提升,更是迈向真正泛化能力的一步:从结构分解到归一化,模型每一个组件都能够和上下文协同工作。
在下一篇文章中,我们将把全部组件整合为一套完整算法,在历史金融数据上开展实地测试。借此评估SSCNN在真实场景下的鲁棒性与预测精度。
参考文献
文中所用的程序
| # | 名称 | 类型 | 描述 |
|---|---|---|---|
| 1 | Study.mq5 | EA | 用于离线模型训练的EA |
| 2 | StudyOnline.mq5 | EA | 用于在线模型训练的EA |
| 3 | Test.mq5 | EA | 模型测试EA |
| 4 | Trajectory.mqh | 类库 | 用于描述系统状态与模型架构的结构体 |
| 5 | NeuroNet.mqh | 类库 | 用于构建神经网络的类库 |
| 6 | NeuroNet.cl | 库 | OpenCL程序代码库 |
本文由MetaQuotes Ltd译自俄文
原文地址: https://www.mql5.com/ru/articles/19103
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。

 市场模拟:仓位视图(四)
 从基础到中级:FileSave 和 FileLoad
 新手在交易中的10个基本错误
 基于平均K线(Heikin Ashi)搭建专业交易系统(第一部分):自定义指标开发
