

交易中的神经网络:时间序列查询模型(结论)
 30
 0

引言
TQNet框架是一套简洁灵活的神经网络建模方案,能够高效处理时序数据与结构化数据。它的核心优势在于融合局部依赖与全局依赖,在分析深度和计算效率之间形成独特平衡。与传统模型结构不同,TQNet将时序数据处理机制与长期依赖捕获方法无缝结合。这一点在金融时序场景中尤为重要,瞬时波动与逐步演化的趋势,二者都不能忽视。
该算法依托一套独创的计算组织方式,全局相关张量在整个计算流程中处于核心地位。它相当于序列元素间关联关系的一张映射图,让模型既可以捕捉局部模式,也能构建对数据结构的全局认知。
TQNet的计算流程由一系列协同步骤构成:第一步,输入数据经过局部特征层,提取当前状态的关键特征;随后激活全局相关机制,把前面所有时序步累积得到的结构化依赖作用于这些特征。这套迭代机制让模型可以灵活适应环境变化,挖掘隐藏模式。其独到之处在于模型不受固定数据流顺序约束 —— 序列内部的关联可以沿任意方向建立,拓展了它在预测与分析任务上的能力边界。
当数据存在噪声或是内部结构复杂时,TQNet的实用价值就会凸显出来。金融市场、气象预测、工业过程分析 —— 在这些场景下,除了预测精度,模型能否抵御异常离群点、适应动态变化同样关键。得益于精心设计的参数更新算法和对计算资源的高效利用,TQNet在大数据集上也能保持稳定表现,且不会过度消耗训练资源。
作者绘制的框架示意图如下。
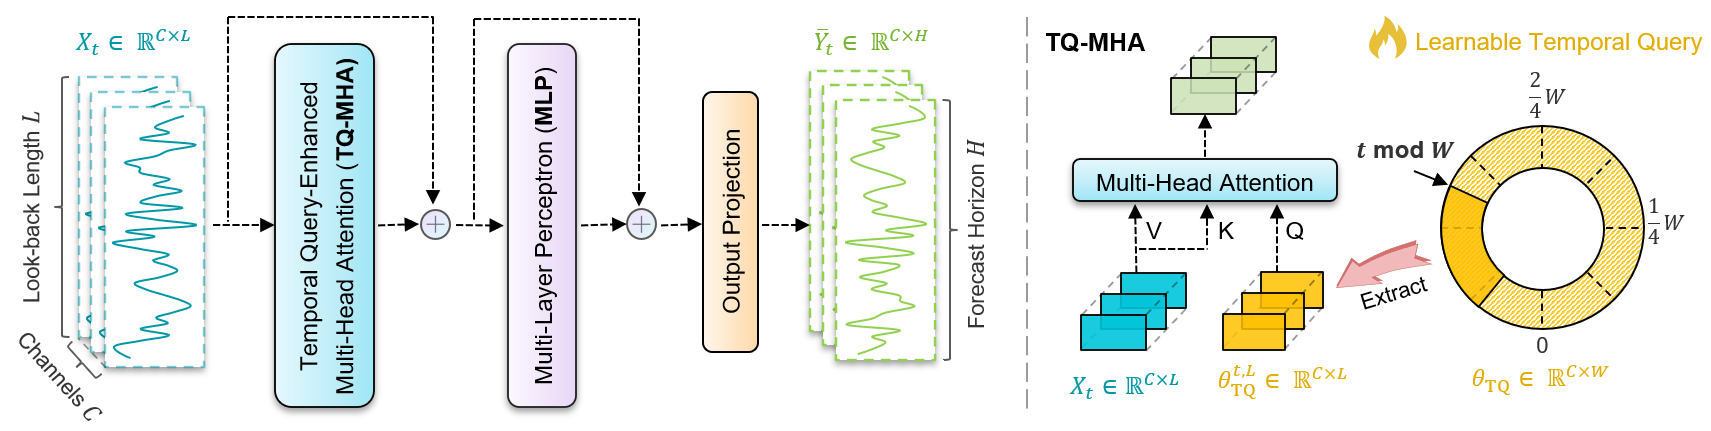
在前一篇文章中,我们探讨了TQNet框架的理论内容:模块化架构、对市场现实的灵活适配能力以及高效的资源管理机制。然而,理论还只是一个框架。当时我们还探究了CCircleParams对象,它可以将全局关联关系封装为可在每个时间步动态切换的对象。今天,我们继续基于MQL5实现TQNet框架作者提出的方案。
TQ-MHA模块
在成功实现关联参数的张量轮播(tensor carousel)算法之后,顺理成章的下一步,就是开发TQ-MHA模块。在原作者的设计构想里,该模块承担着特殊作用:它相当于一个智能滤波器,不会孤立地分析已累积的关联参数,而是和原始待分析数据紧密结合在一起运算。换言之,它基于统计信息,挖掘变量之间鲜活的关联结构,并结合当前市场上下文对其进行补充修正。可以类比资深分析师的工作方式:不只是盯着冰冷的表格与图表,而是持续把数值和真实事件、市场动态相互印证。
如果对照我们熟悉的模型结构来看,TQ-MHA在很多方面和交叉注意力(cross-attention)模块相近。然而,它却有独到之处:并非简单对两路信息(键与查询)做比对,而是一套更精细的运算流程。TQ-MHA模块将原始数据作用于关联依赖矩阵,从中识别出最重要的关联交集。这不只是一项技术优化,而是分析层次上的跃升,让框架能够在更广阔的背景下解读市场信号。
这里还有一个值得留意的关键点。在我们之前基于Transformer原理实现的交叉注意力模块中,都会配备FeedForward块。这个组件体量不大却至关重要,负责在注意力层之间做非线性变换。而TQNet框架的作者在结构上省略了该模块,仿佛从我们熟悉的链路中抽去了一环。乍看之下这似乎是过度简化,但深入理解框架内部逻辑后可以发现:TQ-MHA的后方衔接了MLP模块,它实质上完整实现了经典FeedForward块的全部功能。
唯一的区别落在一处细节:激活函数。但这对我们而言并非阻碍,反而是实验的机会:我们可以方便地替换激活函数,选出更契合建模目标、更贴合金融时序特征的类型。
因此,我们开始设计专用的CNeuronTQMHA对象。该对象内置交叉注意力逻辑,能够读取累积得到的关联参数,并和框架其余模块无缝协同。新类的结构如下所示。
class CNeuronTQMHA   :  public CNeuronCrossAttention
  {
protected:
   uint              iTimeframe;
   CCircleParams     cParams;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput);
   virtual bool      calcInputGradients(CNeuronBaseOCL *prevLayer, CBufferFloat *SecondInput,
                       CBufferFloat *SecondGradient, ENUM_ACTIVATION SecondActivation = None);
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput);

public:
                     CNeuronTQMHA(void) {};
                    ~CNeuronTQMHA(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint window, uint window_key, uint heads,
                          uint units_in, uint period, uint timeframe,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronTQMHA;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle);
   virtual bool      Load(int const file_handle);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj);
  };
CNeuronTQMHA类继承自交叉注意力对象CNeuronCrossAttention,复用其基础核心功能以及大部分内部成员。但和基础版本的交叉注意力不同,该类专门用于读取来自张量轮播的关联参数。
在类体内部,我们仅声明两个核心成员:第一个是iTimeframe,用于指定轮播结构中切换关联矩阵的时间步长;第二个是 cParams,为CCircleParams类实例,用来存放累积的关联参数。多头注意力机制正是以这批参数为原始素材,结合初始输入数据开展运算。
类中的内部对象采用静态声明方式,因此构造函数与析构函数可以保持为空 —— 对象创建和销毁时不会执行额外逻辑。所有繁重的运算逻辑都迁移到初始化方法中。这样让对象生命周期清晰可控:创建实例开销很低,正式运行前的准备工作显式、可控。
Init方法会依次执行多项关键操作,并对每一步的执行结果做严格校验。
bool CNeuronTQMHA::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                        uint window, uint window_key, uint heads,
                        uint units_count, uint period, uint timeframe,
                        ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronCrossAttention::Init(numOutputs, myIndex, open_cl, window,
                                   window_key, heads, units_count, window,
                                   units_count, optimization_type, batch))
      return false;
首先,调用父类同名初始化方法,完成基础交叉注意力逻辑的继承与配置。倘若基础初始化失败,该方法会直接返回false —— 这种提前退出机制可避免无效状态沿调用栈继续传递,同时降低调试难度。
接下来,我们设置FeedForward块的层间激活函数:
FF[0].SetActivationFunction(GELU);
前面提到,原框架作者在TQ-MHA之后接入的MLP,本质上等价于传统的前FeedForward块。修改激活函数,能够灵活调整非线性变换形式,适配金融时序数据的特性。GeLU的近似曲线更加平滑,在带噪声的数据上,表现通常比硬截断的ReLU更稳定。突如其来的市场脉冲信号不会让该激活函数产生剧烈突变,训练过程因此更加平稳。
iTimeframe参数设置了下限保护 —— 这是一项简单但关键的防护逻辑:该参数取值不能为0。实际效果是:即便配置出错,模块依然能保持最低限度的合理运行状态。
   iTimeframe = MathMax(1, timeframe);
   if(!cParams.Init(0, 0, OpenCL, window * units_count, period, optimization, iBatch))
      return false;
   if(!cParams.Zeros())
      return false;
//---
   return true;
  }
初始化流程里至关重要的一环就是准备cParams对象。我们在这里显式构建一套全局关联框架。针对每一个时间窗口(window)以及每一条待分析的单变量序列(units_count),都会在关联张量中创建对应的元素。初始化时会把这些缓冲区绑定到OpenCL上下文,保证后续处理大批量数据时具备较高运算效率。
最后,调用cParams.Zeros,采用原作者推荐的初始化方案:将全部全局记忆参数置零。这是一项关键设计选择:零初始化消除了关联关系上的初始偏置,让模型从零开始,完全依靠训练数据自主学习变量间的关联。当我们不希望在记忆参数层引入额外噪声时,该方案通常优于随机初始化。
如果全部步骤执行成功,方法返回true:对象就绪可用,缓冲区创建完成、激活函数配置完毕、周期记忆已经清零。总的来说,该方法搭建了一个稳定、可预期、高性能的运行底座;后续CNeuronTQMHA会在此基础上,把累积的θ向量和待分析数据建立关联,并从历史报价中完成学习。
介绍完类结构之后,接着顺理成章地分析它的核心流程 —— 前向传播算法。该方法从一个简单但基础的校验步骤开始:检查第二输入(SecondInput)缓冲区指针是否有效。
bool CNeuronTQMHA::feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   if(!SecondInput)
      return false;
该缓冲区用于传入参考位置,以此确定关联参数轮播结构中的当前位置。如果缓冲区不存在,函数会立刻终止执行并返回false。该校验可以保护模块,避免非法调用,同时省去后续不必要的计算。
接下来,确定轮播结构的当前位置。实现方式是读取SecondInput缓冲区下标为0的元素。在实际使用场景中,该值一般取最新K线的开盘时间。
   int pos = int(SecondInput[0]);
   pos = (pos / int(iTimeframe)) % cParams.GetPeriod();
   if(!cParams.SetPosition(pos) ||
      !cParams.FeedForward())
      return false;
得到的整数值会被转换为参数轮播的索引。首先,用该值除以iTimeframe,将连续时序步划分成指定步长的分组,得到块编号;再对周期长度取余,得到关联参数轮播中具体元素的索引。这两步运算共同实现了周期记忆机制:落在同一个块、且间隔为周期长度的时间点,会复用同一组TQ向量。
接下来的代码块会切换到对应的有效参数副本,并在该副本上执行一次前向传播,完成关联参数的预处理。只要其中任意一步出错,方法就返回false。这套机制保证后续运算始终使用准备就绪的全局参数集合。
后续步骤基本上与交叉注意力模块一致。我们本可以直接调用父类的同名方法,但这样做在逻辑上并不可取。在基础实现中,残差连接是沿着Query主干通路搭建的。而在本模块中,Query并不是当前窗口的局部表征,而是累积得到的TQ向量,也就是全局记忆。如果直接把这份全局记忆送入残差通路,就有可能覆盖当前局部的Key/Value信号,压制输入数据里的重要特征。放到金融市场的场景下,这个缺陷会很快显现:模型会过度依赖历史框架,对新的市场脉冲响应变差,预测精度随之下降。
因此,我们选择复用注意力计算的底层逻辑,但自行实现残差连接与结果归一化逻辑。这样既可以在计算注意力权重时使用全局TQ先验知识,又能保留当前实时数据的信息权重。
全局关联向量完成激活与准备之后,会被投影到Query空间。
   if(!Q_Embedding.FeedForward(cParams.AsObject()))
      return false;
//---
   if(!KV_Embedding.FeedForward(NeuronOCL))
      return false;
这里,Q_Embedding对全局关联向量执行线性投影,并将其分配到各个注意力头。
与此同时,键(Key)与值(Value)由外部程序传入的原始数据生成。由此形成两路信息流:携带长期依赖“记忆”的全局查询,以及反映当前市场状态的局部Key/Value流。
接下来调用继承而来的attentionOut方法,用于计算多头注意力。这一步执行标准的多头注意力(MHA)运算,将每个注意力头输出的注意力矩阵聚合,存入共享缓冲区MHAttentionOut。
关键点在于本模块实现的正是全局信息(来自θTQ的Query)与局部信息(原始数据生成的Key/Value)融合的逻辑 —— 这正是TQ方法的核心。
   if(!attentionOut())
      return false;
//---
   if(!W0.FeedForward(GetPointer(MHAttentionOut)))
      return false;
//---
   if(!SumAndNormilize(W0.getOutput(), NeuronOCL.getOutput(), AttentionOut.getOutput(), iWindow))
      return false;
注意力计算结果完成后,送入输出投影层。也就是矩阵WO,它把所有注意力头的输出拼接融合,映射回原始数据空间维度。
随后,两路信息流的数据相加,并对结果做归一化。这是残差连接的标准流程,原始数据张量与注意力投影结果相加,再在iWindow窗口维度上执行归一化。该设计可以稳定训练过程、保留输入信息,防止信号衰减。归一化同时用来抵御分布漂移,这对波动率不断变化的金融时序至关重要。
接下来,顺序执行MLP模块链路。
   if(!FF[0].FeedForward(GetPointer(AttentionOut)))
      return false;
   if(!FF[1].FeedForward(GetPointer(FF[0])))
      return false;
//---
   if(!SumAndNormilize(FF[1].getOutput(), AttentionOut.getOutput(), Output, iWindow))
      return false;
//---
   return true;
  }
这是一个两层结构的多层感知机,中间带有非线性激活(我们的实现选用GeLU)。本质上,这两层的作用和Transformer里传统的FeedForward层一致:扩展特征表征空间、引入非线性变换、放大有效特征,同时调整模型对信号的响应频带。
最后第二次调用SumAndNormilize,将MLP的输出和上一层表征相加并归一化,得到模块最终输出。这一步完成整套处理流程:从提取全局TQ向量,到输出经过适配、归一化的表征,供给模型下一层使用。
如果全部步骤执行成功,方法返回true,代表前向传播通过,结果可用。
一个重要的架构细节:多处前置校验与出错即返回的机制,可以节约算力,避免OpenCL缓冲区出现异常操作,在实盘环境中尤为关键。
探讨完前向传播后,我们顺理成章进入对应的反向流程 —— CNeuronTQMHA内部误差梯度的分配。此处,梯度计算按照运算逆序执行:从模块输出往输入方向回传,仔细累积误差信号,并分发到所有组件 —— MLP、注意力模块、各投影层以及全局记忆cParams。
bool CNeuronTQMHA::calcInputGradients(CNeuronBaseOCL *prevLayer,
                                      CBufferFloat *SecondInput,
                                      CBufferFloat *SecondGradient,
                                      ENUM_ACTIVATION SecondActivation = None)
  {
   if(!prevLayer)
     return false;
在该方法内部,首先校验原始数据对象的指针是否有效。这是一项简单但至关重要的防护逻辑。如果不存在上一层,就不应该继续执行这条没有意义的计算链路。
接下来,从MLP链路的末端开始逐层剥离梯度。MLP的内部参数接收对应的误差贡献,同时梯度被妥善处理,以便继续沿着链路向前传递。
   if(!FF[0].CalcHiddenGradients(FF[1].AsObject()))
      return false;
   if(!AttentionOut.CalcHiddenGradients(FF[0].AsObject()))
      return false;
以下这行代码把信号从MLP回传到MLP的输入源:AttentionOut。换言之,相当于告知注意力模块:这部分误差来自MLP的运算,请把它分配到各个输入项上。以此保证特征表征经过非线性优化的部分,与注意力输出生成的表征本身保持一致。
但在继续往下之前,我们需要计算残差连接第二条信息流的误差梯度,生成输出投影矩阵W0的梯度,并继续向前传递。
   if(!SumAndNormilize(FF[1].getGradient(), AttentionOut.getGradient(), W0.getGradient(),
                                                                         iWindow, false))
      return false;
   if(!MHAttentionOut.CalcHiddenGradients(W0.AsObject()))
      return false;
   if(!AttentionInsideGradients())
      return false;
下一步将梯度送入W0投影之前生成的多头注意力输出。换言之,我们对W0投影做“反向解包”:该投影层的梯度已经算出,现在需要推导出传递到各个注意力头本身的误差。
调用AttentionInsideGradients是解析注意力内部细节的核心操作。这一步会计算注意力机制全部内部组件的梯度,最终得到Query、Key和Value张量各自对应的梯度。这一步将来自多头聚合输出空间的汇总误差信号拆分成全局Queries和局部Keys/Values各自对应的误差分量。
随后,累积得到的梯度向原始输入数据回传(prevLayer代表局部输入)。我们调用对应的方法,将误差合理分配到权重上,并生成prevLayer输入本身的梯度。
   if(!prevLayer.CalcHiddenGradients(KV_Embedding.AsObject()))
      return false;
   if(!cParams.CalcHiddenGradients(Q_Embedding.AsObject()))
      return false;
与此同时,我们对全局记忆做对称处理:Queries得到的梯度会传入cParams中。因此,训练过程不仅更新局部投影权重,也会更新全局关联记忆本身的参数:θTQ会拿到属于自己的误差分量,后续将利用该误差完成权重更新。
误差分量拆分完成后,我们需要用输入主干通路的梯度,补充原始输入数据的误差梯度。但在此之前,要先用上一层激活函数的导数值对梯度做缩放。完成缩放之后,才能把两路信息流的梯度相加合并。
   if(!DeActivation(prevLayer.getOutput(), W0.getPrevOutput(), W0.getGradient(),
                                                                    prevLayer.Activation()))
      return false;
   if(!SumAndNormilize(prevLayer.getGradient(), W0.getPrevOutput(), prevLayer.getGradient(),
                                                                          iWindow_K, false))
      return false;
//---
   return true;
  }
这一步十分关键:它保证传给prevLayer的最终梯度,同时纳入局部输入的影响与W0投影带来的误差贡献,并且和前向传播里的归一化运算保持正确的分配关系。
上述步骤全部顺利执行完毕后,该方法标记梯度已经在模块所有内部组件上完成正确分发,模型可以进入权重更新环节。
误差梯度在神经元内部所有结构上精细分发完成后,顺理成章的下一步就是参数更新。updateInputWeights方法完成整个训练闭环。它读取已经计算好的梯度,依次更新各投影层与MLP的参数,更重要的是,也更新全局关联记忆本身。
我们采用的模块化方案,使得更新的参数代码相当简洁。只需要依次调用内部对象的同名方法,并传入对应数据源缓冲区的正确指针即可。
bool CNeuronTQMHA::updateInputWeights(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   if(!cParams.UpdateInputWeights())
      return false;
   if(!Q_Embedding.UpdateInputWeights(cParams.AsObject()))
      return false;
   if(!KV_Embedding.UpdateInputWeights(NeuronOCL))
      return false;
   if(!W0.UpdateInputWeights(GetPointer(MHAttentionOut)))
      return false;
   if(!FF[0].UpdateInputWeights(GetPointer(AttentionOut)))
      return false;
   if(!FF[1].UpdateInputWeights(GetPointer(FF[0])))
      return false;
//---
   return true;
  }
updateInputWeights方法是训练流程严谨而完整的收尾环节。它确保全局关联记忆及其全部映射关系、后续变换层都能得到一致且正确的更新。这一点对 TQNet在金融时序预测任务中稳定可靠地运行尤为关键。
CNeuronTQMHA类及其全部方法的完整源码见附件。
模型架构
在组装完TQNet框架所有核心组件后,我们进入下一阶段:描述可训练模型的整体架构。和之前一致,我们的目标是搭建一套交易系统,能够自主分析市场状态并生成交易决策。训练采用Actor-Critic(行动者 - 评估器)范式,TQNet作为环境状态编码器。它把当前市场状态压缩成信息丰富的低维表征,Actor依靠该表征选择动作,Critic则利用它评估动作价值。
和原版TQNet不同,我们在数据预处理与特征生成层面做了扩展:新增上下文信息预处理与聚合模块,以此提升系统的稳健性与泛化能力。模型架构描述由CreateDescriptions方法生成。该方法搭建网络层的架构序列,后续所有训练与推理逻辑都基于该架构展开。
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&actor,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
该方法首先执行一个简单但很关键的步骤:如果层容器指针为空,则新建容器对象。这不只是走流程 —— 我们以此保证三大架构模块各自拥有独立的层描述集合,可按顺序填充层结构。这种显式分配方式让逻辑更加清晰。后续代码可以默认容器已经就绪,无需在多处重复校验有效性。
接下来开始构建编码器 —— 它是整个模型的核心组件。先清空容器,再逐个添加层描述,每一步都附带严格的成功校验:如果对象创建或数组添加操作因任何原因失败,方法会稳妥释放资源并返回错误。这种严谨的内存与状态管理方式,无论是调试阶段还是实盘环境都很有价值,可以避免问题沿着调用栈持续扩散。
//--- Encoder
   encoder.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   uint prev_count = descr.count = (HistoryBars * BarDescr);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormWithNoise;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
编码器的第一层是基础神经元层 CNeuronBaseOCL,神经元数量设置为HistoryBars * BarDescr的乘积。设计思路很清晰:我们把一段历史窗口送入网络,窗口数据按各类描述特征拆分。该层不带激活函数,相当于入口网关,仅作为缓冲区接收原始输入数据。
下一个模块是CNeuronBatchNormWithNoise,保持上一层维度不变,同时引入归一化与噪声正则化。这不是可有可无的细节:金融时序普遍存在分布漂移和离群异常点。带噪声的批量归一化能够提升模型对这类异常的耐受能力,为后续层标准化输入,同时抑制模型对微小随机扰动的过拟合。
归一化后,使用CNeuronConcatDiff对时序结构做变换。该层按K线归集历史数据,重点计算步长为1的差分,显式构造动态特征:不只保留价格水平,同时保留变化量信息。这种处理方式通常能让模型更好地刻画趋势波动、动量以及局部反转信号。
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConcatDiff;
   prev_count = descr.count = HistoryBars;
   descr.layers = BarDescr;
   descr.step = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
接下来轮到CMamba4CastEmbeding层,该层实现了多窗口正弦时间戳嵌入逻辑。这使得模型能够同时捕捉短期与长期模式,生成信息丰富的市场状态表征。
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defMamba4CastEmbeding;
   prev_count = descr.count = HistoryBars;
   descr.window = 2 * BarDescr;
   uint prev_out = descr.window_out = NSkills;
     {
      uint temp[] = {PeriodSeconds(PERIOD_D1), PeriodSeconds(PERIOD_MN1)};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
这里需要注意的是,前面所有运算都是在多变量时序表征空间内完成的。但TQNet框架想要正常运行,需要接收一组单变量时序序列。因此下一步我们对张量做转置,重新排布维度,为后续注意力运算做好维度适配。
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = descr.count;
现在我们来到整个结构的核心 —— CNeuronTQMHA层。这里我们将周期大小设置为24×7,对应H1(1小时)周期下的一个自然周。而步长等于该时间周期下单根K线的秒数。我们希望这套TQ轮播结构能够存储周度模式,并以一小时K线的粒度调取这些周规律。
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTQMHA;
     {
      uint temp[] = {prev_out, 64, 24*7, PeriodSeconds(PERIOD_H1)};
                   // window, window_key, period, timeframe
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.step=NHeads;
   descr.count=prev_count;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   uint count = prev_count;
   uint window = prev_out;
请注意,我们采用自然周(7天)作为周期,即便当前分析品种在周末没有交易。这是必要的设计,因为轮播元素是依据K线开盘时间来计算定位的。
接下来是一层带TANH激活函数的卷积层,作用是对得到的特征表征做压缩,并映射到指定预测视界。在这一步,丰富的特征表征被转化为明确的预测信号。
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.step = prev_out;
   prev_out=descr.window_out = NForecast;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out=descr.count;
随后,再次执行张量转置,将数据还原为和原始输入一致的多变量时序表征形式。
下一个卷积层用于把特征维度压缩至原始数据维度。
//--- layer 8
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.step = prev_out;
   prev_out=descr.window_out = BarDescr;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
这些卷积运算相当于局部聚合器 —— 它们汇总各个预测分量的信息,输出一份可供反归一化处理的特征表征。
编码器的最后一层是CNeuronRevInDenormOCL。该模块将预测结果还原至原始量纲,恢复预处理阶段被剥离的原始数据均值与方差。
//--- layer 9
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronRevInDenormOCL;
   descr.count = prev_count*prev_out;
   descr.layers = 1;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
对于金融场景而言,这一步至关重要:预测结果必须落在可解释的量纲上,才能用于交易决策与风险计算。
整套结构贯穿同一个核心思路:先对输入数据做精细预处理与归一化,接着在多尺度下提取动态特征与嵌入表征,再使用TQ增强注意力机制,最后聚合预测信息并投影回原始数据空间,还原量纲。
Actor和Critic模型的架构沿用之前方案,本文不再展开详述。所有可训练模型的完整架构设计见附件。
测试
训练流程分为先后衔接、互为补充的两个阶段,既打下扎实的基础,又适配真实市场环境所需的灵活性。
第一阶段为离线训练:我们采用2024全年H1周期的EURUSD历史数据开展充分训练。该年份覆盖了丰富的市场状态 —— 平稳震荡行情、持续性趋势、波动率突然飙升以及高噪声时段,非常适合作为模型的训练场。
第二阶段为在线微调。训练环境尽量贴近实盘交易:在MetaTrader 5策略测试器中,模型按顺序逐根处理K线数据流,和实盘时序保持一致。在线模式下可以暴露出批量训练看不到的特性:抗噪声能力、对流动性变化的响应能力,以及正确处理延迟与端到端滑点影响的能力。微调过程中我们模拟真实成交条件,保证模型迁移到实盘时行为可预期。
最后,也可能是最严苛的一环:在完全样本外的数据上测试,采用 2025年1月至3月的行情报价。模型全部参数与超参数冻结,不会基于该数据集做任何额外调参。这种验证方式能够客观评估实际效果,检验算法在全新市场环境下能否维持稳定、具备稳健性。
测试结果如下所示。
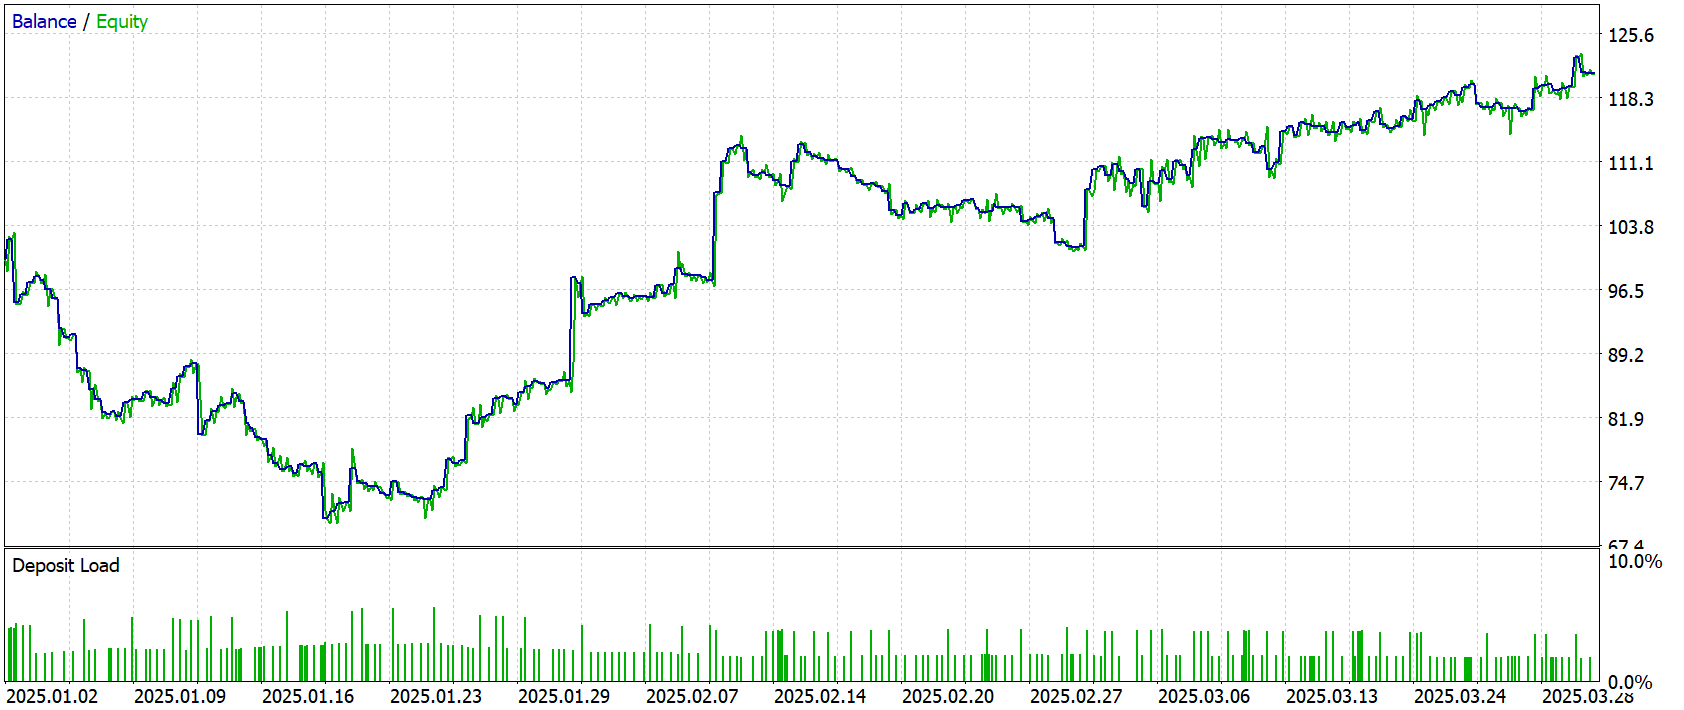
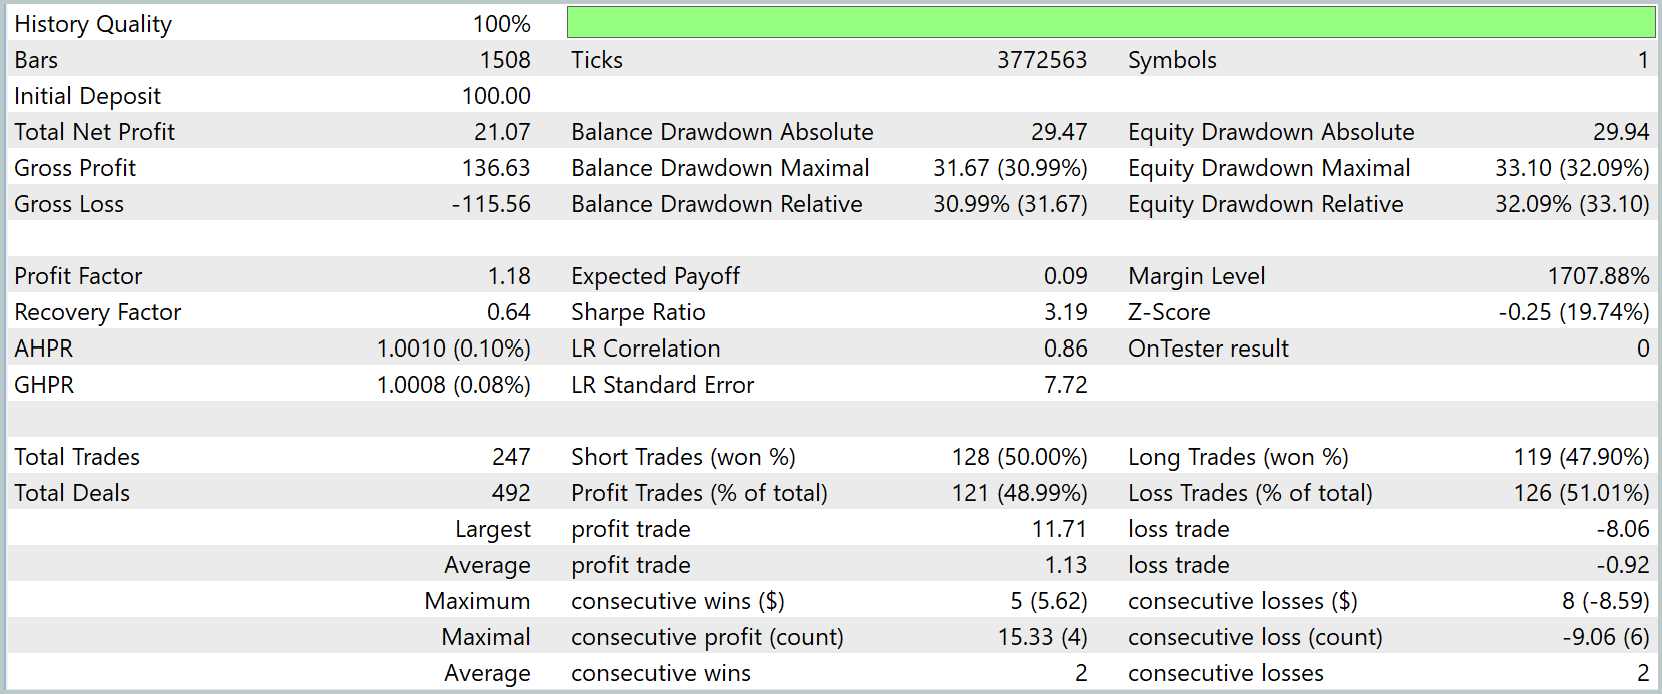
测试结果显示模型具备小幅的正向优势。初始资金100美元,净利润为21.07美元。盈利订单占比接近49%。其中空头交易的盈利频次略高于多头。单笔盈利交易平均盈利为1.13 美元,单笔亏损交易平均亏损为0.92美元。盈利因子1.18,单笔期望收益仅0.09 美元,说明利润缓冲非常有限。
对权益曲线做线性回归得到相关系数0.86,但误差依旧明显。这印证了测试结果中噪声成分较大。
风险表现远未达到理想水平:较大的回撤叠加偏低的单笔期望收益,这样的组合难以支撑安全的资金增长。本案例中保证金压力不大,说明问题不在于仓位大小,而是入场信号质量与出场规则。
结论
本文详细探讨了TQNet框架的理论基础,以及它嵌入可训练交易模型架构的实现细节。文中剖析了各模块的核心设计思想(含改进型交叉注意力机制),这套设计让算法在金融市场环境下拥有更强的灵活性与稳定性。
项目实践部分,我们基于MQL5实现TQNet原文方案,并在特征工程、数据预处理环节增加自研改进。模型采用两阶段训练:历史数据离线训练,以及在贴近真实市场环境下(MetaTrader 5策略测试器中)在线微调。
在全新且未参与训练的行情数据上完成模型最终测试,结果呈现正向收益趋势。资金曲线在初期回撤之后稳步抬升,说明算法具备适应市场变化的能力。
实验结果证明:搭配精心设计的架构方案与两阶段训练流程,TQNet能够产生正期望收益。
参考文献
文中所用的程序
| # | 名称 | 类型 | 描述 |
|---|---|---|---|
| 1 | Study.mq5 | EA | 用于离线模型训练的EA |
| 2 | StudyOnline.mq5 | EA | 用于在线模型训练的EA |
| 3 | Test.mq5 | EA | 用于模型测试的EA |
| 4 | Trajectory.mqh | 类库 | 用于描述系统状态与模型架构的结构 |
| 5 | NeuroNet.mqh | 类库 | 用于构建神经网络的类库 |
| 6 | NeuroNet.cl | 库 | OpenCL程序代码库 |
本文由MetaQuotes Ltd译自俄文
原文地址: https://www.mql5.com/ru/articles/19181
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。

 机器学习中的高斯过程(第二部分):在 MQL5 中实现和测试分类模型
 新手在交易中的10个基本错误
 交易中的神经网络:时间序列查询模型(TQNet)
