

交易中的神经网络:时间序列查询模型(TQNet)
 38
 0

引言
金融多变量时序预测是一场与时间的赛跑,精度与速度是核心。汇率、指数、成交量、利率与流动性指标 —— 这些因子持续相互作用,构成一套复杂且不断演化的系统。交易员、资管从业者与分析师都清楚:想要抢占先机,就必须理解所有变量之间的实时联动关系。这种把握全局的能力,正是现代金融市场预测的核心。
问题在于金融数据不同于在纯净可控环境下采集的实验室观测值。市场自有其运行规律:消息驱动的剧烈价格波动、高低波动率交替出现,还有短短数小时内凭空出现又迅速消失的非预期相关性。再叠加噪声(观测误差、报价延迟、数据缺失),我们就面临一个经典难题:如何在充满随机性的环境里提取可靠信号。当单个时间片段内变量间的局部关联,和全观测历史体现的整体规律相互矛盾时,问题会变得尤为棘手。好比只依靠单日行情去预测汇率,而长达数月的大趋势却恰好反向运行。
为解决这一难题,论文《Temporal Query Network for Efficient Multivariate Time Series Forecasting(面向高效多变量时序预测的时序查询网络)》提出一种全新方案 —— 时序查询,该机制可以融合市场的局部视角与全局视角。它基于可训练向量,在时间维度上循环移位,捕捉经过全量历史数据验证、稳定存在的跨变量关联关系。与此同时,报价、指标以及其余市场参数本身,在多头注意力机制中充当键(Key)与值(Value),刻画每一个时刻独有的市场特征。该设计带来双重效果:模型既能够响应瞬时行情变化,又可以依托底层更稳定的市场关联规律。
基于这一核心思想,由此设计出时序查询网络(TQNet)框架 —— 一套极简但能力强大的架构,可对一组相互关联金融标的的走势进行预测。它的结构极其精简:仅一层多头注意力,搭配一个浅层全连接网络。但在简约的外壳之下,它能够捕捉资产之间微弱的依赖关系,响应速度优于绝大多数传统模型。在作者开展的实验中,TQNet取得了和最复杂模型相当的预测精度,同时计算速度接近轻量线性模型。
TQNet的一大核心特性:依靠同一套“平衡局部与全局依赖”机制,适配不同的预测范围。这在金融市场中价值突出 —— 行情可能数分钟内快速演化,但同时也存在不可忽视的长期规律。
在当今金融市场,胜出者既不是只盯着细节的人,也不是只依赖宏观趋势的人,而是能够融合两个维度信息的人。时序查询机制与TQNet正是为此而生,并且实现方式简洁优雅,值得纳入专业分析师的工具库。
TQNet算法
多变量时序预测(Multivariate Time Series Forecasting,MTSF)的目标,是同时预测多个相互关联变量未来的走势。形式化定义:在时刻t,我们观测到历史序列Xt ∈ RC*L。其中,C = 变量/通道数量(货币对、市场指数、成交量以及各类指标);L = 观测窗口长度(纳入计算的历史数据点数)。任务是在未来预测时域H上构建预测,通过获取Yt ∈ RC*H,也就是相同变量在未来一段时间的取值序列。
放到金融场景中,它可以是基于选定历史数据,预测未来数小时主要货币对报价、未来数个交易日的关键指数点位,或是数周维度的利率走势。建模时不能只单独挖掘每个变量自身的时序模式,还必须捕捉变量间的相关性 —— 市场是一个整体,一个板块的变化会立刻传导至其他板块。
针对该问题,研究提出TQNet框架。尽管架构设计简洁,它融合两大核心模块:变量间依赖关系提取、时序结构建模。
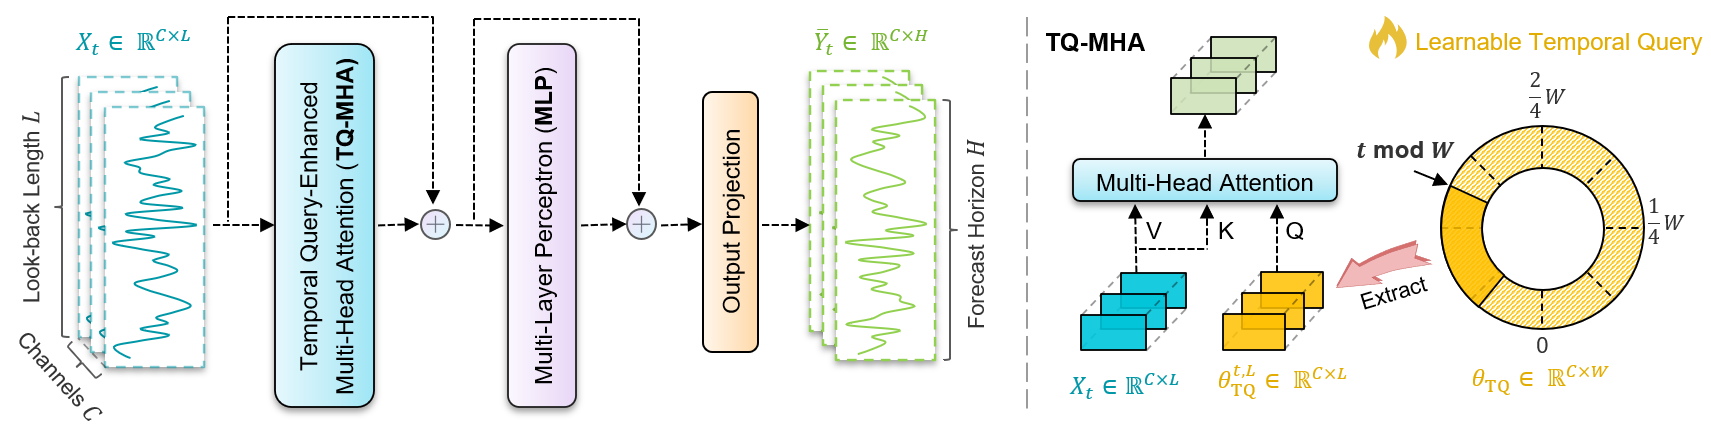
TQNet的运算流程:将分析后的序列Xt送入时间序列(TQ-MHA)组件增强的多头注意力层。该层负责挖掘并整合变量间的相关性 —— 既包括长期稳定的全局相关性,也包括适配当前市场环境的局部相关性。注意力层输出送入浅层多层全连接网络(MLP)做进一步处理,细化时序依赖,帮助模型捕捉趋势与行情变化节奏。
TQ-MHA模块与MLP模块均配备残差连接,用以提升训练稳定性,降低大数据集上模型效果退化的风险。最后一层为带Dropout的线性层,将隐空间表征映射到输出空间,生成预测结果Ŷt ∈ RC*H。
TQNet架构的核心组件是时序查询(TQ)模块,它是注意力机制里查询向量(Query)的特殊构造方式。思路简洁巧妙:经典自注意力机制直接从原始输入生成查询向量;而本框架不这么做,改用一组可训练向量,沿着时间轴周期性移位。该设计能够捕捉变量间的全局相关性,这类关联抗短期市场扰动且抗噪声。
形式化描述:设待分析数据的周期长度为W,初始化参数矩阵θTQ ∈ RC×W。其中,C是变量数(通道数);W是向量长度,决定周期移位步长。将这些参数初始化为0,训练过程中自适应更新,拟合数据内在关联。W的选取十分关键:在金融场景下,它可以对应一周的交易时段数量、周期性流动性循环或是其他稳定季节性规律。W可以依靠市场专家经验确定,也可以通过统计方法自动选取。
TQ机制的工作流程:对于时刻t的样本,从参数矩阵θTQ中截取长度为L的片段,起始位置由t mod W算出,超出边界时循环回绕取值。因此,时间间隔恰好为W步的两个时刻,会使用完全相同的查询向量。这就形成周期记忆效应,让模型复用已经学到的全局依赖关系,削弱随机市场扰动带来的影响。
放到金融语境理解:这就好比资深交易员,记住每周同一天、特定交易时段的典型行情范式,并把这些先验知识用于当下行情研判。
在TQNet中,这套机制被嵌入多头注意力(TQ-MHA):此处,查询向量(Query)不再由原始输入生成,而是来自承载全局依赖的时序 TQ 向量;与此同时,键(Key)与值(Value)仍然从当前输入序列Xt提取,保留该时刻全部独有的局部市场信息。
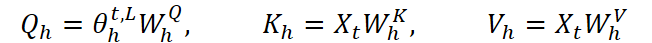
下标h代表注意力头编号, W h Q、W h K和W h V为可训练投影矩阵。
接下来,对每个注意力头分别计算注意力。
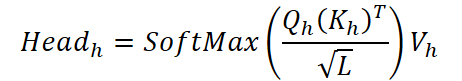
与经典多头自注意力机制类似,各头输出结果拼接之后,再经过一次最终投影。
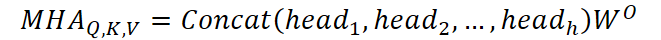
这种全局查询 向量搭配局部键/值的组合方式,在抗噪声鲁棒性与适配当前行情上下文之间取得平衡。在真实市场数据中,平稳行情可能瞬间转入剧烈震荡阶段,这种平衡至关重要。模型不会丧失对特殊事件的响应能力 —— 例如超预期宏观数据、消息驱动的快速行情异动;同时它依托长期稳定的全局依赖关系作为底层支撑。
本文提出的时序查询(TQ)方法,目标是把时序中的全局关联与局部关联有机融合进注意力机制。思路简洁而有效:查询向量(Query)不再直接由原始数据生成,而是取自周期移位的可训练向量θTQ;键(Key)仍然从原始序列中提取。该方法使得模型能够兼顾市场整体格局,以及每一段数据独有的局部特征。
为实证评估全局依赖与局部依赖各自的作用,论文作者对比了三种方案:
- 经典方案:Query和Key均由原始数据构造。该模式下注意力仅捕捉样本内、局部的观测关联。
- 混合方案:也就是TQNet所实现的方案。Query由可训练的TQ向量生成,Key取自原始输入序列。计算注意力权重时同时纳入全局依赖与样本局部依赖;这一点在金融市场尤为关键 —— 长期趋势和瞬时波动总是交织在一起。
- 纯全局方案:Query和Key全部由可训练TQ向量生成。该方式完全忽略局部波动,只学习时序整体结构。
基于包含100个以上变量的大规模多变量数据集汇总得到的结果,并对4个预测时域的结果取平均,结果显示TQNet混合方案效果最优,它同时融合两类相关性。第二名是只捕捉样本局部关联的传统方案;纯全局方案表现最差。结论很清晰:均衡融合全局与局部依赖,可以提升预测精度与模型鲁棒性,对于动态变化的金融时序非常有价值。
TQ-MHA层提取出稳定的变量间关联、并融合局部信息之后,多层感知机(MLP)开始介入计算。它负责在时间维度对已提取特征做进一步加工,捕捉趋势、波动节律以及变量间关联的滞后效应。
MLP结构虽简单,但在捕捉时序模式上效果出众。在TQNet架构中采用轻量化实现:仅两层全连接层,搭配GeLU激活函数;相较于ReLU,GeLU的信号变换更加平滑,尤其适合复杂多变的金融行情。
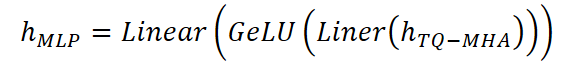
从金融角度理解这一步:分析师拿到市场核心关联关系汇总之后,再做一轮深度研判 —— 识别日内模式、评估波动幅度、捕捉行情惯性与反转信号。
随后将处理得到的表征送入输出投影层。这里执行线性变换,把模型内部表征映射到指定预测范围H。此外,还可以使用Dropout来降低过拟合风险并提升模型的鲁棒性。
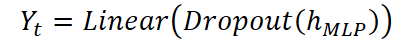
TQNet特别强调对数据分布偏移的鲁棒性 —— 这是金融领域非常普遍的现象。汇率、大宗商品价格、股票指数,这些都可能因为消息、宏观因子或者监管政策,发生统计特征的突变。如果模型固化在旧的数据分布上,它的预测很快就会失效。
为规避该问题,TQNet框架采用可逆实例归一化(RevIN)—— 该方法已在多款现代时序模型中验证有效。其核心思路:数据送入模型前,减去均值、除以标准差做归一化;生成预测结果之后,再把数据还原回原始量纲。放到交易场景理解,这就如同资深分析师会随行情变化,动态调整自身的参照基准。归一化可以消除短期量级与波动率偏移,让模型专注挖掘内在模式,而非被报价幅值的随机波动干扰。
因此,在TQNet中,MLP与输出投影层承担预测结果的最终精细化修正工作。TQ-MHA搭建起变量间依赖关系的骨架,MLP在时间维度上进一步细化时序关联,而归一化机制抵御统计分布偏移。最终模型输出的预测值,既能捕捉当下时刻的局部特征,又能维持全局市场规律的一致性。
作者给出的TQNet框架结构图如下。
在MQL5中的实现
我们在梳理完TQNet的理论基础并阐明融合全局与局部相关性为何能提升预测精度后,接下来我们从理论转向工程落地。我们重点介绍在MQL5环境下的一种实现方案,对该架构做适配,用于金融市场时序分析与预测。
从Queries、Keys的构造,到数据归一化、结果投影,所有组件都将用代码实现。借此演示理论如何转化为可用于实盘交易的工具。基于这套实现,我们可以使用实时报价测试TQNet的效果,在不同市场阶段评估鲁棒性:包括平稳震荡行情以及快速趋势行情。
依托此前开发各类注意力模块的经验,我们可以把TQNet和经典交叉注意力(Cross-Attention)模块做深入对比。传统交叉注意力机制中,Queries、Keys、Values张量来自不同数据源。该方法允许一条序列选择性地提取另一条序列内的信息,挖掘两组序列之间的关联。
而TQNet对这一思路做了更精巧的改造,使之更契合时序预测任务。它对数据源做角色划分:Queries承载由可训练向量θTQ编码得到的全局泛化信息;Keys则保留原始数据的局部时序结构。这种组合在金融市场中意义重大:需要把季节性、宏观周期这类长期规律,和价格脉冲、市场噪声、短期供需失衡等局部波动结合建模。
因此,TQNet可以看作一种混合交叉注意力机制,模型将全局记忆与瞬时市场信号融合在同一套机制中。这不仅拓宽了模型能够捕捉的关联关系范围,还提升了模型对市场机制突变的抗扰动能力,这一点在外汇、股票或大宗商品等高波动市场环境下极具价值。
在此基础上,我们面临一项核心任务:构建并训练一个全局相关性参数张量,该张量将作为生成Queries的数据来源。正是这个由可训练向量θTQ 构成的张量,承载着各个变量之间的全局关联信息,也是正确搭建注意力机制的基础。
训练该张量需要严谨的方法:张量需要拟合数据分布,捕捉稳定的相关关系,同时对噪声和局部异常值保持稳健。对于金融时序数据而言这尤为关键,资产价格序列常会出现剧烈波动,例如流动性短期脉冲、突发市场事件等。
通过构建并训练该张量,模型在处理每一段新序列时就可以调用全局市场模式。基于该张量生成的Queries相当于一个筛选器,引导模型重点关注变量间最关键的关联,同时将其与当前时间片段的局部特征相结合。借此,TQNet融合全局记忆的稳定性与对特定市场环境的自适应能力,实现较高的预测精度。
我们的工具库中已经存在CParams对象,它实现了一套可训练参数的创建与维护算法。理论上,我们可以用它来构建全局相关性张量。然而,这里引出一个问题:该方法的计算效率如何?
事实上,金融市场的多变量时序预测需要 规模相当大的张量 ,以此容纳分析周期内全部变量间的相关关系。另一方面,张量尺寸过大将带来高昂的计算开销,拖累训练速度与模型实时推理性能。
另外,绝大部分算力都会被无谓消耗。在每一轮训练或预测步,我们仅使用张量里和当前时间窗口对应的一小部分;其余部分处于闲置状态,对这部分做任何运算本质上都是空操作。
同时,张量大小与空操作数量会随周期长度、变量数量同步增长。对于金融数据,特征通道数可达数百,历史时间步多达数千,这种低效会迅速形成性能瓶颈,拖慢训练、降低模型整体表现。
因此我们必须寻找解决方案:削减冗余计算,同时在不损失精度的前提下保留模型捕捉全局相关性的能力。
为了保证更高效的实现,我们重新设计了相关参数的存储与更新方式。不再使用单个静态CParams对象生成完整张量,而是对该类进行改造,在内部维护一个可训练参数对象数组。
数组内的每个元素分别对应一个独立时间步,从而只需加载当前预测窗口所需的参数与数据。该方式大幅减少冗余计算,同时保留模型在整个分析区间内捕捉变量全局关联的能力。
换言之,我们得到动态参数张量:每个元素对应一个特定时间点,完全消除其余时间步上的无效运算。这使得TQNet的实现具备更高的资源利用率与良好的扩展性,能够适配大规模金融数据集。
在介绍完动态参数张量的思路和论证按时间步拆分为对象数组的必要性之后,接下来自然进入代码实现环节。CCircleParams类在整套架构中承担核心角色,它继承自全连接神经层CNeuronBaseOCL,复用后者的基础能力。
class CCircleParams  :  public CNeuronBaseOCL
  {
protected:
   CLayer            cOnes;
   CNeuronBaseOCL    *cCurrent;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override          { return FeedForward(); }

   ///\ingroup neuron_base_opt
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override   { return UpdateInputWeights(); }
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override   { return true; }

public:
                     CCircleParams(void) : cCurrent(NULL) {};
                    ~CCircleParams(void)  {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint numNeurons, uint period,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   virtual bool      Identity(const int rows, const int cols);
   virtual bool      Zeros(void);
   //---
   virtual bool      FeedForward(void);
   virtual bool      UpdateInputWeights(void);
   virtual bool      SetPosition(int position);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defCircleParams; }
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual CBufferFloat   *getWeightsParams(void);
   virtual int       GetPeriod(void) const { return cOnes.Total(); }
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
  };
该类是专门用于存放和管理可训练相关系数参数的容器,保障参数能够被正确更新,并与OpenCL上下文机制高效交互;当在GPU上处理大规模金融数据集时,这一点尤为关键。
在CCircleParams类内部,cOnes对象承担特殊作用:它是一个由可训练张量构成的动态数组,适配该类的周期化运行特性。cCurrent参数相当于数组内活跃对象的指针,指向当前启用的时间步对象。借此,模型可以在不同上下文之间动态切换,在处理每一段时序片段时保证最高精度,同时保留整个分析周期内累积得到的全局依赖关系。
CCircleParams对象的内部结构在Init初始化方法中完成创建与配置,该方法负责为相关参数张量的正常运行准备全部所需组件。
bool CCircleParams::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                         uint numNeurons, uint period,
                         ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, numNeurons, optimization_type, batch))
      return false;
调用该方法时,首先由父类CNeuronBaseOCL完成继承接口的初始化,设置对象的基础参数。如果此阶段发生错误,方法会直接返回false,避免后续出现异常行为。
接下来对动态数组cOnes进行准备:先清空数组,再将其绑定至OpenCL上下文,保证后续所有张量运算都可以在GPU上高效执行。
   cOnes.Clear();
   cOnes.SetOpenCL(OpenCL);
   for(uint i = 0; i < period; i++)
     {
      cCurrent = new CNeuronBaseOCL();
      if(!cCurrent)
         return false;
      if(!cCurrent.Init(Neurons(), i, OpenCL, 1, optimization, iBatch) ||
         !cOnes.Add(cCurrent))
        {
         delete cCurrent;
         return false;
        }
      cCurrent.SetActivationFunction(None);
     }
该方法的主循环用于创建对象数组,数组内每个对象分别对应一个独立时间步。针对每一个时间步,都会新建一个CNeuronBaseOCL实例,并使用该时间步专属的统一参数完成初始化。初始化成功后,该实例会被加入管理全部时间步对象的容器cOnes。一旦过程中出现任何错误,正在创建的对象会被立即销毁,以此防止内存泄漏,保证结构完整性。
同时,所有新建神经元都关闭激活函数。这对相关张量的正常工作至关重要:Feed-Forward(前向传播)阶段只需要直接传递数值,不需要引入非线性变换。
全部时间步对象创建完成后,调用SetPosition方法将数组首个元素设为激活对象,为后续计算设定初始状态。
//---
   if(!SetPosition(0))
      return false;
//---
   return true;
  }
因此,Init方法不只是简单创建一个对象数组,而是构建出一套结构化、可管控的参数存储结构,其中每一个元素都代表一个特定时间点。这使得模型能够高效利用全局相关性、规避冗余计算,为训练以及金融多变量时序预测做好准备。
SetPosition方法在CCircleParams中负责管理相关性动态参数张量,承担核心作用。它的功能是将激活对象切换至指定时间步,保证模型使用该时刻对应的有效数据进行运算。
调用该方法时,指针cCurrent会指向cOnes数组中对应位置的元素。如果选中的对象不存在或者尚未初始化,方法返回false作为错误标识,避免错误计算。反之,对象选中成功则返回true,代表模型已就绪,可以继续处理数据。
bool CCircleParams::SetPosition(int position)
  {
   cCurrent = cOnes[position];
   if(!cCurrent)
      return false;
//---
   return true;
  }
该方法看似简单,背后却承载着一项关键功能:TQNet模型正是依靠SetPosition实现跨时间步的动态运算,激活对应的相关性参数,而无需重新创建或加载整个张量。这一点对于金融时序数据尤为重要:每一段新时序片段都需要同时兼顾局部依赖与全局依赖;通过对激活位置的高效管理,即便处理海量数据,模型依旧可以保持高速运行与自适应能力。
需要着重说明:在Init标准初始化流程中,所有全局相关性张量都会被随机赋值。绝大多数场景下该方式完全可用:随机初始化能够提供多样化的初始状态,让可训练参数逐步拟合数据分布。
然而, TQNet框架的作者推荐另一种方案 —— 将张量初始化为0值。该方案在金融时序场景下具备充分合理性:训练开始时不对变量间的相关关系预先做任何假设,让模型纯粹依靠历史数据,逐步挖掘稳定的关联模式。
为实现该机制,CCircleParams类提供了Zeros方法,依次将全部时间步的参数置0。调用该方法时,会遍历cOnes数组内的每一个元素,把全局相关性张量的所有数值清0。由此我们可以从零开始训练,避免随机初值带来的预测偏置;整套参数的拟合过程完全由待分析数据与TQNet自身结构驱动。
bool CCircleParams::Zeros(void)
  {
   matrix<float> zeros = matrix<float>::Zeros(Neurons(), 2);
//---
   CBufferFloat *w = NULL;
   for(int i = 0; i < cOnes.Total(); i++)
     {
      if(!cOnes[i])
         return false;
      w = cOnes[i].getWeights();
      if(!w || !w.AssignArray(zeros))
         return false;
      w.BufferFree();
      if(!w.BufferCreate(OpenCL))
         return false;
     }
//---
   return FeedForward();
  }
因此,Zeros方法为管控全局相关性参数的初始状态提供了便捷有效的手段,提升金融数据上模型训练过程的可解释性与可预测性。
除初始化为0值之外,我们还实现了另一种初始化方式:使用单位矩阵对全局相关性张量进行初始化。该方式适用于需要预先设定变量相互独立的场景,模型可在训练过程中逐步学习变量之间真实存在的关联关系。
Identity方法首先校验待生成矩阵的维度是否和对象内神经元数量保持一致。
bool CCircleParams::Identity(const int rows, const int cols)
  {
   if(rows * cols != Neurons())
      return false;
   matrix<float> ident = matrix<float>::Identity(rows, cols);
   if(!ident.Reshape(rows * cols, 1))
      return false;
   if(!ident.Resize(rows * cols, 2))
      return false;
   if(!ident.Col(vector<float>::Zeros(rows * cols), 1))
      return false;
接下来,创建指定维度的单位矩阵,再依次对其做维度变换,适配该类的内部数据结构。流程重点借助Reshape和Resize方法完成内存准备与重分配,同时将额外的偏置列置0,保证赋值操作正常执行。
矩阵准备完成后,该方法遍历cOnes容器中的全部时间步。
   CBufferFloat *w = NULL;
   for(int i = 0; i < cOnes.Total(); i++)
     {
      if(!cOnes[i])
         return false;
      w = cOnes[i].getWeights();
      if(!w || !w.AssignArray(ident))
         return false;
      w.BufferFree();
      if(!w.BufferCreate(OpenCL))
         return false;
     }
//---
   return FeedForward();
  }
对于每一个时间步,通过getWeights方法取出权重,再将预先准备好的对角矩阵内容赋值给这些权重。之后,释放OpenCL上下文内的缓冲区,并基于新数值重建缓冲区,以此保证后续模型训练时能够和GPU正常交互。
流程最后调用FeedForward方法,可以立刻验证数值在该层中传递是否正确。这种初始化方式保证训练起始时,变量间的全局相关性是无偏的,处于中性初始状态;同时保留相应结构,让模型在预测过程中能够有效学习并纳入真实依赖关系。
在金融场景下这点尤为关键:单位矩阵为各个变量提供了干净的初始基底,消除初始偏置,让模型逐步挖掘稳定的市场关联,例如不同资产之间的相关关系。
在详细介绍完初始化算法以及相关参数的预置方法之后,接下来我们介绍前向传播算法,它是CCircleParams类运行流程中的核心环节之一。
FeedForward方法会准备当前时间步对应的全局相关性参数,供模型更新内部状态。
bool CCircleParams::FeedForward(void)
  {
   if(!cCurrent)
      if(!SetPosition(0))
         return false;
//---
   return CNeuronBaseOCL::feedForward(cCurrent);
  }
首先,该方法会检查cCurrent指针是否已经绑定了激活时间步。如果尚未指定当前对象,则调用 SetPosition方法自动选中cOnes数组里的第一个时间步,保证计算流程正常启动。
激活时间步设置完成后,控制权交给父类的同名方法,以此生成所需的全局相关性参数。
因此,FeedForward相当于一套桥梁,衔接已经构建好的全局相关性张量结构与TQNet的注意力机制。该方案兼顾预测的灵活性与精度,模型既可以响应局部市场波动,也能捕捉长期趋势。
在理解前向传播流程、清楚 FeedForward如何保证数据沿激活时间步正确流转之后,接下来我们介绍UpdateInputWeights方法 —— 该方法负责模型参数更新。
这个方法在训练阶段至关重要:权重与相关参数会依据算出的梯度在此处调整,让模型逐步拟合数据分布。在CCircleParams内部,该方法将逻辑转发给父类同名函数,并传入当前激活的时间步对象。
bool CCircleParams::UpdateInputWeights(void)
  {
   return CNeuronBaseOCL::updateInputWeights(cCurrent);
  }
传入当前时间步对象的指针,可以确保只对张量内对应的片段执行参数更新。这提升了计算效率,避免其余时间步产生无效运算。
需要重点说明的是,本阶段我们不会校验cCurrent指针的合法性。这是刻意设计的。前向传播和反向传播必须使用同一个时间步对象,这一点极其关键。权重更新过程中如果切换该对象,会破坏计算一致性,造成参数拟合出错。
指针有效性的校验交由父类方法完成。一旦出现异常,父类直接返回false,阻止权重错误更新。这套设计让我们聚焦当前时间步参数更新的核心逻辑,既不引入额外开销,也不会破坏全局相关性张量的结构。
这在金融时序场景下意义重大。模型每一步都基于当前数据稳定运算,同时保留全局模式,即便市场变化剧烈、噪声繁多,依旧可以保证预测精度与训练稳定性。
您应该已经注意到,我们跳过了误差梯度沿网络反向传播的环节。取而代之的是calcInputGradients方法被重写为桩实现(stub),直接返回成功标识。该设计看起来比较特殊,但对于全局相关性参数的更新而言完全够用。模型只需要知道该层输出端的误差梯度,就可以调整当前时间步对应的权重。
底层原始输入数据并不参与这部分计算,因为CCircleParams本质上并不接收外部原始输入。向该层回传梯度没有实际意义。
桩实现在这里起到重要作用:它让该类可以接入整体网络结构、和其他组件保持接口兼容,保证权重正常更新,同时不给系统增加不必要的算力负担。
综合以上机制,CCircleParams不再只是动态全局相关性张量的抽象构想,而是一套完备可控的组件,可以无缝集成至TQNet中。模型能够同时学习稳定的全局模式,并捕捉每个时间步的局部数据特征。这对金融市场尤为重要:模型既能够识别周期性规律、资产间稳定的相关关系,也可以应对短期震荡、市场噪声与突发行情。
我们已经完成了大量工作,本文篇幅也已经很长。上述内容需要一定时间消化理解,我们在此稍作停顿,梳理已经介绍的内容。
在下一篇文章中,我们将继续开发注意力算法,完成TQNet各组件的整体集成,演示前面介绍的结构与方法如何组合成一套有效的金融时序预测工具。
结论
在本文中,我们针对兼具模块化、灵活性与高性能的TQNet框架进行探究。这些特性使其成为金融时间序列预测与分析领域极具价值的工具。该框架的架构设计中,每个组件职责划分清晰,当替换或升级单个组件时,无需对整套系统进行大规模重构。
实践部分重点实现了全新的CCircleParams对象,用于管理全局相关性参数。我们详细剖析了它的初始化流程以及时间步的组织方式,还实现了多种张量初始值的设置算法。重点阐述了前向传播的构建、权重更新机制,以及各个时间步之间的计算同步逻辑。
由此,我们完成了这套灵活可靠的框架组件开发,可直接集成到更复杂的模型中完整使用。在下一篇文章中,我们将搭建统一的计算流水线,并基于历史数据开展测试,评估该系统在真实金融市场环境下的效果与鲁棒性。
链接
文中所用的程序
| # | 名称 | 类型 | 描述 |
|---|---|---|---|
| 1 | Study.mq5 | EA | 用于离线模型训练的EA |
| 2 | StudyOnline.mq5 | EA | 用于在线模型训练的EA |
| 3 | Test.mq5 | EA | 用于模型测试的EA |
| 4 | Trajectory.mqh | 类库 | 用于描述系统状态与模型架构的结构体 |
| 5 | NeuroNet.mqh | 类库 | 用于创建神经网络的类库 |
| 6 | NeuroNet.cl | 库 | OpenCL程序代码库 |
本文由MetaQuotes Ltd译自俄文
原文地址: https://www.mql5.com/ru/articles/19157
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。

 运用聪明钱概念(SMC)提升交易水平:订单块(OB)、结构突破(BOS)与公允价值缺口(FVG)
 新手在交易中的10个基本错误
 从新手到专家:使用MQL5实现动态新闻标题(X)——新闻交易的多品种图表视图
