

Скрытые полумарковские модели (HSMM) на MQL5: Распознавание рыночных режимов с учетом их длительности
 66
 0

Введение
В большинстве статей об определении рыночных режимов используется обычная скрытая марковская модель (HMM): несколько состояний, матрица переходов и прямой и обратный проходы для оценки текущего состояния. При этом предполагается геометрическое распределение времени пребывания в состоянии: вероятность того, что рыночный режим завершится на следующем баре, постоянна и не зависит от того, сколько времени он уже длится. Рынки ведут себя иначе: и тренды, и беспорядочные колебания цены обладают своего рода инерцией, связанной со средней длительностью этих рыночных режимов.
Скрытая полумарковская модель (HSMM) решает эту проблему, вынося описание длительности за пределы матрицы переходов и явно задавая для каждого состояния собственное распределение времени пребывания в состоянии. Таким образом, модель поддерживает текущую оценку ожидаемой оставшейся длительности текущего состояния, что позволяет торговому советнику (EA) удерживать трендовую позицию в основной фазе движения, но выходить из рынка, когда эта оценка приближается к нулю.
Здесь используется та же схема, что и в предыдущих работах этой серии о рыночных режимах: обучение вне торговой среды на Python и работа в реальном времени непосредственно на MQL5, но ставится другой вопрос: не только какое состояние наблюдается сейчас, но и сколько времени оно, вероятно, еще продлится.
Примечание о границах реализации: механизм вероятностного вывода с учетом длительности полностью реализован на MQL5 — Python используется только вне торговой среды для оценки параметров с помощью алгоритма EM. Все показанные решения рассчитаны на XAUUSD на таймфрейме M5, хотя математическая часть не привязана к конкретному инструменту.
Содержание
- Введение
- Почему длительность важна: от HMM к HSMM
- Конструирование признаков: три сигнала для определения рыночного режима
- Прямой фильтр с учетом длительности
- Чтение манифеста: JSON-мост между Python и MQL5, реализованный средствами MQL5
- От вероятностной оценки к торговле: гистерезис, фильтрация торговых решений по оставшейся длительности и расчет объема позиции
- Визуализация рыночного режима: инкрементальный фильтр индикатора
- Пограничные случаи и возможные проблемы
- Тестирование в тестере стратегий
- Заключение
Почему важна длительность: от HMM к HSMM
В стандартной HMM вероятность пребывания в состоянии j ровно ещё один бар соответствует диагональному элементу матрицы переходов, а вероятность пребывания ровно ещё k баров подчиняется геометрическому распределению:
P(duration = k | state = j) = (A_jj)^(k-1) * (1 - A_jj)
Мода этого распределения приходится на k = 1: на каждом баре наиболее вероятный исход — завершение рыночного режима прямо сейчас. Такая форма распределения необычна для рыночного режима: реальные тренды и боковые диапазоны сначала формируются, и лишь затем вероятность их завершения становится высокой. В HSMM вместо этого для каждого состояния явно подбирается распределение длительности d_j(k), независимое от матрицы переходов. Сама матрица задает лишь условные вероятности того, какое состояние наступит после завершения текущего.
В этом проекте для каждого состояния распределение d_j(k) подбирается в виде дискретизированного отрицательного биномиального распределения с верхним пределом в 60 баров на M5. Это двухпараметрическое семейство сглаживает шум в хвостах эмпирического распределения длительности, при этом точно воспроизводя эмпирические среднее и дисперсию.
Подобранные распределения длительности для каждого состояния рыночного режима
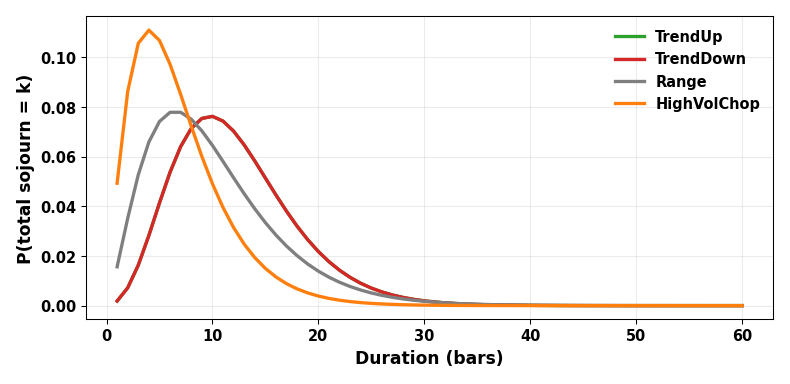
Рис. 1. Дискретизированные отрицательные биномиальные распределения длительности для четырех состояний рыночного режима в том виде, в котором они хранятся в hsmm_manifest.json. TrendUp и TrendDown имеют схожие распределения, смещенные вправо, в сторону большей длительности; распределение Range убывает быстрее всего; HighVolChop по замыслу является самым кратковременным состоянием, поскольку всплески волатильности, не переходящие в четкий тренд, обычно быстро затухают.
На практике HMM неявно задает оставшееся время через постоянную вероятность перехода, поэтому оценка оставшегося времени не зависит от того, сколько уже длится рыночный режим. В HSMM оценка оставшейся длительности постоянно обновляется и уменьшается, когда длительность текущего рыночного режима превышает моду его распределения. Эту оценку можно получать на каждом баре и непосредственно использовать для принятия решений.
Четыре состояния охватывают все рыночные режимы, которые должна различать система: TrendUp, TrendDown, Range (последнее — для беспорядочных колебаний цены с низким коэффициентом эффективности Кауфмана) и HighVolChop — для всплесков волатильности, которые так и не переходят в движение с четким направлением. Без HighVolChop такие всплески ошибочно интерпретируются как неоднозначная смесь двух трендовых состояний.
Конструирование признаков: три сигнала для определения рыночного режима
Модель наблюдений оценивает каждый закрытый бар по трем признакам, каждый из которых рассчитывается в скользящем окне из 20 баров. Все три признака представляют собой безразмерные отношения, а не исходные значения цены или волатильности, поэтому обученная модель применима к различным рыночным режимам волатильности и не требует повторной подгонки при каждом изменении ATR:
- realized_vol_dev — отношение реализованной волатильности в коротком окне к уровню волатильности, подразумеваемому ATR брокера, минус единица; выявляет рост волатильности до того, как ATR успеет на него отреагировать.
- efficiency_ratio — коэффициент эффективности Кауфмана: отношение результирующего изменения цены к суммарной длине ее пути; близок к 1,0 при четком тренде и к 0,0 при беспорядочных колебаниях цены.
- return_skew — асимметрия доходностей, то есть третий стандартизованный момент распределения доходностей в окне; позволяет отличить медленное поступательное движение от панического одностороннего движения и придает TrendUp/TrendDown различимые характеристики даже при схожих волатильности и коэффициенте эффективности Кауфмана.
Все три формулы реализованы в одном месте — в CHSMMFilter::ComputeFeatures(); торговый советник (EA) и индикатор используют эту реализацию без изменений, что исключает расхождения между ними в расчете признаков при обучении и применении модели:
//+------------------------------------------------------------------+
//| CHSMMFilter::ComputeFeatures                                     |
//+------------------------------------------------------------------+
bool CHSMMFilter::ComputeFeatures(const double &close[], int shift, double atr_value, double &features_out[])
  {
//--- close[] must be a series-indexed array (ArraySetAsSeries(...,true))
//--- so that close[shift] is the bar we are scoring and close[shift+1]
//--- is one bar older. FEATURE_LOOKBACK+1 closes are required to form
//--- FEATURE_LOOKBACK log-returns, so callers must guarantee that many
//--- bars exist before calling this -- callers should check
//--- Bars(...) >= FEATURE_LOOKBACK+2 before entering their bar loop.
   ArrayResize(features_out, NUM_FEATURES);

   double returns[FEATURE_LOOKBACK];
   for(int i = 0; i < FEATURE_LOOKBACK; i++)
     {
      double c_new = close[shift + i];
      double c_old = close[shift + i + 1];
      if(c_old <= 0.0 || c_new <= 0.0)
         return(false);   // guard: corrupt/zero price would poison MathLog below
      returns[i] = MathLog(c_new / c_old);
     }

//--- feature 0: realized_vol_dev -- how far the SHORT-WINDOW realized
//--- volatility of returns sits from the volatility implied by the
//--- broker's own ATR reading. Zero means "about what ATR would
//--- predict"; a large positive value flags a volatility expansion
//--- that ATR (a slower, smoothed measure) has not yet caught up to
//--- -- exactly the kind of regime break this model is meant to
//--- detect early.
   double mean_r = 0.0;
   for(int i = 0; i < FEATURE_LOOKBACK; i++)
      mean_r += returns[i];
   mean_r /= FEATURE_LOOKBACK;

   double var_r = 0.0;
   for(int i = 0; i < FEATURE_LOOKBACK; i++)
     {
      double d = returns[i] - mean_r;
      var_r += d * d;
     }
   var_r /= FEATURE_LOOKBACK;
   double realized_sigma = MathSqrt(var_r);

   double atr_frac = atr_value / close[shift];
   if(atr_frac < 1e-8)
      atr_frac = 1e-8;   // guard against a zero/near-zero ATR reading on a very quiet symbol
   features_out[0] = (realized_sigma / atr_frac) - 1.0;

//--- feature 1: Kaufman efficiency ratio -- net directional travel
//--- divided by total path length walked to get there, over the same
//--- lookback window. Close to 1.0 means the price moved in a
//--- straight line (a clean trend); close to 0.0 means it wandered
//--- back and forth and ended up near where it started (chop/range).
   double net_change = MathAbs(close[shift] - close[shift + FEATURE_LOOKBACK]);
   double path_sum = 0.0;
   for(int i = 0; i < FEATURE_LOOKBACK; i++)
      path_sum += MathAbs(close[shift + i] - close[shift + i + 1]);
   if(path_sum < 1e-12)
      path_sum = 1e-12;   // guard: a perfectly flat window would otherwise divide by zero
   features_out[1] = net_change / path_sum;

//--- feature 2: return skew -- third standardized moment of the
//--- return window. Distinguishes a slow grinding trend (mildly
//--- skewed) from a panic move (heavily skewed in one direction),
//--- which is useful because two regimes can share similar realized
//--- volatility and efficiency ratio yet have very different skew
//--- signatures.
   double m3 = 0.0;
   for(int i = 0; i < FEATURE_LOOKBACK; i++)
     {
      double d = returns[i] - mean_r;
      m3 += d * d * d;
     }
   m3 /= FEATURE_LOOKBACK;
   double sigma3 = MathPow(realized_sigma, 3.0);
   if(sigma3 < 1e-12)
      sigma3 = 1e-12;   // guard: near-zero variance window would otherwise blow up the ratio
   features_out[2] = m3 / sigma3;

   return(true);
  }
Проверка на нулевую цену перед вызовом MathLog() и нижняя граница для ATR, выраженного как доля цены, защищают от реальной, хотя и редкой ситуации: на участке с полным отсутствием ликвидности (малоликвидная сессия, кратковременный сбой потока котировок) возникает бар с нулевым диапазоном. Без этих мер это привело бы к делению на величину, близкую к нулю, и необоснованному всплеску правдоподобия наблюдения.
Приведенная ниже диаграмма рассеяния показывает, почему эти три признака позволяют достаточно хорошо разделить четыре состояния для подбора гауссовой модели наблюдений на синтетической последовательности, сгенерированной по оцененным параметрам из самого манифеста: это проверка правдоподобия формы распределений, а не заявление об эффективности торговли на рынке:
Разделение четырех состояний рыночного режима в пространстве синтетических признаков
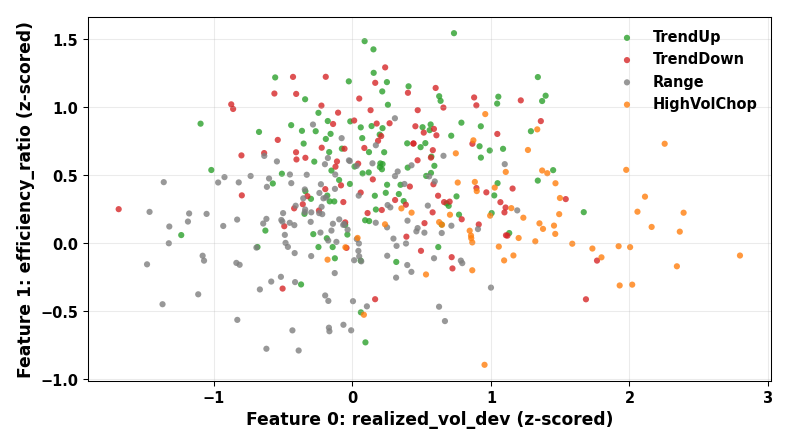
Рис. 2. Диаграмма realized_vol_dev и efficiency_ratio для 400 синтетически сгенерированных баров; цвет обозначает истинное состояние, в котором сгенерирован каждый бар. TrendUp и TrendDown образуют кластеры при высоких значениях коэффициента эффективности Кауфмана; Range располагается в области низких значений по обеим осям; HighVolChop выделяется вдоль оси волатильности, сохраняя низкие значения коэффициента эффективности Кауфмана — именно это разделение и должны использовать гауссовы распределения модели наблюдений.
Прямой фильтр с учетом длительности
Именно это позволяет модели учитывать длительность в реальном времени: здесь используется принципиально иное рекуррентное соотношение, чем в классическом прямом проходе HMM из учебников. Распределение вероятностей состояний и оставшейся длительности представлено массивом alpha[state][remaining_duration]: каждая ячейка содержит вероятность нахождения в определенном состоянии с заданным числом баров до его завершения. На каждом баре это распределение может изменяться двумя способами: детерминированным и вероятностным:
alpha_t(j, d) for d > 0:  mass simply moves to (j, d-1) -- the state continues, deterministically
alpha_{t-1}(j, 0):     the state finishes; mass exits to a NEW state j' ~ A[j][j'],
                          drawing a brand-new duration k ~ duration_pmf[j'], landing on (j', k-1)
Первый случай сводится к простому учету: длительность уже была случайным образом выбрана при входе в состояние, поэтому ее обратный отсчет не требует дополнительных вычислительных затрат. Во втором случае в работу вступают матрица переходов и функция вероятностей длительности: следующее состояние случайным образом выбирается по матрице переходов с нулевой диагональю, а его длительность независимо выбирается по соответствующей этому состоянию функции вероятностей длительности. Это функция CHSMMFilter::PredictStep():
//+------------------------------------------------------------------+
//| CHSMMFilter::PredictStep                                         |
//+------------------------------------------------------------------+
void CHSMMFilter::PredictStep(void)
  {
//--- explicit-duration (residual-time) HSMM time update. Each belief
//--- cell alpha[j,d] holds P(state=j, d bars remaining in this state).
//--- Two things can happen to the mass in a cell between bar t-1 and
//--- bar t:
//---   1) d > 0: the state simply continues -- remaining duration
//---      counts down by exactly one, deterministically. No branch,
//---      no probability multiply, because the duration was already
//---      drawn when the state was entered.
//---   2) d == 0: this bar was the LAST bar of the state's sojourn,
//---      so the process transitions OUT to some new state j' (drawn
//---      from the off-diagonal transition matrix) and simultaneously
//---      draws a brand-new total duration k for j' from that state's
//---      duration pmf, landing in cell (j', k-1).
   double pred[NUM_STATES * MAX_DURATION];
   ArrayInitialize(pred, 0.0);

   double finishing[NUM_STATES];
   for(int j = 0; j < NUM_STATES; j++)
      finishing[j] = m_alpha[j * MAX_DURATION + 0];

//--- case 1: deterministic countdown for every cell with d > 0.
   for(int j = 0; j < NUM_STATES; j++)
     {
      for(int d = 1; d < MAX_DURATION; d++)
        {
         double mass = m_alpha[j * MAX_DURATION + d];
         if(mass <= 0.0)
            continue;
         pred[j * MAX_DURATION + (d - 1)] += mass;
        }
     }

//--- case 2: mass finishing state j is redistributed into every
//--- other state j', weighted by the transition probability and by
//--- that state's own duration pmf (which sets its NEW remaining
//--- duration on entry). Truncating k at MAX_DURATION means a tiny
//--- amount of probability mass for exceptionally long regimes is
//--- dropped rather than wrapped or clipped into the last bucket --
//--- an acceptable approximation as long as the duration pmf was fit
//--- so its tail is already small beyond MAX_DURATION bars.
   for(int j = 0; j < NUM_STATES; j++)
     {
      if(finishing[j] <= 0.0)
         continue;
      for(int jp = 0; jp < NUM_STATES; jp++)
        {
         if(jp == j)
            continue;
         double outflow = finishing[j] * m_transition[j * NUM_STATES + jp];
         if(outflow <= 0.0)
            continue;
         for(int k = 1; k <= MAX_DURATION; k++)
           {
            double p_dur = m_duration_pmf[jp * MAX_DURATION + (k - 1)];
            if(p_dur <= 0.0)
               continue;
            pred[jp * MAX_DURATION + (k - 1)] += outflow * p_dur;
           }
        }
     }

   ArrayCopy(m_alpha, pred);
  }
При усечении на MAX_DURATION небольшая вероятностная масса, соответствующая очень длительным рыночным режимам, отбрасывается, а не переносится в последнюю ячейку распределения. Это допустимо, если хвост функции вероятностей длительности уже мал к 60 барам, что обеспечивается при обучении сглаживанием на основе отрицательного биномиального распределения.
После переноса распределения вероятностей на следующий шаг признаки закрытого бара учитываются посредством байесовского обновления по правдоподобию: каждая ячейка, относящаяся к состоянию j, умножается на гауссово правдоподобие наблюдения для этого состояния, поскольку в данной модели длительность по построению не влияет на распределение наблюдений:
//+------------------------------------------------------------------+
//| CHSMMFilter::GaussianLogLik                                      |
//+------------------------------------------------------------------+
double CHSMMFilter::GaussianLogLik(int state, const double &norm_features[])
  {
//--- diagonal-covariance multivariate Gaussian log-density, summed
//--- feature-by-feature. Working in log space (rather than
//--- multiplying raw densities together) avoids underflow to exactly
//--- zero when several features are simultaneously several standard
//--- deviations from a state's mean -- a real risk once NUM_FEATURES
//--- and the number of states both grow.
   double log_lik = 0.0;
   for(int f = 0; f < NUM_FEATURES; f++)
     {
      double var = m_emission_var[state * NUM_FEATURES + f];
      if(var < 1e-8)
         var = 1e-8;    // guard: a state that saw almost no feature variance during training
      double mean = m_emission_mean[state * NUM_FEATURES + f];
      double diff = norm_features[f] - mean;
      log_lik += -0.5 * MathLog(2.0 * M_PI * var) - 0.5 * (diff * diff) / var;
     }
   return(log_lik);
  }

//+------------------------------------------------------------------+
//| CHSMMFilter::UpdateStep                                          |
//+------------------------------------------------------------------+
void CHSMMFilter::UpdateStep(const double &raw_features[])
  {
//--- Bayesian measurement update: multiply every (state,duration)
//--- cell by that state's emission likelihood for the bar just
//--- closed, then renormalize. Duration does not affect the
//--- emission -- by construction the observation model only reads
//--- the discrete regime label, not how long it has been active --
//--- so every cell belonging to state j gets the SAME multiplier.
   double norm_features[];
   NormalizeFeatures(raw_features, norm_features);

   double log_lik[NUM_STATES];
   double max_log_lik = -DBL_MAX;
   for(int j = 0; j < NUM_STATES; j++)
     {
      log_lik[j] = GaussianLogLik(j, norm_features);
      if(log_lik[j] > max_log_lik)
         max_log_lik = log_lik[j];
     }

//--- numerically stable exponentiation: subtract the max log-lik
//--- before calling MathExp() so the largest term becomes exp(0)=1
//--- and every other term is a well-behaved value in (0,1], instead
//--- of risking exp() underflow/overflow on raw log-likelihoods that
//--- can run to several hundred in magnitude.
   double lik[NUM_STATES];
   for(int j = 0; j < NUM_STATES; j++)
      lik[j] = MathExp(log_lik[j] - max_log_lik);

   double total = 0.0;
   for(int j = 0; j < NUM_STATES; j++)
     {
      for(int d = 0; d < MAX_DURATION; d++)
        {
         m_alpha[j * MAX_DURATION + d] *= lik[j];
         total += m_alpha[j * MAX_DURATION + d];
        }
     }

//--- renormalize so the belief stays a proper probability
//--- distribution. If total collapses to (near) zero -- e.g. after
//--- many bars of extremely unlikely observations under every state
//--- -- fall back to a fresh uniform prior rather than dividing by
//--- (near) zero and injecting NaNs into the belief state.
   if(total < 1e-300)
     {
      ResetBelief();
      return;
     }
   for(int i = 0; i < NUM_STATES * MAX_DURATION; i++)
      m_alpha[i] /= total;
  }
Вычитание максимума перед вызовом MathExp() — не формальность: исходные значения логарифма правдоподобия могут достигать сотен по модулю, а непосредственное экспоненцирование грозит переполнением или незаметным переполнением снизу, при котором результат округляется до нуля, что создало бы у фильтра искусственно завышенную уверенность. Предварительное вычитание максимума удерживает все экспоненцированные значения в численно безопасном диапазоне [0,1].
Чтобы принять решение, нужно просуммировать вероятности по длительности для оценки состояния, а затем вычислить ожидаемую оставшуюся длительность как среднее значений длительности, взвешенных по их вероятностям. Функция ManageTrades() использует это значение; в обычной HMM его прямого аналога нет:
//+------------------------------------------------------------------+
//| CHSMMFilter::StepFilter                                          |
//+------------------------------------------------------------------+
void CHSMMFilter::StepFilter(const double &raw_features[])
  {
//--- convenience wrapper: advance the belief by exactly one closed
//--- bar. Predict must run BEFORE Update -- Predict propagates last
//--- bar's posterior forward through the countdown/transition
//--- dynamics to form this bar's prior, and only then does Update
//--- fold in this bar's actual observation. Calling these in the
//--- opposite order would condition on an observation before the
//--- state had even been allowed to evolve, which is not the filter
//--- this class is documented to implement.
   PredictStep();
   UpdateStep(raw_features);
  }

//+------------------------------------------------------------------+
//| CHSMMFilter::GetFilteredState                                    |
//+------------------------------------------------------------------+
int CHSMMFilter::GetFilteredState(double &confidence)
  {
//--- marginalizes the belief over duration to get P(state=j) for
//--- each state, then returns the argmax and its probability mass as
//--- a confidence score the caller can threshold against before
//--- acting on a regime call.
   double state_prob[NUM_STATES];
   for(int j = 0; j < NUM_STATES; j++)
     {
      double s = 0.0;
      for(int d = 0; d < MAX_DURATION; d++)
         s += m_alpha[j * MAX_DURATION + d];
      state_prob[j] = s;
     }
   int best = 0;
   for(int j = 1; j < NUM_STATES; j++)
      if(state_prob[j] > state_prob[best])
         best = j;
   confidence = state_prob[best];
   return(best);
  }

//+------------------------------------------------------------------+
//| CHSMMFilter::GetExpectedRemainingDuration                        |
//+------------------------------------------------------------------+
double CHSMMFilter::GetExpectedRemainingDuration(int state)
  {
//--- E[remaining bars | state=j] = sum_d d * alpha[j,d] / sum_d alpha[j,d].
//--- This is the number that makes the model "duration-aware" in a way
//--- a plain HMM's transition-matrix diagonal never gives you directly:
//--- a caller can gate entries on the regime STILL having runway left,
//--- not just on which regime is currently most likely.
   double num = 0.0, den = 0.0;
   for(int d = 0; d < MAX_DURATION; d++)
     {
      double mass = m_alpha[state * MAX_DURATION + d];
      num += d * mass;
      den += mass;
     }
   if(den < 1e-12)
      return(0.0);
   return(num / den);
  }
E[remaining bars | state=j] = sum_d( d * alpha[j,d] ) / sum_d( alpha[j,d] )
При обработке синтетической последовательности из 400 баров, сгенерированной по параметрам из самого манифеста, фильтр определяет истинный рыночный режим, породивший данные, примерно на трех из каждых четырех баров — это полезная проверка корректности перед применением рекуррентного алгоритма к реальным данным:
Апостериорное распределение рыночных режимов после фильтрации на синтетической последовательности из 400 баров
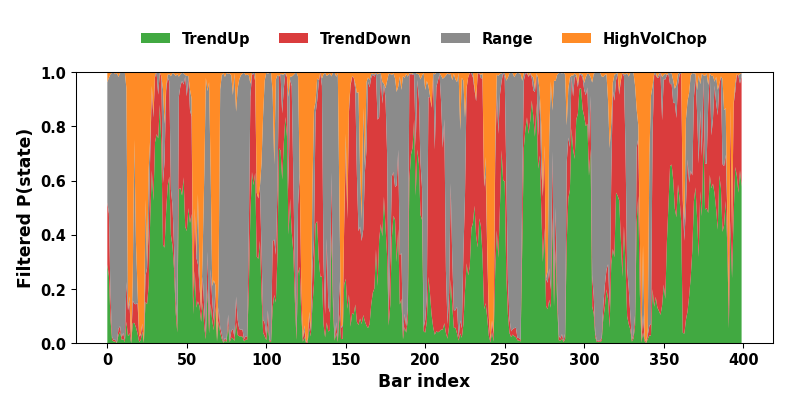
Рис. 3. Апостериорное распределение P(state) после фильтрации на 400 синтетических барах, представленное диаграммой с накоплением. Высота каждой полосы соответствует текущей вероятности данного состояния; модель отслеживает смены исходных рыночных режимов (известных, поскольку они сгенерированы синтетически) с небольшой задержкой, что и ожидается от любого каузального фильтра: он всегда учитывает только прошлые данные.
Чтение манифеста: JSON-мост между Python и MQL5 без сторонних библиотек
Скрипт алгоритма EM, работающий офлайн, экспортирует все оцененные параметры в hsmm_manifest.json: параметры модели наблюдений, матрицу переходов, функции вероятностей длительности и статистики нормализации. В MQL5 нет встроенного парсера JSON для загрузки этого файла. Вместо подключения полноценного синтаксического анализатора JSON для манифеста с небольшим фиксированным набором ключей CJSONArrayUtils реализует всего две операции: извлечение необработанного значения именованного поля из документа и развертывание числового массива любой глубины вложенности в буфер с построчным порядком элементов. Обе операции используют один и тот же прием: при сканировании отслеживается глубина вложенности скобок ("[" или "{"), а запятая или закрывающая скобка считается границей только при нулевой глубине — именно это позволяет SplitTopLevel() безопасно рекурсивно обрабатывать вложенные массивы:
void CJSONArrayUtils::SplitTopLevel(string s, string &parts_out[])
  {
//--- splits a comma-separated JSON list at commas that sit at
//--- bracket-depth zero only. A manifest field such as
//--- "[[1,2],[3,4]]" must NOT be split at the commas that separate
//--- 1 from 2, only at the comma that separates the two inner
//--- arrays -- so we track '[' / '{' depth as we scan and only
//--- treat a comma as a delimiter when depth == 0.
   ArrayResize(parts_out, 0);
   int depth = 0;
   int start = 0;
   int len = StringLen(s);
   for(int i = 0; i < len; i++)
     {
      ushort c = StringGetCharacter(s, i);
      if(c == '[' || c == '{')
         depth++;
      else if(c == ']' || c == '}')
         depth--;
      else if(c == ',' && depth == 0)
        {
         string token = StringSubstr(s, start, i - start);
         StringTrimLeft(token);
         StringTrimRight(token);
         int n = ArraySize(parts_out);
         ArrayResize(parts_out, n + 1);
         parts_out[n] = token;
         start = i + 1;
        }
     }
//--- flush the final token -- there is no trailing comma after the
//--- last element, so the loop above never emits it on its own.
   string last_token = StringSubstr(s, start, len - start);
   StringTrimLeft(last_token);
   StringTrimRight(last_token);
   if(StringLen(last_token) > 0)
     {
      int n2 = ArraySize(parts_out);
      ArrayResize(parts_out, n2 + 1);
      parts_out[n2] = last_token;
     }
  }
ExtractValueRaw() использует тот же принцип, чтобы извлечь заключенное в скобки значение поля целиком, а не обрезать его на первой внутренней запятой, как при простом поиске следующей запятой с помощью StringFind():
string CJSONArrayUtils::ExtractValueRaw(string json, string key)
  {
//--- returns the raw (still JSON-encoded) value text that follows
//--- "\"key\":" inside json, respecting bracket depth so a value that
//--- is itself an object/array is captured whole rather than cut off
//--- at its first internal comma. This is a targeted extractor (not
//--- a general parser) because the manifest has a small, fixed key
//--- set -- a full recursive-descent grammar would be more code for
//--- no practical benefit here.
   string needle = "\"" + key + "\":";
   int pos = StringFind(json, needle);
   if(pos < 0)
      return("");
   int cursor = pos + StringLen(needle);
   int len = StringLen(json);
//--- skip whitespace between the colon and the value proper.
   while(cursor < len && StringGetCharacter(json, cursor) == ' ')
      cursor++;
   ushort first = StringGetCharacter(json, cursor);
   int start = cursor;
   if(first == '[' || first == '{')
     {
      //--- bracketed value: walk forward counting depth until the
      //--- matching close bracket is found.
      ushort open_ch  = first;
      ushort close_ch = (first == '[') ? ']' : '}';
      int depth = 0;
      for(int i = cursor; i < len; i++)
        {
         ushort c = StringGetCharacter(json, i);
         if(c == open_ch)
            depth++;
         else if(c == close_ch)
           {
            depth--;
            if(depth == 0)
               return(StringSubstr(json, start, i - start + 1));
           }
        }
      return(StringSubstr(json, start, len - start));
     }
   else if(first == '"')
     {
      //--- quoted string value: find the closing quote.
      int i = cursor + 1;
      while(i < len && StringGetCharacter(json, i) != '"')
         i++;
      return(StringSubstr(json, start, i - start + 1));
     }
   else
     {
      //--- bare number/literal: ends at the next comma or closing
      //--- brace at the current (top) level.
      int i = cursor;
      while(i < len)
        {
         ushort c = StringGetCharacter(json, i);
         if(c == ',' || c == '}' || c == '\n' || c == '\r')
            break;
         i++;
        }
      return(StringSubstr(json, start, i - start));
     }
  }
С помощью этих двух базовых операций LoadManifest() считывает весь файл, извлекает каждое поле по имени и копирует каждый разобранный массив в соответствующий массив-член класса фиксированного размера с сохранением индексов:
bool CHSMMFilter::LoadManifest(string filename)
  {
   string json;
   if(!ReadWholeFile(filename, json))
      return(false);

//--- scalar contract fields -- read first so ValidateContract() can
//--- reject a mismatched manifest before we waste time parsing the
//--- (potentially large) numeric arrays below.
   m_manifest_num_states   = (int)StringToInteger(CJSONArrayUtils::ExtractValueRaw(json, "num_states"));
   m_manifest_max_duration = (int)StringToInteger(CJSONArrayUtils::ExtractValueRaw(json, "max_duration"));

//--- feature_names is an array; its element COUNT (not its content)
//--- is what the three-way contract actually checks against
//--- NUM_FEATURES -- there is no separate scalar "feature count"
//--- field in the manifest, since that would just be a second source
//--- of truth that could itself drift out of sync with the array.
   string feat_names_raw = CJSONArrayUtils::ExtractValueRaw(json, "feature_names");
   string feat_name_tokens[];
   CJSONArrayUtils::SplitTopLevel(CJSONArrayUtils::StripBrackets(feat_names_raw), feat_name_tokens);
   m_manifest_num_features = ArraySize(feat_name_tokens);

   if(!ValidateContract())
      return(false);

//--- numeric parameter blocks -- each parsed into a flat double
//--- array via CJSONArrayUtils::ParseDoubleArray, then copied into
//--- the fixed-size member arrays index-for-index (row-major, so
//--- emission_mean[state][feature] lives at state*NUM_FEATURES+feature).
   double tmp[];

   CJSONArrayUtils::ParseDoubleArray(CJSONArrayUtils::ExtractValueRaw(json, "emission_mean"), tmp);
   for(int i = 0; i < ArraySize(tmp) && i < NUM_STATES * NUM_FEATURES; i++)
      m_emission_mean[i] = tmp[i];

   CJSONArrayUtils::ParseDoubleArray(CJSONArrayUtils::ExtractValueRaw(json, "emission_var"), tmp);
   for(int i = 0; i < ArraySize(tmp) && i < NUM_STATES * NUM_FEATURES; i++)
      m_emission_var[i] = tmp[i];

   CJSONArrayUtils::ParseDoubleArray(CJSONArrayUtils::ExtractValueRaw(json, "transition_matrix"), tmp);
   for(int i = 0; i < ArraySize(tmp) && i < NUM_STATES * NUM_STATES; i++)
      m_transition[i] = tmp[i];

   CJSONArrayUtils::ParseDoubleArray(CJSONArrayUtils::ExtractValueRaw(json, "duration_pmf"), tmp);
   for(int i = 0; i < ArraySize(tmp) && i < NUM_STATES * MAX_DURATION; i++)
      m_duration_pmf[i] = tmp[i];

   CJSONArrayUtils::ParseDoubleArray(CJSONArrayUtils::ExtractValueRaw(json, "feature_norm_mean"), tmp);
   for(int i = 0; i < ArraySize(tmp) && i < NUM_FEATURES; i++)
      m_feat_norm_mean[i] = tmp[i];

   CJSONArrayUtils::ParseDoubleArray(CJSONArrayUtils::ExtractValueRaw(json, "feature_norm_std"), tmp);
   for(int i = 0; i < ArraySize(tmp) && i < NUM_FEATURES; i++)
      m_feat_norm_std[i] = tmp[i];

//--- state_names is a string array, not numeric, so it gets its own
//--- lightweight split-and-strip-quotes pass rather than reusing
//--- ParseDoubleArray.
   string names_raw = CJSONArrayUtils::ExtractValueRaw(json, "state_names");
   string name_tokens[];
   CJSONArrayUtils::SplitTopLevel(CJSONArrayUtils::StripBrackets(names_raw), name_tokens);
   for(int i = 0; i < ArraySize(name_tokens) && i < NUM_STATES; i++)
     {
      string t = name_tokens[i];
      StringTrimLeft(t);
      StringTrimRight(t);
      StringReplace(t, "\"", "");
      m_state_names[i] = t;
     }

   m_loaded = true;
   ResetBelief();
   Print("CHSMMFilter: manifest loaded OK from ", filename);
   return(true);
  }
Скалярные поля контракта совместимости — num_states, max_duration и число элементов в feature_names — считываются и проверяются с помощью ValidateContract() до разбора любых больших числовых массивов:
bool CHSMMFilter::ValidateContract(void)
  {
//--- the three-way contract: compile-time constants, manifest
//--- fields, and (implicitly, via array sizes above) the actual
//--- parsed array lengths must all agree. We fail loudly here rather
//--- than silently truncating or padding a mismatched array, because
//--- a silent truncation would let the EA run with a corrupted model
//--- and produce plausible-looking but meaningless regime calls.
   bool ok = true;
   if(m_manifest_num_states != NUM_STATES)
     {
      Print("CHSMMFilter: CONTRACT MISMATCH -- manifest num_states=", m_manifest_num_states,
            " but compiled NUM_STATES=", NUM_STATES);
      ok = false;
     }
   if(m_manifest_num_features != NUM_FEATURES)
     {
      Print("CHSMMFilter: CONTRACT MISMATCH -- manifest feature_names count=", m_manifest_num_features,
            " but compiled NUM_FEATURES=", NUM_FEATURES);
      ok = false;
     }
   if(m_manifest_max_duration != MAX_DURATION)
     {
      Print("CHSMMFilter: CONTRACT MISMATCH -- manifest max_duration=", m_manifest_max_duration,
            " but compiled MAX_DURATION=", MAX_DURATION);
      ok = false;
     }
   return(ok);
  }
Несовместимый манифест — например, полученный при обучении модели с пятью состояниями после изменения NUM_STATES без перекомпиляции — не усекается и не дополняется нулями без предупреждения: OnInit() возвращает INIT_FAILED, и торговый советник (EA) не запускается, вместо того чтобы торговать на основе распределения вероятностей состояний и оставшейся длительности, полученного из поврежденной модели.
Манифест создается скриптом train_hsmm.py, который запускается в автономном режиме на исторических данных OHLC, экспортированных из MetaTrader 5. При импорте CSV учитываются две особенности: запись средствами FILE_CSV в MetaTrader 5 выполняется в кодировке UTF-16, а не UTF-8, а разделитель определяется региональными настройками терминала и не обязательно является запятой:
def load_mt5_csv(path):
    """
    Loads an OHLC history CSV as exported from the MT5 terminal.

    Two MT5-specific quirks are handled here rather than left for pandas'
    defaults to mangle silently:
      - MT5's FILE_CSV writer emits UTF-16, not UTF-8, so a plain
        pd.read_csv() call would either raise or -- worse -- succeed
        while reading garbage.
      - The column delimiter follows the terminal's Windows regional
        setting (comma OR semicolon depending on locale), so we let
        pandas' python engine sniff it via sep=None rather than hard-
        coding one and having the import silently misparse on a
        different machine.
    """
    df = pd.read_csv(path, sep=None, engine="python", encoding="utf-16")
    # a UTF-16 BOM sometimes survives as a literal character glued onto
    # the first column name (e.g. "\ufeffTime") -- strip it so column
    # lookups by name don't mysteriously fail.
    df.columns = [c.replace("\ufeff", "") for c in df.columns]
    df = df.rename(columns={c: c.strip().lower() for c in df.columns})
    df = df.sort_values("time" if "time" in df.columns else df.columns[0])
    df = df.reset_index(drop=True)
compute_features() — это точный перенос функции CHSMMFilter::ComputeFeatures() из раздела 4 на Python, векторизованный с помощью numpy, но без изменения структуры: обе реализации должны одинаково вычислять значения признаков на каждом баре:
def compute_features(close, atr):
    """
    Builds the same three features CHSMMFilter::ComputeFeatures()
    computes on the MQL5 side, over a rolling FEATURE_LOOKBACK window.
    Vectorized with numpy for training-time speed across a full history,
    but the underlying formulas are deliberately kept identical,
    term-for-term, to the MQL5 implementation.

    Returns an (N - FEATURE_LOOKBACK, NUM_FEATURES) array; row i
    corresponds to bar index i + FEATURE_LOOKBACK in the original series.
    """
    close = np.asarray(close, dtype=np.float64)
    atr = np.asarray(atr, dtype=np.float64)
    n = len(close)
    log_ret = np.diff(np.log(close))  # log_ret[t] = ln(close[t+1]/close[t])

    n_rows = n - FEATURE_LOOKBACK
    feats = np.zeros((n_rows, NUM_FEATURES), dtype=np.float64)

    for row, t in enumerate(range(FEATURE_LOOKBACK, n)):
        # window of returns ending at bar t: the FEATURE_LOOKBACK returns
        # immediately preceding it, matching CHSMMFilter's
Оценка параметров выполняется в цикле алгоритма ожидания-максимизации (EM) — аналога алгоритма Баума–Велча, расширенного за счет явного измерения длительности. На E-шаге выполняются полные прямой и обратный проходы по всей последовательности, в отличие от онлайн-фильтра MQL5, который учитывает только прошлые данные. В результате получаются сглаженные апостериорные распределения как по состояниям, так и по оставшейся длительности каждого состояния:
def forward_backward_hsmm(feats, trans, dur_pmf, em_mean, em_var):
    """
    Full (non-truncated-for-real-time) explicit-duration forward-backward
    pass over the WHOLE training sequence, used only inside the EM loop.
    This differs from CHSMMFilter's online PredictStep()/UpdateStep() in
    one important way: it also runs a BACKWARD pass, giving smoothed
    (not just filtered) state/duration posteriors -- appropriate for
    offline parameter estimation, where the whole sequence is already
    available, but not something the live EA can do (it only ever sees
    the past).

    Returns:
      gamma:      (T, NUM_STATES)               smoothed P(state=j | all data)
      xi_finish:  (T, NUM_STATES, NUM_STATES)    smoothed P(state j finishes and
                                                  transitions to j' at time t)
      dur_gamma:  (T, NUM_STATES, MAX_DURATION)  smoothed P(state=j, remaining=d)
      total_loglik: float                        true data log-likelihood under the
                                                  CURRENT parameters, log P(O_1:T),
                                                  accumulated from the forward pass's
                                                  own normalizing constants -- this is
                                                  what should actually be tracked for
                                                  EM convergence, not a property of
                                                  gamma (which sums to 1 by
                                                  construction at every t and so
                                                  carries no information about fit
                                                  quality at all).
    """
    T = feats.shape[0]

    # emission log-likelihoods, precomputed once per state for the whole
    # sequence -- this is the single most expensive step per EM
    # iteration, so it is deliberately hoisted out of the T-length loops
    # below rather than recomputed per time step.
    loglik = np.zeros((T, NUM_STATES))
    for j in range(NUM_STATES):
        loglik[:, j] = gaussian_logpdf_diag(feats, em_mean[j], em_var[j])
    lik = np.exp(loglik - loglik.max(axis=1, keepdims=True))

    # forward pass -- same recursion as CHSMMFilter::PredictStep() /
    # UpdateStep(), just kept in an explicit (T, NUM_STATES, MAX_DURATION)
    # array instead of updated in place, because the backward pass below
    # needs every time step's alpha, not just the latest one.
    #
    # This is also a SCALED forward pass in the classic HMM sense: each
    # step's normalizing constant (the total probability mass before
    # dividing it back down to 1) is itself meaningful -- summed in log
    # space across all T steps, it IS the true log-likelihood of the
    # whole observed sequence under the current parameters. Discarding
    # these constants (as an earlier version of this function did) throws
    # away the one number EM convergence should actually be checked
    # against.
    alpha = np.zeros((T, NUM_STATES, MAX_DURATION))
    alpha[0] = 1.0 / (NUM_STATES * MAX_DURATION)
    alpha[0] *= lik[0][:, None]
    c0 = alpha[0].sum()
    alpha[0] /= max(c0, 1e-300)
    # lik[t] = exp(loglik[t] - loglik[t].max()) for numerical stability,
    # which scales every state's likelihood at time t down by a uniform
    # factor of exp(-loglik[t].max()). The true (unscaled) normalizing
    # constant is therefore this step's computed total multiplied back
    # up by exp(+loglik[t].max()) -- i.e. ADD the max back on in log
    # space, not subtract it.
    total_loglik = np.log(max(c0, 1e-300)) + loglik[0].max()

    for t in range(1, T):
        pred = np.zeros((NUM_STATES, MAX_DURATION))
        finishing = alpha[t - 1, :, 0]
        pred[:, :-1] += alpha[t - 1, :, 1:]
        for j in range(NUM_STATES):
            if finishing[j] <= 0:
                continue
            for jp in range(NUM_STATES):
                if jp == j:
                    continue
                outflow = finishing[j] * trans[j, jp]
                if outflow <= 0:
                    continue
                pred[jp, :] += outflow * dur_pmf[jp, :]
        pred *= lik[t][:, None]
        total = pred.sum()
        alpha[t] = pred / total if total > 1e-300 else 1.0 / (NUM_STATES * MAX_DURATION)
        total_loglik += np.log(max(total, 1e-300)) + loglik[t].max()

    # backward pass -- mirror recursion run from T-1 down to 0.
    beta = np.zeros((T, NUM_STATES, MAX_DURATION))
    beta[T - 1] = 1.0
    for t in range(T - 2, -1, -1):
        nxt = beta[t + 1] * lik[t + 1][:, None]
        b = np.zeros((NUM_STATES, MAX_DURATION))
        # continuing (d>0 at t maps to d-1 at t+1)
        b[:, 1:] += nxt[:, :-1]
        # finishing (d==0 at t): probability mass flows out via
        # transition+duration draw, symmetric to the forward pass.
        for j in range(NUM_STATES):
            acc = 0.0
            for jp in range(NUM_STATES):
                if jp == j:
                    continue
                acc += trans[j, jp] * np.sum(dur_pmf[jp, :] * nxt[jp, :])
            b[j, 0] += acc
        s = b.sum()
        beta[t] = b / s if s > 1e-300 else 1.0

    post = alpha * beta
    post /= post.sum(axis=(1, 2), keepdims=True)
    gamma = post.sum(axis=2)                       # (T, NUM_STATES)
    dur_gamma = post                                # (T, NUM_STATES, MAX_DURATION)

    # xi_finish[t, j, jp]: smoothed probability that state j finished
    # (d==0) at time t and the NEXT state is jp -- this is what drives
    # the transition-matrix M-step below.
    xi_finish = np.zeros((T - 1, NUM_STATES, NUM_STATES))
    for t in range(T - 1):
        finishing = alpha[t, :, 0]
        for j in range(NUM_STATES):
            if finishing[j] <= 0:
                continue
            for jp in range(NUM_STATES):
                if jp == j:
                    continue
                mass = finishing[j] * trans[j, jp] * np.sum(dur_pmf[jp, :] * beta[t + 1, jp, :] * lik[t + 1, jp])
                xi_finish[t, j, jp] = mass
        s = xi_finish[t].sum()
        if s > 1e-300:
            xi_finish[t] /= s

    return gamma, xi_finish, dur_gamma, total_loglik
Прямой проход повторяет логику CHSMMFilter::PredictStep()/UpdateStep() из раздела 5 и выполняется по всему обучающему набору один раз за итерацию EM, а не один раз на каждом новом баре при работе в реальном времени. total_loglik накапливает истинное логарифмическое правдоподобие каждого шага в логарифмическом пространстве — именно по этой величине проверяется сходимость EM. Обратный проход воспроизводит эту логику в обратном направлении. Вместе оба прохода дают сглаженные апостериорные распределения (gamma, dur_gamma, xi_finish), на которых основан описанный ниже M-шаг.
При переоценке длительности на M-шаге распределение не подгоняется непосредственно к исходной гистограмме: при ограниченном объеме данных "мягкие" частоты в хвостовых интервалах (для длительностей около 60 баров) оказываются зашумленными, из-за чего могут возникать участки с нулевой вероятностью, которые при работе в реальном времени ошибочно исключат фактически наблюдаемый длительный рыночный режим. Подбор двухпараметрического отрицательного биномиального распределения методом моментов регуляризует кривую, придавая ей гладкую форму и при этом обеспечивая точное совпадение с эмпирическими средним и дисперсией:
def fit_negative_binomial_moments(weighted_durations, weights):
    """
    Fits a negative-binomial duration distribution to a WEIGHTED sample
    of durations via method-of-moments, then discretizes its pmf over
    1..MAX_DURATION.

    Why parametric smoothing instead of just normalizing the raw
    weighted histogram: with limited training data, the tail bins (long
    durations) get very few effective soft-counts, so a raw histogram's
    tail is noisy and can even contain isolated zero-probability gaps
    that would incorrectly veto a real long-running regime live. Fitting
    a two-parameter negative binomial regularizes the whole curve to a
    smooth, monotonically-plausible shape while still matching the
    empirical mean and variance exactly.
    """
    mean = np.average(weighted_durations, weights=weights)
    var = np.average((weighted_durations - mean) ** 2, weights=weights)
    var = max(var, mean + 1e-6)  # negative binomial requires var > mean
    p = mean / var
    r = mean * p / (1 - p)
    r = max(r, 1e-3)

    k = np.arange(1, MAX_DURATION + 1)
    # shift the standard NB(support 0,1,2,...) so k=1 is the minimum
    # possible sojourn length of one bar.
    pmf = stats.nbinom.pmf(k - 1, r, p)
    pmf = pmf / pmf.sum()
    return pmf
Все три описанные выше процедуры M-шага (переоценка параметров модели наблюдений, переходов и длительностей) выполняются внутри run_em(), которая также отвечает за начальную инициализацию методом k-средних и цикл итераций до сходимости. Стоит отметить одну деталь: метки состояний, присваиваемые алгоритмом k-means, произвольны и при каждом запуске могут идти в разном порядке, из-за чего STATE_NAMES[0] при каждом повторном запуске скрипта обозначало бы другое состояние. Строки order/remap сразу после k-means устраняют эту проблему. Они сортируют начальные центроиды по одному и тому же критерию (сначала идут центроиды с высоким отклонением реализованной волатильности и низким коэффициентом эффективности Кауфмана), прежде чем индексы состояний будут использованы на последующих этапах:
def run_em(feats):
    T = feats.shape[0]

    # --- initialization via k-means (warm start) -------------------
    from scipy.cluster.vq import kmeans2
    centroids, labels = kmeans2(feats, NUM_STATES, minit="++", seed=42)
    # order states by their realized_vol_dev / efficiency_ratio profile
    # so state indices line up with STATE_NAMES in a stable, inspectable
    # way run-to-run rather than an arbitrary k-means label order.
    order = np.lexsort((centroids[:, 1], -centroids[:, 0]))
    remap = {old: new for new, old in enumerate(order)}
    labels = np.array([remap[l] for l in labels])
    centroids = centroids[order]

    em_mean = centroids.copy()
    em_var = np.ones((NUM_STATES, NUM_FEATURES)) * 0.5

    trans = np.full((NUM_STATES, NUM_STATES), 1.0 / (NUM_STATES - 1))
    np.fill_diagonal(trans, 0.0)

    dur_pmf = np.zeros((NUM_STATES, MAX_DURATION))
    for j in range(NUM_STATES):
        dur_pmf[j] = fit_negative_binomial_moments(np.arange(1, MAX_DURATION + 1),
                                                     np.ones(MAX_DURATION))

    prev_loglik = -np.inf
    for it in range(EM_ITERATIONS):
        gamma, xi_finish, dur_gamma, cur_loglik = forward_backward_hsmm(feats, trans, dur_pmf, em_mean, em_var)

        # --- M-step: emissions ---------------------------------
        for j in range(NUM_STATES):
            w = gamma[:, j]
            wsum = w.sum()
            if wsum < 1e-8:
                continue
            em_mean[j] = np.average(feats, axis=0, weights=w)
            diff = feats - em_mean[j]
            em_var[j] = np.average(diff ** 2, axis=0, weights=w)

        # --- M-step: transition matrix (off-diagonal only) -----
        trans_counts = xi_finish.sum(axis=0)
        for j in range(NUM_STATES):
            row_sum = trans_counts[j].sum()
            if row_sum > 1e-8:
                trans[j] = trans_counts[j] / row_sum
            trans[j, j] = 0.0

        # --- M-step: duration distributions ---------------------
        for j in range(NUM_STATES):
            d_values = np.arange(1, MAX_DURATION + 1)
            weights = dur_gamma[:, j, :].sum(axis=0)  # soft count per duration bucket, this state
            if weights.sum() < 1e-6:
                continue
            dur_pmf[j] = fit_negative_binomial_moments(d_values, weights)

        # --- convergence check -----------------------------------
        # cur_loglik is the TRUE data log-likelihood under the
        # parameters used to run the E-step above (i.e. the parameters
        # as of the END of the previous iteration's M-step) -- this is
        # exactly the quantity EM's monotonic-improvement guarantee
        # applies to, and it is expected to increase (or hold flat)
        # every iteration until convergence.
        print(f"EM iteration {it+1:2d}: loglik={cur_loglik:.1f}")
        if abs(cur_loglik - prev_loglik) < EM_TOLERANCE * max(1.0, abs(prev_loglik)):
            print("EM converged.")
            break
        prev_loglik = cur_loglik

    return em_mean, em_var, trans, dur_pmf
Все массивы с оцененными параметрами (средние и дисперсии модели наблюдений, матрица переходов, четыре функции вероятностей длительности, статистики нормализации признаков), а также служебные метаданные, такие как число баров в обучающей выборке и дата, сериализуются в JSON-манифест в точном соответствии со схемой, которую ожидает CHSMMFilter::LoadManifest(). Это замыкает цикл обмена данными между скриптом, работающим офлайн, и описанной выше частью на MQL5, работающей в реальном времени.
От вероятностной оценки к торговле: гистерезис, фильтрация торговых решений по оставшейся длительности и расчет объема позиции
Советник HSMM_RegimeEA.mq5 загружает манифест один раз, в OnInit(), и не запускается, если загрузить манифест или создать дескриптор ATR не удается. И манифест, и дескриптор необходимы для работы, поэтому лучше сразу завершить инициализацию с ошибкой, чем продолжать работу в частично инициализированном состоянии:
//+------------------------------------------------------------------+
//| OnInit                                                           |
//+------------------------------------------------------------------+
int OnInit()
  {
//--- cold-start bootstrap: before any bars have been processed there
//--- is no meaningful "confirmed" regime yet, so we start pending on
//--- Range (the most conservative label -- it authorizes no trend
//--- trades) rather than defaulting to state 0, which would otherwise
//--- look like an immediate (and unearned) TrendUp confirmation.
   g_confirmed_state = REGIME_RANGE;
   g_pending_state   = REGIME_RANGE;
   g_pending_count   = 0;
   g_last_bar_time   = 0;

   if(!g_filter.LoadManifest(InpManifestFilename))
     {
      Print("HSMM_RegimeEA: manifest load/contract check failed, refusing to start.");
      return(INIT_FAILED);
     }

   g_atr_handle = iATR(_Symbol, _Period, InpATRPeriod);
   if(g_atr_handle == INVALID_HANDLE)
     {
      Print("HSMM_RegimeEA: failed to create ATR handle, err=", GetLastError());
      return(INIT_FAILED);
     }

   g_trade.SetExpertMagicNumber(InpMagic);

   if(!OpenLogFile())
      return(INIT_FAILED);

   Print("HSMM_RegimeEA: initialized OK on ", _Symbol, " ", EnumToString(_Period));
   return(INIT_SUCCEEDED);
  }
Подтвержденный рыночный режим инициализируется значением REGIME_RANGE, а не состоянием 0: значение 0 по умолчанию воспринималось бы как уже подтвержденное определение TrendUp, а не как произвольный индекс массива. Range — наиболее консервативная метка, которая сама по себе не разрешает открывать торговые операции по тренду.
Состояние, непосредственно определяемое фильтром, может переключаться от бара к бару, когда апостериорные вероятности двух состояний почти равны. Функция UpdateConfirmedState() допускает смену подтвержденного состояния только при выполнении двух условий: апостериорная вероятность нового состояния должна быть не ниже минимального порога, а само состояние должно сохраняться на нескольких последовательных барах. Лишь после этого оно заменяет значение, на основе которого ManageTrades() принимает решения:
//+------------------------------------------------------------------+
//| UpdateConfirmedState                                             |
//+------------------------------------------------------------------+
void UpdateConfirmedState(int raw_state, double confidence)
  {
//--- hysteresis gate: the raw filtered state can flicker bar-to-bar
//--- whenever two states have close-to-equal posterior mass. Acting
//--- on every flicker would open and close trades on noise, so a new
//--- state must (a) clear a minimum confidence bar AND (b) be seen
//--- for InpConfirmBars CONSECUTIVE bars before it replaces
//--- g_confirmed_state, which is the only variable ManageTrades()
//--- ever reads.
   if(confidence < InpConfirmThreshold)
     {
      //--- low-confidence bar: does not break an existing pending
      //--- streak (a single ambiguous bar shouldn't reset progress),
      //--- but it also does not advance it.
      return;
     }

   if(raw_state == g_confirmed_state)
     {
      g_pending_state = g_confirmed_state;
      g_pending_count = 0;
      return;
     }

   if(raw_state == g_pending_state)
      g_pending_count++;
   else
     {
      g_pending_state = raw_state;
      g_pending_count = 1;
     }

   if(g_pending_count >= InpConfirmBars)
     {
      Print("HSMM_RegimeEA: regime confirmed change ", g_filter.StateName(g_confirmed_state),
            " -> ", g_filter.StateName(g_pending_state));
      g_confirmed_state = g_pending_state;
      g_pending_count = 0;
     }
  }
Расчет объема позиции намеренно выполняется через OrderCalcProfit(), а не через SYMBOL_TRADE_TICK_VALUE. В других частях этой серии использование стоимости тика приводило к некорректному расчету объема позиций по металлам и CFD на индексы. Прямой запрос к терминалу о том, какую прибыль или убыток принесет позиция объемом один лот при движении цены на точное расстояние до стоп-лосса, позволяет обойти эту проблему: расчет использует тот же механизм ценообразования, что и при исполнении реального ордера:
//+------------------------------------------------------------------+
//| CalculateLotSize                                                 |
//+------------------------------------------------------------------+
double CalculateLotSize(ENUM_ORDER_TYPE order_type, double entry_price, double sl_price)
  {
//--- risk-normalized sizing: convert the requested percent-of-equity
//--- risk into a lot size that actually loses that much money if
//--- price reaches sl_price. SYMBOL_TRADE_TICK_VALUE is documented
//--- to return misleading figures on some brokers/instruments (seen
//--- earlier in this series on metals and indices), so instead we
//--- ask the terminal directly, via OrderCalcProfit(), what ONE lot
//--- would gain or lose over that exact price distance -- this is
//--- always broker-correct because it goes through the same pricing
//--- engine that will actually fill the order.
   double equity = AccountInfoDouble(ACCOUNT_EQUITY);
   double risk_money = equity * (InpRiskPercent / 100.0);

   double one_lot_pl = 0.0;
   if(!OrderCalcProfit(order_type, _Symbol, 1.0, entry_price, sl_price, one_lot_pl))
     {
      Print("HSMM_RegimeEA: OrderCalcProfit failed, err=", GetLastError());
      return(0.0);
     }
   double loss_per_lot = MathAbs(one_lot_pl);
   if(loss_per_lot < 1e-8)
      return(0.0);   // guard: degenerate SL distance would otherwise divide by zero

   double raw_lots = risk_money / loss_per_lot;

//--- clamp to the broker's allowed lot step/min/max -- an unclamped
//--- lot size is one of the most common reasons a live order gets
//--- rejected outright.
   double lot_step = SymbolInfoDouble(_Symbol, SYMBOL_VOLUME_STEP);
   double lot_min  = SymbolInfoDouble(_Symbol, SYMBOL_VOLUME_MIN);
   double lot_max  = SymbolInfoDouble(_Symbol, SYMBOL_VOLUME_MAX);
   double lots = MathFloor(raw_lots / lot_step) * lot_step;
   lots = MathMax(lot_min, MathMin(lot_max, lots));
   return(lots);
  }
Именно здесь оценка длительности оправдывает себя. ManageTrades() не откроет новую торговую операцию по тренду, пока ожидаемая оставшаяся длительность подтверждённого режима не достигнет минимального порога в барах: даже если состояние уверенно определяется как TrendUp, вход может быть нецелесообразен, когда режим близится к завершению. Для выхода действует обратная логика: не дожидаясь смены метки состояния, открытая трендовая позиция закрывается, как только ожидаемая оставшаяся длительность соответствующего режима опускается ниже меньшего порога выхода:
//+------------------------------------------------------------------+
//| ManageTrades                                                     |
//+------------------------------------------------------------------+
void ManageTrades(int confirmed_state, double exp_remaining_duration, double close_price, double atr_value)
  {
//--- Range and HighVolChop never authorize a NEW entry -- both are,
//--- by construction, states where directional persistence is not
//--- expected, so a trend-following entry there would be fighting
//--- the model's own read of the market.
   bool has_position = PositionSelect(_Symbol);
   int  pos_type = has_position ? (int)PositionGetInteger(POSITION_TYPE) : -1;

//--- duration-aware EXIT: this is the concrete edge a plain HMM does
//--- not give you. Even while still in a trend state, once the
//--- filtered posterior says the regime is very likely almost over
//--- (expected remaining duration below InpExitDuration), we exit
//--- ahead of the reversal rather than waiting for the state label
//--- itself to flip -- by the time the label flips, some of the
//--- reversal has usually already happened.
   if(has_position)
     {
      bool trend_state = (confirmed_state == REGIME_TREND_UP || confirmed_state == REGIME_TREND_DOWN);
      bool wrong_direction =
         (pos_type == POSITION_TYPE_BUY  && confirmed_state == REGIME_TREND_DOWN) ||
         (pos_type == POSITION_TYPE_SELL && confirmed_state == REGIME_TREND_UP);
      bool duration_exhausted = trend_state && (exp_remaining_duration < InpExitDuration);
      bool regime_broke_down = (confirmed_state == REGIME_RANGE || confirmed_state == REGIME_HIGH_VOL_CHOP);

      if(wrong_direction || duration_exhausted || regime_broke_down)
        {
         g_trade.PositionClose(_Symbol);
         has_position = false;
        }
     }

   if(has_position)
      return;   // already holding a (still-valid) position -- nothing left to do this bar

   if(exp_remaining_duration < InpMinEntryDuration)
      return;   // regime confidently identified but not expected to run long enough to be worth entering

   if(confirmed_state == REGIME_TREND_UP)
     {
      double sl = close_price - InpSL_ATR_Mult * atr_value;
      double tp = close_price + InpTP_ATR_Mult * atr_value;
      double lots = CalculateLotSize(ORDER_TYPE_BUY, close_price, sl);
      if(lots > 0.0)
         g_trade.Buy(lots, _Symbol, 0.0, sl, tp, "HSMM TrendUp");
     }
   else if(confirmed_state == REGIME_TREND_DOWN)
     {
      double sl = close_price + InpSL_ATR_Mult * atr_value;
      double tp = close_price - InpTP_ATR_Mult * atr_value;
      double lots = CalculateLotSize(ORDER_TYPE_SELL, close_price, sl);
      if(lots > 0.0)
         g_trade.Sell(lots, _Symbol, 0.0, sl, tp, "HSMM TrendDown");
     }
  }
Вся эта логика выполняется из OnTick(), причем фильтр обновляется ровно один раз на каждый закрытый бар, а не на каждом тике. Если обновлять рекурсивный фильтр несколько раз за один модельный шаг времени, это приведет как к лишнему уменьшению оставшейся длительности, так и к повторному учету одного и того же наблюдения:
//+------------------------------------------------------------------+
//| OnTick                                                           |
//+------------------------------------------------------------------+
void OnTick()
  {
//--- the model advances exactly once per CLOSED bar -- stepping it on
//--- every intra-bar tick would call PredictStep()/UpdateStep()
//--- multiple times for what the math treats as a single time
//--- increment, over-counting both the duration countdown and the
//--- observation evidence and badly distorting the belief state.
   datetime current_bar_time = iTime(_Symbol, _Period, 0);
   if(current_bar_time == g_last_bar_time)
      return;
   g_last_bar_time = current_bar_time;

//--- need FEATURE_LOOKBACK+1 closes to form FEATURE_LOOKBACK returns,
//--- plus one extra bar of headroom -- bail out quietly on a
//--- freshly-attached chart that has not built up enough history yet.
   if(Bars(_Symbol, _Period) < FEATURE_LOOKBACK + 2)
      return;

   double close[];
   ArraySetAsSeries(close, true);
   if(CopyClose(_Symbol, _Period, 1, FEATURE_LOOKBACK + 1, close) < FEATURE_LOOKBACK + 1)
      return;   // history not fully available yet (e.g. still downloading)

   double atr_buf[];
   ArraySetAsSeries(atr_buf, true);
   if(CopyBuffer(g_atr_handle, 0, 1, 1, atr_buf) < 1)
      return;
   double atr_value = atr_buf[0];

//--- shift=0 here means "the most recently CLOSED bar" because both
//--- CopyClose and CopyBuffer above were called with start=1, i.e.
//--- skipping the still-forming bar 0.
   double features[];
   if(!g_filter.ComputeFeatures(close, 0, atr_value, features))
      return;

   g_filter.StepFilter(features);

   double confidence;
   int raw_state = g_filter.GetFilteredState(confidence);
   UpdateConfirmedState(raw_state, confidence);

   double exp_dur = g_filter.GetExpectedRemainingDuration(g_confirmed_state);
   LogBar(current_bar_time, raw_state, confidence, exp_dur, features);

   double close_price = close[0];
   ManageTrades(g_confirmed_state, exp_dur, close_price, atr_value);

   Comment("HSMM regime: ", g_filter.StateName(g_confirmed_state),
           "  | raw=", g_filter.StateName(raw_state), " conf=", DoubleToString(confidence, 2),
           "  | E[remaining]=", DoubleToString(exp_dur, 1), " bars");
  }
На графике ниже показаны обе части этой логики на той же синтетической последовательности, что использовалась в разделе 5: сверху — цена с цветовым выделением рыночных режимов, снизу — ожидаемая оставшаяся длительность; порог входа отмечен пунктирной линией.
Синтетическая ценовая траектория с цветовым выделением рыночных режимов и ожидаемая оставшаяся длительность
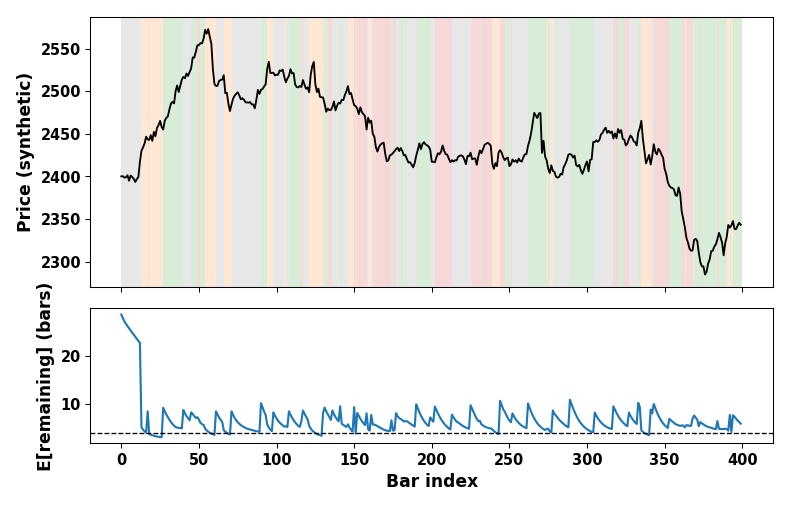
Рис. 4. Вверху: синтетическая ценовая траектория с цветовым выделением рыночного режима, подтвержденного фильтром. Внизу: ожидаемая оставшаяся длительность состояния, которому фильтр сейчас отдает предпочтение; отмечен иллюстративный порог входа (4 бара). Обратите внимание, как оценка длительности приближается к нулю вблизи каждого перехода между рыночными режимами задолго до смены цветового выделения: именно это снижение служит сигналом раннего предупреждения, который ManageTrades() использует для выхода по оставшейся длительности.
Визуализация рыночного режима: инкрементальный фильтр индикатора
HSMM_RegimeIndicator.mq5 отображает ту же модель на графике в виде линии рыночного режима с цветовой кодировкой и гистограммы длительности, загружая из того же манифеста собственный независимый экземпляр CHSMMFilter. Благодаря этому индикатор не связан с внутренним состоянием фильтра советника: его можно добавлять на график или удалять, не влияя на данные, на основе которых советник принимает торговые решения.
//+------------------------------------------------------------------+
//| OnInit                                                           |
//+------------------------------------------------------------------+
int OnInit()
  {
   SetIndexBuffer(0, BufferRegimeValue, INDICATOR_DATA);
   SetIndexBuffer(1, BufferRegimeColor, INDICATOR_COLOR_INDEX);
   SetIndexBuffer(2, BufferDuration,    INDICATOR_DATA);

   ArraySetAsSeries(BufferRegimeValue, false);
   ArraySetAsSeries(BufferRegimeColor, false);
   ArraySetAsSeries(BufferDuration,    false);

   PlotIndexSetDouble(0, PLOT_EMPTY_VALUE, EMPTY_VALUE);
   PlotIndexSetDouble(1, PLOT_EMPTY_VALUE, EMPTY_VALUE);

   if(!g_ind_filter.LoadManifest(InpManifestFilename))
     {
      Print("HSMM_RegimeIndicator: manifest load/contract check failed, refusing to start.");
      return(INIT_FAILED);
     }

   g_ind_atr_handle = iATR(_Symbol, _Period, InpATRPeriod);
   if(g_ind_atr_handle == INVALID_HANDLE)
     {
      Print("HSMM_RegimeIndicator: failed to create ATR handle, err=", GetLastError());
      return(INIT_FAILED);
     }

//--- -1 is a deliberate "nothing finalized yet" sentinel, distinct
//--- from any real array index (which starts at 0), so the first
//--- OnCalculate() call can unambiguously detect the cold-start case.
   g_last_finalized_index = -1;

   IndicatorSetString(INDICATOR_SHORTNAME, "HSMM Regime (Duration-Aware)");
   return(INIT_SUCCEEDED);
  }
Главная тонкость заключается в обработчике OnCalculate(). Большинство индикаторов могут пересчитывать любой бар независимо — скользящее среднее на 500-м баре не зависит от 499-го бара. Эта модель так работать не может: CHSMMFilter::StepFilter() — рекурсивная функция, поэтому обычная для MQL5 схема "продолжить с prev_calculated-1" привела бы к ее повторному вызову для бара, уже окончательно обработанного фильтром (чаще всего — для еще формирующегося текущего бара, пересчитываемого на каждом тике). В результате наблюдение этого бара учитывалось бы дважды, и все последующие обновления искажались бы.
Решение — вести в самом индикаторе собственный учет обработанных баров, независимо от prev_calculated: g_last_finalized_index продвигается вперед только после того, как бар действительно обработан фильтром. Полная перезагрузка истории сбрасывает и распределение вероятностей состояний и оставшейся длительности, и этот счетчик, поскольку иначе распределение больше не соответствовало бы барам на графике:
//+------------------------------------------------------------------+
//| OnCalculate                                                      |
//+------------------------------------------------------------------+
int OnCalculate(const int rates_total,
                 const int prev_calculated,
                 const datetime &time[],
                 const double &open[],
                 const double &high[],
                 const double &low[],
                 const double &close[],
                 const long &tick_volume[],
                 const long &volume[],
                 const int &spread[])
  {
//--- this indicator's model, CHSMMFilter, is RECURSIVE: each call to
//--- StepFilter() consumes exactly one bar's worth of evidence and
//--- permanently updates the belief state. That makes it fundamentally
//--- different from a typical indicator formula, which can recompute
//--- any single bar independently of the others. If we used the standard
//--- "resume from prev_calculated-1" pattern, some bars would be
//--- revisited (e.g., during recalculation of the still-forming bar).
//--- The filter would process them twice, double-counting evidence and
//--- corrupting subsequent belief updates. g_last_finalized_index
//--- is this indicator's OWN bookkeeping, kept deliberately separate
//--- from prev_calculated, and it only ever advances -- never rewinds
//--- -- once a bar has actually been stepped through the filter.
   if(rates_total < FEATURE_LOOKBACK + 2)
      return(0);   // not enough history yet to form even one feature window

//--- a full history reload (e.g. chart timeframe change, or history
//--- reload after a terminal restart) invalidates our bookkeeping --
//--- detected here as prev_calculated resetting to zero while we
//--- believe bars were already finalized. In that case the belief
//--- state itself is stale (it was built from a DIFFERENT bar
//--- sequence), so we must reset the filter's belief from scratch
//--- rather than silently continuing to step a belief that no longer
//--- corresponds to the bars actually on the chart.
   if(prev_calculated == 0 && g_last_finalized_index >= 0)
     {
      g_ind_filter.ResetBelief();
      g_last_finalized_index = -1;
     }

   int start_index;
   if(g_last_finalized_index < 0)
     {
      //--- cold start: the earliest bar with a full FEATURE_LOOKBACK
      //--- window behind it is index FEATURE_LOOKBACK (0-based,
      //--- ascending array), so pre-fill everything before that with
      //--- EMPTY_VALUE (there is simply no feature window available).
      for(int i = 0; i < FEATURE_LOOKBACK && i < rates_total; i++)
        {
         BufferRegimeValue[i] = EMPTY_VALUE;
         BufferRegimeColor[i] = 0;
         BufferDuration[i]    = EMPTY_VALUE;
        }
      start_index = FEATURE_LOOKBACK;
     }
   else
      start_index = g_last_finalized_index + 1;

//--- the LAST array index (rates_total-1) is always the still-forming
//--- bar -- we deliberately never step the filter on it, only on
//--- bars that have actually closed, so last_closed is the true upper
//--- bound for stepping.
   int last_closed = rates_total - 2;

   double atr_array[];
   ArraySetAsSeries(atr_array, false);
   int atr_needed = rates_total;
   if(CopyBuffer(g_ind_atr_handle, 0, 0, atr_needed, atr_array) < atr_needed)
      return(prev_calculated);   // ATR history not fully available yet -- try again next call

   double temp_close[];
   ArrayResize(temp_close, FEATURE_LOOKBACK + 1);

   for(int i = start_index; i <= last_closed; i++)
     {
      //--- CHSMMFilter::ComputeFeatures expects a SERIES-indexed
      //--- window (index 0 = the bar being scored, higher index =
      //--- older), but OnCalculate's close[] here is ascending. Rather
      //--- than write and maintain a second, ascending-array version
      //--- of the feature math, we copy the FEATURE_LOOKBACK+1 bars
      //--- ending at i into a small local buffer in series order and
      //--- reuse the exact same function the EA calls -- guaranteeing
      //--- the indicator's features can never silently drift out of
      //--- sync with the EA's.
      for(int k = 0; k <= FEATURE_LOOKBACK; k++)
         temp_close[k] = close[i - k];

      double features[];
      if(!g_ind_filter.ComputeFeatures(temp_close, 0, atr_array[i], features))
        {
         BufferRegimeValue[i] = (i > 0) ? BufferRegimeValue[i - 1] : EMPTY_VALUE;
         BufferRegimeColor[i] = (i > 0) ? BufferRegimeColor[i - 1] : 0;
         BufferDuration[i]    = (i > 0) ? BufferDuration[i - 1]    : EMPTY_VALUE;
         g_last_finalized_index = i;
         continue;
        }

      g_ind_filter.StepFilter(features);

      double confidence;
      int state = g_ind_filter.GetFilteredState(confidence);
      double exp_dur = g_ind_filter.GetExpectedRemainingDuration(state);

      BufferRegimeValue[i] = state;
      BufferRegimeColor[i] = state;   // color index maps 1:1 onto the four indicator_color1 entries
      BufferDuration[i]    = exp_dur;

      g_last_finalized_index = i;
     }

//--- the still-forming bar is drawn as a repeat of the last finalized
//--- value so the plotted line does not visibly drop to EMPTY_VALUE
//--- for one bar on every chart refresh -- purely cosmetic, it never
//--- touches the filter's belief state.
   if(rates_total - 1 >= 0 && last_closed >= start_index - 1 && last_closed >= 0)
     {
      int forming = rates_total - 1;
      BufferRegimeValue[forming] = BufferRegimeValue[last_closed];
      BufferRegimeColor[forming] = BufferRegimeColor[last_closed];
      BufferDuration[forming]    = BufferDuration[last_closed];
     }

   return(rates_total);
  }
Последний, еще формирующийся бар никогда не подается на вход фильтра: для него просто повторяется значение предыдущего бара, чтобы линия не проваливалась при каждом обновлении. Это чисто визуальный прием, который никак не затрагивает фактическое распределение вероятностей состояний и оставшейся длительности в g_ind_filter.
Пограничные случаи и возможные проблемы
- Несоответствие манифеста параметрам, заданным при компиляции. Если NUM_STATES, NUM_FEATURES или MAX_DURATION меняются без переобучения модели (или наоборот), только ValidateContract() не дает устаревшему манифесту привести к искажению распределения вероятностей состояний и оставшейся длительности. Сообщение в журнале о нарушении контракта совместимости следует считать основанием для немедленной остановки, а не предупреждением, с которым можно разобраться позже.
- Пограничные случаи для распределения вероятностей состояний и оставшейся длительности: холодный запуск и обнуление из-за переполнения снизу. В течение первых нескольких десятков баров после запуска m_alpha все еще близко к равномерному априорному распределению, а состояние, определяемое фильтром, почти случайно. Параметры InpConfirmBars/InpConfirmThreshold обеспечивают некоторую защиту, но не стоит сразу ожидать содержательной оценки состояния. UpdateStep() также заново задает равномерное распределение вероятностей состояний и оставшейся длительности, если сумма после умножения падает ниже 1e-300. Такое должно происходить лишь после длительной последовательности наблюдений, маловероятных при любом из состояний. Обычно это указывает на аномалию данных или на то, что манифест больше не соответствует торговому инструменту; ограничиваться незаметным сбросом и продолжать работу в таком случае нельзя.
- Усеченные хвосты распределения длительности. Если у состояния значимая вероятностная масса истинного распределения длительности приходится на значения свыше MAX_DURATION баров, эта масса незаметно отбрасывается в цикле PredictStep(), ограниченном этим пределом. В результате модель несколько переоценивает вероятность скорого завершения давно продолжающегося рыночного режима. Для увеличения значения MAX_DURATION требуется как перекомпиляция, так и повторное обучение.
- Пограничные случаи при расчете признаков: периоды низкой ликвидности и расхождения между обучением и работой в реальном времени. На участке с фактически неизменными ценами (малоликвидная сессия, сбой потока котировок) path_sum может приблизиться к своему нижнему пределу, из-за чего efficiency_ratio принимает вводящее в заблуждение экстремальное значение. Защитные нижние пороги предотвращают неконтролируемый рост этого значения, но не поступление некорректных данных в модель. Кроме того, поскольку советник и индикатор используют один и тот же код ComputeFeatures() без изменений, единственный реальный риск расхождения связан с различиями между этой реализацией на MQL5 и ее версией на Python в train_hsmm.py. Проверки контракта совместимости, аналогичной проверке размерностей массивов, здесь нет, поэтому такие расхождения необходимо выявлять за счет строгого контроля согласованности реализаций.
- Взаимодействие гистерезиса с фильтрацией торговых решений по оставшейся длительности. Функция UpdateConfirmedState() и проверки длительности в ManageTrades() защищают от разных рисков и иногда могут противодействовать друг другу: действительно кратковременный рыночный режим (каким по замыслу является HighVolChop) может завершиться до того, как счетчик гистерезиса подтвердит его, из-за чего некоторые кратковременные режимы фактически остаются невидимыми для торговой логики, хотя модель правильно их определяет. Это сделано намеренно: если рыночный режим длится слишком недолго, чтобы его можно было подтвердить, его длительности также недостаточно для безопасной торговли.
Тестирование в тестере стратегий
Это фактические результаты тестера стратегий, полученные с использованием манифеста с параметрами модели, обученной на реальных исторических данных XAUUSD M5 с помощью train_hsmm.py, а не результаты имитационного примера. В течение этого периода система в целом была убыточной, и этот результат отражается в отчёте без изменений.
Этот прогон охватывал период с 1 января по 24 августа 2026 года на XAUUSD M5 — около восьми месяцев, то есть один непрерывный отрезок, а не многолетний период с различными рыночными режимами, как первоначально предполагалось в данном разделе. Восьми месяцев достаточно для предварительной оценки, но недостаточно, чтобы судить о том, как этот манифест ведет себя при существенно ином уровне волатильности; поэтому стоит провести более длительное тестирование на нескольких последовательных скользящих окнах.
| настройка | Значение |
|---|---|
| Инструмент/таймфрейм | XAUUSD/M5 |
| Период тестирования | 01.01.2026 — 24.08.2026 (около 8 месяцев) |
| InpRiskPercent | риск — 0,75% средств счета на сделку |
| InpSL_ATR_Mult/InpTP_ATR_Mult | 2,0/4,0 |
| InpConfirmBars/InpConfirmThreshold | 3 бара/0,55 |
| InpMinEntryDuration/InpExitDuration | 4,0 бара/1,0 бара |
| Результат | Значение |
|---|---|
| Начальный депозит / Конечный баланс | 10 000,00 долл. / 9 327,25 долл. |
| Чистая прибыль | -672,75 доллара |
| Коэффициент прибыльности | 0,99 |
| Коэффициент Шарпа / Математическое ожидание выигрыша | -0,41 / -0,29 |
| Относительная просадка баланса | 32,26% (4 439,31 долл.) |
| Всего торговых операций / Всего сделок | 2 336 / 4 672 |
| Доля прибыльных торговых операций (коротких/длинных) | 44,04% / 46,44% |
Фактическая кривая средств из тестера стратегий, XAUUSD M5, январь–август 2026 г.
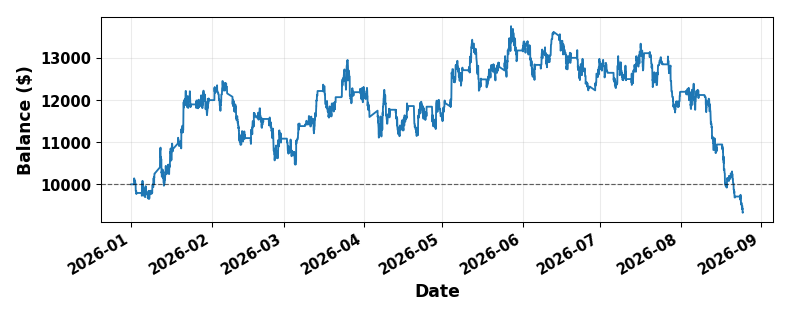
Рис. 5. Фактическая динамика баланса счета за весь тест из 2 336 торговых операций, XAUUSD M5, январь–август 2026 года. Пунктирная линия обозначает начальный баланс в размере 10 000 долларов. В середине теста баланс вырос примерно до 13 760 долларов, затем почти весь прирост был утрачен, и к концу теста баланс оказался немного ниже начального уровня.
По результатам этого единственного прогона уже можно оценить один из трех диагностических показателей, которые первоначально предлагалось проверить в этом разделе: распределение причин выхода. Из 2 336 завершенных торговых операций 1 365 (58,4%) были закрыты программно функцией ManageTrades() по условиям оставшейся длительности и рыночного режима, а не при достижении уровня стоп-лосса или тейк-профита; 733 (31,4%) были закрыты по стоп-лоссу, а 237 (10,1%) — по тейк-профиту. Уже одно это показывает, что ограничение по длительности — не редкий частный случай, а механизм, который действительно часто срабатывает и выполняет важную функцию.
Именно разбивка прибыли по причинам выхода делает этот результат по-настоящему информативным, а не просто обескураживающим. Торговые операции с выходом по условиям оставшейся длительности или рыночного режима сами по себе дали чистую прибыль: в среднем 16,48 доллара на операцию, при доле прибыльных операций 59,3% среди всех 1 365 операций и совокупном вкладе в результат около +22 500 долларов. Как и следовало ожидать, торговые операции с выходом по тейк-профиту показали наилучший результат среди отдельных категорий: в среднем 161,17 доллара прибыли на торговую операцию. Совокупный убыток от 733 торговых операций с выходом по стоп-лоссу превысил весь чистый убыток по тесту: средний результат каждой такой операции составил −83,72 доллара, а суммарный — примерно −61 370 долларов. Другими словами, тот компонент системы, который мы намеревались создать в этой статье, — выход из угасающего тренда до смены самой метки состояния — по-видимому, работает и окупается. Причина убыточного результата находится на более раннем этапе — в отборе торговых операций для входа и в том, насколько близко параметр InpSL_ATR_Mult задает стоп-лосс с учетом частоты ошибок модели наблюдений при определении рыночного режима. Это прямо указывает на то, что в первую очередь следует настраивать фильтрацию входов и размещение стоп-лоссов, а не сам механизм учета длительности, хотя именно для проверки такой интерпретации и предназначен описанный ниже абляционный тест, который пока не проводился.
Для расчёта двух других диагностических показателей — среднего времени удержания позиции относительно ожидаемой оставшейся длительности на момент входа и задержки подтверждения рыночного режима — требуется CSV-журнал с записью рыночного режима для каждого бара. Он формируется функцией LogBar() во время того же прогона. Одного списка сделок для этого недостаточно, поэтому эти показатели здесь пока не рассматриваются. Естественный следующий шаг, наряду с увеличением периода тестирования, — абляционный тест, изначально предложенный в этом разделе: выполнить прогон с тем же манифестом и настройками, установив InpMinEntryDuration и InpExitDuration в ноль; это фактически отключит фильтрацию торговых решений по оставшейся длительности, и входы и выходы будут определяться только самой меткой состояния. Сравнение результатов этого прогона с приведенными выше данными в разбивке по выходам по стоп-лоссу и закрытиям по условиям длительности и режима позволило бы непосредственно определить, какая часть положительного результата этих закрытий действительно обусловлена учетом длительности, а не одной лишь меткой состояния, подтвержденной гистерезисом.
Заключение
Основная идея здесь довольно проста, но на практике оказывается гораздо важнее, чем кажется на бумаге: возраст рыночного режима — это информация. Обычная HMM по своему устройству отбрасывает эту информацию, сводя длительность к одной постоянной вероятности перехода, которая остается одинаковой независимо от того, только ли начался тренд или он продолжается уже несколько часов. HSMM явно задает отдельное распределение длительности для каждого состояния, что дает обновляемый в реальном времени показатель — ожидаемую оставшуюся длительность, на основе которого торговая система может принимать решения: открывать торговые операции по тренду только тогда, когда, по оценке модели, у него еще есть запас времени, и выходить до разворота, не дожидаясь смены самой метки состояния.
Всё, что работает в режиме реального времени, специально реализовано на языке MQL5. Самописный JSON-парсер в CJSONArrayUtils — не универсальная библиотека, а небольшой специализированный инструмент, созданный именно под схему манифеста этого проекта. Прямой фильтр в CHSMMFilter — это непосредственная реализация рекурсии HSMM по оставшемуся времени, без средств ускорения: ни нейронных сетей, ни среды выполнения ONNX, ни каких-либо зависимостей за пределами того, что входит в состав терминала. Python используется только на этапе автономной подготовки: параметры однократно оцениваются с помощью алгоритма ожидания-максимизации (EM), прежде чем модель начнет работать на графике.
Первый результат тестирования подтверждает это конкретными, проверяемыми данными, а не только в теории: в восьмимесячном прогоне на XAUUSD M5 торговые операции, закрытые по условиям длительности или рыночного режима, в совокупности принесли чистую прибыль (доля прибыльных операций — 59,3%, средний результат — +16,48 доллара), тогда как чистый убыток системы в целом почти полностью пришелся на выходы по стоп-лоссу. Это действительно полезный сигнал по итогам одного теста, но не вывод: описанный в разделе 10 абляционный тест позволил бы проверить, действительно ли такое распределение результатов обусловлено фильтрацией торговых решений по оставшейся длительности или же одна лишь метка состояния, подтвержденная гистерезисом, дала бы сходный результат.
Теперь, когда получены результаты прогона в тестере стратегий, наиболее очевидный следующий шаг — именно такой абляционный тест, за которым последуют тестирование на более длительном периоде, охватывающем несколько рыночных режимов, и переобучение на скользящем окне с последующим тестированием. Для этого нужно заново обучать модель на скользящем окне, обновлять манифест и сравнивать периодически обновляемую модель со статической моделью, поставляемой в данной реализации. Это позволит выяснить, какая часть преимущества (если оно вообще есть) обусловлена самим учетом длительности, а какая — лишь поддержанием актуальности статистик признаков модели наблюдений. Второе естественное расширение — добавить пятое состояние для резких всплесков волатильности, вызванных именно новостями, отделив их от уже имеющегося в модели состояния HighVolChop, которое развивается более постепенно. Распределения длительности этих двух состояний, вероятно, будут существенно различаться, а именно такие различия и призван отражать этот подход.
При адаптации к другому инструменту или временному интервалу перед повторным обучением следует пересмотреть значения MAX_DURATION и FEATURE_LOOKBACK; универсальных настроек не существует. Значение MAX_DURATION следует выбирать по фактической статистике длительности рыночных режимов инструмента на выбранном таймфрейме: 60 баров — разумная отправная точка для XAUUSD M5, где устойчивый внутридневной тренд обычно длится несколько часов, но на значительно более старшем таймфрейме значение этой константы в барах должно быть гораздо меньше, чтобы соответствовать сопоставимой длительности в часах. Параметр FEATURE_LOOKBACK задает компромисс между скоростью реакции и шумом в противоположном направлении: более короткое окно быстрее реагирует на действительную смену рыночного режима, но на инструментах с меньшей ликвидностью в расчете на бар дает более шумные оценки коэффициента эффективности Кауфмана и асимметрии доходностей; это, в свою очередь, расширяет гауссовы распределения модели наблюдений и делает состояния менее различимыми для фильтра. Оба параметра намеренно заданы как константы времени компиляции, чтобы изменение любого из них требовало осознанного переобучения и перекомпиляции, а не приводило к незаметному несоответствию во время выполнения. Описанная в разделе 5 трехсторонняя проверка контракта совместимости специально предназначена для выявления случаев, когда один из этих двух шагов пропущен.
| Файл | Тип | Описание |
|---|---|---|
| HSMMFilter.mqh | Подключаемый файл | CJSONArrayUtils (разбор манифеста) и CHSMMFilter (прямой фильтр с учетом длительности, конструирование признаков, оценка правдоподобия наблюдений). |
| HSMM_RegimeEA.mq5 | Торговый советник (EA) | Загружает манифест, выполняет один шаг фильтра для каждого закрытого бара, применяет фильтрацию торговых решений по рыночному режиму с подтверждением посредством гистерезиса и ведет торговлю с расчетом объема позиции с нормализацией по ATR и фильтрацией торговых решений по оставшейся длительности при входах и выходах. |
| HSMM_RegimeIndicator.mq5 | Индикатор | Визуализация на графике рыночного режима, оцененного фильтром, и ожидаемой оставшейся длительности с собственным пошаговым учетом обработанных данных и защитой от повторного выполнения шага фильтра. |
| train_hsmm.py | Python (в автономном режиме) | Загружает историю OHLC, экспортированную из MetaTrader 5, формирует признаки, идентичные признакам в реализации на MQL5, обучает скрытую полумарковскую модель (HSMM) с помощью алгоритма ожидания-максимизации (EM) (E-шаг — прямой и обратный проходы, M-шаг — оценка параметров отрицательного биномиального распределения длительности) и экспортирует файл hsmm_manifest.json. |
| hsmm_manifest.json | Файл данных | Параметры обученной модели (средние значения и дисперсии модели наблюдений, матрица переходов, функции вероятностей длительности, статистики нормализации признаков) в структуре, ожидаемой методом CHSMMFilter::LoadManifest(). Здесь файл представлен как наглядный пример структуры — замените его результатом обучения собственной модели. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/24460
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


