

Нейросети в трейдинге: AlphaGen — поиск торговых факторов (нейросетевые политики)
 34
 0

Введение
Два похожих индикатора могут почти одинаково реагировать на движение цены финансового инструмента. В предыдущих частях мы научились искать формулы и оценивать вклад каждой из них в общий сигнал. Но даже полезная комбинация факторов не превращается сама по себе в команду Buy или Sell. Торговой модели ещё предстоит учесть состояние позиции и счёта. В исходном AlphaGen поисковая политика генерирует формулы. Отдельную торговую политику мы добавили при адаптации фреймворка для решения задач принятия торговых решений.
В первой статье были разработаны язык формул и маска допустимых продолжений. Во второй реализованы генератор токенов и вычисление формул средствами OpenCL. В третьей собрали класс CAlphaGenPool, который оценивает кандидатов, хранит подготовленный и действующий составы, формирует историю нормированного сигнала. Теперь используем эти результаты как готовые исходные данные. Повторять устройство маски, вычислителя и пула не будем.
Из третьей части переходят два результата с разным назначением. Оценка законченной формулы впоследствии служит вознаграждением поискового контура. В момент выбора очередного токена эта оценка ещё неизвестна. История сигнала действующего пула, напротив, уже доступна торговой политике на закрытых барах. Поэтому рассмотрим две сети: первая выбирает продолжение выражения, вторая формирует нормированные параметры торгового действия. У них различаются не только данные, но и форма самого решения.
Задача этой статьи — разобрать устройство обеих политик и их локальные операции: прямой проход, вычисление производных и применение подготовленных градиентов. Сравним общий базовый класс, нейросетевые слои и форматы выхода. Затем разберём, почему две специализированные реализации удобнее одного класса с переключателем режима.
Общая основа двух политик
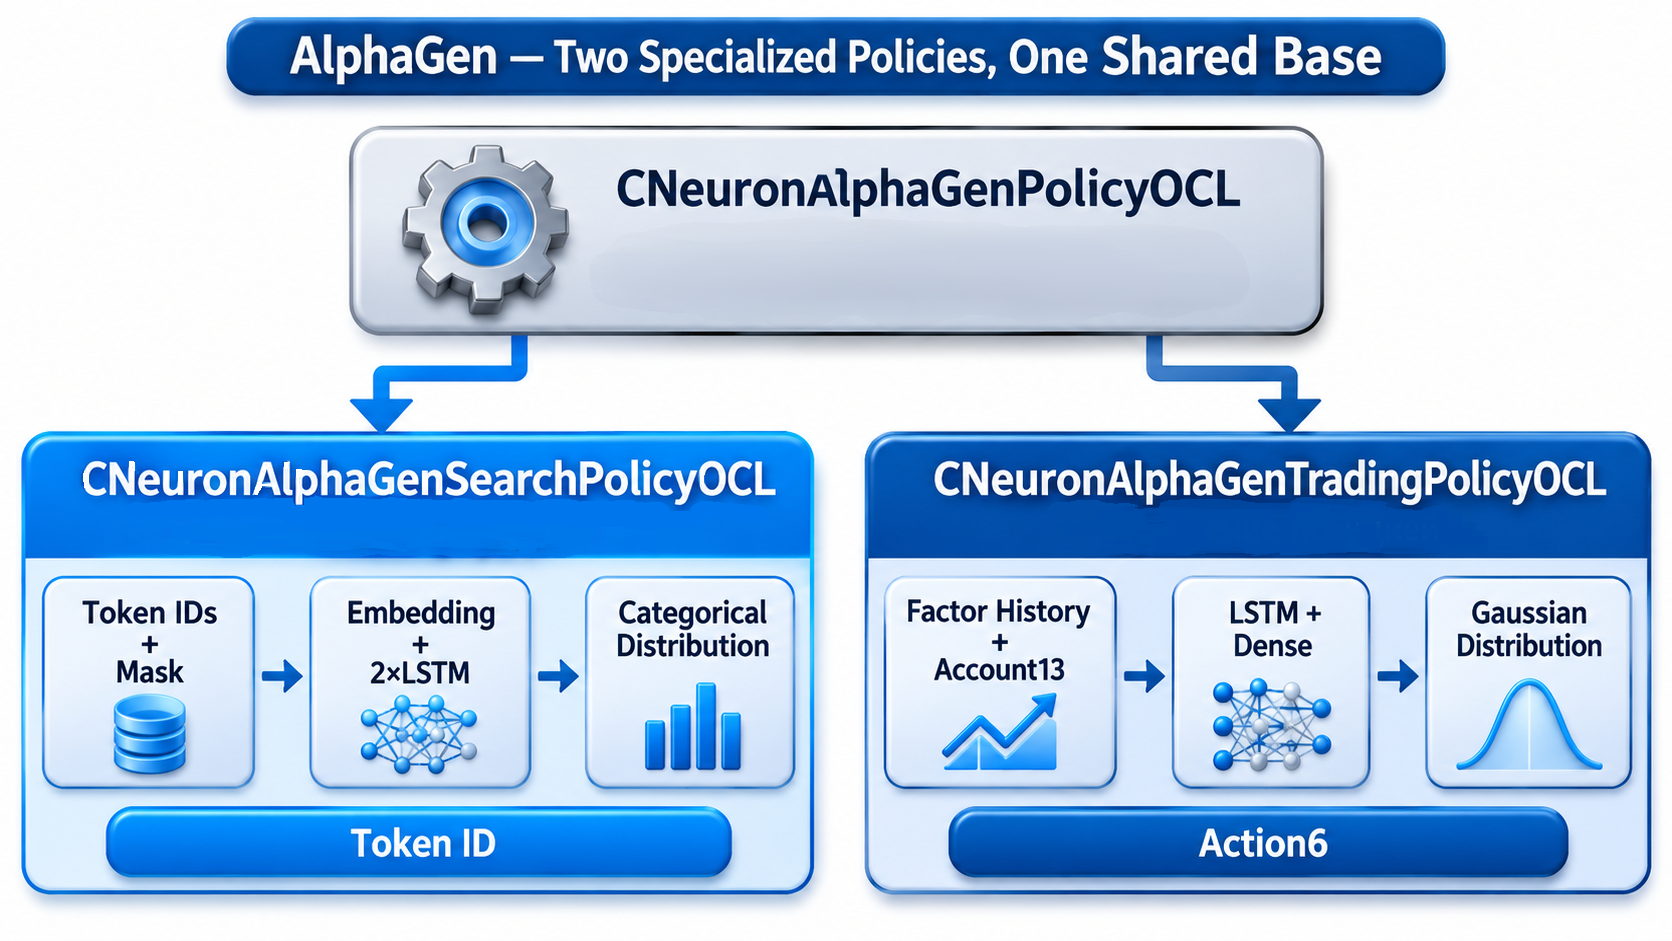
В библиотеке обе политики наследуют CNeuronAlphaGenPolicyOCL. Общий класс не задаёт единую сеть для двух задач. Он хранит конфигурацию, служебные буферы и состояние генератора случайных чисел. Кроме того, он предоставляет механизм распределений, числовые проверки и общие операции сериализации. Конкретные нейросетевые слои создают наследники: CNeuronAlphaGenSearchPolicyOCL и CNeuronAlphaGenTradingPolicyOCL.
В общей части предусмотрены m_cSample, m_cAction, m_cMetadata и m_cNoise. Для торговли m_cSample хранит шесть гауссовских значений до сигмоиды, а m_cAction — их преобразованный вариант. Для поиска основным результатом служит индекс токена в m_cSample. Одинаковые имена буферов обеспечивают общий вызов распределения, но не делают индекс токена торговым действием.
Буфер m_cMetadata содержит семь полей. Первые три — текущие log-probability действия, энтропия распределения и значение функции ценности. При воспроизведении учебного примера используются также прежняя log-probability, преимущество и целевая оценка функции ценности. Последнее поле хранит диагностическую величину ошибки. Это служебный формат политики, а не отчёт о прибыли или торговых сделках. Не все поля заполняются в каждом режиме вызова.
Метод Setup проверяет конфигурацию и выделяет буферы для сэмпла, действия, метаданных и случайных величин. Их общая ёмкость привязана к AG_ACTIONS. Поисковому объекту нужен лишь один индекс токена, но он пользуется тем же механизмом выделения памяти. Такой подход сокращает служебный код и сохраняет разные контракты выходов.
   if(config[AG_CFG_EMBEDDING]<1 ||
      config[AG_CFG_SEARCH_HIDDEN]<1 ||
      config[AG_CFG_TRADE_HIDDEN]<1 ||
      config[AG_CFG_MLP]<1 ||
      config[AG_CFG_MAX_TOKENS]<1 ||
      config[AG_CFG_W]<1 ||
      !m_cConfig.AssignArray(config) ||
      !m_cConfig.BufferCreate(OpenCL) ||
      !Allocate(m_cSample,AG_ACTIONS) ||
      !Allocate(m_cAction,AG_ACTIONS) ||
      !Allocate(m_cMetadata,7) ||
      !Allocate(m_cNoise,AG_ACTIONS))
      ReturnFalse;

   return(true);
  }
Для последовательных данных обе политики используют CNeuronAlphaGenLSTMOCL. Он развивает существующий LSTM-слой и добавляет работу с последовательностью и BPTT. Класс CNeuronAlphaGenPolicyLSTMOCL дополняет эту основу инициализацией, контролем геометрии и сохранением параметров. Из таких элементов поисковая модель собирает две LSTM, а торговая — одну. Общая реализация рекуррентных операций не делает их состояния общими.
Чтобы вычислить градиент по времени, одного последнего состояния LSTM недостаточно. Буфер m_cTape хранит промежуточные значения шагов, а m_cAnchor задаёт начальные значения скрытого состояния и состояния ячейки. Для выходов последовательности и производных выделены отдельные буферы. Благодаря этому Backward использует результаты того же прямого прохода, а не случайно восстановленную историю.
   if(!m_cTape.BufferInit(capacity*hidden*6,0) || !m_cTape.BufferCreate(OpenCL) ||
      !m_cAnchor.BufferInit(hidden*2,0) || !m_cAnchor.BufferCreate(OpenCL)||
      !m_cSequence.BufferInit(capacity*hidden,0) || !m_cSequence.BufferCreate(OpenCL)||
      !m_cSequenceGradient.BufferInit(capacity*hidden,0) || !m_cSequenceGradient.BufferCreate(OpenCL)||
      !m_cBPTTWork.BufferInit(capacity*hidden*4,0) || !m_cBPTTWork.BufferCreate(OpenCL))
      ReturnFalse;
Параметр capacity задаёт предельную длину последовательности, а hidden — размер скрытого состояния. Буфер m_cTape содержит capacity × hidden × 6 элементов, а якорь — hidden × 2. Число шесть здесь относится к внутренним рекуррентным значениям, а не к шести параметрам торгового действия. Совпадение числа в двух контрактах не означает их взаимозаменяемости.
Метод Sequence передаёт кернелу AGLSTMForward входную последовательность, её длину, веса и якорь. Кернел сохраняет как выходы, так и данные для последующей производной. Backward использует AGLSTMBackward и AGLSTMWeightGradient. Когда градиенты подготовлены и проверены, Apply обновляет матрицы методом Adam. Далее посмотрим, как две политики по-разному вызывают эти общие операции.
   setBuffer(def_k_AGLSTMForward,def_ag_AGLSTMForward_input,source.GetIndex())
   setArgument(def_k_AGLSTMForward,def_ag_AGLSTMForward_length,length)
   setArgument(def_k_AGLSTMForward,def_ag_AGLSTMForward_inputs,m_iInputs)
   setArgument(def_k_AGLSTMForward,def_ag_AGLSTMForward_hidden,(int)Neurons())
   setBuffer(def_k_AGLSTMForward,def_ag_AGLSTMForward_weights,m_cWeightsLSTM.GetIndex())
   setBuffer(def_k_AGLSTMForward,def_ag_AGLSTMForward_anchor,m_cAnchor.GetIndex())
   setBuffer(def_k_AGLSTMForward,def_ag_AGLSTMForward_tape,m_cTape.GetIndex())
   setBuffer(def_k_AGLSTMForward,def_ag_AGLSTMForward_output,m_cSequence.GetIndex())
   if(!OpenCL.SetArgumentLocalMemory(def_k_AGLSTMForward,def_ag_AGLSTMForward_state,
                                    (int)((long)Neurons()*22*sizeof(float))))
      ReturnFalse;
Полносвязные операции вынесены в CNeuronAlphaGenDenseOCL. Этот класс обеспечивает преобразование входного вектора, числовой контроль и обновление матриц методом Adam. У поисковой политики он обслуживает embedding и проекцию на словарь токенов. У торговой — соединение рекуррентного состояния с данными счёта и расчёт параметров действия. Общая арифметика матриц здесь обслуживает два разных вычислительных графа.
Общий метод Distribution вызывает кернел AGDistribution. Параметр categorical выбирает категориальную ветвь для токенов либо гауссовскую для вещественных действий. Параметр mode различает сэмплирование, детерминированный торговый вывод и расчёт градиента по сохранённому выбору. Метод получает готовую голову сети. Способ построения её входа остаётся обязанностью конкретной политики.
bool CNeuronAlphaGenPolicyOCL::Distribution(CNeuronBaseOCL *head,
                                            CBufferFloat *mask,
                                            const bool categorical,
                                            const int mode)
  {
   m_iMode=mode;
   m_bReady=false;

   if(mode<0||mode>2)
      ReturnFalse;

   if(mode==0)
     {
      if(categorical)
         m_cNoise.Update(0,Uniform());
      else
         for(int j=0;j<AG_ACTIONS;j+=2)
           {
            double radius=MathSqrt(-2.0*MathLog((double)Uniform()));
            double angle=2.0*M_PI*(double)Uniform();
            m_cNoise.Update(j,(float)(radius*MathCos(angle)));
            m_cNoise.Update(j+1,(float)(radius*MathSin(angle)));
           }

      if(!m_cNoise.BufferWrite())
         ReturnFalse;
     }
   setBuffer(def_k_AGDistribution,def_ag_AGDistribution_head,head.getOutputIndex())
   setBuffer(def_k_AGDistribution,def_ag_AGDistribution_mask,mask.GetIndex())
   setBuffer(def_k_AGDistribution,def_ag_AGDistribution_noise,m_cNoise.GetIndex())
   setBuffer(def_k_AGDistribution,def_ag_AGDistribution_cfg,m_cConfig.GetIndex())
   setArgument(def_k_AGDistribution,def_ag_AGDistribution_categorical,(int)categorical)
   setArgument(def_k_AGDistribution,def_ag_AGDistribution_mode,mode)
   setBuffer(def_k_AGDistribution,def_ag_AGDistribution_sample,m_cSample.GetIndex())
   setBuffer(def_k_AGDistribution,def_ag_AGDistribution_action,m_cAction.GetIndex())
   setBuffer(def_k_AGDistribution,def_ag_AGDistribution_metadata,m_cMetadata.GetIndex())
   setBuffer(def_k_AGDistribution,def_ag_AGDistribution_gradient,head.getGradientIndex())
   uint global_work_offset[]={0};
   uint global_work_size[]={1};
   kernelExecute(def_k_AGDistribution,global_work_offset,global_work_size)

   return(true);
  }
Обе политики имеют Configure, Backward, Apply, Save и Load. Но одинаковые имена методов не означают одинаковой формы прямого прохода. Поисковой модели нужны префикс токенов и маска. Торговой — история факторного сигнала, входной рекуррентный якорь и Account13. Поэтому у наследников разные публичные методы вычисления действия.
Политика поиска формул
В первой статье мы научились определять допустимые продолжения выражения. Теперь эти разрешения становятся частью вероятностного выбора. Поисковая политика принимает префикс формулы и маску. Её выход — распределение по AG_VOCABULARY токенам. За один шаг выбирается индекс следующего обозначения. Этот индекс нельзя трактовать ни как значение индикатора, ни как приказ открыть позицию.
В поисковом классе находятся m_cEmbedding, две LSTM (m_cFirst и m_cSecond) и настроенный как обучаемая проекция m_cMean. Её выход должен содержать логиты токенов и значение функции ценности. Название m_cMean здесь не означает математическое ожидание гауссовской торговли. Служебный m_cHead передаёт результат общему распределению и не имеет собственной обучаемой матрицы: при его настройке число выходных связей равно нулю.
   return(m_cEmbedding.Configure(context,EmbeddingDim()-1,AG_VOCABULARY,seed+1) &&
           m_cMean.Configure(context,SearchHidden(),AG_VOCABULARY+1,seed+2) &&
           m_cHead.Configure(context,AG_VOCABULARY+1,0,seed+5) &&
           m_cFirst.Configure(context,EmbeddingDim(),SearchHidden(),capacity) &&
           m_cSecond.Configure(context,SearchHidden(),SearchHidden(),capacity) && Workspace());
Выход проекции имеет размер AG_VOCABULARY + 1. Для каждого токена сеть выдаёт логит — оценку предпочтительности до нормировки. Дополнительное значение относится к функции ценности поисковой политики. Она оценивает ожидаемое будущее вознаграждение, а не изменение цены анализируемого инструмента в пунктах. Важно разделять результат выбора токена, оценку формулы пулом и прогноз торгового действия.
Токен представлен целым индексом. Чтобы передать его в LSTM, AGEmbedding выбирает строку обучаемой матрицы и добавляет позиционное синусно-косинусное кодирование. Так одинаковые операции могут влиять на состояние сети по-разному в зависимости от места в формуле. PAD получает нулевое представление. Перед обращением к weights прямой кернел должен проверить, что raw_token конечен, находится в диапазоне словаря и является целым числом.
   int token=(int)raw_token;

   if(token==AG_PAD)
     {
      output[t*dimension+j]=0.0f;
      return;
     }
   float angle=(float)t/pow(position_scale,(float)(2*(j/2))/(float)dimension);

   output[t*dimension+j]=weights[token*dimension+j]+((j%2)==0 ? sin(angle) : cos(angle));
Два LSTM-слоя последовательно обрабатывают представления токенов. При обработке самостоятельного префикса поисковая политика сбрасывает якоря обоих слоёв. Иначе память о предыдущей формуле попала бы в новую последовательность. В ForwardPrefix поэтому выполняются два вызова ResetAnchor, затем оба прямых прохода.
   if(!m_cFirst.ResetAnchor() ||
      !m_cSecond.ResetAnchor()||
      !m_cFirst.Sequence(GetPointer(m_cEmbedded),length) ||
      !m_cSecond.Sequence(m_cFirst.SequenceOutput(),length) ||
      !SequenceMap(m_cSecond.SequenceOutput(),m_cMean.getOutput(),length,SearchHidden(),0,mask) ||
      !m_cHead.ForwardDense(GetPointer(m_cMean)))
      ReturnFalse;

   return(Distribution(GetPointer(m_cHead),mask,true,mode));
После второй LSTM на выходе находится последовательность скрытых векторов, по одному для каждой позиции. В этой архитектуре политика использует их среднее. Кернел AGSequence в режиме 0 суммирует значения каждого признака по реальным позициям и делит на длину. Здесь усредняются признаки, а не готовые вероятности токенов. После проекции общий слой получает один вектор для категориального распределения.
__kernel void AGSequence(__global const float *input,
                         __global       float *output,
                                  const int    length,
                                  const int    hidden,
                                  const int    mode,
                         __global const float *account)
  {
   int j=get_global_id(0);

   if(mode==0&&j<hidden)
     {
      float sum=0.0f;

      for(int t=0;t<length;t++)
         sum+=input[t*hidden+j]/(float)length;
      output[j]=sum;
     }
   else
      if(mode==1&&j<length*hidden)
         output[j]=input[j%hidden]/(float)length;
      else
         if(mode==2&&j<hidden+AG_ACCOUNT)
            output[j]=j<hidden?input[(length-1)*hidden+j]:account[j-hidden];
         else
            if(mode==3&&j<length*hidden)
               output[j]=j/hidden==length-1?input[j%hidden]:0.0f;
            else
               if(mode==4&&j<hidden*2)
                  output[j]=input[(length-1)*hidden*6+j];
  }
Маска участвует непосредственно в вычислении вероятностей. Кернел AGDistribution ищет максимальный логит и суммирует экспоненты только по разрешённым токенам. Если сначала нормировать весь словарь, а затем удалить запрещённые варианты, сумма вероятностей оставшихся действий могла бы оказаться меньше единицы. Поэтому нормировка ведётся сразу внутри допустимого множества.
      float total=0.0f;

      for(int j=0;j<AG_VOCABULARY;j++)
         if(mask[j]>0.0f)
            maximum=fmax(maximum,head[j]);

      for(int j=0;j<AG_VOCABULARY;j++)
         if(mask[j]>0.0f)
            total+=exp(head[j]-maximum);

      if(!(total>0.0f)||!isfinite(total))
        {
         metadata[6]=NAN;
         return;
        }
      float normalizer=maximum+log(total);
      float cumulative=0.0f;
      int   choice=-1;
      int   last=-1;

      for(int j=0;j<AG_VOCABULARY;j++)
         if(mask[j]>0.0f)
           {
            float lp=head[j]-normalizer;
            float p=exp(lp);

            entropy-=p*lp;
            cumulative+=p;
            last=j;

            if(choice<0&&noise[0]<cumulative)
               choice=j;
           }

      if(mode!=2)
         sample[0]=(float)(choice<0?last:choice);
      int selected=(int)sample[0];
Предположим, на некотором шаге маска оставила три разрешённых продолжения, а остальные закрыла. Если их нормированные вероятности составляют 0,20, 0,50 и 0,30, выбирается только один из этих трёх токенов. Это условный пример работы распределения. Он не утверждает, что именно такие вероятности наблюдались при поиске факторов на рыночной истории.
Математически маска ограничивает множество допустимых индексов M. Тогда вероятность разрешённого действия i рассчитывается по его логиту z и нормировке внутри M:
p(i) = exp(zi) / Σj∈M exp(zj), i ∈ M.
Маска определяет, какое продолжение формулы допустимо синтаксически. Она не оценивает будущую доходность. Предпочтения внутри разрешённого множества задают обучаемые веса сети. После завершения формулы её полезность оценивает пул из третьей статьи. Это разные этапы: сначала выбор символов, затем проверка формулы и только после этого вознаграждение поиска.
При одинаковых логитах разные маски дают разные вероятности. Поэтому состояние поискового выбора включает не только префикс, но и маску, действовавшую на данном шаге. Для повторного вычисления вероятности выбранного токена потребуется сохранить оба значения. В этой статье достаточно установить контракт политики; запись и обработку учебных примеров рассмотрим позже.
Во второй статье уже рассматривался AGSearchGenerate, создающий кандидатов на стороне OpenCL. Теперь видно, откуда он получает веса: GenerateBatch передаёт ему параметры поисковой политики. Метод ForwardPrefix использует те же параметры, но последовательно обрабатывает заданный префикс. Генерация пакета не является циклом вызовов ForwardPrefix из MQL5. Это два маршрута через одну модель с разными задачами.
Для обратного прохода Backward получает производные по выходной голове. Затем градиент распределяется от среднего представления к позициям, проходит обе LSTM и достигает таблицы embedding. Кернел AGEmbeddingBackward суммирует вклады только для встретившихся токенов. Один и тот же токен, использованный несколько раз, получает сумму соответствующих производных.
__kernel void AGEmbeddingBackward(__global const float *tokens,
                                           const int    length,
                                  __global const float *gradient,
                                           const int    dimension,
                                  __global       float *weights_gradient)
  {
   int j=get_global_id(0);
   int token=get_global_id(1);

   if(j>=dimension||token>=AG_VOCABULARY)
      return;

   float sum=0.0f;

   for(int t=0;t<length;t++)
     {
      float raw_token=tokens[t];

      if(!isfinite(raw_token)||raw_token<0.0f||raw_token>=(float)AG_VOCABULARY||
         raw_token!=floor(raw_token))
        {
         weights_gradient[token*dimension+j]=NAN;
         return;
        }

      if(token!=AG_PAD&&(int)raw_token==token)
         sum+=gradient[t*dimension+j];
     }
   weights_gradient[token*dimension+j]=sum;
  }
Обратное распространение здесь меняет параметры распределения, из которого выбирались токены. Сам индекс токена остаётся дискретным; его нельзя дифференцировать как вещественную цену или показание индикатора. Производная относится к функции оптимизации политики и её логитам. Такая граница важна при дальнейшем объединении поиска с торговой моделью.
Метод Apply поисковой политики обновляет четыре набора параметров: embedding, две LSTM и выходную проекцию. Перед применением должен завершиться Backward и пройти числовой контроль. Служебный m_cHead в перечне обновляемых матриц отсутствует. Тем самым по коду можно установить реальное множество обучаемых компонент.
bool CNeuronAlphaGenSearchPolicyOCL::Apply(void)
  {
   if(!m_bReady)
      ReturnFalse;

   m_bReady=false;

   return(m_cEmbedding.Apply() &&
          m_cFirst.Apply() &&
          m_cSecond.Apply()&&
          m_cMean.Apply());
  }
Торговая политика
Третья статья закончилась формированием истории нормированного сигнала действующего пула. Именно эту последовательность получает торговая политика. Сигнал характеризует совместную динамику факторов на закрытых барах. Сам по себе он ещё не выбирает направление и объём сделки. При одном и том же сигнале решение может зависеть от того, открыта ли позиция и как изменилось состояние счёта.
Дополнительный вход — Account13, снимок из тринадцати признаков на момент решения. В нём содержатся нормированные показатели баланса и equity, отдельные объёмы длинной и короткой экспозиции, прибыль по направлениям и временные признаки. Эти данные имеют иную природу, чем последовательность значений фактора. Токены формул и синтаксическая маска в торговую сеть не передаются.
Внутри торговой политики находится одна LSTM m_cRecurrent с одним входным признаком на бар. Затем следуют полносвязные компоненты m_cInput, m_cHidden1, m_cHidden2 и служебный m_cHead. На вход m_cInput поступает TradeHidden() + AG_ACCOUNT значений. Голова получает AG_ACTIONS * 2 + 1 чисел — для шести средних, шести параметров масштаба и одного значения критика.
   return(m_cRecurrent.Configure(context,1,TradeHidden(),(int)config[AG_CFG_W])&&
           m_cInput.Configure(context,TradeHidden()+AG_ACCOUNT,MLP(),seed+2)&&
           m_cHidden1.Configure(context,MLP(),MLP(),seed+3,None)&&
           m_cHidden2.Configure(context,MLP(),AG_ACTIONS*2+1,seed+4,None)&&
           m_cHead.Configure(context,AG_ACTIONS*2+1,0,seed+5)&&
           Allocate(m_cSignalGradient,(int)config[AG_CFG_W]));
Метод Encode сначала передаёт в LSTM только историю сигнала. После этого Heads объединяет последний скрытый вектор с текущим Account13. Тем самым сеть использует прошлое движение факторов и актуальные финансовые ограничения как разные виды входов. Подача текущего состояния счёта на каждый исторический бар нарушила бы временную привязку наблюдений.
bool CNeuronAlphaGenTradingPolicyOCL::Heads(CBufferFloat*account,const int mode)
  {
   m_bReady=false;

   if(!account||account.Total()!=AG_ACCOUNT||m_iLength<1)
      ReturnFalse;

   if(!SequenceMap(m_cRecurrent.SequenceOutput(),m_cInput.getOutput(),m_iLength,TradeHidden(),2,account)||
      !m_cHidden1.ForwardDense(GetPointer(m_cInput))||!ReLU(GetPointer(m_cHidden1),0)||
      !m_cHidden2.ForwardDense(GetPointer(m_cHidden1))||!ReLU(GetPointer(m_cHidden2),0)||
      !m_cHead.ForwardDense(GetPointer(m_cHidden2)))
      ReturnFalse;

   return(Distribution(GetPointer(m_cHead),GetPointer(m_cNoise),false,mode));
  }
Поиск каждой независимой формулы начинается с нулевых якорей. Торговая сеть работает иначе: её Encode допускает внешний anchor для продолжения контекста или воспроизведения нужного участка. Методы Anchor, CommitAnchor и ResetAnchor дают возможность читать, фиксировать и сбрасывать рекуррентное состояние. Это управление историей признака, а не изменение самих значений фактора.
В реализации AGSequence режим 2 берёт последний выход LSTM и добавляет Account13 в конец вектора. Последнее скрытое состояние уже содержит информацию о предшествующем ряде, а текущий снимок счёта дополняет его перед выходными слоями.
Выход торговой головы содержит параметры шести гауссовских компонент и значение функции ценности. Для каждой компоненты сеть выдаёт среднее mu и внутреннюю величину xi. Масштаб sigma получается через SoftPlus с добавкой AG_CFG_SIGMA_FLOOR. Такая параметризация задаёт положительный масштаб при конечных корректных значениях. Шесть компонент описывают распределение нормируемого действия, а не шесть независимых торговых заявок.
σj = SoftPlus(ξj) + σmin, uj = μj + σjεj.
При обычном сэмплировании значения шума ε берутся из стандартного нормального распределения. В детерминированном режиме торговой политики используется u = mu. Далее каждая компонента проходит сигмоиду и превращается в число между нулём и единицей. При вычислении в float крайние значения зависят также от округления.
      for(int j=0;j<AG_ACTIONS;j++)
        {
         float mu=head[j];
         float xi=head[AG_ACTIONS+j];
         float sigma=fmax(xi,0.0f)+log1p(exp(-fabs(xi)))+cfg[AG_CFG_SIGMA_FLOOR];

         if(mode!=2)
            sample[j]=mode==1?mu:mu+sigma*noise[j];
         float u=sample[j];
         float standard=(u-mu)/sigma;

         action[j]=u>=0.0f?1.0f/(1.0f+exp(-u)):exp(u)/(1.0f+exp(u));
         logp-=0.5f*(standard*standard+2.0f*log(sigma)+log(2.0f*M_PI_F));
         entropy+=0.5f*(log(2.0f*M_PI_F*M_E_F)+2.0f*log(sigma));
        }
На выходе торговой политики нужно различать параметры распределения, сэмпл и действие. Значения mu и xi определяют распределение, m_cSample сохраняет выбор u до сигмоиды, а m_cAction содержит шесть преобразованных величин. Именно их затем интерпретирует торговое приложение. Для расчёта вероятности прежнего выбора нельзя заменять сохранённый u фактическим объёмом сделки.
Формат Action6 состоит из трёх параметров Buy и трёх параметров Sell: компоненты объёма, TP и SL. Это один вектор намерения, а не шесть заявок. Исполнитель сравнивает компоненты объёма двух направлений, определяет знак и рассчитывает целевой объём. Лоты, шаг объёма и допустимые расстояния до защитных уровней проверяются вне политики. Поэтому её вещественный выход нельзя напрямую отправить торговому серверу.
Например, если числовые компоненты стороны Buy и Sell равны соответственно 0,7 и 0,4, их разность ещё не является объёмом 0,3 лота. Приложение должно перевести её через максимальный объём, спецификацию инструмента и шаг лота. То же относится к TP и SL: значение 0,5 не означает непосредственно пять пунктов или фиксированную цену. Поэтому выход сети нельзя без преобразования передавать торговому серверу.
Защитный Flat относится к правилам применения торгового действия. Если целевая позиция равна нулю, исполнитель может закрыть имеющуюся экспозицию или не открывать новую. Нулевая цель не возникает автоматически из обычного гауссовского сэмплирования с последующей сигмоидой; её обработку определяет исполнитель.
Торговый Backward передаёт градиент от выходной головы к полносвязным слоям. Затем AGSequence в режиме 3 помещает производную на последний временной выход LSTM. BPTT распространяет её назад по последовательности. Account13 участвует в прямом проходе как набор входных признаков. Обновляются веса сети, а не записанные финансовые наблюдения.
bool CNeuronAlphaGenTradingPolicyOCL::Backward(CNeuronAlphaGenEvaluatorOCL*evaluator)
  {
   m_bReady=false;

   if(!evaluator||m_iMode!=2||!m_cHidden2.CalcHiddenGradients(GetPointer(m_cHead))||
      !ReLU(GetPointer(m_cHidden2),1)||!m_cHidden1.CalcHiddenGradients(GetPointer(m_cHidden2))||
      !ReLU(GetPointer(m_cHidden1),1)||!m_cInput.CalcHiddenGradients(GetPointer(m_cHidden1))||
      !m_cInput.Outer(GetPointer(m_cHidden1))||!m_cHidden1.Outer(GetPointer(m_cHidden2))||
      !m_cHidden2.Outer(GetPointer(m_cHead))||
      !SequenceMap(m_cInput.getGradient(),m_cRecurrent.SequenceGradient(),m_iLength,TradeHidden(),3,
                   GetPointer(m_cNoise))||
      !m_cRecurrent.Backward(m_cSignal,GetPointer(m_cSignalGradient)))
      ReturnFalse;
Apply торговой политики обновляет LSTM и три полносвязные матрицы. Здесь отсутствуют таблица токенов и две поисковые LSTM. После Backward проверяется готовность градиента; повторный вызов Apply без нового расчёта не должен повторно менять веса. Этот контракт одинаков по смыслу у обоих классов, хотя сами обновляемые параметры различаются.
bool CNeuronAlphaGenTradingPolicyOCL::Apply(void)
  {
   if(!m_bReady)
      ReturnFalse;

   m_bReady=false;

   return(m_cRecurrent.Apply() &&
          m_cInput.Apply() &&
          m_cHidden1.Apply() &&
          m_cHidden2.Apply());
  }
Общие механизмы
Обе политики вычисляют распределение действий и значение функции ценности. Поисковая ветвь AGDistribution нормирует логиты разрешённых токенов, торговая рассчитывает масштаб, плотность и энтропию шести гауссовских компонент. PPO использует log-probability сохранённого выбора; общие служебные буферы содержат метаданные, но сами действия имеют разные форматы.
В режиме расчёта градиента AGDistribution сопоставляет новую log-probability с сохранённой прежней. Экспонента их разности задаёт отношение вероятностей ratio = exp(logp − old_logp). В PPO это отношение ограничивается параметром AG_CFG_PPO_CLIP. Дополнительные члены функции цели отвечают за ошибку оценки ценности и энтропию распределения.
Маршруты производной зависят от типа политики. В поисковой ветви градиент проходит через логиты разрешённых токенов, усреднение позиций, две LSTM и embedding. В торговой ветви он относится к mu и xi гауссовских компонент, проходит через полносвязные слои и последнюю позицию одной LSTM, а затем распространяется по истории методом BPTT.
Режим 0 общего Distribution выполняет случайный выбор, режим 2 использует сохранённый сэмпл для расчёта градиента. Режим 1 торговой политики выдаёт детерминированные средние mu перед сигмоидой. Перед изменением весов обе политики проверяют производные; Backward устанавливает m_bReady после числового контроля, а Apply сбрасывает этот признак после обновления. Полное расписание обучения остаётся задачей внешнего координатора.
Оба наследника поддерживают Save и Load. Общий SaveCommon записывает конфигурацию и состояние генератора случайных чисел. Специализированные методы сохраняют параметры своих слоёв, а загрузка проверяет их геометрию. Поисковую модель с двумя LSTM и таблицей токенов нельзя без преобразования прочитать как торговую модель с иной размерностью входов и головы.
При сохранении обучаемых слоёв записываются также состояния оптимизатора, предусмотренные их реализацией. Это важно для продолжения изменения весов: последующие шаги Adam зависят не только от матриц, но и от накопленных моментов. Сохранённый объект политики при этом остаётся лишь частью общего состояния системы. Он не содержит подтверждений совершённых сделок.
Сериализация отдельной политики не восстанавливает автоматически весь торговый процесс. Накопленные события, незавершённые переходы и расписание обновлений относятся к прикладной системе. Здесь достаточно определить, что сохраняет каждый объект и какие условия он проверяет при загрузке.
Теперь можно ответить на архитектурный вопрос. Базовый класс повторно использует распределения, буферы и контроль. Специализированные классы определяют разные данные и последовательности операций. Это разделение заметно уже по их публичным методам.
Почему два объекта, а не один универсальный
Формально можно создать один универсальный класс и использовать два его экземпляра. Параметр режима выбирал бы один из двух наборов слоёв, входов и функций распределения. Однако существующий CNeuronAlphaGenPolicyOCL — общая инфраструктура, а не готовая универсальная сеть. Он не реализует единый Forward и не задаёт взаимозаменяемый контракт для токенов и торговой истории.
| Контракт | Поиск формул | Торговая политика |
|---|---|---|
| Вход | Префикс токенов и маска | История сигнала и Account13 |
| Рекуррентная часть | Две LSTM, нулевые якоря | Одна LSTM, управляемый якорь |
| Агрегация | Среднее по позициям | Последний выход LSTM + счёт |
| Распределение | Категориальное с маской | Гауссовское, 6 компонент |
| Действие | Индекс следующего токена | Нормированный Action6 |
| Обновляемые параметры | Таблица токенов, 2 LSTM, проекция | LSTM, 3 полносвязных слоя |
Главное различие двух политик — контракт действия. Поисковая выбирает один токен из множества, ограниченного маской. Торговая формирует шесть непрерывных параметров Action6, которые исполнитель затем проверяет и преобразует. Поэтому универсальному объекту потребовались бы отдельные выходные головы и ветви вычисления распределения.
Различаются и входные представления. Поисковая политика преобразует индексы токенов через embedding и позиционное кодирование, обрабатывает префикс двумя LSTM и усредняет скрытые состояния. Торговая получает вещественную историю сигнала, обрабатывает её одной LSTM, берёт последний выход и объединяет его с Account13.
Рекуррентная память также подчиняется разным правилам: поисковая политика сбрасывает якоря перед независимым префиксом, торговая допускает внешний якорь и фиксацию состояния. Эти контракты определяют и обратный маршрут: в поиске градиент проходит через агрегацию, две LSTM и embedding; в торговле — через полносвязные слои и BPTT одной LSTM. Наборы обновляемых параметров отражены в таблице выше.
Два экземпляра одного параметризованного класса могли бы выполнять те же задачи, если явно задать тип политики, прямой и обратный маршруты, правила сохранения и проверки. Общий абстрактный интерфейс с двумя реализациями — ещё один вариант, но действующий базовый класс не объявляет полный набор взаимозаменяемых виртуальных методов. Поисковый наследник предоставляет ForwardPrefix и GenerateBatch, торговый — Encode, Heads и Forward.
Два специализированных класса сохраняют независимые веса и связываются потоком данных: поиск предлагает формулы, пул формирует сигнал, торговая политика принимает его историю. Градиент торгового решения не проходит напрямую через дискретную замену состава пула; эти этапы согласует внешний координатор. Такое разделение — инженерный выбор адаптации, а не обязательное условие исходного AlphaGen.
Заключение
На этом этапе мы получили два отдельных нейросетевых компонента. CNeuronAlphaGenSearchPolicyOCL принимает префикс и маску, использует embedding и две LSTM, формирует распределение по допустимым токенам. CNeuronAlphaGenTradingPolicyOCL обрабатывает историю сигнала и текущий Account13, затем выдаёт параметры распределения для нормированного Action6. Это разные действия и разные представления состояния.
Общие методы и буферы вынесены в CNeuronAlphaGenPolicyOCL. Он обеспечивает распределения и служебные операции, а наследники задают собственные прямые и обратные проходы. Один универсальный класс с двумя экземплярами был бы возможен, но скрывал бы два вычислительных графа за переключением режима. Специализированные объекты яснее фиксируют назначение входов, устройство памяти и обновляемые матрицы.
Теперь последовательно собраны примитивы языка формул, вычислитель, пул и обе нейросетевые политики. Этого достаточно, чтобы перейти к следующему уровню реализации, но недостаточно для вывода о результативности торговли. В заключительной статье объединим компоненты, разберём подготовку учебных переходов и режимы обучения, затем рассмотрим проверку на отдельной истории. Так продолжится путь от формулы к решению и его финансовому результату.
Ссылки
- Generating Synergistic Formulaic Alpha Collections via Reinforcement Learning.
- Proximal Policy Optimization Algorithms.
- Другие статьи автора.
Файлы проекта
| # | Имя | Тип | Описание |
|---|---|---|---|
| 1 | AlphaGen_Contract.mqh | Общий контракт | Идентификаторы токенов и параметры общего контракта |
| 2 | AlphaGen.cl | OpenCL-программа | Вычислительные кернелы |
| 3 | Trajectory.mqh | Общий модуль | Общие настройки, подготовка данных, финансовая среда, исполнение и завершение |
| 4 | Study.mq5 | Советник | Советник предварительного офлайн-обучения |
| 5 | StudyOnline.mq5 | Советник | Советник обучения в тестере стратегий |
| 6 | Test.mq5 | Советник | Исполнение торговой политики с фиксированными весами |
| 7 | NeuroNet.mqh | Библиотека классов | Подключение модулей нейронной библиотеки |
| 8 | NeuroNet.cl | OpenCL-программа | Вычислительные кернелы нейронной библиотеки |
| 9 | AlphaGen_Pool.cl | OpenCL-программа | Пакетная обработка кандидатов и вычисление факторов пула |
Исходные файлы доступны в репозитории проекта.
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.



