

Изолирующий лес средствами MQL5: Обнаружение аномалий качества исполнения заявок
 14
 0

Введение
Большая часть того, что пишут об обнаружении аномалий в торговых кругах, касается цен: выявления обвалов, скачков или смены режима на самом рынке. Практически никто не применяет тот же инструмент для анализа качества исполнения сделок, хотя именно качество исполнения на самом деле определяет, выдержит ли стратегия работу с реальным брокером. Проскальзывание, задержка исполнения, спред в момент исполнения заявки, который вы фактически оплатили, частичные исполнения, незаметные серии реквот. Именно эти переменные определяют, проявится ли ваше преимущество, выявленное в ходе бэктеста, на реальном счете или будет полностью поглощено скрытыми издержками, на которые никто не обратил внимания.
В этой статье описывается реализация изолирующего леса на MQL5 для мониторинга качества исполнения. Каждый раз при открытии позиции советник фиксирует небольшой вектор признаков, описывающий качество исполнения заявки, и рассчитывает для него оценку аномальности с помощью модели, обученной на недавней истории исполнений заявок самого советника. Советник реагирует — приостанавливает новые входы, увеличивает расстояние до стоп-лоссов или полностью прекращает торговлю — в тот момент, когда показатели перестают походить на что-либо из того, с чем стратегия сталкивалась ранее. Без ONNX, без ALGLIB, без внешних DLL. Весь ансамбль деревьев — от случайного выбора разбиений до расчета оценки аномальности по длине пути — написан исключительно на MQL5 и работает внутри процесса советника.
Примечание об области применения: это слой мониторинга и механизм защитной остановки торговли, а не генератор сигналов. Он не позволяет предсказать направление движения цены и не сделает прибыльной посредственную стратегию. Его задача — защитить уже работающую стратегию от незаметного ухудшения результатов из-за снижения ликвидности брокера, увеличения задержек вашего VPS или ухудшения рыночных условий в момент исполнения заявок.
Почему для контроля качества исполнения нужен отдельный детектор аномалий
Если вы когда-нибудь сравнивали отчет тестера стратегий с выпиской по реальному счету и задавались вопросом, откуда взялась эта разница, то вам уже знакома эта проблема. В бэктестах предполагается фиксированная модель исполнения с предсказуемым поведением. В реальной торговле вы имеете дело с распределением, в котором хвост важнее среднего значения. Один случай проскальзывания на 40 пунктов во время резкого движения цены на новостях или серия двухсекундных задержек исполнения в период дефицита ликвидности могут нанести больший ущерб, чем сотня обычных сделок вместе взятых. Обычно это происходит настолько незаметно, что проблему обнаруживают лишь тогда, когда кривая средств уже пошла вниз.
Первое желание — установить жесткий лимит проскальзывания и отклонять исполнения заявок, выходящие за этот лимит. Это работает в задачах с одним признаком, но качество исполнения действительно многомерно: исполнение заявки может быть "нормальным" по каждому отдельному показателю — проскальзыванию, задержке и спреду, — а их сочетание при этом может быть необычным, чего отдельный порог для каждого признака никогда не выявит. Именно поэтому здесь нужен многомерный детектор, обучаемый без учителя, а не набор независимых защитных ограничений.
Стоит перечислить возможные варианты, а не переходить сразу к ответу. Z-оценка, рассчитанная отдельно для каждого признака, не выявляет описанный выше случай необычного сочетания значений признаков. Алгоритмам DBSCAN и Local Outlier Factor нужны метрика расстояния и параметр размера окрестности, подходящие значения которых трудно поддерживать по мере обновления скользящего окна. Для одноклассовой SVM необходимо подбирать ядро и параметр ширины разделяющей полосы для каждого набора данных, и ни для одного из этих трех алгоритмов нет готового варианта на MQL5 без внешних зависимостей, в отличие от ансамбля деревьев со случайными разбиениями. Изолирующий лес подходит для этой задачи, поскольку требует настройки лишь небольшого числа параметров, не нуждается в метрике расстояния или ядре, при малом размере выборки его эффективность снижается постепенно, а сам алгоритм можно реализовать средствами MQL5 без использования численных библиотек.
Изолирующий лес хорошо подходит для этой задачи по причине, которую легко упустить из виду: для обучения ему не нужны размеченные аномалии, а для аномалий исполнения как раз редко бывает заранее подготовленная надежная разметка. Расчет оценки аномальности требует O(num_trees × height_limit) сравнений на одну точку — примерно 100 × 8, то есть менее тысячи сравнений в конфигурации по умолчанию. Именно поэтому он может выполняться внутри функции OnTradeTransaction(). Это оценка вычислительной сложности в нотации Big O, а не результат замера производительности: чтобы не приводить цифру, которую я не могу подтвердить, в советнике предусмотрен входной параметр InpLogTimings, при включении которого в журнал выводится фактическое время расчета оценки аномальности и повторного обучения в миллисекундах на вашем оборудовании. Пошаговые инструкции см. в разделе "Как запустить и воспроизвести".
Жесткий лимит проскальзывания в коде исполнения торговых заявок всё же стоит сохранить — это отдельный уровень защиты, решающий другую задачу. Лимит защищает отдельную сделку от исполнения с экстремальным проскальзыванием. Изолирующий лес отслеживает закономерность в совокупности множества исполнений заявок, каждое из которых по отдельности проходит все жесткие проверки, но вместе они не похожи ни на что из того, с чем стратегия сталкивалась ранее. Ни один из них не заменяет другой.
Идея изолирующего леса вкратце
Ключевая идея изолирующего леса, изложенная в исходной статье Лю, Тин и Чжоу 2008 года, выгодно отличается от большинства подходов к обнаружению аномалий. Вместо того чтобы моделировать "норму" и измерять расстояние до нее, этот подход напрямую использует структурное свойство аномалий: их мало, и они отличаются от обычных наблюдений, поэтому для их изоляции от остальных данных требуется меньше случайных разбиений, чем для нормальных точек.
Изолирующее дерево строится путем многократного выбора случайного признака и случайного порога разбиения между минимальным и максимальным значениями этого признака в текущем подмножестве, пока каждая точка не окажется в отдельном подмножестве или не будет достигнуто ограничение глубины дерева. Повторите эту процедуру много раз с разными случайными подвыборками и усредните по всем деревьям леса длину пути, необходимого для изоляции заданной точки. Малая средняя длина пути означает, что точку было легко изолировать: вероятно, это аномалия. Большая средняя длина пути означает, что для отделения точки от соседей потребовалось много разбиений: это нормальная точка в плотной области.
Однако исходные значения длины пути нельзя напрямую сравнивать при разных размерах подвыборок: путь длиной 8 уровней в подвыборке из 32 точек имеет иной смысл, чем в подвыборке из 512 точек. Именно для этого и предназначен следующий этап нормализации:
Чтобы преобразовать исходную среднюю длину пути в пригодную для использования оценку аномальности в диапазоне от 0 до 1, ее нормируют относительно ожидаемой длины пути при неудачном поиске в двоичном дереве поиска с числом элементов, равным размеру подвыборки:
s(x, n) = 2 ^ ( -E(h(x)) / c(n) )

where:
  E(h(x)) = average path length of point x across all trees
  c(n)    = expected unsuccessful-search path length for a sample of size n
          = 2*H(n-1) - (2*(n-1) / n)
  H(i)    ~= ln(i) + 0.5772156649   (the Euler-Mascheroni constant)
Оценки, близкие к 1, указывают на выраженную аномалию, а 0,5 — теоретический ориентир, полученный в статье на основе асимптотических рассуждений. На практике эта теоретическая середина диапазона редко служит рабочим порогом: оценки нормальных точек в реальном журнале группируются ниже нее, поэтому фактическую границу принятия решения в итоге подбирают по данным. В разделе о валидации ниже показано, что для одного реального журнала этот порог оказался в диапазоне 0,65–0,70. Поэтому в советнике задано исходное значение по умолчанию InpAnomalyThreshold = 0.68, выбранное по результатам этого прогона, а не как универсальная константа.
Инженерия признаков: что на самом деле означает "качество исполнения"
Полезность леса определяется качеством вектора признаков, для которого он рассчитывает оценку аномальности, поэтому выбору признаков стоит уделить больше внимания, чем обычно. В этой статье вектор признаков намеренно сделан небольшим — всего пять измерений: данные в журналах исполнения накапливаются медленнее, чем ценовые данные, а изолирующий лес, обученный на скользящем окне с небольшим числом наблюдений, лучше работает с небольшим числом тщательно подобранных признаков, чем с большим набором, размывающим сигнал.
1. Проскальзывание (пункты) — абсолютная разница между запрошенной ценой, зафиксированной непосредственно перед вызовом OrderSend, и ценой подтвержденной сделки.
2. Задержка исполнения (мс) — фактически прошедшее время от отправки запроса до торговой транзакции, подтверждающей сделку, измеренное с миллисекундным разрешением с помощью GetTickCount64(), а не TimeCurrent().
3. Спред в момент исполнения заявки (пункты) — текущая разница между ценами Bid и Ask в момент исполнения, поскольку проскальзывание при широком спреде имеет иной смысл, чем такое же проскальзывание при узком.
4. Отклонение объема (%) — разница между запрошенным и исполненным объемом в процентах, позволяющая выявлять частичное исполнение. В этой версии запрашиваемый объем берется из InpLots. Если объем позиции будет рассчитываться динамически, фиксируйте запрошенный объем в момент отправки запроса, а не считывайте его из статического входного параметра.
5. Флаг отказа в исполнении — всегда присутствует как пятый компонент вектора, но пока служит заглушкой с фиксированным значением: каждая строка, поступающая в OnTradeTransaction(), по определению соответствует подтвержденному исполнению заявки, поэтому в текущей реализации для этого столбца жестко задано значение 0.0. Этот признак намеренно сохранен в контракте признаков: структура массива, схема сохраняемого леса и заголовок CSV рассчитаны на пять столбцов. Благодаря этому последующее подключение реальных событий реквот и отказов в исполнении через TRADE_TRANSACTION_REQUEST и коды результатов потребует изменения всего одной строки, а не миграции схемы с нарушением совместимости. Ниже, в разделе об ограничениях, это указано явно, а не оставлено подразумеваемым.
Вектор признаков содержит ровно пять признаков. Контракт признаков, сохраненная модель и схема CSV рассчитаны именно на такую структуру. Расширение вектора требует одновременного увеличения значений ISO_FEATURE_COUNT и EXEC_FEATURE_COUNT и повторного обучения с нуля.
В ранней версии прошедшее время измерялось с помощью TimeCurrent() с разрешением лишь в одну секунду — это была настоящая ошибка, поскольку признак был обозначен как "ms", хотя содержал данные с секундным разрешением. GetTickCount64() устраняет эту проблему, предоставляя монотонный счетчик миллисекунд в пределах сеанса — именно этого достаточно для одного измерения времени от отправки запроса до исполнения заявки.
Соблюдение этого контракта признаков проверяется принудительно, а не просто предполагается. В OnInit() советник сверяет три независимых источника достоверных данных: заданную при компиляции директивой #define константу ISO_FEATURE_COUNT, собственную константу EXEC_FEATURE_COUNT из заголовочного файла модуля журналирования признаков и — если на диске есть сохраненный лес — число признаков, на которых этот лес фактически обучался. Любое расхождение между этими тремя источниками приводит к явному отказу инициализации с кодом INIT_FAILED, а не к незаметному переходу на резервный вариант:
//+------------------------------------------------------------------+
//| OnInit                                                           |
//+------------------------------------------------------------------+
int OnInit()
  {
//--- three-way feature contract check (compile-time vs. header vs. persisted forest)
   if(EXEC_FEATURE_COUNT != ISO_FEATURE_COUNT)
     {
      Print("FATAL: feature contract mismatch...");
      return(INIT_FAILED);
     }

   g_logger.Init(InpTrainingWindow, "IsoForestExecMonitor\\execution_log.csv");

   string forest_file = "IsoForestExecMonitor\\isoforest_model.bin";
   if(g_forest.LoadFromFile(forest_file))
     {
      if(g_forest.FeatureCount() != ISO_FEATURE_COUNT)
         {
          Print("FATAL: persisted forest feature count mismatch...");
          return(INIT_FAILED);
         }
     }
   // ... EMA handle setup, anomaly-history buffer sizing, INIT_SUCCEEDED ...
  }
Лес, обученный на четырех признаках, при расчете оценки аномальности для вектора из пяти признаков выдает правдоподобные, но бессмысленные числа, что хуже явного аварийного завершения. Поэтому вместо незаметного перехода на резервный вариант предусмотрен явный отказ.
Архитектура, реализованная непосредственно на MQL5: CIsoTree и CIsoForest
Реализация четко разделена на два класса. CIsoTree хранит одно рандомизированное дерево в виде плоского массива узлов, а не структуры с указателями — это упрощает сериализацию в файл с флагом FILE_COMMON и отладку, когда дерево изолирует точки не так, как ожидалось.
Нормировочная константа из формулы расчета оценки аномальности вычисляется отдельной небольшой функцией, которая используется как на уровне всего леса (в AnomalyScore() ниже), так и локально (для поправки на число точек в листе в PathLength()):
//+------------------------------------------------------------------+
//| IsoAvgPathLength - c(n), average path length of an unsuccessful  |
//| BST search                                                       |
//+------------------------------------------------------------------+
double IsoAvgPathLength(const int n)
  {
   if(n <= 1)
     return(0.0);
   if(n == 2)
     return(1.0);
   double h = MathLog(n - 1) + 0.5772156649015329; // Euler-Mascheroni constant
   return(2.0 * h - (2.0 * (n - 1) / n));
  }
Полный код построения дерева — случайный выбор признака, случайный порог, рекурсивное разбиение и все условия остановки:
//+------------------------------------------------------------------+
//| BuildRecursive - random feature/threshold selection and recursive|
//| split                                                            |
//+------------------------------------------------------------------+
int CIsoTree::BuildRecursive(double &data[][], int &idx[], int n, int depth, int feature_count)
  {
   int node_idx = AddNode();

   if(depth >= m_height_limit || n <= 1)
     {
      m_nodes[node_idx].is_external = true;
      m_nodes[node_idx].size        = n;
      return(node_idx);
     }

   int feat = (int)MathFloor(MathRand() / 32767.0 * feature_count);
   if(feat >= feature_count)
     feat = feature_count - 1;

   double vmin =  DBL_MAX;
   double vmax = -DBL_MAX;
   for(int i = 0; i < n; i++)
     {
      double v = data[idx[i]][feat];
      if(v < vmin) vmin = v;
      if(v > vmax) vmax = v;
     }

   if(vmin == vmax)
     {
      // no separation possible on this feature - treat as external
      m_nodes[node_idx].is_external = true;
      m_nodes[node_idx].size        = n;
      return(node_idx);
     }

   double split_value = vmin + (vmax - vmin) * (MathRand() / 32767.0);

   int left_idx[], right_idx[];
   ArrayResize(left_idx, n);
   ArrayResize(right_idx, n);
   int nl = 0, nr = 0;
   for(int i = 0; i < n; i++)
     {
      if(data[idx[i]][feat] < split_value)
         left_idx[nl++] = idx[i];
      else
         right_idx[nr++] = idx[i];
     }
   ArrayResize(left_idx, nl);
   ArrayResize(right_idx, nr);

   if(nl == 0 || nr == 0)
     {
      m_nodes[node_idx].is_external = true;
      m_nodes[node_idx].size        = n;
      return(node_idx);
     }

   m_nodes[node_idx].split_feature = feat;
   m_nodes[node_idx].split_value   = split_value;

   int left_node  = BuildRecursive(data, left_idx,  nl, depth + 1, feature_count);
   int right_node = BuildRecursive(data, right_idx, nr, depth + 1, feature_count);

   m_nodes[node_idx].left  = left_node;
   m_nodes[node_idx].right = right_node;

   return(node_idx);
  }
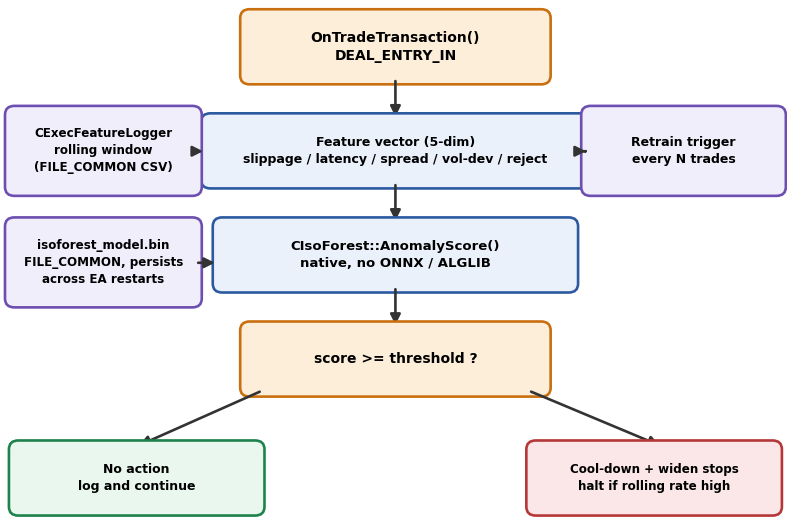
Рис. 1. Полный цикл обработки: от подтвержденного исполнения заявки через извлечение признаков и расчет оценки аномальности средствами MQL5 до действий механизма защитной остановки торговли.
Каждый узел в плоском массиве — либо внутренний узел, хранящий индекс признака разбиения и порог разбиения, либо внешний узел (лист). Рекурсивное построение прекращается досрочно, когда достигнуто ограничение глубины дерева (ceil(log2(subsample_size)), согласно рекомендации статьи), когда дальнейшее разбиение подмножества не имеет смысла или — в случае, подробно показанном ниже, — когда для подмножества выбран признак, значение которого одинаково у всех оставшихся точек, так что разбиение по нему невозможно.
Длина пути для оцениваемой точки определяется простым проходом по дереву, но здесь есть важная деталь, которую легко упустить: если проход заканчивается во внешнем узле (листе), содержащем более одной точки, поскольку ограничение глубины дерева было достигнуто до их полного разделения, глубина без поправки занижает степень "нормальности" этой точки. Решение заключается в том, чтобы к достигнутой глубине прибавить поправку c(size), соответствующую количеству оставшихся точек в данном листе.
//+------------------------------------------------------------------+
//| PathLength - root-to-leaf depth plus the c(size) leaf correction |
//+------------------------------------------------------------------+
double CIsoTree::PathLength(const double &x[]) const
  {
   int node  = 0;
   int depth = 0;
   while(true)
     {
      if(m_nodes[node].is_external)
         return(depth + IsoAvgPathLength(m_nodes[node].size));
      int feat = m_nodes[node].split_feature;
      node = (x[feat] < m_nodes[node].split_value) ? m_nodes[node].left : m_nodes[node].right;
      depth++;
     }
  }
CIsoForest хранит массив деревьев, выполняет формирование подвыборки без возвращения для каждого дерева (частичное перемешивание Фишера — Йетса обеспечивает сложность O(subsample_size) вместо O(n) на дерево), усредняет длины путей по всему ансамблю при расчете оценки аномальности и сериализует весь лес в FILE_COMMON. Благодаря этому обученный лес сохраняется после перезапуска советника и доступен любому процессу, читающему общую папку данных терминалов, включая агентов тестера стратегий. Важная оговорка: если параллельные агенты оптимизации одновременно записывают модель в файл с одним и тем же именем, возникает состояние гонки, поскольку MQL5 не предоставляет межпроцессной блокировки файлов. Задайте отдельное имя файла для каждого прохода оптимизации или отключите повторное обучение в тестере стратегий.
Формула расчета оценки аномальности в коде:
//+------------------------------------------------------------------+
//| AnomalyScore - s(x, n) = 2^(-E(h(x))/c(n))                       |
//+------------------------------------------------------------------+
double CIsoForest::AnomalyScore(const double &x[]) const
  {
   if(!m_trained || m_num_trees == 0)
     return(0.5); // no opinion yet - see "what happens when there is no model" below

   double total_path = 0.0;
   for(int t = 0; t < m_num_trees; t++)
     total_path += m_trees[t].PathLength(x);

   double avg_path = total_path / m_num_trees;
   double c_n      = IsoAvgPathLength(m_subsample_size);
   if(c_n <= 0.0)
     return(0.5);

   return(MathPow(2.0, -avg_path / c_n)); // s(x, n) = 2^(-E(h(x))/c(n))
  }
Для каждого дерева вызывается PathLength(), а средняя длина пути по всем деревьям нормализуется с помощью той же функции IsoAvgPathLength(), которая используется для поправки внутри листа. Это в точности формула из раздела об изолирующем лесе: никаких скрытых шагов между математикой и кодом нет.
По умолчанию используются 100 деревьев и размер подвыборки 256 — значения, близкие к тем, которые в исходной статье показали стабильные результаты на разных наборах данных. Однако раздел о валидации ниже показывает, что эти настройки нельзя без проверки переносить на небольшой журнал исполнений заявок.
Для повышения производительности лес сериализуется в плоский двоичный формат (FileWriteInteger/FileWriteDouble), а не в JSON или CSV. При нескольких сотнях узлов в каждом из 100 деревьев это десятки тысяч записей, и двоичный ввод-вывод позволяет при каждом перезапуске избежать затрат на разбор текста и преобразование чисел с плавающей запятой в текст и обратно. Недостаток в том, что без небольшого вспомогательного скрипта такой файл сложнее читать человеку.
Интеграция в советник: расчет оценки аномальности по событиям и механизм защитной остановки торговли
Расчет оценки аномальности выполняется исключительно внутри OnTradeTransaction() при обработке событий TRADE_TRANSACTION_DEAL_ADD с типом входа DEAL_ENTRY_IN. Опрос на каждом тике был бы расточительным и некорректным по смыслу, поскольку между исполнениями заявок оценивать нечего. Запрошенная цена и отметка времени фиксируются непосредственно перед вызовом trade.Buy()/trade.Sell(), поэтому проскальзывание и задержка исполнения рассчитываются относительно фактических параметров запроса.
При подтверждении исполнения заявки монитор последовательно выполняет пять действий:
1. Формирует вектор из пяти признаков на основе сделки и сохраненного контекста торгового запроса.
2. Помещает его в буфер скользящего окна CExecFeatureLogger и добавляет в CSV-журнал в общей папке данных терминалов с использованием флага FILE_COMMON.
3. Если лес уже обучен, рассчитывает оценку аномальности вектора и сравнивает ее с пороговым значением.
4. При обнаружении аномалии временно приостанавливает открытие новых позиций, при необходимости увеличивает расстояние до стоп-лоссов по открытым позициям и обновляет счетчик доли аномалий в скользящем окне.
5. Если эта доля в скользящем окне достигает дополнительного порога или превышает его, трактует это как смену режима качества исполнения и полностью останавливает торговлю, а не просто приостанавливает входы.
При единичном некачественном исполнении заявки — период приостановки входов, при устойчивой серии таких исполнений — полная остановка торговли. Одно аномальное исполнение заявки во время новостного всплеска нормально и не должно останавливать стратегию, но устойчивая серия обычно означает, что на стороне брокера или в канале связи что-то изменилось, и никакое управление рисками на уровне отдельных сделок этого не исправит. В такой ситуации правильно остановить торговлю и разобраться в причинах, а не бесконечно увеличивать расстояние до стоп-лоссов.
//+------------------------------------------------------------------+
//| HandleAnomaly                                                    |
//+------------------------------------------------------------------+
void HandleAnomaly(double score)
  {
   g_cooldown_bars_left = InpCooldownBars;
   Print("Execution-quality anomaly detected, score=", DoubleToString(score, 4),
         " - entries paused for ", InpCooldownBars, " bars.");

   if(InpWidenStopsOnAnom)
      WidenOpenStops();

   double rate = CurrentAnomalyRate();
   if(rate >= InpHaltAnomalyRate)
     {
      g_trading_halted = true;
      Print("Execution-quality regime break - trading halted.");
     }
  }
Повторное обучение и расчёт оценки аномальности выполняются средствами MQL5 на скользящем окне и не требуют внешних зависимостей. Точные условия запуска повторного обучения и полный код обучения приведены ниже в разделе "Детали реализации" и здесь не повторяются.
Краткий обзор входных параметров
Все входные параметры, упомянутые выше и ниже, собраны здесь в одном месте, поскольку их описания разбросаны по нескольким разделам:
| Входной параметр | По умолчанию | Цель |
|---|---|---|
| InpFastEMA / InpSlowEMA | 12 / 48 | Сигнал входа базовой стратегии по пересечению EMA |
| InpLots | 0,10 | Фиксированный объем в лотах; также используется как исходный "запрошенный объем" |
| InpStopLossPts / InpTakeProfitPts | 400 / 800 | Расстояния до стоп-лосса и тейк-профита в базовой стратегии |
| InpTrainingWindow | 500 | Число исполнений заявок в скользящем окне, необходимое для первого обучения и используемое при каждом повторном обучении |
| InpRetrainEveryTrades | 100 | Число исполнений заявок между повторными обучениями после создания модели |
| InpNumTrees | 100 | Количество деревьев в лесу |
| InpSubsampleSize | 256 | Количество строк, отбираемых для каждого дерева (не больше числа доступных строк) |
| InpAnomalyThreshold | 0,68 | Порог оценки аномальности, откалиброванный в автономном режиме (см. раздел "Валидация") |
| InpCooldownBars | 10 | Длительность приостановки входов после обнаружения аномалии, в барах |
| InpHaltAnomalyRate | 0,35 | Доля аномалий в скользящем окне, при достижении которой торговля полностью останавливается |
| InpHaltLookbackTrades | 30 | Окно, по которому рассчитывается доля аномалий для полной остановки торговли |
| InpWidenStopsOnAnom / InpWidenStopMultiplier | true / 1.5 | Следует ли увеличивать расстояние до стоп-лоссов открытых позиций при обнаружении аномалии и во сколько раз |
| InpLogTimings | false | Выводить в журнал фактическое время расчета оценки аномальности и повторного обучения в миллисекундах |
Граничные случаи и подводные камни
В процессе разработки я столкнулся с несколькими проблемами, о которых стоит упомянуть, а не просто пройти мимо.
Холодный запуск. Лес не может рассчитывать оценки аномальности, пока не накопится достаточно истории для обучения: невозможно обнаружить аномалию относительно нормы, которая еще не установлена. Советник не вмешивается в торговлю и только ведет журнал, пока число накопленных исполнений заявок не достигнет значения InpTrainingWindow. Не уменьшайте это окно, чтобы раньше запустить расчет оценки аномальности: лес, обученный на 40 исполнениях заявок, переобучится на этом шуме и будет помечать как аномалии то, что через неделю окажется совершенно нормальным.
Постоянные признаки останавливают построение дерева, но не работу леса. В начале тестирования на демо-счете с фиксированным спредом и без реквот признак "спред в момент исполнения заявки" имел одинаковое значение во всем обучающем окне. При построении отдельных деревьев для этого признака постоянно срабатывало условие "vmin == vmax", и дальнейшее построение соответствующей ветви прекращалось, что совершенно правильно. Просто при первом появлении в журнале дерева с необычно малым числом узлов это выглядело тревожно. Лес в целом по-прежнему работал нормально, поскольку значения остальных четырех признаков оставались достаточно разнообразными для разбиений.
Размер подвыборки превышает объем имеющихся данных. Если значение InpSubsampleSize превышает фактический размер скользящего окна, при обучении оно ограничивается значением n_rows, а не вызывает ошибку, но при этом без уведомления меняется и фактическое ограничение глубины дерева, поскольку оно вычисляется на основе размера подвыборки. Стоит записывать в журнал фактический размер подвыборки, использованный при повторном обучении, а не предполагать, что был использован заданный размер.
GetTickCount64() отсчитывает время относительно начала сеанса, а не возвращает календарное время. После исправления расчета задержки этот признак действительно выражается в миллисекундах, однако для его измерения используется счетчик, который сбрасывается при перезапуске терминала и показания которого бессмысленно сравнивать между разными сеансами или компьютерами. Для этой задачи это допустимо: отправка запроса и исполнение всегда происходят в рамках одного сеанса работы терминала. Но если вы будете экспортировать значения задержки для сравнения с журналом другого советника или с данными сеанса у другого брокера, помните: это не напрямую сопоставимые временные отметки, а лишь длительности, измеренные в рамках соответствующего сеанса.
Частота аномалий меняется с волатильностью рынка, а не только с качеством исполнения. В периоды действительно высокой волатильности спреды расширяются, а проскальзывание усиливается для всех — это не обязательно проблема исполнения, просто рынок ведет себя так, как ему свойственно. Здесь помогает регулярное повторное обучение на скользящем окне, поскольку базовый уровень адаптируется. Однако если вы торгуете во время запланированных публикаций важных новостей, ожидайте временного роста числа выявленных аномалий, не связанного с проблемами у брокера. Разумным усовершенствованием, выходящим за рамки показанной реализации, было бы не учитывать заранее известные периоды выхода новостей в логике остановки торговли, продолжая при этом записывать события этих периодов в журнал.
Вычислительные затраты на повторное обучение — с той же оговоркой, что и выше. Построение леса из 100 деревьев на окне из 500 строк выполняется внутри OnTradeTransaction() сразу после расчета оценки аномальности — включите InpLogTimings, прежде чем существенно увеличивать число деревьев или размер окна обучения относительно значений по умолчанию.
Валидация: синтетические аномалии и честное обсуждение компромиссов при настройке
Поскольку для утверждения "это исполнение заявки было аномальным" в журнале реальной торговли нет готовой эталонной разметки, валидацию приходится начинать с синтетических данных. Вспомогательный скрипт на Python берет журнал реальных исполнений из CSV-файла советника, внедряет искусственные всплески проскальзывания и задержки с заданной долей аномалий в выборке и эталонной разметкой, а затем проверяет, выявляют ли эти внедренные наблюдения как расчет оценки аномальности, реализованный средствами MQL5, так и эталонная реализация IsolationForest из scikit-learn.
Структура CSV. Метод CExecFeatureLogger::LogToCsv() записывает строку заголовка, а затем по одной строке на каждое подтвержденное исполнение, строго в следующем порядке столбцов:
time,slippage_pts,latency_ms,spread_pts,volume_dev_pct,reject_flag,anomaly_score,is_anomaly
2026.03.11 09:14:02,3.20,142.0,18.00,0.000,0,0.4821,0
2026.03.11 09:19:47,2.80,138.0,18.00,0.000,0,0.4695,0
2026.03.11 10:02:15,41.60,2380.0,54.00,0.000,0,0.8112,1
Последняя строка показывает, как выглядит настоящая аномалия в этой структуре данных: резкие одновременные скачки проскальзывания и задержки, сопровождающиеся расширением спреда, дают оценку аномальности значительно выше откалиброванного порога.
Точная схема внедрения синтетических аномалий. Функция inject_synthetic_anomalies() во вспомогательном скрипте использует numpy.random.default_rng(seed=42) для обеспечения воспроизводимости результатов. При заданной доле аномалий в выборке (5% в запуске, по результатам которого построены рис. 3 и 4) функция равновероятно и без возвращения выбирает ceil(len(df) * contamination) индексов строк, а затем изменяет ровно два из пяти столбцов в этих строках: значение slippage_pts увеличивается на случайную величину, равномерно распределенную в диапазоне [15, 40] пунктов, а значение latency_ms — на случайную величину, равномерно распределенную в диапазоне [800, 2500] мс. Спред, отклонение объема и флаг отказа в исполнении в строках с внедренными аномалиями остаются неизменными: синтетическая аномалия представляет собой именно резкий скачок проскальзывания и задержки, характерный для провала ликвидности или приостановки обработки на стороне брокера. Столбец ground_truth_anomaly (1 для строк с внедренными аномалиями, 0 для остальных) служит эталонной разметкой для расчета точности, полноты и F1-меры:
def inject_synthetic_anomalies(df, contamination=0.05, seed=42):
    """Injects synthetic slippage/latency spikes with a ground-truth label,
    used only for precision/recall validation - never for training the
    native runtime model."""
    rng = np.random.default_rng(seed)
    df = df.copy()
    df["ground_truth_anomaly"] = 0

    n_inject = max(1, int(len(df) * contamination))
    inject_idx = rng.choice(df.index, size=n_inject, replace=False)

    df.loc[inject_idx, "slippage_pts"] += rng.uniform(15, 40, size=n_inject)
    df.loc[inject_idx, "latency_ms"] += rng.uniform(800, 2500, size=n_inject)
    df.loc[inject_idx, "ground_truth_anomaly"] = 1

    return df
Параметры эталонной модели. Для перекрестной проверки в scikit-learn используется sklearn.ensemble.IsolationForest(n_estimators=n_trees, max_samples=subsample_size, contamination=contamination, random_state=42). Результат model.score_samples() умножается на −1, чтобы, как и в реализации на MQL5, более высокая оценка означала большую аномальность, а выражение model.predict() == -1 дает бинарный результат: является ли наблюдение аномальным. F1-мера вычисляется как sklearn.metrics.f1_score(ground_truth, predictions) — это стандартное гармоническое среднее точности и полноты, рассчитанное непосредственно по меткам искусственно внедренных аномалий, без сглаживания или корректировок:
def reference_isolation_forest(df, n_estimators, max_samples, contamination):
    """scikit-learn reference model, used only to sanity-check the native
    MQL5 scoring math - not used for any live trading decision."""
    model = IsolationForest(
        n_estimators=n_estimators,
        max_samples=max_samples,
        contamination=contamination,
        random_state=42,
    )
    model.fit(df[FEATURE_COLS])
    scores = -model.score_samples(df[FEATURE_COLS])
    preds = (model.predict(df[FEATURE_COLS]) == -1).astype(int)
    return scores, preds
Как сравниваются оценки аномальности в варианте, реализованном непосредственно на MQL5, и в sklearn. Это проверка на отсутствие явных ошибок, а не утверждение о численной эквивалентности: в двух реализациях по определению получаются разные случайные разбиения, поэтому точное совпадение оценок для каждого наблюдения никогда не было целью. Проверяется согласованность ранжирования: попадают ли в обеих реализациях одни и те же строки в группу с наивысшими оценками, доля которой равна заданной доле аномалий в выборке, и сходна ли структура распределения оценок (одновершинный кластер нормальных наблюдений и отделенный от него хвост аномалий). Устойчивые расхождения в ранжировании между двумя реализациями указывали бы на ошибку в варианте на MQL5. Прогоны, по которым построен рис. 3, показали ожидаемую согласованность, поэтому на графике приведено распределение оценок именно этой реализации, а не sklearn.
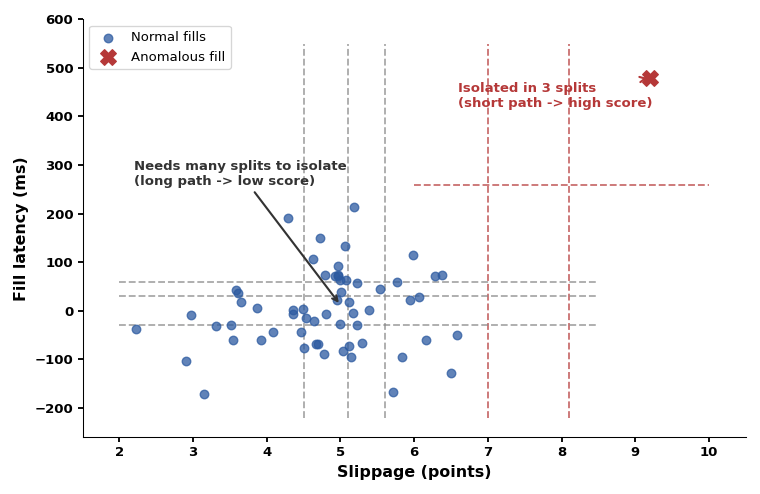
Рис. 2. Действительно аномальное исполнение заявки находится далеко от кластера нормальных наблюдений и изолируется за очень небольшое число случайных разбиений. Для отделения друг от друга плотно сгруппированных нормальных исполнений заявок требуется гораздо больше разбиений.
При проверке на реальном журнале из 900 исполнений заявок с демо-счета, в 5% записей которого искусственно внесли аномалии, распределение оценок оказалось достаточно чётким, чтобы обосновать выбор порогового значения в диапазоне 0,65–0,70. На результатах калибровки основано значение 0,68, установленное по умолчанию и упомянутое ранее.
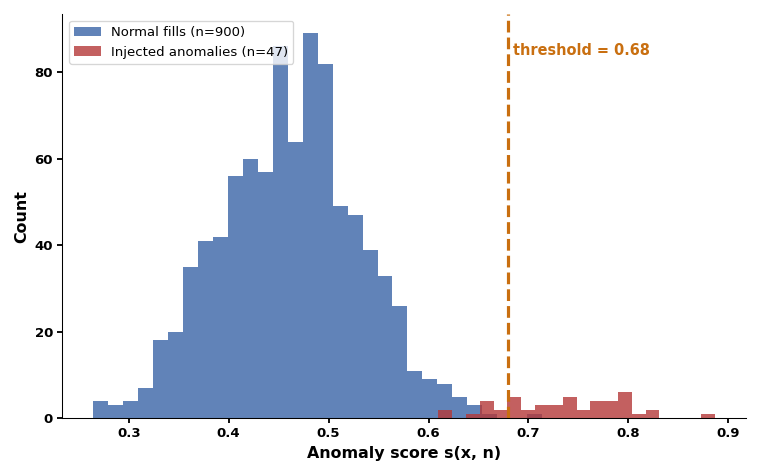
Рис. 3. Распределение оценок аномальности для нормальных исполнений заявок и исполнений с искусственно внедренными аномалиями с отмеченным откалиброванным порогом.
Стоит прямо оговорить момент, который в подобной статье легко обойти вниманием: качество работы изолирующего леса на столь небольшом наборе данных заметно зависит от числа деревьев и размера подвыборки, причем эта зависимость не сводится к желаемому простому правилу "чем больше, тем лучше". Перебор четырех значений числа деревьев и четырех размеров подвыборки при анализе чувствительности с использованием одной и той же эталонной разметки искусственно внедренных аномалий дает скорее плато с пологим пиком, чем монотонный рост.
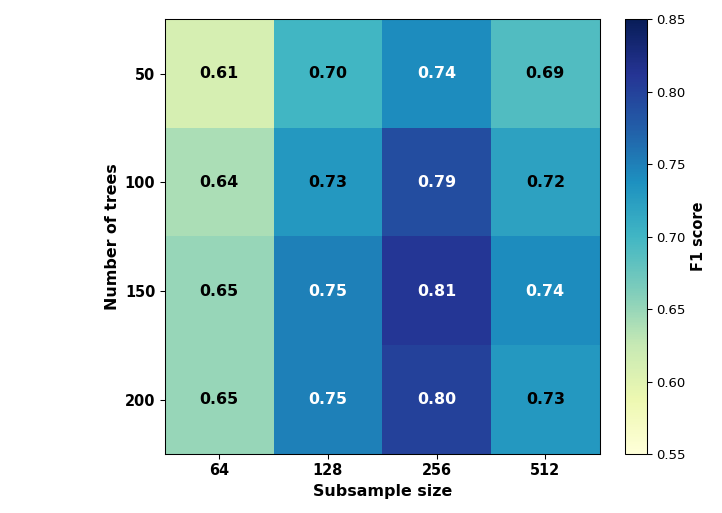
Рис. 4. F1-мера, рассчитанная по эталонной разметке искусственно внедренных аномалий, в зависимости от числа деревьев и размера подвыборки. Пик достигается примерно при 150 деревьях и размере подвыборки 256. Дальнейшее увеличение подвыборки на этом наборе данных даже немного снижает качество обнаружения.
Вывод не в том, чтобы принять "150 деревьев и 256 наблюдений в подвыборке" за универсальное правило, а в том, что перебор по этой сетке параметров нужно повторить на собственном журнале исполнений заявок, а не полагаться на готовые настройки, особенно если при вашей обычной частоте торговли скользящее окно оказывается меньше или больше используемого здесь по умолчанию окна из 500 исполнений заявок. Когда размер подвыборки приближается к размеру всего обучающего окна, разнообразие деревьев в лесу становится недостаточным для эффективного усреднения их результатов. Это реальная, проверяемая причина ухудшения работы, а не теоретическое опасение.
Детали реализации
Этот раздел восполняет конкретный пробел: выше описывалось поведение системы, но читателю, который хочет воспроизвести реализацию на практике, нужны конкретные форматы и правила принятия решений, а не только их словесное описание.
Формат узла дерева. Каждый узел представляет собой структуру фиксированного размера и хранится в плоском массиве с заранее выделенной памятью, а не в связной структуре на указателях:
//+------------------------------------------------------------------+
//| IsoNode - single node of an isolation tree                       |
//+------------------------------------------------------------------+
struct IsoNode
  {
   int        left;        // index of left child, -1 if none
   int        right;        // index of right child, -1 if none
   int        split_feature; // feature index used for the split
   double   split_value;   // threshold value
   int        size;        // points reaching this node (external nodes only)
   bool      is_external;  // true = leaf/external node
  };
Массивы и типы MQL5. CIsoTree заранее выделяет память под массив узлов блоками по ISO_MAX_NODES_PER_TREE (4096) элементов, увеличивая массив с помощью ArrayResize() только тогда, когда дереву требуется больше места. Индексы дочерних узлов типа int вместо ссылок на объекты делают сериализацию дерева предельно простой: не нужно переходить по указателям, достаточно последовательно записать записи фиксированного размера.
Как хранится набор данных. CExecFeatureLogger содержит двумерный массив фиксированного размера (double m_buffer[][EXEC_FEATURE_COUNT]), который используется в качестве циклического буфера. Одна из тонкостей MQL5: для локального двумерного массива необходимо явно указать размер каждого измерения, начиная со второго (double data[][EXEC_FEATURE_COUNT];). Запись с пустыми квадратными скобками, допустимая для параметра, передаваемого по ссылке, здесь приводит к ошибке компиляции "invalid index value" ("недопустимое значение индекса").
Ниже приведен полный код класса. Он находится в одном из трех основных файлов, и от него зависит работа скользящего окна:
//+------------------------------------------------------------------+
//| CExecFeatureLogger - rolling execution-quality feature buffer    |
//+------------------------------------------------------------------+
class CExecFeatureLogger
  {
private:
   double           m_buffer[][EXEC_FEATURE_COUNT];
   int           m_capacity;
   int           m_count;
   int           m_write_pos;
   string       m_csv_filename;

public:
              CExecFeatureLogger(void);
   void           Init(int capacity, string csv_filename);
   void           Push(const double &features[]);
   int            Count(void) const { return(m_count); }
   bool          GetMatrix(double &out[][]) const;
   void           LogToCsv(const double &features[], const double anomaly_score, const bool is_anomaly);
  };

void CExecFeatureLogger::Init(int capacity, string csv_filename)
  {
   m_capacity      = capacity;
   m_csv_filename = csv_filename;
   ArrayResize(m_buffer, m_capacity);
   m_count     = 0;
   m_write_pos = 0;
  }

void CExecFeatureLogger::Push(const double &features[])
  {
   for(int f = 0; f < EXEC_FEATURE_COUNT; f++)
     m_buffer[m_write_pos][f] = features[f];

   m_write_pos = (m_write_pos + 1) % m_capacity;
   if(m_count < m_capacity)
     m_count++;
  }

bool CExecFeatureLogger::GetMatrix(double &out[][]) const
  {
   if(m_count < 1)
     return(false);

   ArrayResize(out, m_count);
   int start = (m_write_pos - m_count + m_capacity) % m_capacity;
   for(int i = 0; i < m_count; i++)
     {
      int src = (start + i) % m_capacity;
      for(int f = 0; f < EXEC_FEATURE_COUNT; f++)
         out[i][f] = m_buffer[src][f];
     }
   return(true);
  }

void CExecFeatureLogger::LogToCsv(const double &features[], const double anomaly_score, const bool is_anomaly)
  {
   bool exists = FileIsExist(m_csv_filename, FILE_COMMON);
   int handle = FileOpen(m_csv_filename, FILE_READ | FILE_WRITE | FILE_CSV | FILE_COMMON, ',');
   if(handle == INVALID_HANDLE)
     {
      Print("CExecFeatureLogger::LogToCsv - failed to open ", m_csv_filename, " err=", GetLastError());
      return;
     }

   FileSeek(handle, 0, SEEK_END);

   if(!exists)
     FileWrite(handle, "time", "slippage_pts", "latency_ms", "spread_pts", "volume_dev_pct", "reject_flag", "anomaly_score", "is_anomaly");

   FileWrite(handle,
                TimeToString(TimeCurrent(), TIME_DATE | TIME_SECONDS),
                DoubleToString(features[0], 2), DoubleToString(features[1], 1), DoubleToString(features[2], 2),
                DoubleToString(features[3], 3), DoubleToString(features[4], 0),
                DoubleToString(anomaly_score, 4), is_anomaly ? "1" : "0");

   FileClose(handle);
  }
GetMatrix() по запросу восстанавливает из циклического буфера плотную матрицу, упорядоченную хронологически, поэтому скользящее окно действительно "скользит": самые старые записи об исполнениях заявок автоматически исключаются, а не накапливаются в постоянно растущем журнале, целиком хранящемся в памяти.
Как рассчитывается глубина дерева. Ограничение глубины дерева равно ceil(log2(subsample_size)). Это значение вычисляется один раз при каждом вызове Train() и передается в метод Build() каждого дерева. Это соответствует обоснованию из оригинальной статьи: поскольку ожидаемая глубина полностью случайного бинарного дерева для n точек составляет примерно log2(n), любая точка, которая остается неизолированной за пределами этой глубины, по своему поведению считается "достаточно нормальной", и дальнейшие разбиения мало помогают отличать аномалии от нормальных наблюдений. Ограничение глубины на этом уровне позволяет сохранять небольшую среднюю глубину деревьев, быстро строить их и выполнять запросы к ним.
Как обрабатываются постоянные признаки. Полная реализация показана выше в BuildRecursive(): одна и та же проверка vmin == vmax применяется независимо от того, какие признаки постоянны в данном подмножестве и сколько их. Алгоритм построения дерева не предусматривает особой обработки какого-либо конкретного индекса признака.
Как рассчитывается пороговое значение. Здесь порог не выводится из математических формул в замкнутом виде: InpAnomalyThreshold — обычный входной параметр, с которым советник сравнивает текущую оценку аномальности. Значение по умолчанию 0,68 не вычисляется советником во время работы: оно было заранее выбрано по результатам анализа распределения оценок аномальности на одном журнале исполнений, проведенного скриптом валидации на Python, а затем зафиксировано в коде как значение по умолчанию в поставляемой версии. Автоматическая калибровка порога внутри советника (например, его динамическая настройка по процентилю оценок аномальности в скользящем окне) здесь не реализована — см. раздел "Что не охватывает данная реализация" ниже.
Когда повторное обучение разрешено или запрещено. Для запуска обучения в MaybeRetrainForest() необходимо одновременное выполнение двух условий: уже зарегистрировано не менее InpTrainingWindow исполнений заявок (чтобы повторное обучение никогда не запускалось на недостаточной выборке), и либо лес еще ни разу не обучался, либо с момента последнего повторного обучения поступило не менее InpRetrainEveryTrades новых исполнений заявок. Явного запрета на повторное обучение при открытой позиции или во время остановки торговли нет: оно зависит только от зарегистрированных данных и не затрагивает открытые позиции, поэтому его безопасно запускать независимо от того, остановлена ли торговля советника или действует период приостановки входов. Более того, это необходимо, чтобы базовая модель нормальных условий могла восстановиться после нормализации ситуации.
До сих пор процесс обучения описывался только словами — ниже приведен его полный код вместе с вызывающим кодом советника, который определяет, когда запускать обучение:
//+------------------------------------------------------------------+
//| Train                                                            |
//+------------------------------------------------------------------+
bool CIsoForest::Train(double &data[][], int n_rows, int feature_count, int num_trees, int subsample_size)
  {
   if(n_rows < 4 || feature_count < 1 || num_trees < 1)
     {
      Print("CIsoForest::Train - insufficient data: n_rows=", n_rows, " feature_count=", feature_count);
      return(false);
     }

   m_feature_count  = feature_count;
   m_num_trees      = num_trees;
   m_subsample_size = MathMin(subsample_size, n_rows); // effective subsample size, clamped to available rows

   int height_limit = (int)MathCeil(MathLog(m_subsample_size) / MathLog(2.0));

   ArrayResize(m_trees, m_num_trees);

   for(int t = 0; t < m_num_trees; t++)
     {
      //--- random subsample without replacement (partial Fisher-Yates)
      int pool[];
      ArrayResize(pool, n_rows);
      for(int i = 0; i < n_rows; i++)
         pool[i] = i;

      int sample_idx[];
      ArrayResize(sample_idx, m_subsample_size);
      int pool_size = n_rows;
      for(int i = 0; i < m_subsample_size; i++)
         {
         int r = (int)MathFloor(MathRand() / 32767.0 * pool_size);
         if(r >= pool_size) r = pool_size - 1;
         sample_idx[i] = pool[r];
         pool[r] = pool[pool_size - 1];
         pool_size--;
       }

      m_trees[t].Build(data, sample_idx, m_subsample_size, feature_count, height_limit);
     }

   m_trained = true; // only ever set here, on a completed pass over every tree
   return(true);
  }
//+------------------------------------------------------------------+
//| MaybeRetrainForest                                               |
//+------------------------------------------------------------------+
void MaybeRetrainForest(void)
  {
   if(g_trades_since_retrain < InpRetrainEveryTrades && g_forest.IsTrained())
     return;
   if(g_logger.Count() < InpTrainingWindow)
     return; // not enough rolling history yet

   double data[][EXEC_FEATURE_COUNT];
   if(!g_logger.GetMatrix(data))
     return;

   ulong t0 = GetTickCount64();
   bool  ok = g_forest.Train(data, ArrayRange(data, 0), ISO_FEATURE_COUNT, InpNumTrees, InpSubsampleSize);
   ulong elapsed_ms = GetTickCount64() - t0;

   if(ok)
     {
      g_trades_since_retrain = 0;
      Print("IsoForest: retrained natively on ", ArrayRange(data, 0), " executions",
           " (effective subsample=", MathMin(InpSubsampleSize, ArrayRange(data, 0)), ").");
      if(InpLogTimings)
        Print("IsoForest: Train() took ", elapsed_ms, " ms for ", InpNumTrees, " trees.");
     }
  }
GetMatrix() преобразует циклический буфер обратно в плотную упорядоченную матрицу, которую использует Train(); фактический размер подвыборки равен MathMin(InpSubsampleSize, n_rows) как внутри Train(), так и в строке журнала, сообщающей об этом размере, поэтому эти значения не могут незаметно разойтись; а переменная m_trained получает значение true ровно в одном месте — в последней строке полностью выполненного вызова Train(), после построения всех деревьев.
Что происходит, когда модели нет? До первого успешного вызова Train() метод IsTrained() возвращает false, AnomalyScore() ни разу не вызывается, а каждое исполнение заявки записывается в журнал с временными значениями anomaly_score = 0.5 и is_anomaly = false. Это действительно состояние "оценки пока нет": в этот период советник работает исключительно в режиме наблюдения, что соответствует описанной выше проблеме холодного старта.
Как синхронизируются контекст торгового запроса и событие исполнения заявки. Функция RecordPendingRequest() выполняется синхронно непосредственно перед вызовом trade.Buy()/trade.Sell(), сохраняя цену и текущее значение GetTickCount64() в двух глобальных переменных, значения которых функция OnTradeTransaction() считывает при поступлении подтверждающей сделки. Это безопасно для используемой здесь базовой стратегии с одной позицией, но заведомо небезопасно для стратегии, отправляющей несколько заявок одновременно: второй запрос перезапишет контекст первого до подтверждения исполнения первой заявки (см. раздел об ограничениях ниже).
Две функции из исходного кода приведены целиком и без изменений: вместе они показывают большую часть того, что читателю нужно проследить от начала до конца, — полный процесс расчета оценки аномальности исполнения заявки и полный цикл сохранения и восстановления модели.
//+------------------------------------------------------------------+
//| OnTradeTransaction                                               |
//+------------------------------------------------------------------+
void OnTradeTransaction(const MqlTradeTransaction &trans,
                            const MqlTradeRequest &request,
                            const MqlTradeResult &result)
  {
   if(trans.type != TRADE_TRANSACTION_DEAL_ADD)
     return;
   if(!HistoryDealSelect(trans.deal))
     return;
   if(HistoryDealGetInteger(trans.deal, DEAL_ENTRY) != DEAL_ENTRY_IN)
     return; // only score opening fills - that's where execution quality matters here

   double fill_price  = HistoryDealGetDouble(trans.deal, DEAL_PRICE);
   double point         = SymbolInfoDouble(_Symbol, SYMBOL_POINT);
   double slippage_pts = (g_pending_request_price > 0.0)
                 ? MathAbs(fill_price - g_pending_request_price) / point
                 : 0.0;

   double latency_ms   = (g_pending_request_ticks > 0)
                 ? (double)(GetTickCount64() - g_pending_request_ticks)
                 : 0.0;

   double spread_pts    = (double)SymbolInfoInteger(_Symbol, SYMBOL_SPREAD);
   double filled_vol     = HistoryDealGetDouble(trans.deal, DEAL_VOLUME); // actual filled size, NOT the requested size
   double volume_dev_pct = (InpLots > 0.0) ? MathAbs(filled_vol - InpLots) / InpLots * 100.0 : 0.0; // InpLots stands in for "requested size" - see note below
   double reject_flag    = 0.0; // this deal filled; rejections/requotes are a separate event stream

   double features[EXEC_FEATURE_COUNT];
   features[0] = slippage_pts;
   features[1] = latency_ms;
   features[2] = spread_pts;
   features[3] = volume_dev_pct;
   features[4] = reject_flag;

   g_logger.Push(features);

   double anomaly_score = 0.5;
   bool   is_anomaly    = false;
   if(g_forest.IsTrained())
     {
      ulong t0 = GetTickCount64();
      anomaly_score = g_forest.AnomalyScore(features);
      is_anomaly    = (anomaly_score >= InpAnomalyThreshold);
      if(InpLogTimings)
        Print("IsoForest: AnomalyScore() took ", (GetTickCount64() - t0), " ms");
     }

   g_logger.LogToCsv(features, anomaly_score, is_anomaly);
   RecordAnomalyOutcome(is_anomaly);

   if(is_anomaly)
     HandleAnomaly(anomaly_score);

   g_trades_since_retrain++;
   MaybeRetrainForest();
  }
//+------------------------------------------------------------------+
//| SaveToFile / LoadFromFile                                        |
//+------------------------------------------------------------------+
bool CIsoForest::SaveToFile(const string filename)
  {
   int handle = FileOpen(filename, FILE_WRITE | FILE_BIN | FILE_COMMON);
   if(handle == INVALID_HANDLE)
     {
      Print("CIsoForest::SaveToFile - failed to open ", filename, " err=", GetLastError());
      return(false);
     }

   FileWriteInteger(handle, m_num_trees);
   FileWriteInteger(handle, m_subsample_size);
   FileWriteInteger(handle, m_feature_count);
   for(int t = 0; t < m_num_trees; t++)
     m_trees[t].Save(handle);

   FileClose(handle);
   return(true);
  }

bool CIsoForest::LoadFromFile(const string filename)
  {
   if(!FileIsExist(filename, FILE_COMMON))
     return(false);

   int handle = FileOpen(filename, FILE_READ | FILE_BIN | FILE_COMMON);
   if(handle == INVALID_HANDLE)
     return(false);

   m_num_trees      = FileReadInteger(handle);
   m_subsample_size = FileReadInteger(handle);
   m_feature_count  = FileReadInteger(handle);

   ArrayResize(m_trees, m_num_trees);
   for(int t = 0; t < m_num_trees; t++)
     m_trees[t].Load(handle);

   FileClose(handle);
   m_trained = true;
   return(true);
  }
Функции сохранения и загрузки в точности зеркальны: одинаковый порядок полей, одинаковые типы, построчное соответствие вызовов чтения и записи. Именно это позволяет безопасно сохранять и восстанавливать модель в плоском двоичном формате без отдельной метки версии, помимо трех целых чисел в заголовке, уже используемых для проверки контракта признаков.
Как запустить и воспроизвести это
1. Скопируйте три файла исходного кода в локальную папку MQL5: файл советника — по пути Experts\IsoForestExecMonitor\IsoForestExecMonitor.mq5, а оба файла .mqh — в папку Include\IsoForestExecMonitor\. Скомпилируйте советник в MetaEditor — оба подключаемых файла будут автоматически подключены по путям, указанным в исходном коде.
2. Прикрепите советник к графику XAUUSD M5 (или выберите свой инструмент и таймфрейм — логика не привязана к золоту) с входными параметрами по умолчанию: либо на демо-счете, либо в тестере стратегий в режиме "Все тики" или "Каждый тик на основе реальных тиков", чтобы функция OnTradeTransaction() вызывалась в реалистичных условиях.
3. Дайте советнику торговать, пока число накопленных исполнений заявок не достигнет значения InpTrainingWindow (по умолчанию — 500). До тех пор в журнале будет продолжать появляться сообщение "no persisted model found", а каждая строка журнала исполнений будет содержать временное значение оценки аномальности 0,5 — это ожидаемое поведение, а не ошибка.
4. Убедитесь, что файл execution_log.csv существует в подпапке IsoForestExecMonitor общей папки данных терминалов (путь можно найти в MetaTrader через меню "Файл" — "Открыть каталог данных". Папка Common расположена на одном уровне с папкой конкретного терминала). Откройте его и убедитесь, что строки накапливаются в соответствии со схемой, приведённой выше.
5. Когда окно обучения заполнится, дождитесь в журнале сообщения "retrained natively on N executions" и убедитесь, что рядом с CSV-файлом в той же общей папке появился файл isoforest_model.bin.
6. Продолжайте торговлю после повторного обучения и следите за появлением сообщения "Execution-quality anomaly detected, score=...". На демо-счете со стабильными условиями такие сообщения могут быть редкими в силу принципа работы алгоритма, что само по себе дает полезную информацию об условиях исполнения ваших заявок.
7. Экспортируйте CSV-файл и передайте его скрипту iso_forest_crossvalidation.py (поместите файл в рабочий каталог и выполните python iso_forest_crossvalidation.py, предварительно установив зависимости командой pip install pandas numpy scikit-learn). Убедитесь, что скрипт создает файл tuning_sensitivity_report.csv и выводит таблицу чувствительности в консоль.
8. Включите входной параметр InpLogTimings и ненадолго повторите шаг 6, чтобы увидеть в журнале фактическое время расчета оценки аномальности и повторного обучения в миллисекундах на вашем оборудовании, а не принимать на веру приведенные в статье доводы о вычислительной сложности.
Что не охватывает данная реализация
Явное указание ограничений укрепляет доверие к реализованному решению, не создавая впечатления, что оно универсальнее, чем есть на самом деле.
Конфликты контекстов торговых запросов при работе с несколькими инструментами или советниками. Глобальные переменные g_pending_request_price/g_pending_request_ticks хранят только по одному значению. Для работы этой логики с несколькими инструментами или несколькими одновременно работающими экземплярами советника с общим состоянием потребуется таблица контекстов торговых запросов с ключом по идентификатору запроса или инструменту, а не две глобальные переменные.
Параллельные или перекрывающиеся во времени запросы. У базовой стратегии в каждый момент времени может быть не более одной позиции и одного запроса, ожидающего завершения обработки. В более активной стратегии, отправляющей несколько ордеров одновременно, контекст торгового запроса незаметно перезаписывался бы при отправке очередного запроса — для безопасной работы в таком сценарии нужна структура, в которой ключом служит тикет запроса.
Частичное исполнение несколькими сделками. Признак "отклонение объема" отражает результат сравнения объема одной подтверждающей сделки с запрошенным объемом в лотах. Частичные исполнения одного запроса, зарегистрированные в нескольких отдельных событиях сделки, здесь не объединяются в одно логическое исполнение.
Асинхронная обработка ордеров. Методы trade.Buy() и trade.Sell() используются синхронно. В советнике, использующем CTrade::SetAsyncMode(true), сохранение контекста торгового запроса нужно перенести на момент сразу после подтверждения принятия запроса при асинхронной отправке, а не до него.
Особенности отказов в исполнении и реквот у конкретного брокера. Выше описан флаг отказа в исполнении, пока используемый как заглушка: реальные коды отказов в исполнении и реквот зависят от брокера, а в этой версии они не разбираются и не учитываются в векторе признаков.
Управление версиями модели или обратная совместимость. Сохраняемый двоичный формат не содержит отдельной метки версии: в заголовке есть лишь три целочисленных значения, используемых для проверки числа признаков на соответствие контракту признаков. Если в будущем формат изменится, этот загрузчик не сможет его прочитать: такая совместимость не предусмотрена.
Подавление срабатываний по календарю новостей. Проблема всплесков аномалий из-за повышенной волатильности во время выхода новостей упомянута, но не решена: интеграции с календарем, которая ограничивала бы срабатывания механизма остановки торговли в заранее известные периоды выхода важных новостей, нет.
Автоматическая калибровка порога. InpAnomalyThreshold — статический входной параметр, значение которого задается заранее по результатам валидации на Python. В советнике нет логики динамической перекалибровки этого порога на основе распределения оценок аномальности в скользящем окне.
Тестирование в тестере стратегий
Базовая стратегия намеренно проста — обычное пересечение быстрой и медленной EMA на XAUUSD, M5, — поскольку цель статьи — показать работу системы мониторинга, а не поиск торгового преимущества. Сравнение кривых средств при включенном и отключенном защитном механизме позволяет выделить вклад системы мониторинга, не смешивая его с качеством самой стратегии.
| настройка | Значение |
|---|---|
| Символ / таймфрейм | XAUUSD / M5 |
| Быстрая / медленная EMA | 12 / 48 |
| Окно обучения / периодичность повторного обучения | 500 исполнений заявок / каждые 100 исполнений заявок |
| Число деревьев / размер подвыборки | 100 / 256 |
| Порог аномальности | 0,68 |
| Условие остановки торговли | Доля аномалий 35% за последние 30 сделок |
Фактические результаты обоих прогонов. Два прогона в тестере стратегий с полностью одинаковыми условиями — XAUUSD M5, режим "Каждый тик на основе реальных тиков", один и тот же диапазон дат, охватывающий 28 098 баров и 36 520 722 тика, качество истории 100% — различались лишь одним входным параметром:
| Показатель | Механизм защитной остановки торговли включен (порог = 0,68) | Механизм защитной остановки торговли выключен (порог = 2,0) |
|---|---|---|
| Общее количество сделок | 695 | 695 |
| Общая чистая прибыль | -292,40 | -292,40 |
| Коэффициент прибыльности | 0,98 | 0,98 |
| Матожидание выигрыша | -0,42 | -0,42 |
| Максимальная просадка баланса | 1960,50 (19,60%) | 1960,50 (19,60%) |
| Максимальная просадка средств | 1975,90 (19,74%) | 1975,90 (19,74%) |
| Выявленные аномалии (журнал) | 0 | 0 |
| Срабатывания приостановки входов / полной остановки торговли | 0/0 | 0/0 |
Оба прогона совпадают до цента, и это достоверный результат, а не ошибка. Журнал исполнений за тот же период объясняет причину — она наглядно видна на рисунке ниже.
Так на уровне системы проявляется проблема "постоянные признаки останавливают построение дерева": модель исполнения заявок в тестере не воспроизводит реалистичную изменчивость проскальзывания, задержки исполнения и частичного исполнения, поэтому при прогонах только в тестере механизму защитной остановки торговли практически нечего обнаруживать. Это содержательный вывод об ограничениях данного метода валидации, а не повод сомневаться в логике детектора, которая уже успешно прошла проверку в описанных выше тестах с внедрением синтетических аномалий. Для содержательной проверки влияния механизма защитной остановки торговли на прибыль и убытки нужны данные реального или демо-счета с подлинной изменчивостью параметров исполнения либо непосредственная подача данных, сформированных по схеме внедрения аномалий из Python-скрипта, на расчет оценки аномальности.
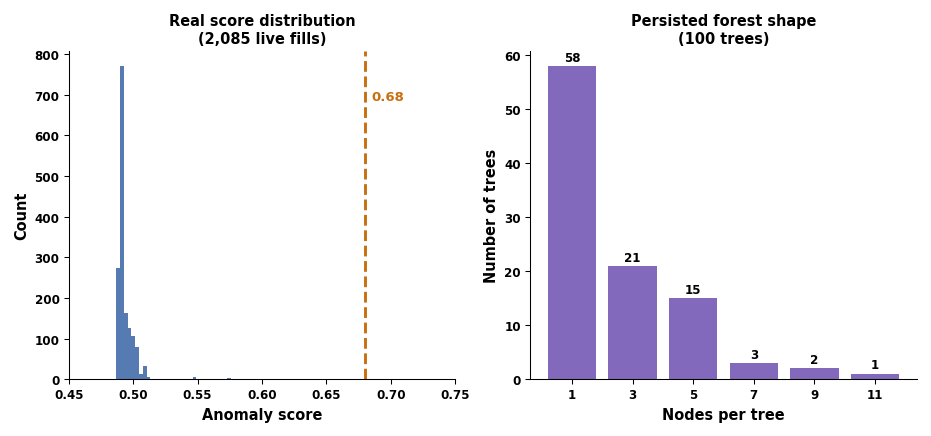
Рис. 5. Фактические данные двух приведенных выше прогонов в тестере. Слева: распределение оценок аномальности для всех 1 585 исполнений заявок, для которых были рассчитаны оценки (500 исполнений заявок на этапе холодного старта до первого повторного обучения исключены, поскольку им присвоено лишь условное значение 0,5), — все фактически рассчитанные оценки значительно ниже порога 0,68. Справа: фактическая структура сохраненного леса, полученная из файла модели, — 58 из 100 деревьев состоят из единственного узла, что напрямую связано с описанной выше проблемой постоянных признаков.
Оценивайте работу защиты в реальных условиях по максимальной просадке в периоды низкой ликвидности, а не просто по доходности: именно от просадки защищает этот слой, и совпадающие до цента результаты тестера не означают, что механизм защитной остановки торговли бездействует. Это означает, что в данном периоде не было тех ухудшений условий исполнения, для выявления которых предназначен этот механизм. Проверка на демо-счете или реальном счете с подлинной изменчивостью параметров исполнения на стороне брокера принципиально отличается от тестирования на "чистых" исторических тиках.
Что на самом деле показали проверка и тестирование:
1. Реализация алгоритма на MQL5 корректно работает на всех этапах: проверка контракта признаков, обучение, сохранение и восстановление модели, а также расчёт оценки аномальности выполняются в соответствии с замыслом. Корректность работы подтверждена перекрёстной проверкой на синтетических данных с помощью Python и практическими испытаниями в тестере стратегий.
2. Тестирование с внедрением синтетических аномалий подтверждает качество ранжирования, обеспечиваемое самой математикой расчета оценки аномальности: аномальные наблюдения действительно отделяются от нормальных исполнений заявок в распределении оценок. Ранжирование по оценкам реализации на MQL5 достаточно хорошо согласуется с ранжированием эталонной модели sklearn, чтобы доверять реализации.
3. Модель исполнения по умолчанию в тестере стратегий плохо воспроизводит реальные аномалии качества исполнения: она не создает той изменчивости проскальзывания, задержки исполнения и объема исполнения заявки, которая возникает в реальной инфраструктуре брокера в стрессовых условиях, поэтому сравнение прибыли и убытков только в тестере по самой своей постановке близко к проверке, в которой эффект практически не может проявиться.
4. Фактическое влияние защитного механизма на торговые результаты, а не только корректность расчета оценки аномальности, еще предстоит измерить на потоке исполнений с демо-счета или реального счета с подлинной изменчивостью параметров либо на синтетическом потоке данных с намеренно внесенными возмущениями, прежде чем делать выводы о положительном или отрицательном влиянии на прибыль и убытки.
Заключение
Каждый трейдер знает, что качество исполнения важно, но почти никто не внедряет средства его измерения и контроля. Большинство систем настраивают по ценовым данным и результатам тестирования на истории, а исполнения заявок, обеспечивающие эти сделки, почти не отслеживают, поэтому снижение ликвидности у брокера или ухудшение соединения с VPS обычно становится заметным лишь после того, как ущерб уже отразился на кривой средств. Если рассматривать качество каждого исполнения заявки как самостоятельный сигнал, который стоит регистрировать и на который следует реагировать в реальном времени, эту слепую зону можно устранить.
Эта статья демонстрирует, что ансамбль рандомизированных деревьев, расчет оценки аномальности по длине пути и обработчик событий потока торговых транзакций могут быть реализованы средствами MQL5, без ONNX, ALGLIB или внешних процессов. Одна и та же архитектура проверена на всех этапах — от контракта признаков до сохранения и восстановления модели и расчета оценки аномальности в реальном времени — как при синтетической проверке, так и в приведенных выше реальных запусках тестера стратегий. Однако статья пока не демонстрирует измеримого улучшения финансового результата по вполне объективной причине: модель исполнения тестера стратегий не создала условий, для выявления которых предназначен механизм защитной остановки торговли.
Для тех, кто адаптирует это решение, следующий практический шаг — запуск на демо-счете или реальном счете в условиях реальной изменчивости исполнения у брокера. При этом следует отслеживать те же два аспекта, что и в статье: четко ли отделяются оценки аномальности от базового уровня нормальных исполнений заявок и действительно ли периоды приостановки входов и полной остановки торговли совпадают с периодами, которые можно независимо выявить по собственным журналам исполнения. Порог и периодичность повторного обучения следует подбирать по данным собственного журнала исполнения, а не считать константами, скопированными из статьи. Отсутствие сообщений в журнале стоит воспринимать как вполне допустимый результат, а не как неспособность что-либо обнаружить.
| Файл | Тип | Описание |
|---|---|---|
| IsoForestExecMonitor.mq5 | Советник | Базовая стратегия на пересечении EMA с подключенными монитором качества исполнения на основе изолирующего леса, реализованным непосредственно на MQL5, и механизмом защитной остановки торговли. |
| IsoForest.mqh | Подключаемый файл | Классы CIsoTree и CIsoForest — построение рандомизированных деревьев, расчет оценки аномальности по длине пути, а также сохранение и восстановление модели через FILE_COMMON, реализованные на MQL5. |
| ExecFeatureLogger.mqh | Подключаемый файл | Класс CExecFeatureLogger — буфер признаков исполнения со скользящим окном и экспорт в CSV для последующего автономного анализа. |
| iso_forest_crossvalidation.py | Скрипт на Python | Вспомогательный инструмент только для автономной работы: внедрение синтетических аномалий, проверка математической корректности расчета оценки аномальности, реализованного непосредственно на MQL5, путем сравнения с scikit-learn и исследование чувствительности к настройкам путем перебора их значений. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/24251
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


