

Каналы линейной регрессии на MQL5: Построение статистически обоснованных доверительных и прогнозных полос
 55
 1

Введение
Полосы Боллинджера и каналы Дончиана — наиболее широко используемые канальные индикаторы в алгоритмической и дискреционной торговле. Оба метода просты в расчёте, интуитивно понятны и доступны практически на любой платформе для построения графиков. Кроме того, оба инструмента служат скорее для описания данных, чем для статистического вывода. Они обобщают фактическое поведение цен без опоры на явно заданную статистическую модель, из которой можно было бы вывести формальные утверждения о вероятности покрытия. Понимание этого различия — не просто теоретическое упражнение: от него напрямую зависит, как следует интерпретировать выходы цены за границы канала, моделировать ширину канала и разрабатывать системы определения размера позиции, опирающиеся на границы канала.
Канал Дончиана фиксирует наибольший максимум и наименьший минимум цены в окне ретроспективного анализа. Его ширина полностью определяется фактически наблюдавшимися экстремальными ценами. Он ничего не говорит об ожидаемом будущем распределении цен относительно какого-либо тренда. Полосы Боллинджера располагаются выше и ниже простой скользящей средней на расстоянии, равном выборочному стандартному отклонению, умноженному на фиксированный коэффициент. Множитель стандартного отклонения, который почти всегда задают равным 2,0, — это произвольно принятое правило масштабирования, а не параметр, выведенный из вероятностной модели. Полученная огибающая не дает формальной гарантии вероятности покрытия: нельзя в статистически строгом смысле утверждать, что она будет содержать 95% будущих цен закрытия, поскольку соответствующий вывод не был выполнен.
Для статистического вывода необходимы генеративная модель, оценка параметров и вероятностное распределение ошибки оценки. В этой статье рассматривается именно такая структура, построенная с помощью метода наименьших квадратов, применённого к скользящему окну цен закрытия. В результате получаются две полосы, для которых свойства вероятности покрытия формально определены в рамках модели: доверительный интервал для среднего отклика на линии регрессии и прогнозный интервал для отдельного наблюдения. Оба интервала рассчитываются с использованием критических значений t-распределения Стьюдента с соответствующим числом степеней свободы, а не фиксированного множителя. Обратите внимание: «формально определены в рамках модели» не означает «эмпирически гарантированы на ценовых данных». Номинальная вероятность покрытия 95% обеспечивается только при выполнении предпосылок МНК, а для финансовых цен эти предпосылки регулярно нарушаются. И каналы регрессии, и полосы Боллинджера требуют эмпирической калибровки, прежде чем можно будет доверять каким-либо утверждениям о вероятности покрытия. Каналы регрессии лучше обоснованы теоретически, поскольку их ширина выводится из явно заданной модели, а не определяется эвристическим множителем.
Раздел 1: Теоретические основы
Метод наименьших квадратов (МНК) на скользящем окне
Для заданных n цен закрытия y₁, y₂, …, yₙ, наблюдаемых при целочисленных индексах баров x₁, x₂, …, xₙ, МНК позволяет оценить линейную модель:
ŷ = β₀ + β₁ · x
путём минимизации суммы квадратов остатков (SSE):
SSE = Σᵢ (yᵢ − β₀ − β₁ · xᵢ)²
Оценки в замкнутой форме имеют следующий вид:
β₁ = [n·Σ(xᵢ·yᵢ) − Σxᵢ·Σyᵢ] / [n·Σxᵢ² − (Σxᵢ)²]
β₀ = ȳ − β₁·x̄
где x̄ и ȳ — выборочные средние индексов баров и цен закрытия соответственно.
Обозначения переменных МНК
| Обозначение | Значение |
|---|---|
| x | Индекс бара в окне регрессии |
| y | Цена закрытия |
| β₀ | Свободный член — значение линии регрессии при x = 0 |
| β₁ | Коэффициент наклона — изменение цены на единицу индекса бара |
| SSE | Сумма квадратов остатков |
| σ² | Дисперсия остатков (оцененная по SSE) |
| n | Размер окна (число баров в регрессии) |
| x̄ | Среднее значение индексов баров |
| ȳ | Среднее значение цен закрытия |
| Sxx | Σ(xᵢ − x̄)² — характеристика разброса значений x |
Дисперсия остатков и число степеней свободы
После оценки β₀ и β₁ остаток для каждого наблюдения равен:
eᵢ = yᵢ − (β₀ + β₁·xᵢ)
Несмещенная оценка дисперсии остатков равна:
s² = SSE / (n − 2)
Знаменатель равен n − 2, а не n, поскольку на основе данных были оценены два параметра: коэффициент наклона и свободный член. На оценивание каждого параметра расходуется одна степень свободы. Деление на n − 2 позволяет устранить это искажение и получить несмещенную оценку истинной дисперсии ошибки σ².
Справочные сведения о числе степеней свободы
| Параметр | Значение |
|---|---|
| Размер выборки | n |
| Оцениваемые параметры | 2 (β₀ и β₁) |
| Число степеней свободы остатков | n − 2 |
Для окна длиной 50 баров число степеней свободы регрессии равно 48. Число степеней свободы напрямую определяет ширину t-распределения, используемого при последующих расчётах интервалов.
Доверительные интервалы для среднего отклика
Доверительный интервал в точке x в пределах окна регрессии количественно характеризует неопределённость оценки среднего отклика — ожидаемого значения y при данном x с учётом оценённых параметров. Формула такова:
ŷ(x) ± t(α/2, n−2) · s · √[ 1/n + (x − x̄)² / Sxx ]
где:
- t(α/2, n−2) — критическое значение t-распределения Стьюдента с числом степеней свободы n−2 при уровне значимости α (например, 0,05 для вероятности покрытия 95%)
- s = √s² — стандартная ошибка регрессии
- Sxx = Σ(xᵢ − x̄)²
Выражение под квадратным корнем состоит из двух слагаемых. Член 1/n отражает общую неопределённость оценки, то есть неопределённость относительно того, где в среднем проходит линия регрессии по всему окну. Член (x − x̄)²/Sxx отражает рычаг наблюдения: насколько точка оценки x удалена от центра области значений x. Точки, удалённые от x̄, оказывают большее влияние на оценку коэффициента наклона, и, следовательно, с ними связана большая неопределённость.
Это означает, что полосы доверительного интервала наиболее узки в точке x̄ (в центре окна регрессии) и расширяются к обоим краям. Это детерминированное геометрическое свойство, а не следствие разреженности данных на границах окна.
Прогнозные интервалы для отдельных наблюдений
Прогнозный интервал отвечает на другой вопрос: при заданной оценённой линии регрессии какой диапазон отдельных значений y правдоподобен в точке x? В формуле под квадратным корнем добавляется 1 для учёта неустранимого шума на уровне отдельных наблюдений:
ŷ(x) ± t(α/2, n−2) · s · √[ 1 + 1/n + (x − x̄)² / Sxx ]
Эта дополнительная единица отражает дисперсию нового независимого наблюдения, порождённого процессом. Даже если бы параметры регрессии были известны точно, так что слагаемое 1/n и слагаемое, связанное с рычагом наблюдения, исчезли бы, разброс будущего наблюдения вокруг прямой всё равно имел бы дисперсию s². Таким образом, прогнозные интервалы всегда строго шире доверительных интервалов в каждой точке окна.
Интервал на краю выборки и прогноз на один шаг вперед
Точное указание точки, в которой рассчитывается интервал, так же важно, как и сама формула. Если барам в окне присвоены индексы x = 0, 1, …, n−1, то имеет смысл рассматривать две различные точки расчёта.
Расчёт в точке x = n−1, соответствующей последнему наблюдаемому бару внутри окна, даёт интервал на краю выборки: условную полосу разброса вокруг оценённой линии регрессии в точке последнего наблюдения, использованного для её построения. Именно этот интервал естественно отображать на правом краю канала, отслеживающего текущую цену.
Расчёт в точке x = n, на один бар за пределами окна, даёт собственно прогнозный интервал на один шаг вперед для следующего, ещё не наблюдавшегося бара. Соответствующее расчётное значение и полуширина:
ŷ(n) = β̂₀ + β̂₁·n
ŷ(n) ± t(α/2, n−2) · s · √[ 1 + 1/n + (n − x̄)² / Sxx ]
Эти два интервала не являются взаимозаменяемыми. Интервал на краю выборки описывает разброс в точке, которую модель уже видела; интервал для прогноза на один шаг вперед описывает разброс в точке, которую она еще не видела. Прилагаемый индикатор реализует оба варианта и позволяет выбрать нужный с помощью входного параметра, поэтому отображаемую полосу можно корректно обозначить как полосу на краю выборки или как прогнозную полосу. Даже интервал для прогноза на один шаг вперед по-прежнему строится по данным выборки, поскольку на каждом баре регрессия оценивается заново с использованием данных по этот бар включительно. Для строгой оценки качества прогнозов необходима описанная ниже проверка частоты покрытия вне выборки.
Сравнение типов каналов
| Канал | Основа расчета ширины | Статистическая основа |
|---|---|---|
| Канал Дончиана | Исторические экстремумы | Отсутствует — подход описательный |
| Полосы Боллинджера | Фиксированный множитель × стандартное отклонение | Эвристика |
| Доверительный интервал | Неопределенность оценки среднего отклика (МНК) | t-распределение Стьюдента, число степеней свободы n−2 |
| Прогнозный интервал | Неопределенность отдельного наблюдения (МНК) | t-распределение Стьюдента, число степеней свободы n−2 |
Почему необходимо использовать t-распределение Стьюдента
Использование z-значений (критических значений нормального распределения) вместо t-значений асимптотически корректно, но приводит к систематической недооценке ширины интервалов при малых и умеренных объемах выборки. При 48 степенях свободы 97,5-й процентиль t-распределения составляет приблизительно 2,0106, тогда как для стандартного нормального распределения он равен 1,9600. Разница невелика, но быстро увеличивается по мере уменьшения n. При n = 10 баров (число степеней свободы — 8) критическое значение t-распределения Стьюдента составляет примерно 2,306, что дает интервал на 17,7 % шире, чем при z-аппроксимации.
При n → ∞ t-распределение сходится к стандартному нормальному распределению. Для используемых на практике окон скользящей регрессии длиной от 30 до 200 баров поправка на t-распределение Стьюдента численно существенна и должна применяться явно.
Объяснение расширения полос через рычаг наблюдения
Величина:
hᵢ = 1/n + (xᵢ − x̄)² / Sxx
— это диагональный элемент проекционной матрицы (рычаг наблюдения) для наблюдения i. Она показывает, насколько i-е наблюдение влияет на собственное расчетное значение. Рычаг наблюдения достигает максимума в крайних точках области значений x и минимума при x = x̄.
При вычислении интервалов на крайнем левом или крайнем правом баре окна регрессии точка вычисления находится на максимально возможном в пределах выборки расстоянии от x̄, что максимизирует соответствующее слагаемое в выражении для рычага наблюдения и расширяет полосу. С геометрической точки зрения линия регрессии наименее ограничена данными на краях диапазона, по которому она оценена. Небольшое изменение оцененного коэффициента наклона вызывает наибольшее вертикальное смещение именно на краях, поэтому линия может поворачиваться вокруг центроида, по-прежнему хорошо описывая центральное скопление наблюдений. (Если же интервал вычисляется при x = n, то есть на один бар за пределами окна, это уже настоящая экстраполяция, и соответствующее слагаемое в выражении для рычага наблюдения увеличивается еще больше.)
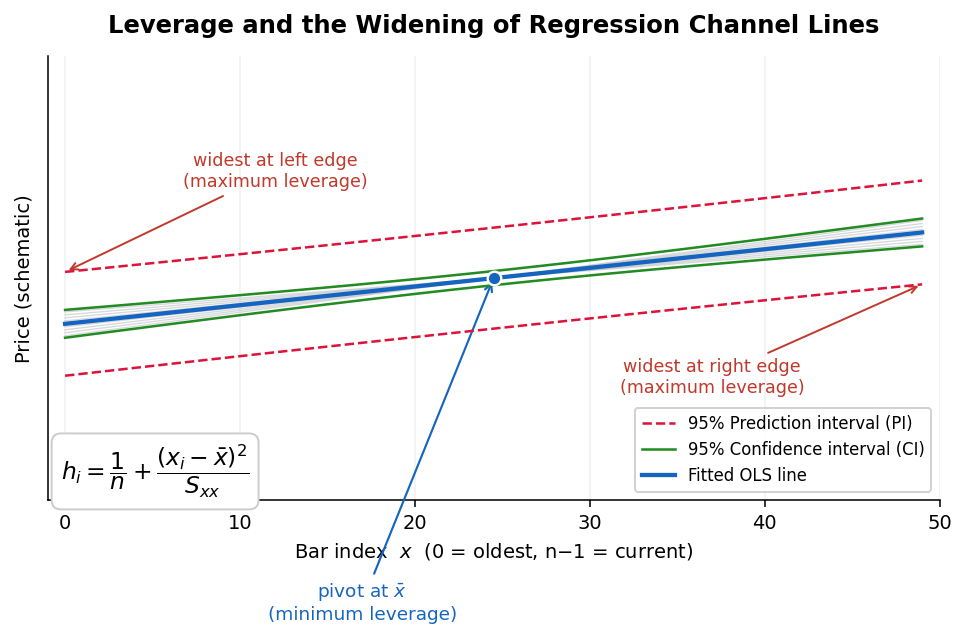
Геометрическое объяснение рычага наблюдения в каналах регрессии по МНК с отображением в виде тех же пяти линий, которые использует индикатор. Линия регрессии (сплошная синяя) поворачивается вокруг точки, соответствующей среднему значению x̄ в окне, где неопределенность коэффициента наклона вызывает наименьшее смещение, а граничные линии расположены ближе всего друг к другу. По мере приближения к любому краю окна слагаемое (xᵢ − x̄)²/Sxx в выражении для рычага наблюдения растет квадратично, поэтому границы доверительной полосы (сплошные зеленые линии) и более широкой прогнозной полосы (пунктирные малиновые линии) симметрично расходятся веером. Это расширение является закономерным математическим следствием геометрии проекционной матрицы, а не снижения плотности данных на границах.
Это свойство отличает каналы регрессии от полос Боллинджера, ширина которых одинакова по всему окну, поскольку в них используется стандартное отклонение по всему окну без поправки на зависящий от положения рычаг наблюдения.
Допущения метода наименьших квадратов и их нарушение на финансовых рынках
Метод наименьших квадратов основан на четырёх основных допущениях. Финансовые временные ряды регулярно нарушают большинство из них.
- Независимость остатков: МНК предполагает, что eᵢ и eⱼ не коррелируют при i ≠ j. Доходности часто демонстрируют автокорреляцию на коротких интервалах (эффекты микроструктуры) и на более длительных горизонтах (моментум и возврат к среднему). При условии, что регрессоры остаются экзогенными, а ошибки имеют нулевое условное среднее, автокорреляция сама по себе не приводит к смещению МНК-оценки коэффициента наклона; однако она делает некорректными стандартные ошибки, используемые для построения интервалов, поэтому рассчитанная вероятность покрытия отличается от номинальной вероятности покрытия 95%. В динамических моделях финансовых рядов сама эта экзогенность является нетривиальным допущением, а не данностью.
- Гомоскедастичность: МНК предполагает, что var(eᵢ) = σ² постоянно для всех наблюдений. Финансовые доходности демонстрируют кластеризацию волатильности: в периоды высокой волатильности остатки велики по модулю, а в периоды низкой волатильности — малы. Единая оценка s², полученная по окну регрессии, усредняет значения по этим режимам, занижая ширину интервала в периоды высокой волатильности и завышая её в спокойные периоды.
- Нормальность остатков: нормальность не требуется ни для получения несмещённых оценок коэффициентов по МНК, ни для выполнения теоремы Гаусса — Маркова, согласно которой МНК-оценка является наилучшей линейной несмещённой оценкой: это свойство относится к коэффициентам, а не к интервалам. Нормальность необходима для того, чтобы точный t-интервал в конечной выборке сохранял номинальную вероятность покрытия. Распределения доходностей финансовых активов имеют более тяжёлые хвосты, чем нормальное распределение, поэтому номинальная 95%-я вероятность покрытия прогнозного интервала на практике может соответствовать фактическому уровню покрытия ниже 95%. При экстремальных движениях значения выходят за пределы интервала чаще, чем предсказывает модель. Следует также отметить, что даже несмещённые оценки коэффициентов и корректная точечная оценка не гарантируют сохранения вероятности покрытия обычного t-интервала в условиях гетероскедастичности (непостоянства дисперсии ошибок) или автокорреляции.
- Стационарность тренда: МНК оценивает детерминированный линейный тренд в пределах окна. Если реальный процесс формирования данных включает структурные разрывы, смену режимов или стохастические тренды (случайные блуждания), условное среднее в регрессии будет задано неверно, а остатки поглотят компоненты тренда, что приведёт к завышению s² и искусственному расширению интервалов.
Эти нарушения не лишают каналы регрессии практической ценности. Однако они означают, что обозначение «95%» следует рассматривать как приближение, полученное на основе модели, а не как гарантированную эмпирическую частоту покрытия.
Вычислительная сложность метода скользящей регрессии
При наивной реализации все пять сумм регрессии (Σx, Σy, Σx², Σxy, Σy²) пересчитываются заново для каждого бара, что приводит к затратам времени O(n) на каждый бар и O(N·n) в целом для всего ценового ряда длиной N с окном размером n.
При инкрементальной реализации поддерживаются обновляемые суммы: на каждом новом баре к ним добавляется новое наблюдение, а самое старое исключается из расчёта. Это снижает вычислительные затраты на один бар до O(1), а общую сложность — до O(N), независимо от размера окна.
| Метод | Сложность на один бар | Общая сложность |
|---|---|---|
| Полный перерасчет | O(n) | O(N·n) |
| Инкрементальное обновление статистик | O(1) | O(N) |
Для наглядности изложения в реализации, описанной в данной статье, используется полный пересчёт в рамках каждого прохода по окну. Представленную здесь архитектуру можно дополнить инкрементальной оптимизацией без изменения статистической логики.
Раздел 2: Архитектура программного обеспечения
Реализация распределена между пятью заголовочными файлами и одним основным файлом индикатора. Такая структура отделяет статистические вычисления от механизмов работы индикатора и позволяет независимо тестировать каждый модуль.
OLSStatistics.mqh        — Slope, intercept, SSE computation
ResidualAnalysis.mqh     — Residual variance, degrees of freedom
TDistribution.mqh        — Student's t critical value lookup
ConfidenceInterval.mqh   — Mean uncertainty band calculation
PredictionInterval.mqh   — Individual observation band calculation
RegressionChannels.mq5   — Main indicator: buffers, line plots, diagnostics
Примечание о стиле программирования: все исходные файлы оформлены в соответствии с соглашениями Стандартной библиотеки MetaQuotes. Функции-члены объявляются с явным указанием (void) для пустых списков параметров, конструкторы и деструкторы объявляются явно, в операторах return используются выражения в скобках, а расположение фигурных скобок соответствует принятой в библиотеке схеме с отступами в два пробела. Благодаря этому код сразу узнаваем для опытных разработчиков MQL5 и согласуется с подключаемыми файлами самой платформы.
Раздел 3: Практическое замечание об отображении: почему индикатор рисует линии, а не полосы с заливкой
Прежде чем представить модули, следует пояснить одно проектное решение, поскольку оно определяет структуру основного файла индикатора. При визуализации вложенных каналов естественно закрасить прогнозный интервал одним цветом, а доверительный интервал — другим, используя тип графического построения DRAW_FILLING. На практике механизм отрисовки DRAW_FILLING в MetaTrader 5 надежно работает только с одной закрашенной областью, ограниченной двумя линиями. Он не всегда корректно отображает две закрашенные области, которые перекрываются или имеют общую границу, а именно такую геометрию имеет доверительный интервал, вложенный в прогнозный интервал.
Проблему усугубляют два взаимосвязанных ограничения. Во-первых, тип color в MQL5 представляет собой трёхбайтовое значение BGR без альфа-канала, поэтому цвета DRAW_FILLING всегда полностью непрозрачны; сделать внутреннюю заливку полупрозрачной, чтобы сквозь неё была видна внешняя заливка, невозможно. При попытке закодировать альфа-байт в шестнадцатеричном цветовом литерале значение без предупреждения усекается и интерпретируется как непрозрачный цвет BGR. Во-вторых, когда границы двух закрашенных областей в точности совпадают (например, верхняя граница доверительного интервала совпадает с нижней границей верхней прогнозной зоны), механизм отрисовки рассматривает этот участок как непрерывный, и заливка, отрисованная позже, не всегда корректно перекрывает предыдущую.
Надежное решение — отображать канал с помощью пяти отдельных графических построений DRAW_LINE: линии регрессии и четырёх границ интервалов. Линейные графические построения корректно отображаются во всех сборках MetaTrader 5, вложенность каналов хорошо различима благодаря цвету и стилю линий, а используемые буферы статистических величин остаются теми же, что и в версии с заливкой. В оставшейся части статьи описывается эта реализация с отображением в виде линий.
Раздел 4: Реализации модулей с пояснениями
OLSStatistics.mqh — Оценка параметров регрессии
//+------------------------------------------------------------------+
//|                                                OLSStatistics.mqh |
//| Ordinary Least Squares parameter estimation for rolling windows. |
//+------------------------------------------------------------------+
#ifndef __OLS_STATISTICS_MQH__
#define __OLS_STATISTICS_MQH__

//+------------------------------------------------------------------+
//| Structure: SOLSResult                                            |
//| Holds all regression outputs from a single OLS pass.             |
//+------------------------------------------------------------------+
struct SOLSResult
  {
   double            slope;          // Estimated slope β₁
   double            intercept;      // Estimated intercept β₀
   double            sse;            // Sum of squared errors
   double            x_mean;         // Mean of bar indices x̄
   double            sxx;            // Σ(xᵢ − x̄)²
   int               n;              // Number of observations used
   bool              valid;          // False if computation failed
  };

//+------------------------------------------------------------------+
//| Class: COLSStatistics                                            |
//| Fits an OLS regression line to a price array over the fixed      |
//| integer grid x = 0,1,..,count-1.                                 |
//+------------------------------------------------------------------+
class COLSStatistics
  {
public:
                     COLSStatistics(void);
                    ~COLSStatistics(void);

   //--- x_mean and sxx are precomputed by the caller because, for a
   //--- fixed window over the grid 0..count-1, they are constants:
   //---   x_mean = (count-1)/2,  sxx = count(count^2-1)/12.
   SOLSResult        Compute(const double &y[], int count,
                             double x_mean, double sxx);
  };

//+------------------------------------------------------------------+
//| Constructor                                                      |
//+------------------------------------------------------------------+
COLSStatistics::COLSStatistics(void)
  {
  }

//+------------------------------------------------------------------+
//| Destructor                                                       |
//+------------------------------------------------------------------+
COLSStatistics::~COLSStatistics(void)
  {
  }

//+------------------------------------------------------------------+
//| COLSStatistics::Compute                                          |
//| Accepts a price array, its length, and the precomputed x-domain  |
//| constants x_mean and sxx. Only the y-dependent sums are computed |
//| here, in a single pass. Returns a populated SOLSResult.          |
//+------------------------------------------------------------------+
SOLSResult COLSStatistics::Compute(const double &y[], int count,
                                   double x_mean, double sxx)
  {
   SOLSResult result;
   result.valid = false;

   if(count < 3)
      return(result);

   if(MathAbs(sxx) < 1e-14)
      return(result);

//--- Accumulate only the y-dependent sums. The x-only sums are not
//--- needed because x_mean and sxx are supplied by the caller.
   double sum_y  = 0.0;
   double sum_xy = 0.0;
   double sum_yy = 0.0;

   for(int i = 0; i < count; i++)
     {
      double xi = (double)i;
      double yi = y[i];

      if(!MathIsValidNumber(yi))
         return(result);

      sum_y  += yi;
      sum_xy += xi * yi;
      sum_yy += yi * yi;
     }

   double n      = (double)count;
   double y_mean = sum_y / n;

//--- Sxy = Σ(xᵢ − x̄)(yᵢ − ȳ) = Σxᵢyᵢ − n·x̄·ȳ
   double sxy = sum_xy - n * x_mean * y_mean;

//--- OLS slope and intercept
   double slope     = sxy / sxx;
   double intercept = y_mean - slope * x_mean;

//--- SSE = Syy − β₁·Sxy, where Syy = Σyᵢ² − n·ȳ²
   double syy = sum_yy - n * y_mean * y_mean;
   double sse = syy - slope * sxy;

   if(sse < 0.0)
      sse = 0.0;

   result.slope     = slope;
   result.intercept = intercept;
   result.sse       = sse;
   result.x_mean    = x_mean;
   result.sxx       = sxx;
   result.n         = count;
   result.valid     = true;

   return(result);
  }

#endif
//+------------------------------------------------------------------+
Структура SOLSResult объединяет все величины, необходимые последующим модулям: оценки коэффициента наклона и свободного члена для вычисления ŷ, сумму квадратов остатков (SSE) для вычисления дисперсии остатков, x̄ и Sxx для вычисления рычага наблюдения, а также n для определения числа степеней свободы. Объединение этих величин позволяет избежать их повторного вычисления на разных этапах конвейера.
Метод COLSStatistics::Compute принимает массив цен закрытия, его длину и две константы, определяемые значениями x: x̄ и Sxx. Эти константы передаются в функцию, а не вычисляются заново, поскольку для фиксированного окна на целочисленной сетке x = 0, 1, …, n−1 они никогда не изменяются: x̄ = (n−1)/2 и Sxx = n(n²−1)/12. Основной индикатор вычисляет их один раз при инициализации, поэтому объем работы, выполняемый для каждого бара, сводится к суммам, которые действительно зависят от цены. Это намеренная оптимизация: пересчет сумм, зависящих только от x, на каждом баре был бы пустой тратой ресурсов, поскольку сетка значений x одинакова для всех окон.
Внутри цикла суммируются только величины, зависящие от y: Σy, Σxy и Σy². Из этих сумм непосредственно получаются Sxy = Σxᵢyᵢ − n·x̄·ȳ и коэффициент наклона β₁ = Sxy/Sxx, а свободный член равен β₀ = ȳ − β₁·x̄. Каждая цена перед использованием проверяется с помощью MathIsValidNumber, поэтому при некорректном или неконечном значении котировки процедура возвращает недопустимый результат, не допуская искажения сумм. Проверка MathAbs(sxx) < 1e-14 сохранена как дополнительная защитная мера, хотя для целочисленной сетки при n ≥ 3 переданное значение Sxx заведомо положительно и далеко от нуля.
SSE вычисляется с помощью алгебраического тождества SSE = Syy − β₁·Sxy, где Syy = Σyᵢ² − n·ȳ², а не путем суммирования квадратов остатков во втором цикле. Для хорошо обусловленных данных эти способы численно эквивалентны; ограничение if(sse < 0.0) sse = 0.0 обнуляет небольшие отрицательные значения, которые могут возникнуть из-за потери значащих цифр при вычитании близких чисел и привести к получению мнимой стандартной ошибки на последующих этапах вычислений. Для данных с почти линейной зависимостью или почти постоянными значениями непосредственный расчет по остаткам во втором проходе может быть немного устойчивее, но для финансовых цен вычисление по тождеству достаточно надежно и при этом быстрее.
Вычислительная сложность: O(n) на вызов, один проход по массиву цен; постоянный множитель теперь меньше, поскольку статистики, зависящие только от x, больше не пересчитываются внутри цикла.
ResidualAnalysis.mqh — дисперсия и число степеней свободы
//+------------------------------------------------------------------+
//|                                             ResidualAnalysis.mqh |
//| Residual variance and degrees of freedom from OLS output.        |
//+------------------------------------------------------------------+
#ifndef __RESIDUAL_ANALYSIS_MQH__
#define __RESIDUAL_ANALYSIS_MQH__

#include "OLSStatistics.mqh"

//+------------------------------------------------------------------+
//| Structure: SResidualStatistics                                   |
//| Holds residual analysis outputs.                                 |
//+------------------------------------------------------------------+
struct SResidualStatistics
  {
   double            variance;            // s² = SSE / (n−2)
   double            std_error;           // s  = √s²
   int               degrees_of_freedom;  // n − 2
   bool              valid;
  };

//+------------------------------------------------------------------+
//| Class: CResidualAnalysis                                         |
//| Derives residual statistics from a completed OLS result.         |
//+------------------------------------------------------------------+
class CResidualAnalysis
  {
public:
                     CResidualAnalysis(void);
                    ~CResidualAnalysis(void);

   SResidualStatistics Compute(const SOLSResult &ols);
  };

//+------------------------------------------------------------------+
//| Constructor                                                      |
//+------------------------------------------------------------------+
CResidualAnalysis::CResidualAnalysis(void)
  {
  }

//+------------------------------------------------------------------+
//| Destructor                                                       |
//+------------------------------------------------------------------+
CResidualAnalysis::~CResidualAnalysis(void)
  {
  }

//+------------------------------------------------------------------+
//| CResidualAnalysis::Compute                                       |
//| Receives a validated SOLSResult and returns residual statistics. |
//+------------------------------------------------------------------+
SResidualStatistics CResidualAnalysis::Compute(const SOLSResult &ols)
  {
   SResidualStatistics res;
   res.valid = false;

   if(!ols.valid || ols.n < 3)
      return(res);

   int df = ols.n - 2;

   if(df < 1)
      return(res);

   double variance  = ols.sse / (double)df;
   double std_error = MathSqrt(variance);

   res.variance           = variance;
   res.std_error          = std_error;
   res.degrees_of_freedom = df;
   res.valid              = true;

   return(res);
  }

#endif
//+------------------------------------------------------------------+
CResidualAnalysis::Compute выполняет единственное вычисление: делит SSE на n−2, получая несмещенную оценку дисперсии остатков s². Квадратный корень из этой величины дает стандартную ошибку регрессии s, которая служит основным масштабным коэффициентом для полуширин всех интервалов.
Проверка df < 1 предотвращает деление на ноль или получение вырожденной дисперсии для окон, содержащих менее трех наблюдений. На практике входной параметр inp_regression_window в основном индикаторе задает разумное минимальное значение на более высоком уровне, поэтому эта ветвь служит дополнительной защитой, а не штатным путем выполнения.
Единственное назначение этого модуля — централизовать вычисления, связанные с числом степеней свободы. Благодаря отделению этого процесса от COLSStatistics архитектура обеспечивает изоляцию оценки дисперсии от оценки параметров. Если аналитик захочет заменить оценку дисперсии на робастную (например, оценку типа «сэндвич» HC3 для гетероскедастических остатков), то изменить потребуется только этот модуль. Оценка МНК остается наилучшей линейной несмещенной оценкой согласно теореме Гаусса — Маркова независимо от того, является ли распределение остатков нормальным; однако гарантия вероятности покрытия интервалов опирается на предположение о нормальности, поэтому SResidualStatistics предоставляет и дисперсию, и число степеней свободы для использования модулем t-распределения.
TDistribution.mqh — критическое значение t-распределения Стьюдента
//+------------------------------------------------------------------+
//|                                                TDistribution.mqh |
//| Student's t critical value approximation for arbitrary df.       |
//+------------------------------------------------------------------+
#ifndef __T_DISTRIBUTION_MQH__
#define __T_DISTRIBUTION_MQH__

//+------------------------------------------------------------------+
//| Class: CTDistribution                                            |
//| Provides two-tailed t critical values via rational approximation.|
//| All public results signal failure through a negative return so   |
//| that callers can detect invalid input rather than receiving a    |
//| silently substituted value.                                      |
//+------------------------------------------------------------------+
class CTDistribution
  {
public:
                     CTDistribution(void);
                    ~CTDistribution(void);

   //--- Returns t_{alpha/2, df}; returns -1.0 on invalid input.
   double            CriticalValue(int degrees_of_freedom, double alpha);

private:
   double            InverseNormalApprox(double p);
   double            TQuantileApprox(double p, int df);
  };

//+------------------------------------------------------------------+
//| Constructor                                                      |
//+------------------------------------------------------------------+
CTDistribution::CTDistribution(void)
  {
  }

//+------------------------------------------------------------------+
//| Destructor                                                       |
//+------------------------------------------------------------------+
CTDistribution::~CTDistribution(void)
  {
  }

//+------------------------------------------------------------------+
//| CTDistribution::CriticalValue                                    |
//| Returns t_{alpha/2, df} — the upper tail critical value for a    |
//| two-tailed interval at significance level alpha.                 |
//| Example: alpha=0.05, df=48 returns approximately 2.0106.         |
//| Returns -1.0 if df < 1 or alpha is outside (0, 1), so the caller |
//| can treat the result as invalid instead of proceeding with a     |
//| substituted constant.                                            |
//+------------------------------------------------------------------+
double CTDistribution::CriticalValue(int degrees_of_freedom, double alpha)
  {
//--- Reject invalid degrees of freedom and significance levels.
   if(degrees_of_freedom < 1)
      return(-1.0);
   if(alpha <= 0.0 || alpha >= 1.0)
      return(-1.0);

   double p = 1.0 - alpha * 0.5;
   return(TQuantileApprox(p, degrees_of_freedom));
  }

//+------------------------------------------------------------------+
//| CTDistribution::InverseNormalApprox                              |
//| Rational approximation to the inverse standard normal CDF.       |
//| Accuracy: absolute error < 4.5e-4 for 0 < p < 1.                 |
//| Source: Abramowitz and Stegun 26.2.17                            |
//+------------------------------------------------------------------+
double CTDistribution::InverseNormalApprox(double p)
  {
   if(p <= 0.0)
      return(-1e15);
   if(p >= 1.0)
      return(1e15);

   double sign = 1.0;
   double q    = p;

   if(q < 0.5)
     {
      sign = -1.0;
      q    = 1.0 - q;
     }

   double t = MathSqrt(-2.0 * MathLog(1.0 - q));

   double c0 = 2.515517;
   double c1 = 0.802853;
   double c2 = 0.010328;
   double d1 = 1.432788;
   double d2 = 0.189269;
   double d3 = 0.001308;

   double numerator   = c0 + c1 * t + c2 * t * t;
   double denominator = 1.0 + d1 * t + d2 * t * t + d3 * t * t * t;

   double z = t - numerator / denominator;

   return(sign * z);
  }

//+------------------------------------------------------------------+
//| CTDistribution::TQuantileApprox                                  |
//| Approximates the t-distribution quantile at probability p        |
//| with the given degrees of freedom.                               |
//| Uses the Cornish-Fisher expansion for moderate-to-large df,      |
//| and a direct closed-form for df=1 and df=2.                      |
//+------------------------------------------------------------------+
double CTDistribution::TQuantileApprox(double p, int df)
  {
//--- Handle special cases with exact closed-form results
   if(df == 1)
     {
      //--- Cauchy distribution: t = tan(π·(p − 0.5))
      return(MathTan(M_PI * (p - 0.5)));
     }

   if(df == 2)
     {
      //--- t₂ quantile: t = (2p−1)/√(2p(1−p))
      double q = 2.0 * p - 1.0;
      double r = 2.0 * p * (1.0 - p);
      if(r < 1e-15)
         return(1e15);
      return(q / MathSqrt(r));
     }

//--- For df >= 3 use the Cornish-Fisher expansion
//--- t ≈ z + (z³+z)/(4·df) + (5z⁵+16z³+3z)/(96·df²) + ...
//--- where z is the corresponding normal quantile

   double z  = InverseNormalApprox(p);
   double z2 = z * z;
   double z3 = z2 * z;
   double z5 = z3 * z2;

   double v  = (double)df;
   double v2 = v * v;

   double t = z
              + (z3 + z) / (4.0 * v)
              + (5.0 * z5 + 16.0 * z3 + 3.0 * z) / (96.0 * v2)
              + (3.0 * z5 * z2 + 19.0 * z5 + 17.0 * z3 - 15.0 * z) / (384.0 * v2 * v);

   return(t);
  }

#endif
//+------------------------------------------------------------------+
CTDistribution::CriticalValue — единственный открытый интерфейс: он принимает число степеней свободы и уровень значимости α (например, 0,05 для 95-процентных интервалов) и возвращает критическое значение для верхнего хвоста распределения t(α/2, df). Сначала проверяется корректность обоих аргументов: если число степеней свободы меньше 1 или α не принадлежит открытому интервалу (0, 1), возвращается отрицательное значение, которое вызывающий код трактует как признак недопустимых аргументов; подстановка константы без уведомления не выполняется. Это инженерный аналог тщательного статистического подхода, применяемого в других частях статьи: запрос со значениями вне допустимого диапазона приводит к явному сигналу об ошибке, а не к незаметному возврату правдоподобного числа.
В реализации используется разложение Корниша — Фишера — классическое разложение в ряд, представляющее t-квантили как возмущения соответствующего квантиля нормального распределения. Для значений числа степеней свободы df, встречающихся в окнах скользящей регрессии (обычно от 28 до 198 при длине окна от 30 до 200), это разложение быстро сходится. Абсолютная погрешность этой комбинированной аппроксимации (начальное приближение обратной функции нормального распределения по формуле Абрамовица — Стегуна с последующим разложением Корниша — Фишера для t-квантиля) мала во всем практически значимом диапазоне, однако статья не заявляет гарантированной границы погрешности: ответственный подход к использованию этой аппроксимации состоит в сверке возвращаемых критических значений с эталонной таблицей для фактически используемого числа степеней свободы. Диагностический вывод включает вычисленное критическое значение t-распределения Стьюдента именно для сверки со стандартной таблицей: например, значение около 2,011, полученное при числе степеней свободы 48, соответствует табличному 97,5-му процентилю. Для задач, требующих гарантированной точности, этот модуль можно заменить реализацией поиска по таблице с интерполяцией или прямого численного обращения функции распределения Стьюдента, не изменяя другие модули.
Функция InverseNormalApprox реализует рациональное приближение Абрамовица и Стегуна (формула 26.2.17) для обратной функции нормального распределения. Это начальное приближение для разложения Корниша — Фишера. Максимальная абсолютная погрешность этого приближения меньше 4,5 × 10⁻⁴ на всем интервале (0, 1).
Обработка частных случаев df = 1 (распределение Коши) и df = 2 (точная алгебраическая формула) включена для полноты реализации и для того, чтобы приближение в виде ряда использовалось только в области его надежной применимости. На практике окно регрессии длиной менее четырех баров не имеет смысла с вычислительной точки зрения. Проверка минимальной длины окна в основном индикаторе гарантирует, что при нормальной работе эти ветви кода никогда не выполняются.
Заранее вычисленная таблица соответствий для конкретных значений df была бы компактной и точной, однако требовала бы интерполяции для промежуточных значений df и не могла бы быть обобщена на различные значения α. Подход на основе разложения Корниша — Фишера требует немного большего объема кода, но является полностью параметрическим.
ConfidenceInterval.mqh — Полосы неопределенности среднего отклика
//+------------------------------------------------------------------+
//|                                       ConfidenceInterval.mqh     |
//| Computes OLS confidence intervals for the mean response.         |
//+------------------------------------------------------------------+
#ifndef __CONFIDENCE_INTERVAL_MQH__
#define __CONFIDENCE_INTERVAL_MQH__

#include "OLSStatistics.mqh"
#include "ResidualAnalysis.mqh"
#include "TDistribution.mqh"

//+------------------------------------------------------------------+
//| Structure: SIntervalBand                                         |
//| Holds the upper and lower band values at a single x position.    |
//+------------------------------------------------------------------+
struct SIntervalBand
  {
   double            upper;
   double            lower;
   double            fitted;
   bool              valid;
  };

//+------------------------------------------------------------------+
//| Class: CConfidenceInterval                                       |
//| Calculates mean confidence interval bands over a regression.     |
//+------------------------------------------------------------------+
class CConfidenceInterval
  {
public:
                     CConfidenceInterval(void);
                    ~CConfidenceInterval(void);

   SIntervalBand     Evaluate(const SOLSResult           &ols,
                              const SResidualStatistics  &res,
                              double                     t_critical,
                              int                        x_position);
  };

//+------------------------------------------------------------------+
//| Constructor                                                      |
//+------------------------------------------------------------------+
CConfidenceInterval::CConfidenceInterval(void)
  {
  }

//+------------------------------------------------------------------+
//| Destructor                                                       |
//+------------------------------------------------------------------+
CConfidenceInterval::~CConfidenceInterval(void)
  {
  }

//+------------------------------------------------------------------+
//| CConfidenceInterval::Evaluate                                    |
//| Computes the confidence interval at position x_position.         |
//|                                                                  |
//| Formula:                                                         |
//|    ŷ ± t · s · √(1/n + (x − x̄)² / Sxx)                           |
//+------------------------------------------------------------------+
SIntervalBand CConfidenceInterval::Evaluate(const SOLSResult           &ols,
      const SResidualStatistics  &res,
      double                     t_critical,
      int                        x_position)
  {
   SIntervalBand band;
   band.valid = false;

   if(!ols.valid || !res.valid)
      return(band);

   double x      = (double)x_position;
   double fitted = ols.intercept + ols.slope * x;

   double deviation = x - ols.x_mean;
   double leverage  = (1.0 / (double)ols.n) + (deviation * deviation) / ols.sxx;

   double half_width = t_critical * res.std_error * MathSqrt(leverage);

   band.fitted = fitted;
   band.upper  = fitted + half_width;
   band.lower  = fitted - half_width;
   band.valid  = true;

   return(band);
  }

#endif
//+------------------------------------------------------------------+
CConfidenceInterval::Evaluate реализует вычисление полуширины доверительного интервала по явной формуле в одной точке x_position.
Переменная leverage соответствует рычагу наблюдения hᵢ = 1/n + (xᵢ − x̄)²/Sxx — диагональному элементу проекционной матрицы. Вычисление организовано так, чтобы явно отразить эту формулу: отклонение x − x_mean возводится в квадрат и делится на Sxx (знаменатель оценки коэффициента наклона), затем результат прибавляется к общему слагаемому неопределенности 1/n. Это стандартная формула для диагонального элемента проекционной матрицы, примененная в произвольной точке, а не только в точках наблюдаемых данных. Такое применение корректно, поскольку мы вычисляем полосу для каждого индекса бара от 0 до n−1.
Переменная half_width равна t · s · √h, где t — заранее вычисленное критическое значение t-распределения Стьюдента, s — стандартная ошибка регрессии, а √h — квадратный корень из рычага наблюдения. Такое разложение на множители делает вклад каждого из них понятным: t задает масштаб с учетом размера выборки и доверительного уровня, s — с учетом присущего цене шума, а √h — с учетом положения в окне регрессии.
Структура результата SIntervalBand содержит расчетное значение (точку на линии регрессии), а также верхнюю и нижнюю границы, поэтому вызывающий код индикатора может за один вызов заполнить буфер линии регрессии и оба буфера границ доверительного интервала. Эта структура определена здесь и также используется модулем прогнозного интервала.
PredictionInterval.mqh — Полосы для отдельных наблюдений
//+------------------------------------------------------------------+
//|                                           PredictionInterval.mqh |
//| Computes OLS prediction intervals for individual observations.   |
//+------------------------------------------------------------------+
#ifndef __PREDICTION_INTERVAL_MQH__
#define __PREDICTION_INTERVAL_MQH__

#include "OLSStatistics.mqh"
#include "ResidualAnalysis.mqh"
#include "TDistribution.mqh"
#include "ConfidenceInterval.mqh"   // Provides SIntervalBand

//+------------------------------------------------------------------+
//| Class: CPredictionInterval                                       |
//| Calculates prediction interval bands over a regression.          |
//+------------------------------------------------------------------+
class CPredictionInterval
  {
public:
                     CPredictionInterval(void);
                    ~CPredictionInterval(void);

   SIntervalBand     Evaluate(const SOLSResult           &ols,
                              const SResidualStatistics  &res,
                              double                     t_critical,
                              int                        x_position);
  };

//+------------------------------------------------------------------+
//| Constructor                                                      |
//+------------------------------------------------------------------+
CPredictionInterval::CPredictionInterval(void)
  {
  }

//+------------------------------------------------------------------+
//| Destructor                                                       |
//+------------------------------------------------------------------+
CPredictionInterval::~CPredictionInterval(void)
  {
  }

//+------------------------------------------------------------------+
//| CPredictionInterval::Evaluate                                    |
//| Computes the prediction interval at position x_position.         |
//|                                                                  |
//| Formula:                                                         |
//|    ŷ ± t · s · √(1 + 1/n + (x − x̄)² / Sxx)                       |
//|                                                                  |
//| The additional 1 under the square root represents the variance   |
//| of a new individual observation around the regression line.      |
//+------------------------------------------------------------------+
SIntervalBand CPredictionInterval::Evaluate(const SOLSResult           &ols,
      const SResidualStatistics  &res,
      double                     t_critical,
      int                        x_position)
  {
   SIntervalBand band;
   band.valid = false;

   if(!ols.valid || !res.valid)
      return(band);

   double x      = (double)x_position;
   double fitted = ols.intercept + ols.slope * x;

   double deviation     = x - ols.x_mean;
   double pred_variance = 1.0
                          + (1.0 / (double)ols.n)
                          + (deviation * deviation) / ols.sxx;

   double half_width = t_critical * res.std_error * MathSqrt(pred_variance);

   band.fitted = fitted;
   band.upper  = fitted + half_width;
   band.lower  = fitted - half_width;
   band.valid  = true;

   return(band);
  }

#endif
//+------------------------------------------------------------------+
Метод CPredictionInterval::Evaluate структурно идентичен методу расчета доверительного интервала, но имеет одно существенное отличие: для переменной pred_variance используется выражение 1.0 + 1/n + (x−x̄)²/Sxx вместо 1/n + (x−x̄)²/Sxx. Первое слагаемое 1.0 представляет единичную дисперсию нового наблюдения из распределения ошибок. Даже если бы параметры регрессии были оценены с бесконечной точностью, новое значение цены всё равно отклонялось бы от линии примерно на ±s.
Это дополнительное слагаемое 1.0 гарантирует, что прогнозные интервалы всегда строго шире доверительных интервалов. Отношение полуширины прогнозного интервала к полуширине доверительного интервала в любой точке x равно:
отношение = √(1 + 1/n + (x−x̄)²/Sxx) / √(1/n + (x−x̄)²/Sxx)
В точке x = x̄ (в центре окна) рычаг наблюдения минимален, а отношение максимально. В центре окна из 50 баров прогнозный интервал шире доверительного в √(1 + 1/50) / √(1/50) ≈ √51 ≈ 7,14 раза. Вблизи краев окна рычаг наблюдения увеличивается, а относительное превышение ширины уменьшается, однако прогнозные интервалы остаются строго шире доверительных во всех точках.
Этот модуль подключает файл ConfidenceInterval.mqh, чтобы получить определение SIntervalBand. В более ранней версии модуля это подключение отсутствовало: предполагалось, что основной файл индикатора предварительно подключит определение, из-за чего заголовочный файл не компилировался отдельно. Прямое подключение заголовочного файла с определением устраняет эту ненадежную зависимость от порядка подключения. Защита от повторного подключения на основе #ifndef гарантирует, что структура будет определена ровно один раз, даже если этот файл подключают несколько модулей.
RegressionChannels.mq5 — Основной индикатор
//+------------------------------------------------------------------+
//|                                           RegressionChannels.mq5 |
//| Rolling OLS regression channels with confidence and prediction   |
//| intervals computed using Student's t-distribution.               |
//| Line-only rendering: regression line plus four boundary lines.   |
//+------------------------------------------------------------------+

#property description "Linear Regression Channels: OLS + Student's t"
#property indicator_chart_window
#property indicator_buffers 5
#property indicator_plots   5

//--- Plot 1: Regression line
#property indicator_label1  "Regression Line"
#property indicator_type1   DRAW_LINE
#property indicator_color1  clrDodgerBlue
#property indicator_style1  STYLE_SOLID
#property indicator_width1  2

//--- Plot 2: Prediction interval upper boundary
#property indicator_label2  "PI Upper"
#property indicator_type2   DRAW_LINE
#property indicator_color2  clrCrimson
#property indicator_style2  STYLE_DASH
#property indicator_width2  1

//--- Plot 3: Prediction interval lower boundary
#property indicator_label3  "PI Lower"
#property indicator_type3   DRAW_LINE
#property indicator_color3  clrCrimson
#property indicator_style3  STYLE_DASH
#property indicator_width3  1

//--- Plot 4: Confidence interval upper boundary
#property indicator_label4  "CI Upper"
#property indicator_type4   DRAW_LINE
#property indicator_color4  clrForestGreen
#property indicator_style4  STYLE_SOLID
#property indicator_width4  1

//--- Plot 5: Confidence interval lower boundary
#property indicator_label5  "CI Lower"
#property indicator_type5   DRAW_LINE
#property indicator_color5  clrForestGreen
#property indicator_style5  STYLE_SOLID
#property indicator_width5  1

//--- Includes
#include <Linear_Regression_Prediction_Channels/OLSStatistics.mqh>
#include <Linear_Regression_Prediction_Channels/ResidualAnalysis.mqh>
#include <Linear_Regression_Prediction_Channels/TDistribution.mqh>
#include <Linear_Regression_Prediction_Channels/ConfidenceInterval.mqh>
#include <Linear_Regression_Prediction_Channels/PredictionInterval.mqh>

//+------------------------------------------------------------------+
//| Evaluation mode for the interval bands.                          |
//| CURRENT_EDGE: evaluate at x = window-1, the last observed bar    |
//|               inside the window. This is an in-sample edge band. |
//| NEXT_BAR:     evaluate at x = window, a genuine one-step-ahead   |
//|               forecast point one bar beyond the window.          |
//+------------------------------------------------------------------+
enum ENUM_EVAL_MODE
  {
   EVAL_CURRENT_EDGE = 0, // In-Sample Edge (x = n-1)
   EVAL_NEXT_BAR     = 1  // One-Step-Ahead Forecast (x = n)
  };

//--- Input parameters
input int            inp_regression_window = 50;              // Regression Window (Bars)
input double         inp_confidence_level  = 0.95;            // Confidence Level (0.90 to 0.99)
input ENUM_EVAL_MODE inp_eval_mode         = EVAL_CURRENT_EDGE;// Interval Evaluation Mode
input bool           inp_show_ci           = true;            // Show Confidence Interval Lines
input bool           inp_show_pi           = true;            // Show Prediction Interval Lines
input bool           inp_print_diagnostics = true;            // Print Diagnostics To Experts Log

//--- Indicator buffers
double g_buffer_regression[];
double g_buffer_pi_upper[];
double g_buffer_pi_lower[];
double g_buffer_ci_upper[];
double g_buffer_ci_lower[];

//--- Module instances (global)
COLSStatistics      g_ols_engine;
CResidualAnalysis   g_residual_engine;
CTDistribution      g_t_distribution;
CConfidenceInterval g_ci_engine;
CPredictionInterval g_pi_engine;

//--- Precomputed x-domain constants (fixed for a given window size)
double g_x_mean = 0.0;   // x̄ = (n-1)/2
double g_sxx    = 0.0;   // Σ(xᵢ − x̄)² = n(n²−1)/12
int    g_x_eval = 0;     // evaluation position (n-1 or n)

//--- Reusable working buffer for the price window (allocated once)
double g_prices[];

//--- Diagnostics state
bool g_diagnostics_printed = false;

//+------------------------------------------------------------------+
//| Self-check: verify x-domain constants for a known window.        |
//| Returns true when the closed-form constants match the expected   |
//| values for the active window, providing a lightweight unit test  |
//| that runs once at initialization.                                |
//+------------------------------------------------------------------+
bool SelfCheckXConstants(int window)
  {
   double expect_mean = (double)(window - 1) / 2.0;
   double expect_sxx  = (double)window * ((double)window * window - 1.0) / 12.0;

   if(MathAbs(g_x_mean - expect_mean) > 1e-9)
      return(false);
   if(MathAbs(g_sxx - expect_sxx) > 1e-6)
      return(false);

   return(true);
  }

//+------------------------------------------------------------------+
//| Custom indicator initialization function                         |
//+------------------------------------------------------------------+
int OnInit(void)
  {
//--- Validate inputs
   if(inp_regression_window < 5)
     {
      Print("RegressionChannels: inp_regression_window must be >= 5. Received: " +
            IntegerToString(inp_regression_window));
      return(INIT_PARAMETERS_INCORRECT);
     }

   if(inp_confidence_level <= 0.50 || inp_confidence_level >= 1.00)
     {
      Print("RegressionChannels: inp_confidence_level must be in (0.50, 1.00). Received: " +
            DoubleToString(inp_confidence_level, 4));
      return(INIT_PARAMETERS_INCORRECT);
     }

//--- Precompute x-domain constants for the fixed window. Because bar
//--- indices are always 0..window-1, these never change between bars,
//--- so they are computed once here rather than on every bar.
   int n = inp_regression_window;
   g_x_mean = (double)(n - 1) / 2.0;
   g_sxx    = (double)n * ((double)n * n - 1.0) / 12.0;

//--- Choose the evaluation position from the selected mode.
   g_x_eval = (inp_eval_mode == EVAL_NEXT_BAR) ? n : (n - 1);

//--- Run the lightweight self-check on the x-domain constants.
   if(!SelfCheckXConstants(n))
     {
      Print("RegressionChannels: x-domain self-check failed. "
            "x_mean=" + DoubleToString(g_x_mean, 4) +
            " sxx=" + DoubleToString(g_sxx, 4));
      return(INIT_FAILED);
     }

//--- Allocate the reusable price working buffer once.
   if(ArrayResize(g_prices, n) != n)
     {
      Print("RegressionChannels: failed to allocate price buffer.");
      return(INIT_FAILED);
     }

//--- Bind buffers
   SetIndexBuffer(0, g_buffer_regression, INDICATOR_DATA);
   SetIndexBuffer(1, g_buffer_pi_upper,   INDICATOR_DATA);
   SetIndexBuffer(2, g_buffer_pi_lower,   INDICATOR_DATA);
   SetIndexBuffer(3, g_buffer_ci_upper,   INDICATOR_DATA);
   SetIndexBuffer(4, g_buffer_ci_lower,   INDICATOR_DATA);

//--- Set empty value per plot (5 plots, indices 0..4)
   PlotIndexSetDouble(0, PLOT_EMPTY_VALUE, EMPTY_VALUE);
   PlotIndexSetDouble(1, PLOT_EMPTY_VALUE, EMPTY_VALUE);
   PlotIndexSetDouble(2, PLOT_EMPTY_VALUE, EMPTY_VALUE);
   PlotIndexSetDouble(3, PLOT_EMPTY_VALUE, EMPTY_VALUE);
   PlotIndexSetDouble(4, PLOT_EMPTY_VALUE, EMPTY_VALUE);

//--- Apply current visibility from inputs. Using DRAW_LINE / DRAW_NONE
//--- here (rather than only in OnInit on first load) means the plots
//--- track input changes when the indicator is re-initialized.
   int pi_type = inp_show_pi ? DRAW_LINE : DRAW_NONE;
   int ci_type = inp_show_ci ? DRAW_LINE : DRAW_NONE;
   PlotIndexSetInteger(1, PLOT_DRAW_TYPE, pi_type);
   PlotIndexSetInteger(2, PLOT_DRAW_TYPE, pi_type);
   PlotIndexSetInteger(3, PLOT_DRAW_TYPE, ci_type);
   PlotIndexSetInteger(4, PLOT_DRAW_TYPE, ci_type);

//--- Require enough historical bars
   IndicatorSetInteger(INDICATOR_DIGITS, _Digits);

   string mode_tag   = (inp_eval_mode == EVAL_NEXT_BAR) ? "fwd" : "edge";
   string short_name = "RegCh(" +
                       IntegerToString(inp_regression_window) + "," +
                       DoubleToString(inp_confidence_level * 100.0, 0) + "%," +
                       mode_tag + ")";
   IndicatorSetString(INDICATOR_SHORTNAME, short_name);

   g_diagnostics_printed = false;

   return(INIT_SUCCEEDED);
  }

//+------------------------------------------------------------------+
//| Custom indicator deinitialization function                       |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
  }

//+------------------------------------------------------------------+
//| Helper: write EMPTY_VALUE into every buffer at one bar           |
//+------------------------------------------------------------------+
void ClearBar(int bar)
  {
   g_buffer_regression[bar] = EMPTY_VALUE;
   g_buffer_pi_upper[bar]   = EMPTY_VALUE;
   g_buffer_pi_lower[bar]   = EMPTY_VALUE;
   g_buffer_ci_upper[bar]   = EMPTY_VALUE;
   g_buffer_ci_lower[bar]   = EMPTY_VALUE;
  }

//+------------------------------------------------------------------+
//| Custom indicator iteration function                              |
//+------------------------------------------------------------------+
int OnCalculate(const int      rates_total,
                const int      prev_calculated,
                const datetime &time[],
                const double   &open[],
                const double   &high[],
                const double   &low[],
                const double   &close[],
                const long     &tick_volume[],
                const long     &volume[],
                const int      &spread[])
  {
   int window = inp_regression_window;

//--- Need at least one full window before drawing
   if(rates_total < window)
      return(0);

//--- Determine starting bar for this pass
   int start_bar = prev_calculated - 1;
   if(start_bar < window - 1)
      start_bar = window - 1;

//--- Fill leading bars with EMPTY_VALUE
   if(prev_calculated == 0)
     {
      for(int i = 0; i < window - 1; i++)
         ClearBar(i);
     }

//--- Compute alpha from confidence level
   double alpha = 1.0 - inp_confidence_level;

//--- Process each bar from start_bar to the most recent
   for(int bar = start_bar; bar < rates_total; bar++)
     {
      //--- Copy this window's closing prices into the reusable buffer.
      //--- prices[0] = oldest bar in window, prices[window-1] = bar itself.
      for(int k = 0; k < window; k++)
         g_prices[k] = close[bar - (window - 1) + k];

      //--- Step 1: Fit OLS regression (passing the precomputed x stats)
      SOLSResult ols = g_ols_engine.Compute(g_prices, window, g_x_mean, g_sxx);

      if(!ols.valid)
        {
         ClearBar(bar);
         continue;
        }

      //--- Step 2: Compute residual variance
      SResidualStatistics res = g_residual_engine.Compute(ols);

      if(!res.valid)
        {
         ClearBar(bar);
         continue;
        }

      //--- Step 3: Get t critical value; skip the bar if it is invalid
      double t_crit = g_t_distribution.CriticalValue(res.degrees_of_freedom, alpha);

      if(t_crit < 0.0)
        {
         ClearBar(bar);
         continue;
        }

      //--- Step 4: Evaluate intervals at the configured position.
      //--- g_x_eval is window-1 for the in-sample edge, or window for a
      //--- one-step-ahead forecast one bar beyond the window.
      SIntervalBand ci = g_ci_engine.Evaluate(ols, res, t_crit, g_x_eval);
      SIntervalBand pi = g_pi_engine.Evaluate(ols, res, t_crit, g_x_eval);

      //--- Default this bar to empty, then fill in whatever is valid/enabled
      ClearBar(bar);

      //--- Regression line
      if(ci.valid)
         g_buffer_regression[bar] = ci.fitted;

      //--- Prediction interval boundary lines
      if(inp_show_pi && pi.valid)
        {
         g_buffer_pi_upper[bar] = pi.upper;
         g_buffer_pi_lower[bar] = pi.lower;
        }

      //--- Confidence interval boundary lines
      if(inp_show_ci && ci.valid)
        {
         g_buffer_ci_upper[bar] = ci.upper;
         g_buffer_ci_lower[bar] = ci.lower;
        }

      //--- Step 5: Print diagnostics on first valid bar only
      if(inp_print_diagnostics && !g_diagnostics_printed && ci.valid && pi.valid)
        {
         PrintDiagnostics(ols, res, t_crit, ci, pi, bar);
         g_diagnostics_printed = true;
        }
     }

   return(rates_total);
  }

//+------------------------------------------------------------------+
//| PrintDiagnostics                                                 |
//| Outputs regression statistics to the MetaTrader Experts log.     |
//+------------------------------------------------------------------+
void PrintDiagnostics(const SOLSResult          &ols,
                      const SResidualStatistics  &res,
                      double                     t_crit,
                      const SIntervalBand        &ci,
                      const SIntervalBand        &pi,
                      int                        bar_index)
  {
   string mode_text = (inp_eval_mode == EVAL_NEXT_BAR)
                      ? "One-Step-Ahead Forecast (x = n)"
                      : "In-Sample Edge (x = n-1)";

   Print("=== RegressionChannels Diagnostics ===");
   Print("Evaluation Mode     = " + mode_text);
   Print("Evaluation x        = " + IntegerToString(g_x_eval));
   Print("Bar Index           = " + IntegerToString(bar_index));
   Print("Regression Window   = " + IntegerToString(ols.n));
   Print("Degrees Of Freedom  = " + IntegerToString(res.degrees_of_freedom));
   Print("Regression Slope    = " + DoubleToString(ols.slope, 8));
   Print("Regression Intercept= " + DoubleToString(ols.intercept, 8));
   Print("SSE                 = " + DoubleToString(ols.sse, 8));
   Print("Residual Variance   = " + DoubleToString(res.variance, 8));
   Print("Residual Std Error  = " + DoubleToString(res.std_error, 8));
   Print("t Critical Value    = " + DoubleToString(t_crit, 6));
   Print("x Mean              = " + DoubleToString(ols.x_mean, 4));
   Print("Sxx                 = " + DoubleToString(ols.sxx, 4));
   Print("--- Confidence Interval ---");
   Print("CI Fitted           = " + DoubleToString(ci.fitted, _Digits));
   Print("CI Upper            = " + DoubleToString(ci.upper,  _Digits));
   Print("CI Lower            = " + DoubleToString(ci.lower,  _Digits));
   Print("CI Half Width       = " + DoubleToString(ci.upper - ci.fitted, _Digits));
   Print("--- Prediction Interval ---");
   Print("PI Fitted           = " + DoubleToString(pi.fitted, _Digits));
   Print("PI Upper            = " + DoubleToString(pi.upper,  _Digits));
   Print("PI Lower            = " + DoubleToString(pi.lower,  _Digits));
   Print("PI Half Width       = " + DoubleToString(pi.upper - pi.fitted, _Digits));
   Print("--- Width Ratio PI/CI ---");
   double ci_hw = ci.upper - ci.fitted;
   double pi_hw = pi.upper - pi.fitted;
   if(ci_hw > 1e-15)
      Print("Width Ratio         = " + DoubleToString(pi_hw / ci_hw, 6));
   Print("======================================");
  }
//+------------------------------------------------------------------+
Индикатор объявляет пять индикаторных буферов и пять графических построений типа DRAW_LINE. Каждое графическое построение использует ровно один буфер, поэтому значения indicator_buffers и indicator_plots совпадают, а индекс буфера каждого построения определяется порядком его объявления. Это простейшая схема организации буферов, позволяющая избежать проблем с отрисовкой DRAW_FILLING, рассмотренных в разделе 3. Соответствие буферов графическим построениям следующее: буфер 0 = линия регрессии, буфер 1 = верхняя граница прогнозного интервала, буфер 2 = нижняя граница прогнозного интервала, буфер 3 = верхняя граница доверительного интервала, буфер 4 = нижняя граница доверительного интервала.
Функция OnInit прежде всего проверяет два важнейших входных параметра (размер окна и доверительный уровень) и возвращает INIT_PARAMETERS_INCORRECT, если хотя бы один из них выходит за пределы допустимого диапазона. Затем функция предварительно вычисляет константы для значений x — x̄ и Sxx — по явным формулам и задаёт точку вычисления g_x_eval в соответствии с выбранным режимом: n−1 для края выборки или n для прогноза на один шаг вперед. Простая процедура самопроверки SelfCheckXConstants перед продолжением работы индикатора подтверждает, что предварительно вычисленные x̄ и Sxx совпадают с ожидаемыми значениями для текущего окна. Это проверка в стиле модульного теста, которая выполняется один раз и позволяет сразу обнаружить ошибку, если в результате последующих изменений будет нарушена корректность вычислений по явным формулам. Буфер цен g_prices, предназначенный для многократного использования, выделяется здесь один раз, а не для каждого бара.
После привязки буферов и назначения EMPTY_VALUE в качестве маркера пустого значения для каждого графического построения функция OnInit задаёт тип отрисовки каждого построения полосы в соответствии с текущими входными флагами: DRAW_LINE, если полоса включена, и DRAW_NONE, если она отключена. Поскольку этот код выполняется при каждой инициализации, графические построения отражают изменения входных параметров. Включение или отключение полосы либо переключение режима вычисления вступает в силу при повторной инициализации без необходимости удалять и заново добавлять индикатор. Краткое имя содержит размер окна, доверительный уровень и активный режим (край выборки или прогноз на один шаг вперед), что позволяет сразу определить настройки индикатора на графике.
Функция OnDeinit намеренно оставлена пустой. Очищать индикаторные буферы при деинициализации нет смысла, поскольку они освобождаются вместе с экземпляром индикатора; очистку выполняет платформа, поэтому отдельная процедура была бы излишней формальностью.
OnCalculate — это вычислительное ядро. Логика start_bar соответствует протоколу инкрементального пересчёта MetaTrader: при prev_calculated > 0 обрабатывается только вновь поступивший бар, а при первоначальном добавлении индикатора (prev_calculated == 0) обрабатываются все бары; при этом перекрытие в один бар (prev_calculated − 1) обеспечивает пересчёт последнего подтверждённого бара без пропусков. Для каждого бара цены закрытия в окне копируются в заранее выделенный буфер g_prices (prices[0] — цена закрытия самого старого бара в окне, prices[window−1] — цена закрытия текущего обрабатываемого бара), что позволяет избежать выделения памяти на каждом баре.
Последовательность обработки в цикле по барам точно соответствует иерархии модулей: оценивание регрессии по МНК, анализ остатков, вычисление критического значения t-распределения Стьюдента, затем вычисление интервалов в точке g_x_eval. Каждый шаг проверяется перед тем, как перейти к следующему. Если результат оценивания регрессии по МНК или анализа остатков недопустим, вызывается ClearBar(bar) и выполняется continue; теперь также явно проверяется критическое значение t-распределения Стьюдента: если CriticalValue возвращает отрицательное сигнальное значение для недопустимых входных данных, значения на этом баре очищаются, а не отрисовываются с подставленной константой. Оба метода вычисления интервалов используют заданную точку, поэтому в зависимости от режима отображается либо полоса на краю выборки при x = n−1, либо полоса полноценного прогноза на один шаг вперед при x = n. Повторяющийся код очистки буферов вынесен во вспомогательную функцию ClearBar, чтобы во всех ветвях обработки недопустимых данных бара и при обработке каждого бара по умолчанию очистка выполнялась одинаково; это устраняет целый класс несогласованностей, возникающих при копировании и вставке кода. Диагностические данные выводятся только один раз за время существования экземпляра индикатора — на первом баре с полностью корректными результатами расчётов; повторный вывод блокируется флагом g_diagnostics_printed, поэтому журнал «Эксперты» не засоряется при полном пересчёте исторических данных.
Развертывание
Все шесть файлов представлены в полном виде, без сокращений. Для развертывания:
- В каталоге данных MetaTrader 5 создайте в MQL5/Include/ папку Linear_Regression_Prediction_Channels и поместите в нее пять файлов .mqh. Пути подключаемых файлов, указанные в угловых скобках в RegressionChannels.mq5, отсчитываются относительно каталога Include.
- Поместите файл RegressionChannels.mq5 в MQL5/Indicators/ или в подпапку этого каталога.
- Откройте индикатор в MetaEditor и скомпилируйте его, нажав F7. Программа должна скомпилироваться без ошибок и предупреждений.
- Добавьте индикатор на график из «Навигатора». Изменения входных параметров, включая включение и отключение полос и переключение режима оценки, корректно применяются при штатной переинициализации индикатора, поэтому удалять и заново добавлять его не требуется.
Помимо пяти заголовочных файлов проекта никаких внешних библиотек не требуется.
Раздел 5: Ожидаемые результаты диагностики
При добавлении индикатора на график EURUSD H1 с окном в 50 баров, доверительным уровнем 95% и режимом интервала на краю выборки, выбранным по умолчанию, он записывает один диагностический блок в журнал «Эксперты» на первом баре, для которого все расчёты выполнены успешно. Ниже приведен фактический вывод при таком запуске:
=== RegressionChannels Diagnostics ===
Evaluation Mode     = In-Sample Edge (x = n-1)
Evaluation x        = 49
Bar Index           = 49
Regression Window   = 50
Degrees Of Freedom  = 48
Regression Slope    = 0.00002402
Regression Intercept= 1.12126659
SSE                 = 0.00034255
Residual Variance   = 0.00000714
Residual Std Error  = 0.00267141
t Critical Value    = 2.011095
x Mean              = 24.5000
Sxx                 = 10412.5000
--- Confidence Interval ---
CI Fitted           = 1.12244
CI Upper            = 1.12394
CI Lower            = 1.12095
CI Half Width       = 0.00150
--- Prediction Interval ---
PI Fitted           = 1.12244
PI Upper            = 1.12802
PI Lower            = 1.11687
PI Half Width       = 0.00558
--- Width Ratio PI/CI ---
Width Ratio         = 3.725425
======================================
Ряд независимых проверок подтверждает, что реализация работает в соответствии с теоретическими требованиями. Строки Evaluation Mode и Evaluation x явно указывают, для какой точки рассчитаны полосы: здесь это край выборки при x = 49, то есть последний бар в окне из 50 баров. Выведенные значения x Mean = 24,5000 и Sxx = 10412,5000 точно совпадают со значениями, рассчитанными по явным формулам для целочисленной сетки 0…49: x̄ = (n−1)/2 = 24,5 и Sxx = n(n²−1)/12 = 10412,5; именно эти вычисления проверяются при самопроверке во время инициализации, еще до начала отрисовки.
Критическое значение t-распределения Стьюдента, равное 2,011095, совпадает с табличным 97,5-м процентилем этого распределения при числе степеней свободы 48 (приблизительно 2,0106), что подтверждает точность приближения Корниша — Фишера при используемом числе степеней свободы. Поскольку это значение выводится в журнал, его можно непосредственно сверить со справочной таблицей. Именно так и следует проверять точность приближения, а не доверять ему вслепую.
Соотношения между интервалами выполняются в силу способа их построения. Расчетное значение одинаково для доверительного и прогнозного интервалов (1,12244), поскольку оба интервала центрированы на одной и той же линии регрессии; различаются лишь их полуширины. Полуширина прогнозного интервала (0,00558) в несколько раз превышает полуширину доверительного интервала (0,00150), что дает отношение ширин, равное 3,725425. Это отношение отражает преобладание неустранимой дисперсии отдельных наблюдений над неопределенностью оценки среднего отклика в рассматриваемой точке. Это значение зависит от положения: в центре окна отношение было бы больше, поскольку общий для обоих интервалов рычаг наблюдения там минимален, а в режиме прогноза на один шаг вперед при x = 50 оно было бы немного меньше, поскольку сразу за краем окна рычаг наблюдения возрастает.
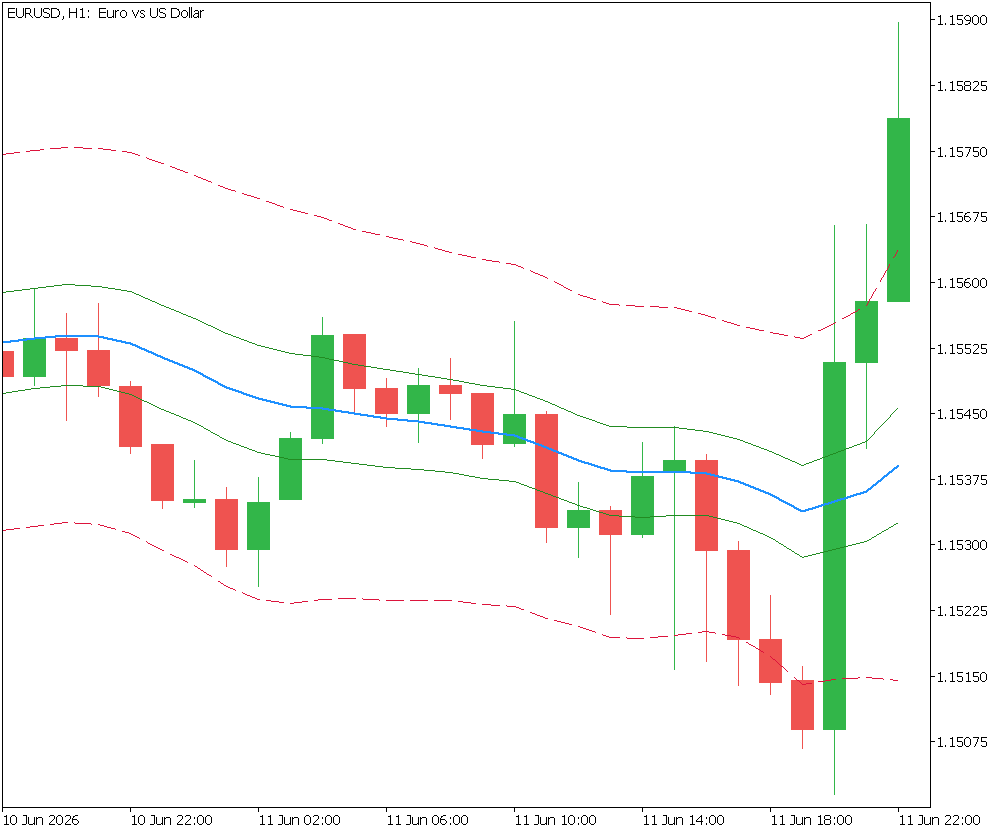
Канал скользящей регрессии по МНК на графике EURUSD H1: сплошная синяя линия регрессии, две сплошные зеленые линии доверительного интервала внутри и две штриховые малиновые линии прогнозного интервала снаружи; все пять линий сближаются к центру окна и расходятся к его краям.
Раздел 6: Интерпретация канала на графике в реальном времени
При установке индикатора на график рынка с выраженным трендом пять линий неизменно располагаются в следующем порядке, что видно по значениям для одного бара в «Окне данных»: PI Lower < CI Lower < Regression < CI Upper < PI Upper. Типичный пример показаний на графике EURUSD H1 в реальном времени: PI Lower — 1,14343, CI Lower — 1,14740, Regression — 1,14886, CI Upper — 1,15032 и PI Upper — 1,15429. Строгая вложенность сохраняется на каждом баре, поскольку по построению полуширина прогнозного интервала превышает полуширину доверительного интервала.
Трактовка касания границы зависит от конкретной линии. То, что цена достигает границы доверительного интервала или выходит за неё, не является чем-то необычным. Доверительный интервал отражает неопределённость самого тренда, а не отдельных цен, поэтому цены регулярно находятся за его пределами. Достижение ценой линии прогнозного интервала или выход за её пределы имеет статистический смысл. Обоснованность этого утверждения зависит от режима оценки. В режиме прогноза на один шаг вперед (x = n) линия прогнозного интервала задает границу прогноза для следующего бара, и в рамках модели примерно одна цена закрытия из двадцати должна выходить за пределы 95%-ной полосы. Заметно более высокая частота таких выходов указывает на нарушение предпосылок модели, что следует подтвердить с помощью проверки частоты покрытия вне выборки, описанной в разделе 8. В режиме интервала на краю выборки (x = n−1) линия характеризует разброс на баре, уже использованном при оценивании модели, поэтому трактовка «один из двадцати» напрямую здесь неприменима, а полосу лучше рассматривать как описательную границу на краю выборки, а не как прогноз.
Раздел 7: Геометрическая интерпретация эффекта расширения
Расширение обоих интервалов к границам окна часто неформально объясняют тем, что на краях данных меньше. Это описание неверно, и данное различие имеет значение для интерпретации.
Окно регрессии везде содержит ровно n наблюдений; градиента плотности данных нет. Расширение является следствием геометрии проекционной матрицы. При подборе прямой регрессии к облаку точек коэффициент наклона оценивается, по сути, путём поворота прямой вокруг центра тяжести данных (x̄, ȳ). Небольшие изменения коэффициента наклона, обусловленные неопределённостью его оценки, приводят к большим смещениям прямой регрессии в точках, удалённых от x̄, и к малым смещениям вблизи x̄.
Формально, если оценка коэффициента наклона β₁ имеет стандартную ошибку SE(β₁) = s/√Sxx, то неопределенность в ŷ(x) равна:
var(ŷ(x)) = s² · [ 1/n + (x − x̄)² / Sxx ]
Член (x − x̄)² растёт квадратично с увеличением расстояния от центроида. В точке x̄ этот член обращается в нуль, и остаётся только член 1/n. На краях окна, где x = 0 или x = n−1, отклонение составляет ±(n−1)/2, а рычаг наблюдения достигает максимального значения.
Раздел 8: Распределение остатков и диагностика модели
Корректно специфицированная модель МНК должна давать остатки, распределённые приблизительно нормально и имеющие постоянную дисперсию. Систематические отклонения свидетельствуют о неверной спецификации модели.
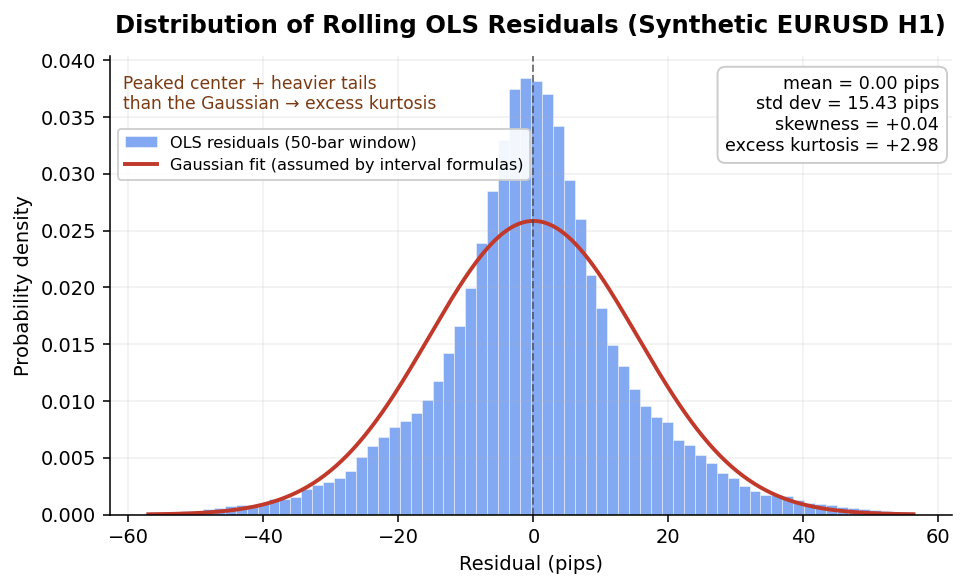
Распределение остатков скользящей регрессии по МНК с окном 50 баров по синтетическим ценам закрытия EURUSD на таймфрейме H1 с наложенной гауссовой кривой, соответствующей оценённой дисперсии остатков. Эмпирическое распределение имеет выраженный пик в центре и более тяжёлые хвосты, чем гауссово распределение (эксцесс ≈ +2,98), оставаясь при этом почти симметричным (коэффициент асимметрии ≈ +0,04). Такая лептокуртическая форма показывает, почему номинальную вероятность покрытия 95%-го прогнозного интервала следует считать приблизительной: при тяжёлых хвостах распределения остатки выходят за границы полосы чаще, чем предсказывает нормальная модель.
На практике остатки моделей цен финансовых инструментов часто характеризуются следующими свойствами:
- Эксцесс (тяжёлые хвосты): экстремальные значения остатков встречаются чаще, чем предсказывает нормальное распределение, из-за чего фактическая вероятность покрытия 95%-го прогнозного интервала оказывается ниже 95%; выходы за границы полос происходят чаще, чем предполагает номинальный уровень.
- Асимметрия: асимметричные распределения остатков, характерные для инструментов с направленным импульсом.
- Автокорреляция остатков: если статистика Дурбина — Уотсона существенно отклоняется от 2,0, стандартные ошибки МНК смещены, а ширина интервалов ненадёжна.
Ни одно из этих нарушений не делает вывод формул алгебраически неверным. Они приводят к отклонению вероятности покрытия от номинальных значений. Статистически грамотный пользователь этого индикатора рассматривает обозначения «95%» как результаты модели, справедливые при выполнении предпосылок МНК, и соответствующим образом интерпретирует их.
Эмпирическая вероятность покрытия и робастные альтернативы
Поскольку номинальная вероятность покрытия 95% — это утверждение модели, ее следует проверять, а не принимать на веру. Минимальная эмпирическая проверка заключается в определении на длительном участке данных вне выборки доли баров, цена закрытия которых выходит за пределы 95%-го прогнозного интервала для прогноза на один шаг вперед, рассчитанного при x = n. При корректной спецификации модели эта доля должна быть близка к 5%; существенно более высокая частота выходов за границы интервала прямо свидетельствует о том, что в текущем рыночном режиме нарушаются предпосылки модели — чаще всего гомоскедастичность или нормальность распределения ошибок. В более полном исследовании эту проверку повторяют для разных инструментов и таймфреймов, а частоту выходов за границы интервала сравнивают с соответствующей частотой для огибающей Боллинджера сопоставимой ширины.
Два структурных усовершенствования позволяют учесть наиболее распространенные нарушения предпосылок. Во-первых, оценивание регрессии по логарифмам цен или разностям цен вместо исходных уровней цен уменьшает близость ряда к нестационарности, из-за которой остатки регрессии по исходным ценам обладают сильной автокорреляцией. Во-вторых, замена стандартной ошибки регрессии s, рассчитанной в предположении гомоскедастичности, на оценку, устойчивую к гетероскедастичности (например, HC3), или на оценку, состоятельную при гетероскедастичности и автокорреляции (например, оценку Ньюи — Уэста), либо отдельное моделирование условной дисперсии с помощью спецификации типа GARCH позволяет получать интервалы, ширина которых адаптируется к кластеризации волатильности. Это естественные расширения представленной здесь архитектуры: изменится только модуль дисперсии остатков, тогда как модули МНК, t-распределения и интервалов останутся без изменений.
Раздел 9: Сравнение индикаторов каналов
| Индикатор | Фактор, определяющий ширину | Зависимость от положения | Статистическая интерпретация |
|---|---|---|---|
| Канал Дончиана | Диапазон между историческими максимумом и минимумом | Нет | Описательная характеристика экстремумов |
| Полосы Боллинджера | Выборочное стандартное отклонение × фиксированный множитель | Нет (одинаковая ширина) | Эвристическая огибающая волатильности |
| Доверительный интервал МНК | Неопределенность оценки среднего | Да — минимальная ширина при x̄ | Неопределенность оценки тренда |
| Прогнозный интервал МНК | Неопределенность оценки среднего + неопределенность отдельного наблюдения | Да — минимальная ширина при x̄ | Неопределенность для отдельного наблюдения |
Ключевым структурным отличием является зависимость от положения. Полосы Боллинджера формируют симметричную огибающую постоянной ширины независимо от положения бара в окне скользящего среднего. Каналы регрессии формируют огибающие, ширина которых зависит от положения: она минимальна в центре окна регрессии и детерминированно увеличивается к обоим краям. Эта асимметрия является прямым следствием статистической модели, а не стилистическим приёмом.
Полосы Боллинджера не следует считать статистически некорректными. Они представляют собой чётко определённый описательный инструмент для измерения волатильности относительно скользящего среднего. Их ограничение состоит в том, что они не дают формальных вероятностных утверждений и не могут быть откалиброваны на заданную вероятность покрытия без явного задания генеративной модели.
Заключение
В данной статье представлена полная реализация на MQL5 каналов линейной регрессии, основанных на оценивании по МНК, критических значениях t-распределения Стьюдента и формальных доверительных и прогнозных интервалах. Коэффициент наклона и свободный член оцениваются за один проход по каждому окну, дисперсия остатков рассчитывается со знаменателем n−2, учитывающим два оцениваемых параметра, а критические значения t-распределения Стьюдента — полученные с помощью приближения на основе разложения Корниша — Фишера, результаты которого следует сверять с эталонной таблицей, — заменяют фиксированный множитель нормального распределения, используемый в описательных каналах.
Практическое значение этой реализации определяется двумя ключевыми различиями. Во-первых, доверительный интервал описывает неопределённость оценки тренда, тогда как более широкий прогнозный интервал дополнительно учитывает разброс отдельного наблюдения; оба интервала сужаются в центре окна и расширяются к краям по мере увеличения рычага наблюдения. Во-вторых, полоса, рассчитанная при x = n−1, относится к краю выборки и остаётся внутри неё, тогда как полоса при x = n представляет собой настоящий прогноз на один шаг вперед; индикатор позволяет выбирать между этими режимами, чтобы отображаемый канал можно было корректно обозначить. Во всех случаях номинальная вероятность покрытия 95% точна лишь в рамках модели. Для финансовых цен, где предположения о независимости остатков, гомоскедастичности, нормальности и стационарности регулярно нарушаются, это обоснованное приближение, которое следует подтверждать эмпирической проверкой фактической вероятности покрытия, а не принимать как данность.
С точки зрения реализации вычислительные затраты на каждый бар определяются проходом по окну цен со сложностью O(n); постоянный множитель уже уменьшен за счёт предварительного вычисления неизменных статистик по x, а использование обновляемых сумм позволяет снизить сложность до O(1). Для отображения используются пять отдельных графических построений DRAW_LINE, чтобы обойти проблемы MetaTrader 5 с перекрывающимися заливками и отсутствие поддержки альфа-канала. Калибровка ширины канала на основе явно заданной модели и её фактического числа степеней свободы, а не эвристического множителя, делает такие каналы более понятными с точки зрения их статистической интерпретации, чем полосы Боллинджера или каналы Дончиана. Однако заявленную вероятность покрытия необходимо проверить, прежде чем использовать эти каналы в качестве вероятностных сигналов.
Программы, использованные в статье
| # | Название | Тип | Описание |
|---|---|---|---|
| 1 | OLSStatistics.mqh | Подключаемый файл | Оценивает линию регрессии по МНК для каждого окна цен закрытия, возвращая коэффициент наклона, свободный член и сумму квадратов остатков (SSE); принимает неизменные статистики по оси x в качестве входных данных, чтобы они вычислялись один раз, а не на каждом баре. |
| 2 | ResidualAnalysis.mqh | Подключаемый файл | Вычисляет дисперсию остатков и стандартную ошибку регрессии на основе суммы квадратов остатков (SSE), используя деление на число степеней свободы n−2, оставшихся после оценки коэффициента наклона и свободного члена. |
| 3 | TDistribution.mqh | Подключаемый файл | Вычисляет критическое значение t-распределения Стьюдента для любого числа степеней свободы и доверительного уровня с помощью приближения на основе разложения Корниша — Фишера и при недопустимых входных данных выдаёт однозначный сигнал об ошибке вместо подстановки резервного значения. |
| 4 | ConfidenceInterval.mqh | Подключаемый файл | Вычисляет доверительный интервал вокруг линии регрессии — полосу, описывающую неопределённость оценки самого тренда, и определяет общую структуру данных для полос, которую также использует модуль расчёта прогнозного интервала. |
| 5 | PredictionInterval.mqh | Подключаемый файл | Вычисляет более широкий прогнозный интервал, в котором к неопределённости тренда добавляется разброс отдельного наблюдения и который тем самым описывает ожидаемый диапазон для отдельной ценовой точки. |
| 6 | RegressionChannels.mq5 | Пользовательский индикатор | Основной индикатор, объединяющий модули. Выполняет скользящую регрессию бар за баром, отображает линию регрессии и четыре границы интервалов в виде пяти отдельных линий, позволяет пользователю выбирать между полосой интервалов на краю выборки и полосой прогноза на один шаг вперед, проверяет собственные константы настройки и выводит диагностическую сводку в журнал «Эксперты». |
| 7 | Linear_Regression.zip | Архив в формате ZIP | ZIP-архив, содержащий все прилагаемые файлы с сохранением их путей относительно корневой папки терминала. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/23130
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 Создание индикатора EquiVolume на языке MQL5
 Нейросети в трейдинге: Habi — быстрое принятие решений без сложного планирования (формирование и оценка действий)
 Конструирование признаков для машинного обучения (Часть 8): Энтропийные признаки в MQL5
 Возможности Мастера MQL5, которые вам нужно знать (Часть 99): Использование KD-дерева и эхо-сети (ESN) в пользовательском классе управления капиталом

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования
Отличное исследование и статья, подготовленные вами. Я воспользуюсь вашими рекомендациями и наблюдениями. Надеюсь, это будет очень полезно.