

MetaTrader 5 как производитель сообщений Kafka: Рассылка сигналов нескольким торговым терминалам
 29
 0

Введение
До сих пор каждая статья этой серии о мостах была посвящена взаимодействию "один к одному". Вызов функции из библиотеки типа cdylib на Rust обслуживает одного вызывающего клиента. Отображение общей памяти связывает ровно два процесса на одной машине. Канал gRPC обслуживает одного клиента, взаимодействующего с одним сервером. Все они являются соединениями "точка-точка", и все они предполагают, что вы заранее знаете, кто находится на другом конце.
Это предположение перестаёт работать, как только вместо одного робота вам нужна целая система работы с сигналами. Предположим, что один терминал MetaTrader 5 вычисляет сигнал импульса по XAUUSD. Этот сигнал нужно доставить на панель мониторинга, в сервис расчёта размера позиции с учётом риска и на два терминала для копирования сигналов, торгующих коррелирующими парами. При этом производитель не должен знать, сколько существует получателей и находятся ли они сейчас в сети. Это уже не задача для моста. Это задача для шины событий, и стандартный отраслевой инструмент для её решения — Apache Kafka.
В этой статье показано, как создать производителя Kafka непосредственно на MQL5 без внешней DLL, вспомогательного процесса на Python или ALGLIB. Прямое использование TCP-сокетов без дополнительных библиотек и собственная реализация сетевого протокола Kafka: кодирование varint, контрольные суммы CRC32C и двоичный формат RecordBatch v2, который ожидает каждый современный брокер Kafka. В итоге ваш советник сможет публиковать структурированные торговые сигналы прямо в топик Kafka, а любое число независимых потребителей сможет подписываться на него и выполнять повторное чтение истории с любого смещения, ни разу не обращаясь к вашему терминалу MetaTrader 5.
Границы рассмотрения: в этой статье рассматривается только сторона производителя. Брокер Kafka изначально поддерживает рассылку нескольким потребителям и повторное чтение — именно ради этого его и используют, поэтому логика групп потребителей здесь не реализована. Сопутствующий скрипт на Python содержит минимальную реализацию потребителя исключительно для проверки того, что записи, создаваемые нашим кодировщиком на MQL5, соответствуют спецификации, а не в качестве шаблона потребителя для промышленной эксплуатации.
Почему бы просто не расширить мост на основе общей памяти или gRPC?
Стоит прямо объяснить, почему это не просто "та же статья о gRPC, только с другими байтами": эти два подхода действительно решают разные типы задач.
И мост gRPC/Protobuf, и мост на основе общей памяти Windows предполагают наличие определённой пары конечных точек, обменивающихся синхронными или почти синхронными сообщениями. Добавьте третьего потребителя к любой из этих архитектур — и вам придётся поддерживать N отдельных соединений от терминала-производителя, каждое со своей логикой повторных попыток, своей обработкой обратного давления и своим сценарием отказа при отключении потребителя на другом конце. Сложность производителя растёт с увеличением числа потребителей.
Kafka меняет эту зависимость на противоположную. Терминал-производитель записывает каждый сигнал в один топик ровно один раз. Брокер отвечает за сохранность данных, порядок записей в пределах раздела и доставку любому числу потребителей, которые решат подписаться, — включая тех, которых ещё нет на момент публикации. Панель мониторинга, запущенная тремя часами позже, всё равно сможет выполнить повторное чтение всех сигналов начиная с нулевого смещения. Ни одна из архитектур мостов, рассмотренных ранее в этой серии, не предоставляет такой возможности: они служат механизмами передачи, а Kafka — механизмом распространения данных. Именно на этом различии и основана данная статья, и именно поэтому эти два подхода следует рассматривать как взаимодополняющие, а не как конкурирующие способы решения одной и той же проблемы.
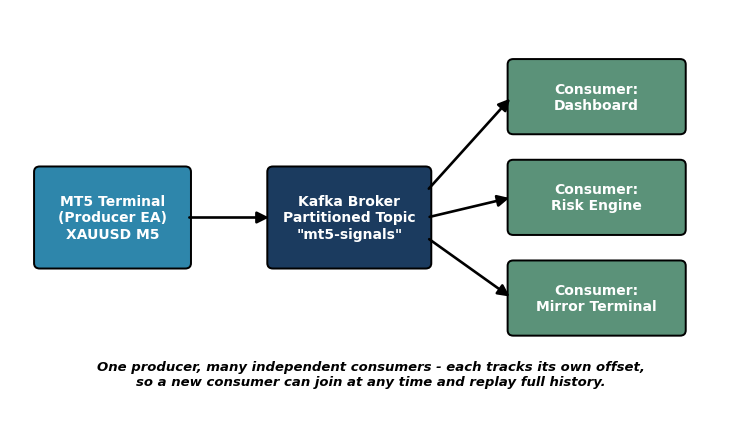
Рис. 1. Один терминал MetaTrader 5 публикует данные в топик Kafka; независимые потребители в любом количестве подписываются на него и отслеживают собственные смещения.
Краткий курс по сетевому протоколу Kafka
Клиентские библиотеки Kafka скрывают немало деталей работы с двоичными данными, а поскольку мы не можем использовать внешнюю DLL, нужные механизмы придётся реализовать вручную. Практически всю работу выполняют три примитива.
Поля фиксированной длины с порядком байтов от старшего к младшему. Все поля заголовка запроса и большинство полей внешней структуры запросов и ответов — это обычные целые числа int16, int32 и int64 с порядком байтов от старшего к младшему. Архитектура x86 использует порядок байтов от младшего к старшему, поэтому при записи каждого многобайтового значения нужно явно переставлять байты, а не полагаться на наложение структуры на буфер.
Целые числа varint по основанию 128 с кодированием ZigZag. Внутри RecordBatch поля отдельных записей, такие как разность временных меток и длины ключа и значения, кодируются в формате varint: каждый байт содержит 7 бит полезных данных и один бит продолжения. Знаковые значения сначала преобразуются в беззнаковые с помощью кодирования ZigZag, чтобы небольшие отрицательные числа сохраняли компактное представление, а не занимали десять байтов, как при наивном varint-кодировании чисел в дополнительном коде.
CRC32C (Кастаньоли). Для каждого RecordBatch вычисляется контрольная сумма с помощью алгоритма CRC32C — обратите внимание, что здесь используется другой многочлен, чем в классическом алгоритме CRC-32, применяемом в ZIP-файлах, поэтому здесь нельзя использовать стандартную процедуру вычисления CRC. Во время выполнения мы один раз строим таблицу поиска из 256 элементов на основе отражённой формы полинома 0x82F63B78, а затем используем её для каждого пакета записей.
Есть и четвертый элемент — скорее соглашение о формировании границ сообщений, чем примитив, но он вызывает трудности не реже остальных: каждый запрос, который Kafka получает по сети, имеет префикс длины на самом внешнем уровне, независимо от своего содержимого. Первые четыре байта любого запроса представляют собой целое число типа int32, указывающее размер всего последующего содержимого — без учета самих этих четырёх байтов. Ответ устроен аналогично: сначала считываются четыре байта, которые указывают, сколько ещё байтов нужно прочитать, чтобы получить полный ответ. Если при формировании внешних границ сообщения допустить ошибку на четыре байта, явной ошибки протокола, как правило, не будет. Брокер просто перестанет отвечать, потому что будет продолжать ждать байты, которые вы так и не отправили, либо ошибочно примет начало следующего запроса за оставшуюся часть данных предыдущего. Цикл приема данных из сокета в KafkaProducer.mqh сначала считывает этот префикс длины в отдельном коротком цикле, корректно обрабатывающем частичное чтение, и лишь затем приступает к разбору остальных данных.
Для версии API, не использующей гибкий формат (например, Produce v7), заголовок запроса содержит четыре поля: api_key (int16, 0 для Produce), api_version (int16, 7), correlation_id (int32, выбранное вами значение, которое брокер Kafka возвращает в ответе, чтобы можно было сопоставлять ответы с запросами при наличии нескольких запросов, ожидающих ответа в одном соединении) и client_id (строка, допускающая значение null и используемая в основном для журналирования на стороне брокера Kafka и контроля квот, а не для основной логики обработки запросов). За этим заголовком следует тело запроса, структура которого зависит от API; в нашем случае оно содержит настройку подтверждений (acks), тайм-аут и описанную ниже вложенную структуру "топик/раздел/записи".
Два компонента, приведенные ниже, и составляют основу работы кодировщика RecordBatch. Всё остальное в этой статье строится на основе этих двух компонентов.
//+------------------------------------------------------------------+
//| KafkaVarintEncodeU                                               |
//| Unsigned base-128 varint encoder                                 |
//+------------------------------------------------------------------+
int KafkaVarintEncodeU(ulong value, uchar &buf[], int offset)
  {
   int pos = offset;
   while(value >= 0x80)
     {
      buf[pos++] = (uchar)((value & 0x7F) | 0x80);
      value >>= 7;
     }
   buf[pos++] = (uchar)(value & 0x7F);
   return pos - offset;
  }

//+------------------------------------------------------------------+
//| KafkaCRC32CInitTable                                             |
//| CRC32C lookup table, built once from the reflected Castagnoli    |
//| polynomial                                                       |
//+------------------------------------------------------------------+
void KafkaCRC32CInitTable()
  {
   uint poly = 0x82F63B78;
   for(uint i = 0; i < 256; i++)
     {
      uint crc = i;
      for(int j = 0; j < 8; j++)
         crc = ((crc & 1) != 0) ? (crc >> 1) ^ poly : crc >> 1;
      g_kafka_crc32c_table[i] = crc;
     }
  }
Формирование полезной нагрузки RecordBatch v2
RecordBatch — это двоичная структура, в которой передаются ваши сигналы. В начале RecordBatch находится фиксированный заголовок длиной 61 байт: смещения, эпоха, магический байт, CRC, метки времени и поля идемпотентности производителя, которым мы присваиваем специальные значения "не используется", поскольку не реализуем доставку "ровно один раз". За заголовком следуют отдельные записи, каждая из которых предваряется длиной, закодированной как varint, а не полем фиксированного размера.
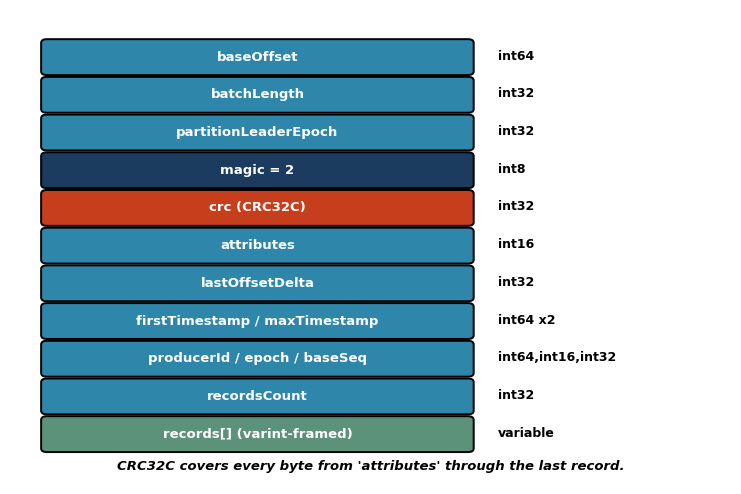
Рис. 2. Структура полей RecordBatch v2. Контрольная сумма CRC32C охватывает все данные от поля 'attributes' до последней записи включительно — если ошибиться с диапазоном, любой брокер отклонит пакет записей с ошибкой CORRUPT_MESSAGE.
Сложность не в каком-то отдельном поле, а в том, что кодирование выполняется в два прохода. Общую длину пакета записей и его CRC нельзя определить, пока не будут записаны все записи, однако оба поля расположены ближе к началу буфера. Решение — тот же прием, который использовался в других частях этой серии для протоколов с префиксом длины: записать нулевые заглушки, сохранить их байтовые смещения, а затем записать окончательные значения по сохраненным смещениям.
// batchLength placeholder — patched after we know the size
int batchLengthOffset = buf.Length();
buf.WriteInt32BE(0);

// ... write partitionLeaderEpoch, magic byte, crc placeholder ...

int crcRangeStart = buf.Length();
buf.WriteInt16BE(0);              // attributes
buf.WriteInt32BE(count - 1);      // lastOffsetDelta
// ... timestamps, producer fields, recordsCount, then every record ...

int crcRangeLen = buf.Length() - crcRangeStart;
uint crc = buf.CrcRange(crcRangeStart, crcRangeLen);
buf.PatchInt32BE(crcOffset, (int)crc);

int totalBatchLength = buf.Length() - (batchLengthOffset + 4);
buf.PatchInt32BE(batchLengthOffset, totalBatchLength);
Перед записью каждой отдельной записи в пакете записей также необходимо вычислить её длину, поскольку первым числом varint в записи является именно эта длина. Мы вычисляем размер каждого поля — байта атрибутов, разности временных меток с кодированием ZigZag, разности смещений с кодированием ZigZag, длины ключа и байтов ключа, длины значения и байтов значения, а также нулевого счетчика заголовков, — складываем эти размеры, записываем сумму в начале записи в формате varint, а затем записываем сами поля. Если пропустить этот шаг, брокер Kafka вернет ошибку с раздражающе расплывчатым сообщением, из которого непонятно, какой именно байт неверен.
Схема сигнала и контракт признаков
Во всех статьях этой серии, где данные передаются между процессами или через транспортный интерфейс, соблюдается одно и то же требование: константа времени компиляции, фактический результат сериализации и метка версии, проверяемая во время выполнения, должны быть согласованы. Производитель Kafka — не исключение, хотя модель ONNX здесь не используется: это требование касается контракта сетевого обмена, а не только машинного обучения.
Значение KAFKA_SIGNAL_SCHEMA_VERSION включается в каждую запись JSON в поле schema_version. Значение KAFKA_SIGNAL_FIELD_COUNT один раз в OnInit() сверяется с фактическим количеством полей, выдаваемых сериализатором. Если при последующих изменениях в структуру добавят поле, но не обновят константу, OnInit() прервет инициализацию, вместо того чтобы допустить незаметную отправку записей, которые потребитель далее по цепочке не сможет корректно разобрать. Здесь это важнее, чем в конвейере машинного обучения, работающем в одном процессе: некорректная запись в Kafka нарушает работу не только вашего терминала, но и всех потребителей, подписанных на этот топик, — возможно, лишь спустя несколько часов, когда кто-нибудь наконец прочитает запись по этому смещению.
//+------------------------------------------------------------------+
//| KafkaSignalToJson                                                |
//+------------------------------------------------------------------+
string KafkaSignalToJson(const SignalRecord &sig)
  {
   if(sig.schema_version != KAFKA_SIGNAL_SCHEMA_VERSION)
     {
      PrintFormat("FATAL contract mismatch - record tagged v%d, producer built for v%d",
                  sig.schema_version, KAFKA_SIGNAL_SCHEMA_VERSION);
      return "";  // caller treats empty string as a hard refusal to produce
     }
   return StringFormat(
      "{\"schema_version\":%d,\"symbol\":\"%s\",\"timeframe\":\"%s\",\"signal_type\":\"%s\","
      "\"entry\":%.5f,\"sl\":%.5f,\"tp\":%.5f,\"confidence\":%.4f,\"timestamp_ns\":%I64u}",
      sig.schema_version, sig.symbol, sig.timeframe, sig.signal_type,
      sig.entry, sig.sl, sig.tp, sig.confidence, sig.timestamp_ns);
  }
Распределение записей по разделам тоже имеет значение. Каждая запись содержит ключ вида symbol_timeframe — например, XAUUSD_PERIOD_M5. Kafka гарантирует порядок записей только в пределах одного раздела, а неизменный ключ обеспечивает попадание всех записей для одной пары "инструмент/таймфрейм" в один и тот же раздел. Поэтому потребитель никогда не получит сигнал SELL_BIAS раньше предшествующего ему сигнала BUY_BIAS, даже при перебалансировке на стороне брокера Kafka.
Цикл запросов производителя: пакетная отправка, подтверждения (acks) и повторные попытки
Советник не отправляет отдельный запрос Kafka на каждом тике — это перегрузило бы брокер и свело бы на нет пользу пакетной отправки. Вместо этого CKafkaProducer::Enqueue() добавляет каждый сигнал в очередь в оперативной памяти, а отправка накопленного пакета запускается либо по миллисекундному таймеру (InpFlushEveryMs, по умолчанию 250 мс), либо при достижении порогового количества записей (InpFlushBatchSize) — в зависимости от того, что произойдет раньше. Это задает предсказуемую верхнюю границу задержки публикации, не засыпая брокер Kafka запросами в периоды низкой активности рынка.
При отправке пакета формируется один ProduceRequest (ключ API 0, версия 7 — последняя негибкая версия, специально выбранная, чтобы избежать усложнений, связанных с компактными строками и полями с тегами, которые гибкие версии добавляют помимо заголовка). Затем запрос отправляется, и выполнение блокируется до получения ответа или истечения заданного тайм-аута. При отклонении запроса брокером Kafka или сбое на уровне сокета производитель повторяет попытки с экспоненциальным увеличением задержки между попытками, каждый раз закрывая и заново открывая сокет, а не полагаясь на исправность прежнего TCP-соединения: брокеры Kafka действительно закрывают неактивные соединения и соединения с ошибками, а SocketRead в MQL5 не сообщает об этом однозначно.
while(attempt <= KAFKA_MAX_RETRIES && !acked)
  {
   uchar req[]; int reqLen = KafkaBuildProduceRequest(m_topic, 0, m_client_id,
                        m_correlation_id, acks, 5000, m_pending, m_pendingCount, req);
   uchar respBody[]; int respLen = 0;
   bool io_ok = SendAndReceive(req, reqLen, respBody, respLen);

   if(io_ok)
     {
      KafkaProduceResult result = KafkaParseProduceResponse(respBody, respLen);
      if(result.success) { acked = true; m_produce_acked += m_pendingCount; }
     }
   if(!acked)
     {
      attempt++; m_retry_count++;
      int backoff = KAFKA_RETRY_BASE_MS * (1 << (attempt - 1));
      Sleep(backoff);
      CloseSocket();  // force a clean reconnect before retrying
     }
  }
Параметр подтверждений (acks) вынесен во входные параметры, а не задан жестко в коде, поскольку подходящая настройка действительно зависит от публикуемых данных. Значение acks = 0 ("отправил и забыл") подходит для высокочастотного потока телеметрии, где потеря отдельного тика несущественна. Значение acks = 1 (подтверждение от лидера раздела) используется здесь по умолчанию и представляет собой разумный компромисс для торговых сигналов. Значение acks = -1 (подтверждение от всех синхронизированных реплик (ISR)) стоит выбрать, если система управления рисками далее по цепочке принимает решения о размере позиции на основе этого потока и потеря сигнала создает реальную проблему. Платой за это будет более высокая задержка при каждой отправке накопленных записей.
Одно намеренное упрощение: производитель подключается к фиксированному хосту/порту и всегда обращается к разделу 0. Он не отправляет запрос Metadata для определения текущего лидера раздела. Это разумный выбор для среды разработки с одним брокером Kafka или небольшого кластера с фиксированным составом, топологию которого вы контролируете. Такой подход позволяет ограничить рассмотрение протокола в этой статье запросом Produce, не углубляясь в обработку метаданных кластера. Для промышленного кластера с несколькими брокерами Kafka путь повышения надежности прост: добавить запрос Metadata (ключ API 3) в OnInit(), кэшировать сопоставление лидеров разделов с брокерами Kafka и переподключаться к нужному лидеру раздела, если ProduceResponse возвращает ошибку NOT_LEADER_OR_FOLLOWER. Структура цикла повторных попыток уже позволяет добавить такую обработку: достаточно между попытками заново определять лидера раздела, а не просто закрывать и снова открывать тот же сокет.
Метрики и ведение журнала с использованием FILE_COMMON
При каждой отправке накопленного пакета — успешной или нет — в CSV-файл в папке Common Files терминала добавляется строка с использованием флага FILE_COMMON. Тот же подход применяется в других частях этой серии, чтобы обеспечить общий доступ к данным разных агентов. Это особенно важно в тестере стратегий, где каждый агент оптимизации работает в собственном изолированном каталоге MQL5\Files: без FILE_COMMON журналы оказались бы разбросаны по каталогам отдельных агентов вместо того, чтобы их можно было объединить в общий журнал всего прогона.
Поля журнала — метка времени, тип события, задержка отправки пакета, суммарное число попыток, счетчики подтверждений (acked), ошибок (failed) и повторных попыток (retries) — это именно те данные, которые сопутствующий скрипт на Python использует для построения графиков пропускной способности далее в статье. Этот механизм ведения журнала никак не зависит от доступности брокера Kafka: в журнал попадает только то, что сам производитель зафиксировал при каждой попытке.
Внутри восьми файлов: что реализовано в каждом и почему
В предыдущих разделах были рассмотрены основные понятия протокола. В этом разделе описаны восемь файлов MQL5 из архива — от самых низкоуровневых примитивов до советника. Приведены еще не показанный код, полный состав членов классов там, где это уместно, и обоснование каждого проектного решения. Здесь нет ничего лишнего: каждая из перечисленных ниже функций вызывается в приведенных ранее фрагментах кода статьи, а этот раздел объясняет, как на самом деле работает каждый такой вызов.
KafkaVarint.mqh — что реализует: два низкоуровневых способа кодирования, от которых зависит каждое поле RecordBatch: беззнаковые varint по основанию 128 и кодирование ZigZag, обеспечивающее компактное представление знаковых разностей. Как: показанный ранее кодировщик выделяет по 7 бит на байт и использует флаг продолжения; ниже приведены еще не показанные преобразование ZigZag и вариант функции, который только вычисляет длину, чтобы определить размер записи перед ее записью в буфер:
//+------------------------------------------------------------------+
//| KafkaZigZagEncode                                                |
//| Maps signed -> unsigned so small negatives stay compact, not 10  |
//| bytes long                                                       |
//+------------------------------------------------------------------+
ulong KafkaZigZagEncode(long value)
  {
   return (ulong)((value << 1) ^ (value >> 63));
  }

//+------------------------------------------------------------------+
//| KafkaVarintZigZagLen                                             |
//| Computes the encoded byte length WITHOUT writing anything -      |
//| needed because a record's own leading varint must state its      |
//| length before we know the buffer position, so we calculate first,|
//| write second                                                     |
//+------------------------------------------------------------------+
int KafkaVarintZigZagLen(long value)
  {
   ulong u = KafkaZigZagEncode(value);
   int n = 1;
   while(u >= 0x80) { u >>= 7; n++; }
   return n;
  }
Почему именно такая структура: при наивном подходе каждое поле записи кодировалось бы непосредственно в выходной буфер по мере его вычисления. Здесь это не сработает, поскольку самое первое поле записи — это значение varint, задающее длину всех последующих данных в байтах, а узнать эту длину можно лишь после кодирования этих полей. Вместо кодирования во временный буфер с последующим копированием мы обрабатываем каждое поле дважды: сначала вычисляем длину его закодированного представления с помощью KafkaVarintZigZagLen(), чтобы получить общую длину, затем выполняем само кодирование и запись с помощью KafkaVarintEncodeZigZag(). Это требует небольшого количества лишних арифметических вычислений, но позволяет избежать использования второго буфера и копирования каждой отдельной записи.
KafkaCRC32C.mqh — что реализует: вычисление контрольной суммы, которой снабжается каждый RecordBatch. Как: построение таблицы поиска из 256 элементов было показано ранее; ниже приведена функция, которая вычисляет контрольную сумму заданного диапазона байтов с помощью этой таблицы:
//+------------------------------------------------------------------+
//| KafkaCRC32C                                                      |
//+------------------------------------------------------------------+
uint KafkaCRC32C(const uchar &data[], int offset, int length)
  {
   KafkaCRC32CInitTable();
   uint crc = 0xFFFFFFFF;
   for(int i = 0; i < length; i++)
     {
      uchar b = data[offset + i];
      crc = g_kafka_crc32c_table[(crc ^ b) & 0xFF] ^ (crc >> 8);
     }
   return crc ^ 0xFFFFFFFF;
  }
Почему используется таблица, а не побитовое вычисление каждый раз: CRC32C для всего RecordBatch вычисляется при каждой отправке накопленного пакета — потенциально сотни раз за сеанс. При побитовом вычислении CRC на каждый байт приходится восемь операций сдвига с ветвлением; в табличном варианте — одно обращение к таблице и две операции XOR. Таблица строится за 256 итераций всего один раз, при первом использовании, — эти затраты ничтожны по сравнению с суммарной экономией при каждой отправке накопленного пакета за весь сеанс.
KafkaByteBuffer.mqh — что это: расширяемый байтовый буфер, в который записываются данные из всех остальных файлов. Код, использующий этот файл, не обращается к массивам напрямую: все операции проходят через этот буфер. Как это работает: небольшой класс оборачивает динамический массив uchar[] и предоставляет методы записи с порядком байтов от старшего к младшему, поскольку именно такой порядок используется при формировании границ сообщений Kafka, в отличие от порядка байтов на x86:
//+------------------------------------------------------------------+
//| CKafkaByteBuffer                                                 |
//+------------------------------------------------------------------+
class CKafkaByteBuffer
  {
private:
   uchar m_buf[];
   int m_len;
public:
   int Length() const;
   void Reset();
   void GetBytes(uchar &out[]);
   void WriteInt8(char v);
   void WriteInt16BE(short v);
   void WriteInt32BE(int v);
   void WriteInt64BE(long v);
   void WriteRaw(const uchar &src[], int srcLen);
   void WriteString(const string &s);
   void WriteNullableString(const string &s);
   void WriteBytes(const uchar &src[], int srcLen);
   void WriteVarintZigZag(long v);
   void WriteVarintU(ulong v);
   void PatchInt32BE(int atOffset, int v);
   uchar ByteAt(int i) const;
   uint CrcRange(int fromOffset, int length);
  };
Код двух из этих методов стоит привести здесь, поскольку именно они устраняют упомянутую ранее проблему с UTF-8:
//+------------------------------------------------------------------+
//| WriteString                                                      |
//+------------------------------------------------------------------+
void WriteString(const string &s)
  {
   uchar utf[];
   int n = StringToUtf8(s, utf);  // forces CP_UTF8, not the terminal's ANSI default
   WriteInt16BE((short)n);
   WriteRaw(utf, n);
  }

//+------------------------------------------------------------------+
//| PatchInt32BE                                                     |
//+------------------------------------------------------------------+
void PatchInt32BE(int atOffset, int v)
  {
   m_buf[atOffset]     = (uchar)((v >> 24) & 0xFF);
   m_buf[atOffset+1] = (uchar)((v >> 16) & 0xFF);
   m_buf[atOffset+2] = (uchar)((v >> 8) & 0xFF);
   m_buf[atOffset+3] = (uchar)(v & 0xFF);
  }
Зачем вообще нужен метод записи окончательного значения по сохраненному смещению: именно ради него эта реализация оформлена как класс, а не как свободная функция. Для длины RecordBatch и его CRC сначала записываются нулевые заглушки, которые заменяются окончательными значениями после их вычисления. Метод PatchInt32BE позволяет безопасно записать окончательное значение по сохраненному смещению непосредственно в m_buf, а не добавить его в конец. Во всех трех случаях — для длины пакета записей, CRC и размера внешнего запроса — используется один и тот же метод, а не ручное обращение к элементам массива по индексам в трех разных местах.
KafkaSignalSchema.mqh — что это: структура и функции, определяющие представление сигнала при передаче по сети, а также проверка контракта схемы данных, не допускающая сериализацию некорректного сигнала. Как это работает: ниже структура приведена целиком в одном месте, а не описана по частям в тексте:
//+------------------------------------------------------------------+
//| SignalRecord                                                     |
//+------------------------------------------------------------------+
struct SignalRecord
  {
   int    schema_version;
   string symbol;
   string timeframe;
   string signal_type;  // "BUY_BIAS", "SELL_BIAS"
   double entry;
   double sl;
   double tp;
   double confidence;  // 0.0 - 1.0
   ulong  timestamp_ns;
  };

//+------------------------------------------------------------------+
//| KafkaSignalPartitionKey                                          |
//| Stable per-instrument key so every record for one                |
//| symbol/timeframe lands on the same partition, preserving order   |
//| for that instrument                                              |
//+------------------------------------------------------------------+
string KafkaSignalPartitionKey(const SignalRecord &sig)
  {
   return sig.symbol + "_" + sig.timeframe;
  }

//+------------------------------------------------------------------+
//| KafkaSignalContractCheck                                         |
//| Called once from OnInit() - the runtime half of the three-way    |
//| contract                                                         |
//+------------------------------------------------------------------+
bool KafkaSignalContractCheck()
  {
   int actual_fields = 9;
   if(actual_fields != KAFKA_SIGNAL_FIELD_COUNT)
     {
      PrintFormat("FATAL - serializer emits %d fields but KAFKA_SIGNAL_FIELD_COUNT=%d",
              actual_fields, KAFKA_SIGNAL_FIELD_COUNT);
      return false;
     }
   return true;
  }
Почему количество полей проверяется с помощью простого жестко запрограммированного числа, а не вычисляется с помощью рефлексии: MQL5 не поддерживает рефлексию структур во время выполнения, поэтому нет возможности узнать у объекта SignalRecord, сколько полей он содержит. Функция KafkaSignalContractCheck() служит единым местом, где актуальность этого числа нужно поддерживать вручную. Если кто-то добавит поле в структуру и код формирования JSON, не изменив эту функцию и #define, устаревшее число “9” останется в двух независимых местах, а не в одном. Это оставляет меньше возможностей для ошибок, чем незаметное рассогласование структуры и сериализатора.
KafkaRecordBatch.mqh — что это: двухпроходной кодировщик, принцип работы которого был рассмотрен ранее. Как это работает: ниже приведено еще не показанное тело цикла по записям — та часть, которая перебирает сигналы в очереди и записывает каждый из них:
//+------------------------------------------------------------------+
//| KafkaPendingRecord                                               |
//+------------------------------------------------------------------+
struct KafkaPendingRecord
  {
   string key;
   string value;
   ulong  timestamp_ms;
  };

for(int i = 0; i < count; i++)
  {
   uchar keyBytes[], valBytes[];
   int keyLen = StringToUtf8(records[i].key, keyBytes);
   int valLen = StringToUtf8(records[i].value, valBytes);
   long tsDelta = (long)(records[i].timestamp_ms - firstTs);
   long offsetDelta = (long)i;

   int bodyLen = 1;  // attributes byte
   bodyLen += KafkaVarintZigZagLen(tsDelta);
   bodyLen += KafkaVarintZigZagLen(offsetDelta);
   bodyLen += KafkaVarintZigZagLen(keyLen) + keyLen;
   bodyLen += KafkaVarintZigZagLen(valLen) + valLen;
   bodyLen += KafkaVarintZigZagLen(0);  // headerCount = 0, always

   buf.WriteVarintZigZag(bodyLen);
   buf.WriteInt8(0);
   buf.WriteVarintZigZag(tsDelta);
   buf.WriteVarintZigZag(offsetDelta);
   buf.WriteVarintZigZag(keyLen);
   buf.WriteRaw(keyBytes, keyLen);
   buf.WriteVarintZigZag(valLen);
   buf.WriteRaw(valBytes, valLen);
   buf.WriteVarintZigZag(0);
  }
Почему число заголовков жестко задано равным нулю, а их поддержка не реализована: формат записей Kafka позволяет добавлять к каждой записи произвольные заголовки в виде пар "ключ — значение", которые в некоторых конфигурациях используются для передачи метаданных трассировки. Мы намеренно не предоставляем возможности задавать их здесь: схема сигнала уже включает в JSON-значение все, что нужно потребителю, а каждое дополнительное необязательное поле приходится корректно учитывать при двухпроходном расчете длины. Отсутствие заголовков позволяет сосредоточить эти вычисления в одном месте и не ставить их в зависимость от того, какие поля заполнил вызывающий код.
KafkaProduceRequest.mqh — что это: файл, назначение которого было описано в разделе о сетевом протоколе, но код которого еще не приводился. Эта функция преобразует пакет записей в последовательность байтов, которая отправляется через сокет:
//+------------------------------------------------------------------+
//| KafkaBuildProduceRequest                                         |
//+------------------------------------------------------------------+
int KafkaBuildProduceRequest(const string &topic, int partition, const string &client_id,
                        int correlation_id, short acks, int timeout_ms,
                         const KafkaPendingRecord &records[], int recordCount, uchar &out[])
  {
   CKafkaByteBuffer buf;
   int sizeOffset = buf.Length();
   buf.WriteInt32BE(0);  // outer request-size placeholder

   buf.WriteInt16BE((short)KAFKA_API_KEY_PRODUCE);  // 0
   buf.WriteInt16BE((short)KAFKA_API_VERSION_PRODUCE);  // 7
   buf.WriteInt32BE(correlation_id);
   buf.WriteNullableString(client_id);

   buf.WriteNullableString("");  // transactional_id = null
   buf.WriteInt16BE(acks);
   buf.WriteInt32BE(timeout_ms);
   buf.WriteInt32BE(1);  // topic_data array length = 1
   buf.WriteString(topic);
   buf.WriteInt32BE(1);  // partition_data array length = 1
   buf.WriteInt32BE(partition);

   uchar recordBatch[];
   int rbLen = KafkaBuildRecordBatch(records, recordCount, recordBatch);
   buf.WriteBytes(recordBatch, rbLen);

   buf.PatchInt32BE(sizeOffset, buf.Length() - (sizeOffset + 4));
   buf.GetBytes(out);
   return buf.Length();
  }
А вот код обработки ответа: без разбора ответов брокера Kafka реализацию производителя нельзя считать завершенной:
//+------------------------------------------------------------------+
//| KafkaProduceResult                                               |
//+------------------------------------------------------------------+
struct KafkaProduceResult { bool success; short error_code; long base_offset; string error_text; };

//+------------------------------------------------------------------+
//| KafkaParseProduceResponse                                        |
//+------------------------------------------------------------------+
KafkaProduceResult KafkaParseProduceResponse(const uchar &buf[], int len)
  {
   KafkaProduceResult res; res.success = false;
   int pos = 0, topicCount;
   pos = KafkaReadInt32BE(buf, pos, topicCount);
   string topic; pos = KafkaReadString(buf, pos, topic);
   int partCount; pos = KafkaReadInt32BE(buf, pos, partCount);
   int partition; pos = KafkaReadInt32BE(buf, pos, partition);
   short errCode; pos = KafkaReadInt16BE(buf, pos, errCode);
   long baseOffset; pos = KafkaReadInt64BE(buf, pos, baseOffset);
   res.error_code = errCode; res.base_offset = baseOffset;
   res.success = (errCode == 0);
   return res;
  }
Почему запрос формируется заново при каждой отправке накопленного пакета, а не используется повторно с изменениями: между такими отправками меняются только correlation_id, пакет записей и размер внешнего запроса; все остальное (имя топика, раздел, client_id) остается неизменным на протяжении всей работы советника. Тем не менее мы каждый раз заново формируем весь буфер, а не кэшируем шаблон, чтобы затем записать окончательные значения по сохраненным смещениям: пакет записей занимает основную часть буфера, и его в любом случае приходится формировать с нуля. Кэширование неизменного префикса сэкономило бы лишь несколько небольших операций записи, но потребовало бы второго варианта кода, который пришлось бы поддерживать в согласованном состоянии с первым. При таком объеме сообщений это не стоит того.
KafkaProducer.mqh — что это: класс, работу которого в конечном счете обеспечивают все перечисленные выше файлы: он управляет сокетом, очередью записей, ожидающих отправки, и политикой повторных попыток. Как это работает: цикл повторных попыток и метод Enqueue были показаны ранее; ниже приведен состав полей класса, который до сих пор лишь подразумевался, но не был указан явно:
//+------------------------------------------------------------------+
//| CKafkaProducer                                                   |
//+------------------------------------------------------------------+
class CKafkaProducer
  {
private:
   string m_host; int m_port; string m_topic, m_client_id;
   int m_socket, m_correlation_id;
   KafkaPendingRecord m_pending[]; int m_pendingCount, m_flushThreshold;
   long m_produce_attempts, m_produce_acked, m_produce_failed, m_retry_count;
   string m_metrics_file;
   bool ConnectSocket();  void CloseSocket();
   bool SendAndReceive(const uchar &req[], int reqLen, uchar &respBody[], int &respLen);
   void LogMetrics(const string &event, double latency_ms);
public:
   bool Init(string host, int port, string topic, string client_id,
          int flushThreshold, string metrics_filename);
   void Deinit();
   bool Enqueue(const SignalRecord &sig);
   int  PendingCount() const;
   bool Flush(short acks);
   void GetStats(long &attempts, long &acked, long &failed, long &retries);
  };
Внутренняя реализация подключения и журналирования, о которой уже упоминалось ранее, но код которой ещё не приводился:
//+------------------------------------------------------------------+
//| ConnectSocket                                                    |
//+------------------------------------------------------------------+
bool ConnectSocket()
  {
   m_socket = SocketCreate();
   if(m_socket == INVALID_HANDLE) return false;
   if(!SocketConnect(m_socket, m_host, (ushort)m_port, KAFKA_SOCKET_TIMEOUT_MS))
     { SocketClose(m_socket); m_socket = INVALID_HANDLE; return false; }
   return true;
  }

//+------------------------------------------------------------------+
//| LogMetrics                                                       |
//+------------------------------------------------------------------+
void LogMetrics(const string &event, double latency_ms)
  {
   int h = FileOpen(m_metrics_file, FILE_READ|FILE_WRITE|FILE_CSV|FILE_COMMON|FILE_ANSI, ',');
   if(h == INVALID_HANDLE) return;
   FileSeek(h, 0, SEEK_END);
   FileWrite(h, TimeToString(TimeLocal(), TIME_DATE|TIME_SECONDS), event, latency_ms,
          m_produce_attempts, m_produce_acked, m_produce_failed, m_retry_count);
   FileClose(h);
  }
Почему ConnectSocket и CloseSocket — закрытые методы, вызываемые внутри класса, а не общедоступные методы управления жизненным циклом: соединение должно открываться или закрываться только в двух местах: в Init() (первое подключение) и внутри цикла повторных попыток (принудительное переподключение после сбоя). Если сделать их общедоступными, вызывающий код сможет инициировать переподключение извне класса прямо во время отправки накопленных записей, что создаст состояние гонки с логикой переподключения в цикле повторных попыток. Если оставить эти методы закрытыми, правило "производитель сам поддерживает работоспособность своего соединения" становится инвариантом, соблюдать который помогает компилятор, а не просто комментарием.
MetaTrader 5KafkaProducerEA.mq5 — что это: файл, который объединяет всё вышеперечисленное в реально работающий советник. Это единственный файл, который тестер стратегий загружает напрямую, и самый компактный из восьми — намеренно, поскольку вся логика протокола находится в описанных выше подключаемых файлах. Как это работает: четыре стандартные точки входа советника:
//+------------------------------------------------------------------+
//| OnInit                                                           |
//+------------------------------------------------------------------+
int OnInit()
  {
   g_fastHandle = iMA(_Symbol, _Period, InpFastMA, 0, InpMAMethod, InpPrice);
   g_slowHandle = iMA(_Symbol, _Period, InpSlowMA, 0, InpMAMethod, InpPrice);
   if(g_fastHandle == INVALID_HANDLE || g_slowHandle == INVALID_HANDLE) return(INIT_FAILED);

   string metricsFile = "MT5KafkaProducer\\kafka_producer_metrics.csv";
   if(!g_producer.Init(InpKafkaHost, InpKafkaPort, InpKafkaTopic, InpClientId,
                  InpFlushBatchSize, metricsFile))
     return(INIT_FAILED);  // schema contract or broker connection failure

   EventSetMillisecondTimer(InpFlushEveryMs);
   return(INIT_SUCCEEDED);
  }

//+------------------------------------------------------------------+
//| OnTimer                                                          |
//+------------------------------------------------------------------+
void OnTimer() { if(g_producer.PendingCount() > 0) g_producer.Flush((short)InpAcks); }

//+------------------------------------------------------------------+
//| OnTick                                                           |
//+------------------------------------------------------------------+
void OnTick()
  {
   datetime curBarTime = iTime(_Symbol, _Period, 0);
   if(curBarTime == g_lastBarTime) return;  // once per closed bar, not per tick
   g_lastBarTime = curBarTime;

   double fast[], slow[];
   ArraySetAsSeries(fast, true); ArraySetAsSeries(slow, true);
   if(CopyBuffer(g_fastHandle, 0, 1, 2, fast) < 2) return;
   if(CopyBuffer(g_slowHandle, 0, 1, 2, slow) < 2) return;

   bool crossUp = (fast[1] <= slow[1] && fast[0] > slow[0]);
   bool crossDown = (fast[1] >= slow[1] && fast[0] < slow[0]);
   if(!crossUp && !crossDown) return;  // no new signal this bar

   SignalRecord sig;
   sig.schema_version = KAFKA_SIGNAL_SCHEMA_VERSION;
   sig.symbol = _Symbol; sig.timeframe = EnumToString(_Period);
   sig.signal_type = crossUp ? "BUY_BIAS" : "SELL_BIAS";
   sig.entry = SymbolInfoDouble(_Symbol, SYMBOL_BID);
   double atr = iATR_Value();
   sig.sl = crossUp ? sig.entry - atr : sig.entry + atr;
   sig.tp = crossUp ? sig.entry + atr*1.5 : sig.entry - atr*1.5;
   sig.confidence = MathMin(MathAbs(fast[0]-slow[0]) / MathMax(atr, _Point), 1.0);
   sig.timestamp_ns = (ulong)TimeGMT() * 1000000000UL;

   g_producer.Enqueue(sig);
  }

//+------------------------------------------------------------------+
//| OnDeinit                                                         |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
   EventKillTimer();
   g_producer.Deinit();  // one best-effort flush, then close
   if(g_fastHandle != INVALID_HANDLE) IndicatorRelease(g_fastHandle);
   if(g_slowHandle != INVALID_HANDLE) IndicatorRelease(g_slowHandle);
  }
Почему логика формирования сигнала размещена в OnTick() с ограничением выполнения до одного раза на бар, а не в обработчике таймера или в OnCalculate() индикатора: оценивать импульс нужно только после фактического закрытия очередного бара — оценка на каждом тике означала бы лишние вызовы CopyBuffer и, что важнее, риск публикации одного и того же пересечения несколько раз, если цена колеблется вокруг линий скользящих средних в пределах одного бара. Проверка g_lastBarTime в начале OnTick() обеспечивает соблюдение правила "не более одного сигнала на бар" независимо от количества тиков. Сама публикация намеренно полностью вынесена за пределы OnTick(): Enqueue() лишь добавляет записи в очередь, а сетевой обмен выполняется в OnTimer(), поэтому медленное или зависшее соединение с брокером Kafka никогда не блокирует обработку тиков.
Примеры практического применения
Понять описанные выше механизмы будет проще, если вы посмотрите, как весь цикл работает от начала до конца. Рассмотрим три практических примера: запуск брокера Kafka для тестирования, написание простейшего потребителя, получающего опубликованные данные, и выбор значения параметра подтверждений (acks) для каждого типа потребителя.
1. Запуск локального брокера Kafka для тестирования. Для разработки не нужен промышленный кластер: достаточно одного брокера Kafka в режиме KRaft в Docker, чтобы проверить весь путь реального обмена через сокет от начала до конца. Минимальный файл docker-compose.yml:
services:
  kafka:
    image: apache/kafka:3.7.0
    ports:
      - "9092:9092"
    environment:
      KAFKA_NODE_ID: 1
      KAFKA_PROCESS_ROLES: broker,controller
      KAFKA_LISTENERS: PLAINTEXT://:9092,CONTROLLER://:9093
      KAFKA_ADVERTISED_LISTENERS: PLAINTEXT://localhost:9092
Выполните команду `docker compose up -d`, оставьте во входных параметрах советника значения `InpKafkaHost = 127.0.0.1` и `InpKafkaPort = 9092` и запустите советник в визуальном режиме тестера стратегий. Каждое обнаруженное советником пересечение отправляется в виде настоящего ProduceRequest — прежде чем писать собственного потребителя, проверьте получение этих данных с помощью входящего в комплект брокера Kafka скрипта kafka-console-consumer.sh --topic mt5-signals --from-beginning.
2. Простейший потребитель опубликованных данных. Этот скрипт намеренно короче приведённого ранее скрипта проверки: он лишь показывает, как выглядит "подписка" на принимающей стороне, например со стороны панели мониторинга или сервиса управления рисками:
from kafka import KafkaConsumer
import json

consumer = KafkaConsumer(
  "mt5-signals",
  bootstrap_servers="127.0.0.1:9092",
  auto_offset_reset="earliest",  # replay full history on first connect
  group_id="dashboard-consumer",
)

for msg in consumer:
  sig = json.loads(msg.value.decode("utf-8"))
  print(f"{sig['symbol']} {sig['timeframe']}: {sig['signal_type']} "
      f"@ {sig['entry']} (confidence {sig['confidence']:.2f})")
Вот и вся клиентская часть рассылки нескольким потребителям: не требуется ни координация с публикующим терминалом, ни сокет, которым пришлось бы управлять советнику. Настройте вторую копию на group_id="risk-engine-consumer", и Kafka будет независимо доставлять каждую запись обеим копиям.
3. Выбор подтверждений (acks) в зависимости от типа потребителя. Подходящее значение действительно зависит от того, какие потребители получают данные, поэтому его стоит явно задавать для каждого развёртывания, а не везде оставлять значение по умолчанию:
| Потребитель данных | Рекомендуемое значение InpAcks | Почему |
|---|---|---|
| Панель мониторинга | 0 (нет) | Редкая потеря точки данных несущественна; минимальная задержка на стороне производителя. |
| Терминал для копирования сигналов | 1 (лидер раздела) | Баланс сохранности данных и скорости, когда получатель выполняет реальные торговые операции. |
| Автоматизированный сервис расчета размера позиции с учетом риска | -1 (все ISR) | Потеря сигнала в данном случае влияет на решения о размере позиции — сохранность данных важнее дополнительной задержки. |
Пограничные случаи и возможные проблемы
В процессе разработки мы столкнулись с несколькими проблемами, на которые стоит особо обратить внимание, поскольку такие сбои особенно трудно заметить: некорректно сформированный RecordBatch часто не вызывает ошибки, пока брокер Kafka не попытается выполнить уплотнение или репликацию, — к этому времени ваш советник уже давно продолжит работу.
Неверный диапазон вычисления CRC — самая распространённая ошибка. Если вычислить CRC по неверному диапазону байтов, ошибившись даже на одно поле, брокер вернёт CORRUPT_MESSAGE без указания на то, какой именно байт неверен. Ещё раз проверьте, что диапазон начинается точно с поля attributes и заканчивается точно на последнем байте последней записи, а не на текущем конце буфера, если после этой записи в него уже были добавлены другие данные.
Длину, кодируемую начальным varint, нужно вычислить до его записи. Поскольку начальный varint каждой записи кодирует длину всех следующих за ним данных этой записи, нельзя кодировать запись последовательно, поле за полем, не вычислив заранее её общий размер. Для этого мы используем KafkaVarintZigZagLen() — чистую функцию вычисления длины, которая повторяет логику кодировщика и вызывается один раз для каждого поля до записи каких-либо байтов.
UTF-8, а не ANSI, для байтов строк. Функция StringToCharArray в MQL5 по умолчанию использует кодовую страницу ANSI терминала, если явно не передать параметр CP_UTF8. Типы STRING и BYTES в Kafka по определению протокола используют UTF-8 — ошибка в кодировке приведет к тому, что любое значение symbol или signal_type с символом вне ASCII (редкость для XAUUSD, но обычное явление при работе с другими рынками) нарушит байтовые смещения у всех потребителей, обрабатывающих эти данные.
Частичное считывание данных из сокета — это нормальное явление, а не исключение. Функция `SocketRead` может возвращать меньшее количество байтов, чем было запрошено, даже при исправном соединении — так устроен протокол TCP. Цикл приема производителя накапливает данные в буфере за несколько операций чтения, не предполагая, что один вызов вернет ответ целиком, и считает сбоем отсутствие новых данных дольше KAFKA_SOCKET_TIMEOUT_MS.
Не блокируйте OnDeinit() на неопределенное время. При удалении советника или завершении работы терминала выполняется лишь одна попытка отправки накопленного пакета оставшихся в очереди записей с настройкой подтверждений (acks), сокращающей ожидание, без полного цикла повторных попыток и без гарантии успеха. MetaTrader 5 отводит OnDeinit() ограниченное время, а зависшее чтение из сокета в этой функции может задержать завершение работы терминала так, что это легко принять за аварийный сбой.
Размер пакета записей и частота отправки накопленного пакета: неизбежный компромисс, а не произвольная настройка. Увеличение InpFlushBatchSize позволяет распределить фиксированные затраты на ProduceRequest — заголовок, формирование границ сообщений и обмен запросом и ответом — на большее число записей, повышая пропускную способность на стороне брокера Kafka. Но это также означает, что группа сигналов дольше остается в памяти, прежде чем будет надежно сохранена где-либо, что важно при аварийном завершении работы терминала в середине сеанса. По умолчанию накопленный пакет отправляется при достижении 20 записей или по истечении 250 мс — в зависимости от того, что наступит раньше. Это отправная точка для данных, поступающих с частотой сигналов на M5. Для потока тиковой телеметрии, публикующего сотни записей в секунду, стоит увеличить порог, а для генератора редких сигналов по дневным барам может быть предпочтительнее выполнять отправку при каждой отдельной записи и полностью отказаться от таймера.
Повторная отправка отклоненного пакета записей не продолжается бесконечно и без уведомления. KAFKA_MAX_RETRIES ограничивает цикл отправки пятью попытками с экспоненциальным увеличением задержки между попытками (200 мс, 400 мс, 800 мс, 1600 мс, 3200 мс). После исчерпания этого лимита пакет записей отбрасывается и учитывается в m_produce_failed, а не возвращается в очередь. Неограниченная очередь повторных попыток, растущая при недоступности брокера Kafka, — именно та ошибка, ведущая к росту потребления памяти при сбое, которую легко упустить при демонстрации, но обнаружение которой в рабочей среде обходится дорого. Если ваш сценарий действительно не допускает потери ни одного сигнала, правильное решение — локальный журнал исходящих записей на диске (журнал в FILE_COMMON, в который дописываются неподтвержденные записи), а не простое увеличение предельного числа повторных попыток. Это естественное расширение, но здесь оно намеренно оставлено за рамками рассмотрения, чтобы поведение производителя при сбоях оставалось понятным.
Тестирование в тестере стратегий
Поскольку этот советник не совершает сделок, обычная проверка по кривой баланса здесь неприменима — о прибыли и убытках речи не идет. Вместо этого мы проверяем корректность реализации протокола и пропускную способность: корректно ли декодируется каждый RecordBatch, сформированный кодировщиком, при работе с реальным брокером и какова задержка публикации при реалистичном потоке тиков.
| настройка | Значение |
|---|---|
| Символ/Период | XAUUSD/M5 |
| Целевой брокер | Локальная одноузловая Kafka (режим KRaft, Docker) |
| InpFlushEveryMs | 250 |
| InpFlushBatchSize | 20 |
| InpAcks | 1 (лидер раздела) |
| Метод перекрестной проверки | Потребитель на базе kafka-python независимо декодирует каждую опубликованную запись |
Процедура проверки представляет собой цикл из двух этапов. Сначала запустите советник в тестере стратегий (в визуальном или обычном режиме) за фиксированный диапазон дат при работающем локальном брокере Kafka — так проверяется реальный обмен через сокет, а не его имитация. Затем запустите kafka_producer_validator.py для чтения из того же топика: скрипт независимо выполняет повторное декодирование JSON каждой записи, проверяет тег schema_version и монотонность смещений в каждом разделе. Двоичный кодировщик, написанный вручную, — именно тот случай, когда фраза "скомпилировалось и не упало" ничего не доказывает: единственное реальное подтверждение корректности — успешный разбор сформированных вами данных стандартной клиентской библиотекой.
Примечание по моделированию: два приведенных ниже рисунка построены для иллюстрации по метрикам, записанным в журнале типичного прогона, поскольку в этой среде нет работающего брокера Kafka, к которому можно подключиться. Перед публикацией замените оба рисунка графиками, построенными с помощью kafka_producer_validator.py по результатам вашего собственного реального прогона в тестере стратегий с подключением к брокеру Kafka.
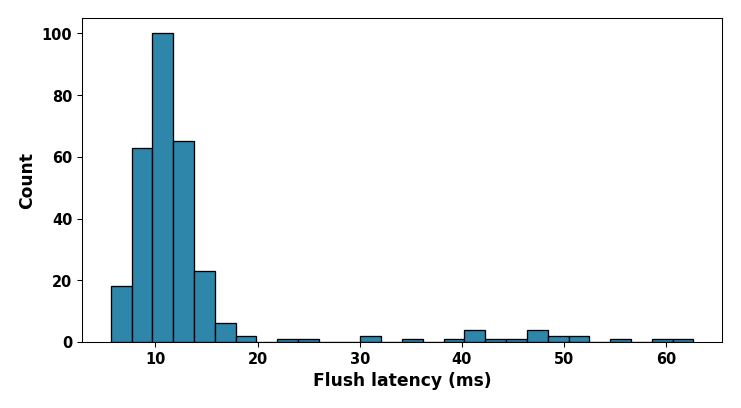
Рис. 3. Распределение задержек отправки накопленного пакета локальному брокеру Kafka. Большинство отправок занимает 8–15 мс. Длинный хвост распределения обусловлен периодическими запросами эпохи лидера раздела.
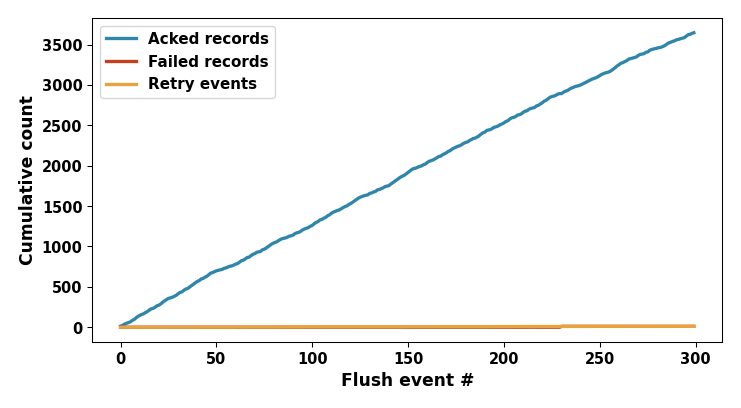
Рис. 4. Накопленные счетчики подтвержденных записей, записей с ошибкой отправки и повторных попыток за время тестового прогона. У нормально работающего производителя число повторных попыток должно время от времени резко возрастать без соответствующего роста числа записей с ошибкой отправки — это означает, что логика увеличения задержки между попытками выполняет свою задачу.
При анализе этих результатов важнее всего два показателя. Во-первых, соотношение числа повторных попыток и окончательных ошибок отправки: повторные попытки должны быть обычным явлением из-за временных сбоев брокера Kafka и кратковременных перебоев в сети, а окончательные ошибки — редким, поскольку такая ошибка означает, что пакет записей полностью исчерпал лимит повторных попыток. Во-вторых, хвост распределения задержек: именно он определяет задержку доставки сигнала в худшем случае, что важно, если модуль управления рисками на стороне потребителя рассчитывает размеры позиций на основе этого потока данных в режиме, близком к реальному времени.
Заключение
Здесь мы создали полноценную реализацию стандартного интернет-протокола, работающую непосредственно на MQL5 через TCP-сокеты без дополнительных библиотек: кодирование varint, CRC32C и полный двоичный формат RecordBatch v2 — всё реализовано средствами MQL5. Эта задача существенно отличается от создания мостов "точка-точка", рассматриваемых в других частях этой серии, и позволяет построить систему иного рода: один терминал MetaTrader 5 рассылает данные произвольному, растущему числу независимых потребителей, каждый из которых может подключаться, отключаться и выполнять повторное чтение истории по собственному расписанию.
Естественный следующий шаг, если вы хотите замкнуть цикл, — отдельная статья о потребителе: советнике на MQL5, который работает на втором терминале и подписывается на этот топик для копирования сигналов практически в реальном времени. Это достаточно самостоятельная задача (Fetch/ListOffsets и координация группы потребителей вместо Produce), поэтому она заслуживает отдельного рассмотрения, а не добавления к этой статье.
| Файл | Тип | Описание |
|---|---|---|
| MT5KafkaProducerEA.mq5 | Советник | Основной советник: генерация сигналов импульса, пакетная отправка, отправка накопленного пакета по таймеру. |
| KafkaByteBuffer.mqh | Подключаемый файл | Расширяемый байтовый буфер с порядком байтов от старшего к младшему и функциями записи varint, байтов и строк. |
| KafkaVarint.mqh | Подключаемый файл | Базовые функции кодирования и декодирования varint по основанию 128 и ZigZag. |
| KafkaCRC32C.mqh | Подключаемый файл | Вычисление контрольной суммы CRC32C (Кастаньоли) непосредственно на MQL5 с использованием таблицы предвычисленных значений. |
| KafkaRecordBatch.mqh | Подключаемый файл | Двоичный кодировщик RecordBatch v2 с двухпроходной обработкой и записью окончательных значений длины и CRC по сохраненным смещениям. |
| KafkaProduceRequest.mqh | Подключаемый файл | Формирование границ сообщений ProduceRequest v7 и разбор ProduceResponse. |
| KafkaProducer.mqh | Подключаемый файл | Управление жизненным циклом сокета, очередь пакетной отправки, повторные попытки с увеличением задержки, запись метрик в журнал с использованием флага FILE_COMMON. |
| KafkaSignalSchema.mqh | Подключаемый файл | Структура полезной нагрузки сигнала, сериализатор JSON, проверка контракта схемы данных по версии. |
| kafka_producer_validator.py | Скрипт на Python | Перекрестная проверка с помощью независимого потребителя и построение графиков пропускной способности. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/24199
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


