

Альтернатива временным барам (Часть 4): Эффективность разных типов баров в трендовых стратегиях и стратегиях возврата к среднему
 56
 0

Содержание
- Введение
- Проблема объема на спотовом валютном рынке
- Почему тип баров — смешивающий фактор, а не произвольный выбор
- Проверяемая теория
- План эксперимента
- Построение баров с общей периодичностью
- Первичные стратегии и ловушка направленности
- Метаразметка точек входа
- Уникальность наблюдений и скорректированный лес
- Оценка при перекрестной проверке с очисткой
- Статистические свойства на реальных данных EURUSD
- Результаты
- Статистические свойства и эффективность
- Сетка — проблема множественной проверки гипотез
- От Python к MQL5
- Заключение
- Прикрепленные файлы
Введение
В первых трех статьях серии был создан инструментарий для альтернативных баров: в первой части были построены бары активности и дисбаланса, во второй добавлены бары серий, а в третьей разработан индикатор для отслеживания их формирования в терминале. Во всех трех статьях одно утверждение принималось на веру. Лопес де Прадо в разделе 2.3 книги "Advances in Financial Machine Learning" утверждает, что альтернативные бары (формируемые по торговой активности или дисбалансу потока ордеров, а не по времени) обладают лучшими статистическими свойствами, чем бары фиксированной длительности. Неявное следствие, постоянно повторяемое в литературе для частных трейдеров, состоит в том, что стратегии и модели машинного обучения, построенные на этих барах, поэтому должны работать лучше.
Это следствие утверждается гораздо чаще, чем проверяется на данных. Улучшение статистических свойств доходностей характеризует сэмплирование, но не переносится автоматически на стратегию, использующую его результаты. В правиле RSI не учитывается, какой механизм формирования баров создал его входные данные. Помогает ли этому правилу изменение представления данных — эмпирический вопрос, на который нужно отвечать контролируемым экспериментом, а не ссылкой на литературу.
В этой статье проводится эксперимент на 60,5 млн котировочных тиков EURUSD за 2022-2023 годы. За этот период EURUSD опустился с 1,15 ниже паритета, а затем вновь поднялся выше 1,10; в данных представлены и трендовые режимы, и режимы возврата к среднему. Для каждого представления баров запускаются три классические первичные стратегии: RSI и полосы Боллинджера (возврат к среднему), а также правило ADX/DI (следование за трендом). Каждая точка входа размечается методом тройного барьера, а метамодель обучается определять, когда открывать сделку по сигналу первичной стратегии. Эффективность каждой ячейки характеризуется двумя показателями: исходной долей успешных сигналов первичной стратегии и AUC метамодели вне выборки при перекрестной проверке с очисткой.
Скорректированный эксперимент приводит к прямому выводу. Ни одно семейство баров не обеспечивает надежного преимущества для этих правил. Все значения AUC вне выборки находятся в узком диапазоне от 0,42 до 0,55; ранжирование семейств по статистическим свойствам не предсказывает их ранжирование по эффективности, а перестановочный тест Монте-Карло для одной ячейки с наилучшим на первый взгляд результатом дает p-значение 0,10. Видимая структура в сетке неотличима от той, которую дали бы случайные метки. Статистическое свойство, описанное Лопесом де Прадо, существует и подтверждается в этой статье на реальных данных EURUSD, но не переносится на эффективность стратегии так, как предполагается упомянутым следствием из литературы для частных трейдеров.
Проблема объема на спотовом валютном рынке
Прежде чем можно будет доверять какому-либо сравнению, необходимо решить одну проблему, характерную именно для валютного рынка. Шесть из десяти типов баров AFML определяются через фактический объем сделок: объемные бары, долларовые бары, а также объемные и долларовые варианты семейств баров дисбаланса и серий. Спотовый валютный рынок децентрализован. Здесь нет ни консолидированной ленты, ни истинного рыночного объема, а поток MetaTrader для частных трейдеров или выгрузка из Tick Data Suite содержит только котировки. Используемые здесь выгрузки за 2022 и 2023 годы содержат ровно два столбца — bid и ask — без поля объема.
Обычный обходной путь — задавать объем, равный единице, для каждого тика, так что "объем" становится числом обновлений котировок. Это незаметно стирает различие, которое должны были обеспечивать объемные и долларовые бары. Объемный бар закрывается после достижения фиксированного накопленного объема; при одной единице на тик это фиксированное число тиков, то есть тиковый бар. Долларовый бар закрывается, когда накопленная сумма произведений цены и объема достигает фиксированного уровня; при одной единице на тик это фиксированная сумма цен, то есть тиковый бар, зависящий только от медленно меняющегося уровня цены. В таблице ниже приведен коэффициент вариации числа тиков на бар; ноль означает строго постоянное число тиков в баре и, следовательно, тиковый бар.
| Тип бара (единичный объем) | CV числа тиков на бар | Значение |
|---|---|---|
| тиковый бар | 0,000 | эталон (регулярный по построению) |
| объем | 0,000 | идентичен тиковому бару |
| долларовый бар | 0,040 | тиковый бар с 4%-ным колебанием ценового уровня |
Семейства баров дисбаланса и серий так же сводятся к тиковым вариантам. Тиковый бар дисбаланса использует только последовательность знаков по тиковому правилу, поэтому сохраняет отличия. В его объемном и долларовом вариантах знак умножается на объем или стоимость, а при единице на тик они снова сводятся к тиковому варианту. Таким образом, на котировочных данных спотового валютного рынка десять типов баров AFML сводятся к четырем действительно различным семействам: временным барам, тиковым барам, тиковым барам дисбаланса и тиковым барам серий.
Здесь речь идет о более глубокой проблеме, чем просто отсутствующий столбец данных. Лопес де Прадо обосновывает использование долларовых баров в разделе 2.3.1.4 двумя аргументами, специфичными для акций: нормализацией с учетом значительного роста цены и устойчивостью к изменениям количества акций в обращении из-за корпоративных действий. На спотовом валютном рынке нет ни того, ни другого. Здесь нет акций в обращении, сплитов или обратных выкупов, а цена основной валютной пары меняется в узком диапазоне. Даже при наличии потока данных с фактическим объемом сделок долларовые бары дали бы мало дополнительной пользы по сравнению с объемными барами для валютной пары. На спотовом валютном рынке эта конструкция решает проблему, которой у рынка нет, а название "долларовый бар" описывает взвешенный по цене тиковый бар.
Почему тип баров — смешивающий фактор, а не произвольный выбор
Наивный способ сравнить типы баров — выбрать порог для каждого из них, запустить стратегию и сравнить доходность. Такой подход некорректен с самого начала: при изменении типа бара одновременно меняются два фактора. Тиковые бары заданного размера и часовые временные бары на одной истории дают разное число баров, а также разную структуру серийной корреляции. Любое различие в последующей эффективности становится смешением эффектов размера выборки и представления данных; разделить их задним числом невозможно.
Решение заключается в том, чтобы удерживать число наблюдений постоянным и изменять только представление. Каждое семейство здесь калибруется примерно на 12 000 баров за два года, поэтому разницу в AUC метамодели между семействами можно связать с представлением данных, а не с тем, что в одном варианте для обучения использовалось больше данных. Фактическая частота формирования баров по-прежнему колеблется, и именно эти колебания исследуются, но ее среднее значение привязано к общему ориентиру.
Проверяемая теория
Аргументация Лопеса де Прадо носит статистический характер, и стоит точно указать, где именно в книге она приводится. В разделе 2.3.1 рассматриваются стандартные бары активности (тиковые, объемные, долларовые); в разделе 2.3.2 — информационные бары (дисбаланса и серий). Явные свидетельства улучшения статистических свойств доходностей относятся к первой группе. Вслед за Мандельбротом и Тейлором (1967), а также Ане и Геман (2000), сэмплирование по торговой активности дает доходности, более близкие к независимым, одинаково распределенным гауссовым величинам, с более слабой серийной корреляцией, чем у временных баров. Для информационных баров из раздела 2.3.2 то же превосходство утверждается и выносится в упражнения в конце главы, а не демонстрируется. Данная статья в том числе устраняет разрыв между тем, что показано, и тем, что утверждается.
Все это не вызывает споров, пока речь идет о распределениях доходностей. Стоит внимательно проверить именно переход к эффективности стратегии. Задача метамодели — отделить прибыльные сигналы первичной стратегии от убыточных. Упрощает ли информационное сэмплирование такое разделение, зависит от того, сохраняются ли преимущество первичной стратегии и предсказывающие его признаки при смене схемы сэмплирования. Правило следования за трендом, преимущество которого проявляется в сериях движений цены, и правило возврата к среднему, преимущество которого проявляется при чрезмерных отклонениях цены, могут противоположным образом реагировать на одно и то же ресэмплирование. Именно для проверки этой гипотезы построена данная сетка.
План эксперимента
В экспериментальном стенде все параметры остаются неизменными, кроме одного проверяемого фактора. В каждой ячейке "стратегия-разметка" меняется только представление баров. Набор признаков, целевой уровень волатильности, ширины барьеров, метамодель и протокол перекрестной проверки одинаковы для всех семейств. Именно это делает сравнение интерпретируемым.
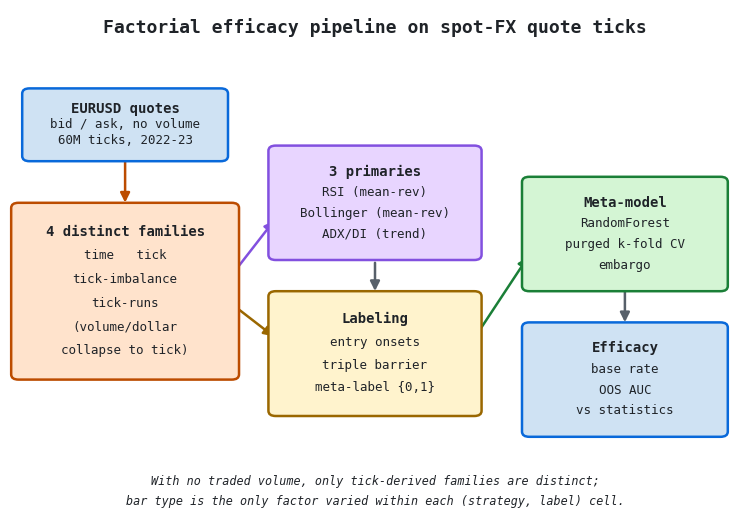
Рис. 1. Пятиэтапная схема пайплайна оценки эффективности в факторном эксперименте.
- Поток котировок — 60,5 млн тиков Bid/Ask без поля объема; они используются на всех последующих этапах, поэтому каждое семейство баров получает одну и ту же исходную информацию.
- Четыре различных семейства баров — временные, тиковые, тиковые бары дисбаланса и тиковые бары серий; объемные и долларовые варианты сводятся к тиковым и исключаются.
- Три первичные стратегии — RSI и полосы Боллинджера (возврат к среднему), а также ADX/DI (следование за трендом) задают направление каждой сделки.
- Разметка — точки входа сэмплируются и обрабатываются методом тройного барьера, после чего формируется бинарная метаметка из {0, 1}.
- Метамодель и эффективность — случайный лес с контролем уникальности оценивается при k-блочной перекрестной проверке с очисткой, а его эффективность сравнивается с показателями статистических свойств доходностей.
Построение баров с общей периодичностью
Средняя цена между Bid и Ask лежит в основе построения каждого бара. Временные бары закрываются каждый час; тиковые — при фиксированном числе тиков, откалиброванном под ту же периодичность. Пороги тиковых баров дисбаланса и тиковых баров серий калибруются под тот же ориентир, чтобы все четыре семейства имели сопоставимое число баров.
for bt in BAR_TYPES:  # time, tick, tick_imbalance, tick_runs
    if bt == "time":
        b = make_bars(ticks, bar_type="time", bar_size="H1", price="mid_price")
    elif bt == "tick":
        b = make_bars(ticks, bar_type="tick", bar_size=size, price="mid_price")
    else:  # information bars auto-calibrate to the cadence
        b = make_bars(ticks, bar_type=bt, target_timeframe="H1",
                      ewm_span=EWM_SPAN, price="mid_price")
    bars[bt] = b
Одна тонкость прослеживается на протяжении всего исследования. На данных только по котировкам тиковое правило отражает направление изменений средней цены между Bid и Ask, а не направление сделки, инициированной агрессором (которое здесь не наблюдается). На этих данных распределение знаков почти идеально сбалансировано: доля знаков покупки составляет 0,499, поскольку в изменениях котировок почти нет устойчивого дисбаланса потока ордеров. Тиковые бары дисбаланса и тиковые бары серий по-прежнему корректно определены, но на данных только по котировкам ослабевает их информационное обоснование, опирающееся на устойчивость потока сделок. Это ослабление — одно из явлений, которые становятся видны по результатам.
Первичные стратегии и ловушка направленности
Две из трех первичных стратегий используют правила возврата к среднему; третья — правило следования за трендом. В трендовом правиле есть ловушка, которую стоит разобрать: эта ошибка незаметно переносится в метамодель.
ADX измеряет силу тренда, а не его направление. Высокое значение ADX свидетельствует о наличии тренда; оно ничего не говорит о том, стоит ли покупать или продавать. При метаразметке первичная стратегия, напротив, должна задавать направление сделки: задача метамодели — определить, открывать ли сделку в этом направлении. Если трактовать пересечение ADX или ADXR как сигнал на покупку или продажу, к чему подталкивает наивная реализация, метамодель получит направление, которого индикатор на самом деле не определял. В правильной схеме направление сделки определяется по соотношению +DI/-DI, а ADX используется только как фильтр силы тренда. Направление определяется системой направленного движения; ADX его фильтрует.
def primary_side(strategy, bars_df):
    sig = strategy.generate_signals(bars_df).astype("float64")
    if type(strategy).__name__ == "DirectionalMovementStrategy":
        # hold the trend, don't re-open only on the crossover bar
        sig = sig.replace(0, np.nan).ffill().fillna(0)
    return sig.astype("int8")
Перенос последнего известного значения вперед тоже важен. Сигнал простого пересечения возникает на одном баре, а позицию удерживают, пока тренд сохраняется. Перенос значения направления на последующие бары превращает краткий сигнал пересечения в сохраняемое состояние. Это реалистичнее и объясняет, почему ячейки следования за трендом содержат втрое больше событий, чем ячейки возврата к среднему.
Метаразметка точек входа
При метаразметке событиями являются точки входа, заданные самим правилом. Учитывается каждый момент появления сигнала, а также периодические повторные оценки, пока сигнал сохраняется. Этот подход применяется одинаково ко всем стратегиям, так что ячейки различаются только представлением. Каждое событие обрабатывается методом тройного барьера. get_events отслеживает будущие значения цены до первого касания масштабированного по волатильности тейк-профита, стоп-лосса или вертикального барьера, а get_bins, получив направление сделки первичной стратегии, возвращает метку из {0, 1}: единицу, если сделка была бы прибыльной, и ноль в противном случае. Именно этот бинарный результат является целевой переменной метамодели.
vbar = add_vertical_barrier(t_events, close, num_bars=VBAR)
events = get_events(close=close, t_events=t_events, pt_sl=PT_SL, target=vol,
                    min_ret=0.0, vertical_barrier_times=vbar,
                    side_prediction=side.reindex(t_events))
binned = get_bins(events, close)  # bin in {0,1} = meta-label
Набор признаков намеренно невелик и одинаков для всех ячеек: RSI, z-оценка Боллинджера, ADX, разность +DI и -DI, доходность последнего бара, оценка волатильности на основе EWM и число тиков на бар. Именно фиксация набора признаков позволяет выделить представление баров как изменяемую переменную. Если бы для каждой стратегии использовались специально подобранные признаки, различие между ячейками нельзя было бы связать со схемой формирования баров.
Уникальность наблюдений и скорректированный лес
Метки метода тройного барьера перекрываются. Событие, начавшееся на баре t, может завершиться лишь на баре t + 20; окно определения исхода каждого события, начавшегося между этими барами, частично перекрывается с его окном. Поэтому наблюдения не независимы, и случайный лес при формировании полной бутстрэп-выборки размера N выбирает почти дублирующие друг друга строки. Его деревья становятся коррелированными, и ковариационный член в разложении ошибки из раздела 6.2 AFML перестает уменьшаться независимо от числа добавленных деревьев. Бэггинг снижает дисперсию только в том случае, если его базовые модели декоррелированы.
Решение основано на положениях разделов 4.5 и 6.3 AFML. Средняя уникальность характеризует неперекрытие меток: для каждого бара уникальность равна единице, деленной на число одновременных событий, а уникальность отдельного наблюдения — среднему значению этой величины за его временной интервал. Присвоение параметру леса max_samples значения средней уникальности позволяет каждому дереву выбирать только эффективное (неизбыточное) число строк вместо полного N. Веса классов перебалансируются при каждой бутстрэп-выборке с помощью balanced_subsample; эта настройка допустима для случайного леса, но не для одиночного дерева решений.
from afml.sampling.concurrent import get_av_uniqueness_from_triple_barrier

def cell_uniqueness(t1, close):
    # mean of the per-event average uniqueness (AFML Snippet 4.4)
    events = pd.DataFrame({"t1": t1})
    u = get_av_uniqueness_from_triple_barrier(events, close, num_threads=1, verbose=False)
    return float(u["tW"].mean())

def meta_forest(max_samples):
    # AFML 4.5 / 6.3: draw only avgU of the rows per tree; rebalance per draw
    return RandomForestClassifier(
        n_estimators=300, max_samples=max_samples, class_weight="balanced_subsample",
        criterion="entropy", max_features="sqrt", n_jobs=-1)
Уникальность ячейки определяется ее событиями, а не одним лишь типом бара; приведенные ниже значения показывают одно проектное решение. Правило ADX/DI с сохранением состояния удерживает позицию на протяжении всего тренда, поэтому его события сильно перекрываются, а уникальность низкая — около 0,38. Правила возврата к среднему срабатывают в коротких отдельных эпизодах, поэтому их события мало перекрываются, а уникальность высока — около 0,63. В ячейках ADX/DI лес выбирает пропорционально меньше строк на каждое дерево — именно такая поправка требуется из-за перекрытия.
| Семейство баров | RSI | Полосы Боллинджера | ADX/DI |
|---|---|---|---|
| временные бары | 0,634 | 0,649 | 0,366 |
| тиковые бары | 0,624 | 0,649 | 0,380 |
| тиковые бары дисбаланса | 0,609 | 0,647 | 0,379 |
| тиковые бары серий | 0,651 | 0,664 | 0,383 |
Оценка при перекрестной проверке с очисткой
То же перекрытие, из-за которого требуется поправка на уникальность, делает наивную перекрестную проверку некорректной. Метка, окно которой пересекает границу между обучающим и тестовым фолдами, приводит к утечке информации об исходе через границу разбиения. PurgedKFold удаляет обучающие наблюдения, окно метки которых перекрывается с тестовым набором, и накладывает эмбарго после каждого фолда. AUC рассчитывается по вероятностям из predict_proba, которые далее определяют размер позиции.
def purged_auc(X, y, t1, max_samples, n_splits=5, embargo=0.01):
    cv = PurgedKFold(n_splits=n_splits, t1=t1, pct_embargo=embargo)
    aucs = []
    for train, test in cv.split(X):
        clf = meta_forest(max_samples).fit(X.iloc[train], y.iloc[train])
        p = clf.predict_proba(X.iloc[test])[:, 1]
        aucs.append(roc_auc_score(y.iloc[test], p))
    return np.mean(aucs)
Статистические свойства на реальных данных EURUSD
Прежде всего следует проверить, выполняется ли вообще статистическое утверждение Лопеса де Прадо на этих данных. Да, причем явно — для стандартных баров активности.
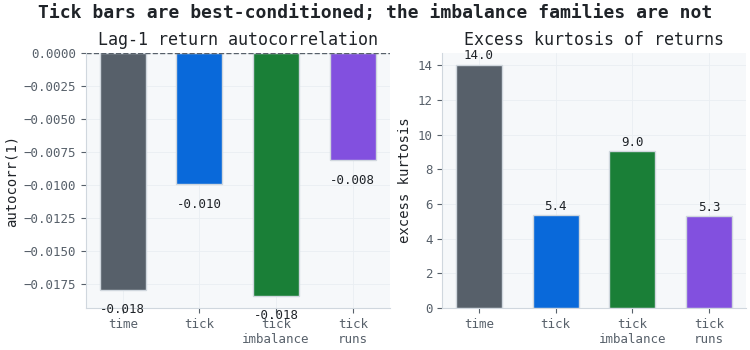
Рис. 2. Иллюстрация из двух панелей, показывающая статистические свойства доходностей по семействам баров.
- Панель (a) — автокорреляция доходностей с лагом 1. Значения для всех четырех семейств близки к нулю; у временных баров наибольшее остаточное значение — -0,018.
- Панель (b) — эксцесс. Тиковые бары и тиковые бары серий более чем вдвое уменьшают выраженность тяжелых хвостов по сравнению с временными барами — эксцесс снижается с 14,0 до примерно 5,3.
Бары активности выигрывают по статистическим свойствам доходностей — именно это предсказывает раздел 2.3.1. Семейство информационных баров не дает дополнительного улучшения. Тиковые бары дисбаланса имеют эксцесс 9,0 — хуже, чем у обычных тиковых баров и тиковых баров серий. Причина в том, что накапливаемые знаки определяются котировками и почти уравновешивают друг друга, а не отражают устойчивое направление сделок. На этих данных наилучшие статистические свойства доходностей наблюдаются у двух самых простых семейств на основе тиков.
Результаты:
В сетке эффективности каждое из четырех семейств сочетается с каждой из трех первичных стратегий.
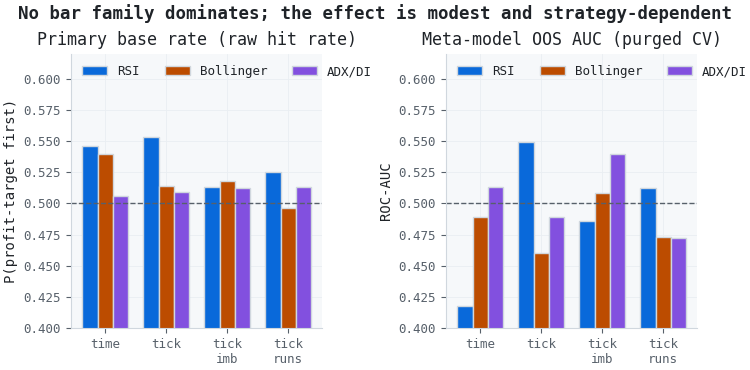
Рис. 3. Иллюстрация из двух панелей, показывающая эффективность семейств баров для разных стратегий.
- Панель (a) — базовая доля успешных исходов первичной стратегии, или исходная доля успешных сигналов. Значение каждой ячейки находится около линии 0,50, в диапазоне от 0,50 до 0,55; ни одно семейство не имеет систематического преимущества.
- Панель (b) — AUC метамодели вне выборки при перекрестной проверке с очисткой. Значения всех ячеек находятся между 0,42 и 0,55, по обе стороны от линии 0,50, соответствующей отсутствию прогностической способности; ни одно семейство не оказывается явно выше нее.
Влияние представления данных барами невелико и не носит систематического характера. Средние значения по семействам близки друг к другу: 0,47 для временных баров, 0,50 для тиковых баров, 0,51 для тиковых баров дисбаланса и 0,49 для тиковых баров серий. Наибольшее значение в отдельной ячейке — у тиковых баров с RSI, 0,550, а наименьшее — у временных баров с RSI, 0,418. Поэтому разброс между семействами внутри одной стратегии имеет тот же порядок величины, что и шум. Исходная базовая доля успешных исходов ничего из этого не отражает. Этот показатель везде близок к результату подбрасывания монеты, что ожидаемо для классических правил: их преимущество, если оно есть, заключается в выборе сигналов для торговли, а не в среднем сигнале.
Статистические свойства и эффективность
Размещение этих двух показателей на одних и тех же осях делает основной вывод явным. Горизонтальная ось отражает статистические свойства доходностей: в аргументации Лопеса де Прадо меньший эксцесс означает лучшие свойства. По вертикальной оси отложена эффективность — среднее значение AUC метамодели по трем стратегиям.
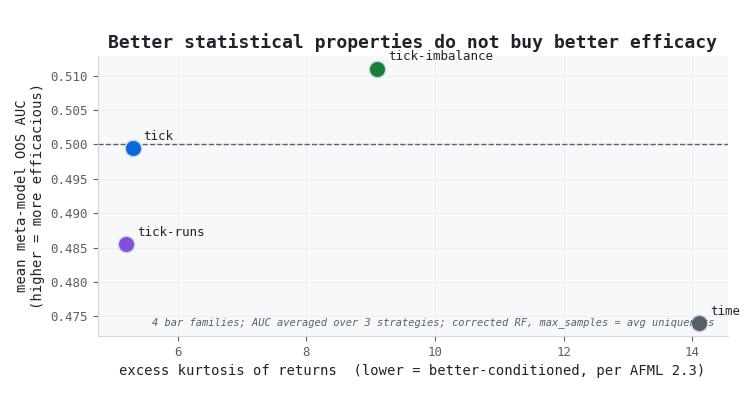
Рис. 4. Иллюстрация на одной панели, сопоставляющая статистические свойства доходностей и эффективность четырех семейств.
Если бы следствие из литературы для частных трейдеров было верным, точки легли бы вдоль нисходящей линии: лучшие статистические свойства доходностей слева соответствовали бы более высокой эффективности вверху. Но этого не происходит. Два семейства с наилучшими статистическими свойствами доходностей — тиковые бары и тиковые бары серий с эксцессом около пяти — дают эффективность 0,50 и 0,49 соответственно. Семейство с наихудшими статистическими свойствами — временные бары с эксцессом около четырнадцати — оказывается ниже всех на уровне 0,47, а промежуточное семейство тиковых баров дисбаланса — выше всех на уровне 0,51. Четыре точки разбросаны в пределах 0,04 по оси эффективности без связи с положением на оси статистических свойств доходностей. Статистические свойства доходностей не объясняют разброс эффективности, а сам разброс настолько мал, что любая его интерпретация требует предварительной проверки значимости.
Сетка — проблема множественной проверки гипотез
Оценены 12 ячеек — сочетания четырех семейств баров и трех первичных стратегий. В ноутбуке строятся все десять типов баров AFML, после чего шесть объемных и долларовых вариантов исключаются как дубликаты на валютных данных, содержащих только котировки. Лучшая ячейка будет выглядеть хорошо по самому принципу отбора. Это смещение из-за дата-майнинга — центральная проблема книги Аронсона "Evidence-Based Technical Analysis" и причина, по которой Уайт разработал тест Reality Check. Правильный подход — сравнить лучшую ячейку с распределением результатов того же пайплайна на бессмысленных метках.
Мы проводим перестановочный тест Монте-Карло для лучшей ячейки — тиковых баров с RSI. Столбец меток перемешивается, обучение повторяется в рамках полного пайплайна перекрестной проверки с очисткой, а полученное значение AUC фиксируется. Повторение процедуры 200 раз дает нулевое распределение AUC при отсутствии реальной связи.
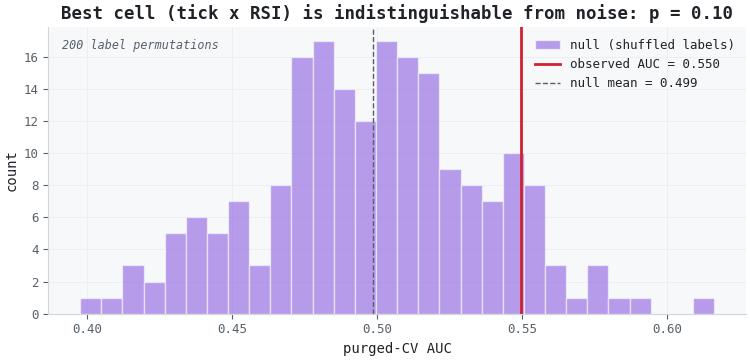
Рис. 5. Иллюстрация на одной панели, показывающая нулевое распределение перестановочного теста для лучшей ячейки.
Наблюдаемое значение AUC (0,550) находится в основной массе нулевого распределения (среднее 0,499, стандартное отклонение 0,039). p-значение перестановочного теста составляет 0,10. Лучшая ячейка во всей сетке незначима на уровне 0,05 даже до поправки на двенадцать тестов, а поправка Шидака снизила бы требуемый порог ниже 0,005. Ничто в этой сетке не проходит такую планку. Корректная интерпретация такова: представление данных барами для этих классических правил на котировочных данных спотового валютного рынка не дает преимущества в эффективности, отличимого от шума.
От Python к MQL5
Исследование выполняется на Python: перебор сочетаний факторов относится к исследовательскому этапу, а не к эксплуатации системы. При внедрении используется инструментарий MQL5, созданный ранее в этой серии статей. BarBuilderEA строит бары лучшего типа в реальном времени по потоку тиков (части 1 и 2), а AlternativeBarsViewer (часть 3) позволяет наблюдать калибровку в терминале до передачи данных модели. Поэтому проверка вырожденных баров, защищающая офлайновый пайплайн формирования признаков, защищает и пайплайн реального времени. Метамодель экспортируется в ONNX, а направление сделки первичной стратегии и вероятность вторичной модели определяют размер позиции через bet_size_probability.
В рабочей системе приведенный выше упрощенный стенд заменяется ModelDevelopmentPipeline, который выполняет предварительную обработку, оптимизацию гиперпараметров, калибровку и управление артефактами. Первичная модель обучается с параметром is_primary=True и передает свои события вторичной модели через prepare_meta_labeling_inputs(); вторичная модель обучается с параметром is_primary=False. Чтобы сменить представление при внедрении, достаточно изменить одну строчку — поле bar_type в конфигурации данных пайплайна.
Заключение
Информационные бары действительно обладают лучшими статистическими свойствами, описанными Лопесом де Прадо, и в этой статье это подтверждено на реальных данных EURUSD: тиковые бары снижают эксцесс временных баров более чем наполовину. В статье проверяется следующее звено цепочки: повышают ли эти свойства эффективность классических индикаторов, которые трейдеры фактически используют. На двухлетних данных EURUSD этого не происходит. Показатели каждого семейства находятся около линии отсутствия прогностической способности; статистические свойства доходностей не предсказывают эффективность, а ячейка с наилучшим на первый взгляд результатом не проходит перестановочный тест.
Два полученных вывода применимы и за пределами EURUSD. Во-первых, на спотовом валютном рынке, где нет фактического объема сделок, шесть из десяти типов баров AFML сводятся к тиковым барам, а долларовые бары решают проблему рынка акций, которой у валютного рынка нет. Второй вывод методологический: перед сравнением выравнивайте размеры выборок, контролируйте бутстрэп с учетом перекрытия меток, проводите перекрестную проверку с очисткой и учитывайте множественную проверку гипотез с помощью перестановочного теста, прежде чем доверять любому лучшему результату. Статистическое обоснование альтернативных баров состоятельно. Данные не подтверждают аргументы об эффективности классических правил на спотовом валютном рынке. В следующей статье мы перейдем от представления баров к самому ансамблю и выясним, изменит ли последовательный бутстрэп вместо использованного здесь леса с контролем уникальности этот вывод.
Прикрепленные файлы
Папка afml/ — минимальный фрагмент пакета Blueprint Quant afml: только подпакеты, импортируемые этим ноутбуком, с пустыми маркерами пакетов вместо загрузчика полного пакета. Для работы требуются numba, scipy, statsmodels и TA-Lib, а также numpy, pandas и scikit-learn.
| Файл | Расположение | Описание | |
|---|---|---|---|
| 1. | BeyondTheClock_Part4_Efficacy.ipynb | Notebooks\ | Воспроизводимый ноутбук. Строит четыре семейства баров по котировочным тикам за 2022-2023 годы, вычисляет среднюю уникальность, выполняет расчеты по сетке эффективности с использованием леса с контролем уникальности и воспроизводит перестановочный тест и все рисунки из текста. |
| 2. | afml/data_structures/ | afml\ | make_bars и средства построения и калибровки стандартных и информационных баров, формирующие из тиков бары четырех семейств. |
| 3. | afml/strategies/ | afml\ | Первичные стратегии на основе RSI, полос Боллинджера, ADX и направленного движения, определяющие направление сделки для каждой ячейки. |
| 4. | afml/labeling/ | afml\ | Разметка методом тройного барьера (add_vertical_barrier, get_events, get_bins) и сканирование тренда. |
| 5. | afml/sampling/ | afml\ | get_av_uniqueness_from_triple_barrier для определения max_samples, а также последовательный бутстрэп, используемый в пятой части. |
| 6. | afml/cross_validation/ | afml\ | PurgedKFold и вспомогательные функции оценки метамодели без утечки данных через метки. |
| 7. | afml/ensemble/, filters/, util/, sample_weights/ | afml\ | SequentiallyBootstrappedBaggingClassifier, фильтр CUSUM, целевой уровень волатильности и вспомогательные функции для весов наблюдений. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/23310
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 Трейдинг с экономическим календарем MQL5 (часть 12): Хранение данных в SQLite и предотвращение повторных сделок
 Построение системы обнаружения дивергенций (Часть II): Пользовательский индикатор Adaptive SuperTrend
 Автоматизация торговых стратегий в MQL5 (Часть 51): Модель Bread and Butter Judas Swing с зонами премии и дисконта
 Трейдинг с экономическим календарем MQL5 (Часть 11): Модульная новостная панель на Canvas

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования