

Конструирование признаков для машинного обучения (Часть 10): Tесты на структурные сдвиги в MQL5
 94
 0

Содержание
- Введение
- Архитектура: CStructuralBreaks
- Правила индексации: источник большинства ошибок при переносе
- CUSUM-тест Чу — Стинчкомба — Уайта
- Тест Дики — Фуллера типа Чоу
- SADF: выбор скользящего окна
- Тесты на субмартингальность и супермартингальность
- Накопление сумм для МНК в каждом семействе тестов
- Интеграция с советником и маршрутизация признаков
- Индикатор StructuralBreaksViewer
- Проверка
- Согласованность численных результатов Python и MQL5
- Заключение
- Список литературы
- Прикрепленные файлы
Введение
В 9-й части этой серии на Python был реализован набор тестов на структурные сдвиги из главы 17 книги AFML, включающий CUSUM-тест Чу — Стинчкомба — Уайта, тест Дики — Фуллера типа Чоу, SADF для шести регрессионных моделей, а также два варианта с повышенной устойчивостью (QADF и CADF). В этой статье три основных теста — CSW, Chow и SADF — переносятся в MQL5 в виде единого подключаемого файла CStructuralBreaks.mqh, размещенного в каталоге MQL5/Include/StructuralBreaks/. Также включены тесты на субмартингальность и супермартингальность (SM-Exp и SM-Power), что доводит общее число статистик до пяти на каждый бар.
Реализация на MQL5 отличается от версии на Python одним архитектурным решением, о котором стоит сказать сразу: SADF использует скользящее окно с заданной глубиной истории, а не полное расширяющееся окно. В Python использование расширяющегося окна оправданно, поскольку вычисления выполняются однократно в автономном режиме на фиксированном наборе данных. В советнике, выполняющем пересчёт на каждом новом баре, вычислительная сложность при использовании расширяющегося окна составляет O(T²), где T — число завершённых баров. При T = 1 000 баров — небольшом двухлетнем ряде дневных данных — использование расширяющегося окна требует в 15 раз больше операций во внутреннем цикле, чем использование скользящего окна длиной 252 бара. При T = 5 000 баров оно требует в 400 раз больше таких операций. Скользящее окно не является компромиссом; оно слегка меняет интерпретацию статистики, и это изменение описано в разделе 6.
Архитектура: CStructuralBreaks
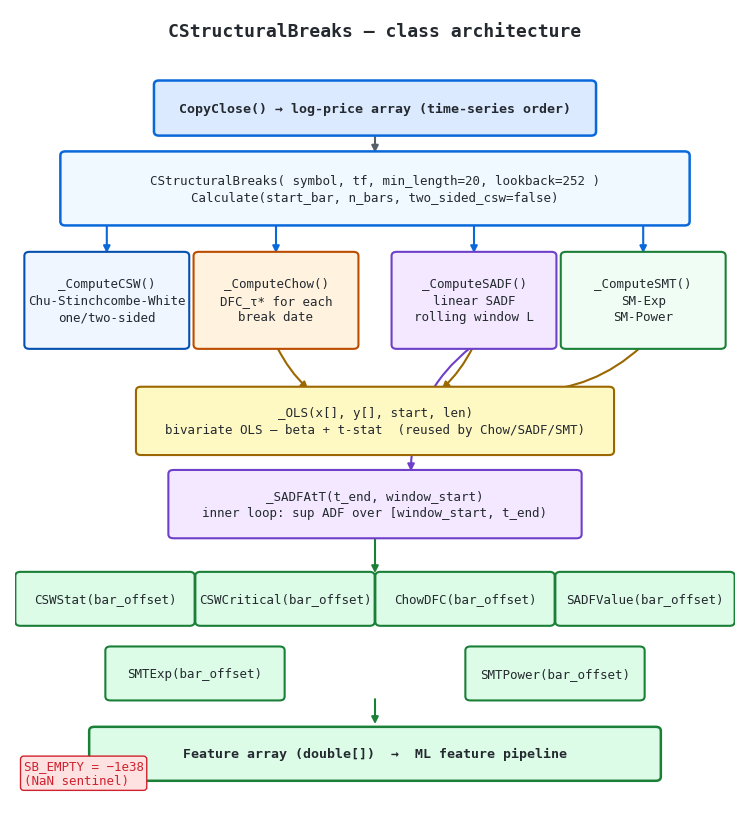
Рисунок 1. Архитектура класса CStructuralBreaks
- Входные данные (синий): функция CopyClose() заполняет массив исходных цен закрытия, к которому сразу применяется логарифмирование. Все вычисления выполняются с логарифмами цен; передача ряда исходных цен привела бы к смещённым результатам по причине, объяснённой в части 9.
- Вычислительные методы (бирюзовый/оранжевый/фиолетовый/зелёный): каждое семейство тестов реализовано в отдельном закрытом методе. _ComputeCSW() предварительно вычисляет σ²t с помощью накопленной суммы, затем выполняет двухпроходный внутренний цикл. _ComputeChow() строит фиктивный регрессор Dt[τ*] для каждой даты структурного сдвига. _ComputeSADF() вызывает общий вспомогательный метод _SADFAtT() для каждой конечной точки. _ComputeSMT() оценивает регрессию логарифмов цен на функции времени.
- Накопление сумм для МНК: каждый вычислительный метод накапливает суммы для регрессии непосредственно в своём коде. В тесте Чоу используется МНК без свободного члена (β = ΣXY / ΣX²), поскольку спецификация Чоу не содержит константы; при расчёте дисперсии остатков число степеней свободы составляет df = n − 1. В SADF и SMT используется МНК со свободным членом: α и β оцениваются совместно, при вычислении остатков вычитаются вклады обоих коэффициентов, а число степеней свободы составляет df = n − 2.
- Методы доступа (зелёный): шесть значений типа double на каждый бар, индексируемых по смещению относительно самого нового бара. SB_EMPTY = −1e38 — значение-маркер; результат считается допустимым, если value > SB_EMPTY + 1.0.
#include <StructuralBreaks\CStructuralBreaks.mqh>

//+------------------------------------------------------------------+
//| EA initialization: create structural breaks engine               |
//+------------------------------------------------------------------+
void OnInit()
  {
   //--- Instantiate with min_length=20 (τ) and lookback=252 (L)
   g_sb = new CStructuralBreaks(_Symbol, _Period, 20, 252);
   if(g_sb == NULL) return(INIT_FAILED);
   return(INIT_SUCCEEDED);
  }

//+------------------------------------------------------------------+
//| New bar handler: compute all statistics and read latest values   |
//+------------------------------------------------------------------+
void OnTick()
  {
   //--- Only process once per new bar
   if(iTime(_Symbol, _Period, 0) == g_last) return;
   g_last = iTime(_Symbol, _Period, 0);

   //--- Calculate for the most recent 300 bars (or less if unavailable)
   if(!g_sb.Calculate(1, 300)) return;

   //--- Retrieve features for the current bar (offset 0)
   double csw_excess = g_sb.CSWStat(0) - g_sb.CSWCritical(0);
   double sadf       = g_sb.SADFValue(0);
   double chow_dfc   = g_sb.ChowDFC(0);
   double smt_exp    = g_sb.SMTExp(0);
   //--- Use these values in regime logic (see Section 9)
  }
Правило индексации: источник большинства ошибок при переносе
Самым распространённым источником ошибок при портировании статистического кода с Python на MQL5 являются правила индексации массивов. Python обрабатывает данные в хронологическом порядке: индекс 0 соответствует самому раннему наблюдению, а индекс T−1 — самому позднему. Функции Copy* в MQL5 при использовании ArraySetAsSeries(true) работают в порядке индексации таймсерии: индекс 0 соответствует самому новому бару, а индекс T−1 — самому старому.
В файле CStructuralBreaks.mqh массив логарифмов цен на всех этапах хранится в порядке индексации таймсерии. Соответствие между этими двумя системами выглядит следующим образом:
//+------------------------------------------------------------------+
//| Index mapping between chronological (Python) and time-series (MT5)|
//+------------------------------------------------------------------+
// Chronological index k ↔ time-series index ts:
//   ts = (n - 1) - k
//   k  = (n - 1) - ts
//
// Price difference in chronological order:
//   dp[k] = chron[k+1] - chron[k]
//         = m_log_p[n-2-k] - m_log_p[n-1-k]   (newer minus older)
//
// In Python (np.diff):
//   dp[k] = log_p[k+1] - log_p[k]              (older to newer)
//
// Both produce the same differences; the loop direction is reversed.
Внутренний цикл CSW, в котором вычисляется Sn,t = (yt − yn) / (σ̂t √(t−n)), должен брать значение в позиции t при хронологической индексации и сравнивать его со значениями во всех более ранних позициях n. В MQL5 позиции t при хронологической индексации соответствует m_log_p[n-1-t]. Ошибка в этом преобразовании не вызывает ошибки компиляции: статистика без каких-либо предупреждений вычисляется по ряду с обратным порядком наблюдений, что меняет знак на трендовых участках и приводит к тому, что статистика растёт при нисходящих трендах и падает при восходящих.
Все четыре метода расчёта используют хронологическую индексацию и записывают результаты в выходные массивы с порядком индексации таймсерии, выполняя одно преобразование индекса в конце каждой итерации внутреннего цикла. Это упрощает сопоставление статистической логики с формулами главы и одновременно обеспечивает корректную работу методов доступа в порядке индексации таймсерии.
CUSUM-тест Чу — Стинчкомба — Уайта
Оптимизированная реализация CSW из модуля Python напрямую переносится в MQL5. Ключевая оптимизация — предварительное вычисление σ²t с помощью накопленной суммы перед внутренним циклом — устраняет повторное вычисление дисперсии со сложностью O(n), из-за которого общая сложность наивной реализации составляет O(n³):
//+------------------------------------------------------------------+
//| _ComputeCSW: Chu-Stinchcombe-White CUSUM test on levels          |
//|   Precomputes cumulative squared differences, then scans all     |
//|   (n,t) pairs to find the supremum normalized departure.         |
//|   two_sided=true uses absolute differences (symmetric).          |
//+------------------------------------------------------------------+
void CStructuralBreaks::_ComputeCSW(bool two_sided)
  {
   //--- Build sigma² via cumulative sum in chronological order — O(n)
   cum_sq[0] = 0.0;
   for(int k = 1; k < n; k++)
     {
      double dp = m_log_p[n-1-k] - m_log_p[n-1-(k-1)];
      cum_sq[k] = cum_sq[k-1] + dp*dp;
     }

   //--- Outer loop: t from 2 to n-1 (chronological)
   for(int t = 2; t < n; t++)
     {
      double sigma = MathSqrt(cum_sq[t] / (double)(t-1));
      if(sigma <= 0.0) continue;
      double val_t     = m_log_p[n-1-t];
      double max_s     = SB_EMPTY;
      int    best_span = 0;
      //--- Inner loop: n from 0 to t-1 (earlier points)
      for(int nn = 0; nn < t; nn++)
        {
         double diff = two_sided ? MathAbs(val_t - m_log_p[n-1-nn])
                                  : (val_t - m_log_p[n-1-nn]);
         double s = diff / (sigma * MathSqrt((double)(t-nn)));
         if(s > max_s) { max_s = s; best_span = t-nn; }
        }
      //--- Write to time-series index (most recent bar first)
      int ts = n-1-t;
      m_csw_stat[ts] = max_s;
      if(best_span > 0)
         m_csw_crit[ts] = MathSqrt(4.6 + MathLog((double)best_span));
     }
  }
Признак, извлекаемый для конвейера машинного обучения, — это превышение над критическим значением с учетом знака: CSWStat(0) − CSWCritical(0). Положительные значения означают, что нулевая гипотеза об отсутствии тренда отвергается; отрицательные — что ряд остаётся в пределах границы, соответствующей белому шуму. Двусторонний вариант выбирается передачей значения true в метод Calculate(); он использует выражение MathAbs(val_t − val_n) и симметричен относительно подъёмов и распродаж.
Тест Дики — Фуллера типа Чоу
В реализации теста Чоу массивы первых разностей логарифмов цен и лагированных уровней формируются один раз при каждом вызове Calculate(). Затем выполняется цикл по всем датам структурного сдвига τ* в диапазоне [min_length, n − min_length − 1]. Для каждого τ* фиктивный регрессор Dt[τ*] равен нулю до τ* и единице начиная с τ*, поэтому цикл накопления сумм для МНК фактически выполняется только на активном участке [τ*, n−1]:
//+------------------------------------------------------------------+
//| _ComputeChow: Chow-Type Dickey-Fuller with unknown break date    |
//|   For each possible τ*, fits Δy_t = δ·y_{t-1}·D_t[τ*] + ε_t      |
//|   using no-intercept OLS. Stores DFC_{τ*} at time-series index.  |
//+------------------------------------------------------------------+
for(int tau = min_l; tau <= n - min_l - 1; tau++)
  {
   //--- No-intercept OLS: beta = SXY/SXX over active (D=1) segment
   double sxx = 0.0;
   double sxy = 0.0;
   int    cnt = 0;
   for(int k = tau; k < n-1; k++)
     { sxx += lag_c[k]*lag_c[k]; sxy += lag_c[k]*diff_c[k]; cnt++; }
   if(cnt < 4 || sxx < 1e-20) continue;
   double beta = sxy / sxx;

   //--- Residuals over full sample (both segments) with df = n_full - 1
   double ss_res = 0.0;
   int    n_full = 0;
   for(int k = 0; k < n-1; k++)
     {
      double x_d = (k >= tau) ? lag_c[k] : 0.0;
      ss_res += (diff_c[k] - beta*x_d) * (diff_c[k] - beta*x_d);
      n_full++;
     }
   if(n_full < 2) continue;
   double s2    = ss_res / (double)(n_full - 1);
   double var_b = s2 / sxx;   // var(beta) = s²/SXX for no-intercept OLS
   if(var_b <= 0.0) continue;
   double t_stat = beta / MathSqrt(var_b);
   //--- Store t-ratio at the time-series index corresponding to tau
   int ts = n - 1 - tau;
   m_chow_dfc[ts] = t_stat;
  }
Спецификация без свободного члена в точности соответствует регрессии DFC типа Чоу: Δyt = δ · yt−1 · Dt[τ*] + εt не содержит свободного члена. При одном оцениваемом параметре число степеней свободы остатков равно n − 1, а дисперсия оценки коэффициента наклона составляет var(β) = σ² / ΣX², без поправки на центрирование, необходимой в формуле со свободным членом. Использование формулы для β, учитывающей свободный член, вместе с остатками модели без свободного члена приводит к завышению ss_res и занижению t-статистики.
Такое разделение — X'X по активному сегменту, а остатки по полной выборке — соответствует спецификации типа Чоу, приведенной в этой главе. t-статистика DFCτ* сохраняется в массиве по индексу, соответствующему τ* в порядке индексации таймсерии. Супремум SDFC = maxτ* |DFCτ*| можно вычислить по полному массиву после завершения выполнения Calculate():
//+------------------------------------------------------------------+
//| Compute SDFC and locate the break bar after Calculate()          |
//+------------------------------------------------------------------+
double sdfc      = SB_EMPTY;
int    break_bar = -1;
for(int i = 0; i < g_sb.Count(); i++)
  {
   double v = g_sb.ChowDFC(i);
   if(v > SB_EMPTY + 1.0 && MathAbs(v) > MathAbs(sdfc))
     { sdfc = v; break_bar = i; }
  }
//--- break_bar is the bar offset (time-series index) of the most likely break point
SADF: выбор скользящего окна
Вычислительная сложность алгоритма SADF растёт квадратично по длине анализируемого исторического ряда. На приведенном ниже графике это наглядно продемонстрировано: здесь сравнивается количество операций для полного расширяющегося окна и скользящего окна длиной 252 бара по мере накопления ежедневных баров в ряду.
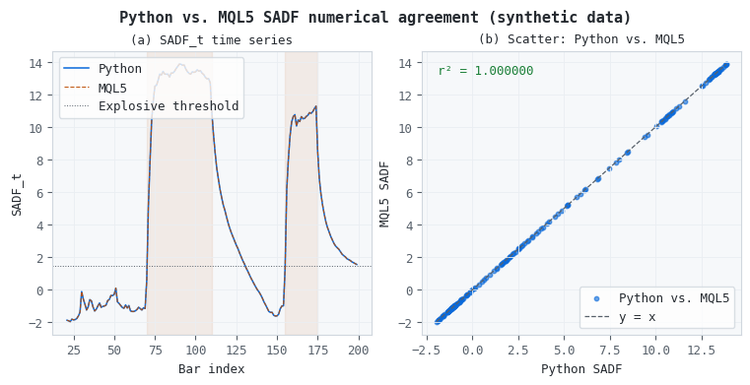
Рисунок 2. Двухпанельное сравнение вычислительных затрат SADF для расширяющегося и скользящего окон
- График (a): абсолютное число операций во внутреннем цикле для расширяющегося окна (красная линия, O(T²)) и скользящего окна с L = 252 (зеленая линия, O(L²) при T > L). Зеленая линия становится горизонтальной при T > 252, поскольку ограничение глубины истории предотвращает дальнейший рост числа операций.
- График (b): отношение вычислительных затрат для расширяющегося окна к затратам для скользящего окна. При T = 1 000 баров расчет с расширяющимся окном требует в 15.4 раза больше операций. При T = 5 000 баров (20-летний ряд дневных данных) это отношение достигает 394 раз. Для советника, работающего в реальном времени на каждом новом баре, скользящее окно — единственный практически реализуемый вариант.
Скользящее окно изменяет интерпретацию SADF в одном конкретном отношении: тест отвечает на вопрос «наблюдается ли взрывная динамика ряда на последних L барах?», а не «наблюдалась ли она когда-либо?». Для признака, предназначенного для выбора текущей торговой стратегии — следования за трендом при высоком значении SADF и возврата к среднему при низком, — интерпретация на основе скользящего окна полностью соответствует задаче. Важен текущий рыночный режим, а не исторический максимум. Только для долгосрочного мониторинга пузырей, когда для выявления многолетнего накопления требуется полное расширяющееся окно, более подходящей является версия на Python с ограниченной глубиной истории (L = 504 или аналогичное значение).
Внутренняя вспомогательная функция SADF _SADFAtT() один раз формирует массивы разностей и лаговых уровней для среза окна и выполняет цикл перебора начальных точек расширяющегося окна:
//+------------------------------------------------------------------+
//| _SADFAtT: compute supremum ADF statistic for one endpoint t_end  |
//|   within the rolling window [window_start, t_end].               |
//|   Returns the maximum ADF t-statistic over all start points.     |
//+------------------------------------------------------------------+
double CStructuralBreaks::_SADFAtT(int t_end, int window_start)
  {
   double bsadf = SB_EMPTY;
   //--- Build dp[] and lev[] once for this slice
   for(int j = 0; j < slice_len - 1; j++)
     {
      int k  = window_start + j;
      lev[j] = m_log_p[m_n - 1 - k];
      dp[j]  = m_log_p[m_n - 1 - (k+1)] - m_log_p[m_n - 1 - k];
     }
   //--- Inner start-point loop: OLS with intercept on each subsample
   for(int s = 0; s <= n_dp - tau; s++)
     {
      //--- Accumulate sums for intercept-augmented OLS
      double sx=0, sy=0, sxx=0, sxy=0;
      for(int i = s; i < s + tau; i++) { ... }
      //--- Compute t-statistic for beta (slope) with df = n-2
      if(t_val > bsadf) bsadf = t_val;
     }
   return(bsadf);
  }
Параметр m_lookback определяет значение L. По умолчанию установлено значение 252 (один год дневных баров), подходящее для выявления краткосрочных (свинговых) и среднесрочных пузырей. Для внутридневных баров с периодом H1 один год соответствует 252 × 24 = 6 048 барам; установка lookback = 504 (две недели баров H1) позволяет выявлять краткосрочные движения со взрывной динамикой на этом таймфрейме.
Тесты на субмартингальность и супермартингальность
Тесты SM-Exp и SM-Power заменяют спецификацию ADF прямыми регрессиями по функциональным формам времени, проверяя, следует ли логарифм цены экспоненциальной или степенной траектории. Оба используют ту же схему скользящего окна, что и SADF:
//+------------------------------------------------------------------+
//| Sub-/Super-martingale test regressors:                           |
//|   SM-Exp: log(y_t) = log(α) + β·t + ξ_t   (t-stat on β)          |
//|   SM-Power: log(y_t) = log(α) + β·log(t) + ξ_t                   |
//+------------------------------------------------------------------+
double t_e = (double)(k - s);               // linear time index for SM-Exp
double t_p = (t_e > 0.0) ? MathLog(t_e) : 0.0;  // log-time index for SM-Power
Оба теста возвращают абсолютные значения t-статистик, поэтому SMTExp(0) и SMTPower(0) всегда неотрицательны, если их значения определены. Высокое значение SM-Exp указывает на то, что логарифмы цен следуют линейному временному тренду (экспоненциальный рост цен); высокое значение SM-Power указывает на рост цен по степенному закону. Включение обоих тестов наряду с SADF дает модели, использующей их результаты, информацию о функциональной форме траектории взрывной динамики, полезную для определения размера позиции и оценки продолжительности рыночного режима.
Накопление сумм для МНК в каждом семействе тестов
Каждое из трех семейств тестов, требующих регрессии, реализует накопление сумм для МНК непосредственно в своем коде. Формулы различаются, поскольку спецификация Чоу не содержит свободного члена, тогда как спецификации SADF и SMT его включают.
Регрессия DFC типа Чоу имеет вид Δyt = δ · yt−1 · Dt[τ*] + εt: без свободного члена. Оценка коэффициента наклона равна β = ΣXY / ΣX², причем суммы накапливаются только по активному участку (k ≥ τ*). Дисперсия остатков рассчитывается по всей выборке с числом степеней свободы df = n − 1 (один оцениваемый параметр). Дисперсия оценки равна var(β) = σ² / ΣX². Использование формулы оценки β для модели со свободным членом (n·ΣXY − ΣX·ΣY) / (n·ΣX² − (ΣX)²) вместе с остатками модели без свободного члена приводит к смещенной оценке σ² и заниженной t-статистике; остатки необходимо вычислять при тех же предположениях о модели, что и оценку коэффициента.
Внутренний цикл SADF в _SADFAtT() оценивает регрессию Δy на yt−1 со свободным членом: y = α + β · x + ε. В нем накапливаются суммы для нормальных уравнений со свободным членом — n·ΣXY − ΣX·ΣY в числителе, n·ΣX² − (ΣX)² в знаменателе, — вычисляются α и β, а на втором проходе при расчете остатков вычитаются оба слагаемых модели. Для расчета дисперсии остатков используется число степеней свободы df = n − 2. Цикл перебора начальных точек SMT следует той же схеме, но лаговый уровень заменяется функцией времени (линейной для SM-Exp, логарифмической для SM-Power).
Во всех трёх случаях внутренний цикл не выделяет никаких временных массивов помимо заранее сформированного фрагмента. Все суммы накапливаются за один прямой проход. Для каждого семейства применяются защита от почти вырожденного случая (|denom| < 1e-20) и проверка минимального числа допустимых наблюдений (n ≥ 4). Если знаменатель слишком мал или допустимых наблюдений недостаточно, вызывающий код оставляет в выходном массиве значение SB_EMPTY, не допуская появления NaN или сбоя. Это согласуется с логикой CMicrostructureFeatures.mqh: любое значение признака, превышающее SB_EMPTY + 1.0, считается допустимым.
Интеграция с советником и маршрутизация признаков
Шесть статистик структурных сдвигов, вычисляемых CStructuralBreaks, используются в советнике для двух задач: выявления рыночного режима и выбора стратегии. Превышение над критическим значением с учетом знака для CSW и значение SADF определяют, какая стратегия активна; индекс бара структурного сдвига по тесту Чоу задает параметры окон глубины истории; статистики SMT уточняют классификацию рыночных режимов, когда сигнал SADF неоднозначен.
#include <StructuralBreaks\CStructuralBreaks.mqh>

//+------------------------------------------------------------------+
//| Input parameters for structural break thresholds                 |
//+------------------------------------------------------------------+
input int    inp_lookback        = 252;
input int    inp_min_length      = 20;
input int    inp_n_bars          = 300;
input double inp_sadf_explosive  = 1.5;
input double inp_sadf_steady     = -0.5;

CStructuralBreaks *g_sb  = NULL;
datetime          g_last = -1;

//+------------------------------------------------------------------+
//| OnInit: create structural breaks engine                          |
//+------------------------------------------------------------------+
int OnInit()
  {
   g_sb = new CStructuralBreaks(_Symbol, _Period,
                                  inp_min_length, inp_lookback);
   if(g_sb == NULL) return(INIT_FAILED);
   return(INIT_SUCCEEDED);
  }

//+------------------------------------------------------------------+
//| OnTick: process new bar, read features, apply regime logic       |
//+------------------------------------------------------------------+
void OnTick()
  {
   //--- New bar check
   if(iTime(_Symbol, _Period, 0) == g_last) return;
   g_last = iTime(_Symbol, _Period, 0);

   //--- Compute statistics on the last inp_n_bars bars
   if(!g_sb.Calculate(1, inp_n_bars)) return;

   //--- Retrieve current SADF value (offset 0)
   double sadf = g_sb.SADFValue(0);
   if(sadf <= SB_EMPTY + 1.0) return;   // window not yet filled

   //--- Three-regime classifier based on SADF
   if(sadf > inp_sadf_explosive)
     {
      //--- Explosive regime: trend / event strategy
      //--- Refine with SMT for trajectory shape
      double smt_exp   = g_sb.SMTExp(0);
      double smt_power = g_sb.SMTPower(0);
      //--- smt_exp > smt_power → exponential acceleration likely
     }
   else if(sadf < inp_sadf_steady)
     {
      //--- Steady regime: mean-reversion strategy
      //--- half-life ≈ -log(2) / log(1 + beta) from ADF coefficient
     }
   else
     {
      //--- Unit-root zone: reduce exposure, wait
      //--- CSW excess confirms whether drift has accumulated
      double csw_excess = g_sb.CSWStat(0) - g_sb.CSWCritical(0);
     }
  }
Пороговые значения SADF — inp_sadf_explosive и inp_sadf_steady — предоставляются в качестве входных параметров, а не задаются жестко. Их оптимальные значения зависят от инструмента, таймфрейма и глубины истории L; их следует устанавливать на основе анализа исторического распределения SADF для целевого инструмента, а не считать значения 1.5 и −0.5 универсальными. Проверочный скрипт выводит примеры значений на баре 0, которые помогают откалибровать эти пороги по текущим рыночным данным перед вводом в эксплуатацию.
Индикатор StructuralBreaksViewer
Описанный выше класс представляет собой вычислительный модуль без собственной визуализации. StructuralBreaksViewer.mq5 служит для него оболочкой в виде индикатора в отдельном окне, который можно добавить на любой график для одновременного отображения всех шести статистик. Его основное назначение — калибровка: анализ исторического распределения каждой статистики перед окончательным выбором пороговых значений для классификатора рыночных режимов в советнике.
Устройство
Индикатор использует шесть буферов для построения линий DRAW_LINE — по одному для каждой статистики. Отображение каждого ряда можно независимо включить или отключить с помощью логических входных параметров (InpShowCSWStat, InpShowSADF и т. д.). Статистики семейств CSW, Chow, SADF и SMT имеют разные диапазоны абсолютных значений: статистика CSW обычно находится в пределах от 0 до 5; статистика SADF на инструментах с выраженным трендом может принимать значения от −3 до 10 и выше. Если нанести все ряды данных на одну ось без корректировки, получится нечитаемый график, в котором доминируют наибольшие значения. Переключатель InpNormalize решает эту проблему, выполняя независимую нормализацию по z-оценке каждого ряда в пределах видимого окна перед записью в буфер отрисовки. В выводе Comment() всегда отображается последнее исходное значение каждого видимого ряда независимо от настройки нормализации, поэтому пороги всегда можно калибровать по фактической шкале статистики без перезапуска индикатора.
Вычисления выполняются один раз при появлении нового бара, а не на каждом тике. Механизм проверки появления нового бара сравнивает rates_total со значением, сохраненным при предыдущем вызове; изменение запускает полный пересчет последних InpMaxBars баров. Вычислительные ядра SADF и SMT со сложностью O(L²) делают эту операцию основной по вычислительным затратам; на дневном графике с параметрами по умолчанию InpMaxBars = 400 и InpLookback = 252 один вызов Calculate() занимает значительно меньше секунды. На внутридневных графиках та же глубина истории охватывает гораздо меньше календарных дней; пропорциональное уменьшение InpLookback с учетом частоты баров позволяет сохранить прежний бюджет времени на вычисления.
//+------------------------------------------------------------------+
//| OnCalculate: indicator main loop – recompute on new bar only     |
//+------------------------------------------------------------------+
int OnCalculate(const int rates_total,
               const int prev_calculated,
               const int begin,
               const double &price[])
  {
   bool recompute = (prev_calculated == 0) || (rates_total != g_last_rt);
   if(recompute)
     {
      //--- ComputeFeatures populates g_raw and g_computed_n.
      //--- FillBuffers is called unconditionally: if compute fails,
      //--- g_computed_n is 0 and FillBuffers clears all buffers to
      //--- EMPTY_VALUE, preventing stale data from the previous pass.
      bool ok = ComputeFeatures(rates_total);
      FillBuffers(rates_total);
      if(ok) RefreshReadout();
      g_last_rt = rates_total;
     }
   return(rates_total);
  }
Функция FillBuffers() отделяет решение о применении нормализации от этапа вычислений. Когда InpNormalize = true, функция за один прямой проход вычисляет среднее значение и стандартное отклонение каждого ряда по всем допустимым значениям, а затем записывает (v − mean) / sd в буфер отрисовки. Когда InpNormalize = false, значение записывается напрямую в исходном виде. В обоих случаях для вывода Comment данные берутся из массива g_latest[], в котором хранится последнее допустимое исходное значение, записанное функцией ComputeFeatures().
Известные ограничения
Остаются два структурных ограничения, для устранения которых потребуются более существенные изменения архитектуры.
Индикатор рассчитывает все шесть статистических показателей для каждого нового бара, независимо от того, какие ряды данных отображаются. Когда и InpShowSADF, и входные параметры SMT имеют значение false, вычислительные ядра со сложностью O(L²) в функциях _ComputeSADF() и _ComputeSMT() всё равно выполняются для всех InpMaxBars баров. При InpMaxBars = 400 и InpLookback = 252 на эти вычисления приходится основная часть процессорного времени, затрачиваемого на обработку каждого бара. Добавление в Calculate() параметра маски вычислений позволило бы полностью пропускать эти ядра, когда соответствующие ряды скрыты, снизив вычислительные затраты на бар примерно на 70 % в режиме отображения только CSW.
Кроме того, при появлении каждого нового бара индикатор с нуля пересчитывает статистики для всех InpMaxBars баров. На самом деле изменяется только последняя конечная точка; предыдущие n − 1 значений совпадают с результатами вычислений на предыдущем баре. При инкрементальном обновлении сохранялись бы n − 1 предыдущих значений SADF, а вычислялось бы только значение для одной новой конечной точки, что снизило бы вычислительные затраты на SADF для каждого бара с O(n · L²) до O(L²). Это позволило бы использовать индикатор при большем количестве баров без увеличения верхнего предела глубины истории.
Проверка
Сопутствующий скрипт StructuralBreaksValidation.mq5 проверяет пять математических инвариантов, которые должны выполняться для любого допустимого торгового инструмента и таймфрейма:
| Проверка | Свойство | Обоснование |
|---|---|---|
| 1 | f.Count() == n_bars | Размеры выходных массивов должны соответствовать запрошенному количеству баров. |
| 2 | Критическое значение CSW ≥ √4.6 ≈ 2.14 во всех точках, где оно определено | cα[n,t] = √(4.6 + log(span)) ≥ √4.6 для всех значений span ≥ 1. |
| 3 | Значение SADF конечно во всех точках, где оно определено | Любое значение NaN или Inf указывает на ошибку в дисперсии остатков или в знаменателе. |
| 4 | SMT-Exp ≥ 0 во всех точках, где значение определено | В SMT используется |t-stat|; абсолютное значение всегда неотрицательно. |
| 5 | Значение DFC типа Чоу конечно во всех точках, где оно определено | Та же проверка дисперсии остатков, что и для SADF. |
Перед развертыванием любого советника, использующего CStructuralBreaks, запустите скрипт на EURUSD D1 с глубиной истории по умолчанию — 150 баров. Если проверка 2 завершилась с ошибкой, это означает, что было вычислено отрицательное значение best_span, что указывает на переполнение индекса во внутреннем цикле CSW — убедитесь, что n_bars ≥ min_length + 4. Если проверка 3 или 5 завершилась неудачно, дисперсия, близкая к нулю, приводит к появлению ложного значения Inf; уменьшите min_length или увеличьте n_bars, чтобы для оценивания методом МНК было доступно больше данных в каждом окне.
Совпадение численных результатов Python и MQL5
Приведенный ниже рисунок подтверждает, что реализация SADF на MQL5 воспроизводит результаты Python с машинной точностью на том же синтетическом ряде из 200 баров, который использовался в части 9, с двумя искусственно добавленными эпизодами взрывной динамики.
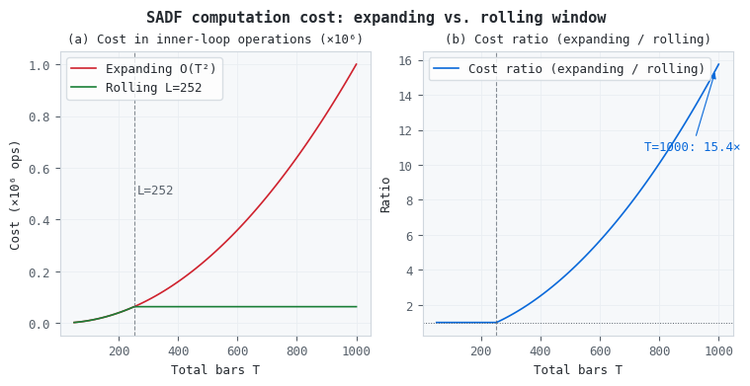
Рисунок 3. Двухпанельная иллюстрация совпадения результатов SADF в Python и MQL5 на синтетическом ряде из 200 баров (два эпизода взрывной динамики выделены затенением)
- Панель (a): временные ряды SADF из обеих реализаций, наложенные друг на друга. Линии Python (сплошная синяя) и MQL5 (пунктирная оранжевая) визуально неотличимы. В обеих реализациях статистика корректно подскакивает выше порога взрывной динамики 1.5 во время обоих искусственно добавленных эпизодов.
- Панель (b): диаграмма рассеяния результатов Python и MQL5 на каждом баре. Значение r² = 1,000000 подтверждает совпадение результатов вычислений с плавающей точкой. Любая ошибка в выборе порядка индексации привела бы к систематическому смещению точек относительно диагонали y = x на величину, пропорциональную тренду ряда.
Чтобы повторить эту проверку на собственных данных, экспортируйте бары OHLCV из MetaTrader 5 в файл CSV, примените функцию Python get_sadf() из части 9 к столбцу с логарифмами цен и сравните результаты по каждому бару с результатами функции SADFValue(), полученными из скрипта. Используйте одинаковые значения параметров min_length и lookback в обеих реализациях; несовпадение любого из этих параметров приводит к систематическим различиям в результатах, которые легко принять за следствие ошибки в формуле.
Заключение
В этой статье три семейства тестов на структурные сдвиги из части 9 были перенесены на MQL5 в виде единого подключаемого файла CStructuralBreaks.mqh, размещенного в папке MQL5/Include/StructuralBreaks/. Класс предоставляет шесть признаков для каждого бара: статистику CSW и ее критическое значение, DFC типа Чоу, SADF, SM-Exp и SM-Power. Для каждого семейства тестов накопление сумм для МНК реализовано непосредственно в коде; тест Чоу использует МНК без свободного члена с df = n − 1, тогда как SADF и SMT используют МНК со свободным членом с df = n − 2. Для всех шести статистик используется единое значение-маркер SB_EMPTY = −1e38, принятое в CMicrostructureFeatures.mqh.
Ключевое проектное решение — использование скользящего окна вместо расширяющегося окна для SADF — ограничивает вычислительную сложность на один бар величиной O(L²), а не O(T²), что позволяет применять эту реализацию в советнике при любой практически встречающейся длине ряда. При использовании скользящего окна SADF интерпретируется не как исторический максимум, а как максимум в текущем окне, что соответствует назначению признака для выбора рыночного режима в реальном времени.
Различие между хронологическим порядком индексации в Python и порядком индексации таймсерии в MQL5 — основной источник скрытых ошибок при подобном переносе кода. Внутри каждого вычислительного метода класса используется хронологический порядок, а преобразование индексов в порядок индексации таймсерии выполняется только при записи результатов. Такая структура позволяет напрямую проверять соответствие статистической логики формулам, приведенным в главе.
Сопутствующий индикатор StructuralBreaksViewer.mq5 предоставляет графический инструмент на основе этого класса, работающий в отдельном окне индикатора. Переключатель нормализации по z-оценке позволяет отображать все шесть статистик на общей оси для визуального анализа; вывод исходных значений через Comment показывает фактический масштаб статистик, необходимый для калибровки порогов выбора рыночного режима в советнике перед запуском.
Список литературы
- Лопес де Прадо, М. (2018). Достижения в области финансового машинного обучения. Wiley. Глава 17.
- Эндрюс, Д. (1993). Тесты на нестабильность параметров и структурные сдвиги с неизвестной точкой сдвига. Econometrica, 61(4), 821–856.
- Чоу, Г. (1960). Тесты на равенство наборов коэффициентов в двух линейных регрессиях. Econometrica, 28(3), 591–605.
- Хомм, У., и Брейтунг, Й. (2012). Выявление спекулятивных пузырей на фондовых рынках: сравнение альтернативных методов. Journal of Financial Econometrics, 10(1), 198–231.
- Филлипс, П., Ву, Ю., и Ю, Дж. (2011). Взрывная динамика Nasdaq в 1990-е годы: когда эйфория привела к росту стоимости активов? International Economic Review, 52, 201–226.
- Филлипс, П., и Ю, Дж. (2011). Определение временных рамок финансовых пузырей в период кризиса субстандартного ипотечного кредитования. Quantitative Economics, 2, 455–491.
- Маддала, Г., и Ким, И. (1998). Единичные корни, коинтеграция и структурные изменения. Издательство Кембриджского университета.
- Грин, У. (2008). «Эконометрический анализ», 6-е изд. Pearson Prentice Hall.
Прикрепленные файлы
| Файл | Местоположение | Описание | |
|---|---|---|---|
| 1. | CStructuralBreaks.mqh | MQL5/Include/StructuralBreaks/ | Модуль тестов на структурные сдвиги. Предоставляет шесть показателей, индексируемых по барам: статистику CSW и ее критическое значение, DFC типа Чоу, SADF (скользящее окно с глубиной истории L), SM-Exp и SM-Power. |
| 2. | StructuralBreaksViewer.mq5 | MQL5/Indicators/StructuralBreaks/ | Индикатор просмотра в отдельном окне. Отображает все шесть статистических показателей с переключателями видимости для каждого ряда и переключателем нормализации по z-оценке для калибровки пороговых значений. |
| 3. | StructuralBreaksValidation.mq5 | MQL5/Scripts/StructuralBreaks/ | Скрипт проверки. Выполняет пять проверок инвариантов (количество, нижняя граница критического значения CSW, конечность SADF, знак SMT-Exp, конечность статистики Чоу) и выводит примеры значений на баре 0. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/23159
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


