Нейросети в трейдинге: Habi — быстрое принятие решений без сложного планирования (Окончание)
 16
 0

Введение
Повторное диффузионное планирование требует вычислений на каждом шаге. Идея Habi — перенести этот опыт в нейросетевую политику, которая после обучения предлагает действия без повторного построения плана.
В первой статье мы разобрали подход и торговую адаптацию. Во второй части подготовили обработку наблюдений, параметры распределения и выборку латентных векторов. В третьей статье реализовали формирование действий и их оценку. Теперь соберём модели, свяжем их с обучением и исполнением. Завершим серию разбором одного исторического теста EURUSD H1. Он иллюстрирует работу системы, но не устанавливает устойчивость или преимущество метода.
В нашей адаптации эталоны подготавливает Oracul. Последующая история доступна ему только при офлайн-разметке. Для торгового решения модель получает текущее наблюдение. Критик оценивает денежные последствия действий. Имитация онлайн-торговли в тестере связывает изменения счёта между соседними барами с оценкой продолжения.
Обучение и проверка разделены между тремя советниками:
| Программа | Задача | Как используются действия |
|---|---|---|
| Study | Офлайн-обучение на истории | Восстановление эталона и расчёт последствий предложений модели |
| StudyOnline | Обучение в режиме имитации онлайн-торговли | Передача всего пакета кандидатов на исполнение на одном счёте в тестере стратегий |
| Test | Проверка готовых моделей | Исполнение одного кандидата с наибольшей оценкой |
Построение моделей
Объект CHabiModels управляет четырьмя самостоятельными CNet. Prior формирует распределение по наблюдению, Decoder создаёт из его выборок действия, Critic оценивает их. При офлайн-обучении Posterior дополнительно получает эталон. Веса моделей сохраняются отдельно.
Наблюдение содержит историю глубиной HistoryBars, счёт и время решения. В Habi_History.mqh метод CHabiHistory.Market задаёт состав и порядок рыночных признаков: ценовые изменения, тиковый объём и индикаторы. Сведения о счёте и времени подготавливает HabiAccount.
В Trajectory.mqh размеры бара, счёта и действия заданы через BarDescription, AccountState и NActions. Рыночный блок M и наблюдение O имеют длины:
M = HistoryBars × BarDescription; O = M + AccountState.
Для новых моделей LatentSize задаёт длину латентного вектора L, Candidates — число кандидатов N. Размерность действия A равна NActions. Глубина истории, L и N определяют размеры слоёв и буферов, но не меняют назначение моделей.
| Модель | Получаемые данные | Выход |
|---|---|---|
| Prior | Наблюдение длины O | 2L параметров: L средних и L логарифмов дисперсий |
| Posterior | Наблюдение и эталонное действие, O + A значений | Такой же формат распределения из 2L значений |
| Decoder | Одно распределение из 2L значений | N действий по A компонентов |
| Critic | Пакет действий N × A и общее распределение из 2L значений | N скалярных оценок |
Функция HabiCreate собирает для Prior и Posterior одинаковую последовательность преобразований. Общий формат распределений позволяет сопоставлять их при обучении. Различается вход: Posterior дополнительно получает эталон.
CNeuronHabiObservationOCL нормализует рыночные признаки разных масштабов. Счёт и эталон подготовлены своими формирователями и проходят без повторной нормализации.
Два полносвязных слоя ширины L с LReLU выделяют нелинейные сочетания признаков. Так модель может учитывать, что одинаковое движение цены требует разных действий при пустом счёте и открытой позиции. Связи определяются обучением весов.
Линейный слой ширины 2L выдаёт средние и параметры разброса. CNeuronHabiGaussianOCL преобразует вторую половину в положительные стандартные отклонения. На выход поступают средние и логарифмы дисперсий. Это распределение задаёт центр и разброс латентных выборок декодера.
   uint in=role<=1?g.O+(role==1?g.A:0):(role==2?2*g.L:g.N*g.A);

   if(!HabiLayer(d,defNeuronBaseOCL,in,g))
      return(false);

   if(role<=1)
     {
      if(!HabiLayer(d,defNeuronHabiObservationOCL,in,g,None,role==1) ||
         !HabiLayer(d,defNeuronBaseOCL,g.L,g,LReLU) ||
         !HabiLayer(d,defNeuronBaseOCL,g.L,g,LReLU) ||
         !HabiLayer(d,defNeuronBaseOCL,2*g.L,g) ||
         !HabiLayer(d,defNeuronHabiGaussianOCL,2*g.L,g,None,role==1))
         return(false);
     }
В Decoder слой CNeuronHabiVAEOCL получает N выборок длины L. Свёрточные слои обрабатывают строки с общими весами; окно и шаг равны ширине строки. Разные выборки дают варианты действий. SIGMOID переводит их компоненты в диапазон от нуля до единицы.
   else
      if(role==2)
        {
         if(!HabiLayer(d,defNeuronHabiVAEOCL,g.N*g.L,g) ||
            !HabiLayer(d,defNeuronConvOCL,g.N,g,LReLU,false,g.L,g.L) ||
            !HabiLayer(d,defNeuronConvOCL,g.N,g,LReLU,false,g.L,g.L) ||
            !HabiLayer(d,defNeuronConvOCL,g.N,g,SIGMOID,false,g.L,g.A) ||
            !HabiLayer(d,defNeuronHabiDecoderHeadOCL,g.N*g.A,g))
            return(false);
        }
Теперь нужно сравнить предложения. В авторской архитектуре критик получает латентную выборку и действие. Мы сохраняем решение третьей статьи: все действия пакета оцениваются в общем контексте параметров распределения.
c = [μ; ℓ], ℓ = log(σ²)
В μ собраны средние значения, а в σ — стандартные отклонения.
Выборки z остаются внутри декодера. Критику передаются 2L + A значений: распределение и действие. Три свёрточных преобразования ширины L с LReLU обрабатывают строки с общими весами. Последнее преобразование выдаёт денежную оценку без ограничивающей активации: допустимы оба знака. Обучение задаёт CNeuronHabiCriticHeadOCL.
      else
        {
         if(!HabiLayer(d,defNeuronHabiCriticInputOCL,g.N*(2*g.L+g.A),g) ||
            !HabiLayer(d,defNeuronConvOCL,g.N,g,LReLU,false,2*g.L+g.A,g.L) ||
            !HabiLayer(d,defNeuronConvOCL,g.N,g,LReLU,false,g.L,g.L) ||
            !HabiLayer(d,defNeuronConvOCL,g.N,g,LReLU,false,g.L,g.L) ||
            !HabiLayer(d,defNeuronConvOCL,g.N,g,None,false,g.L,1) ||
            !HabiLayer(d,defNeuronHabiCriticHeadOCL,g.N,g))
            return(false);
        }
При запуске CHabiModels.Init получает стадию работы: 0 для офлайн-обучения, 1 для имитации онлайн-торговли и 2 для торгового теста. Во время обучения недостающие модели можно создать. В Test проверяем наличие сохранённых Prior, Decoder и Critic: здесь используются уже подготовленные веса.
   bool              Init(int stage)
     {
      bool training=stage!=2;
      if(!training && (!FileIsExist(PriorFile,CommonFiles?FILE_COMMON:0) ||
                       !FileIsExist(DecoderFile,CommonFiles?FILE_COMMON:0) ||
                       !FileIsExist(CriticFile,CommonFiles?FILE_COMMON:0)))
        {
         Print("Habi: Test requires saved Prior/Decoder/Critic models");
         return(false);
        }
Если файл Prior существует, длину L берём из его выходного слоя. Декодер должен принять представление той размерности, с которой работал сохранённый энкодер.
      if(prior_file!="")
        {
         if(!HabiLoad(prior,prior_file,"Prior") || !prior.Layer(5) ||
            prior.Layer(5).Type()!=defNeuronHabiGaussianOCL)
            return(false);

         g.L=((CNeuronHabiGaussianOCL*)prior.Layer(5)).Latent();
        }
При загрузке Decoder узнаём число кандидатов N. Если Prior ещё предстоит создать, длину L задаёт декодер. Если загружены обе модели, проверяем совпадение их латентных размерностей.
      if(decoder_file!="")
        {
         if(!HabiLoad(decoder,decoder_file,"Decoder") || !decoder.Layer(1) ||
            decoder.Layer(1).Type()!=defNeuronHabiVAEOCL)
            return(false);

         CNeuronHabiVAEOCL *s=decoder.Layer(1);

         g.N=s.Rows();

         if(prior_file=="")
            g.L=s.Latent();
         else
            if(g.L!=s.Latent())
               return(false);
        }
После согласования размеров создаём отсутствующие Prior и Decoder. HabiShape проверяет типы и число слоёв, размеры их буферов. Вход модели должен соответствовать объёму передаваемых данных, а выход — числу ожидаемых результатов.
      if(prior_file=="" && (!training || !HabiCreate(prior,0,g)))
         return(false);

      if(!HabiShape(prior,0,g))
         return(false);

      if(decoder_file=="" && (!training || !HabiCreate(decoder,2,g)))
         return(false);

      if(!HabiShape(decoder,2,g) || !decoder.SetOpenCLChecked(prior.GetOpenCL()))
         return(false);
Study и StudyOnline допускают самостоятельный запуск с новыми или перенесёнными весами. Для Test нужен совместимый готовый комплект. Все модели работают в общем контексте OpenCL, но имеют раздельные веса и рабочие буферы. ValidateRuntime проверяет среду и отсутствие совпадений доступных для проверки буферов разных моделей.
Вместе с весами загружается статистика нормализации Prior. BNReady проверяет её готовность и допустимость. В Test метод Predict использует этот масштаб признаков без накопления статистики на контрольном периоде.
Офлайн-обучение на истории
Обучающий пример связывает наблюдение с действием и его последствиями. Study загружает историю через CHabiHistory.Load в диапазоне Start…End для символа графика. Число проходов задаёт Epochs, таймфрейм — TimeFrame. При PERIOD_CURRENT используется период графика.
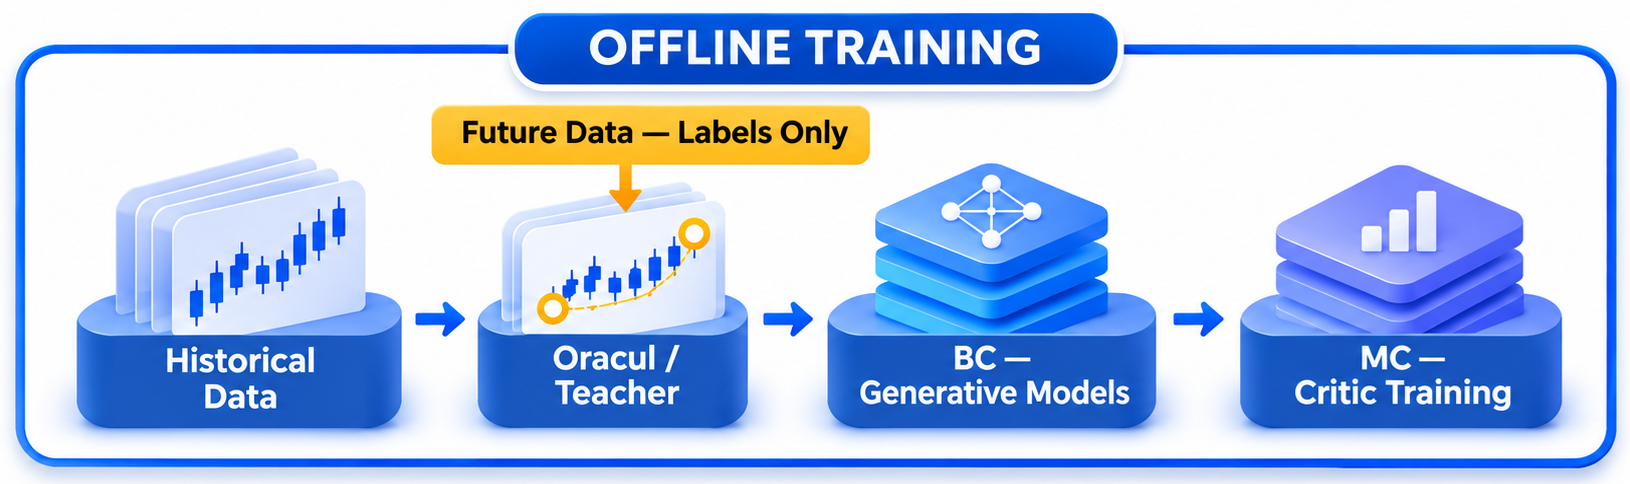
На границе нового бара CHabiHistory.Market читает только предыдущие завершённые бары. В наблюдение входят изменения Close, High и Low относительно Open, тиковый объём, RSI, CCI, ATR и две линии MACD. Данные расположены по столбцам: сначала первый признак для всей глубины истории, затем второй и так далее. Одинаковый порядок при обучении и торговле сохраняет смысл каждого входа модели.
К рыночным данным добавим состояние счёта. Оно влияет на смысл решения: новая целевая покупка может означать открытие, увеличение или сокращение уже имеющейся позиции. Метод Sample создаёт разные исходные состояния на одной истории. После проверки прошлых баров и диапазона MinBalance…MaxBalance он выбирает случайный баланс. Если диапазон не задан, используется InitialOfflineBalance. Затем выбирается покупка, продажа либо отсутствие позиции.
   bool              Sample(int e,SHabiSnapshot &s,SState &record,float &o[])
     {
      ZeroMemory(s);
      ZeroMemory(record);

      if(e<0 || e+MathMax(HistoryBars,5)>=ArraySize(rates))
         return(false);

      bool range=MinBalance!=0 || MaxBalance!=0;

      if(range && (MinBalance<=0 || MaxBalance<MinBalance))
         return(false);

      s.balance=range?MinBalance+Uniform()*(MaxBalance-MinBalance):InitialOfflineBalance;

      if(!MathIsValidNumber(s.balance) || s.balance<=0)
         return(false);

      s.previous_balance=s.balance;
      s.previous_equity=s.balance;
      s.equity=s.balance;

      int side=Discrete(3)-1;
Для открытой позиции выбираются допустимый объём и возраст. Цена входа и плавающий результат рассчитываются по истории. EtalonBalance задаёт масштаб признаков счёта, а не депозит теста. Синтетические снимки не образуют непрерывную торговую траекторию. Проверка покрытия реальных состояний и возможного смещения не представлена.
TP и SL выбираются как допустимые уровни на момент наблюдения. История их предыдущих изменений не восстанавливается: мы моделируем текущее состояние позиции. Примеры с неподходящими котировками, индикаторами или финансовыми параметрами пропускаются и учитываются в статистике прохода.
Эталон подготавливает HabiTeacher. Параметр NForecast задаёт длину последующей истории для HabiOracul. Полученное нормированное шестикомпонентное действие ещё проходит проверку денежных последствий.
HabiHistoricalEvaluate сравнивает предложение учителя с FLAT от одного снимка счёта. Уже накопленный результат позиции входит в исходное состояние. Критерий — изменение стоимости счёта после нового решения, а не вся прибыль с момента открытия позиции.
   vector<float> candidate=HabiOracul(av,future);
   float         pair[];

   ArrayResize(pair,12);
   ArrayInitialize(pair,0);

   for(int k=0;k<6;k++)
      pair[k]=candidate[k];

   SHabiEvaluation evaluation;

   if(!HabiHistoricalEvaluate(h,e,snapshot,pair,2,evaluation))
      return(false);
Предложение учителя становится эталоном, если не получило штраф и его оценка строго выше FLAT. Иначе эталон — FLAT. Поэтому выход из рынка также участвует в обучении.
   bool valid=evaluation.penalty[0]==0 && evaluation.target[0]>evaluation.target[1];

   ArrayResize(teacher,6);

   for(int k=0;k<6;k++)
      teacher[k]=valid?pair[k]:0;

   teacher_return=evaluation.target[valid?0:1];

   return(true);
  }
Будущая история используется только для офлайн-целей, не для входа Prior. Posterior получает выбранное действие и то же рыночное наблюдение. В StudyOnline и Test нет HabiTeacher и Posterior. Поэтому обучение должно согласовать представления с подсказкой и без неё.
Эту задачу решает поведенческое клонирование в CHabiModels.BC. Сначала получаем распределение Prior по наблюдению и распределение Posterior по наблюдению с эталоном. Оба результата сохраняем до обновления весов, чтобы сравнивать модели в одном состоянии.
   bool              BC(const float &o[],const float &teacher[],double &mse,double &kl,double &beta_used)
     {
      float beta=((CNeuronHabiGaussianOCL*)posterior.Layer(5)).EffectiveBeta();
      if(!MathIsValidNumber(beta) || beta<=0)
         return(false);

      uint id=++serial;
      float empty[],qinput[],pv[],qv[],reconstruction[],payload[],prediction[];

      ArrayCopy(qinput,o);
      ArrayCopy(qinput,teacher,ArraySize(o));

      HabiRelease(prior);
      HabiRelease(posterior);
      HabiRelease(decoder);

      if(!HabiForward(prior,o,1,id,empty,true) ||
         !HabiForward(posterior,qinput,1,id,empty,true) ||
         !HabiOutput(prior,5,2*g.L,pv) ||
         !HabiOutput(posterior,5,2*g.L,qv))
         return(false);
Decoder создаёт пакет из распределения Posterior. Все кандидаты сравниваются с одним эталоном. Обратный проход ошибки нормированных координат обновляет декодер и возвращает сигнал reconstruction к параметрам распределения.
      if(!HabiForward(decoder,qv,21,id,empty,true) ||
         !HabiOutput(decoder,5,g.N*g.A,prediction) ||
         !HabiBackward(decoder,23,id,teacher) ||
         !HabiGradient(decoder,reconstruction))
         return(false);
Для Posterior этот сигнал соединяется с KL-дивергенцией между двумя распределениями. Ошибка восстановления направляет модель к действию учителя. Составляющая KL с весом β сближает её распределение с тем, которое Prior получает без подсказки.
      ArrayCopy(payload,pv);
      ArrayCopy(payload,reconstruction,2*g.L);
      ArrayResize(payload,4*g.L+1);
      payload[4*g.L]=beta;

      if(!HabiBackward(posterior,12,id,payload))
         return(false);
Prior приближает сохранённое распределение Posterior из qv, получая только KL-сигнал. Ошибка восстановления напрямую в него не поступает. Оба энкодера используют β из начала шага: адаптация коэффициента не меняет вес согласования посреди обновления.
      ArrayResize(payload,0);
      ArrayCopy(payload,qv);
      ArrayResize(payload,2*g.L+1);
      payload[2*g.L]=beta;

      if(!HabiBackward(prior,11,id,payload))
         return(false);
Ошибку BC рассчитываем по всем компонентам пакета, полученного до обновления. Вместе с KL и фактически использованным весом beta_used она поступает в отчёт об обучении.
      mse=0;
      for(uint i=0;i<g.N*g.A;i++)
        {
         double residual=(double)prediction[i]-teacher[i%g.A];
         mse+=residual*residual;
        }
      mse/=g.N*g.A;
      kl=((CNeuronHabiGaussianOCL*)posterior.Layer(5)).LastKL();
      beta_used=beta;
      return(true);
     }
При включённом AdaptiveBeta вес согласования β изменяется в ходе обучения. BetaValue задаёт начальное значение, BetaLearningRate — скорость изменения его логарифма. После обратного прохода Posterior регулятор реагирует на отклонение суммарной KL от KTarget.
Init задаёт эти параметры новой модели. Для загруженной модели он делает это при включённом ResetLoadedBeta, недопустимом или неположительном β либо несовпадении режима адаптации. В остальных случаях загруженный Posterior сохраняет коэффициент, состояние и прежние параметры регулятора. Проверки при запуске и перед каждым BC требуют конечного положительного β, чтобы согласование распределений участвовало в обучении Prior.
После BC нужно оценить предложения с учётом выполненного обучающего шага. Для этого метод MC повторно подаёт наблюдение и эталон в Posterior, затем выполняет семплирование и декодирование.
   bool              MC(const float &o[],const float &teacher[],float &distribution[],float &a[],uint &id)
     {
      id=++serial;

      float in[],empty[],qv[];

      ArrayCopy(in,o);
      ArrayCopy(in,teacher,ArraySize(o));

      HabiRelease(posterior);
      HabiRelease(decoder);

      return(HabiForward(posterior,in,2,id,empty,false) &&
             HabiOutput(posterior,5,2*g.L,distribution) &&
             HabiForward(decoder,distribution,21,id,empty,false) &&
             HabiOutput(decoder,5,g.N*g.A,a));
     }
Исторический расчёт сопоставит каждому действию денежный результат. Распределение сохраняем для критика вместе с соответствующим пакетом.
В HabiHistoricalEvaluate кандидаты размещены в строках матрицы состояния. Все строки начинают расчёт с одного снимка счёта, затем к каждой применяется своё действие. Общий цикл по PlanningHorizonBars обновляет денежное состояние всех альтернатив. Этот параметр задаёт горизонт оценки последствий; NForecast по-прежнему определяет только участок истории для предложения учителя.
Действие задаёт целевую позицию. Разность нормированных компонентов покупки и продажи определяет её направление и объём. Объём приводится к шагу инструмента и ограничивается VolumeCap. TP и SL переводятся из нормированных расстояний в цены. Проверяются направление торговли, защитные расстояния и доступная маржа. При этом критик сохраняет связь результата с исходным Action6: исполнимый объём не подставляется вместо предложенных моделью компонентов.
После первоначального изменения позиции расчёт отслеживает её на всём горизонте. Новые действия политики внутри него не генерируются. Позиция закрывается по TP или SL. Когда OHLC свечи не позволяет установить порядок достижения обоих уровней, сначала учитывается SL. Если цена вышла за защитный уровень уже на открытии, используется цена открытия. Оставшаяся позиция закрывается на последнем баре горизонта.
Денежные изменения суммируются с дисконтированием. Ближайший результат получает больший вес, если γ находится между нулём и единицей. Цель для кандидата n записывается так:
yn = ∑h=0H−1γh · ΔVn,h − Pn.
Здесь H — PlanningHorizonBars, h — номер бара от нуля, γ — DiscountGamma. Приращение ΔV включает переоценку открытой позиции. В HabiHistoricalEvaluate к HC_RETURN добавляется разность value и HC_PREVIOUS, умноженная на MathPow(DiscountGamma,h). Затем HC_PREVIOUS получает текущее value. Начальная база содержит уже накопленный плавающий результат. Первый шаг имеет вес 1; при γ = 0,5 следующие веса равны 0,5, 0,25 и 0,125. Штраф вычитается один раз после суммирования, а не на каждом баре.
После обхода HC_RETURN содержит дисконтированный денежный результат. Из него вычитаем штраф за установленную экономическую недопустимость или нулевую защиту. Результат и штраф сохраняются отдельно. Расчёт доходит до конца горизонта и после закрытия позиции.
   for(int n=0;n<C;n++)
     {
      double money=agents[n,HC_RETURN];
      double penalty=agents[n,HC_PENALTY];
      double target=money-penalty;

      if(!MathIsValidNumber(target) || MathAbs(target)>FLT_MAX)
         return(false);

      result.target[n]=(float)target;
      result.money_return[n]=money;
      result.penalty[n]=penalty;
      result.reason[n]=(int)(penalty>0 || agents[n,HC_EXIT_REASON]==HABI_OK ? agents[n,HC_REASON] :
                                                                              agents[n,HC_EXIT_REASON]);
      result.status[n]=1;
     }

   return(true);
Спред в этом расчёте учитывается через Bid и Ask. Отдельные комиссии и свопы для виртуальных исходов не начисляются. Стоимость ценового изменения берётся из доступного терминалу значения тика, маржа — через OrderCalcMargin. Поэтому при переносе на инструменты со сложной конвертацией и издержками нужно учитывать эти допущения. В режиме имитации онлайн-торговли денежные данные уже поступают из журнала сделок тестера.
В LearnMC метод Scores оценивает исходные действия в сохранённом распределении. Обратный проход уменьшает отличие от исторических целей, обновляя только Critic. В генератор денежный сигнал на этом этапе не передаётся.
   bool              LearnMC(const float &distribution[],
                             const float &a[],
                             const float &targets[],
                             uint id, double &mse)
     {
      float q[];

      if(!Scores(critic,distribution,a,id,31,true,q) || !HabiBackward(critic,32,id,targets))
         return(false);
Средний квадрат отклонений сохранённых до обновления оценок q от целей даёт ошибку критика на пакете.
      mse=0;
      for(uint i=0;i<g.N;i++)
        {
         double residual=(double)q[i]-targets[i];
         mse+=residual*residual;
        }
      mse/=g.N;
      return(true);
     }
Описанные операции объединяет StudyStep. Он движется от старой части истории к новой, проверяя наличие прошлого окна и полного будущего горизонта. Таймер выполняет шаги последовательно и между ними проверяет лимит времени обработки. Из-за пропусков за заданное число проходов для обучения используется меньше примеров.
На графике показаны BC-обновления, MC-шаги, пропуски и скорость обработки. RMSE — корень из средней квадратической ошибки. BC Action6 RMSE относится к нормированным действиям, Critic MC RMSE — к денежным оценкам, KL — к распределениям. Снижение этих разных ошибок само по себе не доказывает улучшения торговли.
RMSE и KL агрегируются по примерам с начала запуска. Показанный β использован в последнем успешном BC-шаге, хотя сохранённая модель может уже содержать коэффициент после адаптации. BC-обновлений иногда оказывается больше, чем MC-шагов: историческая оценка может стать недоступной уже после изменения генератора.
Кнопка остановки вызывает сохранение моделей. Позиция обхода истории не сохраняется: при новом запуске индекс примера и счётчики создаются заново. Можно продолжить обучение имеющихся весов, но прежний проход и случайная последовательность полностью не восстанавливаются.
Обучение в режиме имитации онлайн-торговли
Офлайн-расчёт ограничен заданным горизонтом. Советник StudyOnline учит учитывать продолжение торговли, связывая денежное изменение за бар с оценкой следующего состояния. Он работает в режиме имитации онлайн-торговли в тестере стратегий и получает данные по мере продвижения моделируемого времени.
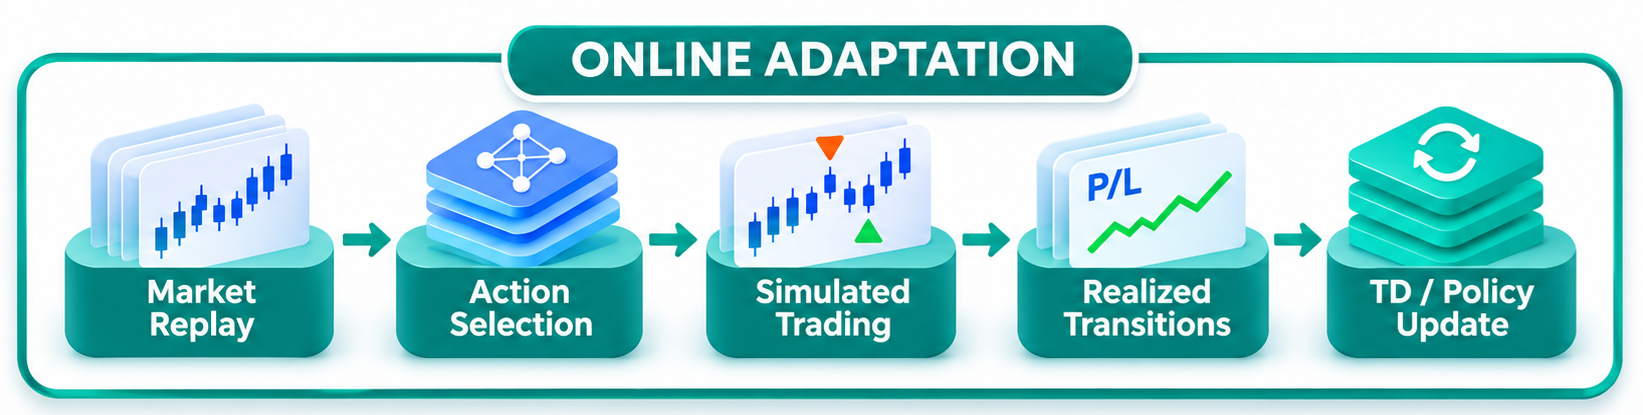
Распределение формирует Prior. Декодер создаёт N действий, каждое передаётся в слот со своим Magic. Требуется хеджинговый счёт. Баланс, маржа и следующее наблюдение общие; позиции символа агрегируются. Исполнение одного предложения может ограничить средства для остальных. Индивидуальный денежный учёт не делает эти действия независимыми. Поэтому StudyOnline обучает оценки в совместной среде, а не строгие контрфактические оценки одиночного действия. Перенос этих оценок в однокандидатный Test — методическое допущение. Его влияние нужно проверять отдельно; кривые двух советников напрямую несопоставимы.
Метод Begin сохраняет наблюдение, точное распределение, действия и начальные денежные значения. Это связывает последующее обучение с контекстом генерации. Повторный прогноз старого наблюдения после обновления весов дал бы уже другое распределение.
   bool              Begin(const float &observation[],
                           const float &distribution[],
                           const float &actions[],
                           datetime bar)
     {
      int k=ArraySize(records);
      int N=ArraySize(slots);

      ArrayResize(records,k+1);

      ZeroMemory(records[k]);

      records[k].id=++next_record;
      records[k].start=bar;

      ArrayCopy(records[k].observation,observation);
      ArrayCopy(records[k].distribution,distribution);
      ArrayCopy(records[k].actions,actions);
На следующей границе Boundary добавляет наблюдение, накопленный денежный и плавающий результат. Пропуск границы — разрыв данных. Внутри бара события уточняют исполнение, но не запускают прогноз и не продлевают старую команду.
Сведения об исполнении и издержках могут прийти позже запроса. Ready допускает обучение после окончания интервала. Для этого денежные данные на обеих границах должны быть подтверждены для всех слотов. Незавершённые запросы откладывают обучение по этой записи. При разрыве данных она исключается из обучения.
   bool              Ready(int k)
     {
      if(!records[k].boundary || records[k].used || records[k].gap)
         return(false);

      int N=ArraySize(slots);

      for(int n=0;n<N;n++)
        {
         if((slots[n].pending || slots[n].unknown) && slots[n].command==records[k].command[n])
            return(false);

         //--- an unestablished monetary snapshot is not repaired with today's cash
         //--- the whole record stays unresolved instead of receiving a fake reward
         if(!records[k].money_known[n])
            return(false);
Вознаграждение слота складывается из изменения накопленного результата сделок ΔC и плавающего результата ΔF, за вычетом штрафа P:
r = ΔC + ΔF − P
В ΔC входят прибыль, своп, комиссия и сбор. Изменение плавающего результата учитывается и тогда, когда позиция остаётся открытой и новых сделок нет. Неустановленные суммы не заменяются нулём или текущим балансом.
         double r=records[k].end_cash[n]-records[k].start_cash[n]+records[k].end_float[n]-
                  records[k].start_float[n]-records[k].penalty[n];

         if(!MathIsValidNumber(r) || MathAbs(r)>FLT_MAX)
           {
            records[k].gap=true;

            return(false);
           }

         records[k].reward[n]=(float)r;
        }

      return(true);
     }
Повторное получение данных одной сделки обновляет запись по её идентификатору и не удваивает результат. После закрытия позиции торговля может продолжиться новым решением. Признак done задаётся границей OnlineEpisodeEnd. По умолчанию она равна 0 и не задана. Остановка тестера сама по себе не создаёт терминальный переход. Для последнего перехода также нужны полные денежные данные.
Теперь готовый переход можно использовать для TD-обновления — обучения по временной разности. За один бар обрабатывается не более одного самого старого готового перехода. Его распределение и действия берутся из сохранённой записи.
Если эпизод завершён для всех слотов, дальнейших решений в нём нет. Метод TD оставляет оценки продолжения нулевыми и пропускает дополнительный прогноз. Обучающая цель определяется только результатом последнего интервала.
   bool              TD(const float &distribution[],
                        const float &a[],
                        const float &reward[],
                        const float &done[],
                        const float &next[])
     {
      uint id=++serial;

      float boot[],payload[],q[];

      ArrayResize(boot,g.N);
      ArrayInitialize(boot,0);

      bool terminal=true;

      for(uint n=0;n<g.N;n++)
         if(done[n]!=1)
            terminal=false;
Для незавершённого эпизода TargetPrior, TargetDecoder и TargetCritic оценивают следующее наблюдение. Их параметры фиксированы между синхронизациями. Максимум нового пакета служит общим продолжением всех слотов, хотя текущая награда у каждого своя.
      if(!terminal)
        {
         float target_distribution[],ta[],tq[];

         HabiRelease(target_prior);
         HabiRelease(target_decoder);

         if(!Generate(target_prior,target_decoder,next,id,false,target_distribution,ta) ||
            !Scores(target_critic,target_distribution,ta,id,35,false,tq))
            return(false);

         float mx=tq[0];

         for(uint n=1;n<g.N;n++)
            mx=MathMax(mx,tq[n]);

         ArrayInitialize(boot,mx);
        }
Для каждого действия обучающая цель y складывается из его вознаграждения и взвешенной оценки продолжения:
y = r + γ × (1 − done) × Qnext.
Здесь Qnext — найденный максимум, γ задаёт вес будущего результата. При done, равном единице, остаётся только r. Эти величины передаются основному Critic. Его веса меняются так, чтобы уменьшить расхождение оценки с целью; в целевые модели этот обучающий сигнал не поступает.
      ArrayCopy(payload,reward);
      ArrayCopy(payload,done,g.N);
      ArrayCopy(payload,boot,2*g.N);

      return(Scores(critic,distribution,a,id,31,true,q) &&
             HabiBackward(critic,33,id,payload));
     }
Метод Sync обновляет целевые модели полным копированием текущих параметров. Частоту задаёт target_period, а счётчик растёт только после успешного TD-обновления. Период синхронизации поэтому измеряется принятыми переходами: для их накопления может потребоваться больше календарных баров.
Policy обновляет генератор для повышения средней оценки пакета. Используются сохранённые действия, случайные значения и активации предыдущего прогноза. Новая выборка нарушила бы эту связь. Флаги train_prior и train_decoder разрешают обновления. Без сохранённого прохода или при запрете обоих обновлений шаг пропускается.
   bool              Policy()
     {
      if(!policy_live || (!train_prior && !train_decoder))
        {
         HabiRelease(prior);
         HabiRelease(decoder);

         policy_live=false;

         return(true);
        }

      float empty[],q[],ga[],gc[],payload[],gp[];
Во время этого шага веса критика временно замораживаются. Его обратный проход показывает, в какую сторону менять действие и общий контекст распределения для повышения оценки. Затем прежний режим обновления критика восстанавливается.
      bool frozen=critic.WeightsUpdateEnabled();

      if(!critic.SetWeightsUpdate(false))
         return(false);

      bool ok=Scores(critic,last_distribution,last_actions,policy_frame,36,true,q) &&
              HabiBackward(critic,34,policy_frame,empty) && HabiGradient(critic,ga) &&
              ((CNeuronHabiCriticInputOCL*)critic.Layer(1)).DirectGradient(gc);

      critic.SetWeightsUpdate(frozen);

      if(!ok)
         return(false);
payload содержит градиент действий ga и прямой градиент распределения gc. Первый проходит через декодер и выборку. train_decoder управляет весами, но не блокирует производную по входу: Prior можно обучать через фиксированный декодер.
      ArrayCopy(payload,ga);
      ArrayCopy(payload,gc,g.N*g.A);

      bool old=decoder.WeightsUpdateEnabled();

      decoder.SetWeightsUpdate(train_decoder);

      ok=HabiBackward(decoder,24,policy_frame,payload);

      decoder.SetWeightsUpdate(old);

      if(!ok)
         return(false);
После обратного прохода VAE сигнал действий относится к 2L параметрам распределения. К нему добавляется прямой gc. При включённом train_prior сумма обучает энкодер по обоим путям влияния на оценку. Затем сохранённый проход освобождается.
      if(train_prior && (!HabiGradient(decoder,gp) || !HabiBackward(prior,13,policy_frame,gp)))
         return(false);

      HabiRelease(prior);

      policy_live=false;

      return(true);
     }
На новом баре согласуется торговое состояние и фиксируется денежная граница. При выполнении условий следуют TD, Policy и синхронизация целей. policy_period отсчитывается в барах независимо от готовности TD. Для продолжающегося эпизода обновлённые модели создают и исполняют следующий пакет.
Критик обучается по исходным действиям и их денежным последствиям. Округление объёма, торговое исполнение и выбор максимума в Test не передают производных в генератор. Влияние фактического исполнения на обучение учитывается через вознаграждение и оценку критика.
Торговля с фиксированными моделями
Советник Test проверяет выбор готовой политики. Для него нужны Prior, Decoder и Critic; эталонное действие и Posterior при торговле не используются. Модуль исполнения работает с одним слотом и требует хеджингового счёта.
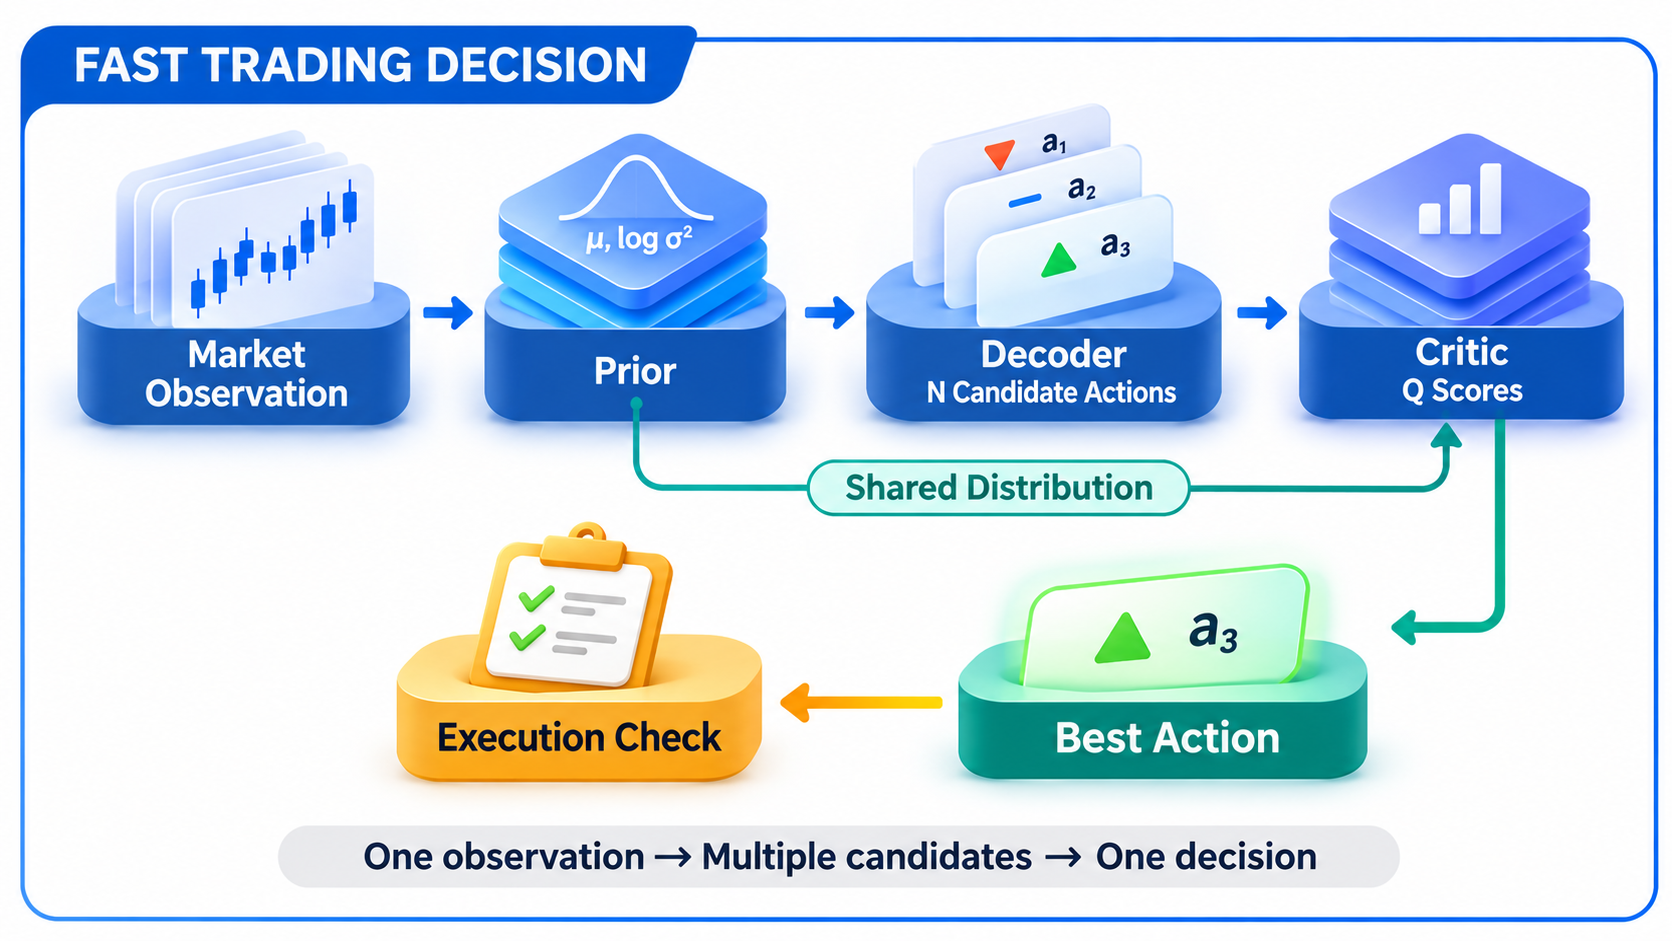
На границе нового бара программа согласует состояние сделок, строит наблюдение и вызывает Predict без обучения. Затем Scores оценивает предложенные действия в общем контексте распределения.
   ulong start=GetMicrosecondCount();
   float observation[];
   float scores[];

   if(!ExtExecution.Observation(ExtHistory,bar,observation) ||
      !ExtModels.Predict(observation,false) ||
      !ExtModels.Scores(ExtModels.critic,ExtModels.last_distribution,ExtModels.last_actions,
                                                         ++ExtModels.serial,35,false,scores))
     {
      ExtFailed=true;
      HabiFatal("Test observation/forward failed");

      return;
     }

   ExtExecution.CommitAccountBoundary();
Для исполнения выбирается максимум оценки критика. Индекс меняется только при строгом превышении, поэтому при равенстве остаётся первый кандидат.
   int best=0;

   for(uint n=1;n<ExtModels.g.N;n++)
      if(scores[n]>scores[best])
         best=(int)n;

   ulong elapsed=GetMicrosecondCount()-start;

   PrintFormat("Habi Test decision_us=%I64u N=%u selected=%d Q=%.9g",
                             elapsed,ExtModels.g.N,best,scores[best]);
Показатель decision_us — разность показаний GetMicrosecondCount до подготовки наблюдения и после выбора кандидата. Он включает Observation, Predict, Scores, получение выходов моделей, CommitAccountBoundary и поиск максимума. PrepareBar выполнен до начала отсчёта; вывод строки журнала и Execute — после его окончания. Это время данного участка программы, а не отдельного GPU-кернела и не задержка исполнения ордера. Без серии замеров, параметров оборудования и сопоставимого планировщика оно не доказывает ускорения. Такие замеры здесь не представлены.
Компоненты выбранного действия передаются в единственный торговый слот. Метод Execute проверяет их допустимость и обрабатывает команду с учётом существующей позиции.
   float raw[];

   ArrayResize(raw,6);

   ArrayCopy(raw,ExtModels.last_actions,0,best*6,6);

   ExtExecution.generation++;

   if(!ExtExecution.Execute(0,raw,bar))
     {
      ExtFailed=true;
      HabiFatal("Test execution data/profile failure");
     }
Отказ выбранного действия не запускает поиск следующего кандидата по оценке. FLAT задаёт нулевую целевую позицию и запускает закрытие имеющейся позиции. Нулевая защита также запускает закрытие. Смена направления требует подтверждённого закрытия прежней позиции и повторной проверки условий нового входа. Экономический отказ в прежнем направлении может оставить позицию без изменений. При технической ошибке данных или профиля советник прекращает принимать новые решения. При этом позиции у брокера могут остаться открытыми.
Даже при фиксированных весах VAE семплирует новые векторы. Использованное RandomSeed = 0 означает seed по времени, а не фиксированный ноль. HabiStart выводит фактическое значение в журнал. Для повторения нужны seed каждого этапа, те же веса, настройки и вычислительная среда.
Тестирование
Для обучения и тестирования использовали параметры по умолчанию. Обучающая история — EURUSD H1 с 01.01.2024 по 01.01.2026; торговый тест — январь–апрель 2026 года, депозит — 1000 USD. Результат относится к одному запуску. Отделим настройки программы от условий тестера.
| Условие | Значение или граница подтверждения |
|---|---|
| Инструмент, тест, депозит | EURUSD H1; январь–апрель 2026 года; 1000 USD. |
| Обучение | Start = 01.01.2024; End = 01.01.2026; Epochs = 500. |
| Настройки | Использованы значения по умолчанию; основные приведены ниже. |
Последовательность этапов: Study — BC/KL и MC; StudyOnline — TD и обновления политики; Test — фиксированные модели.
TimeFrame = PERIOD_H1. При создании модели получаем M = 216, O = 229, вход Posterior — 235 значений. При загрузке L и N берутся из весов.
| Параметры | Значения |
|---|---|
| HistoryBars; BarDescription; AccountState; NActions | 24; 9; 13; 6 |
| LatentSize; Candidates | 256; 64 |
| normalization_batch; TrainingBatch | 100000; 10000; оптимизатор ADAM |
| PlanningHorizonBars; NForecast; DiscountGamma | 24 бара; 12 баров; 0,5 |
| AdaptiveBeta; BetaValue; BetaLearningRate; KTarget | true; 0,001; 0,001; 5,042 |
| BetaRho1; BetaRho2; BetaEpsilon; ResetLoadedBeta | 0,9; 0,999; 10⁻⁸; false |
| VolumeCap; MaxTP; MaxSL | 1 лот; 1000; 1000 пунктов |
| EtalonBalance; PenaltyInvalidCurrency | 10000; штраф 1 в валюте счёта |
| policy_period; target_period | 5 баров; 120 успешных TD-обновлений |
| enable_critic_td; enable_policy; train_prior; train_decoder | Все true |
| Индикаторы | RSI 14, Close; CCI 14, Typical; ATR 14; MACD 12/26/9, Close |
| Study: MinBalance; MaxBalance; Epochs | 50; 150; 500 |
| RandomSeed; OnlineEpisodeEnd; CommonFiles | 0; 0; true |
Здесь использован штатный профиль, а не заявленный оптимум:
- γ = 0,5 уменьшает вес продолжения вдвое за шаг;
- β = 0,001 — начальное, а не постоянное значение.
В представленном примере январский рост сменился снижением к февралю. Восстановление продолжилось в марте; в апреле рост чередовался с откатами.
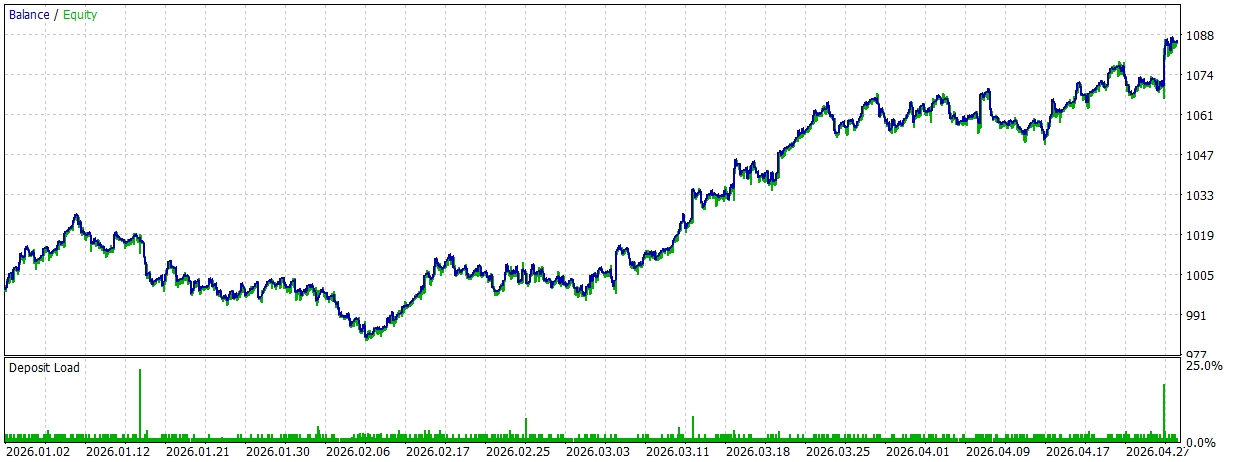
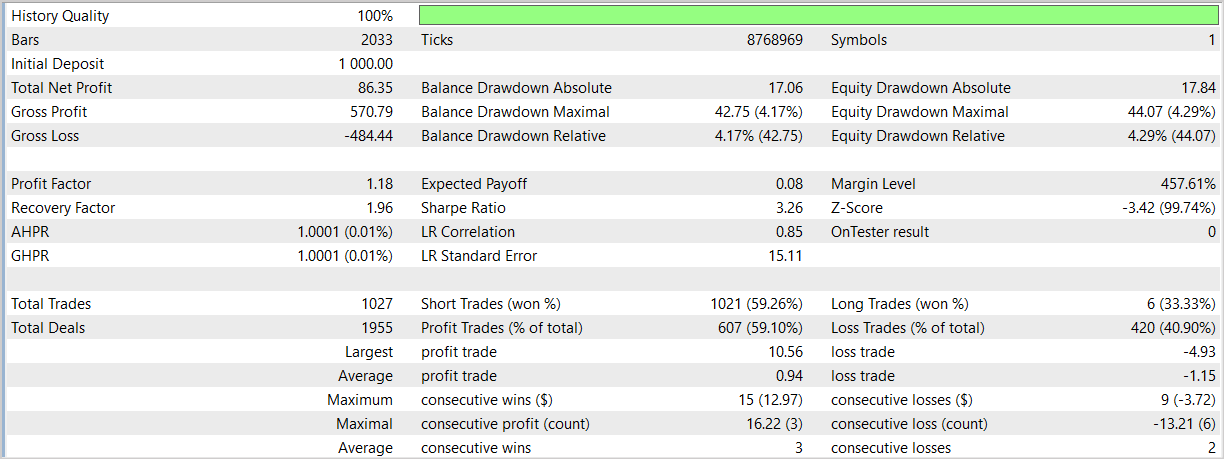
Чистая прибыль составила 86,35 USD, или 8,64% начального депозита. Максимальная просадка средств — 44,07 USD (4,29%), баланса — 42,75 USD (4,17%). Фактор восстановления — 1,96. Эти показатели сохранены из представленного результата; независимый повторный прогон не выполнен.
Совершено 1027 сделок, прибыльных — 607 (59,10%). Средняя прибыль — 0,94 USD, средний убыток — 1,15 USD. Profit factor — 1,18, средний результат сделки — 0,08 USD.
Продаж было 1021, покупок — 6. Причина этого перекоса отдельно не проверена. Шести покупок недостаточно для оценки длинной стороны. Без сравнения с удержанием короткой позиции нельзя отделить вклад метода от направленности рынка.
Минимальный уровень маржи — 457,61%. Краткие всплески загрузки депозита дополняют сведения о просадке, но не заменяют анализ риска на других участках.
Заключение
Мы собрали слои Habi в четыре модели и связали их с историей, обучением и исполнением. Офлайн генератор восстанавливает эталон, а критик оценивает исторические последствия. В имитации онлайн-торговли обучение использует продолжение на следующем баре.
При выборе действия Prior формирует распределение по текущему наблюдению. Decoder создаёт предложения, Critic выбирает лучшее по своей оценке. В этом маршруте нет повторного диффузионного планирования; его ускорение здесь численно не подтверждено.
В показанном тесте EURUSD H1 получены 8,64% прибыли и 4,29% максимальной просадки средств. Использованы параметры по умолчанию. Без сопоставимых базовых прогонов и повторных OOS-проверок результат не доказывает устойчивость или превосходство Habi, торговая пригодность требует дополнительных испытаний.
Ссылки
- Habitizing Diffusion Planning for Efficient and Effective Decision Making.
- Другие статьи серии "Нейросети в трейдинге".
Файлы проекта
| # | Имя | Тип | Описание |
|---|---|---|---|
| 1 | Trajectory.mqh | Общий модуль | Подключение модулей моделей, истории и исполнения; общий запуск |
| 2 | Study.mq5 | Советник | Советник предварительного офлайн-обучения |
| 3 | StudyOnline.mq5 | Советник | Советник тонкой онлайн-настройки |
| 4 | Test.mq5 | Советник | Исполнение торговой политики с фиксированными весами |
| 5 | NeuroNet.mqh | Библиотека классов | Подключение модулей нейронной библиотеки |
| 6 | NeuroNet.cl | OpenCL-программа | Вычислительные кернелы нейронной библиотеки |
| 7 | NeuroNet_Habi.mqh | Библиотека классов | Базовый слой и компоненты Habi, рассматриваемые в статье |
Репозиторий проекта: NN_in_Trading.
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.