Построение моделей волатильности в MQL5 (Часть IV): Долгая память волатильности — диагностика и реализация FIGARCH и HARCH
 40
 0

Содержание
- Введение: недостатки модели GARCH
- Долгая память волатильности
- FIGARCH или HARCH: что выбрать?
- GARCH с дробным интегрированием
- Гетерогенная авторегрессионная модель с условной гетероскедастичностью
- Заключение
Введение: недостатки модели GARCH
Трейдеры и разработчики алгоритмов, использующие модели семейства GARCH(1,1), часто сталкиваются с практической дилеммой: модель либо слишком быстро "забывает" сильные шоки, связанные со сменой режима, либо, при настройке на высокую персистентность, ведет себя как IGARCH, в которой шоки никогда не затухают. На реальных рынках волатильность часто затухает гораздо медленнее: кластеры волатильности могут сохраняться неделями или месяцами, и одно экспоненциальное ядро часто дает плохое приближение. Таким образом, практический вопрос звучит конкретно: как доказать, что ваш прокси-показатель волатильности (|r| или r²) обладает долгой памятью, и, если это так, какую реализацию на MQL5 следует использовать — FIGARCH с гиперболическим затуханием или HARCH с явной агрегацией по нескольким горизонтам — чтобы она была одновременно статистически обоснованной и пригодной для практического применения? 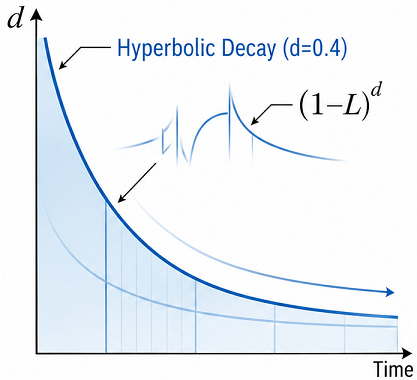
В статье дается ответ на этот вопрос: приводятся формальные тесты (R/S-тест Херста и GPH) с проверками достаточности размера выборки; предлагается визуальная спектральная диагностика; предоставляются рабочие реализации на языке MQL5 и демонстрационные скрипты, которые позволят вам тестировать и выбирать модели волатильности с долгой памятью, оценивать их параметры и внедрять их в ваш торговый стек.
Долгая память волатильности
Теоретическое обоснование использования моделей FIGARCH или HARCH основано на доказательстве того, что волатильность демонстрирует долгосрочную персистентность. Чтобы количественно оценить это свойство, можно оценить показатель Херста (H) с помощью анализа нормированного размаха. Если показатель Херста находится в диапазоне от 0,5 до 1,0, то наблюдается персистентность с долгой памятью. Точность показателя Херста зависит от того, как временной ряд разбивается на сегменты. Оптимальный подход заключается в том, чтобы учитывать минимальную и максимальную длину сегмента, а не выбирать произвольное число. Минимальный размер сегмента ни в коем случае не должен быть меньше 10–20 точек данных. Использование окон меньшего размера приводит к статистически недостоверным оценкам. Максимальная длина, как правило, ограничивается значением N/2 или N/4, где N — общий размер выборки. Это гарантирует наличие достаточного количества отдельных сегментов для получения достоверного среднего значения.
Для уточнения регрессии размеры окон выбираются с равным шагом по логарифмической шкале. Это обеспечивает равный вес масштабов коротких и длинных окон за счёт выбора их размеров по геометрической прогрессии. В тесте вместо цены используются модули доходностей или квадраты доходностей, поскольку они служат косвенными показателями волатильности. Более высокий показатель Херста укрепляет аргументы в пользу моделей FIGARCH или HARCH. Тест на показатель Херста реализован в виде функции hurst_exponent_rs() в файле tests.mqh. Функция принимает два параметра: вектор ряда, который необходимо проанализировать, и целое число, обозначающее количество сегментов для разбиения.
//+-------------------------------------------------------------------+
//| Calculates the Hurst Exponent using Rescaled Range (R/S) Analysis.|
//+-------------------------------------------------------------------+
double hurst_exponent_rs(vector& time_series, int partitions = 20)
  {
//--- Get total elements in the source array
   int N = (int)time_series.Size();

//--- Enforce sample size threshold to guarantee statistical validity
   if(N < 200)
     {
      Print(__FUNCTION__, ": Time series too short for robust R/S analysis.\nMinimum length is 200");
      return EMPTY_VALUE;
     }

   int max_chunks = 0;

//--- Clamp the minimum partition scale dimension to 10 to ensure a valid regression sample size
   if(partitions < 10)
      partitions = 10;

   max_chunks = partitions;

//--- Generate a vector of target window sizes spaced logarithmically from 50 up to N/2
   vector log_space = np::logspace(log10(50), log10(floor(N / 2)), ulong(max_chunks));
//--- Deduplicate window sizes to ensure distinct scale steps
   vector chunk_sizes = np::unique(log_space);

//--- Declare processing vectors for holding calculations at various scoping levels
   vector rs_values, rslist, valid_sizes, chunk, y, z;
   double R, S;
   ulong num_chunks, rsl, rs;

   rs = 0;
//--- Explicitly allocate space for tracking metrics across the unique window configurations
   rs_values.Resize(0, chunk_sizes.Size());
   valid_sizes.Resize(0, chunk_sizes.Size());
   ulong size = 0;

//--- Main Loop: Iterate through each scale size group
   for(ulong j = 0; j < chunk_sizes.Size(); ++j)
     {
      size = (ulong)chunk_sizes[j];
      num_chunks = ulong(N) / ulong(size); //--- Total complete intervals of length 'size'
      rslist.Resize(0, num_chunks);        //--- Reset sub-period collection buffer
      rsl = 0;

      //--- Sub-Loop: Extract segments and compute R/S components for each chunk
      for(ulong i = 0; i < num_chunks; ++i)
        {
         //--- Slice time series array from [i * size] to [(i + 1) * size]
         chunk = np::sliceVector(time_series, long(i * size), long((i + 1) * size));
         if(!chunk.Size())
           {
            Print(__FUNCTION__, ": vector size ", time_series.Size(), " params: ", long(i * size), ",", long((i + 1) * size));
            return EMPTY_VALUE;
           }

         //--- Mean-center the localized segment data
         y = chunk - chunk.Mean();
         //--- Compute integrated time series through cumulative summation
         z = y.CumSum();
         //--- Range calculation: Max peak value minus Min trough value
         R = z.Max() - z.Min();
         //--- Unbiased sample standard dev estimation (N-1 normalization)
         S = chunk.Std(1);

         //--- Prevent NaN or Infinity states by checking that standard deviation is non-zero
         if(S > 0.0)
           {
            //--- Dynamically scale down/up the array allocation bounds as required
            if(rslist.Size() < rsl + 1)
               rslist.Resize(rsl + 1, num_chunks - (rsl + 1));
            rslist[rsl++] = R / S; //--- Store calculated rescaled range
           }
        }

      //--- If the processed scale size yielded valid R/S pairs, aggregate them
      if(rslist.Size())
        {
         if(rs_values.Size() < rs + 1)
           {
            rs_values.Resize(rs + 1, chunk_sizes.Size() - (rs + 1));
            valid_sizes.Resize(rs + 1, chunk_sizes.Size() - (rs + 1));
           }
         //--- Save the average R/S scalar across this chunk size grouping
         rs_values[rs] = rslist.Mean();
         valid_sizes[rs++] = double(size);
        }
     }

//--- Convert the valid scales and their respective averaged R/S values to natural logarithms
   valid_sizes = log(valid_sizes);
   rs_values = log(rs_values);

//--- Fit a straight line (order=1) to the log-log transform points.
//--- poly[0] holds the calculated gradient (slope), which is the Hurst Exponent (H).
   vector poly = np::polyfit(valid_sizes, rs_values, 1);

   return poly[0];
  }
//+------------------------------------------------------------------+
Альтернативным или дополнительным методом является тест Гевеке и Портера-Худака (GPH). Тест GPH представляет собой полупараметрический подход к оценке параметра дробного интегрирования (d). Если d > 0, то процесс обладает долгой памятью. Если d находится в диапазоне от 0 до 0,5, процесс является стационарным, и его память затухает гораздо медленнее, чем в стандартной модели GARCH. В тесте GPH выполняется регрессионный анализ на самых низких частотах периодограммы. Периодограмма — это инструмент, используемый в обработке сигналов и анализе временных рядов для выявления основных частот в наборе данных. Она разлагает временной ряд на частотные составляющие, показывая, какие из них наиболее выражены. Количество частот, включенных в регрессию, зависит от параметра ширины полосы — альфа.
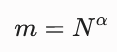
где N — длина выборочного временного ряда. Параметр альфа регулирует соотношение между смещением и дисперсией при оценке d. В научной литературе значение альфа, равное 0,5, считается распространенным и оптимальным выбором для наборов данных среднего размера. При проведении теста на очень больших наборах данных (например, N > 100 000) может оказаться полезным проверить ряд при различных значениях альфа в диапазоне от 0,4 до 0,6.
В заголовочном файле tests.mqh определена функция gph_test(). Функция принимает в качестве аргументов вектор и параметр ширины полосы — альфа. Функция возвращает вектор, состоящий из двух элементов. Первый элемент — оценка параметра дробного интегрирования. Второй элемент — это значение вероятности (p-значение). p-значение отражает вероятность того, что наблюдаемая оценка параметра дробного интегрирования обусловлена случайностью. Чем меньше значение, тем лучше.
//+------------------------------------------------------------------+
//| Geweke and Porter-Hudak (GPH) Test for fractional integration    |
//+------------------------------------------------------------------+
vector gph_test(vector& time_series, double alpha=0.5)
  {
//--- Step 1: Pre-validation ---
//--- Ensure there are enough data points to compute a meaningful discrete Fourier transform.
   if(time_series.Size() < 30)
     {
      Print(__FUNCTION__, ": Sample size is too small to compute a meaningful periodogram.");
      return vector::Zeros(0);
     }

//--- Mean-center the time series to eliminate any DC bias (zero-frequency component)
   vector x = time_series - time_series.Mean();

//--- Prepare data structures for the Native MQL5 Fourier Transform library
   CRowDouble real = x;
   CRowComplex dft;

//--- --- Step 2: Spectral Density Estimation ---
//--- Execute a Real-to-Complex 1D Fast Fourier Transform (FFT)
   CFastFourierTransform::FFTR1D(real, real.Size(), dft);
   vectorc vec = dft.ToVector();

//--- Compute the periodogram: I(λ) = |I_f(λ)|^2 / (2 * π * N)
//--- This measures the variance contribution of each fundamental frequency.
   vector periodogram = pow(c_abs(vec), 2.) / (2. * M_PI * double(x.Size()));

//--- Step 3: Bandwidth Selection ---
//--- Determine the number of low-frequency ordinates (g) to include in the log-periodogram regression.
//--- Commonly set to g = N^α, where α is usually 0.5.
   int g = int(floor(pow(x.Size(), alpha)));
   if(g < 2)
      g = 2; //--- Enforce a mathematical minimum of 2 frequencies to perform linear regression

//--- Compute the Fourier frequencies: λ_j = (2 * π * j) / N
   vector frequencies = 2. * M_PI * np::arange(1.0, double(g + 1), 1.) / double(x.Size());

//--- Slice out the periodogram values corresponding to the selected low-frequency spectrum (skipping DC offset at index 0)
   vector raw = np::sliceVector(periodogram, 1, long(g + 1));

//--- Apply a tiny floor to prevent log(0) domain errors during the regression transformation
   for(ulong i = 0; i < raw.Size(); ++i)
      if(!raw[i])
         raw[i] = 1.e-13;

//--- --- Step 4: Log-Periodogram Linear Regression ---
//--- Dependent variable (Y): Log of the periodogram ordinates
   vector y = log(raw);

//--- Independent variable (X): -2 * log(2 * sin(λ_j / 2)), derived from the spectral density of an ARFIMA process
   vector x_reg = -2. * log(2. * sin(frequencies / 2.));

//--- Fit a ordinary least squares (OLS) linear model. The slope is our estimate of the fractional integration parameter 'd'.
   LinRegressResult rr = linregress(x_reg, y);

//--- --- Step 5: Statistical Inference ---
//--- Compute the denominator (sum of squared deviations of X) to calculate the standard error of the slope
   double denom = (pow(x_reg - x_reg.Mean(), 2.)).Sum();
   if(!denom)
      return vector::Zeros(0);

//--- The GPH test has a known asymptotic theoretical error variance of π^2 / 6
   double theoretical_std_err = sqrt((pow(M_PI, 2.) / 6.0) / denom);

//--- Compute the standard Z-score test statistic
   double z_stat = rr.slope / theoretical_std_err;

//--- Compute the two-tailed p-value using the standard cumulative normal distribution function
   double p_val_theoretical = 2. * (1. - CNormalDistr::NormalCDF(fabs(z_stat)));

//--- Package the output results: index 0 is the memory parameter (d), index 1 is the theoretical significance
   vector out(2);
   out[0] = rr.slope;
   out[1] = p_val_theoretical;

   return out;
  }
Скрипт TestsForLongMemoryInVolatility.ex5 демонстрирует проведение этих тестов на произвольной выборке ценовых данных. Программа позволяет пользователям выбирать в качестве показателя волатильности либо квадраты доходностей, либо модули доходностей.
#include<figarch_harch\Arch\univariate\tests.mqh>

//--- Input parameters for script customization
input string           Symbol_ = "AUDUSD";               //--- Financial asset to test
input ENUM_TIMEFRAMES  TimeFrame = PERIOD_D1;            //--- Chart timeframe interval
input datetime         StartDate = D'2025.01.01';        //--- Start date for historical data retrieval
input ulong            HistoryLen = 1000;                //--- Size of historical data footprint
input ulong            Partitions = 20;                  //--- Target scale segments to feed R/S calculation
input double           PvalueSignificance = 0.05;        //--- Alpha critical limit for statistical hypothesis checks
input double           Bandwidth = 0.5;                  //--- Frequency exponent boundary scaling factor for GPH
input ENUM_VOL_PROXY   VolatilityProxy = VOL_ABSOLUTE_RETURNS; //--- Choice of proxy to represent unobserved volatility

//+------------------------------------------------------------------+
//| Script program start function                                    |
//+------------------------------------------------------------------+
void OnStart()
  {
   vector prices;
//--- --- Step 1: Historical Data Fetch ---
//--- Copy raw historical closing rates directly into a vector array
   if(!prices.CopyRates(Symbol_, TimeFrame, COPY_RATES_CLOSE, StartDate, HistoryLen))
     {
      Print(" failed to get close prices for ", Symbol_, ". Error ", GetLastError());
      return;
     }

//--- --- Step 2: Extract Log Returns and Volatility Proxy ---
//--- Map raw price series into natural log space
   prices = log(prices);

//--- Compute the first-difference array: r_t = ln(P_t) - ln(P_{t-1})
   vector returns = np::diff(prices);

//--- Extract chosen unobserved variance proxy: absolute returns |r_t| or squared returns (r_t)^2
   vector volatility_proxy = VolatilityProxy == VOL_ABSOLUTE_RETURNS ? fabs(returns) : pow(returns, 2.);

//--- ==================================================================
//--- --- 1. Testing for Persistence via Hurst Exponent ($R/S$ Analysis) ---
//--- ==================================================================
   Print("--- 1. Testing for Persistence via Hurst Exponent ---");
   Print("Number of Partitions: ", Partitions ? Partitions : 10);

//--- Calculate the scaling Hurst exponent across the data segments
   double h = hurst_exponent_rs(volatility_proxy, (int)Partitions);
   if(h == EMPTY_VALUE)
     {
      Print("Failed Hurst exponent calculation");
      return;
     }

   PrintFormat("Hurst Exponent: %.4f", h);

//--- Interpret the Hurst exponent scaling score bounds:
//--- H > 0.5: Long memory / persistent trend dynamics
//--- H < 0.5: Mean reverting / anti-persistent dynamics
//--- H == 0.5: Uncorrelated random noise / white noise process
   if(h > 0.55)
      Print("Result: Volatility exhibits long-memory persistence.");
   else
      if(h < 0.45)
         Print("Result: Volatility is anti-persistent.");
      else
         Print("Result: Volatility behaves like a random walk.");

//--- ==================================================================
//--- --- 2. Testing Fractional Integration via GPH ($d$-parameter) ---
//--- ==================================================================
   Print("\n--- 2. Testing Fractional Integration via GPH ---");
   Print("Bandwidth: ", Bandwidth);
   Print("Pvalue significance level: ", 100.0 * (1. - PvalueSignificance));

//--- Execute Geweke and Porter-Hudak log-periodogram OLS spectral density check
//--- Returns: gph_results[0] = estimated parameter (d), gph_results[1] = asymptotic p-value
   vector gph_results = gph_test(volatility_proxy, Bandwidth);
   PrintFormat("Fractional Parameter d: %.4f (p-value: %.4e)", gph_results[0], gph_results[1]);

//--- Check statistical integration conditions:
//--- Under H0, d = 0 (no fractional integration).
//--- If p-value < significance and 0 < d < 0.5, we confirm a stationary long-memory process.
   if((gph_results[1] < PvalueSignificance) && 0 < gph_results[0] && gph_results[0] < 0.5)
      Print("Result: Reject H0. Significant fractional integration detected (Use FIGARCH/HARCH).");
   else
      Print("Result: Fail to reject H0. No strong long memory detected via GPH.");
  }
Ниже приведён пример результатов работы скрипта. Скрипт выводит в терминал результаты каждого теста.
--- 1. Testing for Persistence via Hurst Exponent ---
Number of Partitions: 50
Hurst Exponent: 0.8572
Result: Volatility exhibits long-memory persistence.
--- 2. Testing Fractional Integration via GPH ---
Bandwidth: 0.6
Pvalue significance level: 95.0
Fractional Parameter d: 0.3234 (p-value: 3.4000e-04)
Result: Reject H0. Significant fractional integration detected (Use FIGARCH/HARCH).
Когда волатильность обладает долгой памятью, сложность заключается в том, чтобы математически описать это явление. Стандартные модели GARCH навязывают жесткий выбор. Шоки либо исчезают практически мгновенно в результате экспоненциального затухания, либо навсегда изменяют систему. Мы должны выйти за пределы этих рамок, чтобы реалистично смоделировать кластеры с медленным затуханием, наблюдаемые на финансовых рынках. В финансовой литературе предлагаются две различные парадигмы решения этой проблемы.
- Дробное интегрирование (FIGARCH). Данный подход позволяет решить проблему затухания с помощью чистой математики. В этом подходе вводится параметр дробного интегрирования, позволяющий заменить экспоненциальное затухание функцией гиперболического затухания. Это позволяет преодолеть разрыв между моделями GARCH и IGARCH. В результате модель сохраняет память о прошлых шоках на очень длительных временных горизонтах, не предполагая при этом постоянных структурных сдвигов.
- Гетерогенность рынка (HARCH). Данный подход позволяет решить эту проблему с помощью экономической интуиции. Вместо применения единой функции затухания модель HARCH учитывает, что на рынках действуют разнородные участники. Эти участники действуют на разных временных горизонтах. Долгая память возникает как побочный продукт их взаимодействий.
Реализовав обе модели на языке MQL5, мы сможем рассматривать рынок с двух точек зрения. Одна из них основана на статистическом анализе временных рядов. Другая опирается на реальные поведенческие особенности структуры рынка. Однако прежде чем приступить к изучению кода, нам необходимо создать практическую основу для определения того, какая модель лучше всего подходит для данного набора данных.
FIGARCH или HARCH: что выбрать?
Выбор между FIGARCH и HARCH в MQL5 предполагает поиск баланса между статистической точностью и операционной эффективностью. Математический подход модели FIGARCH к моделированию долгой памяти делает её идеальным выбором для высоколиквидных активов, динамика которых определяется макроэкономическими факторами. Однако такая статистическая строгость сопряжена со значительными вычислительными затратами. Модель HARCH, напротив, представляет собой более практичную с вычислительной точки зрения альтернативу. HARCH идеально подходит для внутридневной торговли (M5, M15, H1) или стратегий скальпинга. В приведенной ниже таблице перечислены преимущества каждой модели по сравнению с другой.
| Преимущества модели HARCH по сравнению с моделью FIGARCH. | Преимущества модели FIGARCH по сравнению с моделью HARCH. |
|---|---|
| Вычислительная эффективность в MQL5: с математической точки зрения для обработки биномиального разложения (1-L)^d в FIGARCH требуется бесконечный цикл суммирования. На практике этот цикл необходимо усечь (обычно ограничившись 1000 или более лагами), чтобы советник MetaTrader не работал с задержками и не зависал при обработке тиков в реальном времени. Модель HARCH, напротив, требует лишь вычисления простых скользящих средних по нескольким конкретным временным интервалам, что не требует больших вычислительных затрат и выполняется быстрее. | Экономность параметризации: для модели FIGARCH требуется оценить лишь несколько параметров (омега, альфа, бета, d). HARCH требует указания количества интервалов и точной длины каждого окна агрегации. Если эти окна выбирать произвольно, возникает риск сильного переобучения. |
| Структурный реализм: HARCH изначально учитывает, что ценовой разрыв после выходных или заявление центрального банка изменяют структуру рынка иначе, чем спокойная азиатская торговая сессия. FIGARCH применяет к каждой единице прошедшего времени одинаковые правила математического взвешивания. | Независимость от временного интервала: параметры FIGARCH сохраняют свою интерпретацию независимо от шага данных. Модель HARCH очень чувствительна к выбору конкретных временных окон. Выбор 4-часового окна вместо 6-часового может радикально изменить прогнозы волатильности. |
Если вы не уверены, какая модель — FIGARCH или HARCH — подходит лучше, проанализируйте периодограмму модулей доходности или квадратов доходностей. Модели с долгой памятью демонстрируют характерное поведение на периодограмме в двойном логарифмическом масштабе, где спектральная плотность представлена как функция частоты. Скрипт FigarchVsHarchSelectionTests.ex5 демонстрирует этот анализ.
#include<figarch_harch\Arch\univariate\tests.mqh>

//--- Input parameters for script customization
input string            Symbol_ = "AUDUSD";               //--- Financial asset to test
input ENUM_TIMEFRAMES   TimeFrame = PERIOD_D1;            //--- Chart timeframe interval
input datetime          StartDate = D'2025.01.01';        //--- Start date for structural history
input ulong             HistoryLen = 1000;                //--- Total historical observations (larger size helps spectral testing)
input double            Bandwidth = 0.5;                  //--- Alpha parameter scaling the GPH test low-frequency ordinates
input ENUM_VOL_PROXY    VolatilityProxy = VOL_ABSOLUTE_RETURNS; //--- Choice of metric to capture historical volatility

//+------------------------------------------------------------------+
//| Script program start function                                    |
//+------------------------------------------------------------------+
void OnStart()
  {
   vector prices;
//--- --- Step 1: Historical Data Retrieval ---
//--- Request raw closing prices into a memory-efficient vector array
   if(!prices.CopyRates(Symbol_, TimeFrame, COPY_RATES_CLOSE, StartDate, HistoryLen))
     {
      Print(" failed to get close prices for ", Symbol_, ". Error ", GetLastError());
      return;
     }

//--- --- Step 2: Calculate Log-Returns ---
//--- Log-transform raw prices and extract the first-difference array
   vector returns = np::diff(log(prices));

//--- --- Step 3: Extract the Volatility Proxy ---
//--- Volatility itself is unobservable, so we extract a proxy tracking it over time.
//--- Evaluates whether to measure asset variance via absolute returns |r_t| or squared returns (r_t)^2.
   vector volatility_proxy = VolatilityProxy == VOL_ABSOLUTE_RETURNS ? fabs(returns) : pow(returns, 2.);

//--- --- Step 4: Spectral Linear Regression & Visualization ---
//--- Pass our chosen proxy into the logging/plotting routine to estimate fractional integration decay.
//--- This handles the Fast Fourier Transform, extracts the periodogram bins, fits a slope trend line,
//--- and automatically renders a graphical analytical window directly inside MetaTrader.
   plot_frequency_domain_fit(volatility_proxy, Bandwidth, "Log-Periodogram");
  }
Скрипт строит логарифмическую периодограмму модулей доходности или квадратов доходностей. Согласно теории, зависимость между спектральной мощностью и частотой вблизи нуля подчиняется степенному закону. Применение логарифмов позволяет преобразовать эту зависимость в линейную. Это подчёркивает линия тренда, проведённая по всему диапазону низких частот, включённых в тест GPH. Поэтому, чтобы выявить источник долгой памяти, мы анализируем поведение спектральной плотности на ультранизких частотах в крайней левой части оси x. Когда долгая память обусловлена дробным интегрированием, логарифмическая периодограмма по мере приближения к нулевой частоте имеет вид плавной непрерывной прямой с большим по модулю отрицательным наклоном. Такой постоянный наклон без изломов подтверждает гиперболическое затухание. Наклон этого линейного тренда напрямую связан с параметром дробного интегрирования d. Функция plot_frequency_domain_fit() определена в файле tests.mqh следующим образом.
//+------------------------------------------------------------------+
//| Computes and plots the log-periodogram vs log-frequency          |
//+------------------------------------------------------------------+
void plot_frequency_domain_fit(vector& time_series, double alpha=0.5, string plotname = NULL)
  {
//--- --- Step 1: Verification & Pre-processing ---
//--- Ensure a sufficient data footprint exists to prevent empty Fourier bins
   if(time_series.Size() < 30)
     {
      Print(__FUNCTION__, ": Time series too short for meaningful spectal analysis");
      return;
     }

//--- De-trend the source data by zero-centering it around its mean
   vector x = time_series - time_series.Mean();
   CRowDouble real = x;
   CRowComplex dft;

//--- --- Step 2: Extract Spectral Energy (FFT) ---
//--- Convert the time-domain series into its raw complex frequency components
   CFastFourierTransform::FFTR1D(real, real.Size(), dft);
   vectorc vec = dft.ToVector();

//--- Normalize the complex magnitudes into standard continuous power spectral densities
   vector periodogram = pow(c_abs(vec), 2.) / (2. * M_PI * double(x.Size()));

//--- --- Step 3: Nyquist Limit Mapping ---
//--- Real signal symmetry means we only need the lower positive spectrum half (up to Nyquist frequency)
   ulong half_n = x.Size() / 2;
   vector frequencies = 2. * M_PI * np::arange(1.0, double(half_n + 1), 1.0) / double(x.Size());
   vector power_spectrum = np::sliceVector(periodogram, 1, long(half_n + 1));

//--- Enforce strict positive boundaries using a clip function to safely prevent log(0) domain errors
   if(!frequencies.Clip(1.e-13, frequencies.Max()) ||
      !power_spectrum.Clip(1.e-13, power_spectrum.Max()))
     {
      Print(__FUNCTION__, ": Clip() vector method error ", GetLastError());
      return;
     }

//--- Map values into a uniform log-log space to reveal linear fractional relationships
   vector log_freq = log(frequencies);
   vector log_power = log(power_spectrum);

//--- --- Step 4: Long-Memory Region Isolation ---
//--- Isolate the low-frequency boundary coordinates where long-term persistence dynamics occur
   int g = int(pow(x.Size(), alpha));
   g = fmax(2, fmin(g, int(log_freq.Size()))); //--- Constrain bounds between 2 and maximum vector boundaries

   vector log_freq_low = np::sliceVector(log_freq, 0, long(g));
   vector log_power_low = np::sliceVector(log_power, 0, long(g));

//--- --- Step 5: Linear Fit Estimation ---
//--- Perform OLS linear regression across the target long-memory region to resolve the scaling trend line
   vector pf = np::polyfit(log_freq_low, log_power_low, 1);
   vector trend_line_low = pf[0] * log_freq_low + pf[1];
   Print("Fraction Decay Fit, slope/d :", pf[0]);

//--- --- Step 6: Render Graphic Matrix ---
//--- Define descriptive display keys for the multi-series plot legend
   string plots[] =
     {
      "Log-Periodogram (Full Spectrum)",
      "Long Memory Zone (Low Freq)",
      "Fractional Decay Fit (Slope/d:" + DoubleToString(pf[0], 2) + ")"
     };

//--- Bundle data into a structured vector array to feed the graphical plot engine
   vector yplots[3];
   yplots[0] = log_power;       //--- Original complete power spectral structure
   yplots[1] = log_power_low;   //--- Truncated long-memory region highlight dots
   yplots[2] = trend_line_low;  //--- Calculated regression trend line over the low-frequency subset

//--- Pass structures to the visual canvas overlay utility
   np::plotxys(log_freq, yplots, plots, "Frequency Domain Periodogram Analysis: " + plotname, "Log frequency", "Log Power(Spectral Density)", false, 0, 0, 20, 20, 750, 500, true, 2, 1, 30);
   return;
  }
Ниже приведён график логарифмической периодограммы с типичными признаками дробного интегрирования, обосновывающими применение модели FIGARCH.
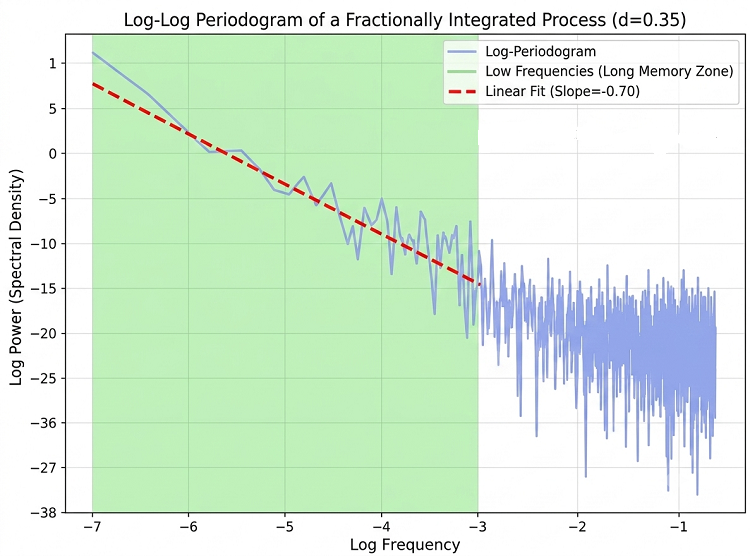
Ключевой особенностью является низкочастотная зона (выделенная зеленым цветом), простирающаяся от log(λ) = −3 до −7. По мере снижения частоты (при перемещении влево, что соответствует более длительным временным горизонтам) спектральная мощность линейно и непрерывно увеличивается. Красная пунктирная линия линейной аппроксимации имеет явный отрицательный наклон, равный −0,70. В спектральном анализе наклон в этом диапазоне ультранизких частот напрямую связан с параметром дробного интегрирования соотношением: наклон ≈ −2d. При наклоне −0,70 получаем d ≈ 0,35. Поскольку значение d лежит внутри диапазона 0 < d < 0,5, подтверждается стационарность ряда при наличии долгой памяти с медленным гиперболическим затуханием.
В отличие от спектра рынка с чётко разграниченными, конфликтующими торговыми горизонтами, этот спектр плавно спадает вдоль линии линейной регрессии. Отсутствие отдельных изолированных пиков или провалов спектральной мощности свидетельствует о том, что долгосрочная зависимость однородна и непрерывна на всех дальних временных горизонтах. FIGARCH является идеальным выбором в данном случае, поскольку плавный тренд соответствует его фильтру дробного разложения. Применение к этому ряду модели HARCH с фиксированными дискретными окнами агрегации дало бы лишь грубое приближение плавного непрерывного дробного затухания.
Напротив, когда долгую память формируют участники с разными временными горизонтами, логарифмическая периодограмма отклоняется от плавной линии. Она демонстрирует отчетливые локальные ступени или сдвиги мощности в определенных частотных диапазонах. Эти структурные неравномерности соответствуют дискретным торговым горизонтам различных участников рынка. Вместо равномерного затухания график показывает изрезанное распределение спектральной энергии. Это свидетельствует о том, что долгая память актива является совокупным побочным результатом столкновения инвестиционных циклов.
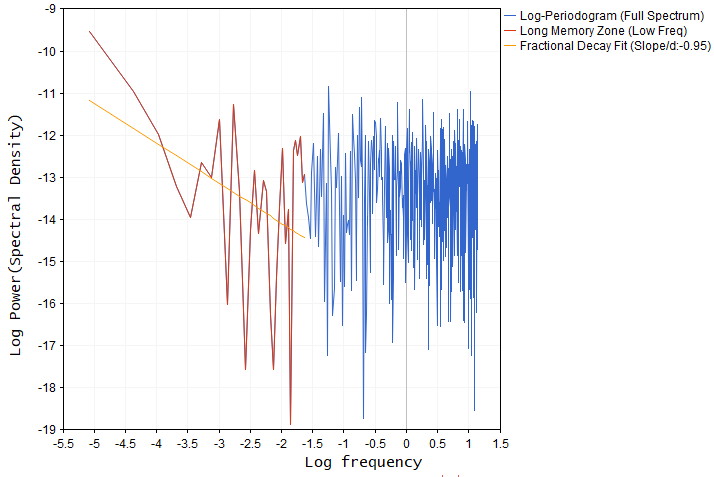
При запуске скрипта на выборке данных в низкочастотной области в крайней левой части графика вместо плавного снижения обнаруживаются отчетливые зубчатые колебания и выраженные структурные пики. В то время как прямая линия регрессии призвана отразить единый дробный тренд, исходные данные отклоняются от нее, образуя локальные волны и резкие спады. Такое стратифицированное распределение спектральной энергии служит явным свидетельством неоднородной структуры рынка. Долгая память волатильности обусловлена действиями участников с разными временными горизонтами, работающих на дискретных временных интервалах, а не непрерывным процессом дробного затухания.
Следовательно, для этого конкретного набора данных лучше всего подходит модель HARCH. Модель FIGARCH неоправданно сгладила бы эти отчетливые спектральные сдвиги, навязав данным гладкую математическую кривую. Напротив, модель HARCH учитывает эти локализованные скопления энергии, агрегируя волатильность по независимым окнам ретроспективного анализа.
При отсутствии признаков персистентности логарифмическая периодограмма имеет тенденцию к росту, как показано на приведенном ниже графике.
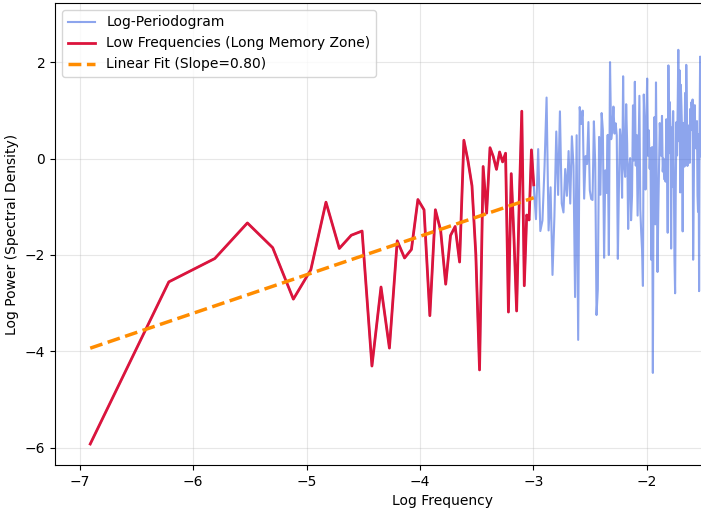
При переходе справа налево в сторону сверхнизких частот логарифм мощности резко падает. В этом наборе данных дисперсия не накапливается на длительных горизонтах: энергия долгосрочных циклов практически равна нулю. Поскольку на нулевой частоте мощность резко падает, этот ряд не является процессом с долгой памятью. Это означает, что данные демонстрируют сильную тенденцию к возврату к среднему значению. Любой краткосрочный шок немедленно компенсируется коррекцией в противоположном направлении, полностью устраняющей долгосрочную структурную персистентность.
Для перехода от этой теоретической динамики рынка к работающей торговой системе требуются модели, способные учитывать как краткосрочный возврат к среднему значению, так и долгосрочную кластеризацию волатильности. В следующих разделах мы перейдем от теории к практике, рассмотрев детали реализации моделей FIGARCH и HARCH на языке MQL5.
GARCH с дробным интегрированием
Чтобы преодолеть разрыв между моделью GARCH с быстрым затуханием и моделью IGARCH с постоянным эффектом шоков, Ричард Бэйли, Тим Боллерслев и Ханс Оле Миккельсен предложили модель FIGARCH (GARCH с дробным интегрированием). Чтобы понять структуру этой модели, необходимо рассмотреть, как она устраняет разрыв между стандартной моделью GARCH (с короткой памятью) и интегрированной моделью GARCH (с бесконечной памятью). Стандартная модель GARCH(p,q) выражает текущую условную дисперсию (σ_t)^2 как функцию прошлых остаточных шоков (ϵ_t)^2 и прошлых дисперсий.
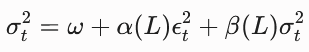
Где L — оператор запаздывания.
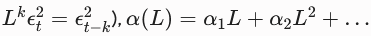
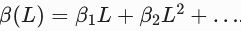
Определим неожиданное изменение волатильности, или инновацию, следующим образом.
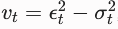
Мы можем переписать стандартный процесс GARCH в виде ARMA-процесса для квадратов доходностей.
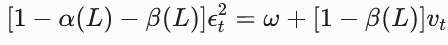
Если сгруппировать полиномы запаздывания, определив ϕ(L) = [1 − α(L) − β(L)], получим следующее выражение.
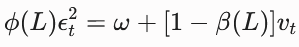
В интегрированной модели GARCH (IGARCH) авторегрессионный многочлен ϕ(L) содержит единичный корень. Это означает, что сумма коэффициентов α и β равна ровно 1, что вводит в уравнение оператор разности первого порядка (1−L).
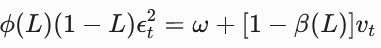
Из-за наличия члена (1−L) эффект любого шока в системе сохраняется навсегда. Память никогда не затухает. В реальном мире обычно не происходит резкого перехода от быстрого экспоненциального затухания (GARCH) к шокам с постоянным эффектом (IGARCH). Для моделирования медленного гиперболического затухания Бэйли, Боллерслев и Миккельсен заменили оператор разности целого порядка (1−L) оператором дробной разности (1−L)^d, где d — дробное число от 0 до 1. Таким образом, мы получаем исходную формулу FIGARCH(p,d,q).
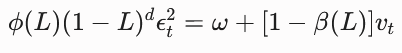
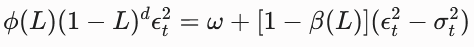
Раскройте скобки в правой части уравнения.
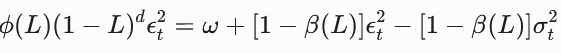
Выделите член, выражающий условную дисперсию, переместив его влево, а дробный член — вправо.
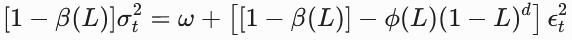
Теперь разделим всё уравнение на [1−β(L)], чтобы явно выразить σ².
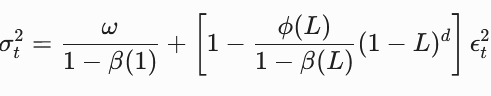
(Примечание: β(1) — это просто сумма коэффициентов β; для свободного члена оператор запаздывания заменяется единицей.) Вычислительная сложность связана с разложением дробного члена (1−L)^d. Если d представляет собой дробь, выражение (1−L)^d невозможно вычислить с использованием конечного числа лагов. Вместо этого его необходимо разложить с помощью биномиальной теоремы.
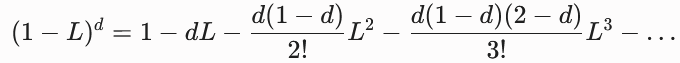
Это разложение даёт бесконечную последовательность коэффициентов с медленным гиперболическим затуханием. Если представить всё выражение в больших скобках из полученного уравнения в виде бесконечного полиномиального ряда, формула упрощается до следующего вида.
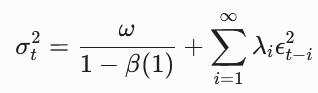
Поскольку текущая дисперсия теперь определяется бесконечной линейной комбинацией квадратов всех прошлых шоков, по своей структуре модель стала моделью ARCH с бесконечным числом параметров. Для практической реализации программисты задают лаг усечения (например, 1000 дней), обрывая бесконечную сумму там, где медленно затухающие гиперболические веса становятся достаточно малыми, чтобы ими можно было пренебречь.
Для поддержки этой архитектуры с усечённой бесконечной суммой необходимо расширить нашу библиотеку MQL5. Мы начинаем реализацию с обновления основных файлов, чтобы обеспечить распознавание новой модели и учёт требований к её настройке. В заголовочном файле base.mqh в перечисление ENUM_VOLATILITY_MODEL добавляется элемент VOL_FIGARCH.
//+------------------------------------------------------------------+
//| Configured conditional volatility structure models               |
//+------------------------------------------------------------------+
enum ENUM_VOLATILITY_MODEL
  {
   VOL_CONST = 0, // Homoskedastic variance baseline profiles
   VOL_ARCH,      // Autoregressive Conditional Heteroskedasticity (Linear lag squares mapping)
   VOL_AVARCH,    // Absolute Value ARCH framework configurations
   VOL_AVGARCH,   // Absolute Value GARCH process modeling variations
   VOL_TARCH,     // Threshold ARCH / ZARCH threshold tracking handling asymmetric volatility shocks
   VOL_GARCH,     // Generalized ARCH processes combining structural innovations and past variance memory
   VOL_GJR_GARCH, // Glosten-Jagannathan-Runkle GARCH tracking sign-dependent asymmetric leverage adjustments
   VOL_FIGARCH    // Fractionally Integrated GARCH mapping long-memory long-term decay processes
  };
Одновременно в структуру ArchParameters добавляется новое свойство figarch_truncation для хранения заданного пользователем предельного лага.
//+------------------------------------------------------------------+
//| Comprehensive specification payload structure for ARCH models    |
//+------------------------------------------------------------------+
struct ArchParameters
  {
   // --- Data & Core Configuration
   vector            observations;       // Vector tracking endog target returns data series
   matrix            exog_data;          // Matrix tracking exogenous external regressor blocks
   vector            mean_lags;          // Vector defining selected conditional mean lag lengths

   ENUM_MEAN_MODEL   mean_model_type;    // Specified mean structural method profile reference
   ENUM_VOLATILITY_MODEL vol_model_type; // Specified volatility variance framework engine reference
   ENUM_DISTRIBUTION_MODEL dist_type;    // Specified baseline conditional probability density model

   ulong             holdout_size;       // Out-of-sample data truncation window count bounds
   bool              is_rescale_enabled; // Scale switch flag to normalize inputs to unit variances
   double            scaling_factor;     // Internal scale factor used for numerical optimization convergence

   // --- Mean Model Parameters
   bool              include_constant;   // Conditional mean calculation model constant flag
   bool              use_har_rotation;   // Flag enabling volatility horizon mapping blocks rotations

   // --- Volatility Process Parameters (GARCH/ARCH)
   int               vol_rng_seed;       // Random initialization seeding value used for variance simulations
   ulong             garch_p;            // Shock innovations lag loop parameter allocation bounds (ARCH)
   ulong             garch_o;            // Asymmetric conditional volatility component bounds (Leverage)
   ulong             garch_q;            // Historical tracking persistence variance memory depth (GARCH)
   double            vol_power;          // Exponent index scaling term used in variance conversions
   ulong             figarch_truncation; // Expansion step cutoff limit boundary tracking fractional integration weights
Переходя к файлу volatility.mqh, мы определяем класс CFiGarchProcess как производный от базового класса CVolatilityProcess. Класс CVolatilityProcess служит основой для всех моделей условной волатильности. Он определяет стандартизированный интерфейс, который позволяет основному механизму оптимизации библиотеки единообразно работать с различными моделями динамики дисперсии.
//+------------------------------------------------------------------+
//|FIGARCH process                                                   |
//+------------------------------------------------------------------+
class CFiGarchProcess: public CVolatilityProcess
  {
protected:
   ulong             m_p,m_q;
   double            m_power;
   ulong             m_truncation;
   //--- Generate model name as string
   string            _genetrateName(void)
     {
      if(m_power == 2.)
        {
         if(m_q == 0)
            return "FIARCH";
         else
            return "FIGARCH";
        }
      else
         if(m_power == 1.)
           {
            if(m_q == 0)
               return "FIAVARCH";
            else
               return "FIAVGARCH";
           }
         else
            if(m_q == 0)
               return StringFormat("Power FIARCH (power: {%.1f})",m_power);
            else
               return StringFormat("Power FIGARCH (power: {%.1f})",m_power);
     }
   //--- Verify the requested forecasting method as valid for the specification
   virtual bool      _check_forecasting_method(ENUM_FORECAST_METHOD method, ulong horizon);
   //--- Analytic multi-step volatility forecasts from the model
   virtual VarianceForecast _analyticforecast(vector& parameters, vector &resids, vector &backcast, matrix &varbounds, long _start, ulong horizon);
   //--- Simulation-based volatility forecasts from the model
   virtual VarianceForecast _simulationforecast(vector& parameters, vector &resids, vector &backcast, matrix &varbounds, long _start, ulong horizon, ulong simulations, BootstrapRng &rng);
   //--- Initialize class members
   virtual bool      _initialize(ENUM_VOLATILITY_MODEL volmodel = WRONG_VALUE,bool updateable = true, bool closedform = false,ulong nparams = 0, string name = NULL,int seed = 0,ulong p = 0, ulong o = 0, ulong q = 0, double power = 0.0,long start=0, long stop=-1,ulong bootstrap_obs=100);
public:
                     CFiGarchProcess(void)
     {
      m_initialized = _initialize(VOL_FIGARCH,true,false,4,"FIGARCH",0,1,1000,1,2.0);
     }
                     CFiGarchProcess(ulong p, ulong q, double power, ulong truncation, int seed, long start, long stop, ulong boot)
     {
      m_initialized = _initialize(VOL_FIGARCH,true,false,0,"FIGARCH",seed,p,truncation,q,power,start,stop,boot);
     }
   //--- Returns starting values for the ARCH model
   virtual vector    startingValues(vector& resids);
   //--- Construct values for backcasting to start the recursion
   virtual vector    backCast(vector& resids);
   //--- Transformation to apply to user-provided backcast values
   virtual vector    backCastTransform(vector& backcast);
   //--- Construct loose bounds for conditional variances
   virtual matrix    varianceBounds(vector& resids, double power = 2.);
   //--- Returns bounds for parameters
   virtual matrix    bounds(vector& resids);
   //--- Compute the variance for the ARCH model
   virtual vector    computeVariance(vector& parameters, vector& resids, vector& _sigma2, vector& _backcast, matrix& varbounds);
   //--- Construct parameter constraints arrays for parameter estimation
   virtual Constraints constraints(void);
   //--- Simulate data from the model
   virtual matrix       simulate(vector& parameters, ulong _nobs, BootstrapRng &rng, ulong burn = 500, double initial_value = NULL);
   //--- Names of model parameters
   virtual string       parameterNames(void);
  };
Каждый процесс волатильности должен определять количество необходимых ему параметров и их названия. Базовый класс требует от подклассов реализации определённых свойств для хранения этих сведений. Эти свойства инициализируются в методе _initialize(), который вызывается конструктором. Класс CFigarchProcess, как и все процессы волатильности в библиотеке, содержит конструктор по умолчанию, который инициализирует переменные-члены значениями по умолчанию, а также параметризованный конструктор, позволяющий пользователям настраивать свойства класса.
//--- Initialize class members
virtual bool      _initialize(ENUM_VOLATILITY_MODEL volmodel = WRONG_VALUE, bool updateable = true, bool closedform = false, ulong nparams = 0, string name = NULL, int seed = 0, ulong p = 0, ulong o = 0, ulong q = 0, double power = 0.0, long start = 0, long stop = -1, ulong bootstrap_obs = 100) override
  {
//--- Synchronize configuration parameters to localized private class properties
   m_updateable = updateable;
   m_closedform = closedform;
   bootstraps(bootstrap_obs);
   m_start = start;
   m_stop = stop;
   m_name = name;
   m_seed = seed;
   m_model = volmodel;
   m_p = p;
   m_q = q;
   m_truncation = o; //--- Maps the truncation lag dimension
   m_power = power;  //--- Declares structural model exponent (e.g. 2.0 for FIGARCH)
   m_num_params = 2 + m_p + m_q; //--- Core total parameter footprint (omega + phi + beta + d)

//--- Initialize the distribution object wrapper
   return m_normal.initialize(vector::Zeros(0), seed);
  }
Метод startingValues() определяет оптимальные начальные значения параметров для передачи оптимизатору, оценивая на исторических данных сетку допустимых вариантов. Сначала метод инициализирует фиксированные соотношения параметров для дробного дифференцирования (d, вектор ds), инноваций (phi) и лагов дисперсии (beta), динамически обнуляя соответствующие соотношения, если в модели отсутствуют лаги соответствующего порядка (m_p или m_q). После вычисления целевого масштаба дисперсии по историческим остаткам, подвергнутым степенному преобразованию, метод во вложенных циклах вычисляет координаты комбинаций параметров и для каждой комбинации определяет допустимое значение свободного члена (omega) с учётом ограничений на веса, задающие долгую память.
Наконец, алгоритм удаляет неиспользуемые столбцы параметров в соответствии с заданной спецификацией лагов, вычисляет гауссово логарифмическое правдоподобие по всему набору остатков для каждой отдельной строки сетки и с помощью ArgMax() выбирает строку с наибольшим значением в качестве начального приближения.
//--- Returns starting values for the ARCH model using a grid-search heuristic initialization
virtual vector    startingValues(vector& resids) override
  {
//--- Establish parameter boundary array configurations for the grid search optimization initialization
   vector ds = {0.2, 0.5, 0.7};
   vector phi_ratio, beta_ratio;

   if(m_p)
     {
      phi_ratio.Resize(3);
      phi_ratio[0] = 0.2;
      phi_ratio[1] = 0.5;
      phi_ratio[2] = 0.8;
     }
   else
     {
      phi_ratio.Resize(1);
      phi_ratio[0] = 0;
     }

   if(m_q)
     {
      beta_ratio.Resize(3);
      beta_ratio[0] = 0.1;
      beta_ratio[1] = 0.5;
      beta_ratio[2] = 0.9;
     }
   else
     {
      beta_ratio.Resize(1);
      beta_ratio[0] = 0;
     }

//--- Establish baseline variance expectations derived directly from residuals footprint
   double target = pow(fabs(resids), m_power).Mean();
   double scale  = pow(resids, 2.).Mean() / (pow(target, 2.0 / m_power));
   target *= pow(scale, m_power / 2.);

//--- Map space to permute all parameter combinations
   matrix all_starting;
   all_starting.Resize(ds.Size() * phi_ratio.Size() * beta_ratio.Size(), 4);
   double beta, omega, d, phi, br, pr;
   vector temp = vector::Zeros(3);
   vector lam;
   ulong row = 0;

//--- --- Grid Execution Matrix Search Loop ---
   for(ulong i = 0; i < ds.Size(); ++i)
     {
      d = ds[i];
      for(ulong j = 0; j < phi_ratio.Size(); ++j)
        {
         pr = phi_ratio[j];
         phi = (1. - d) / 2. * pr; //--- Force stationary constraints
         for(ulong k = 0; k < beta_ratio.Size(); ++k)
           {
            br = beta_ratio[k];
            beta = (d + phi) * br;

            temp[0] = phi;
            temp[1] = d;
            temp[2] = beta;
            lam = figarch_weights(temp, 1, 1, int(m_truncation));

            //--- Calculate corresponding consistent omega constant for the localized parameter combination
            omega = (1. - beta) * target * (1. - lam.Sum());

            all_starting[row, 0] = omega;
            all_starting[row, 1] = phi;
            all_starting[row, 2] = d;
            all_starting[row++, 3] = beta;
           }
        }
     }

//--- Extract unique configurations to minimize processing waste
   matrix sv = np::unique(all_starting, 1);

//--- Strip unused parameter tracking columns if lag settings are set to zero (p=0 or q=0)
   if(!m_q)
      sv = np::sliceMatrixCols(sv, 0, long(sv.Cols() - 1));
   if(!m_p)
     {
      long cols[];
      ArrayResize(cols, int(sv.Cols() - 1));
      cols[0] = 0;
      for(long i = 1; i < long(cols.Size()); cols[i] = i + 1, ++i);
      sv = np::selectMatrixCols(sv, cols);
     }

   matrix vb = varianceBounds(resids);
   vector bc = backCast(resids);
   vector llfs = vector::Zeros(sv.Rows());

//--- Score every starting candidate against the target log-likelihood function
   for(ulong i = 0; i < sv.Rows(); ++i)
     {
      vector row = sv.Row(i);
      llfs[i] = _gaussianloglikelihood(row, resids, bc, vb);
     }

//--- Return the parameter configuration vector that optimized/maximized the log-likelihood (ArgMax)
   return sv.Row(llfs.ArgMax());
  }
Процедура backCast() вычисляет базовое историческое значение, используемое для инициализации рекурсии условной дисперсии до начала основного набора данных. Анализ ограничивается начальным интервалом остатков, при этом берутся либо первые 75 наблюдений, либо полная длина набора данных — в зависимости от того, что меньше. Затем метод формирует вектор весов с экспоненциальным затуханием на основе коэффициента 0,94, нормализуя их таким образом, чтобы их сумма равнялась 1,0. Наконец, метод выделяет этот начальный фрагмент остатков, применяет к их абсолютным значениям заданное в модели степенное преобразование, поэлементно умножает полученные значения на затухающие веса и возвращает их сумму в виде одноэлементного вектора, представляющего начальное значение ретроспективной оценки.
//--- Construct values for backcasting to start the recursion
virtual vector    backCast(vector& resids) override
  {
//--- Limit calculation depth up to a safe window threshold (e.g. 75 observations)
   ulong tau = MathMin(75, resids.Size());
   vector w = vector::Zeros(tau);

//--- Generate an exponentially decaying weights structure (RiskMetrics style, lambda = 0.94)
   for(ulong i = 0; i < w.Size(); w[i] = pow(0.94, double(i)), ++i);
   w = w / w.Sum(); //--- Normalize weight values to sum to 1.0

//--- Extract the start of the series, apply transformation power, and scale by decay weights
   vector sres = np::sliceVector(resids, 0, long(tau));
   sres = pow(fabs(sres), m_power) * w;

   vector bc(1);
   bc[0] = sres.Sum(); //--- Aggregate into scalar backcast representation
   return bc;
  }
Далее мы подробно рассмотрим метод backCastTransform(). Этот метод корректирует заданное пользователем значение ретроспективной оценки, приводя его к математическому пространству, в котором определены используемые моделью показатели волатильности. Сначала он передаёт входной вектор методу backCastTransform базового класса, чтобы применить стандартные преобразования, определённые для всех процессов волатильности. Затем он извлекает это базовое значение, берёт из него квадратный корень, получая соответствующее стандартное отклонение, и возводит результат в степень, заданную пользовательским параметром модели m_power. На этом заключительном этапе начальные условия динамически масштабируются так, чтобы механизм рекурсии мог обрабатывать их единообразно независимо от того, настроен ли вариант модели на отслеживание обычной дисперсии, абсолютных отклонений или другого степенного показателя.
//--- Transformation to apply to user-provided backcast values
virtual vector    backCastTransform(vector& backcast) override
  {
//--- Defer to core base class method transformations first
   backcast = CVolatilityProcess::backCastTransform(backcast);
//--- Apply specific fractional variance power adjustments to the processed vector values
   vector _backcast = pow(sqrt(backcast), m_power);
   return _backcast;
  }
Метод bounds() определяет численные границы каждого параметра, удерживающие процедуру оптимизации в математически устойчивой области. Сначала метод вычисляет малое смещение на основе квадратного корня из машинного эпсилон, а затем находит среднее абсолютных значений остатков после степенного преобразования, чтобы оценить общий масштаб данных. Затем он создаёт заполненную нулями матрицу границ, строки которой соответствуют параметрам модели: свободному члену (ω), коэффициентам инноваций (ϕ), параметру дробного интегрирования (d) и коэффициентам при лагах дисперсии (β). Первый столбец содержит нижние границы, равные 0,0, а второй — верхние.
Верхняя граница свободного члена устанавливается равной десятикратному среднему значению преобразованных остатков, параметры ϕ ограничиваются сверху значением 0,5, а остальные параметры долгой памяти (d и β) — значением чуть меньше 1,0 за счёт эпсилон-смещения. Затем вся матрица транспонируется и возвращается в формате, ожидаемом оптимизатором.
//--- Returns boundary matrix structures for parameters optimization constraints
virtual matrix    bounds(vector& resids) override
  {
   double eps_half = sqrt(2.220446049250313e-16); //--- System machine precision constant limit
   double v = (pow(fabs(resids), m_power)).Mean();
   matrix bnds = matrix::Zeros(m_p + m_q + 2, 2);

   bnds[0, 1] = 10. * v; //--- Enforce an upper bound ceiling on baseline intercept omega constant
   for(ulong i = 1; i < m_p + 1; bnds[i, 1] = 0.5, ++i); //--- Limit short term memory parameters
   for(ulong i = m_p + 1; i < bnds.Rows(); bnds[i, 1] = 1. - eps_half, ++i); //--- Bound persistence variables below 1.0

   return bnds.Transpose();
  }
Метод varianceBounds() вычисляет верхнюю и нижнюю границы условных дисперсий с учётом конкретного степенного преобразования, используемого в модели.
//--- Construct loose bounds for conditional variances
virtual matrix    varianceBounds(vector& resids, double power = 2.) override
  {
//--- Pass computation parameters over to internal system tracker
   return CVolatilityProcess::varianceBounds(resids, m_power);
  }
Метод computeVariance() использует окончательные или промежуточные значения параметров модели и наблюдаемые остатки для вычисления полной траектории условной дисперсии по всей выборке. Сначала метод применяет заданное в модели степенное преобразование к абсолютным значениям исходных остатков, переводя их в метрическое пространство, необходимое для процесса волатильности с долгой памятью. Затем выполняется основное рекурсивное уравнение FIGARCH: преобразованные остатки, параметры и начальное значение ретроспективной оценки передаются в функцию figarch_recursion, которая шаг за шагом заполняет вектор _sigma2.
Наконец, поскольку рекурсия выполняется с использованием заданного пользователем параметра m_power, метод возводит вычисленные значения в степень 2/power, чтобы перед возвратом результата привести их обратно к обычным единицам условной дисперсии.
//--- Compute the variance for the ARCH model
virtual vector    computeVariance(vector& parameters, vector& resids, vector& _sigma2, vector& _backcast, matrix& varbounds)
  {
//--- Transform base residuals into process space based on model's power coefficient
   vector fresids = pow(fabs(resids), m_power);
   int nobs = (int)resids.Size();

//--- Execute the fractional integration recursion engine to write conditional variance calculations directly into _sigma2
   figarch_recursion(parameters, fresids, _sigma2, int(m_p), int(m_q), nobs, m_truncation, _backcast[0], varbounds);

//--- Apply inverse power mapping to re-align output to standard variance units
   double inv_power = 2. / m_power;
   _sigma2 = pow(_sigma2, inv_power);
   return _sigma2;
  }
Метод constraints() вычисляет линейные ограничения в виде неравенств. Здесь определены три отдельные заранее вычисленные конфигурации матриц (a, aa и aaa) и соответствующие им предельные значения граничных векторов (b, bb и bbb). По умолчанию используется полное матричное представление с четырьмя параметрами, однако с помощью условных проверок применяются альтернативные структуры, если в модели отсутствуют лаги дисперсии или лаги инноваций. Эта заранее заданная схема выбора определяет систему неравенств и объединяет их в специальную структуру Constraints, предназначенную для хранения полного набора ограничений.
//--- Construct parameter constraints arrays for parameter estimation (Boundary bounding vectors)
virtual Constraints constraints(void) override
  {
//--- Initialize hard-coded inequality constraint matrices (A) for OLS/ML parameter bounding
   matrix a =
     {
        {1, 0, 0, 0},
        {0, 1, 0, 0},
        {0, -2, -1, 0},
        {0, 0, 1, 0},
        {0, 0, -1, 0},
        {0, 0, 0, 1},
        {0, 1, 1, -1},
     };
   matrix aa =
     {
        {1, 0, 0},
        {0, 1, 0},
        {0, -1, 0},
        {0, 0, 1},
        {0, 1, -1},
     };
   matrix aaa =
     {
        {1, 0, 0},
        {0, 1, 0},
        {0, -2, -1},
        {0, 0, 1},
        {0, 0, -1}
     };

//--- Associated boundary mapping verification vectors (B) where: A * parameters >= B
   vector b = {0, 0, -1, 0, -1, 0, 0};
   vector bb = {0, 0, -1, 0, 0};
   vector bbb = {0, 0, -1, 0, -1};

   Constraints constr;
   constr._one = a;
   constr._two = b;

//--- Adjust structural linear constraint layout mapping depending on specified lag dimension flags (p=0 or q=0)
   if(!m_q)
     {
      constr._one = aaa;
      constr._two = bbb;
     }
   if(!m_p)
     {
      constr._one = aa;
      constr._two = bb;
     }
   return constr;
  }
Метод simulate() генерирует синтетические данные и траектории условной дисперсии на основе процесса FIGARCH с использованием заданного вектора параметров и генератора случайных шоков, представленного экземпляром BootstrapRng. Сначала вычисляются веса дробного интегрирования модели и меняется порядок их следования на обратный для согласования с хронологией данных, после чего рассчитывается безусловное значение в установившемся состоянии для инициализации буферов исторических данных, если пользователь не задал начальное значение. Метод заполняет начальные окна исторических данных на общем горизонте, охватывающем лаги усечения, запрошенные наблюдения и начальный буфер разгона, предназначенный для устранения смещения, связанного с запуском.
Затем подпрограмма последовательно выполняет цикл по времени: на каждом шаге преобразованная волатильность вычисляется как скалярное произведение весов лагов в обратном порядке и модулей недавних шоков, после чего результат переводится обратно в единицы дисперсии и используется вместе со случайными инновациями из стандартного нормального распределения для формирования новой точки данных. Наконец, метод отбрасывает начальные участки, соответствующие разгону и усечению, и формирует итоговую двухстолбцовую матрицу, содержащую только траектории наблюдаемых доходностей и условных дисперсий после стабилизации.
//--- Simulate data paths from the model structure
virtual matrix      simulate(vector& parameters, ulong _nobs, BootstrapRng &rng, ulong burn = 500, double initial_value = NULL) override
  {
   vector params = np::sliceVector(parameters, 1);

//--- Extract long memory hyperbolic expansion decay parameter array
   vector lam = figarch_weights(params, m_p, m_q, m_truncation);
   vector lam_rev = lam;
   if(!np::reverseVector(lam_rev))
      return matrix::Zeros(0, 0);

//--- Pre-allocate standardized random error distribution array including the requested burn-in footprint
   vector errs = rng.rng(ulong(m_truncation + _nobs + burn));

//--- Calculate stationary unconditional expectation values if no initial value parameter was provided
   if(initial_value == NULL)
     {
      double persistence = lam.Sum();
      double beta = (m_q) ? parameters[parameters.Size() - 1] : 0.0;
      initial_value = parameters[0];
      if(beta < 1.)
         initial_value /= 1. - beta;
      if(persistence < 1.)
         initial_value /= 1. - persistence;
      if(persistence >= 1. || beta >= 1.)
         Print(__FUNCTION__": WARNING: Initial value warning (non-stationary bounds detected)");
     }

   if(initial_value == NULL)
     {
      Print(__FUNCTION__, ": Initial value is NULL");
      return matrix::Zeros(0, 0);
     }

//--- Allocate unified arrays tracking simulated states over time
   vector sigma2 = vector::Zeros(ulong(m_truncation + _nobs + burn));
   vector data = sigma2;
   vector fsigma = data;
   vector fdata = fsigma;

//--- Initialize index blocks spanning pre-sample truncation window constraints
   if(!np::vectorFill(fsigma, initial_value, 0, long(m_truncation)) ||
      !np::vectorFill(sigma2, pow(initial_value, 2. / m_power), 0, long(m_truncation)))
     {
      Print(__FUNCTION__, ": vector fill error");
      return matrix::Zeros(0, 0);
     }

   data = sqrt(sigma2) * errs;
   fdata = pow(fabs(data), m_power);

   double omega = parameters[0];
   double beta = (m_q) ? parameters[parameters.Size() - 1] : 0;
   double omega_tilde = 0;
   if(beta < 1.)
      omega_tilde = omega / (1. - beta);
   else
     {
      Print(__FUNCTION__, ": Beta >= 1.0, using omega as intercept since long-run variance is ill-defined.");
      omega_tilde = omega;
     }

//--- --- Simulation Time March Loop ---
//--- Recursively project long-memory volatility evolution paths forward chronologically
   for(long t = long(m_truncation); t < long(m_truncation + _nobs + burn); ++t)
     {
      //--- Convolve the reversed weights against the sliding window vector slice of previous absolute values
      fsigma[t] = omega_tilde + lam_rev.Dot(np::sliceVector(fdata, long(t - m_truncation), t));
      sigma2[t] = pow(fsigma[t], 2.0 / m_power); //--- Convert out of process shape parameters
      data[t] = errs[t] * sqrt(sigma2[t]);        //--- Generate synthetic asset return realization
      fdata[t] = pow(fabs(data[t]), m_power);     //--- Cache internal tracking absolute shape value
     }

//--- Slice out and discard the initial initialization burn-in sequence block
   data = np::sliceVector(data, long(m_truncation + burn));
   sigma2 = np::sliceVector(sigma2, long(m_truncation + burn));

//--- Package the output data streams into a 2-column matrix structure [Returns, Variance]
   matrix out = matrix::Zeros(data.Size(), 2);
   if(!out.Col(data, 0) || !out.Col(sigma2, 1))
     {
      Print(__FUNCTION__, ": Column insertion error out ", GetLastError());
      return matrix::Zeros(0, 0);
     }
   return out;
  }
Для получения прогнозов модели FIGARCH используется один из двух методов: _analyticforecast() или _simulationforecast(). Перед построением прогноза с помощью метода _check_forecasting_method() проверяется, совместим ли выбранный подход к прогнозированию с конфигурацией модели на заданном горизонте. Он автоматически допускает использование любого метода прогнозирования, если горизонт прогнозирования составляет ровно один шаг вперед, поскольку дисперсия следующего периода полностью зависит от известных исторических данных. Однако при многошаговом горизонте (больше единицы) метод явно запрещает аналитическое прогнозирование в замкнутой форме, если показатель степени модели не равен 2,0, поскольку при нелинейной динамике дисперсии многошаговый прогноз невозможно вычислить аналитически.
//--- Verify the requested forecasting method as valid for the specification
virtual bool      _check_forecasting_method(ENUM_FORECAST_METHOD method, ulong horizon) override
  {
//--- A 1-step horizon is always mathematically valid across all execution pipelines
   if(horizon == 1)
      return true;

//--- Closed-form analytic projections over multiple horizons are invalid if the model's
//--- target shape parameter (power) deviates from standard squared variance representation (power = 2.0)
   if(method == FORECAST_ANALYTIC && m_power != 2.)
     {
      Print(__FUNCTION__, ": Analytic forecasts not available for horizon > 1 when power != 2");
      return false;
     }
   return true;
  }
Метод _analyticforecast() вычисляет многошаговые аналитические прогнозы дисперсии в замкнутой форме на заданном временном горизонте. Сначала выполняется расчёт базового прогноза на один шаг вперёд, который сразу же возвращается, если запрашиваемый горизонт равен ровно одному. Для более длительных горизонтов метод извлекает коэффициенты модели, вычисляет веса дробного интегрирования с долгой памятью с помощью figarch_weights и меняет порядок их следования на обратный для согласования с хронологией данных. Затем метод перебирает все временные шаги в окне оценивания, на каждом шаге инициализируя временный скользящий буфер квадратами исторических остатков; если исторических данных недостаточно для заполнения буфера до лага усечения, недостающие значения заменяются ретроспективной оценкой.
Наконец, метод пошагово прогнозирует дисперсию до максимального горизонта, многократно вычисляя скалярное произведение дробных весов в обратном порядке и значений из скользящего окна лагов и сохраняя рассчитанную многошаговую траекторию в матрице прогнозов.
//--- Analytic multi-step volatility forecasts from the model
virtual VarianceForecast _analyticforecast(vector& parameters, vector &resids, vector &backcast, matrix &varbounds, long _start, ulong horizon)
  {
   vector sg;
   matrix fc;
//--- Establish the initial one-step look-ahead matrix boundaries to seed the multi-step recursion
   if(!_onestepforecast(parameters, resids, backcast, varbounds, _start, horizon, sg, fc))
      return VarianceForecast();

//--- Short-circuit execution if only dealing with a single look-ahead window
   if(horizon == 1)
      return VarianceForecast(fc, EMPTY_MATRIX_ARRAY, EMPTY_MATRIX_ARRAY);

//--- Extract model-specific parameters (skipping omega at parameters[0])
   vector params = np::sliceVector(parameters, 1);

//--- Pre-calculate the expansion weights up to the allocated truncation lag
   vector lam = figarch_weights(params, m_p, m_q, m_truncation);
   vector lam_rev = lam;

//--- Reverse the weights vector to align chronological steps for a vector dot product (convolution)
   if(!np::reverseVector(lam))
      return VarianceForecast();

   long t = long(resids.Size());
   double omega = parameters[0];
   double beta = (m_q) ? parameters[parameters.Size() - 1] : 0.0;
   double omega_tilde = omega / (1. - beta); //--- Long-run intercept scaling

//--- Allocate a unified workspace vector to hold past realized shocks and future forecast values sequentially
   vector temp_forecasts = vector::Zeros(m_truncation + horizon);
   vector resids2 = pow(resids, 2.0); //--- Pre-square raw structural innovations

//--- Loop across the time-series sliding calculation window starting at '_start'
   for(long i = _start; i < t; ++i)
     {
      long fcast_loc = i - _start;
      long available = long(i + 1 - fmax(0, i - m_truncation + 1));

      //--- Load historical squared innovations into the sliding workspace vector
      for(long j = long(m_truncation - available), k = (long)fmax(0, i - m_truncation + 1); j < long(m_truncation) && k < (i + 1); ++k, ++j)
         temp_forecasts[j] = resids2[k];

      //--- Hand off backcast estimates if historical data depth does not span the truncation requirements
      if(available < long(m_truncation))
         if(!np::fillVector(temp_forecasts, backcast[0], 0, long(m_truncation) - available))
            return VarianceForecast();

      //--- --- Multi-Step Analytic Loop ---
      //--- Step sequentially into the future horizon, resolving expectations via a convolution of reversed weights
      for(ulong h = 0; h < horizon; ++h)
        {
         vector lagged_forecasts = np::sliceVector(temp_forecasts, long(h), long(m_truncation + h));
         temp_forecasts[m_truncation + h] = omega_tilde + lam_rev.Dot(lagged_forecasts);
        }

      //--- Transfer the computed future horizons into the destination forecast result matrix row
      if(!fc.Row(np::sliceVector(temp_forecasts, long(m_truncation)), fcast_loc))
         return VarianceForecast();
     }
   return VarianceForecast(fc, EMPTY_MATRIX_ARRAY, EMPTY_MATRIX_ARRAY);
  }
В качестве альтернативы метод _simulationforecast() использует моделирование по методу Монте-Карло для учета сложных структур волатильности во времени. Он инициализирует буферы исторических данных известными квадратами остатков и значениями ретроспективной оценки, а также извлекает веса FIGARCH с долгой памятью в обратном порядке. Для каждого момента времени в окне прогнозирования подпрограмма формирует матрицу случайных инноваций из стандартного нормального распределения для всех траекторий моделирования и временных шагов.
На каждом шаге горизонта прогнозирования она вычисляет преобразованную дисперсию, умножая матрицу лаговых значений, зависящих от траектории, на веса дробного интегрирования. Этот результат приводится к стандартным единицам дисперсии, умножается на случайные шоки для получения смоделированных будущих остатков и усредняется по всем траекториям на каждом этапе с целью определения окончательного точечного прогноза, при этом сохраняются полные смоделированные траектории и шоки.
//--- Simulation-based volatility forecasts from the model
virtual VarianceForecast _simulationforecast(vector& parameters, vector &resids, vector &backcast, matrix &varbounds, long _start, ulong horizon, ulong simulations, BootstrapRng &rng)
  {
   vector sig;
   matrix fc;
//--- Baseline one-step layout verification
   if(!_onestepforecast(parameters, resids, backcast, varbounds, _start, horizon, sig, fc))
      return VarianceForecast();

   ulong t = resids.Size();
   matrix paths[], shocks[];
   ArrayResize(paths, int(t - _start));
   ArrayResize(shocks, int(t - _start));

   vector params = np::sliceVector(parameters, 1);
   vector lam = figarch_weights(params, m_p, m_q, m_truncation);
   vector lam_rev = lam;
   if(!np::reverseVector(lam_rev))
      return VarianceForecast();

   double omega = parameters[0];
   double beta = (m_q) ? parameters[parameters.Size() - 1] : 0.0;
   double omega_tilde = omega / (1. - beta);

//--- Allocate parallel simulation matrices [simulations rows x (truncation + horizon) columns]
   matrix fpath = matrix::Zeros(simulations, m_truncation + horizon);
   vector fresids = pow(fabs(resids), 2.);

//--- Loop chronologically across the forecasting evaluation footprint
   for(long i = _start; i < long(t); ++i)
     {
      //--- Extract structured random standard normal variables from the random number generator
      matrix std_shocks = rng.rng(simulations, horizon);
      long available = i + 1 - fmax(0, i - long(m_truncation) + 1);
      vector frd = np::sliceVector(fresids, fmax(0, i + 1 - m_truncation), i + 1);

      //--- Inject identical historical realized shocks across all path simulations
      for(long ii = long(m_truncation - available); ii < long(m_truncation); ++ii)
         fpath.Col(frd, ii);

      //--- Pad empty history with backcast values where data boundary overflows
      if(available < long(m_truncation))
         for(long ii = 0; ii < long(m_truncation - available); ++ii)
            fpath.Col(backcast, ii);

      //--- --- Horizon Path Integration Simulation ---
      for(ulong h = 0; h < horizon; ++h)
        {
         //--- Matrix column slice retrieves conditional tracking variables across all simulation paths simultaneously
         matrix lagged_forecasts = np::sliceMatrixCols(fpath, long(h), long(m_truncation + h));
         vector temp = omega_tilde + lagged_forecasts.MatMul(lam_rev);

         //--- Invert the structural transformation power variable back into basic variance space
         vector sigma2 = pow(temp, 2. / m_power);
         long path_loc = i - _start;

         //--- Generate dynamic synthesized shocks and variance values for this horizon index
         shocks[path_loc].Col(std_shocks.Col(h) * sqrt(sigma2), h);
         paths[path_loc].Col(sigma2, h);

         //--- Expected forecast point equals the mathematical mean across all simulated iterations
         fc[path_loc, h] = sigma2.Mean();

         //--- Feed back the generated structural shock into the path matrix for the next recursive horizon step
         fpath.Col(pow(fabs(shocks[path_loc].Col(h)), m_power), m_truncation + h);
        }
     }
   return VarianceForecast(fc, paths, shocks);
  }
Последнее изменение вносится в файл mean.mqh, где мы модифицируем закрытый метод _initialize() класса HARX для обработки новых параметров спецификации модели.
//--- Set and initialize the polymorphic volatility process object wrapper
switch(vol_dist_params.vol_model_type)
  {
//--- Homoscedastic baseline: constant variance over time (no clustering effects)
case VOL_CONST:
   m_vp = new CConstantVariance(m_model_spec.vol_rng_seed, m_model_spec.min_bootstrap_sims);
   break;

//--- Autoregressive Conditional Heteroscedasticity: models short-term clusters via past squared shocks (p lags)
case VOL_ARCH:
   m_vp = new CArchProcess(m_model_spec.garch_p, m_model_spec.vol_rng_seed, m_model_spec.min_bootstrap_sims);
   break;

//--- Generalized ARCH: factors in both historical shocks (p) and historical variance memory (q)
case VOL_GARCH:
   m_vp = new CGarchProcess(m_model_spec.garch_p, m_model_spec.garch_q, m_model_spec.vol_rng_seed, m_model_spec.min_bootstrap_sims);
   break;

//--- Absolute Value ARCH: models standard deviation (absolute returns) instead of raw variance to soften outlier impacts
case VOL_AVARCH:
   m_vp = new CAvarchProcess(m_model_spec.garch_p, m_model_spec.vol_rng_seed, m_model_spec.min_bootstrap_sims);
   break;

//--- Absolute Value GARCH: combines absolute return shocks with linear standard deviation historical loops
case VOL_AVGARCH:
   m_vp = new CAvgarchProcess(m_model_spec.garch_p, m_model_spec.garch_q, m_model_spec.vol_rng_seed, m_model_spec.min_bootstrap_sims);
   break;

//--- Threshold ARCH (Zakoian): captures leverage asymmetries by splitting negative vs positive innovations using 'o' indicator lags
case VOL_TARCH:
   m_vp = new CTarchProcess(m_model_spec.garch_p, m_model_spec.garch_o, m_model_spec.garch_q, m_model_spec.vol_rng_seed, m_model_spec.min_bootstrap_sims);
   break;

//--- Glosten-Jagannathan-Runkle GARCH: incorporates asymmetric volatility spikes explicitly for squared negative asset returns
case VOL_GJR_GARCH:
   m_vp = new CGjrGarchProcess(m_model_spec.garch_p, m_model_spec.garch_o, m_model_spec.garch_q, m_model_spec.vol_rng_seed, m_model_spec.min_bootstrap_sims);
   break;

//--- Fractionally Integrated GARCH: captures long-memory hyperbolic decay over high truncation intervals using fractionally integrated lags
case VOL_FIGARCH:
   m_vp = new CFiGarchProcess(m_model_spec.garch_p, m_model_spec.garch_q, m_model_spec.vol_power, m_model_spec.figarch_truncation, m_model_spec.vol_rng_seed, m_model_spec.sample_start_idx, m_model_spec.sample_end_idx, m_model_spec.min_bootstrap_sims);
   break;

//--- Fallback protection state: defaults to homoscedastic variance calculation
default:
   m_vp = new CConstantVariance(m_model_spec.vol_rng_seed, m_model_spec.min_bootstrap_sims);
   break;
  }
Настройка процесса волатильности FIGARCH продемонстрирована в скрипте FiGARCH_Demo.ex5. В приведенном ниже фрагменте кода показано, как настроить параметры, связанные с FIGARCH.
#define __SLSQP__
#include<figarch_harch\Arch\univariate\mean.mqh>

//--- Input parameters for script customization
input string           Symbol_ = "AUDUSD";            //--- Financial asset to analyze
input ENUM_TIMEFRAMES  TimeFrame = PERIOD_D1;         //--- Data horizon interval (Daily chart default)
input datetime         StartDate = D'2025.01.01';     //--- Historical capture anchor start date
input ulong            HistoryLen = 504;              //--- Total historical data bars to request
input double           ScaleFactor = 100.;            //--- Rescaling factor to optimize optimizer convergence
input bool             MeanConstant = true;           //--- Flag to include an intercept in the conditional mean
input ulong            _P_ = 1;                       //--- Short-term ARCH lag order
input ulong            _Q_ = 1;                       //--- Long-term variance persistence GARCH lag order
input double           _Vol_Power_ = 2.0;             //--- Power transformation parameter for the innovations
input ulong            Truncation = 1000;             //--- Truncation depth for the infinite sum expansion weight array

//+------------------------------------------------------------------+
//| Script program start function                                    |
//+------------------------------------------------------------------+
void OnStart()
  {
   vector prices;
//--- --- Step 1: Historical Data Fetch ---
//--- Pull close prices directly into an array using native vector operations
   if(!prices.CopyRates(Symbol_, TimeFrame, COPY_RATES_CLOSE, StartDate, HistoryLen))
     {
      Print(" failed to get close prices for ", Symbol_, ". Error ", GetLastError());
      return;
     }

//--- --- Step 2: Returns Generation ---
//--- Apply a natural log transform to prices to calculate standard log-returns
   prices = log(prices);

//--- Compute the first-difference array: r_t = ln(P_t) - ln(P_{t-1})
   vector returns = np::diff(prices);

//--- --- Step 3: Model Configuration Setup ---
//--- Initialize structural settings mapping onto the target FIGARCH container
   ArchParameters figarch_spec;

//--- Scale returns (e.g., multiply by 100 to convert to percentage returns).
//--- This enlarges small numbers, helping prevent mathematical underflow inside the optimizer.
   figarch_spec.observations = ScaleFactor * returns;
   figarch_spec.include_constant = MeanConstant;
   figarch_spec.vol_model_type = VOL_FIGARCH;
   figarch_spec.figarch_truncation = Truncation;
   figarch_spec.garch_p = _P_;
   figarch_spec.garch_q = _Q_;
   figarch_spec.vol_power = _Vol_Power_;

//--- --- Step 4: Model Instantiation ---
//--- Instantiate the mean model wrapper object (Constant Mean model specification)
   ConstantMean figarch_model;

//--- Bind settings configuration array to the active runtime model pipeline
   if(!figarch_model.initialize(figarch_spec))
      return;

//--- --- Step 5: Optimization & Estimation Execution ---
//--- Trigger the Maximum Likelihood Estimation (MLE) or SLSQP routine to estimate parameters
   vector empty;
   ArchModelResult figarch_params = figarch_model.fit();

//--- --- Step 6: Post-Convergence Guard ---
//--- Verify that the estimation returned a valid non-empty parameter vector array
   if(!figarch_params.params.Size())
     {
      Print("Convergence failed ", GetLastError());
      return;
     }

//--- --- Step 7: Parse and Output Results ---
//--- Print the optimal parameter vector array to the terminal logs
   Print("FIGARCH model parameters ", figarch_params.params);

//--- Extract calculated asymptotic parameter p-values to evaluate statistical significance
   vector pv = figarch_params.pvalues();
   Print("FIGARCH model pvalues: ");
   for(ulong i = 0; i < pv.Size(); ++i)
     {
      //--- Map out individual values index-by-index to easily associate parameters to significance scores
      Print(" pvalue for param at ", i, " :- ", pv[i]);
     }
  }
Пользователям следует проявлять осторожность при настройке параметра figarch_truncation. Значение этого параметра не должно превышать число наблюдений в выборке и не может быть равно нулю. В противном случае метод initialize() завершится с ошибкой. По умолчанию установлено значение 1000. После успешной подгонки модели в векторном свойстве params объекта ArchModelResult содержатся четыре параметра FIGARCH.
- Первый параметр волатильности — ω (Омега) — отражает базовую дисперсию.
- Вторым параметром волатильности является параметр дробного интегрирования (d).
- Далее следует параметр ϕ (фи), который ослабляет или усиливает непосредственную краткосрочную реакцию на резкую рыночную аномалию до того, как в действие вступит функция затухания с долгой памятью.
- Последним параметром волатильности является β (бета), коэффициент при лаговом значении дисперсии. Как и параметр β в стандартной модели GARCH, он влияет на характер сглаживания. Этот показатель определяет, насколько текущая дисперсия связана с предыдущей оценкой дисперсии.
Эти параметры следуют в указанном выше порядке после параметров модели среднего. В демонстрационном скрипте модель среднего задается единственным параметром — константой.
FIGARCH model parameters [-0.0255499859497827,0.0678486143425001,0.4421923966649389,0.1156152066701203,0.5058075945010996]
FIGARCH model pvalues:
pvalue for param at 0 :- 0.3160938229161918
pvalue for param at 1 :- 0.04872262159333707
pvalue for param at 2 :- 0.006222703454970224
pvalue for param at 3 :- 0.022889668047700096
pvalue for param at 4 :- 0.00018360906129921695
Рассмотрев реализацию FIGARCH, перейдем к модели HARCH, чтобы расширить наш набор инструментов для анализа волатильности.
Гетерогенная авторегрессионная модель с условной гетероскедастичностью
Модель HARCH, представленная Мишелем Дакоронья, Рамазаном Генджаем, Ульрихом Мюллером, Ричардом Олсеном и Оливье Пикте, использует иной подход к моделированию долгой памяти. Вместо того чтобы рассматривать время как однородный континуум, модель HARCH исходит из того, что на рынке действуют разные типы трейдеров с разными временными горизонтами (например, маркет-мейкеры, внутридневные скальперы, дневные свинг-трейдеры и институциональные долгосрочные инвесторы). В модели HARCH условная дисперсия задается как линейная комбинация квадратов доходностей, агрегированных по различным интервалам.
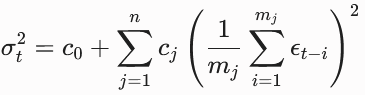
Здесь c_0 — постоянная базовая дисперсия, n — число различных торговых горизонтов, а c_j — положительные коэффициенты, определяющие вес влияния каждого горизонта. Агрегированная доходность, как правило, представляет собой простое скользящее среднее исходных доходностей на интервале заданной длины. Например, в стандартной конфигурации может использоваться четыре различных временных горизонта.
- Дневной: вчерашний шок.
- Недельный: средний шок за последние 5 дней.
- Двухнедельный: средний шок за последние 10 дней.
- Месячный: средний шок за последние 20 дней.
Эта спецификация учитывает долгую память, поскольку месячный компонент охватывает 20-дневное окно. Масштабный рыночный шок будет продолжать влиять на текущую оценку условной дисперсии в течение целого месяца, причем его влияние будет ослабевать ступенчато, а не исчезать мгновенно. Это создает асимметричный информационный каскад: долгосрочная волатильность влияет на краткосрочное торговое поведение, но краткосрочный дневной шум редко меняет долгосрочные инвестиционные стратегии.
Реализация HARCH на MQL5 построена аналогично реализации FIGARCH. В перечисление ENUM_VOLATILITY_MODEL добавляется значение VOL_HARCH.
//+------------------------------------------------------------------+
//| Configured conditional volatility structure models               |
//+------------------------------------------------------------------+
enum ENUM_VOLATILITY_MODEL
  {
   VOL_CONST = 0, // Homoskedastic variance baseline profiles
   VOL_ARCH,      // Autoregressive Conditional Heteroskedasticity (Linear lag squares mapping)
   VOL_AVARCH,    // Absolute Value ARCH framework configurations
   VOL_AVGARCH,   // Absolute Value GARCH process modeling variations
   VOL_TARCH,     // Threshold ARCH / ZARCH threshold tracking handling asymmetric volatility shocks
   VOL_GARCH,     // Generalized ARCH processes combining structural innovations and past variance memory
   VOL_GJR_GARCH, // Glosten-Jagannathan-Runkle GARCH tracking sign-dependent asymmetric leverage adjustment
   VOL_FIGARCH,    // Fractionally Integrated GARCH mapping long-memory long-term decay processes
   VOL_HARCH      // Heterogeneous ARCH handling multi-scale localized aggregate time horizons
  };
Затем структура ArchParameters расширяется для поддержки различных горизонтов, задаваемых с помощью нового свойства harch_lags.
//+------------------------------------------------------------------+
//| Comprehensive specification payload structure for ARCH models    |
//+------------------------------------------------------------------+
struct ArchParameters
  {
   // --- Data & Core Configuration
   vector            observations;       // Vector tracking endog target returns data series
   matrix            exog_data;          // Matrix tracking exogenous external regressor blocks
   vector            mean_lags;          // Vector defining selected conditional mean lag lengths

   ENUM_MEAN_MODEL   mean_model_type;    // Specified mean structural method profile reference
   ENUM_VOLATILITY_MODEL vol_model_type; // Specified volatility variance framework engine reference
   ENUM_DISTRIBUTION_MODEL dist_type;    // Specified baseline conditional probability density model

   ulong             holdout_size;       // Out-of-sample data truncation window count bounds
   bool              is_rescale_enabled; // Scale switch flag to normalize inputs to unit variances
   double            scaling_factor;     // Internal scale factor used for numerical optimization convergence

   // --- Mean Model Parameters
   bool              include_constant;   // Conditional mean calculation model constant flag
   bool              use_har_rotation;   // Flag enabling volatility horizon mapping blocks rotations

   // --- Volatility Process Parameters (GARCH/ARCH)
   int               vol_rng_seed;       // Random initialization seeding value used for variance simulations
   ulong             garch_p;            // Shock innovations lag loop parameter allocation bounds (ARCH)
   ulong             garch_o;            // Asymmetric conditional volatility component bounds (Leverage)
   ulong             garch_q;            // Historical tracking persistence variance memory depth (GARCH)
   double            vol_power;          // Exponent index scaling term used in variance conversions
   ulong             figarch_truncation; // Expansion step cutoff limit boundary tracking fractional integration weights
   vector            harch_lags;         // Structural lookback specification arrays targeted by HARCH processes
Это свойство представляет собой вектор, элементы которого задают длины интервалов для произвольного числа горизонтов. По умолчанию это свойство содержит один элемент со значением 1.
Класс CHarchProcess, инкапсулирующий процесс волатильности HARCH, определяется в файле volatility.mqh, после чего необходимо внести соответствующие изменения в файл mean.mqh.
//+------------------------------------------------------------------+
//| HARCH process                                                    |
//+------------------------------------------------------------------+
class CHarchProcess: public CVolatilityProcess
  {
protected:
   //--- Custom structure of containers
   struct CFC
     {
      double         Const;
      vector         Arch;
      matrix         Resids2;

                     CFC(void)
        {
         Const = 0;
         Arch = vector::Zeros(0);
         Resids2 = matrix::Zeros(0,0);
        }
                     CFC(double c, vector& a, matrix& r)
        {
         Const = c;
         Arch = a;
         Resids2 = r;
        }
                     CFC(CFC& other)
        {
         Const = other.Const;
         Arch = other.Arch;
         Resids2 = other.Resids2;
        }
      void           operator=(CFC& other)
        {
         Const = other.Const;
         Arch = other.Arch;
         Resids2 = other.Resids2;
        }
     };

   ulong             m_num_lags;
   vector            m_lags;
   //--- Model transformation
   vector            _harch_to_arch(vector& parameters);
   //--- Verify the requested forecasting method as valid for the specification
   virtual bool      _check_forecasting_method(ENUM_FORECAST_METHOD method, ulong horizon);
   //--- Intermediate forecast components
   CFC               _common_forecast_components(vector& parameters, vector& resids, vector& backcast, ulong horizon);
   //--- Analytic multi-step volatility forecasts from the model
   virtual VarianceForecast _analyticforecast(vector& parameters, vector &resids, vector &backcast, matrix &varbounds, long _start, ulong horizon);
   //--- Simulation-based volatility forecasts from the model
   virtual VarianceForecast _simulationforecast(vector& parameters, vector &resids, vector &backcast, matrix &varbounds, long _start, ulong horizon, ulong simulations, BootstrapRng &rng);
   //--- Initialize class members
   virtual bool      _initialize(ENUM_VOLATILITY_MODEL volmodel = WRONG_VALUE,bool updateable = true, bool closedform = false,ulong nparams = 0, string name = NULL,int seed = 0,ulong p = 0, ulong o = 0, ulong q = 0, double power = 0.0,long start=0, long stop=-1,ulong bootstrap_obs=100);
public:
                     CHarchProcess(void);
                     CHarchProcess(vector& lags);
   //--- Returns bounds for parameters
   virtual matrix    bounds(vector& resids);
   //--- Construct parameter constraints arrays for parameter estimation
   virtual Constraints constraints(void);
   //--- Compute the variance for the ARCH model
   virtual vector    computeVariance(vector& parameters, vector& resids, vector& sigma2, vector& backcast, matrix& varbounds);
   //--- Simulate data from the model
   virtual matrix       simulate(vector& parameters, ulong _nobs, BootstrapRng &rng, ulong burn = 500, double initial_value = NULL);
   //--- Returns starting values for the ARCH model
   virtual vector    startingValues(vector& resids);
   //--- Names of model parameters
   virtual string       parameterNames(void);
  };
//+------------------------------------------------------------------+
Как было показано в предыдущем разделе, метод _initialize() присваивает переменным-членам базовые настройки. В данном контексте основными параметрами являются лаги для разных временных горизонтов. Их можно явно задать, вызвав конструктор с параметрами. Метод _initialize() проверяет, что максимальное окно агрегации, заданное в наборе лагов, составляет не менее 1, и устанавливает точную размерность пространства оптимизации параметров.
//--- Initialize class members
virtual bool      _initialize(ENUM_VOLATILITY_MODEL volmodel = WRONG_VALUE, bool updateable = true, bool closedform = false, ulong nparams = 0, string name = NULL, int seed = 0, ulong p = 0, ulong o = 0, ulong q = 0, double power = 0.0, long start = 0, long stop = -1, ulong bootstrap_obs = 100) override
  {
//--- Bind interface arguments down to private global properties
   m_updateable = updateable;
   m_closedform = closedform;
   bootstraps(bootstrap_obs);
   m_start = start;
   m_stop = stop;
   m_name = name;
   m_seed = seed;
   m_model = volmodel;

//--- Instantiate a base uniform linear lag array configuration if no dynamic mapping exists
   if(!m_lags.Size())
     {
      m_lags = vector::Ones(1);
      for(ulong i = 0; i < m_lags.Size(); m_lags[i] = 1. + double(i), ++i);
     }

//--- Boundary safety verification check: lookback steps must resolve to valid non-zero intervals
   if(int(m_lags.Max()) < 1)
     {
      Print(__FUNCTION__, ": Invalid input. All lags should resolve to > 0 integers ");
      return false;
     }

   m_num_lags = m_lags.Size();
   m_num_params = m_num_lags + 1; //--- Total estimated parameters (omega intercept + interval weights)

//--- Initialize the tracking normal distribution object instance wrapper
   return m_normal.initialize(vector::Zeros(0), seed);
  }
Метод bounds() задает для каждого параметра нижнюю границу, равную 0,0. Это гарантирует, что свободный член (ω) и все веса гетерогенных компонентов остаются строго неотрицательными, что не позволяет модели прогнозировать отрицательную дисперсию. Базовый свободный член (ω) ограничен сверху величиной, равной 10-кратному среднему значению квадратов исторических остатков. Это позволяет параметру адаптироваться к масштабу данных, не принимая экстремальных значений, приводящих к неустойчивости. Для каждого веса гетерогенной лаговой составляющей устанавливается верхняя граница, равная 1,0. Это не позволяет компонентам вызывать взрывной рост дисперсии. Перед возвратом итоговая матрица транспонируется, в результате чего она приобретает следующую структуру: в строке 0 содержатся все нижние границы, а в строке 1 — все верхние границы.
//--- Returns parameter boundaries for optimization
   virtual matrix    bounds(vector& resids) override
     {
      // Create a matrix to store bounds (rows = number of parameters, 2 columns for min/max)
      matrix out = matrix::Zeros(m_lags.Size()+1,2);

      // Calculate squared residuals to estimate variance magnitude
      vector squared = pow(resids, 2.);

      // Set the upper bound for the constant term (intercept) as 10x the mean squared residual
      out[0,1] = 10. * squared.Mean();

      // Set the upper bound for all autoregressive (ARCH) coefficients to 1.0
      // (Common constraint for stationarity in ARCH models)
      for(ulong i = 1; i<out.Rows(); ++i)
         out[i,1] = 1.0;

      // Transpose to match expected [2 x N] output format for the optimizer
      return out.Transpose();
     }
В отличие от реализации FIGARCH, в которой использовались жестко запрограммированные структуры, процедура constraints() программно масштабирует ограничения в зависимости от количества активных гетерогенных компонентов. Метод заполняет значениями 1,0 главную диагональ в первых N+1 строках матрицы a. В сочетании с первыми N+1 нулевыми элементами вектора b это гарантирует, что свободный член и веса всех компонентов остаются строго неотрицательными.
Чтобы предотвратить взрывной рост дисперсии до бесконечности, сумма весов всех гетерогенных компонентов должна быть меньше 1. Данный метод реализует это путем добавления дополнительной строки в конец матрицы и вектора. Умножение обеих частей неравенства на −1 меняет направление знака неравенства, обеспечивая соблюдение требуемого порога устойчивости. Полученная пара "матрица — вектор" помещается в структуру Constraints (out._one и out._two) и возвращается для задания ограничений оптимизатору.
//--- Construct parameter constraints arrays for parameter estimation
//--- This implements linear inequality constraints of the form: (A * parameters) >= b
virtual Constraints constraints(void) override
  {
   // Initialize matrix A for the linear constraints
   // Size is [number of constraints, number of parameters]
   matrix a = matrix::Zeros(m_num_lags + 2, m_num_lags + 1);

   // Create identity matrix portion to enforce positivity constraints on all parameters (w > 0, alpha_i > 0)
   for(ulong i = 0; i < m_num_lags + 1; a[i, i] = 1., ++i);

   // Add constraint to ensure the sum of ARCH coefficients is less than 1 (sum(alpha_i) < 1)
   // This is a common requirement for the stationarity of the variance process
   for(ulong j = 1; j < a.Cols(); ++j)
      a[m_num_lags + 1, j] = -1.;

   // Initialize vector b for the constraint constants
   vector b = vector::Zeros(m_num_lags + 2);

   // Set the value for the stationarity constraint (sum <= 1 translates to -sum >= -1)
   b[m_num_lags + 1] = -1.;

   // Package into the Constraints structure
   Constraints out;
   out._one = a;
   out._two = b;
   return out;
  }
Метод computeVariance() отличается от реализации в FIGARCH тем, что не требует никаких преобразований и сразу завершает работу без дополнительного масштабирования.
//--- Compute the variance for the ARCH model using recursive updates
virtual vector    computeVariance(vector& parameters, vector& resids, vector& sigma2, vector& backcast, matrix& varbounds) override
  {
   // Cache the lag structure (e.g., [1, 2, 5] for ARCH(5))
   vector lags = m_lags;

   // Determine the total number of observations to process
   int nobs = int(resids.Size());

   // Perform the recursive ARCH calculation:
   // The variance at time t is computed as: sigma^2_t = omega + sum(alpha_i * resids^2_{t-i})
   // This helper function handles the loop over observations and lags,
   // utilizing 'backcast' values for the initial periods where lagged data is missing.
   harch_recursion(parameters, resids, sigma2, lags, nobs, backcast[0], varbounds);

   // Return the completed variance series
   return sigma2;
  }
Метод simulate() генерирует выборку из модели, явно вычисляя лаги гетерогенных компонентов во вложенных циклах. Он генерирует случайные ошибки, следующие стандартному нормальному распределению, на протяжении всего периода моделирования. Метод также предусматривает резервную проверку ограничений для обработки результатов генератора случайных чисел, представленных одномерным вектором либо двумерной матрицей-столбцом. Если начальное значение явно не указано, процедура вычисляет долгосрочную безусловную дисперсию процесса HARCH. Если параметры могут привести к взрывной динамике, алгоритм использует свободный член (ω) в качестве начального значения, чтобы избежать деления на ноль или отрицательных значений дисперсии. Первые maxlag элементов заранее заполняются начальным значением, соответствующим установившемуся режиму. Элементам sigma2 присваивается исходное базовое значение дисперсии. А элементы data инициализируются квадратным корнем из этого значения дисперсии, чтобы задать стабильные начальные шоки доходности.
Моделирование продолжается в хронологическом порядке до конца временного ряда. Чтобы устранить начальное смещение, вызванное жестко заданной инициализацией, метод отбрасывает первые burn элементов обоих векторов. Доходности и условные дисперсии объединяются в итоговую матрицу из двух столбцов, которую метод возвращает в качестве результата.
//--- Simulate data from the ARCH model
virtual matrix        simulate(vector& parameters, ulong _nobs, BootstrapRng &rng, ulong burn = 500, double initial_value = NULL) override
  {
   // Generate random innovations (shocks) for the duration of the sample plus burn-in
   vector errs = rng.rng(_nobs + burn);
   if(!errs.Size())
     {
      matrix container = rng.rng(_nobs + burn, 1);
      errs = container.Col(0);
     }

   // Calculate unconditional variance (long-run average) for initialization if not provided
   // Formula: sigma^2 = omega / (1 - sum(alpha_i))
   if(!initial_value)
     {
      vector vp = np::sliceVector(parameters, 1);
      double psum = vp.Sum();
      if(1.0 - psum > 0)
         initial_value = parameters[0] / (1.0 - psum);
      else
        {
         Print(__FUNCTION__, ": Initial value WARNING - Model may be non-stationary or invalid");
         initial_value = parameters[0];
        }
     }

   vector sigma2 = vector::Zeros(_nobs + burn);
   vector data = sigma2;
   long maxlag = long(m_lags.Max());

   // Pre-fill the start of the series with the initial variance/data values
   for(long i = 0; i < maxlag; ++i)
     {
      sigma2[i] = initial_value;
      data[i] = sqrt(initial_value);
     }

   // Recursive generation of volatility and data series
   double param = 0;
   for(long t = maxlag; t < long(_nobs + burn); ++t)
     {
      // Start with the constant term (omega)
      sigma2[t] = parameters[0];

      // Accumulate the weighted sum of squared past residuals (ARCH components)
      for(ulong i = 0; i < m_lags.Size(); ++i)
        {
         param = parameters[1 + i] / double(m_lags[i]);
         for(ulong j = 0; j < ulong(m_lags[i]); ++j)
            sigma2[t] += param * pow(data[t - 1 - j], 2.);
        }
      // Generate observation based on current volatility and random shock
      data[t] = errs[t] * sqrt(sigma2[t]);
     }

   // Discard the burn-in period to minimize dependency on arbitrary initial values
   data = np::sliceVector(data, long(burn));
   sigma2 = np::sliceVector(sigma2, long(burn));

   // Return a matrix containing the simulated data and corresponding variance
   matrix out(data.Size(), 2);
   out.Col(data, 0);
   out.Col(sigma2, 1);

   return out;
  }
При расчете начальных значений параметров метод startingValues() задает целевой базовый уровень персистентности (α), равный 0,9, для совокупного влияния ARCH-компонентов. То есть в модели предполагается, что 90 % будущей волатильности будет обусловлено историческими шоками, а оставшиеся 10 % (1−α) будут отражены в свободном члене. Метод инициализирует весь вектор, умножая выборочную дисперсию исходных остатков на оставшуюся долю в 10 %. Поскольку первый элемент представляет собой свободный член (ω), это задает реалистичное начальное приближение для базового уровня долгосрочной дисперсии с учетом масштаба данных. Затем метод перебирает оставшиеся элементы вектора, соответствующие гетерогенным лаговым компонентам. Он равномерно распределяет заданную персистентность ARCH в размере 90 % между всеми компонентами.
///--- Returns starting values for the ARCH model optimization
//--- Provides a reasonable initial guess to help the solver converge
virtual vector    startingValues(vector& resids) override
  {
   // Set initial weight for the constant term (omega)
   double alpha = 0.9;

   // Initialize vector with (1 - alpha) * sample variance as the starting omega
   // and set the initial coefficients for the ARCH components
   vector sv = (1. - alpha) * resids.Var() * vector::Ones(m_num_lags + 1);

   // Distribute the remaining alpha weight evenly across all ARCH lag coefficients
   // This ensures the starting parameters imply a stationary process (sum of coefficients < 1)
   for(ulong i = 1; i < sv.Size(); sv[i] = alpha / double(m_num_lags), ++i);

   return sv;
  }
Как было показано в предыдущем разделе, прогнозы можно составлять аналитическим способом или с помощью моделирования. Оба способа используют два вспомогательных метода: _harch_to_arch() и _common_forecast_components(). Метод _harch_to_arch() преобразует параметры гетерогенной модели ARCH (HARCH) в эквивалентное представление линейной модели ARCH, перераспределяя агрегированные эффекты волатильности по отдельным временным лагам. Он инициализирует результирующий вектор параметров, размер которого определяется максимальным лагом в конфигурации модели (m_lags), перенося исходный свободный член в первый элемент без изменений.
Затем процедура в цикле перебирает параметры компонентов HARCH, извлекая для каждого оцененный вес и соответствующее окно, охватывающее несколько периодов. Во вложенном цикле процедура равномерно распределяет значение коэффициента HARCH по отдельным периодам, после чего возвращает итоговый набор коэффициентов ARCH.
//--- Model transformation
//--- Converts Heterogeneous ARCH (HARCH) parameters to standard ARCH representation
//--- HARCH models often group lags (e.g., weekly, monthly), this flattens them into individual coefficients
vector          _harch_to_arch(vector& parameters)
  {
   // Initialize output vector with size of the longest lag + 1 (for constant omega)
   vector arch_params = vector::Zeros(1 + int(m_lags.Max()));

   // Copy the constant term (omega) directly
   arch_params[0] = parameters[0];

   double lag = 0;
   double param = 0;

   // Distribute each grouped HARCH coefficient across the individual lag indices
   for(ulong i = 1; i < arch_params.Size(); ++i)
     {
      // Extract the coefficient and the corresponding lag grouping size
      param = parameters[i];
      lag = m_lags[i - 1];

      // Calculate the uniform weight for each lag within the group and add to the specific index
      for(ulong j = 1; j < ulong(lag + 1.); arch_params[j] += param / lag, ++j);
     }

   return arch_params;
  }
Метод _common_forecast_components() подготавливает матрицы структурных данных и параметры, необходимые для построения вневыборочных прогнозов волатильности модели HARCH. Сначала он преобразует коэффициенты HARCH в эквивалентные коэффициенты стандартной линейной модели ARCH с помощью вспомогательной функции _harch_to_arch, сохраняя отдельно выделенный свободный член модели и веса лагов ARCH в специальной структуре компонентов (CFC). Затем он выделяет память под большую матрицу хранения исторических данных (Resids2), заполняя позиции, для которых исторические данные отсутствуют, заданным пользователем значением ретроспективной оценки.
Наконец, он вычисляет квадраты наблюдаемых остатков временного ряда и размещает их в матрице хранения данных с последовательными диагональными смещениями, чтобы каждой точке начала прогноза соответствовало правильно выровненное по времени окно квадратов прошлых инноваций, используемое в уравнениях прогнозирования.
//--- Intermediate forecast components
//--- Prepares the historical data and parameter structures required for both analytic and simulation-based forecasting
CFC _common_forecast_components(vector& parameters, vector& resids, vector& backcast, ulong horizon)
  {
   CFC out;
   // Convert grouped HARCH parameters into a flat ARCH representation for easier matrix operations
   vector ap = _harch_to_arch(parameters);
   long t = long(resids.Size());
   long m = long(m_lags.Max());

   // Initialize the matrix to hold squared residuals, expanded to accommodate the forecast horizon
   out.Resids2 = matrix::Zeros(t, m + horizon);

   // Fill the forecast horizon portion of the matrix with initial backcast values
   for(long i = m; i < (long)out.Resids2.Rows(); ++i)
      for(long j = m; j < long(out.Resids2.Cols()); ++j)
         out.Resids2[i, j] = backcast[0];

   // Map historical squared residuals into the matrix aligned with the lag structure
   vector sqresids = pow(resids, 2.);
   for(long i = 0; i < m; ++i)
      for(long j = m - i - 1, k = 0; j < long(out.Resids2.Rows()) && k < long(t - (m - i - 1)); ++k, ++j)
         out.Resids2[j, i] = sqresids[k];

   // Separate the constant (omega) and the ARCH coefficient vector for the forecast calculations
   out.Const = ap[0];
   out.Arch = np::sliceVector(ap, 1);

   return out;
  }
В отличие от модели FIGARCH, которая ограничивает выбор методов прогнозирования при определенных условиях, в данном случае никаких ограничений на выбор метода прогнозирования нет. Поэтому процедура _check_forecasting_method() всегда возвращает значение true.
//--- Verify the requested forecasting method as valid for the specification
//--- Returns true as this model supports all forecasting methods (Analytic and Simulation)
virtual bool      _check_forecasting_method(ENUM_FORECAST_METHOD method, ulong horizon) override
  {
   // In more complex models, this would check if a specific method (like analytic)
   // is mathematically supported for the given horizon, or if simulation is required.
   // For this implementation, all methods are compatible.
   return true;
  }
Основная процедура аналитического прогнозирования сначала получает исходную матрицу хранения данных и преобразованные параметры линейной модели ARCH из вспомогательной функции _common_forecast_components, выбирая строки матрицы в соответствии с заданным индексом начала расчета. Затем он располагает коэффициенты ARCH в обратном порядке, чтобы правильно согласовать их с историческими данными по времени.
Последовательно проходя в цикле все шаги горизонта прогнозирования, метод извлекает скользящее окно квадратов последних остатков (или ранее рассчитанных ожидаемых дисперсий), выполняет матричное умножение с весами, расположенными в обратном порядке, добавляет свободный член модели и записывает полученную ожидаемую дисперсию обратно в матрицу хранения данных для использования на последующих шагах. Наконец, он выбирает из матрицы вновь заполненные столбцы с вневыборочными прогнозами и помещает их в объект VarianceForecast.
//--- Analytic multi-step volatility forecasts from the model
//--- Calculates the conditional variance forecast using the law of iterated expectations
virtual VarianceForecast _analyticforecast(vector& parameters, vector &resids, vector &backcast, matrix &varbounds, long _start, ulong horizon) override
  {
   // Retrieve the model constant and ARCH parameter vectors
   CFC cfc = _common_forecast_components(parameters, resids, backcast, horizon);
   long m = long(m_lags.Max());

   // Trim historical residuals to start from the requested time point
   cfc.Resids2 = np::sliceMatrixRows(cfc.Resids2, _start);

   // Reverse the ARCH coefficients to facilitate dot-product calculation with lagged squared residuals
   vector arch_rev = cfc.Arch;
   if(!np::reverseVector(arch_rev))
      return VarianceForecast();

   // Recursively project the variance into the future
   // For h > 0, E[resids^2_{t+h}] is replaced by the forecast of the variance
   for(long i = 0; i < long(horizon); ++i)
     {
      // Extract the relevant window of past squared residuals (or previous forecasts)
      matrix cc = np::sliceMatrixCols(cfc.Resids2, i, m + i);

      // Calculate variance: sigma^2_{t+i} = omega + sum(alpha * E[resids^2_{t+i-lag}])
      if(!cfc.Resids2.Col(cfc.Const + cc.MatMul(arch_rev), m + i))
        {
         Print(__FUNCTION__, ": Failed Columns assignment cfc.Resids2 ", GetLastError());
         return VarianceForecast();
        }
     }

   // Isolate the forecasted portion of the matrix (excluding the historical input)
   matrix out = np::sliceMatrixCols(cfc.Resids2, m);
   matrix empty[];

   // Return the analytic forecast (no simulation paths or shocks used here)
   return VarianceForecast(out, empty, empty);
  }
Метод, отвечающий за прогнозирование на основе моделирования, сначала получает предварительно выровненную матрицу структурных компонентов и веса линейной модели ARCH в обратном порядке, а затем создает внутренние контейнеры для хранения траекторий и шоков для каждой исторической точки начала прогноза в пределах расчетного окна. Для каждой точки начала прогноза алгоритм генерирует матрицу независимых случайных инноваций для заданного числа симуляций и последовательно проходит весь горизонт прогнозирования, период за периодом. В этом внутреннем цикле прогнозирования алгоритм умножает исторические данные каждой симуляции на веса ARCH, расположенные в обратном порядке, чтобы получить прогнозируемую дисперсию, умножает случайные инновации на квадратный корень из этой дисперсии для формирования искусственных будущих ценовых шоков и записывает квадраты этих шоков обратно в матрицу исторических данных для использования на следующем шаге горизонта прогнозирования.
В итоге метод агрегирует данные множества траекторий, вычисляя на каждом шаге среднее по столбцам по всем смоделированным траекториям, и возвращает компактную матрицу ожидаемых точечных прогнозов вместе с полными исходными данными смоделированных траекторий и шоков.
//--- Simulation-based volatility forecasts from the model
//--- Performs Monte Carlo simulations to project future variance paths
virtual VarianceForecast _simulationforecast(vector& parameters, vector &resids, vector &backcast, matrix &varbounds, long _start, ulong horizon, ulong simulations, BootstrapRng &rng) override
  {
   // Retrieve model-specific components (constants and ARCH parameters)
   CFC cfc = _common_forecast_components(parameters, resids, backcast, horizon);
   long t = long(resids.Size());
   long m = long(m_lags.Max());

   matrix paths[], shocks[];
   matrix temp_resids2 = matrix::Zeros(simulations, m + horizon);

   // Allocate memory for simulation paths and associated shocks
   ArrayResize(paths, int(t - _start));
   ArrayResize(shocks, int(t - _start));
   for(uint i = 0; i < paths.Size(); paths[i] = shocks[i] = matrix::Zeros(simulations, horizon), ++i);

   // Reverse ARCH coefficients for matrix multiplication alignment (dot product with lagged residuals)
   vector arch_rev = np::sliceVector(cfc.Arch, BEGIN_REVERSE, END_REVERSE, -1);

   // Iterate over each time point to generate future paths
   for(long i = _start; i < t; ++i)
     {
      matrix stdshocks = rng.rng(simulations, horizon);
      matrix rd2 = np::sliceMatrixRows(cfc.Resids2, i, i + 1);
      temp_resids2 = rd2;
      long path_loc = i - _start;

      // Project variance for each step of the horizon
      for(long j = 0; j < long(horizon); ++j)
        {
         rd2 = np::sliceMatrixCols(temp_resids2, j, m + j);

         // Calculate next period variance: sigma^2 = omega + sum(alpha * eps^2)
         if(!paths[path_loc].Col(cfc.Const + rd2.MatMul(arch_rev), j))
           {
            Print(__FUNCTION__, ": Column assignment error paths", GetLastError());
            return VarianceForecast();
           }

         // Calculate simulated shocks based on the projected volatility
         if(!shocks[path_loc].Col(stdshocks.Col(j) * sqrt(paths[path_loc].Col(j)), j))
           {
            Print(__FUNCTION__, ": Column assignment error shocks", GetLastError());
            return VarianceForecast();
           }

         // Update temporary residual buffer for the next simulation step
         if(!temp_resids2.Col(pow(shocks[path_loc].Col(j), 2.), m + j))
           {
            Print(__FUNCTION__, ": Column assignment error temp_resids2", GetLastError());
            return VarianceForecast();
           }
        }
     }

   // Aggregate simulation paths into an average forecast matrix
   matrix out(paths.Size(), paths[0].Cols());
   for(uint i = 0; i < paths.Size(); ++i)
      if(!out.Row(paths[i].Mean(1), i))
        {
         Print(__FUNCTION__, ": Row assignment error out", GetLastError());
         return VarianceForecast();
        }

   return VarianceForecast(out, paths, shocks);
  }
Скрипт HARCH_Demo.ex5 демонстрирует, как настроить модель, определяемую процессом волатильности HARCH. Приведенный ниже фрагмент кода демонстрирует задание параметров, связанных с моделью HARCH.
#define __SLSQP__
#include<figarch_harch\Arch\univariate\mean.mqh>

//--- Input parameters for script customization
input string           Symbol_ = "AUDUSD";            //--- Financial asset to process
input ENUM_TIMEFRAMES  TimeFrame = PERIOD_D1;         //--- Data horizon interval
input datetime         StartDate = D'2025.01.01';     //--- Historical capture anchor start date
input ulong            HistoryLen = 504;              //--- Total historical data bars to request
input double           ScaleFactor = 100.;            //--- Rescaling multiplier to prevent optimizer underflow
input bool             MeanConstant = true;           //--- Flag to include an intercept in the conditional mean
input string           HarchLags = "3,6";             //--- Comma-separated list defining heterogeneous lookback windows

//+------------------------------------------------------------------+
//| Script program start function                                    |
//+------------------------------------------------------------------+
void OnStart()
  {
   vector prices;
//--- --- Step 1: Historical Data Fetch ---
//--- Pull raw close prices into a high-performance vector array
   if(!prices.CopyRates(Symbol_, TimeFrame, COPY_RATES_CLOSE, StartDate, HistoryLen))
     {
      Print(" failed to get close prices for ", Symbol_, ". Error ", GetLastError());
      return;
     }

//--- --- Step 2: Transform Prices to Returns ---
//--- Map closing prices to logarithmic space
   prices = log(prices);

//--- Compute log returns: r_t = ln(P_t) - ln(P_{t-1})
   vector returns = np::diff(prices);

//--- --- Step 3: Base Model Configuration Setup ---
//--- Initialize core specification fields mapping onto the HARCH container
   ArchParameters harch_spec;

//--- Apply the scaling factor (multiplying by 100 scales returns to percentage form)
   harch_spec.observations = ScaleFactor * returns;
   harch_spec.include_constant = MeanConstant;
   harch_spec.vol_model_type = VOL_HARCH;

//--- --- Step 4: Dynamically Parse String Lags ---
//--- Tokenize the input string "HarchLags" into individual text segments using commas as delimiters
   string lag_info[];
   int nlags = StringSplit(HarchLags, StringGetCharacter(",", 0), lag_info);

   if(nlags > 0)
     {
      //--- Pre-allocate the specification's internal target lags vector block
      harch_spec.harch_lags = vector::Zeros(nlags);

      //--- Loop through parsed tokens, validate them, and convert them to continuous metrics
      for(uint i = 0; i < uint(nlags); ++i)
        {
         if(StringLen(lag_info[i]) > 0)
            harch_spec.harch_lags[i] = StringToDouble(lag_info[i]);
         else
           {
            //--- Abort execution safely if an invalid or empty string token structure is detected
            Print("Invalid lag value ", lag_info[i], ". Should be >= 1.");
            return;
           }
        }
     }

//--- --- Step 5: Model Initialization ---
//--- Instantiate the continuous tracking constant mean container wrapper
   ConstantMean harch_model;

//--- Pass structural parameters down into the optimization initialization routine
   if(!harch_model.initialize(harch_spec))
      return;

//--- --- Step 6: Parameter Optimization (Fitting) ---
//--- Trigger the non-linear execution optimizer loop (SLSQP engine solver)
   vector empty;
   ArchModelResult harch_params = harch_model.fit();

//--- --- Step 7: Optimization Convergence Guard ---
//--- Verify that the resulting parameters array size matches the model criteria configurations
   if(!harch_params.params.Size())
     {
      Print("Convergence failed ", GetLastError());
      return;
     }

//--- --- Step 8: Results Output Extraction ---
//--- Print optimal target parameter solutions to the MetaTrader Terminal panel
   Print("HARCH model parameters ", harch_params.params);

//--- Extract statistical asymptotic standard deviation errors mapped out to individual p-values
   vector pv = harch_params.pvalues();
   Print("HARCH model pvalues: ");
   for(ulong i = 0; i < pv.Size(); ++i)
     {
      //--- Log individual calculated p-values step-by-step to evaluate structural significance
      Print(" pvalue for param at ", i, " :- ", pv[i]);
     }
  }
//+------------------------------------------------------------------+
При успешной подгонке получаются параметры, которые напрямую соотносятся с заданными горизонтами. Первым параметром процесса волатильности является базовая дисперсия. Затем по порядку перечисляются коэффициенты (c_j) для каждого заданного горизонта. Результаты выполнения скрипта приведены ниже.
HARCH model parameters [-0.0246053603937225,0.3290220407542077,0.05471622381862901,7.075421387748211e-16]
HARCH model pvalues:
pvalue for param at 0 :- 0.3439919771544495
pvalue for param at 1 :- 8.959410990883043e-11
pvalue for param at 2 :- 0.6356834250774976
pvalue for param at 3 :- 0.999999999999997
Заключение
В статье представлен полный цикл работы с моделями волатильности с долгой памятью: от диагностики и выбора модели до реализации. На практике теперь в вашем распоряжении воспроизводимый порядок действий:
- проверьте свой прокси-показатель волатильности с помощью функции расчета показателя Херста rs() (анализ нормированного размаха) и функции gph test() (логарифмическая периодограмма/GPH), чтобы получить H, d и p-значения (с обязательными проверками минимального объема выборки);
- проанализируйте низкочастотную логарифмическую периодограмму с помощью функции plot frequency domain fit(), чтобы отличить плавное дробное затухание от дискретной структуры с несколькими горизонтами;
- выбирайте модель FIGARCH, если спектр демонстрирует непрерывный дробный наклон, или модель HARCH, если в спектре наблюдаются локальные пики, соответствующие отдельным горизонтам;
- оцените параметры выбранной модели и используйте ее с помощью предоставленной библиотеки MQL5 и демонстрационных скриптов.
В комплект входят два новых класса процессов волатильности (FIGARCH, HARCH), утилиты для тестирования и примеры скриптов для оценивания и прогнозирования. Учитывайте практические ограничения: модель FIGARCH требует задания глубины усечения и больших вычислительных затрат (при показателе степени != 2 возможности аналитического многошагового прогнозирования ограничены), тогда как модель HARCH менее ресурсоемка, но чувствительна к выбранным окнам временных горизонтов. С помощью этих инструментов вы сможете проводить количественную диагностику, оценивать робастные модели с долгой памятью и интегрировать прогнозы условной дисперсии в процессы разработки стратегий, управления рисками или обнаружения режимов.
| Файл | Описание |
|---|---|
| MQL5/Include/figarch_harch/Arch. | В этой папке находятся все заголовочные файлы библиотеки моделирования волатильности и утилит для тестирования, упомянутых в статье. |
| MQL5/Scripts/figarch_harch/FiGARCH_Demo.mq5. | Скрипт, демонстрирующий настройку и оценивание параметров модели FIGARCH. |
| MQL5/Scripts/figarch_harch/HARCH_Demo.mq5. | Скрипт, демонстрирующий настройку и оценивание параметров модели HARCH. |
| MQL5/Scripts/figarch_harch/TestsForLongMemoryInVolatility.mq5. | Скрипт для проверки персистентности на реальных данных. |
| MQL5/Scripts/figarch_harch/FigarchVsHarchSelectionTests.mq5. | Скрипт для построения логарифмических периодограмм с целью выбора модели. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/23171
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.