Arbitragem estatística com ações cointegradas (Parte 3): Configuração do banco de dados
 23
 0

Introdução
No artigo anterior desta série (Parte 2), realizamos o backtest de uma estratégia de arbitragem estatística baseada em uma cesta de ações cointegradas do setor de microprocessadores, negociadas na Nasdaq. Primeiro, selecionamos, entre centenas de tickers, aqueles que apresentavam maior correlação com a Nvidia. Em seguida, aplicamos o teste de Johansen para avaliar a cointegração do grupo selecionado e os testes ADF e KPSS para verificar a estacionariedade do spread. Por fim, obtivemos os pesos relativos da carteira a partir do autovetor de Johansen correspondente ao primeiro posto de cointegração. Os resultados do backtest foram promissores.
Entretanto, dois ou mais ativos podem ter permanecido cointegrados durante os últimos dois anos e começar a perder essa relação já amanhã. Em outras palavras, não há garantia de que um par ou grupo de ativos continue cointegrado. Mudanças na gestão de uma empresa, nas condições macroeconômicas ou no próprio setor podem afetar os fundamentos que originalmente sustentavam a cointegração entre os ativos. O contrário também pode acontecer: ativos que antes não eram cointegrados podem passar a apresentar cointegração a qualquer momento, pelos mesmos motivos. O mercado é um "enigma em constante transformação". Precisamos nos adaptar a essas mudanças. [PALOMAR, 2025]
Os pesos relativos dos ativos em uma cesta de ações cointegradas mudam quase continuamente. Esses pesos determinam não apenas o tamanho das nossas ordens (a quantidade de ações negociadas), mas também sua direção (compra ou venda). Portanto, precisamos acompanhar essas mudanças e ajustar nossa estratégia. Embora a cointegração represente uma relação de longo prazo, os pesos da carteira variam constantemente. Por isso, precisamos verificá-los com maior frequência e atualizar o modelo assim que houver alterações. Quando identificamos que nosso modelo está desatualizado, precisamos agir imediatamente, substituindo-o por um modelo atualizado.
Nosso Expert Advisor (EA) deve ser capaz de identificar, em tempo real, se os pesos da carteira utilizados pelo EA continuam atualizados ou se já sofreram alterações. Caso tenham mudado, o EA precisa receber os novos pesos o mais rápido possível. Além disso, deve verificar se o próprio modelo continua válido. Se não estiver mais válido, o EA precisa receber informações sobre quais ativos devem ser substituídos e realizar imediatamente a rotação dos ativos na carteira atual.
Utilizamos a integração do MetaTrader 5 com Python e as funções estatísticas especializadas da biblioteca statsmodels, mas, até agora, trabalhamos apenas com dados em tempo real, obtendo as cotações (dados de preços) conforme a necessidade. Essa abordagem é conveniente durante a fase de pesquisa devido à sua simplicidade. Entretanto, se pretendemos realizar a rotação dos ativos da carteira, atualizar os modelos ou os pesos da carteira, precisamos considerar o armazenamento dos dados. Em outras palavras, devemos começar a armazená-los em um banco de dados, pois baixar novamente as cotações sempre que precisamos delas se torna pouco prático. Além disso, talvez precisemos investigar relações entre diferentes classes de ativos e entre instrumentos que não participaram dos nossos testes iniciais de cointegração.
Um banco de dados de alta qualidade, escalável e rico em metadados é a base de qualquer projeto sério de arbitragem estatística. Como a modelagem de um banco de dados depende, em grande parte, das necessidades específicas de cada projeto (um bom banco de dados é aquele que atende aos requisitos do negócio), neste artigo vamos explorar uma das possíveis abordagens para criar um banco de dados voltado à arbitragem estatística.
Quais perguntas nosso banco de dados deve responder?
Ao tentar desenvolver um "framework de baixo custo para arbitragem estatística", ou seja, um sistema acessível ao trader de varejo comum, que dispõe de um notebook convencional e uma conexão à internet com velocidade convencional, enfrentamos diversas dificuldades decorrentes da falta de conhecimento especializado em áreas como estatística e desenvolvimento de software. A modelagem de bancos de dados NÃO é exceção. Trata-se de uma área extensa, sobre a qual seria possível escrever livros inteiros sem esgotar o assunto. O ideal, naturalmente, seria contar com um ou mais especialistas para cuidar da modelagem, implementação e manutenção do banco de dados.
Entretanto, como estamos desenvolvendo esse framework para o trader comum, precisamos trabalhar com os recursos disponíveis: estudar livros, consultar fóruns especializados e outros materiais, aprender com profissionais experientes, fazer tentativas, cometer erros, experimentar, assumir riscos e estar preparados para modificar a arquitetura do banco de dados caso ela se mostre inadequada. Precisamos de flexibilidade e de uma abordagem gradual. É melhor começar com uma estrutura simples e expandi-la de baixo para cima (bottom-up), em vez de adotar uma abordagem de cima para baixo (top-down), evitando assim uma complexidade desnecessária.
Em última análise, nosso banco de dados deve ser capaz de responder a uma pergunta muito simples: quais ativos devemos negociar agora para obter o maior lucro possível?
Retomando o artigo anterior, no qual a direção e o tamanho das ordens eram determinados pelos pesos dos ativos na carteira, uma possível resposta do banco de dados seria semelhante a esta:
| Símbolos | Pesos | Timeframe |
|---|---|---|
| "MU", "NVDA", "MPWR", "MCHP" | 2.699439, 1.000000, -1.877447, -2.505294 | D1 |
Tabela 1 — Exemplo de resposta esperada de uma consulta para atualização do modelo em tempo real
Se nosso banco de dados conseguir fornecer essas informações relativamente simples, com uma frequência de atualização adequada, teremos tudo o que precisamos para manter a negociação contínua com a estratégia tão otimizada quanto possível.
Atualização do banco de dados como serviço
Até agora, realizamos a análise dos dados utilizando cotações em tempo real obtidas do terminal MetaTrader 5 por meio de código Python (tecnicamente, na maior parte do tempo, utilizamos cotações que já estavam armazenadas pelo mecanismo interno do terminal). Depois de definir os símbolos e os pesos da carteira, atualizávamos manualmente nosso EA, configurando os novos símbolos e/ou pesos.
A partir de agora, vamos separar a análise de dados do terminal e passar a utilizar os dados armazenados em nosso banco de dados. Isso permitirá atualizar o EA assim que novos pesos da carteira estiverem disponíveis, interromper as negociações caso a relação de cointegração deixe de existir ou migrar para outro grupo de instrumentos com perspectivas mais favoráveis. Em outras palavras, queremos melhorar a exposição ao mercado de cada instrumento, atualizando os pesos da carteira em tempo real e/ou realizando a rotação dos ativos sempre que os resultados da análise indicarem essa necessidade.
Para atualizar o banco de dados, vamos implementar um serviço do MetaTrader 5.
De acordo com a documentação do MetaTrader 5:
- Os serviços não estão vinculados a um gráfico específico.
- Os serviços são carregados automaticamente após a inicialização do terminal, desde que estivessem ativos quando ele foi fechado.
- Os serviços são executados em threads próprias.
Com isso, podemos concluir que um serviço é a solução ideal para manter o banco de dados funcionando adequadamente. Se o serviço estiver ativo no momento do encerramento da sessão de negociação e do fechamento do terminal, sua execução será retomada automaticamente na próxima inicialização, independentemente do gráfico ou símbolo que estiver aberto. Além disso, como o serviço é executado em uma thread independente, não interfere na execução de outros serviços, indicadores, scripts ou EAs, nem depende deles para funcionar.
Assim, nosso fluxo de trabalho será o seguinte:
- Toda a análise de dados será realizada em Python, fora do ambiente do MetaTrader 5. Para executar a análise, carregaremos os dados históricos e os armazenaremos no banco de dados.
- Sempre que houver uma alteração na composição da carteira ativa, com a inclusão ou remoção de um símbolo, atualizaremos os parâmetros de entrada do serviço, fornecendo um array de símbolos e outro de timeframes.
- Sempre que houver uma alteração na composição da carteira ativa, com a inclusão ou remoção de um símbolo, também atualizaremos os parâmetros de entrada do EA.
Por enquanto, as atualizações das etapas 2 e 3 serão realizadas manualmente. Posteriormente, automatizaremos essas etapas.
Configuração do banco de dados
Durante a preparação deste artigo, confirmei mais uma vez que a ferramenta ideal para essa tarefa seria um banco de dados colunar especializado em séries temporais. Existem diversas soluções no mercado que atendem a esses requisitos, tanto pagas quanto gratuitas, proprietárias ou de código aberto. Essas soluções foram desenvolvidas para lidar com cargas de trabalho altamente especializadas e volumes enormes de dados, oferecendo tempos de resposta inferiores a um segundo tanto na ingestão de dados quanto na execução de consultas em tempo real.
No entanto, em nosso caso, a escalabilidade não é a prioridade. Nosso foco está na simplicidade e na possibilidade de utilização por um único usuário, sem depender de uma equipe de administradores de bancos de dados (DBAs) altamente qualificados e especialistas em sistemas de armazenamento de séries temporais. Por isso, começaremos pela solução mais simples, cientes das limitações dessa escolha e de que o sistema evoluirá conforme necessário.
Começaremos utilizando o banco de dados SQLite integrado ao MetaTrader 5. Há diversos materiais disponíveis sobre como criar e utilizar esse banco de dados no ambiente do MetaTrader 5. Podemos encontrá-los:
- na documentação do MetaEditor, que explica como utilizar a interface gráfica para criar, acessar e gerenciar bancos de dados;
- na documentação do MetaEditor sobre as funções da API para operações com bancos de dados;
- no artigo introdutório da MetaQuotes sobre as operações básicas com bancos de dados SQL em MQL5;
- no livro sobre MQL5, que aborda o uso avançado do banco de dados SQLite integrado.
Se você pretende utilizar esse banco de dados SQLite de forma mais aprofundada, é altamente recomendável estudar todos esses materiais. A seguir, apresentamos um resumo das etapas necessárias para nosso caso de uso específico, acompanhado de algumas explicações sobre as decisões adotadas.
Esquema do banco de dados
O arquivo db-setup.mq5, disponibilizado com este artigo, é um script em MQL5 que recebe dois parâmetros de entrada: o nome do arquivo do banco de dados SQLite e o nome do arquivo que contém o esquema do banco de dados. Os valores padrão são statarb-0.1.db e schema-0.1.sql, respectivamente.
ATENÇÃO: é altamente recomendável manter o arquivo do esquema do banco de dados sob controle de versão e evitar duplicá-lo no sistema de arquivos. O MetaTrader 5 já conta com um sistema robusto de controle de versão integrado.
Ao executar o script com os parâmetros padrão, será criado um banco de dados SQLite na pasta MQL5/Files/StatArb do seu terminal (NÃO na pasta compartilhada), contendo todas as tabelas e campos descritos a seguir. O script também criará um arquivo chamado output.sql na pasta MQL5/Files, destinado exclusivamente à depuração. Caso ocorra algum problema, você poderá examinar esse arquivo para entender como o sistema está lendo o esquema do banco de dados. Se tudo funcionar corretamente, o arquivo poderá ser excluído sem problemas.
Como alternativa, você pode criar o banco de dados por outros meios e carregar o esquema utilizando qualquer cliente SQLite3, a interface do MetaEditor, o Windows PowerShell ou a linha de comando do SQLite3. Ainda assim, recomendamos utilizar o script fornecido para criar o banco de dados pelo menos na primeira vez. Posteriormente, você poderá adaptar o procedimento às suas necessidades.
Esquema do banco de dados
O esquema inicial do banco de dados contém apenas quatro tabelas, duas das quais são estruturas preliminares reservadas para etapas futuras. Portanto, neste momento, utilizaremos somente as tabelas "symbol" e "market_data".
A Figura 1 apresenta o diagrama entidade-relacionamento (ERD) desse esquema inicial.
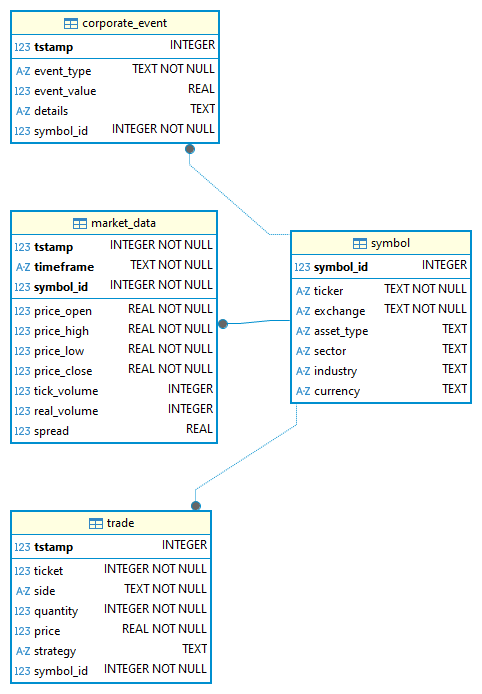
Figura 1. Diagrama entidade-relacionamento (ERD) do esquema inicial
do banco de dados Como o próprio nome sugere, a tabela "corporate_event" foi criada para armazenar eventos corporativos relacionados às empresas que compõem nossa carteira, como pagamentos de dividendos e seus respectivos valores, desdobramentos de ações, recompras de ações, fusões, entre outros. Por enquanto, não utilizaremos essa tabela.
A tabela "trade" armazenará nossas operações. Ao reunir esses registros, teremos um conjunto de dados exclusivo, que poderá ser utilizado para agregação e análise. Essa tabela só será utilizada quando começarmos a negociar.
A tabela "market_data" armazenará os dados OHLC, incluindo todos os campos da estrutura MqlRates. Ela utiliza uma chave primária composta (symbol_id, timeframe e timestamp) para garantir que cada registro seja único. A tabela "market_data" está vinculada à tabela "symbol" por meio de uma chave estrangeira.
Como podemos observar, essa é a única tabela que utiliza uma chave primária composta. Em todas as demais tabelas, a chave primária é uma marca de tempo armazenada como INTEGER. Há um motivo para essa escolha. Segundo a documentação do SQLite3:
"Os dados das tabelas com rowid são armazenados em uma árvore B que contém um registro para cada linha da tabela, utilizando o valor de rowid como chave. Isso significa que a recuperação ou ordenação dos registros por rowid é rápida. A busca por um registro com um rowid específico ou por todos os registros cujos valores de rowid estejam em determinado intervalo é aproximadamente duas vezes mais rápida do que uma busca equivalente por qualquer outra CHAVE PRIMÁRIA ou valor indexado.
(...) Se uma tabela com rowid tiver uma chave primária composta por uma única coluna, cujo tipo declarado seja "INTEGER", independentemente de maiúsculas ou minúsculas, essa coluna se tornará um alias de rowid. Esse tipo de coluna é geralmente chamado de "chave primária inteira".
(...) É possível obter consultas 'aproximadamente duas vezes mais rápidas' utilizando INTEGER como chave primária. As marcas de tempo Unix epoch podem ser inseridas como valores INTEGER em bancos de dados SQLite3."
(...) "O SQLite armazena números inteiros de 64 bits utilizando a representação em complemento de dois¹. Isso permite armazenar valores no intervalo de -9223372036854775808 a +9223372036854775807, inclusive. Os números inteiros nesse intervalo são representados com exatidão. (Documentação do SQLite3)".
Portanto, podemos substituir nossas strings de data e hora por marcas de tempo Unix epoch e utilizá-las como chaves primárias, obtendo um ganho de velocidade que supera a própria velocidade da luz. 🙂
As tabelas a seguir apresentam a documentação completa do esquema do banco de dados (dicionário de dados), que servirá como referência para nossa equipe e para consultas futuras.
Tabela: symbol
Armazena metadados dos instrumentos financeiros negociados ou monitorados.
| Campo | Tipo de dado | Null | Chave | Descrição |
|---|---|---|---|---|
| symbol_id | INTEGER | NO | PK | Identificador único de cada instrumento financeiro. |
| ticker | TEXT(≤10) | NO | Ticker do ativo (por exemplo, "AAPL", "MSFT"). | |
| exchange | TEXT(≤50) | NO | Bolsa em que o ativo é cotado (por exemplo, "NASDAQ", "NYSE"). | |
| asset_type | TEXT(≤50) | YES | Tipo de ativo (por exemplo, "Equity", "ETF", "FX", "Crypto"). | |
| sector | TEXT(≤50) | YES | Classificação do setor econômico (por exemplo, "Technology", "Healthcare"). | |
| industry | TEXT(≤50) | YES | Classificação do ramo de atividade dentro do setor econômico. | |
| currency | TEXT(≤50) | YES | Moeda em que o ativo é denominado (por exemplo, "EUR", "USD"). |
Tabela 2 – Descrição do dicionário de dados da tabela 'symbol' (v0.1)
Tabela: corporate_event
Registra eventos que afetam os ativos, como pagamentos de dividendos, desdobramentos de ações ou divulgações de resultados financeiros.
| Campo | Tipo de dado | Null | Chave | Descrição | Exemplo |
|---|---|---|---|---|---|
| tstamp | INTEGER | NO | PK | Marca de tempo Unix em que o evento entra em vigor. | 1678905600 |
| event_type | TEXT ENUM {'dividend', 'split', 'earnings'} | NO | Tipo de evento corporativo. | "dividend" | |
| event_value | REAL | YES | Valor numérico associado ao evento: • Valor do dividendo por ação • Fator de desdobramento das ações • Lucro por ação (EPS). | 0.85, 2.0, 1.35 | |
| details | TEXT(≤255) | YES | Observações adicionais ou informações contextuais. | "Q2 dividend payout" | |
| symbol_id | INTEGER | NO | FK | Referência a symbol(symbol_id), que vincula o evento ao ativo. | 1 |
Tabela 3 – Descrição do dicionário de dados da tabela 'corporate_event' (v0.1)
Tabela: market_data
Armazena dados OHLCV (open, high, low, close, volume) e as séries temporais relacionadas aos ativos.
| Campo | Tipo de dado | Null | Chave | Descrição | Exemplo |
|---|---|---|---|---|---|
| tstamp | INTEGER | NO | PK* | Marca de tempo Unix da barra ou candle. | 1678905600 |
| Timeframe | TEXT ENUM {M1,M2,M3,M4,M5,M6, M10,M12,M15,M20,M30,H1,H2,H3, H4,H6,H8,H12,D1,W1,MN1} | NO | PK* | Granularidade dos dados da série temporal. | "M5", "D1" |
| price_open | REAL | NO | Preço de abertura da barra. | 145.20 | |
| price_high | REAL | NO | Preço máximo registrado durante a barra. | 146.00 | |
| price_low | REAL | NO | Preço mínimo registrado durante a barra. | 144.80 | |
| price_close | REAL | NO | Preço de fechamento da barra. | 145.75 | |
| tick_volume | INTEGER | YES | Número de ticks (atualizações de preço) registrados durante o período da barra. | 200 | |
| real_volume | INTEGER | YES | Quantidade de unidades ou contratos negociados, quando disponível. | 15000 | |
| spread | REAL | YES | Spread (bid-ask) médio ou instantâneo durante o período da barra. | 0.02 | |
| symbol_id | INTEGER | NO | PK*, FK | Referência a symbol(symbol_id). | 1 |
Tabela 4 – Descrição do dicionário de dados da tabela 'market_data' (v0.1)
Tabela: trade
Registra operações reais ou simuladas das estratégias de negociação.
| Campo | Tipo de dado | Null | Chave | Descrição | Exemplo |
|---|---|---|---|---|---|
| tstamp | INTEGER | NO | PK | Marca de tempo Unix da execução da operação. | 1678905600 |
| ticket | INTEGER | NO | Ticket/ID da ordem. | 20230001 | |
| side | TEXT ENUM {'buy', 'sell'} | NO | Direção da operação. | "buy" | |
| quantity | INTEGER (>0) | NO | Quantidade de ações ou contratos negociados na operação. | 100 | |
| price | NO | Preço de execução. | 145.50 | ||
| strategy | YES | Identificador da estratégia de negociação que gerou a operação. | "StatArb_Pairs" | ||
| symbol_id | INTEGER | NO | FK | Referência a symbol(symbol_id). | 1 |
Tabela 5 – Descrição do dicionário de dados da tabela 'trade' (v0.1)
STRICT
Ao examinar o arquivo do esquema, você verá que todas as tabelas foram definidas como STRICT.
CREATE TABLE symbol(
    symbol_id INTEGER PRIMARY KEY,
    ticker TEXT CHECK(LENGTH(ticker) <= 10) NOT NULL,
    exchange TEXT CHECK(LENGTH(exchange) <= 50) NOT NULL,
    asset_type TEXT CHECK(LENGTH(asset_type) <= 50),
    sector TEXT CHECK(LENGTH(sector) <= 50),
    industry TEXT CHECK(LENGTH(industry) <= 50),
    currency TEXT CHECK(LENGTH(currency) <= 10)
) STRICT;
Isso significa que optamos pela tipagem estrita das tabelas, em vez da flexibilidade oferecida pelo sistema de afinidade de tipos do SQLite. Acreditamos que essa decisão poderá evitar problemas no futuro.
"Na instrução CREATE TABLE, a inclusão da palavra-chave "STRICT" ao final, após o parêntese de fechamento ")", faz com que as regras de tipagem estrita sejam aplicadas à tabela." (Documentação do SQLite)
VERIFICAÇÃO DO COMPRIMENTO
Além disso, implementamos verificações de comprimento em alguns campos de texto. Isso ocorre porque, diferentemente de outros sistemas de gerenciamento de bancos de dados (SGBDs), o SQLite não impõe limites de comprimento nem trunca strings com base no valor (n) especificado em CHAR(n) ou VARCHAR(n).
E quanto aos índices?
Você pode estar se perguntando por que ainda não criamos nenhum índice. Vamos criá-los quando começarmos a executar consultas, pois assim saberemos exatamente onde serão necessários.
Carga inicial dos dados
A ideia é que o banco de dados seja alimentado automaticamente, sem exigir nossa intervenção, durante a análise de dados realizada por meio da integração do MQL5 com Python. Entretanto, para facilitar essa etapa, disponibilizamos um script Python (db_store_quotes.ipynb) que permite armazenar as cotações de uma lista de símbolos, em um timeframe específico e durante um intervalo de tempo selecionado. Posteriormente, utilizaremos esses dados armazenados em nossas análises, incluindo os testes de correlação, cointegração e estacionariedade.

Figura 2. Tabela 'Symbol' após a carga inicial de dados realizada pelo script Python
Como podemos observar, a maioria dos metadados dos símbolos está preenchida com 'UNKNOWN'. Isso ocorre porque as funções SymbolInfo disponíveis em Python não fornecem todos os metadados dos símbolos acessíveis pela API do MQL5. Preencheremos essas informações posteriormente.
   # Insert new symbol
    cursor.execute("""
    INSERT INTO Symbol (ticker, exchange, asset_type, sector, industry, currency)
    VALUES (?, ?, ?, ?, ?, ?)
    """, (
        mt5_symbol,
        # some of this data will be filled by the MQL5 DB Update Service
        # because some of them are not provided by the Python MT5 API
        symbol_info.exchange or 'UNKNOWN',
        symbol_info.asset_class or 'UNKNOWN',
        symbol_info.sector or 'UNKNOWN',
        symbol_info.industry or 'UNKNOWN',
        symbol_info.currency_profit or 'UNKNOWN'
    ))
O caminho do banco de dados deve ser definido em uma variável de ambiente, e utilizamos o módulo python-dotenv para carregá-la. Isso ajuda a evitar problemas com variáveis de ambiente do terminal e/ou do PowerShell que podem não ser reconhecidas pelo editor utilizado.
Logo no início do script, o notebook Jupyter carrega a extensão python-dotenv e o arquivo *.env correspondente.
%load_ext dotenv
%dotenv .env
Um exemplo de arquivo *.env também acompanha este artigo.
# keep this file at the root of your project
# or in the same folder of the Python script that uses it
STATARB_DB_PATH="your/db/path/here"
A chamada principal está localizada no final do notebook db_store_quotes.ipynb.
symbols = ['MPWR', 'AMAT', 'MU']  # Symbols from Market Watch
timeframe = mt5.TIMEFRAME_M5    # 5-minute timeframe
start_date = '2024-02-01'
end_date = '2024-03-31'
db_path = os.getenv('STATARB_DB_PATH')  # Path to your SQLite database

if db_path is None:
        print("Error: STATARB_DB_PATH environment variable is not set.")
else:
        print("db_path: " + db_path)
# Download historical quotes and store them in the database
        download_mt5_historical_quotes(symbols, timeframe, start_date, end_date, db_path)
Atualizações
O serviço MQL5 executado em segundo plano é a base da manutenção do nosso banco de dados, necessária para automatizar a atualização do modelo e a rotação da carteira. Conforme nosso banco de dados evoluir, esse serviço também precisará ser atualizado.
O serviço se conecta ao arquivo local do banco de dados SQLite ou o cria, caso ainda não exista.
ATENÇÃO: ao criar um banco de dados completamente novo por meio do serviço de atualização, não se esqueça de inicializá-lo utilizando o script db_setup, conforme explicado anteriormente.
Em seguida, o serviço configura as restrições necessárias para garantir a integridade dos dados e entra em um laço contínuo de verificação de
novos dados de mercado. Para cada símbolo e timeframe, ele:
- obtém a última barra de preços concluída (incluindo open, high, low, close, volume e spread);
- verifica se essa barra já existe no banco de dados;
- insere as novas cotações caso ainda não estejam armazenadas.
O serviço executa a inserção dentro de uma transação do banco de dados para garantir a atomicidade. Se ocorrer algum problema, como um erro no banco de dados, ele tentará novamente até atingir o limite configurado (três tentativas, por padrão), com intervalos de um segundo entre elas. O registro de mensagens no log fica a seu critério. O laço faz uma pausa entre as atualizações e só é interrompido quando o serviço é encerrado manualmente.
Agora, vamos examinar alguns de seus componentes.
Nos parâmetros de entrada, você pode definir o caminho do banco de dados no sistema de arquivos, a frequência de atualização em minutos, o número máximo de novas tentativas em caso de falha na inserção e se deseja registrar mensagens de sucesso ou falha no log do EA. Essa última opção pode ser útil quando o código estiver estabilizado após a conclusão do desenvolvimento.
//+------------------------------------------------------------------+
//|   Inputs                                                         |
//+------------------------------------------------------------------+
input string   InpDbPath      = "StatArb\\statarb-0.1.db";  // Database filename
input int      InpUpdateFreq  = 1;     // Update frequency in minutes
input int      InpMaxRetries  = 3;     // Max retries
input bool     InpShowLogs    = true; // Enable logging?
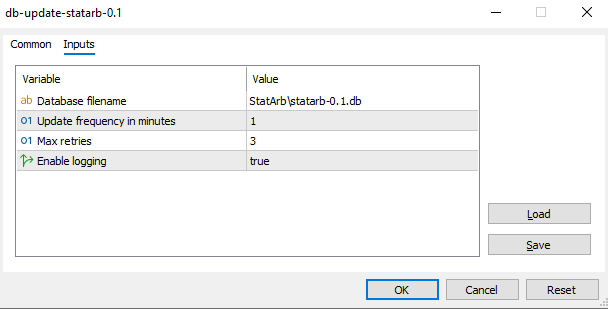
Figura 3. Caixa de diálogo do MetaTrader 5 com os parâmetros de entrada do serviço de atualização do banco de dados
Você deve selecionar os símbolos e os respectivos timeframes cujos dados serão atualizados. A configuração desses parâmetros será automatizada na próxima etapa.
//+------------------------------------------------------------------+
//|   Global vars                                                    |
//+------------------------------------------------------------------+
string symbols[] = {"EURUSD", "GBPUSD", "USDJPY"};
ENUM_TIMEFRAMES timeframes[] = {PERIOD_M5};
Aqui, inicializamos o handle do banco de dados com INVALID_HANDLE. Sua validade será verificada posteriormente, durante a abertura do banco de dados.
// Database handle
int dbHandle = INVALID_HANDLE;
OnStart()
No único manipulador de eventos do serviço, OnStart, criamos um laço infinito e chamamos a função UpdateMarketData, na qual começa a atualização dos dados de mercado. A função Sleep recebe o tempo de espera, em milissegundos, entre as iterações do laço (ou seja, entre as solicitações de atualização das cotações). Para facilitar a configuração, permitimos que o usuário informe esse intervalo em minutos e fazemos a conversão para milissegundos. Além disso, não esperamos que sejam necessárias atualizações em intervalos inferiores a um minuto.
//+------------------------------------------------------------------+
//| Main Service function                                            |
//| Parameters:                                                      |
//|   symbols    - Array of symbol names to update                   |
//|   timeframes - Array of timeframes to update                     |
//|   InpMaxRetries - Maximum number of retries for failed operations|
//+------------------------------------------------------------------+
void OnStart()
  {
   do
     {
      printf("Updating db: %s", InpDbPath);
      UpdateMarketData(symbols, timeframes, InpMaxRetries);
      Sleep(1000 * 60 * InpUpdateFreq); // 60 secs
     }
   while(!IsStopped());
  }
UpdateMarketData()
Começamos chamando a função responsável pela inicialização do banco de dados. Se ocorrer algum erro, retornamos 'false' e devolvemos o controle ao laço principal. Assim, caso haja algum problema na inicialização do banco de dados, você pode manter o serviço em execução enquanto corrige a falha. Na próxima iteração, ele fará uma nova tentativa.
//+------------------------------------------------------------------+
//| Update market data for multiple symbols and timeframes           |
//+------------------------------------------------------------------+
bool UpdateMarketData(string &symbols_array[], ENUM_TIMEFRAMES &time_frames[], int max_retries = 3)
  {
// Initialize database
   if(!InitializeDatabase())
     {
      LogMessage("Failed to initialize database");
      return false;
     }
   bool allSuccess = true;

If the database is initialized (open), we start processing each symbol and timeframe.

// Process each symbol
   for(int i = 0; i < ArraySize(symbols_array); i++)
     {
      string symbol = symbols_array[i];
      // Process each timeframe
      for(int j = 0; j < ArraySize(time_frames); j++)
        {
         ENUM_TIMEFRAMES timeframe = time_frames[j];
         int retryCount = 0;
         bool success = false;
Nesse laço while, controlamos o número máximo de tentativas e chamamos diretamente a função de atualização do banco de dados.
         // Retry logic
         while(retryCount < max_retries && !success)
           {
            success = UpdateSymbolTimeframeData(symbol, timeframe);
            if(!success)
              {
               retryCount++;
               Sleep(1000); // Wait before retry
              }
           }
         if(!success)
           {
            LogMessage(StringFormat("Failed to update %s %s after %d retries",
                                    symbol, TimeframeToString(timeframe), max_retries));
            allSuccess = false;
           }
        }
     }
   DatabaseClose(dbHandle);
   return allSuccess;
  }
UpdateSymbolTimeframeData()
Como a tabela market_data exige symbol_id como chave estrangeira, primeiro precisamos obter esse identificador. Para isso, verificamos se já existe um symbol_id associado ao símbolo na tabela "symbol". Caso seja um símbolo novo, criamos o registro correspondente e obtemos seu symbol_id.
//+------------------------------------------------------------------+
//| Update market data for a single symbol and timeframe             |
//+------------------------------------------------------------------+
bool UpdateSymbolTimeframeData(string symbol, ENUM_TIMEFRAMES timeframe)
  {
   ResetLastError();
// Get symbol ID (insert if it doesn't exist)
   long symbol_id = GetOrInsertSymbol(symbol);
   if(symbol_id == -1)
     {
      LogMessage(StringFormat("Failed to get symbol ID for %s", symbol));
      return false;
     }
Convertemos o timeframe do tipo MQL5 ENUM_TIMEFRAMES para o formato de texto (TEXT) exigido pela tabela.
   string tfString = TimeframeToString(timeframe);
   if(tfString == "")
     {
      LogMessage(StringFormat("Unsupported timeframe for symbol %s", symbol));
      return false;
     }
Copiamos os dados da última barra fechada.
// Get the latest closed bar
   MqlRates rates[];
   if(CopyRates(symbol, timeframe, 1, 1, rates) != 1)
     {
      LogMessage(StringFormat("Failed to get rates for %s %s: %d", symbol, tfString, GetLastError()));
      return false;
     }
Verificamos se esse registro já existe no banco de dados. Em caso afirmativo, registramos a informação no log e retornamos 'true'.
   if(MarketDataExists(symbol_id, rates[0].time, tfString))
     {
      LogMessage(StringFormat("Data already exists for %s %s at %s",
                              symbol, tfString, TimeToString(rates[0].time)));
      return true;
     }
Se for um novo registro de cotação, iniciamos uma transação no banco de dados para garantir a atomicidade da operação. Se ocorrer alguma falha, fazemos o rollback da transação. Se tudo for executado corretamente, confirmamos a transação com um commit e retornamos 'true'.
// Start transaction
   if(!DatabaseTransactionBegin(dbHandle))
     {
      LogMessage(StringFormat("Failed to start transaction: %d", GetLastError()));
      return false;
     }
// Insert the new data
   if(!InsertMarketData(symbol_id, tfString, rates[0]))
     {
      DatabaseTransactionRollback(dbHandle);
      return false;
     }
// Commit transaction
   if(!DatabaseTransactionCommit(dbHandle))
     {
      LogMessage(StringFormat("Failed to commit transaction: %d", GetLastError()));
      return false;
     }
   LogMessage(StringFormat("Successfully updated %s %s data for %s",
                           symbol, tfString, TimeToString(rates[0].time)));
   return true;
  }
InitializeDatabase()
Aqui, abrimos o banco de dados e verificamos se o identificador é válido.
//+------------------------------------------------------------------+
//| Initialize database connection                                   |
//+------------------------------------------------------------------+
bool InitializeDatabase()
  {
   ResetLastError();
// Open database (creates if it doesn't exist)
   dbHandle = DatabaseOpen(InpDbPath, DATABASE_OPEN_READWRITE | DATABASE_OPEN_CREATE);
   if(dbHandle == INVALID_HANDLE)
     {
      LogMessage(StringFormat("Failed to open database: %d", GetLastError()));
      return false;
     }
A diretiva PRAGMA que habilita foreign_keys no SQLite não é estritamente necessária quando utilizamos o banco de dados SQLite integrado, pois sabemos que ele foi compilado com suporte a esse recurso. Trata-se apenas de uma medida de precaução caso você utilize um banco de dados externo.
// Enable foreign key constraints
   if(!DatabaseExecute(dbHandle, "PRAGMA foreign_keys = ON"))
     {
      LogMessage(StringFormat("Failed to enable foreign keys: %d", GetLastError()));
      return false;
     }
   LogMessage("Database initialized successfully");
   return true;
  }
TimeframeToString()
A conversão de MQL5 ENUM_TIMEFRAMES para texto é realizada por meio de uma estrutura switch simples.
//+------------------------------------------------------------------+
//| Convert MQL5 timeframe to SQLite format                          |
//+------------------------------------------------------------------+
string TimeframeToString(ENUM_TIMEFRAMES tf)
  {
   switch(tf)
     {
      case PERIOD_M1:
         return "M1";
      case PERIOD_M2:
         return "M2";
      case PERIOD_M3:
         return "M3";
(...)
      case PERIOD_MN1:
         return "MN1";
      default:
         return "";
     }
  }
MarketDataExists()
Para verificar se os dados de mercado já estão armazenados, executamos uma consulta utilizando a chave primária composta da tabela market_data.
//+------------------------------------------------------------------+
//| Check if market data exists for given timestamp and timeframe    |
//+------------------------------------------------------------------+
bool MarketDataExists(long symbol_id, datetime tstamp, string timeframe)
  {
   ResetLastError();
   int stmt = DatabasePrepare(dbHandle, "SELECT 1 FROM market_data WHERE symbol_id = ? AND tstamp = ? AND timeframe = ? LIMIT 1");
   if(stmt == INVALID_HANDLE)
     {
      LogMessage(StringFormat("Failed to prepare market data existence check: %d", GetLastError()));
      return false;
     }
   if(!DatabaseBind(stmt, 0, symbol_id) ||
      !DatabaseBind(stmt, 1, (long)tstamp) ||
      !DatabaseBind(stmt, 2, timeframe))
     {
      LogMessage(StringFormat("Failed to bind parameters for existence check: %d", GetLastError()));
      DatabaseFinalize(stmt);
      return false;
     }
   bool exists = DatabaseRead(stmt);
   DatabaseFinalize(stmt);
   return exists;
  }
InsertMarketData()
Por fim, para inserir novos dados de mercado (atualização), executamos uma instrução de inserção utilizando a função StringFormat do MQL5, conforme recomendado na documentação.
Tenha cuidado com as valores de texto interpolados na cláusula VALUES. Elas precisam estar entre aspas. Depois você me agradece. 🙂
//+------------------------------------------------------------------+
//| Insert market data into database                                 |
//+------------------------------------------------------------------+
bool InsertMarketData(long symbol_id, string timeframe, MqlRates &rates)
  {
   ResetLastError();
   string req = StringFormat(
                   "INSERT INTO market_data ("
                   "tstamp, timeframe, price_open, price_high, price_low, price_close, "
                   "tick_volume, real_volume, spread, symbol_id) "
                   "VALUES(%d, '%s', %G, %G, %G, %G, %d, %d, %d, %d)",
                   rates.time, timeframe, rates.open, rates.high, rates.low, rates.close,
                   rates.tick_volume, rates.real_volume, rates.spread, symbol_id);
   if(!DatabaseExecute(dbHandle, req))
     {
      LogMessage(StringFormat("Failed to insert market data: %d", GetLastError()));
      return false;
     }
   return true;
  }
Enquanto o serviço estiver em execução...

Figura 4. Navegador do MetaEditor com o serviço de atualização do banco de dados em execução
... você deverá ver algo semelhante na aba Experts do diário do MetaTrader 5.

Figura 5. Aba Experts do MetaTrader 5 mostrando as mensagens do serviço de atualização do banco de dados
Sua tabela "market_data" deverá ter a aparência mostrada a seguir. Observe que, por enquanto, armazenamos todos os dados de mercado de todos os símbolos e timeframes em uma única tabela. Posteriormente, aprimoraremos essa estrutura conforme a necessidade. Neste momento, ela é mais do que suficiente para começarmos a realizar nossas análises de dados de maneira mais robusta.

Figura 6. Aba SQLite integrada ao MetaEditor mostrando as atualizações do banco de dados
Conclusão
Neste artigo, vimos como deixar de trabalhar com dados de preços obtidos sob demanda, sem armazenamento persistente, e passar a utilizar a primeira versão do banco de dados do nosso framework de arbitragem estatística. Examinamos os critérios adotados na definição do esquema inicial, os métodos de inicialização e a carga dos primeiros dados.
Agora, todas as tabelas, os campos e os relacionamentos do esquema estão documentados, com descrições, restrições e exemplos.
Também detalhamos as etapas necessárias para manter o banco de dados atualizado por meio de um serviço do MetaTrader 5. Apresentamos a implementação desse serviço e os scripts Python para realizar a carga inicial dos dados de qualquer símbolo (ticker) e timeframe disponível.
Com essas ferramentas, sem precisar escrever uma única linha de código, o trader de varejo comum, público-alvo do nosso framework de arbitragem estatística, pode começar a armazenar não apenas os dados de mercado atuais (cotações de preços), mas também metadados sobre as ações utilizadas em nossa estratégia de cointegração e o histórico das operações.
Esse esquema inicial começará a evoluir já na próxima etapa, quando passaremos a atualizar os pesos da carteira em tempo real e a realizar a rotação dos ativos caso a relação de cointegração da cesta enfraqueça, substituindo e/ou adicionando símbolos sem intervenção manual.
Referências
Daniel P. Palomar (2025). Portfolio Optimization: Theory and Application. Cambridge University Press.
* Uma limitação importante do SQLite em comparação com alguns bancos de dados orientados a séries temporais é a ausência de "as-of joins" (junções temporais por proximidade). Como indexaremos nossos dados de mercado por marcas de tempo, é quase certo que não poderemos utilizar junções entre tabelas no futuro, pois utilizamos marcas de tempo como chaves primárias, e elas raramente, ou talvez nunca, coincidirão em duas ou mais tabelas, enquanto as junções (inner, left e outer joins) dependem dessa correspondência entre os índices. Portanto, ao utilizar essas junções, obteremos conjuntos de resultados vazios (null). Este artigo de blog explica detalhadamente esse problema.
| Nome do arquivo | Descrição |
|---|---|
| StatArb/db-setup.mq5 | Script MQL5 para criar e inicializar o banco de dados SQLite a partir da leitura do arquivo de esquema schema-0.1.sql. |
| StatArb/db-update-statarb-0.1.mq5 | Serviço MQL5 para atualizar o banco de dados SQLite com os dados das últimas barras de preços fechadas. |
| StatArb/schema-0.1.sql | Arquivo SQL com o esquema do banco de dados (DDL), utilizado na inicialização para criar as tabelas, os campos e as restrições. |
| db_store_quotes.ipynb | Notebook Jupyter com código Python. Arquivo auxiliar para carregar o banco de dados SQLite com as cotações dos símbolos referentes a um intervalo de tempo e timeframe específicos. |
| .env | Exemplo de arquivo com variáveis de ambiente a serem carregadas pelo arquivo auxiliar Python mencionado acima. (Opcional) |
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/19242
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.