

Integración de MQL5 con paquetes de procesamiento de datos (Parte 5): Aprendizaje adaptativo y flexibilidad
 25
 0

Introducción
El problema al que se enfrentan muchos traders algorítmicos radica en la rigidez y la falta de adaptabilidad de los sistemas de negociación tradicionales. Tal y como se comentó en el artículo anterior, la mayoría de los Asesores Expertos (EA) están codificados de forma rígida con condiciones y umbrales estáticos, lo que a menudo les impide adaptarse en tiempo real a la dinámica cambiante del mercado, a los cambios de volatilidad o a patrones imprevistos. Como consecuencia, estos sistemas ofrecen un buen rendimiento en determinados entornos de mercado, pero su rendimiento se ve mermado cuando cambia el comportamiento del mercado, lo que da lugar a oportunidades perdidas, señales falsas frecuentes o caídas prolongadas.
Los modos de aprendizaje adaptativo y de flexibilidad ofrecen una solución muy atractiva a este problema. Al utilizar Python para crear un modelo de aprendizaje por refuerzo capaz de aprender continuamente a partir de la evolución histórica de los precios del XAUUSD, permitimos que el sistema adapte su estrategia en función de las condiciones cambiantes del mercado. La flexibilidad de las bibliotecas de Python (como PyTorch, Gym, Pandas, etc.) permite realizar un preprocesamiento avanzado de datos, simular entornos y optimizar modelos. Una vez entrenado, el modelo se puede exportar a ONNX, lo que permite su implementación en el entorno MQL5.
Obtención de datos históricos
from datetime import datetime
import MetaTrader5 as mt5
import pandas as pd
import pytz

# Display data on the MetaTrader 5 package
print("MetaTrader5 package author: ", mt5.__author__)
print("MetaTrader5 package version: ", mt5.__version__)

# Configure pandas display options
pd.set_option('display.max_columns', 500)
pd.set_option('display.width', 1500)

# Establish connection to MetaTrader 5 terminal
if not mt5.initialize():
    print("initialize() failed, error code =", mt5.last_error())
    quit()

# Set time zone to UTC
timezone = pytz.timezone("Etc/UTC")
# Create 'datetime' objects in UTC time zone to avoid the implementation of a local time zone offset
utc_from = datetime(2025, 05, 15, tzinfo=timezone.utc)
utc_to = datetime.(2025, 07,08, tzinfo=timezone.utc)

# Get bars from XAU H1 (hourly timeframe) within the specified interval
rates = mt5.copy_rates_range("XAUUSD", mt5.TIMEFRAME_H1, utc_from, utc_to)

# Shut down connection to the MetaTrader 5 terminal
mt5.shutdown()

# Check if data was retrieved
if rates is None or len(rates) == 0:
    print("No data retrieved. Please check the symbol or date range.")
else:
    # Display each element of obtained data in a new line (for the first 10 entries)
    print("Display obtained data 'as is'")
    for rate in rates[:10]:
        print(rate)

    # Create DataFrame out of the obtained data
    rates_frame = pd.DataFrame(rates)
    # Convert time in seconds into the 'datetime' format
    rates_frame['time'] = pd.to_datetime(rates_frame['time'], unit='s')

    # Save the data to a CSV file
    filename = "XAU_H1.csv"
    rates_frame.to_csv(filename, index=False)
    print(f"\nData saved to file: {filename}")
Para recuperar datos históricos, empezamos por inicializar una conexión con la terminal MetaTrader 5 mediante la función mt5.initialize(), que permite la comunicación entre Python y la plataforma MetaTrader 5. A continuación, definimos el intervalo de fechas concreto para la extracción de datos estableciendo tanto una fecha de inicio como una de finalización. Estas fechas se gestionan como objetos de fecha y hora en UTC para garantizar la coherencia entre las distintas zonas horarias. En este caso, el script está configurado para solicitar datos históricos por horas del símbolo XAUUSD, que abarcan el periodo comprendido entre el 15 de mayo de 2025 y el 8 de julio de 2025, utilizando la función mt5.copy_rates_range().
filename = "XAUUSD_H1.csv"
rates_frame.to_csv(filename, index=False)
print(f"\nData saved to file: {filename}")
Como quizá ya sepas, mi sistema operativo es Linux. Si tu sistema operativo es Windows, puedes obtener fácilmente los datos históricos con el siguiente script de Python:
from datetime import datetime
import MetaTrader5 as mt5
import pandas as pd
import pytz

# Display data on the MetaTrader 5 package
print("MetaTrader5 package author: ", mt5.__author__)
print("MetaTrader5 package version: ", mt5.__version__)

# Configure pandas display options
pd.set_option('display.max_columns', 500)
pd.set_option('display.width', 1500)

# Establish connection to MetaTrader 5 terminal
if not mt5.initialize():
    print("initialize() failed, error code =", mt5.last_error())
    quit()

# Set time zone to UTC
timezone = pytz.timezone("Etc/UTC")
# Create 'datetime' objects in UTC time zone to avoid the implementation of a local time zone offset
utc_from = datetime(2025, 05, 15, tzinfo=timezone.utc)
utc_to = datetime(2025, 07, 08, tzinfo=timezome.utc)

# Get bars from XAUUSD H1 (hourly timeframe) within the specified interval
rates = mt5.copy_rates_range("XAUUSD", mt5.TIMEFRAME_H1, utc_from, utc_to)

# Shut down connection to the MetaTrader 5 terminal
mt5.shutdown()

# Check if data was retrieved
if rates is None or len(rates) == 0:
    print("No data retrieved. Please check the symbol or date range.")
else:
    # Display each element of obtained data in a new line (for the first 10 entries)
    print("Display obtained data 'as is'")
    for rate in rates[:10]:
        print(rate)

    # Create DataFrame out of the obtained data
    rates_frame = pd.DataFrame(rates)
    # Convert time in seconds into the 'datetime' format
    rates_frame['time'] = pd.to_datetime(rates_frame['time'], unit='s')

    # Display data directly
    print("\nDisplay dataframe with data")
    print(rates_frame.head(10)
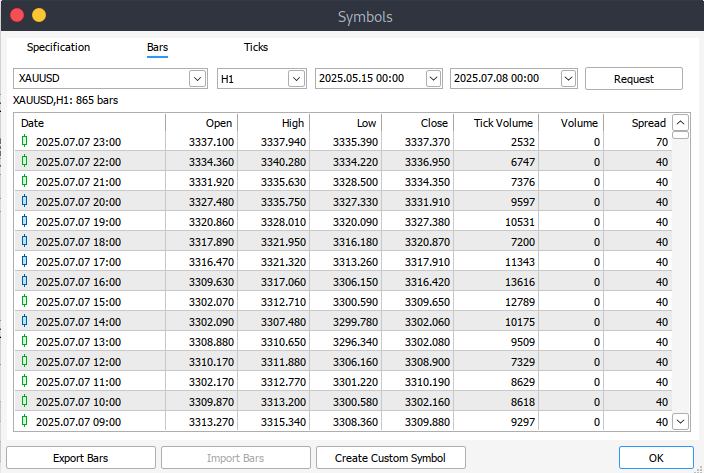
Si no puedes recuperar los datos históricos mediante programación, puedes descargarlos manualmente directamente desde tu plataforma MetaTrader 5. Empieza por abrir la plataforma; a continuación, ve al menú superior y selecciona «Herramientas» > «Opciones», lo que te llevará a la configuración de los gráficos. Aquí tendrás que indicar cuántas barras quieres que se muestren en el gráfico. Se recomienda seleccionar la opción «barras ilimitadas», sobre todo porque vamos a trabajar con intervalos de fechas y no podemos predecir con exactitud cuántas barras contendrá un intervalo de tiempo determinado.
A continuación, para descargar los datos propiamente dichos, ve a «Ver» > «Símbolos» en la barra de menús; se abrirá la ventana «Símbolos» en la pestaña «Especificaciones». A continuación, selecciona la pestaña «Barras» o «Marcas», según el tipo de datos que necesites. Introduce las fechas de inicio y fin deseadas para tus datos históricos y, a continuación, haz clic en el botón «Solicitar». Una vez recuperados los datos, puedes exportarlos y guardarlos en formato .csv para utilizarlos más adelante.
Primeros pasos
import pandas as pd

# Load the uploaded BTC 1H CSV file
file_path = '/home/int_j/Documents/Art Draft/Data Science/Adaptive Learning/XAUUSD_H1.csv'
xau_data = pd.read_csv(file_path)

# Display basic information about the dataset
xau_data_info = xau_data.info()
xau_data_head = xau_data.head()

xau_data_info, xau_data_head
Empezamos por examinar el conjunto de datos para comprender su estructura. Esto implica comprobar los tipos de datos, las dimensiones y si los datos están completos mediante la función info(). Además, visualizamos las primeras filas con la función `head()` para hacernos una idea del contenido y la estructura del conjunto de datos. Este paso forma parte del análisis exploratorio de datos y sirve para confirmar que los datos se han importado correctamente y para ofrecer una visión general inicial de su formato.
# Reload the data with tab-separated values
xau_data = pd.read_csv(file_path, delimiter='\t')

# Display basic information and the first few rows after parsing
xau_data_info = xau_data.info()
xau_data_head = xau_data.head()

xau_data_info, xau_data_head
Este bloque de código comienza cargando de nuevo los datos históricos del XAUUSD desde una ruta de archivo especificada, utilizando la tabulación (\t) como delimitador en lugar de la coma predeterminada. Al trabajar con archivos TSV (valores separados por tabulaciones), es importante asegurarse de que los datos se interpreten correctamente. Tras cargar los datos en el DataFrame xau_data, se muestra información esencial sobre el conjunto de datos —como los tipos de columna, el número de valores no nulos y el uso de memoria— mediante la función info(), y también se muestran las primeras filas con head() para obtener una vista previa rápida.
import pandas as pd
import numpy as np
import ta
from sklearn.preprocessing import StandardScaler

# Split the single column into proper columns
if len(xau_data.columns) == 1:
    # Extract column headers from the first row
    headers = xau_data.columns[0].split('\t')

    # Split data into separate columns
    xau_data = xau_data[xau_data.columns[0]].str.split('\t', expand=True)
    xau_data.columns = headers

# Convert columns to proper data types
numeric_cols = ['<OPEN>', '<HIGH>', '<LOW>', '<CLOSE>', '<TICKVOL>', '<VOL>', '<SPREAD>']
xau_data[numeric_cols] = xau_data[numeric_cols].apply(pd.to_numeric, errors='coerce')

# Clean and create features
xau_data = xau_data.dropna()
xau_data['return'] = xau_data['<CLOSE>'].pct_change()

# Add technical indicators
xau_data['rsi'] = ta.momentum.RSIIndicator(xau_data['<CLOSE>'], window=14).rsi()
xau_data['macd'] = ta.trend.MACD(xau_data['<CLOSE>']).macd_diff()
xau_data['sma_20'] = ta.trend.SMAIndicator(xau_data['<CLOSE>'], window=20).sma_indicator()
xau_data['sma_50'] = ta.trend.SMAIndicator(xau_data['<CLOSE>'], window=50).sma_indicator()
xau_data = xau_data.dropna()

# Normalize features
scaler = StandardScaler()
features = ['rsi', 'macd', 'sma_20', 'sma_50', 'return']
xau_data[features] = scaler.fit_transform(xau_data[features])
En este bloque de código, el proceso comienza con la limpieza y el formateo del conjunto de datos históricos de XAUUSD. Si los datos se han cargado incorrectamente como una sola columna (lo cual puede ocurrir con archivos separados por tabulaciones), el script divide esa columna utilizando las tabulaciones para extraer los encabezados y valores correctos. A continuación, convierte explícitamente columnas clave como «open», «high», «low», «close», «volume» y «spread» a tipos de datos numéricos, gestionando cualquier error que surja durante la conversión con «errors=“coerce”». A continuación, el script elimina los valores que falten y añade una nueva columna con las rentabilidades diarias, calculadas como la variación porcentual del precio de cierre.
En la siguiente sección se amplía el conjunto de datos con indicadores técnicos, utilizando la biblioteca de análisis técnico (TA). Indicadores como el RSI (Índice de Fuerza Relativa), el MACD (Convergencia/Divergencia de Medias Móviles) y las medias móviles simples (de 20 y 50 períodos) se calculan a partir del precio de cierre. Estas características se utilizan habitualmente en el trading algorítmico para ayudar a los modelos a identificar tendencias y momentum. Por último, todas las columnas de características seleccionadas se estandarizan utilizando StandardScaler de scikit-learn para garantizar que tengan una media de cero y una varianza unitaria, un paso esencial antes de introducir los datos en un modelo de aprendizaje automático o de aprendizaje por refuerzo para su entrenamiento.
import gym
from gym import spaces

class TradingEnv(gym.Env):
    def __init__(self, df, window_size=30, initial_balance=10000):
        super(TradingEnv, self).__init__()
        self.df = df.reset_index(drop=True)
        self.window_size = window_size
        self.initial_balance = initial_balance
        self.action_space = spaces.Discrete(3)  # 0: hold, 1: buy, 2: sell

        # Use correct shape (window_size, number of features)
        self.observation_space = spaces.Box(
            low=-np.inf, high=np.inf,
            shape=(self.window_size, len(features)), dtype=np.float32
        )

    def reset(self):
        self.current_step = self.window_size
        self.balance = self.initial_balance
        self.position = 0  # 1 = long, -1 = short, 0 = neutral
        self.entry_price = 0
        self.trades = []
        return self._next_observation()

    def _next_observation(self):
        # Use iloc to prevent overshooting shape
        obs = self.df.iloc[self.current_step - self.window_size : self.current_step]
        obs = obs[features].values
        return obs

    def step(self, action):
        current_price = self.df.loc[self.current_step, '<CLOSE>']
        reward = 0

        if action == 1 and self.position == 0:  # Buy
            self.position = 1
            self.entry_price = current_price
        elif action == 2 and self.position == 0:  # Sell
            self.position = -1
            self.entry_price = current_price
        elif action == 0 and self.position != 0:  # Close position
            if self.position == 1:
                reward = current_price - self.entry_price
            elif self.position == -1:
                reward = self.entry_price - current_price
            self.position = 0

        self.current_step += 1
        done = self.current_step >= len(self.df) - 1
        obs = self._next_observation()
        return obs, reward, done, {}
En el código anterior, definimos un entorno personalizado de OpenAI Gym denominado «TradingEnv», diseñado para entrenar agentes de aprendizaje por refuerzo en la toma de decisiones de negociación utilizando un conjunto de datos financieros históricos (en nuestro caso, XAUUSD). El entorno simula operaciones de trading permitiendo tres acciones distintas: mantener (0), comprar (1) o vender (2). Se inicializa con una ventana fija de observaciones históricas (window_size) y simula el comportamiento de negociación utilizando las características de los datos. El espacio de observación es una ventana que muestra los valores de los indicadores históricos (por ejemplo, el RSI o el MACD), y el entorno realiza un seguimiento de elementos clave como el saldo, el estado de la posición y el precio de entrada.
La función reset() prepara el entorno para un nuevo episodio restableciendo el contador de pasos, el saldo, la posición y cualquier operación abierta. La función step() implementa la lógica correspondiente a cada acción de un agente. Si el agente compra o vende mientras se encuentra en una posición neutra, abre una operación. Si decide mantener la posición mientras ya tiene una operación abierta, esta se cierra y el beneficio o la pérdida (P&L) se calcula como recompensa. El episodio avanza paso a paso por el conjunto de datos hasta llegar al final (done=True). Las observaciones obtenidas son fragmentos de características históricas que el agente utiliza para tomar decisiones futuras.
import torch.nn as nn
import torch.nn.functional as F

class DuelingDQN(nn.Module):
    def __init__(self, state_shape, action_dim):
        super(DuelingDQN, self).__init__()
        # Calculate flattened dimension
        flattened_dim = np.prod(state_shape)

        # Network layers
        self.fc1 = nn.Linear(flattened_dim, 128)

        # Value stream
        self.value_stream = nn.Sequential(
            nn.Linear(128, 128),
            nn.ReLU(),
            nn.Linear(128, 1)
        )

        # Advantage stream
        self.advantage_stream = nn.Sequential(
            nn.Linear(128, 128),
            nn.ReLU(),
            nn.Linear(128, action_dim)
        )

    def forward(self, state):
        # Flatten state while keeping batch dimension
        x = state.view(state.size(0), -1)
        x = F.relu(self.fc1(x))
        value = self.value_stream(x)
        advantages = self.advantage_stream(x)
        return value + (advantages - advantages.mean(dim=1, keepdim=True))
A continuación, definimos una red Q profunda en duelo (Dueling DQN) utilizando PyTorch, que es una variante de la arquitectura DQN estándar que separa la estimación de la función de valor del estado y la función de ventaja. La clase DuelingDQN hereda de nn. Module toma como parámetros la forma del estado de entrada y el número de acciones posibles (action_dim). En primer lugar, aplana el estado de entrada y lo hace pasar por una capa compartida totalmente conectada (fc1). A partir de ahí, la salida se divide en dos flujos: uno que estima el valor del estado y otro que estima la ventaja de cada acción.
En el método forward(), los dos flujos se vuelven a combinar utilizando la fórmula:
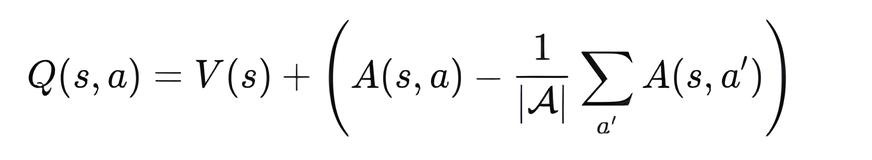
Esto garantiza que el modelo aprenda a distinguir entre el valor intrínseco de un estado (V(s)) y el beneficio relativo de realizar cada acción posible (A(s, a)), lo que mejora la estabilidad y el rendimiento en tareas de aprendizaje por refuerzo basadas en el valor, como el trading.
# Training loop parameters
env = TradingEnv(xau_data)

# Use positional arguments instead of keyword arguments
model = DuelingDQN(150, 3)  # input_dim=150 (flattened state), action_dim=3
target_model = DuelingDQN(150, 3)  # Same dimensions
target_model.load_state_dict(model.state_dict())
Resultado:
<All keys matched successfully>
Aquí inicializamos el entorno de entrenamiento y los modelos para un agente de red Q profunda en duelo (Dueling DQN). El entorno TradingEnv se crea utilizando el conjunto de datos xau_data ya preparado, que proporciona características del mercado para el aprendizaje por refuerzo. Se crean dos instancias del modelo DuelingDQN: «model» (la red en línea) y «target_model» (la red objetivo), ambas con una dimensión de entrada aplanada de 150 y un espacio de acción de 3 (comprar, vender, mantener). El `target_model` se inicializa copiando los pesos del modelo, lo cual es una práctica habitual en el entrenamiento de DQN para estabilizar el aprendizaje mediante el uso de una red objetivo que se actualiza lentamente durante las actualizaciones de diferencia temporal.
class ReplayBuffer:
    def __init__(self, capacity=10000):
        self.buffer = deque(maxlen=capacity)

    def push(self, state, action, reward, next_state, done):
        self.buffer.append((state, action, reward, next_state, done))

    def sample(self, batch_size):
        batch = random.sample(self.buffer, batch_size)
        state, action, reward, next_state, done = map(np.array, zip(*batch))
        return (
            torch.tensor(state, dtype=torch.float32),          # Shape: [batch, state_dim]
            torch.tensor(action, dtype=torch.int64),           # Should be integer (for indexing)
            torch.tensor(reward, dtype=torch.float32),
            torch.tensor(next_state, dtype=torch.float32),
            torch.tensor(done, dtype=torch.float32)
        )

    def __len__(self):
        return len(self.buffer)
La clase `ReplayBuffer` implementa un búfer de memoria que se utiliza en el aprendizaje por refuerzo para almacenar y muestrear experiencias con fines de entrenamiento. Utiliza una cola doble con una capacidad máxima fija (por defecto: 10 000) para gestionar de forma eficiente el almacenamiento de tuplas que contienen (estado, acción, recompensa, siguiente_estado, finalizado). El método push() añade nuevas experiencias al búfer y descarta automáticamente las más antiguas cuando se supera la capacidad.
El método `sample()` selecciona aleatoriamente un lote de experiencias y las convierte en tensores de PyTorch adecuados para el entrenamiento del modelo, garantizando que cada elemento tenga el tipo de datos adecuado (por ejemplo, `int64` para las acciones y `float32` para los estados y las recompensas). Este búfer favorece un aprendizaje más estable al reducir la correlación entre las experiencias de entrenamiento.
env = TradingEnv(xau_data)
obs_shape = env.observation_space.shape
n_actions = env.action_space.n

# Calculate flattened dimension
flattened_dim = np.prod(obs_shape)  # 30*5 = 150

model = DuelingDQN(flattened_dim, n_actions)
target_model = DuelingDQN(flattened_dim, n_actions)
target_model.load_state_dict(model.state_dict())

optimizer = optim.Adam(model.parameters(), lr=0.0005)
buffer = ReplayBuffer()
gamma = 0.99
epsilon = 1.0
batch_size = 64
target_update_interval = 10

all_rewards = []
all_actions = []  # We'll collect actions for the entire dataset

# Training loop
for episode in range(200):
    state = env.reset()
    total_reward = 0
    done = False
    episode_actions = []  # Store actions for this episode

    while not done:
        if random.random() < epsilon:
            action = env.action_space.sample()
        else:
            with torch.no_grad():
                # Flatten state and pass to model
                state_tensor = torch.tensor(state, dtype=torch.float32).flatten().unsqueeze(0)
                q_values = model(state_tensor)
                action = q_values.argmax().item()

        next_state, reward, done, _ = env.step(action)
        buffer.push(state, action, reward, next_state, done)
        state = next_state
        total_reward += reward
        episode_actions.append(action)  # Record action

        if len(buffer) >= batch_size:
            s, a, r, s2, d = buffer.sample(batch_size)

            q_val = model(s).gather(1, a.unsqueeze(1)).squeeze()
            next_q_val = target_model(s2).max(1)[0]
            target = r + (1 - d) * gamma * next_q_val

            loss = nn.MSELoss()(q_val, target)
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()

    epsilon = max(0.01, epsilon * 0.995)
    if episode % target_update_interval == 0:
        target_model.load_state_dict(model.state_dict())
        print(f"Episode {episode}, Reward: {total_reward}")

    # After episode completes
    all_rewards.append(total_reward)
    all_actions.extend(episode_actions)  # Add episode actions to master list
Resultado:
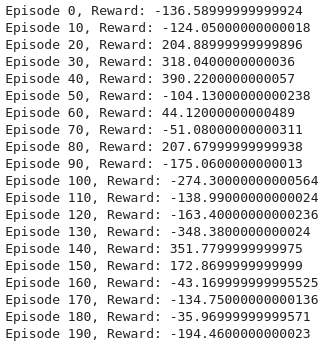
Este bucle de entrenamiento configura un entorno de aprendizaje por refuerzo para la negociación bursátil utilizando una red Q profunda en duelo (Dueling DQN). En primer lugar, se inicializa el entorno con datos históricos del XAUUSD y se derivan los parámetros clave a partir de los espacios de observación y de acción. Se crean un modelo Dueling DQN y un modelo de referencia, ambos con una forma de entrada aplanada de 150 (que representa 30 pasos temporales × 5 características). Se configuran un optimizador (Adam) y un búfer de repetición, junto con hiperparámetros como el factor de descuento (gamma), la tasa de exploración (epsilon), el tamaño del lote y la frecuencia de las actualizaciones de la red objetivo.
En cada episodio, el entorno se reinicia y el agente interactúa con él paso a paso, seleccionando acciones mediante una política «epsilon-greedy». Si un número aleatorio es menor que épsilon, se elige una acción aleatoria; en caso contrario, el modelo selecciona la acción con el valor Q previsto más alto. Tras ejecutar la acción, el agente recibe información de retroalimentación del entorno, que se almacena en el búfer de repetición. Una vez que el búfer contiene suficientes datos, se selecciona un lote de experiencias para entrenar el modelo. Se calculan los valores Q y los objetivos, y se aplica la retropropagación de la pérdida por error cuadrático medio para actualizar los parámetros del modelo.
Para estabilizar el entrenamiento, el modelo de referencia se actualiza periódicamente para que coincida con los pesos del modelo actual. Epsilon se va reduciendo gradualmente para disminuir la exploración con el paso del tiempo, lo que permite al agente aprovechar los conocimientos adquiridos con mayor seguridad. A lo largo del entrenamiento, se registran las recompensas totales y las acciones por episodio para evaluar el rendimiento. Este bucle ayuda al agente a aprender una estrategia de negociación óptima, equilibrando la exploración y la explotación a lo largo de 200 episodios.
import matplotlib.pyplot as plt

# Plotting performance metrics like cumulative reward
plt.plot([r for r in range(len(buffer.buffer))], label="Reward Trend")
plt.title("Training Rewards")
plt.show()
Resultado:
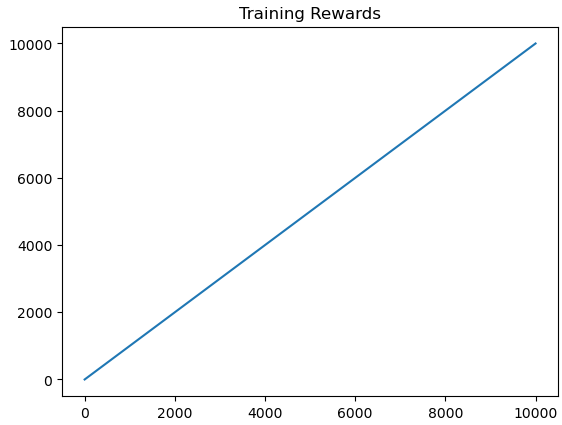
Aquí utilizamos matplotlib para visualizar el rendimiento del entrenamiento, representando gráficamente la evolución de la recompensa a lo largo del tiempo a partir de los datos almacenados en el búfer de repetición. Permite hacer un seguimiento de la evolución de las recompensas acumuladas del agente durante el entrenamiento.
import matplotlib.pyplot as plt

plt.figure(figsize=(12, 6))
plt.plot(all_rewards)
plt.xlabel("Episode")
plt.ylabel("Total Reward")
plt.title("Training Performance")
plt.grid(True)
plt.show()
Resultado:
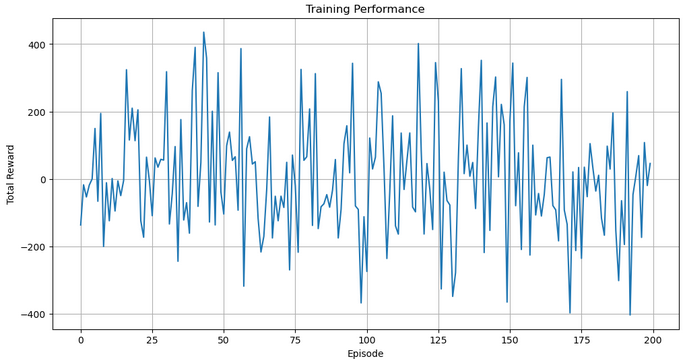
A continuación, visualizamos el rendimiento del agente a lo largo de los episodios representando gráficamente la variable `all_rewards`, que almacena la recompensa total obtenida en cada episodio. El gráfico ofrece información sobre el progreso en el aprendizaje y la estabilidad del agente de negociación a lo largo del tiempo, con una cuadrícula y etiquetas claras que facilitan su lectura.
# Run a clean evaluation with the trained model (no exploration)
eval_env = TradingEnv(xau_data)
state = eval_env.reset()
eval_actions = []  # Store actions for this single episode

with torch.no_grad():
    while True:
        # Flatten state and predict
        state_tensor = torch.tensor(state, dtype=torch.float32).flatten().unsqueeze(0)
        q_values = model(state_tensor)
        action = q_values.argmax().item()

        next_state, _, done, _ = eval_env.step(action)
        eval_actions.append(action)
        state = next_state

        if done:
            break

# Now plot using eval_actions
close_prices = xau_data['<CLOSE>'].values
window_size = eval_env.observation_space.shape[0]

# Create action array with same length as price data
action_array = np.full(len(close_prices), np.nan)
action_array[window_size:window_size + len(eval_actions)] = eval_actions

# Create plot
plt.figure(figsize=(14, 8))
plt.plot(close_prices, label='XAUUSD Price', alpha=0.7)

# Plot buy signals (action=1)
buy_mask = (action_array == 1)
buy_indices = np.where(buy_mask)[0]
plt.scatter(buy_indices, close_prices[buy_mask],
            color='green', label='Buy', marker='^', s=100)

# Plot sell signals (action=2)
sell_mask = (action_array == 2)
sell_indices = np.where(sell_mask)[0]
plt.scatter(sell_indices, close_prices[sell_mask],
            color='red', label='Sell', marker='v', s=100)

plt.legend()
plt.title("Trading Actions on XAUUSD (Trained Policy)")
plt.xlabel("Time Step")
plt.ylabel("Price")
plt.grid(True)
plt.show()
Resultado:
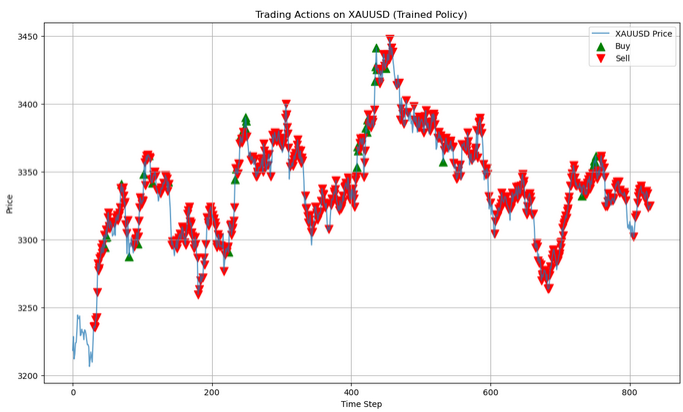
En esta fase de evaluación, el modelo entrenado se utiliza para realizar predicciones en un entorno limpio y sin exploración (eval_env). El agente observa el estado del mercado, selecciona la mejor acción basándose en los valores Q que ha aprendido (eligiendo de forma «codiciosa» la más alta) y registra cada acción realizada. Este bucle continúa hasta que finaliza el episodio, lo que permite al agente demostrar la política aprendida sin aleatoriedad.
dummy_input = torch.randn(1, *obs_shape)
torch.onnx.export(model, dummy_input, "dueling_dqn_xauusd.onnx",
                  input_names=["input"], output_names=["output"],
                  dynamic_axes={"input": {0: "batch_size"}, "output": {0: "batch_size"}}
Por último, el modelo Dueling DQN entrenado se exporta al formato ONNX utilizando una entrada ficticia para garantizar la compatibilidad con otras plataformas. Esto permite implementar el modelo de negociación fuera de PyTorch, por ejemplo, en sistemas en tiempo real o en entornos MQL5.
Ponemos todo en práctica en MQL5
//+------------------------------------------------------------------+
//|                                  ONNX_DQN_Trading_Script.mq5     |
//|                        Copyright 2023, MetaQuotes Ltd.           |
//|                                             https://www.mql5.com |
//+------------------------------------------------------------------+
#property copyright "Copyright 2023, MetaQuotes Ltd."
#property link      "https://www.mql5.com"
#property version   "1.00"
#property script_show_inputs

//--- input parameters
input string   ModelPath = "dueling_dqn_xauusd.onnx";  // File in MQL5\Files\
input int      WindowSize = 30;                        // Observation window size
input int      FeatureCount = 5;                       // Number of features

//--- ONNX model handle
long onnxHandle;

//--- Normalization parameters (REPLACE WITH YOUR ACTUAL VALUES)
const double   RSI_MEAN = 55.0,       RSI_STD = 15.0;
const double   MACD_MEAN = 0.05,      MACD_STD = 0.5;
const double   SMA20_MEAN = 1800.0,   SMA20_STD = 100.0;
const double   SMA50_MEAN = 1800.0,   SMA50_STD = 100.0;
const double   RETURN_MEAN = 0.0002,  RETURN_STD = 0.01;

//+------------------------------------------------------------------+
//| Script program start function                                    |
//+------------------------------------------------------------------+
void OnStart()
{
   //--- Load ONNX model
   onnxHandle = OnnxCreate(ModelPath, ONNX_DEFAULT);
   if(onnxHandle == INVALID_HANDLE)
   {
      Print("Error loading model: ", GetLastError());
      return;
   }

   //--- Prepare input data buffer
   double inputData[];
   ArrayResize(inputData, WindowSize * FeatureCount);

   //--- Collect and prepare data
   if(!PrepareInputData(inputData))
   {
      Print("Data preparation failed");
      OnnxRelease(onnxHandle);
      return;
   }

   //--- Set input shape (no need to set shape for dynamic axes)
   //--- Run inference
   double outputData[3];
   if(!RunInference(inputData, outputData))
   {
      Print("Inference failed");
      OnnxRelease(onnxHandle);
      return;
   }

   //--- Interpret results
   InterpretResults(outputData);
   OnnxRelease(onnxHandle);
}
//+------------------------------------------------------------------+
//| Prepare input data for the model                                 |
//+------------------------------------------------------------------+
bool PrepareInputData(double &inputData[])
{
   //--- Get closing prices
   double closes[];
   int closeCount = WindowSize + 1;
   if(CopyClose(_Symbol, _Period, 0, closeCount, closes) != closeCount)
   {
      Print("Not enough historical data. Requested: ", closeCount, ", Received: ", ArraySize(closes));
      return false;
   }

   //--- Calculate returns (percentage changes)
   double returns[];
   ArrayResize(returns, WindowSize);
   for(int i = 0; i < WindowSize; i++)
      returns[i] = (closes[i] - closes[i+1]) / closes[i+1];

   //--- Calculate technical indicators
   double rsi[], macd[], sma20[], sma50[];
   if(!CalculateIndicators(rsi, macd, sma20, sma50))
      return false;

   //--- Verify indicator array sizes
   if(ArraySize(rsi) < WindowSize || ArraySize(macd) < WindowSize ||
      ArraySize(sma20) < WindowSize || ArraySize(sma50) < WindowSize)
   {
      Print("Indicator data mismatch");
      return false;
   }

   //--- Normalize features and fill input data
   int dataIndex = 0;
   for(int i = WindowSize - 1; i >= 0; i--)
   {
      inputData[dataIndex++] = (rsi[i] - RSI_MEAN) / RSI_STD;
      inputData[dataIndex++] = (macd[i] - MACD_MEAN) / MACD_STD;
      inputData[dataIndex++] = (sma20[i] - SMA20_MEAN) / SMA20_STD;
      inputData[dataIndex++] = (sma50[i] - SMA50_MEAN) / SMA50_STD;
      inputData[dataIndex++] = (returns[i] - RETURN_MEAN) / RETURN_STD;
   }

   return true;
}
//+------------------------------------------------------------------+
//| Calculate technical indicators                                   |
//+------------------------------------------------------------------+
bool CalculateIndicators(double &rsi[], double &macd[], double &sma20[], double &sma50[])
{
   //--- RSI (14 period)
   int rsiHandle = iRSI(_Symbol, _Period, 14, PRICE_CLOSE);
   if(rsiHandle == INVALID_HANDLE) return false;
   if(CopyBuffer(rsiHandle, 0, 0, WindowSize, rsi) != WindowSize) return false;
   IndicatorRelease(rsiHandle);

   //--- MACD (12,26,9)
   int macdHandle = iMACD(_Symbol, _Period, 12, 26, 9, PRICE_CLOSE);
   if(macdHandle == INVALID_HANDLE) return false;
   double macdSignal[];
   if(CopyBuffer(macdHandle, 0, 0, WindowSize, macd) != WindowSize) return false;
   if(CopyBuffer(macdHandle, 1, 0, WindowSize, macdSignal) != WindowSize) return false;

   // Calculate MACD difference (histogram)
   for(int i = 0; i < WindowSize; i++)
      macd[i] = macd[i] - macdSignal[i];

   IndicatorRelease(macdHandle);

   //--- SMA20
   int sma20Handle = iMA(_Symbol, _Period, 20, 0, MODE_SMA, PRICE_CLOSE);
   if(sma20Handle == INVALID_HANDLE) return false;
   if(CopyBuffer(sma20Handle, 0, 0, WindowSize, sma20) != WindowSize) return false;
   IndicatorRelease(sma20Handle);

   //--- SMA50
   int sma50Handle = iMA(_Symbol, _Period, 50, 0, MODE_SMA, PRICE_CLOSE);
   if(sma50Handle == INVALID_HANDLE) return false;
   if(CopyBuffer(sma50Handle, 0, 0, WindowSize, sma50) != WindowSize) return false;
   IndicatorRelease(sma50Handle);

   return true;
}
//+------------------------------------------------------------------+
//| Run model inference                                              |
//+------------------------------------------------------------------+
bool RunInference(const double &inputData[], double &outputData[])
{
   //--- Run model directly without setting shape (for dynamic axes)
   if(!OnnxRun(onnxHandle, ONNX_DEBUG_LOGS, inputData, outputData))
   {
      Print("Model inference failed: ", GetLastError());
      return false;
   }
   return true;
}
//+------------------------------------------------------------------+
//| Interpret model results                                          |
//+------------------------------------------------------------------+
void InterpretResults(const double &outputData[])
{
   //--- Find best action
   int bestAction = ArrayMaximum(outputData);
   string actionText = "";

   switch(bestAction)
   {
      case 0: actionText = "HOLD"; break;
      case 1: actionText = "BUY"; break;
      case 2: actionText = "SELL"; break;
   }

   //--- Print results
   Print("Model Output: [HOLD: ", outputData[0], ", BUY: ", outputData[1], ", SELL: ", outputData[2], "]");
   Print("Recommended Action: ", actionText);
}
Este script de MQL5, ONNX_DQN_Trading_Script.mq5, está diseñado para ejecutar un modelo Dueling DQN entrenado y exportado en formato ONNX con el fin de generar señales de trading en MetaTrader 5. En primer lugar, se carga el modelo ONNX desde el directorio «Files» y se preparan los datos de entrada basándose en una ventana de observación fija. Recopila datos recientes sobre precios y calcula varios indicadores técnicos —RSI, histograma MACD, SMA20 y SMA50— y los devuelve antes de normalizarlos en función de valores predefinidos de media y desviación estándar. Estas características procesadas se reorganizan en una matriz unidimensional para que se ajusten al formato de entrada previsto por el modelo.
Una vez que el vector de entrada está listo, el script realiza la inferencia mediante OnnxRun y devuelve tres valores de salida que representan los valores Q previstos para las acciones: MANTENER, COMPRAR y VENDER. La acción con el valor más alto se interpreta como la recomendación del modelo, que a continuación se muestra en el terminal. El paso de inferencia se realiza dentro de un proceso de comprobación de errores para garantizar su solidez, y los identificadores se liberan una vez finalizadas las operaciones para liberar recursos del sistema.
Conclusión
En resumen, desarrollamos un modelo de aprendizaje adaptativo y de negociación flexible utilizando una arquitectura Dueling DQN entrenada con datos históricos del XAUUSD. El modelo procesa una ventana deslizante de características técnicas que incluyen RSI, histograma MACD, SMA20, SMA50 y porcentajes de retorno normalizados en función de parámetros estadísticos. El progreso del entrenamiento se visualizó mediante recompensas acumulativas para garantizar la estabilidad del aprendizaje. Una vez entrenado, el modelo se exportó al formato ONNX para su integración en MetaTrader 5, donde un script MQL5 específico carga el modelo, prepara los datos de entrada de forma dinámica, ejecuta la inferencia e interpreta la acción recomendada por el modelo (MANTENER, COMPRAR o VENDER) en función del valor Q de salida más alto.
En conclusión, este sistema integral ofrece a los traders un sistema de apoyo a la toma de decisiones potente y automatizado, que combina el aprendizaje por refuerzo profundo con datos de mercado en tiempo real. La flexibilidad del sistema permite una fácil adaptación a nuevos símbolos o configuraciones de indicadores mediante el ajuste de las características de entrada y el reentrenamiento. Al integrar la inferencia de ONNX directamente en MQL5, los traders pueden desplegar modelos inteligentes de forma nativa en sus plataformas, mejorando tanto la ejecución de la estrategia como la capacidad de respuesta del mercado sin necesidad de depender de software externo.
| Nombre del archivo | Descripción |
|---|---|
| Ada_flex.mq5 | Archivo que contiene el script MQL5 que actúa como puente entre un modelo de aprendizaje por refuerzo entrenado en Python. |
| Ada_L.ipynb | Archivo que contiene el cuaderno para entrenar el modelo y guardarlo. |
| XAUUSD_H1.csv | Archivo que contiene datos históricos del precio del XAUUSD. |
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/18761
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Utilizando redes neuronales en MetaTrader
 Del básico al intermedio: Recursos
 Particularidades del trabajo con números del tipo double en MQL4
 Red neuronal en la práctica: Gradiente

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso