

Arbitragem estatística com ações cointegradas (Parte 1): testes de cointegração de Engle-Granger e Johansen
 17
 2

Introdução
Este é o primeiro de dois artigos que mostram como utilizar a cointegração em estratégias de arbitragem estatística. Muitas pessoas acreditam, equivocadamente, que essas estratégias são fórmulas "mágicas" livres de risco ou algo praticamente inacessível ao trader de varejo comum. Essa percepção equivocada é alimentada pelas histórias sobre os resultados extraordinários alcançados pelos grandes participantes do mercado, pela busca incessante do "Santo Graal" por traders iniciantes e, em última análise, pela falta de compreensão do que realmente é a arbitragem estatística.
Quando bem desenvolvidas e acompanhadas de uma infraestrutura adequada para a execução de ordens, essas estratégias podem apresentar baixo risco e rentabilidade consistente no longo prazo. No entanto, como qualquer outra atividade de negociação no mercado, também exigem uma gestão de risco adequada. Vale reforçar: estratégias de arbitragem estatística não são fórmulas mágicas isentas de risco.
No artigo anterior, analisamos uma estratégia simples de trading de pares baseada em correlação, que apresentou bons resultados no backtest, mas fracassou completamente após duas semanas de operação em tempo real em uma conta demo. Esse provavelmente é um dos exemplos mais claros e clássicos de que os backtests, embora úteis para avaliar a viabilidade de uma estratégia, podem dizer muito pouco sobre seu desempenho nas condições reais de mercado. Além disso, o resultado demonstra claramente que a arbitragem estatística não está livre de riscos. Mesmo uma estratégia promissora exige uma gestão de risco rigorosa (que não implementamos em nosso protótipo) e um ambiente adequado para a execução de ordens, questões que estão no cerne deste artigo.
Por que os resultados na conta demo foram tão ruins em comparação com o backtest? Como podemos aprimorar nossas ferramentas e ir além do coeficiente de correlação, que apenas indica como dois ativos se movimentam em conjunto, para estabelecer uma base mais confiável de identificação de relações de longo prazo entre três ou mais ativos? E como podemos ir além do trading de pares simples e ampliar nossa carteira para incluir um grupo de ações do mesmo setor?
Sucesso no backtest, fracasso na prática
Recentemente, eu e meu parceiro participamos de uma conversa informal com uma trader acostumada a operar contratos de dólar na bolsa brasileira B3. Ela comentou que gostaria de ter os recursos necessários para experimentar "alguma estratégia de arbitragem estatística com commodities agrícolas". No entanto, como era uma trader discricionária tradicional, com formação em análise técnica e Price Action, mas sem conhecimentos aprofundados de matemática ou estatística, estava convencida de que a arbitragem estatística seria algo "fora do seu alcance". Suas palavras refletiam exatamente a crença generalizada que mencionamos no início: a ideia de que a arbitragem estatística é inacessível ao trader de varejo.
Para ir direto ao ponto, transformamos essa ideia em um desafio entre amigos: e se aproveitássemos nosso tempo livre para desenvolver um sistema automatizado de arbitragem estatística como exercício de aprendizado? Mas como fazer isso se nenhum de nós é um grande especialista em estatística ou matemática, nem dispõe do poder computacional necessário para competir com os grandes participantes do mercado? Fizemos o que qualquer pessoa em fase de aprendizado faria: começamos a pesquisar o assunto em fontes acadêmicas para entender o problema, examinamos as alternativas disponíveis no mercado e analisamos tanto os casos de sucesso quanto os fracassos.
Nossos primeiros passos nessa jornada foram dados com um artigo que publiquei recentemente aqui sobre o matemático e gestor de hedge fund Jim Simons e seu lendário fundo Medallion. Naquele artigo, utilizamos um EA bastante simples para ilustrar a arbitragem estatística entre XAUEUR e XAUUSD.
O gráfico abaixo apresenta os resultados do nosso backtest, publicados anteriormente.
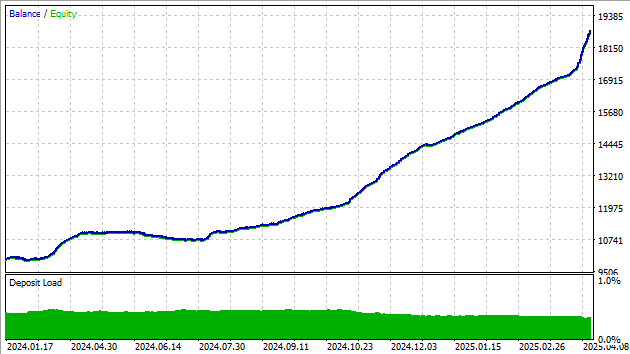
Figura 1. Resultados do backtest do EA de trading de pares (artigo anterior)
Em seguida, para verificar se o EA seria viável em condições reais, deixamos essa versão bastante simples operando durante duas semanas em uma conta demo com spread zero e comissão. Os resultados foram catastróficos.
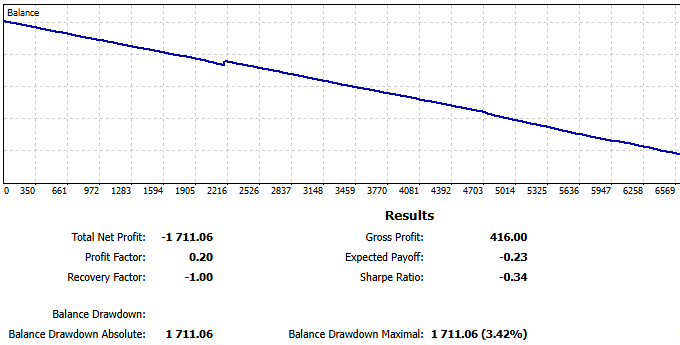
Figura 2. Histórico de operações (ReportHistory) do EA de trading de pares durante duas semanas na conta demo
Causas prováveis
Quando tentamos descobrir por que uma estratégia de trading fracassou, é tentador começar pelo "ajuste forçado dos parâmetros". Mas vamos adotar uma abordagem mais sistemática e investigar as causas fundamentais do problema.
Foram apenas duas semanas ruins seguidas?
Será que simplesmente enfrentamos duas semanas desfavoráveis no mercado? Afinal, mesmo no backtest tivemos períodos sem lucro nem prejuízo e até pequenos drawdowns, não é?
Sim, mas nem mesmo nas nossas piores semanas registramos tantas perdas consecutivas. Nesse teste em tempo real, nossa maior sequência de operações vencedoras foi de apenas quatro, enquanto a maior sequência de perdas chegou a quarenta e duas! A média de operações vencedoras consecutivas foi de apenas uma, enquanto a média de perdas consecutivas chegou a cinco. Em resumo, estávamos perdendo em praticamente todas as operações!
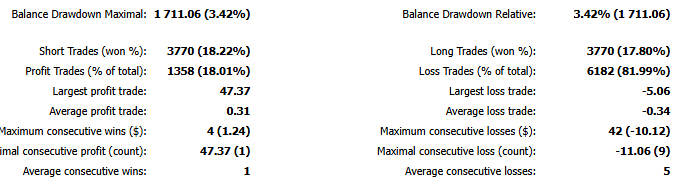
Figura 3. Sequência de perdas do EA de trading de pares na conta demo
Estava claro que havia algo fundamentalmente errado. As condições eram muito diferentes daquelas observadas no nosso backtest. Além disso, por definição, o trading de pares é uma estratégia neutra em relação ao mercado, ou seja, seu retorno não depende dos retornos de valores mobiliários específicos.(O trading de pares, como a forma mais simples de arbitragem estatística, costuma ser neutro em relação ao mercado. No entanto, nossos estudos acadêmicos mostram que, em um contexto mais amplo, nem sempre essa neutralidade se mantém. Dependendo do método de hedge adotado, a arbitragem estatística pode apresentar exposição a riscos de mercado ou setoriais. Abordaremos essa questão ao desenvolver o módulo de gestão de risco e de capital do nosso sistema. Por enquanto, podemos considerar nossa estratégia simples de trading de pares neutra em relação ao mercado.)
Jim Simons ganhou enormes quantias de dinheiro enquanto os mercados despencavam durante a crise do subprime de 2008. O fundo Medallion não era o único hedge fund que recorria à arbitragem estatística. Então, por que eles ganhavam milhões enquanto outros gestores do setor eram "massacrados" pela crise? Ao que tudo indica, havia algo que faziam melhor do que os demais. Apesar do sigilo rigoroso em torno de suas operações, deixaram algumas pistas valiosas que hoje parecem óbvias, mas que os traders de varejo frequentemente ignoram. A equipe do Medallion sempre se apoiou em volumes enormes de dados de alta qualidade. Também investiu em capacidade computacional de ponta e em roteamento de ordens de alta velocidade.
Portanto, uma semana ruim provavelmente não explica o fracasso. Embora a arbitragem estatística seja neutra em relação ao mercado, ela também é extremamente sensível à qualidade dos dados e ao momento de execução das ordens.
Mudança no ambiente de negociação?
Será que o problema foi a troca de corretora e a diferença nos spreads? Em estratégias de trading de pares de curto prazo, com milhares de entradas por semana, o spread bid/ask pode facilmente se tornar um problema. Como você sabe, as corretoras de Forex normalmente são remuneradas pelo spread e/ou por comissões calculadas com base no volume negociado.
Mas podemos descartar o spread. No backtest, utilizei deliberadamente uma conta com spreads elevados, de aproximadamente 170 pips para o ouro e 50 pips para o XAUEUR, em média. Para o teste na conta demo, passei a utilizar uma conta com spread bruto (raw spread) e cobrança de comissão, na qual os spreads médios eram de aproximadamente 20 pips para o XAUUSD e 10 pips para o XAUEUR.
Como o spread era menor na conta demo, dificilmente poderia ser o responsável pelo fracasso.
Slippage?
A arbitragem costuma ser sensível ao momento de execução das operações, e nossa estratégia de trading de pares não é exceção. Vejamos o que diz a política de execução de ordens da nossa corretora de CFDs sobre o tempo de execução das ordens:
Por fim, chegamos ao "suspeito de sempre": o slippage. Enviávamos ordens de execução imediata a preço de mercado, mas alguém conseguia fechar essa diferença de preços antes de nós. Se esse era o problema, não havia nada de errado nisso. Esse tipo de "front-running" é legal. Na prática, faz parte das regras do jogo da arbitragem. Significa apenas que alguém dispõe de mais recursos e/ou de recursos melhores: hardware mais potente, servidores instalados em um data center próximo à corretora (colocation) ou simplesmente software otimizado para alto desempenho, enquanto nós utilizávamos um protótipo. Provavelmente estávamos perdendo essa corrida para vários participantes ao mesmo tempo, cada um com alguma dessas vantagens e alguns com todas elas. Em outras palavras, os grandes participantes do mercado estavam simplesmente dando uma surra no nosso modesto protótipo.
O manual do usuário do MetaTrader 5 informa que é possível simular atrasos nos backtests:
"O Testador de Estratégias permite simular atrasos de rede durante a execução do EA, reproduzindo condições de teste próximas às reais. Para isso, é introduzido um intervalo de tempo entre o envio de uma solicitação de negociação e sua execução no testador. Durante esse intervalo, o preço pode mudar. Isso permite avaliar como a velocidade de processamento das operações afeta os resultados da estratégia.
No modo de execução instantânea, também é possível testar como o EA reage a uma requote enviada pelo servidor de negociação. Se a diferença entre o preço solicitado e o preço de execução ultrapassar o desvio permitido (deviation) especificado na ordem, o EA receberá uma requote."
Realizamos esse teste configurando um atraso aleatório...
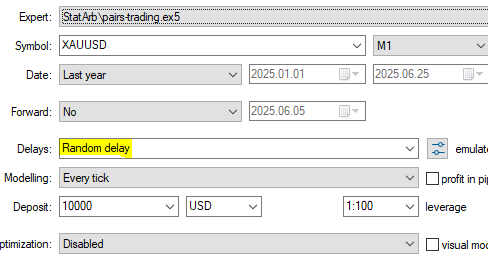
Figura 4. Configurações do Testador de Estratégias do MetaTrader 5 com simulação de atraso
... e BINGO! Mesmo que o slippage não seja o único responsável pelo fracasso, nosso "suspeito de sempre" parece ser o principal culpado.
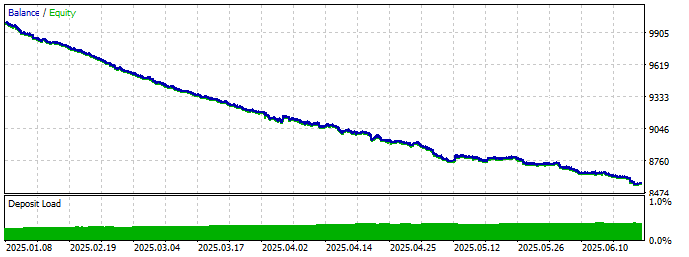
Figura 5. Gráfico de resultados após a execução do teste com simulação de atraso
Poderíamos tentar definir no código um desvio máximo permitido, mas essa restrição comprometeria completamente nossa estratégia. Para que ela seja lucrativa, precisamos conseguir operar ao preço certo praticamente de imediato. Além disso, a configuração do desvio máximo geralmente está disponível apenas em contas profissionais, o que já nos afastaria do nosso objetivo principal: desenvolver um sistema de arbitragem estatística acessível ao trader de varejo comum.
O principal problema: a execução
A arbitragem permite obter lucro comprando e vendendo praticamente qualquer coisa: de torradeiras a tokens, de commodities a moedas e praticamente qualquer outra coisa. Podemos imaginar que essa prática surgiu quando as pessoas começaram a trocar mercadorias, muito antes da existência do dinheiro como o conhecemos hoje. O conceito é simples: se uma hipotética torradeira estiver subvalorizada no mercado A, talvez possamos comprá-la ali e vendê-la no mercado B, onde é negociada pelo "preço justo". Se a diferença de preços for suficiente para cobrir os custos de transação, podemos obter lucro com risco mínimo.
O problema é que a possibilidade de lucrar com risco mínimo atrai muita gente. Quanto maior a relação retorno/risco, mais pessoas querem aproveitar a oportunidade. Quando falamos de arbitragem nos mercados financeiros, envolvendo commodities e moedas, os lucros podem ser enormes, assim como o número de participantes tentando comprar um ativo subvalorizado. Cada um faz o possível para enviar sua ordem antes dos concorrentes. A necessidade de ser o primeiro a apresentar uma cotação e ter sua ordem executada acabou impulsionando o desenvolvimento da infraestrutura, dos métodos e das práticas de negociação de alta frequência (HFT). Como você provavelmente sabe, operar com HFT não é nada simples e muito menos barato.
O principal problema é que o trader de varejo comum não dispõe dos recursos necessários para superar os grandes participantes do mercado em velocidade. Mesmo deixando de lado a falta de uma equipe altamente qualificada de estatísticos e matemáticos, apoiada por uma enorme capacidade computacional para desenvolver modelos, ainda precisaríamos, no mínimo, de serviços de colocation (instalação de um servidor no data center da corretora), código de alto desempenho e uma corretora capaz de enviar e rotear ordens em poucos milissegundos...
Os resultados do backtest demonstraram a viabilidade teórica da estratégia em condições ideais de execução de ordens. Ou seja, nossas ordens eram executadas praticamente de imediato, sem atrasos de rede nem erros no servidor da corretora.
É fácil perceber que essa infraestrutura não está ao alcance do trader de varejo comum. Como pequenos investidores individuais, se quisermos aproveitar oportunidades de arbitragem nos mercados financeiros, precisamos encontrar alternativas ao nosso protótipo rudimentar de trading de pares. Precisamos investigar e identificar padrões e anomalias que não dependam tanto da velocidade de execução.
Da correlação à cointegração
Anteriormente, apresentamos o mercado financeiro como Jim Simons o descrevia: um enigma em constante transformação. Um enigma que exige dos participantes do mercado uma adaptação contínua para maximizar os lucros e minimizar as perdas. Construímos uma "carteira" mínima com dois ativos, XAUUSD e XAUEUR, e escolhemos como relação estatística de interesse o desvio em relação à média das cotações dos dois ativos, tomando o dólar americano como referência. O alargamento do spread e seu posterior retorno à média serviam, respectivamente, como sinais de entrada e saída.
Até aqui, nossa "carteira" de arbitragem estatística ainda é bastante limitada, assim como as relações estatísticas que analisamos. Além disso, como não temos controle sobre a velocidade de execução, tentar otimizá-la agora seria prematuro. Primeiro, precisamos aprimorar nossa capacidade de análise, em vez de dedicar tempo a algo que está fora do nosso alcance. Precisamos ampliar a carteira. Nossas ferramentas de varredura precisam identificar mais relações estatísticas e incorporar mais indicadores capazes de gerar sinais de negociação.
O critério que utilizamos para selecionar esses pares foi a correlação. Limitamos nossa busca aos principais pares de moedas e escolhemos o par com maior correlação no intervalo de tempo analisado. Agora, vamos incorporar a cointegração à seleção dos ativos da nossa carteira.
Segundo os estatísticos:
"A correlação capta apenas relações de curto prazo, enquanto a cointegração identifica relações de equilíbrio de longo prazo. Duas variáveis podem apresentar forte correlação sem serem cointegradas, e vice-versa." [Alexander, 2001]
O coeficiente de correlação indica até que ponto os preços de XAUUSD e XAUEUR tendem a se movimentar simultaneamente na mesma direção. Já o teste de cointegração identifica uma relação de equilíbrio entre os ativos que se mantém no longo prazo. Além disso, enquanto o coeficiente de correlação analisa apenas dois ativos por vez, os testes de cointegração não estão necessariamente sujeitos a essa limitação. Isso significa que podemos avaliar simultaneamente vários ativos candidatos à nossa carteira, tornando esses testes ideais para nossos objetivos.
Como traders ou desenvolvedores de EAs, não precisamos dominar toda a matemática por trás dos testes de cointegração. Como utilizaremos a integração do Python com o MetaTrader 5 para analisar os dados e selecionar os ativos da carteira, podemos recorrer a funções prontas de bibliotecas especializadas. Além disso, assistentes de IA (incluindo os GPTs integrados ao MetaTrader 5) podem nos ajudar a economizar tempo no desenvolvimento de scripts simples para essas tarefas.
Como traders, precisamos entender o que significa cointegração e como utilizá-la para identificar oportunidades, especialmente no mercado de ações, onde ela é reconhecidamente mais útil e eficaz do que no mercado cambial. Como desenvolvedores de EAs, precisamos saber utilizar as melhores bibliotecas disponíveis e interpretar seus resultados para realizar ciclos sucessivos de ajustes e aprimorar nosso sistema. Ao recorrer a bibliotecas de alta qualidade, e o ecossistema Python supera os demais na oferta de bibliotecas de matemática, estatística e aprendizado de máquina, economizamos tempo, evitamos erros e possivelmente obtemos um desempenho melhor.
Se quiser se aprofundar no assunto, recomendo consultar o livro de Carol Alexander citado anteriormente, especialmente o capítulo 12, inteiramente dedicado à cointegração. Nesse livro, a autora aborda desde a história do uso da cointegração nas finanças até suas aplicações em diferentes mercados, incluindo Forex. Trata-se de uma obra de referência bastante conhecida nessa área.
Vamos ver como aplicar os dois testes de cointegração mais recomendados, o teste de Engle-Granger e o teste de Johansen, a diferentes classes de ativos e como interpretar seus resultados.
Teste de cointegração de Engle-Granger
O teste de Engle-Granger pode ser utilizado para avaliar o grau de cointegração entre dois ativos. Seu objetivo é responder à seguinte pergunta: "Esses dois ativos compartilham uma relação de equilíbrio de longo prazo?" Do ponto de vista de traders e desenvolvedores de EAs, esse teste permite identificar se o spread entre os dois ativos apresenta reversão à média. No entanto, a resposta não é simplesmente binária ("sim" ou "não"). Assim como o coeficiente de correlação de Pearson, que analisamos anteriormente, o teste fornece um valor relativo (p-value). Podemos comparar esse valor com os resultados de outros pares para identificar qual deles apresenta maior grau de cointegração.
O p-value representa a probabilidade de observarmos esses dados supondo que NÃO exista cointegração. Portanto, quanto menor o p-value, melhor. Existem alguns limiares de referência amplamente utilizados: um p-value inferior a 0,05 costuma ser interpretado como um sinal moderado de cointegração; inferior a 0,01, como um sinal forte; e superior a 0,05, como um sinal de ausência de cointegração. Como sempre acontece no trading, é importante ajustar cuidadosamente esses limiares às necessidades específicas da sua estratégia.
Para executar os dois testes de cointegração em Python, utilizamos a conhecida biblioteca statsmodels:
"Um módulo Python que oferece classes e funções para estimar diversos modelos estatísticos, realizar testes estatísticos e explorar dados estatísticos."
from datetime import datetime, timedelta
import MetaTrader5 as mt5
import pandas as pd
import numpy as np
from statsmodels.tsa.stattools import coint
import matplotlib.pyplot as plt

# connect to MetaTrader 5 terminal
if not mt5.initialize(login=********, server="MetaQuotes-Demo",password="********"):
    print("initialize() failed, error code =",mt5.last_error())
    quit()

# Forex majors - check your Market Watch names
symbols = ['EURUSD', 'GBPUSD', 'USDJPY', 'AUDUSD', 'USDCAD', 'NZDUSD', 'USDCHF']
Nosso objetivo é encontrar o par com maior grau de cointegração entre as principais moedas. Não esperamos encontrar um nível elevado de cointegração; o objetivo, por enquanto, é apenas ilustrar o funcionamento do teste de Engle-Granger.
# define the timeframe and the number of days
timeframe = mt5.TIMEFRAME_D1  # Daily
n_days = 600
utc_to = datetime.now()
utc_from = utc_to - timedelta(days=n_days)
Utilizaremos as variáveis utc_from e utc_to para solicitar cotações referentes a um período de 600 dias, conforme definido nos parâmetros do script. Como referência, um ano tem aproximadamente 250 dias de negociação.
# download historical data for each symbol
data = {}

for symbol in symbols:
    # Make sure the symbol is available in Market Watch
    mt5.symbol_select(symbol, True)

    # Get historical rates
    rates = mt5.copy_rates_range(symbol, timeframe, utc_from, utc_to)

    if rates is None or len(rates) == 0:
        print(f"No data for {symbol}.")
        continue

    df = pd.DataFrame(rates)
    df['time'] = pd.to_datetime(df['time'], unit='s')
    df.set_index('time', inplace=True)
    data[symbol] = df['close']
Nesse laço for, obtemos os preços de fechamento de cada símbolo, convertemos os dados em um DataFrame do Pandas e definimos o array time como índice da tabela.
Depois de concatenar os DataFrames e remover as linhas com valores ausentes, que poderiam distorcer os resultados, executamos o teste de cointegração.
# Store cointegration test results
results = []

# Test all unique pairwise combinations for cointegration
pairs = [(a, b) for i, a in enumerate(data.columns) for j, b in enumerate(data.columns) if i < j]

print("Cointegration test results (Engle-Granger):")
for a, b in pairs:
    score, pvalue, _ = coint(data[a], data[b])
    results.append((a, b, pvalue))
    print(f"{a} vs {b} | p-value: {pvalue:.4f}")
Index(['EURUSD', 'GBPUSD', 'USDJPY', 'AUDUSD', 'USDCAD', 'NZDUSD', 'USDCHF'], dtype='object')
Cointegration test results (Engle-Granger):

EURUSD vs GBPUSD | p-value: 0.3183
EURUSD vs USDJPY | p-value: 0.6990
EURUSD vs AUDUSD | p-value: 0.9308
EURUSD vs USDCAD | p-value: 0.9206
EURUSD vs NZDUSD | p-value: 0.9741
EURUSD vs USDCHF | p-value: 0.4342
GBPUSD vs USDJPY | p-value: 0.3273
GBPUSD vs AUDUSD | p-value: 0.7995
GBPUSD vs USDCAD | p-value: 0.6264
GBPUSD vs NZDUSD | p-value: 0.7810
GBPUSD vs USDCHF | p-value: 0.0238
USDJPY vs AUDUSD | p-value: 0.6299
USDJPY vs USDCAD | p-value: 0.5620
USDJPY vs NZDUSD | p-value: 0.6398
USDJPY vs USDCHF | p-value: 0.2377
AUDUSD vs USDCAD | p-value: 0.1260
AUDUSD vs NZDUSD | p-value: 0.2920
AUDUSD vs USDCHF | p-value: 0.5980
USDCAD vs NZDUSD | p-value: 0.0052
USDCAD vs USDCHF | p-value: 0.8574
NZDUSD vs USDCHF | p-value: 0.6384

Most cointegrated pair: USDCAD and NZDUSD (p = 0.0052)
Após identificar o par com maior grau de cointegração, podemos avaliar se vale a pena incluí-lo na nossa carteira de trading de pares. O gráfico abaixo mostra claramente que o spread reverte à média, mas a questão é: será que essa operação realmente compensa?
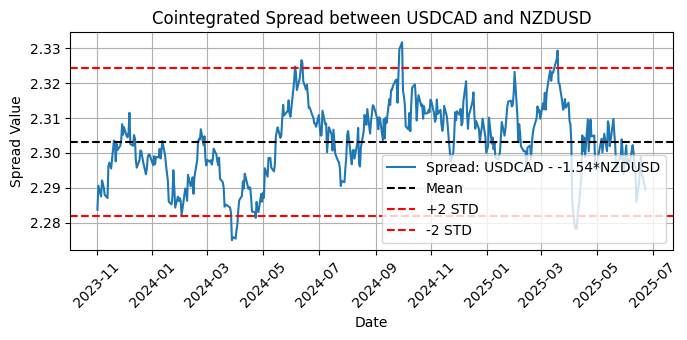
Figura 6. Gráfico do spread cointegrado entre USDCAD e NZDUSD com a média e dois desvios-padrão
A linha preta tracejada indica a média do spread, que representa seu nível de equilíbrio de longo prazo. As duas linhas vermelhas tracejadas marcam os limites de dois desvios-padrão. Esses limites estabelecem os limiares para identificar possíveis sinais de negociação quando o spread atinge níveis excepcionalmente altos ou baixos. Portanto, o número de desvios-padrão é um parâmetro importante a ser considerado na otimização da estratégia.
Coeficiente de hedge
Observe o valor -1,54 utilizado no cálculo do spread de longo prazo:
Spread = USDCAD - (-1.54) * NZDUSD
ou
USDCAD + 1.54 * NZDUSD
Esse valor é o coeficiente de hedge. Trata-se da proporção ideal, estimada estatisticamente por regressão linear, que pondera as cotações de USDCAD e NZDUSD para obter um spread estacionário, ou seja, oscile em torno de uma média constante. Esse é um elemento fundamental das estratégias de reversão à média. Ao utilizar esse coeficiente, colocamos os preços em uma escala comparável, levando em conta a volatilidade de cada ativo e a relação direcional entre eles.
O spread representa os desvios relativos entre os preços. Em termos de trading de pares, quando o spread ultrapassa +2 STD, ele está historicamente elevado, e podemos considerar a possibilidade de vender o spread. Por outro lado, quando cai abaixo de -2 STD, ele está historicamente baixo, e podemos considerar a possibilidade de comprá-lo.
Para montar um par neutro em relação ao mercado com base nesses dados, devemos vender simultaneamente 1,54 unidades de NZDUSD para cada unidade de volume de USDCAD que compramos (long), ou fazer o inverso, dependendo da direção do sinal. Quando o spread retorna à média, encerramos a operação fechando as duas posições.
Você pode utilizar esse mesmo código com símbolos de qualquer mercado ou classe de ativos. Para executá-lo sem outras modificações, basta substituir os nomes dos símbolos na parte superior do script.
Teste de cointegração de Johansen
O teste de cointegração de Johansen busca responder à mesma pergunta que o teste de Engle-Granger: esses ativos compartilham uma relação de equilíbrio de longo prazo? Na prática, para nossos objetivos, a principal diferença é que o teste de Johansen permite avaliar mais de dois ativos simultaneamente e determinar se esses N ativos podem formar um spread comum com reversão à média. Podemos utilizá-lo como uma ferramenta poderosa para investigar possíveis relações de cointegração entre ações de um mesmo setor, como empresas de petróleo e gás, gigantes da tecnologia e assim por diante. Isso nos permite identificar grupos de três, quatro ou mais ações (ou quaisquer outros ativos) que compartilham uma relação de equilíbrio de longo prazo.
O teste verifica se existem combinações de variáveis que sejam estacionárias (com reversão à média), mesmo quando as séries temporais originais não apresentam essa propriedade. Ele determina quantas relações de cointegração independentes existem entre as variáveis. Esse número é chamado de posto de cointegração (cointegration rank).
O teste fornece duas medidas estatísticas principais: a estatística do traço (Trace Statistic) e o valor crítico.
Para cada posto possível (0, 1, 2, ..., N-1, em que N é o número de séries), obtemos um valor da estatística do traço. Quanto maior esse valor, mais fortes são as evidências de cointegração. O valor crítico é o limiar com o qual comparamos a estatística do traço. Ele depende de:
- Número de variáveis avaliadas;
- Tamanho da amostra;
- Nível de confiança (90%, 95% ou 99%).
Neste caso específico, o número de variáveis corresponde à quantidade de instrumentos financeiros (símbolos) incluídos no teste.
# Johansen Test
from datetime import datetime, timedelta
import MetaTrader5 as mt5
import pandas as pd
import numpy as np
from statsmodels.tsa.stattools import coint
from statsmodels.tsa.vector_ar.vecm import coint_johansen
import matplotlib.pyplot as plt
# Create a matrix for the test
log_prices = data.apply(np.log)

johansen_result = coint_johansen(log_prices, det_order=0, k_ar_diff=1)

# Trace statistics and critical values
print("\nJohansen Test Results (Trace Statistic):")
for i, stat in enumerate(johansen_result.lr1):
    cv = johansen_result.cvt[i, 1]  # 5% critical value
    print(f"Rank {i}: Trace Stat = {stat:.2f} | 5% CV = {cv:.2f} | {'Significant' if stat > cv else 'Not significant'}")
Para consultar os resultados em outros níveis de confiança, basta utilizar os índices correspondentes:
johansen_result.cvt[i, 0] para 90%
johansen_result.cvt[i, 2] para 99%
Considerando um nível de confiança de 95% (nível de significância de 5%), apresentamos abaixo os resultados obtidos para os principais pares de moedas, utilizando o mesmo período e o mesmo timeframe (D1) adotados no teste de Engle-Granger.
Index(['EURUSD', 'GBPUSD', 'USDJPY', 'AUDUSD', 'USDCAD', 'NZDUSD', 'USDCHF'], dtype='object')

Johansen Test Results (Trace Statistic):

Rank 0: Trace Stat = 105.25 | 5% CV = 125.62 | Not significant
Rank 1: Trace Stat = 68.10 | 5% CV = 95.75 | Not significant
Rank 2: Trace Stat = 42.01 | 5% CV = 69.82 | Not significant
Rank 3: Trace Stat = 25.83 | 5% CV = 47.85 | Not significant
Rank 4: Trace Stat = 11.73 | 5% CV = 29.80 | Not significant
Rank 5: Trace Stat = 5.74 | 5% CV = 15.49 | Not significant
Rank 6: Trace Stat = 0.58 | 5% CV = 3.84 | Not significant
Como esperado, não encontramos cointegração estatisticamente significativa entre os sete principais pares de moedas.
No entanto, ao testar duas ações conhecidas, Google e Nvidia, no timeframe H1 (veja abaixo), obtemos um resultado de cointegração estatisticamente significativo para o mesmo período e nível de confiança.
Index(['NVDA', 'GOOGL'], dtype='object')
Number of observations: 5769
Number of variables: 2

Johansen Test Results (Trace Statistic):
Rank 0: Trace Stat = 18.71 | 5% CV = 15.49 | Significant
Rank 1: Trace Stat = 0.29 | 5% CV = 3.84 | Not significant

Most cointegrated pair (Engle-Granger): NVDA and GOOGL | p-value: 0.0824
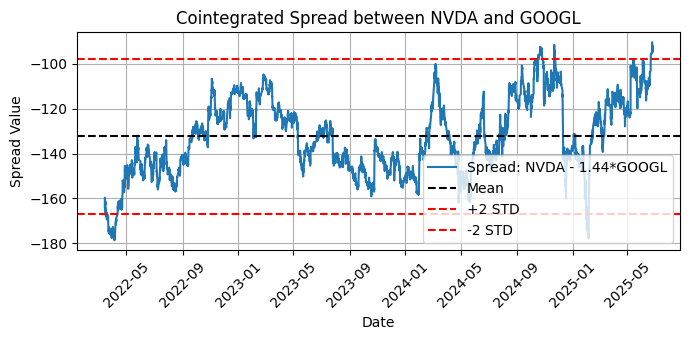
Figura 7. Gráfico do spread cointegrado entre NVDA e GOOGL com a média e dois desvios-padrão
Muito bem, segundo o teste de Johansen, existe cointegração significativa entre GOOGL e NVDA. Entretanto, o p-value do teste de Engle-Granger é superior a 0,05, indicando ausência de cointegração. Por que os resultados dos dois testes se contradizem? O que isso significa?
Vamos executar o mesmo script, apenas invertendo a ordem dos símbolos. Você perceberá uma diferença interessante entre os testes de Engle-Granger e Johansen.
Index(['GOOGL', 'NVDA'], dtype='object')
Number of observations: 5769
Number of variables: 2

Johansen Test Results (Trace Statistic):
Rank 0: Trace Stat = 18.71 | 5% CV = 15.49 | Significant
Rank 1: Trace Stat = 0.29 | 5% CV = 3.84 | Not significant

Most cointegrated pair (Engle-Granger): GOOGL and NVDA | p-value: 0.0403
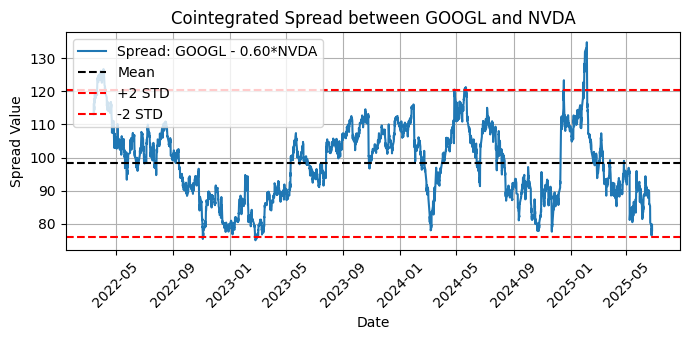
Figura 8. Gráfico do spread cointegrado entre GOOGL e NVDA com a média e dois desvios-padrão
Como você pode observar, o teste de Engle-Granger é sensível à ordem dos ativos, enquanto os resultados do teste de Johansen não foram afetados por essa inversão. Se você estudar o teste de Johansen mais a fundo, descobrirá que, em determinadas situações, ele também pode apresentar sensibilidade à ordem das variáveis, especialmente com amostras pequenas ou quando os resultados estão próximos do limiar de significância estatística. No entanto, em termos teóricos, o teste geralmente é invariante à ordem. Se você perceber resultados contraditórios após inverter a ordem dos ativos, a primeira medida a tomar é aumentar o tamanho da amostra. Foi justamente por isso que substituímos o timeframe D1 (diário) pelo H1 (horário): para fornecer mais dados ao teste.
Como o teste de Engle-Granger é sensível à ordem das variáveis, devemos sempre executá-lo nas duas ordens possíveis e complementar a avaliação com uma análise visual dos gráficos, para confirmar se o spread realmente apresenta reversão à média.
Teste de estacionariedade do spread
O spread é uma série temporal e, para confirmar que apresenta reversão à média, precisamos testar sua estacionariedade. Isso significa verificar se sua média, variância e covariância permanecem constantes ao longo do tempo. Quando uma série temporal é estacionária, torna-se muito mais fácil modelá-la e fazer previsões utilizando modelos como o ARIMA.
A mesma biblioteca Python que utilizamos nos testes de cointegração oferece funções prontas para testar a estacionariedade: o teste aumentado de Dickey-Fuller (ADF) e o teste de Kwiatkowski-Phillips-Schmidt-Shin (KPSS).
from statsmodels.tsa.stattools import adfuller

(...)

adf_result = adfuller(spread)
ADF Test on Spread:
ADF Statistic : -3.0946
p-value : 0.0270
Critical Values:
1%: -3.4315
5%: -2.8620
10%: -2.5670
O spread é estacionário (a hipótese nula é rejeitada).
from statsmodels.tsa.stattools import kpss

(...)

def run_kpss(series, regression='c'):
    statistic, p_value, lags, crit_values = kpss(series, regression=regression, nlags='auto')

(...)

# Run KPSS test on the residuals
run_kpss(spread, regression='c')  # 'c' = test for level stationarity (use 'ct' for trend)
KPSS Test on Spread:
KPSS Statistic : 2.2702
p-value : 0.0100
Lags Used : 44
Critical Values: 10% : 0.347
5% : 0.463
2.5% : 0.574
1% : 0.739
❌ O spread NÃO é estacionário (a hipótese nula de estacionariedade é rejeitada).
Parece que encontramos novamente resultados contraditórios. O teste ADF indica que o spread é estacionário, enquanto o KPSS aponta o contrário. Mas não há motivo para preocupação! Os desenvolvedores da biblioteca statsmodels oferecem uma explicação clara de como interpretar qualquer combinação de resultados desses dois testes. Vou reproduzir um trecho da documentação do statsmodels porque, na minha opinião, seria difícil explicar isso de maneira mais concisa e compreensível.
"Caso 1: Ambos os testes indicam que a série não é estacionária. A série não é estacionária.
Caso 2: Ambos os testes indicam que a série é estacionária. A série é estacionária.
Caso 3: O KPSS indica estacionariedade, mas o ADF não. A série é estacionária em torno de uma tendência. É necessário remover essa tendência para tornar a série estritamente estacionária. Após a remoção da tendência, a série deve ser novamente submetida a um teste de estacionariedade.
Caso 4: O KPSS indica ausência de estacionariedade, enquanto o ADF indica estacionariedade. A série é estacionária em diferenças. Para torná-la estacionária, é necessário aplicar a diferenciação. A série resultante dessa operação deve ser novamente submetida a um teste de estacionariedade."
Agora sabemos que nosso spread é estacionário em diferenças, mas não estritamente estacionário. O que isso significa? Significa que a série temporal pode apresentar deriva, mas suas variações permanecem estáveis. Podemos transformá-la em uma série temporal estritamente estacionária simplesmente calculando a diferença entre valores consecutivos. Não por acaso, essa técnica é chamada de diferenciação. Ela permite remover tendências e sazonalidade, tornando a série temporal mais adequada para análise e previsão.
Precisamos tornar nosso spread estritamente estacionário? Muitos modelos de séries temporais exigem dados estacionários, mas esse não é o nosso caso. Na abordagem de cointegração que vamos implementar, não utilizaremos modelos de previsão.
Na verdade, não faremos previsões. Ainda assim, vale a pena saber que a análise de cointegração não se limita aos próprios testes de cointegração.
Conclusão
Neste artigo, avançamos mais uma etapa na construção do nosso framework de arbitragem estatística, voltado para o trader de varejo comum. Acrescentamos duas ferramentas ao nosso conjunto de recursos estatísticos para a composição da carteira: os testes de cointegração de Engle-Granger e Johansen. Vimos o que esperar de cada um deles e como interpretar seus resultados em um nível básico. Também aprendemos a testar a estacionariedade do spread utilizando o teste aumentado de Dickey-Fuller (ADF) e o teste de Kwiatkowski-Phillips-Schmidt-Shin (KPSS).
Este foi o primeiro de dois artigos dedicados à apresentação das ferramentas fundamentais. No próximo artigo, complementaremos esta introdução com a implementação prática, os backtests e a otimização de uma estratégia envolvendo um par de símbolos cambiais cointegrados e um grupo de ações cointegradas do mesmo setor.
Arrisco dizer que o mais importante aqui não é a apresentação das ferramentas, das funções ou mesmo dos exemplos de código. O principal aprendizado é que, se você é um trader de varejo, que não é matemático, estatístico nem desenvolvedor profissional, sua habilidade mais valiosa ao desenvolver uma estratégia de arbitragem estatística é compreender o ativo ou grupo de ativos com que está trabalhando.
Seu conhecimento dos mercados é inestimável, pois todo o trabalho complexo de matemática e estatística já foi feito para você por especialistas altamente qualificados. Os resultados desse trabalho estão disponíveis gratuitamente em diversas bibliotecas de código aberto, incluindo as bibliotecas MQL5 da plataforma MetaTrader 5. Também podemos contar com a ajuda valiosa de assistentes de IA para implementar essas soluções corretamente.
A lição que fica é simples: se seus recursos são limitados, evite estratégias que dependam da velocidade de execução e procure maneiras criativas de analisar os dados, aproveitando seu conhecimento dos mercados.
Referências bibliográficas
- Alexander, C. (2001). Market Models: A Guide to Financial Data Analysis, Wiley.
- Engle, R. F., & Granger, C. W. J. (1987). Co-integration and error correction: representation, estimation, and testing. Econometrica.
- Gatev, E., Goetzmann, W. N., & Rouwenhorst, K. G. (2006). "Pairs Trading: Performance of a Relative-Value Arbitrage Rule." Review of Financial Studies.
- Johansen, S. (1988). Statistical analysis of cointegration vectors. Journal of Economic Dynamics and Control.
| Arquivo anexo | Descrição |
|---|---|
| coint.ipynb | Notebook Jupyter simplificado, com código Python para executar um único teste de cointegração de Engle-Granger em um par de instrumentos de negociação. |
| coint_googl_nvda.ipynb | Notebook Jupyter mais completo, com código para executar os testes de Engle-Granger e Johansen em um número teoricamente ilimitado de instrumentos, além de testar a estacionariedade do spread. |
| helper_quotes_to_db.ipynb | Arquivo auxiliar para salvar as cotações baixadas em um banco de dados SQLite3. Também é um notebook Jupyter com código Python. Seu objetivo é evitar downloads desnecessários e permitir trabalhar offline. |
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/18702
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.
 Automatização de estratégias de negociação em MQL5 (Parte 22): Desenvolvimento de um sistema de recuperação por zonas para negociação a favor da tendência com o indicador Envelopes
 Implementação em MQL5 de módulos úteis de outras linguagens (Parte 1): Criação de uma biblioteca SQLite3 semelhante à do Python
 Está chegando o novo MetaTrader 5 e MQL5
 Desenvolvimento de ferramentas para análise de Price Action (Parte 30): EA CCI Zero Line

- Aplicativos de negociação gratuitos
- 8 000+ sinais para cópia
- Notícias econômicas para análise dos mercados financeiros
Você concorda com a política do site e com os termos de uso
Artigo interessante! Já trabalhei em projetos semelhantes antes e também tive problemas na execução em ambiente de produção. :)
Mas o artigo está bem escrito. Quem está começando nesse assunto vai conseguir acompanhá-lo facilmente.