

MetaTrader 5 Global Optimizer: Clusterização
 19
 0

Introdução
A otimização de Expert Advisors não se resume a encontrar a combinação de parâmetros que produz o melhor resultado em um backtest. À medida que o espaço de busca cresce, torna-se igualmente importante avaliar se uma configuração representa um comportamento consistente ou apenas um ponto excepcional, sensível a pequenas alterações nos parâmetros ou ao período analisado. A série MetaTrader 5 Global Optimizer aborda esse problema construindo progressivamente um processo de otimização, seleção e validação de parâmetros.
Nesta terceira parte, o foco passa da avaliação de passes individuais para a análise da estrutura do espaço de parâmetros. A questão central é determinar se um resultado promissor pertence a uma região consistente, na qual combinações próximas apresentam comportamento semelhante, ou se corresponde apenas a um pico isolado da otimização. Para isso, o Global Optimizer passa a disponibilizar um modo de Walk-Forward baseado em clusterização, capaz de identificar regiões paramétricas, selecionar representantes reais dessas regiões e submetê-los posteriormente à validação out-of-sample.
Essa abordagem dá continuidade à infraestrutura desenvolvida nos artigos anteriores. MetaTrader 5 Global Optimizer: Uma Estrutura Profissional para Otimizar EAs por Grupos, Subgrupos e Critérios de Robustez, foi construída uma infraestrutura para organizar parâmetros em grupos e subgrupos, gerar arquivos .set e .ini, executar o Strategy Tester e comparar os resultados de forma automatizada. Em MetaTrader 5 Global Optimizer: Validação por Walk-Forward Efficiency, essa estrutura recebeu uma dimensão temporal: os parâmetros selecionados dentro de uma janela in-sample (ISS) passaram a ser congelados e testados no período out-of-sample seguinte. O novo modo cluster complementa esse processo sem substituir o Walk-Forward tradicional. O modo normal mantém a seleção baseada no score, enquanto o modo cluster acrescenta uma etapa regional dentro do ISS. Em vez de considerar somente o melhor passe, procura-se identificar grupos de combinações próximas, avaliar sua vizinhança e selecionar representantes de regiões mais consistentes antes da validação OOS. 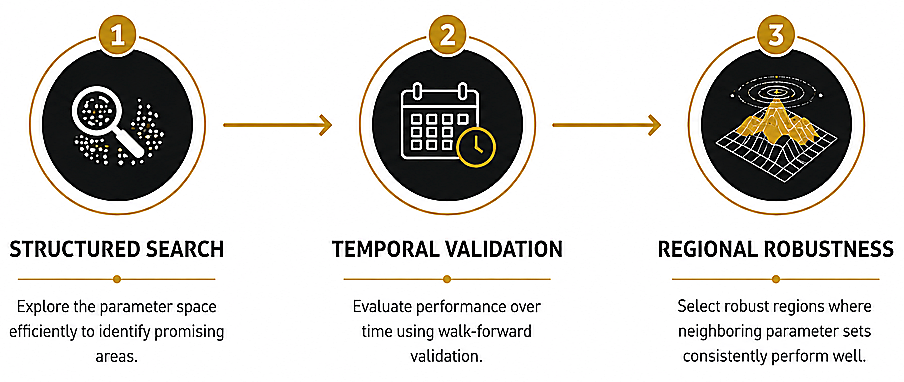
Figure 1 — Evolution of the MetaTrader 5 Global Optimizer: from structured parameter search to temporal validation and regional robustness.
Do melhor passe à região robusta
Cada passe de uma otimização representa um ponto no espaço de parâmetros. Quando poucas variáveis são avaliadas, essa estrutura ainda pode ser visualizada como uma superfície. À medida que mais parâmetros são adicionados, entretanto, os resultados passam a ocupar um espaço multidimensional.
A seleção tradicional normalmente ordena esses passes por lucro, Profit Factor, drawdown, número de operações ou alguma função personalizada de score. Essas métricas continuam sendo importantes, mas o melhor valor isolado não necessariamente representa uma configuração estável.
Um passe pode apresentar score elevado enquanto pequenas alterações em seus parâmetros produzem resultados muito inferiores. Nesse caso existe um pico isolado. Em outra situação, diferentes combinações próximas podem manter desempenho semelhante, formando uma região paramétrica com menor sensibilidade a pequenas alterações.
O modo cluster acrescenta justamente essa informação regional. Ele não substitui a função objetivo nem os filtros utilizados na otimização; procura avaliar a estrutura existente ao redor dos resultados promissores.
A diferença em relação ao WFE utilizado anteriormente pode ser resumida assim:
| Global Optimizer II | Global Optimizer III |
|---|---|
| Otimiza o ISS | Otimiza o ISS |
| Ordena resultados | Analisa a distribuição dos resultados |
| Seleciona candidato pelo score | Procura regiões paramétricas |
| Congela o candidato | Seleciona representante real da região |
| Executa OOS | Pode refinar a região dentro do próprio ISS |
| Consolida WFE | Congela candidatos e executa OOS |
| Foco no melhor resultado | Foco em região + vizinhança + desempenho |
Table 1 — Main differences
Os dois modos continuam coexistindo. O modo normal permanece útil quando a seleção direta é suficiente; o modo cluster acrescenta análise de vizinhança e estrutura regional quando as interações entre os parâmetros tornam a superfície mais difícil de interpretar.
Preparando parâmetros para o Cluster WFE
Nas versões anteriores, @wfe podia identificar um parâmetro individual e @wfe1, @wfe2 e @wfe3 permitiam formar pequenos grupos avaliados conjuntamente.
Nesta versão foi acrescentado @wfeall. A marcação reúne todos os parâmetros anotados dentro de um mesmo subgrupo em uma única busca WFE multidimensional.
Por exemplo:
// @group SIGNAL
// @subgroup SIGNAL_CLUSTER

// @wfeall
// @opt 80 5 110
input int RegimePeriod = 95;

// @wfeall
// @opt 20 5 50
input int RetracementPeriod = 35;

// @wfeall
// @opt 10 2 20
input int ATRPeriod = 14;

// @wfeall
// @opt 0.6 0.1 1.4
input double EntryDistanceATR = 1.0;
Os quatro parâmetros passam a representar coordenadas de um mesmo espaço de busca. Isso é especialmente útil quando há interação entre variáveis e analisar cada parâmetro de forma isolada deixa de representar adequadamente a estratégia.
Entretanto, @wfeall deve ser utilizado com critério. À medida que novas dimensões são adicionadas, cresce rapidamente a quantidade potencial de combinações. Na otimização genética, os clusters representam apenas os pontos efetivamente avaliados, e não uma confirmação de que todo o espaço possível foi percorrido. Além disso, uma boa análise regional continua dependendo de uma função objetivo e de métricas adequadas.
Antes de executar uma bateria longa, o parser pode verificar como as anotações foram interpretadas:
python mt5_global_optimizer_cluster.py --parse-mq5 "C:\...\MeuEA.mq5" O Wizard é utilizado para produzir a configuração da bateria:
python mt5_global_optimizer_cluster.py --wizard
Nele são definidos, entre outros itens, símbolo, modelo do Tester, períodos WFE, método de otimização e quantidade de repetições genéticas.
Observação: Agora é possível realizar simulação em ticks reais que antes não era possível nas versões anteriores.
Otimização completa lenta, genética e reprodutibilidade
A interpretação dos clusters depende da forma como os passes foram obtidos.
Na otimização completa lenta, todas as combinações da grade são executadas. Se existem 400 combinações, os 400 pontos são conhecidos, e repetir exatamente a mesma otimização normalmente não acrescenta informação sobre a cobertura.
Na otimização genética, o MetaTrader 5 procura regiões promissoras sem visitar necessariamente todo o espaço. Quanto maior a quantidade de dimensões e combinações possíveis, menor pode ser a proporção do espaço efetivamente observada.
Por isso, um cluster encontrado em uma otimização genética deve ser interpretado como uma estrutura existente dentro da amostra explorada pela busca. Aumentar o número de passes melhora a amostragem, mas não transforma automaticamente a otimização genética em uma busca exaustiva.
Para acrescentar informação sobre reprodutibilidade, o Global Optimizer pode executar a mesma janela genética mais de uma vez, removendo o cache correspondente antes de cada repetição para evitar a reutilização dos resultados da execução anterior. Essas repetições não são tratadas como amostras estatisticamente independentes. Seu objetivo é observar se novas execuções do processo de otimização genética voltam a explorar regiões semelhantes do espaço de parâmetros.
Os resultados são preservados em duas estruturas:
ISS_MERGED/
    ISS1/
    ISS2/
    ...

ISS_SEPARATE_RUNS/
    ISS1/
        RUN01/
        RUN02/
        ...
    ISS2/
        RUN01/
        RUN02/
        ...
ISS_MERGED contém a base consolidada e deduplicada utilizada para a descoberta das regiões globais. ISS_SEPARATE_RUNS mantém as execuções separadas e funciona como uma camada diagnóstica de reprodutibilidade.
As execuções repetitivas não competem para produzir diretamente candidatos OOS. Primeiro a região é descoberta na base consolidada; depois pode-se verificar quantas buscas repetitivas também produziram observações próximas a ela.
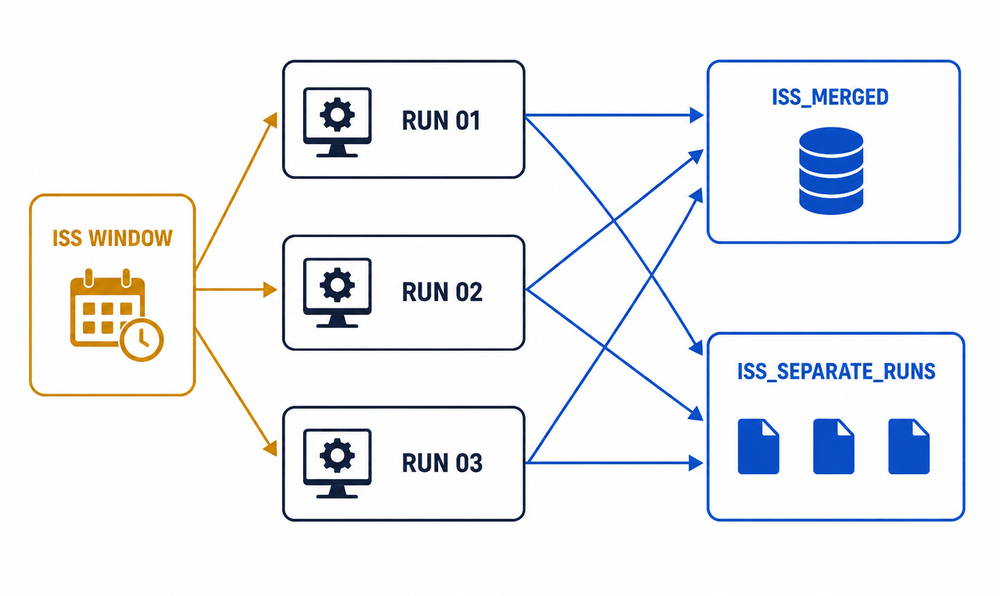
Figure 2 — Optimization Workflow
Análise externa e formação das regiões
O MetaTrader 5 Global Optimizer não depende de um clusterizador específico. Depois de concluir as janelas ISS, ele exporta os resultados em um único arquivo .zip, mantendo a ordem temporal das janelas e preservando tanto a base consolidada quanto as execuções separadas descritas anteriormente.
Qualquer ferramenta externa pode ser utilizada, desde que interprete os relatórios e devolva os candidatos na estrutura esperada pelo Global Optimizer.
Na otimização genética existem duas visões complementares. A primeira é a base consolidada, representada por ISS_MERGED, utilizada para descobrir as regiões globais e selecionar os candidatos. A segunda e ISS_SEPARATE_RUNS, na qual cada ISS preserva suas execuções RUN01, RUN02 e assim por diante. Essas execuções repetitivas não devem criar candidatos OOS diretamente; sua função é diagnosticar se buscas genéticas distintas conseguem reencontrar regiões semelhantes.ISS_MERGED/ ISS1/... ISS2/... ISS_SEPARATE_RUNS/ ISS1/RUN01 ... RUN10 ISS2/RUN01 ... RUN10
Como o OCA representa os parâmetros e forma os agrupamentos
Neste artigo será utilizado como exemplo o Optimization Cluster Analyzer — OCA.
No OCA, os parâmetros são separados das métricas de desempenho. Parâmetros numéricos formam dimensões normalizadas e parâmetros discretos, como bool e enum, são tratados como categorias. Para espaços mistos, a distância de Gower permite combinar diferenças numéricas e categóricas na mesma geometria.
A política de análise depende da origem dos dados:
| Origem | Análise principal | Complemento |
|---|---|---|
| Genética | K-Medoids + Gower | HDBSCAN ou hierárquico quando há evidência suficiente |
| Completa | Quality Plateau | Vizinhança pelos passos reais do grid |
| Dados insuficientes | Nenhuma região promovida | Nenhum candidato exportado |
Table 2 — Adaptive regional-analysis policy.
A concentração de passes na otimização genética não é interpretada diretamente como densidade do espaço paramétrico, pois também depende do mecanismo de busca do algoritmo. As regiões representam estruturas encontradas apenas entre os passes observados.
O K-Medoids possui uma vantagem importante nesse fluxo: seu representante é um passe realmente executado, e não um centro artificial. Isso permite transformá-lo diretamente em um arquivo .set.
A formação de um cluster, entretanto, não significa aprovação automática. A região ainda é avaliada por quantidade de evidência, qualidade, dispersão, suporte de vizinhança e posição do representante em relação às bordas. Se o suporte for insuficiente, nenhum candidato é exportado.
Quando a região possui estrutura adequada, o representante é escolhido entre os passes observados considerando desempenho, centralidade regional e suporte local. Assim, um pico isolado pode ser preterido em favor de um passe ligeiramente inferior, mas localizado em uma região com maior suporte dentro da amostra observada.
O OCA pode importar relatórios individuais ou conjuntos de arquivos, reconhecendo formatos utilizados nas exportações do MetaTrader 5, como XML SpreadsheetML, CSV/TXT, HTML, XLS/XLSX e pacotes ZIP. Assim, ele também pode receber diretamente o pacote organizado em janelas produzido pelo Global Optimizer.
Caso haja interesse foi deixado em anexo um arquivo PDF mostrando como são feitos os agrupamentos, métodos e limitações do OCA.
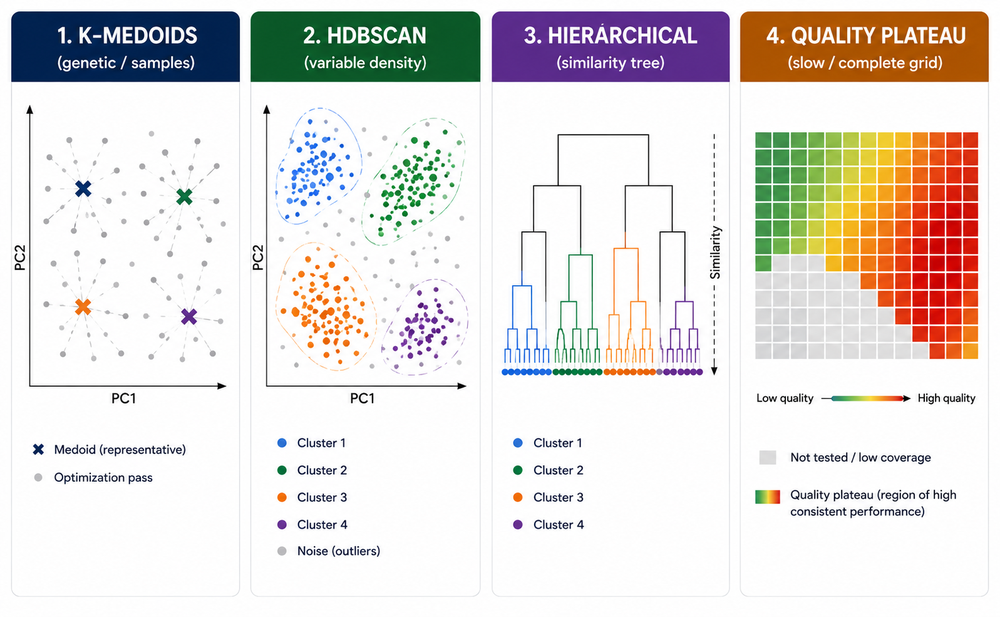
Figure 3 — Clustering methods used in OCA
Sets, vizinhanças e exportação de arquivos
Depois de formar as regiões, o OCA ainda verifica a vizinhança local dos passes. São considerados fatores como vizinhos recíprocos, raio adaptativo, proporção de vizinhos pertencentes à mesma região, qualidade local, dispersão e posição do ponto em relação às bordas do agrupamento. Isso é importante porque um passe com excelente score, mas isolado dos demais, não possui a mesma evidência regional de outro passe cercado por diversas configurações semelhantes.
Somente depois dessa validação é escolhido o representante de cada região aprovada. O representante final continua sendo um passe real, e sua escolha combina a qualidade observada, o suporte da vizinhança e sua proximidade ao centro da região. Assim, o melhor resultado absoluto não é necessariamente escolhido: um ponto um pouco inferior em desempenho, mas localizado no interior de uma região consistente, pode ser considerado mais representativo do que um pico situado na borda ou praticamente isolado.
Nas otimizações genéticas com múltiplas repetições, existe ainda uma etapa separada de reprodutibilidade. A região global é determinada pela base consolidada, enquanto os relatórios das execuções repetidas são comparados posteriormente com essas regiões. O objetivo é verificar quantas buscas repetidas voltaram a encontrar configurações próximas aos representantes globais. Essa evidência é diagnóstica e não é utilizada para criar artificialmente novos candidatos.
Quando utilizado com o adaptador do Global Optimizer, o resultado volta a ser reunido em um único arquivo .zip, preservando a ordem das janelas:
MetaTrader 5 Optimizer.zip
│
├── OOS1
│   ├── Cluster01_fixed.set
│   └── Cluster01_refine.set
│
├── OOS2
│
├── OOS3
│   ├── Cluster02_fixed.set
│   └── Cluster02_refine.set
│
├── README.txt
└── OOS_MANIFEST.csv
Cada pasta OOSn corresponde ao relatório ISS analisado na mesma posição. Os arquivos *_fixed.set contêm representantes congelados que podem seguir para a validação OOS, enquanto *_refine.set descreve um pequeno grid local que ainda precisa ser avaliado no ISS de origem antes de produzir um novo candidato congelado. Quando nenhuma região é aprovada, a pasta OOS correspondente permanece explicitamente vazia. As execuções genéticas repetidas são utilizadas apenas para diagnóstico de reprodutibilidade e não são exportadas como candidatos OOS.
É importante destacar novamente que o OCA é apenas o analisador utilizado neste artigo. O Global Optimizer continua independente da técnica empregada externamente. Outro clusterizador pode utilizar regras, algoritmos ou critérios diferentes, desde que preserve a relação entre as janelas e devolva os candidatos na estrutura esperada.
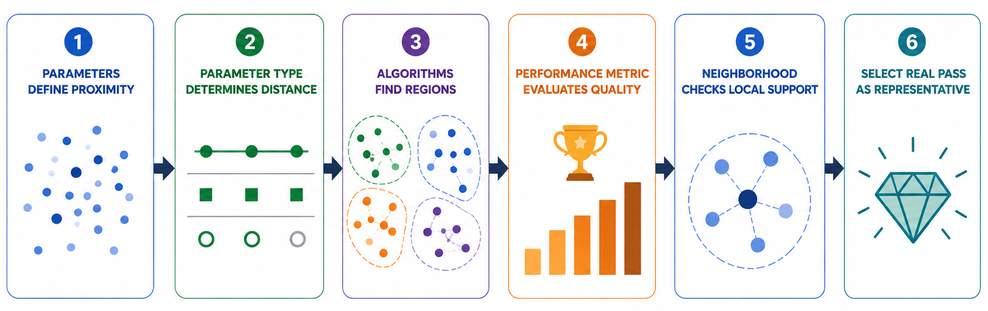
Figure 4 — Process OCA
Dos ISS aos candidatos para validação OOS
Depois que todas as janelas ISS terminam, o Global Optimizer deixa de gerar novas amostras e passa a aguardar a definição dos conjuntos que seguirão para a validação futura. Após a análise dos resultados ISS e a escolha dos representantes das regiões, o programa aguarda um arquivo .zip organizado por janela, preservando a correspondência entre cada ISSn e seu respectivo OOSn.
Dentro de cada pasta OOSn podem existir arquivos *_fixed.set, que representam candidatos já selecionados e congelados e podem seguir diretamente para o OOS, e arquivos *_refine.set, que contêm um pequeno grid local e precisam ser novamente avaliados no mesmo ISS de origem antes de gerar um novo candidato congelado. Se o refinamento atender aos critérios definidos, o novo ponto é aprovado e pode avançar para o OOS; caso contrário, é descartado.
Todas as pastas esperadas devem existir no pacote, mesmo quando estiverem vazias. Uma pasta OOSn sem arquivos indica apenas que nenhuma nova região foi aprovada naquela janela. Se a política de continuidade estiver habilitada e já existir uma família congelada anterior, ela pode ser mantida no OOS seguinte. Caso ainda não exista uma família válida, ou a continuidade esteja desabilitada, aquela janela permanece sem candidato.
Para tornar o processo reproduzível, será apresentado um exemplo de pacote exportado e um exemplo da estrutura esperada para importação no Global Optimizer. Dessa forma, fica claro como as pastas OOSn e os arquivos *_fixed.set e *_refine.set devem ser organizados para manter a correspondência correta entre cada janela ISS e sua respectiva validação OOS.
Dessa forma, o arquivo ZIP funciona como a ligação entre a descoberta das regiões no ISS e a posterior validação dos candidatos no OOS.
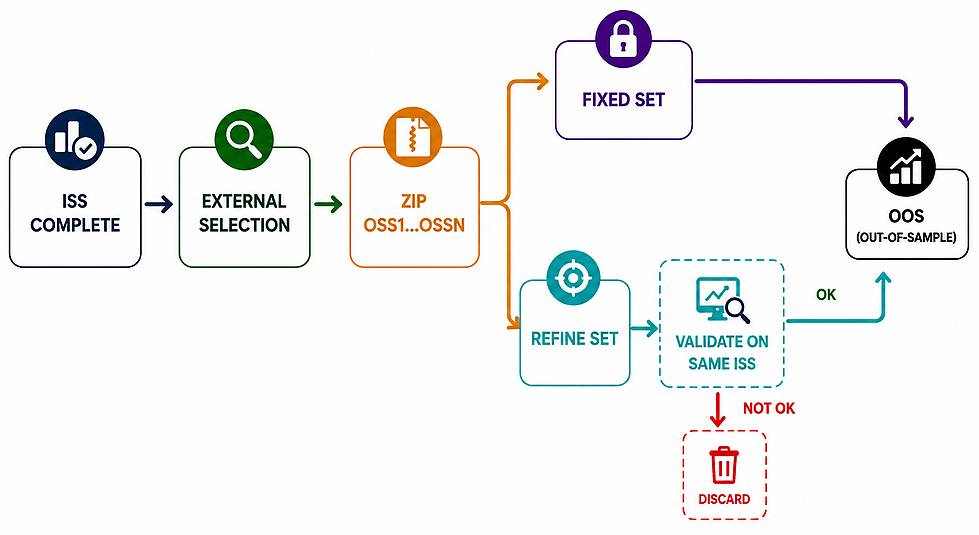
Figure 5 — Process of Selected Candidates
Por que utilizar um arquivo ZIP
No modo cluster, o arquivo .zip é utilizado principalmente para manter toda a organização das janelas em um único pacote.
Após as otimizações ISS, os resultados podem ser enviados para uma ferramenta externa de análise regional. O ZIP preserva a separação entre as diferentes janelas, evitando que resultados pertencentes a períodos distintos sejam misturados durante a análise ou devolvidos ao Global Optimizer.
A ferramenta de clusterização deve retornar uma estrutura semelhante a:
MetaTrader 5 Optimizer
│
├── OOS1
│   ├── Cluster01_fixed.set
│   └── Cluster01_refine.set
│
├── OOS2
│
├── OOS3
│   └── Cluster02_fixed.set
│
└── ...
Cada pasta OOSn corresponde à janela ISS de mesma posição. Dessa forma, candidatos encontrados a partir de ISS1 são devolvidos em OOS1, os de ISS2 em OOS2 e assim sucessivamente.
Os arquivos *_fixed.set representam candidatos já congelados, enquanto os *_refine.set descrevem regiões que ainda precisam passar por uma avaliação local no ISS de origem antes de seguirem para o OOS. Uma pasta também pode permanecer vazia quando nenhuma nova região foi aprovada naquela janela.
O ZIP, portanto, não possui função estatística. Ele funciona apenas como um formato de transporte e contrato estrutural do experimento, permitindo reunir em um único arquivo todas as janelas, subpastas e conjuntos necessários para preservar a correspondência entre ISS e OOS, de modo que uma estrutura incorreta pode comprometer o procedimento.
Continuidade temporal entre as janelas
Quando o Global Optimizer encontra uma pasta OOSn vazia, essa condição significa que nenhum novo cluster aprovado para aquela janela, e não uma falha do processo.
Se uma família de parâmetros já tiver sido congelada anteriormente, a política de continuidade pode manter esse mesmo conjunto no OOS seguinte. Caso OOS1 esteja vazio, ainda não existe uma família anterior que possa ser reutilizada e, portanto, o primeiro OOS permanece sem candidato.
Por exemplo, a primeira janela pode terminar sem cluster e sem candidato para o OOS1. Na janela seguinte, o surgimento do Cluster A permite sua validação no OOS2. Se OOS3 vier vazio, o mesmo representante pode continuar sendo testado no OOS3. Posteriormente, se surgir um Cluster B, ele passa a ser utilizado no OOS4.
Existe, porém, uma distinção importante entre continuidade e recorrência. Quando uma pasta OOSn está vazia e um candidato anterior é apenas mantido por continuidade, essa janela representa uma nova validação temporal do conjunto, mas não uma nova redescoberta da região.
Por esse motivo, o candidato mantido por continuidade não aumenta sua recorrência nem sua consistência no Robustness Score. Ele volta a contar como nova evidência somente quando a análise regional o apresenta novamente como candidato aprovado em uma pasta OOSn não vazia.
Assim, uma pasta vazia permite continuar avaliando temporalmente um conjunto já aprovado, mas não cria artificialmente uma nova aparição do cluster. Essa separação evita que a simples continuidade de um candidato seja interpretada como se a mesma região tivesse sido reencontrada pelo processo de otimização.
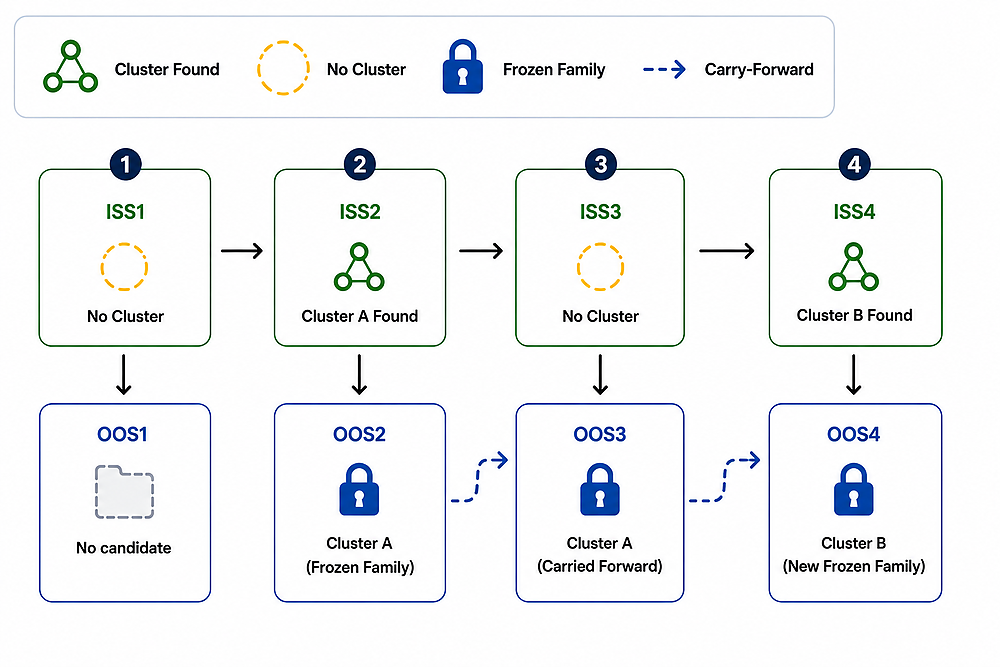
Figure 6 — Continuity Between Windows
Validação OOS e ranking final
Depois de congelado, cada candidato é executado no período OOS correspondente. Ao final das janelas, combinações idênticas de parâmetros são tratadas como o mesmo set, independentemente do nome do arquivo.
O ranking combina duas evidências diferentes: recorrência durante a seleção e desempenho posterior fora da amostra. Janelas executadas apenas por carry-forward participam das métricas OOS, mas não aumentam a recorrência.
A fórmula abaixo é apenas a política padrão utilizada neste exemplo. Ela não representa uma regra estatística universal. O usuário pode alterar os pesos, as normalizações, as métricas utilizadas ou até substituir completamente a ordenação final conforme sua própria metodologia.
Por padrão, utiliza-se:
onde:
- R: proporção de janelas em que o set foi novamente selecionado;
- C: proporção de testes OOS positivos;
- PF: PF mediano normalizado entre 1,00 e 1,50;
- DD: utiliza o maior drawdown relativo percentual observado no OOS. A fórmula é 1 / (1 + (DD / 15)²), portanto 15 representa 15% de drawdown, e não moeda ou pontos;
- P: lucro médio por teste em relação ao maior lucro médio positivo.
A recorrência possui uma limitação importante. Na implementação padrão, ela é calculada em relação ao total de janelas do experimento. Assim, sets descobertos apenas nas últimas janelas tiveram menos oportunidades de reaparecer do que aqueles encontrados desde o início. Portanto, R deve ser interpretado como uma medida de persistência ao longo do experimento, e não como uma probabilidade imparcial de recorrência. Essa regra também pode ser modificada pelo usuário.
Todo o cálculo do score e a ordenação final encontram-se na função build_cluster_set_analysis(), a partir de aproximadamente linha 6356.
Métricas normalizadas:
# R - Recurrence across discovery windows.
recurrence_quality = as_float(item.get("oss_appearance_rate"))

# C - Fraction of positive OOS tests.
consistency_quality = as_float(item.get("oss_positive_rate"))

# PF - Median OOS Profit Factor.
# PF <= 1.00 -> 0 | PF >= 1.50 -> 1.
pf_quality = max(
    0.0,
    min(1.0, (as_float(item.get("oos_median_pf")) - 1.0) / 0.50),
)

# DD - Maximum relative OOS drawdown (%).
# 15.0 means 15% drawdown.
dd_quality = 1.0 / (
    1.0 + (as_float(item.get("oos_max_ddRel")) / 15.0) ** 2
)

# P - Average OOS profit normalized by the
# largest positive average profit among the analyzed SETs.
profit_quality = (
    max(0.0, as_float(item.get("oss_profit_per_test")))
    / max_positive_profit_per_test
)
Pesos utilizados no ROSS:
# These weights are only the default example and may be changed by the user.

item["oss_robustness_score"] = 100.0 * (
    0.35 * recurrence_quality
    + 0.25 * consistency_quality
    + 0.20 * pf_quality
    + 0.10 * dd_quality
    + 0.10 * profit_quality
)
Ordem efetiva do ranking:
# Final ranking priority:
# 1. Absolute number of real recurrences
# 2. ROSS
# 3. Positive OOS rate
# 4. Total OOS profit
# 5. SET identifier only as a deterministic tie-break

output.sort(
    key=lambda item: (
        -int(as_float(item.get("oss_appearances"), 0)),
        -as_float(item.get("oss_robustness_score")),
        -as_float(item.get("oss_positive_rate")),
        -as_float(item.get("oos_total_profit")),
        str(item.get("set_id", "")),
    )
)
Relatórios finais
Depois que todas as janelas OOS são concluídas, o Global Optimizer consolida os resultados em diferentes arquivos. A ideia é separar o registro completo das execuções da análise final, permitindo tanto auditoria quanto interpretação dos candidatos.
| Relatório | Função principal |
|---|---|
| WFE_RESULTS.csv | Reúne os resultados detalhados das execuções ISS e OOS. |
| WFE_SUMMARY.csv | Consolida as métricas finais de cada candidato. |
| WFE_REPORT.md | Apresenta um resumo textual do protocolo, candidatos e resultados. |
| ANALYSIS.csv | Reúne análises por set, parâmetros e janelas para auditoria. |
| WFE_ANALYSIS.xlsx | Principal relatório visual para interpretação do Walk-Forward. |
Table 3 — Reports
O WFE_ANALYSIS.xlsx concentra a parte mais importante da análise final. Além da visão geral do experimento e da leitura janela por janela, o modo cluster acrescenta a aba OSS_ROBUST_SETS, dedicada ao ranking dos conjuntos que mais se repetiram e apresentaram melhor comportamento nos OOS.
Nessa aba são apresentados, entre outros dados, o número de aparições de cada set, cobertura das janelas, proporção de testes positivos, lucro, Profit Factor mediano, drawdown, número de operações e Robustness Score. A prioridade do ranking é a recorrência entre diferentes janelas, complementada pelo desempenho observado nos OOS. utilizando as métricas de robustez para diferenciar conjuntos com frequência semelhante.
A aba WFE_ANALYSIS complementa essa visão, mostrando o comportamento dos candidatos em cada janela, permitindo acompanhar quando uma família foi introduzida, mantida ou substituída.
Dessa forma, o relatório final permite analisar o experimento em três níveis: resultado geral, comportamento temporal e robustez dos sets recorrentes. O objetivo deixa de ser apenas identificar qual candidato ganhou mais e passa a observar quais configurações demonstraram maior consistência ao longo da validação OOS.
Exemplo de utilização
Para tornar o exemplo mais próximo de uma aplicação real, será utilizado como base o ExpertMACD.mq5, que pode ser encontrado em Experts/Advisors do próprio terminal.
O objetivo é preservar a estrutura original fornecida pela Standard Library, expor alguns de seus recursos como inputs, marcar esses parâmetros com @wfeall e acrescentar somente a infraestrutura necessária para que os passes possam ser processados pelo mt5_global_optimizer_cluster.py e posteriormente analisados pelo OCA.
Para este exemplo foi utilizada a seguinte configuração:
Symbol:                     EURUSD
Initial deposit:            1000 USD
Tester model:               1 minute OHLC
Optimization:               Genetic
Repeat ISS runs:            5
Mode:                       Cluster
ISS window:                 12 months
OOS window:                 3 months
Step:                       3 months
Cada janela ISS é, portanto, executada cinco vezes de forma repetida utilizando a otimização genética.
Essas cinco execuções não significam que todo o espaço paramétrico será visitado. Cada busca genética avalia apenas parte das combinações possíveis. As repetições permitem posteriormente observar se determinadas regiões voltam a aparecer em execuções repetidas realizadas sobre a mesma janela temporal.
Preparação do Expert Advisor
O Expert continua utilizando a arquitetura da Standard Library:
#include <Expert\Expert.mqh>
#include <Expert\Signal\SignalMACD.mqh>
#include <Expert\Trailing\TrailingNone.mqh>
#include <Expert\Money\MoneyNone.mqh>
CExpert coordena a execução e CSignalMACD fornece os padrões relacionados ao MACD. Recursos como ThresholdClose, StopLevel, TakeLevel e PatternsUsage já fazem parte da hierarquia de sinais e podem ser expostos como parâmetros sem reimplementar a lógica básica.
A classe CMoneyNone é utilizada como módulo de gerenciamento de volume. Nesse modo não há dimensionamento por percentual de risco; o Expert utiliza o volume mínimo permitido pelo símbolo. Se o EURUSD possuir SYMBOL_VOLUME_MIN = 0.01 , por exemplo, será utilizado 0.01 lote. O volume permanece, assim, fora do espaço de otimização.
Para integração com o Python, o EA também fornece os inputs esperados pelo parser:
input string optimizationTag        = "EXPERTMACD_GLOBAL_CLUSTER";
input bool   saveOptimizationPasses = true;
input string csvExportPrefix        = "ExpertMACD_GlobalOptCluster";
input int    dummyOptimizationPass  = 0;
Esses parâmetros pertencem à infraestrutura de automação e não à lógica da estratégia.
Espaço @wfeall
O subgrupo utilizado no exemplo contém nove dimensões:
// @group MACD
// @subgroup MACD_CLUSTER

// @wfeall
// @opt 8 2 16
input int Inp_Signal_MACD_PeriodFast = 12;

// @wfeall
// @opt 20 4 32
input int Inp_Signal_MACD_PeriodSlow = 24;

// @wfeall
// @opt 5 2 11
input int Inp_Signal_MACD_PeriodSignal = 9;

// @wfeall
// @opt false true
input bool Inp_Signal_MACD_UseCross = true;

// @wfeall
// @opt false true
input bool Inp_Signal_MACD_UseZeroCross = false;

// @wfeall
// @opt 20 20 100
input int Inp_Signal_ThresholdClose = 100;

// @wfeall
// @opt 0 20 120
input int Inp_Signal_MACD_TakeProfit = 80;

// @wfeall
// @opt 0 10 50
input int Inp_Signal_MACD_StopLoss = 20;

// @wfeall
// @opt 1 1 5
input int Inp_Signal_MACD_TimeframeIndex = 1;
Os três períodos controlam o MACD. UseCross e UseZeroCross habilitam padrões nativos do CSignalMACD; ThresholdClose, Stop Loss e Take Profit utilizam recursos da própria CExpertSignal.
O último input acrescenta o timeframe do sinal ao espaço analisado:
1 = H1
2 = H2
3 = H3
4 = H4
5 = H6
Foi utilizado um índice porque ENUM_TIMEFRAMES não possui uma sequência contínua de todos os períodos horários. A conversão para o período nativo ocorre dentro do EA antes de signal.Period().
O espaço cartesiano anotado possui:
5 × 4 × 4 × 2 × 2 × 5 × 7 × 6 × 5 = 336,000 combinações teóricas.
Nem todas são operacionalmente válidas. Por exemplo, quando os dois padrões MACD estão desabilitados, o OnInit() rejeita o passe.
O número elevado de combinações também explica a utilização da otimização genética: o objetivo não é executar a grade completa, mas analisar as regiões formadas pelos pontos efetivamente visitados durante as cinco buscas repetidas.
Função objetivo OnTester()
Para orientar a otimização genética foi implementado um OnTester() próprio. Em vez de utilizar somente o lucro líquido, o critério combina informações de retorno, drawdown, Profit Factor, Sharpe, Recovery Factor e quantidade de operações.
As métricas são obtidas diretamente do Strategy Tester por meio de TesterStatistics(). O lucro é convertido em retorno relativo ao depósito inicial de US$ 1.000, evitando que o score dependa apenas do valor monetário nominal.
O score utiliza os seguintes pesos:
Relative return     30%
Drawdown            25%
Profit Factor       15%
Sharpe              15%
Recovery            15%
A quantidade de trades é utilizada como penalização adicional para reduzir a classificação de amostras muito pequenas. Foram adotadas 30 operações como referência mínima e 100 como referência para normalização.
De forma simplificada, o cálculo final é:
double score=100.0;

score*=MathPow(MathMax(profitScore,0.01),0.30);
score*=MathPow(MathMax(ddScore,0.01),0.25);
score*=MathPow(MathMax(pfScore,0.01),0.15);
score*=MathPow(MathMax(sharpeScore,0.01),0.15);
score*=MathPow(MathMax(recoveryScore,0.01),0.15);
score*=tradeScore;
A combinação geométrica faz com que uma métrica muito fraca reduza o resultado global, evitando que lucro elevado compense completamente drawdown ou qualidade estatística desfavoráveis.
Passes sem operações ou com lucro não positivo recebem score negativo, mas continuam sendo exportados. Isso preserva também informações sobre regiões pouco interessantes do espaço de busca.
A comunicação utiliza FrameAdd() no agente e os callbacks OnTesterInit(), OnTesterPass() e OnTesterDeinit() no processo controlador. FrameNext() recupera os resultados e FrameInputs() associa cada frame aos parâmetros utilizados naquele passe.
Assim, o CSV mantém a relação entre: parâmetros + função objetivo + métricas do backtest, e essa associação é utilizada posteriormente pelo Global Optimizer e pelo analisador regional.
Verificação do EA antes da bateria
Antes de criar o JSON, o arquivo deve ser compilado normalmente no MetaEditor.
Depois disso, abra o PowerShell no diretório onde está localizado o mt5_global_optimizer_cluster.py.
Por exemplo:
cd "C:\Users\SeuUsuario\Downloads" Execute então:
python mt5_global_optimizer_cluster.py --parse-mq5 "C:\...\ExpertMACD_GlobalOptCluster.mq5" Esse comando não inicia uma otimização.
Ele apenas verifica a interpretação das marcações:
@group
@subgroup
@opt
@fixed
@wfe
@wfe1
@wfe2
@wfe3
@wfeall
e também a presença dos inputs exigidos para integração:
optimizationTag
saveOptimizationPasses
dummyOptimizationPass
csvExportPrefix
Para este EA também deverão ser reconhecidas as nove dimensões pertencentes ao MACD_CLUSTER.
Após verificação, é necessário configurar o arquivo json pelo Wizard onde ocorrerá a bateria cluster, certifique-se que a lógica mq5 já esteja formulada e compilada antes de iniciar.
python mt5_global_optimizer_cluster.py --wizard
Será deixado em anexo um arquivo config_wizard.txt para exemplo de como configurar o wizard caso haja dificuldades.
Bateria ISS, OOS e relatórios finais
Após a criação do arquivo JSON, realize o comando no PowerShell abaixo para iniciar a bateria ISS.
python mt5_global_optimizer_cluster.py --config "C:\...\Downloads\example.json" --stage wfe O Python executará a bateria ISS conforme a periodicidade escolhida. Os parâmetros marcados com @wfeall serão avaliados em conjunto, enquanto outros grupos ou subgrupos serão processados separadamente conforme suas marcações.
Ao finalizar todas as janelas ISS, o programa abrirá o Explorer para selecionar o ZIP com os candidatos OOS e indicará o diretório de trabalho, onde ficam organizados o pacote ZIP, ISS_MERGED, ISS_REPEAT_RUNS e ANALYSIS.
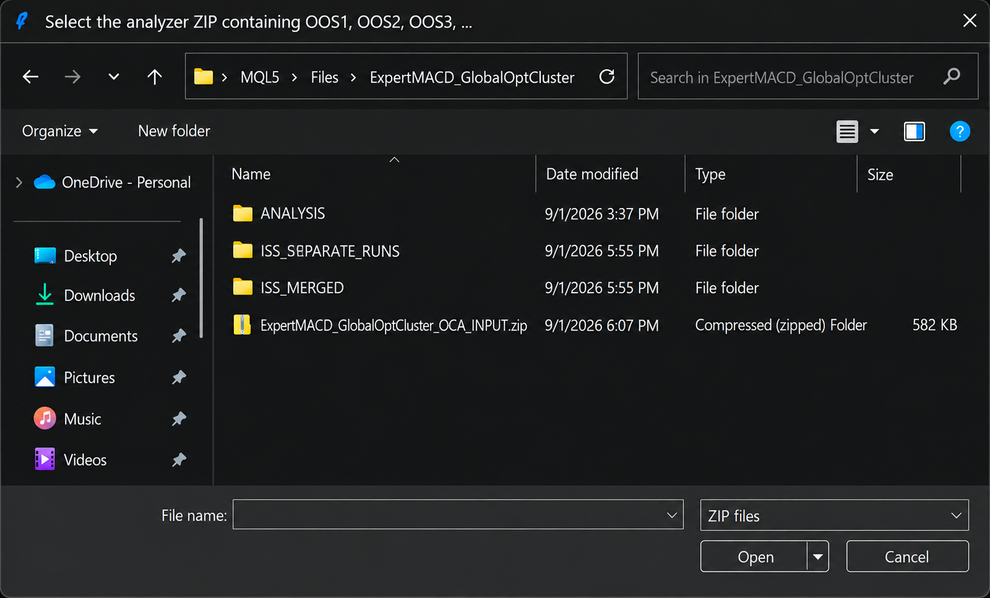
Figure 7 — Opening of the explorer compartment following the depletion of the ISS battery.
Caso o OCA seja o analisado externo, mova o arquivo ZIP para MQL5\\Files do terminal. Isso é necessário porque o OCA é executado em MQL5 e tem acesso limitado às pastas permitidas pelo terminal. Em seguida, execute o OCA, selecione o tipo de otimização e importe o arquivo ZIP na opção “Selecionar relatório”.
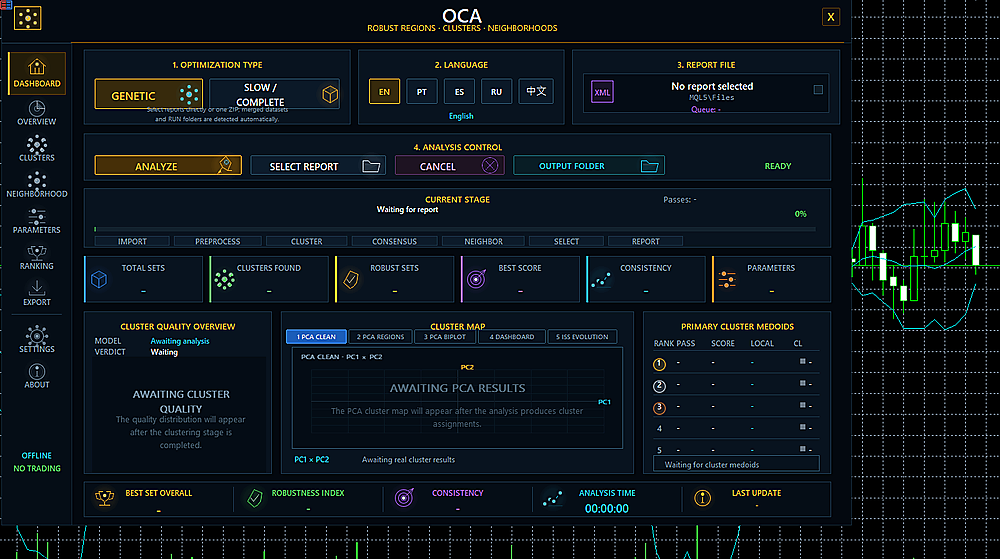
Figure 8 — Window Optimizer Cluster Analyzer
Antes de selecionar “Analyze”, vá em “Export” e marque “Adapt to MetaTrader 5 Global Optimizer”. Ao finalizar a análise de clusters, o OCA cria, no diretório Files, a pasta OptimizationClusterAnalyzer com o arquivo ZIP para importar no MetaTrader 5 Global Optimizer e continuar a etapa OOS. Além do arquivo ZIP o OCA cria uma análise independente de cada janela de como construiu os clusters com os dados informados.
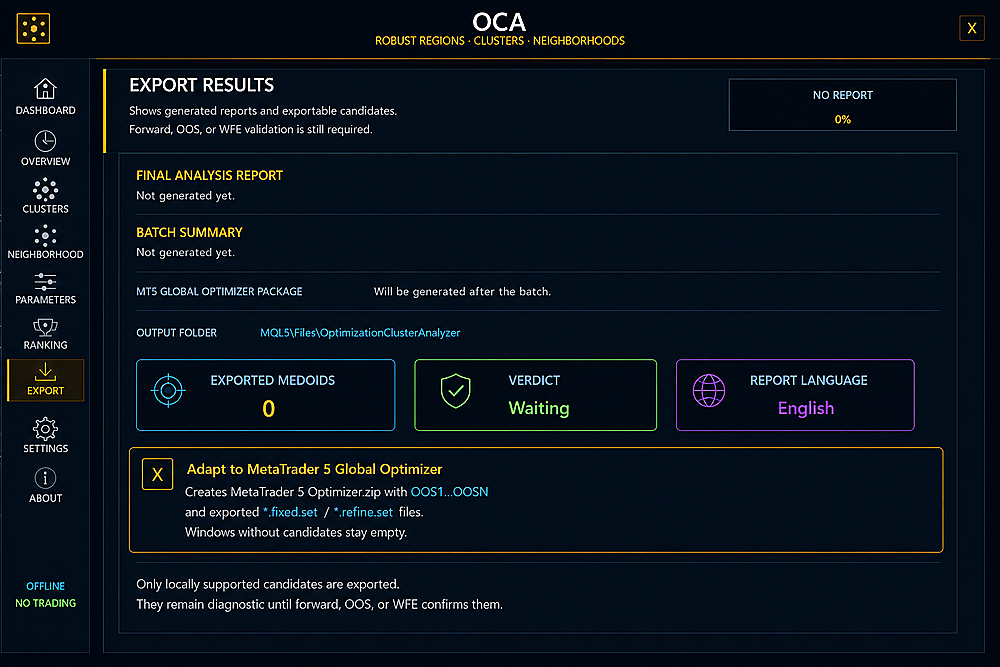
Figure 9 — Export Window
Ao fim da bateria OOS o programa também cria uma pasta com o nome do EA, e dentro dela há a pasta ANALYSIS com os resultados WFE. Ao abrir o WFE_ANALYSIS poderá ver na janela OOS_ROBUST_SETS os resultados dos melhores sets, recorrência, quantas janelas OOS ficaram positivas entre outras métricas para escolha.
No final terá uma planilha informando os resultados. A imagem foi adaptada para que pudesse apresentar os dados em uma imagem.
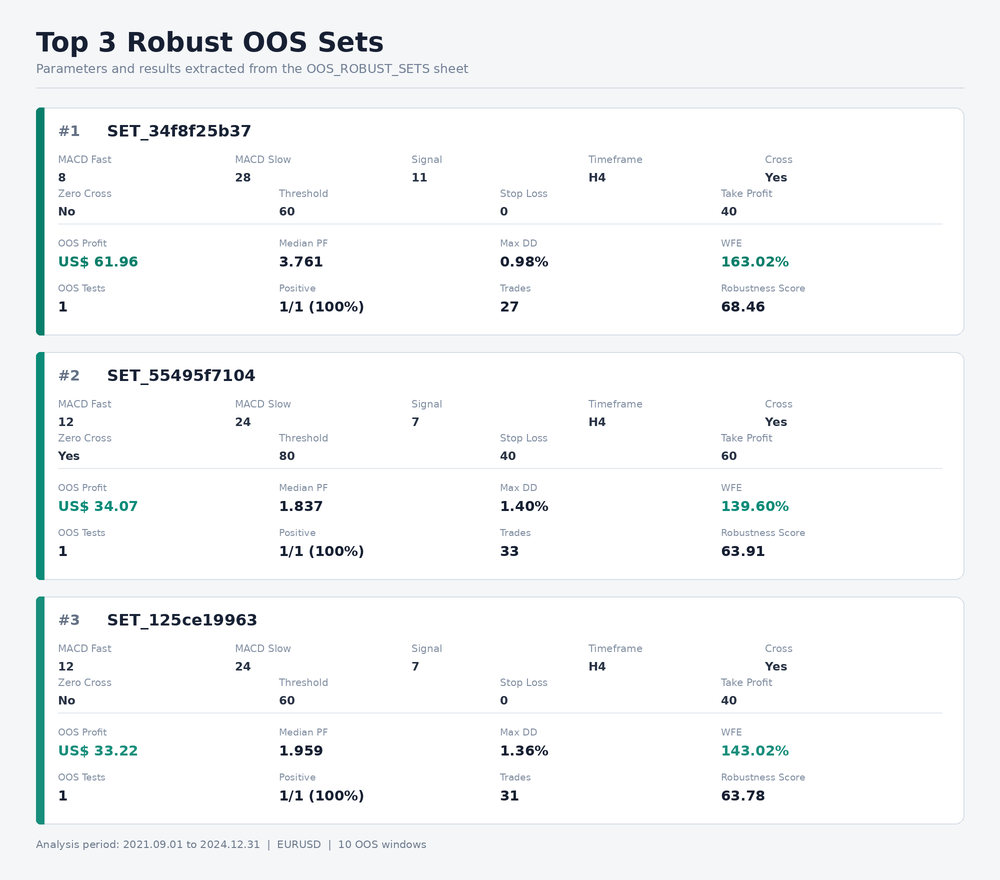
Figure — 10 Analysis
Quando usar WFE normal e quando usar clusterização?
Clusterização adiciona informação, mas também adiciona custo computacional e complexidade.
Por isso, nem todo experimento precisa começar com ela.
WFE normal pode ser suficiente quando:
- Poucos parâmetros estão sendo avaliados.
- O grid é pequeno.
- A superfície é fácil de inspecionar.
- O objetivo é estudar um componente isolado.
- A primeira hipótese ainda está sendo explorada.
- Vários parâmetros interagem.
- O espaço possui muitas dimensões.
- Existem milhares ou milhões de combinações possíveis.
- Genética precisa ser utilizada.
- O melhor resultado parece instável.
- Vários resultados próximos possuem desempenho semelhante.
- Deseja-se distinguir regiões de pico.
- Pretende-se estudar a persistência de famílias paramétricas ao longo do WFE.
Assim, clusterização não precisa substituir a otimização convencional.
Conclusão
Ao longo dos três artigos, o processo de otimização foi ampliado progressivamente.
Na primeira parte foi estruturada e automatizada a busca por parâmetros. Na segunda foi introduzida a validação temporal através das janelas ISS e OOS. Nesta terceira etapa, além do desempenho individual, passa-se a considerar a região paramétrica à qual o candidato pertence.
A principal mudança não é simplesmente adicionar um algoritmo de clusterização. O objetivo é modificar a forma como os resultados ISS são interpretados: uma configuração interessante deixa de ser avaliada apenas pelo score isolado e passa a ser analisada também pelo suporte existente em sua vizinhança.
No modo genético, essa evidência continua limitada aos pontos efetivamente explorados, razão pela qual as execuções repetidas são preservadas como informação adicional de reprodutibilidade. No modo completo, a disponibilidade da grade permite avaliar diretamente regiões quando existe cobertura suficiente.
Os representantes aprovados são congelados ou submetidos a um pequeno refinamento ainda dentro do ISS antes da validação futura. No ranking final, recorrência e desempenho são novamente separados. Continuidade permite continuar testando uma família anterior, mas somente a redescoberta de uma região aumenta sua recorrência.
O resultado não elimina a incerteza inerente à otimização. Em vez disso, acrescenta novas etapas de verificação para reduzir a dependência de um único passe excepcional e fornecer mais informação sobre quais configurações justificam avançar no processo de validação.
| Nº | Nome | Tipo | Descrição |
|---|---|---|---|
| 1 | mt5_global_optimizer_cluster.py | Script Python | Programa em Python utilizado para automação das otimizações e do WFE baseado em clusters. |
| 2 | ExpertMACD_GlobalOptCluster.mq5 | Expert Advisor | EA de exemplo preparado com as marcações @wfeall e função OnTester() utilizada pelo fluxo do Global Optimizer III. |
| 3 | Example_ISS_OOS.zip | ZIP | Exemplo da estrutura utilizada na troca de dados entre o MetaTrader 5 Global Optimizer e o analisador durante as etapas ISS e OOS. |
| 4 | config_wizard.txt | txt | Exemplo e instruções de configuração Wizard. |
| 5 | MQL5.zip | ZIP | Arquivo contendo todos os anexos do projeto organizados na estrutura correta do diretório MQL5. Pode ser descompactado diretamente no diretório de dados do terminal, mantendo cada arquivo em sua pasta correspondente. |
| 6 | OCA_v1.75_Methods_Region_Formation_Limitations | Descreve como é feito os clusters, métodos e limitações no OCA. |
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.

 Recursos do Assistente MQL5 que você precisa conhecer (Parte 71): Utilização de padrões MACD e OBV
 Recursos do Assistente MQL5 que você precisa conhecer (Parte 70): Uso dos padrões SAR e RVI com uma rede neural cujos kernels crescem exponencialmente
 A arte de trabalhar com logs (Parte 8): Registros de erros com tradução automática
 Criação de EAs auto-otimizáveis em MQL5 (Parte 8): Análise de múltiplas estratégias

- Aplicativos de negociação gratuitos
- 8 000+ sinais para cópia
- Notícias econômicas para análise dos mercados financeiros
Você concorda com a política do site e com os termos de uso