
Técnicas do Assistente MQL5 que você deve conhecer (Parte 62): Utilizando padrões de ADX e CCI com aprendizado por reforço via TRPO
 47
 0

Introdução
Continuamos nossa análise de como indicadores técnicos que acompanham diferentes aspectos da ação do preço podem ser combinados com aprendizado de máquina. No artigo anterior, vimos como o aprendizado supervisionado em um Perceptron Multicamadas (MLP) estabelece a base para a previsão da ação do preço. Chamamos as entradas da MLP de recursos e suas saídas de previsão de estados. Pela forma como definimos nossos recursos no último artigo, ligeiramente diferente da abordagem utilizada nos artigos 57 a 60, buscamos obter um vetor de entrada mais contínuo, em vez da alternativa discreta que havíamos utilizado anteriormente. A mudança em direção a dados contínuos e à regressão, afastando-se de dados discretos e da classificação, talvez possa ser melhor compreendida ao observarmos as tendências da inteligência artificial.
No passado, para que um programa de computador fornecesse uma resposta útil ou prática a uma solicitação, essa resposta precisava ser explicitamente programada. Essencialmente, as estruturas condicionais if eram fundamentais para a programação da maioria dos sistemas. E, pensando bem, essa dependência de estruturas if significava que os dados fornecidos pelo usuário ou processados pelo programa precisavam se enquadrar em determinadas categorias. Ou seja, precisavam ser discretos. Portanto, pode-se argumentar que, em grande parte, o desenvolvimento e a utilização de dados discretos surgiram como resposta às limitações da programação, e não necessariamente em função da natureza dos dados ou do problema que estava sendo resolvido.
Então veio a OpenAI, no segundo semestre de 2023, com seu primeiro GPT lançado publicamente, e esse cenário mudou. O desenvolvimento das redes Transformer e dos GPTs não ocorreu da noite para o dia, já que os primeiros perceptrons foram desenvolvidos no final da década de 1960, mas é possível afirmar que o lançamento do ChatGPT representou um marco importante. Com a ampla adoção dos grandes modelos de linguagem, tornou-se evidente que a tokenização, os embeddings de palavras e, naturalmente, o mecanismo de self-attention são componentes fundamentais para permitir que os modelos ampliem sua capacidade de processamento. Chega de cláusulas if. É nesse contexto de utilização da tokenização e dos embeddings de palavras para tornar as entradas das redes o mais contínuas possível que também tornamos as entradas da nossa MLP de aprendizado supervisionado ‘mais contínuas’.
Para ilustrar isso, nosso segundo conjunto de sinais, denominado feature_1, é representado da seguinte forma para a MLP em Python:
def feature_1(adx_df, cci_df):
    """
    Creates a modified 3D signal array with:
    1. ADX > 25 (1 when above 25, else 0)
    2. CCI crosses from below 0 to above +50 (1 when condition met, else 0)
    3. CCI crosses from above 0 to below -50 (1 when condition met, else 0)
    """
    # Initialize empty array with 3 dimensions
    feature = np.zeros((len(adx_df), 5))

    # Dimension 1: ADX above 25 (continuous, not just crossover)
    feature[:, 0] = (adx_df['adx'] > 25).astype(int)

    # Dimension 2: CCI crosses from <0 to >+50
    feature[:, 1] = (cci_df['cci'] > 50).astype(int)
    feature[:, 2] = (cci_df['cci'].shift(1) < 0).astype(int)

    # Dimension 3: CCI crosses from >0 to <-50
    feature[:, 3] = (cci_df['cci'] < -50).astype(int)
    feature[:, 4] = (cci_df['cci'].shift(1) > 0).astype(int)

    # Set first row to 0 (no previous values to compare)
    feature[0, :] = 0

    return feature
Se mantivéssemos o método utilizado nos artigos 57 a 60, ele seria processado da seguinte maneira:
def feature_1(adx_df, cci_df):
    """
    """
    # Initialize empty array with 3 dimensions and same length as input
    feature = np.zeros((len(dem_df), 3))

    # Dimension 1:
    feature[:, 0] = (adx_df['adx'] > 25).astype(int)
    feature[:, 1] = ((cci_df['cci'] > 50) &
                     (cci_df['cci'].shift(1) < 0)).astype(int)
    feature[:, 2] = ((cci_df['cci'] < -50) &
                     (cci_df['cci'].shift(1) > 0)).astype(int)

    # Set first row to 0 (no previous values to compare)
    feature[0, :] = 0

    return feature
Essa abordagem tende a classificar os sinais de acordo com os padrões normalmente esperados de alta e de baixa, pois o segundo elemento do vetor de saída captura exclusivamente características de um sinal de alta. O terceiro elemento captura apenas características de baixa. Ao se limitar a padrões previamente definidos como de alta ou de baixa, essa abordagem tende, portanto, a funcionar mais como um classificador e, consequentemente, a apresentar uma natureza mais discreta. Dito isso, nossos testes mostraram que apenas 3 dos 10 padrões avaliados conseguiram apresentar resultados satisfatórios no forward walk de 01.01.2024 a 01.01.2025, após terem sido testados e treinados no período de 01.01.2020 a 01.01.2024. O ativo utilizado foi o EURUSD, no gráfico Diário.
Portanto, considerando o período gráfico mais amplo e a janela de treinamento relativamente longa que utilizamos, parece haver argumentos favoráveis à manutenção de dados de entrada mais discretos em nossa MLP inicial. Outro argumento a favor dessa abordagem pode ser encontrado ao analisarmos as entradas dos LLMs. Sim, a tokenização e os embeddings de palavras tornam os dados de entrada mais contínuos; no entanto, o “ingrediente secreto” dos LLMs, a self-attention, ainda opera sobre unidades discretas da entrada. Isso ocorre porque ele busca atribuir um peso de importância relativa a cada uma das palavras fornecidas na entrada do prompt.
Não estamos implementando algo semelhante, e essa pode ser uma possível explicação para os resultados obtidos. Os leitores, portanto, podem modificar e testar diferentes formatos de entrada, já que todo o código-fonte em MQL5 está anexado. De nossa parte, manteremos essa abordagem e veremos quais resultados obteremos com o Aprendizado por Reforço.
Aprendizado por Reforço
Partimos do modelo de aprendizado supervisionado do artigo anterior e acrescentamos ações e recompensas. Lembre-se de que tínhamos os recursos como entradas da nossa MLP e os estados — alterações previstas nos preços — como suas saídas. Nesta etapa, as ações representam como devemos agir diante daquilo que nossa MLP está prevendo. Por exemplo, se a previsão indicar queda dos preços, podemos executar uma ordem Sell Limit, uma ordem Sell Stop ou uma venda imediata a mercado. O desenvolvimento e o treinamento de uma rede de política podem ajudar a aperfeiçoar essa decisão.
Normalmente, em um cenário como o apresentado acima, no qual podemos utilizar diferentes tipos de ordens de venda, o tamanho do vetor de saída da rede de política corresponderia ao número de ações possíveis. Nesse caso, ele teria dimensão 3, correspondendo às três alternativas: ordem limitada, ordem stop e ordem a mercado. O treinamento com essas configurações deve produzir diferenças de desempenho, e o leitor pode explorar essas possibilidades. De nossa parte, manteremos as ações representadas por um vetor unidimensional que, essencialmente, reproduz o vetor de saída dos estados gerado pela MLP no artigo anterior. Qual é, então, a finalidade disso? Ele funciona como uma confirmação da previsão de compra ou venda realizada pela rede de aprendizado supervisionado.
Além disso, as recompensas são utilizadas para quantificar o lucro obtido em cada operação realizada. As recompensas constituem a saída da rede de valor e, embora novamente as estejamos representando por um vetor unidimensional, elas também podem ser multidimensionais. Isso ocorre porque a análise posterior à operação pode considerar não apenas o lucro ou prejuízo, mas também os movimentos favoráveis e adversos do preço durante a operação. Assim, o vetor de recompensas também pode ter dimensão 3, incluindo excursão adversa, excursão favorável e ganho líquido.
Otimização de Política por Região de Confiança
Otimização de Política por Região de Confiança (TRPO) é um algoritmo de aprendizado por reforço voltado ao aprimoramento da política. Ele faz isso de forma iterativa, atualizando os pesos e vieses da rede de política e, ao mesmo tempo, mantendo essas alterações dentro de uma ‘região de confiança’ em relação à política atual.
Os principais componentes envolvidos nessa implementação são a rede de política, a região de confiança e a divergência KL. A rede de política é uma rede neural responsável pela seleção das ações, mapeando os estados para uma distribuição de probabilidade sobre as possíveis ações. A região de confiança é uma restrição que limita o quanto a política pode mudar a cada iteração. Ela garante que a nova política não se afaste excessivamente da anterior, evitando, assim, instabilidades. Por fim, a divergência KL mede a diferença entre a distribuição prevista e a distribuição da política de referência/anterior. Essencialmente, ela define a restrição da região de confiança.
O processo de treinamento envolve: coletar dados, idealmente em lotes de trajetórias, utilizando a política atual; estimar a função de vantagem para cada par estado-ação presente nos dados coletados, a fim de avaliar o quanto determinada ação é melhor do que uma ação média; formular o problema de otimização para encontrar pesos e vieses adequados para as redes de política e de valor, maximizando as recompensas sob restrições de divergência KL que mantenham a diferença entre as políticas nova e anterior dentro de um limite específico; resolver o problema de otimização utilizando técnicas como o gradiente descendente; e, por fim, atualizar os pesos das redes de política e de valor.
As principais vantagens do TRPO são: melhoria monotônica, em que as melhorias da política são garantidas; estabilidade, pois a região de confiança impede que a política realize atualizações excessivamente grandes que poderiam torná-la instável; e eficiência, já que o TRPO tende a aprender de maneira eficaz utilizando menos amostras do que outros métodos baseados em gradiente de política. Em resumo, a ideia central do TRPO é maximizar a vantagem esperada de uma nova política em relação à política anterior, sujeita a uma restrição sobre o quanto essa política pode mudar. Isso é representado pelas seguintes equações:
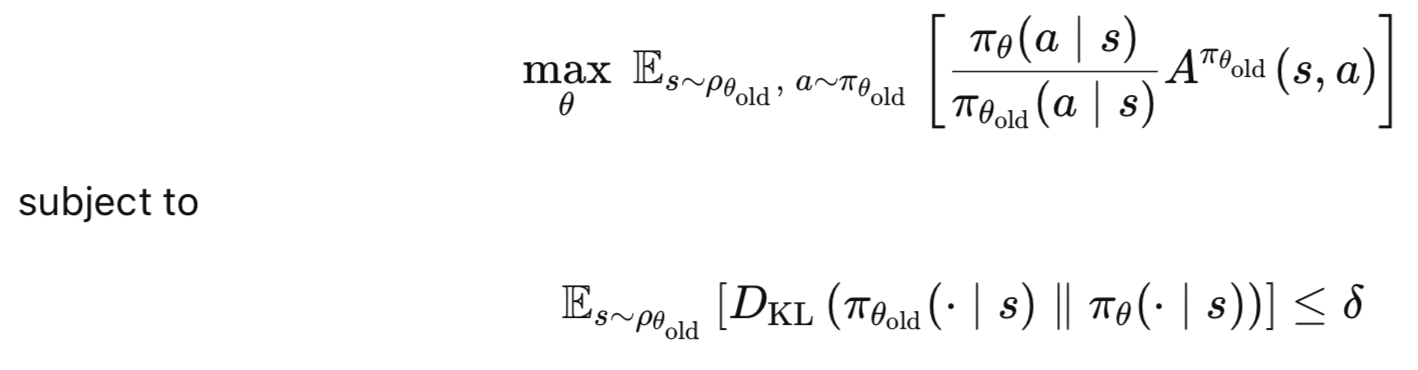
Onde:
- θ: Parâmetros da nova política.
- θold: Parâmetros da política anterior à atualização.
- πθ(a∣s): Probabilidade da ação a sob a nova política πθ.
- πθold(a∣s): Probabilidade da ação a sob a política anterior πθold.
- Aπθold(s,a): Função de vantagem, que estima o quanto a ação a é melhor do que a ação média no estado s.
- ρθold (s): Distribuição de visitação dos estados sob a política anterior.
- DKL: Divergência de Kullback-Leibler (KL), que mede a diferença entre as políticas anterior e nova.
- δ: Restrição da região de confiança (pequeno valor positivo).
A Rede de Política
Implementamos nossas redes de política e de valor em Python da seguinte forma:
class PolicyNetwork(nn.Module):
    def __init__(self, state_dim, action_dim, hidden_size=64, discrete=False):
        super(PolicyNetwork, self).__init__()
        self.discrete = discrete

        self.fc1 = nn.Linear(state_dim, hidden_size)
        self.fc2 = nn.Linear(hidden_size, hidden_size)

        self.export_mode = False

        if self.discrete:
            self.fc3 = nn.Linear(hidden_size, action_dim)
        else:
            self.mean = nn.Linear(hidden_size, action_dim)
            self.log_std = nn.Parameter(torch.zeros(action_dim))

    def forward(self, x):
        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))

        if self.discrete:
            action_probs = F.softmax(self.fc3(x), dim=-1)
            dist = Categorical(action_probs)
        else:
            mean = self.mean(x)
            std = torch.exp(self.log_std)

            if self.export_mode:
                return mean, std  # return raw tensors

            cov_mat = torch.diag_embed(std).unsqueeze(dim=0)

            dist = MultivariateNormal(mean, cov_mat)

        return dist
A rede de política herda de nn.Module, o que a torna um módulo de rede do PyTorch. Ela recebe como parâmetros a dimensão do estado, que representa o tamanho do espaço de estados de entrada; a dimensão da ação, que representa o tamanho do espaço de ações; e o tamanho da camada oculta, cujo valor padrão é 64. Também recebemos como entrada uma flag booleana denominada discrete, que determina se o espaço de ações é discreto ou contínuo. Essa flag discrete acaba determinando tanto a estrutura da camada de saída quanto o tipo de distribuição utilizada.
Essa configuração torna nossa rede versátil para lidar tanto com espaços de ações discretos quanto contínuos em ambientes de aprendizado por reforço. Assim, jogos como CartPole podem utilizar a opção discrete igual a True, enquanto nosso caso de negociação, ou mesmo aplicações de robótica, utilizariam essa opção definida como False. No TRPO, a rede de política define a política do agente, que consiste em um mapeamento dos estados para as ações. A flexibilidade para lidar com diferentes tipos de espaços de ações pode, portanto, ser importante para sua aplicação em diferentes contextos. No caso de traders, poderíamos querer restringir nossas ações aos três tipos de ordens mencionados anteriormente — limitadas, stop e a mercado — e, nesse caso, discrete seria definido como True.
Ao implementar essa estrutura, é importante garantir que a dimensão do estado e a dimensão da ação correspondam às especificações definidas no ambiente ou nos conjuntos de dados utilizados. A flag discrete também deve estar alinhada ao tipo de espaço de ações do ambiente. O tamanho 64 da camada oculta é um hiperparâmetro ajustável que pode precisar ser aumentado, ou até mesmo exigir a inclusão de outras camadas ocultas, dependendo da complexidade do ambiente ou do conjunto de dados utilizado.
A arquitetura da rede possui duas camadas lineares totalmente conectadas, nas quais fc1 mapeia o estado de entrada para uma camada oculta e fc2 realiza o mapeamento para outra camada oculta de mesmo tamanho. O parâmetro export_mode é uma flag utilizada para controlar se a rede retorna tensores brutos para exportação ou uma distribuição para treinamento/amostragem.
Essas camadas formam a estrutura principal da rede de política, pois transformam efetivamente as entradas brutas dos estados em uma representação de nível mais elevado de uma ação adequada para seleção. Por ser uma arquitetura simples de duas camadas com ativações ReLU, conseguimos expressividade suficiente enquanto mantemos o modelo leve. No TRPO, a rede de política precisa ser diferenciável. Isso é importante para o cálculo dos gradientes utilizados nas atualizações da política. Com essas duas camadas lineares, esse requisito é atendido.
A escolha de duas camadas ocultas com tamanho 64 é adequada como configuração padrão, mas frequentemente pode exigir ajustes à medida que o ambiente ou os conjuntos de dados testados se tornam maiores ou mais complexos. Nos casos em que mais de dois indicadores são combinados para gerar padrões de recursos ou em que estados mais elaborados são fornecidos à rede de política, esse número pode precisar ser aumentado.
Por fim, dependendo de a nossa rede estar ou não operando em modo discreto, nossa camada final de saída utilizará uma ou duas saídas. Para espaços discretos, a saída da camada linear fc3 representa os logits de cada ação. Por outro lado, se discrete estiver definido como False, estaremos trabalhando com espaços contínuos e, nesse caso, duas saídas da rede produzirão vetores distintos. O primeiro corresponde à média de uma distribuição Gaussiana para cada dimensão da ação. O segundo corresponde ao vetor do logaritmo do desvio padrão da distribuição Gaussiana para cada dimensão da ação.
Isso é importante porque essa bifurcação permite modelar diferentes tipos de espaços de ações. Com a opção discreta ativada, a saída é uma distribuição de probabilidade sobre um número predefinido de ações. Na alternativa contínua, ou com discrete desativado, a saída é uma distribuição Gaussiana multivariada. Em termos simples, são dois vetores: um deles, a média, fornece um valor médio indicativo e, portanto, uma ponderação para cada ação; enquanto o outro vetor, contendo os logaritmos dos desvios padrão, fornece uma medida da dispersão ou da confiança associada a cada uma das previsões médias.
No TRPO, a distribuição da política é utilizada para amostrar ações e calcular as log-probabilidades empregadas nas atualizações por gradiente de política. A escolha entre espaços discretos e contínuos afeta, portanto, a quantidade de cálculos necessários e a eficiência da rede. O logaritmo do desvio padrão é um parâmetro aprendível, permitindo que a rede adapte o nível de exploração, ou variância, durante o treinamento. Isso é importante para equilibrar exploração e aproveitamento.
Para ações discretas, a dimensão da ação deve corresponder ao número de ações possíveis. Manteremos uma única dimensão, pois estamos trabalhando com uma variável contínua, mas voltaremos a explorar opções de ações discretas em artigos posteriores. Para nossas ações contínuas atuais, no entanto, é sempre essencial inicializar log_std cuidadosamente. Começar com Torch.zeros(action_dim) significa que os desvios padrão iniciais serão exp(0)=1, o que pode representar uma faixa excessivamente ampla ou estreita, dependendo da escala das ações. Portanto, deve ser utilizado um método de escalonamento específico para o ambiente.
Além disso, no TRPO, as log-probabilidades da política são utilizadas na função objetivo e nas restrições de divergência KL. Por isso, é fundamental garantir a estabilidade numérica dentro da distribuição. Por fim, nos casos em que o ambiente utiliza ações limitadas a determinados intervalos, as saídas da rede podem eventualmente ultrapassar esses limites. Nesse caso, será necessário aplicar clipping ou escalonamento às saídas médias para garantir que permaneçam dentro do intervalo desejado.
A passagem direta pela rede de política realiza um processamento comum no qual o estado de entrada x passa por fc1 e fc2, com ativações ReLU aplicadas para introduzir não linearidade. Caso as ações sejam discretas, a saída de fc3 passa por uma função softmax para produzir as probabilidades das ações. Se as ações forem contínuas, por outro lado, a média será calculada por meio da camada correspondente à média; o desvio padrão será obtido como exp(log_std), garantindo que seja positivo; e, se export_mode estiver definido como True, os desvios padrão serão retornados como tensores brutos. Se export_mode estiver definido como False, será construída uma matriz de covariância diagonal (cov_mat) e criada uma distribuição normal multivariada para a amostragem e o cálculo das log-probabilidades.
A passagem direta define a forma como a política mapeia os estados para distribuições de ações, sendo um elemento central do processo de tomada de decisão do agente de aprendizado por reforço. No TRPO, a distribuição da política é utilizada para: amostrar ações durante a interação com o ambiente, calcular as log-probabilidades para o objetivo do gradiente de política e avaliar a restrição da região de confiança. O uso de distribuições categóricas e normais multivariadas garante compatibilidade com bibliotecas padrão de aprendizado por reforço, como torch.distributions do PyTorch. A opção export_mode permite a implementação prática do modelo, pois utiliza saídas brutas que podem ser posteriormente processadas conforme necessário.
No caso discreto, a função softmax garante que a soma das probabilidades seja igual a 1. Instabilidades numéricas podem ocorrer com frequência nos logits e, portanto, é recomendável monitorar a ocorrência de NaNs e utilizar Torch.Clamp quando necessário. Para ações contínuas, a matriz de covariância diagonal cov_mat pressupõe que as dimensões das ações sejam independentes. Por outro lado, se as ações forem correlacionadas, deverá ser utilizada uma matriz de covariância completa. Isso aumentará o custo computacional. No TRPO, as log-probabilidades da política devem ser calculadas de forma eficiente e precisa, pois são utilizadas nas etapas de gradiente conjugado e busca em linha.
A Rede de Valor
Implementamos nossa rede de valor da seguinte forma:
class ValueNetwork(nn.Module):
    def __init__(self, state_dim, hidden_size=64):
        super(ValueNetwork, self).__init__()
        self.fc1 = nn.Linear(state_dim, hidden_size)
        self.fc2 = nn.Linear(hidden_size, hidden_size)
        self.fc3 = nn.Linear(hidden_size, 1)

    def forward(self, x):
        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))
        x = self.fc3(x)
        return x
Existe uma considerável sobreposição entre o projeto e a implementação da rede de valor e da rede de política. Portanto, não entraremos em detalhes sobre a maior parte desses aspectos. Em princípio, porém, a rede de valor estima o valor do estado para o cálculo da vantagem (e, por extensão, para a estimativa de retornos/recompensas acumuladas). Também utilizamos uma arquitetura simples, semelhante à da rede de política, e nossa saída é um único valor escalar. Essa rede é fundamental para garantir atualizações estáveis da política no TRPO por meio de estimativas precisas das recompensas.
Agente TRPO
Implementamos nossa classe de agente TRPO em Python da seguinte forma:
class TRPO_Agent:
    def __init__(self, state_dim, action_dim, discrete=False,
                 hidden_size=64, lr_v=0.001, gamma=0.99,
                 delta=0.01, lambda_=0.97, max_kl=0.01, cg_damping=0.1,
                 cg_iters=10, device='cpu'):

        self.policy = PolicyNetwork(state_dim, action_dim, hidden_size, discrete).to(device)
        self.value_net = ValueNetwork(state_dim, hidden_size).to(device)
        self.value_optimizer = optim.Adam(self.value_net.parameters(), lr=lr_v)

        self.gamma = gamma
        self.delta = delta
        self.lambda_ = lambda_
        self.max_kl = max_kl
        self.cg_damping = cg_damping
        self.cg_iters = cg_iters

        self.discrete = discrete
        self.device = device
        self.state_dim = state_dim

    def get_action(self, state):
        # Convert state to tensor and add batch dimension
        state = torch.FloatTensor(state).unsqueeze(0).to(self.device)

        # Get action distribution from policy
        dist = self.policy(state)

        # Sample action from distribution
        action = dist.sample()

        # Get log probability BEFORE converting to numpy/item
        log_prob = dist.log_prob(action)

        # Convert action to appropriate format
        if self.discrete:
            action = action.item()  # For discrete actions
        else:
            action = action.detach().cpu().numpy()[0]  # For continuous actions

        # Clip continuous actions to [-1, 1] range (optional for discrete)
        if not self.discrete:
            action = np.clip(action, -1, 1)

        return action, log_prob

    def update_value_net(self, states, targets):
        # Convert inputs to proper tensor format
        if torch.is_tensor(states):
            states = states.detach().cpu().numpy()
        if torch.is_tensor(targets):
            targets = targets.detach().cpu().numpy()

        states = np.array(states, dtype=np.float32)
        targets = np.array(targets, dtype=np.float32)

        # Ensure proper shapes
        if len(states.shape) == 1:
            states = np.expand_dims(states, 0)
        if len(targets.shape) == 0:
            targets = np.expand_dims(targets, 0)

        states_tensor = torch.FloatTensor(states).to(self.device)
        targets_tensor = torch.FloatTensor(targets).to(self.device)

        # Forward pass
        self.value_optimizer.zero_grad()
        values = self.value_net(states_tensor)

        # Ensure matching shapes for loss calculation
        values = values.view(-1)
        targets_tensor = targets_tensor.view(-1)

        loss = F.mse_loss(values, targets_tensor)
        loss.backward()
        self.value_optimizer.step()

    def update_policy(self, states, actions, old_log_probs, advantages):
        # Handle tensor conversion safely
        def safe_convert(x):
            if torch.is_tensor(x):
                return x.detach().cpu().numpy()
            return np.array(x, dtype=np.float32)

        states = safe_convert(states)
        actions = safe_convert(actions)
        old_log_probs = safe_convert(old_log_probs)
        advantages = safe_convert(advantages)

        # Convert to tensors with proper shapes
        states_tensor = torch.FloatTensor(states).to(self.device)
        actions_tensor = torch.FloatTensor(actions).to(self.device)
        old_log_probs_tensor = torch.FloatTensor(old_log_probs).to(self.device)
        advantages_tensor = torch.FloatTensor(advantages).to(self.device)

        # Get old distribution
        with torch.no_grad():
            old_dist = self.policy(states_tensor)

        # Compute gradient of surrogate loss
        def get_loss():
            dist = self.policy(states_tensor)
            if self.discrete:
                log_probs = dist.log_prob(actions_tensor.long())
            else:
                log_probs = dist.log_prob(actions_tensor)
            return -self.surrogate_loss(log_probs, old_log_probs_tensor, advantages_tensor)

        # Rest of the TRPO update remains the same...
        loss = get_loss()
        grads = torch.autograd.grad(loss, self.policy.parameters(), create_graph=True)
        flat_grad = torch.cat([grad.view(-1) for grad in grads]).detach()

        step_dir = self.conjugate_gradient(states_tensor, old_dist, flat_grad, nsteps=self.cg_iters)

        shs = 0.5 * torch.dot(step_dir, self.hessian_vector_product(states_tensor, old_dist, step_dir))
        step_size = torch.sqrt(self.max_kl / (shs + 1e-8))
        full_step = step_size * step_dir

        old_params = torch.cat([param.view(-1) for param in self.policy.parameters()])

        def line_search():
            for alpha in [0.5**x for x in range(10)]:
                new_params = old_params + alpha * full_step
                self.set_policy_params(new_params)

                with torch.no_grad():
                    new_dist = self.policy(states_tensor)
                    new_loss = get_loss()
                    kl = self.kl_divergence(old_dist, new_dist)

                if kl <= self.max_kl and new_loss < loss:
                    return True
            return False

        if not line_search():
            self.set_policy_params(old_params)

    def set_policy_params(self, flat_params):
        prev_idx = 0
        for param in self.policy.parameters():
            flat_size = param.numel()
            param.data.copy_(flat_params[prev_idx:prev_idx + flat_size].view(param.size()))
            prev_idx += flat_size

    def compute_advantages(self, rewards, values, dones):
        advantages = np.zeros_like(rewards)
        last_advantage = 0

        for t in reversed(range(len(rewards))):
            if dones[t]:
                delta = rewards[t] - values[t]
                last_advantage = delta
            else:
                delta = rewards[t] + self.gamma * values[t+1] - values[t]
                last_advantage = delta + self.gamma * self.lambda_ * last_advantage
            advantages[t] = last_advantage

        advantages = (advantages - advantages.mean()) / (advantages.std() + 1e-8)
        return advantages

    def surrogate_loss(self, new_probs, old_probs, advantages):
        ratio = torch.exp(new_probs - old_probs)
        return torch.mean(ratio * advantages)

    def kl_divergence(self, old_dist, new_dist):
        if self.discrete:
            return torch.mean(torch.sum(old_dist.probs * (torch.log(old_dist.probs) - torch.log(new_dist.probs)), dim=1))
        else:
            return torch.distributions.kl.kl_divergence(old_dist, new_dist).mean()

    def hessian_vector_product(self, states, old_dist, vector):
        kl = self.kl_divergence(old_dist, self.policy(states))

        # First compute gradient of KL
        grads = torch.autograd.grad(kl, self.policy.parameters(), create_graph=True)
        flat_grad_kl = torch.cat([grad.view(-1) for grad in grads])

        # Compute gradient of (grad_KL * vector)
        grad_vector_product = torch.sum(flat_grad_kl * vector)
        grad_grad = torch.autograd.grad(grad_vector_product, self.policy.parameters(), retain_graph=True)
        flat_grad_grad = torch.cat([grad.contiguous().view(-1) for grad in grad_grad])

        return flat_grad_grad + self.cg_damping * vector

    def conjugate_gradient(self, states, old_dist, b, nsteps=10, residual_tol=1e-10):
        x = torch.zeros_like(b)
        r = b.clone()
        p = b.clone()
        rdotr = torch.dot(r, r)

        for i in range(nsteps):
            Avp = self.hessian_vector_product(states, old_dist, p)
            alpha = rdotr / torch.dot(p, Avp)
            x += alpha * p
            r -= alpha * Avp
            new_rdotr = torch.dot(r, r)
            if new_rdotr < residual_tol:
                break
            beta = new_rdotr / rdotr
            p = r + beta * p
            rdotr = new_rdotr

        return x
A classe do agente TRPO funciona tanto com espaços de ações contínuos quanto discretos, utilizando uma rede de política para escolher as ações e uma rede de valor para estimar as recompensas de cada estado. Uma distinção importante das redes de valor no TRPO é que suas entradas são compostas apenas pelos estados e não incluem as ações, como ocorre frequentemente em outros algoritmos de aprendizado por reforço. O TRPO otimiza a política maximizando uma função objetivo substituta, ao mesmo tempo que restringe as atualizações da política para mantê-las dentro de uma região de confiança definida pela divergência KL. Essa classe inclui métodos para escolha de ações, atualização da função de valor, otimização da política, estimativa de recompensas e outros cálculos.
O método __init__() inicializa o agente TRPO com as redes de política e de valor, os otimizadores e os hiperparâmetros utilizados na otimização da região de confiança do TRPO. As entradas incluem diversos hiperparâmetros, alguns específicos do TRPO, como ‘max_kl’ e ‘cg_damping’, e outros específicos do aprendizado por reforço, como gamma e lambda. No ajuste desses hiperparâmetros, os valores padrão max_kl=0.01, cg_damping=0.1 e lambda=0.97 são razoáveis, mas devem ser adaptados ao ambiente ou conjunto de dados utilizado.
Para ambientes mais complexos, como conjuntos de dados de alta dimensionalidade, um max_kl menor, em torno de 0.005, pode ser mais adequado para impor restrições mais rígidas, enquanto um número maior de cg_iters, em torno de 20, pode favorecer a convergência do gradiente conjugado. A escolha do otimizador Adam para a rede de valor é padrão. No entanto, a rede de política depende do mecanismo de atualização personalizado do TRPO, sem utilizar esse otimizador. Também é recomendável garantir que a taxa de aprendizado da rede de valor seja suficientemente pequena para proporcionar maior estabilidade ao aprendizado da rede.
O método get_action() converte o estado de entrada em um tensor do PyTorch. O estado é processado pela rede de política para obter uma distribuição de ações; em seguida, uma ação é amostrada dessa distribuição para calcular sua log-probabilidade e, por fim, a ação é convertida para um formato compatível com o ambiente. Esse formato corresponde a um valor escalar para ações discretas e a um array NumPy com clipping para ações contínuas.
Essa função representa a interface do agente com o ambiente, pois permite selecionar ações com base na política A log-probabilidade é fundamental para os cálculos de gradiente do TRPO, pois é utilizada na função de perda substituta para avaliar o desempenho da política. Aplicar clipping às ações contínuas para mantê-las no intervalo [-1,1] pode garantir que as saídas da rede de política sejam compatíveis com os limites de ação esperados pelo ambiente. Para ações contínuas, o desvio padrão deve ser monitorado para evitar distribuições degeneradas. O método de processamento em lote utilizado pressupõe entradas compostas por um único estado. No entanto, em estados vetorizados ou multidimensionais, ele pode ser estendido para processá-los de forma mais eficiente.
A atualização da rede de valor usa os estados de entrada para estimar valores-alvo da função de valor, que servem de base para o cálculo dos retornos/recompensas esperadas. Ela calcula a perda pelo erro quadrático médio em relação aos valores-alvo e atualiza a rede de valor por retropropagação utilizando o otimizador Adam. Estimativas precisas de valor reduzem a variância nos gradientes da política e, consequentemente, melhoram a estabilidade do TRPO. A perda MSE permite que a rede de valor aprenda a prever o retorno descontado esperado, mantendo-se, assim, alinhada ao objetivo do aprendizado por reforço. Estamos utilizando alvos de Diferença Temporal para calcular os valores-alvo empregados no treinamento da rede de valor. Esses valores precisam ser calculados com precisão, pois estimativas imprecisas podem gerar atualizações instáveis da política.
A função de perda utilizada é a MSE padrão. No entanto, a Huber Loss também pode ser considerada para proporcionar maior robustez a valores atípicos em ambientes ou conjuntos de dados com alta variância. A lógica de correção dos formatos dos dados também parece adequada, embora possa enfrentar limitações em situações envolvendo grandes conjuntos de dados. Nesses casos, pode ser necessário realizar uma pré-otimização dos formatos das entradas para garantir que sejam pré-processadas com as dimensões corretas. Além disso, o clipping de gradientes pode ser incorporado por meio de módulos como torch.nn.utils.clip_grd_norm_, a fim de limitar atualizações excessivamente grandes e, assim, estabilizar o treinamento da rede.
A função de atualização da política converte estados, ações, log-probabilidades anteriores e recompensas em tensores com os formatos apropriados. Ela também calcula a distribuição da política anterior para os cálculos da divergência KL e define a função de perda substituta, que mede a recompensa esperada sob a nova política em comparação com a política anterior. Além disso, a função de atualização da política calcula o gradiente da política, utiliza o gradiente conjugado para determinar a direção de busca e define o tamanho do passo com base na restrição da região de confiança, ‘max-kl’. Ela executa uma busca em linha para garantir que a nova política atenda às restrições de divergência KL e também melhore a função de perda substituta, ou restaura os parâmetros anteriores caso a busca falhe.
De várias maneiras, esse é o núcleo do TRPO, pois implementa a otimização da região de confiança, equilibrando a melhoria da política com a estabilidade. A perda substituta estima o objetivo do gradiente de política, enquanto a restrição de divergência KL garante que não ocorram alterações excessivamente grandes na política que possam prejudicar seu desempenho. Em outras palavras, o método do gradiente conjugado determina de forma eficiente a direção de busca, enquanto a busca em linha garante atualizações mais robustas.
No TRPO, o parâmetro max-kl é fundamental. Um valor muito pequeno, como abaixo de 0.005, pode restringir excessivamente as atualizações e resultar em um aprendizado muito lento. Por outro lado, um valor muito alto, como acima de 0.05, pode gerar atualizações desestabilizadoras, justamente o problema que o TRPO busca reduzir. O parâmetro ‘cg-iters’ — número de iterações do gradiente conjugado — deve ser suficientemente elevado para permitir a convergência. O resíduo também deve ser monitorado para verificar a precisão da solução.
A função de definição dos parâmetros da política atualiza os parâmetros da rede de política copiando os valores de um vetor achatado e, em seguida, remodelando-os para corresponder às dimensões de cada parâmetro. Isso permite realizar as atualizações personalizadas dos parâmetros do TRPO, que são calculadas como um vetor achatado durante a busca em linha com gradiente conjugado. Assim, essa função garante que a rede de política reflita os parâmetros otimizados após cada atualização.
O cálculo das recompensas, denominado compute-advantage no código, determina as recompensas utilizando a Estimativa Generalizada de Vantagem, ou GAE. Isso envolve o cálculo do erro de Diferença Temporal para cada etapa de tempo. A combinação dos erros de TD com lambda_ ajuda a equilibrar viés e variância. O processo também reinicializa a recompensa/vantagem ao final de cada episódio, conforme indicado pelo parâmetro dones[t], e normaliza essas recompensas para que apresentem média zero e variância unitária.
A função de perda substituta calcula essa perda como o valor esperado da razão de probabilidades πnew(a∣s)/πold(a∣s) multiplicada pelas vantagens. A perda substituta estima o objetivo do gradiente de política ao medir como as alterações na política afetam as recompensas esperadas. No TRPO, essa função é maximizada e, portanto, seu valor é negado em get-loss, respeitando a restrição da região de confiança.
A função de divergência KL determina a magnitude da diferença entre as distribuições da política anterior e da nova política. Quando as ações são discretas, utiliza-se uma fórmula analítica para distribuições categóricas. Para ações contínuas, o PyTorch utiliza distribuições normais multivariadas. Essas medidas ajudam a impor a restrição da região de confiança do TRPO.
A função de produto Hessiana-vetor, como o próprio nome sugere, calcula o produto da Hessiana utilizado para a divergência KL no método do gradiente conjugado. Os cálculos obtêm o gradiente da divergência KL, multiplicam-no pelo vetor de entrada e, em seguida, calculam o gradiente de segunda ordem. Também é adicionado um termo de amortecimento para melhorar a estabilidade numérica. Ao aproximar a ação da matriz de informação de Fisher sobre um vetor, torna-se possível calcular de forma eficiente a direção de busca no TRPO. O termo de amortecimento ajuda a garantir que a Hessiana seja definida positiva e que o gradiente conjugado apresente convergência.
Por fim, a função de gradiente conjugado implementa o método utilizado para resolver Hx = g, em que H é a matriz de Fisher aproximada pela função hessian_vector_product e g representa o gradiente da política. Ela refina iterativamente sua solução x, ou seja, a direção de busca, até que ocorra a convergência ou seja atingido o número de iterações definido por nsteps.
Execuções de Teste
Se realizarmos o forward walk apenas para os três padrões de recursos que conseguiram apresentar resultados satisfatórios no forward walk do artigo anterior — Recursos 2, 3 e 4 — obteremos os relatórios apresentados abaixo. Estamos testando o par EURUSD no período de 01.01.2020 a 01.01.2025. O treinamento foi realizado em Python utilizando dados correspondentes a 80% desse período, ou seja, de 01.01.2020 a 01.01.2024.
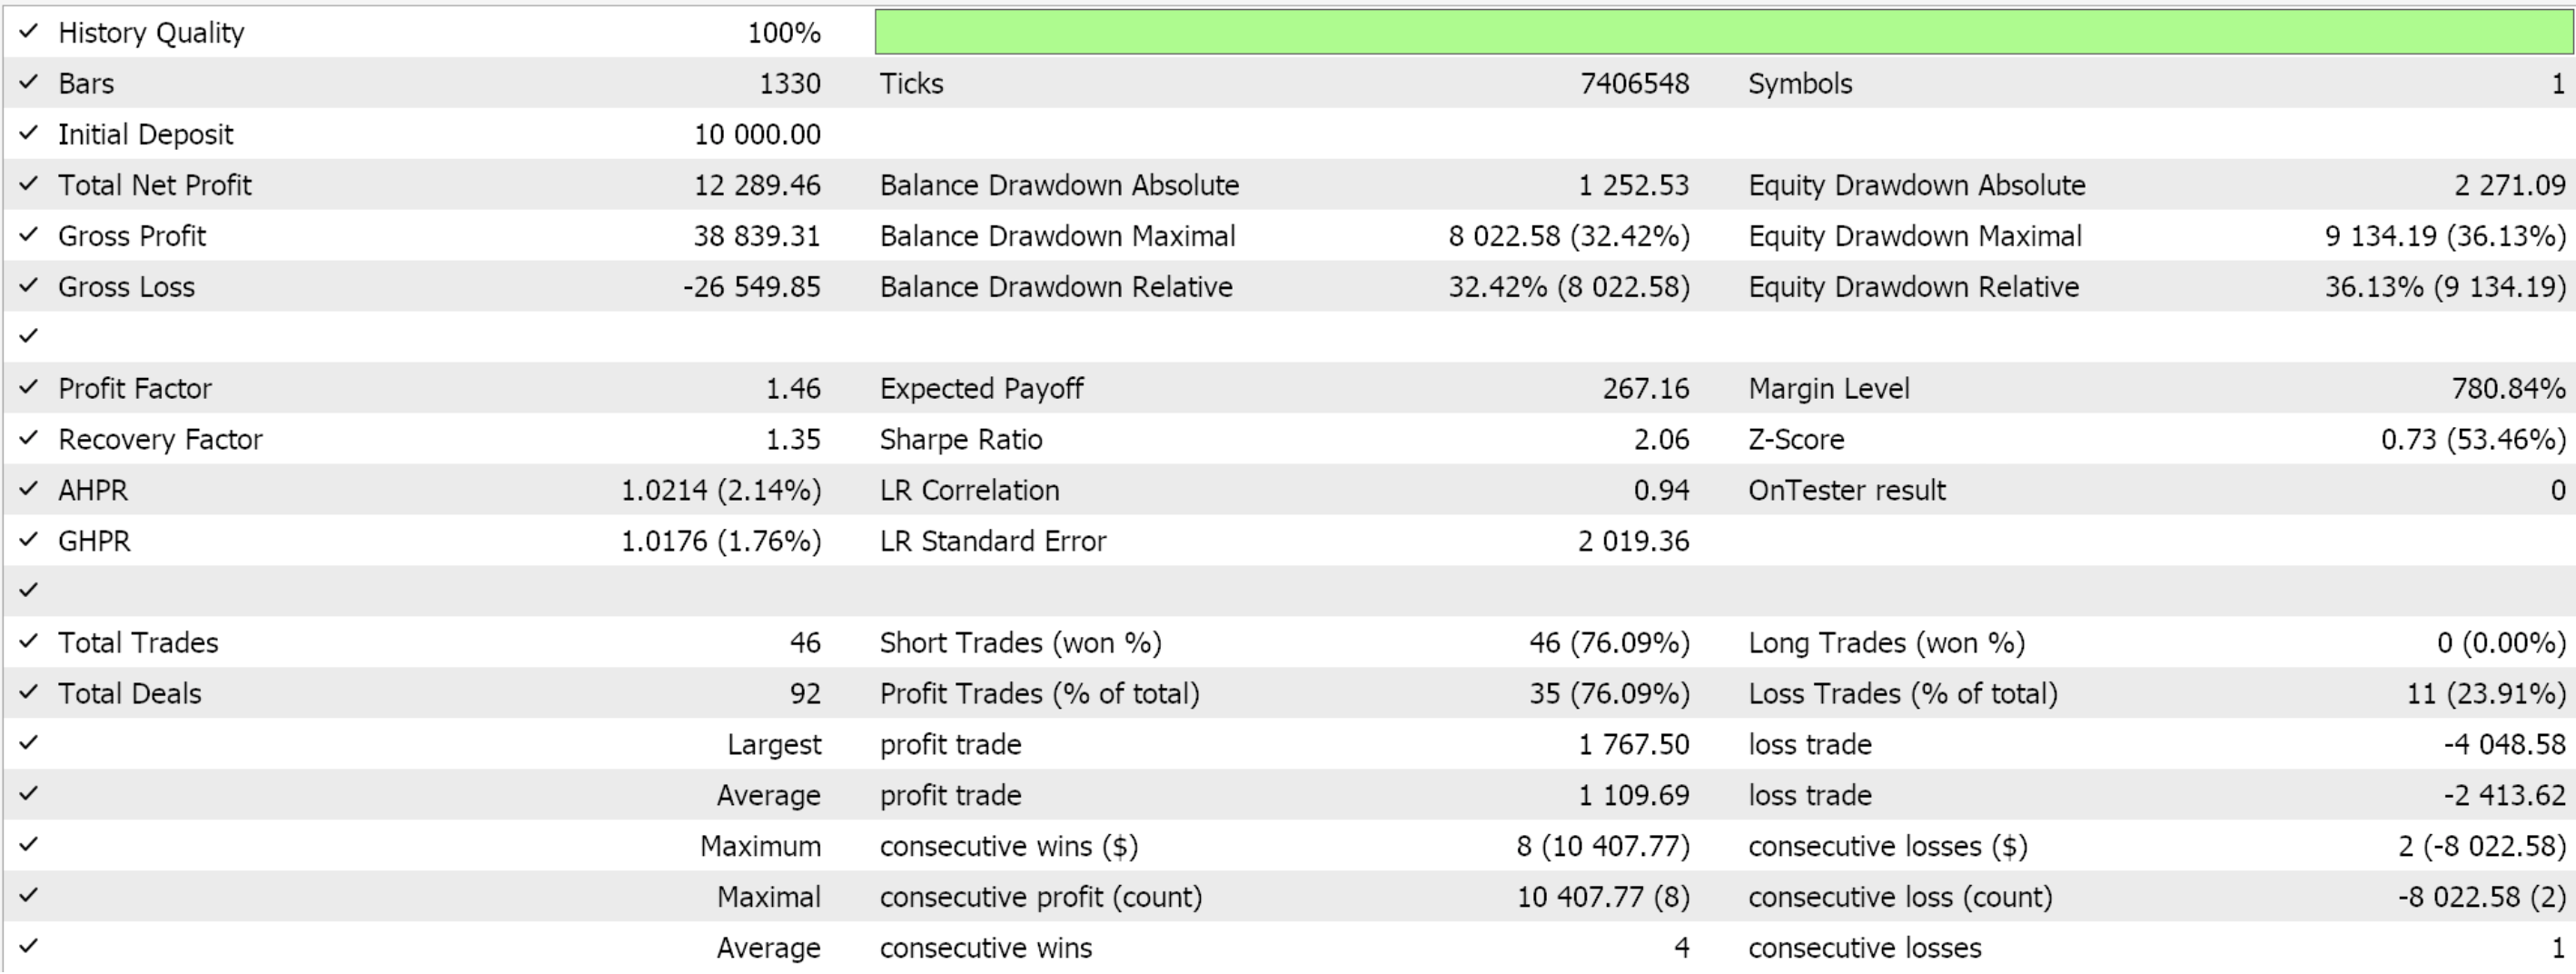
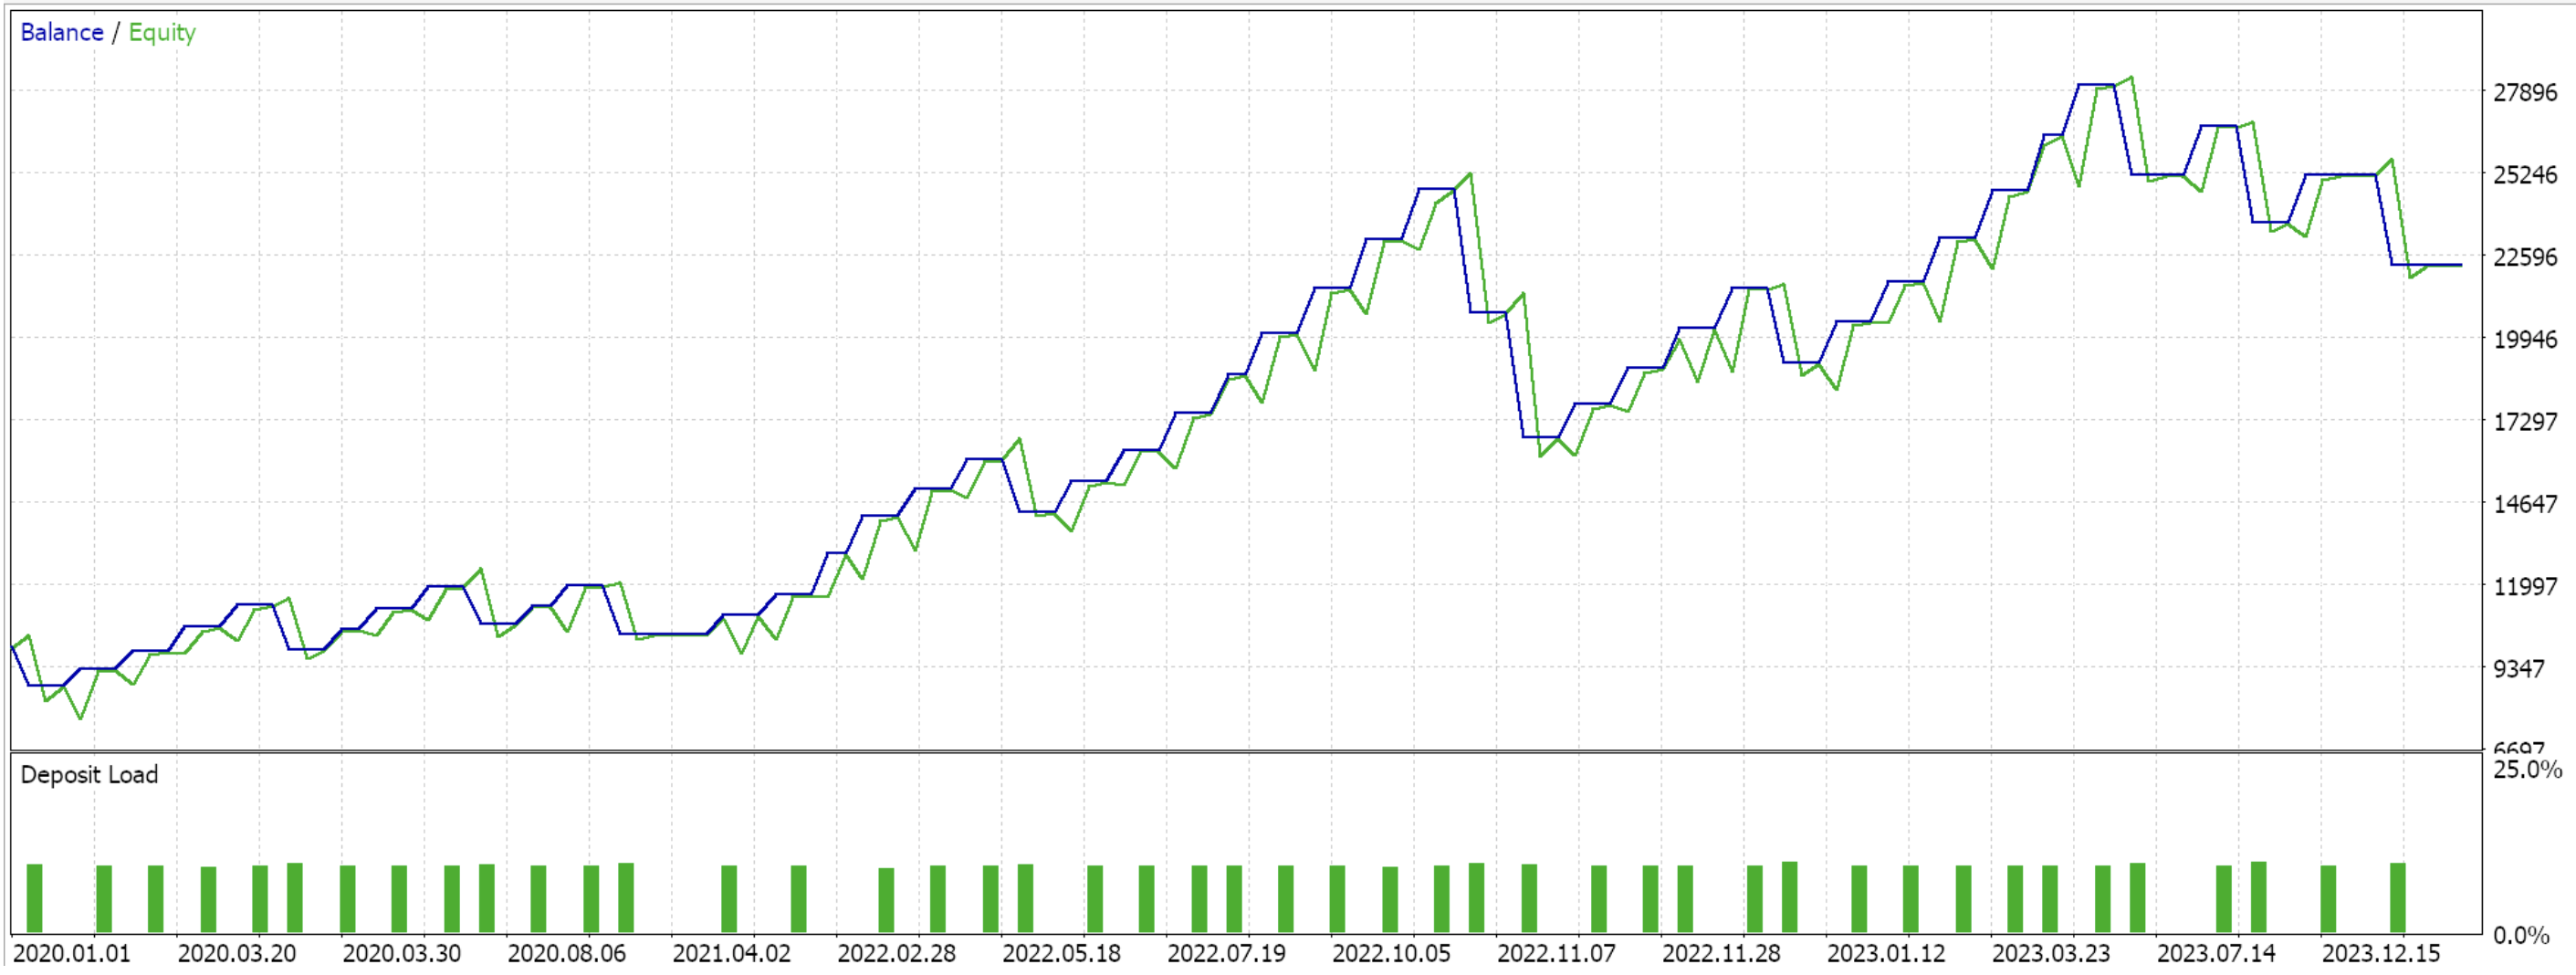
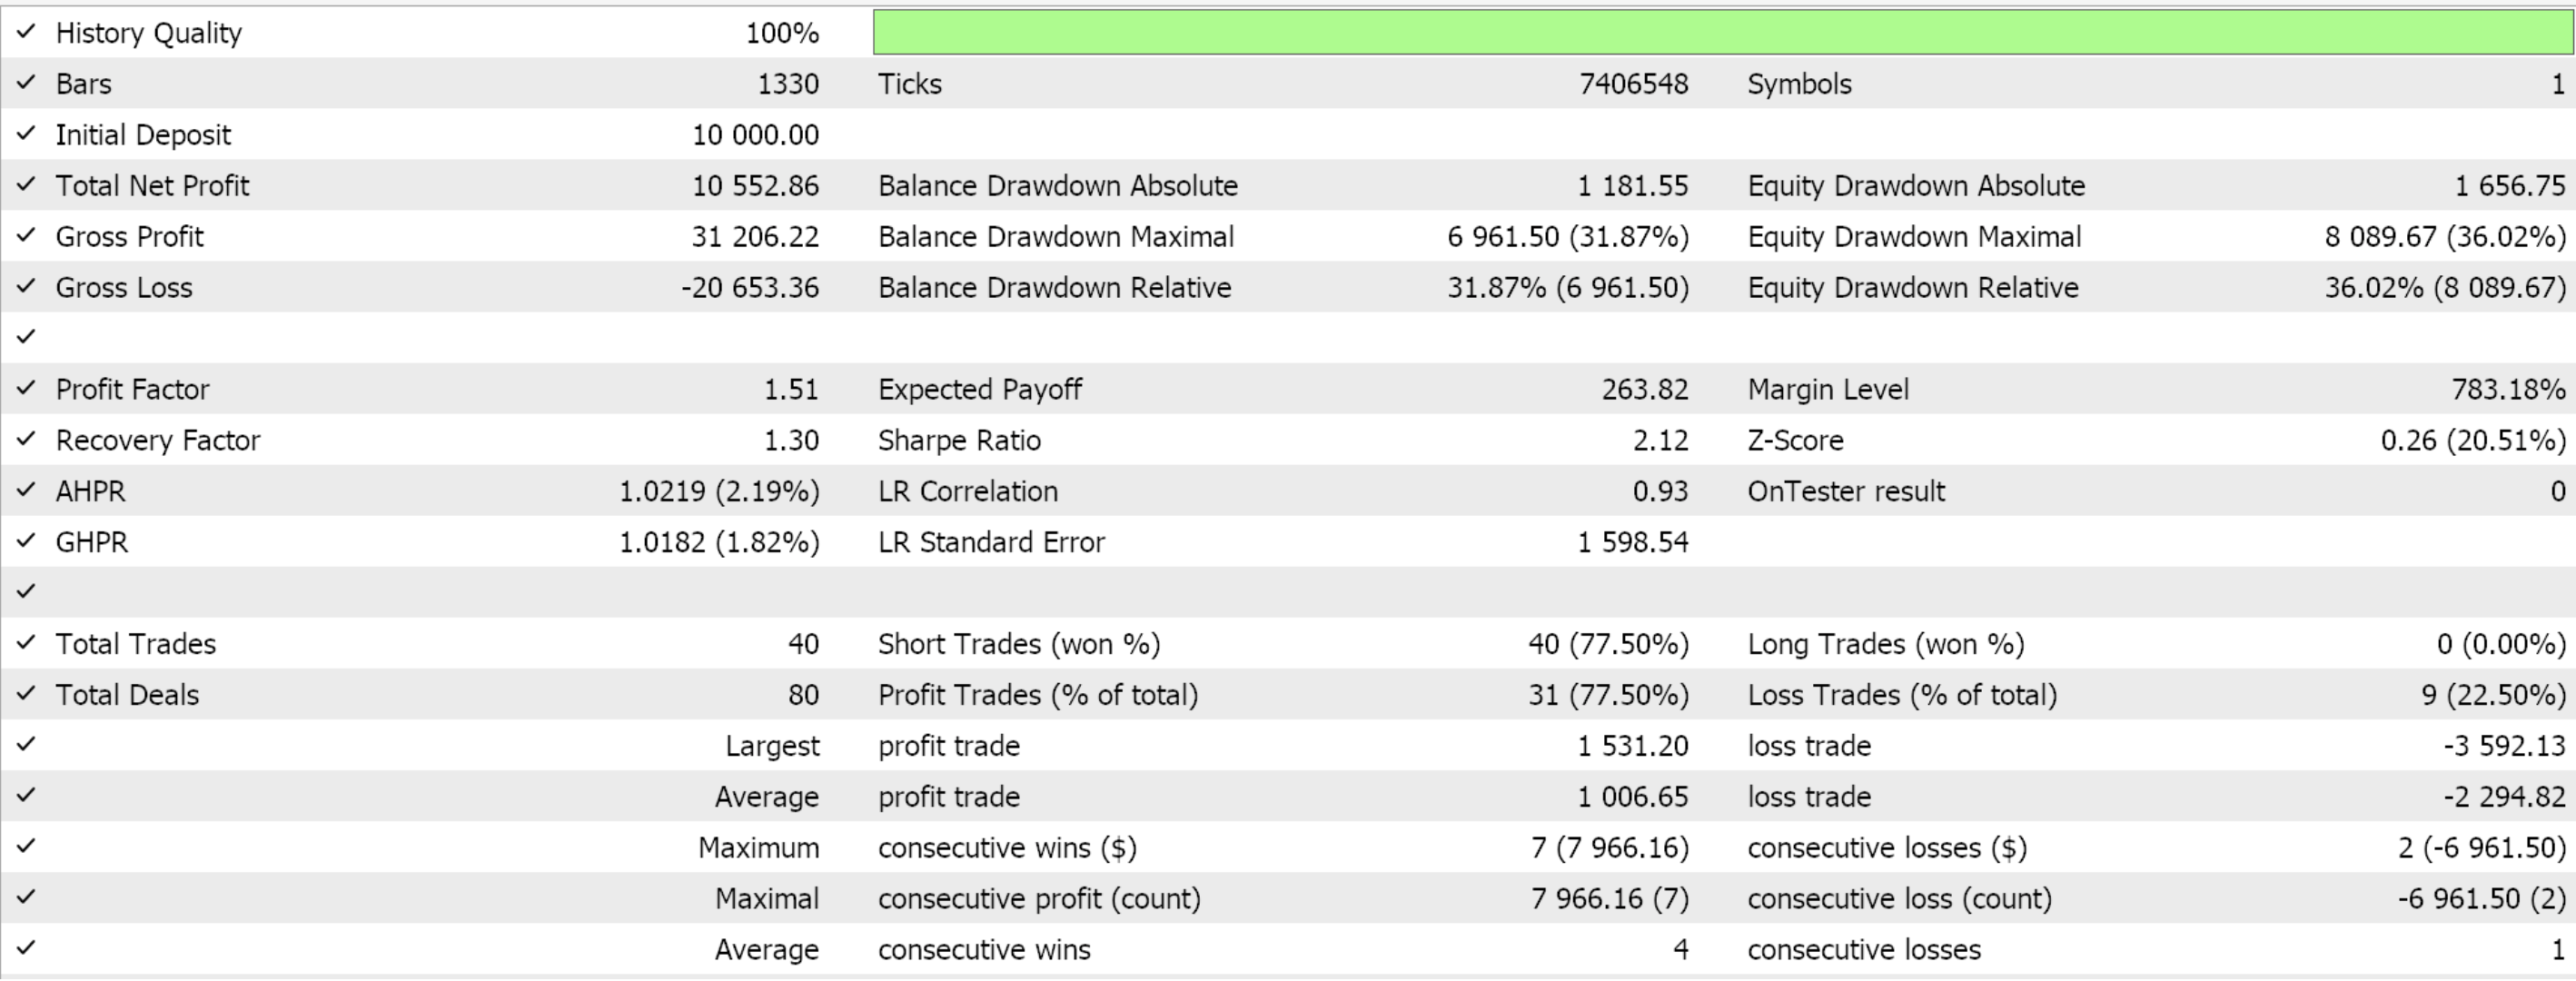
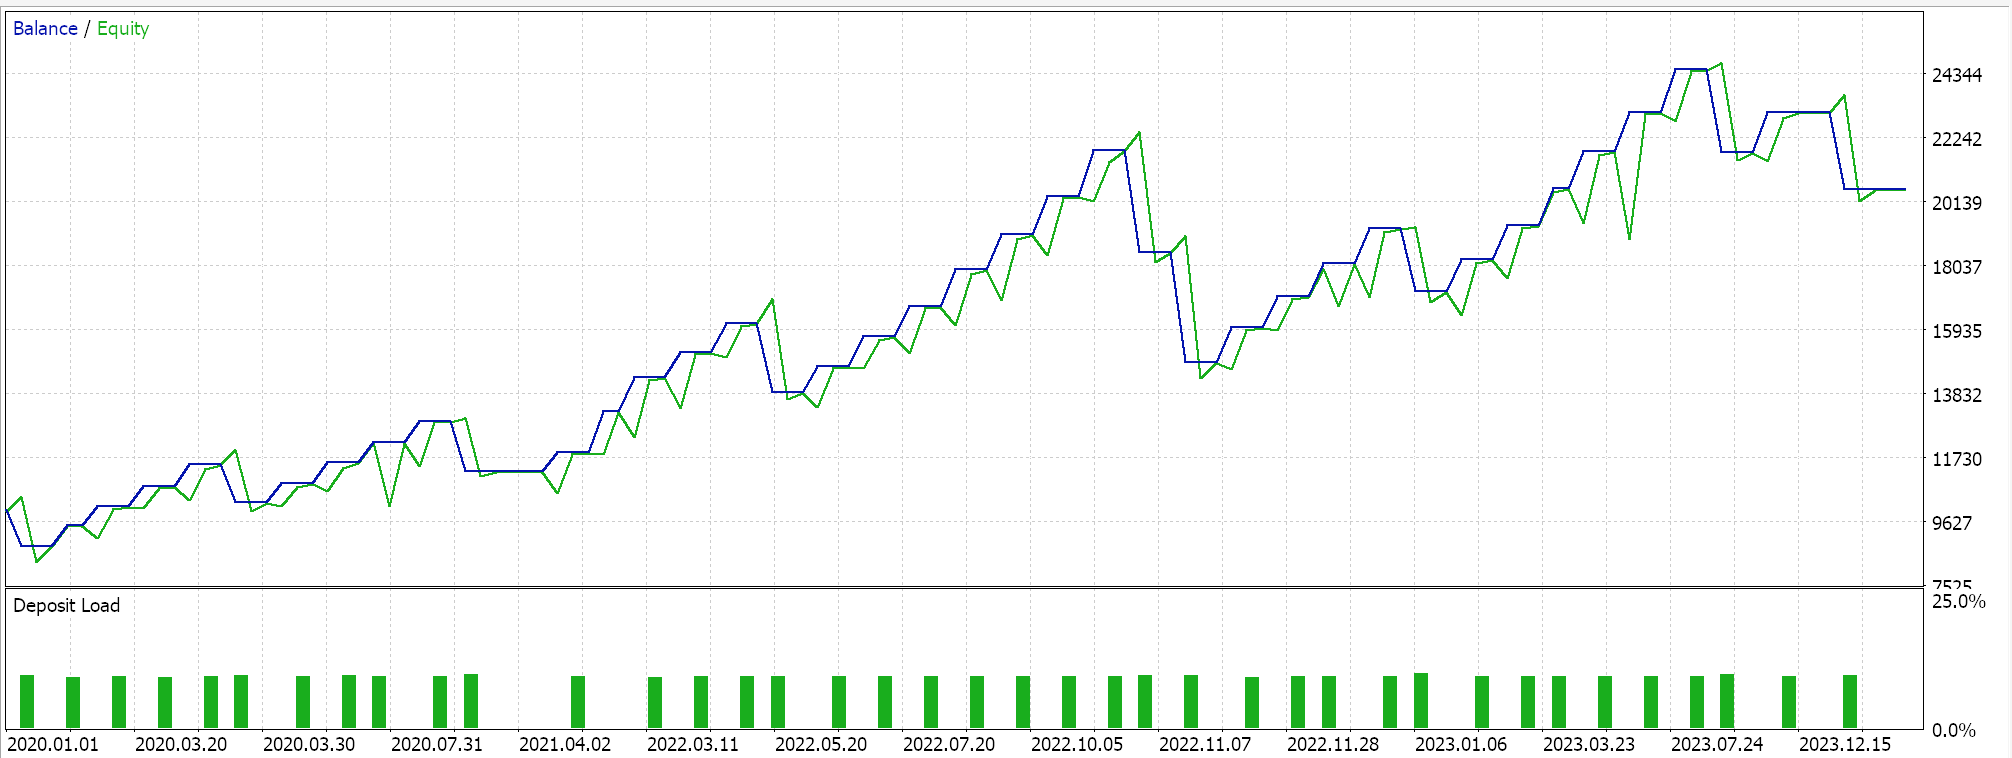
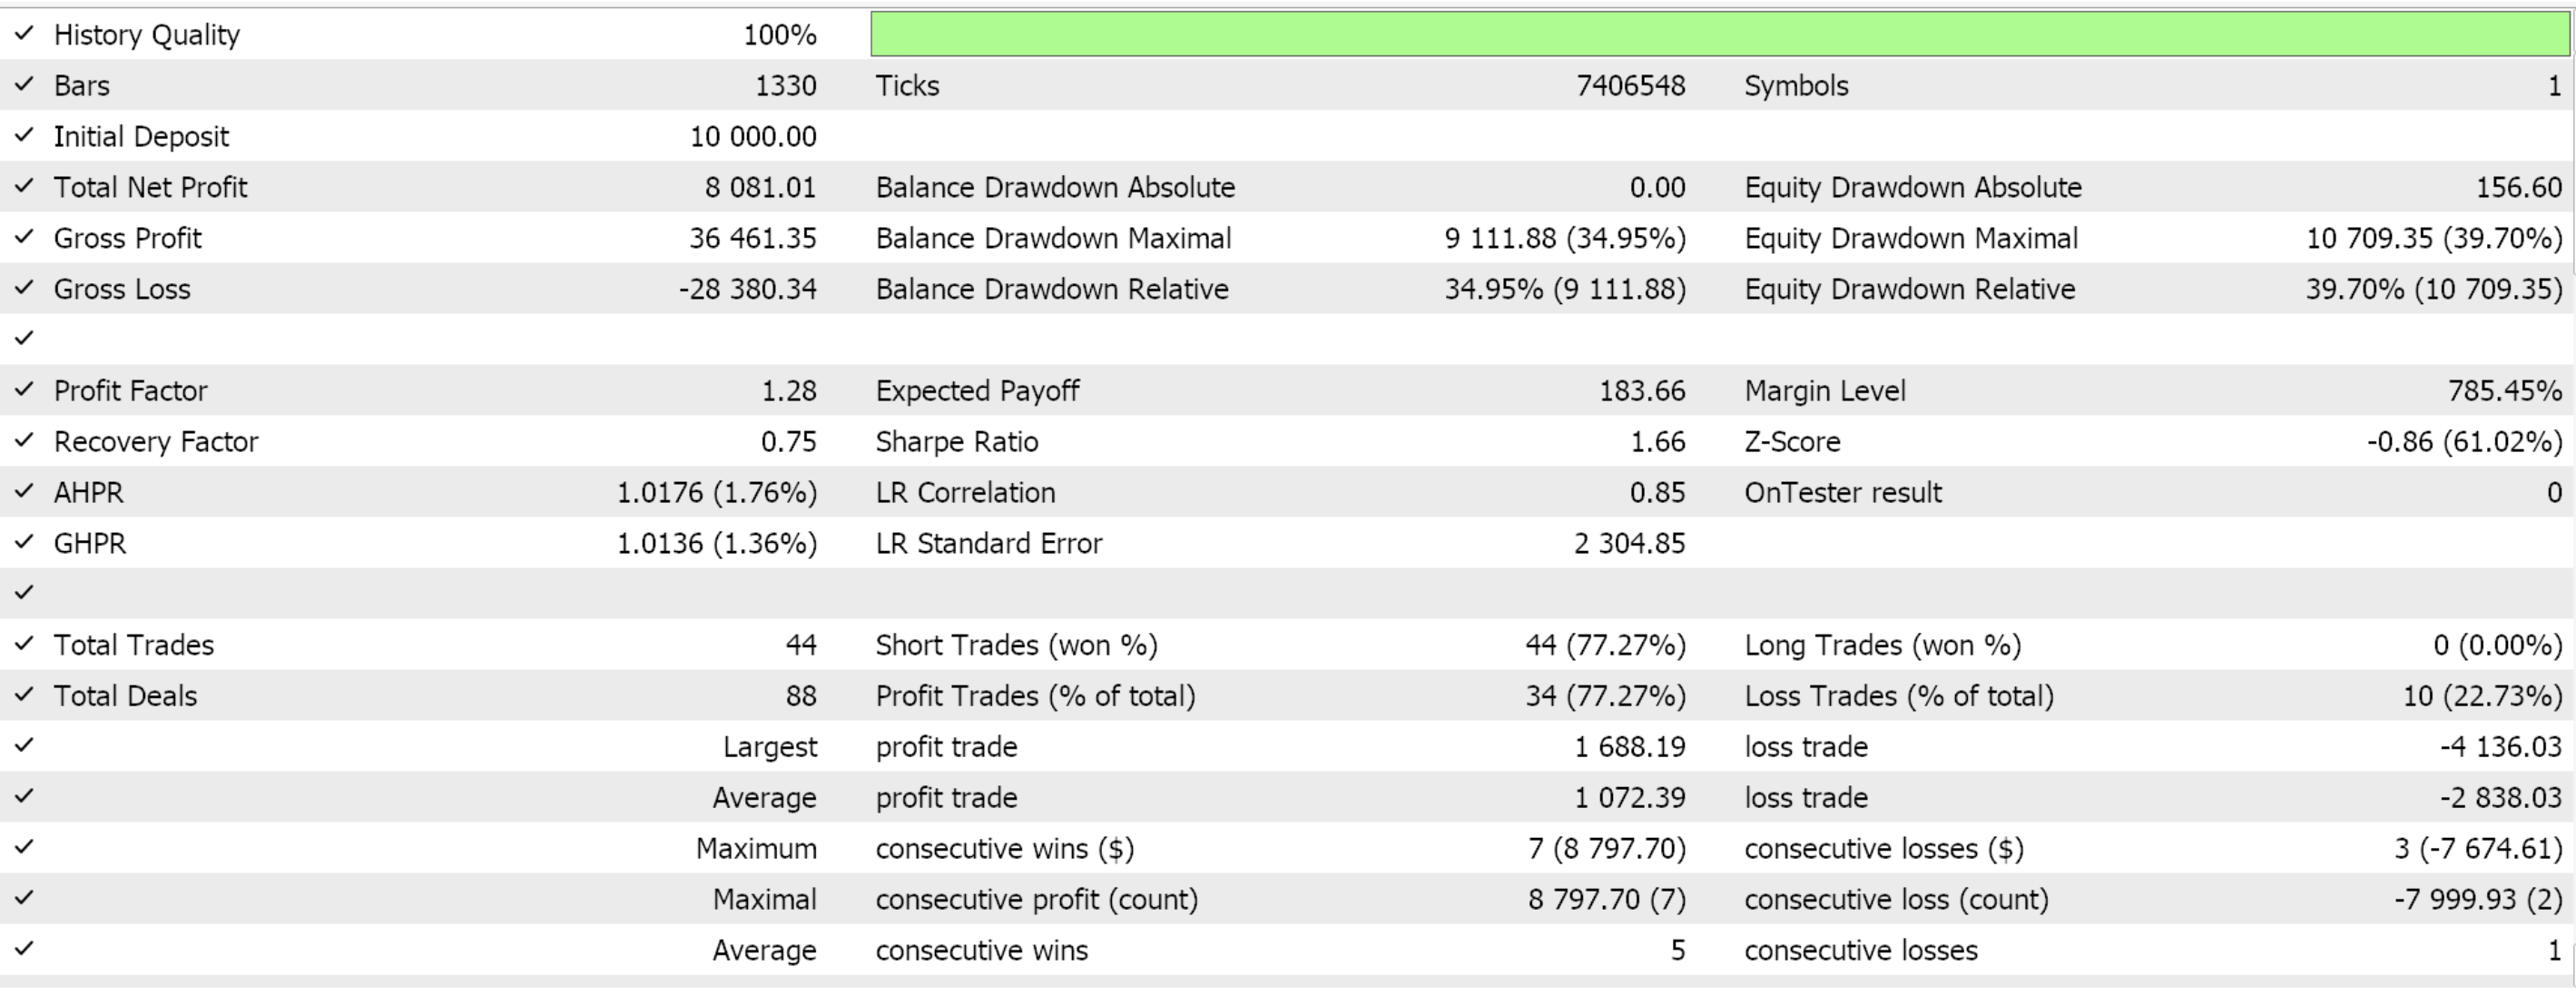
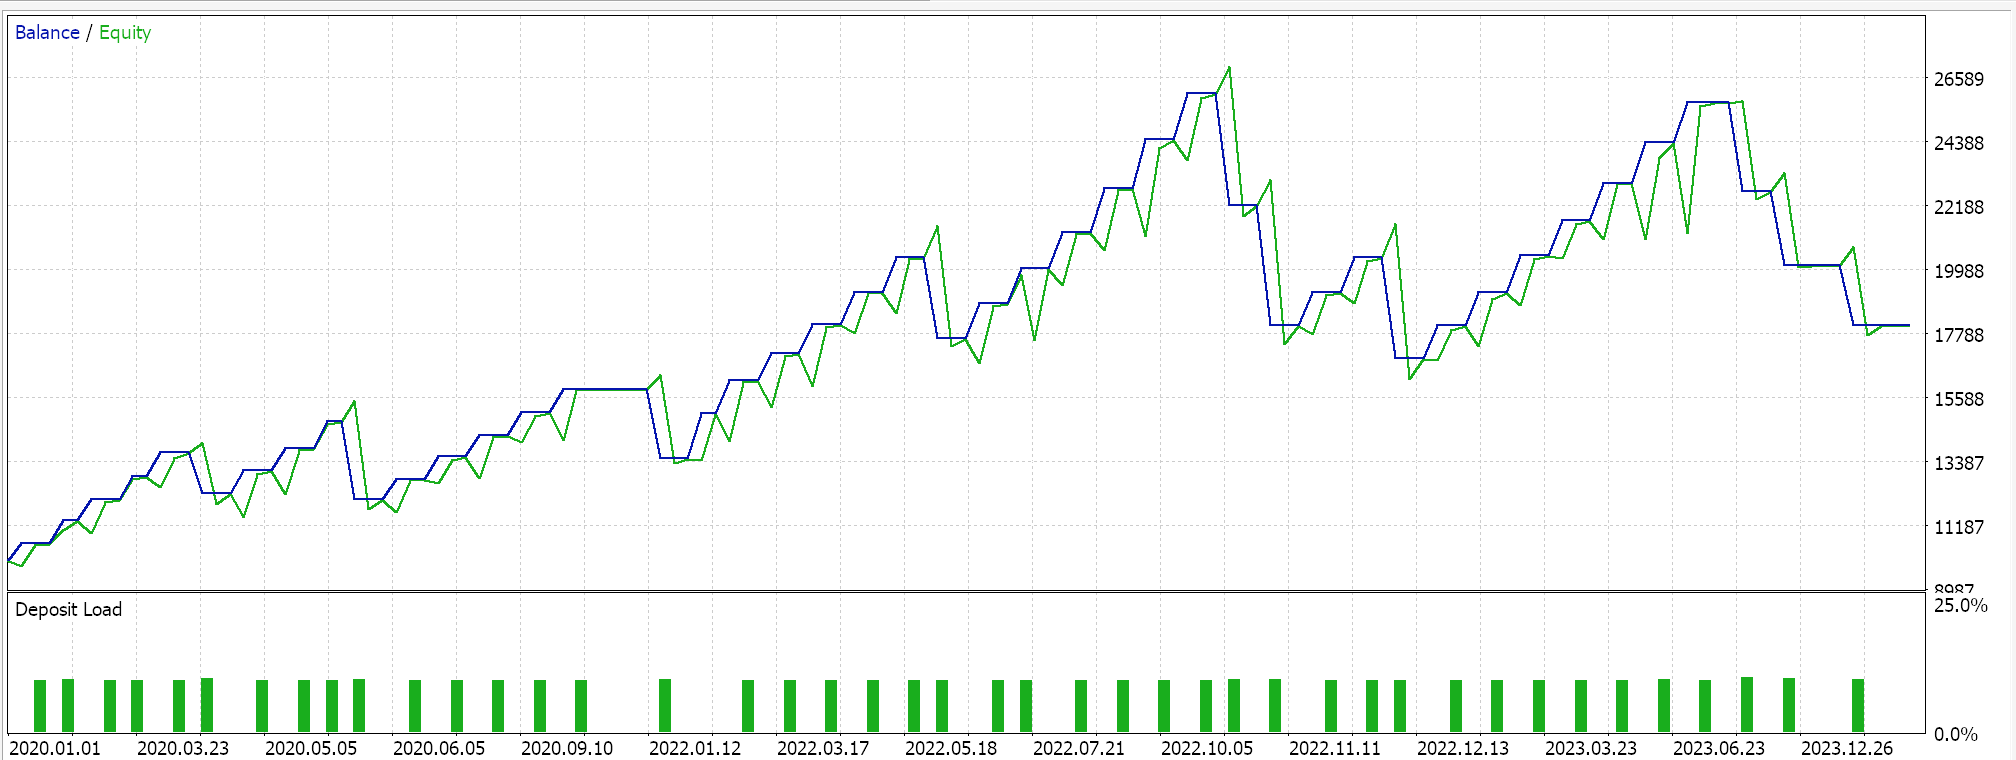
Se considerarmos que o período de forward walk corresponde apenas ao ano de 2024, apenas os padrões 2 e 3 conseguiram avançar no forward walk Como sempre, há diversos fatores envolvidos, e recomenda-se uma análise independente antes de utilizar qualquer código ou material compartilhado nestes artigos. Para montar e utilizar Expert Advisors como o empregado nos testes acima, é necessário utilizar os arquivos do código anexado juntamente com o Assistente MQL5. Para novos leitores, há orientações aqui e aqui sobre como realizar esse processo.
Conclusão
Damos continuidade ao artigo anterior, no qual vimos como um modelo de aprendizado supervisionado que utiliza como entradas os padrões do ADX e do CCI pode ser desenvolvido e incorporado a um Expert Advisor. Neste artigo, utilizamos os mesmos indicadores, porém aplicados ao aprendizado por reforço. O aprendizado por reforço busca tornar o Expert Advisor desenvolvido anteriormente mais robusto, ampliando de maneira cautelosa sua janela de aprendizado.
O artigo de síntese previsto deveria abordar inferência. Entendemos inferência aqui como uma forma de resumir e “arquivar” o que foi aprendido. Exemplos dessa abordagem podem ser encontrados neste artigo. No entanto, deixaremos a utilização da inferência a cargo do leitor, pois retornaremos a um formato de artigo mais simples, no qual apresentaremos, de forma alternada, algumas ideias relacionadas ao aprendizado de máquina.
| Nome | Descrição |
|---|---|
| wz_62.mq5 | Expert Advisor montado pelo Assistente MQL5, cujo cabeçalho mostra os arquivos incluídos |
| SignalWZ_62.mqh | Arquivo da classe de sinais personalizada. |
| 61_2.onnx | Modelo ONNX de Aprendizado Supervisionado do Recurso-2 |
| 61_3.onnx | Modelo ONNX de Aprendizado Supervisionado do Recurso-3 |
| 61_4.onnx | Modelo ONNX de Aprendizado Supervisionado do Recurso-4 |
| 62_policy_2.onnx | Recurso-2 Ator de Aprendizado por Reforço |
| 62_policy_3.onnx | Recurso-3 Ator de Aprendizado por Reforço |
| 62_policy_4.onnx | Recurso-4 Ator de Aprendizado por Reforço |
| 62_value_2.onnx | Recurso-2 Crítico de Aprendizado por Reforço |
| 62_value_3.onnx | Recurso-3 Crítico de Aprendizado por Reforço |
| 62_value_4.onnx | Recurso-4 Crítico de Aprendizado por Reforço |
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/17938
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.
 Caminhe em novos trilhos: Personalize indicadores no MQL5
 Técnicas do MQL5 Wizard que você deve conhecer (Parte 61): Uso de padrões do ADX e CCI com aprendizado supervisionado
 Está chegando o novo MetaTrader 5 e MQL5
 Desenvolvimento do Kit de Ferramentas de Análise de Price Action (Parte 21): Detector de Inversão da Estrutura de Mercado

- Aplicativos de negociação gratuitos
- 8 000+ sinais para cópia
- Notícias econômicas para análise dos mercados financeiros
Você concorda com a política do site e com os termos de uso