

初級から中級まで:ファイル内データへのランダムアクセス(I)
 13
 0

はじめに
前回の「初級から中級まで:FileSaveとFileLoad」では、FileLoadとFileSaveというライブラリ関数を紹介しました。特定の操作が煩雑になることがあるため、多くの開発者はこれらの関数をある程度制限のあるものと考えていますが、ログファイルを生成する場合には非常に便利です。ログファイルについてあまりご存じない方のために説明すると、ログファイルは、特定の状況でコードがどのように動作するのかを理解するのに役立つものであり、開発者にとって非常に便利なツールです。
とはいえ、FileSave関数とFileLoad関数は、主にファイルデータへのアクセスを順次おこなう実装を想定しています。これは、これらの関数がどのように動作するかによるものです。開発者はファイルにランダムアクセスする必要があることも多いのですが、FileLoadとFileSaveでこれをおこなう場合、ファイル全体をメモリに読み込んでから再度保存するという、間接的な方法しかありません。
したがって、ランダムアクセスをエミュレートすることはできますが、通常の意味でランダムアクセスが実際におこなわれているわけではありません。この場合の目的は、ファイルの必要な部分だけを小さなブロック単位で読み込むことです。大容量のファイルを保持できるほどメモリが安価になった現在では、これは不要に思えるかもしれません。しかし、ファイルの特定の断片だけを処理したり、その部分にアクセスしたりする必要がある多くの場面では、非常に役立ちます。
ファイル内データへのランダムアクセス(パート1)
さまざまなプログラミング言語のドキュメントを調べ、組み込みの関数や手続きを確認し、特にファイル処理に関するセクションに注目してみると、実際に必要になる可能性が高いものよりも、はるかに多くの機能が提供されていることに気づくでしょう。一方、C++のように、ファイルを扱うための関数やプロシージャが非常に少ない言語もあります。
しかし、C++には拡張可能なI/O機能があり、これを他の用途にも適用できます。そのため、I/Oストリーム演算子をベースにした、より表現力豊かな構文を利用できます。MQL5にも同様の機能がありますが、これについては今後の記事で取り上げることにします。今は基本にとどめておきましょう。あまり早い段階から物事を複雑にする必要はないからです。
MQL5のドキュメントを確認すると、ファイルへのデータの読み込みと書き込みの両方を目的とした、さまざまな関数やプロシージャが数多く用意されていることに気づくでしょう。最もシンプルな関数はFileLoadとFileSaveで、これらについては前回の記事で紹介し、詳しく説明しました。しかし、この記事の冒頭ですでに述べたように、これらの関数はファイルの内容へのランダムアクセスを目的としたものではありません。そのため、MQL5のドキュメントには、ファイルの内容へのランダムアクセスを行うための関数が他にもいくつか用意されています。
これは、ドキュメントに非常に多くの異なる関数が記載されている理由の一つを説明しています。しかし、それだけでは、これらの関数をどのように使えばよいのか、またユーザー定義型をどのように扱えばよいのかまでは分かりません。そうです、読者の皆さん。プログラマーである皆さんは、プログラミング言語によってあらかじめ定義された型だけを扱うことに限定されているわけではありません。MQL5のような優れたプログラミング言語では、特定の状況に合わせてカスタマイズした独自の型を作成できます。これは少し特殊なことに思えるかもしれないので、私が何を言っているのか、まだ十分に理解できないかもしれません。
しかし、本連載の別の記事でtemplateとtypenameについて説明した際、まさにそれを行っていました。つまり、特定の問題に合わせてカスタマイズした型を作成していたのです。また、共用体(union)や構造体(struct)を使って、特殊なデータのための抽象化を構築することもできます。
そこで、これからの説明を簡潔にするために、意図的にいくつかの制約を設けることにします。ここでの目的は、特定の操作をできるだけ明確に示すことです。そのため、MQL5のドキュメントに記載されているすべてのファイル処理関数を説明する必要はなく、一つのモデリング手法に焦点を当てることにします。
ここで紹介する方法を、決して唯一の方法だと考えないでください。状況によっては、MQL5標準ライブラリに用意されている関数やプロシージャを使うことが、特定の種類のタスクを解決する最も適した方法になるでしょう。その場合は、別の解決法を回り道で実現するより、より直接的に処理できるからです。
それでも、ここでは利用可能な関数のごく一部だけを使用します。ただし、だからといって、MQL5標準ライブラリのより具体的な操作を理解するために、ほかの関数やプロシージャを試してみることをためらわないでください。ですから、ここで示した方法だけにとらわれず、それ以外の可能性についても考えてみてください。同じ結果を得る方法は、多くの場合、いくつもあります。そして、あるプログラマーにとって理解しやすい方法が、別のプログラマーにとっても理解しやすいとは限りません。それでは、以下に示すコードから始めましょう。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     int handle;
07.
08.     if ((handle = FileOpen("Hello.txt", FILE_WRITE)) == INVALID_HANDLE)
09.     {
10.         Print("Error...");
11.         return;
12.     };
13.     FileWrite(handle, "This file was created by a script written in MQL5.");
14.     FileWrite(handle, "New information is being added to the file.");
15.     FileWrite(handle, "Version FileWrite...");
16.     FileWrite(handle, "Checking writing values [", 1, "]-[", M_PI, "]");
17.
18.     FileClose(handle);
19.
20.     Print("Success");
21. }
22. //+------------------------------------------------------------------+
コード01
コード01を実行すると、ファイルが適切なランタイムのサンドボックスフォルダに作成されることが確認できます。読者の皆さんであれば、どのファイルが対象なのか、そしてそのファイルがどこに作成されるのかを理解するのに、何も問題はないと思います。しかし、ファイルの内容について、一つ特に重要な点があります。ここからが興味深いところです。
次の点に注目してください。コード01では、08行目でファイルを書き込みモードで開くように指定しています。操作が成功すると、変数には有効なハンドルが格納され、このハンドルを使ってファイルを操作できるようになります。ここまでは、すべて非常に簡単です。実際、あまりにも簡単なので、ファイル操作が完了したことを示すために、18行目でファイルを閉じ、ハンドルを解放して、ほかの用途に使用できるようにしています。しかし、本当に注目したいのは、13行目から16行目までのコードです。この部分で、ファイルにデータを書き込んでいます。
読み込みをどのように行うのかを見る前に、まずは書き込み操作について確認しておきましょう。これは、最初に思う以上に重要な意味を持っています。
ファイルに何を書き込みたいのかは、はっきりと分かります。内容はすべて非常にシンプルで、理解しやすいものだからです。それでも、ここで一つ疑問が生じます。実際には、ファイルの中に何が保存されているのでしょうか。この疑問に答えるために、以下に示すファイルの内容を見てみましょう。
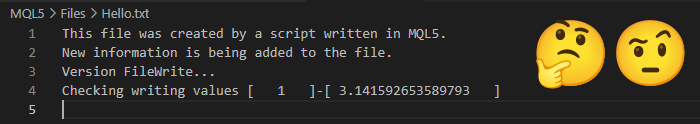
図01
図01は、データをファイルに書き込んだ結果を示しています。「なるほど。でも、この内容は少し変に見えますね。」では、図01と同じファイルを、今度はバイナリ形式で見てみましょう。以下のようになります。
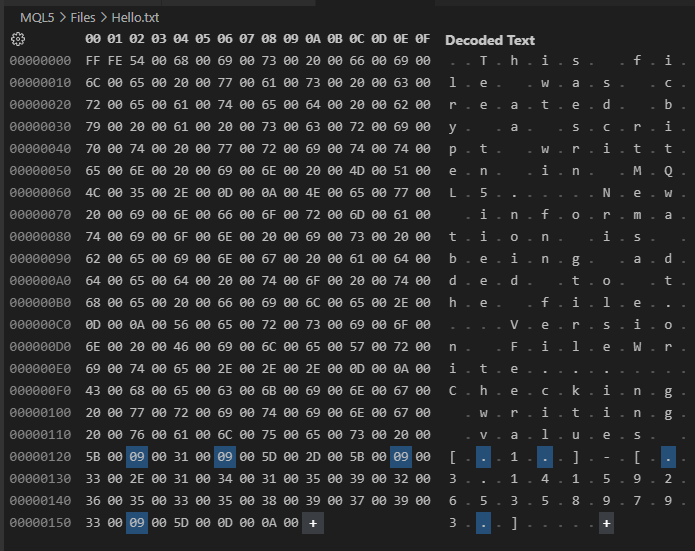
図02
ここで注目してください。図02の内容は、図01の内容とまったく同じものです。ただし、図02では、コード01によってファイルに書き込まれたすべてのバイトを確認できます。図02から分かる重要な点があります。これは、ファイルをランダムアクセスで読み込んだときに正しい値を取得できるか、それともまったく正しくない値を取得してしまうかを左右する可能性があります。
図01とコード01を見れば分かるように、ファイルの先頭に何かを指定したわけではありません。それにもかかわらず、図02に示されたファイルの先頭には、意味がよく分からない2つの奇妙なバイトがあります。これらのバイトはファイル形式を示すものであり、今回の説明には関係しません。また、コード01を見ても、これらがどこかで明示的に指定されているわけではないことがはっきり分かります。しかし、それ以外にも、コード01には登場していない文字が含まれています。それが、キャリッジリターンとラインフィードの文字です。
同じ図02では、いくつかのバイトが強調表示されています。なぜでしょうか。これらはタブ区切りとして挿入されたもので、コード01の16行目で書き込まれた値の間隔を空けています。これらのタブ文字が持つ意味を理解することは非常に重要です。書き込む内容の種類、そして何よりも、そのファイルを何のために作成するのかによっては、これらの余分な文字が、後からファイルを正しく読み込むことを不可能にしてしまう場合があります。このような文字が存在するとは予想していないかもしれません。しかし、これらの文字が、読み込み時に使用するインデックスの仕組みに影響を与えてしまう可能性があります。
「分かりました。コードに書かれている内容が、ファイルに書き込まれる際には、必ずしもまったく同じ形で表現されるわけではない、ということですね。でも、これは常にそうなのでしょうか。」それは状況によります。コード01を、以下に示すコードのように変更すると、結果はまったく異なるものになる可能性があります。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     int handle;
07.
08.     if ((handle = FileOpen("Hello.txt", FILE_WRITE | FILE_ANSI)) == INVALID_HANDLE)
09.     {
10.         Print("Error...");
11.         return;
12.     };
13.     FileWrite(handle, "This file was created by a script written in MQL5.");
14.     FileWrite(handle, "New information is being added to the file.");
15.     FileWrite(handle, "Version FileWrite...");
16.     FileWrite(handle, "Checking writing values [", 1, "]-[", M_PI, "]");
17.
18.     FileClose(handle);
19.
20.     Print("Success");
21. }
22. //+------------------------------------------------------------------+
コード02
ここで注目すべきは、コード01とコード02の唯一の違いは、FileOpenに渡している追加のフラグだけです。そして、この単純な変更だけで、コード02がファイルを作成すると、どのようなことが起こるでしょうか。以下の図03と図02を比較すると、その違いが分かります。
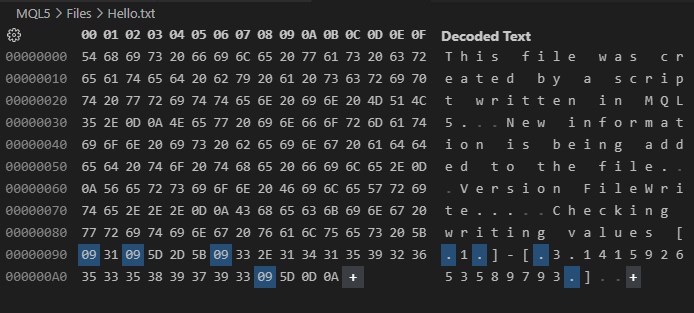
図03
「すごいですね。コードを少し変更しただけでは、結果にはそれほど大きな影響はないと思っていました。」実際に試して観察してみなければ、本当の意味では理解できないことがあります。今見た動作も、その一例です。だからこそ、ここで扱っている内容を実際に試し、少し異なる方法で応用してみることをお勧めします。そして何よりも、コードの特定の要素を変更したときに何が起こるのかを確認してみてください。
では、この話を続けましょう。図03に示されている結果は、コード02を見たときに私たちが期待する内容に、かなり近くなっていることに注目してください。それでも、タブ、キャリッジリターン、ラインフィードの文字はまだ残っています。なぜこのようになるのでしょうか。その理由は、ファイルがバイナリモードで書き込まれていないからです。
いずれにしても、ここでコードに小さな変更を加えてみましょう。これによって、ファイル内の特定の位置から読み込めるようになります。これは、バイナリファイルへの書き込みに進む前に、理解しておく必要がある一つの小さな点を確認するためです。
バイナリモードをいつ使用し、通常のテキストモードをいつ使用するのかを理解していなければ、実際の実装のさまざまな段階で適切な選択をすることはかなり難しくなります。
ここで示したいことを明確に確認するために、新しいコードを用意する必要があります。そのコードを以下に示します。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     int handle;
07.
08.     if ((handle = FileOpen("Hello.txt", FILE_WRITE | FILE_READ | FILE_ANSI)) == INVALID_HANDLE)
09.     {
10.         Print("Error...");
11.         return;
12.     };
13.     FileWrite(handle, "This file was created by a script written in MQL5.");
14.     FileWrite(handle, "New information is being added to the file.");
15.     FileWrite(handle, "Version FileWrite...");
16.     FileWrite(handle, "Checking writing values [", 1, "]-[", M_PI, "]");
17.
18.     FileFlush(handle);
19.
20.     FileSeek(handle, 0, SEEK_SET);
21.     while (!FileIsEnding(handle))
22.         Print(FileReadString(handle));
23.
24.     FileClose(handle);
25. }
26. //+------------------------------------------------------------------+
コード03
コード03では、コード02と同じようにファイルへ書き込めるだけでなく、ファイルの内容を読み込むこともできます。ここから先の内容を理解するためには、まずコード03を実行すると何が起こるのかを理解しておく必要があります。
基本的には、図03に示されているファイルが書き込まれます。ファイルに実際に期待どおりの情報が含まれていることを確実にするため、18行目でバッファの内容をディスクへフラッシュします。18行目の操作は、場合によっては必要ないこともあります。オペレーティングシステムがディスクの読み書き処理でどの程度忙しいかによっては、13行目から16行目で行った書き込みがすぐにディスクへ反映されることがあります。しかし、常にそうなるとは限りません。ここでは、ファイルを閉じてから再び開き、保存されたデータを読み込むという方法を取りたくありません。そのため、18行目では、このライブラリ関数を使ってデータを強制的にすぐファイルへフラッシュしています。
さて、これで、ファイルには図03に示されているデータが含まれていると、かなり確信を持ってよいでしょう。では、読み込みに進みます。現在、ファイルポインタはファイルの末尾に位置しています。そのため、まず別の位置へ移動させる必要があります。今回は、ファイルの先頭を指すようにします。そのために使用するのが20行目です。ここでは、読み書き用のポインタをファイルの先頭へ移動させています。ここは重要なので、よく注意してください。これからおこなう読み込みは、バッファの内容からおこなわれるのではなく、ディスク上のファイルそのものからおこなわれます。
書き込みと読み込みには、同じ原則が当てはまります。21行目に示されている読み込み関数を使用できます。この場合、ファイルの末尾に到達するまで読み込みが続きます。ここで本当に注目したいのは、22行目が何をしているのかという点です。この行では、ファイルから読み込んだ内容をMetaTrader 5のターミナルに出力するよう、アプリケーションに指示しています。ここが今回、最も重要な部分です。
では、ここで注目してください。今回のケースでは、4行を書き込みました。これは図01で確認できます。したがって、当然ながら、コード03の22行目が実行されたときには、図01と同じようなターミナル出力になると予想するでしょう。しかし、MetaTrader 5のターミナルを確認すると、以下の図04のような結果が表示されます。
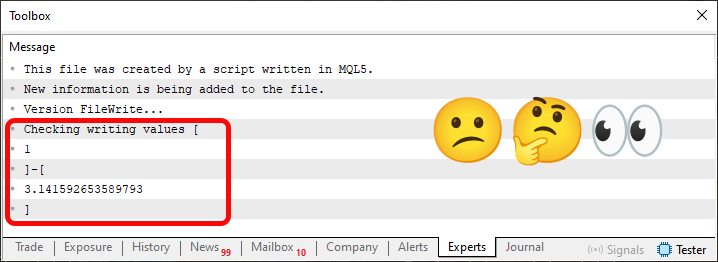
図04
「うーん、奇妙ですね。最初の3行は正しく表示されているようです。しかし、赤で示された部分には、予想していたものとは異なるデータが表示されています。とても不思議です。」一見すると予想外の結果に思えるかもしれません。しかし、実はこの結果は、今回の目的にとって非常に役立つものです。ここで改めてお伝えしておきたいのは、今回は可能な限り単純な方法で処理を行っているということです。つまり、多くの開発者が自然に試してみるであろう方法を使って、どのような結果になるのかを確認しています。そして、その方法では、最終的に期待したものとは異なる結果になることがあります。
この予想外の結果を引き起こしているのが、タブ文字です。「ちょっと待ってください。それで、なぜそんなことが起こるのでしょうか。」その理由は、今回の読み込みがバイナリモードではないということです。このモードでは、FileReadStringはキャリッジリターンとラインフィードの組み合わせ、またはタブ文字に遭遇すると、その時点で読み込みを停止します。詳しい動作については、ドキュメントを確認すれば分かります。ただし、ドキュメントではCSVファイルの使用について説明されています。今回のケースはそれとは異なります。ここで扱っているファイルの内容は、CSV形式を表すことを目的としていないからです。
さて、ここにも学ぶべきことがあります。このような動作になるのは、ファイルの読み込みに使用するフラグの中で、読み込み時にデータをどのように解釈するかを指定していないためです。その結果、22行目の処理では、タブ文字が区切り文字として扱われてしまいます。したがって、この問題を解決するには、もう一度コードを変更する必要があります。次に示すバージョンを使用してみましょう。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     int handle;
07.
08.     if ((handle = FileOpen("Hello.txt", FILE_WRITE | FILE_READ | FILE_ANSI | FILE_TXT)) == INVALID_HANDLE)
09.     {
10.         Print("Error...");
11.         return;
12.     };
13.     FileWrite(handle, "This file was created by a script written in MQL5.");
14.     FileWrite(handle, "New information is being added to the file.");
15.     FileWrite(handle, "Version FileWrite...");
16.     FileWrite(handle, "Checking writing values [", 1, "]-[", M_PI, "]");
17.
18.     FileFlush(handle);
19.
20.     FileSeek(handle, 0, SEEK_SET);
21.     while (!FileIsEnding(handle))
22.         Print(FileReadString(handle));
23.
24.     FileClose(handle);
25. }
26. //+------------------------------------------------------------------+
コード04
ここで注意してください。すでに説明したとおり、コードの変更が必要なのは1か所だけです。それが、コード04の08行目です。それだけの変更ですが、結果は図04に示したものとは大きく異なります。今回、コード04を実行すると、ターミナルには次のように表示されます。
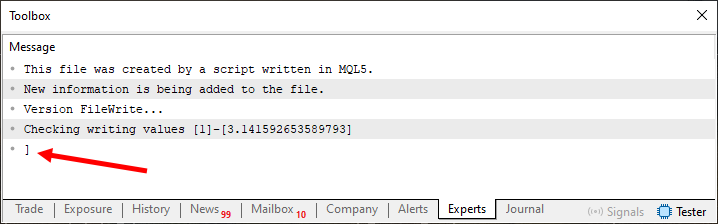
図05
この場合、出力結果は、書き込み処理から期待していた内容に非常に近くなっていることに注目してください。もちろん、図05から分かるように、小さな問題が一つ残っています。しかし、これは二次的な問題です。というのも、今回の目的は達成できたと考えられるからです。ここでの目的はまさに、ファイルを読み込むことで、コード04の13行目から16行目に書かれているテキストと非常によく似た内容を取得することでした。
これで目的が達成され、その結果も視覚的に確認できました。それでは、次にバイナリ形式での読み込みと書き込みへ進みましょう。これによって、ファイルの内容へのランダムアクセスについても扱えるようになります。ただし、今回書き込んで読み込んでいる内容は通常のテキストに近いため、バイナリ操作やランダムアクセスが実際にどのように行われるのかを、明確かつ簡単に示すにはあまり適していません。このテーマを理解するための最初のステップとして、扱う内容をもう少し単純なものに変更する必要があります。そのために使用するのが、以下に示すコードです。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     int handle;
07.
08.     if ((handle = FileOpen("Hello World.txt", FILE_WRITE| FILE_READ | FILE_BIN)) == INVALID_HANDLE)
09.     {
10.         Print("Error...");
11.         return;
12.     };
13.     for (uchar c = 0; c < 10; c++)
14.         FileWriteInteger(handle, c, CHAR_VALUE);
15.
16.     FileFlush(handle);
17.
18.     FileSeek(handle, 0, SEEK_SET);
19.     Print("The byte value of the ", FileTell(handle), " position in the file is ", FileReadInteger(handle, CHAR_VALUE));
20.
21.     FileClose(handle);
22. }
23. //+------------------------------------------------------------------+
コード05
コード05を実行すると、14行目で行っているように、0から9までの値が書き込まれたファイルが作成されます。しかし、ここには一つ小さな点があります。そして、この点をしっかり理解することが非常に重要です。書き込みをおこなう際、書き込む値の型としてCHAR_VALUEを指定していることに注目してください。これは非常に重要なことです。なぜなら、この関数はデフォルトではINT_VALUE型の値を書き込むからです。「でも、なぜこれが重要なのでしょうか。」その重要性を理解するには、まず共用体がどのように機能するのかを理解する必要があります。
本連載では、共用体についてすでに2本の基本的な記事を公開しています。そのうちの一つが「初級から中級まで:共用体(I)」です。これに加えて、配列の扱い方についても理解しておく必要があります。これについても、本連載の別の記事で説明しています。前の記事で説明した必要な知識がすべて身についていることを前提として、コード05を実行すると、なぜ以下のような結果になるのかを考えてみましょう。
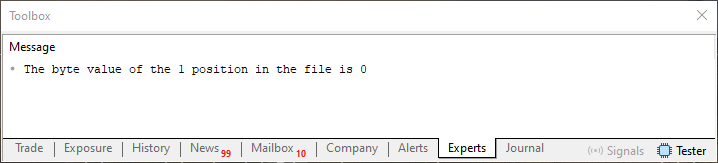
図06
コード05の19行目を実行すると、図06に示されているような内容が表示されます。では、ターミナルに出力されたこのメッセージには、どのような意味があるのでしょうか。ご覧のように、このメッセージには2つの数値が表示されています。最初の値は、ファイル内の現在の位置を示しています。2番目の値は、その特定の位置にあるデータの内容を示しています。ここは、よく注意してください。この読み込み関数を使う場合、ファイルは配列として扱う必要があります。言い換えれば、これはインデックスが自動的に増加していく配列のようなものです。また、この配列内のインデックスを指定することもできます。それをおこなっているのが18行目です。
配列のカウントがインデックス0から始まるのと同じように、ファイル内のデータにアクセスするときも、インデックスは0から始まります。ただし、配列の範囲外のインデックスを指定した場合とは異なり、ファイルを扱う場合、システムは常にインデックスを有効な位置に設定します。これを理解するために、コード05を実際に試してみてください。18行目の関数で使用されている0という値を、別の値に置き換えてみましょう。そして、結果を確認してください。これによって、データへのアクセスがどのように行われるのかを理解しやすくなるはずです。
しかし、ここではもう一つ理解しておく必要がある点があります。FileReadIntegerでもCHAR_VALUEが使用されていることに注目してください。これは、1バイトだけを読み込みたいからです。通常であれば4バイトが読み込まれるため、ファイル内のインデックス、つまり位置も、その4バイト分だけ進むことになります。ここで説明している細かな点には、十分に注意してください。まさにこのため、共用体の仕組みを理解しておくと、このような方法でファイルのデータにアクセスする処理を理解するうえで大いに役立ちます。
次に進む前に、コード05を十分に試してみてください。どのように動作するのかを完全に理解するまで、何度も実行してみましょう。つまり、ファイルとは、ディスク上に保存された配列にほかならないということを理解できるところまで進めてください。この考え方をしっかり身につければ、この先で行う処理も、ずっと理解しやすくなるでしょう。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     int handle;
07.
08.     if ((handle = FileOpen("Hello World.txt", FILE_WRITE| FILE_READ | FILE_BIN)) == INVALID_HANDLE)
09.     {
10.         Print("Error...");
11.         return;
12.     };
13.     for (uchar c = 0; c < 10; c++)
14.         FileWriteInteger(handle, c, CHAR_VALUE);
15.
16.     FileFlush(handle);
17.
18.     FileSeek(handle, 4, SEEK_SET);
19.     FileWriteInteger(handle, 45, CHAR_VALUE);
20.
21.     FileFlush(handle);
22.
23.     FileSeek(handle, 4, SEEK_SET);
24.     Print("The byte value of the ", FileTell(handle), " position in the file is ", FileReadInteger(handle, CHAR_VALUE));
25.
26.     FileClose(handle);
27. }
28. //+------------------------------------------------------------------+
コード06
次に、コード06を見てみましょう。ご覧のとおり、コード05と非常によく似ています。ただし、ここではコード05よりも少し踏み込んだことを行っています。ファイルへの書き込みを、完全なランダムアクセスによって行っているのです。ここで、もし「配列」と「ファイル」が同じようなものだという考え方をまだ十分に理解できていないと、少々やっかいな落とし穴があります。コード06では、通常の配列では不可能な操作をおこなっているからです。少なくとも、一般的な方法で配列を扱っている場合には、そのような操作はできません。
コード06を詳しく見る前に、まず実行結果を確認してみましょう。
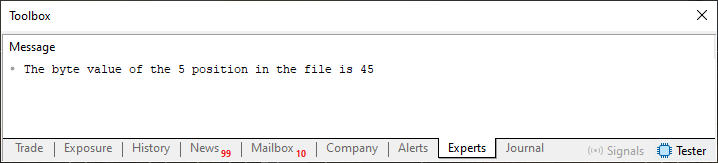
図07
さて、ここからが最も興味深いところです。図07のメッセージがどのようにして得られたのかを理解してみましょう。まず、コード06でコード05から変更されているのは、18行目と19行目だけであることに注目してください。この2行を使って、ファイル内の特定の位置にある値を変更しています。これは、配列の特定の要素に新しい値を代入するのと同じことです。ここまでは非常に簡単に理解できます。指定した位置が、13行目のループによって作成された範囲内にあるからです。
ところが、位置をあらかじめ作成しておかなくても、同じことができます。より正確に言えば、値を代入する前に、すべての位置をあらかじめ確保しておく必要はありません。ここで扱っているのはファイルだということを思い出してください。この場合、現在のファイルの末尾よりもはるか先の位置を指定しても、その操作は問題なく実行されます。
少し分かりにくく聞こえるかもしれません。しかし、実際には非常にシンプルです。18行目のFileSeek関数に指定している値を、13行目のループによって作成される10個の要素よりも大きな値に変更してみてください。たとえば14にします。また、23行目の値も、18行目で使用したものと同じ値に変更することを忘れないでください。このコードを実行すると、以下のような結果が得られます。
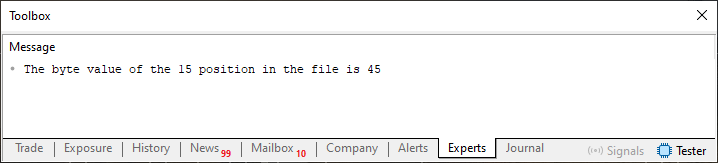
図08
「なんだか不思議ですね。私は、データはファイルに1バイトずつ、そして位置ごとに書き込まなければならないものだと、ずっと思っていました。では、すでに存在しているデータが何であっても、どこにでも書き込めるということですか?」確かに興味深い動作です。このような場面こそが、プログラミングを印象深く、面白いものにしてくれるのです。ただし、プログラミングを学び始めたばかりの人にとっては、少し分かりにくく感じられることもあるでしょう。
最後に
この記事では、初めてファイルの内容へのランダムアクセスについて取り上げました。もちろん、ここでそう言うのは、読者の皆様が、ファイルの扱いには実に多くの細かな点があることに、まだ気づいていないかもしれないことを前提としています。
今回の記事では、主にファイル内の任意の位置への書き込みに焦点を当てたため、ファイルそのものの内部でデータをインデックス化する際のいくつかの細かな点については説明する機会がありませんでした。そして、この問題は非常に重要なので、次の記事で扱うテーマとして自然につながります。ですから、この記事で説明した内容を、添付されているソースファイルを使って実際に試しながら学習し、しっかり身につけてください。それでは、次の記事でお会いしましょう。
| MQ5ファイル | 説明 |
|---|---|
| Code 01 | ファイルアクセスのデモ |
| Code 02 | ファイルアクセスのデモ |
| Code 03 | ファイルアクセスのデモ |
| Code 04 | ファイルアクセスのデモ |
MetaQuotes Ltdによりポルトガル語から翻訳されました。
元の記事: https://www.mql5.com/pt/articles/16246
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。

 機械学習におけるガウス過程(第2回):MQL5での分類モデルの実装とテスト
 エラー 146 (「トレードコンテキスト ビジー」) と、その対処方法
 人工原子アルゴリズム(A3)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索