

初級から中級まで:ランダムアクセス(II)
 20
 0

はじめに
前回の「初級から中級まで:ランダムアクセス(I)」では、ファイル内のデータを読み書きするためのランダムアクセスの仕組みについて簡単に紹介しました。 しかし、あまり多くの情報を一度に提示しないようにするため、ファイル関連の機能を実装する際に特に重要となる問題の一つについては、詳しく説明しませんでした。
ここから説明する内容には、ぜひ細心の注意を払ってください。この点を正しく理解することは、この記事で取り上げるほかの内容を理解すること以上に重要だからです。 ファイルにどのようなデータ型が格納されているのかを、必ずしも事前に把握しておく必要はありません。 多くの場合、ファイルには何らかの構造があり、その構造は形式によって異なります。 そして、その構造によって、使用するデータ型が大きく決まり、あるいは可能になります。言い換えれば、ファイルの構造を理解していれば、低レベルの読み書き操作を一つひとつ意識しなくても、適切なデータ型を使って処理できるのです。
少し奇妙に聞こえるかもしれませんが、実際には多くの場合、そのとおりに処理が行われています。 ごく特殊な状況を除けば、ファイル内の特定の位置にどのようなデータ型が格納されているのかを、正確に把握する必要はほとんどありません。 しかし、そのような状況に直面したときには、何をすべきかを理解していることが、想像以上に重要になります。 こうした仕組みへの理解が不十分だと、プログラマーは特定のファイル処理の問題を解決する際に、深刻な困難に直面する可能性があるからです。 そのため、読者の皆さんには、この記事で説明する一つひとつのポイントに注意を払っていただきたいと思います。ここで扱う内容を理解できるかどうかが、ファイルを正しく読み取れるか、それとも内容をまったく理解できないままになってしまうかを左右することもあるのです。
ファイルへのランダムアクセス(第2部)
共用体については、本連載のこれまでの記事でも、データ型と、それぞれの型が占めるバイト数に注意する必要があることを説明してきました。 こうした知識がなければ、特定のデータ型が実際に何を表しているのかを理解することは非常に困難です。
多くの開発者は、共用体を無視したり、使用そのものを避けたりする傾向があります。 しかし、構造体や配列となると、事情はまったく異なります。 これらの概念を十分に理解していなければ、特定のデータモデルを構築することは、ほぼ不可能といってよいほど難しくなる場合があります。日常的なプログラミングでは、共用体よりも構造体や配列のほうがはるかによく使われるためです。
とはいえ、多くの開発者は、やがてさらに難しい問題に直面します。 構造体、配列、共用体を組み合わせたデータモデルを扱う場合、問題は一段と複雑になります。 こうした状況では、それぞれの概念がどのように相互作用するのかを理解していなければ、実装はすぐに複雑で分かりにくいものになってしまいます。 そして、このようなデータモデルには、ランダムアクセスファイルが関係することもあります。
「読者を怖がらせようとしているのですか? ファイルがそこまで複雑になるとは思えません」しかし、実際にはそうとも限りません。 読者の皆さんは、ファイルが持つ複雑さを、まだ十分に理解していないのかもしれません。 ファイルは、プログラマーが作成・設計しうるデータ編成の方法の中で、間違いなく最も複雑なものです。 これは決して大げさな表現ではありません。新しいファイル形式が登場すると、通常は、その形式をどのように解釈すべきかを説明するドキュメントも用意されます。
ファイルの内部構造を説明するドキュメントがなければ、そのファイルが純粋なテキストベースでない限り、内容についてほとんど何も分からないでしょう。 内部形式の文書化が不可欠でないのは、おそらくこの場合だけです。 これを説明するために、最も簡単な例としてビットマップ(BMP)形式を取り上げてみます。 この形式については、ウェブ上でさまざまな資料が公開されています。BMPは、複雑な圧縮処理を必要とせずに画像を保存することを目的として設計された、非常にシンプルで実用的な形式です。
場合によっては、多少の圧縮がおこなわれることもありますが、今はその点を無視しても問題ありません。 ここで重要なのは、 ファイルに何が格納されているのかを、私たちが正確に理解しているかどうかということです。 たとえば、画像ファイルを16進エディタで開くと、次の図のような内容が表示されます。
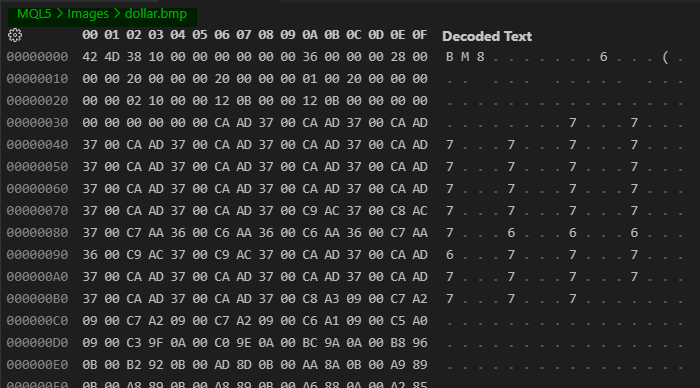
図01
図01をご覧ください。 興味深い点があることに気づくでしょう。 ファイルの内容が緑色で強調表示されています。 しかし、このデータを眺めるだけで、ファイルに何が含まれているのかを正確に判断できるでしょうか。特定のマーカーがファイル形式の識別に役立つことはありますが、それだけでは内容を完全に把握することはできません。 たとえば、このファイルの先頭にある3つの値に注目してください。 もちろん、別のプログラマーや別のアプリケーションが、まったく異なるファイル形式を表すために、同じ3つの値を使用することも可能です。 一般的なことではありませんが、それを禁止するものは何もありません。
とはいえ、そのようなケースが存在しないと仮定すれば、これはビットマップファイルだと推測できます。 したがって、ビットマップとして読み取る必要があります。 では、ここで質問です。ファイルの内部構造を説明するドキュメントがない状態で、このファイルからデータを抽出する方法が分かるでしょうか。 おそらく分からないでしょう。 その理由は、先頭の3つの値がBMP形式を示していることを除けば、生のデータを見ただけでは、ファイルが内部でどのように構成されているのかを判断するための情報がほとんど得られないからです。 したがって、ファイルの実際の内容を表示するためにどのプログラムを使えばよいのか分からなければ、そのファイルにどのような情報が含まれているのかを知ることはできません。
ファイルの関連付けも、基本的にはこのような仕組みに基づいています。 一見すると魔法のように思えるかもしれませんが、オペレーティングシステムはファイルヘッダーを確認し、 そのヘッダーやシグネチャに応じて、特定のアプリケーションと関連付けることがあります。 関連付けが設定されていれば、ファイルの内容を表示しようとしたときに、オペレーティングシステムは、そのヘッダーやシグネチャに対応するアプリケーションを起動します。 もちろん、ファイルの関連付けには、これ以外の要因が関係することもあります。 しかし、 今はその点について詳しく説明する必要はありません。
さて、ここまで説明してきたのは何のためでしょうか。 前回の記事では、FileSeekなどの関数やヘルパー関数を使って、ファイル内のデータを任意の位置から読み書きする方法を紹介しました。 ただし、そこで扱ったのは1バイトずつの読み書きでした。1バイトを読み取る、あるいは書き込むたびに、ファイル位置は1バイトずつ進みます。 しかし、常にそうなるのでしょうか。 この疑問に答えるには、ほかの記事で取り上げた内容にも触れる必要があります。たとえば、共用体、構造体、配列について説明したときのことを思い出してください。 これまでは、これらの概念を個別に、段階を追って学んできました。しかし、ここでは、それらをすべて同時に扱います。 その目的は、読み取りや書き込みを行うたびに、ファイル位置がどのように進むのかを理解することです。
それでは、図01のことはいったん忘れましょう。今の段階では、あの図は役に立ちません。 まずは、もっと単純でありながら、これから説明する内容に適した例から始める必要があります。 そのために、次のコードを使用します。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     int handle;
07.     const datetime dt = D'31.10.2024 15:30:10';
08.     const int i32 = 356248;
09.
10.     if ((handle = FileOpen("Hello World.txt", FILE_WRITE| FILE_READ | FILE_ANSI)) == INVALID_HANDLE)
11.     {
12.         Print("Error...");
13.         return;
14.     };
15.
16.     FileWrite(handle, i32, "Info", dt);
17.
18.     FileFlush(handle);
19.
20.     FileSeek(handle, 0, SEEK_SET);
21.     while (!FileIsEnding(handle))
22.         Print(FileTell(handle), " >> ", FileReadString(handle));
23.
24.     FileClose(handle);
25. }
26. //+------------------------------------------------------------------+
コード01
さて、コード01を実行すると、次の図に示すような内容のファイルが作成されます。
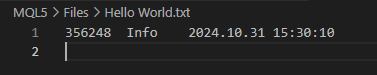
図02
また、同じコード01を実行すると、ターミナルには次のような出力も表示されます。
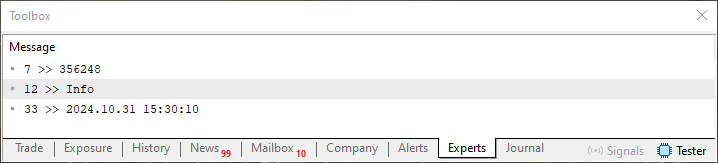
図03
ここからが、最も重要なポイントです。 図03をご覧ください。ファイルから読み取られた各値の前に、数値が表示されていることに注目してください。 この数値は、現在の値の読み取りが終わり、次の値の読み取りが始まる位置を示しています。 したがって、読み取り位置または書き込み位置の直前の値が分かっていれば、その間に何単位のデータが読み取られたのか、あるいは書き込まれたのかを特定できます。 「ちょっと待ってください。ここは『読み取られたバイト数』や『書き込まれたバイト数』と言うほうが正確ではないでしょうか?」いいえ、そうではありません。その理由は、これからすぐに分かるはずです。
それでは、1回の操作で何単位のデータが読み取られるのか、そして同じように、書き込みでは何単位のデータが処理されるのかを理解するために、コードを少し変更してみましょう。 ここでは読み取りのみを扱いますが、同じ原則は書き込みにも当てはまります。 では、次のコードを見ていきましょう。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     int     handle;
07.     ulong   old;
08.
09.     const datetime dt = D'31.10.2024 15:30:10';
10.     const int i32 = 356248;
11.
12.     if ((handle = FileOpen("Hello World.txt", FILE_WRITE| FILE_READ | FILE_ANSI)) == INVALID_HANDLE)
13.     {
14.         Print("Error...");
15.         return;
16.     };
17.
18.     FileWrite(handle, i32, "Info", dt);
19.
20.     FileFlush(handle);
21.
22.     FileSeek(handle, 0, SEEK_SET);
23.     while (!FileIsEnding(handle))
24.     {
25.         old = FileTell(handle);
26.         Print(FileTell(handle) - old, " || ", FileTell(handle), " >> ", FileReadString(handle));
27.     }
28.
29.     FileClose(handle);
30. }
31. //+------------------------------------------------------------------+
コード02
コード02を実行すると、次のような結果が得られます。
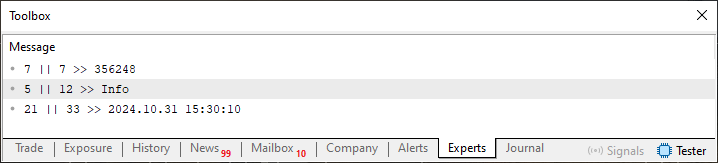
図04
コード02とその実行結果は分かりやすいものなので、次の段階に進みましょう。 ただし、読者の皆さんには、ここで次の点を理解しておいていただきたいと思います。 現時点で行っている読み取り処理では、ファイル内に格納された区切り文字を使って、システムが値を1つずつ読み取るようになっています。 今回の区切り文字はタブ文字です。次の図を見れば、そのことが分かります。
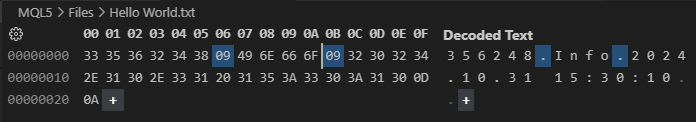
図05
図05では、タブ文字が強調表示されています。 では、コードを少し変更するとどうなるでしょうか。 これを確認するために、次のコードを使います。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     int     handle;
07.     ulong   old;
08.
09.     const datetime dt = D'31.10.2024 15:30:10';
10.     const int i32 = 356248;
11.
12.     if ((handle = FileOpen("Hello World.txt", FILE_WRITE| FILE_READ | FILE_ANSI | FILE_TXT)) == INVALID_HANDLE)
13.     {
14.         Print("Error...");
15.         return;
16.     };
17.
18.     FileWrite(handle, i32, "Info", dt);
19.
20.     FileFlush(handle);
21.
22.     FileSeek(handle, 0, SEEK_SET);
23.     while (!FileIsEnding(handle))
24.     {
25.         old = FileTell(handle);
26.         Print(FileTell(handle) - old, " || ", FileTell(handle), " >> ", FileReadString(handle));
27.     }
28.
29.     FileClose(handle);
30. }
31. //+------------------------------------------------------------------+
コード03
コード03を実行すると、次の画像に示すような結果が表示されます。
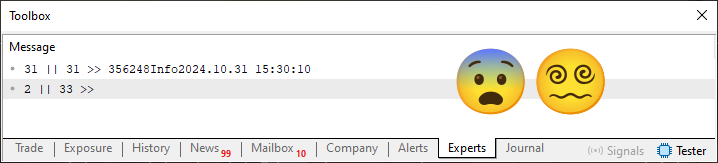
図06
「いったい何が起きたのでしょうか。 コードのどこが変わったせいで、こんな結果になったのか分かりません」さて、それは教えません。 どこが変更されたのか、自分でコードを調べて見つけてください。 ただし、ファイルのバイナリデータを確認すると、次の図のようになっていることが分かります。
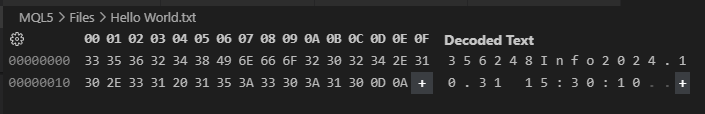
図07
「いったい何をしたのですか。 どこを変更したのか教えてください。」繰り返しになりますが、何を変更したのかを理解するには、自分でコードを確認する必要があります。 いずれにしても、以前とは結果が異なっていることは分かるはずです。 これは、ファイルそのものの形式を変更したためです。 アプリケーションがファイルの読み取り方法を正しく把握できなくなり、データを正しく読み戻せなくなった結果、出力がこのように乱雑になってしまったのです。
ここで、よく注意してください。この出力を正しく解釈するには、ある値がどこで終わり、次の値がどこから始まるのかを、何らかの方法でプログラムに伝える必要があります。 その方法はいくつもあります。 今回は、その数ある方法のうち、1つだけを取り上げます。 ケースごとに条件が異なるため、あらゆる状況に適用できる万能な解決策はありません。 とはいえ、先を急ぐ必要はありません。適切な方法でこれを実現するにはどうすればよいのか、順を追って理解していきましょう。
まず、コードを変更して、次の例に示すような形にしてみます。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     int     handle;
07.     ulong   old;
08.
09.     const datetime dt = D'31.10.2024 15:30:10';
10.     const int i32 = 356248;
11.
12.     if ((handle = FileOpen("Hello World.txt", FILE_WRITE | FILE_READ | FILE_ANSI | FILE_BIN)) == INVALID_HANDLE)
13.     {
14.         Print("Error...");
15.         return;
16.     };
17.     FileWriteString(handle, (string)i32);
18.     FileWriteString(handle, "info");
19.     FileWriteString(handle, StringFormat("%s", TimeToString(dt, TIME_DATE | TIME_SECONDS)));
20.
21.     FileFlush(handle);
22.
23.     FileSeek(handle, 0, SEEK_SET);
24.     while (!FileIsEnding(handle))
25.     {
26.         old = FileTell(handle);
27.         Print(FileTell(handle) - old, " || ", FileTell(handle), " >> ", FileReadString(handle));
28.     }
29.
30.     FileClose(handle);
31. }
32. //+------------------------------------------------------------------+
コード04
すばらしいですね。 ターミナルへの出力はコード03の実行結果と同じですが、コード04では、次の図に示すように、ファイルの内容がわずかに異なる形で生成されます。
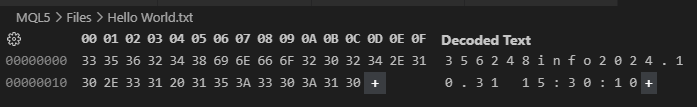
図08
ここで注意してください。 すでに説明したとおり、同じことを実現する方法はいくつもあります。 今回は、かつてBASIC言語で使われていたものの、現在ではほとんど使われなくなった手法によく似た方法を採用します。 それでは、次のステップに進みましょう。以下をご覧ください。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     int     handle;
07.     ulong   old;
08.
09.     const datetime dt = D'31.10.2024 15:30:10';
10.     const int i32 = 356248;
11.
12.     if ((handle = FileOpen("Hello World.txt", FILE_WRITE | FILE_READ | FILE_ANSI | FILE_BIN)) == INVALID_HANDLE)
13.     {
14.         Print("Error...");
15.         return;
16.     };
17.     FileWriteInteger(handle, 0, CHAR_VALUE);
18.     FileWriteString(handle, (string)i32);
19.     FileWriteInteger(handle, 0, CHAR_VALUE);
20.     FileWriteString(handle, "info");
21.     FileWriteInteger(handle, 0, CHAR_VALUE);
22.     FileWriteString(handle, StringFormat("%s", TimeToString(dt, TIME_DATE | TIME_SECONDS)));
23.
24.     FileFlush(handle);
25.
26.     FileSeek(handle, 0, SEEK_SET);
27.     while (!FileIsEnding(handle))
28.     {
29.         old = FileTell(handle);
30.         Print(FileTell(handle) - old, " || ", FileTell(handle), " >> ", FileReadString(handle));
31.     }
32.
33.     FileClose(handle);
34. }
35. //+------------------------------------------------------------------+
コード05
ここで、細心の注意を払ってください。 コード05を実行すると、次の画像に示すようなファイルが生成されます。
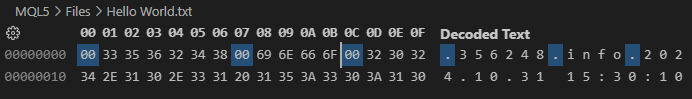
図09
図09を見ると、16進値がゼロになっている箇所に、私が印を付けていることが分かります。 なぜでしょうか。 それは、これらの値が格納されている位置を正確に把握することで、アプリケーションに文字列の正しい読み取り方法を指示できるからです。 こうすることで、アプリケーションは文字列を適切に読み取り、その結果、正しいテキストをターミナルに出力できるようになります。 コード05を実行したときにターミナルの出力を確認すると、少し奇妙な結果に気づくでしょう。しかし、これまでの記事で説明や実例を追ってきた読者の皆さんにとっては、十分に理解できる現象のはずです。 その理由は、ターミナルに何かを出力しようとした際、ファイルの先頭にある最初の文字の値がゼロになっているということです。 その結果、最初はやや奇妙に見える結果が得られることになります。
ただし、コード05でも、26行目にあるFileSeek関数に渡す値を変更し、ファイルの先頭にある最初のゼロ値を読み飛ばすようにすれば、ターミナルに特定のデータが表示されることが分かるはずです。 ぜひ後で試してみてください。プログラムがどのように動作するのかを、自分で確認し、理解するためです。 この実験は、後で皆さん自身に試していただく課題として残しておきます。 この記事では、あえて実行しません。コードを変更することで結果をどのように制御できるのか、皆さん自身で確かめていただきたいからです。 それでは、本題に戻りましょう。
現在生成しているファイルはバイナリとして扱う必要があるため、FileReadString関数には、読み込むべき文字数、つまりこの表現ではバイト数を指定する必要があります。 これは、ターミナルに表示されるテキストを正確かつ完全なものにするために必要です。 このため、次に示すように、コードをもう一度修正します。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     int     handle;
07.
08.     const datetime dt = D'31.10.2024 15:30:10';
09.     const int i32 = 356248;
10.
11.     if ((handle = FileOpen("Hello World.txt", FILE_WRITE | FILE_READ | FILE_ANSI | FILE_BIN)) == INVALID_HANDLE)
12.     {
13.         Print("Error...");
14.         return;
15.     };
16.     FWriteString(handle, (string)i32);
17.     FWriteString(handle, "info");
18.     FWriteString(handle, StringFormat("%s", TimeToString(dt, TIME_DATE | TIME_SECONDS)));
19.
20.     FileFlush(handle);
21.
22.     FileSeek(handle, 0, SEEK_SET);
23.     while (!FileIsEnding(handle))
24.     {
25.         uchar old = (uchar) FileReadInteger(handle, CHAR_VALUE);
26.         Print(old, " || ", FileTell(handle), " >> ", FileReadString(handle, old));
27.     }
28.
29.     FileClose(handle);
30. }
31. //+------------------------------------------------------------------+
32. void FWriteString(int &handle, const string szArg)
33. {
34.     long offs = (long) FileWriteInteger(handle, 0, CHAR_VALUE);
35.     long size = (long) FileWriteString(handle, szArg);
36.     ulong ftell = FileTell(handle);
37.     FileSeek(handle, (size + offs) * -1, SEEK_CUR);
38.     FileWriteInteger(handle, (uchar)size, CHAR_VALUE);
39.     FileSeek(handle, ftell, SEEK_SET);
40. }
41. //+------------------------------------------------------------------+
コード06
すばらしいですね。 これで、ターミナルに興味深い結果を表示できるコードが完成しました。 このコードを実行すると、次の画像に示す結果が得られます。
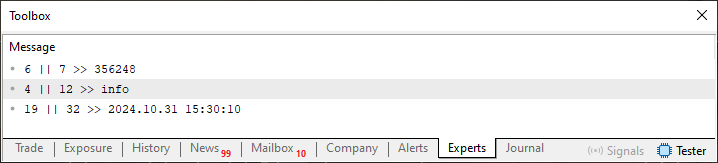
図10
それでは、ファイルの中身を確認してみましょう。 16進エディタで開くと、次の図のような内容が表示されます。
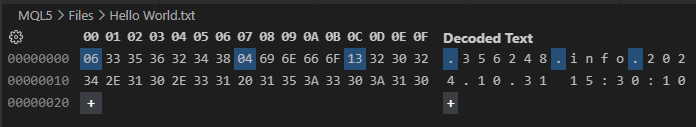
図11
図11では、いくつかの値が強調表示されていることに注目してください。 これらの値は、ファイル形式を構成するうえで欠かせないものです。 なぜなら、FileReadString関数が読み取るべき文字数を示しているからです。 つまり、強調表示されたそれぞれの値が、その後に何文字を読み取るべきかを指定しています。 実際、図10にも、これらと同じ値が表示されていることがはっきりと分かります。 では、なぜコード06は正しく動作したのでしょうか。一方、それ以前のコードでは、ターミナルに表示しても意味のある結果が得られないファイルが生成されるだけでした。その違いはどこにあるのでしょうか。
これを理解するには、コード06の32行目で定義されているプロシージャを詳しく調べる必要があります。 このプロシージャは、ある意味でアプリケーションの中核を担っています。ファイルにランダムアクセスし、書き込むデータ領域を構築する役割を果たすからです。 ただし、このプロシージャが扱うのは、1種類のデータ型、より正確には、バイト幅が固定された値です。そのため、ファイルにどのようなデータを格納するかによって、処理の大部分が左右されます。
ここで、いくつかの重要な点を確認しておきましょう。 34行目では、1バイトを書き込んでいます。 このバイトは、後でオフセットを調整するために使用されます。 ここで重要になるのが、このオフセットです。 ただし、この点については、焦らず順を追って説明していきます。 まず、32行目のサブルーチンがどのように動作するのかを理解しましょう。 長さを格納するための1バイト分の領域を確保したら、 35行目で文字列の内容をファイルに書き込みます。 ここで注意してください。文字列の長さは、255文字を超えてはなりません。先に書き込んだ1バイトで長さを表すため、これが上限となるからです。 続いて36行目では、現在のファイル位置を一時的に保存します。 これは、メッセージの長さを格納するバイトの位置に戻り、その内容を書き換えるためです。 この位置への移動は37行目でおこない、 実際の書き込みは38行目で実行します。 なお、これらのディスクアクセスは、配列を使った1回の操作に置き換えることもできます。 しかし、今は処理の内容を正確に理解しやすくするため、あえて現在の実装のままにしておきましょう。
さて、データを書き込んだ後、20行目では、バッファに未書き込みのデータが残っている場合に備えて、そのデータを直ちにディスクへ書き出すようにしています。 次に、22行目でファイル位置を先頭に戻します。そして、23行目のループに入ると、読み取り処理が始まります。まず、これから読み取る文字数を示す1バイトを読み込みます。 続いて、26行目で指定された文字数分のデータを読み取り、ターミナルに表示します。
ここで、25行目と34行目の処理が一致していなければならない点に注目してください。 これにより、長さを示すフィールドが、書き込み時と同じバイト幅で読み取られます。 まさにここで、オフセットの問題が重要になってくるのです。 すばらしいですね。 ただし、同じデータレイアウトは、別の方法でも実装できます。私の考えでは、そのような方法を採用することで、コードの開発だけでなく、保守や改良も大幅に容易になります。
ここで少し立ち止まって考えてみてください。 今回作成しているファイルで行っていることは、実は、本連載の別の記事ですでに取り上げた内容と同じです。 ただし、その記事を書いた時点では、ここで実際に応用できるいくつかのポイントについて説明するための情報が、まだ十分にそろっていませんでした。 つまり、今回の実装を詳しく見ていくと、私たちが実際に扱っているのはデータ構造であることが分かります。 したがって、コードそのものだけに注目するのではなく、そこで使われている概念を理解し、同じ結果を得るためにどのような方法が考えられるかを検討することが重要です。 より単純な方法もあれば、より効率的な方法もあります。 いずれにしても、コードを丸暗記し、意味を理解しないまま再現するよりも、その背後にある概念を理解することのほうが重要です。
それでは、これまでに確認してきた内容を少し応用して、別の方法でも同じ結果が得られることを確かめてみましょう。 そのために、いくつかの点を変更したコードを使用します。 以下をご覧ください。
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. void OnStart(void)
05. {
06.     int     handle,
07.             start = 1;
08.     uchar   arr[];
09.
10.     const datetime dt = D'31.10.2024 15:30:10';
11.     const int i32 = 356248;
12.
13.     if ((handle = FileOpen("Hello World.txt", FILE_WRITE | FILE_READ | FILE_BIN)) == INVALID_HANDLE)
14.     {
15.         Print("Error...");
16.         return;
17.     };
18.
19.     start += arr[start - 1] = (uchar) StringToCharArray((string)i32, arr, start);
20.     start += arr[start - 1] = (uchar) StringToCharArray("info", arr, start);
21.     start += arr[start - 1] = (uchar) StringToCharArray(StringFormat("%s", TimeToString(dt, TIME_DATE | TIME_SECONDS)), arr, start);
22.
23.     FileWriteArray(handle, arr, 0, start - 1);
24.     FileFlush(handle);
25.
26.     ArrayFree(arr);
27.
28.     FileSeek(handle, 0, SEEK_SET);
29.     FileReadArray(handle, arr);
30.
31.     FileClose(handle);
32.
33.     for (uint i = 0; i < arr.Size(); i+= arr[i])
34.         Print(i, " >> ", CharArrayToString(arr, i + 1, arr[i]));
35. }
36. //+------------------------------------------------------------------+
コード07
コード07を実行すると、ターミナルには次のような結果が表示されます。
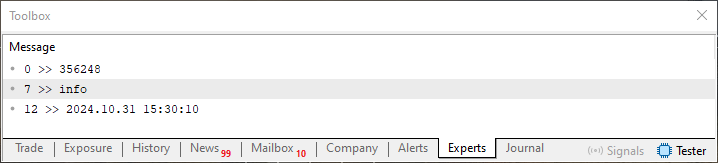
図12
ここで理解しておくべき重要な点があります。 これまでに見てきたほかのコード例とは異なり、ここでは一部の処理を少し違った方法で実行しています。 これは、ディスクへのアクセスを何度も繰り返す代わりに、多くの処理をRAM上で直接行うように変更したためです。 コード07を見ると、そのことがよく分かるはずです。 では、この変更はコードやアプリケーションのパフォーマンスに、どのような影響を与えるのでしょうか。 最終的に、処理の目的も得られる結果も変わっていないように見えます。
実際、ディスクへの繰り返しアクセスをなくし、ほとんどの処理をメモリ上で実行することで、アプリケーションの処理速度を向上させることができます。また、処理の遅延を軽減し、ディスクへの書き込み要求を繰り返すことで生じるMetaTrader 5のパフォーマンス低下も、不要な範囲で抑えられます。 実際にディスクへの書き込みを行うのは、コード内の該当する1か所だけです。 ただし、コード07には、プログラミング初心者にとって少し分かりにくい部分もあるかもしれません。 これまでの記事でコードの多くの部分を説明してきましたが、なぜコード07が正しく動作し、以前の例と同じ結果を得られるのかについて、ここで簡単に説明しておきたいと思います。
まず、7行目で変数を初期化していることに注目してください。この変数は、後の処理で非常に重要な役割を果たします。 さらに、8行目では動的配列を宣言しています。 この配列は、メモリ上にファイルを構築するために使用します。 では、19行目、20行目、21行目で何がおこなわれているのかを見てみましょう。 コード07のこれら3行では、コード06の16行目、17行目、18行目と同じ処理をおこなっています。 しかし、コード07では、それに加えて、コード06に登場するFWriteStringプロシージャと同等の処理も実現しています。
「ちょっと待ってください。 今度はコード07が少し分かりにくくなってきました。 つまり、19行目、20行目、21行目だけで、コード06でファイルにデータを書き込むために行っていた処理をすべて置き換えられるということですか?」はい、そうです。 「でも、コード07のその3行が、そこまでの処理を行っているようには見えません。 少なくとも、今の段階では理解できません。 もう少し詳しく説明してもらえますか?」もちろんです。 それでは、ほかの行も同じ仕組みで動作するので、まずはそのうちの1行が何をしているのかを詳しく見てみましょう。
おそらく、分かりにくく感じる原因は、これらの行が簡潔にまとめられていることにあるのでしょう。 そこで、19行目の処理を確認します。 まず、StringToCharArray関数が実行される時点で、start変数にはすでに値が設定されていることを覚えておいてください。 つまり、startの値によって、文字列の各文字を配列のどの位置から格納し始めるのかが決まります。 StringToCharArray関数の詳細については、ドキュメントを参照してください。 文字列の文字が配列に格納されると、この関数は格納した文字数を返します。 そこで、その戻り値を利用し、startが示す位置を更新するとともに、配列の先頭に文字数を格納します。 このようにして、コード06で実装したものと同じ形式のデータレイアウトを作成できるのです。
ただし、ここには違いがあります。 StringToCharArray関数は、文字列の終端を示すNULL文字も含めて文字数を数えます。 つまり、この関数が返す値は、コード06で得られる値とは異なります。 この点には、特に注意してください。 そして、19行目の最後の処理では、start変数の値を更新します。
それでは、コードの中でも特に興味深い部分である23行目に進みましょう。 19行目、20行目、21行目で何がおこなわれているのかを理解できていれば、start変数が配列内の終端NULL文字の位置を指していることに気づくはずです。 この文字は、配列の最後に格納されています。 しかし、今回はこの終端NULL文字をファイルに保存する必要がありません。そこで、FileWriteArray関数を使用し、最後のNULL文字を除いたデータだけをディスクに書き込みます。 その結果、コード06が生成するものと非常によく似たバイナリファイルが得られます。 ただし、先頭に格納される長さを示すバイトの計算方法が異なるため、コード06が生成するファイルとは互換性がありません。 この違いに対応するため、読み取り処理も変更しています。それが29行目の処理です。 ここでは、ファイル全体を1回の操作で読み込みます。 そして、期待どおりの結果を得るために、33行目のループを使って読み込んだデータを適切に表示します。
まとめ
この記事では、ファイルにデータを書き込むためのランダムアクセスの仕組みを、どのように実装できるのかを検討してきました。 この方法を使えば、データを保存するためのシンプルなプロトコルを定義できます。 しかし、ファイルに対して直接この処理をおこなうことが、必ずしも最善の方法とは限りません。
多くの場合、ファイルの内容をまずメモリ上の配列として構築し、すべての値を配列に格納してから、 まとめてディスクに書き込む方法が適しています。 RAMはストレージデバイスよりもはるかに高速であるため、この方法によって処理を効率化できます。 SSDであっても、RAMよりアクセス速度は遅くなります。 また、ファイルを1バイトずつ読み込む方法は、一般的にあまり実用的ではありません。 より適切なのは、ファイルから大きなデータブロックをまとめてメモリに読み込み、そのメモリ上で処理する方法です。こうすれば、必要なデータをバイト単位で検索することもできます。
今回は1バイト型のデータだけを扱いましたが、ここで紹介した考え方は、より大きなデータ型や、さらに複雑なデータ型にも応用できます。 構造体や共用体を利用すれば、同じアプローチを拡張することも難しくありません。 これらについては、この連載のこれまでの記事ですでに解説しています。
| MQ5ファイル | 説明 |
|---|---|
| コード01 | ファイルアクセスのデモ |
| コード02 | ファイルアクセスのデモ |
| コード03 | ファイルアクセスのデモ |
| コード04 | ファイルアクセスのデモ |
| コード05 | ファイルアクセスのデモ |
| コード06 | ファイルアクセスのデモ |
| コード07 | ファイルアクセスのデモ |
MetaQuotes Ltdによりポルトガル語から翻訳されました。
元の記事: https://www.mql5.com/pt/articles/16271
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。
 初級から中級まで:サンドボックスの操作
 MQL5をマスターする — 初心者からプロまで(第7回):MQLアプリケーションのデバッグの原則
 取引におけるニューラルネットワーク:インテリジェントな予測パイプライン(スパース混合エキスパート)
 初級から中級まで:オブジェクトイベント(II)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索