

Características del Wizard MQL5 que debe conocer (Parte 85): Uso de patrones del oscilador estocástico y el FrAMA con aprendizaje por inferencia mediante beta-VAE
 21
 0

Introducción
Dentro del ecosistema de MetaTrader 5, el Asistente de MQL5 se erige como una herramienta sólida que permite a los operadores crear rápidamente prototipos y poner en práctica nuevas ideas de trading. Como ya hemos explicado en artículos anteriores, todo esto ocurre sin necesidad de recurrir a la programación de bajo nivel. En esencia, el asistente usa un marco modular que permite a los operadores elegir entre clases de señales predefinidas, estrategias de gestión del capital o mecanismos de stop dinámico. La posibilidad de adoptar un enfoque «plug and play» a la hora de crear un asesor experto tiene como consecuencia no prevista la democratización del trading algorítmico, lo que hace que el trading sea más accesible para personas con distintos niveles de experiencia; esto debería tener, a largo plazo, el efecto de impulsar la liquidez del mercado, si el resto de factores se mantienen constantes.
En la parte 85 de esta serie, profundizamos en una aplicación ampliada del asistente, tal y como hemos hecho en algunos de los artículos anteriores, mediante la integración del aprendizaje automático. En concreto, nos centramos en el algoritmo de autoencoder variacional beta de un modelo de inferencia, que ya habíamos analizado en un artículo reciente, pero que ahora usamos para procesar las señales codificadas en binario del par de indicadores de nuestro último artículo. En resumen, el beta-VAE se aplica como un modelo de aprendizaje no supervisado que comprime datos de entrada de alta dimensión en un espacio latente. De este modo, capta las estructuras y relaciones subyacentes que los sistemas tradicionales basados en reglas podrían pasar por alto. Este proceso de automatización, en teoría, tiene como objetivo no solo mejorar el reconocimiento de patrones, sino también facilitar la toma de decisiones basada en la inferencia dentro de nuestras clases de señales personalizadas.
Utilizamos el emparejamiento de indicadores de nuestra última entrega, la parte 84, en la que, como es habitual, analizamos 10 patrones clave y distintos, numerados del 0 al 9, derivados del oscilador estocástico y de la media móvil adaptativa fractal. En las pruebas walk-forward que realizamos, observamos que el rendimiento variaba entre estos 10 patrones. Los patrones del 0 al 4, así como los del 7 al 8, demostraron cierta solidez al resultar rentables en toda nuestra gama de activos, que habíamos seleccionado para sacar partido de los distintos regímenes de mercado. No obstante, los patrones 5, 6 y 9 mostraron un rendimiento muy inferior, ya que no lograron generar rentabilidad durante el periodo de la prueba forward fuera de la muestra.
Vale la pena volver a destacar que nuestro periodo de pruebas es muy limitado; por lo tanto, estos resultados, en el mejor de los casos, deben considerarse una pista sobre qué patrones requieren más pruebas, y no sobre cuáles son fiables. Los patrones de bajo rendimiento se definieron como un FrAMA plano con cruces del oscilador estocástico para el patrón 5; ganchos del oscilador estocástico en sobrecompra/sobreventa con un FrAMA inclinado para el patrón 6; y niveles extremos del oscilador estocástico con pendientes opuestas del FrAMA para el patrón 9.
Estos fallos podrían atribuirse a las limitaciones derivadas de la rigidez de estos patrones. O tal vez el alcance de las pruebas fuera demasiado restrictivo, y sean estos patrones —y no algunos de los «rentables» que hemos mencionado anteriormente— los que resulten resilientes a largo plazo. La mejor forma de zanjar este debate es que el lector realice pruebas independientes. No obstante, a efectos de este estudio, analizamos cómo el aprendizaje automático podría, en su caso, revertir la situación de los patrones 5, 6 y 9.
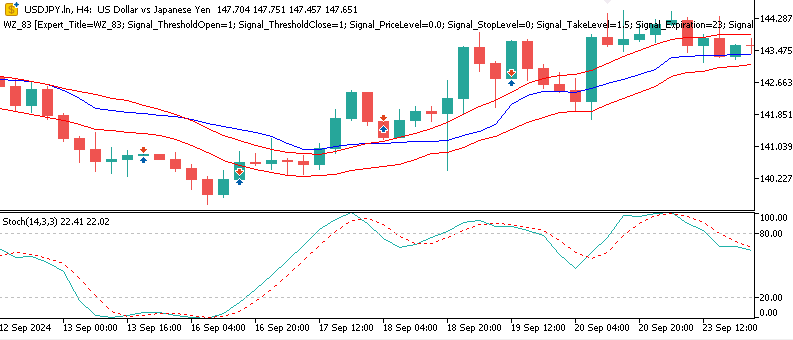
Señal de compra (patrón 5): FrAMA plano + cruce alcista del estocástico por debajo de 30
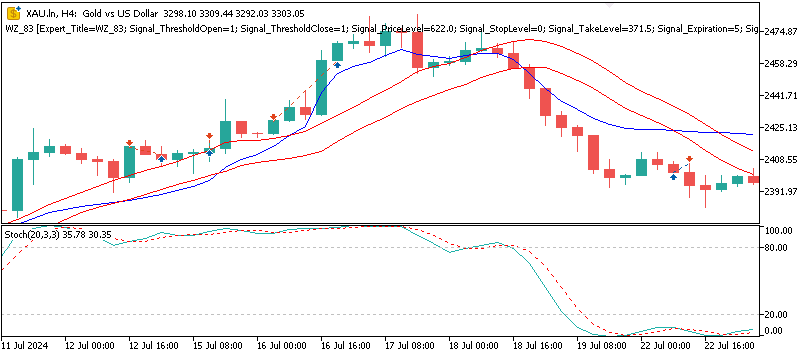
Señal de venta (patrón 6): pico en «M» del estocástico por encima de 80 + pendiente alcista del FrAMA
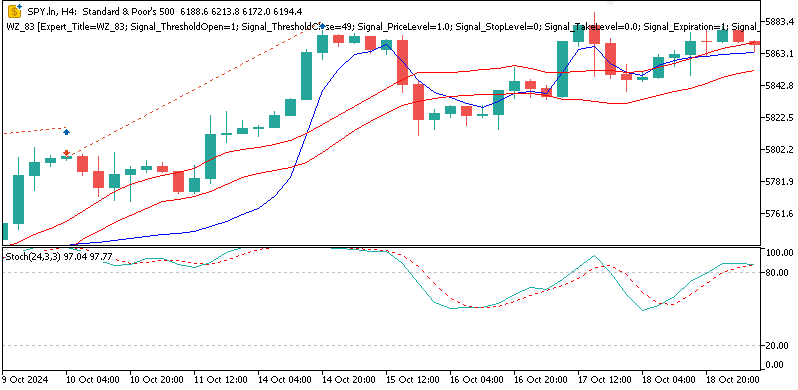
Señal de venta (patrón 9): FrAMA alcista + estocástico > 90 y a la baja
La hipótesis de este artículo sostiene que el modelo beta-VAE es capaz de transformar valores binarios de indicadores, expresados en forma de vectores, en representaciones latentes significativas. Como hacemos hincapié en las características desentrelazadas gracias al parámetro beta —cuyo objetivo es equilibrar la precisión de la reconstrucción y la regularización latente—, el modelo es capaz de descubrir patrones y estructuras ocultas en la negociación. Podemos demostrarlo mediante el entrenamiento con datos históricos de XAU/USD, SPX 500 y USD/JPY. Una vez finalizado el entrenamiento, exportamos nuestro modelo a través de ONNX a una clase de señales personalizada en MQL5 para integrarla con el asistente de MQL5. Los resultados de nuestra prueba forward sí mostraron ganancias modestas para el activo XAU/USD, lo que, en cierto sentido, pone de relieve el potencial del aprendizaje por inferencia para ajustar algunos patrones de señales en bruto de bajo rendimiento.
Detección de patrones
En el caso de los modelos de aprendizaje automático usados para la predicción —y no, por ejemplo, para el reconocimiento de patrones—, las entradas continuas vectorizadas, que pueden incluir valores normalizados de precios o indicadores, suelen ser el primer paso hacia la integración del aprendizaje automático. Permiten que grandes conjuntos de datos de series temporales se incorporen al modelo sin necesidad de realizar ramificaciones manuales. Esto permite que los algoritmos deduzcan, de forma totalmente autónoma, las relaciones entre las oscilaciones del estocástico, la forma del FrAMA y la volatilidad de la evolución de los precios.
Esta estructura puede escalar de forma natural porque, una vez alineados los vectores de los indicadores y agrupados en ventanas, en Python se pueden procesar varias barras simultáneamente en tan solo unos milisegundos. Al exportar a MQL5, los métodos «on-new-bar» del probador de estrategias no ofrecen un rendimiento similar. Sin embargo, con este enfoque no necesitaríamos cláusulas if para determinar, por ejemplo, si la línea K del estocástico ha cruzado por encima de la D o si el FrAMA se está aplanando, etc. Toda esta información se almacena en los tensores de coma flotante. En el caso de los sistemas entrenados en GPU, estos tensores ofrecen un almacenamiento elegante y compacto, no solo al almacenar temporalmente las entradas, sino, lo que es más importante, al guardar los deltas de entrenamiento, lo que evita tener que calcular continuamente estas diferencias entre la salida y el objetivo.
No obstante, esa elegancia conlleva cierta fragilidad. El carácter continuo de estos vectores de entrada implica que nunca son puros, ya que contienen ruido del mercado, retrasos en los indicadores y artefactos de redondeo que tienden a simular falsas correlaciones. En este contexto, basta con que una sola característica tenga una escala incorrecta para que se desplace la media, se alteren los gradientes de entrenamiento y se obtenga una precisión engañosa. En los casos en que los datos de entrada se recogen en regímenes de alta volatilidad, el modelo puede aprender fluctuaciones que parecen predictivas durante el entrenamiento, pero que resultan inútiles en el trading real. Es más, las señales continuas pueden difuminar los límites lógicos: pasar de un valor de K de 69,8 a uno de 70,1 puede cambiar la clasificación sin que se produzcan cambios significativos en la tendencia. El uso de datos de entrada continuos, tal y como hemos destacado en artículos recientes, puede dar lugar a sistemas que funcionan bien en simulación, pero que flaquean cuando cambian los regímenes de mercado, ya que la suavidad de los datos en coma flotante enmascara el comportamiento discreto del mercado. El modelo, como dicen algunos, «alucinaría», por ejemplo, al ofrecer previsiones incluso con datos aleatorios.
Una «vía intermedia» pragmática, que analizamos en este artículo y que ya hemos recomendado en otras ocasiones, consiste en sintetizar los datos de entrada en coma flotante en vectores booleanos o binarios que actúan como huellas digitales de eventos específicos. En lugar de introducir en el modelo rangos numéricos exhaustivos, traducimos patrones como un cruce al alza de los búferes del estocástico o un aplanamiento del FrAMA en un 1 cuando están presentes, o en un 0 cuando no lo están. Por consiguiente, cada bit del vector formado por estos valores representa una condición bien definida, ya verificada mediante una pequeña cláusula if incluida en las funciones de preprocesamiento. A partir de estos patrones binarios se crea una entrada de baja dimensión —y, podría decirse, resistente al ruido— que da prioridad a la estructura frente a la magnitud. El modelo beta-VAE puede aprender las relaciones subyacentes entre combinaciones de eventos, en lugar de aprender valores fluctuantes. Entonces, comprimir estos datos en un espacio latente puede contribuir a reflejar los regímenes de mercado de forma más fiable.
Por lo tanto, mientras que los datos continuos vectorizados nos proporcionan la escala y el rendimiento necesarios para realizar los cálculos, ya que evitamos por completo las cláusulas if, la vectorización binaria aporta claridad a las decisiones. Es capaz de convertir el «caos» numérico bruto en una forma de «orden simbólico», en la que cada 1 o 0 codifica un significado. Además, la inferencia no dependerá únicamente de umbrales frágiles, sino también de la lógica ya codificada de las cláusulas if fundamentales.
Inconvenientes del oscilador estocástico
Este oscilador, desarrollado por George Lane, se basa intrínsecamente en el impulso. Ofrece una medida de la posición del precio de cierre en relación con su rango reciente, lo que indica la probabilidad de que se produzca una reversión de precio. En resumen, esto se calcula, para el búfer K principal, de la siguiente manera:
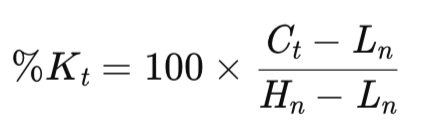
Donde:
- Ct = precio de cierre actual,
- Hn = máximo más alto de los últimos n períodos,
- Ln = mínimo más bajo de los últimos n períodos,
Nuestro periodo retrospectivo, n, suele tener un valor predeterminado de 20; sin embargo, en los dos últimos artículos, en los que presentamos este par de indicadores, dejamos este valor como un hiperparámetro ajustable. Esto no supone necesariamente una buena práctica, ya que puede dar lugar a un sobreajuste. Sin embargo, el periodo retrospectivo usado se suaviza a lo largo de «m» periodos. Este valor m suele ser de 3 por defecto, y lo hemos mantenido así para nuestros fines. El suavizado nos proporciona un valor K depurado o menos volátil. El búfer D, tal y como explicamos en la parte 83, presenta un retraso respecto al K, pues es una media móvil suavizada de este, también con un periodo predeterminado de 3 que hemos mantenido. Sirve para localizar los picos en el búfer K con la ayuda de los cruces. Utilizamos este indicador mediante la clase integrada «CiStochastic» y, al igual que todos los osciladores estocásticos, ofrece valores en el intervalo de 0 a 100, con los niveles de 80 y 20 como umbrales clave.
Aunque se trata de un indicador muy sencillo, puede presentar importantes puntos débiles. Cuando los mercados siguen una tendencia, el indicador suele presentar un retraso considerable. Por ejemplo, si estas tendencias son alcistas, los valores del búfer K pueden mantenerse en los niveles superiores, de 80 en adelante, durante un periodo prolongado, pese a los cruces que se revierten dentro de esta banda, sin descender a niveles inferiores. Esto genera falsas señales de venta de forma persistente, ya que el impulso se mantiene. Por otra parte, las tendencias bajistas mantienen el búfer K por debajo del nivel 20, lo que, en la práctica, «retrasa las señales de compra», ya que, una vez más, nos encontramos ante el «síndrome del reloj estropeado»: se generan muchas señales falsas hasta que finalmente una resulta acertada.
Este retraso podría atribuirse a la fórmula basada en el rango, que normaliza el precio de cierre con respecto a sus valores extremos, pero ignora la persistencia de la tendencia. Esto da lugar a «lecturas estancadas». Nuestra implementación en Python permite obtener los búferes K y D como series vectorizadas. Hemos implementado una clase personalizada denominada «SignalFrAMAStochastic» con funciones como «cross-up-series», en las que los desplazamientos permiten detectar cambios de una barra a la siguiente. No obstante, el ruido real del mercado observado en las pruebas en tiempo real tiende a amplificar el ruido de los falsos cruces cuando los mercados siguen una tendencia. Lo implementamos en Python de la siguiente manera:
def Stochastic(
    df: pd.DataFrame,
    k_period: int = 20,
    d_period: int = 3,
    smooth_k: int = 3,
    source_col: str = "close",
    only_stochastic: bool = False
) -> pd.DataFrame:
    """
    Compute Stochastic Oscillator (%K and %D) and append columns to the DataFrame.

    Parameters
    ----------
    df : pd.DataFrame
        Input DataFrame; must include columns 'high', 'low', and the `source_col` (default 'close').
    k_period : int
        Lookback period for %K (highest high / lowest low). Default 14.
    d_period : int
        Period for %D (moving average of %K). Default 3.
    smooth_k : int
        Smoothing window applied to raw %K before computing %D. Default 3.
    source_col : str
        Price column to use for close values (default 'close').
    only_stochastic : bool
        If True, return only the Stochastic columns.

    Returns
    -------
    pd.DataFrame
        DataFrame with appended columns: 'Stoch_%K', 'Stoch_%K_smooth', 'Stoch_%D'
    """
    required_cols = {"high", "low", source_col}
    if not required_cols.issubset(df.columns):
        raise ValueError(f"DataFrame must contain columns: {required_cols}")
    if not all(isinstance(p, int) and p > 0 for p in (k_period, d_period, smooth_k)):
        raise ValueError("k_period, d_period, and smooth_k must be positive integers")

    out = df.copy()

    low_k = out["low"].rolling(window=k_period, min_periods=k_period).min()
    high_k = out["high"].rolling(window=k_period, min_periods=k_period).max()

    # Raw %K (0-100)
    raw_k = (out[source_col] - low_k) / (high_k - low_k)
    raw_k = raw_k * 100.0

    # Smoothed %K (optional smoothing)
    stoch_k = raw_k.rolling(window=smooth_k, min_periods=smooth_k).mean()
    # %D is SMA of smoothed %K
    stoch_d = stoch_k.rolling(window=d_period, min_periods=d_period).mean()

    out['raw_k'] = raw_k
    out["k"] = stoch_k
    out["d"] = stoch_d

    if only_stochastic:
        return out[["raw_k", "k", "d"]].copy()
    return out
class SignalFrAMAStochastic:
    # constructor unchanged — can accept pandas Series too
    def __init__(
        self,
        frama: Sequence[float],
        close: Sequence[float],
        high: Sequence[float],
        low: Sequence[float],
        k: Sequence[float],           # Stochastic %K series
        pips: float,
        point: float,
        past: int,
        x_index: int = 0
    ):
        # store as pandas.Series if possible to help with vectorized operations
        if isinstance(frama, pd.Series): self.frama = frama
        else: self.frama = pd.Series(frama)
        if isinstance(close, pd.Series): self.close = close
        else: self.close = pd.Series(close)
        if isinstance(high, pd.Series): self.high = high
        else: self.high = pd.Series(high)
        if isinstance(low, pd.Series): self.low = low
        else: self.low = pd.Series(low)
        if isinstance(k, pd.Series): self.k = k
        else: self.k = pd.Series(k)

        self.m_pips = pips
        self.point = point
        self.m_past = past
        self._x = x_index

    # ------------------------
    # Small helpers (vectorized)
    # ------------------------
    @staticmethod
    def cross_up_series(a: pd.Series, b: pd.Series) -> pd.Series:
        """
        Vectorized CrossUp: True where a crossed up b between previous and current bar.
        Equivalent MQL: (a1 <= b1) && (a0 > b0)
        In pandas chronological order: a.shift(1) = previous a, a = current a
        """
        a_prev = a.shift(1)
        b_prev = b.shift(1)
        return (a_prev <= b_prev) & (a > b)


    # Trimmed code...


    # ------------------------
    # Vectorized divergence detection
    # ------------------------
    def bullish_divergence_series(self) -> pd.Series:
        """
        Vectorized detection of bullish divergence:
        - Find local lows (low < low.shift(1) & low < low.shift(-1))
        - For consecutive pairs of local lows (older -> newer), mark the time of the *second*
          low True when:
            low_old < low_new  (price makes lower low)
            K_old   > K_new    (oscillator makes higher low)
        This mirrors the MQL routine that finds two local lows within a lookback and checks them.
        """
        low = self.low
        k = self.k
        # boolean mask of local minima
        is_local_min = (low < low.shift(1)) & (low < low.shift(-1))
        local_idx = np.flatnonzero(is_local_min.to_numpy(copy=False))
        # prepare result array
        res = np.zeros(len(low), dtype=bool)

        # We will iterate adjacent pairs of local extrema (sparse).
        # Only consider pairs where the two minima are not more than (m_past+? ) apart is optional;
        # Here we mimic original by not imposing an explicit global window; user can post-filter if needed.
        for i in range(1, len(local_idx)):
            older = local_idx[i - 1]
            newer = local_idx[i]
            # compare values (note: these are numpy indices; preserve pandas indexing by assigning by position)
            if low.iat[older] < low.iat[newer] and k.iat[older] > k.iat[newer]:
                # mark the time of the newer local low
                res[newer] = True

        return pd.Series(res, index=low.index)

    def bearish_divergence_series(self) -> pd.Series:
        """
        Vectorized detection of bearish divergence:
        - Find local highs (high > high.shift(1) & high > high.shift(-1))
        - For consecutive pairs of local highs (older -> newer), mark the time of the *second*
          high True when:
            high_old > high_new (price makes higher high)
            K_old   < K_new   (oscillator makes lower high)
        """
        high = self.high
        k = self.k
        is_local_max = (high > high.shift(1)) & (high > high.shift(-1))
        local_idx = np.flatnonzero(is_local_max.to_numpy(copy=False))
        res = np.zeros(len(high), dtype=bool)

        for i in range(1, len(local_idx)):
            older = local_idx[i - 1]
            newer = local_idx[i]
            if high.iat[older] > high.iat[newer] and k.iat[older] < k.iat[newer]:
                res[newer] = True

        return pd.Series(res, index=high.index)

    # ------------------------
    # Convenience wrappers for CrossUp/Down using stored Series
    # ------------------------
    def cross_up(self, a_col: pd.Series, b_col: pd.Series) -> pd.Series:
        return self.cross_up_series(a_col, b_col)

    def cross_down(self, a_col: pd.Series, b_col: pd.Series) -> pd.Series:
        return self.cross_down_series(a_col, b_col)
El comportamiento de este indicador también puede variar considerablemente en función de los distintos regímenes de mercado. En entornos de reversión a la media, por ejemplo, cuando el par de divisas USD/JPY se encuentra en una fase de baja volatilidad, el indicador estocástico puede dar buenos resultados, ya que los rebotes desde niveles de sobreventa y los retrocesos desde niveles de sobrecompra son frecuentes y suelen concordar con los movimientos de retorno al equilibrio. Sin embargo, en escenarios dominados por el impulso, que pueden incluir las poco frecuentes rupturas del XAU/USD, el indicador tiende a fallar con frecuencia al confundir la aceleración con los cambios de tendencia. Las pruebas retrospectivas del último artículo indicaron que los patrones 5 y 9 dependían en gran medida de los niveles extremos por debajo de 10 y por encima de 90. Los cruces estaban dando resultados inferiores a lo esperado, y los resultados no rentables de las pruebas forward pueden atribuirse a desajustes entre regímenes de mercado: el mercado estaba en tendencia, no en rango. La tendencia alcista del SPX 500 este año, especialmente desde los mínimos de abril, agravó esta situación, dado que la sensibilidad del oscilador estocástico al ruido del mercado a corto plazo puede hacer que ignore los impulsos generales del mercado.
Para remediar estas deficiencias, el filtro contextual de FrAMA resulta fundamental. Nuestro indicador de media adaptativa, que usa un alfa basado en la dimensión fractal, modifica su nivel de suavizado para adaptarse a la estructura del mercado. El periodo de promediado se reduce cuando las tendencias son suaves y se amplía cuando los mercados son erráticos, con el fin de captar la dinámica general del mercado. Al incorporar la pendiente de FrAMA o su comportamiento plano como filtro de las señales del estocástico, por ejemplo al validar el patrón 5, solo aceptamos los cruces cuando FrAMA está plano. Básicamente, filtramos el ruido provocado por la volatilidad. Esta relación simbiótica determina las entradas del modelo beta-VAE, en el que el indicador binario codifica interacciones adaptadas al régimen de mercado, lo que permite al modelo aprender representaciones latentes que ayuden a distinguir las ventajas estadísticas reales de los efectos del retardo y que, en teoría, hagan más robustos los asesores expertos.
FrAMA en Python
Nuestra media móvil adaptativa supone un cambio de paradigma, pasando de un suavizado estático a uno dinámico y, por ello, más sensible. Este indicador se basa en la teoría del caos e incorpora la dimensión fractal para cuantificar el ruido del mercado en relación con su estructura. Así pues, para una ventana de n barras, el valor predeterminado habitual es también 20, al igual que en el indicador estocástico, pero FrAMA divide este periodo en dos partes iguales. Esto permite calcular las relaciones de rango N1 y N2 en las subventanas, así como N(1+2) para la ventana completa. Como recordatorio de lo expuesto en nuestro artículo anterior, D se define como:
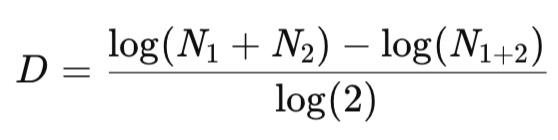
Donde N1 y N2 son las relaciones de rango mencionadas anteriormente. La dimensión fractal D se limita al intervalo de 1 a 2: 1 corresponde a una tendencia suave y 2 indica únicamente ruido. El peso adaptativo alfa también está limitado al intervalo de 0,01 a 1,0, y lo utilizamos junto con los búferes de promediado de precios para obtener una media adaptativa, tal y como ya se ha destacado en artículos anteriores, concretamente en el penúltimo, que, en el momento de redactar este artículo, aún está pendiente de publicación. En MQL5 lo implementamos usando la clase de indicador integrada «CiFrAMA», sin necesidad de abordar todas las complejidades de estas fórmulas. Sin embargo, con Python, nuestro enfoque es el siguiente:
def FrAMA(
    df: pd.DataFrame,
    period: int = 20,
    price_col: str = "close",
    min_alpha: float = 0.01,
    max_alpha: float = 1.0,
    only_frama: bool = False
) -> pd.DataFrame:
    """
    Compute Fractal Adaptive Moving Average (FRAMA) per John Ehlers' formulation.

    Parameters
    ----------
    df : pd.DataFrame
        Input DataFrame; must include 'high', 'low', and price_col (default 'close').
    period : int
        Window length used to compute fractal dimension (commonly 16). Must be >= 4.
    price_col : str
        Column name to use as price (commonly 'close').
    min_alpha : float
        Minimum alpha clamp (commonly 0.01).
    max_alpha : float
        Maximum alpha clamp (commonly 1.0).
    only_frama : bool
        If True, return only the FRAMA column.

    Returns
    -------
    pd.DataFrame
        DataFrame with appended column: 'FRAMA'
    """
    required_cols = {"high", "low", price_col}
    if not required_cols.issubset(df.columns):
        raise ValueError(f"DataFrame must contain columns: {required_cols}")
    if not (isinstance(period, int) and period >= 4):
        raise ValueError("period must be an integer >= 4")
    if not (0.0 < min_alpha <= max_alpha <= 1.0):
        raise ValueError("min_alpha and max_alpha must satisfy 0 < min_alpha <= max_alpha <= 1")

    out = df.copy()
    n = period
    half = n // 2

    price = out[price_col].to_numpy(dtype=float)
    high = out["high"].to_numpy(dtype=float)
    low = out["low"].to_numpy(dtype=float)
    length = len(out)

    frama = np.full(length, np.nan, dtype=float)

    # Seed: before we have enough bars, set FRAMA to price (common practice)
    # We'll start the loop at index 0 and set initial FRAMA to price[0].
    if length == 0:
        out["frama"] = frama
        return out if not only_frama else out[["frama"]].copy()

    frama[0] = price[0]

    # iterate; we need at least 'n' bars to compute a fractal dimension
    for i in range(1, length):
        if i < n:
            # not enough history to compute full fractal measure -> fallback to price
            frama[i] = price[i]
            continue

        start = i - n + 1
        # first half window: start .. start+half-1
        fh_start = start
        fh_end = start + half - 1
        # second half window: start+half .. i
        sh_start = fh_end + 1
        sh_end = i

        # compute ranges per sub-window (using highs and lows)
        mH = np.max(high[fh_start: fh_end + 1])   # max high in first half
        mL = np.min(low[fh_start: fh_end + 1])    # min low in first half
        N1 = (mH - mL) / float(max(1, half))

        HH = np.max(high[sh_start: sh_end + 1])   # max high in second half
        LL = np.min(low[sh_start: sh_end + 1])    # min low in second half
        N2 = (HH - LL) / float(max(1, half))

        # entire window:
        Mx = np.max(high[start: i + 1])
        Mn = np.min(low[start: i + 1])
        N3 = (Mx - Mn) / float(max(1, n))

        # compute fractal dimension D according to Ehlers:
        # D = (log(N1 + N2) - log(N3)) / log(2)
        # Use guard clauses when N1, N2, N3 are zero or negative
        if (N1 > 0.0) and (N2 > 0.0) and (N3 > 0.0):
            D = (np.log(N1 + N2) - np.log(N3)) / np.log(2.0)
        else:
            # fallback to D = 1 (line-like) when not computable
            D = 1.0

        # alpha conversion using Ehlers' exponential mapping (clamped)
        alpha = np.exp(-4.6 * (D - 1.0))
        if alpha < min_alpha:
            alpha = min_alpha
        if alpha > max_alpha:
            alpha = max_alpha

        # EMA-like update
        frama[i] = alpha * price[i] + (1.0 - alpha) * frama[i - 1]

    out["frama"] = frama
    if only_frama:
        return out[["frama"]].copy()
    return out
Podría decirse que el principal punto fuerte de FrAMA radica en su capacidad camaleónica para adaptarse a las tendencias. En tendencias eficientes, en las que D es bajo y alfa se reduce hacia 0,01, FrAMA imita una media móvil simple de periodo largo, una forma de seguimiento con retraso reducido. Por otra parte, en condiciones de caos fractal, a medida que D alcanza sus valores más altos, alfa se acercaría a 1,0 y, en esencia, FrAMA se comportaría como una media móvil exponencial (EMA) rápida que sigue de cerca el precio para evitar las falsas señales provocadas por rápidos cambios de dirección. Esto suele ofrecer mejores resultados que las medias móviles con periodos retrospectivos fijos cuando se produce un cambio de régimen. Por ejemplo, si nos fijamos en los picos de volatilidad del XAU/USD de este año, cuando el oro inició su tendencia alcista, los altos valores de alfa de FrAMA lo hacen más sensible y permitirían hacer frente fácilmente al retraso del estocástico —o «síndrome del reloj roto»— que hemos destacado anteriormente. Lo implementamos en Python de la siguiente manera:
class SignalFrAMAStochastic:
    # constructor unchanged — can accept pandas Series too
    def __init__(
        self,
        frama: Sequence[float],
        close: Sequence[float],
        high: Sequence[float],
        low: Sequence[float],
        k: Sequence[float],           # Stochastic %K series
        pips: float,
        point: float,
        past: int,
        x_index: int = 0
    ):
        # store as pandas.Series if possible to help with vectorized operations
        if isinstance(frama, pd.Series): self.frama = frama
        else: self.frama = pd.Series(frama)
        if isinstance(close, pd.Series): self.close = close
        else: self.close = pd.Series(close)
        if isinstance(high, pd.Series): self.high = high
        else: self.high = pd.Series(high)
        if isinstance(low, pd.Series): self.low = low
        else: self.low = pd.Series(low)
        if isinstance(k, pd.Series): self.k = k
        else: self.k = pd.Series(k)

        self.m_pips = pips
        self.point = point
        self.m_past = past
        self._x = x_index

    # Trimmed Code...

    @staticmethod
    def frama_slope_series(frama: pd.Series) -> pd.Series:
        """
        Vectorized FrAMASlope: FrAMA(t) - FrAMA(t-1)  (maps MQL FrAMA(ind) - FrAMA(ind+1))
        Note: first value will be NaN because shift(1) yields NaN at the start.
        """
        return frama - frama.shift(1)

    def flat_frama_series(self, window: Optional[int] = None) -> pd.Series:
        """
        Return boolean Series: True where absolute FRAMA slope stayed <= tol
        for `window` bars including current bar and previous (window-1) bars.
        - window default: self.m_past
        - tol = self.m_pips * self.point
        """
        if window is None:
            window = self.m_past
        tol = self.m_pips * self.point
        slope = self.frama_slope_series(self.frama).abs()
        # rolling max over the last `window` bars (includes current and previous window-1)
        # need min_periods=window to mimic MQL conservative behavior
        rolling_max = slope.rolling(window=window, min_periods=window).max()
        return rolling_max <= tol

    def far_above_series(self, mult: float) -> pd.Series:
        """
        Vectorized FarAboveFrama for every row:
        dist = abs(close - frama)
        atr = high.shift(1) - low.shift(1)   (previous bar's range, matching MQL's ind+1)
        condition: close > frama AND dist > mult * point * atr / 4
        """
        dist = (self.close - self.frama).abs()
        atr = (self.high.shift(1) - self.low.shift(1))
        # avoid divide-by-zero; treat atr<=0 as False
        cond = (self.close > self.frama) & (atr > 0) & (dist > (mult * self.point * atr / 4.0))
        # fill NaNs with False
        return cond.fillna(False)

    def far_below_series(self, mult: float) -> pd.Series:
        """
        Vectorized FarBelowFrama for every row:
        condition: close < frama AND dist > mult * point * atr / 4
        """
        dist = (self.close - self.frama).abs()
        atr = (self.high.shift(1) - self.low.shift(1))
        cond = (self.close < self.frama) & (atr > 0) & (dist > (mult * self.point * atr / 4.0))
        return cond.fillna(False)

    # ------------------------
    # Vectorized divergence detection
    # ------------------------

    # Trimmed code...
Las funciones de utilidad “flatframaseries” y “framaslopeseries” ayudan a identificar, respectivamente, las fases laterales del mercado para el patrón 5 y las pendientes de FrAMA para el patrón 9, respectivamente.
Arquetipos de mercado
Los comportamientos observados en los mercados pueden clasificarse según una amplia variedad de taxonomías. En los dos últimos artículos y en este, nos hemos centrado, en principio, únicamente en tres. Con tendencia frente a con reversión a la media; autocorrelacionados frente a desacoplados; y de alta volatilidad frente a de baja volatilidad. Los regímenes de mercado con tendencia pueden presentar movimientos direccionales persistentes en los que predominen indicadores como la pendiente positiva del FrAMA, lo que favorece las estrategias de impulso, sin tener en cuenta, no obstante, las falsas señales de reversión del estocástico. Por otro lado, las fases de mercado con reversión a la media fluctúan en torno a un punto de equilibrio, lo que favorece los rebotes desde las zonas de sobrecompra y sobreventa del oscilador estocástico, sobre todo si el FrAMA se mantiene prácticamente plano.
Las correlaciones reflejan la interdependencia entre activos; por ejemplo, se habla mucho de la inquietante correlación entre las acciones y las supuestas coberturas, como el bitcoin. Ambos se mueven al unísono en muchas ocasiones, en contra de la tesis académica de que el bitcoin es una cobertura frente a la economía estadounidense y la «irresponsabilidad fiscal». Si ambos estuvieran realmente desacoplados, mantener posiciones en los dos constituiría una forma eficaz de diversificación. Dentro del SPX 500, en ocasiones hay sectores que pueden presentar correlaciones negativas, y estos cambios justificaron que utilizáramos este activo en los últimos artículos para analizar los patrones de autocorrelación 2, 3 y 9.
Esta diversidad de tipos de mercados justifica el uso de un «universo de pruebas amplio» para poner a prueba y validar el aprendizaje de patrones de nuestro beta-VAE. Sostuvimos que cada uno de estos tipos de mercado se adecuaba a determinados activos, por lo que elegimos tres activos, cada uno perteneciente a una clase de activos consolidada. Hemos elegido XAU/USD, SPX 500 y USD/JPY. El oro se seleccionó de entre la cesta de materias primas y refleja en gran medida la volatilidad de estas, que suele estar determinada por los flujos hacia activos refugio, las tensiones geopolíticas, la elevada volatilidad de la inflación, etc. Sus efectos de memoria, que pueden prolongarse, ponen a prueba la capacidad del beta-VAE para captar la persistencia del régimen en su espacio latente.
Se seleccionó el SPX 500 como indicador de referencia consolidado de lo que está ocurriendo en el mercado de valores. Presenta un comportamiento correlacionado de seguimiento de tendencias que depende del sentimiento de riesgo. Esto ayudó a poner de manifiesto el retraso del estocástico en las fases de impulso, durante las cuales fallaba el patrón 9. Por último, se eligió el par USD/JPY como representante del mercado de divisas para aprovechar las oportunidades de negociación basadas en la volatilidad generada por los diferenciales de rendimiento y las intervenciones de los bancos centrales. Esta elección sirvió para analizar los filtros «flat-FrAMA», especialmente en el patrón 5.
Para nuestro modelo VAE, implementamos los tres patrones de bajo rendimiento de forma simultánea, desarrollando un modelo latente que capta o aprende los patrones subyacentes presentes en los patrones de señal 5, 6 y 9. Seguimos probando cada activo de forma independiente, examinando simultáneamente los tres patrones de bajo rendimiento en las pruebas de cada activo. Las pruebas con múltiples patrones pueden resultar problemáticas si sus señales no se agregan correctamente. El enfoque de aprendizaje automático utilizado en este artículo busca evitar este problema mediante su integración. En artículos anteriores ya hemos mencionado el riesgo de que las posiciones de los distintos patrones se anulen entre sí, de modo que el entrenamiento a menudo se reduce a un ejercicio de sobreajuste. Con el enfoque que utilizamos aquí, todas las señales se unifican y generan recomendaciones de compra o venta de forma conjunta. No de forma independiente, por lo que esta combinación de los patrones en un modelo beta-VAE podría ser un caso en el que el todo sea mayor que la suma de las partes.
El modelo beta-VAE
El núcleo de nuestro modelo que engloba las señales es el autoencoder variacional beta, un modelo generativo no supervisado que mejora el VAE estándar al centrarse en representaciones desentrelazadas. Su estructura consta de un codificador y un decodificador, con un espacio oculto cuya dimensionalidad suele ser elevada, un orden de magnitud superior a la de la entrada. El codificador es una red neuronal de propagación hacia adelante que transforma un espacio de entrada de baja dimensionalidad en un espacio latente de alta dimensionalidad.
En este artículo, nuestra entrada de 6 dimensiones se mapea a un espacio latente de 2048 dimensiones. Las 6 dimensiones de entrada corresponden a los 3 patrones de señal 5, 6 y 9; recordemos que cada patrón genera un vector de 2 dimensiones en el que cada componente se normaliza para tomar el valor 1 o 0. Los dos índices miden, respectivamente, el carácter alcista y bajista de un patrón de señal determinado. Implementamos el modelo beta-VAE en Python de la siguiente forma:
# ----------------------------- β-VAE (inference simplified to VAE-only) -----------------------------
class BetaVAEUnsupervised(nn.Module):
    """
    Encoder: features -> (mu, logvar)
    Decoder: z -> x_hat
    **Inference (now VAE-only):** latent z is mapped to y via an internal head.
    All former infer modes (ridge/knn/kernel/lwlr/mlp) are bypassed.
    """
    def __init__(self, feature_dim, latent_dim, k_neighbors=5, beta=4.0, recon='bce',
                 infer_mode='vae', ridge_alpha=1e-2, kernel_bandwidth=1.0):
        super().__init__()
        self.latent_dim = latent_dim
        self.k_neighbors = k_neighbors
        self.beta = beta
        self.recon = recon
        self.infer_mode = 'vae'  # force VAE-only
        self.ridge_alpha = float(ridge_alpha)
        self.kernel_bandwidth = float(kernel_bandwidth)

        # Encoder
        self.feature_encoder = nn.Sequential(
            nn.Linear(feature_dim, 256), nn.ReLU(),
            nn.Linear(256, 128), nn.ReLU(),
            nn.Linear(128, latent_dim * 2)
        )
        # Decoder
        self.decoder = nn.Sequential(
            nn.Linear(latent_dim, 128), nn.ReLU(),
            nn.Linear(128, 256), nn.ReLU(),
            nn.Linear(256, feature_dim)
        )
        # New: latent→y head (supervised head trained with MSE)
        self.y_head = nn.Sequential(
            nn.Linear(latent_dim, 128), nn.ReLU(),
            nn.Linear(128, 1)
        )

    def encode(self, features):
        h = self.feature_encoder(features)
        z_mean, z_logvar = torch.chunk(h, 2, dim=1)
        return z_mean, z_logvar

    def reparameterize(self, mean, logvar):
        std = torch.exp(0.5 * logvar)
        eps = torch.randn_like(std)
        return mean + eps * std

    def decode(self, z):
        return self.decoder(z)

    def predict_from_latent(self, z):
        # VAE-only mapping
        return self.y_head(z)

    def forward(self, features, y=None):
        mu, logvar = self.encode(features)
        z = self.reparameterize(mu, logvar)
        x_logits = self.decode(z)
        y_hat = self.predict_from_latent(z)
        if y is not None:
            return {'z': z, 'z_mean': mu, 'z_logvar': logvar, 'x_logits': x_logits, 'y_hat': y_hat}
        else:
            return {'y': y_hat}
La transformación de la entrada binaria de 6 dimensiones en una capa latente de 2048 dimensiones se realiza mediante capas lineales con activación ReLU, con la configuración 6⇾256⇾128⇾4096. Tenemos 4096 al final porque representa dos conjuntos de 2048. Además, tenemos una división en la que una rama conduce a la media y la otra al logaritmo de la varianza; cada una tiene un tamaño de 2048. Esta codificación probabilística utiliza la reparametrización para muestrear z, la entrada regenerada, que a continuación se utiliza para generar la salida de la red, lo que permite realizar la retropropagación. La decodificación se realiza en orden inverso al de la configuración indicada, es decir, en el orden 2048⇾128⇾256⇾6. Esta reconstrucción de la entrada binaria proporciona logits, que a continuación se someten a una activación sigmoide para generar probabilidades.
En una implementación reciente de un beta-VAE, nos basamos exclusivamente en el modo dual de una «pasada hacia adelante» para predecir la evolución de los precios, ya que durante el entrenamiento esta se había emparejado con los valores de entrada de los indicadores. En los datos de entrada usados para realizar esta predicción, se asignarían valores neutros de relleno a las posiciones correspondientes a las variaciones futuras del precio que se deseaba predecir. Dado que el rango de las variaciones de precio iba de 0,0 a 1,0, el valor neutro de relleno era 0,5. El beta-VAE que hemos implementado cuenta con una función de pasada hacia adelante igualmente flexible; sin embargo, hemos añadido un nuevo cabezal de salida que transforma la representación latente en y, con dimensiones 2048⇾128⇾1, y predice la siguiente evolución del precio mediante valores entre -1 y +1, que indican un movimiento bajista y alcista, respectivamente. Para ello se utiliza z como entrada, lo que, en la práctica, significa que estamos combinando el aprendizaje no supervisado con el aprendizaje supervisado.
El parámetro beta que utilizamos en este VAE determina en qué medida el modelo impone la simplicidad y la independencia de las variables en su espacio oculto, también conocido como espacio latente. En un autoencoder variacional, hay que encontrar un equilibrio entre dos aspectos. La precisión de la reconstrucción de los datos de entrada y la regularización, es decir, una medida de hasta qué punto el espacio latente se ajusta a un sistema métrico bien establecido, como una distribución normal estándar.
Cuando beta es 1, se denomina VAE «normal». El nombre, como es de suponer, proviene de la distribución normal y, en este caso, la divergencia de Kullback-Leibler ajustaría los valores del espacio latente para que siguieran aproximadamente una distribución gaussiana. Sin embargo, en cuanto empezamos a aumentar el valor de beta y, por ejemplo, lo fijamos en 4, comenzamos a otorgar más importancia o «peso» a la regularización. En esencia, se favorecería una representación lo más esparsa posible en el espacio latente, con muchos valores cercanos a cero, una mayor independencia y menos correlaciones. En la práctica, el objetivo es que esto ayude al modelo a separar y «desentrelazar» mejor las distintas características y patrones ocultos en el espacio latente.
Se supone que un espacio oculto mejor diferenciado ayuda al VAE a generalizar e identificar mejor los patrones en situaciones fuera de la muestra. Nuestra función de pérdida beta-VAE-Loss está diseñada para calcular la divergencia de Kullback-Leibler y la implementamos en Python de la siguiente manera:
def beta_vae_loss(features, x_logits, mu, logvar, beta=4.0, recon='bce'):
    if recon == 'bce':
        recon_loss = F.binary_cross_entropy_with_logits(x_logits, features, reduction='sum') / features.size(0)
    else:
        recon_loss = F.mse_loss(torch.sigmoid(x_logits), features, reduction='mean') * features.size(1)
    kl = -0.5 * torch.sum(1 + logvar - mu.pow(2) - logvar.exp()) / features.size(0)
    loss = recon_loss + beta * kl
    return loss, recon_loss.detach(), kl.detach()
KL se calcula como -0,5 ∑(1 + logvar - μ² - exp(logvar)) y, a continuación, se promedia por lote y se pondera por beta. Esto, tal y como se ha argumentado anteriormente, sacrifica la precisión de la reconstrucción a cambio de la variabilidad del espacio latente, revelando jerarquías ocultas de indicadores. La descomposición de la pérdida es un proceso de varios pasos, en el que podemos reconstruir los datos de entrada utilizando la entropía cruzada binaria con logits. La pérdida total es un objetivo híbrido que garantiza no solo que el modelo pueda reconstruir los patrones de entrada, sino también que el espacio latente pueda «especializarse» y captar distintas facetas de las características de entrada; por ejemplo, algunos valores registran la intensidad del cruce y otros, la dirección de la pendiente, etc. La capacidad de registrar una gran variedad de estas características está controlada, una vez más, por el factor beta, tal y como hemos argumentado anteriormente.
Implementación en MQL5
Con el fin de conectar el ecosistema de aprendizaje automático de Python con el marco de operaciones de MQL5, explicamos los pasos clave en Python que permiten exportar un archivo ONNX para su uso en MQL5. Estos pasos, tal y como se ha explicado anteriormente, permiten crear un proceso fluido para el tratamiento de datos, el entrenamiento de modelos y la puesta en marcha. Inicializamos los modelos ONNX exportados, uno por cada activo; recordemos que cada modelo utiliza los tres patrones de forma sinérgica, sin que se produzcan conflictos entre las órdenes. Mientras que en artículos anteriores los modelos ONNX se centraban en patrones concretos, los que aquí se presentan se centran en activos concretos. Por consiguiente, el constructor de nuestra clase y su validación quedan así:
//+------------------------------------------------------------------+
//| Constructor                                                      |
//+------------------------------------------------------------------+
CSignalIL_Stochastic_FrAMA::CSignalIL_Stochastic_FrAMA(void) : m_pattern_6(50),
   m_pattern_9(50),
   m_pattern_5(50),
   m_model_type(0)
//m_patterns_usage(255)
{
//--- initialization of protected data
   m_used_series = USE_SERIES_CLOSE + USE_SERIES_TIME;
   PatternsUsage(m_patterns_usage);
//--- create model from static buffer
   m_handles[0] = OnnxCreateFromBuffer(__84_USDJPY, ONNX_DEFAULT);
   m_handles[1] = OnnxCreateFromBuffer(__84_XAU, ONNX_DEFAULT);
   m_handles[2] = OnnxCreateFromBuffer(__84_SPY, ONNX_DEFAULT);
}
//+------------------------------------------------------------------+
//| Validation settings protected data.                              |
//+------------------------------------------------------------------+
bool CSignalIL_Stochastic_FrAMA::ValidationSettings(void)
{
//--- validation settings of additional filters
   if(!CExpertSignal::ValidationSettings())
      return(false);
//--- initial data checks
   // Set input shapes
   const long _in_shape[] = {1, 6};
   const long _out_shape[] = {1, 1};
   if(!OnnxSetInputShape(m_handles[m_model_type], ONNX_DEFAULT, _in_shape))
   {  Print("OnnxSetInputShape error ", GetLastError());
      return(false);
   }
   // Set output shapes
   if(!OnnxSetOutputShape(m_handles[m_model_type], 0, _out_shape))
   {  Print("OnnxSetOutputShape error ", GetLastError());
      return(false);
   }
//--- ok
   return(true);
}
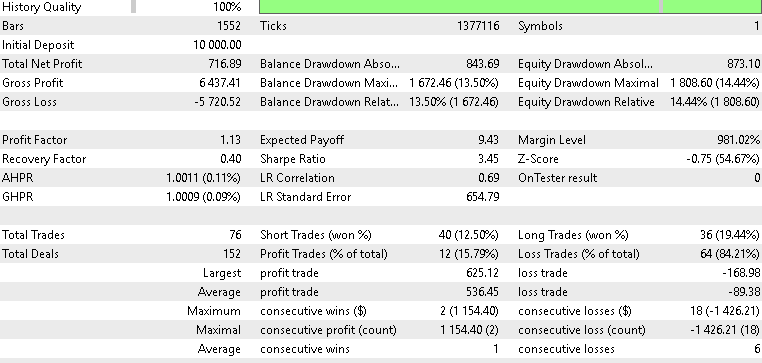
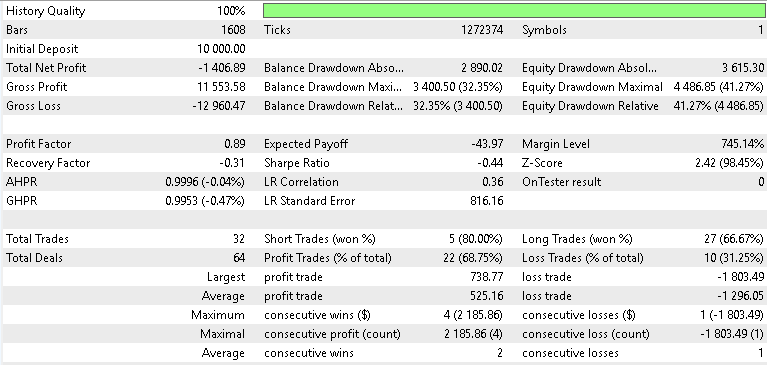
Las pruebas se llevaron a cabo con los distintos «tipos de modelo»; este parámetro es un acrónimo que hace referencia a los tres activos que estamos probando mientras ejecutamos los tres patrones de señal a la vez. Por lo tanto, cuando a este parámetro entero se le asignaba el valor 0, probábamos el USD/JPY; cuando se le asignaba el valor 1, probábamos el XAU/USD; y cuando se le asignaba el valor 2, probábamos el SPX 500. El objetivo de nuestras pruebas era analizar si se podía mejorar el bajo rendimiento de los patrones de señal 5, 6 y 9. Normalmente, esto se hace de forma más directa, probando un patrón cada vez, pero en este caso estamos unificando los tres patrones en torno a los tres activos sometidos a prueba. Nuestro universo de pruebas está formado por distintos activos, cada uno de ellos orientado a tipos de mercado concretos.
Hemos realizado el entrenamiento y la optimización a partir de ventanas de prueba similares a las que utilizamos en el último artículo, que abarcaban desde julio de 2023 hasta julio de 2024. Los criterios que ajustamos fueron los umbrales de apertura y cierre de la señal personalizada, la distancia del precio de entrada en pips —que determina la distancia de nuestras órdenes limitadas— y los umbrales de los patrones de señal que deben acumularse para cada patrón cuando se detecta su presencia en la comprobación que se realiza en cada nueva barra. Los resultados de la prueba forward fueron los siguientes:
Para XAU/USD
Para USD/JPY
Para el SPX 500
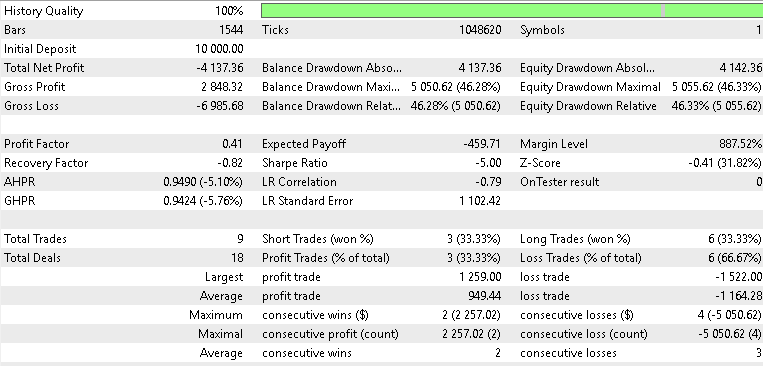
Los resultados de nuestras pruebas forward fueron dispares, pero, aun así, reveladores. En las pruebas realizadas con el oro, nuestro modelo beta-VAE registró una rentabilidad moderada del 2,1 % a lo largo del año, en el marco temporal de 4 horas. No podemos analizar por separado las variables de la capa latente ni determinar con exactitud cuáles se especializan en cada patrón de señal; sin embargo, cabe suponer que las representaciones vectoriales «flat-cross» del patrón 5 fueron capaces de detectar reversiones impulsadas por la volatilidad en medio de los movimientos bruscos del oro. También realizamos pruebas con el activo SPX 500, y la rentabilidad anual en la prueba forward fue del -0,8 %. Del mismo modo, el par USD/JPY tampoco obtuvo mejores resultados en sus pruebas; de hecho, fue el que peor se comportó de los tres, con una rentabilidad del -1,4 %. En general, por lo tanto, solo el XAU logró superar el umbral de rentabilidad, lo que significa que los resultados de esta prueba se asemejaron en gran medida a los que obtuvimos en el último artículo, el n.º 84, ya que el VAE solo nos ha proporcionado una mejora modesta al realizar pruebas con el XAU/USD.
Conclusión
En resumen, combinar el modelo de inferencia beta-VAE con el par de indicadores formado por el oscilador estocástico y la media móvil adaptativa fractal permite obtener características ocultas desentrelazadas que han demostrado cierta aplicabilidad. Nuestro «flujo de trabajo» de ONNX a MQL5 ha puesto de manifiesto algunas mejoras con respecto al último artículo, sobre todo en el caso del XAU/USD; sin embargo, también ha puesto de relieve algunas limitaciones. Los resultados de las pruebas forward con el USD/JPY y el SPX 500 fueron poco convincentes y, en el mejor de los casos, mediocres. Por lo tanto, esto requiere una cuidadosa ingeniería de características, pruebas adaptadas al régimen de mercado y un despliegue prudente. Todos los resultados que aquí se presentan, como siempre, son experimentales y requieren pruebas independientes y un análisis minucioso antes de ser tenidos en cuenta.
| nombre | descripción |
|---|---|
| WZ-84.mq5 | Asesor experto creado mediante el asistente, cuyo encabezado incluye el nombre y la ubicación de los archivos a los que hace referencia |
| SignalWZ-84.mqh | Archivo de clase de señal personalizada |
| 84-XAU.onnx | Modelo ONNX entrenado con datos del oro |
| 84-USDJPY.onnx | Modelo ONNX entrenado para el par dólar-yen |
| 84-SPY.onnx | Modelo entrenado para el SPX 500 |
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/19948
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.



