

Características del Wizard MQL5 que debe conocer (Parte 80): Uso de patrones Ichimoku y ADX-Wilder con aprendizaje por refuerzo TD3
 26
 0

Introducción
El ámbito del trading con algoritmos ha evolucionado de forma constante, pasando de estrategias estáticas basadas en indicadores a métodos más dinámicos que se adaptan a las condiciones cambiantes del mercado. Uno de los métodos más prometedores en este ámbito es el aprendizaje por refuerzo. Recordemos que ya hemos analizado implementaciones del aprendizaje por refuerzo, así como del aprendizaje por inferencia, en prototipos de asesores expertos creados con el Asistente de MQL5. A diferencia de los métodos clásicos de aprendizaje automático, que realizan predicciones o clasificaciones, el aprendizaje por refuerzo (RL) permite a un agente aprender mediante la interacción con su entorno. A la hora de operar, esto implica observar continuamente las características de los precios, elegir acciones como comprar, vender o mantener la posición, y recibir recompensas en forma de beneficios o pérdidas.
Dentro de la familia de algoritmos de aprendizaje por refuerzo (RL), el «Twin Delayed Deep Deterministic Policy Gradient» (TD3) se está perfilando, en algunos círculos, como un candidato sólido para aplicaciones financieras. TD3 está diseñado para espacios de acciones continuos, lo que lo hace especialmente adecuado para problemas de trading en los que el dimensionamiento de las posiciones y la elección del momento de operar no se reducen a decisiones binarias, sino que requieren un control muy preciso. Si lo comparamos con su predecesor, DDPG, TD3 aporta mejoras cruciales de estabilidad, como el uso de más de un crítico, la aplicación de suavizado mediante ruido a las acciones objetivo y el retraso de las actualizaciones de la política para evitar el sobreajuste a las fluctuaciones transitorias.
Nuestro objetivo principal con este artículo, como siempre, es demostrar cómo los modelos TD3, una vez entrenados en Python, pueden integrarse en el marco de trabajo de los asesores expertos de MQL5 para la creación de prototipos. En concreto, nuestro objetivo es demostrar cómo una red del actor de TD3 exportada al formato ONNX puede encapsularse y utilizarse dentro de una clase de señales personalizada. Como siempre, estas clases de señales se integran posteriormente en un robot de trading mediante el Asistente de MQL5.
Para dar un enfoque más práctico a esta explicación, el artículo concluirá con un repaso de algunas pruebas prospectivas realizadas en el Probador de Estrategias de MetaTrader. En nuestra investigación se analizan tres informes, cada uno de los cuales abarca los tres patrones de señal que habíamos seleccionado para su estudio en profundidad en el artículo «Parte 74». Eran los patrones de señal 0, 1 y 5.
Antecedentes sobre el aprendizaje por refuerzo (RL) en el trading
El aprendizaje por refuerzo (RL) se basa en un ciclo sencillo pero potente: un agente interactúa con un entorno, realiza acciones y aprende de las recompensas que recibe. Para comprender cómo lo aplicamos en el trading, puede resultar útil repasar el papel que desempeñan los distintos componentes del aprendizaje por refuerzo (RL).
- Agente: en nuestro caso, es el algoritmo de negociación que decide si compramos, vendemos o mantenemos la posición.
- Entorno: el mercado financiero, representado por el historial de precios, los indicadores y las características derivadas.
- Estado: representación numérica de las condiciones actuales del mercado, que en nuestro caso corresponden a las lecturas de los indicadores de los patrones 0, 1 y 5. No usamos los datos de entrada en formato binario que veníamos empleando, sino que vamos a probar un formato más continuo.
- Acción: decisión de negociación. Esta puede ser discreta, con opciones como adoptar una posición larga, una posición corta o permanecer sin posición; o continua, expresando, por ejemplo, el volumen o el tamaño de la posición que se va a adoptar, con valores negativos para las posiciones cortas y positivos para las largas. En este artículo utilizamos la primera modalidad: las acciones discretas.
- Recompensa: señal numérica que evalúa la calidad de la acción. En el trading, esta suele derivarse de las ganancias y pérdidas. Sin embargo, dichas recompensas suelen ajustarse para tener en cuenta el riesgo mediante penalizaciones por la caída del capital desde un máximo previo (drawdown) o los costes de transacción.
La repetición de este ciclo se produce a medida que el agente explora diferentes estrategias, con el objetivo de maximizar las recompensas acumuladas a lo largo del tiempo. A diferencia de las tareas de regresión o clasificación, en las que un conjunto de datos fijo define el problema, el aprendizaje por refuerzo (RL) se basa en la toma de decisiones secuencial. Las acciones de hoy están destinadas a influir en los resultados de mañana.
Uno de los retos especiales que plantean los mercados financieros es que son no estacionarios. Por ejemplo, a diferencia de los juegos de mesa, en los que las reglas nunca cambian, la dinámica del mercado tiende a evolucionar con la llegada de nuevos participantes, nuevas normativas y acontecimientos internacionales. Esto tiende a hacer que los métodos de aprendizaje por refuerzo (RL) «fuera de política», en particular TD3, resulten especialmente atractivos, ya que pueden aprender a partir de búferes de experiencias que contienen diversos estados del mercado y adaptarse con mayor flexibilidad que los métodos «en política», como SARSA o PPO.
Otro elemento importante es la distinción entre políticas deterministas y estocásticas. Las políticas deterministas, como la usada en TD3, asocian cada estado directamente a una acción concreta, lo que las hace eficientes desde el punto de vista computacional y más fáciles de implementar en sistemas de negociación en los que la latencia es un factor crítico. Esto podría abarcar aspectos como el arbitraje, etc. Las políticas estocásticas, por el contrario, se basan en muestreos a partir de distribuciones de probabilidad, lo que puede resultar útil en entornos altamente exploratorios, pero resulta menos práctico en la ejecución de órdenes, donde la coherencia es fundamental.
Por último, el aprendizaje por refuerzo (RL) introduce el concepto ya mencionado de «exploración frente a explotación», tratado en artículos anteriores sobre aprendizaje por refuerzo (RL). En el mundo del trading, esto suele traducirse en un equilibrio entre probar nuevas estrategias —la exploración— y seguir con un enfoque rentable —la explotación—. TD3 aborda esta cuestión añadiendo ruido controlado a su política durante el entrenamiento, lo que garantiza que el agente pruebe variaciones sin caer en un comportamiento «imprudente».
En resumen, el aprendizaje por refuerzo (RL) ofrece un marco racional para el trading, en el que el proceso repetitivo de identificar oportunidades, elegir y obtener beneficios o sufrir pérdidas tiende a alinearse con el ciclo «agente-entorno-recompensa». Con TD3, estas ideas pueden desarrollarse aún más y dar lugar a algoritmos estables con acciones continuas, capaces de salvar la brecha entre el entrenamiento en Python y la ejecución «práctica» en MQL5.
Argumentos a favor de TD3
Durante las primeras pruebas con el aprendizaje por refuerzo (RL) realizadas por los operadores, el DDPG (gradiente de política determinista profundo) se impuso con bastante rapidez como el algoritmo de referencia para los problemas de acción continua. DDPG combinó el marco actor-crítico con las redes neuronales, lo que permitió aplicar políticas deterministas en tareas como la asignación de carteras o el ajuste del tamaño de las posiciones. Sin embargo, el DDPG adolecía de dos deficiencias fundamentales. Sesgo de sobreestimación en los valores Q e inestabilidad derivada de las frecuentes actualizaciones de la política. Cuando se trabaja con series temporales de datos financieros, en las que la imprevisibilidad es la norma, estas deficiencias suelen hacer que el modelo de aprendizaje por refuerzo (RL) funcione bien en simulaciones, pero que se colapse cuando se expone a condiciones reales.
Estos retos sentaron las bases para el método «Twin Delayed Deep Deterministic Policy Gradient» (TD3). TD3 destaca porque se diseñó para subsanar las deficiencias del DDPG y, al mismo tiempo, conservar sus puntos fuertes. Aporta tres innovaciones que benefician directamente a las aplicaciones de trading. Las repasamos una por una:
- Críticos gemelos: Muchos algoritmos de aprendizaje por refuerzo (RL) suelen basarse en una sola red del crítico a la hora de estimar los valores de las acciones. TD3 utiliza dos. Para cada par estado-acción, los dos críticos generan sendas estimaciones de valor, y el algoritmo toma la menor de ambas. Este enfoque modesto o conservador reduce de forma bastante notable el sesgo de sobreestimación. Desde el punto de vista del trading, evita que el agente sea excesivamente optimista ante una posible operación arriesgada, lo que suele traducirse en una toma de decisiones más prudente y estable.
- Suavizado de la política objetivo: Los mercados financieros están plagados de ruido que se caracteriza por saltos aleatorios en los precios, falsas rupturas y picos de volatilidad a corto plazo. TD3 contrarresta esto añadiendo ruido gaussiano recortado a las acciones objetivo durante las actualizaciones del crítico. Este efecto de suavizado obliga a las redes del crítico a aprender funciones de valor menos sensibles a las pequeñas fluctuaciones. El resultado es una política que no reacciona de forma exagerada ante anomalías de un solo tick, sino que responde a patrones más robustos.
- Actualizaciones diferidas de la política: En DDPG, la red del actor y la red del crítico se actualizan simultáneamente. TD3, sin embargo, sí introduce un retraso deliberado. La red de la política o del actor se actualiza con menos frecuencia que las redes de los críticos. De este modo, se garantiza que el actor se guíe por críticos bien entrenados, en lugar de seguir señales inestables aprendidas solo parcialmente. En la práctica, este retraso se traduce en mejoras más constantes y en menos cambios atípicos en los patrones de negociación.
En conjunto, estas modificaciones hacen que TD3 sea más estable y fiable entre los algoritmos de aprendizaje por refuerzo (RL) para el trading. En un ámbito en el que el control de la reducción del capital (drawdown) y la rentabilidad ajustada al riesgo suelen ser muy importantes, dado que el apalancamiento en forma de inversión por cuenta ajena es una actividad próspera y en expansión, el sesgo conservador de TD3 supone una ventaja. Aunque otros algoritmos, como PPO o SAC, son muy usados para tareas generales de aprendizaje por refuerzo (RL), su naturaleza estocástica y su dependencia del muestreo discreto hacen que su aplicación en contextos de trading continuo en tiempo real sea más compleja o menos directa.
Además, otra razón clave por la que se debería optar por TD3 es su compatibilidad con la exportación a ONNX. La red del actor, que asigna acciones a los estados, es decir, decisiones de trading, es la única red que hay que exportar para generar predicciones para los operadores. Se trata de una configuración ligera y portátil, muy adecuada para integrarse en entornos MQL5 en los que la velocidad de ejecución es muy importante. Ya hemos explicado por qué entrenar directamente en MQL5 resulta ineficiente y consume muchos recursos. El enfoque más recomendable es que Python se encargue de la parte más laboriosa del entrenamiento, mientras que MQL5 se ocupa de la inferencia y la ejecución de las operaciones.
En resumen, la combinación que ofrece TD3 de críticos gemelos, objetivos suavizados y actualizaciones diferidas aporta cierta estabilidad, necesaria para capear la aleatoriedad de muchos mercados financieros. Su diseño determinista garantiza decisiones coherentes en el momento de la ejecución, y sus requisitos mínimos en formato ONNX facilitan su integración en asesores expertos en MQL5. Por ello, TD3 es algo más que una simple mejora académica respecto a DDPG: es una herramienta ligeramente más robusta para las estrategias de negociación.
Entrenamiento de modelos TD3
La fase de entrenamiento de un agente TD3 se realiza íntegramente en Python, donde bibliotecas como PyTorch aportan la flexibilidad y la eficiencia computacional necesarias a la hora de gestionar grandes volúmenes de datos financieros. Todo el proceso se puede dividir en cuatro elementos fundamentales. Son el diseño del entorno, la gestión del búfer de experiencias, el ajuste de hiperparámetros y el ciclo de entrenamiento.
En el aprendizaje por refuerzo (RL), el entorno establece las reglas de interacción. Por consiguiente, para los escenarios de negociación, creamos un entorno estructurado en filas, en el que cada fila de datos históricos corresponde a un paso temporal. Las características de los precios, como las diferencias, las líneas Senkou Span de Ichimoku y los valores del ADX, forman el vector de estado, que es la entrada de la red del actor. La acción es, por tanto, la decisión de negociación correspondiente recomendada por la red del actor de TD3, normalmente escalada al intervalo [-1, 1]. Las recompensas son, como siempre, muy importantes. Esto se debe a que orientan al agente hacia estrategias rentables a largo plazo mediante señales delta para la retropropagación en la red del actor. En nuestro caso, una opción sencilla pero eficaz es:
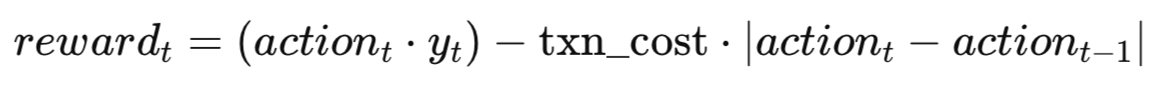
Donde:
- yt es el movimiento direccional del mercado
- txn_cost es una penalización proporcional a los cambios en la acción.
Así pues, en lugar de descartar las experiencias antiguas de interacción con el entorno, estas se almacenan en un gran búfer. Durante el entrenamiento, el agente extrae al azar minilotes de este búfer para actualizar sus redes. Este método elimina las correlaciones temporales de los datos financieros, estabiliza el aprendizaje y mejora la generalización.
En el ámbito del trading, esto implica que el agente es capaz de aprender de diversas condiciones pasadas del mercado, como los periodos de tendencia y las situaciones de cambios bruscos de dirección y señales falsas, sin limitarse únicamente al pasado reciente.
TD3 también cuenta con una variedad de hiperparámetros que influyen de manera bastante significativa en su rendimiento, especialmente en entornos como los mercados financieros. Entre ellos se encuentran el tamaño del lote, ya que los lotes más grandes suavizan las estimaciones del gradiente, pero suelen requerir más memoria; el factor de descuento, gamma, que hace que el agente valore las ganancias a largo plazo casi tanto como los beneficios inmediatos —un factor clave, especialmente en el swing trading—; la tasa de actualización suave, tau, que controla la lentitud con la que las redes objetivo siguen las actualizaciones de las redes en línea para evitar la inestabilidad; el ruido de la política y el límite de recorte del ruido, que regulan la aleatoriedad introducida en las acciones objetivo durante las actualizaciones de la red del crítico e impiden que la red se centre en valores atípicos aislados; y, por último, el retardo de actualización de la política, que garantiza que actualicemos la red del actor con menos frecuencia que las redes de los críticos, lo que estabiliza las mejoras de la política.
Asignar valores a cada uno de estos hiperparámetros es, en parte, una ciencia y, en parte, un arte. Sin embargo, en la práctica, se puede empezar con los valores predeterminados recomendados en los artículos sobre TD3 y, a continuación, ajustarlos en función de las características de los datos de negociación y de lo que mejor funcione. El bucle de entrenamiento funciona por épocas, en las que el agente recorre repetidamente las filas de los datos históricos. En cada paso, observamos el estado extrayendo del conjunto de datos las características, es decir, las señales de Ichimoku y ADX, que se agrupan en un vector; seleccionamos una acción generada por la red del actor, a la que se añade ruido de exploración durante el entrenamiento; a continuación, avanzamos en el entorno aplicando la acción, calculando la recompensa y desplazando nuestro índice al siguiente estado; después, almacenamos la transición guardando la tupla mostrada anteriormente en el búfer de experiencias; por último, realizamos el aprendizaje tomando periódicamente una muestra de un minilote del búfer de experiencias y actualizando las redes de los críticos y también la red del actor, aunque esta última con menor frecuencia.
La implementación de este entrenamiento en Python se muestra en el siguiente fragmento de nuestro código fuente:
if __name__ == "__main__":
    # Example dummy data; replace with your real x_data, y_data arrays
    T = 5000
    state_dim = 6
    action_dim = 1

#----------------------------MT5 Connections-------------------------
    if not mt5.initialize(login = 5040189685, server = "MetaQuotes-Demo", password = "JmYp-u4v"):
        print("initialize() failed, error code =",mt5.last_error())
        quit()

    # set start and end dates for history data
    from datetime import timedelta, datetime
    #end_date = datetime.now()
    end_date = datetime(2024, 7, 1, 0)
    start_date = datetime(2023, 7, 1, 0)

    # print start and end dates
    print("data start date =",start_date)
    print("data end date =",end_date)

    # get rates
    eurusd_rates = mt5.copy_rates_range("EURUSD", mt5.TIMEFRAME_H4, start_date, end_date)

    # create dataframe
    df = pd.DataFrame(eurusd_rates)

    df = Ichimoku(df)
    df = ADX_Wilder(df)

    index = 5
    scaler = 1

    x_data, drops = GetFeatures(index, scaler, df)
    y_data = GetStates(df, drops)

    ##    min_rows = min(len(x_data), len(y_data))
    min_rows = min(x_data.shape[0], y_data.shape[0])
    x_data = x_data[:min_rows]
    y_data =  y_data[:min_rows]

    print(" x rows =",x_data.shape[0])
    print(" y rows =",y_data.shape[0])

    # Example usage (your style)
    state_dim = x_data.shape[1]           # Example state dimension
    action_dim = y_data.shape[1]          # Example action dimension
    agent = TD3Agent(state_dim, action_dim)  # alias to TD3Agent

    # Load the environment
    env = CustomDataEnv(x_data, y_data, txn_cost=TXN_COST)

    epochs = 10

    # Training loop
    for epoch in range(epochs):
        s_np = env.reset()
        for row in range(x_data.shape[0]):
            # Build torch state
            state = torch.tensor(s_np, dtype=torch.float32)
            # Policy action (with exploration noise)
            action = agent.act(state, noise_scale=0.1)
            next_state, reward, done, info = env.step(action)
            agent.replay_buffer.add(state, action, reward, next_state, done)

            # Periodic learning
            if row % BATCH_SIZE == 0:
                agent.learn(batch_size=BATCH_SIZE)

            # Advance
            s_np = next_state
            if done:
                env.render()
                s_np = env.reset()

        print(f"Epoch {epoch+1}/{epochs} done. Buffer size={agent.replay_buffer.size}")

    # Export actor ONNX post-training
    os.makedirs("exports", exist_ok=True)
    out_path = agent.export_actor_onnx(os.path.join("exports",str(index)+"_"+str(scaler)+"_actor.onnx"))
    print(f"Exported trained actor to: {out_path}")
Tras un número adecuado de épocas —en el código anterior utilizamos 10—, la red del actor de TD3 debería aprender y desarrollar una correspondencia estable entre los estados y las acciones. En este momento, solo exportaríamos la red del actor. Este es el componente crucial del entorno en lo que respecta a la toma de decisiones. Las redes de los críticos, cuya función se centra principalmente en guiar la retropropagación de la red del actor, permanecerían en Python. La red del actor puede desplegarse entonces en MQL5 como un modelo ONNX, lo que proporciona señales de negociación más deterministas. Esta separación resulta muy eficaz, ya que Python se encarga del costoso proceso de entrenamiento, mientras que MQL5 ejecuta la inferencia en tiempo real con una sobrecarga mínima o nula.
Es durante la fase de entrenamiento cuando se integra la inteligencia del sistema. Una vez completado el entrenamiento, pasaríamos al siguiente paso, que consiste en exportar la red del actor a un formato ONNX compatible. ONNX es el puente que une la flexibilidad de Python con el entorno de negociación de MQL5. Esta configuración garantiza que el agente aprenda a evitar el exceso de operaciones. Una característica fundamental de los algoritmos «fuera de política», como TD3, es el búfer de experiencias. Cada interacción genera una tupla simple:
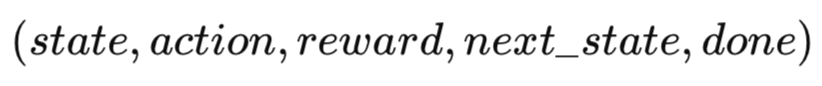
Exportación de TD3 a ONNX
Una vez que el agente TD3 ha completado su entrenamiento en Python, el siguiente paso consiste en exportar la red del actor para su implementación en MetaTrader. La forma más práctica de lograrlo es mediante el formato Open Neural Network Exchange (ONNX). Esto proporciona un formato de modelo independiente del marco de trabajo. ONNX nos permite entrenar modelos con PyTorch y, a continuación, realizar la inferencia de forma eficiente en MetaTrader a través de sus enlaces con el entorno de ejecución de ONNX.
¿Por qué solo exportamos la red del actor? Esto se debe a que, en TD3 —y, de hecho, en la mayoría de los algoritmos de aprendizaje por refuerzo (RL)—, el actor se encarga de generar las acciones necesarias para el estado actual que se presenta. La red del crítico solo es necesaria durante el entrenamiento, no durante la inferencia en tiempo real. Al exportar únicamente el actor, nos aseguramos de que el consumo de recursos en tiempo de ejecución sea mínimo y, además, evitamos las complejidades innecesarias que supone intentar realizar el entrenamiento en MQL5. Nuestro código de exportación en Python es el siguiente:
    # -------------------- ONNX Export --------------------
    def export_actor_onnx(self, path: str):
        self.actor.eval()
        dummy = torch.zeros(1, self.state_dim, dtype=torch.float32, device=DEVICE)
        torch.onnx.export(
            self.actor, dummy, path,
            export_params=True, opset_version=17, do_constant_folding=True,
            input_names=["state"], output_names=["action"], dynamic_axes=None
        )
        return path
En el código de nuestra función de exportación anterior, la entrada se denomina «state» y la salida, «action», con una forma del tensor de salida de [1, action_dim] para que coincida con el tamaño de la capa de salida. Tanto la capa de entrada como la de salida son tensores del tipo de datos float32. Además, utilizamos opset_version=17 para permitir la compatibilidad con los entornos de ejecución de ONNX actualizados, incluida la implementación de MQL5. Siempre es importante verificar la exportación antes de trasladar el archivo a MQL5, y para ello es necesario realizar pruebas en Python. Además de comprobar que el archivo esté bien formado, también podemos consultar y verificar la forma del tensor de entrada y la del tensor de salida, un requisito previo fundamental a la hora de inicializar recursos ONNX en MQL5.
Una vez confirmado el archivo ONNX e importada la política TD3 entrenada a un asesor experto de MQL5, la capacidad de toma de decisiones del modelo se materializa mediante la generación de señales de trading en el entorno de MetaTrader.
ONNX en MQL5
Una vez realizada la exportación de la red del actor TD3, el siguiente paso es importarla a MetaTrader 5. Como hemos visto en artículos anteriores, MQL5 cuenta con compatibilidad integrada con el entorno de ejecución ONNX, lo que permite ejecutar de forma nativa, durante la negociación, redes neuronales entrenadas en Python. Esto permite, por tanto, que los agentes de aprendizaje por refuerzo (RL) funcionen como si fueran proveedores de señales tradicionales dentro de un asesor experto. En MQL5, inicializamos un modelo ONNX como recurso en la función OnInit() de la clase de señales personalizada de la siguiente manera:
#resource "Python/0_1_actor.onnx" as uchar __81_0[]
#resource "Python/1_1_actor.onnx" as uchar __81_1[]
#resource "Python/5_1_actor.onnx" as uchar __81_5[]
#include <SRI\PipeLine.mqh>
#define __PATTERNS 3
//+------------------------------------------------------------------+
//| Constructor                                                      |
//+------------------------------------------------------------------+
CSignalRL_Ichimoku_ADXWilder::CSignalRL_Ichimoku_ADXWilder(void) : m_pattern_0(50),
   m_pattern_1(50),
   m_pattern_5(50)
//m_patterns_usage(255)
{
//--- initialization of protected data
   //
   //-----omitted source
   //
//--- create model from static buffer
   m_handles[0] = OnnxCreateFromBuffer(__81_0, ONNX_DEFAULT);
   m_handles[1] = OnnxCreateFromBuffer(__81_1, ONNX_DEFAULT);
   m_handles[2] = OnnxCreateFromBuffer(__81_5, ONNX_DEFAULT);
   //
   //-----omitted source
   //
}
Esto carga los tres modelos exportados correspondientes a nuestros patrones de señal 0, 1 y 5 mediante identificadores y los deja listos para las llamadas de inferencia durante la operativa. Las redes del actor TD3 de cada uno de los tres patrones de señal requieren que la forma del tensor de entrada coincida con la utilizada durante el entrenamiento. La forma del tensor es [1, state-dim] y su tipo es float32. Por ello, para completar la inicialización, realizamos una comprobación de validación en la función ValidationSettings(). Esto se codifica de la siguiente forma:
//+------------------------------------------------------------------+
//| Validation settings protected data.                              |
//+------------------------------------------------------------------+
bool CSignalRL_Ichimoku_ADXWilder::ValidationSettings(void)
{
//--- validation settings of additional filters
   if(!CExpertSignal::ValidationSettings())
      return(false);
//--- initial data checks
   const ulong _out_shape[] = {1, 1};
   for(int i = 0; i < __PATTERNS; i++)
   {  // Set input shapes
      int _in = 3;
      if(i == __PATTERNS - 1)
      {  _in = 7;
      }
      const ulong _in_shape[] = {1, _in};
      if(!OnnxSetInputShape(m_handles[i], ONNX_DEFAULT, _in_shape))
      {  Print("OnnxSetInputShape error ", GetLastError(), " for feature: ", i);
         return(false);
      }
      // Set output shapes
      if(!OnnxSetOutputShape(m_handles[i], 0, _out_shape))
      {  Print("OnnxSetOutputShape error ", GetLastError(), " for feature: ", i);
         return(false);
      }
   }
//--- ok
   return(true);
}
Si la forma del tensor de entrada que vamos a proporcionar a cada uno de estos modelos ONNX no coincide con la que espera el modelo, la inicialización fallará. Asimismo, es necesario verificar de la misma manera la forma del tensor de salida. Una vez que el modelo se ha inicializado y ha superado correctamente la validación, ejecutar la inferencia es bastante sencillo. Esto lo gestionamos en la función RunModel(), que se muestra a continuación:
//+------------------------------------------------------------------+
//| Forward Feed Network, to Get Forecast State.                     |
//+------------------------------------------------------------------+
double CSignalRL_Ichimoku_ADXWilder::RunModel(int Index, ENUM_POSITION_TYPE T, vectorf &X)
{  vectorf _y(1);
   _y.Fill(0.0);
   //Print(" x: ", __FUNCTION__, X);
   ResetLastError();
   if(!OnnxRun(m_handles[Index], ONNX_NO_CONVERSION, X, _y))
   {  printf(__FUNCSIG__ + " failed to get y forecast, err: %i", GetLastError());
      return(double(_y[0]));
   }
   //printf(__FUNCSIG__ + " pre y is: " + DoubleToString(_y[0], 5));
   if(T == POSITION_TYPE_BUY && _y[0] > 0.5f)
   {  _y[0] = 2.0f * (_y[0] - 0.5f);
   }
   else if(T == POSITION_TYPE_SELL && _y[0] < 0.5f)
   {  _y[0] = 2.0f * (0.5f - _y[0]);
   }
   //printf(__FUNCSIG__ + " post y is: ", DoubleToString(_y[0], 5));
   return(double(_y[0]));
}
Las salidas de este tipo de modelos de aprendizaje por refuerzo (RL) son muy personalizables. Por ejemplo, si el modelo genera más de una acción, como cuando las salidas son el tamaño de la posición y la dirección prevista, el vector de salida tendrá tantos componentes como acciones, en este caso dos. Estamos generando una salida unidimensional, cuyo valor de tipo float se espera que esté comprendido en el intervalo [0,1]. Esto significa que tenemos que convertir esta salida única en operaciones de trading. Para ello, adoptamos la siguiente interpretación simplificada:
- Si el valor de «Action» es igual o superior a 0.5f, abrimos o mantenemos una posición de compra.
- Si el valor de «Action» es inferior a 0.5f, abrimos o mantenemos una posición de venta.
Tenga en cuenta que no existe un umbral de neutralidad entre la compra y la venta, pero los lectores podrían explorar esta posibilidad utilizando un margen simétrico de neutralidad entre ambas. Por ejemplo, si este margen es 0,2, la zona de inactividad iría de -0.2f a 0.2f, y así sucesivamente. Establecer este umbral puede ayudar a evitar que el asesor experto opere en exceso, dada su sensibilidad a las pequeñas fluctuaciones en torno al cero. Si el asesor experto se optimiza con un tamaño de posición no fijo, sino continuo, la magnitud de la acción podría escalarse a un tamaño de lote dentro de los límites permitidos por el bróker.
El preprocesamiento de datos está cobrando cada vez más importancia. El módulo de Python de SCIKIT-LEARN ha contribuido a consolidar el preprocesamiento como un paso muy importante para normalizar o estandarizar los datos antes de introducirlos en una red o un modelo. Ahora bien, siempre que esto se haga en Python durante el entrenamiento, es fundamental aplicar exactamente el mismo escalado a los datos de entrada antes de realizar la inferencia. Si durante el entrenamiento se ha utilizado escalado min-máx, escalado estándar, escalado robusto, etc., es necesario aplicar esas transformaciones exactas antes de llamar a la función RunModel(). Cualquier desajuste en el escalado provocará que la red del actor se comporte de forma impredecible.
Dentro de la función Direction(), que llama a las importantes funciones LongCondition() y ShortCondition(), nuestra secuencia efectiva consiste en construir un vector de características a partir de las barras recientes; escalar las características para que se ajusten a la transformación de entrenamiento, que en nuestro caso es el escalador estándar; pasar estas características al modelo ONNX; convertir la acción de salida en una decisión de compra o venta; y, por último, ejecutar operaciones usando los umbrales de apertura y cierre de la señal personalizada de MQL5.
Esta secuencia convierte a la red del actor de TD3 en el cerebro que toma las decisiones del asesor experto. La plataforma MQL5 permite crear asesores expertos mediante el Asistente de MQL5, con el que los operadores pueden desarrollar prototipos de robots de trading a partir de bloques de código modulares. Para los nuevos lectores, aquí y aquí hay guías sobre cómo hacerlo. Como ya hemos visto en esta serie, el principal de estos bloques es una clase de señales personalizada que suele usar indicadores como RSI o las medias móviles; este bloque se combina con bloques de código de gestión monetaria y de trailing stop implementados como clases independientes. Integramos el aprendizaje por refuerzo (RL) en este ecosistema a través de la clase de señales, mediante una clase de señales personalizada que el Asistente de MQL5 puede reconocer.
La implementación de las condiciones de compra y venta dentro de esta clase es la siguiente:
//+------------------------------------------------------------------+
//| "Voting" that price will grow.                                   |
//+------------------------------------------------------------------+
int CSignalRL_Ichimoku_ADXWilder::LongCondition(void)
{  int result  = 0, results = 0;
   vectorf _x;
//--- if the model 0 is used
   if(((m_patterns_usage & 0x01) != 0))
   {  matrixf _raw = IsPattern_0();
      matrixf _fitted(_raw.Rows(), _raw.Cols());
      if(m_pipeline.FitTransformPipeline(_raw, _fitted))
      {  _x = _fitted.Row(0);
         //Print(" buy x: ", __FUNCTION__, _x);
         double _y = RunModel(0, POSITION_TYPE_BUY, _x);
         if(_y > 0.0)
         {  result += m_pattern_0;
            results++;
         }
      }
   }
//--- if the model 1 is used
   if(((m_patterns_usage & 0x02) != 0))
   {  matrixf _raw = IsPattern_1();
      matrixf _fitted(_raw.Rows(), _raw.Cols());
      if(m_pipeline.FitTransformPipeline(_raw, _fitted))
      {  _x = _fitted.Row(0);
         double _y = RunModel(1, POSITION_TYPE_BUY, _x);
         if(_y > 0.0)
         {  result += m_pattern_1;
            results++;
         }
      }
   }
//--- if the model 5 is used
   if(((m_patterns_usage & 0x20) != 0))
   {  matrixf _raw = IsPattern_5();
      matrixf _fitted(_raw.Rows(), _raw.Cols());
      if(m_pipeline.FitTransformPipeline(_raw, _fitted))
      {  _x = _fitted.Row(0);
         double _y = RunModel(2, POSITION_TYPE_BUY, _x);
         if(_y > 0.0)
         {  result += m_pattern_5;
            results++;
         }
      }
   }
//--- return the result
//if(result > 0)printf(__FUNCSIG__+" result is: %i",result);
   if(results > 0 && result > 0)
   {  return(int(round(result / results)));
   }
   return(0);
}
//+------------------------------------------------------------------+
//| "Voting" that price will fall.                                   |
//+------------------------------------------------------------------+
int CSignalRL_Ichimoku_ADXWilder::ShortCondition(void)
{  int result  = 0, results = 0;
   vectorf _x;
//--- if the model 0 is used
   if(((m_patterns_usage & 0x01) != 0))
   {  matrixf _raw = IsPattern_0();
      matrixf _fitted(_raw.Rows(), _raw.Cols());
      if(m_pipeline.FitTransformPipeline(_raw, _fitted))
      {  _x = _fitted.Row(0);
         //Print(" sell x: ", __FUNCTION__, _x);
         double _y = RunModel(0, POSITION_TYPE_SELL, _x);
         if(_y > 0.0)
         {  result += m_pattern_0;
            results++;
         }
      }
   }
//--- if the model 1 is used
   if(((m_patterns_usage & 0x02) != 0))
   {  matrixf _raw = IsPattern_1();
      matrixf _fitted(_raw.Rows(), _raw.Cols());
      if(m_pipeline.FitTransformPipeline(_raw, _fitted))
      {  _x = _fitted.Row(0);
         double _y = RunModel(1, POSITION_TYPE_SELL, _x);
         if(_y > 0.0)
         {  result += m_pattern_1;
            results++;
         }
      }
   }
//--- if the model 5 is used
   if(((m_patterns_usage & 0x20) != 0))
   {  matrixf _raw = IsPattern_5();
      matrixf _fitted(_raw.Rows(), _raw.Cols());
      if(m_pipeline.FitTransformPipeline(_raw, _fitted))
      {  _x = _fitted.Row(0);
         double _y = RunModel(2, POSITION_TYPE_SELL, _x);
         if(_y > 0.0)
         {  result += m_pattern_5;
            results++;
         }
      }
   }
//--- return the result
//if(result > 0)printf(__FUNCSIG__+" result is: %i",result);
   if(results > 0 && result > 0)
   {  return(int(round(result / results)));
   }
   return(0);
}
Resultados de las pruebas
No importa si un algoritmo de aprendizaje por refuerzo (RL) resulta muy prometedor durante el entrenamiento o sobre el papel; al fin y al cabo, tiene que superar un obstáculo muy importante. Pruebas prospectivas. El Probador de Estrategias de MetaTrader ofrece un entorno razonable para simular condiciones reales que, en cierta medida, permite evaluar el asesor experto con datos no utilizados previamente, al tiempo que tiene en cuenta las reglas de ejecución, los spreads y la gestión de órdenes. Tal y como hemos explicado en artículos anteriores, a diferencia de las pruebas retrospectivas —en las que optimizamos los parámetros del asesor experto para obtener el mejor rendimiento con esos datos de entrenamiento o precios—, en una prueba prospectiva simplemente comprobamos si esos mismos parámetros ofrecen un rendimiento similar con datos de precios no utilizados previamente.
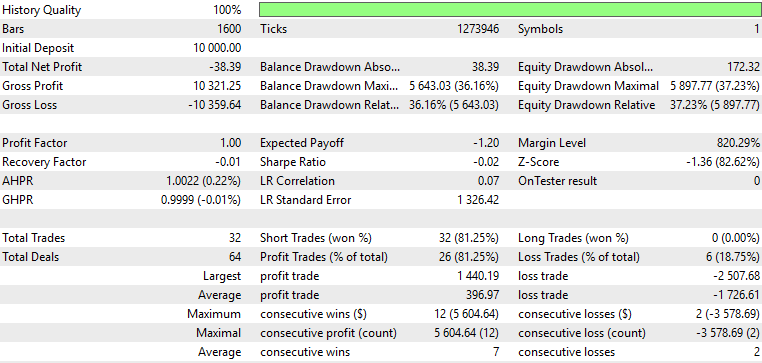
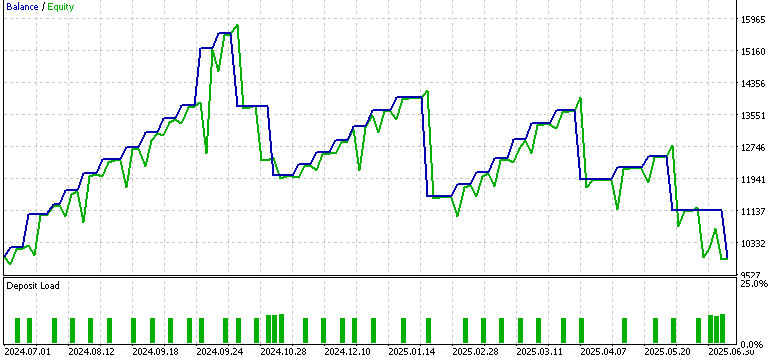
Para este artículo, hemos realizado tres pruebas independientes, una para cada uno de los tres patrones de señal (0, 1 y 5) del artículo de la parte 74. Cada uno de estos patrones contaba con una red del actor independiente, que se entrenó en Python y, posteriormente, se exportó en formato ONNX. Los tres se entrenaron con el par de divisas EUR/USD y en el marco temporal de 4 horas. El periodo de entrenamiento fue del 1 de julio de 2023 al 1 de julio de 2024. El periodo posterior de prueba prospectiva se extendió desde el 1 de julio de 2024 hasta el 1 de julio de 2025. Hemos introducido algunos cambios en el vector de entrada de las redes, además de seguir utilizando las cadenas de preprocesamiento del artículo anterior. No utilizamos entradas en formato binario para la red del actor. Recordemos que, en el pasado, cuando, por ejemplo, barajamos la posibilidad de incorporar el aprendizaje supervisado a la señal como forma de sistematizar mejor la señal del asesor experto, el vector de entrada estaba compuesto exclusivamente por ceros y unos. La presencia de un «1» en cualquier dimensión indicaba que se cumplían todos los criterios importantes del patrón de señal seleccionado, ya fuera para la señal alcista o para la bajista.
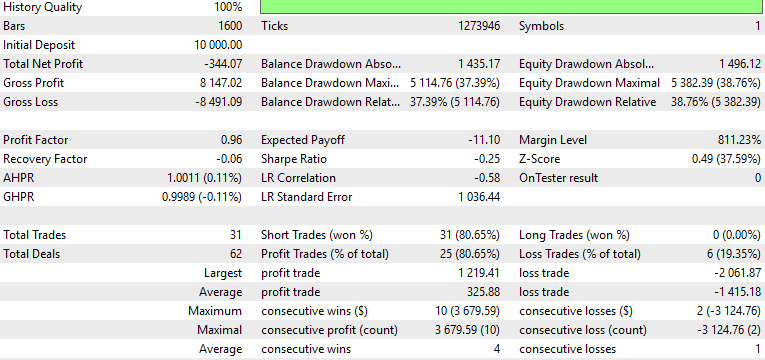
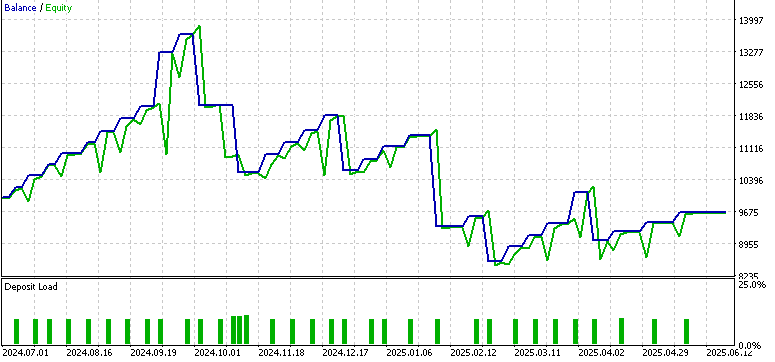
En este artículo, con el objetivo de explorar nuevas posibilidades y aprovechar el potencial de las cadenas de preprocesamiento, volvemos a experimentar con entradas en coma flotante, es decir, vectores con múltiples valores de tipo «double». Así pues, nuestros vectores de entrada recogen la magnitud de las lecturas de los indicadores que se comprueban, por lo que no tienen un tamaño estándar, como el de dos componentes que utilizábamos en artículos anteriores. A continuación se presentan los resultados, que distan mucho de los que obtuvimos la última vez que utilizamos vectores de entrada binarios; solo el patrón de señal 5 muestra cierto potencial en la prueba prospectiva.
Patrón 0:
Patrón 1:
Patrón 5:
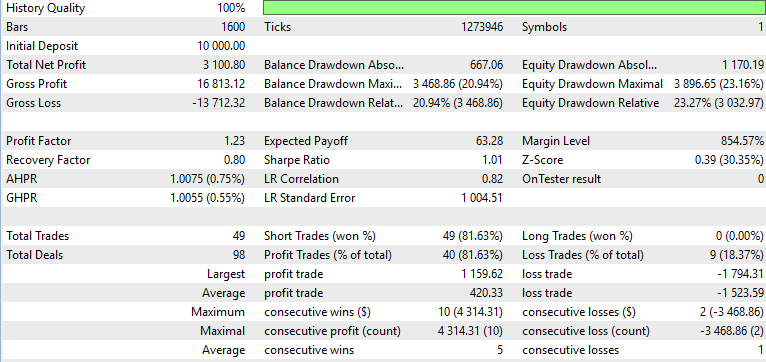
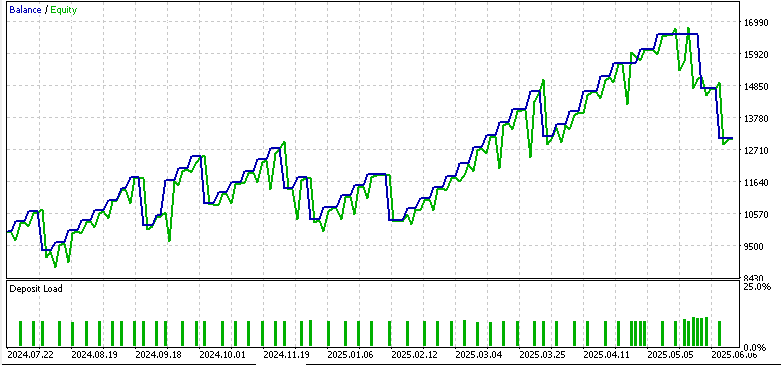
De los informes anteriores se desprende, tal y como se ha señalado anteriormente, que el cambio que realizamos en el formato de las características de entrada —de valores binarios (0 y 1) a una versión más continua— afectó negativamente a nuestro rendimiento. No obstante, estos cambios se realizaron para aprovechar el preprocesamiento de datos que hemos introducido recientemente y que cabe considerar importante. Se podría argumentar que la implementación del preprocesamiento que hemos elegido en este artículo podría no ser la óptima; por lo tanto, en futuros artículos analizaré cómo se podría perfeccionar.
Conclusión
Para terminar, hemos demostrado aquí que TD3 se puede entrenar en Python, exportar mediante ONNX e integrar en MQL5 como una clase de señales personalizada. Sin embargo, nuestro enfoque en este caso es un poco heterodoxo, ya que utilizamos el aprendizaje por refuerzo como si fuera aprendizaje supervisado, en el sentido de que no realizamos ningún entrenamiento ni retropropagación cuando llevamos a cabo la inferencia u operamos en tiempo real. Aunque el entrenamiento y la retropropagación se realizan durante la simulación o el entrenamiento en Python, en el aprendizaje por refuerzo (RL) suele ser necesario o esperable que ambos continúen durante el funcionamiento en producción.
Las pruebas prospectivas que realizamos con los patrones de señal 0, 1 y 5 revelaron que la transición de entradas binarias a vectores de características continuas puede resultar problemática, ya que solo el patrón 5 arrojó resultados moderadamente alentadores. Aunque estos resultados han sido dispares, sí que ponen de manifiesto el carácter iterativo de la investigación, es decir, que las pruebas posteriores aportan mejoras que nos acercan a sistemas de negociación sólidos. En futuros artículos, se considerarán la optimización de estas cadenas de preprocesamiento, una selección de características más matizada y, probablemente, pruebas prospectivas más elaboradas, a medida que vayamos introduciendo mejoras.
| nombre | descripción |
|---|---|
| WZ-81.mq5 | Asesor experto creado con el Asistente de MQL5, cuyo encabezado enumera los archivos a los que hace referencia |
| SignalWZ-81.mqh | Archivo de la clase de señales personalizada utilizado en la creación del asesor experto con el Asistente de MQL5 |
| 0-1-actor.onnx | Red exportada del patrón 0 |
| 1-1-actor.onnx | Red del patrón 1 |
| 5-1-actor.onnx | Red del patrón 5 |
| PipeLine.mqh | Clases para los distintos tipos de transformación |
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/19627
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Redes neuronales en el trading: De los Transformer a las neuronas de impulsos (SpikingBrain)
 Algoritmo del Bisonte: Bison Algorithm (BIA)
 Automatización de estrategias de trading en MQL5 (Parte 33): Creación de un sistema basado en el patrón armónico Shark y la acción del precio
 Cómo crear y optimizar un sistema de trading basado en ciclos (Detrended Price Oscillator - DPO)

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso