

Características del Wizard MQL5 que debe conocer (Parte 82): Uso de patrones del TRIX y del WPR con aprendizaje por refuerzo mediante una red Q profunda (DQN)
 17
 0

Introducción
A la hora de operar con robots o asesores expertos, la búsqueda de reglas de trading estructuradas y repetibles suele comenzar con indicadores técnicos con los que se está familiarizado. Con frecuencia se tiende a experimentar con osciladores, medias móviles y patrones basados en los precios con el fin de elaborar estrategias que puedan resistir los cambios en los regímenes de mercado. Entre ellos, el TRIX —también conocido como «media móvil exponencial suavizada tres veces»— y el WPR —también denominado «rango porcentual de Williams»— forman una pareja clásica. El indicador TRIX suele captar el impulso filtrando el ruido de los precios a corto plazo, mientras que el WPR destaca las situaciones de sobrecompra o sobreventa. Por lo tanto, los patrones de ambos indicadores pueden complementarse al combinarse y ayudar a detectar puntos de inflexión o la continuación de los movimientos del precio.
En general, las estrategias que se han desarrollado a partir de estos indicadores suelen basarse en reglas fijas. Por ejemplo, estas reglas pueden ser «comprar cuando el TRIX cruce por encima de cero y el WPR esté por debajo de -80» o «vender cuando el TRIX alcance un máximo mientras el WPR esté por encima de -20». A pesar de su carácter determinista y de que son fáciles de someter a pruebas retrospectivas, presentan una debilidad común, que consiste en dar por sentada una relación estática en un mercado altamente dinámico. Por este motivo, su probabilidad de acierto puede verse mermada cuando cambian las condiciones imperantes, por lo que estos «umbrales absolutos» deben ajustarse en cierta medida.
Esta situación complicada, por tanto, allana el camino para el aprendizaje por refuerzo (RL). El RL forma parte de las técnicas de aprendizaje automático que tratan de aprender las acciones adecuadas a partir de la experiencia o de la interacción con el entorno. En lugar de basarse exclusivamente en umbrales preestablecidos para los indicadores, un agente de aprendizaje por refuerzo (RL) puede explorar diferentes niveles de umbral y, de este modo, ajustar el proceso de toma de decisiones de trading con el fin de maximizar las recompensas a largo plazo. Para la mayoría de los traders, esto se traduciría en un sistema que no se limita a seguir unas reglas, sino que se adapta; al menos, en teoría.
Uno de los métodos de aprendizaje por refuerzo (RL) que parece prometedor en el ámbito del trading es la red Q profunda (DQN). A diferencia de los modelos de aprendizaje supervisado, que intentan establecer una correspondencia directa entre las entradas y las salidas, las redes DQN evalúan el valor de realizar determinadas acciones en estados concretos. En el contexto del trading, los estados pueden ser características obtenidas a partir de indicadores, ya sea tras aplicar transformaciones en una cadena de procesamiento, en formato binario o incluso como valores sin procesar. En este artículo, esos indicadores son el TRIX y el WPR. Por otra parte, las acciones pueden consistir en comprar, vender o mantenerse neutral. El framework de aprendizaje por refuerzo con DQN permite evaluar y ajustar estas acciones a partir de la experiencia, en lugar de basarse en reglas fijas y arbitrarias.
Por lo tanto, esta 82.ª entrega de la serie se centra en los patrones de los indicadores TRIX y WPR con el algoritmo de aprendizaje por refuerzo DQN. Empezaremos analizando qué es una red Q profunda (DQN) y cómo encaja en el ámbito más amplio de los algoritmos de aprendizaje por refuerzo. A continuación, analizaremos la implementación en Python de una red DQN con regresión cuantílica en la clase que hemos denominado «QuantileNetwork». Además, veremos los retos que plantea el despliegue de modelos de aprendizaje por refuerzo en MetaTrader. Por último, estudiaremos los resultados del Probador de Estrategias correspondientes a los tres patrones de los indicadores TRIX y WPR en los que nos habíamos centrado: el 1, el 4 y el 5. El objetivo general de este artículo es tender un puente entre la teoría y la aplicación práctica mediante el uso del Asistente de MQL5, mostrando tanto las oportunidades como los inconvenientes de este flujo de trabajo híbrido.
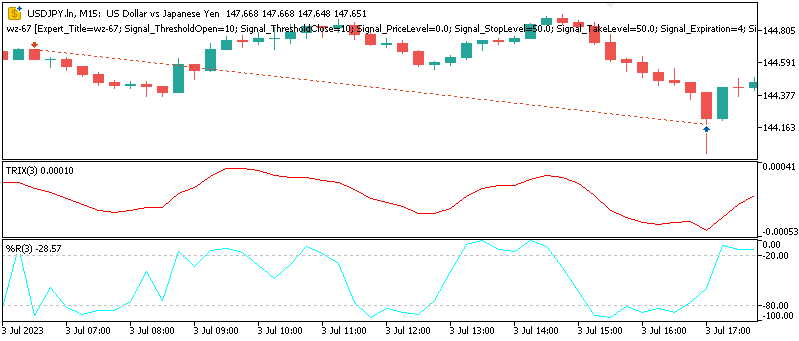
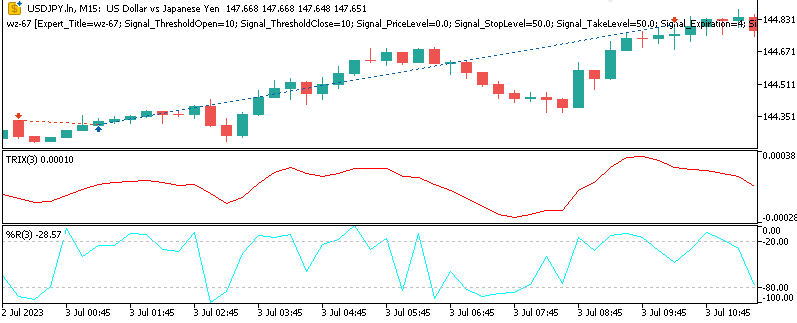
Los patrones 1, 4 y 5 se representan de la siguiente manera en un gráfico:
Patrón 1
La señal bajista se registra cuando se produce una divergencia negativa en el TRIX y el WPR se encuentra en la zona de resistencia o de sobrecompra.
Patrón 4
La señal alcista se produce cuando el TRIX rompe una resistencia mientras el WPR se sitúa entre -50 y -20.
Patrón 5
La señal bajista se produce cuando el TRIX invierte su dirección desde un nivel de sobreventa y el WPR sale de la zona de sobreventa, lo que sugiere un posible retroceso hacia una tendencia bajista.

Redes Q profundas: aprendizaje por refuerzo basado en el valor
Para comprender mejor por qué las redes DQN son tan adecuadas para su uso en el ámbito del trading, podría resultar útil empezar por repasar los fundamentos del aprendizaje por refuerzo. En esencia, el aprendizaje por refuerzo (RL) es una forma sistemática en la que un agente interactúa con un entorno determinado. En cada paso temporal o intervalo, este agente observa el estado actual, realiza una acción y, a continuación, recibe una recompensa por ello en proporción a lo deseable que sea la acción que ha llevado a cabo. El objetivo final del agente es obtener, a lo largo del tiempo, la mayor recompensa acumulada posible; algo que puede lograr si su política —la correspondencia entre estados y acciones— también mejora con el tiempo.
En los mercados, el estado podría incluir un conjunto de indicadores técnicos, como se ha mencionado anteriormente, que podrían abarcar desde valores brutos hasta transformaciones de la cadena de procesamiento. Las acciones, como también se ha señalado, pueden corresponder a decisiones de negociación como adoptar una posición larga, una posición corta o mantenerse neutral. La recompensa que recibe el agente suele expresarse en términos de pérdidas y ganancias, teniendo en cuenta en ocasiones los costes de transacción o incluso la exposición a las variaciones del precio. Sin embargo, hay que tener en cuenta que, a diferencia del aprendizaje supervisado, no existe una única respuesta correcta que se pueda copiar. Más bien, el agente tiene la misión de descubrir, principalmente mediante la exploración, qué opciones dan lugar sistemáticamente a mayores recompensas.
Una red Q profunda (DQN) se basa en el principio del aprendizaje Q. Este es uno de los algoritmos basados en el valor más consolidados del aprendizaje por refuerzo e introduce el concepto de función de valor Q. Esta función se representa como Q(s, a) y estima la recompensa futura esperada al realizar la acción a cuando el agente observa el estado s y, posteriormente, sigue la política óptima. Si esta función Q es precisa, la acción más adecuada en cualquier momento dado será aquella que tenga el valor Q más alto. Las implementaciones clásicas del aprendizaje Q almacenan estos valores Q en una tabla, lo cual solo es viable cuando el espacio de acciones y las dimensiones del estado son manejables.
Sin embargo, los mercados financieros suelen generar estados continuos y de alta dimensión, lo que hace que los métodos basados en tablas no resulten muy prácticos. Es precisamente ante esta limitación donde el aprendizaje profundo amplía las posibilidades de este método. En lugar de basarse en una tabla de consulta, una red neuronal profunda estima la función Q. Es precisamente esta simbiosis entre el aprendizaje por refuerzo y el aprendizaje profundo la que da origen a la red Q profunda (DQN).
El proceso de entrenamiento de una red Q profunda (DQN) refleja la naturaleza tanto iterativa como adaptativa del propio trading. Las transiciones, compuestas por el estado, la acción, la recompensa, el siguiente estado y un indicador de finalización, se almacenan en un búfer de repetición de experiencias. A continuación, la red se entrena con minilotes que se extraen aleatoriamente de este búfer. Este muestreo aleatorio tiene por objeto reducir la correlación entre muestras consecutivas y, por lo tanto, estabilizar el proceso de aprendizaje.
Otra característica de este enfoque es el uso de una red objetivo. Esta red, que se actualiza gradualmente, es una copia de la red Q. Su objetivo es evitar los bucles de retroalimentación desestabilizadores que inevitablemente se producen cuando la red aprende directamente a partir de sus propias previsiones, que se revisan constantemente. Este mecanismo de actualización se basa en la ecuación de Bellman, según la cual los parámetros de la red se ajustan para minimizar la diferencia entre las recompensas y las estimaciones basadas en los rendimientos futuros descontados. La capacidad de explorar se mantiene introduciendo un cierto grado de aleatoriedad en las decisiones del agente. Esto suele adoptar la forma de una política épsilon-greedy, cuyo objetivo es garantizar que el modelo no quede atrapado en una explotación prematura de un único patrón. Épsilon es un valor de coma flotante cercano a cero, por lo que suele corresponder a un porcentaje muy pequeño.
En el contexto del trading, este proceso implica que la red aprende gradualmente a identificar qué patrones de los indicadores tienen más probabilidades de preceder a determinadas configuraciones rentables. Todo esto ocurre mientras se siguen probando opciones alternativas de indicadores con el fin de evitar el sobreajuste a los datos históricos o, dicho de forma más concisa, el sesgo de recencia. Las redes Q profundas (DQN) suelen destacar en este contexto porque se adaptan de forma natural a espacios de acciones discretas, como la elección entre adoptar una posición larga, una corta o mantenerse neutral. Lo hacen sin dejar de ser capaces de aprender de forma adaptativa, en lugar de basarse en umbrales estáticos. Sin embargo, lo más importante es que tienen la capacidad de tener en cuenta la realidad de las recompensas diferidas, dado que la rentabilidad no siempre se materializa tan pronto como se toma una decisión. Por lo tanto, al descontar las recompensas futuras, la DQN tiende a equilibrar las recompensas inmediatas con la rentabilidad a largo plazo.
En el estudio realizado para este artículo, las características se obtienen a partir de TRIX y WPR para definir el estado que se utiliza como entrada. Las acciones discretas se corresponderán con las posiciones que el operador puede adoptar. Estas opciones pueden incluir órdenes pendientes si se busca un planteamiento más elaborado, pero nos limitaremos a adoptar una posición larga, una corta o mantenernos neutrales. El entrenamiento de un modelo DQN con datos históricos permite que el modelo capte las interacciones que pueden darse entre estos indicadores y que quizá no resulten evidentes al aplicar reglas fijas. Con este enfoque, la red adquiere la capacidad de asignar valores relativos a las acciones. Esto transforma las señales brutas de los indicadores técnicos en políticas de negociación aplicables que combinan adaptabilidad y capacidad de anticipación.
Aprendizaje por refuerzo basado en valores frente a los métodos basados en políticas y los métodos actor-crítico
He pensado en incluir también una comparación entre estos dos enfoques. Las redes Q profundas pertenecen a la familia de algoritmos de aprendizaje por refuerzo basados en valores, que se caracterizan por centrarse en estimar el valor de las acciones, en lugar de aprender una pseudocorrespondencia directa entre estados y acciones. Dicho de otro modo, un agente basado en valores intenta responder a la pregunta: «Si realizo esta acción ahora, ¿qué recompensa puedo esperar obtener a largo plazo?». Por el contrario, otros métodos de aprendizaje por refuerzo no suelen centrarse en valorar las acciones, sino en aprender directamente la política o en combinar de algún modo la valoración con el aprendizaje de la política. Comprender estas diferencias puede resultar fundamental, sobre todo a la hora de evaluar en qué medida cada método se ajusta a los requisitos específicos para operar con éxito en los mercados.
Los métodos basados en políticas, como REINFORCE o la optimización proximal de políticas (PPO), ni siquiera estiman los valores Q. En su lugar, parametrizan la propia política como una distribución de probabilidad sobre las acciones posibles. Por ello, el proceso de aprendizaje ajusta la política para que las acciones que conducen a mayores recompensas acumuladas sean seleccionadas mediante muestreo con mayor frecuencia. Un enfoque como este resulta especialmente útil en entornos en los que los espacios de acción son continuos y en los que no sería viable discretizar todas las opciones posibles. Para los traders, los métodos basados en políticas pueden, en principio, generar un rango continuo de tamaños de posición, que incluso pueden llevar un signo (+ o −) para indicar posiciones largas o cortas, en lugar de limitarse a nuestro reducido espacio de tres opciones: posición larga, posición corta o estado neutral. Sin embargo, los métodos de gradiente de políticas suelen presentar una elevada varianza durante la actualización, lo que normalmente requiere más datos para su estabilización en comparación con los métodos basados en valores.
Los enfoques actor-crítico intentan aunar los puntos fuertes de ambos mundos. En este enfoque híbrido, el «actor» representa la política y determina qué acciones llevar a cabo. Por su parte, el «crítico» evalúa estas acciones seleccionadas ofreciendo una estimación de su valor. Gracias al trabajo conjunto de estos dos componentes, los algoritmos actor-crítico pueden aportar estabilidad al proceso de aprendizaje y hacer que las actualizaciones de la política sean más eficientes. En los mercados financieros, los enfoques actor-crítico podrían permitir que un modelo propusiera acciones de negociación de intensidad variable, mientras que el «crítico» se encargaría de refinar la selección de esas acciones. Entre los ejemplos más consolidados de esta combinación se encuentran el método actor-crítico con ventaja (A2C), Deep Deterministic Policy Gradient (DDPG) y Twin Delayed DDPG (también conocido como TD3 y tratado recientemente).
Por consiguiente, la principal diferencia entre los métodos basados en valores y los basados en políticas radica en el equilibrio entre simplicidad y flexibilidad. Las redes Q profundas (DQN), basadas en valores, suelen ser más sencillas de implementar, sobre todo cuando el espacio de acciones es discreto por naturaleza. Además, tienden a converger mucho más rápido en entornos en los que son habituales las recompensas tardías, pero discretas. Esto debería hacer que resulten más atractivas para situaciones de negociación que puedan plantearse como una elección entre un número limitado de opciones. Aunque los métodos basados en políticas y los métodos actor-crítico son potentes sobre el papel, introducen cierta complejidad. Esto, a su vez, aumenta los requisitos de recursos computacionales y suele plantear dificultades de implementación en plataformas como la nuestra, MetaTrader, donde la retropropagación de modelos ONNX entrenados de forma eficiente no se puede gestionar de forma nativa. Hablaremos de ello más adelante.
Implementación en Python de la red de cuantiles
El código en el que se basa el asesor experto presentado en este artículo ofrece un ejemplo sólido de cómo adaptar una red Q profunda al trading mediante regresión cuantílica. El código se muestra a continuación:# ---------------------------- QR-DQN Core --------------------------- class QuantileNetwork(nn.Module): def __init__(self, state_dim: int, action_dim: int, hidden: int = 256, num_quantiles: int = NUM_QUANTILES): super().__init__() self.num_quantiles = num_quantiles self.action_dim = action_dim self.fc1 = nn.Linear(state_dim, hidden) self.fc2 = nn.Linear(hidden, hidden) self.fc3 = nn.Linear(hidden, hidden) self.fc4 = nn.Linear(hidden, action_dim * num_quantiles) fanin_init(self.fc1.weight); nn.init.zeros_(self.fc1.bias) fanin_init(self.fc2.weight); nn.init.zeros_(self.fc2.bias) fanin_init(self.fc3.weight); nn.init.zeros_(self.fc3.bias) nn.init.uniform_(self.fc4.weight, -3e-3, 3e-3); nn.init.zeros_(self.fc4.bias) def forward(self, x): x = F.relu(self.fc1(x)) x = F.relu(self.fc2(x)) x = F.relu(self.fc3(x)) q = self.fc4(x) # [batch, action_dim * num_quantiles] # FIX: only one inferred dimension allowed — reshape explicitly return q.view(x.size(0), self.num_quantiles, self.action_dim) # [batch, N, A] def q_values(self, x): q = self.forward(x) # [batch, N, A] return q.mean(dim=1) # [batch, A]
La clase principal de nuestro proyecto en Python, QuantileNetwork, se encarga de aproximar la función Q. Esto constituye la esencia del aprendizaje por refuerzo basado en valores. Mientras que una DQN estándar genera una única estimación del valor Q para cada acción, la variante de cuantiles amplía esta capacidad al predecir una distribución de posibles resultados. Esto puede resultar especialmente relevante en el ámbito del trading, donde la incertidumbre de los mercados es tan importante como la expectativa media. Al modelar la distribución completa mediante varios cuantiles, la red puede captar no solo la recompensa esperada, sino también el riesgo asociado a cada acción.
Nuestra clase de red de cuantiles está estructurada como una red neuronal totalmente conectada de cuatro capas lineales. Las tres primeras de las cuatro capas aplican transformaciones lineales seguidas de una función de activación lineal rectificada (ReLU). El objetivo es que la red sea capaz de reconocer relaciones no lineales entre los estados de entrada y las acciones generadas. La cuarta capa constituye la cabeza de salida de la red, y sus dimensiones se ajustan al número de acciones y de cuantiles.
Durante el entrenamiento y la inferencia, esta salida plana se reorganiza en un tensor de dimensiones tamaño del lote × número de cuantiles. En la práctica, esto implica que, para cada estado introducido, la red debe disponer de un conjunto de valores Q basados en cuantiles para todas las acciones posibles. Al calcular la media de estos cuantiles, el modelo puede recuperar un valor Q convencional, adecuado para la toma de decisiones, sin perder la flexibilidad esencial para el análisis de riesgos cuando sea necesario.
La inicialización de los pesos se lleva a cabo con mucho cuidado, aplicando un escalado «fan-in» a las capas iniciales. Para la capa de salida final se usan distribuciones uniformes de rango reducido. Esta forma de inicialización es esencial en el aprendizaje por refuerzo, ya que las distribuciones inestables de los pesos pueden tender a amplificar cualquier ruido presente en los datos. Esto desestabilizaría el proceso de entrenamiento; por lo tanto, al garantizar cierto equilibrio en los valores iniciales de los pesos, la red cuantílica puede evitar, hasta cierto punto, una divergencia prematura y mejorar su convergencia durante el proceso de optimización y retropropagación.
El agente que utilizamos con nuestra red Q profunda (DQN) coordina el proceso de aprendizaje manteniendo la red cuantílica principal junto con una red objetivo, que no es más que una copia de nuestra red cuantílica. Dicha copia se actualiza periódicamente mediante un mecanismo de actualización suave. Esta actualización diferida garantiza que los objetivos utilizados en el entrenamiento evolucionen de forma gradual, en lugar de hacerlo de manera errática. Además, el agente también es fundamental para inicializar el optimizador, que en nuestro caso es Adam. Adam resulta adecuado para gestionar las actualizaciones basadas en gradientes ruidosos, características del aprendizaje por refuerzo. El listado de código de nuestro agente es el siguiente:
class QRDQNAgent:
    def __init__(self, state_dim: int, action_dim: int, hidden: int = 256):
        self.state_dim = state_dim
        self.action_dim = action_dim
        self.num_quantiles = NUM_QUANTILES

        self.net        = QuantileNetwork(state_dim, action_dim, hidden).to(DEVICE)
        self.target_net = QuantileNetwork(state_dim, action_dim, hidden).to(DEVICE)
        self.target_net.load_state_dict(self.net.state_dict())

        self.optimizer = optim.Adam(self.net.parameters(), lr=LR)
        self.replay_buffer = ReplayBuffer(capacity=100_000, state_dim=state_dim)

        # quantile fractions τ_i (midpoints)
        self.taus = torch.linspace(0.0 + 1.0/(2*self.num_quantiles),
                                   1.0 - 1.0/(2*self.num_quantiles),
                                   self.num_quantiles, device=DEVICE).view(1, -1)  # [1, N]

    @torch.no_grad()
    def act(self, state: torch.Tensor, epsilon: float = 0.1) -> int:
        if np.random.rand() < epsilon:
            return np.random.randint(self.action_dim)
        q_vals = self.net.q_values(state.unsqueeze(0).to(DEVICE))  # [1, A]
        return int(torch.argmax(q_vals, dim=1).item())

    def _quantile_huber_loss(self, preds: torch.Tensor, target: torch.Tensor, taus: torch.Tensor) -> torch.Tensor:
        """
        preds:  [B, N]   (predicted quantiles for chosen action)
        target: [B, N]   (target quantiles)
        taus:   [1, N]
        """
        diff = target.unsqueeze(1) - preds.unsqueeze(2)  # [B, N, N]
        huber = torch.where(diff.abs() <= KAPPA,
                            0.5 * diff.pow(2),
                            KAPPA * (diff.abs() - 0.5 * KAPPA))
        tau = taus.view(1, -1, 1)  # [1, N, 1]
        loss = (torch.abs(tau - (diff.detach() < 0).float()) * huber).mean()
        return loss

    def learn(self, batch_size: int = BATCH_SIZE):
        if self.replay_buffer.size < batch_size:
            return

        s, a, r, ns, d = self.replay_buffer.sample(batch_size)

        with torch.no_grad():
            # Double DQN selection w/ target evaluation (simple variant)
            q_next_online = self.net.q_values(ns)                  # [B, A]
            a_next = q_next_online.argmax(dim=1, keepdim=True)     # [B,1]
            q_next_all = self.target_net(ns)                       # [B, N, A]
            q_next_sel = q_next_all.gather(2, a_next.unsqueeze(1).expand(-1, self.num_quantiles, 1)).squeeze(-1)  # [B, N]
            target = r + (1.0 - d) * GAMMA * q_next_sel            # broadcast [B,1] + [B,N] -> [B,N]

        q_preds_all = self.net(s)                                  # [B, N, A]
        a_expanded  = a.view(-1, 1, 1).expand(-1, self.num_quantiles, 1)  # [B, N, 1]
        q_preds     = q_preds_all.gather(2, a_expanded).squeeze(-1)       # [B, N]

        loss = self._quantile_huber_loss(q_preds, target, self.taus)

        self.optimizer.zero_grad()
        loss.backward()
        self.optimizer.step()

        # Soft update target
        with torch.no_grad():
            for tp, sp in zip(self.target_net.parameters(), self.net.parameters()):
                tp.data.mul_(1.0 - TARGET_TAU)
                tp.data.add_(TARGET_TAU * sp.data)

    # -------------------- ONNX Export --------------------
    def export_qnet_onnx(self, path: str):
        """
        Export a wrapper that outputs mean Q-values: [1, action_dim]
        """
        class QValuesHead(nn.Module):
            def __init__(self, net: QuantileNetwork):
                super().__init__()
                self.net = net
            def forward(self, x):
                return self.net.q_values(x)

        wrapper = QValuesHead(self.net).to(DEVICE).eval()
        dummy = torch.zeros(1, self.state_dim, dtype=torch.float32, device=DEVICE)
        torch.onnx.export(
            wrapper, dummy, path,
            export_params=True, opset_version=17, do_constant_folding=True,
            input_names=["state"], output_names=["q_values"], dynamic_axes=None
        )
        return path
También necesitamos implementar un búfer de repetición de experiencias para almacenar nuestras transiciones de estado. Nuestro agente puede seleccionar aleatoriamente pequeños lotes de datos de este búfer para ayudar a reducir la correlación entre los datos de entrenamiento, tal y como ya se ha explicado anteriormente.
Nuestro proceso de aprendizaje implica el cálculo de una pérdida de Huber cuantílica, una métrica que mide la diferencia entre los cuantiles predichos y los cuantiles objetivo o esperados. Este cálculo mantiene la robustez frente a los valores atípicos. Para construir los objetivos se utiliza el conocido enfoque DQN, y la siguiente acción se elige de acuerdo con la red en línea. Sin embargo, la evaluación de su valor la realiza la red objetivo. Esto permite reducir el sesgo que, de otro modo, aparece casi siempre cuando se utiliza la misma red tanto para la selección como para la evaluación. Dicha pérdida de Huber por cuantiles aplica penalizaciones, no solo a las previsiones cuyas medias son erróneas, sino también a las desviaciones en todo el espectro de la distribución de los rendimientos posibles. Esto sin duda hará que el modelo sea más resistente en mercados volátiles e inciertos.
Nuestro listado de código anterior también incluye una clase de entorno, CustomDataEnv, cuyo objetivo es definir cómo interactúa el agente con los datos históricos. El presente entorno toma como entrada una matriz de características derivada de los patrones de los indicadores TRIX y WPR, así como una matriz de valores objetivo que muestra la evolución del precio posterior a la aparición de dichos patrones. En cada paso, el agente puede elegir una acción que corresponda a una posición larga, una posición corta o una posición neutral. A continuación, el entorno devuelve el siguiente estado, así como una recompensa que se calcula como el producto de la acción y el rendimiento observado, a la que se restan los costes de transacción cada vez que cambia la acción. Esta metodología permite transformar los datos históricos en un entorno de toma secuencial de decisiones en el que simulamos operaciones de negociación en condiciones reales.
Al final, la implementación ofrece una función de exportación a ONNX. Sin embargo, cabe destacar que no es posible realizar la retropropagación en MetaTrader con el modelo exportado a ONNX; lamentablemente, este formato es la única opción cuando se utilizan modelos entrenados en Python. Está pensado para utilizarse únicamente con fines de inferencia. Sin embargo, la exportación encapsula la clase QuantileNetwork en una cabeza de salida ligera que devuelve los valores Q medios. Esto garantiza que el modelo resultante sea lo suficientemente compacto y eficiente como para realizar evaluaciones para un asesor experto. Como ya hemos mencionado en artículos anteriores, este paso, en el que debemos verificar las dimensiones de las capas de entrada y salida, es fundamental para garantizar la conexión entre unos modelos ligeros y bien entrenados y su uso en cuentas reales.
Para terminar, la clase QuantileNetwork y la clase de agente que la encapsula ayudan a demostrar cómo los conceptos del aprendizaje por refuerzo pueden traducirse en código útil. El uso de la regresión cuantílica mejora la adaptabilidad al capturar las distribuciones de recompensas; a su vez, el búfer de repetición de experiencias y la red objetivo contribuyen a aportar cierta estabilidad al proceso de entrenamiento, mientras que ONNX ofrece una vía para la integración en aplicaciones reales. Por lo tanto, para nosotros, los traders, estos listados de código en Python —que no son exhaustivos— constituyen un primer paso fundamental para pasar de las señales basadas en indicadores a una toma de decisiones sólida y basada en datos.
Retos de la integración de RL y MQL5
Aunque el uso de Python y su conexión con MQL5 demuestran cómo se pueden entrenar modelos de aprendizaje por refuerzo con datos históricos, la incorporación de estos modelos a MetaTrader suele presentar algunas dificultades. Ya había aludido a estas dificultades en artículos anteriores, sobre todo en la conclusión del último artículo, en el que utilizamos un modelo entrenado mediante aprendizaje por refuerzo. La principal limitación es que MQL5, al igual que cualquier otra plataforma, no admite la retropropagación en modelos en formato ONNX. Los archivos ONNX estaban y siguen estando concebidos únicamente para la propagación directa, al menos en las versiones más recientes.
En Python, dado que disponemos tanto del código original de la red como de bibliotecas de tensores que facilitan el trabajo, podemos entrenar las redes y realizar la retropropagación de forma eficiente. La limitación inherente de MQL5 en este momento es que está diseñado y desarrollado para una ejecución eficiente y ligera de la lógica de negociación, y no para realizar cálculos numéricos a gran escala. Esto implica que, cuando exportamos un modelo ONNX y lo referenciamos desde el entorno aislado de archivos o lo integramos en el asesor experto, solo podemos realizar inferencias mediante propagación directa. En las versiones más recientes de ONNX, no es posible actualizar los pesos del modelo exportado.
Esta limitación nos obliga a adoptar una solución de compromiso que es nuestra mejor alternativa disponible o, estrictamente hablando, nuestra única opción para aprovechar todo el entrenamiento del modelo exportado. Dicha solución de compromiso también explica por qué, por el momento, solo exportamos un modelo de red a ONNX cuando vamos a aprovechar el aprendizaje por refuerzo en MQL5. En el ciclo clásico del aprendizaje por refuerzo, el agente interactúa continuamente con el entorno, almacena experiencias y ajusta sus valores Q en tiempo real. No obstante, en nuestro contexto de MQL5, el entrenamiento debería realizarse íntegramente fuera de línea, en Python. El modelo está diseñado para aprender una sola vez a partir de datos históricos; una vez entrenado, se exportan los pesos, las capas y los sesgos de su red y se despliega como un actor estático.
Por este motivo, el denominado sistema de aprendizaje por refuerzo de MetaTrader es, en realidad, un modelo de aprendizaje supervisado. Simplemente transforma las características de entrada de los indicadores TRIX y WPR en valores de salida que indican la conveniencia relativa de las acciones de negociación. Esta política, o relación de correspondencia, no se adapta a estados nuevos o emergentes durante la negociación en tiempo real, ni siquiera durante las pruebas fuera de muestra.
Otro pequeño contratiempo, aunque manejable, es la necesidad de ajustarse a los requisitos del entorno de ejecución de ONNX en la interfaz de MQL5. Los modelos ONNX son, en la práctica, variables constantes, ya que esperan formas concretas de entrada y salida para las respectivas capas. Estas formas se definen en Python con unas dimensiones de lote y una precisión de coma flotante concreta, ya sea de 32 o de 64 bits. Si las formas de los contenedores declaradas en MQL5 al inicializar los identificadores de ONNX no coinciden con lo establecido en Python, la inicialización del entorno de ejecución fallará. A menudo se trata de un problema que, aunque se puede resolver, resulta complicado, ya que la mayoría de las personas que exportan sus modelos no dedican tiempo a mostrar las formas reales de estas capas de entrada y salida.
Sin embargo, la buena noticia es que, además de poder mostrar la forma real de estas capas en Python, MetaEditor ofrece ahora, en su menú de herramientas, una aplicación para visualizar redes neuronales. Una vez iniciada la aplicación en una ventana independiente de MetaEditor, se puede abrir el archivo ONNX exportado y, a continuación, visualizar su estructura detallada, incluidos los tamaños y las formas de las capas de entrada y salida.
Solución de compromiso con el aprendizaje supervisado
Cuando un modelo de aprendizaje por refuerzo, entrenado en Python y exportado a ONNX, se integra en MQL5, su finalidad cambia notablemente. El modelo ya no funciona tal y como se había previsto y diseñado; ya no es un sistema de aprendizaje adaptativo, sino un motor de decisión estático. En la práctica, esto implica que la red del actor exportada se utiliza como cualquier otra red predictiva de aprendizaje supervisado. Lo hace tras haber sido entrenada como una red de aprendizaje por refuerzo, lo que significa que su número de capas, el tamaño de las mismas y otros detalles de su arquitectura pueden no resultar tan atractivos como los de modelos equivalentes de aprendizaje supervisado, que están diseñados y entrenados específicamente para tal fin. No obstante, nuestro enfoque de compromiso permite integrar algo más de lógica en MQL5, lo cual, aunque es posible sin Python ni ONNX, no se puede llevar a cabo con la misma eficiencia.
Así pues, nuestra implementación de compromiso comienza por integrar los archivos ONNX de la red del actor directamente en MQL5 como recursos. Estos archivos ONNX contienen, básicamente, los pesos, los sesgos y los tamaños de las capas de nuestra red cuantílica entrenada. La información de la red se comprime en un formato que el entorno de ejecución de MQL5 puede procesar de forma eficiente. En nuestra clase de señales personalizada se hace referencia a los tres modelos correspondientes a los patrones 1, 4 y 5, cada uno de los cuales se corresponde con un conjunto único de patrones de los indicadores TRIX y WPR. Al inicializarse, el asesor experto crea identificadores ONNX a partir de estos búferes, lo que garantiza que se pueda invocar cada una de las redes al evaluar las condiciones de entrada al mercado. En este punto, el modelo no se vuelve a entrenar ni se modifica, sino que simplemente se carga en memoria como una herramienta de referencia lista para usar.
Lógica de las señales
Una vez exportado el modelo a ONNX e integrado en MQL5, uno de los siguientes pasos clave es escribir el código de las señales y definir las condiciones de apertura de posiciones. Este es el código que traduce las salidas de la red cuantílica en condiciones de negociación significativas. La lógica se define en las funciones LongCondition y ShortCondition de la clase de señales personalizada, tal y como se muestra a continuación:
//+------------------------------------------------------------------+
//| "Voting" that price will grow.                                   |
//+------------------------------------------------------------------+
int CSignalRL_TRX_WPR::LongCondition(void)
{  int result  = 0, results = 0;
   vectorf _x;
   _x.Init(2);
   _x.Fill(0.0);
//--- if the model 1 is used
   if(((m_patterns_usage & 0x02) != 0) && IsPattern_1(POSITION_TYPE_BUY))
   {  _x[0] = 1.0f;
      double _y = RunModel(0, POSITION_TYPE_BUY, _x);
      if(_y > 0.0)
      {  result += m_pattern_1;
         results++;
      }
   }
//--- if the model 4 is used
   if(((m_patterns_usage & 0x10) != 0) && IsPattern_4(POSITION_TYPE_BUY))
   {  _x[0] = 1.0f;
      double _y = RunModel(0, POSITION_TYPE_BUY, _x);
      if(_y > 0.0)
      {  result += m_pattern_4;
         results++;
      }
   }
//--- if the model 5 is used
   if(((m_patterns_usage & 0x20) != 0) && IsPattern_5(POSITION_TYPE_BUY))
   {  _x[0] = 1.0f;
      double _y = RunModel(0, POSITION_TYPE_BUY, _x);
      if(_y > 0.0)
      {  result += m_pattern_5;
         results++;
      }
   }
//--- return the result
//if(result > 0)printf(__FUNCSIG__+" result is: %i",result);
   if(results > 0 && result > 0)
   {  return(int(round(result / results)));
   }
   return(0);
}
//+------------------------------------------------------------------+
//| "Voting" that price will fall.                                   |
//+------------------------------------------------------------------+
int CSignalRL_TRX_WPR::ShortCondition(void)
{  int result  = 0, results = 0;
   vectorf _x;
   _x.Init(2);
   _x.Fill(0.0);
//--- if the model 1 is used
   if(((m_patterns_usage & 0x02) != 0) && IsPattern_1(POSITION_TYPE_SELL))
   {  _x[1] = 1.0f;
      double _y = RunModel(0, POSITION_TYPE_SELL, _x);
      if(_y < 0.0)
      {  result += m_pattern_1;
         results++;
      }
   }
//--- if the model 4 is used
   if(((m_patterns_usage & 0x10) != 0) && IsPattern_4(POSITION_TYPE_SELL))
   {  _x[1] = 1.0f;
      double _y = RunModel(0, POSITION_TYPE_SELL, _x);
      if(_y < 0.0)
      {  result += m_pattern_4;
         results++;
      }
   }
//--- if the model 5 is used
   if(((m_patterns_usage & 0x20) != 0) && IsPattern_5(POSITION_TYPE_SELL))
   {  _x[1] = 1.0f;
      double _y = RunModel(0, POSITION_TYPE_SELL, _x);
      if(_y < 0.0)
      {  result += m_pattern_5;
         results++;
      }
   }
//--- return the result
//if(result > 0)printf(__FUNCSIG__+" result is: %i",result);
   if(results > 0 && result > 0)
   {  return(int(round(result / results)));
   }
   return(0);
}
El listado de código de estos dos métodos, mostrado más arriba, constituye el núcleo de la lógica con la que el asesor experto decide cuándo abrir posiciones de compra o de venta. Para ello, combina el reconocimiento de patrones de los indicadores técnicos con las decisiones obtenidas mediante el aprendizaje por refuerzo.
La función de compra comienza declarando un vector de características que representa el estado de entrada. Este vector, x, se inicializa y, a continuación, se rellena con ceros. Una vez hecho esto, primero asignamos de forma selectiva el valor 1 a uno de sus dos índices, en función de los patrones que utilice el asesor experto. En resumen, este es el significado del parámetro de entrada «patterns-used».
Si, por ejemplo, a un patrón se le asigna el índice 1, entonces debemos establecer el parámetro «Patterns-Used» en 2 elevado a 1, lo que da como resultado 2. Si el índice es 2, el valor será 2 elevado a 2, es decir, 4, y así sucesivamente. El valor máximo que se le puede asignar a este parámetro, de forma que tenga sentido, es 1023, ya que solo disponemos de 10 parámetros. Cualquier número entre 0 y 1023 que no sea una potencia de 2 representaría una combinación de estos patrones, y el lector podría explorar la configuración del asesor experto para utilizar varios patrones. Sin embargo, basándonos en nuestros argumentos y en los resultados de las pruebas presentados en artículos anteriores, hemos decidido no explorar esta vía en esta serie, al menos por ahora.
Solo estamos utilizando los patrones 1, 4 y 5, por lo que esos son los únicos que tenemos que comprobar. Si se cumplen las condiciones del patrón 1, al primer índice del vector se le asigna un 1. Esto también se hace cuando operamos con el patrón 4 o el patrón 5. Tenga en cuenta que, aunque en teoría se puede ajustar el parámetro de entrada «patterns-used» de este asesor experto para permitir el uso de varios patrones, tal y como se explica en el texto en cursiva anterior, nosotros utilizamos estrictamente un solo patrón cada vez. De hecho, el uso de múltiples patrones dará lugar inevitablemente a resultados de prueba muy poco fiables, ya que la cancelación cruzada de señales será muy frecuente.
Una vez que se detecta un patrón en uso, tanto el peso optimizado como una propagación hacia delante del modelo ONNX contribuyen al resultado final de la condición. El método ShortCondition también sigue esta lógica, pero se centra en las oportunidades que ofrecen los patrones de venta. Luego se declara el vector de características x y se realizan comprobaciones similares de los patrones. La principal diferencia en este caso, siguiendo la lógica que siempre hemos utilizado, es que, cuando se detecta un patrón y la red cuantílica lo confirma, asignamos el 1 al segundo índice, y no al primero. El resto de las medias ponderadas y el cálculo del valor del resultado coinciden con los de la condición de compra.
Resultados de las pruebas
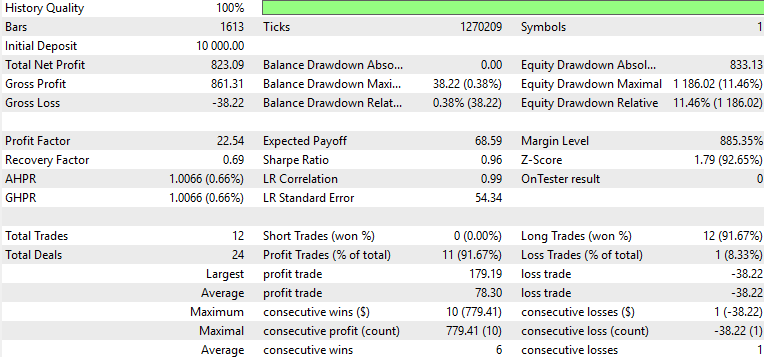
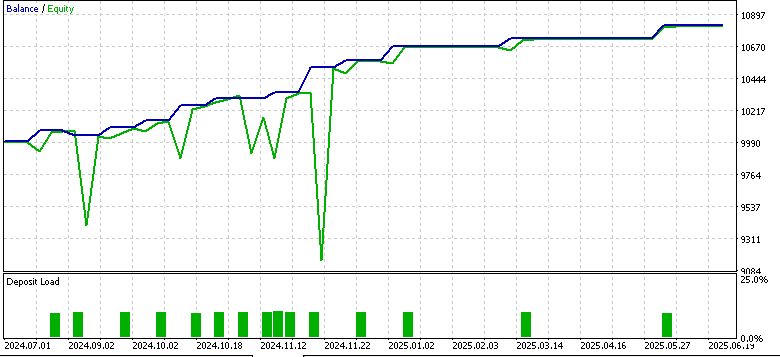
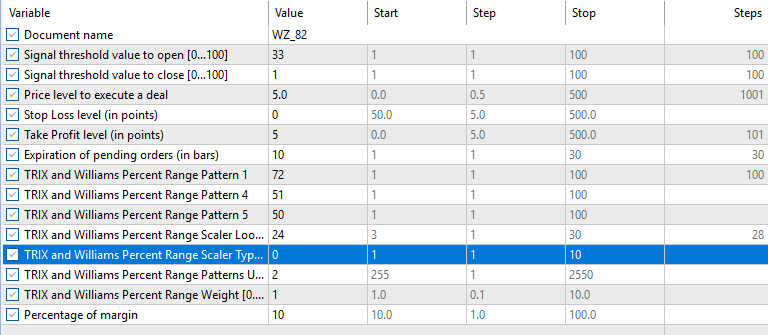
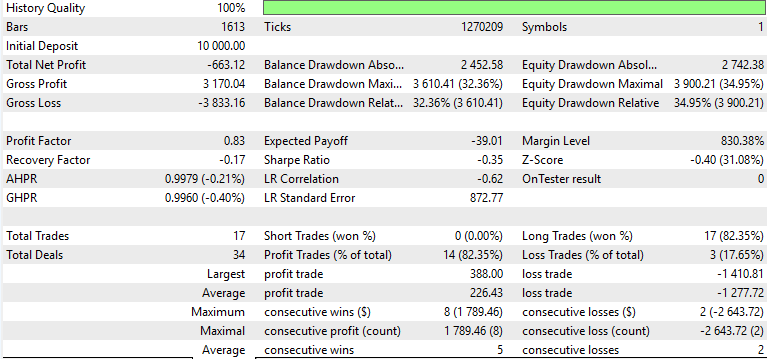
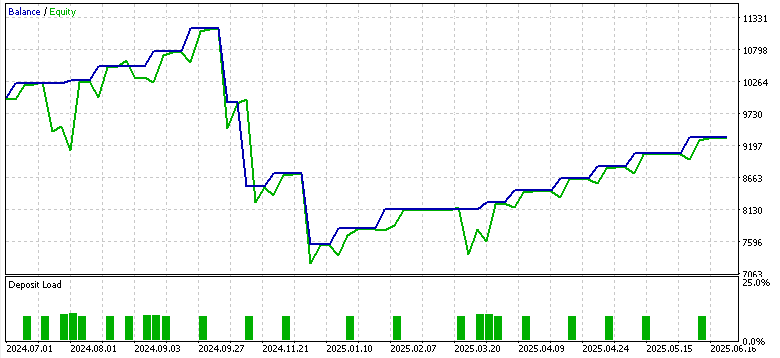
Durante el entrenamiento y la optimización, realizamos pruebas con el par EUR/USD en el marco temporal de 4 horas (H4), desde el 1 de julio de 2023 hasta el 1 de julio de 2024. El periodo de la prueba fuera de muestra abarcó desde el 1 de julio de 2024 hasta el 1 de julio de 2025 y nos proporcionó los siguientes resultados para los tres patrones: 1, 4 y 5.
Patrón 1
Patrón 4
Patrón 5
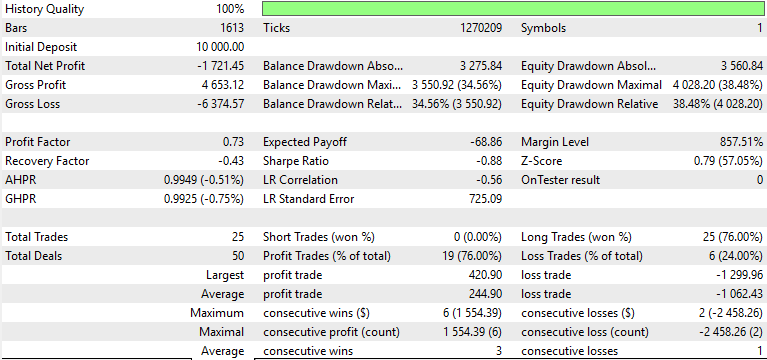
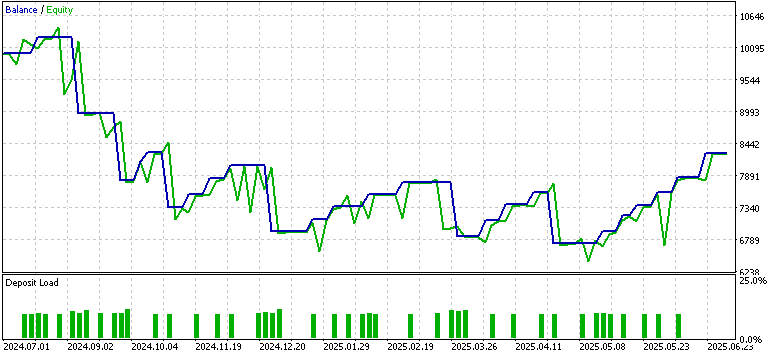
Solo el patrón 1 pareció generar beneficios en la prueba fuera de muestra, mientras que los patrones 4 y 5 tuvieron dificultades. Como siempre, este contenido no constituye asesoramiento financiero. No obstante, el uso de redes del actor “débiles” o no adaptadas como modelos de aprendizaje supervisado podría explicar estos resultados. Nuestro objetivo aquí, como siempre, no es ofrecer soluciones prefabricadas, sino explorar un amplio abanico de oportunidades e intentar mostrar lo que es posible. El trabajo de pulido y la debida diligencia recaen siempre en el lector, en caso de que decida incorporar algunas de las ideas aquí expuestas.
Conclusión
Nuestro artículo sobre los patrones de señales TRIX y WPR en el framework del aprendizaje por refuerzo ha puesto de manifiesto tanto el potencial como las limitaciones actuales de MQL5. Los módulos de Python se actualizan constantemente, por lo que es posible que, en algún momento del futuro, las redes exportadas en formato ONNX puedan actualizarse mediante retropropagación. Por ahora, no es así, por lo que eso supone una limitación. Los modelos deben entrenarse fuera de línea y, a continuación, «fijarse de forma definitiva», de modo que funcionen como motores de inferencia.
| nombre | descripción |
|---|---|
| WZ_82.mq5 | Archivo principal del asesor experto generado mediante el asistente, cuyo encabezado enumera los archivos referenciados |
| SignalWZ_82.mqh | Clase de señal personalizada que importa redes Q profundas (DQN) |
| 82_5_0.onnx | Modelo exportado a ONNX para el patrón 5 |
| 82_4_0.onnx | Modelo exportado a ONNX para el patrón 4 |
| 82_1_0.onnx | Modelo exportado en formato ONNX para el patrón 1 |
Los nuevos lectores pueden encontrar aquí instrucciones sobre cómo utilizar los archivos adjuntos.
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/19794
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.



