
Características del Wizard MQL5 que debe conocer (Parte 81): Uso de patrones de Ichimoku y ADX-Wilder con aprendizaje por inferencia mediante β-VAE
 19
 0

Introducción
Casi todos los traders han llegado a aceptar que los mercados evolucionan en ciclos de optimismo y pesimismo y, sin embargo, disponemos de muy pocas herramientas listas para usar que reflejen estos ciclos con la consistencia necesaria para operar de forma rentable. Últimamente, en los mercados mundiales ha predominado el sentimiento bajista, y cada vez son más frecuentes las ventas masivas repentinas y los rebotes de escasa magnitud. En un contexto así, las estrategias mecánicas basadas en reglas de indicadores rezagados están abocadas a generar señales falsas, ya que la volatilidad provoca el cierre de operaciones que habrían seguido evolucionando favorablemente en condiciones más tranquilas.
La falta de soluciones listas para usar pone de manifiesto la necesidad de personalizarlas. Aquí es donde destacan las plataformas de trading que cuentan con un entorno de desarrollo integrado (IDE). No solo ofrecen una ejecución y herramientas gráficas de calidad institucional, sino que además pueden incluir asistentes para crear sistemas. Estos asistentes, como en el caso de MetaTrader, constituyen un marco que permite a los traders crear rápidamente un asesor experto (EA), incluso sin programar desde cero una lógica de negociación compleja. La verdadera fortaleza del Asistente de MQL5 reside en su capacidad para integrar clases de señales personalizadas, lo que significa que los traders pueden incorporar técnicas avanzadas de aprendizaje automático directamente en sus estrategias automatizadas.
Entre los métodos modernos de aprendizaje automático disponibles, los autocodificadores variacionales (VAE) han llamado la atención por su capacidad para comprimir datos ruidosos y de alta dimensionalidad en representaciones latentes estructuradas. A diferencia de un autocodificador simple, un β-VAE introduce una penalización controlada que favorece que su capa oculta capture características desentrelazadas y significativas, en lugar de memorizar las entradas sin procesar. En la negociación financiera, esto se traduce en extraer la esencia de los patrones a partir de flujos de indicadores técnicos y en una menor susceptibilidad al ruido.
Pero la idea clave —y el tema de este artículo— es que los VAE resultan especialmente potentes cuando operan con características codificadas en binario. En lugar de introducir valores continuos de los indicadores o utilizar cadenas de procesamiento con escalado, definimos condiciones claras basadas en eventos. ¿Ha cruzado la línea Tenkan-sen de Ichimoku por encima de la línea Kijun-sen? Asignamos un 1 si la respuesta es sí y un 0 si es no; ¿Ha roto el precio de cierre a la baja la nube de Ichimoku? De nuevo, un 1 si la respuesta es sí y un 0 si es no; ¿Está el ADX por encima de 25, confirmando una tendencia fuerte? Aplicamos el mismo criterio.
Estamos trabajando con los patrones 0, 1 y 5 de este par de indicadores, Ichimoku y ADX, que pueden aparecer de la siguiente manera en un gráfico.
Patrón 0
Señal bajista en la que el precio cruza por debajo de la línea Senkou Span A, lo que indica una ruptura por debajo de la nube Kumo. Esto se ve respaldado por un valor del ADX de al menos 25.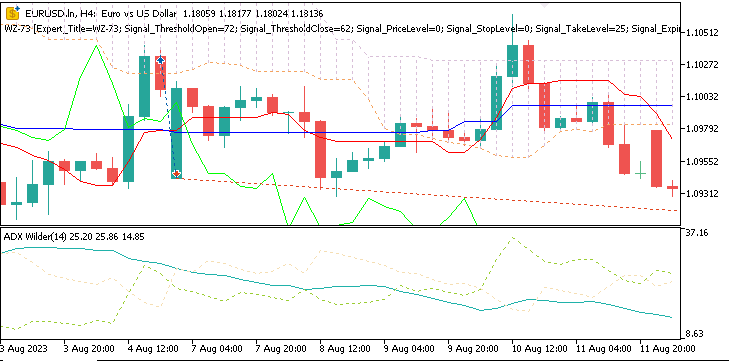
Patrón 1
Señal bajista en la que la línea Tenkan-Sen cruza la línea Kijun-Sen de arriba abajo y cierra por debajo de ella, lo cual indica un cambio a corto plazo hacia un impulso bajista. El ADX estaría, como mínimo, en 20.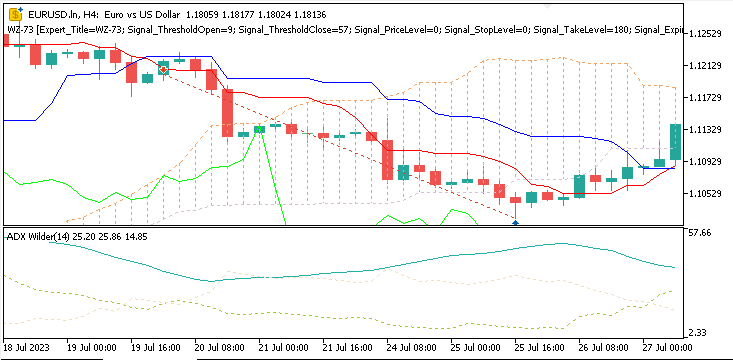
Patrón 5
Se produce una señal alcista cuando el precio rebota en la línea Tenkan-Sen y el ADX se sitúa, como mínimo, en el umbral de 25.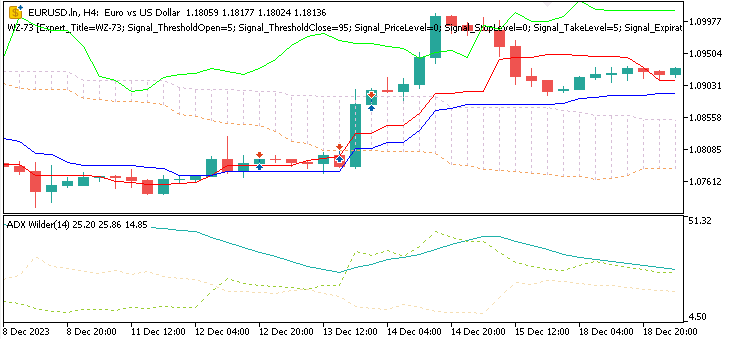
Nuestra premisa a la hora de implementar este sistema en el presente artículo es que estas codificaciones binarias forman vectores compactos que indican si hay patrones importantes presentes o ausentes en cada momento. Al pasar por el VAE, ofrecen una estructura de señal mucho más limpia que algunas cadenas de procesamiento de valores de coma flotante normalizados. En las pruebas que hemos realizado aquí, este ajuste por sí solo mejoró el proceso de entrenamiento y dio lugar a señales más sólidas durante las pruebas.
En este artículo se explica paso a paso cómo implementar este sistema. Combinaremos el indicador Ichimoku con el ADX de Wilder, generaremos vectores de características binarias, entrenaremos un β-VAE con datos históricos del mercado y, a continuación, exportaremos el modelo entrenado a formato ONNX para utilizarlo en MQL5. Por último, analizaremos los resultados del Probador de Estrategias para mostrar el rendimiento de las codificaciones binarias, tomando como referencia nuestra reciente incursión en las cadenas de procesamiento de valores continuos.
El Asistente de MQL5
El Asistente de MQL5 permite a los traders crear rápidamente asesores expertos (EA) a partir de bloques predefinidos —señales, gestión del capital, salidas y trailing stops— sin necesidad de escribir código repetitivo. Una de las funciones más importantes para los traders con algo más de experiencia es la inserción de clases de señales personalizadas en un asesor experto (EA) creado con el Asistente de MQL5. Para quienes no estén familiarizados con el tema, una clase de señal es donde usted define la lógica concreta que determina qué operaciones deben abrirse y cuándo deben cerrarse. MetaQuotes ofrece señales estándar que incluyen medias móviles o el RSI; sin embargo, las señales personalizadas suelen ampliar considerablemente las posibilidades del Asistente de MQL5. Con una clase de señal personalizada, podemos conectar modelos de aprendizaje automático, previsiones probabilísticas o, como en este caso, un beta-VAE, a cualquiera de los patrones de señal estándar incorporados, ya que los traders no solo buscan alfa, sino también carteras con volatilidad estabilizada.
Una característica clave es la posibilidad de insertar clases de señales personalizadas. Si bien las señales integradas incluyen las medias móviles (MA) o el RSI, las clases personalizadas pueden integrar modelos de aprendizaje automático, previsiones probabilísticas o un autocodificador variacional (VAE). El Asistente de MQL5 se encarga de la gestión de órdenes y del cálculo del tamaño de las posiciones, mientras que la lógica personalizada aporta adaptabilidad, lo que ayuda a filtrar las señales falsas y permite aplicar estrategias que tienen más en cuenta el contexto.
Cadenas de procesamiento y entradas binarias
En el artículo anterior al último publicado, analizamos cómo las cadenas de procesamiento previo al estilo de SCIKIT-LEARN podrían resultar útiles para normalizar las características de un modelo, tanto antes del entrenamiento como antes de la inferencia. La idea era sencilla: aplicar de forma sistemática los pasos de imputación, escalado y transformación, de modo que todos los valores de los indicadores se situaran dentro de rangos comparables. Se utilizaron métodos que incluían el escalado min-máx, el escalado estándar y el escalado robusto para preparar los datos de Ichimoku y ADX-Wilder antes de introducirlos en un modelo. Sin embargo, como hemos visto, este enfoque presentaba un par de puntos débiles a la hora de negociar.
En primer lugar, se produjo una pérdida de nitidez de la señal. El escalado de los valores continuos acabó suavizando precisamente aquellas condiciones que queríamos destacar o identificar. Por ejemplo, una ruptura al alza por encima de la nube de Ichimoku —un evento claramente booleano o binario— se diluyó hasta convertirse en una diferencia en coma flotante tras la normalización. En esencia, se estaba obligando al modelo a volver a aprender lo que los traders ya sabían que era bastante obvio: el momento en que se producen los cruces o las rupturas.
En segundo lugar, durante el entrenamiento, notamos que la estabilidad era deficiente. Las características continuas generadas tendían a amplificar el ruido. Las fluctuaciones del mercado que carecen de una causalidad clara y son aleatorias no tienen importancia en la práctica y, sin embargo, los transformadores de escalado les otorgaban la misma importancia. Esto provocó una convergencia más lenta durante el entrenamiento y una inferencia menos precisa una vez implementado en las pruebas en entorno real.
Al parecer, la solución consistía en cambiar nuestra perspectiva. En lugar de exigir a nuestros modelos que interpretaran la magnitud de las diferencias, nos propusimos indicar si se daban o no determinadas condiciones. Esta es la idea fundamental de la conversión de patrones de indicadores en entradas booleanas o binarias. Por ejemplo, si la línea Tenkan-Sen cruzara la línea Kijun-Sen con el ADX por encima de 20, lo consideraríamos una señal alcista confirmada para un patrón concreto y le asignaríamos un 1. Cualquier otra cosa recibiría un 0. Del mismo modo, si el precio de cierre rompiera a la baja el Senkou-Span A, mientras el ADX se mantuviera por encima de 25, asignaríamos un 1 inequívoco, mientras que cualquier otra indicación recibiría un 0 en lo que respecta a este patrón concreto.
Estas codificaciones booleanas se representaban en un vector limpio de señales de «patrón activado»/«patrón desactivado» para cada barra de precios. Por consiguiente, en lugar de utilizar cadenas de procesamiento para generar números de coma flotante escalados, nuestra función «get-features» del código Python del VAE, que se muestra a continuación, construye directamente los vectores booleanos
def GetFeatures(functions, *args, **kwargs) -> np.ndarray:
    features_per_func = []
    n_rows = None
    for f in functions:
        out = f(*args, **kwargs)
        a = np.asarray(out)
        if a.ndim == 1:
            row = SetRow(a)
            block = row
        elif a.ndim == 2:
            rows = [SetRow(a[i, :]) for i in range(a.shape[0])]
            block = np.concatenate(rows, axis=0)
        else:
            raise ValueError("Feature function returned array with ndim "+str(a.ndim))
        if n_rows is None:
            n_rows = block.shape[0]
        elif block.shape[0] != n_rows:
            raise ValueError("Inconsistent number of rows across feature functions.")
        features_per_func.append(block)
    return np.concatenate(features_per_func, axis=1)


def GetStates(df):
    diffs = df['close'].diff()
    df['states'] = np.select(
        condlist=[diffs > 0, diffs < 0],
        choicelist=[1.0, -1.0],
        default=0.0
    )
    return df[['states']]
Cabe destacar que, a diferencia de lo que ocurría en artículos anteriores —en los que optamos por no combinar los patrones de señal y los mantuvimos separados, de modo que acabamos teniendo un modelo para cada patrón de señal—, en este artículo combinamos los tres patrones de señal estudiados en uno solo. Solo los tres, no los diez originales. Esto significa que estamos desarrollando y probando un único modelo.
Al parecer, el impacto fue inmediato. El VAE ya no tiene que averiguar qué partes de la escala numérica corresponden a eventos significativos y cuáles carecen de relevancia. En cambio, funciona con indicadores de «activado/desactivado» que, podría decirse, se ajustan mejor a la intuición de los traders. Con este cambio de diseño, se espera lograr una mayor estabilidad en las pruebas retrospectivas, así como un mejor rendimiento en condiciones reales tras las pruebas. En un entorno de mercado como este, en el que podría producirse un retroceso significativo de la renta variable —lo que sin duda conllevará una gran volatilidad—, una representación binaria permite modelar mejor la distinción entre el ruido y las señales válidas de continuación.
Así pues, abandonar las cadenas de procesamiento y adoptar la codificación de eventos binarios no solo simplifica el preprocesamiento en sí, sino que también proporciona a nuestro modelo, el beta-VAE, el tipo de entrada que está diseñado para comprimir y representar de forma eficaz.
El autocodificador variacional beta
Una vez definidos los vectores de características booleanos, el siguiente paso es pasarlos a un modelo. La capacidad de Python para gestionar este y otros pasos similares por lotes es una de las razones por las que resulta muy eficiente a la hora de entrenar modelos. A esto hay que añadir que el uso de tensores en la retropropagación requiere memoria intermedia o almacenamiento adicional para los gradientes registrados en cada propagación directa. Nuestro modelo VAE está diseñado para aprender representaciones compactas de estructuras recurrentes del mercado. Esta es una de las principales ventajas del beta-VAE.
Un autocodificador estándar comprime sus entradas en una capa oculta. A menudo también se le denomina «espacio latente». Una vez hecho esto, las reconstruye, devolviéndolas a su forma original. Un autocodificador «variacional» va un paso más allá al hacer que el espacio latente sea probabilístico. Esta capa oculta se modela como una distribución, en lugar de como puntos fijos. Por ello, el codificador genera tanto una media como una varianza durante el entrenamiento. De esta distribución se extrae una muestra aleatoria mediante lo que también se conoce como «reparametrización».
El beta-VAE va un paso más allá del VAE estándar descrito anteriormente e introduce una modificación adicional. Multiplica el término de la divergencia de KL en la función de pérdida por un factor beta. El resultado es que se refuerza la regularización, lo que a su vez favorece que el modelo aprenda características significativas y desentrelazadas, en lugar de memorizar las entradas. En el ámbito del trading, esto es fundamental porque permite que el espacio latente codifique mejor los patrones clave, como una ruptura de la nube o incluso la continuación de una tendencia, en lugar de otorgar inútilmente el mismo peso al ruido.
Nuestro modelo se divide en los siguientes componentes clave:
- Codificador: Toma el vector de características booleanas de entrada y lo hace pasar a través de las capas densas. Su salida representa una distribución y consta de una media (z_mean) y del logaritmo de la varianza (z_logvar).
- Reparametrización: extrae una muestra z de la distribución gaussiana latente. En este caso, z es la «salida implícita» de las características de entrada y, como ya se ha mencionado y es bien sabido, los codificadores se entrenan para construir un par de matrices de pesos entre las capas visibles y ocultas que permitan la codificación «estándar» de cualquier dato de entrada pertinente.
- Decodificador: a continuación, intenta reconstruir el vector booleano de entrada original a partir de z. Esto obliga al espacio latente a centrarse en la estructura fundamental de las entradas anteriores o a captarla.
- Cabeza de predicción de y a partir del espacio latente: por último, tenemos una cabeza de predicción supervisada que transforma z en un valor estimado, y. En nuestro caso, esto equivale a una previsión de la tendencia de la evolución de los precios, ya sea alcista, bajista o lateral.
La función de pérdida que utilizamos para este VAE combina tres valores de pérdida. En primer lugar, la pérdida de reconstrucción, medida mediante la entropía cruzada binaria entre las salidas reconstruidas y las características binarias de entrada previas. En segundo lugar, tenemos la divergencia de KL, que penaliza la desviación de las distribuciones latentes respecto a la distribución gaussiana estándar a priori. Este es el caso en el que se aplica el multiplicador beta. En tercer lugar, tenemos la pérdida supervisada de la cabeza. A efectos de este trabajo, se trata simplemente de un término que representa el error cuadrático medio (MSE) entre el valor y previsto (salida final) y el valor y real (salida).
La capa de entrada de nuestro autocodificador variacional (VAE) tiene la particularidad de que, además de las características de entrada típicas de los indicadores, añadimos una dimensión correspondiente a la salida esperada. Al introducir los datos, asignamos a esta dimensión un valor neutro de 0,5. Tras un ciclo de ida al espacio latente y de vuelta a la entrada, la salida y sería la evolución posterior del precio que falta y que sigue o se asocia a las seis características de entrada proporcionadas anteriormente. Esto significa que funciona en dos modos, y que cada uno de ellos ofrece un resultado diferente. A continuación le mostramos el código fuente de la implementación de beta-VAE en Python:
# ----------------------------- β-VAE (inference simplified to VAE-only) -----------------------------
class BetaVAEUnsupervised(nn.Module):
    """
    Encoder: features -> (mu, logvar)
    Decoder: z -> x_hat
    **Inference (now VAE-only):** latent z is mapped to y via an internal head.
    All former infer modes (ridge/knn/kernel/lwlr/mlp) are bypassed.
    """
    def __init__(self, feature_dim, latent_dim, k_neighbors=5, beta=4.0, recon='bce',
                 infer_mode='vae', ridge_alpha=1e-2, kernel_bandwidth=1.0):
        super().__init__()
        self.latent_dim = latent_dim
        self.k_neighbors = k_neighbors
        self.beta = beta
        self.recon = recon
        self.infer_mode = 'vae'  # force VAE-only
        self.ridge_alpha = float(ridge_alpha)
        self.kernel_bandwidth = float(kernel_bandwidth)

        # Encoder
        self.feature_encoder = nn.Sequential(
            nn.Linear(feature_dim, 256), nn.ReLU(),
            nn.Linear(256, 128), nn.ReLU(),
            nn.Linear(128, latent_dim * 2)
        )
        # Decoder
        self.decoder = nn.Sequential(
            nn.Linear(latent_dim, 128), nn.ReLU(),
            nn.Linear(128, 256), nn.ReLU(),
            nn.Linear(256, feature_dim)
        )
        # New: latent→y head (supervised head trained with MSE)
        self.y_head = nn.Sequential(
            nn.Linear(latent_dim, 128), nn.ReLU(),
            nn.Linear(128, 1)
        )

    def encode(self, features):
        h = self.feature_encoder(features)
        z_mean, z_logvar = torch.chunk(h, 2, dim=1)
        return z_mean, z_logvar

    def reparameterize(self, mean, logvar):
        std = torch.exp(0.5 * logvar)
        eps = torch.randn_like(std)
        return mean + eps * std

    def decode(self, z):
        return self.decoder(z)

    def predict_from_latent(self, z):
        # VAE-only mapping
        return self.y_head(z)

    def forward(self, features, y=None):
        mu, logvar = self.encode(features)
        z = self.reparameterize(mu, logvar)
        x_logits = self.decode(z)
        y_hat = self.predict_from_latent(z)
        if y is not None:
            return {'z': z, 'z_mean': mu, 'z_logvar': logvar, 'x_logits': x_logits, 'y_hat': y_hat}
        else:
            return {'y': y_hat}

# Reconstruction + KL
def beta_vae_loss(features, x_logits, mu, logvar, beta=4.0, recon='bce'):
    if recon == 'bce':
        recon_loss = F.binary_cross_entropy_with_logits(x_logits, features, reduction='sum') / features.size(0)
    else:
        recon_loss = F.mse_loss(torch.sigmoid(x_logits), features, reduction='mean') * features.size(1)
    kl = -0.5 * torch.sum(1 + logvar - mu.pow(2) - logvar.exp()) / features.size(0)
    loss = recon_loss + beta * kl
    return loss, recon_loss.detach(), kl.detach()
En la función de propagación directa, podemos recibir o bien la variable y (el siguiente valor de la evolución del precio), o bien este valor más el vector de distribución que recoge la media y la varianza de z. A efectos de la exportación a ONNX, dado que el entrenamiento ya se ha realizado, siempre generamos únicamente el valor y, que indica la siguiente tendencia del precio, donde cualquier valor superior a 0,5 se considera alcista y cualquier valor inferior, bajista.
Volviendo a los tres valores de pérdida, combinarlos durante el entrenamiento favorece que el modelo comprima las características binarias sin perder su capacidad para predecir la dirección del precio. El procedimiento de entrenamiento se lleva a cabo con el optimizador Adam a lo largo de varias épocas. En nuestro modelo, utilizamos 50 épocas. Sin embargo, en cada paso del entrenamiento, las características se codifican para obtener la media y la varianza de la distribución latente, a partir de la cual se muestrea z; el decodificador reconstruye las características originales; la capa latente envía su salida a una cabeza de predicción para pronosticar el siguiente estado del mercado; se calcula una pérdida si se ha proporcionado una entrada y y, por tanto, estamos en fase de entrenamiento; y, por último, la retropropagación actualiza los pesos tanto del VAE como de la cabeza de predicción.
El bucle de entrenamiento que llevamos a cabo utiliza un «bootstrap» que nos permite iterar de forma eficiente sobre un conjunto de datos, al tiempo que muestra resúmenes de la pérdida época por época. Los mensajes de salida permiten supervisar la capacidad del VAE para lograr un equilibrio entre la compresión y el desentrelazamiento, así como la precisión de las predicciones de los siguientes estados que genera la cabeza de predicción.
Exportando a MQL5
Como saben los lectores habituales, el entrenamiento en Python es solo la mitad del camino. Para utilizar los modelos desarrollados en este lenguaje distinto de MQL5 dentro de un asesor experto (EA) creado con el Asistente de MQL5, necesitamos un puente. Esto, como ya hemos explicado en artículos anteriores, es ONNX, abreviatura de Open Neural Network Exchange. Este «puente» nos ofrece un formato estandarizado para representar modelos entrenados en Python, con el fin de utilizarlos en otras muchas plataformas, además de MetaTrader. Sin embargo, cuando lo exportamos a MQL5, este archivo —cuyo tamaño puede oscilar entre unos pocos cientos de kilobytes y hasta 128 MB, según mis últimas pruebas con MQL5— puede cargarse en distintos entornos de ejecución. Esto incluye aquellos a los que se puede acceder a través del sistema de archivos de su entorno aislado o mediante la compilación de recursos. En definitiva, entrenamos de forma eficiente modelos avanzados con PyTorch, los validamos en Python y, a continuación, los desplegamos para utilizarlos en asesores expertos (EA), sin necesidad de reescribir la lógica de los modelos. Este proceso se gestiona principalmente mediante la función «export_onnx_y». Su código se muestra a continuación:
import torch
import torch.nn as nn
import onnx
import onnxruntime as ort

def export_onnx_y(model: nn.Module, feature_dim: int, output_path: str,
                  opset: int = 14):
    """
    Export the VAE so that ONNX takes ONLY `features` and returns the inferred y.
    No latent (z, mu, logvar) are exported. No `y` input is used.
    """
    model.eval()

    # Wrapper that returns a plain tensor (y_hat), suitable for ONNX export
    class _YOnly(nn.Module):
        def __init__(self, m: nn.Module):
            super().__init__()
            self.m = m
        def forward(self, features: torch.Tensor) -> torch.Tensor:
            mu, logvar = self.m.encode(features)
            z = self.m.reparameterize(mu, logvar)
            y_hat = self.m.predict_from_latent(z)
            return y_hat  # shape: [N, 1]

    wrapped = _YOnly(model)

    dummy_features = torch.randn(1, feature_dim, dtype=torch.float32)

    torch.onnx.export(
        wrapped,
        dummy_features,
        output_path,
        input_names=["features"],
        output_names=["y_hat"],
        dynamic_axes={
            "features": {0: "batch_size"},
            "y_hat":    {0: "batch_size"},
        },
        opset_version=opset,
        do_constant_folding=True,
    )

    # Validate and print IO for sanity
    onnx_model = onnx.load(output_path)
    onnx.checker.check_model(onnx_model)
    print(f"ONNX model '{output_path}' exported and validated (features -> y_hat).")

    sess = ort.InferenceSession(output_path)
    for i in sess.get_inputs():
        print(f"input:  {i.name}, shape={i.shape}, type={i.type}")
    for o in sess.get_outputs():
        print(f"output: {o.name}, shape={o.shape}, type={o.type}")
La función de exportación anterior genera una cabeza de predicción en formato ONNX, limpia y lista para su uso en producción. Esta está preparada para realizar la propagación directa, tomando como entrada las características precalculadas de nuestros dos indicadores y generando un único valor y, sin salidas de depuración ni entradas adicionales. Para ello, lo primero que hace es poner el VAE de PyTorch en modo «eval», con el fin de congelar el comportamiento del «dropout» y la normalización por lotes. Una vez hecho esto, codifica las características para obtener la media y la varianza y, a continuación, muestrea un vector latente z mediante el truco de reparametrización mencionado anteriormente. A continuación, pasa z a la cabeza de predicción del modelo mediante la función de predicción a partir del vector latente y devuelve el valor y con la forma [batch, 1]. Este envoltorio se instancia en torno al modelo entrenado para garantizar que el grafo exportado incluya únicamente las operaciones mínimas necesarias para la propagación directa.
Solo se crea un tensor de entrada ficticio de forma [1, 6] para facilitar el trazado del grafo. A continuación, se invoca el módulo torch.onnx.export con una denominación explícita y con ejes dinámicos en la dimensión del lote, de modo que el modelo exportado pueda admitir cualquier tamaño de lote. El parámetro «opset» tiene un valor predeterminado de 14 y, además, se activa el plegado de constantes para que el grafo resulte más fácil de interpretar.
En Python, una vez exportado el archivo, debemos validarlo inmediatamente volviéndolo a importar y comprobando también el tamaño de las capas de entrada y salida. Para ello, cargamos el archivo con el módulo onnx.load; a continuación, realizamos una comprobación mediante `onnx.checker.check_model` para ver si es válido y lo abrimos en una sesión de inferencia adecuada. Imprimimos las firmas de las capas de entrada y salida detectadas, que son datos importantes cuando pasemos a MetaTrader. El modelo que hemos elegido para la exportación simplifica el modelo VAE hasta el punto de que casi parece una red de aprendizaje supervisado; no obstante, como ya hemos explicado, se trata de un VAE que asigna automáticamente un valor neutro de cero a la entrada «y» que falta, realiza un ciclo completo desde la entrada hasta la capa oculta y de vuelta a la entrada, y después infiere el valor que falta a partir de los pesos aprendidos por el VAE.
Una vez exportado, el archivo ONNX debe validarse inmediatamente en MQL5. En lugar de hacer referencia a un archivo ONNX en el entorno aislado, hemos decidido, tal y como hemos venido haciendo hasta ahora, importar este archivo como recurso. Sin embargo, esta opción tiene implicaciones en cuanto al tamaño máximo que puede tener un modelo exportado. Antes, el límite de un archivo de recursos era de unos 256 MB, pero últimamente parece que se ha reducido a la mitad de ese valor y se ha estabilizado en unos 128 MB. Aún no lo he confirmado, pero es posible que los archivos ONNX que no se incorporan como recursos y que se encuentran en un entorno aislado no estén sujetos a limitaciones similares. Estas limitaciones podrían estar vigentes, sobre todo para los traders que dependen del uso del VPS de MQL5.
Realización de inferencias a partir de características parciales para obtener previsiones
El entrenamiento de un modelo es solo un paso del proceso; utilizarlo según lo previsto en operaciones reales suele ser otra cuestión. Una vez exportado el beta-VAE a ONNX, se invoca —en nuestro caso, como recurso— para realizar predicciones. Sin embargo, en Python comprobamos cómo funcionará esta inferencia en MQL5 utilizando datos binarios sintéticos con la función infer_example. Esto puede ayudar a determinar si las lecturas preestablecidas de los indicadores, ya sean de compra o de venta, se interpretarán realmente como se espera.
# ----------------------------- Inference demo (updated) -----------------------------
def infer_example(model, dataloader=None, num_examples=5, prob_one_in_pair=0.6, seed=None, partial_rows=None):
    """
    If partial_rows is provided, we zero-fill missing inputs and run a full VAE cycle
    to produce y that pairs with that incomplete input.
    Otherwise, we keep the previous synthetic-pairs demo using the dataloader.
    """
    model.eval()
    with torch.no_grad():
        if partial_rows is not None:
            device = next(model.parameters()).device
            X = _zero_fill_rows(partial_rows, feature_dim, device)
            preds = model(X)
            print("Inference with partial inputs (zero-filled):")
            for i in range(X.size(0)):
                yhat = float(preds['y'][i].item())
                print(f"X[{i}] first 8: {X[i, :8].tolist()} -> y_hat={yhat:.6f}")
            return
        # ----- legacy synthetic example (kept) -----
        if dataloader is None:
            raise ValueError("dataloader required when partial_rows is None")
        batch = next(iter(dataloader))
        N = min(num_examples, batch["features"].shape[0])
        feat_dim = batch["features"].shape[1]
        assert feat_dim >= 6 and feat_dim % 2 == 0, "feature_dim must be even and >= 6"
        pairs = 3
        device = next(model.parameters()).device
        if seed is not None:
            torch.manual_seed(seed)
        X = torch.zeros((N, feat_dim), device=device)
        any_one = torch.bernoulli(torch.full((N, pairs), float(prob_one_in_pair), device=device)).bool()
        side = torch.bernoulli(torch.full((N, pairs), 0.5, device=device)).long()
        row_idx = torch.arange(N, device=device).unsqueeze(1).expand(N, pairs)
        base = (torch.arange(pairs, device=device).unsqueeze(0).expand(N, pairs) * 2)
        col_idx = base + side
        sel_rows = row_idx[any_one]; sel_cols = col_idx[any_one]
        X[sel_rows, sel_cols] = 1.0
        preds = model(X)
        print(" Example Inference (3 exclusive pairs):")
        for i in range(N):
            yhat = float(preds['y'][i].item())
            print(f"X[{i}]={X[i, :6].int().tolist()}{'...' if feat_dim > 6 else ''} -> ŷ={yhat:.5f}")
Rara vez los mercados presentan un vector completo de señales claras en todas las barras de precios. A menudo ocurre que el cruce entre Tenkan y Kijun es evidente, pero no se produce la ruptura de la nube. Para simularlo mejor, nuestro ejemplo de inferencia admite entradas parciales y utiliza cero como valor predeterminado para los valores que faltan. Asimismo, cabe destacar que nuestra simulación se asegura de que no se introduzcan simultáneamente en el modelo condiciones de compra y de venta, ya que esto no es posible por la forma en que se definen las características de los indicadores.
Resultados del Probador de Estrategias
Como se suele decir, la prueba está siempre en el resultado final; y aunque, estrictamente hablando, para los traders esto implicaría aspectos de la gestión de cuentas de trading que abarcan la planificación de retiradas —algo que MetaTrader puede simular—, a efectos de este artículo nos centraremos en la rentabilidad del modelo cuando se prueba en MQL5. Tras entrenar el modelo beta-VAE con características codificadas como valores booleanos a partir de las lecturas de los indicadores del par EUR/USD, en el marco temporal de 4 horas, desde el 1 de julio de 2023 hasta el 1 de julio de 2024, exportamos el modelo para realizar una prueba fuera de muestra desde el 1 de julio de 2024 hasta el 1 de julio de 2025 en MetaTrader. Los resultados de la prueba fuera de muestra, aunque sujetos a la advertencia habitual, fueron mejores que los que obtuvimos en el último artículo, en el que utilizamos cadenas de procesamiento en un modelo de aprendizaje por refuerzo.


Hay muchos factores que influyen aquí: los distintos tipos de aprendizaje (por inferencia frente a por refuerzo), los distintos tipos de modelos (beta-VAE frente a TD3) y el hecho de que nuestro periodo de prueba se limite a un solo año. Además, no se utilizaron técnicas de regularización más complejas para garantizar que la ventana de prueba contuviera datos objetivo equilibrados, con un número aproximadamente igual de estados alcistas y bajistas de la acción del precio. Por eso todos nuestros informes indican únicamente operaciones de compra. Estos y otros aspectos más complejos no se tratan en profundidad aquí; no obstante, se adjunta el código MQL y se describe a grandes rasgos el enfoque general en Python, de modo que los traders puedan profundizar en ello para seguir desarrollándolo.
Dicho esto, dado que las condiciones son casi equivalentes a las del entorno de pruebas del último artículo, podría resultar esclarecedor comparar el rendimiento del modelo que recibe características binarias con los resultados del modelo que recibe datos de una cadena de procesamiento. Cuando utilizábamos las cadenas de procesamiento al estilo de SCIKIT-LEARN, el modelo en cuestión recibía valores continuos derivados de las separaciones y diferencias en los indicadores Ichimoku y ADX. Aunque los resultados del entrenamiento eran prometedores, con una disminución de las pérdidas, la prueba fuera de muestra indicaba lo contrario. La curva de capital en la prueba fuera de muestra también fue inestable y presentó una mala relación riesgo-beneficio. Este mismo problema se da también en nuestros mejores resultados con vectores de entrada binarios, en parte porque no utilizamos un stop-loss.
También obtuvimos numerosos falsos positivos durante los rebotes irregulares en las tres pruebas de los patrones 0, 1 y 5. Estas pruebas eran todas independientes, a diferencia de lo que ocurre en este artículo, donde hemos unificado las lecturas de los indicadores correspondientes para utilizarlas como entrada de un único modelo VAE. Esa es también otra diferencia importante con respecto a nuestro último artículo.
Por el contrario, el enfoque de codificación binaria parece ofrecer resultados más claros, con un capital neto en constante aumento y la ejecución de muy pocas operaciones, todas ellas acertadas. Esto corresponde al mismo periodo de pruebas. Aunque este periodo de pruebas de un año es limitado y estamos ejecutando una estrategia de trading sin una gestión adecuada de los stops, esta comparación en igualdad de condiciones entre el modelo de escalado de la cadena de procesamiento y las entradas booleanas sí pone de manifiesto las ventajas de estas últimas. Podría ser que estuviéramos obteniendo los beneficios de «eliminar el ruido» asociado a las entradas de coma flotante o continuas al utilizar, en su lugar, datos de tipo «sí/no».
Conclusión
En este artículo hemos mostrado, como es habitual, cómo se puede ampliar el Asistente de MQL5 más allá de la biblioteca de señales integrada mediante la incorporación del aprendizaje por inferencia; en este caso, un autocodificador variacional (VAE) beta entrenado con patrones booleanos de indicadores. Al codificar las condiciones de Ichimoku y ADX Wilder en vectores binarios de «sí/no», parece que hemos reducido el ruido presente en los datos de mercado, a diferencia de cuando utilizábamos transformadores en la cadena de procesamiento, con los que, al parecer, solo lo amplificábamos. Con un periodo limitado de apenas dos años, uno para el entrenamiento y otro para las pruebas, conseguimos un proceso de entrenamiento estable, representaciones latentes más claras y cierta mejora del rendimiento de la estrategia en el Probador de Estrategias. Como es habitual, siempre es necesario realizar pruebas en periodos más amplios y con datos de ticks reales del bróker antes de poder extraer conclusiones más definitivas.
| nombre | descripción |
|---|---|
| 81b.mq5 | Asesor experto generado con el Asistente de MQL5, cuyo encabezado enumera los archivos referenciados |
| SignalWZ_81b.mqh | Archivo de una clase de señal personalizada que incorpora el aprendizaje por inferencia |
| 81_.onnx | Modelo exportado en formato ONNX. Importado como recurso |
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/19781
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.



