

Redes neuronales en el trading: De los Transformer a las neuronas de impulsos (SpikingBrain)
 27
 0

Introducción
Los mercados financieros siempre han sido un ámbito en el que el azar convive con la regularidad, y a menudo una reacción inmediata es más importante que un análisis prolongado. Se les ha comparado con el océano, donde una superficie tranquila puede dar paso a una tormenta en un instante, y con un organismo, en el que los impulsos nerviosos determinan el ritmo de la vida. Pero quizá la metáfora más acertada siga siendo la del sistema nervioso, capaz de responder a los estímulos externos con una rapidez fulgurante y una precisión milimétrica. Precisamente por eso, la aparición del framework SpikingBrain, presentado en el artículo «SpikingBrain Technical Report: Spiking Brain-inspired Large Models», ha suscitado tanto interés.
Se inspira en la biología del cerebro y se basa en el modelo de procesamiento de la información mediante impulsos. A diferencia de las redes neuronales tradicionales, que procesan datos en bruto de forma continua, las redes neuronales de impulsos actúan como centinelas. Permanecen en silencio hasta que llega un momento crítico, y solo entonces envían una señal. Esta lógica refleja de manera sorprendente la propia naturaleza del mercado, donde el precio puede fluctuar dentro de un rango estrecho durante horas y, de repente, un solo acontecimiento altera el equilibrio, y el movimiento se convierte en una tendencia en toda regla.
Para hacerte una idea de esta analogía, solo tienes que echar un vistazo a los gráficos Renko. En este caso, un nuevo ladrillo Renko no aparece en función del tiempo, sino únicamente cuando el precio alcanza un umbral determinado. Todo el ruido de fondo desaparece, dejando un patrón de movimiento nítido. Una neurona de impulsos funciona de la misma manera. Permanece en silencio hasta que la señal que se está analizando alcanza un nivel determinado. Para un operador, esto equivale a una señal clara del mercado en medio del caos de las cotizaciones, donde innumerables detalles superfluos ocultan lo esencial.
En realidad, el mercado financiero no se rige por el tiempo, sino por los acontecimientos. El ejemplo del informe de empleo no agrícola de Estados Unidos (NFP) es especialmente revelador. Unos minutos antes de que se publiquen los datos, el mercado puede parecer adormilado. Las cotizaciones se estancan, la liquidez se reduce y los operadores se mantienen a la espera. Pero en cuanto las cifras resultan ser inesperadas, se desata una explosión. Los pares de divisas registran saltos bruscos, los spreads se amplían y las órdenes stop del libro de órdenes se activan una tras otra. Los modelos convencionales suelen necesitar tiempo para reflejar cambios tan bruscos. Promedian y suavizan los datos, por lo que detectan el movimiento solo cuando ya casi ha terminado. La arquitectura de impulsos capta estos eventos de forma diferente: cada impulso reconfigura al instante la red, lo que permite tomar una decisión de trading en ese mismo segundo, mientras aún tiene sentido.
Se observa un patrón similar durante las rupturas de niveles psicológicos. El precio se mantiene en torno a ese nivel durante mucho tiempo; los operadores esperan y la tensión va en aumento. Entonces se produce un único movimiento brusco y se rompe el nivel. Comienza una avalancha de órdenes, el movimiento se acelera y el mercado explota. En un momento así, es especialmente importante que el modelo reaccione específicamente ante el evento de ruptura, en lugar de ante la acumulación gradual de datos estadísticos. Este comportamiento concuerda plenamente con la intuición de un operador con experiencia. Sabe que todo el ruido anterior no era más que un preludio y que la señal surge precisamente en el momento del movimiento decisivo.
Hay otro ejemplo más: la activación en cadena de las órdenes stop loss. El precio alcanza una zona crítica y las órdenes se activan una tras otra, lo que provoca un efecto de avalancha. Este fenómeno es muy similar al funcionamiento de un circuito neuronal, en el que el primer impulso desencadena el segundo, el segundo desencadena el tercero, y la onda sigue propagándose cada vez más lejos. Los modelos tradicionales tienden a percibir estas dinámicas como un movimiento caótico. Sin embargo, para el modelo de impulsos, se trata de un proceso natural. Cada impulso se convierte en el desencadenante de otro nuevo, y el sistema refleja de forma orgánica estos fenómenos similares a una avalancha.
A partir de estas observaciones, queda claro que SpikingBrain piensa en términos de eventos. A diferencia de los modelos tradicionales, que consideran el flujo de datos como un proceso continuo, este modelo destaca precisamente aquellos momentos que realmente contienen información significativa. Su funcionamiento no se basa en un análisis constante, sino en una reacción inmediata. Este enfoque evita malgastar recursos en fluctuaciones debidas al ruido y se centra en lo que realmente mueve el mercado.
La eficiencia energética es otra ventaja clave. En los modelos tradicionales, las neuronas están siempre activas, incluso cuando no hay ninguna señal de entrada significativa. En los modelos de impulsos, la situación es diferente. Una neurona solo emite un impulso cuando se alcanza el umbral. En condiciones de mercado, esto significa que los recursos informáticos solo se utilizan en el momento en que se produce un movimiento importante. Este enfoque permite ejecutar el algoritmo directamente en los terminales de trading, sin necesidad de conectarse a servidores externos y sin retrasos excesivos.
Otra de las cualidades de SpikingBrain que lo hace especialmente valioso en la práctica es su capacidad para el aprendizaje en línea. El mercado cambia constantemente, y los patrones que funcionaban ayer pueden resultar inútiles mañana. Los modelos clásicos suelen verse atrapados en el pasado. Se han entrenado con datos antiguos y les cuesta hacer frente a situaciones inesperadas. El modelo de impulsos, por el contrario, ajusta su previsión sobre la marcha. Cada nuevo suceso forma parte de su proceso de aprendizaje, lo que permite que el algoritmo se mantenga flexible y dinámico. Esto se asemeja mucho al comportamiento de un operador experimentado, que reacciona al instante ante las últimas noticias y adapta su estrategia sin quedarse anclado en viejos patrones.
Todas estas cualidades permiten considerar SpikingBrain como un intento de crear un sistema nervioso completo para un robot de trading. Piensa por impulsos, reacciona ante los acontecimientos y se adapta a las nuevas condiciones con la misma rapidez que el mercado. Al igual que los gráficos Renko, que ayudan a los operadores a ver la esencia de los movimientos de precios sin ruido innecesario, el modelo de impulsos destaca lo que importa y pasa por alto lo que es secundario.
El algoritmo SpikingBrain
Si analizamos SpikingBrain desde la perspectiva de la evolución de los conceptos relacionados con las redes neuronales, parece ser un paso adelante natural, tanto lógico como oportuno. El modelo Transformer provocó en su día una auténtica revolución al alejarse de las engorrosas estructuras recurrentes e introducir un mecanismo de atención capaz de atender a toda la secuencia de datos a la vez. Esta versatilidad lo ha convertido en el referente por excelencia para los modelos de lenguaje y para una amplia gama de tareas relacionadas. Sin embargo, la versatilidad también tiene su lado negativo. Una arquitectura que funciona a la perfección con el texto se satura rápidamente cuando se enfrenta al mercado. Al fin y al cabo, la mayor parte del tiempo no ocurre nada significativo y hay demasiadas fluctuaciones ruidosas.
Y es precisamente aquí donde SpikingBrain aporta una idea novedosa. Los autores del framework se basan en el concepto de atención, pero lo trasladan al ámbito de los sistemas basados en eventos. En una red Transformer clásica, la atención se distribuye a lo largo de toda la secuencia: el modelo tiene en cuenta todo a la vez e identifica las partes que son más o menos significativas. En SpikingBrain, la atención surge como un destello: una respuesta instantánea cuando se alcanza un nivel umbral.
Esta diferencia se aprecia especialmente en el mercado financiero. Las cotizaciones pueden considerarse como un flujo de letras que conforman las palabras y las frases de la historia del mercado. A diferencia del lenguaje natural, aquí hay una gran cantidad de letras adicionales, repeticiones e inserciones aleatorias. El Transformer es capaz de procesar todos esos elementos. Pero a menudo lo hace de forma excesiva, como un profesor pedante que no pasa por alto ni un solo detalle, ni siquiera uno sin importancia. SpikingBrain, por el contrario, actúa como un editor experimentado, eliminando los patrones predecibles y centrándose únicamente en lo que cambia el significado. El resultado es que la estructura de datos sigue siendo sencilla y la señal no se sobrecarga con información innecesaria.
Además, la eficiencia energética es importante. El Transformer requiere enormes recursos computacionales. Esto está justificado en tareas como la generación de texto o la traducción, en las que cada detalle cuenta. En el mercado financiero, este tipo de análisis excesivo da lugar a señales erróneas y a costes innecesarios. El modelo de impulsos funciona de otra manera. Una neurona permanece inactiva hasta que ha acumulado suficiente potencial, y solo entonces envía una señal. Así es como el modelo ahorra recursos. Su comportamiento se aproxima más a la naturaleza de la operativa bursátil. Un operador no reacciona ante cada tick; en cambio, espera el momento en que un movimiento del precio merezca realmente su atención.
SpikingBrain puede considerarse un híbrido. Por un lado, hereda la potencia conceptual del Transformer; por otro, la enriquece con dinámicas basadas en eventos e inspiradas en la biología. En esta reinterpretación, la atención ya no es un elemento de fondo, sino un acto de elección: un cambio instantáneo del sistema a un modo reactivo. Es precisamente esta característica la que hace que el modelo resulte especialmente valioso para un mercado en el que el papel decisivo no lo desempeñan todos los datos, sino únicamente los momentos críticos capaces de alterar la trayectoria de los flujos de capital.
El ahorro de recursos informáticos es un argumento de peso por sí mismo. Sin embargo, en los mercados financieros, también tiene un significado más profundo. No se trata solo de la velocidad, sino también de la capacidad de generar señales oportunas y fiables. Si un modelo está sobrecargado de información, o bien se ralentiza o bien genera señales falsas. La complejidad cuadrática del Transformer, a medida que aumenta la longitud de la secuencia, hace que el sistema empiece a saturarse. En lugar de una visión clara, el operador recibe ruido disfrazado de análisis.
SpikingBrain aborda este problema de una forma radicalmente diferente. El procesamiento basado en eventos reduce la carga y filtra los datos de forma natural. Una neurona se dispara solo cuando la dinámica acumulada realmente importa. El modelo se convierte en una especie de editor del mercado, descartando las fluctuaciones sin importancia y conservando únicamente los puntos de inflexión. Como resultado, las señales son menos frecuentes, pero más fiables, que es precisamente lo que se necesita en el mundo del trading, donde cada decisión conlleva un riesgo y debe estar bien fundamentada.
Además, la reducción de la carga computacional abre la puerta a escenarios de aplicación más complejos. Mientras que el Transformer clásico se ve limitado por las restricciones del hardware, la arquitectura de impulsos puede procesar grandes volúmenes de datos de mercado en tiempo real sin sacrificar el rendimiento. En el caso del trading algorítmico, donde unos milisegundos pueden determinar el resultado de una operación, esta ventaja es fundamental.
La arquitectura SpikingBrain se basa en principios que combinan de forma orgánica el procesamiento de impulsos con un mecanismo de atención rediseñado para un funcionamiento basado en eventos. Se basa en un conjunto de neuronas de impulsos, cada una de las cuales recibe una señal de entrada y acumula potencial hasta alcanzar un umbral crítico. En ese momento, la neurona se dispara, generando un impulso que se propaga por la red, afecta a otras neuronas y activa las unidades de procesamiento correspondientes.
Este enfoque permite que la red se centre en los eventos significativos, al tiempo que ignora las fluctuaciones menores y las variaciones provocadas por el ruido. El mecanismo de atención en SpikingBrain ya no es un peso distribuido, como en el Transformer clásico, sino que se convierte en un filtro dinámico. Amplifica la respuesta de las neuronas que reciben la información de entrada más relevante y atenúa la respuesta ante señales menos significativas. Como consecuencia, la red no reacciona ante todos los cambios, sino solo ante aquellos que realmente pueden alterar la situación del mercado.
Las conexiones entre las neuronas están estructuradas para facilitar tanto las respuestas locales como las globales. Las conexiones locales siguen los cambios en segmentos de datos concretos. Las conexiones globales permiten que las señales viajen más lejos, lo que desencadena la sincronización y las respuestas ante acontecimientos del mercado a mayor escala, como la ruptura de un nivel de liquidez o la activación en cadena de órdenes stop. Esta estructura permite conservar información detallada sin perder de vista la visión global del mercado.
Otro elemento clave es la adaptación del umbral. El umbral de activación de las neuronas no es fijo, sino que varía dinámicamente en función de la volatilidad actual y la dinámica histórica. Esto permite que el modelo siga siendo sensible a los movimientos inesperados, al tiempo que evita una respuesta excesiva ante el ruido de poca magnitud. Esto, junto con el procesamiento basado en eventos, hace que la arquitectura SpikingBrain sea especialmente resistente a las fluctuaciones del mercado y capaz de generar señales de gran valor.
En su artículo, los autores del framework SpikingBrain concluyen que, mediante un ajuste fino ligero, el Transformer básico puede transformarse en diversas variantes de atención eficaces. Esto abre nuevas posibilidades para encontrar un equilibrio flexible entre la precisión y la eficiencia computacional. Esto reviste especial importancia en el contexto de los mercados financieros: algunas tareas requieren un análisis rápido de largas secuencias de precios, mientras que otras exigen una alta precisión de la señal con recursos limitados.
Para ilustrarlo, el artículo de los autores analiza dos enfoques implementados mediante un único modelo Transformer clásico preentrenado. El primero, SpikingBrain-7B, es un modelo puramente lineal optimizado para procesar contextos largos con un consumo mínimo de recursos. El segundo, SpikingBrain-76B, una variante híbrida de MoE, combina la atención lineal y la atención local, logrando un equilibrio entre la eficiencia y la calidad de la predicción.
En SpikingBrain-7B, la atención lineal se alterna con capas locales de atención de ventana deslizante (SWA) con una ventana de análisis fija. Las capas locales captan patrones de precios detallados, de forma muy similar a como un operador identifica los impulsos a corto plazo, mientras que la atención lineal condensa de manera eficiente las dependencias a largo plazo, lo que permite al modelo preservar la integridad contextual sin una sobrecarga computacional excesiva. Como resultado, el entrenamiento del modelo mantiene una complejidad temporal lineal, mientras que el consumo de memoria durante el funcionamiento se mantiene constante, independientemente de la longitud de la secuencia. En la práctica, la atención lineal se implementa mediante el módulo de atención lineal con compuertas (Gated Linear Attention), que amplifica las señales importantes y ayuda a las neuronas a recordar la dinámica del mercado al responder únicamente a los eventos verdaderamente significativos.
SpikingBrain-76B lleva esta idea un paso más allá. En esta arquitectura, la atención lineal y la atención local se combinan dentro de una capa en una configuración híbrida paralela. También se insertan capas estándar de atención completa entre estas capas para mejorar la coherencia global de las señales. Esta arquitectura permite captar simultáneamente los acontecimientos del mercado, tanto locales como globales, sin sobrecargar el modelo con datos innecesarios. Para aumentar la flexibilidad de la atención local y reducir el efecto sumidero de atención, se han añadido al modelo tokens especiales entrenables; estos tokens interactúan con la secuencia sin restricciones causales. Además, en este caso se utiliza una arquitectura dispersa de mezcla de expertos (MoE) para los módulos FFN. Cada capa activa solo un subconjunto de los expertos, lo que permite ahorrar recursos y hace que el modelo pueda procesar grandes volúmenes de datos en tiempo real.
Ambas implementaciones muestran cómo se pueden reinterpretar los principios de Transformer dentro de un paradigma basado en eventos.
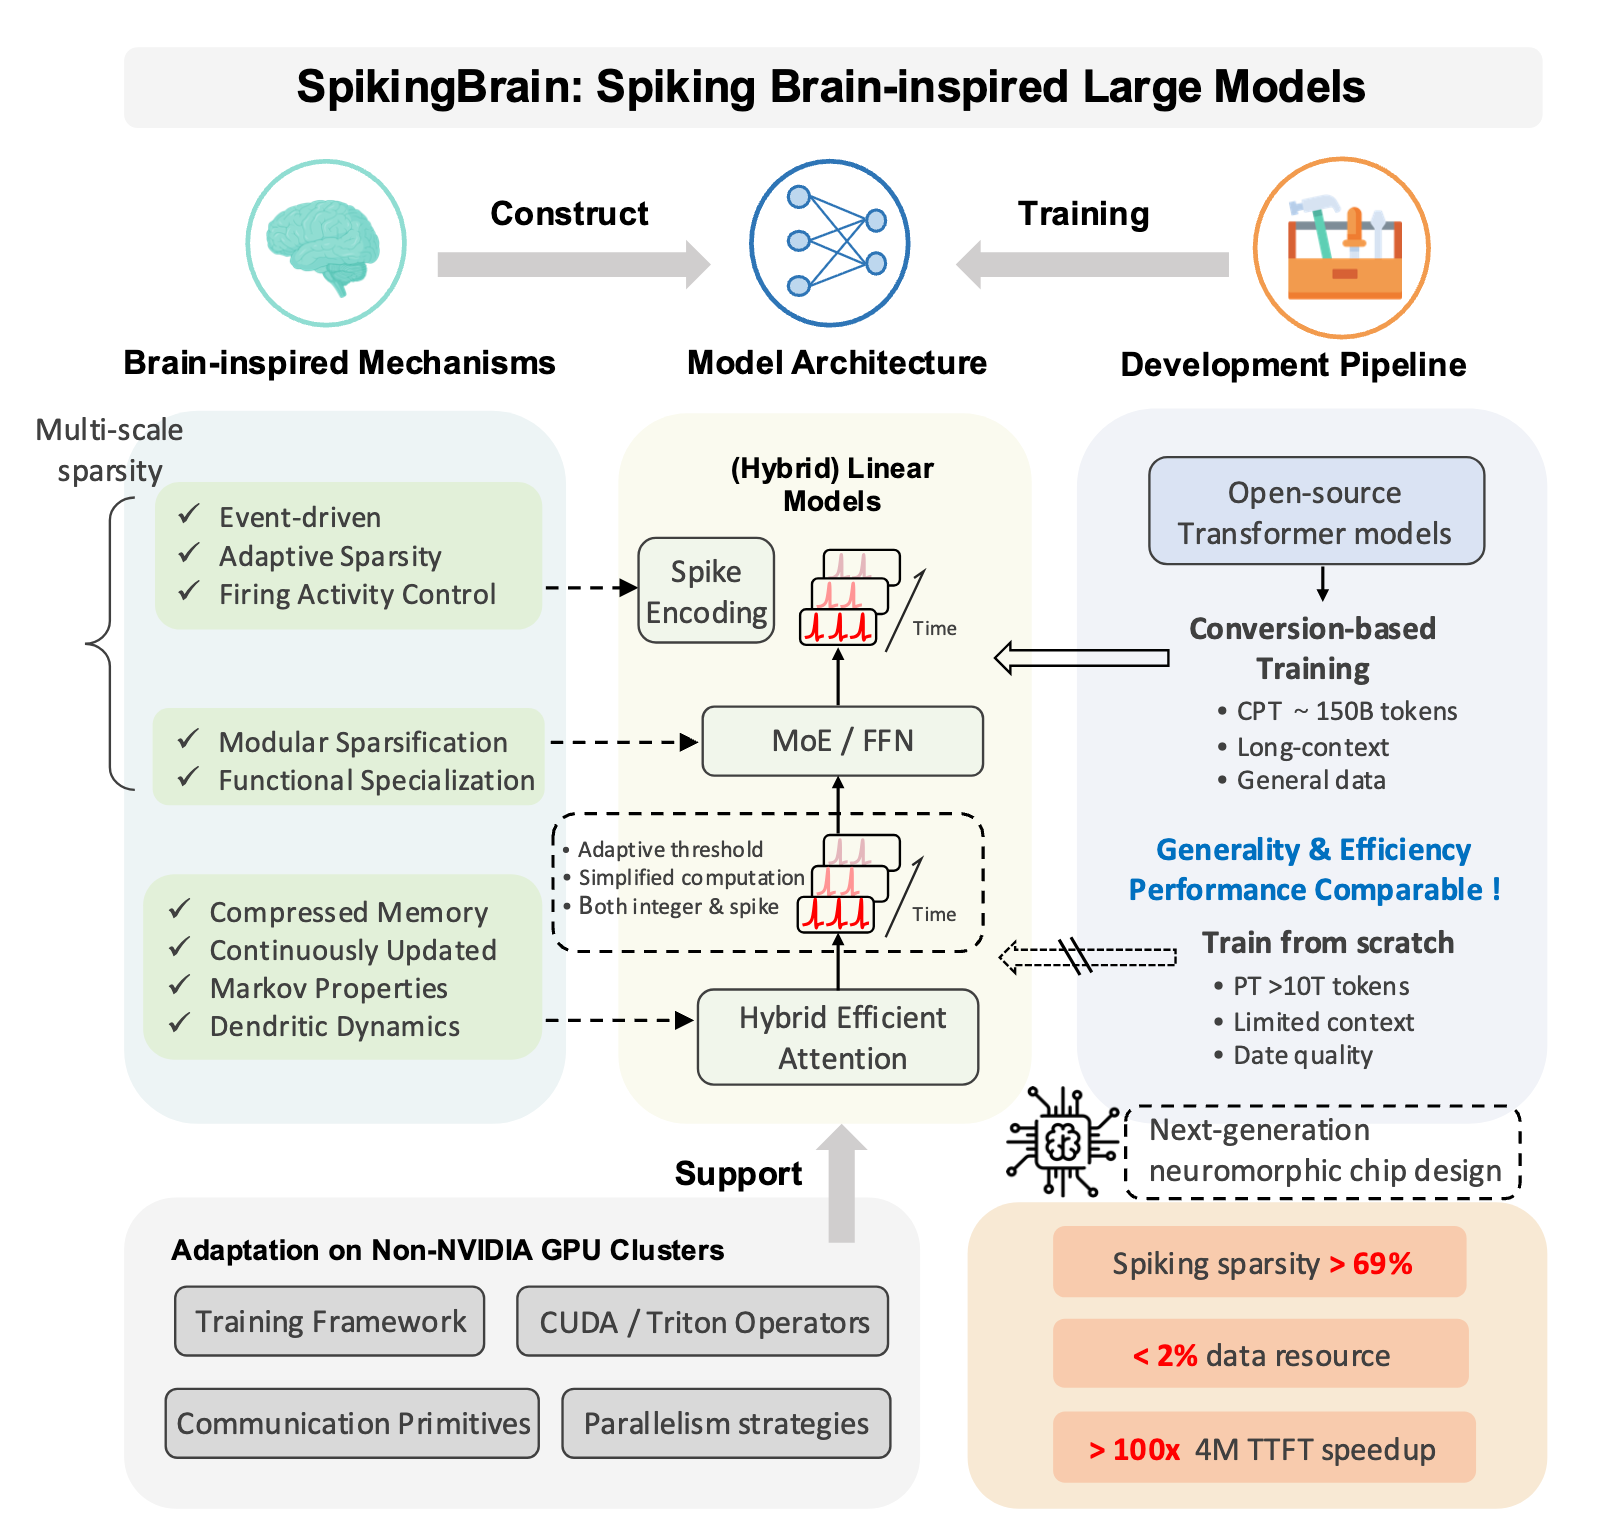
El diseño arquitectónico de SpikingBrain se ajusta, en muchos aspectos, a los principios de funcionamiento del cerebro biológico. Los módulos de atención lineal presentan propiedades similares a las de la memoria humana. Se basan en estados comprimidos y actualizados continuamente. En cada paso, extraen información únicamente del estado actual de la memoria, mostrando un comportamiento que recuerda al de un proceso de Markov. Desde una perspectiva biológica, este tipo de procesamiento recurrente a lo largo del tiempo puede considerarse una abstracción simplificada de la dinámica dendrítica con una morfología ramificada, en la que cada rama lleva a cabo un procesamiento local de la señal.
El componente de mezcla de expertos (MoE) encarna el principio de activación modular dispersa y especialización funcional, similar al procesamiento distribuido y especializado de los circuitos neuronales. Cada experto procesa solo una parte de la información, y el resultado global se obtiene a partir de módulos activos, lo que mejora la eficiencia y la estabilidad del sistema.
El esquema de codificación por impulsos propuesto por los autores del framework se inspira en los sistemas biológicos, caracterizados por una activación neuronal basada en eventos y con un grado de dispersión adaptativo. Al combinar la dispersión a nivel de modelo (MoE) con la dispersión a nivel de neurona individual, los recursos computacionales se asignan de forma eficiente, lo que da lugar a un mecanismo de eficiencia de dos niveles. Este enfoque permite que el sistema se active únicamente cuando sea necesario, centrando los recursos en los acontecimientos más importantes del mercado y manteniendo al mismo tiempo una elevada velocidad de procesamiento de datos.
En conjunto, estas soluciones muestran un camino prometedor hacia la creación de arquitecturas para modelos de gran tamaño que sean a la vez eficientes y económicas desde el punto de vista computacional. Al mismo tiempo, mantienen la plausibilidad biológica al combinar la potencia de las redes neuronales con los principios organizativos del cerebro vivo. En el contexto de los mercados financieros, esto significa que SpikingBrain es capaz de destacar los acontecimientos clave, al tiempo que actúa de forma selectiva y minimiza el ruido.
El entrenamiento de SpikingBrain se basa en principios que permiten una transferencia eficaz de conocimientos desde modelos Transformer preentrenados a nuevas arquitecturas de impulsos e híbridas. Esto se basa en la correspondencia entre los mapas de atención. En un Transformer preentrenado, la atención viene determinada por la función SoftMax estándar aplicada al producto consulta-clave multiplicado por la máscara de secuencia. En este contexto, la atención local de ventana deslizante (SWA) puede considerarse una versión dispersa de este mapa con un marcado sesgo hacia los acontecimientos recientes. En ese caso, la atención lineal es una aproximación de rango bajo, en la que el rango máximo del mapa viene limitado por la dimensionalidad de los vectores de consulta y clave.
Mediante esta correspondencia, los parámetros de proyección de QKV pueden inicializarse directamente a partir de un punto de control de un Transformer preentrenado. Mediante un ajuste fino ligero con una cantidad relativamente pequeña de datos, la atención se adapta a configuraciones locales o de rango bajo. La atención local preserva la precisión del análisis de los acontecimientos recientes, mientras que la atención lineal capta las relaciones globales. Su combinación en modo híbrido ofrece una aproximación más precisa al mapa de atención original. Para el mercado financiero, esto significa que el modelo puede seguir simultáneamente tanto los saltos del precio a corto plazo como las tendencias globales, al tiempo que mantiene la coherencia en sus señales.
Se utilizan varias técnicas importantes para garantizar un entrenamiento estable y una transición fluida a la nueva arquitectura. En primer lugar, las activaciones QK en la atención lineal se convierten en valores no negativos mediante ReLU o Sigmoid para preservar las propiedades de SoftMax y garantizar una transferencia de conocimiento correcta. En segundo lugar, se conservan los parámetros de rango bajo, como los componentes de normalización y de control por compuertas. Durante la fase de conversión, el entrenamiento se lleva a cabo con un tamaño de paso pequeño, lo que dificulta la optimización de un gran número de parámetros inicializados aleatoriamente. Los autores del framework reutilizan todos los pesos de proyección en los módulos de atención y en la FFN, lo que permite minimizar el número de nuevos parámetros.
La tercera característica es la ampliación de la longitud del contexto durante el ajuste fino. Dado que los mecanismos de atención eficientes escalan de forma subcuadrática, resulta práctico limitar la longitud del contexto durante la conversión inicial y aumentarla gradualmente durante el entrenamiento. Al mismo tiempo, se mantiene la eficiencia computacional. El modelo se entrena por completo durante la fase de conversión para garantizar su rendimiento, utilizando técnicas de calentamiento de la tasa de aprendizaje y de destilación de conocimiento entre arquitecturas, o bien entrenando todos los parámetros a la vez.
En un contexto financiero, este enfoque permite una transferencia fluida de conocimientos desde potentes modelos preentrenados a arquitecturas especializadas de impulsos de SpikingBrain. El modelo conserva la información sobre los acontecimientos clave del mercado, al tiempo que filtra eficazmente el ruido y reduce los costes computacionales.
El proceso de entrenamiento de SpikingBrain se lleva a cabo mediante una conversión en varias etapas. El preentrenamiento continuo (CPT), con una ampliación gradual del contexto, da paso de forma fluida al ajuste fino supervisado (SFT). En su trabajo, los autores del framework de entrenamiento de modelos utilizaron conjuntos de datos abiertos de alta calidad. No obstante, en la práctica, pueden utilizarse datos financieros específicos para adaptar el modelo a mercados o activos concretos.
El artículo de los autores describe un proceso de tres etapas para entrenar el modelo de lenguaje SpikingBrain. En cada una de estas etapas, la longitud del contexto aumenta gradualmente y el modelo se adapta a los nuevos requisitos. En la primera fase, los modelos se entrenan con 100 000 millones de tokens con una longitud de secuencia de 8K. Esto permite transferir los patrones de atención a las variantes locales y de rango bajo, y lograr una convergencia estable de la función de pérdida. En la segunda y tercera etapas, la longitud de la secuencia se amplía a 32K y 128K, respectivamente, utilizando entre 20 000 y 30 000 millones de tokens en cada ocasión. En total, la conversión requiere unos 150 000 millones de tokens, lo que supone solo alrededor del 2 % de los datos necesarios para entrenar el modelo desde cero, y permite una adaptación eficaz con recursos limitados. En todas las etapas, la codificación posicional rotatoria (RoPE) básica permanece inalterada, al igual que en el modelo original.
Tras la fase CPT viene el ajuste fino, que a su vez se divide en tres fases. La primera de ellas se centra en la comprensión básica del lenguaje y los conocimientos del dominio, utilizando el amplio conjunto de datos Infinity Instruct, que abarca conocimientos científicos, interpretación de código y resolución de problemas matemáticos. El entrenamiento se lleva a cabo con 500.000 ejemplos con una longitud de secuencia de 8K. La segunda fase se centra en las habilidades de diálogo y en la capacidad de seguir instrucciones, mediante una serie de diálogos de varios turnos orientados a tareas y preguntas con contenido educativo. El volumen de datos y la longitud de la secuencia siguen siendo los mismos. La tercera fase se centra en tareas de razonamiento, utilizando un conjunto de datos de alta calidad que contiene cadenas de razonamiento detalladas para demostraciones matemáticas, inferencias lógicas, análisis de casos y otros problemas de varios pasos.
Este enfoque por etapas permite a SpikingBrain adquirir conocimientos de forma gradual a partir de modelos preentrenados, adaptarse a contextos largos y, al mismo tiempo, mejorar la precisión de la señal en distintos niveles.
Para transformar de forma eficaz el modelo de red de propagación hacia delante densa (FFN) en una arquitectura de mezcla de expertos (MoE), los autores del framework utilizan la técnica de upcycling, que aumenta la capacidad del modelo al tiempo que reutiliza el conocimiento ya codificado en los parámetros originales. Durante la inicialización, los parámetros del modelo base de red de propagación hacia delante densa (FFN) se copian en N expertos y se introduce un enrutador aleatorio para cada token. Este enrutador selecciona a los K mejores expertos con una probabilidad p y devuelve su suma ponderada, lo que garantiza la equivalencia funcional con la red densa original en el momento de la inicialización.
Durante el entrenamiento, el enrutamiento estocástico y la incorporación de ruido a los datos rompen gradualmente la simetría inicial, creando gradientes diferenciados y fomentando la especialización de los expertos. Además de los expertos enrutados, el modelo SpikingBrain-76B utiliza un único experto compartido que está siempre activo para todos los tokens y contribuye a estabilizar el proceso de conversión.
La copia directa y la activación de varios expertos aumentan la magnitud de los valores de salida. Para mantener la coherencia entre las salidas de la mezcla de expertos (MoE) y las de la red de propagación hacia delante densa (FFN), se introduce un factor de escala que se aplica a todos los expertos durante la inicialización. Así pues, en un primer momento, la red MoE funciona de manera equivalente al modelo denso original, al tiempo que conserva el potencial para una mayor especialización y una mayor capacidad.
En un contexto financiero, esta arquitectura MoE permite al modelo SpikingBrain supervisar simultáneamente numerosos escenarios de mercado, asignando expertos especializados a diferentes tipos de señales. Algunos se centran en los impulsos de los precios a corto plazo, mientras que otros se centran en las tendencias globales o en acontecimientos poco frecuentes. Gracias al «upcycling», la red se adapta rápidamente al reutilizar los conocimientos acumulados anteriormente, lo que acelera el entrenamiento y mejora la precisión de la señal sin imponer una carga computacional excesiva.
Inspirándose en los mecanismos computacionales biológicos —el procesamiento basado en eventos y la activación dispersa—, los autores del framework proponen una estrategia especializada de codificación por impulsos que convierte las activaciones de modelos de gran tamaño en valores enteros y secuencias de impulsos. Este esquema puede aplicarse tanto durante como después del entrenamiento, convirtiendo las activaciones del modelo en señales de impulsos. Para mejorar la eficiencia energética, además de la generación de impulsos, se propone cuantizar los pesos del modelo y la caché KV a una precisión INT8. La integración de esta estrategia con la conversión ligera de SpikingBrain elimina la necesidad de realizar un ajuste fino completo. Basta con una muestra de calibración relativamente pequeña para optimizar los parámetros de cuantización.
Las activaciones en SpikingBrain se convierten siguiendo una lógica de dos etapas. En la primera etapa se utiliza la generación de impulsos con umbral adaptativo. Las activaciones se convierten en impulsos de valor entero mediante un umbral regulado dinámicamente que mantiene un equilibrio estadístico de la actividad neuronal. Esto evita tanto el disparo neuronal excesivo como la inactividad, lo cual es fundamental para preservar el contenido informativo de las señales.
Formalmente, el umbral se define como el valor absoluto medio del potencial de membrana, multiplicado por el hiperparámetro k, que controla el número de impulsos. Este mecanismo es resistente a los valores atípicos poco frecuentes. Las neuronas mantienen una actividad estable para la mayoría de las señales y solo aumentan el número de impulsos ante picos de intensidad de importancia crítica. En un contexto financiero, esto puede compararse con el cruce del precio con la línea de una media móvil. Las fluctuaciones normales de los precios no alcanzan el umbral de neutralidad y, por lo tanto, no provocan ninguna reacción. Solo cuando el precio cruza la media móvil —el momento clave— se genera una señal. Del mismo modo, una red neuronal de impulsos responde únicamente a eventos significativos, filtrando el ruido y centrándose en los movimientos del mercado que tienen un valor real para la negociación.
En la segunda etapa, ya en la fase de inferencia, los impulsos de valor entero resultantes se despliegan a lo largo del eje temporal en secuencias dispersas de impulsos con valores {−1, 0, 1}. Esto permite sustituir las multiplicaciones de matrices densas por acumulaciones basadas en eventos, lo que mejora considerablemente la eficiencia computacional. Los autores del framework proponen tres esquemas de codificación para distintos escenarios.
El primero es la codificación binaria {0,1}. Cada 1 corresponde a la activación de una neurona, y el número de impulsos se acumula con el tiempo. Se trata de una solución sencilla y eficaz para una baja densidad de impulsos; sin embargo, los valores elevados requieren muchos pasos temporales.
La segunda es la codificación ternaria {−1, 0, 1}, que introduce impulsos inhibidores. Este enfoque permite expresar tanto la excitación como la inhibición, lo que se ajusta más a los principios biológicos de la excitación y la inhibición. La codificación ternaria reduce el número de pasos temporales y disminuye la frecuencia de impulsos en más de la mitad, al tiempo que conserva la expresividad de las señales.
La tercera es la codificación bit a bit (codificación bit a bit). El número entero de impulsos se desglosa bit a bit a lo largo del tiempo. Este esquema garantiza la máxima compresión a lo largo del eje temporal. Son posibles la codificación bidireccional y la representación con signo, lo que permite tener en cuenta simultáneamente tanto los valores positivos como los negativos, al tiempo que se mantienen la simplicidad y la plausibilidad biológica. La codificación bit a bit reduce el número total de impulsos hasta una octava parte, lo que minimiza la sobrecarga de comunicación y la carga computacional.
En consecuencia, este enfoque permite a SpikingBrain evitar reaccionar ante cada tick o movimiento del mercado debido al ruido y, en su lugar, centrarse en los eventos significativos, de forma muy similar a un operador que solo toma una decisión cuando el precio cruza un nivel clave. Cada conversión de activaciones en impulsos hace que el modelo sea más selectivo y eficiente y esté mejor adaptado al entorno dinámico de los mercados financieros.
A continuación se muestra la representación que hacen los autores del framework SpikingBrain.
Implementación en MQL5
Tras un análisis detallado de los aspectos teóricos del framework SpikingBrain, pasamos a la parte práctica de nuestro trabajo, en la que exploraremos una posible implementación de los enfoques propuestos utilizando MQL5. Y deberíamos quitarnos ya mismo las gafas de color de rosa. El ahorro de recursos al que se refieren los autores del framework se consigue, en gran medida, mediante el uso de grandes modelos de lenguaje preentrenados basados en la arquitectura Transformer. Sin acceso a dichos modelos, el proceso de entrenamiento sigue requiriendo mucho trabajo y muchos recursos, por lo que es importante tenerlo en cuenta a la hora de planificar el trabajo.
No obstante, la cuestión clave sobre la eficacia de la arquitectura propuesta sigue sin resolverse. Esto es precisamente lo que pretendemos evaluar en la práctica, analizando cómo se comportan el procesamiento por impulsos y la estructura modular de MoE con recursos computacionales limitados y datos reales del mercado. Esto nos permitirá evaluar las ventajas reales de SpikingBrain: su capacidad para filtrar el ruido, identificar señales clave del mercado y ahorrar recursos computacionales en un entorno en el que los milisegundos y la precisión son fundamentales.
Al mismo tiempo, el uso de modelos neuronales preentrenados, tal y como proponen los autores del framework, abre una importante oportunidad. En esta implementación podemos utilizar módulos y capas de la red neuronal ya creados. Esto agiliza considerablemente el proceso. Sin embargo, no será posible prescindir por completo de la implementación de nuevos algoritmos. La combinación de componentes ya disponibles y nuevos algoritmos permitirá implementar de forma eficaz SpikingBrain utilizando MQL5 y comprobar su eficacia.
Empecemos por desarrollar un algoritmo relativamente sencillo que convierta la señal continua de una neurona estándar en un valor ternario discreto {-1, 0, 1}. Este enfoque se basa en la idea fundamental de la activación por impulsos: una neurona permanece inactiva hasta que el potencial alcanza un umbral crítico, y solo entonces emite una señal, ya sea en sentido positivo o negativo. Para implementar este algoritmo, creamos un nuevo kernel en el programa OpenCL.
El funcionamiento del kernel es sencillo y claro. En primer lugar, comprobamos que el valor de origen sea válido y que no sea NaN ni infinito. Si no hay señal o si la señal es demasiado débil en relación con el nivel umbral, la neurona permanece en estado de reposo; se le asigna un valor de 0.
__kernel void FloatToSpike(__global const float* values,
                           __global const float* levels,
                           __global float* outputs
                          )
  {
   const size_t id = get_global_id(0);
   float val = IsNaNOrInf(values[id], 0.0f);
   if(val == 0.0f)
      outputs[id] = 0.0f;
   else
     {
      const float lev = IsNaNOrInf(levels[id], 0.0f);
      if(fabs(val) < lev)
         outputs[id] = 0.0f;
      else
         outputs[id] = (float)sign(val);
     }
  }
Si el valor absoluto supera el umbral, la neurona emite un impulso en función de la dirección del cambio: +1 para un impulso positivo y −1 para uno negativo.
Este enfoque permite modelar el principio fundamental del procesamiento por impulsos: responder únicamente a los eventos significativos. La conversión de los datos a {-1, 0, 1} permite filtrar los movimientos insignificantes y centrarse en los puntos clave de los eventos, del mismo modo que un operador solo reacciona cuando el precio cruza un nivel importante.
Sin embargo, tras la aparente simplicidad del algoritmo de pasada hacia delante se esconde la tarea nada trivial de distribuir el gradiente del error necesario para entrenar el modelo. La cuestión principal es cuándo y cómo debe propagarse el gradiente de vuelta a la señal de entrada de la neurona. Si limitamos la propagación del gradiente únicamente a las neuronas activas, podemos encontrarnos fácilmente con el problema de la desactivación masiva de un gran número de neuronas, momento en el que el entrenamiento se detiene de hecho. El gradiente, sencillamente, no se propaga, y el modelo deja de adaptarse.
La complejidad se acentúa aún más cuando se utiliza una señal de tres valores {-1, 0, 1}. Durante el proceso de aprendizaje, resulta inevitablemente necesario cambiar la dirección de la activación de una neurona de positiva a negativa —o viceversa— pasando por un intervalo de inactividad. Si el gradiente queda bloqueado dentro de este intervalo, la neurona se bloquea y pierde su capacidad de aprendizaje.
Partiendo de esto, tomamos una decisión fundamental: el gradiente del error debe propagarse en todo momento, independientemente del estado actual de la neurona. Este enfoque garantiza la actualización continua de los parámetros, evita que el entrenamiento se estanque y preserva la adaptabilidad del modelo, incluso si la mayoría de las neuronas permanecen temporalmente inactivas. Este es un paso clave que garantiza la eficacia del procesamiento por impulsos al trabajar con señales discretas y permite que el modelo aprenda de forma estable a partir de flujos de datos financieros.
El segundo aspecto importante se refiere al umbral a partir del cual las neuronas se disparan. Tal y como señalan los autores del framework SpikingBrain, un umbral elevado da lugar a una generación de señales poco frecuente. Como consecuencia, el modelo pasa por alto una parte importante de la información útil. Por el contrario, un umbral bajo aumenta la sensibilidad de las neuronas, pero al mismo tiempo hace que respondan al ruido, lo que genera señales falsas.
Por lo tanto, la solución óptima consiste en dejar que el modelo aprenda por sí mismo los umbrales de disparo de cada neurona. Esto da lugar a una propiedad interesante: los gradientes del error de la señal y del umbral de disparo se orientan en direcciones opuestas. Si es necesario amplificar la respuesta de una neurona ante acontecimientos significativos, se debe reducir el umbral para que la señal pueda atravesar la barrera con mayor facilidad. Si, por el contrario, el objetivo es suprimir las fluctuaciones ruidosas, hay que elevar el umbral para limitar las señales falsas.
Por lo tanto, aprender los valores de los umbrales se convierte en un delicado ejercicio de equilibrio. El modelo debe filtrar el ruido y, al mismo tiempo, seguir siendo sensible a los acontecimientos clave del mercado. Este mecanismo hace que las neuronas de impulsos sean adaptativas y les permite centrarse en las fluctuaciones de precios verdaderamente significativas. Como un operador experimentado que sabe cuándo actuar y cuándo esperar a recibir una confirmación.
Trasladamos la implementación del enfoque descrito al nivel del kernel del programa OpenCL, creando un algoritmo que procesa los gradientes del error de las señales de las neuronas y de sus valores de umbral.
__kernel void FloatToSpikeGrad(__global const float* values,
                               __global float* values_gr,
                               __global float* levels_gr,
                               __global const float* gradients
                              )
  {
   const size_t id = get_global_id(0);
   const float grad = IsNaNOrInf(gradients[id], 0.0f);
   values_gr[id] = grad;
   if(fabs(grad) > 0.0f)
     {
      float val = IsNaNOrInf(values[id], 0.0f);
      levels_gr[id] = (float)(-sign(val) * grad);
     }
   else
      levels_gr[id] = 0.0f;
  }
El principio de funcionamiento del kernel refleja una característica clave del entrenamiento de las neuronas de umbral. El gradiente del error siempre se propaga a la señal de entrada de la neurona a través del array values_gr. En este caso, para el valor de umbral de la neurona, el gradiente se calcula con signo opuesto al correspondiente a la dirección de la señal. Si es necesario potenciar la respuesta de una neurona ante un acontecimiento significativo, se reduce el umbral. Y, para suprimir el ruido, se eleva el umbral.
Para organizar el proceso desde el programa principal, creamos una nueva capa CNeuronSpikeConv, que hereda la funcionalidad básica de los objetos totalmente conectados y, al mismo tiempo, permite combinar el proceso clásico de convolución con la generación de impulsos, formando así un único módulo que produce impulsos discretos para su posterior procesamiento.
class CNeuronSpikeConv  :  public CNeuronBaseOCL
  {
protected:
   CNeuronConvOCL    cConv;
   CParams           cLevels;
   //---
   virtual bool      FloatToSpike(void);
   virtual bool      FloatToSpikeGrad(void);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSpikeConv(void) {};
                    ~CNeuronSpikeConv(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint window, uint step, uint window_out, uint units_count,
                          uint variables, ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual CBufferFloat* GetWeightsConv(void)   {  return cConv.GetWeightsConv();  }
   virtual int       Type(void) override const  {  return defNeuronSpikeConv;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   virtual void      SetOpenCL(COpenCLMy *obj)   override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual uint      GetFilters(void) const { return cConv.GetFilters(); }
   virtual uint      GetVariables(void) const { return cConv.GetVariables(); }
   virtual uint      GetUnits(void) const { return cConv.GetUnits(); }
  };
La clase contiene varios componentes clave. En concreto, el objeto cConv realiza operaciones de convolución de señales, mientras que cLevels aprende y almacena los valores umbral de cada neurona. La clase define los métodos FloatToSpike y FloatToSpikeGrad, que son métodos envoltorio para los kernels del mismo nombre.
Un nuevo objeto se inicializa en el método Init, que configura secuencialmente todos los componentes clave de la capa.
bool CNeuronSpikeConv::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                            uint window, uint step, uint window_out, uint units_count,
                            uint variables, ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, window_out * units_count * variables,
                                                                     optimization_type, batch))
      return false;
En primer lugar, se inicializa el objeto padre, proceso durante el cual se crean las interfaces base heredadas.
A continuación, se inicializa el módulo de convolución cConv y se le pasan los parámetros correspondientes a la ventana, el paso de convolución, el número de elementos y las variables. Se le asigna de inmediato la función de activación TANH, que garantiza un escalado suave de la señal de salida dentro del rango de valores previsto.
   if(!cConv.Init(0, 0, OpenCL, window, step, window_out, units_count, variables, optimization, iBatch))
      return false;
   cConv.SetActivationFunction(TANH);
A continuación, se configura el componente de umbral cLevels, también con la optimización activada y la función de activación SIGMOID definida. Un paso importante consiste en asignar a los pesos de cLevels valores constantes de -10. Esto garantiza que los umbrales se establezcan en un estado inicial correcto antes del entrenamiento —cercano a cero—, lo que permite que las neuronas respondan de inmediato a los eventos significativos sin verse bloqueadas por un umbral elevado.
   if(!cLevels.Init(0, 1, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cLevels.SetActivationFunction(SIGMOID);
   CBufferFloat* temp = cLevels.getWeights();
   if(!temp)
      return false;
   if(!temp.Fill(-10))
      return false;
//---
   return true;
  }
Como resultado, el método Init reúne la preparación de todos los componentes de la capa y crea un módulo listo para su uso, capaz tanto de realizar convoluciones como de generar impulsos. Esta integración garantiza que la capa procese los datos financieros de forma coordinada, lo que permite que las neuronas respondan únicamente a las fluctuaciones significativas y filtren el ruido.
El método feedForward permite la propagación hacia delante de la señal a través de la capa CNeuronSpikeConv. En primer lugar, se invoca el método del mismo nombre del módulo de convolución cConv; este procesa los datos de entrada y genera la señal convolucionada.
bool CNeuronSpikeConv::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cConv.FeedForward(NeuronOCL))
      return false;
   if(bTrain)
      if(!cLevels.FeedForward())
         return false;
//---
   return FloatToSpike();
  }
Si la capa está funcionando en modo de entrenamiento (bTrain==true), el componente de generación de umbrales cLevels realiza una pasada hacia delante adicional, lo que garantiza una adaptación correcta de los umbrales para cada neurona.
El último paso consiste en llamar a la función FloatToSpike, que convierte los valores obtenidos en impulsos discretos.
Como se puede ver, el algoritmo para la pasada hacia delante es bastante sencillo y no plantea complicaciones para la propagación del gradiente. Los parámetros del modelo se actualizan mediante componentes anidados, lo que contribuye a mantener la claridad de la arquitectura y simplifica el proceso de entrenamiento. Por lo tanto, proponemos dejar el estudio de los métodos de la pasada hacia atrás como ejercicio independiente. El código completo de la clase y de todos sus métodos se incluye en el archivo adjunto, lo que te permite revisar todos los detalles de la implementación y la integración de las neuronas de impulsos.
Hoy hemos trabajado mucho, y es hora de tomarnos un descanso para ordenar las ideas. Deja que la información acumulada encaje en su sitio y date tiempo para asimilar los detalles. En el próximo artículo, retomaremos el trabajo que hemos iniciado, continuaremos nuestra exploración de los modelos de impulsos y demostraremos cómo se aplican estos algoritmos a flujos de datos financieros reales, transformando la teoría en señales prácticas de negociación.
Conclusión
En este artículo hemos analizado los fundamentos teóricos del framework SpikingBrain. La principal ventaja de este framework reside en su naturaleza basada en eventos. Las neuronas solo se activan cuando se alcanza un umbral determinado, lo que reduce drásticamente la probabilidad de que se produzcan señales falsas y mejora la calidad de la señal. A diferencia de las arquitecturas tradicionales, como Transformer, este framework permite conservar la información esencial sobre los movimientos significativos del mercado sin sobrecargar el sistema con datos redundantes.
Además, el uso de umbrales adaptativos y la capacidad de integrar módulos preentrenados garantizan la flexibilidad y la escalabilidad del modelo. La arquitectura de impulsos favorece de forma natural la eficiencia energética y computacional, lo que la hace especialmente atractiva para el trading algorítmico y el análisis en tiempo real de grandes volúmenes de datos.
Enlaces
Programas utilizados en este artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Study.mq5 | Asesor experto | Asesor experto para el entrenamiento de modelos fuera de línea |
| 2 | StudyOnline.mq5 | Asesor experto | Asesor experto para el entrenamiento de modelos en línea |
| 3 | Test.mq5 | Asesor experto | Asesor experto para pruebas de modelos |
| 4 | Trajectory.mqh | Biblioteca de clases | Estructura para describir el estado del sistema y la arquitectura del modelo |
| 5 | NeuroNet.mqh | Biblioteca de clases | Biblioteca de clases para crear una red neuronal |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código de programas en OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19709
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.

 Automatización de estrategias de trading en MQL5 (Parte 33): Creación de un sistema basado en el patrón armónico Shark y la acción del precio
 Características del Wizard MQL5 que debe conocer (Parte 80): Uso de patrones Ichimoku y ADX-Wilder con aprendizaje por refuerzo TD3
 Crypto Exchange Integration with MQL5 (Part 1): Connecting to MEXC Futures
 Algoritmo del Bisonte: Bison Algorithm (BIA)

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso