Cópulas bivariantes en MQL5 (Parte 1): Implementación de cópulas gaussianas y t de Student para modelar la dependencia
 7
 0

Introducción
Las estrategias de negociación basadas en cópulas ofrecen un enfoque alternativo interesante para el arbitraje estadístico, ya que modelan la dependencia entre dos activos mediante una función de cópula. El trading de pares tradicional se basa en divergencias temporales respecto a una relación esperada a largo plazo, y se puede utilizar una cópula para modelar esta relación e identificar oportunidades de negociación. La ventaja teórica del uso de cópulas radica en su capacidad para reflejar las dependencias no lineales y asimétricas entre activos.
Teniendo esto en cuenta, este artículo marca el inicio de una serie dedicada a la implementación de herramientas para estrategias de negociación basadas en cópulas. En esta primera entrega, analizamos los fundamentos de las cópulas estadísticas en el contexto del trading de pares y la modelización de dependencias. También presentamos código MQL5 para el preprocesamiento de conjuntos de datos antes de ajustar los modelos de cópula. El objetivo general de la serie será desarrollar una biblioteca que implemente los modelos de cópula más habituales. Para empezar, este artículo presenta las implementaciones de las cópulas gaussianas y t de Student.
Conceptos fundamentales de la teoría de las cópulas
Para trabajar con cópulas, es necesario comprender cinco conceptos relacionados.
La función de densidad de probabilidad. En el estudio de las distribuciones estadísticas, la función de densidad de probabilidad (PDF) describe la densidad de probabilidad de una variable aleatoria continua X en un valor concreto x. A diferencia de una función de masa de probabilidad discreta, la función de densidad de probabilidad (PDF) no asigna probabilidades directamente a valores concretos. En cambio, representa una densidad, de tal forma que la probabilidad de que X se encuentre dentro de un intervalo específico [a, b] viene dada por la integral de la función de densidad de probabilidad (PDF) en ese intervalo.
La función de distribución acumulada. Partiendo de la función de densidad de probabilidad (PDF), la función de distribución acumulada (CDF) indica la probabilidad de que una variable aleatoria X adopte un valor menor o igual que x. La función de distribución acumulada (CDF) es una función no decreciente que toma valores entre 0 y 1 y ofrece una descripción completa de la distribución de probabilidad de una variable aleatoria.
Distribuciones marginales y conjuntas. Cuando se trabaja con varias variables aleatorias, resulta necesario distinguir entre distribuciones marginales y distribuciones conjuntas. Una distribución marginal describe la distribución de probabilidad de una sola variable dentro de un conjunto más amplio, ignorando, en la práctica, la influencia de las demás variables. Por el contrario, una distribución conjunta caracteriza la distribución de probabilidad colectiva de todas las variables de un conjunto de datos.
La transformación integral de probabilidad (Probability Integral Transform, PIT). La PIT es un concepto fundamental de la teoría de la probabilidad y un elemento esencial para comprender las cópulas. Establece que, si X es una variable aleatoria continua con función de distribución acumulada F, entonces la variable transformada U = F(X) sigue una distribución uniforme en el intervalo [0,1]. En otras palabras, independientemente de si X sigue una distribución normal, exponencial o cualquier otra distribución continua, al aplicarle su propia función de distribución acumulada (CDF), se transforma en una variable con una distribución uniforme en [0,1].
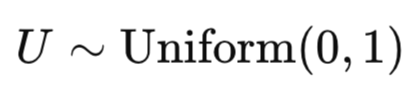
La PIT permite transformar cualquier variable aleatoria continua en una variable con valores en el intervalo unitario, estandarizándola a la vez que conserva su estructura probabilística. Al transformar las distribuciones marginales en distribuciones uniformes, podemos analizar cómo se relacionan las variables sin que influya la distribución de cada una de ellas. Este espacio uniforme es precisamente donde actúan las cópulas, que captan la estructura de dependencia entre las variables una vez que las distribuciones marginales se han transformado de esta manera.
Función de distribución empírica. Cuando se desconoce la distribución subyacente real de una variable, podemos utilizar la función de distribución empírica (Empirical Cumulative Distribution Function, ECDF) como estimación de la función de distribución acumulada (CDF) real. Para una muestra de N observaciones, x1, x2, …, xN, la ECDF se define como:
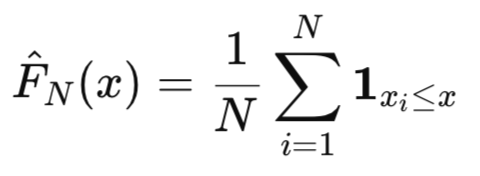
que define una función que toma el valor 1 si x_i ≤ x y 0 en cualquier otro caso.
El uso de la ECDF para realizar la PIT suele denominarse «enfoque de estimación no paramétrica», ya que no presupone una forma específica para las distribuciones marginales. Los puntos de datos transformados son las entradas que se utilizan para ajustar la propia cópula.
El archivo linear_cdf.mqh contiene la definición de la clase CLinearCDF, que se utiliza para estimar la ECDF de un conjunto de datos. La clase genera una ECDF aplicando una interpolación lineal entre los escalones de la ECDF estándar. Esto suaviza el resultado y mantiene la concordancia con la ECDF estándar en los puntos de la muestra.
//+------------------------------------------------------------------+
//|                                                   linear_cdf.mqh |
//|                                  Copyright 2024, MetaQuotes Ltd. |
//|                                             https://www.mql5.com |
//+------------------------------------------------------------------+
#property copyright "Copyright 2024, MetaQuotes Ltd."
#property link      "https://www.mql5.com"
#include<Arrays/ArrayDouble.mqh>
#include<Arrays/ArrayObj.mqh>
#include "ecdf.mqh"
//+------------------------------------------------------------------+
//|CArray objects                                                    |
//+------------------------------------------------------------------+
class CArrayDoubles:public CArrayObj
  {
   virtual bool      CreateElement(const int index)
     {
      m_data[index] = new CArrayDouble();
      return m_data[index]!=NULL;
     }
  };
//+------------------------------------------------------------------+
//| ecdf quantile transformer                                        |
//+------------------------------------------------------------------+
class CLinearCDF
  {
protected:
   CSpline1DInterpolantShell* m_shells[];
   CArrayDoubles      m_internal;
   CArrayDouble      *m_arrays[];
   double            m_ub,m_lb;
   ulong             m_cols;
   void              clean_up(void)
     {

      for(uint i = 0; i<m_shells.Size(); i++)
         delete m_shells[i];
      for(uint i = 0; i<m_arrays.Size(); i++)
         delete m_arrays[i];
      m_internal.Clear();
     }
public:
                     CLinearCDF(void)
     {
      m_cols = 0;
     }
                    ~CLinearCDF(void)
     {
      clean_up();
     }
   bool              save(const int filehandle)
     {
      if(!m_cols)
         return false;
      return m_internal.Save(filehandle);
     }
   bool              load(const int filehandle)
     {
      if(m_cols)
        {
         clean_up();
         m_cols = 0;
        }

      if(m_internal.Load(filehandle))
        {
         int n_arrays = m_internal.Total();
         m_cols = ulong((n_arrays-1)/2);
         ArrayResize(m_shells,int(m_cols));
         ArrayResize(m_arrays,int(m_cols*2)+1);
         double xa[],ya[];
         m_arrays[0] = m_internal.At(0);
         m_ub = m_arrays[0].At(0);
         m_lb = m_arrays[0].At(1);
         for(int i = 0; i<int(m_cols); i++)
           {
            m_arrays[i*2+1] = m_internal.At(i*2+1);
            m_arrays[i*2+2] = m_internal.At(i*2+2);
            ArrayResize(xa,m_arrays[i*2+1].Total());
            for(int j = 0; j<m_arrays[i*2+1].Total(); j++)
               xa[j] = m_arrays[i*2+1][j];
            ArrayResize(ya,m_arrays[i*2+2].Total());
            for(int j = 0; j<m_arrays[i*2+2].Total(); j++)
               ya[j] = m_arrays[i*2+2][j];
            m_shells[i] = new CSpline1DInterpolantShell();
            CAlglib::Spline1DBuildLinear(xa,ya,m_shells[i]);
           }
         return true;
        }
      else
         return false;
     }
   bool              fit(matrix &data,double upper_bound = 1.0-1.e-5,double lower_bound = 1.e-5)
     {
      if(upper_bound<=lower_bound)
        {
         Print(__FUNCTION__, " invalid inputs ");
         return false;
        }

      if(m_cols)
        {
         clean_up();
         m_cols = 0;
        }

      m_ub = upper_bound;
      m_lb = lower_bound;
      m_cols = data.Cols();
      vector v;
      double xa[],ya[];
      vector slopes;
      vector slope_samples;
      CECDF m_ecdf;
      ArrayResize(m_shells,int(m_cols));
      ArrayResize(m_arrays,int(m_cols*2)+1);
      m_arrays[0] = new CArrayDouble();
      if(!m_arrays[0].Add(m_ub) || !m_arrays[0].Add(m_lb) || !m_internal.Add(m_arrays[0]))
        {
         Print(__FUNCTION__, " error ", GetLastError());
         return false;
        }
      for(uint i = 0; i<m_shells.Size(); i++)
        {
         v = data.Col(i);
         if(!m_ecdf.fit(v))
           {
            Print(__FUNCTION__, " error ");
            return false;
           }

         np::quickSort(v,true,0,long(v.Size()-1));
         slopes = np::unique(v);
         slope_samples = m_ecdf.ecdf(slopes);
         m_shells[i] = new CSpline1DInterpolantShell();
         if(!np::vecAsArray(slopes,xa) || !np::vecAsArray(slope_samples,ya))
           {
            Print(__FUNCTION__, " error ");
            return false;
           }
         m_arrays[i*2+1] = new CArrayDouble();
         m_arrays[i*2+2] = new CArrayDouble();
         if(!m_arrays[i*2+1].AddArray(xa) || !m_arrays[i*2+2].AddArray(ya) ||!m_internal.Add(m_arrays[i*2+1])||!m_internal.Add(m_arrays[i*2+2]))
           {
            Print(__FUNCTION__, " error ", GetLastError());
            return false;
           }
         CAlglib::Spline1DBuildLinear(xa,ya,m_shells[i]);
        }

      return true;
     }

   matrix            to_quantile(matrix &in)
     {
      if(in.Cols()!=m_cols)
        {
         Print(__FUNCTION__, " invalid input ");
         return matrix::Zeros(0,0);
        }

      vector temp;
      matrix out(in.Rows(),m_cols);
      for(ulong i = 0; i<m_cols; ++i)
        {
         temp  = in.Col(i);
         for(ulong j = 0; j<in.Rows(); ++j)
            out[j][i] = MathMax(MathMin(CAlglib::Spline1DCalc(m_shells[i],temp[j]),m_ub),m_lb);
        }

      return out;
     }
  };
//+------------------------------------------------------------------+
El método `fit()` toma una matriz con cualquier número de columnas, que se consideran variables de un conjunto de datos multivariante. Los parámetros de entrada opcionales `upper_bound` y `lower_bound` definen restricciones que impiden que los valores sean exactamente 0 o 1. Internamente, la ECDF estándar se evalúa en los puntos de la muestra, ordenados y sin duplicados. A continuación, se crea un modelo de interpolación lineal unidimensional basado en estos puntos y sus correspondientes valores de la ECDF.
//+------------------------------------------------------------------+
//|                                                    ECDF_Demo.mq5 |
//|                                  Copyright 2025, MetaQuotes Ltd. |
//|                                             https://www.mql5.com |
//+------------------------------------------------------------------+
#property copyright "Copyright 2025, MetaQuotes Ltd."
#property link      "https://www.mql5.com"
#property version   "1.00"
#property script_show_inputs
#include<ECDF/linear_cdf.mqh>
//--- input parameters
input string   FirstSymbol = "NZDUSD";
input string   SecondSymbol = "AUDUSD";
input ENUM_TIMEFRAMES TimeFrame = PERIOD_D1;
input datetime StartDate=D'2024.01.01 00:00:01';
input ulong HistoryLength = 1000;
input bool Use_Returns = false;
input int DisplayDuration = 30;//display duration in seconds
//+------------------------------------------------------------------+
//| Script program start function                                    |
//+------------------------------------------------------------------+
void OnStart()
  {
//---download symbol data
   vector syA,syB;
   if(!syA.CopyRates(FirstSymbol,TimeFrame,COPY_RATES_CLOSE,StartDate,HistoryLength) ||
      !syB.CopyRates(SecondSymbol,TimeFrame,COPY_RATES_CLOSE,StartDate,HistoryLength) ||
      syA.Size()!=syB.Size())
     {
      Print("Error downloading price data ", ::GetLastError());
      return;
     }
//---optionally transform to returns
   if(Use_Returns)
     {
      syA = np::diff(log(syA));
      syB = np::diff(log(syB));
     }
//---create matrix container and fill it
   matrix xy(syA.Size(),2);
   if(!xy.Col(syA,0) || !xy.Col(syB,1))
     {
      Print(" column insertion error ", GetLastError());
      return ;
     }
//---build ECDF model
   CLinearCDF qd;
   if(!qd.fit(xy))
     {
      Print(" CLinearCDF failure ");
      return;
     }
//---transform raw values to quantiles
   matrix yx = qd.to_quantile(xy);
//---display QQ plot
   np::scatter_plot(yx.Col(0),yx.Col(1),"Q-Q plot",FirstSymbol,SecondSymbol,true,0,0,0,0,500,500,true,30);
//---
  }
//+------------------------------------------------------------------
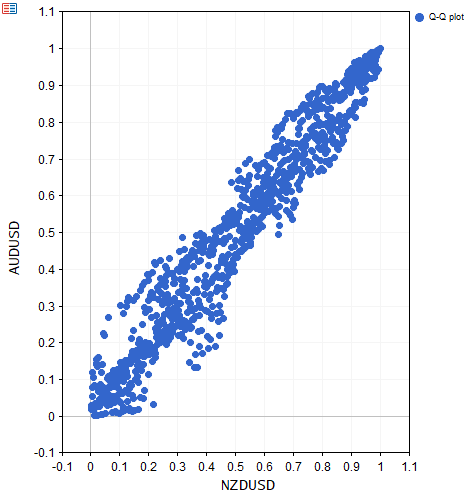
El script ECDF_Demo.ex5 muestra cómo utilizar la clase CLinearCDF aplicándola a un conjunto de datos de precios bivariante. A continuación, los valores transformados se utilizan para mostrar el gráfico cuantil-cuantil (Q-Q) de los datos.
Definición de una cópula
Una cópula es una función de distribución acumulada multivariante que describe la estructura de dependencia entre variables aleatorias, independientemente de sus distribuciones marginales. En términos más sencillos, una cópula es un mecanismo matemático que nos permite separar la dependencia entre variables del comportamiento individual de cada una de ellas.
Dadas unas variables aleatorias, cada una con su propia distribución marginal, una cópula une estas distribuciones marginales en una distribución conjunta al describir cómo se relacionan entre sí las variables, independientemente de la forma de sus distribuciones individuales. Esta separación entre distribuciones marginales y dependencia es fundamental en el análisis multivariante moderno, especialmente cuando el supuesto de normalidad o de dependencia lineal resulta inadecuado. Esto se formaliza matemáticamente mediante el teorema de Sklar. El teorema de Sklar establece que, para cualquier función de distribución conjunta continua F, existe una única cópula C tal que:
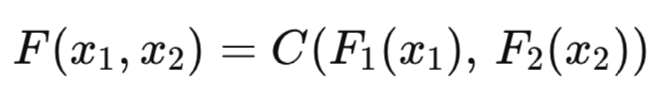
donde F1(x1) y F2(x2) son las funciones de distribución acumulada marginales de X1 y X2, respectivamente.
La capacidad de una cópula para reflejar la dependencia entre dos o más variables aleatorias puede compararse con una medida de asociación, como el coeficiente de correlación. La diferencia radica en que una cópula aporta información adicional sobre la naturaleza de la relación entre las variables, mientras que un coeficiente de correlación resume dicha relación en un único valor.
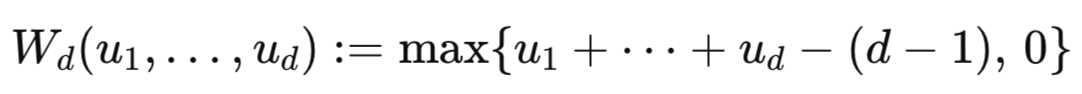
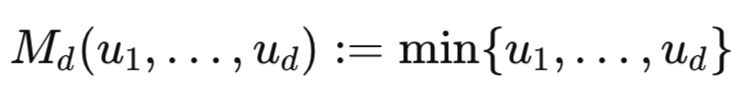
Del mismo modo que el coeficiente de correlación está acotado entre −1 y 1, las cópulas se caracterizan por unas cotas similares denominadas cotas de Fréchet–Hoeffding. Las cotas inferior y superior de Fréchet–Hoeffding son funciones que definen la dependencia más negativa y más positiva que puede captar una cópula concreta. Las cotas de Fréchet–Hoeffding son en sí mismas cópulas, donde d corresponde a la dimensionalidad o al número de variables.
Dependencia de cola
La naturaleza propia de cada función de cópula le permite reflejar diferentes tipos de estructuras de dependencia. Una propiedad de una cópula que suele ser de interés en aplicaciones financieras es su capacidad para modelar la dependencia de cola. La dependencia de cola es una medida del movimiento conjunto de las variables aleatorias cuando estas toman valores extremos. El tipo de dependencia de cola que puede modelar una cópula determina cómo representa los sucesos extremos que se producen conjuntamente. La cola superior se refiere a los valores extremadamente altos de una distribución, mientras que la cola inferior corresponde a los valores extremadamente bajos. La dependencia de cola se cuantifica mediante el coeficiente de dependencia de cola (λ), que se calcula como el límite de una probabilidad condicional. La dependencia de cola es difícil de cuantificar sin expresarla en términos de una cópula.
La dependencia de cola inferior mide la probabilidad de que una variable tome un valor extremadamente bajo, dado que la otra también toma un valor extremadamente bajo.
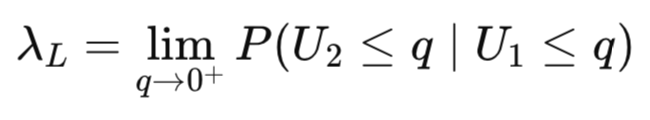
La dependencia de cola superior mide la probabilidad de que una variable tome un valor extremadamente alto, dado que la otra también toma un valor extremadamente alto.
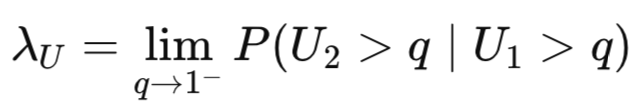
Tipos de cópula
Las cópulas pueden clasificarse en grandes clases y familias que definen formas funcionales específicas. Las cópulas que describiremos en esta serie de artículos son paramétricas. Se trata de cópulas que se caracterizan por parámetros que cuantifican los rasgos de dependencia que captan.
Las cópulas elípticas son una clase de cópulas multivariantes derivadas de distribuciones elípticas, como la distribución normal multivariante (gaussiana) y la distribución t de Student multivariante. Se parametrizan principalmente mediante alguna medida de asociación, que refleja la estructura de dependencia lineal entre las variables. Las dos cópulas elípticas más comunes son la gaussiana y la t de Student. En la siguiente sección, profundizamos en la implementación de las cópulas elípticas bivariantes, comenzando por la cópula gaussiana bivariante.
Cópula gaussiana bivariante
La cópula gaussiana bivariante se deriva de la distribución normal bivariante estándar. Se caracteriza por un único parámetro: el coeficiente de correlación lineal (ρ) de la distribución normal bivariante subyacente. Este parámetro determina la intensidad y la dirección de la dependencia entre las dos variables aleatorias. La cópula gaussiana es radialmente simétrica y es muy utilizada por su facilidad de cálculo, aunque presenta una dependencia de cola débil. Esto significa que no refleja adecuadamente los fenómenos extremos intensos y simultáneos que se producen en las variables.
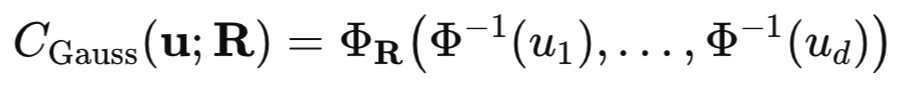
El archivo de cabecera gaussian.mqh contiene la clase CGaussian, que implementa una cópula gaussiana bivariante. CGaussian es una clase derivada de la clase abstracta CBivariateCopula definida en base.mqh y constituye la base de todas las implementaciones de cópulas bivariantes que describiremos.
//+------------------------------------------------------------------+
//| base copula class                                                |
//+------------------------------------------------------------------+
class CBivariateCopula:public CObject
  {
private:
   int               m_len;
protected:
   double            m_eps;
   double            m_theta;
   double            m_rho;
   double            m_nu;
   double            m_threshold;
   ENUM_COPULA_TYPE  m_copula_type;
   vector            m_bounds;
   double            m_tau;
   matrix            m_cov;
   virtual bool      check_theta(void)
     {
       return (m_theta>m_bounds.Min() < m_theta < m_bounds.Max());
     }
   virtual double    pdf(double u,double v) { return EMPTY_VALUE; }
   virtual double    cdf(double u,double v) { return EMPTY_VALUE; }
   virtual double    condi_cdf(double u,double v) { return EMPTY_VALUE; }
   virtual vector    pdf(vector& u,vector& v){ return vector::Zeros(0); }
   virtual vector    cdf(vector& u,vector& v){ return vector::Zeros(0); }
   virtual vector    condi_cdf(vector& u,vector& v){ return vector::Zeros(0); }
   virtual double    theta_hat(const double tau){ return EMPTY_VALUE; }
   void              preprocess(double &u, double &v)
     {
      u = MathMin(MathMax(m_eps,u),1.0-m_eps);
      v = MathMin(MathMax(m_eps,v),1.0-m_eps);
     }
   void              preprocess(vector &u, vector &v)
     {
      u.Clip(m_eps,1.0-m_eps);
      v.Clip(m_eps,1.0-m_eps);
     }
   double            kendalTau(const vector &vec1,const vector &vec2)
     {
      double tau = double("nan");
      ulong size=vec1.Size();
      if(size==0 || vec2.Size()!=size)
        {
         Print(__FUNCTION__, " size of input vectors donot match ");
         return(tau);
        }
      //---
      long cnt1=0,cnt2=0,cnt=0;
      //---
      for(long i=0; i<long(size); i++)
        {
         for(long j=i+1; j<long(size); j++)
           {
            double delta1=vec1[i]-vec1[j];
            double delta2=vec2[i]-vec2[j];
            double delta=delta1*delta2;
            if(delta==0)
              {
               if(delta1!=0)
                  cnt1++;
               if(delta2!=0)
                  cnt2++;
              }
            else
              {
               cnt1++;
               cnt2++;
               if(delta>0.0)
                  cnt++;
               else
                  cnt--;
              }
           }
        }
      //--- calculate Kendall tau
      long den=cnt1*cnt2;
      if(den==0)
        {
         Print(__FUNCTION__, " failed zero check at line 76");
         return tau;
        }
      tau=double(cnt)/MathSqrt(den);
      //---
      return(tau);
     }

public:
                     CBivariateCopula(void)
     {
      m_len = 6;
      m_eps = 1.e-5;
      m_theta = m_rho = m_nu = EMPTY_VALUE;
      m_copula_type = WRONG_VALUE;
      m_cov  = matrix::Zeros(0,0);
      m_bounds = vector::Zeros(2);
      m_bounds[0] = -DBL_MIN;
      m_bounds[1] = DBL_MAX;
     }
                    ~CBivariateCopula(void)
     {
     }
   double            Get_theta(void)  { return m_theta; }
   double            Get_tau(void)    { return m_tau;   }
   double            Get_rho(void)    { return m_rho;   }
   matrix            Get_covar(void)  { return m_cov;   }
   double            Get_nu(void)     { return m_nu;    }
   double            Get_threshold(void) { return m_threshold; }
   double            Get_eps(void)    { return m_eps;   }
   virtual void              Set_theta(double theta) {  m_theta = theta; }
   virtual void              Set_tau(double tau) { m_tau = tau; }
   virtual void              Set_threshold(double threshold) { m_threshold = threshold; }
   virtual void              Set_nu(double nu) { m_nu = nu; }
   virtual void              Set_rho(double rho) { m_rho = rho; }
   virtual void              Set_eps(double eps) { m_eps = eps; }
   virtual matrix            Sample(ulong num_samples) { return matrix::Zeros(0,0); }
   virtual void              Set_covariance(matrix &cov)
     {
      m_cov = cov;
      m_rho = m_cov[0][1] / (sqrt(m_cov[0][0]) * sqrt(m_cov[1][1]));
     }
   virtual double    Fit(vector &u, vector&v)
     {
      if(u.Max()>1.0 || v.Max()>1.0 || v.Min()<0.0 ||u.Min()<0.0)
       {
        Print(__FUNCTION__, " Invalid input variable(s) ");
        return EMPTY_VALUE;
       }
      m_tau = kendalTau(u,v);
      m_theta = theta_hat(m_tau);
      if(!check_theta())
        Print(__FUNCTION__, " Invalid theta " );
      return  m_theta;
     }
   double            Log_likelihood(vector &u, vector &v)
     {
      if(u.Size()!=v.Size())
        {
         Print(__FUNCTION__, " vectors are not of equal length ");
         return EMPTY_VALUE;
        }

      vector ll = pdf(u,v);

      return (log(ll)).Sum();
     }
   double            Copula_PDF(double u, double v)
     {
      preprocess(u,v);
      return pdf(u,v);
     }
   double            Copula_CDF(double u, double v)
     {
      preprocess(u,v);
      return cdf(u,v);
     }
   double            Conditional_Probability(double u, double v)
     {
      preprocess(u,v);
      return condi_cdf(u,v);
     }
   vector            Copula_PDF(vector& u, vector& v)
     {
      preprocess(u,v);
      return pdf(u,v);
     }
   vector            Copula_CDF(vector& u, vector& v)
     {
      preprocess(u,v);
      return cdf(u,v);
     }
   vector            Conditional_Probability(vector& u, vector& v)
     {
      preprocess(u,v);
      return condi_cdf(u,v);
     }
   double            Theta(double tau = 0.0)
     {
      if(!tau && m_tau)
         return theta_hat(m_tau);
      else
         if(tau)
            return theta_hat(tau);
         else
           {
            Print(__FUNCTION__ " invalid input parameter 'tau' ");
            return EMPTY_VALUE;
           }
     }

   virtual bool      Save(const int file_handle)
     {
      if(file_handle!=INVALID_HANDLE)
        {
         //---
         if(FileWriteLong(file_handle,-1)==sizeof(long))
           {
            //---
            if(FileWriteInteger(file_handle,int(m_copula_type),INT_VALUE)!=INT_VALUE)
               return(false);
            //---
            if(FileWriteInteger(file_handle,m_len,INT_VALUE)!=INT_VALUE)
               return(false);
            //---
            if(FileWriteDouble(file_handle,m_eps)!=sizeof(double) ||
               FileWriteDouble(file_handle,m_theta)!=sizeof(double) ||
               FileWriteDouble(file_handle,m_tau)!=sizeof(double) ||
               FileWriteDouble(file_handle,m_rho)!=sizeof(double) ||
               FileWriteDouble(file_handle,m_nu)!=sizeof(double) ||
               FileWriteDouble(file_handle,m_threshold)!=sizeof(double))
               return false;
            return true;
           }
        }
      return false;
     }
   virtual bool      Load(const int file_handle)
     {
      if(file_handle!=INVALID_HANDLE)
        {
         //---
         if(FileReadLong(file_handle)==-1)
           {
            //---
            m_copula_type = ENUM_COPULA_TYPE(FileReadInteger(file_handle,INT_VALUE));

            if(FileReadInteger(file_handle,INT_VALUE)!=m_len)
               return false;

            ResetLastError();
            m_eps=FileReadDouble(file_handle);
            m_theta=FileReadDouble(file_handle);
            m_tau=FileReadDouble(file_handle);
            m_rho=FileReadDouble(file_handle);
            m_nu=FileReadDouble(file_handle);
            m_threshold=FileReadDouble(file_handle);
            if(GetLastError())
              {
               Print(__FUNCTION__, " possible read error ", GetLastError());
               return false;
              }
            return true;
           }
        }
      return false;
     }
   virtual int       Type(void)
     {
      return int(m_copula_type);
     }
  };
Permite especificar modelos de cópula de dos formas diferentes. Un modelo se puede definir explícitamente utilizando los métodos de acceso para establecer los parámetros pertinentes de la cópula. Como alternativa, se puede construir un modelo ajustándolo a un conjunto de datos bivariantes de variables uniformes (las funciones de distribución acumulada marginales, o CDF marginales, de los valores brutos) mediante el método Fit(). Si se ejecuta correctamente, el método devolverá cualquier valor que no sea la constante EMPTY_VALUE.
La densidad de una cópula se calcula llamando al método Copula_PDF(), mientras que Copula_CDF() calcula la función de distribución acumulada conjunta de la cópula. La función de distribución acumulada condicional (CDF) de la cópula se calcula llamando al método Conditional_Probability(). Todos los métodos que acabamos de mencionar están sobrecargados para aceptar entradas escalares y vectoriales. El método Sample() se utiliza para generar conjuntos de datos sintéticos que se ajustan a los parámetros del modelo de una cópula. Por último, los métodos Load() y Save() permiten la serialización y deserialización de los modelos de cópula para su almacenamiento persistente.
Para crear una cópula gaussiana bivariante explícita es necesario especificar una matriz de covarianzas de dos por dos.
virtual void Set_covariance(matrix& cov) override
     {
      if(cov.Rows()!=2 || cov.Cols()!=2)
       {
        Print(__FUNCTION__," invalid input: expecting 2x2 matrix ");
        return;
       }
      m_cov = cov;
      m_rho = m_cov[0][1] / (sqrt(m_cov[0][0]) * sqrt(m_cov[1][1]));
      m_tau = (2.0/M_PI) * MathArcsin(m_rho);
      m_theta = theta_hat(m_tau);
     }
El script «SampleEllipticCopula.ex5» comprueba si los datos sintéticos muestreados a partir de una cópula elíptica se ajustan a los parámetros del modelo especificados. Las entradas configurables por el usuario que llevan el prefijo «Covar» especifican los elementos de una matriz de covarianzas. El parámetro «Degree_Of_Freedom» no es relevante a la hora de realizar pruebas con una cópula gaussiana. El parámetro «Size» define el número de muestras que se van a generar.
//+------------------------------------------------------------------+
//|                                         SampleEllipticCopula.mq5 |
//|                                  Copyright 2025, MetaQuotes Ltd. |
//|                                             https://www.mql5.com |
//+------------------------------------------------------------------+
#property copyright "Copyright 2025, MetaQuotes Ltd."
#property link      "https://www.mql5.com"
#property version   "1.00"
#property script_show_inputs
#include<Copulas/Bivariate/gaussian.mqh>
#include<Copulas/Bivariate/t.mqh>
//+------------------------------------------------------------------+
//|  enum                                                            |
//+------------------------------------------------------------------+
enum ENUM_ELPT_COPULA
 {
  GAUSSIAN=0,//Gaussian
  STUDENT//Student
 };
//--- input parameters
input ENUM_ELPT_COPULA copula_to_sample_from = GAUSSIAN;
input double Covar_0_0_ = 2.0;
input double Covar_0_1_ = 0.5;
input double Covar_1_0_ = 0.5;
input double Covar_1_1_ = 2.0;
input double Degrees_Of_Freedom = 5.0;
input ulong Size = 1000;
El programa utiliza el método Sample() para generar datos sintéticos, que posteriormente se muestran en un gráfico de dispersión. A continuación, se aplica la función de distribución acumulada inversa de la distribución gaussiana estándar al conjunto de datos antes de estimar la matriz de correlaciones.
//+------------------------------------------------------------------+
//| Script program start function                                    |
//+------------------------------------------------------------------+
void OnStart()
  {
//---
   matrix covar(2,2);
//---
   covar[0,0] = Covar_0_0_;
   covar[0,1] = Covar_0_1_;
   covar[1,0] = Covar_1_0_;
   covar[1,1] = Covar_1_1_;
//---
   CBivariateCopula *copula = NULL;
//---
   double set_theta = 0.0;
   switch(copula_to_sample_from)
    {
     case GAUSSIAN:
       copula = (CBivariateCopula*)new CGaussian();
       copula.Set_covariance(covar);
       break;
     case STUDENT:
       copula = (CBivariateCopula*)new CStudent();
       copula.Set_covariance(covar);
       copula.Set_nu(Degrees_Of_Freedom);
       break;
    }
//---
   Print("Specified correlation parameter of ", EnumToString(copula_to_sample_from)," copula :",copula.Get_rho());
   matrix samples = copula.Sample(Size);
   matrix inv_samples = samples;

   for(ulong i = 0; i<inv_samples.Rows(); ++i)
     for(ulong j =0; j<inv_samples.Cols(); ++j)
          inv_samples[i,j] = copula_to_sample_from == GAUSSIAN?CAlglib::InvNormalCDF(inv_samples[i,j]):studentTQuantile(inv_samples[i,j],Degrees_Of_Freedom);

   Print("Correlation of matrix of variable sampled from  ", EnumToString(copula_to_sample_from)," copula :\n", inv_samples.CorrCoef(false));
   string cname = EnumToString((ENUM_COPULA_TYPE)copula.Type());
//---
   delete copula;
//---display scatter plot
   np::scatter_plot(inv_samples.Col(0),inv_samples.Col(1),cname+" Scatter plot","X","Y",true,0,0,0,0,500,300,true,10);
//---
  }
A continuación se muestran los resultados de dos ejecuciones. El resultado esperado es una matriz cuyos elementos fuera de la diagonal son aproximadamente iguales al parámetro de correlación del modelo de cópula. Ten en cuenta que el número de muestras especificado influirá en el resultado. Cuanto mayor sea el número de muestras, más se acercará el resultado al parámetro de correlación especificado.
CQ      0       14:06:16.963    SampleEllipticCopula (XAUEUR,D1)        Specified correlation parameter of GAUSSIAN copula :0.24999999999999994
DJ      0       14:06:17.021    SampleEllipticCopula (XAUEUR,D1)        Correlation of matrix of variable sampled from  GAUSSIAN copula :
DG      0       14:06:17.022    SampleEllipticCopula (XAUEUR,D1)        [[1,0.2497651923653427]
RK      0       14:06:17.022    SampleEllipticCopula (XAUEUR,D1)         [0.2497651923653427,1]]
En la siguiente sección, centraremos nuestra atención en la otra cópula elíptica: la cópula t de Student.
Cópula t de Student bivariante
La cópula t de Student bivariante es una de las alternativas más destacadas a la cópula gaussiana, ya que permite modelar una dependencia de cola que esta última no puede captar. La cópula t de Student viene definida por dos parámetros: el coeficiente de correlación y los grados de libertad, que suelen denominarse ρ y ν, respectivamente. A diferencia de la cópula gaussiana, la cópula t presenta una dependencia de cola distinta de cero, lo que significa que los eventos extremos en una variable aumentan la probabilidad de que se produzcan eventos extremos en la otra.
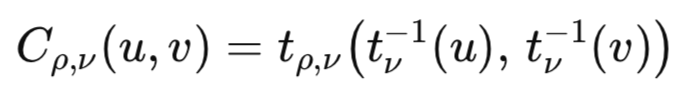
Donde:
- t ρ, ν tρ,ν = función de distribución acumulada (CDF) de la distribución t de Student bivariante con correlación ρ y ν grados de libertad,
- t ν − 1 tν−1 = función de distribución acumulada inversa (función cuantil) de la distribución t univariante con ν grados de libertad,
- u, v ∈ [0,1] u, v ∈ [0,1].
La dependencia en la cópula t es mayor en las colas que en el centro, a diferencia de la cópula gaussiana, que presenta una dependencia uniforme en toda la distribución. Esto la hace especialmente adecuada para modelar las rentabilidades financieras, ya que las caídas bruscas o las subidas extremas simultáneas se producen con mayor frecuencia de lo que predecirían los modelos gaussianos. A medida que aumenta el parámetro de grados de libertad (ν), disminuyen la dependencia de cola superior y la dependencia de cola inferior. De hecho, la cópula t de Student converge hacia una cópula gaussiana a medida que los grados de libertad tienden a infinito. Por el contrario, cuanto menor sea el número de grados de libertad, mayor será la dependencia de cola.
La cópula t de Student se implementa en t.mqh como la clase CStudent, que también es una subclase de CBivariateCopula.
//+------------------------------------------------------------------+
//|                                                            t.mqh |
//|                                  Copyright 2025, MetaQuotes Ltd. |
//|                                             https://www.mql5.com |
//+------------------------------------------------------------------+
#property copyright "Copyright 2025, MetaQuotes Ltd."
#property link      "https://www.mql5.com"
#include "base.mqh"
#ifndef _NP_
#include<np.mqh>
#endif
#include<Math/Stat/T.mqh>
//+------------------------------------------------------------------+
//|utilities for Student's t distribution: Cheng Algorithm           |
//+------------------------------------------------------------------+
double            chengFuAlgo(double probability,double df)
  {
   double k = ceil(df*0.5);
   double a = 1.0 - probability;
   double qi = EMPTY_VALUE;
   if(a!=0.5)
     {
      qi = sqrt(2.0*pow(1.0-2.0*a,2.0)/(1.0 - pow(1.0-2.0*a,2.0)));
      double i = 0.0;
      double gy,j;
      while(i<20.0)
        {
         gy = 0.0;
         j = 0.0;
         while(j<=k-1.0)
           {
            gy+=MathFactorial(int(2*j))/pow(2.0,2.0*j)/pow(MathFactorial(int(j)),2.0)*pow(1.0+pow(qi,2.0)/(2.0*k),-j);
            j+=1.0;
           }
         qi = 1.0/sqrt(1.0/(2.0*k)*(pow(gy/1.0-2.0*a,2.0) - 1.0));
         i+=1.0;
        }
      if(a>0.5)
         return -qi;
      else
         return qi;
     }
   else
      return 0.0;
  }
//+------------------------------------------------------------------+
//| Hills algorithm                                                  |
//+------------------------------------------------------------------+
double            hillsAlgo(double probability,double df)
  {
   double z,a,b,c,x,y,d;
   z = a = b = c = x = y = d = EMPTY_VALUE;
   bool neg = false;
   if(probability>0.5)
     {
      z = 2.0*(1.0-probability);
     }
   else
     {
      neg = true;
      z = 2.0*probability;
     }
   a = 1.0/(df - 0.5);
   b = 48.0/(a*a);
   c = ((20700.0*a/b - 98.0)*a - 16.0)*a + 96.36;
   d = ((94.5/(b + c) - 3.0)/b + 1.0)*sqrt(a*M_PI/2.0)*df;
   x = z*d;
   y = pow(x,(2.0/df));

   if(y>0.05 + a)
     {
      x = CAlglib::InvNormalCDF(z*0.5);
      y = x*x;
      if(df<5.0)
         c = c+0.3*(df-4.5)*(x+0.6);
      c = c + (((0.05*d*x - 5.0)*x - 7.0)*x - 2.0)*x + b;
      y = (((((0.4*y + 6.3)*y + 36.0)*y + 94.5)/c - y - 3.0)/b + 1.0)*x;
      y = a*y*y;
      if(y > 0.002)
         y = exp(y) - 1.0;
      else
         y = y + 0.5*y*y;
     }
   else
      y = ((1.0/(((df + 6.0)/(df*y) - 0.089*d - 0.822)*(df + 2.0)*3.0) + 0.5/(df + 4.0))*y - 1.0)*(df + 1.0)/(df + 2.0) + 1.0/y;
   double q = sqrt(df*y);
   return (neg)?-1.0*q:q;
  }
//+------------------------------------------------------------------+
//| Student's t Inverse CDF                                          |
//+------------------------------------------------------------------+
double            studentTQuantile(double probability, double df)
  {
   if(df == 1.0)
      return tan(M_PI*(probability-1.0/2.0));
   else
      if(df == 2.0)
         return (2.0*probability-1.0)*sqrt(2.0/(4.0*probability*(1.0-probability)));
      else
         if(df == 4.0)
           {
            double a = 4.0*probability*(1.0 - probability);
            double q = cos(1.0/3.0*acos(sqrt(a)))/sqrt(a);
            return np::sign(probability - 0.5)*2.0*sqrt(q-1.0);
           }
         else
            if(!MathMod(df,2.0))
               return chengFuAlgo(probability,df);
            else
               return hillsAlgo(probability,df);
  }
//+------------------------------------------------------------------+
//| Student T Probability Density Function                           |
//+------------------------------------------------------------------+
double studentTDensity(double x, double df)
  {
   return CAlglib::GammaFunction((df + 1.0)/2.0)/(sqrt(df*M_PI)*CAlglib::GammaFunction(df/2.0))*pow((1.0 + pow(x,2.0)/df),(-((df + 1.0)/2.0)));
  }
//+------------------------------------------------------------------+
//| Bivariate Student Copula                                         |
//+------------------------------------------------------------------+
class CStudent : public CBivariateCopula
  {
private:
   virtual double    theta_hat(const double tau) override
     {
      return sin(tau*M_PI/2.0);
     }
   matrix            generate_corr_student(ulong num, matrix& cov, double nu_)
     {
      vector means = vector::Zeros(2);
      matrix normal = np::multivariate_normal(means,cov,num);

      double chi[];
      if(!MathRandomChiSquare(nu_,int(num),chi))
        {
         Print(__FUNCTION__, " Math random chisquare error ", GetLastError());
         return matrix::Zeros(0,0);
        }

      matrix out = matrix::Zeros(num,2);

      for(ulong i = 0; i<out.Rows(); i++)
        {
         double chisqrt = sqrt(chi[i]/nu_);
         out[i,0] = normal[i,0]/chisqrt;
         out[i,1] = normal[i,1]/chisqrt;
        }
      return out;
     }
   double            bvtdist(double z1,double z2, vector& mu, matrix& cov, double df)
     {
      double x1 = z1 - mu[0];
      double x2 = z2 - mu[1];
      double det_cov = cov[0,0]*cov[1,1]-cov[0,1]*cov[1,0];

      double xt = (-2.0*cov[0,1]*x1*x2+cov[0,0]*(pow(x1,2.0)+pow(x2,2.0)))/det_cov;
      double numerator = CAlglib::GammaFunction((2.0+df)/2.0);
      double denominator = (CAlglib::GammaFunction(df/2.0)*df*M_PI*sqrt(det_cov)*pow(1.0+xt/df,(2.0+df)/2.0));
      return numerator/denominator;
     }
   //+------------------------------------------------------------------+
   //|  inner integral function object                                  |
   //+------------------------------------------------------------------+
   class CInnerInt : public CIntegrator1_Func
     {
   private:
      double            m_x;
      double            m_rho;
      matrix            m_corr;
      vector            m_mu;
      double            m_nu;
   public:
      //---
                     CInnerInt(void)
        {
         m_mu = vector::Zeros(2);
        }
                    ~CInnerInt(void) {}
      void              Set(double x, double rho, double nu)
        {
         m_x = x;
         m_nu = nu;
         m_rho = rho;
         matrix crr = {{1.0, m_rho}, {m_rho, 1.0}};
         m_corr = crr;
        }
      virtual void      Int_Func(double x,double xminusa,double bminusx,double &y,CObject &obj)
        {
         double x1 = m_x - 0.0;
         double x2 = x - 0.0;
         double det_cov = m_corr[0,0]*m_corr[1,1]-m_corr[0,1]*m_corr[1,0];

         double xt = (-2.0*m_corr[0,1]*x1*x2+m_corr[0,0]*(pow(x1,2.0)+pow(x2,2.0)))/det_cov;
         double numerator = CAlglib::GammaFunction((2.0+m_nu)/2.0);
         double denominator = (CAlglib::GammaFunction(m_nu/2.0)*m_nu*M_PI*sqrt(det_cov)*pow(1.0+xt/m_nu,(2.0+m_nu)/2.0));
         y =  numerator/denominator;
        }
     };
   //+------------------------------------------------------------------+
   //|  outer integral function object                                  |
   //+------------------------------------------------------------------+
   class COuterInt : public CIntegrator1_Func
     {
   public:
      double            ay_limit;
      double            by_limit;
      double            nu;
      double            rho;
      //---
                     COuterInt(void) {}
                    ~COuterInt(void) {}
      virtual void      Int_Func(double x,double xminusa,double bminusx,double &y,CObject &obj)
        {
         CInnerInt fint;
         //---
         fint.Set(x,rho,nu);
         //---
         CAutoGKStateShell s;
         //---
         double integral;
         //---
         CObject ob;
         //---
         CAutoGKReportShell rep;
         //---
         CAlglib::AutoGKSmooth(ay_limit,by_limit,s);
         //---
         CAlglib::AutoGKIntegrate(s,fint,ob);
         //---
         CAlglib::AutoGKResults(s,integral,rep);
         //---
         CAutoGKReport report = rep.GetInnerObj();
         //---
         if(report.m_terminationtype<0.0)
            Print(__FUNCTION__, " integration error ",report.m_terminationtype);
         //---
         y = integral;
        }
     };
protected:
   virtual double    pdf(double u,double v) override
     {
      double y1,y2;
      y1 = studentTQuantile(u,m_nu);
      y2 = studentTQuantile(v,m_nu);
      vector means = vector::Zeros(2);
      matrix corr = {{1.0,m_rho},{m_rho,1.0}};
      double numerator = bvtdist(y1,y2,means,corr,m_nu);
      double denominator,pdf1,pdf2;
      pdf1 = studentTDensity(y1,m_nu);
      pdf2 = studentTDensity(y2,m_nu);
      denominator = pdf1*pdf2;
      return numerator/denominator;
     }
   virtual double    cdf(double u,double v) override
     {
      double uu,vv;
      uu = MathMax(u,1.e-6);
      vv = MathMax(v,1.e-6);
      //---
      int errcode = 0;
      //---
      COuterInt fout;
      fout.rho = m_rho;
      fout.nu = m_nu;
      fout.ay_limit = double(LONG_MIN);
      fout.by_limit = studentTQuantile(vv,m_nu);
      double ax_limit = double(LONG_MIN);
      double bx_limit = studentTQuantile(uu,m_nu);
      //---
      CObject obj;
      CAutoGKStateShell ss;
      //---
      double outer_integral;
      CAutoGKReportShell repp;
      //---
      CAlglib::AutoGKSmooth(ax_limit,bx_limit,ss);
      //---
      CAlglib::AutoGKIntegrate(ss,fout,obj);
      //---
      CAlglib::AutoGKResults(ss,outer_integral,repp);
      //---
      CAutoGKReport report = repp.GetInnerObj();
      //---
      if(report.m_terminationtype<0.0)
         Print(__FUNCTION__, " integration error ",report.m_terminationtype);
      //---
      return MathMax(MathMin(outer_integral,1.0),0.0);
     }
   virtual double    condi_cdf(double u,double v) override
     {
      double inv_u,inv_v;
      int errcode = 0;
      inv_u = studentTQuantile(u,m_nu);
      inv_v = studentTQuantile(v,m_nu);
      double numerator,denominator;
      numerator = (inv_u-m_rho*inv_v)*sqrt(m_nu+1.0);
      denominator = sqrt((1.0-pow(m_rho,2.))*(pow(inv_v,2.0)+m_nu));
      double tcdf = MathCumulativeDistributionT(numerator/denominator,m_nu+1.0,errcode);
      if(errcode)
        {
         Print(__FUNCTION__, " mathcdf error ", errcode);
         return EMPTY_VALUE;
        }
      return tcdf;
     }
   virtual vector    pdf(vector &u,vector &v) override
     {
      vector out(u.Size());
      for(ulong i = 0; i<u.Size(); ++i)
         out[i] = pdf(u[i],v[i]);
      return out;
     }
   virtual vector    cdf(vector &u,vector &v) override
     {
      vector out(u.Size());
      for(ulong i = 0; i<u.Size(); ++i)
         out[i] = cdf(u[i],v[i]);
      return out;
     }
   virtual vector    condi_cdf(vector &u,vector &v) override
     {
      vector out(u.Size());
      for(ulong i = 0; i<u.Size(); ++i)
         out[i] = condi_cdf(u[i],v[i]);
      return out;
     }
public:
                     CStudent(void)
     {
      m_copula_type = STUDENT_COPULA;
     }
                    ~CStudent(void)
     {
     }

   virtual matrix    Sample(ulong num_samples) override
     {
      matrix spairs = generate_corr_student(num_samples,m_cov,m_nu);
      matrix out = spairs;
      int err1,err2;
      err1 = err2 = 0;
      for(ulong i = 0; i<spairs.Rows(); ++i)
        {
         out[i,0] = MathCumulativeDistributionT(spairs[i,0],m_nu,err1);
         out[i,1] = MathCumulativeDistributionT(spairs[i,1],m_nu,err2);
         if(err1 || err2)
           {
            Print(__FUNCTION__, " mathcdf error ", err1?err1:err2);
            return matrix::Zeros(0,0);
           }
        }
      return out;
     }
   virtual double    Fit(vector &u, vector&v) override
     {
      if(u.Max()>1.0 || v.Max()>1.0 || v.Min()<0.0 ||u.Min()<0.0)
        {
         Print(__FUNCTION__, " Invalid input variable(s) ");
         return EMPTY_VALUE;
        }
      m_tau = kendalTau(u,v);
      m_theta = theta_hat(m_tau);
      if(m_nu == EMPTY_VALUE)
         m_nu = fit_nu(u,v);
      matrix vals = matrix::Zeros(u.Size(),2);
      for(ulong i = 0; i<vals.Rows(); ++i)
        {
         vals[i,0] = studentTQuantile(u[i],m_nu);
         vals[i,1] = studentTQuantile(v[i],m_nu);
        }
      m_cov = vals.Cov(false);
      m_rho = m_cov[0,1]/(sqrt(m_cov[0,0])*sqrt(m_cov[1,1]));
      return m_rho;
     }
  };

//+------------------------------------------------------------------+
A continuación se muestran los resultados de dos ejecuciones del script SampleEllipticCopula.ex5, con la opción de cópula t seleccionada.
IM      0       14:07:00.097    SampleEllipticCopula (XAUEUR,D1)        Specified correlation parameter of STUDENT copula :0.24999999999999994
NQ      0       14:07:00.295    SampleEllipticCopula (XAUEUR,D1)        Correlation of matrix of variable sampled from  STUDENT copula :
GF      0       14:07:00.295    SampleEllipticCopula (XAUEUR,D1)        [[1,0.2441795870726779]
MJ      0       14:07:00.295    SampleEllipticCopula (XAUEUR,D1)         [0.2441795870726779,1]]
Pruebas y validación
Para probar el resto de los métodos de ambas implementaciones de cópula, disponemos de los scripts TestBivariateGaussianCopula.ex5 y TestBivariateStudentTCopula.ex5. Ambos scripts crean modelos de cópula específicos y comprueban las implementaciones de la función de densidad de probabilidad (PDF), la función de distribución acumulada (CDF) y la función de distribución acumulada condicional (CDF condicional). Estas pruebas se han reproducido a partir de las pruebas unitarias del paquete de Python «ArbitrageLab», en el que se basa el código MQL5 presentado. Esto nos permite comprobar si el código MQL5 funciona de la misma manera que la implementación original en Python.
//+------------------------------------------------------------------+
//|                                  TestBivariateGaussianCopula.mq5 |
//|                                  Copyright 2025, MetaQuotes Ltd. |
//|                                             https://www.mql5.com |
//+------------------------------------------------------------------+
#property copyright "Copyright 2025, MetaQuotes Ltd."
#property link      "https://www.mql5.com"
#property version   "1.00"
//--- input parameters
#include<Copulas/Bivariate/gaussian.mqh>
//---
 double Covar_0_0_ = 2.0;
 double Covar_0_1_ = 0.5;
 double Covar_1_0_ = 0.5;
 double Covar_1_1_ = 2.0;
//+------------------------------------------------------------------+
//| Script program start function                                    |
//+------------------------------------------------------------------+
void OnStart()
  {
//---
   matrix covar(2,2);
//---
   covar[0,0] = Covar_0_0_;
   covar[0,1] = Covar_0_1_;
   covar[1,0] = Covar_1_0_;
   covar[1,1] = Covar_1_1_;
//---
   CGaussian norm_copula;
   norm_copula.Set_covariance(covar);
//---
   Print("Rho ", norm_copula.Get_rho());
   Print("Joint cdf(0.7,0.0001) ",norm_copula.Copula_CDF(0.7,0.0001));
   Print("Joint cdf(0.0001,0.7) ",norm_copula.Copula_CDF(0.0001,0.7));
   Print("Joint cdf(0.7,1.0) ",norm_copula.Copula_CDF(0.7,1.0));
   Print("Joint cdf(0.5,0.7) ",norm_copula.Copula_CDF(0.5,0.7));
//---
   Print("Joint pdf(0.5,0.7) ",norm_copula.Copula_PDF(0.5,0.7));
   Print("Joint pdf(0.7,0.5) ",norm_copula.Copula_PDF(0.7,0.5));
   Print("Joint pdf(0.6,0.7) ",norm_copula.Copula_PDF(0.6,0.7));
//---
   Print("Conditional CDF (U<=0.5|V=0.7) ",norm_copula.Conditional_Probability(0.5,0.7));
  }
//+------------------------------------------------------------------+
A continuación se muestran los resultados de la prueba de los métodos de CGaussian.
KR      0       14:40:26.403    TestBivariateGaussianCopula (XAUEUR,D1) Rho 0.24999999999999994
JR      0       14:40:26.403    TestBivariateGaussianCopula (XAUEUR,D1) Joint cdf(0.7,0.0001) 0.00009407442939459683
JG      0       14:40:26.403    TestBivariateGaussianCopula (XAUEUR,D1) Joint cdf(0.0001,0.7) 0.00009407442939459683
KK      0       14:40:26.403    TestBivariateGaussianCopula (XAUEUR,D1) Joint cdf(0.7,1.0) 0.6999973036455064
FL      0       14:40:26.403    TestBivariateGaussianCopula (XAUEUR,D1) Joint cdf(0.5,0.7) 0.38494413131861455
IR      0       14:40:26.403    TestBivariateGaussianCopula (XAUEUR,D1) Joint pdf(0.5,0.7) 1.0233716657780745
KG      0       14:40:26.403    TestBivariateGaussianCopula (XAUEUR,D1) Joint pdf(0.7,0.5) 1.0233716657780745
LK      0       14:40:26.403    TestBivariateGaussianCopula (XAUEUR,D1) Joint pdf(0.6,0.7) 1.0580116369285744
EP      0       14:40:26.403    TestBivariateGaussianCopula (XAUEUR,D1) Conditional CDF (U<=0.5|V=0.7) 0.4461479582632463
A modo de comparación, aquí se muestra el código en Python de la prueba unitaria correspondiente a la cópula gaussiana.
def test_gaussian(self):
        """
        Test Gaussian copula class.
        """

        cov = [[2, 0.5], [0.5, 2]]
        cop = GaussianCopula(cov=cov)
        # Check describe
        descr = cop.describe()
        self.assertEqual(descr['Descriptive Name'], 'Bivariate Gaussian Copula')
        self.assertEqual(descr['Class Name'], 'Gaussian')
        self.assertEqual(descr['cov'], cov)
        self.assertAlmostEqual(descr['rho'], 0.25, delta=1e-5)

        # Check copula joint cumulative density C(U=u,V=v)
        self.assertAlmostEqual(cop.C(0.7, 1e-4), cop.C(1e-4, 0.7), delta=1e-4)
        self.assertAlmostEqual(cop.C(0.7, 1), cop.C(1, 0.7), delta=1e-4)
        self.assertAlmostEqual(cop.C(0.7, 1e-8), 0, delta=1e-4)
        self.assertAlmostEqual(cop.C(0.7, 1), 0.7, delta=1e-4)
        self.assertAlmostEqual(cop.C(0.5, 0.7), 0.384944, delta=1e-4)

        # Check copula joint probability density c(U=u,V=v)
        self.assertAlmostEqual(cop.c(0.5, 0.7), cop.c(0.7, 0.5), delta=1e-8)
        self.assertAlmostEqual(cop.c(0.5, 0.7), 1.023371665778, delta=1e-4)
        self.assertAlmostEqual(cop.c(0.6, 0.7), 1.058011636928, delta=1e-4)

        # Check copula conditional cdf Prob(U<=u|V=v)
        self.assertAlmostEqual(cop.condi_cdf(0.5, 0.7), 0.446148, delta=1e-4
A continuación se muestran los resultados de las pruebas de la clase CStudent.
ER      0       14:40:34.138    TestBivariateStudentTCopula (XAUEUR,D1) Rho 0.24999999999999994
JG      0       14:40:35.369    TestBivariateStudentTCopula (XAUEUR,D1) Joint cdf(0.0,0.2) 0.000006839679521344817
JD      0       14:40:36.613    TestBivariateStudentTCopula (XAUEUR,D1) Joint cdf(0.2,0.0) 0.000006839679521344818
HK      0       14:40:38.041    TestBivariateStudentTCopula (XAUEUR,D1) Joint cdf(0.7,1.0) 0.6999969941893684
PO      0       14:40:39.584    TestBivariateStudentTCopula (XAUEUR,D1) Joint cdf(1.0,0.7) 0.6999969941893683
OR      0       14:40:41.280    TestBivariateStudentTCopula (XAUEUR,D1) Joint cdf(1.0,1.0) 0.9999810861796908
RF      0       14:40:42.452    TestBivariateStudentTCopula (XAUEUR,D1) Joint cdf(0.0,0.0) 0.0000010861794979038194
HJ      0       14:40:43.757    TestBivariateStudentTCopula (XAUEUR,D1) Joint cdf(0.3,0.7) 0.23534922600994124
DL      0       14:40:43.757    TestBivariateStudentTCopula (XAUEUR,D1) Joint pdf(0.5,0.7) 1.0915055449624917
FP      0       14:40:43.757    TestBivariateStudentTCopula (XAUEUR,D1) Joint pdf(0.7,0.5) 1.0915055449624917
MD      0       14:40:43.757    TestBivariateStudentTCopula (XAUEUR,D1) Joint pdf(0.6,0.7) 1.1416004955531887
DD      0       14:40:43.757    TestBivariateStudentTCopula (XAUEUR,D1) Conditional CDF (U<=0.5|V=0.7) 0.441518430406228
MG      0       14:40:43.757    TestBivariateStudentTCopula (XAUEUR,D1) Loglikelihood 2.135711666815534
Prueba unitaria para la cópula t de Student.
def test_student(self):
        """
        Test Student copula class (Student-t).
        """

        cov = [[2, 0.5], [0.5, 2]]
        nu = 5
        cop = StudentCopula(cov=cov, nu=nu)
        # Check describe
        descr = cop.describe()
        self.assertEqual(descr['Descriptive Name'], 'Bivariate Student-t Copula')
        self.assertEqual(descr['Class Name'], 'Student')
        self.assertEqual(descr['cov'], cov)
        self.assertEqual(descr['nu (degrees of freedom)'], nu)
        self.assertAlmostEqual(descr['rho'], 0.25, delta=1e-5)
        # More to be added here for test on C(U<=u, V<=v)

        # Check copula joint probability density c(U=u,V=v)
        self.assertAlmostEqual(cop.c(0.5, 0.7), cop.c(0.7, 0.5), delta=1e-8)
        self.assertAlmostEqual(cop.c(0.5, 0.7), 1.09150554, delta=1e-4)
        self.assertAlmostEqual(cop.c(0.6, 0.7), 1.1416005, delta=1e-4)

        # Check copula joint cumulative density C(U=u,V=v)
        self.assertAlmostEqual(cop.C(0, 0.2), cop.C(0.2, 0), delta=1e-4)
        self.assertAlmostEqual(cop.C(0.7, 1), cop.C(1, 0.7), delta=1e-4)
        self.assertAlmostEqual(cop.C(1, 1), 1, delta=1e-4)
        self.assertAlmostEqual(cop.C(0, 0), 0, delta=1e-4)
        self.assertAlmostEqual(cop.C(0.3, 0.7), 0.23534923332657925, delta=1e-4)

        # Check copula conditional cdf Prob(U<=u|V=v)
        self.assertAlmostEqual(cop.condi_cdf(0.5, 0.7), 0.4415184293094455, delta=1e-4)

        # Check theta(tau)
        self.assertAlmostEqual(cop.theta_hat(2 * np.arcsin(0.2) / np.pi), 0.2, delta=1e-4)

        # log_ml function in ccalc
        u = np.array([0.1, 0.21, 0.5, 0.8])
        v = np.array([0.01, 0.25, 0.4, 0.7])
        new_cop = StudentCopula(nu=5)
        new_cop.fit(u, v)
        ll = new_cop.get_log_likelihood_sum(u=u,
                                            v=v)
        self.assertAlmostEqual(ll, 2.1357117471178584, delta=1e-5
Como se puede observar en la salida, la biblioteca parece funcionar correctamente.
Observaciones finales
Si comparamos las cópulas elípticas implementadas hasta ahora, la cópula t podría ser más adecuada para modelar eventos extremos conjuntos. Sin embargo, no puede reflejar la dependencia de cola asimétrica. Esto ocurre cuando la dependencia es mayor en una de las colas que en la otra. Para ello, serían más útiles las cópulas arquimedianas, como la de Clayton o la de Gumbel.
En la próxima entrega de esta serie de artículos, hablaremos de las cópulas arquimedianas y su implementación en MQL5. Una vez que hayamos implementado un buen número de cópulas, empezaremos a estudiar cómo aplicarlas al trading de pares.
| Archivo o carpeta | Descripción |
|---|---|
| MQL5/include/np.mqh | Un archivo de cabecera con diversas funciones de utilidad para vectores y matrices. |
| MQL5/include/Copulas/Bivariate | Esta carpeta contiene todos los archivos de cabecera de las implementaciones de cópulas. |
| MQL5/include/ECDF | Esta carpeta contiene los archivos de cabecera de la implementación de la función de distribución empírica (ECDF) descrita en el artículo. |
| MQL5/script/ECDF_Demo.mq5 | Este script muestra cómo utilizar la implementación de la función de distribución empírica (ECDF) descrita en el artículo. |
| MQL5/script/TestBivariateGaussianCopula.mq5 | Este script muestra cómo utilizar la clase CGaussian. |
| MQL5/script/TestBivariateStudentTCopula.mq5 | Este script muestra cómo se utiliza la clase CStudent. |
| MQL5/script/SampleEllipticCopula.mq5 | Este script muestra cómo realizar un muestreo a partir de una cópula elíptica. |
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/18361
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.