

Redes neuronales en el trading: Modelos de refinamiento iterativo de previsiones (Componentes principales)
 36
 0

Introducción
El mercado financiero actual no es solo un conjunto de cotizaciones e índices. Se trata de un sistema complejo y dinámico en el que cada variación de precio es el reflejo de toda una red de causas, interacciones y expectativas. El flujo de datos que llega cada segundo se asemeja a un movimiento vivo, en el que cada instante tiene sentido. Percibir este movimiento significa aprender a interpretar el mercado como un proceso, y no como un resultado. Eso es precisamente lo que persigue el framework RAFT (Recurrent All-Pairs Field Transforms), cuya arquitectura se diseñó inicialmente para comprender la dinámica en secuencias de imágenes, pero que se adapta perfectamente a la naturaleza de las series temporales de los mercados.
El concepto fundamental del framework RAFT es la capacidad de pensar en términos de movimiento, continuidad y refinamiento.
En el trading clásico, el precio se considera como una serie de valores discretos: velas, barras y ticks. El analista observa una secuencia e intenta identificar una pauta. Sin embargo, el mercado real fluye como un río. No salta de un punto a otro, sino que fluye de un estado a otro, cambiando de dirección y de velocidad bajo la influencia de miles de factores diferentes. Y es aquí donde la filosofía de RAFT se manifiesta con especial claridad. El modelo interpreta los datos no como un conjunto de instantáneas, sino como un flujo. Cada nuevo estado está relacionado con el anterior a través de numerosas dependencias ocultas. En términos de visión artificial, se trata de la estimación del flujo óptico. Lo importante aquí no es lo que se ve en cada fotograma, sino cómo y hacia dónde se mueve todo de un fotograma a otro. Si hablamos de finanzas, no se trata simplemente de una predicción del próximo precio, sino de comprender la dirección y la fuerza del movimiento del mercado.
La idea del refinamiento constante de la predicción constituye la base de RAFT. El modelo no llega a una conclusión definitiva de inmediato, sino que vuelve sobre ella varias veces, cotejando cada vez la nueva información con los resultados ya obtenidos. Este carácter recurrente recuerda el trabajo de un analista experimentado, que va ajustando sus hipótesis a medida que recibe nuevos datos, sin perder de vista el contexto general. Gracias a ello, RAFT alcanza una gran estabilidad incluso en entornos de fuertes fluctuaciones del mercado, cuando los algoritmos tradicionales pierden la sincronización con el flujo de eventos. En el análisis financiero, esta cualidad es especialmente importante, ya que el mercado rara vez es predecible. Los impulsos se alternan con retrocesos, y las tendencias estables a veces se desmoronan en cuestión de minutos. La capacidad del modelo para revisar sus decisiones lo acerca más al pensamiento real: flexible, iterativo y capaz de autoadaptarse.
Si se analiza la estructura interna de RAFT desde un punto de vista metodológico, esta se basa en tres ideas interrelacionadas:
- extracción de características,
- establecimiento de relaciones entre ellas,
- refinamiento iterativo de estas relaciones.
Las características describen el estado del sistema. En nuestro caso, se trata de las características del mercado: volatilidad, impulso, equilibrio entre la oferta y la demanda y correlaciones entre activos. A continuación, se genera un campo de todas las interacciones posibles, una especie de mapa de relaciones de mercado, en el que cada punto refleja la influencia recíproca de los estados del sistema a lo largo del tiempo. Y, por último, el bloque recurrente va refinando este campo paso a paso, acercando el modelo a la representación más fiel del movimiento del mercado. De este modo, RAFT no se limita a buscar una respuesta, sino que «mantiene un diálogo» con los datos, refinando sus conclusiones en cada paso.
A primera vista, podría parecer que la visión artificial y los datos financieros no tienen nada que ver entre sí. Pero si sustituimos los fotogramas por ventanas temporales y los píxeles por características de los activos, resulta evidente lo cercanos que están estos dos mundos. Tanto en un caso como en el otro, nos enfrentamos a un flujo de información en el que cada cambio solo tiene sentido en el contexto de los anteriores. Cada nuevo «tick» no es un evento aislado, sino la continuación de la historia del mercado, integrada en el tejido general del movimiento. RAFT crea precisamente este contexto al construir un campo de desplazamientos, una especie de mapa del movimiento de la liquidez en el que se pueden observar las direcciones y la intensidad de los cambios. Esto abre nuevas posibilidades no solo en materia de predicción, sino también de interpretación. El investigador dispone de una herramienta para visualizar la dinámica del mercado que permite observar dónde se aceleran las tendencias, dónde se inician los cambios de tendencia y dónde las fuerzas del mercado alcanzan el equilibrio.
A diferencia de los sistemas de redes neuronales de elevado coste computacional, RAFT combina la eficiencia computacional con la profundidad conceptual. Su estructura es concisa y el proceso de refinamiento iterativo no requiere una gran cantidad de recursos. Esto resulta especialmente valioso para su implementación en el entorno MQL5, donde la eficiencia del código y la velocidad de procesamiento de datos son requisitos fundamentales. El modelo se puede adaptar a las condiciones reales del mercado sin que ello afecte a su precisión ni a su estabilidad. Es más, su naturaleza recurrente permite dar una respuesta en tiempo real al flujo de ticks, y no solo analizar muestras históricas.
Pero, quizás, la principal ventaja de RAFT sea su flexibilidad intelectual. No se limita a seguir un único patrón ni se basa en una fórmula aprendida una sola vez. Cada nuevo conjunto de datos supone para el modelo un motivo para revisar sus propias conclusiones. En esto se refleja su filosofía: no predecir el mercado como un objeto estático, sino adaptarse a su evolución y pensar en sintonía con él. En un entorno de cambio constante, esa capacidad es más valiosa que cualquier grado de precisión: al fin y al cabo, el mercado rara vez es correcto, pero siempre se mantiene vivo.
En nuestro trabajo nos centraremos en la arquitectura y la estructura del framework RAFT. Así, analizaremos los principios de su funcionamiento y prepararemos las bases para su implementación paso a paso mediante MQL5. El objetivo es sencillo y ambicioso: mostrar cómo este modelo, creado para analizar el movimiento en flujos de vídeo, puede convertirse en una potente herramienta para el análisis de la evolución de los datos financieros. Y es que, si aprendemos a ver una estructura en este flujo, podremos acercarnos a lo que siempre ha sido el sueño de cualquier operador: comprender hacia dónde se mueve el precio y por qué se mueve precisamente hacia allí.
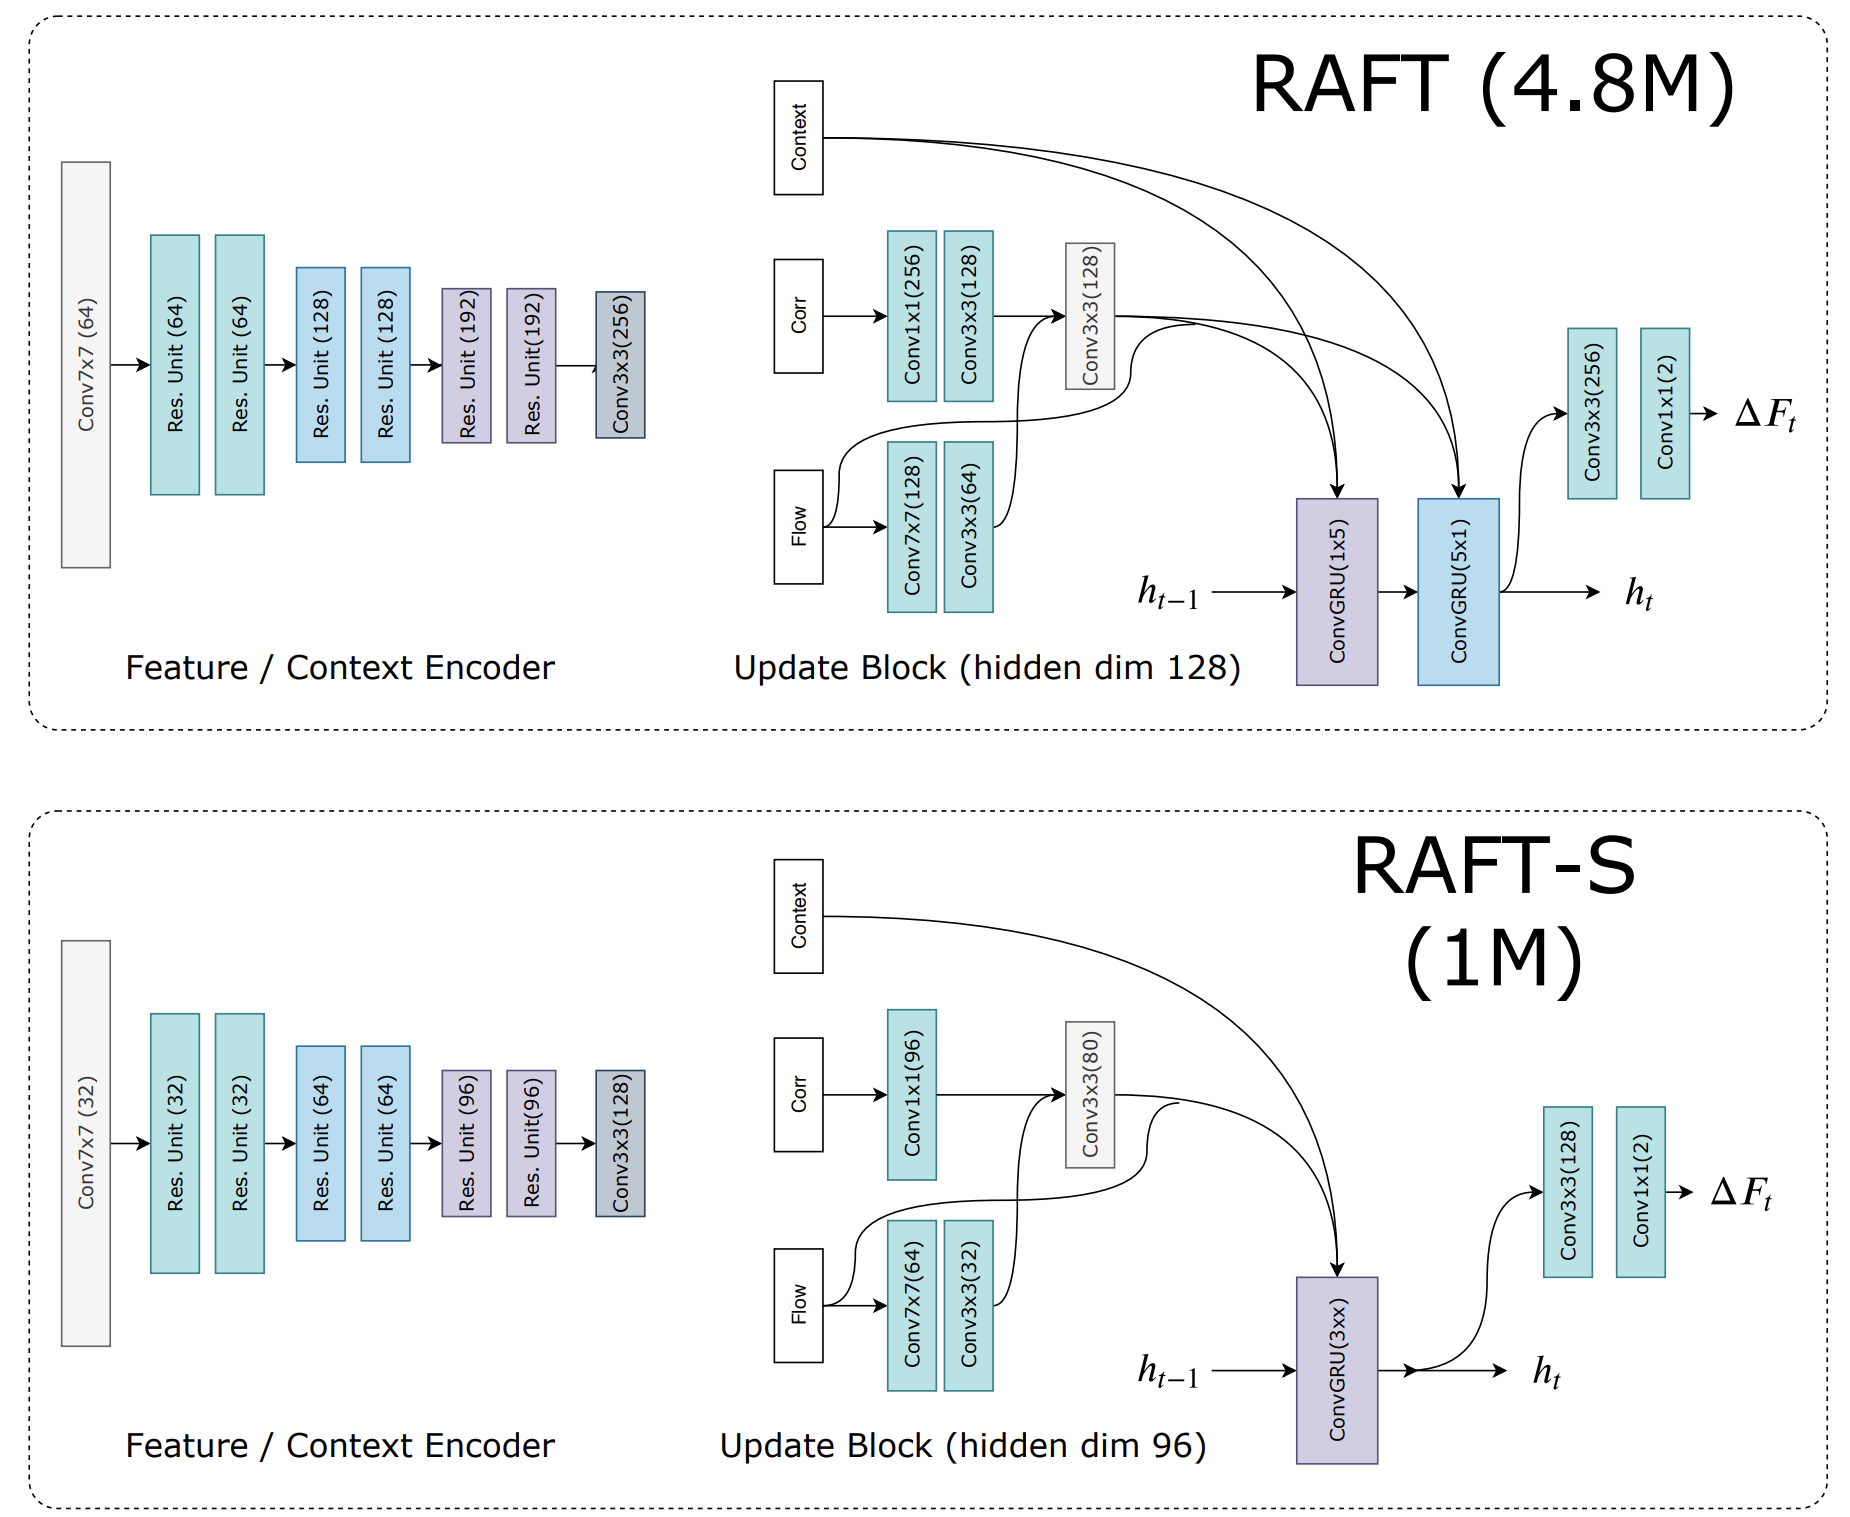
A continuación se muestra una visualización del framework RAFT elaborada por el autor.
Módulo de correlación multiescala
Para que el framework RAFT hable el lenguaje de los mercados, empezamos por elaborar un mapa de correlación de características. Como punto de partida, resulta lógico utilizar los trabajos ya realizados en el marco del proyecto STE-FlowNet. Al igual que antes, en lugar del estado inicial fijo propuesto por los autores del framework, utilizamos una pila de los últimos estados del sistema. Este enfoque permite al modelo ver no solo el valor actual del indicador, sino también el contexto de su evolución: la dinámica, la aceleración y la inercia. Es como si el operador no evaluara una sola vela, sino toda la historia de las fluctuaciones del precio, estableciendo una lógica causal de su comportamiento.
Sin embargo, el mapa de correlaciones clásico de RAFT se basa en un espacio de coordenadas en el que los desplazamientos de los objetos tienen dirección y escala. En los datos financieros no existe una cuadrícula de coordenadas. Los impulsos no se desplazan a través de las características, sino que se desarrollan a lo largo del tiempo. Por consiguiente, en nuestro caso, el escalado se traslada al eje temporal. Crearemos un análogo de la pirámide de correlaciones, pero en una escala temporal. Cada nivel refleja una determinada profundidad histórica, desde las fluctuaciones a corto plazo hasta las tendencias fundamentales. Esto permite a RAFT analizar el mercado en varias dimensiones temporales, captando tanto las microfluctuaciones como las estructuras de onda de larga duración, lo que da lugar a una percepción de los datos más estable y adaptativa.
Luego construiremos un mapa multiescala de características. En primer lugar, se crea para cada intervalo de tiempo, registrando los cambios rápidos y los lentos. Todos estos niveles se agrupan en un tensor global, que se introduce en la pila de estados. Esta jerarquía permite al modelo tener en cuenta simultáneamente tanto las reacciones inmediatas del mercado como sus cambios por inercia, algo que a menudo se pierde en los métodos clásicos.
En la parte práctica del artículo anterior, implementamos un kernel de OpenCL que realiza la agregación y el promediado de las características para todos los niveles de la pirámide temporal. Dicho paso permitió generar representaciones coherentes de los datos a diferentes escalas, sentando así unas bases sólidas para los cálculos posteriores. Hoy daremos un paso más y crearemos un objeto especializado de correlación multiescala de características en el programa principal. Este se convertirá en el núcleo de nuestra implementación del mecanismo RAFT en el contexto financiero, una especie de visión del sistema, capaz de reconocer las interrelaciones entre los estados del mercado con distintos niveles de profundidad histórica.
class CNeuronMultiScaleStackCorrelation :  public CNeuronStackCorrelation
  {
protected:
   uint                 iLevels;
   CNeuronBaseOCL       cScales;
   //---
   virtual bool      AggregationByTime(CNeuronBaseOCL *NeuronOCL);
   virtual bool      AggregationByTimeGrad(CNeuronBaseOCL *NeuronOCL);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronMultiScaleStackCorrelation(void) {};
                    ~CNeuronMultiScaleStackCorrelation(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint stack_size, uint dimension,
                          uint variables, uint levels,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   override const   {  return defNeuronMultiScaleStackCorrelation;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   //---
   virtual uint      GetLevels(void) const { return iLevels; }
   virtual uint      GetVariables(void) override const { return GetVariables() / iLevels; }
  };
El nuevo objeto hereda la funcionalidad básica de la clase CNeuronStackCorrelation y amplía el mecanismo de correlación de estados, añadiendo compatibilidad con el análisis multiescala —la capacidad de examinar los datos simultáneamente en varios niveles de profundidad temporal—. En el contexto de las series temporales financieras, esto equivale a observar la evolución del precio no solo a corto plazo, sino también en marcos temporales más amplios.
En la estructura presentada se añade la variable iLevels, que define el número de escalas de la pirámide temporal. En otras palabras, cuántos niveles de análisis usará el sistema. Cada nivel corresponde a una ventana temporal concreta.
El objeto cScales es una instancia de la clase base CNeuronBaseOCL y está destinado al almacenamiento temporal de la pirámide de características del estado analizado.
El método Init desempeña el papel de una especie de arquitecto: no se limita a preparar el objeto para su funcionamiento, sino que construye toda una infraestructura de percepción de datos a múltiples escalas. Precisamente aquí se produce la unión entre la lógica matemática y la arquitectura informática, lo que convierte la idea abstracta de la pirámide temporal en un mecanismo real y funcional.
bool CNeuronMultiScaleStackCorrelation::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                          uint stack_size, uint dimension, uint variables, uint levels,
                                          ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronStackCorrelation::Init(numOutputs, myIndex, open_cl, stack_size, dimension,
                                     variables * levels, optimization_type, batch))
      return false;
Desde el momento de la llamada al método, comienza la inicialización paso a paso de la estructura, que integra las diferentes escalas temporales del análisis en un único sistema. El método recibe como argumentos los principales parámetros de configuración: el número de salidas, el índice de la neurona actual, la referencia al objeto de control de OpenCL, la profundidad de la pila temporal, la dimensionalidad de los datos, el número de características, el número de escalas, el tipo de optimización y el tamaño del lote. Todos estos parámetros, en conjunto, determinan cómo percibirá exactamente la neurona el contexto temporal, hasta qué punto podrá «remontarse» al pasado y con qué nivel de detalle analizará el mercado.
El primer paso consiste en llamar al método homónimo de la clase padre. Esta llamada puede considerarse como la colocación de los cimientos. Esta conforma la estructura principal de la pila de correlación, asigna memoria y prepara los búferes de OpenCL. Pero aquí hay una diferencia fundamental: el número de características se multiplica por el número de niveles de la pirámide temporal. Este método crea un espacio de características unificado, en el que cada nivel recibe su propio conjunto de datos, que refleja el mercado con diferentes niveles de profundidad temporal. Si, por cualquier motivo, la inicialización básica falla, el método interrumpe inmediatamente su ejecución para evitar errores impredecibles.
Una vez completada con éxito la inicialización básica, se almacena en la variable iLevels el número de niveles de la pirámide temporal. Este valor se convierte en un punto de referencia interno para todos los cálculos posteriores y determina el número de escalas temporales que participarán en la construcción de la estructura de correlación.
   iLevels = levels;
   if(!cScales.Init(0, 0, OpenCL, dimension * levels * variables, optimization, iBatch))
      return false;
//---
   return true;
  }
El siguiente paso consiste en inicializar el objeto cScales, encargado de almacenar las características de las distintas escalas. En esencia, es aquí donde se forma el equivalente digital de una percepción multicapa: el sistema empieza a ver el mercado simultáneamente en varios horizontes temporales, desde las fluctuaciones a corto plazo hasta las tendencias a largo plazo.
Si la creación del contenedor cScales se realiza correctamente, el método finaliza la inicialización y devuelve true. Este breve pero importante paso final simboliza que el objeto está listo para funcionar. A partir de este momento, CNeuronMultiScaleStackCorrelation se convierte en un nodo plenamente funcional del grafo computacional, capaz de acumular, escalar e interpretar la dinámica de los datos financieros a lo largo del tiempo.
Todo lo que ocurre dentro de este método puede entenderse como el proceso de configuración de una herramienta analítica compleja, en la que cada parámetro tiene su propio significado y finalidad.
El algoritmo de propagación directa de la clase CNeuronMultiScaleStackCorrelation implementa la lógica clave del procesamiento de datos mediante correlaciones multiescala: es precisamente aquí donde se combinan la agregación temporal, el análisis multiescala y las transformaciones matriciales que conforman la respuesta final del bloque neuronal.
bool CNeuronMultiScaleStackCorrelation::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!AggregationByTime(NeuronOCL))
      return false;
El funcionamiento del método comienza con la llamada al método AggregationByTime, que actúa como envoltorio del núcleo de OpenCL del mismo nombre, implementado en la parte práctica del artículo anterior. En esta fase se agregan las características actuales junto con la información sobre los estados anteriores de la pila, organizando estos datos en una estructura lógicamente coherente a lo largo del eje temporal. Este paso permite detectar relaciones dinámicas estables y, al mismo tiempo, suavizar las fluctuaciones aleatorias características de las series temporales financieras.
El siguiente paso consiste en añadir la información obtenida a la pila de historial de estados.
   if(!cStack.FeedForward(cScales.AsObject()))
      return false;
Una vez calculados todos los componentes de las distintas escalas, el método pasa a multiplicar matricialmente la pila del historial acumulado por la representación detallada del estado analizado. Aquí se combinan las características de las distintas escalas en el vector de respuesta final.
   if(!MatMul(cStack.getOutput(), NeuronOCL.getOutput(), Output, GetStackSize() * GetLevels(),
              GetDimension(), 1, GetVariables(), true))
      return false;
Tenga en cuenta que los parámetros de la función definen claramente las dimensiones de las matrices. Luego se multiplica una matriz de dimensiones [(StackSize × Levels), Dimension] por un vector columna de dimensión [Dimension]. Al mismo tiempo, se calculan en paralelo Variables productos independientes, generando las matrices de correlación de cada secuencia unitaria para el horizonte dado y el número especificado de escalas. En esencia, esta etapa lleva a cabo una síntesis de la información, reuniendo todos los niveles de correlaciones y escalas en un único resultado generalizado, listo para su posterior procesamiento.
La etapa final consiste en aplicar la función de activación. Por supuesto, siempre que el usuario la haya configurado.
   if(activation != None)
      if(!Activation(Output, Output, activation))
         return false;
//---
   return true;
  }
El algoritmo del método está estructurado de forma lógica y transparente: de la agregación temporal se pasa al análisis multiescala y, a continuación, a la síntesis y a la respuesta no lineal. Esta arquitectura permite extraer de forma eficaz las dependencias ocultas de datos dinámicos y multidimensionales, al tiempo que se mantiene la estabilidad estructural y la interpretabilidad del resultado.
Como se habrá podido observar, este módulo no contiene parámetros entrenables, pero desempeña un papel importante como uno de los componentes de nuestro modelo neuronal. Y, como es sabido, el propio modelo requiere un proceso de entrenamiento. Para que nuestro módulo de correlación multiescala no se convierta en un obstáculo en el proceso de entrenamiento, es necesario garantizar que los gradientes de error se propaguen correctamente a todos los participantes del grafo computacional, de acuerdo con su contribución al resultado final. Este mecanismo se ha implementado en el método calcInputGradients.
bool CNeuronMultiScaleStackCorrelation::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
El método comienza comprobando que el puntero recibido al objeto de datos de origen sea correcto, lo que permite evitar llamadas incorrectas.
El cálculo principal de los gradientes comienza con la llamada a la función MatMulGrad, que realiza la retropropagación a través de la multiplicación matricial para propagar los gradientes de error desde las matrices de correlación de salida hacia los datos de origen y la pila de características multiescala.
   if(!MatMulGrad(cStack.getOutput(), cStack.getGradient(),
                  NeuronOCL.getOutput(), cScales.getGradient(),
                  Gradient, GetStackSize()*GetLevels(),
                  GetDimension(), 1, GetVariables(), true))
      return false;
Aquí se consideran todos los niveles de la pirámide temporal y cada característica, y el cálculo paralelo garantiza la eficiencia en el procesamiento de grandes series temporales.
A continuación, se invoca AggregationByTimeGrad, que realiza la retropropagación de gradientes a través de la agregación temporal. Este paso garantiza que la contribución de cada estado temporal se tenga en cuenta correctamente al ajustar los parámetros del modelo.
   if(!AggregationByTimeGrad(NeuronOCL))
      return false;
En este sentido, es importante señalar que los parámetros del estado analizado intervienen simultáneamente en dos procesos: en la multiplicación matricial, para calcular las correlaciones, y en la agregación de características multiescala. Por ello, resulta necesario combinar con precisión los gradientes obtenidos de estos dos flujos de información. La función SumAndNormilize cumple precisamente esta tarea. Esta suma los valores, garantizando el equilibrio y la coherencia de los gradientes. Gracias a ello, el modelo actualiza correctamente sus componentes entrenables, evitando que se sobrevalore la influencia de unos niveles frente a otros.
   if(!SumAndNormilize(NeuronOCL.getGradient(), cScales.getGradient(), NeuronOCL.getGradient(),
                                                           GetDimension(), false, 0, 0, 0, 1))
      return false;
   Deactivation(NeuronOCL)
//---
   return true;
  }
El proceso concluye con la llamada a Deactivation, que ajusta los gradientes mediante la derivada de la función de activación, dándoles una forma adecuada para su posterior propagación.
En definitiva, el método calcInputGradients convierte el módulo de correlación multiescala de un bloque pasivo en un participante activo en el proceso de entrenamiento, distribuyendo con precisión el error entre todos los componentes relacionados y garantizando un entrenamiento estable y correcto de todo el modelo neuronal.
El bloque 2D-GRU
Una vez creado el módulo de correlación multiescala, lo lógico es centrar nuestra atención en el siguiente eslabón fundamental: las GRU convolucionales. Los autores del framework RAFT proponen no una, sino dos unidades GRU convolucionales consecutivas. Además, cada una de ellas opera en su propia dimensión del plano de coordenadas. En términos de la tarea visual, esto significa que el primer grupo de convoluciones puede tener en cuenta las dependencias horizontales, el segundo —las verticales—, y su acción secuencial ofrece una visión más profunda de los desplazamientos locales y globales. En el contexto financiero, esta misma idea se aplica a diferentes ejes. Una rama GRU puede modelar la dinámica temporal dentro de un conjunto de características, mientras que la segunda puede registrar las interacciones entre conjuntos de características. El requisito clave en este caso no es simplemente la conexión en serie de dos módulos ya existentes, sino la organización de un flujo de datos único, en el que los estados ocultos y los datos de origen se utilicen de forma conjunta y sincrónica.
Si intentamos encadenar dos implementaciones estándar, nos encontraremos con una limitación. Cada una de ellas funcionará en su propio espacio de estados y no podrá compartir de forma eficaz el estado oculto con la rama adyacente, ni acceder simultáneamente a los mismos datos de correlación de origen. Necesitamos un módulo que implemente internamente dos etapas de una GRU convolucional, pero que se considere en la arquitectura como un único nodo, con interfaces comunes, una gestión de memoria unificada y un protocolo predecible para la transmisión de estados ocultos. Este módulo debe recibir como entrada mapas de correlación agregados y características, disponer de búferes internos para los estados ocultos de las dos etapas y ser capaz de garantizar el acceso paralelo de ambas etapas a los tensores de entrada sin copias redundantes.
La idea del procesamiento bidimensional de datos propuesta por los autores del framework RAFT la implementaremos en la clase CNeuronSpikeConvGRU2D, una versión ampliada de una GRU convolucional, adaptada específicamente para el análisis de señales en dos direcciones. Este módulo hereda la funcionalidad básica de CNeuronSpikeConvGRU, pero la complementa con un segundo nivel de cálculo. Esto permite tener en cuenta al mismo tiempo las dependencias temporales y las interrelaciones entre las características. Dicha estructura permite una interpretación más profunda de los datos, en la que cada paso del modelo se basa no solo en el estado anterior, sino también en el contexto espacial, lo que aumenta la precisión del refinamiento iterativo de la predicción.
class CNeuronSpikeConvGRU2D  :  public CNeuronSpikeConvGRU
  {
protected:
   CNeuronConvOCL       cProjectionX;
   CNeuronBaseOCL       cConcatenated2[2];
   CNeuronConvOCL       cZR2;
   CNeuronBaseOCL       cZ2;
   CNeuronBaseOCL       cR2;
   CNeuronConvOCL       cHt2;
   CNeuronBaseOCL       cH2;
   CNeuronTransposeOCL  cTranspose[3];
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSpikeConvGRU2D(void) {};
                    ~CNeuronSpikeConvGRU2D(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint chanels_in, uint chanels_out,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   override const   {  return defNeuronSpikeConvGRU2D;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   //---
   virtual uint      GetChanels(void) const { return cHt.GetFilters(); }
   virtual uint      GetUnits(void) const { return cHt.GetUnits(); }
  };
En la sección protegida de la clase se encuentran los principales nodos de cálculo. El componente cProjectionX proyecta las características de entrada en un espacio alternativo, creando una representación independiente para la segunda iteración de la GRU y ajustando la dimensión de las características de los datos originales a la dimensión del estado oculto que se está analizando. En esencia, ofrece una perspectiva adicional sobre los datos, lo que permite establecer una sensibilidad cruzada entre las relaciones temporales y las correlacionales. Esto resulta especialmente importante en el análisis financiero, donde el comportamiento de un activo puede influir en todo un grupo de instrumentos relacionados.
A continuación vienen dos búferes cConcatenated2[2], que sirven para combinar las salidas de la primera etapa con los datos originales. Dicha técnica crea un contexto enriquecido, en el que se reúnen en un mismo tensor tanto las características nuevas como las originales. Gracias a ello, la segunda celda GRU obtiene una visión completa del estado del sistema, tanto del cambio actual como de su causa original. Esto se asemeja al proceso de revisión de una predicción: primero, el modelo formula una hipótesis preliminar y, a continuación, teniendo en cuenta el contexto y los datos más precisos, corrige su decisión.
Los bloques cZR2, cZ2, cR2, cHt2 y cH2 conforman la estructura interna de la segunda etapa de la GRU. En conjunto, crean un mecanismo cerrado de doble actualización, en el que la información se va refinando de forma gradual, pero continua.
Los tres objetos cTranspose[3] permiten la reorientación de los datos entre las distintas etapas. Desde el punto de vista financiero, esto permite alternar entre la dimensión temporal y la dimensión de los factores: considerar las mismas características como una dinámica a lo largo del tiempo o como interrelaciones entre activos. Esto aporta al modelo una percepción multidimensional del mercado, lo que hace que el análisis no sea lineal, sino espacial.
El proceso de inicialización de los componentes internos del módulo es una fase minuciosamente planificada, en la que cada elemento ocupa su lugar y desempeña su función dentro del esquema general. Todo comienza con la llamada al método homónimo de la clase padre, que prepara la base de la arquitectura, heredando las propiedades clave de la GRU convolucional clásica.
bool CNeuronSpikeConvGRU2D::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                 uint units, uint chanels_in, uint chanels_out,
                                 ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronSpikeConvGRU::Init(numOutputs, myIndex, open_cl, units, chanels_in,
                                           chanels_out, optimization_type, batch))
      return false;
Este paso no es una mera formalidad: garantiza la configuración correcta del entorno de cálculo de OpenCL, vincula el objeto con el contexto de procesamiento y crea las estructuras de datos básicas sobre las que se construye toda la lógica posterior.
Tras la inicialización correcta del nivel básico, se activa el bloque cProjectionX, que actúa como transformador de proyección. Su objetivo es adaptar los tensores de entrada a las dimensiones internas del modelo, es decir, uniformizar el número de canales y el tamaño de los filtros. En esencia, esta capa actúa como un puente de entrada que suaviza las diferencias entre las escalas de los datos y los prepara para su procesamiento profundo. La función de activación se ha desactivado deliberadamente en este caso, ya que en esta fase es necesario conservar la estructura original de las características sin distorsiones adicionales.
   uint index = 0;
   if(!cProjectionX.Init(0, index, OpenCL, chanels_in, chanels_in, chanels_out, units, optimization, iBatch))
      return false;
   cProjectionX.SetActivationFunction(None);
A continuación, se inicializan dos objetos cConcatenated2, cada uno de los cuales se encarga de combinar datos procedentes de diferentes fuentes. La ausencia de activación tampoco es casual en este caso: la combinación debe ser lineal para no alterar el equilibrio de las señales entre las ramas del modelo.
   index++;
   for(uint i = 0; i < cConcatenated2.Size(); i++)
     {
      if(!cConcatenated2[i].Init(0, index, OpenCL, 2 * units * chanels_in, optimization, iBatch))
         return false;
      cConcatenated[i].SetActivationFunction(None);
      index++;
     }
El siguiente paso consiste en crear los bloques de transposición cTranspose. Hay tres, y cada uno de ellos desempeña una función estrictamente definida: el primero proyecta los datos del estado oculto del paso anterior; el segundo realiza una proyección similar de los datos de partida; y el tercero restaura la estructura original al transferir el nuevo estado oculto al siguiente nivel. Estas operaciones pueden compararse con dar la vuelta al tablero de ajedrez: la orientación de los datos cambia, pero sus relaciones lógicas se mantienen. Esta técnica permite trabajar con la información simultáneamente en dos dimensiones, lo que constituye una característica clave del enfoque RAFT.
   if(!cTranspose[0].Init(0, index, OpenCL, units, chanels_out, optimization, iBatch))
      return false;
   index++;
   if(!cTranspose[1].Init(0, index, OpenCL, units, chanels_out, optimization, iBatch))
      return false;
   index++;
   if(!cTranspose[2].Init(0, index, OpenCL, chanels_out, units, optimization, iBatch))
      return false;
A continuación, comienza la construcción del segundo nivel de la GRU, representado por los objetos cZR2, cZ2, cR2 y cHt2. El componente cZR2 genera el vector de puertas de control —de actualización y de reinicio—, que regulan qué parte de la información anterior debe conservarse y qué parte debe sustituirse por datos nuevos. Su activación sigmoidea hace que el proceso de toma de decisiones del modelo sea suave y diferenciable, lo cual es especialmente importante para un entrenamiento correcto.
   index++;
   if(!cZR2.Init(0, index, OpenCL, 2 * units, 2 * units, 2 * units, chanels_out, 1, optimization, iBatch))
      return false;
   cZR2.SetActivationFunction(SIGMOID);
Los bloques cZ2 y cR2 separan las señales de control y las preparan para la siguiente etapa: el cálculo de los candidatos al nuevo estado en cHt2. Aquí se utiliza la función de activación TANH, que establece un rango equilibrado de valores y garantiza la estabilidad durante el entrenamiento, incluso en series temporales largas.
   index++;
   if(!cZ2.Init(0, index, OpenCL, cZR2.Neurons() / 2, optimization, iBatch))
      return false;
   cZ2.SetActivationFunction((ENUM_ACTIVATION)cZR2.Activation());
   index++;
   if(!cR2.Init(0, index, OpenCL, cZR2.Neurons() / 2, optimization, iBatch))
      return false;
   cR2.SetActivationFunction((ENUM_ACTIVATION)cZR2.Activation());
   index++;
   if(!cHt2.Init(0, index, OpenCL, 2 * units, 2 * units, units, chanels_out, 1, optimization, iBatch))
      return false;
   cHt2.SetActivationFunction(TANH);
Toda esta cadena recuerda a un cronómetro de precisión, en el que cada engranaje se encarga de una parte del movimiento, pero todos juntos crean un ritmo armonioso.
El elemento final de la inicialización es cH2, que acumula los resultados del procesamiento de datos. Este bloque integra todos los cálculos intermedios en un conjunto coherente, creando una representación global del estado actual del sistema. En esta fase, el modelo está listo para recibir el flujo de datos y realizar un análisis multidimensional, identificando relaciones que no son accesibles para las arquitecturas unidimensionales clásicas.
   index++;
   if(!cH2.Init(0, index, OpenCL, units * chanels_out, optimization, iBatch))
      return false;
//---
   return true;
  }
De esta forma, el método Init construye todo un ecosistema computacional en el que cada componente conoce exactamente cuál es su lugar e interactúa con los demás siguiendo el principio de un intercambio coordinado de información.
El algoritmo de propagación directa, implementado en el método feedForward, consiste en una secuencia de cálculos minuciosamente estructurada, en la que la lógica recurrente bidimensional se combina con los principios del procesamiento convolucional de datos. Cada paso aquí no supone solo una operación, sino un eslabón de una cadena de transformaciones destinadas a extraer y sintetizar las interrelaciones profundas entre los componentes espaciales y temporales del flujo de entrada.
bool CNeuronSpikeConvGRU2D::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cProjectionX.FeedForward(NeuronOCL))
      return false;
   if(!cTranspose[0].FeedForward(cH.AsObject()))
      return false;
   if(!cTranspose[1].FeedForward(cProjectionX.AsObject()))
      return false;
El funcionamiento del algoritmo comienza con una transformación de proyección de los datos de partida mediante el bloque cProjectionX. Este elemento actúa como adaptador entre las características originales y las representaciones internas del modelo, convirtiendo los datos a un formato adecuado para el análisis bidimensional. A continuación entran en juego las capas de transposición —cTranspose[0] y cTranspose[1]—, que reordenan los tensores a lo largo de los ejes de coordenadas. Esto permite combinar las dimensiones espaciales y temporales, sentando las bases para la interacción cruzada de los datos en ambas direcciones.
Una vez preparados los datos, se calculan los parámetros clave: el número de pasos temporales (units), el número de canales ocultos (hidden) y el tamaño de la ventana de entrada (inputs). Estos parámetros definen la configuración arquitectónica de la iteración actual de la propagación directa y garantizan la coherencia de todas las operaciones posteriores.
   uint units = cHt.GetUnits();
   uint hidden = cHt.GetFilters();
   uint inputs = cHt.GetWindow() - hidden;
Luego se lleva a cabo la primera etapa de la combinación de flujos de datos: la operación Concat, que establece un contexto común para el cálculo de las puertas de control del segundo bloque GRU. Aquí se unen las salidas de las capas de transposición.
   if(!Concat(cTranspose[0].getOutput(), cTranspose[1].getOutput(),
              cConcatenated2[0].getOutput(), units, units, hidden))
      return false;
El tensor obtenido se transmite al bloque cZR2, que se encarga de generar los vectores de actualización y de reinicio. Estas señales de control son una especie de palancas neuronales que regulan qué parte de la información anterior se conserva y qué parte se sustituye por la nueva.
   if(!cZR2.FeedForward(cConcatenated2[0].AsObject()))
      return false;
   if(!DeConcat(cZ2.getOutput(), cR2.getOutput(), cZR2.getOutput(), units, units, hidden))
      return false;
A continuación, los datos se dividen en dos flujos: cZ2 y cR2, cada uno de los cuales desempeña su propia función en el mecanismo de memorización adaptativa. El flujo de reinicio (cR2) interactúa con la salida de la primera capa de transposición, ajustando el grado de influencia del estado anterior.
   if(!ElementMult(cR2.getOutput(), cTranspose[0].getOutput(), cR2.getPrevOutput()))
      return false;
   if(!Concat(cR2.getPrevOutput(), cTranspose[1].getOutput(), cConcatenated2[1].getOutput(), units, units, hidden))
      return false;
   if(!cHt2.FeedForward(cConcatenated2[1].AsObject()))
      return false;
Los resultados se vuelven a combinar mediante una segunda operación Concat, lo que sienta las bases para calcular un nuevo estado candidato en el bloque cHt2. En esta etapa tiene lugar una transformación no lineal con activación TANH, que genera una representación actualizada de las características.
Después se realiza la operación GateElementMult, en la que el estado candidato cHt2 se combina con el estado anterior bajo el control de la puerta de actualización cZ2. Esto permite al sistema ajustar dinámicamente el equilibrio entre la memoria y la actualización, creando una representación interna estable pero flexible.
   if(!GateElementMult(cHt2.getOutput(), cTranspose[0].getOutput(), cZ2.getOutput(), cH2.getOutput()))
      return false;
   if(!cTranspose[2].FeedForward(cH2.AsObject()))
      return false;
El resultado obtenido se transforma de nuevo mediante cTranspose[2], volviendo a la dimensión original, donde tiene lugar la segunda etapa del procesamiento GRU, esta vez en la dirección clásica, de forma análoga a una GRU convolucional estándar.
   if(!Concat(NeuronOCL.getOutput(), cTranspose[2].getOutput(), cConcatenated[0].getOutput(), inputs, hidden, units))
      return false;
   if(!cZR.FeedForward(cConcatenated[0].AsObject()))
      return false;
   if(!DeConcat(cZ.getOutput(), cR.getOutput(), cZR.getOutput(), hidden, hidden, units))
      return false;
   if(!ElementMult(cR.getOutput(), cTranspose[2].getOutput(), cR.getPrevOutput()))
      return false;
   if(!Concat(NeuronOCL.getOutput(), cR.getPrevOutput(), cConcatenated[1].getOutput(), inputs, hidden, units))
      return false;
   if(!cHt.FeedForward(cConcatenated[1].AsObject()))
      return false;
   if(!GateElementMult(cHt.getOutput(), cTranspose[2].getOutput(), cZ.getOutput(), cH.getOutput()))
      return false;
A continuación, la salida pasa por el bloque normalizador cNorm, donde los valores se estabilizan, eliminando las desviaciones acumuladas, y se envía a la etapa final: la activación CNeuronSpikeActivation, que confiere a la salida del modelo una respuesta no lineal, correspondiente a la dinámica de las neuronas de impulsos.
Como resultado, todo el algoritmo de propagación directa genera un flujo coordinado de cálculos, en el que los distintos niveles se complementan entre sí, lo que permite al modelo detectar dependencias multidimensionales en los datos. No se trata simplemente de una secuencia de operaciones, sino de una especie de diálogo entre el espacio y el tiempo, en el que las señales intercambian información, se refinan y se refuerzan mutuamente. Precisamente esta armonía arquitectónica convierte al módulo CNeuronSpikeConvGRU2D en un elemento clave en la implementación de RAFT, ya que proporciona una percepción profunda de la estructura de los datos y una gran adaptabilidad a la hora de analizar procesos dinámicos complejos —desde flujos de imágenes hasta series temporales financieras—.
Hoy hemos realizado un trabajo intenso y productivo: hemos desarrollado los componentes principales del framework RAFT, sentando así las bases de su arquitectura computacional. Es el momento ideal para hacer una pequeña pausa y dejar que las ideas se asienten. Ahora nos espera la etapa final: la integración de todos los módulos creados en una estructura única y coordinada. A eso es precisamente a lo que dedicaremos el próximo artículo.
Conclusión
En este artículo hemos ido avanzando paso a paso hacia la aplicación práctica de las ideas clave del framework RAFT, adaptándolas a las particularidades del análisis financiero. Hemos creado un módulo de correlación multiescala de características y hemos implementado un bloque GRU convolucional bidimensional que permite tener en cuenta tanto las dependencias temporales como las estructurales de los datos. Estos componentes constituyeron una continuación lógica de los desarrollos anteriores y allanaron el camino para la construcción de un modelo iterativo completo de predicción de la dinámica del mercado. En el próximo artículo, integraremos todos los elementos creados en un único sistema, lo pondremos a prueba y evaluaremos la eficacia de los enfoques aplicados utilizando datos históricos reales.
Enlaces
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Study.mq5 | Asesor experto | Asesor de entrenamiento offline de modelos |
| 2 | StudyOnline.mq5 | Asesor experto | Asesor de entrenamiento en línea para modelos |
| 3 | Test.mq5 | Asesor experto | Asesor experto para probar el modelo |
| 4 | Trajectory.mqh | Biblioteca de clases | Estructura para describir el estado del sistema y la arquitectura de los modelos |
| 5 | NeuroNet.mqh | Biblioteca de clases | Biblioteca de clases para crear una red neuronal |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código del programa OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/20120
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.



