

Marktsimulation (Teil 21): Erste Schritte mit SQL (IV)
 21
 1

Einleitung
Hallo und herzlich willkommen zu einem weiteren Artikel aus der Reihe über das Replikations-/Simulationssystem.
Im vorherigen Artikel „Marktsimulation (Teil 20): Erste Schritte mit SQL (III)“ haben wir kurz über den SELECT-Befehl gesprochen. Wir müssen uns noch ein weiteres Konzept ansehen, um SQL effektiver nutzen zu können – oder, genauer gesagt, damit wir alle Möglichkeiten von SQL ausschöpfen können. Das ist eine viel bessere Alternative zum Schreiben einer Anwendung, die dieselbe Aufgabe erfüllen würde – nämlich Datenbanken zu verwalten und Änderungen an ihnen vorzunehmen. Dieses weitere Konzept spielt bei Datenbanken eine entscheidende Rolle. Wir sprechen hier von Schlüsseln, bei denen es sich entweder um Primärschlüssel oder um Fremdschlüssel handeln kann.
Zwar können wir mit MetaEditor Aufgaben im Zusammenhang mit SQLite erledigen, doch wenn Sie gerade erst anfangen und den Umgang mit SQL systematischer erlernen möchten, benötigen Sie ein leistungsfähigeres Tool. Ein wichtiger Punkt: Ich will damit nicht sagen, dass der MetaEditor nicht funktional wäre. Allerdings eignet sich der MetaEditor nicht dazu, bestimmte Aspekte zu verstehen, da er einem anderen Zweck dient: dem Bearbeiten und Kompilieren von MQL5-Code. Die erhebliche Unterstützung, die der MetaEditor uns bei der Nutzung von SQLite bietet, reicht nicht aus für das, was wir beim Lernen wirklich benötigen.
Daher möchte ich mir in diesem Fall erlauben, ein anderes Tool vorzuschlagen. Das liegt daran, dass es tatsächlich auf die Arbeit mit SQLite ausgerichtet ist. Auch wenn wir MySQL oder eine andere Plattform für die Arbeit mit SQL verwenden, erhalten wir in der Praxis dasselbe Ergebnis. Wie wir bereits in früheren Artikeln deutlich gemacht haben, spielt es keine Rolle, welches System wir für den Zugriff auf SQL verwenden. Mit allen Systemen lässt sich im Grunde dasselbe erreichen, vorausgesetzt natürlich, dass wir ausschließlich SQL-Syntax verwenden, ohne auf Elemente zurückzugreifen, die nur in dieser speziellen SQL-Variante existieren.
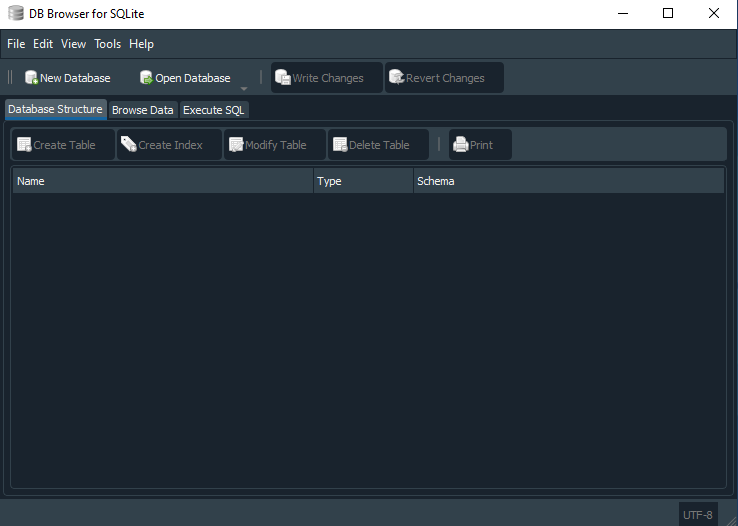
Ich schlage daher vor, dass Sie das Tool DB Browser verwenden. Es handelt sich um Open-Source-Software, die in C++ entwickelt wurde und auf GitHub kostenlos heruntergeladen werden kann. Am Ende dieses Artikels finden Sie einen Link zum Herunterladen des Tools von GitHub. Ein Vorteil von DB Browser besteht darin, dass er das Verständnis verschiedener Konzepte erheblich erleichtert, da Übersetzungen in andere Sprachen verfügbar sind, was für viele Menschen ohne Englischkenntnisse sehr hilfreich sein wird.
Ein weiterer Unterschied besteht darin, dass man im DB Browser – im Gegensatz zum MetaEditor, in dem man SQL-Skripte nicht bearbeiten, speichern und verwenden kann – genau dies tun kann. Solche Dinge sind zu Beginn des Lernprozesses sehr hilfreich. Für diejenigen jedoch, die sich bereits mit SQL auskennen und es ausschließlich für Datenbankabfragen nutzen, macht es keinen Unterschied, welches Tool sie verwenden. Die Wahl des Tools liegt also ganz in Ihrem Ermessen.
Die folgende Abbildung zeigt die Benutzeroberfläche von DB Browser. Natürlich haben wir in dieser Abbildung einige Optionen entfernt, da sie für das, was wir behandeln werden, nicht benötigt werden.
Bevor wir uns jedoch mit dem Thema Primärschlüssel und Fremdschlüssel befassen, möchte ich etwas erläutern, das möglicherweise Fragen aufwirft, insbesondere wenn wir unsere Kenntnisse in SQL vertiefen möchten.
Warum hat sich die Strategie geändert?
Es kann sein, dass Sie sich ein wenig unwohl fühlen und sogar enttäuscht sind, wenn Sie versuchen, mit SQL in einer bestimmten SQL-Implementierung zu arbeiten. Manche Administratoren verlangen, wenn sie einen Datenbankspezialisten einstellen, oft, dass dieser mit einer bestimmten SQL-Implementierung arbeiten kann. Ein Beispiel: Man lernt vielleicht SQL Server, bekommt aber keine Stelle, weil stattdessen MySQL verwendet wird. Oder vielleicht hören Sie Meinungen darüber, dass Oracle besser sei als andere SQL-Implementierungen. In früheren Artikeln haben wir gezeigt, dass Menschen, die so denken, eigentlich nichts von Datenbanken verstehen. Sie stellen sich einfach vor, dass die eine besser oder schlechter ist als die andere. Sie haben kein richtiges Verständnis davon, wie alles im Detail wirklich funktioniert, bleiben auf ihrem Standpunkt stehen und versuchen, etwas zu beurteilen, das sie eigentlich nicht verstehen.
Wenn wir eine Datenbank oder eine Implementierung nutzen, die einen Server verwendet, dann haben wir eine Möglichkeit, auf die Datenbank zuzugreifen. Am häufigsten geschieht dies über Sockets. Bevor wir über SQL gesprochen haben, haben wir in mehreren Artikeln erläutert, wie man mit Sockets arbeitet. Dabei ging es nicht nur darum, die Funktionsweise von Sockets zu erläutern, sondern auch zu zeigen, wie man eine bidirektionale Kommunikation zwischen Excel und MetaTrader 5 einrichtet. Mit anderen Worten: Sowohl Excel als auch MetaTrader 5 können Daten miteinander austauschen. Wir werden uns bei der Datenübertragung nicht auf RTD oder DDE beschränken, da in diesem Fall die Daten nur von Excel empfangen würden. Wenn wir jedoch wissen, wie man Sockets einsetzt, können wir noch viel mehr erreichen.
Das dort vermittelte Wissen lässt sich nutzen, damit MQL5 oder eine in MetaTrader 5 ausgeführte ausführbare Datei SQL verwenden und auf eine Datenbank zugreifen kann. Sie müssen lediglich wissen, wie man mit SQL-Befehlen arbeitet und wie man Informationen über einen Socket sendet und empfängt. Von da an ist der Rest ganz einfach, da Server-Datenbanken in Bezug auf den Informationsfluss wesentlich praktischer sind. Um dies zu verdeutlichen, möchten wir Folgendes erläutern: Eine auf einem SQL-Server gehostete Datenbank ist wesentlich leichter zu skalieren als eine in einer Datei gespeicherte Datenbank.
Bei der Verwendung von SQLite gehen wir jedoch zunächst davon aus, dass die Datenbank in einer Datei gespeichert wird. Das bedeutet jedoch nicht, dass wir ausschließlich darauf beschränkt sind. Ja, es ist möglich, einen SQLite-Server zu verwenden, aber normalerweise nutzen wir bei SQLite Dateien. Das bringt für uns einige Einschränkungen und Unannehmlichkeiten mit sich. Einige dieser Einschränkungen sind akzeptabel, da die Datenbank oft nur von einer bestimmten Anwendung genutzt wird. In anderen Fällen werden uns diese Einschränkungen dazu zwingen, unsere Strategie zu ändern und einen SQL-Server zu verwenden.
Da dieser Artikel jedoch didaktischen Zwecken dient und Ihnen vor allem Folgendes zeigen soll: Wir müssen bestimmte Dinge nicht selbst programmieren und sollten, wann immer möglich, auf vorhandene Tools zurückgreifen. Solche Einschränkungen, die auftreten, wenn die Datenbank in einer Datei gespeichert ist, stellen eigentlich kein Problem dar. Aber bedenken Sie: Ein SQL-Server ist einer Implementierung, bei der die Datenbank in einer Datei gespeichert wird, in einer Reihe von Punkten stets überlegen.
Nachdem wir diesen Punkt nun erläutert haben, können wir uns für eine Weile von MySQL lösen. Auch wenn es mir wirklich gut gefällt, müssen wir uns zunächst auf das konzentrieren, was wirklich notwendig ist. Vielleicht werden wir in Zukunft in einem anderen Artikel erläutern, wie Sockets zur Programmierung einer Datenbank genutzt werden können. Aber lassen Sie uns zunächst etwas anderes betrachten, und um die Themen nicht miteinander zu vermischen, werden wir ein neues Thema aufgreifen.
Warum gibt es Primär- und Fremdschlüssel?
Um etwas zu erklären, das ziemlich schwer zu verstehen ist (zumindest für diejenigen, die sich mit Datenbanken nicht auskennen), muss zunächst ein Punkt erläutert werden, der auch für diejenigen, die mit Programmierung überhaupt nicht vertraut sind, ziemlich schwierig ist. Mit anderen Worten: Das eine hängt mit dem anderen zusammen. Aber schauen wir einmal, ob ich Ihnen erklären kann, warum es Primär- und Fremdschlüssel gibt. Wenn Sie jedoch keinerlei Programmierkenntnisse haben, empfehle ich Ihnen, zumindest die Grundlagen einer Programmiersprache zu erlernen, um einige Konzepte zu verstehen, die wir in dieser Erklärung verwenden werden.
Der Grund für die Existenz von Primär- und Fremdschlüsseln, die ich stets gemeinsam verwende, ist derselbe wie der Grund, warum sich relationale Datenbanken von nicht-relationalen unterscheiden. Jetzt ist alles komplizierter geworden, weil viele Menschen glauben, es gäbe nur eine Art von Datenbank. Das heißt, wenn die meisten Menschen das Wort „Datenbank“ hören, denken sie sofort an eine Beziehung zwischen einem Schlüssel und einem Wert. Das stimmt jedoch nicht ganz. Das Problem liegt in der falschen Verwendung bestimmter Begriffe. Das Konzept „Schlüssel-Wert“ sagt in keiner Weise etwas darüber aus, ob eine Datenbank relational ist oder nicht. Tatsächlich geht das Konzept „Schlüssel-Wert“ über bestimmte Vorstellungen hinaus. Um das zu verstehen, lassen wir Datenbanken einmal beiseite und überlegen wir, wie alles war, bevor der Begriff „Datenbank“ aufkam.
Die einfachste Möglichkeit, das „Schlüssel-Wert“-Konzept anzuwenden, ist die Verwendung eines Arrays. Wenn Sie wissen, was ein Array ist, dann wissen Sie auch, dass jeder Index bzw. jede Position im Array einen Wert oder einen Datensatz enthalten kann. Gut. Anhand des Index, der dem Schlüssel entspräche, können Sie dann den Datensatz an dieser Position abrufen, der dem Wert entspräche. Mit diesem Wissen können Sie diese Daten ändern, löschen oder ganz nach Belieben bearbeiten. Das ist die grundlegendste Ebene dieses Konzepts.
Wenn Sie dasselbe Array, das sich im Arbeitsspeicher befindet, in eine Datei schreiben, können Sie ein Format festlegen, mit dem sich das ursprüngliche Array beim Zurücklesen der Datei in den Arbeitsspeicher problemlos wiederherstellen lässt. Und noch einmal: Das ist die grundlegendste Ebene dieses Konzepts. An dieser Stelle denken Sie vielleicht Folgendes: „Nun, als Programmierer kann ich eine ganze Reihe von Prozeduren und Unterprogrammen erstellen, um beliebige Datensätze im Array zu ändern, zu suchen, zu organisieren, zu löschen und so weiter.“ Bitte beachten Sie, dass Sie in diesem Moment, ohne es zu merken, gerade eine Datenbank erstellt haben. Das liegt daran, dass Sie genau dieselben Dinge einer Datenbank verwenden.
Um dann auf einen beliebigen Datensatz oder Wert in der nun entstandenen Datenbank zuzugreifen, laden Sie die Datei in ein Array im Arbeitsspeicher, führen die erforderlichen Prozeduren aus und speichern das Array unmittelbar danach wieder zurück in die Datei. Solche Dinge werden häufig vermittelt und eingeübt, wenn wir anfangen, das Programmieren zu lernen. Soweit ich weiß, behandelt jedoch niemand so etwas als Datenbank. Warum? Tja, wer weiß. Aber in Wahrheit haben Sie eine persönliche und private Datenbank angelegt, ohne es überhaupt zu merken.
Eine solche Lösung ist jedoch oft nicht skalierbar. Das heißt, Informationen lassen sich nicht ohne Weiteres zwischen verschiedenen Anwendungen übertragen. Und genau an dieser Stelle ergibt das Konzept einer Datenbank Sinn, denn man kann etwas verwenden, das auch andere nutzen – in diesem Fall SQL – und eine Datenbank erstellen, die von verschiedenen Anwendungen genutzt werden kann. Deshalb haben wir von Anfang an gesagt, dass man zwar etwas Neues schaffen kann, es aber manchmal besser ist, das zu nutzen, was bereits vorhanden ist.
All diese Erläuterungen beantworten jedoch noch immer nicht die Frage, mit der das Thema eingeleitet wurde. Darauf werden wir gleich noch einmal zurückkommen. Da wir nun aber bereits eine grundlegende Vorstellung davon haben, was eine Datenbank ist, können wir zum nächsten Punkt übergehen. Das heißt: Was ist der Unterschied zwischen einer relationalen und einer nicht-relationalen Datenbank, und warum gibt es diesen Unterschied? Auch wenn dies eine einfache Frage ist, ist die Antwort doch nicht so einfach. Manche Leute mit etwas Erfahrung werden sofort sagen: Eine relationale Datenbank verwendet SQL, eine nicht-relationale hingegen nicht. Ich würde mir sogar wünschen, dass die Antwort so einfach wäre, aber das ist sie nicht. Der Unterschied zwischen einer relationalen und einer nicht-relationalen Datenbank besteht darin, wie „Schlüssel-Wert“-Paare in der Datenbank abgelegt wird.
„Meine Güte! Wenn schon vorher alles schwierig war, ist es jetzt völlig unerträglich geworden. Aber wie kann das sein? Wie kann es einen Unterschied darin geben, wie das „Schlüssel-Wert“-Paar in der Datenbank abgelegt wird?“ Auf den ersten Blick ergibt das keinen Sinn, aber wenn Sie mehr Erfahrung sammeln und mit Datenbanken arbeiten, werden Sie es irgendwann verstehen. Damit Sie jedoch zumindest verstehen können, wovon wir sprechen – auch wenn es Ihnen verrückt erscheint –, werde ich versuchen, diesen Punkt zu erklären, so schwierig es auch sein mag.
Eines der Hauptmerkmale einer relationalen Datenbank ist ihre Integrität, genauer gesagt die Fähigkeit der Datenbank, ihre Integrität auch dann zu bewahren, wenn wir versuchen, ihr diese Eigenschaft zu entziehen. Man kann sich die gesamte Datenbank als ein Ganzes vorstellen, dessen Integrität gewahrt bleiben soll. Es gibt jedoch Fälle, in denen diese Integrität keine Priorität hat. Und wenn dies geschieht, kommt es zu einem unerwünschten Ergebnis, denn die Datenbank sollte ihre Integrität wahren. Es kommt zu einer Duplizierung von „Schlüssel-Wert“-Paaren. „Aber Moment mal. Diese Duplizierung sollte nicht auftreten, da jeder Index, der als Schlüssel dient, einem Datensatz zugeordnet ist, der den Wert darstellt.“ Wenn Sie das gedacht haben, liegen Sie tatsächlich richtig. Wenn Sie das jedoch gedacht haben, bedeutet das, dass Sie immer noch an ein Array denken. Jetzt ist die Sache etwas komplizierter geworden. Bei einem Array steht jede Position für einen Wert. Daher ist es unmöglich, eine Position zu belegen, die zwei unterschiedliche Werte repräsentiert. Und das ist im Wesentlichen richtig.
Was wäre aber, wenn wir anstelle eines Indexes oder einer Position etwas anderes verwenden würden, zum Beispiel einen Wert oder eine Zeichenkette, also etwas, das in diesem Fall den Index oder den Schlüssel darstellen würde? Jetzt wirkt alles schon ziemlich vertraut. Um das zu verstehen, lassen Sie uns über etwas nachdenken, das heutzutage ganz alltäglich geworden ist: das Programmieren in Python. Und warum verwenden wir Python für die Erklärung? Der Grund dafür ist, dass Python über ein Konzept verfügt, das sich hervorragend dazu eignet, den Unterschied zwischen relationalen und nicht-relationalen Datenbanken zu erklären. Außerdem kann Python auch Arrays verwenden, wodurch die Erklärung wesentlich logischer wird.
In Python gibt es ein Konzept, das als „Dictionary“ bezeichnet wird. Ein Dictionary ist, allgemein ausgedrückt, eine Datenstruktur, in der jeder Eintrag aus einem Schlüssel und einem Wert besteht. Das heißt, es ist nicht mehr der Index im Array, der angibt, mit welchem Wert der Schlüssel verknüpft wird. Sie können den Schlüssel an einem beliebigen Index platzieren, und bei der Suche nach dem Schlüssel wird der entsprechende Wert dennoch gefunden. Diese Analogie ist nützlich, da Schlüssel und Werte zu expliziten Feldern werden und die Zuordnung nicht mehr an einen numerischen Array-Index gebunden ist. Genauso wie dies in Python möglich ist, lässt sich eine ähnliche Aufgabe auch mit SQL lösen. Das heißt, wir werden eine Spalte anlegen, die die als Schlüssel verwendeten Werte enthält.
In einer weiteren Spalte würden wir die Zuordnung zwischen den einzelnen Schlüsseln und den Datensatzwerten festlegen. Ohne angemessene Absicherungen würde eine Datenbank – selbst wenn sie mit SQL erstellt wurde – zu einer nicht-relationalen Datenbank werden. Sehen Sie, wie uns das Verständnis der verschiedenen Elemente – auch wenn das Ganze einfach erscheint – dabei helfen kann, bestimmte Konzepte besser zu verstehen? Aber alles, was bisher gezeigt wurde, dient lediglich dazu, zu erklären, wie wir eine Datenbank betrachten können. Und wie man der Versuchung widerstehen kann, eine Reihe von Unterprogrammen und Prozeduren zu programmieren, nur um das zu erreichen, was SQL ohnehin leisten kann. Oder glauben Sie, dass man zu diesem Zweck mit SQL kein Python-Dictionary erstellen kann?
An dieser Stelle lohnt es sich, ein interessantes Detail zu erwähnen, bevor wir zu den Grundlagen relationaler Datenbanken übergehen. Viele Menschen, vor allem Enthusiasten mit wenig Programmiererfahrung, haben sich tausendundeine Möglichkeit ausgedacht, wie man mit Python ein System für künstliche Intelligenz erstellen kann. Ich möchte diese Menschen nicht kritisieren oder behaupten, dass sie Unrecht haben. Denken Sie jedoch einmal über Folgendes nach: Solche Systeme der künstlichen Intelligenz nutzen im Wesentlichen eine Datenbank. Sie kann nicht-relational sein, wie diejenige, die wir gerade betrachtet haben, oder relational, worauf wir etwas später noch eingehen werden. Meine Frage lautet: Warum sollte man solche Datenbanken in Python erstellen, wenn man dasselbe auch mit SQL erreichen kann?
Trotz der ganzen Euphorie rund um diese GPTs, die viele Menschen dazu veranlassen, Python zu lernen, um etwas Ähnliches zu entwickeln – oder zumindest etwas, das einen bestimmten Bedarf erfüllt –, lässt sich dasselbe auch mit SQL erreichen. Der entscheidende Punkt ist folgender: Wie viel Aufwand müssen Sie betreiben, um etwas in der einen oder anderen Sprache zu tun? Als ich zuvor eine Artikelserie darüber geschrieben habe, wie man einen Expert Advisor erstellt, der automatisch arbeitet, haben mich einige Leute gefragt, warum ich das getan habe. Ich persönlich sehe jedoch keine besonderen Schwierigkeiten dabei, so etwas zu erstellen, da die Umsetzung sehr einfach ist.
Im Gegensatz dazu verdient ein Expert Advisor, der eine mit SQL erstellte und gepflegte Datenbank nutzt, um zu lernen, wie man am Markt handelt, Respekt. Auch wenn die Umsetzung nicht schwierig ist, erfordert sie doch beträchtliches Fachwissen und einen erheblichen Aufwand, insbesondere damit der Expert Advisor richtig lernen und eine Datenbank aufbauen kann. Höchstwahrscheinlich gibt es so etwas bereits: einen Roboter, der mithilfe von MetaTrader 5 in Verbindung mit SQL genau wie ein Mensch arbeitet, mit vollständiger Subjektivität bei der Entscheidungsfindung: ob er handeln, kaufen oder verkaufen soll und welches Signal besser ist als ein anderes. Letztendlich können solche Dinge entstehen, wenn wir uns mit den richtigen Konzepten beschäftigen.
Nun können wir uns damit befassen, was eine relationale Datenbank eigentlich ist. Wenn Sie über Programmierkenntnisse verfügen, verstehen Sie sicherlich, wie eine nicht-relationale Datenbank entstehen kann. Wenn Sie jedoch Ersteres nicht verstehen, werden Sie Letzteres nicht verstehen können. Auch hier spielt es keine Rolle, ob SQL verwendet wird oder nicht. Der Unterschied liegt lediglich darin, wie die Grundlage geschaffen wird.
Um den relationalen Datenbanktyp zu verstehen, müssen wir ein wenig in der Zeit zurückgehen. Tatsächlich müssen wir noch einmal auf den vorherigen Artikel zurückkommen, in dem wir erklärt haben, wie man einen Datensatz in einer Datenbank ändert und löscht. Es reicht aus, die vorherigen Artikel zu lesen, um zu verstehen, worum es hier geht. Dort haben wir ganz deutlich gezeigt, dass man etwas benötigt, um nach einem bestimmten Datensatz zu suchen. Ohne dieses „Etwas“ (das ist der Schlüssel) werden wir die richtige Position nicht finden können. Aber worin unterscheidet sich der in einer relationalen Datenbank verwendete Schlüssel von dem gleichen Schlüssel in einer nicht-relationalen Datenbank? Ein Unterschied besteht darin, dass dieser Schlüssel in einer nicht-relationalen Datenbank nicht eindeutig ist. Aber das ist noch nicht alles. Behalten Sie das vorerst im Hinterkopf.
Dieser Schlüssel wird bei der Verwendung einer relationalen Datenbank nicht doppelt vergeben. Dazu definieren wir ihn in der Regel als Primärschlüssel. Aber die Tatsache, dass er primär ist, bedeutet nicht, dass er nicht mehrfach auftreten könnte. Sie können SQL mitteilen, dass Werte in einer Spalte nicht doppelt vorkommen dürfen. Und dennoch bedeutet dies nicht, dass diese Daten oder die zu dieser bestimmten Spalte gehörenden Datensätze eine Menge von Primärschlüsseln bilden.
Was eine Spalte zu einem Primärschlüssel macht, ist das Vorhandensein von Fremdschlüsseln. Das ist es, was den relationalen Charakter der Datenbank ausmacht und gewährleistet. Das liegt daran, dass nun eine Beziehung zwischen einem Schlüssel in einer Tabelle und einem anderen Schlüssel in einer anderen Tabelle besteht. Dieser Ansatz wird häufig beim Aufbau einer Datenbank verwendet, in der alle Datensätze eindeutig sein müssen. Vor allem aber müssen sie alle in irgendeiner Weise miteinander in Verbindung stehen und so eine Art graphartige Struktur bilden, die der unten abgebildeten sehr ähnlich ist.
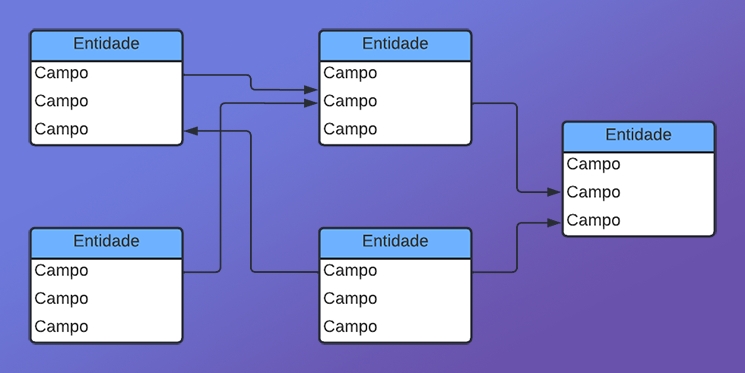
Vielleicht erscheinen die Begriffe „Primärschlüssel“ und „Fremdschlüssel“ allein beim Betrachten dieses Bildes nicht besonders klar. Aber stellen Sie sich einmal vor, wir würden eine Datenbank zu unserem persönlichen Leben anlegen. Diese Datenbank würde weder einen Primärschlüssel noch einen Fremdschlüssel erfordern. Wenn wir jedoch beginnen, unsere persönlichen Kontakte – sei es aus sozialen Netzwerken oder aus unserem näheren Umfeld – in dieselbe Datenbank aufzunehmen, erhält jeder dieser Kontakte einen Schlüssel, der als Primärschlüssel fungiert. Es wird jedoch Momente geben, in denen all diese Datensätze Gemeinsamkeiten aufweisen. Wenn Sie beim Versuch, dieselbe Datenbank zu pflegen, diese gemeinsamen Punkte duplizieren würden, wäre eine Abfrage mit Querverweisen deutlich langsamer und schwieriger.
Wenn diese gemeinsamen Punkte jedoch in einer speziellen Tabelle gespeichert werden, können Sie einen anderen Schlüssel (in diesem Fall einen Fremdschlüssel) verwenden, um die Informationen wesentlich einfacher miteinander zu verknüpfen, wodurch sowohl die Abfrage als auch eventuelle spätere Änderungen an der Datenbank beschleunigt werden. Und so entsteht eine relationale Datenbank. Das heißt, Informationen an einer Stelle werden mit anderen Informationen verknüpft, die an anderer Stelle abgelegt sind.
Abschließende Gedanken
Mir ist bewusst, dass der Inhalt des heutigen Artikels sehr abstrakt und schwer verständlich wirken mag. Ich möchte jedoch betonen, dass Datenbanken, so wie sie heute definiert und genutzt werden, nicht von heute auf morgen entstanden sind. Sie wurden über viele Jahre hinweg schrittweise aufgebaut und implementiert. Viele von Ihnen haben vielleicht weitaus mehr Erfahrung im Umgang mit Datenbanken als ich und sind daher möglicherweise anderer Meinung.
Da es notwendig war, zu erklären, warum Datenbanken so aufgebaut sind, wie sie sind, und warum SQL diese Form hat – insbesondere, warum Primär- und Fremdschlüssel entstanden sind –, mussten einige Dinge etwas abstrakt bleiben. Auch hier gilt: Betrachtet man dieses Thema ausschließlich aus erklärender Sicht, mag es sehr abstrakt und unbegründet erscheinen.
Da ich Ihnen jedoch die Grundlagen dieses Themas näherbringen möchte, damit Sie bestimmte Aufgaben bewältigen können, ohne zu tief in die SQL-Thematik einzusteigen, müssen wir uns mit Konzepten wie Primärschlüsseln und Fremdschlüsseln befassen und verstehen, wie diese tatsächlich funktionieren. Das liegt daran, dass ein korrektes Verständnis dieses Konzepts bei der Erstellung einer Datenbank von großer Bedeutung ist, selbst wenn diese nur zu Lernzwecken gedacht ist.
Wenn wir anfangen, etwas zu verwenden, müssen wir es richtig tun. Sich mit verschiedenen Ideen auseinanderzusetzen, die wir nicht wirklich verstehen, trägt nicht dazu bei, dass wir uns beruflich weiterentwickeln. Wir haben bereits deutlich gemacht, dass die Verwendung von SQL allein noch nicht ausreicht, um eine Datei oder eine Gruppe von Dateien zu einer relationalen Datenbank zu machen. Sie können einfach Ihren eigenen Satz von Prozeduren, Anweisungen und Unterprogrammen erstellen, um eine Datenbank aufzubauen – nicht nur, um mit einer bestehenden Datenbank zu arbeiten, sondern auch, um eine neue zu erstellen. Und wenn Sie einige der damit verbundenen Konzepte nicht verstehen, werden Sie letztendlich ein System entwickeln, das mit der Zeit instabil wird.
Mir wurde das bewusst, weil ich lange Zeit die Verwendung von SQL oder vorhandene Implementierungen ignoriert hatte. Ich habe immer darauf bestanden, meine eigenen Lösungen zu entwickeln, und selbst wenn diese funktionierten, musste ich nach einer Weile doch das nachbauen, was in SQL bereits vorhanden war. Und all diese Mühe und Zeit hätte ich viel produktiver nutzen können, wenn ich einfach von Anfang an die bereits vorhandene Lösung genutzt hätte.
Im nächsten Artikel werden wir uns in der Praxis damit befassen, wie diese Schlüssel in einer Datenbank verwendet werden. Vielleicht wird das derzeit noch abstrakte Konzept auf diese Weise konkreter und verständlicher.
| Datei | Beschreibung |
|---|---|
| Experts\Expert Advisor.mq5 | Veranschaulicht die Interaktion zwischen Chart Trade und dem Expert Advisor (für die Interaktion ist Mouse Study erforderlich). |
| Indicators\Chart Trade.mq5 | Erstellt ein Fenster zur Konfiguration der zu sendenden Order (für die Interaktion ist Mouse Study erforderlich). |
| Indicators\Market Replay.mq5 | Erstellt Steuerelemente für die Interaktion mit dem Replikations-/Simulationsdienst (für die Interaktion ist Mouse Study erforderlich). |
| Indicators\Mouse Study.mq5 | Ermöglicht die Interaktion zwischen grafischen Steuerelementen und dem Benutzer (sowohl für das Replikationssystem als auch für den realen Markt erforderlich). |
| Services\Market Replay.mq5 | Erstellt und verwaltet den Dienst für die Marktreplikation/-simulation (die Hauptdatei des gesamten Systems). |
| Code VS C++\Servidor.cpp | Erstellt und verwaltet einen in C++ entwickelten Server-Socket (Mini-Chat-Version). |
| Code in Python\Server.py | Erstellt und verwaltet einen Python-Socket für die Kommunikation zwischen MetaTrader 5 und Excel. |
| Indicators\Mini Chat.mq5 | Ermöglicht die Implementierung eines Mini-Chats über einen Indikator (die Nutzung des Servers ist erforderlich). |
| Experts\Mini Chat.mq5 | Ermöglicht die Implementierung eines Mini-Chats mithilfe eines Expert Advisors (ein Server ist erforderlich). |
| Scripts\SQLite.mq5 | Veranschaulicht die Verwendung eines SQL-Skripts mit MQL5. |
| Files\Script 01.sql | Zeigt die Erstellung einer einfachen Tabelle mit einem Fremdschlüssel. |
| Files\Script 02.sql | Zeigt, wie man Werte in die Tabelle einfügt. |
Link
Übersetzt aus dem Portugiesischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/pt/articles/12985
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.

 Neuronale Netze im Trading: Ein domänenübergreifendes Framework für die Zeitreihenprognose (TimeFound)
 Vom Anfänger zum Fortgeschrittenen: Indikator (V)
 Marktsimulation (Teil 22): Erste Schritte mit SQL (V)
 Neuronale Netze im Trading: Ein domänenübergreifendes Framework zur Zeitreihenprognose (Fazit)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.