

Нейросети в трейдинге: Habi — быстрое принятие решений без сложного планирования
 166
 0

Введение
При разработке торговой стратегии мы регулярно выбираем между несколькими действиями. Можно открыть позицию, изменить её объём, пересмотреть защитные уровни или остаться вне рынка. Каждое решение зависит не только от движения цены, но и от уже принятых обязательств. Чем подробнее алгоритм оценивает возможные последствия, тем больше вычислений требуется на очередном баре. Особенно заметна эта проблема в системах, которые строят несколько сценариев будущего и подбирают действия для каждого из них.
Сложное планирование полезно при подготовке торговой политики, но его полное повторение на каждом шаге бывает избыточным. Возникает практический вопрос: можно ли научить компактную модель воспроизводить опыт планировщика и получать решения по более короткому вычислительному маршруту? Этот подход рассматривают авторы работы Habitizing Diffusion Planning for Efficient and Effective Decision Making. Разработанный ими фреймворк Habi переносит решения диффузионного планировщика в генеративную политику. Авторы связывают механизм с формированием привычного поведения — habitization.
Обучаемая политика Habi формирует несколько действий из вероятностного представления состояния. Дополнительная нейросеть оценивает предложения, после чего выбирается один кандидат. При исполнении не требуется повторно запускать диффузионный планировщик. Вычислительное преимущество показано авторами на их исследовательских задачах; для финансового рынка его ещё необходимо проверять отдельно.
В нашей серии мы переносим принципы Habi в MQL5 и OpenCL. Источником эталонных торговых действий станет ранее разработанный Oracul, а оценка кандидатов будет учитывать денежные последствия и ограничения торговли. В первой статье разберём авторский алгоритм и объясним решения нашей адаптации. Также подготовим расширения двух OpenCL-кернелов пакетного VAE. Построение нейросетевых объектов и остальных вычислительных операций оставим второй статье. Обучение, онлайн-адаптацию и результаты тестирования рассмотрим в третьей.
Архитектура фреймворка Habi
Чтобы разобраться в Habi, представим задачу сопровождения позиции. Допустим, трейдер держит покупку после сильного движения цены. Одно решение — сохранить прежний объём, другое — сократить риск, третье — выйти из рынка. Более сложный планировщик может оценивать последовательности будущих действий с учётом множества возможных состояний. Диффузионный метод строит такие решения постепенно: начинает со случайного представления и уточняет его за ряд последовательных вычислительных шагов. При следующем наблюдении планирование приходится повторять.
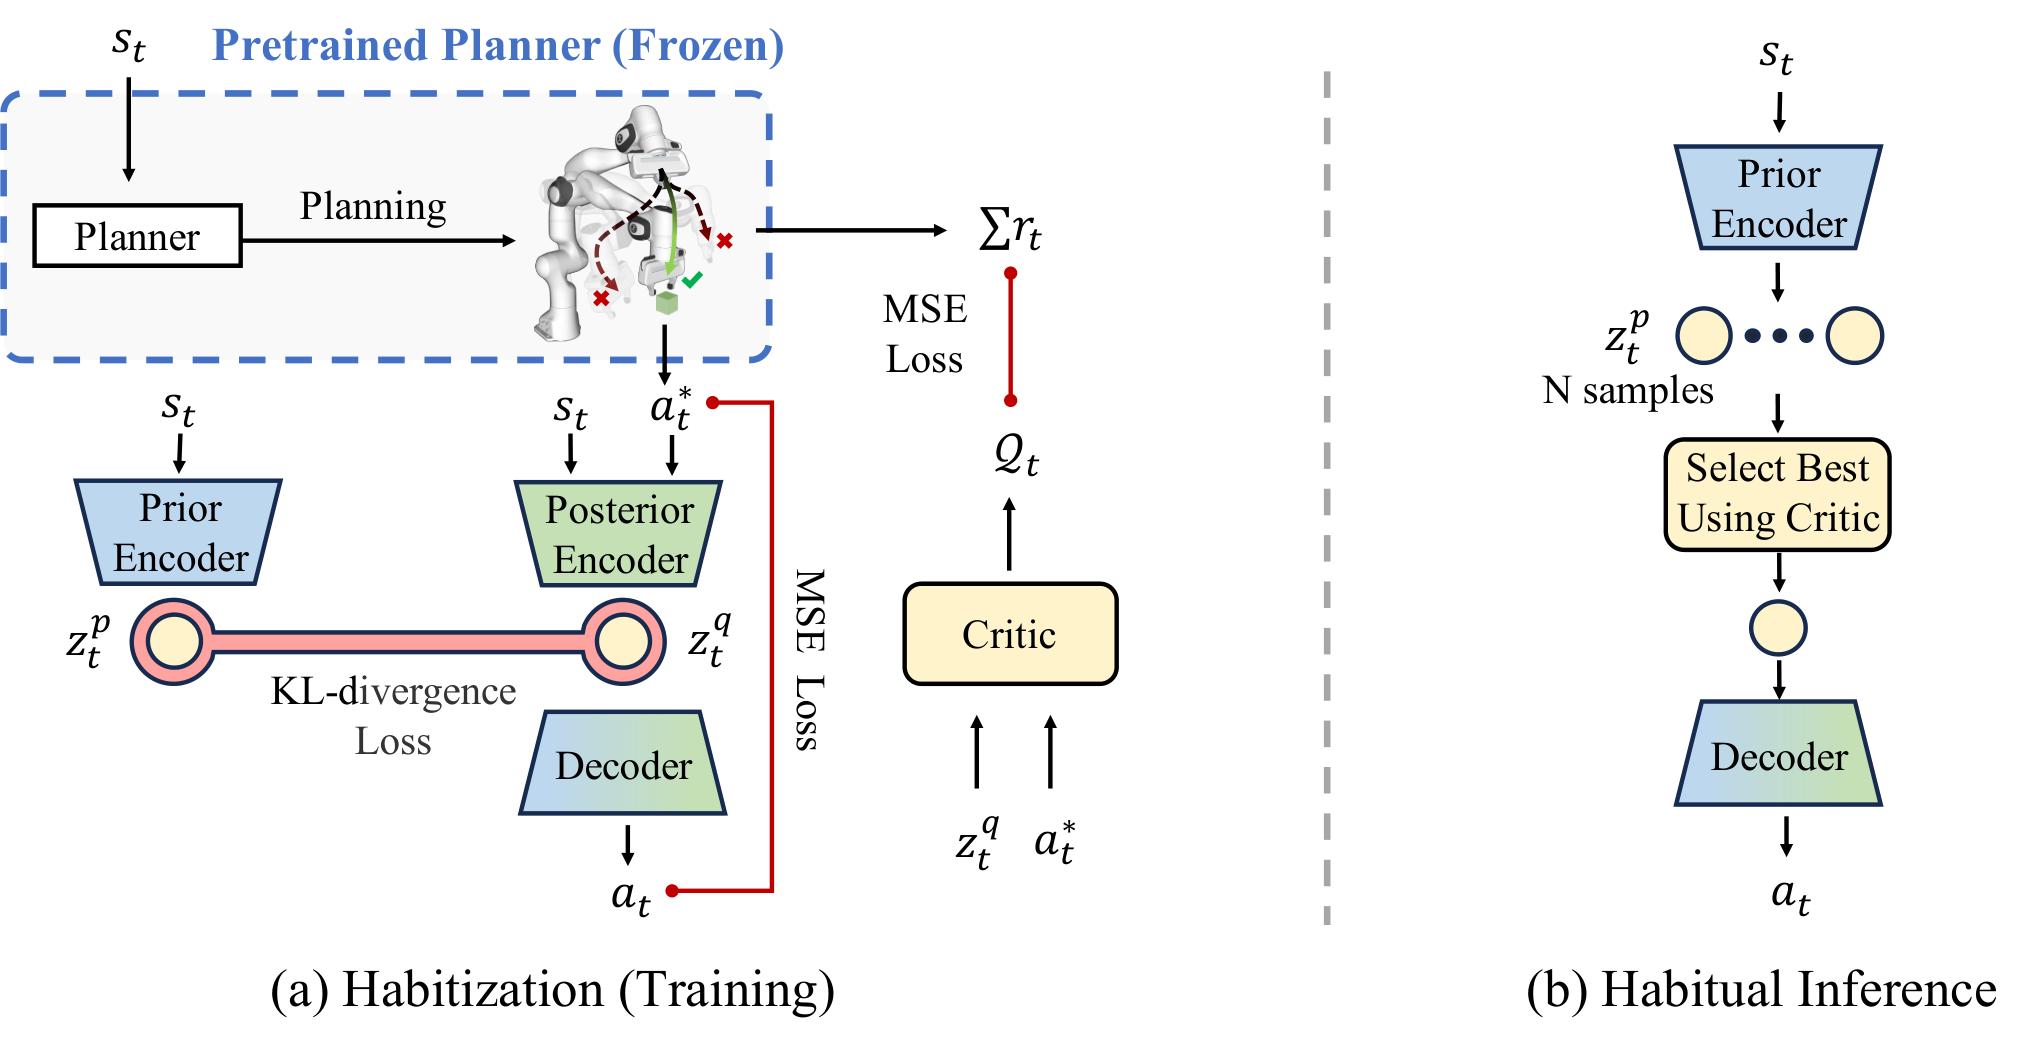
Авторы Habi предложили другой маршрут для непосредственного управления. Планировщик используется для получения качественных примеров при подготовке политики. Более компактная генеративная сеть учится воспроизводить эти решения. По завершении обучения ей достаточно текущего наблюдения, чтобы самостоятельно создавать варианты действий. Так опыт затратного поиска переносится в параметры модели. В авторской работе этот перенос осуществляется с помощью Prior Encoder, Posterior Encoder и Decoder. Дополнительно применяется Critic для оценки предложений.
Обозначим текущее наблюдение через s, эталонное действие планировщика — через a*, а скрытый, или латентный, вектор — через z. В торговой интерпретации наблюдение может содержать динамику цены и состояние счёта. Однако отдельные координаты латентного вектора не являются заранее заданными ценами, объёмами либо торговыми сигналами. Их смысл определяется обучением самой модели.
Prior Encoder получает только состояние s. Он формирует параметры многомерного нормального распределения, из которого впоследствии можно получать разные латентные представления одного наблюдения. Для простоты используется диагональная ковариационная матрица: каждой координате соответствует собственное математическое ожидание и стандартное отклонение.
p(z | s) = 𝒩(μp(s), diag(σp(s)²))
В этом выражении p обозначает распределение Prior, а не вероятность роста или падения котировки. Разброс распределения характеризует разнообразие доступных модели скрытых представлений. Случайные выборки из него позволяют предложить несколько действий для одной рыночной ситуации.
Второй энкодер — Posterior Encoder — работает на этапе обучения. В дополнение к наблюдению он получает эталон a*, который был найден планировщиком. Благодаря этой подсказке Posterior может построить распределение латентных переменных, связанное с желаемым действием:
q(z | s, a*) = 𝒩(μq(s, a*), diag(σq(s, a*)²))
Сравним их на торговом примере. Планировщик после оценки будущей траектории предлагает уменьшить длинную позицию. Posterior видит это предложение и текущее состояние счёта, а Prior — только состояние. При обучении распределения сближаются. В дальнейшем Prior должен создавать полезные латентные представления без знания эталона. Этим объясняется присутствие двух энкодеров в обучающей архитектуре и отсутствие Posterior в рабочем маршруте.
Выборка латентного вектора выполняется методом репараметризации. Вместо не дифференцируемой операции случайного выбора результат выражается через параметры распределения и независимый нормальный шум:
z = μ + σ ⊙ ε, ε ∼ 𝒩(0, I)
Символ ⊙ означает покомпонентное умножение. Для каждого нового кандидата выбирается собственный вектор ε. Благодаря репараметризации ошибка, вычисленная после генерации действия, может распространяться к параметрам распределения. В авторском коде стандартное отклонение получается из промежуточного параметра через функцию softplus с небольшой положительной добавкой.
Полученный вектор поступает в Decoder. Это нейросеть, которая преобразует скрытое представление в действие пространства управления. В общем виде её работу можно записать как:
a = D(z)
Во время обучения Decoder получает выборки из Posterior и учится воспроизводить эталонное действие. Для этого рассчитывается ошибка реконструкции: чем сильнее предложение отличается от эталона, тем больше соответствующая составляющая функции потерь. Однако одной реконструкции недостаточно. Posterior располагает дополнительной информацией, которой Prior не получит во время реальной торговли. Если не согласовать их распределения, хороший результат обучения с подсказкой не обязательно сохранится при самостоятельной генерации.
Для согласования применяется дивергенция Кульбака — Лейблера, или KL-дивергенция. Она измеряет различие двух распределений. В Habi сравниваются Posterior и Prior, а сила согласования регулируется коэффициентом β.
LHabi = Lrecon + β · DKL(q(z | s, a*) ‖ p(z | s))
Первое слагаемое отвечает за восстановление действия планировщика. Второе передаёт опыт Posterior энкодеру Prior. Если вес KL слишком мал, модель может хорошо реконструировать эталоны, но плохо генерировать действия без подсказки. Если слишком велик, может пострадать качество реконструкции. Авторы рассматривают настройку этого баланса, в том числе с помощью адаптивного коэффициента. В нашей серии вычисления соответствующих градиентов разберём при создании нейросетевых классов.
После обучения связка Prior и Decoder формирует самостоятельную генеративную политику. Но даже несколько корректных с точки зрения нейросети предложений могут сильно отличаться по полезности. За оценку отвечает Critic. Он получает согласованную пару латентного представления и сформированного из него действия, а на выходе возвращает одно числовое значение:
Q(z, a) = Critic(z, a)
Для трейдера Q удобно понимать как относительную оценку предпочтительности решения внутри выбранной методики обучения. Это не обязательно прогноз прибыли в валюте депозита. Экономический смысл значения определяется целевыми оценками, на которых обучали Critic. В авторских задачах использовались оценки качества, связанные с исходной средой и планировщиком. При подготовке оценщика рассматриваются как предпочтительные, так и менее удачные варианты. Его отдельная регрессия не обязана изменять параметры генератора.
Посмотрим на рабочий маршрут целиком. Prior получает наблюдение, а из его распределения выбираются N латентных векторов. Decoder превращает каждый из них в действие, затем Critic присваивает парам свои оценки. Для исполнения выбирается кандидат с наибольшим Q:
zn ∼ p(z | s), an = D(zn), n = 1,…,N
n* = arg max1 ≤ n ≤ N Q(zn, an), aselected = an*
Именно это сокращает рабочий путь: нет необходимости заново проводить многошаговую диффузионную генерацию при каждом наблюдении. Вместе с тем качество выбора ограничено предложенным набором действий и точностью Critic. Увеличение N расширяет поиск среди сгенерированных вариантов, но не гарантирует глобально оптимальное решение. Кроме того, опыт успешного применения Habi в исследовательских средах не является доказательством его прибыльности на финансовых рынках.
Адаптация Habi для финансовых рынков
В оригинальном Habi эталонные действия предоставляет диффузионный планировщик. В нашей адаптации на стадии офлайн обучения эту роль выполняет ранее разработанный Oracul. Он анализирует исторический отрезок, включая известное последующее движение цены, и формирует предложение для обучения. Благодаря этому нам не требуется предварительно обучать отдельный диффузионный планировщик. Мы сохраняем основной принцип Habi — перенос опыта подготовки решений в быструю политику, — но изменяем источник эталона.
У такого решения есть важное условие. Будущие котировки можно использовать только для формирования эталона и оценки исторических последствий. Они не передаются в текущее наблюдение энкодера, Decoder или Critic при принятии решения. Иначе тестовая модель получит информацию, недоступную реальному трейдеру. Поэтому для каждого исторического шага отдельно фиксируется граница времени: признаки описывают уже завершённые бары, а будущие бары принадлежат только обучающей процедуре.
Состояние финансового рынка задаётся двумя блоками. Первый описывает котировки и технические признаки, второй — торговый счёт. Такая структура нужна потому, что даже при одинаковом сигнале на графике оптимальное действие зависит от существующей позиции. Например, предложение открыть покупку нельзя одинаково трактовать при пустом счёте и при уже накопленной длинной экспозиции.
В начальной конфигурации каждому историческому бару соответствуют девять рыночных признаков: изменения Close, High и Low относительно Open; тиковый объём; RSI, CCI, ATR, основная и сигнальная линии MACD. Используем только последние завершённые бары. Для последовательности длиной HistoryBars количество рыночных входов равно девятикратной глубине истории. Данные располагаются в порядке "признак — его исторические значения", а не как готовые строки OHLC.
Блок счёта содержит 13 признаков. Среди них нормированный баланс, относительные изменения баланса и эквити, чистая направленная позиция, денежные результаты открытых покупок и продаж, характеристика срока удержания и четыре циклических временных компонента. Рыночные признаки проходят отдельную нормализацию в каждом энкодере; признаки счёта подаются в соответствии с указанными ниже масштабами. Общая размерность наблюдения определяется выражением:
M = HistoryBars · 9, O = M + 13
При пяти анализируемых барах получаем M = 45 и O = 58. Это пример настройки, а не фиксированная размерность. Размеры должны определяться согласованным профилем, а не фиксированными литералами внутри нейронных слоёв. Текущий бар не включается в рыночный блок, но состояние счёта и временные признаки соответствуют моменту принятия решения.
Исходный профиль данных и параметров
Начальный профиль опирается на файлы AC-SRM. Числа, ещё не закреплённые для Habi, указаны как настройки профиля.
| Параметр | Начальная конфигурация и масштаб |
|---|---|
| HistoryBars | 5 закрытых баров; 9 рыночных признаков на бар и 13 признаков счёта. |
| Индикаторы | RSI(14, PRICE_CLOSE), CCI(14, PRICE_TYPICAL), ATR(14), MACD(12, 26, 9, PRICE_CLOSE). |
| Рынок | Close/High/Low − Open в единицах цены; тиковый объём / 1000; RSI и CCI в исходной шкале; ATR и MACD в единицах цены. Затем независимая BatchNorm энкодеров. |
| Счёт | B/10000; (B−Bprev)/Bprev; E/Bprev; (E−Eprev)/Eprev; max(qnet,0) и max(−qnet,0) в лотах; Pbuy, Psell, Dpos делятся на Bprev; Dpos=Σ age·|PnL|/36000; синусы/косинусы года, месяца, недели и суток. Без BatchNorm. |
| L и N | L = 256 в начальном профиле; N настраивается, 8 и 16 — примеры размеров буферов. |
| Коэффициент β | Фиксированный либо адаптивный режим KL; число задаётся профилем обучения. |
| Историческая оценка | Донорский ориентир: H = 24 бара, γ = 0,5 на бар; значения настраиваются. |
| Действие | Шесть долей в [0,1]; исходные пределы: 1 лот и по 1000 пунктов для TP и SL. |
Периоды и масштабы заданы в донорском Trajectory.mqh, горизонт — в Study.mq5. Значения N, β и статистики нормализации должны соответствовать сохранённому профилю модели. Настройку разберём во второй статье, параметры экспериментов — в третьей.
Следующая граница адаптации — формат действия. В нашем проекте Decoder выдаёт шесть нормированных компонентов в диапазоне от нуля до единицы. Они описывают целевой объём покупки, доли расстояний до её Take Profit и Stop Loss, а затем аналогичные три значения для продажи. Обозначим выход как Action6 с координатами [a0, a1, a2, a3, a4, a5]. Подобное представление уже применялось и позволяет переиспользовать знакомые механизмы обработки торговых действий.
Направление определяется разностью первой и четвёртой компонент. Положительный результат соответствует целевой покупке, отрицательный — продаже. При модуле объёма ниже минимально допустимого лота целевое состояние считается FLAT. Так мы не превращаем случайное малое значение сети в принудительное открытие минимальной сделки. Объём ненулевой позиции округляется вниз по разрешённой сетке лота и дополнительно проверяется на ограничения инструмента.
Нейросеть предлагает именно целевую позицию, а не приказ каждый раз открывать новую сделку. Если позиция уже совпадает с целью, исполнитель может ограничиться корректировкой защиты. Если новая цель меньше прежней, требуется сокращение объёма. При развороте сначала подтверждается закрытие старого направления, затем рассматривается противоположный вход. Такой подход позволяет использовать единый вектор действий для открытия, удержания, частичного закрытия и выхода из рынка.
Доли Take Profit и Stop Loss переводятся в реальные расстояния с учётом Bid/Ask и выбранного масштаба в пунктах. Абсолютные цены округляются к ближайшему разрешённому значению по SYMBOL_TRADE_TICK_SIZE. После округления нужно повторно проверить расположение защитных уровней, минимальные расстояния и прочие требования брокера. Выполнение этих правил является частью торгового адаптера, а не нейросетевого слоя.
Некоторые выходы требуют особой обработки. Ненулевая целевая позиция с нулевой долей Take Profit или Stop Loss считается недопустимой. По принятому контракту она не открывает новую сделку и требует закрыть ранее открытую собственную позицию. При установленной экономической причине недопустимости в обучающий результат добавляется отдельный штраф. Сетевой сбой, временный отказ брокера или неизвестный исход исполнения сами по себе таким доказательством не являются.
Для обучения Critic сохраняется исходное нормированное действие, предложенное Decoder. Мы не заменяем его результатом округления объёма и цен. Однако денежная оценка строится с учётом реальной семантики торговой цели после всех необходимых проверок. Так модель может сопоставлять собственные выходы с последствиями их использования, не теряя информацию о непрерывных координатах действия.
В нейросетевой архитектуре также предусмотрены изменения. В авторской реализации параметры среднего и масштаба каждого распределения вычисляются отдельными многослойными перцептронами. Для нашей библиотеки удобнее общая последовательность скрытых слоёв с единым выходом длиной 2L. Первая половина содержит математические ожидания μ, вторая — промежуточные параметры ξ, преобразуемые в логарифмы дисперсий ℓ. При этом Prior и Posterior остаются двумя независимыми CNet с разными весами и собственными блоками нормализации.
При запуске Decoder мы не создаём по одной сети на каждого кандидата. Из общих параметров распределения получаем матрицу N × L латентных векторов. Дальше применяем свёрточные слои с неперекрывающимися окнами и общим банком весов: каждой строке соответствует отдельный кандидат, но все строки используют одинаковую функцию преобразования. Decoder возвращает N шестикомпонентных действий. Аналогично Critic оценивает N согласованных пар [z, raw Action6]. Количество вариантов увеличивает буферы и вычислительную нагрузку, но не число независимых наборов весов.
В результате предусмотрены четыре самостоятельные нейросетевые модели: Prior, Posterior, Decoder и Critic. Для этапа онлайн-TD могут создаваться независимые целевые копии Prior, Decoder и Critic. Отдельное сохранение и загрузка позволяет использовать геометрически совместимые веса из разных источников. Однако совместимая длина векторов ещё не гарантирует одинаковый экономический смысл признаков; корректность конфигурации по-прежнему важна.
Как формировать обучающие состояния, если у нас есть история котировок, но нет полного журнала прошлых сделок? В проекте используется синтетическое состояние счёта. На каждом историческом шаге выбираются баланс и позиция FLAT, BUY либо SELL. Для открытой позиции задаются допустимый объём и возраст от одного до пяти баров. Цена входа берётся из соответствующего исторического Bid/Ask, а плавающий финансовый результат рассчитывается по котировкам и доступным финансовым параметрам инструмента.
Это не реконструкция реально существовавших сделок. Защитные уровни синтетической позиции задаются как текущие параметры на момент наблюдения; мы не требуем, чтобы они были неизменны на протяжении всех предыдущих баров. Подготовленный пример используется лишь при наличии достаточных данных о котировках, издержках и конвертации денежного результата. Неизвестные денежные величины нельзя заменять искусственными нулями.
На этом состоянии Oracul формирует предложение с использованием последующей истории. Его результат сравнивается с альтернативой FLAT от того же исходного счёта. При действующей позиции выход из рынка может давать ненулевой денежный результат, поэтому равенство "FLAT = нулевая прибыль" не предполагается. Эталоном становится экономически исполнимое действие Oracul только при преимуществе над FLAT. Иначе эталоном служит выход из рынка; он продолжает участвовать в обучении генератора.
Чтобы обучать Critic, все N действий Decoder необходимо оценить по финансовым последствиям. Для этого предусмотрен матричный расчёт на горизонте H будущих баров. Все кандидаты стартуют из одного синтетического снимка счёта, но дальше рассматриваются как независимые альтернативы. Один общий цикл по H последовательно обновляет N строк матрицы. При достижении защитных уровней учитывается первое установленное событие, а если TP и SL могли сработать в одной OHLC-свече без известного внутреннего порядка, применяется консервативный приоритет SL.
Оценка кандидата определяется денежными изменениями на границах баров. Учитываются дисконтирование по времени, комиссии и обучающий штраф за доказанную экономическую недопустимость. Конечное значение становится целью для Critic. Такой расчёт выполняется операциями matrix и vector MQL5; отдельный OpenCL-кернел исторического моделирования в выбранной архитектуре не создаётся.
Первоначальное обучение начинается с реконструкции эталона через Posterior и Decoder и согласования распределений Posterior и Prior. Затем на новом пакете действий, полученном от Decoder, Critic обучается по историческим оценкам. На этом этапе его градиенты не меняют генеративную политику. При онлайн-адаптации источником параметров распределения становится Prior. Выполняются N действий с индивидуальным учётом по Magic в пределах одного хеджингового счёта. Денежные результаты используются для TD-обучения Critic, после чего по отдельному расписанию его градиенты могут применяться для обновления Decoder и Prior.
В режиме тестирования обучение полностью отключено. Используются загруженные Prior, Decoder и Critic с подготовленными параметрами нормализации. Модель генерирует N кандидатов, вычисляет Q для каждого и передаёт на исполнение один вариант с максимальной оценкой. Второй кандидат при отказе выбранного действия на этом же баре не подбирается; следующая попытка начинается с нового наблюдения. Рабочий маршрут не требует ни Posterior, ни Oracul, ни будущей истории.
Следовательно, торговая адаптация сохраняет основную идею Habi, но учитывает непрерывные нейросетевые предложения и дискретные брокерские правила. Сокращение пути генерации пока остаётся гипотезой: после сборки моделей измерим время прямого прохода и сравним его с планировщиком или прежней реализацией. Проверим и смещение синтетических состояний счёта относительно реальных или последовательно смоделированных траекторий. Здесь ограничимся вычислительным фундаментом.
Реализация OpenCL-примитивов
Основная вычислительная особенность нашей адаптации — формирование нескольких латентных векторов из одного распределения и обратная передача суммарного градиента к общим параметрам. В библиотеке уже имеется вариационный автоэнкодер, выполняющий репараметризацию для одного представления. Чтобы использовать готовую реализацию и не нарушить ранее опубликованные классы, мы расширяем две функции OpenCL: VAE_FeedForward и VAE_CalcHiddenGradient. Имена кернелов, их идентификаторы и прежние сигнатуры с пятью аргументами сохраняются.
Пакетный прямой проход VAE
На выходе Prior или Posterior имеем вектор из 2L элементов. Первые L значений — математические ожидания μ, остальные L — логарифмы дисперсий ℓ. Для каждого кандидата n и координаты j применяется обычная формула репараметризации:
zn,j = μj + exp(ℓj / 2) · εn,j
Случайная величина ε имеет стандартное нормальное распределение. Параметры μ и ℓ общие для всех N кандидатов, а случайный шум различается. Таким образом, входной буфер остаётся компактным — 2L чисел. Массив заранее подготовленных случайных значений и выходной массив содержат по N × L элементов. Внутри кернела случайность не создаётся: он читает значения из готового буфера random.
Дополним исходный VAE_FeedForward ветвью двумерной рабочей области. Первая координата OpenCL соответствует элементу латентного вектора, вторая — номеру кандидата. В подготовленной редакции NeuroNet.cl добавлен следующий фрагмент тела кернела:
   if(get_work_dim() == 2)
     {
      uint k = (uint)get_global_id(1) * total + i;
      float mean = inputs[i], ell = inputs[i + total], eps = random[k];
      float sigma = exp(0.5f * ell);
      float z = mean + sigma * eps;
      if(flags_enabled)
         numeric_flags[k] = (!isfinite(mean) || !isfinite(ell) ||
                             !isfinite(eps) || !isfinite(sigma) || !isfinite(z));
      outputs[k] = z;
      return;
     }
Переменная i — координата латентного пространства, а total — его размер L. Из второй координаты глобальной области и значения i формируется индекс k. Он указывает нужные элементы в буферах случайных величин и результатов. По адресам inputs[i] и inputs[i + total] читаются математическое ожидание и логарифм дисперсии. Поэтому параметры нормального распределения не требуется физически размножать для каждого кандидата.
После вычисления стандартного отклонения sigma кернел получает очередной элемент z. При включённой диагностике он также фиксирует неконечные исходные или промежуточные числа. Если числовая проверка сообщает ошибку, результат нельзя молча считать корректным торговым предложением. В прежнем одномерном режиме выполнение проходит мимо новой ветви и сохраняет исходную арифметику CVAE.
Для масштаба L = 256 и N = 8 входное распределение занимает 512 элементов типа float. Случайный и выходной буферы содержат по 2048 элементов. При N = 16 эти два буфера вырастут до 4096 элементов каждый, но вход по-прежнему останется длиной 512. Это простое свойство особенно важно при многократной генерации вариантов торгового решения: мы увеличиваем число выборок, не создавая отдельные параметры распределения.
Суммирование градиентов при обратном проходе
При обучении каждый латентный вектор влияет на ошибку соответствующего действия. Обратный проход Decoder возвращает градиенты по всем N × L координатам. Поскольку все кандидаты получены из общих μ и ℓ, необходимо собрать их вклад в один вектор градиентов длиной 2L. Производные репараметризации для одной координаты имеют следующий вид:
∂zn,j / ∂μj = 1
∂zn,j / ∂ℓj = ½ · exp(ℓj / 2) · εn,j
Следовательно, по математическому ожиданию накапливается простая сумма поступивших градиентов, а по логарифму дисперсии — сумма тех же градиентов с дополнительным весом. В используемом библиотекой соглашении об отрицательном градиенте получаем:
gμ,j = Σn=0…N−1 gz,n,j
gℓ,j = ½ · Σn=0…N−1 gz,n,j · exp(ℓj / 2) · εn,j
Масштаб функции потерь по N должен учитываться при формировании исходного градиента в обучающем слое. Внутри самой редукции второй раз делить сумму на N нельзя: так мы искусственно ослабили бы обучение с ростом числа кандидатов.
В существующем VAE_CalcHiddenGradient добавляем вторую двумерную ветвь. В отличие от прямого прохода, здесь рабочие элементы должны обмениваться частичными результатами. Для этого используется локальная память и уже реализованная функция редукции LocalSum4. Сохраняемый фрагмент исходного кода выглядит так:
   __local float4 scratch[LOCAL_ARRAY_SIZE];
   if(get_work_dim() == 2)
     {
      // Every lane reaches every barrier, including for non-power-of-two N.
      uint k = (uint)get_global_id(1) * total + i;
      float c = clamp(IsNaNOrInf(gradient[k], 0), -MAX_GRAD, MAX_GRAD);
      float ell_gradient = 0.5f*c*exp(0.5f*inputs[i+total])*random[k];
      float4 v = (float4)(c, ell_gradient, !isfinite(ell_gradient), 0);
      float4 sum = LocalSum4(v, 1, scratch);
      if(get_local_id(1) == 0)
        {
         inp_grad[i] = sum.z>0 ? nan((uint)0) : sum.x;
         inp_grad[i+total] = sum.z>0 ? nan((uint)0) : sum.y;
        }
      return;
     }
Один рабочий элемент обрабатывает одну пару (n,j). Поступивший градиент сначала проходит принятую в библиотеке обработку неконечных значений и ограничение диапазона. Затем формируется вектор float4: первая компонента — вклад в градиент μ, вторая — вклад в градиент ℓ, третья — признак неконечного промежуточного значения. Функция LocalSum4 складывает эти компоненты внутри группы.
Для каждого j создаётся одна группа, а её второе измерение охватывает N кандидатов. Локальная размерность запуска — {1,N}. После редукции только поток с get_local_id(1) == 0 записывает две суммы в inp_grad. На выходе снова получаем 2L значений. Флаг NaN здесь срабатывает при неконечном ell_gradient; входной градиент обрабатывает IsNaNOrInf. Итоговые sum.x и sum.y после LocalSum4 отдельно не проверяются. Поэтому перед обновлением весов вызывающий объект должен проверить оба записанных градиента.
Локальный буфер scratch использует константу LOCAL_ARRAY_SIZE. Сам алгоритм LocalSum4 обрабатывает вход порциями, поэтому логика не требует, чтобы число N было степенью двойки или не превышало 64. Но конкретный OpenCL-драйвер накладывает собственные ограничения на размер рабочей группы, измерения запуска и локальную память. Их необходимо проверить до диспетчеризации; произвольно уменьшать N при таком отказе нельзя.
Ранее опубликованный одномерный путь VAE_CalcHiddenGradient остаётся доступным. Это позволяет расширить функциональность существующего вариационного автоэнкодера, не изменяя интерфейсы классов, которые уже используют старые кернелы. Двумерные вызовы будут организованы новым классом-наследником, реализацию которого рассмотрим во второй статье.
В новом пакетном режиме встроенная KL-регуляризация CVAE относительно стандартной нормали не применяется: её множитель устанавливается равным нулю. В Habi требуется согласование двух обучаемых распределений Prior и Posterior. Необходимые операции преобразования параметров Gaussian, условного KL и формирования выходных градиентов Critic разберём вместе с реализацией новых нейросетевых объектов во второй статье. Здесь важно было подготовить общий механизм семплирования и его обратного прохода — вычислительное основание для дальнейших классов.
Заключение
В этой статье мы рассмотрели основную идею Habi: перенос опыта затратного планировщика в генеративную политику, способную быстро предлагать несколько действий. Разобрали назначение Prior, Posterior, Decoder и Critic, механизм репараметризации и согласование вероятностных представлений через KL-дивергенцию. На торговых примерах показали, как эти компоненты разделяют подготовку эталонов и непосредственный выбор решения.
Для адаптации к финансовым рынкам мы определили представление рыночного наблюдения и счёта, шестикомпонентный формат торгового действия, общие правила его экономической проверки и источник эталонов Oracul. Предусмотрели пакетную генерацию с общими весами Decoder и Critic, историческую оценку альтернатив от одного состояния счёта и последующую онлайн-адаптацию. Важно, что будущие котировки используются только для обучающих эталонов и оценок, а не в рабочем наблюдении.
В практической части подготовили двумерные расширения VAE_FeedForward и VAE_CalcHiddenGradient. Они формируют N латентных векторов из одного распределения и возвращают общий градиент к его параметрам. В следующей статье построим нейросетевые объекты и рассмотрим операции Gaussian, KL и Critic. Обучение, измерение скорости и торговые результаты оставим заключительной части серии.
Ссылки
- Habitizing Diffusion Planning for Efficient and Effective Decision Making.
- Другие статьи серии "Нейросети в трейдинге".
Файлы проекта
| # | Имя | Тип | Описание |
|---|---|---|---|
| 1 | Trajectory.mqh | Общий модуль | Конфигурации сетей, подготовка данных и общие процедуры обучения |
| 2 | Study.mq5 | Советник | Советник предварительного офлайн обучения |
| 3 | StudyOnline.mq5 | Советник | Советник тонкой онлайн настройки |
| 4 | Test.mq5 | Советник | Исполнение торговой политики с фиксированными весами |
| 5 | NeuroNet.mqh | Библиотека классов | Подключение модулей нейронной библиотеки |
| 6 | NeuroNet.cl | OpenCL-программа | Вычислительные кернелы нейронной библиотеки |
Исходные файлы доступны в репозитории проекта.
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 Создание традиционного индикатора Ренко с наложением на график в MQL5
 Как выявлять ликвидность на круглых ценовых уровнях в MQL5
 От новичка до эксперта: Автоматизация распознавания геометрических паттернов внутри базовых свечей зон ликвидности в MQL5
 Создание системы торговой аналитики (Часть 1): Основы и архитектура системы

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования