

Нейросети в трейдинге: Habi — быстрое принятие решений без сложного планирования (формирование и оценка действий)
 44
 0

Введение
Диффузионные модели показывают хорошие результаты в задачах генерации и планирования. Однако последовательное уточнение результата требует значительных вычислений. Это ограничивает их применение там, где важна скорость принятия решения. Авторы фреймворка Habi предлагают перенести знания диффузионного планировщика в компактную модель, способную выбирать действия без повторения этого затратного процесса.
В основе такого переноса лежит условный вариационный автоэнкодер — VAE. На этапе обучения энкодер Posterior получает состояние среды и эталонное действие планировщика. По этим данным он задаёт распределение скрытых, или латентных, векторов. Декодер Decoder учится восстанавливать эталонное действие по вектору из этого распределения.
На первый взгляд, модель получает готовый ответ на входе, чтобы повторить его на выходе. Она может опереться на эталон и почти не использовать состояние среды. Но точное восстановление известного действия ещё не означает умения выбрать действие самостоятельно. При эксплуатации диффузионный планировщик исключается, а вместе с ним исчезает и эталон. Поэтому нужен второй энкодер — Prior. Он учится формировать распределение латентных векторов только по состоянию среды.
Чтобы Decoder работал с обоими энкодерами, их распределения согласуют через KL-дивергенцию. Ошибка восстановления учит воспроизводить эталонное действие. KL-дивергенция сближает представление, полученное с подсказкой, с тем, которое Prior формирует самостоятельно. Так опыт учителя становится доступен модели без эталона.
В процессе эксплуатации сэмплируется несколько векторов из распределения Prior, которые дают несколько вариантов действия. Критик оценивает предложения, после чего выбирается кандидат с наибольшей оценкой. Так модель сравнивает варианты без нового обращения к диффузионному планировщику.
В нашей торговой адаптации эталонные действия готовим с помощью Oracul. Он использует последующее движение цены на исторических данных, но будущие бары не передаются модели как наблюдение. Действие задаёт объём и доли Take Profit и Stop Loss для покупки и продажи. Critic оценивает денежные последствия таких предложений в общем контексте распределения.
В первой статье мы разобрали авторский метод, решения адаптации и расширили два OpenCL-кернела пакетного VAE. Во второй подготовили объекты обработки наблюдений, параметров распределений и выборки латентных векторов.
В этой части разберём выходные слои Decoder и Critic, а также объединение действий с параметрами распределения. Покажем обратные сигналы при восстановлении эталона, оценке исторических исходов и временной разности. Проследим пути градиента через действие и напрямую от критика к распределению. Полную сборку, обучение и торговые испытания рассмотрим в следующей части.
Выходная часть Decoder
Число кандидатов обозначим через N, длину латентного вектора — через L, размерность действия — через A. В текущем контракте Action6 параметр A = 6: для покупки и продажи задаются объём и доли TP/SL. На вход Decoder поступает вектор [μ; ℓ] длиной 2L. Из него слой VAE получает N латентных векторов, которые преобразуются в N торговых действий.
Ограничение закреплено и в коде: CNeuronHabiLeafOCL::Configure принимает только A = 6. Поэтому смещение N·6 в пакетном VAE соответствует действующему контракту. Поддержка иных размеров действия потребовала бы изменения самого интерфейса, а не одной замены литерала.
Пакет латентных выборок имеет размер N·L, пакет действий — N·A. Критику передаём действия и общий вектор [μ; ℓ], использованный при их генерации. Все кандидаты оцениваются в одном контексте распределения. Порядок действий сохраняем при сопоставлении с оценками, обучающими целями и обратными сигналами.
Последний преобразующий слой Decoder использует сигмоидальную активацию. Поэтому голова получает уже нормированные координаты действий. Перевод этих координат в торговые объёмы и ценовые расстояния относится к процедуре исполнения. Здесь нам нужны их значения в том же представлении, в котором задано учительское действие и работает критик. Повторное масштабирование внутри головы нарушило бы согласованность этих трёх участников.
Голова — служебный слой на выходе модели. При прямом проходе она сохраняет готовый пакет действий, а при обучении готовит сигнал для его изменения. Сами действия рассчитывают предшествующие обучаемые слои. Поэтому CNeuronHabiDecoderHeadOCL не требует собственных обучаемых параметров. Он наследует CNeuronHabiLeafOCL, где уже определены размеры пакета, временные буферы и состояние прохода. Общие параметры задаёт унаследованный Configure, а число выходных нейронов укажем при сборке модели.
class CNeuronHabiDecoderHeadOCL : public CNeuronHabiLeafOCL
  {
public:
   virtual int       Type() const override
     {
      return(defNeuronHabiDecoderHeadOCL);
     }
protected:
   virtual bool      feedForward(CNeuronBaseOCL *p,CBufferFloat *ctx) override
     {
      return(frame.Forward(ctx,0,bTrain) && frame.mode==21 && Pass(p));
     }
   virtual bool      calcInputGradients(CNeuronBaseOCL *p,CBufferFloat *ctx,CBufferFloat *sg,
                                        ENUM_ACTIVATION ac=None) override;
  };
Контекст — дополнительный буфер со служебным заголовком и данными для выбранной операции. Данные после заголовка называем полезной нагрузкой. Например, при обучении в ней можно передать действие учителя. Для выдачи уже рассчитанных действий такие данные не нужны: режим F_DECODER_SAMPLE со значением 21 использует только заголовок. Метод Pass переносит пакет из предыдущего слоя в выход головы.
На этом этапе сохраняем все N·A значений и их порядок. Критик должен получить каждый вариант команды для оценки, а при обучении каждому кандидату понадобится свой обратный сигнал. Выбор одной строки выполняется позднее, когда оценки уже доступны. Проверка размеров в Pass позволяет перенести пакет целиком.
Первый вариант обратного прохода используется при поведенческом клонировании (Behavior Cloning — BC). В этом режиме Decoder получает параметры распределения Posterior, а его слой VAE формирует латентный пакет. Для одного наблюдения учитель Oracul задаёт одно действие из A координат. Оно служит общей целью всех N кандидатов. Так декодер учится восстанавливать эталон по разным выборкам из распределения, сформированного с подсказкой учителя.
Учительскую строку размножаем через MatMul: умножаем столбец единиц N×1 на строку 1×A. Полученная матрица N×A задаёт одинаковую цель каждой строке кандидатов.
Будем обозначать учительскую координату через tj, а координату кандидата — через anj. Составляющая ошибки BC, с которой работает голова, описывает восстановление действия. Она усредняется по кандидатам и координатам:
EBC = (1 / (N·A)) ∑n=0…N−1 ∑j=0…A−1 (an,j − tj)².
В принятом направлении обновления библиотека использует сигнал, противоположный производной минимизируемой ошибки. Для выхода действия получаем:
gn,j = −∂EBC/∂an,j = 2(tj − an,j) / (N·A).
Знак удобно проверить на одной координате. Если выход меньше учительского значения, разность положительна и задаёт направление его увеличения. Если выход больше, направление меняется. Множитель 1/(N·A) относится ко всей сравниваемой матрице. Благодаря этому мы рассматриваем среднюю ошибку пакета, а не сумму, масштаб которой непосредственно растёт с числом строк.
При обучении политики Decoder получает от критика направление изменения действий. Задача этого режима — повысить оценку создаваемых предложений. В контексте B_DECODER_POLICY первые N·A значений относятся к действиям. Следующие 2L значений задают прямой сигнал по общим параметрам распределения. Его добавим после обратного прохода выборки.
bool CNeuronHabiDecoderHeadOCL::calcInputGradients(CNeuronBaseOCL *p,CBufferFloat *ctx,
                                                   CBufferFloat *sg,ENUM_ACTIVATION ac=None)
  {
   int mode;
   uint token;

   if(!frame.Header(ctx,mode,token) || (mode!=23 && mode!=24) ||
      !frame.Backward(ctx,mode==23?A:N*A+2*L))
      return(false);

   if(mode==23)
     {
      if(!Ready(0,N) || !scratch[0].Fill(1) ||
         !HabiPayload(ctx,4,A,GetPointer(scratch[1]),OpenCL) || !Ready(2,N*A) ||
         !MatMul(GetPointer(scratch[0]),GetPointer(scratch[1]),GetPointer(scratch[2]),N,1,A) ||
         !Different(GetPointer(scratch[2]),Output,Gradient,N*A,0,0,0,2.0f/(N*A)))
         return(false);
     }
   else
      if(!HabiPayload(ctx,4,N*A,Gradient,OpenCL))
         return(false);

   return(DeActivation(p.getOutput(),p.getGradient(),Gradient,SIGMOID));
  }
Оба режима используют результаты того прямого прохода, в котором были сформированы действия. Метод frame.Backward проверяет это соответствие по заголовку контекста. Режиму 23 достаточно одного учительского действия из A координат. Режим 24 принимает два готовых сигнала общей длиной N·A + 2L. Такое разделение позволяет передавать эталон и производные через один интерфейс, сохраняя их разное назначение.
При BC метод Different сразу применяет к разности коэффициент 2/(N·A). В режиме политики масштаб сигнала уже задан критиком. В обоих случаях голова получает подготовленное направление изменения действий. Повторное усреднение уменьшило бы его величину ещё раз и изменило бы принятый масштаб обновления.
Обучаемым слоям нужен сигнал по тем величинам, которые они вычисляют. Последний слой сначала получает число u, затем сигмоида преобразует его в координату действия a. Поэтому сигнал по действию ga переводим в сигнал по входу сигмоиды gu. Это делает DeActivation с активацией SIGMOID. Производную можно выразить через уже известное значение действия:
a = 1 / (1 + exp(−u)),
∂a/∂u = a(1 − a),
gu = ga·a(1 − a).
Эта запись задаёт цепное правило. В текущей библиотеке к нему добавлены численные ограничения. Для SIGMOID сумма a + g сначала ограничивается диапазоном [0, 1], затем применяется множитель a(1−a). Итоговый сигнал ограничивается величиной MAX_GRAD. Поэтому он может отличаться от простой аналитической производной.
В следующей записи g обозначает входящий сигнал ga, а clip(x, l, r) — ограничение числа x отрезком [l, r]. Действующий сигнал имеет вид:
g̃ = clip(a + g, 0, 1) − a,
gu = clip(g̃·a(1 − a), −MAX_GRAD, MAX_GRAD).
Сигмоида вычисляется в прямом проходе предыдущего слоя, а её производная учитывается головой при записи в градиент этого слоя. При дальнейшем распространении через свёрточный слой библиотека использует активацию его входного объекта. Такое расположение операций согласуется с передачей уже подготовленного сигнала по логитам — значениям перед сигмоидой последнего слоя.
Подготовка входа критика
Мы сравниваем несколько торговых команд для одной текущей ситуации. Поэтому контекст критика общий для всех кандидатов: средние и логарифмы дисперсий, полученные энкодером. Обозначим этот вектор через c = [μ; ℓ]. Для действия a критик вычисляет Q(c, a). Латентные выборки используются внутри Decoder и отдельно в оценочную модель не передаются.
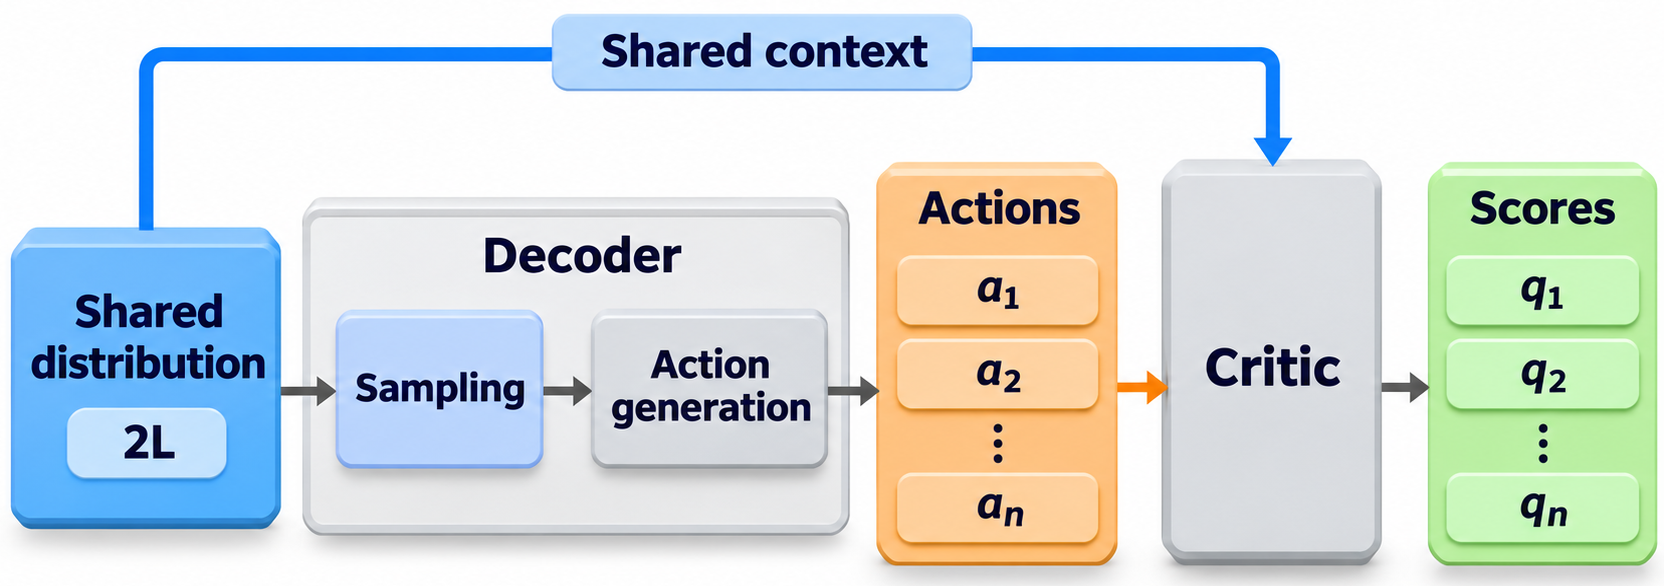
В интерфейсе CNet обычным входным массивом критика служит пакет действий. Вектор c длиной 2L поступает в полезной нагрузке контекста. Слой CNeuronHabiCriticInputOCL присоединяет один и тот же вектор к каждой строке действий.
Каждая выходная строка содержит сначала 2L параметров распределения, затем A координат кандидата. Полный размер выхода равен N·(2L+A). Средние и логарифмы дисперсий повторяются в каждой строке, а координаты берутся из соответствующего действия. Последующие слои обрабатывают эти строки с общими весами.
class CNeuronHabiCriticInputOCL : public CNeuronHabiLeafOCL
  {
public:
   CNeuronHabiCriticInputOCL() { direct_valid=false; }
   virtual int       Type() const override
     {
      return(defNeuronHabiCriticInputOCL);
     }
   bool              DirectGradient(float &v[])
     {
      return(direct_valid && scratch[2].GetData(v)==(int)(2*L));
     }
protected:
   bool direct_valid;
   virtual bool      feedForward(CNeuronBaseOCL *p,CBufferFloat *ctx) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *p,CBufferFloat *ctx,CBufferFloat *sg,
                                        ENUM_ACTIVATION ac=None) override;
  };
Метод DirectGradient возвращает 2L значений из scratch[2]. Это прямой сигнал по общим параметрам распределения. Его доступность отмечает флаг direct_valid, который конструктор устанавливает в false. Сигнал по действиям передаётся через обычный входной слой критика.
Повторение общего вектора возле каждой строки действий выполняет ConcatVecMatrix. В прямом проходе проверим размеры данных и соберём вход оценочной сети.
bool CNeuronHabiCriticInputOCL::feedForward(CNeuronBaseOCL *p,CBufferFloat *ctx)
  {
   direct_valid=false;
   ulong width=2*(ulong)L+A;
   if(!p || N==0 || L==0 || A==0 || width>INT_MAX || N>INT_MAX/width ||
      p.Neurons()!=N*A || Neurons()!=N*width ||
      !frame.Forward(ctx,2*L,bTrain) ||
      (frame.mode!=31 && frame.mode!=35 && frame.mode!=36) ||
      !HabiPayload(ctx,4,2*L,GetPointer(scratch[0]),OpenCL))
      return(false);

   for(int i=0;i<scratch[0].Total();i++)
      if(!MathIsValidNumber(scratch[0].At(i)))
         return(false);

   return(ConcatVecMatrix(GetPointer(scratch[0]),p.getOutput(),Output,2*L,N,A,1,true));
  }
Слой объединяет полный пакет из N действий с одним распределением длиной 2L. Проверки геометрии отсекают несовместимые размеры до запуска объединения. Параметры распределения извлекает HabiPayload. Флаг direct_valid сбрасывается: прямой градиент предыдущего пакета больше не считается готовым результатом.
Во всех трёх режимах вход строится одинаково. F_CRITIC_TRAIN подготавливает обучение критика по числовым целям. F_CRITIC_EVAL выдаёт оценки для сравнения кандидатов. В F_CRITIC_POLICY по оценкам вычисляется сигнал для генератора действий.
Для оценки сохраняем именно тот выход энкодера, из которого Decoder сформировал действия. Если после изменения весов вычислить распределение заново, критик может получить другой контекст для прежнего пакета. Проверка длины буфера этого не обнаружит, поэтому распределение и созданные действия передаются вместе.
В обратном проходе каждая объединённая строка получает сигнал по параметрам распределения и по действию. Координаты действий принадлежат отдельным кандидатам. Параметры распределения общие, поэтому их обратные вклады нужно сложить по всем N строкам.
bool CNeuronHabiCriticInputOCL::calcInputGradients(CNeuronBaseOCL *p,CBufferFloat *ctx,
      CBufferFloat *sg,ENUM_ACTIVATION ac=None)
  {
   direct_valid=false;
   int mode;
   uint token;

   if(!p || !frame.Header(ctx,mode,token) || !frame.Backward(ctx,mode==32?N:(mode==33?3*N:0)) ||
      !Ready(1,N*2*L) ||
      !DeConcat(GetPointer(scratch[1]),p.getGradient(),Gradient,2*L,A,N))
      return(false);

   if(mode!=34)
      return(true);
   if(!Ready(2,2*L) || !Ready(6,2*L))
      return(false);

   int k=def_k_DPCCDenoiserBroadcastGradient;

   setBuffer(k,0,scratch[1].GetIndex())
   setBuffer(k,1,scratch[2].GetIndex())
   setBuffer(k,2,scratch[6].GetIndex())
   setArgument(k,3,(int)N)
   setArgument(k,4,(int)(2*L))

   uint off[]={0};
   uint size[]={2*L};

   kernelExecute(k,off,size)

   direct_valid=Finite(2*L);
   return(direct_valid);
  }
В режимах Монте-Карло (MC) и временной разности (TD) обратный проход обучает оценочную функцию критика. В режиме политики он готовит сигнал для генератора. Метод frame.Backward связывает выбранный режим с ранее выполненным прямым проходом.
DeConcat разделяет строку обратного сигнала в том же месте, где ранее были объединены входы. Часть по действиям сохраняет N строк: изменение одного кандидата относится к его координатам. Вклады по общему распределению пока образуют матрицу N×2L. Для MC и TD метод на этом завершается.
В режиме политики каждый параметр распределения входит в контекст всех кандидатов. Поэтому DPCCDenoiserBroadcastGradient суммирует каждую координату по N строкам. Результат длиной 2L становится доступен через DirectGradient после проверки флагов вычисления методом Finite. Готовность отмечается через direct_valid. Следующий прямой или обратный проход сначала сбрасывает этот флаг.
Сигнал по действиям содержит N·A значений, а прямой сигнал по распределению — 2L. Суммирование контекстных вкладов не требует повторного усреднения: начальный масштаб уже задан головой критика. Finite проверяет флаги редукции. Она не обнаружит нечисловые значения, которые DeConcat ранее заменил нулями.
Оценка кандидатов и обучающий сигнал CriticHead
Преобразующие слои критика сводят каждую пару (c, an) к одному числу qn. Оно оценивает денежный результат команды в контексте распределения. Горизонт и дисконтирование результата задаются целями, на которых обучается критик.
Денежные цели готовятся вне CriticHead, а слой получает готовые значения. Историческая оценка использует Bid/Ask, поэтому учитывает спред. В текущем профиле на базе котировок терминала отдельные комиссии и свопы к виртуальным исходам не прибавляются. Онлайн-награда использует журнал реальных сделок с учётом прибыли, свопа, комиссии и сборов. Подробную подготовку данных разберём при обучении.
Класс CNeuronHabiCriticHeadOCL наследует тот же базовый объект листового слоя. Дополнительным состоянием становится коэффициент дисконтирования gamma. Он нужен для построения TD-цели, в которой будущая оценка добавляется к текущей награде.
class CNeuronHabiCriticHeadOCL : public CNeuronHabiLeafOCL
  {
public:
                     CNeuronHabiCriticHeadOCL()
     {
      gamma=.5f;
     }
   virtual int       Type() const override
     {
      return(defNeuronHabiCriticHeadOCL);
     }
   bool              Discount(float v);
   virtual bool      Save(const int h) override;
   virtual bool      Load(const int h) override;
protected:
   float             gamma;
   virtual bool      feedForward(CNeuronBaseOCL *p,CBufferFloat *ctx) override
     {
      return(frame.Forward(ctx,2*L,bTrain) && (frame.mode==31 || frame.mode==35 ||
             frame.mode==36) && Pass(p));
     }
   virtual bool      calcInputGradients(CNeuronBaseOCL *p,CBufferFloat *ctx,CBufferFloat *sg,
                                        ENUM_ACTIVATION ac=None) override;
  };
Конструктор задаёт γ = 0,5. Это стартовый коэффициент из текущего профиля DiscountGamma, а не универсально рекомендуемое значение. Он быстро уменьшает влияние продолжения: за два бара множитель составляет 0,25. Рабочий коэффициент задаётся методом Discount; его фактическое значение должно фиксироваться в параметрах будущего эксперимента.
В прямом проходе голова принимает те же три режима, что и входной объект критика. Она ожидает контекст с 2L параметрами распределения, хотя непосредственно в Pass они не участвуют. Вход и выход сети проверяют общий контекст по одному интерфейсу.
Голова переносит выход предыдущего слоя без преобразования и сохраняет знак оценки. Для денежного результата нужны как положительные, так и отрицательные значения. Поэтому здесь используется числовой выход без дополнительной сигмоиды. Зависимость оценки от контекста и команды формируют обучаемые слои перед головой.
Чтобы сравнивать торговые команды, критик должен связать каждую из них с оценкой денежного результата. На исторических данных можно рассчитать последствия действия и передать готовую цель MC. В TD текущая награда дополняется оценкой продолжения на следующем наблюдении. Эти два режима обучают самого критика. В режиме POLICY его параметры фиксируются, а рассчитанный сигнал используется для изменения генератора действий.
Общая регрессионная ошибка для первых двух режимов записывается одинаково:
EQ = (1/N) ∑n=0…N−1 (qn − yn)².
Здесь yn — целевая оценка кандидата. Усреднение выполняется по N скалярным выходам. Размерность действия A в знаменатель не входит: критик сравнивает одно число с одной целью для каждой строки. Это отличается от ошибки воспроизведения действия, в которой сравнивались все его координаты.
Соответствующий исходный сигнал имеет вид:
gn = 2(yn − qn) / N.
При недооценке цели разность положительна и направляет оценку вверх. При завышенной оценке сигнал отрицателен. Как и при BC, используется отрицательная производная минимизируемой ошибки.
Формирование начального сигнала вынесено в кернел HabiCriticSeed. Каждый рабочий элемент обслуживает одну строку. MC получает готовое y; TD вычисляет его из трёх блоков контекста; политика использует постоянный положительный сигнал 1/N.
__kernel void HabiCriticSeed(__global const float *q, __global const float *ctx,
                            __global float *gradient, __global float *flags,
                            int N, int mode, float gamma)
  {
   int n=get_global_id(0); float y=0;
   if(mode==32) y=ctx[4+n];
   if(mode==33) y=ctx[4+n]+gamma*(1.0f-ctx[4+N+n])*ctx[4+2*N+n];
   float g=mode==34 ? 1.0f/N : 2.0f*(y-q[n])/N;
   gradient[n]=g; flags[n]=(!isfinite(g)||!isfinite(q[n]));
  }
В режиме B_CRITIC_MC голова получает N готовых скалярных целей в валюте счёта. Каждая цель — сумма денежных изменений по H будущим барам с множителями γ^h и однократным штрафом за установленную экономическую недопустимость. В текущем профиле H = 24. Цель передаётся отдельно для каждого исходного действия.
Все достоверно рассчитанные исходы участвуют с равным весом, включая отрицательные, нулевые, FLAT и экономически недопустимые. Убыточные команды нужны критику так же, как прибыльные: по ним он учится различать последствия действий. Если хотя бы одну цель нельзя достоверно рассчитать, пакет не передаётся в обучение. Неизвестный результат не заменяется нулевой целью.
Учительское действие содержит шесть координат для воспроизведения поведения. MC-цель — один скаляр для действия в контексте общего распределения. Даже на одной истории эти данные обучают разные выходы и передаются через разные режимы.
В режиме B_CRITIC_TD текущую награду дополняем оценкой дальнейшего результата. Так учитываем последствия за пределами рассматриваемого перехода. Для завершённого эпизода продолжения уже нет. Голова получает три последовательных массива: награды, признаки завершения и оценки продолжения. Для кандидата n целевое число строится следующим образом:
yn = rn + γ(1 − dn)bn.
Здесь rn — награда за рассматриваемый переход, dn — его признак завершения, а bn — переданная оценка продолжения. При d = 1 будущая составляющая исключается и цель равна текущей награде. При d = 0 к ней добавляется дисконтированное продолжение.
Признак завершения допускает только точные значения 0 и 1. Голова проверяет их до запуска кернела. Маска задаёт два состояния: продолжение либо участвует в цели, либо исключается. Она не выражает вероятность завершения.
Для числовой иллюстрации возьмём награду 2, коэффициент дисконтирования 0,5 и продолжение 6. У незавершённого перехода целевая оценка составит 5. У завершённого она останется равной 2. Разница возникает только за счёт множителя 1−d; само значение продолжения во второй ситуации не должно влиять на результат.
До обновления текущего критика продолжение рассчитывается целевыми моделями TargetPrior, TargetDecoder и TargetCritic на следующем наблюдении. Максимальная оценка следующего пакета передаётся во все позиции третьего массива. Она фиксируется для текущего обновления; обратный проход через целевые модели не выполняется. Одинаковые номера строк соседних пакетов не означают одну и ту же траекторию кандидата. Голова получает готовое продолжение и сама не ищет максимум.
Признак d = 1 означает известную границу эпизода, а не обычное закрытие позиции по TP/SL. При продолжающемся эпизоде d = 0, и TD-цель учитывает следующую оценку. Пока награда или следующий снимок недостоверны, запись не передаётся в обучение. Подробности формирования переходов рассмотрим в следующей части.
Политика определяет, как модели формируют торговые действия по текущему наблюдению. В режиме B_CRITIC_POLICY критик передаёт сигнал для её обучения. Цель — повысить среднее значение Q по сформированному пакету:
J = (1/N) ∑n=0…N−1 Q(c, an), Epolicy = −J.
Производная этой суммы по каждому выходу равна 1/N. Для направления повышения J каждому выходу задаётся одинаковый положительный сигнал. Далее веса и нелинейности критика преобразуют его в сигналы по действию и параметрам распределения.
Средняя оценка пакета и максимум среди кандидатов решают разные задачи. Максимум используется при выборе одного действия или подготовке продолжения TD-цели. При обучении политики сигнал получают все кандидаты: каждый входит в среднюю оценку с весом 1/N. Если заменить эту цель максимумом, изменится и обратный проход. Одинаковый сигнал для всех строк уже не будет соответствовать выбранной цели.
Во время обучения политики функция Q(c, a) должна оставаться одной и той же. Поэтому параметры критика фиксируются, но обратный расчёт выполняется: он показывает, как изменить действие и общее распределение, чтобы повысить оценку. В коде управления моделями обновление весов отделено от вычисления производных по входам. Так улучшение ищется через изменение предложений генератора; иначе критик мог бы повысить собственные ответы на прежних входах.
Во всех трёх режимах голова готовит по одному сигналу для каждого выхода критика. При MC и TD он направляет оценку к цели, а при POLICY задаёт направление её повышения. Метод calcInputGradients выбирает соответствующий расчёт, проверяет результат и передаёт сигнал предыдущему слою.
bool CNeuronHabiCriticHeadOCL::calcInputGradients(CNeuronBaseOCL *p,CBufferFloat *ctx,
                                                  CBufferFloat *sg,ENUM_ACTIVATION ac=None)
  {
   int mode;
   uint token;

   if(!frame.Header(ctx,mode,token) || (mode!=32 && mode!=33 && mode!=34) ||
      !frame.Backward(ctx,mode==32?N:(mode==33?3*N:0)) || !Ready(6,N))
      return(false);

   if(mode==33)
      for(uint i=0;i<N;i++)
         if(ctx.At(4+N+i)!=0 && ctx.At(4+N+i)!=1)
            return(false);

   int k=def_k_HabiCriticSeed;

   setBuffer(k,0,Output.GetIndex())
   setBuffer(k,1,ctx.GetIndex())
   setBuffer(k,2,Gradient.GetIndex())
   setBuffer(k,3,scratch[6].GetIndex())
   setArgument(k,4,(int)N)
   setArgument(k,5,mode)
   setArgument(k,6,gamma)

   uint off[]= {0};
   uint sz[]= {N};

   kernelExecute(k,off,sz)

   return(Finite(N) && DeActivation(p.getOutput(),p.getGradient(),Gradient,None));
  }
Здесь явно допускаются режимы 32, 33 и 34. Длина нагрузки выбирается по назначению прохода: N значений для MC, 3·N для TD и ноль для политики. Нулевая нагрузка политики не отменяет заголовок: режим и идентификатор всё равно нужны для сопоставления прямого и обратного проходов.
Каждый рабочий элемент кернела обслуживает одного кандидата, поэтому глобальный размер равен N. Все строки обрабатываются за один запуск со стороны MQL5. В режимах MC и TD сигнал строки определяется её оценкой и относящимися к ней целевыми данными.
После исполнения вызывается Finite, проверяющий массив флагов. Только успешная проверка позволяет продолжить передачу через DeActivation. Указанное значение None означает отсутствие производной нелинейной активации, но общий библиотечный вызов всё равно ограничивает градиент по MAX_GRAD.
Формулы задают исходное направление и нормировку сигнала. В буфер предыдущего слоя поступает результат после численных ограничений библиотеки.
Коэффициент дисконтирования влияет на смысл TD-цели, поэтому его значение проверяется при настройке и восстанавливается вместе с состоянием головы. Метод Discount допускает конечные значения от нуля до единицы включительно.
bool CNeuronHabiCriticHeadOCL::Discount(float v)
  {
   if(!MathIsValidNumber(v) || v<0 || v>1)
      return(false);

   gamma=v;

   return(true);
  }
При нулевом коэффициенте будущее не участвует в TD-цели. При единице оно добавляется без уменьшения. Значения внутри интервала задают промежуточное влияние. Для MC-режима голова получает готовую цель, поэтому локальное значение gamma уже не пересчитывает её содержимое. Дисконтирование MC-целей выполняется при их подготовке.
После загрузки модели правило построения TD-целей должно остаться прежним. Поэтому вместе с общим состоянием нейронного слоя сохраняем коэффициент дисконтирования. В Save он записывается после успешного сохранения базовой части.
bool CNeuronHabiCriticHeadOCL::Save(const int h)
  {
   if(!CNeuronHabiLeafOCL::Save(h))
      return(false);

   dFileWriteFloat(h,gamma)

   return(true);
  }
При загрузке коэффициент восстанавливается после базового состояния и проверяется через Discount. Поэтому допустимый диапазон параметра одинаков при настройке новой модели и восстановлении сохранённой.
bool CNeuronHabiCriticHeadOCL::Load(const int h)
  {
   if(!CNeuronHabiLeafOCL::Load(h))
      return(false);

   float stored=0;

   dFileReadUFloat(h,stored)

   return(Discount(stored));
  }
Эти методы дополняют сериализацию геометрии и базового состояния. Для DecoderHead и CriticInput отдельные методы сохранения не понадобились: дополнительных сохраняемых настроек у них нет. Прямой градиент и флаг его готовности относятся к текущему вычислению. Для дальнейшего обучения нужен новый корректный проход.
Возвращение сигнала к латентному распределению
Обозначим через D преобразующую часть Decoder после слоя выборки. Из общего вектора c и случайных значений получаем z, затем действие a = D(z). Критик оценивает Q(c, D(z)). Поэтому параметры распределения влияют на оценку непосредственно и через созданное действие.
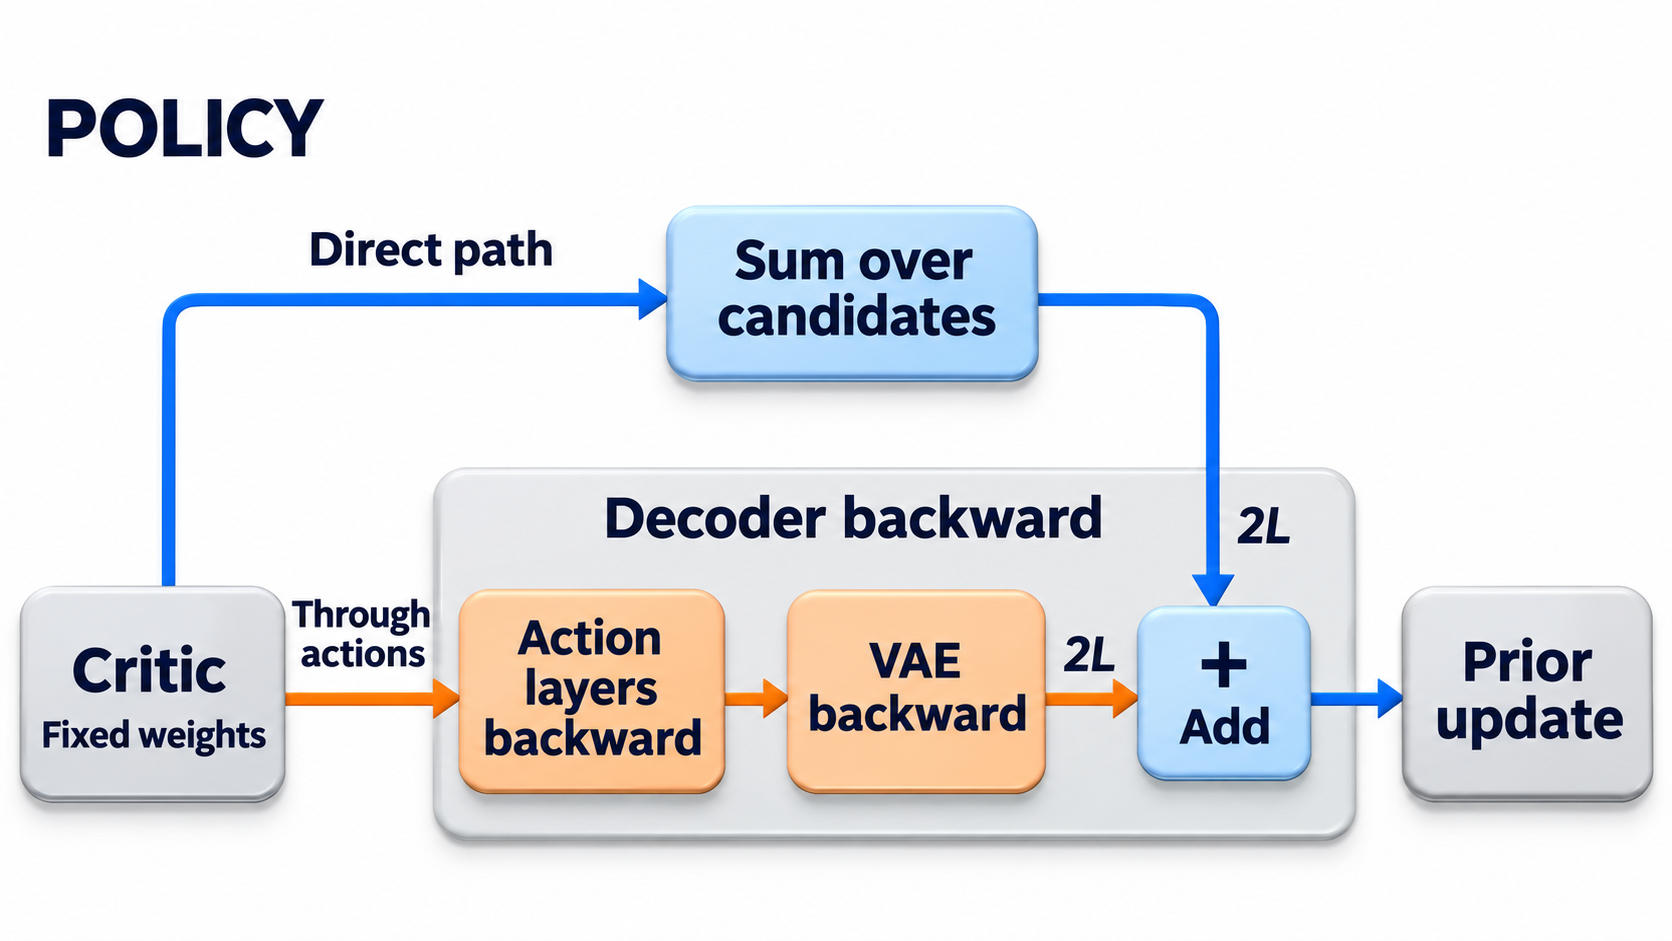
При фиксированных случайных значениях запишем выборку как z(c). Для одного кандидата до применения численных ограничений цепное правило даёт:
∇c Q(c, D(z(c))) = ∂Q/∂c + (∂z/∂c)ᵀ·(∂D/∂z)ᵀ·∂Q/∂a.
Первое слагаемое показывает, как меняется оценка при изменении распределения и неизменном действии. Во втором произведение производных описывает обратный путь: от координат действия к латентному вектору, затем к параметрам распределения. Знак ᵀ обозначает транспонирование матрицы — обмен строк и столбцов. Оно согласует размерности при передаче сигнала назад по этой цепочке. Оба пути относятся к одной оценке, поэтому при возврате к общему источнику их вклады складываются.
CriticInput раздельно возвращает сигналы по своим входам. Часть по действиям извлекается из градиента обычного входа критика. Прямую часть по распределению получаем через DirectGradient. В обратный контекст Decoder записываем сначала N·A значений по действиям, затем 2L значений по распределению.
Складывать эти массивы напрямую нельзя: они относятся к разным величинам. Сигнал по действиям должен пройти через преобразующие слои Decoder, а затем через обратную операцию выборки. Только тогда он будет относиться к тем же средним и логарифмам дисперсий, что и прямой сигнал.
Выходная голова читает первую часть контекста и запускает путь через действия. Прямой сигнал сохраняется до получения входного градиента Decoder. Обе составляющие в этой точке имеют длину 2L. Случайные значения и промежуточные результаты берём из того прохода, который породил оцениваемые действия.
В методе CNeuronHabiVAEOCL::calcInputGradients сначала выполняется обратный кернел выборки. Он собирает сигналы от N латентных строк в градиенты общих средних и логарифмов дисперсий. После этого к ним можно добавить прямой сигнал критика, относящийся к тем же параметрам.
   int k=def_k_VAECalcHiddenGradient;

   setBuffer(k,0,p.getOutputIndex())
   setBuffer(k,1,p.getGradientIndex())
   setBuffer(k,2,m_cRandom.GetIndex())
   setBuffer(k,3,Gradient.GetIndex())
   setArgument(k,4,0.0f)

   uint off[]= {0,0};
   uint sz[]= {L,N};
   uint local[]= {1,N};

   kernelExecuteLoc(k,off,sz,local)

   if(mode!=B_DECODER_POLICY)
      return(true);

   CBufferFloat *input_gradient=p.getGradient();
   if(!HabiPayload(ctx,4+N*6,2*L,GetPointer(direct),OpenCL) ||
      !HabiScratch(GetPointer(flags),OpenCL,2*L) ||
      !SumAndNormalize(input_gradient,GetPointer(direct),input_gradient,2*L,
                       false,0,0,0,1,GetPointer(flags)) || !flags.BufferRead())
      return(false);

   for(int i=0;i<flags.Total();i++)
      if(flags.At(i)!=0)
         return(false);

   return(true);
После обратной выборки входной градиент Decoder содержит 2L значений по общим параметрам распределения. Для BC этого достаточно. В режиме POLICY метод HabiPayload читает прямой сигнал критика после N·6 градиентов действий. Число 6 соответствует фиксированному Action6; две составляющие суммируются после репараметризации.
Теперь обе составляющие относятся к одному вектору и складываются через SumAndNormalize. Нормализация отключена, множитель равен 1: дополнительное деление на число кандидатов изменило бы уже заданный масштаб сигнала. Проверяемая перегрузка записывает флаги вычисления. При ненулевом флаге метод возвращает отказ.
Прямой сигнал уже выражен по параметрам распределения. Если добавить его к латентному градиенту до обратной выборки, он пройдёт лишнее преобразование и получит неверный смысл. Поэтому сумма формируется после кернела, когда обе составляющие относятся к одному вектору [μ; ℓ].
Полученный массив 2L возвращается к Prior без добавления KL. Слой Gaussian один раз переводит сигнал по логарифму дисперсии в сигнал по исходному параметру масштаба. Повторная выборка перед этим обновлением изменила бы зависимость, производную которой мы вычисляем.
В режиме поведенческого клонирования сигнала от критика нет. Ошибка восстановления проходит через Decoder и выборку к Posterior. Рассмотренный ранее слой Gaussian добавляет KL-сигнал с заданным весом. Prior в этой фазе получает только KL. Новая ветвь сложения включается исключительно для B_DECODER_POLICY.
Обратный проход использует промежуточные значения того расчёта, который сформировал оцениваемые действия. Для связи этих двух стадий служит SHabiFrame. Его сохранённое состояние называем кадром вычисления. Заголовок контекста содержит версию формата, режим и идентификатор. По идентификатору сопоставляются прямое вычисление и его обратная часть, а по режиму определяется назначение переданных данных.
После принятия обратного прохода сохранённый кадр закрывается. Для следующего обучающего шага нужно заново подготовить состояние прохода. Это правило действует и при отказе одной из последующих операций: прежнее состояние автоматически не восстанавливается.
Заключение
В этой статье подготовили слои для обучения и оценки торговых действий. При поведенческом клонировании Decoder приближает свои предложения к действию учителя. Critic получает отдельную задачу: связать каждое предложение с денежным результатом. Для этого используются готовые исторические цели MC или TD-цели, объединяющие текущую награду с оценкой продолжения.
При обучении политики критик задаёт направление изменения генератора. Все кандидаты оцениваются в контексте одного распределения. Его параметры влияют на оценку напрямую и через сформированные действия, поэтому учитываются оба пути обратного сигнала. Они объединяются после обратного прохода выборки и передаются Prior. Учитель задаёт образец действия, критик учится оценивать последствия, а генератор получает сигнал для улучшения предложений.
В следующей части соберём модели и подготовим причинные исторические наблюдения. Сначала выполним офлайн-обучение Decoder по эталонам Oracul с согласованием Prior и Posterior. Затем обучим Critic на денежных исходах всех кандидатов. Онлайн-этап объединит TD-обновления и обратный сигнал от критика к политике. Торговую проверку проведём на данных вне обучения: сравним финансовый результат, просадку, качество сделок и работу защитных ограничений. Это задачи следующего этапа, а не результаты текущей статьи.
Ссылки
- Habitizing Diffusion Planning for Efficient and Effective Decision Making.
- Другие статьи серии "Нейросети в трейдинге".
Файлы проекта
В таблице перечислены файлы полного проекта. Обучающие программы будут рассмотрены далее.
| # | Имя | Тип | Описание |
|---|---|---|---|
| 1 | Trajectory.mqh | Общий модуль | Подключение модулей моделей, истории и исполнения; общий запуск |
| 2 | Study.mq5 | Советник | Советник предварительного офлайн-обучения |
| 3 | StudyOnline.mq5 | Советник | Советник тонкой онлайн-настройки |
| 4 | Test.mq5 | Советник | Исполнение торговой политики с фиксированными весами |
| 5 | NeuroNet.mqh | Библиотека классов | Подключение модулей нейронной библиотеки |
| 6 | NeuroNet.cl | OpenCL-программа | Вычислительные кернелы нейронной библиотеки |
| 7 | NeuroNet_Habi.mqh | Библиотека классов | Базовый слой и компоненты Habi, рассматриваемые в статье |
Репозиторий проекта: NN_in_Trading.
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.
 Каналы линейной регрессии на MQL5: Построение статистически обоснованных доверительных и прогнозных полос
 Возможности Мастера MQL5, которые вам нужно знать (Часть 99): Использование KD-дерева и эхо-сети (ESN) в пользовательском классе управления капиталом
 Создание индикатора EquiVolume на языке MQL5
 Архитектура машинного обучения в MetaTrader 5 (Часть 18): Исправленный последовательный бутстрэп — клонирование, стирание типа и инструментарий сравнения

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования