

Нейросети в трейдинге: Диффузионная генерация торговых планов (Окончание)
 78
 0

Введение
Отдельное торговое действие может выглядеть привлекательным, но последовательность таких решений способна привести к нехватке маржи и глубокой просадке. Поэтому при построении торговой политики необходимо оценивать не только следующую сделку, но и возможные изменения состояния счёта.
В серии статей по DPCC рассматриваем планирование на несколько шагов. Модель формирует последовательности действий. В режимах с коррекцией финансовый расчётчик проверяет их по ценовым сценариям, а проектор ищет локальные поправки. Изменяются торговые действия, а не прогнозируемые цены.
В предыдущих частях мы подготовили OpenCL-примитивы, сценарный расчётчик, проектор и диффузионный генератор. Теперь включим эти компоненты в торговую модель на основе нашей адаптации фреймворка AC-SRM. Рыночный энкодер и распределительные критики сохраняем. Непосредственное формирование действия заменяем диффузионным планированием. Для финансовой проверки добавим декодер ценовых траекторий.
Если допустимый план не найден, система задаёт нулевую целевую позицию и направляет операции для выхода из рынка. Это защитное решение, а не команда удерживать прежнюю позицию. Его исполнение зависит от торговых условий и не исключает издержек закрытия.
Рассмотрим архитектуру моделей, подготовку исторических планов и последовательное обучение торговой политики. Основной результат статьи — реализация этого вычислительного маршрута. Порядок запуска и параметры этапов приведены в пресетах приложения.
Архитектура торговой модели
Основу заимствуем из нашей торговой адаптации AC-SRM на MQL5 и OpenCL. Её устройство представлено в заключительной статье серии AC-SRM. Энкодер рыночного состояния содержит входной слой, нормализацию, Dropout, CNeuronCogDriverData, CNeuronCogDriverRankTCM, CNeuronOMPBOCL и CNeuronScenarioForecast. Критики включают сценарное внимание и распределительную голову CNeuronACSRM. Повторно разбирать эти компоненты не будем. Остановимся на изменениях и новой архитектуре Актёра.
Для работы CNeuronScenarioRolloutOCL нужны прогнозные Open, High, Low и Close на всём горизонте плана. Этот класс мы рассмотрели в третьей статье. Сценарный прогноз AC-SRM предоставляет латентные признаки Z, неопределённость U и вероятности Pi. В программных интерфейсах неопределённость представлена через LogU. Этих данных достаточно для внимания, но не для непосредственного расчёта маржи, стоимости позиции и срабатывания защитных уровней.
Поэтому создаём наследника CNeuronScenarioForecastPriceOCL от CNeuronScenarioForecast. Он сохраняет структуру сценарного прогноза и поддерживает совместное обучение с новым CNeuronScenarioDecoderOCL. Декодер преобразует латентные сценарии в ценовые траектории. В DPCCCreateStudyForecastGraphs соответствующие слои описаны следующим образом:
if(ok)
  {
   d = DPCCStudyForecastLayer(price_head ? defNeuronScenarioForecastPriceOCL : defNeuronScenarioForecast, 21);
   if(d)
     {
      d.variables = 5;
      d.window = 16;
      d.window_out = 12;
      d.layers = 9;
     }
   ok = DPCCStudyForecastAdd(market, d);
  }
if(ok && price_head)
  {
   d = DPCCStudyForecastLayer(defNeuronScenarioDecoderOCL, 21 * 12 * 4);
   if(d)
     {
      d.window = 9 * 16;
      d.window_out = 64;
      d.layers = 2;
      d.step = 1;
      d.variables = 1;
      d.batch = 1;
      uint units[] = {21, 9, 12, 16, 64, defScenarioDecoderPriceABI};
      if(ArrayCopy(d.units, units) != 6)
        {
         delete d;
         d = NULL;
        }
     }
   ok = DPCCStudyForecastAdd(market, d);
  }
Параметры сохраняются: 21 сценарий, девять каналов, горизонт 12 шагов и латентная размерность 16. При включении ценовой ветви восьмым слоем становится CNeuronScenarioDecoderOCL. Это самостоятельный декодер OHLC, а не вспомогательный Forecast Decoder из базового описания энкодера.
Декодер состоит из двух обучаемых аффинных преобразований. Для каждого сценария и прогнозного шага девять латентных векторов объединяются в 144 значения. Первое преобразование сокращает их до 64. После TANH второе возвращает четыре параметра. Эти объекты создаются в CNeuronScenarioDecoderOCL::Allocate:
if(!m_first.Init(0, 0, OpenCL, m_width, m_width, hidden, m_tokens, 1, ADAM, iBatch))
   return(Fail(DPCC_OPENCL_ERROR, true));
if(!m_last.Init(0, 1, OpenCL, hidden, hidden, 4, m_tokens, 1, ADAM, iBatch))
   return(Fail(DPCC_OPENCL_ERROR, true));
Четыре выхода ещё не являются независимыми абсолютными ценами. Метод DecodePricePath через кернел DPCCDecoderPricePath восстанавливает нормализованную траекторию. Затем BuildNativeScenarios переводит её в физические цены по сохранённым параметрам нормализации и точности котирования. Получаем K × H × 4, или 1008 значений. Основной рыночный энкодер при этом не меняется.
Архитектуру Q1 и Q2 сохраняем из AC-SRM. На вход каждого критика поступают 13 признаков состояния счёта и шесть параметров действия. Далее следуют сценарное внимание, свёрточное преобразование с GELU, полносвязный слой из 32 элементов и CNeuronACSRM. Устройство FQF и спектральной оценки рассмотрено в статье об объекте верхнего уровня AC-SRM.
Точечное изменение — замена CNeuronScenarioCrossAttention наследником CNeuronScenarioCrossAttentionPriceOCL. Он поддерживает новый тип прогноза без изменения основной математики внимания. В DPCCCreateAction6CriticNet сохраняются пять слоёв:
const uint types[] = {defNeuronBaseOCL, defNeuronScenarioCrossAttentionPriceOCL,
                      defNeuronConvOCL, defNeuronBaseOCL, defNeuronACSRM
                     };
const uint counts[] = {19, forecast.Scenarios(), 1, 32, 1};
Q1 и Q2 имеют одинаковую архитектуру, но независимые веса. Повторное использование вычислительной схемы не означает автоматического переноса ранее обученных параметров.
Основное изменение касается Actor. В AC-SRM входной слой, сценарное внимание и два свёрточных преобразования непосредственно формировали Action6. Теперь внешняя сеть содержит вход из 13 элементов и составной CNeuronDPCCOCL. Метод DPCCCreateAction6ActorNet задаёт следующую конфигурацию:
if(!DPCCSetLayerBaseDefaults(input_layer, defNeuronBaseOCL, 13, 1))
  {
   delete input_layer;
   delete model;
   reason = "model.action6.input_defaults";
   return(false);
  }
if(!DPCCSetLayerBaseDefaults(model, defNeuronDPCCOCL, 6, 1))
  {
   delete input_layer;
   delete model;
   reason = "model.action6.layer_defaults";
   return(false);
  }
model.window = 6;
model.window_out = shape.Embedding;
model.layers = shape.J;
model.step = 1;
model.variables = 1;
Внешний выход сохраняет шесть параметров действия. Базовая геометрия задана в DPCCBuildAction6RuntimeFromInputs файла Trajectory.mqh:
config.shape.K = 21;
config.shape.V = 9;
config.shape.H = 12;
config.shape.D = 4;
config.shape.M = 16;
config.shape.J = 32;
config.shape.E = DPCC_HISTORY_CALENDAR_MIN_EVENTS;
config.shape.PlanBatch = config.shape.M;
config.shape.NActions = 6;
config.shape.StateSize = 13;
config.shape.Embedding = 16;
config.shape.Heads = 1;
config.shape.KeyDimension = 16;
config.shape.Depth = 0;
Здесь H = 12, M = 16, J = 32, Embedding = 16 и Heads = 1. Тензор M × H × 6 содержит 1152 значения. Горизонт, 21 сценарий, девять каналов и ширина 16 сохранены из AC-SRM. M и J фиксированы в этой реализации.
Обучаемую часть составляет CNeuronPlanDenoiserOCL. Он наследуется от CNeuronUShapeAttention, но имеет специальный кадровый режим обработки планов. При инициализации CNeuronDPCCOCL создаём денойзер и задаём его геометрию:
m_denoiser = new CNeuronPlanDenoiserOCL();
if(!m_denoiser)
   return(Fail(DPCC_OPENCL_ERROR, true));
m_denoiser.AttachOpenCL(context);
if(!m_denoiser.InitFrameShape(m_shape.H, m_shape.M, 6, m_shape.Embedding, m_shape.Heads, m_shape.J))
   return(Fail(DPCC_CONTRACT_MISMATCH, true));
Денойзер имеет U-образную структуру с двумя временными разрешениями. В ней используется 21 обучаемое аффинное преобразование. Веса общие для кандидатов и обратных шагов. Отдельно сохраняются промежуточные результаты каждого кадра, необходимые для обучения.
Подготовка контекста. Первые 109 полей условия состоят из 13 признаков счёта, 24 полей его физического состояния, 48 параметров инструмента и 24 ограничений. Это размер интерфейса, а не подобранный гиперпараметр. Разбиение видно в кернеле DPCCAction6PackCondition файла NeuroNet.cl:
if(i>=condition_count)return;
const uint tokens=K*V*Hm, token_width=D+1, token_values=tokens*token_width;
float value=0.0f; uint error=0;
if(i<13) value=account13[i];
else if(i<37) value=physical[account_offset+i-13];
else if(i<85) value=physical[instrument_offset+i-37];
else if(i<109) value=physical[limits_offset+i-85];
Для этих полей DPCCDenoiserFrameCondition вычитает смещение и делит результат на положительный масштаб:
const float raw = source[n];
if(!isfinite(raw))
   error = DPCC_STATUS_NUMERIC;
if(n < 109)
  {
   const float bias = profile[n], scale = profile[109 + n];
   if(!isfinite(bias) || !isfinite(scale) || scale <= 0.0f)
      error = DPCC_STATUS_INVALID;
   const float value = (raw - bias) / scale;
   if(!isfinite(value))
      error = DPCC_STATUS_NUMERIC;
   account[n] = error == 0 ? value : 0.0f;
  }
Коэффициенты bias и scale загружаются из сохранённого профиля нормирования по обучающей выборке. После нормирования контекст проецируется в 16 элементов. Признаки Z и LogU обрабатываются отдельно; Pi задаёт веса сценариев. Эти массивы не входят в число 109.
Входное преобразование. Каждый Action6 переводится в пространство размерности 16. К нему добавляются контекст, кодировка шага диффузии и позиционное кодирование действия на горизонте. Результат имеет форму M × H × 16. Кодировка времени сделки и кодировка шага уточнения выполняют разные функции.
Первый уровень Self-Attention. На полной длине H строятся Query, Key и Value. Внимание связывает действия внутри одного плана. Затем блок обработки признаков расширяет скрытую размерность с 16 до 32, применяет TANH и возвращает 16 элементов. Остаточная связь добавляет вход блока к результату преобразования.
Сокращение горизонта. Соседние шаги группируются попарно. Длина становится (H + 1) / 2 при целочисленном делении: для H = 12 это шесть элементов. Объединённые признаки проецируются обратно в ширину 16. Второй уровень Self-Attention работает с этой укрупнённой последовательностью. За ним следует аналогичный нелинейный блок с остаточной связью.
Восстановление и выход. Представление расширяется с 16 до 32 элементов и разворачивается к исходной длине H. Добавляются сохранённые признаки первого уровня. После TANH завершающее преобразование 16 → 6 возвращает оценку шумовой составляющей каждого действия.
Проследим эти операции в CNeuronPlanDenoiserOCL::FrameForward. Первый вызов FrameSelf выполняет внимание на полной длине. После нелинейного блока первого уровня с остаточной связью метод FramePair уменьшает горизонт. Второй вызов FrameSelf обрабатывает сокращённую последовательность:
if(!FrameSelf(0, 4, 6, m_frame_horizon, 5, 10))
   return(false);
if(!FrameAffine(10, FrameTape(slot, 10)))
   return(false);
if(!FrameActivate(m_frame_affine[10].getOutput(), FrameTape(slot, 11), TANH))
   return(false);
if(!FrameAffine(11, FrameTape(slot, 11)))
   return(false);
if(!FrameSum(FrameTape(slot, 10), m_frame_affine[11].getOutput(), FrameTape(slot, 12)))
   return(false);
if(!FramePair(FrameTape(slot, 12), FrameTape(slot, 13), 0))
   return(false);
if(!FrameAffine(12, FrameTape(slot, 13)))
   return(false);
if(!FrameSelf(1, 34, 13, (m_frame_horizon + 1) / 2, 14, 19))
   return(false);
Восстановление длины и добавление сохранённых признаков выполняются в продолжении метода:
if(!FrameAffine(19, FrameTape(slot, 21)))
   return(false);
if(!FramePair(m_frame_affine[19].getOutput(), FrameTape(slot, 22), 1))
   return(false);
//--- D6 applies TANH after its saved skip sum and publishes epsilon only after admission.
if(!FrameSum(FrameTape(slot, 22), FrameTape(slot, 12), FrameTape(slot, 23)))
   return(false);
if(!FrameActivate(FrameTape(slot, 23), FrameTape(slot, 24), TANH))
   return(false);
if(!FrameAffine(20, FrameTape(slot, 24)))
   return(false);
Денойзер возвращает оценку шума, а обратный шаг выполняет CNeuronDPCCOCL. Его вычислительная схема рассмотрена в четвёртой статье.
В состав Актёра входят также CNeuronScenarioRolloutOCL и CNeuronPlanProjectionTraceOCL. Первый рассчитывает финансовые последствия плана. Второй наследует CNeuronPlanProjectionOCL и сохраняет трассу локальной коррекции для обратного прохода. Основа поиска поправок представлена во второй статье. Объекты создаются в CNeuronDPCCOCL::Configure:
m_rollout = new CNeuronScenarioRolloutOCL();
m_actor_projector = new CNeuronPlanProjectionTraceOCL();
if(!m_rollout || !m_actor_projector)
  {
   PrintFormat("DPCC_ACTION6_CONFIG_FAIL stage=child_allocation rollout=%d projector=%d",
               CheckPointer(m_rollout)!=POINTER_INVALID,CheckPointer(m_actor_projector)!=POINTER_INVALID);
   return(Fail(DPCC_OPENCL_ERROR, true));
  }
Расчётчик и проектор не обучаются: они применяют финансовую модель и правила коррекции к предложениям денойзера. Сохраняем постановку из первой статьи: формируем действия, а состояния счёта вычисляем по ценовым сценариям.
Подготовка и обучение торговой модели
Сначала Market обучается сценарному представлению и прогнозу OHLC. Затем Actor и критики подготавливаются на истории и переходят к последовательному обучению в тестере MetaTrader 5. На двух последних этапах веса рыночной модели фиксированы.
Пресеты всех стадий находятся в Experts/DPCC/Presets. Загружаем их в параметры советников в порядке нумерации:
| Пресет | Советник | Этап |
|---|---|---|
| 01StudyForecast_LATENT_PREPARE.set | StudyForecast.mq5 | Подготовка латентного представления |
| 02StudyForecast_PRICE_JOINT.set | StudyForecast.mq5 | Совместное обучение прогнозов |
| 03StudyForecast_OMPB_CALIBRATE.set | StudyForecast.mq5 | Калибровка OMPB |
| 04StudyForecast_PRICE_ADAPT.set | StudyForecast.mq5 | Адаптация ценового декодера |
| 05Study.set | Study.mq5 | Историческая подготовка Актёра и критиков |
| 06StudyOnline.set | StudyOnline.mq5 | Последовательное TD-обучение |
| 07Test.set | Test.mq5 | Тестирование с фиксированными весами |
Пресеты 01–05 задают период с 01.01.2024 до исключительной границы 01.01.2026. Для StudyOnline тот же интервал указан в конфигурации тестера. InpDiffusionSeed равен 20261007; InpSeed в 06StudyOnline.set — 20260920.
Здесь завершаем интеграцию, отложенную в четвёртой статье. Рабочий RunAction6Forward использует BeginUnroll и ForwardFrame с сохранением кадров. Вместо оценки G фиксированной последовательности EvaluateAndPublishAction6 использует оценки первых действий от Q1/Q2. Критики оценивают действие и последующее поведение политики.
В CNeuronDPCCOCL::FinalizeAction6Plans отдельный финальный сценарный расчёт выполняется только при bTrain = true. В торговом режиме этот вызов пропускается. Параметр require_rollout_valid кернела DPCCAction6CandidateMask включает требование к результату этого расчёта только при обучении.
В P1 финансовая проверка сохраняется внутри проектора, вызываемого после генерации. В P2 она выполняется при вызовах проектора на обратных шагах. В P0 без обучения не вызываются ни проектор, ни отдельный финальный расчёт. Поэтому полный сценарный контроль горизонта H нельзя приписывать этой ветви.
Подготовка рыночного представления — StudyForecast
Программа StudyForecast.mq5 расширяет подготовку рыночного представления AC-SRM ценовой задачей. Предусмотрены четыре стадии: LATENT_PREPARE, PRICE_JOINT, OMPB_CALIBRATE и PRICE_ADAPT. Архитектура Market сохраняется, но между стадиями меняются разрешения на обновление её компонентов.
На LATENT_PREPARE обучаются латентное представление и сценарный прогноз. Цели формируются по историческому продолжению ряда средствами AC-SRM. Ценовой декодер уже присутствует в сети, но его веса не обновляются. Это отделяет первоначальную подготовку сценариев от дополнительной ошибки OHLC.
На PRICE_JOINT подключается обучение ценовой ветви. Сначала Market строит прогноз по доступной истории. Затем из последующих баров формируется целевая последовательность. Для её нормирования используются текущий ценовой якорь и масштаб, полученный по прошлым данным. Будущие цены входят в разметку, но не во входные признаки прогноза.
Разделение стадий показано в CDPCCStudyForecastCore::AdvancePriceJointFit:
if(m_price_study_phase == defForecastPriceLatentPrepare)
  {
   //--- Layer7 records and reverses its tape, then its phase gate completes without a weight write.
   if(!decoder.getGradient() || !decoder.getGradient().Fill(0.0f))
      return(Fail("study_forecast.latent_prepare.zero_price_gradient", reason));
  }
else
   if(m_price_study_phase == defForecastPriceJoint)
     {
      if(!PreparePriceJointTarget(decision, decoder, reason) ||
         !decoder.PreparePriceLoss(price, GetPointer(m_price_target), m_price_lambda, m_price_huber,
                                   m_price_rho_tolerance, true, loss) ||
         !MathIsValidNumber(loss) || loss < 0)
         return(Fail("study_forecast.price_joint.prepare_loss:" + reason, reason));
     }
На первой стадии градиент декодера обнуляется. На второй PreparePriceJointTarget подготавливает цель, а PreparePriceLoss рассчитывает взвешенную ошибку Huber. Градиент проходит к прогнозному блоку, который одновременно получает сигнал латентной задачи.
На OMPB_CALIBRATE сохраняем процедуру AC-SRM с опорной и калибровочной выборками. Обучается только OMPB. Энкодер, прогноз и декодер фиксированы. Изменившееся представление рынка затем требует согласования с ценовым выходом.
Для этого предусмотрена PRICE_ADAPT. Здесь обучается только декодер, а все предшествующие слои остаются фиксированными. Ограничение проверяется в CDPCCStudyForecastCore::SetPriceAdaptPolicy:
//--- Only Layer7 records a training tape and owns a permitted optimizer write.
decoder.TrainMode(train_decoder);
for(int i = 0; i < 7; i++)
   if(!m_market.Layer(i) || m_market.Layer(i).TrainMode())
      return(Fail("study_forecast.price_adapt.upstream_train_mode", reason));
Слои 0–6 остаются фиксированными; декодер расположен в слое 7. Проверка защищает это разделение. На границах стадий сохраняются параметры и состояние подготовки.
Размерности и числовая корректность сценариев проверяются в процессе работы. Диагностика OMPB характеризует подготовку представления, но не заменяет торговую оценку. После PRICE_ADAPT Market работает с фиксированными весами и предоставляет признаки и цены для обучения Actor, Q1 и Q2.
Подготовка диффузионного Актёра — Study
Программа Study.mq5 создаёт торговые модели и восстанавливает подготовленную Market. Для каждой исторической точки подготавливаются состояние счёта и доступные рыночные признаки. Актёр генерирует пакет планов по прогнозным сценариям. Отдельно строится план наставника, для оценки которого разрешено использовать последующее фактическое движение цены.
При наличии допустимого решения исходным предложением становится выбранный план Актёра. Если такого решения нет, массив seed заполняется нулями. Вокруг исходного предложения формируются локальные варианты действий. Финансовый расчёт на историческом продолжении позволяет выбрать наставника из ограниченного набора предложений. Это не поиск гарантированного глобального оптимума.
Подготовка вариантов и выбор наставника выполняются в CDPCCStudyStageConsumer::StepAction6History:
if(!DPCCGenerateOracleCandidatePlans(seed, (uint)horizon, m_z_deltas, candidate_plans,
                                     candidate_count, reason) ||
   !DPCCSelectHistoricalOracleCandidateFromContinuation(m_offline_scoring,
         m_offline_config.shape, context, row.native_ohlc, opens[0], row.decision_bar, opens, closes,
         ordinals, candidate_plans, candidate_count, m_offline_config, 0, teacher_continuation,
         m_z_step, m_z_rows + horizon - 1, teacher_plan, teacher_score, teacher_source, teacher_mask, reason))
   return(Fail("study.action6.factual_oracle:" + reason, reason));
DPCCGenerateOracleCandidatePlans создаёт предложения. DPCCSelectHistoricalOracleCandidateFromContinuation рассчитывает их последствия и возвращает teacher_plan вместе с маской teacher_mask. Маска определяет пригодные для разметки шаги. Будущее используется после прямого прохода Актёра и не подменяет доступную ему историю.
Критики и Актёр получают разные сигналы. Для Q1/Q2 отдельно рассчитывается causal_score текущего действия; при защитном выходе оценивается нулевой план. План наставника служит отдельной целью обучения генеративной модели.
if(!DPCCUpdateAction6Critic(*m_action6_q1, *market, account_action19,
                            (float)(causal_score - (double)prepared.preparation_reward), 1.0f, 1.0f, reason) ||
   !DPCCUpdateAction6Critic(*m_action6_q2, *market, account_action19,
                            (float)(causal_score - (double)prepared.preparation_reward), 1.0f, 1.0f, reason) ||
   !DPCCUpdateAction6OraclePlanActor(*m_action6_actor, decision_id, teacher_plan, valid_steps,
                                     m_offline_config.gamma, reason))
   return(Fail("study.action6.train_update:" + reason, reason));
Цель критиков учитывает causal_score и вычитание уже учтённого preparation_reward. Обновление Актёра получает полную последовательность наставника и маску шагов. Поэтому оценка торгового действия и имитация исторического плана остаются разными задачами.
Отсутствие допустимого решения не всегда исключает обучение по наставнику. DPCCUpdateAction6OraclePlanActor может выбрать кандидата, пригодного для локального обратного прохода, даже при DPCC_NO_FEASIBLE_CANDIDATE. Если подходящего кандидата нет, развёртка освобождается, а это обновление пропускается. Такая учебная ветвь не разрешает исполнение недопустимого плана.
Исторический счёт продвигается на бар по выбранному действию, а не по наставнику. При новом проходе сбрасываются временные состояния; веса и состояние оптимизатора сохраняются.
Обучение распределительных критиков
Q1 и Q2 наследуют распределительную архитектуру AC-SRM, но получают действия от планировщика. Вход по-прежнему содержит 13 признаков счёта и шесть параметров Action6. Рыночный контекст поступает из Market. Критик оценивает отдельное действие относительно текущего состояния, а не всю последовательность как неизменное расписание будущих сделок.
На этапе Study целевой результат рассчитывается по истории с помощью сценарной финансовой модели. Он используется в DPCCUpdateAction6Critic:
if(!critic.feedForward(GetPointer(query), 1, false, GetPointer(market), 6))
  {
   reason = "model.price_q.update_forward";
   return(false);
  }
//--- The native AC-SRM target prepares the Base32 boundary for its specialized backward.
if(!head.calcDistributionTargetGradients(base, target, probability_weight, value_weight))
  {
   reason = "model.price_q.update_distribution_gradient";
   return(false);
  }
if(!critic.backPropGradient(GetPointer(market), 6, -1, false))
  {
   reason = "model.price_q.update_backward";
   return(false);
  }
Сначала выполняется прямой проход. Затем CNeuronACSRM подготавливает градиенты распределительной ошибки относительно целевого результата. А backPropGradient распространяет их через критика и обновляет его веса. Параметры probability_weight и value_weight задают вес составляющих обучения вероятностного и стоимостного представлений.
Оба критика получают один исторический целевой результат, но имеют независимые параметры. Обучается распределение результатов, а не только средняя оценка. Веса Market при этих обновлениях не меняются. Оценка продолжения политики через целевые сети будет добавлена на этапе StudyOnline.
Обучение Актёра и обратное распространение градиента
Для обновления по наставнику выбираем наиболее близкого к цели кандидата среди пригодных для обратного прохода. Расстояние рассчитывается по координатам Action6 с учётом маски и дисконтирования. Вес шага h равен:
wh = (mh × γh) / [Σr=0..H−1 (mr × γr)]
Здесь mh — бинарная маска valid_steps, полученная из teacher_mask; γ принадлежит [0, 1]. В DPCCPrepareAction6OraclePlanGradient сначала накапливается знаменатель, затем вес шага переносится на каждую из шести координат действия:
double discount = 1.0;
double normalization = 0.0;
for(int h = 0; h < horizon; h++)
  {
   if(valid_steps[h] != 0.0f && valid_steps[h] != 1.0f)
     {
      reason = StringFormat("policy.action6_oracle.valid_step.%d", h);
      return(false);
     }
   discounts[h] = discount;
   normalization += (double)valid_steps[h] * discount;
   discount *= (double)gamma;
  }
if(!MathIsValidNumber(normalization) || normalization <= 0.0)
  {
   reason = "policy.action6_oracle.no_discounted_valid_steps";
   return(false);
  }
float weights[], zeros[];
if(ArrayResize(weights, (int)count) != (int)count || ArrayResize(zeros, (int)count) != (int)count)
  {
   reason = "policy.action6_oracle.weight_capacity";
   return(false);
  }
for(int i = 0; i < (int)count; i++)
  {
   if(!MathIsValidNumber(teacher_plan[i]))
     {
      reason = StringFormat("policy.action6_oracle.target_nonfinite.%d", i);
      return(false);
     }
   const int h = i / 6;
   weights[i] = (float)((double)valid_steps[h] * discounts[h] / normalization);
   zeros[i] = 0.0f;
   if(!MathIsValidNumber((double)weights[i]))
     {
      reason = StringFormat("policy.action6_oracle.weight_nonfinite.%d", i);
      return(false);
     }
  }
Пустая взвешенная маска отклоняется до деления. При γ = 0 ненулевой вес возможен только у первого шага. Сумма весов по шагам равна единице, но по всем 6H координатам — шести: дополнительного деления на число координат здесь нет. Это нормирование обучающего сигнала, отдельное от нормирования входного финансового контекста.
DPCCPrepareAction6OraclePlanGradient формирует отклонение от наставника. Затем DPCCUpdateAction6OraclePlanActor связывает градиент с выбранным кандидатом и конкретным decision_id:
if(!top.BindFullPlanGradient(decision_id, selected, GetPointer(gradient)))
  {
   reason = "model.action6.oracle_plan_gradient_non_retryable";
   return(false);
  }
if(IsStopped())
  {
   reason = "model.action6.oracle_plan_stopped_after_bind_non_retryable";
   return(false);
  }
if(!actor.backPropGradient((CBufferFloat*)NULL, (CBufferFloat*)NULL, 1, false))
  {
   reason = "model.action6.oracle_plan_backward_non_retryable";
   return(false);
  }
Вызов проходит через CNet, но обработку выполняет составной слой CNeuronDPCCOCL. Он хранит результаты обратных диффузионных шагов. Это позволяет передать градиент от готовой последовательности к общим параметрам денойзера без повторной случайной генерации.
В CNeuronDPCCOCL::BackwardAction6 сначала обнуляются накопители. Затем кадры обходятся в порядке, обратном генерации:
bool success=m_denoiser.ZeroAccumulatedGradients();
for(uint j=1; success && j<=m_shape.J; j++)
  {
   failure_frame=j;
   //--- The first upstream is physical A_checked; later P2 maps include N.
   const bool project=(m_action_meta.mode == DPCC_P2 ||
                       (m_action_meta.mode == DPCC_P1 && j == 1));
В P0 проектор не участвует. В P1 учитывается коррекция готового плана, поэтому условие истинно только при j = 1. В P2 используются сохранённые отображения коррекции на обратных шагах. Это различие относится к вычислительному пути; оно само по себе не доказывает преимущество одного режима.
Далее градиент разделяется между ветвями диффузионного преобразования и передаётся соответствующему кадру денойзера:
success=Action6GradientStep(def_k_DPCCAction6GradientStep_ddpm_split, m_action_current, m_action_physical,
                            m_action_next, m_action_epsilon, j);
if(success)
  {
   failure_stage=7;
   success=m_denoiser.BackwardFrame(m_shape.J-j, m_action_epsilon,
                                    m_action_physical, m_action_condition);
  }
BackwardFrame получает индекс m_shape.J-j. Каждый кадр использует собственные сохранённые значения, но добавляет вклад в общие градиенты весов. После успешного обхода развёртки выполняется обновление параметров. Наличие J кадров не означает J независимых денойзеров.
Для коррекции используется CNeuronPlanProjectionTraceOCL::BackwardFrame и кернел DPCCProjectionTraceVJP. Магистраль позволяет передавать градиент через локальные преобразования принятой ветви поиска. Выбор поправки и допуск кандидата остаются дискретными. Поэтому речь не идёт о полном дифференцировании гладкой математической проекции.
На этапе Study этот механизм приближает планы к исторической цели. Это не стандартная самостоятельная ε-loss и не оптимизация политики по SRM критика. Выход денойзера остаётся оценкой шума, но обучающий сигнал формируется по итоговому плану. На следующем этапе источник градиента меняется.
Последовательное обучение Actor–Critic — StudyOnline
StudyOnline.mq5 продолжает подготовку в тестере стратегий MetaTrader 5. Сохраняется однобаровая TD-схема AC-SRM. Программа восстанавливает Market, Actor, Q1 и Q2, а также использует TargetActor, TargetQ1 и TargetQ2. Рыночная модель фиксирована. Изменяются параметры торговой политики и критиков.
На новом баре обновляются рыночное представление и состояние счёта. Эти данные завершают переход, начатый предыдущим решением. Вознаграждение определяется изменением Equity между последовательными отметками. В DPCCBuildOneBarReward выполняется следующая операция:
const double candidate = next_open_equity - previous_open_equity;
if(!MathIsValidNumber(candidate))
  {reason = "policy.reward_non_finite_result"; return(false);}
const float candidate_reward = (float)candidate;
Разность включает изменение стоимости позиции и влияние исполненных операций на средства счёта. Ожидаемый результат продолжения не входит в это непосредственное вознаграждение: он добавляется через целевую оценку.
Для следующего состояния TargetActor заново строит планы в заданном режиме. Его первое действие используется в DPCCOnlineBootstrap:
if(!DPCCOnlineActorForward(*EXTTargetActor, EXTTargetAccount, context, decision_open,
                           account, action, meta, has_plan, reason))
   return(false);
if(!DPCCOnlineCancelActor(EXTTargetActor, reason))
   return(false);
if(!has_plan)
   EXTTargetActorNoPlan++;
Если допустимого плана нет, для оценки берётся нулевое действие. Это соответствует защитному выходу в FLAT, а не сохранению прежнего объёма. Целевой Актёр не обучается по данной генерации, поэтому её промежуточные данные освобождаются.
Оба целевых критика оценивают состояние и действие. Из каждого распределения сэмплируется одно значение, обозначенное z1 и z2. Для текущего однобарового перехода формируются цели:
yi = rt + γzi, i ∈ {1, 2}.
rt — полученное изменение Equity, а γ — дисконтирование будущего результата. В показанном вызове маска продолжения равна единице. DPCCOnlineUpdatePending объединяет расчёт вознаграждения, целевого действия и TD-целей:
if(!DPCCBuildOneBarReward(EXTMarkEquity, next_equity, reward, reason))
   return(false);
if(!DPCCOnlineBootstrap(context, decision_open, next_account, z1, z2, reason))
   return(false);
if(!DPCCBuildOneBarTDTargets(reward, EXTGammaTD, 1.0f, z1, z2, y1, y2, reason))
   return(false);
После этого восстанавливается рыночное представление предыдущего решения. Q1 и Q2 получают сохранённое состояние и ранее исполненное действие, но разные значения y1 и y2:
bool updated = DPCCUpdateAction6Critic(*EXTQ1, *market, query, y1,
                                       EXTProbabilityWeight, EXTValueWeight, reason);
if(updated)
   updated = DPCCUpdateAction6Critic(*EXTQ2, *market, query, y2,
                                    EXTProbabilityWeight, EXTValueWeight, reason);
Так прошлое действие связывается с наблюдавшимся вознаграждением и оценкой продолжения. Использование нового рыночного контекста вместо сохранённого изменило бы смысл обучающего примера.
Для обновления Actor также сохраняется его предыдущая развёртка. Повторная генерация с новым шумом не заменяет её. Если допустимое решение было получено, обновление политики выполняется с частотой InpUpdatePolicy. Один из критиков выбирается методом DPCCOnlineActorCritic:
if(updated && EXTPendingActorFrame)
  {
   const ulong transition = EXTTransitions + 1;
   if(transition % EXTUpdatePolicy == 0)
     {
      const int selected = DPCCOnlineActorCritic(EXTPolicyEvents, EXTSelector, EXTDonorSeed);
      updated = selected >= 0 && DPCCUpdateAction6Actor(*EXTActor,
                EXTPendingDecision.decision_id, (uint)selected, reason);
      if(updated)
         EXTPolicyEvents++;
     }
   else
      updated = DPCCOnlineCancelActor(EXTActor, reason);
  }
DPCCUpdateAction6Actor вызывает CNeuronDPCCOCL::BindSelectedPolicyGradient. Через распределительную голову выбранного критика формируется градиент SRM относительно первого действия плана. При этом веса самого критика не обновляются. Градиент привязывается к кандидату и через BackwardAction6 проходит по сохранённым кадрам к денойзеру.
В Study цель задана планом наставника. В StudyOnline генератор обновляется по распределительной оценке результата политики. Критик первого действия не заменяет финансовую проверку всей последовательности.
При отсутствии допустимого решения выполняется защитный выход. Полученный переход остаётся примером для критиков. Но policy-gradient по выбранному плану не рассчитывается, поскольку такого плана нет. Кадр генерации освобождается. Это отличается от допустимого учебного обновления по наставнику в Study.
Целевые параметры обновляются в DPCCOnlineRefreshTargets. Целевой Актёр получает веса рабочего:
if(!EXTTargetActor.WeightsUpdate(EXTActor, EXTTauTarget))
  {
   reason = "online.target_Actor.weights_update";
   return(false);
  }
Обновление критиков перекрёстное: TargetQ1 получает веса Q2, а TargetQ2 — Q1. За событие обновляется одна сеть, за пару событий — обе. Порядок внутри пары выбирается случайно. На границе пар одна сеть может обновляться дважды подряд. Частоту задаёт InpUpdateTargets.
После обновлений восстанавливается контекст нового бара. Actor формирует очередное решение, исполнитель получает первое Action6, а данные сохраняются для следующего перехода. Подготовка по историческим планам и TD-обучение тем самым становятся последовательными этапами одной торговой политики.
Тестирование торговой модели
Советник Test.mq5 проверяет политику с фиксированными весами. Обучение и тестирование проводились на котировках сервера MetaQuotes-Demo для EURUSD H1. Обучающий период — 2024–2025 годы, тестовый — январь–май 2026 года. Начальный депозит составил 1000 USD.
Тест выполнен в режиме P1: коррекция применяется к готовому плану после генерации. В 07Test.set установлено InpMode = 1. Интервал тестера — с 01.01.2026 до 01.06.2026, без включения июня.
Для повторения эксперимента во вложении представлены пресеты всех этапов обучения и настройки тестера стратегий. Порядок применения.set указан выше. В TesterConfigs находятся 06StudyOnline_2024_2025.ini и 07Test_P1_2026_Jan_May.ini. Они задают программу, пресет, EURUSD H1 и даты. Режим тиков, плечо и издержки проверяем отдельно.
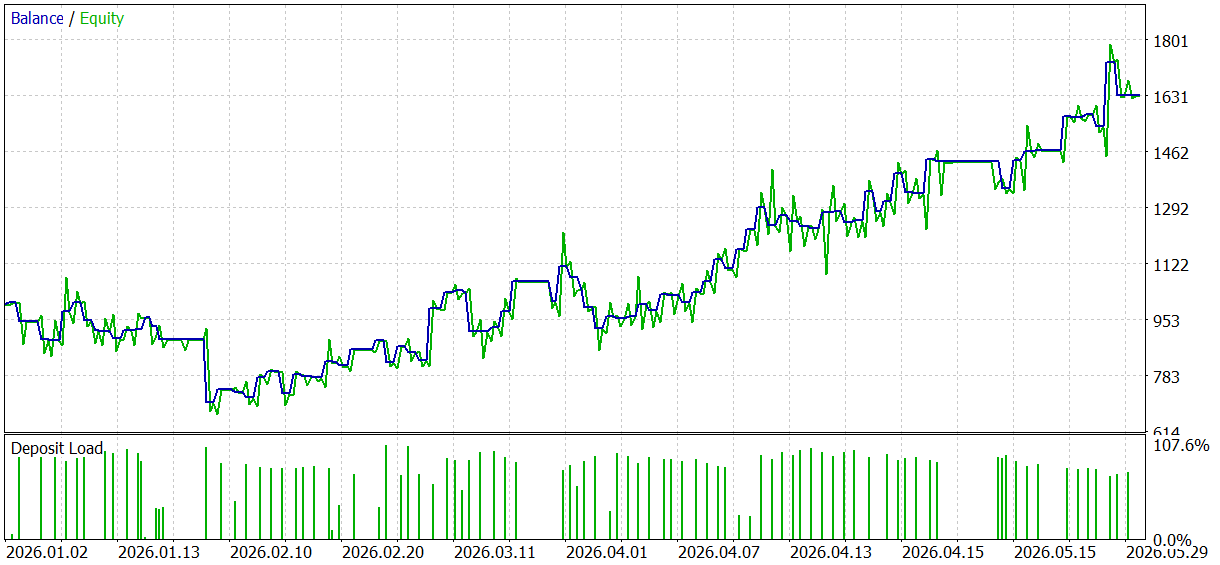
Рисунок 1. Баланс, средства и загрузка депозита в тесте EURUSD H1, январь–май 2026 года.
По результатам тестирования чистая прибыль составляет 633,65 USD, конечный баланс — 1633,65 USD, прирост — 63,37%. На графике начальное снижение капитала сменяется восстановлением и последующим ростом. Эти значения относятся только к показанному запуску.
Просадка баланса в отчёте достигает 303,94 USD, или 30,23%; просадка средств — 413,94 USD, или 38,20%. Положительный итог сопровождался существенным риском. Без фактических настроек ограничений нельзя установить, были ли нарушены заданные лимиты. Сценарная проверка осуществляется по прогнозным значениям и сама по себе не охватывает все возможные движения рынка.
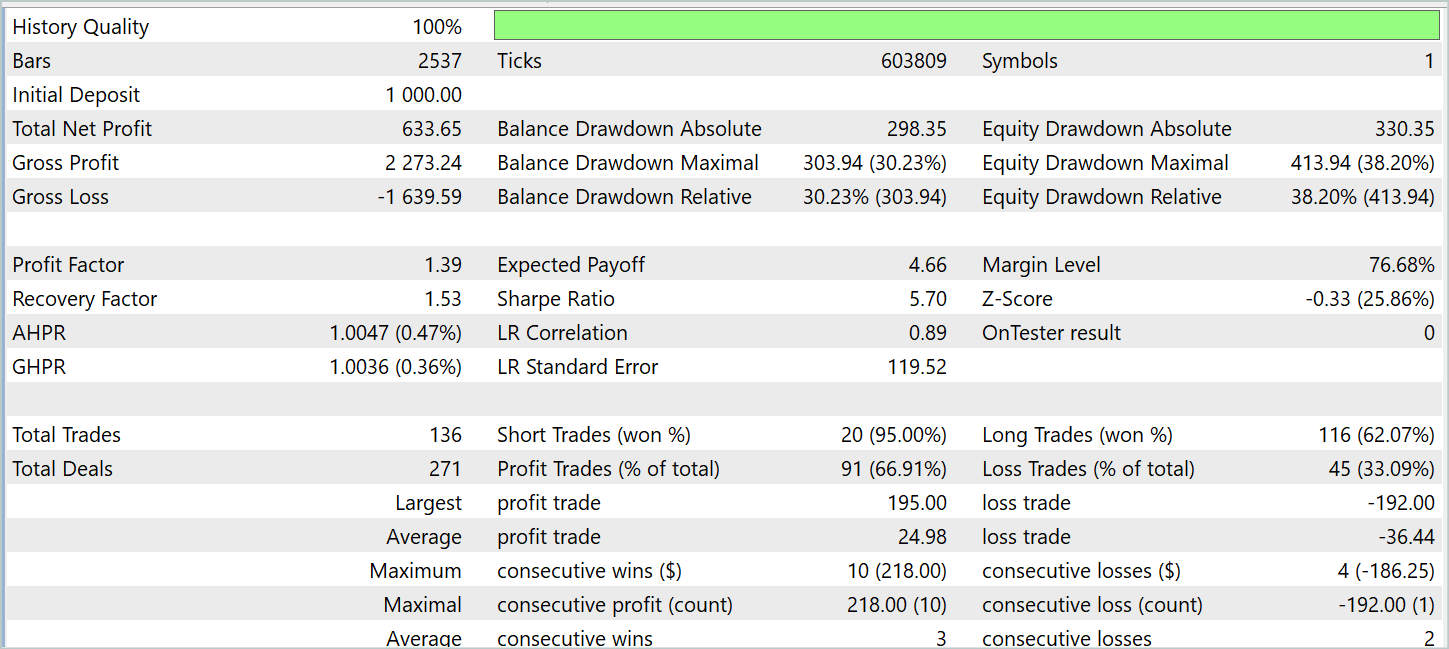
Рисунок 2. Сводная торговая статистика того же тестового прогона.
В отчёте указано 136 сделок: 91 прибыльная (66,91%) и 45 убыточных. Валовая прибыль — 2273,24 USD, совокупный убыток — 1639,59 USD. Profit Factor равен 1,39, Expected Payoff — 4,66 USD.
Средняя прибыльная сделка принесла 24,98 USD при среднем убытке 36,44 USD. Наибольшая прибыль составила 195 USD, наибольший убыток — 192 USD. Поэтому положительный итог связан с высокой долей прибыльных операций, а не с превышением средней прибыли над средним убытком.
Покупок было 116 с долей прибыльных 62,07%; продаж — 20 с долей прибыльных 95%. Такой объём коротких сделок недостаточен для вывода об устойчивом преимуществе на нисходящем рынке. Recovery Factor равен 1,53, Sharpe Ratio — 5,70.
Один прогон не доказывает устойчивость, отсутствие переобучения или преимущество P0/P1/P2. Для этих выводов нужны дополнительные эксперименты.
Заключение
В этой статье мы завершили адаптацию фреймворка DPCC к задачам финансовых рынков. На основе сделанной ранее реализации AC-SRM подготовлена торговая архитектура с диффузионным Актёром. Рыночный энкодер и распределительные критики сохранены, а сценарный прогноз дополнен декодером OHLC для финансовой проверки планов.
Мы рассмотрели подготовку Market, обучение на историческом плане наставника и последующие TD-обновления. Кадровый режим связывает итоговый план с общими весами денойзера. Трасса коррекции поддерживает локальный обратный проход, но не превращает дискретный поиск в гладкую проекцию. При отсутствии допустимого торгового плана сохраняется защитный переход в нулевую позицию.
Положительный результат отдельного теста сопровождался существенной просадкой. Он не доказывает устойчивость политики, преимущество одного режима коррекции или оптимальность гиперпараметров.
Разработанные механизмы позволяют рассчитывать последствия планов в заданных сценариях. Их практическая ценность зависит от прогноза, финансовой модели и ограничений. Перед реальной торговлей нужны дополнительные испытания на других периодах и проверка чувствительности к издержкам.
Ссылки
Файлы проекта
| # | Имя | Тип | Описание |
|---|---|---|---|
| 1 | Trajectory.mqh | Общий модуль | Конфигурации сетей, подготовка данных и общие процедуры обучения DPCC |
| 2 | StudyForecast.mq5 | Советник | Подготовка Market, совместное обучение латентного и ценового прогнозов, калибровка OMPB |
| 3 | Study.mq5 | Советник | Историческая подготовка диффузионного Актёра по наставнику и обучение критиков |
| 4 | StudyOnline.mq5 | Советник | Однобаровые TD-обновления критиков и обучение Актёра по спектральной оценке |
| 5 | Test.mq5 | Советник | Исполнение торговой политики с фиксированными весами |
| 6 | NeuroNet.mqh | Библиотека классов | Подключение модулей нейронной библиотеки |
| 7 | NeuroNet_Attention.mqh | Модуль библиотеки | Кадровый денойзер и совместимое сценарное внимание |
| 8 | NeuroNet_TimeSeries.mqh | Модуль библиотеки | Ценовой сценарный прогноз и декодер OHLC |
| 9 | NeuroNet_AgentsRL.mqh | Модуль библиотеки | Составной Актёр DPCC, сценарный расчётчик, проектор и трасса коррекции |
| 10 | NeuroNet.cl | OpenCL-программа | Вычислительные кернелы нейронной библиотеки |
Исходные файлы доступны в репозитории проекта.
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 Количественный анализ совместной рекуррентности (JRQA) в MQL5: Выявление одновременной рекуррентности в двух временных рядах
 Неопределённость как модель (Часть 9): Процессы авторегрессии

 Логика кэрри-трейда в MQL5: Создание советника, учитывающего ставки свопа при расчете размера позиции и принятии решений об удержании

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования