

Нейросети в трейдинге: Habi — быстрое принятие решений без сложного планирования (вероятностное представление)
 49
 0

Введение
На каждом новом баре торговой системе предстоит решить, сохранить ли позицию, изменить её объём, пересмотреть защитные уровни или выйти из рынка. Ответ зависит от движения цены и состояния счёта. Подробное планирование помогает оценить последствия разных действий, но его повторение на каждом баре требует дополнительных вычислений.
В предыдущей статье мы рассмотрели фреймворк Habi. Он переносит опыт сложного планировщика в компактную генеративную политику. В нашей адаптации эталонные действия предоставляет Oracul, использующий известную по истории траекторию цен. При принятии торгового решения будущие котировки модели недоступны. Поэтому по текущему наблюдению она формирует несколько предложений, которые затем оценивает Critic.
Практическую часть первой статьи мы посвятили расширению OpenCL-кернелов VAE_FeedForward и VAE_CalcHiddenGradient. Они позволяют получать несколько латентных векторов из одного нормального распределения и собирать их градиенты при обратном проходе. Параметры распределения остаются общими для всего пакета.
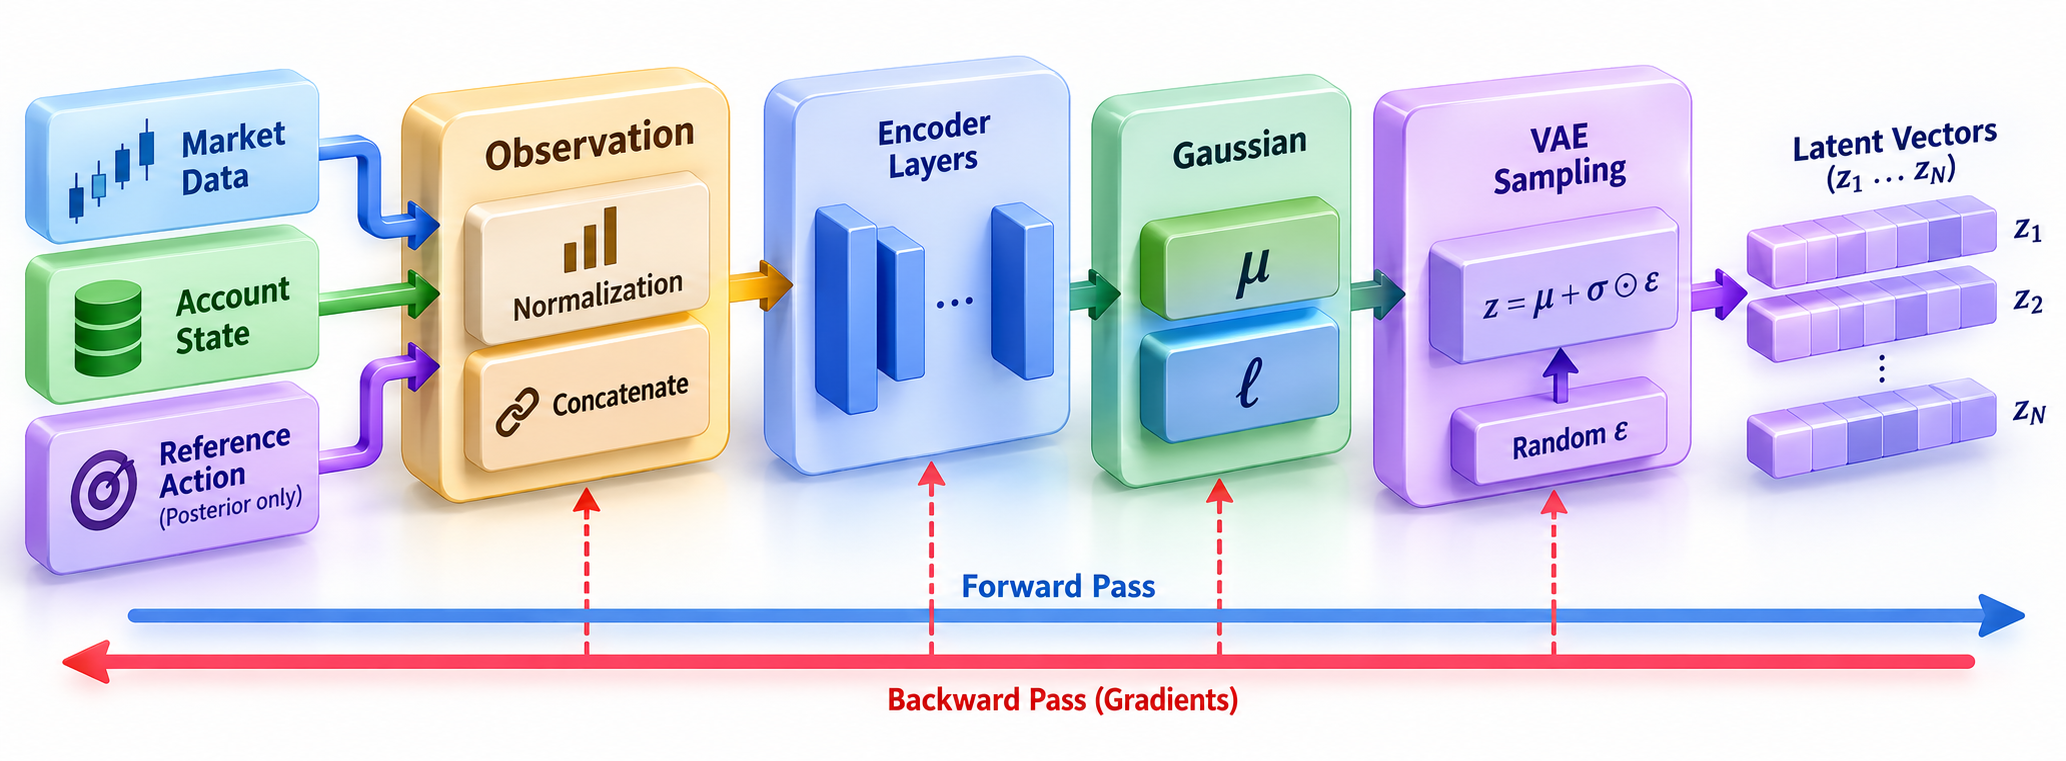
В этой части мы создадим объекты подготовки наблюдений и вероятностных представлений. Prior получает только текущее наблюдение, а Posterior при обучении дополнительно использует эталонное действие. Согласование их распределений помогает затем формировать предложения без эталона. Пакетный вариационный слой получит из одного распределения несколько латентных векторов — внутренних числовых представлений для будущих действий.
Для каждого объекта разберём архитектуру и инициализацию, а также прямой и обратный проход. Прямой проход преобразует входные данные в результат. Обратный проход передаёт градиенты — сигналы о том, как изменение входов и параметров влияет на ошибку обучения. Недостающие OpenCL-операции рассмотрим вместе с использующими их объектами.
В следующих статьях завершим объекты генерации и оценки действий, построим модели Prior, Posterior, Decoder и Critic. Затем перейдём к подготовке данных, обучению, онлайн-адаптации и тестированию.
Базовый объект компонентов Habi
Общие настройки и рабочие буферы вынесем в CNeuronHabiLeafOCL, наследник CNeuronBaseOCL. Ниже показаны объявление конструктора, метод настройки и поля класса. Служебные методы опущены; пропуски отмечены в листинге.
class CNeuronHabiLeafOCL : public CNeuronBaseOCL
  {
public:
                     CNeuronHabiLeafOCL();
   virtual bool      Configure(CLayerDescription *d);
   // ... служебные методы опущены ...
protected:
   uint              N;
   uint              L;
   uint              A;
   uint              M;
   uint              Norm;
   bool              posterior;
   SHabiFrame        frame;
   CBufferFloat      scratch[9];
   // ... служебные методы опущены ...
  };
N задаёт число кандидатов, L — длину латентного вектора, A — число компонентов действия, M — размер рыночного блока. Norm задаёт верхний предел счётчика накопления статистики нормализатора. Флаг posterior отличает роль Posterior от Prior.
Массив scratch содержит девять рабочих буферов. Наследник назначает им размеры и содержимое под свою операцию. Метод Ready подготавливает выбранный буфер, а Finite сводит записанные кернелом признаки числовых ошибок к общему результату.
Поле frame (SHabiFrame) хранит идентификатор и режим вычисления, а также признак ожидания обратного прохода. Оно связывает обучающий сигнал с тем вычислением, которое сформировало результат. Пока ожидается обратный проход, новый прямой вызов отклоняется. Значения и градиенты хранятся отдельно, в буферах.
Основные буферы подготавливает унаследованный Init. Конструктор задаёт начальные значения, а Configure получает рабочие настройки из CLayerDescription:
CNeuronHabiLeafOCL::CNeuronHabiLeafOCL()
  {
   N=1;
   L=1;
   A=6;
   M=45;
   Norm=100000;
   posterior=false;

   frame.Reset();
  }
//+------------------------------------------------------------------+
//| CNeuronHabiLeafOCL::Configure - apply a layer description        |
//+------------------------------------------------------------------+
bool CNeuronHabiLeafOCL::Configure(CLayerDescription *d)
  {
   N=d.window;
   L=d.window_out;
   A=d.step;
   M=d.layers;
   Norm=d.variables;
   posterior=d.probability>0;

   return(N>0 && L>0 && A==6 && M>0 && Norm>1);
  }
При настройке Configure заменяет значения конструктора, проверяет положительность размеров, формат действия из шести компонентов и условие Norm больше единицы. Числа в конструкторе служат начальными установками, а не результатом подбора торговых параметров.
Класс расположен в файле NeuroNet_Habi.mqh. Здесь же определена функция HabiPayload: она копирует нужный участок контекста в рабочий буфер и записывает его на устройство. На этой основе построены объекты Observation и Gaussian. Пакетный вариационный объект наследует CVAE, чтобы использовать готовые буферы семплирования.
Обработка рыночных наблюдений
Архитектура объекта обработки наблюдений
Одно и то же движение цены имеет разное значение для трейдера без позиции и для держателя покупки. Поэтому CNeuronHabiObservationOCL получает рыночные признаки вместе со сведениями о счёте. Рыночный блок проходит нормализацию. Остальные признаки уже подготовлены по своим правилам и передаются без изменения.
К унаследованным настройкам добавлены буфер рыночных данных, нормализатор и признак готовности его статистики. В сокращённом объявлении оставлены эти поля и методы обоих проходов:
class CNeuronHabiObservationOCL : public CNeuronHabiLeafOCL
  {
   // ... служебные методы опущены ...
protected:
   CNeuronBaseOCL      market;
   CNeuronBatchNormOCL bn;
   bool                initialized;
   virtual bool        feedForward(CNeuronBaseOCL *p,CBufferFloat *ctx) override;
   virtual bool        calcInputGradients(CNeuronBaseOCL *p,CBufferFloat *ctx,CBufferFloat *sg,
                                          ENUM_ACTIVATION ac=None) override;
   // ... служебные методы опущены ...
  };
Объект market хранит рыночные данные и их градиенты. Нормализацию выполняет существующий слой CNeuronBatchNormOCL — объект bn. Код Habi организует передачу данных между этими компонентами.
Флаг initialized показывает, подготовлена ли статистика нормализатора. Конструктор инициализирует его значением false:
CNeuronHabiObservationOCL() { initialized=false; }Признак posterior определяет наличие эталонного действия в конце входа. Размеры M и A наследуются от базового класса. Экземпляры для двух энкодеров имеют собственные нормализаторы bn.
Инициализация
После унаследованного Init вызываем Configure. Этот метод проверяет размерность наблюдения и инициализирует внутренние объекты:
bool CNeuronHabiObservationOCL::Configure(CLayerDescription *d)
  {
   if(!CNeuronHabiLeafOCL::Configure(d) || Neurons()!=M+13+(posterior?A:0))
      return(false);

   return(market.Init(0,0,OpenCL,M,ADAM,iBatch) && bn.Init(0,0,OpenCL,M,Norm,ADAM));
  }
Сначала вызываем Configure родительского класса. После этого проверяем общую размерность. К M рыночным значениям добавляются 13 признаков счёта. Для Posterior требуется ещё A компонентов эталонного действия. Например, при M, равном 45, и A, равном 6, получаем 58 входных значений для Prior и 64 для Posterior. Число 13 в проверке соответствует принятому в этой реализации формату счёта.
Объекты market и bn имеют размерность M: признаки счёта и эталонное действие в них не входят. Нулевое число выходных связей позволяет не создавать для внутренних объектов матрицы связей со следующим полносвязным слоем.
Параметр Norm ограничивает накопление статистики нормализатора. Это не размер пакета одновременно передаваемых наблюдений и не количество торговых кандидатов. Выбор оптимизатора ADAM также определяет устройство внутреннего буфера нормализации: в нём выделяется девять значений на каждый рыночный признак. Их начальное заполнение выполняется при первом наблюдении.
Прямой проход
Метод feedForward читает наблюдение из выхода предыдущего слоя p. Дополнительный буфер ctx содержит контекст: режим и идентификатор вычисления. По ним проверяется соответствие прямого и обратного проходов.
После проверки источника и размерностей разделяем вход на рыночный блок и часть, которая обходит нормализатор:
bool CNeuronHabiObservationOCL::feedForward(CNeuronBaseOCL *p,CBufferFloat *ctx)
  {
   if(!p || p.Neurons()!=Neurons() || !frame.Forward(ctx,0,bTrain) ||
      !Ready(0,Neurons()-M))
      return(false);

   if(!DeConcat(market.getOutput(),GetPointer(scratch[0]),p.getOutput(),M,Neurons()-M,1))
      return(false);
Первые M элементов попадают в выходной буфер market. Оставшиеся Neurons() − M значений сохраняются в scratch[0]. Для Prior это сведения о счёте. Для Posterior к ним добавляется эталонное действие. Последний аргумент DeConcat равен единице: здесь обрабатывается одно наблюдение, а не пакет торговых кандидатов.
Если нормализатор ещё не подготовлен, задаём его начальное состояние по первому корректному наблюдению:
   bool startup=!initialized;

   if(startup)
     {
      if(!bTrain || frame.mode==F_GAUSSIAN_EVAL || !market.getOutput().BufferRead())
         return(false);

      CBufferFloat *o=bn.getBatchOptions();

      for(uint j=0;j<M;j++)
         for(int k=0;k<9;k++)
            if(!o.Update((int)j*9+k,k==0?market.getOutput().At(j):(k==3?1.0f:0.0f)))
               return(false);

      if(!o.BufferWrite() || !bn.SetBatchCount(2))
         return(false);
     }
Стартовая настройка разрешена только при включённом обучении и вне режима F_GAUSSIAN_EVAL. Для применения подготовленной модели требуется сохранённая статистика нормализации.
Для подготовки буфера BatchOptions читаем рыночные значения из памяти устройства. В каждой группе из девяти элементов в позицию 0 записываем текущее значение признака — начальное среднее. В позицию 3 записываем единицу — начальный масштабный коэффициент. Остальные значения, включая дисперсию, смещение и состояния оптимизатора, обнуляем. Затем отправляем заполненный буфер на устройство.
Вызов SetBatchCount со значением 2 подготавливает внутренний счётчик к дальнейшей работе. Это техническая настройка библиотеки, а не утверждение, что статистика уже оценена по двум рыночным наблюдениям. Первый проход выполняется с подготовленными параметрами без их повторного накопления.
В режиме фиксированной статистики штатный кернел использует единицу вместо неположительной дисперсии. Поскольку начальное среднее совпадает с текущим значением признака, первый выход рыночного блока равен нулю. Сведения о счёте и, при наличии, эталонное действие передаются без изменения.
Нормализуем рыночный блок и объединяем его с сохранённой частью наблюдения:
   bool accumulate=!startup && bTrain && frame.mode==F_GAUSSIAN_BC;
   int count=bn.GetBatchCount();
   bn.TrainMode(accumulate);
   bool ok=bn.FeedForward(GetPointer(market));

   if(!accumulate && !bn.SetBatchCount(count))
      return(false);

   if(!ok || !Concat(bn.getOutput(),GetPointer(scratch[0]),Output,M,Neurons()-M,1))
      return(false);

   initialized=true;

   return(true);
  }
Накопление статистики разрешено после начальной настройки, при включённом обучении и режиме F_GAUSSIAN_BC. В других случаях используются сохранённые параметры; счётчик после вызова восстанавливается.
После успешного вызова FeedForward объединяем нормализованный рынок с блоком из scratch[0]. Порядок компонентов остаётся прежним: сначала рыночные признаки, затем состояние счёта и, при наличии, эталонное действие. Общая длина вектора не меняется. Флаг initialized устанавливается только после успешного формирования результата.
Обратный проход
В обратном проходе разделение сохраняется. Рыночный градиент направляем через нормализатор. Градиент части, переданной без изменения, возвращаем предыдущему слою напрямую.
bool CNeuronHabiObservationOCL::calcInputGradients(CNeuronBaseOCL *p,CBufferFloat *ctx,
      CBufferFloat *sg,ENUM_ACTIVATION ac=None)
  {
   int mode;
   uint token;

   if(!frame.Header(ctx,mode,token))
      return(false);

   int payload=(int)(mode==11?2*L+1:(mode==12?4*L+1:2*L));

   if(!frame.Backward(ctx,payload) || !Ready(1,Neurons()-M))
      return(false);

   if(!DeConcat(bn.getGradient(),GetPointer(scratch[1]),Gradient,M,Neurons()-M,1) ||
      !market.CalcHiddenGradients(GetPointer(bn)))
      return(false);

   return(Concat(market.getGradient(),GetPointer(scratch[1]),p.getGradient(),M,Neurons()-M,1));
  }
Контекст проверяется по сохранённому прямому проходу. Его длина зависит от режима энкодера. Сам Observation не вычисляет ошибку обучения: он принимает уже полученный градиент от последующих слоёв.
Метод DeConcat направляет первые M значений в градиентный буфер bn, а оставшуюся часть сохраняет в scratch[1]. Затем вызов market.CalcHiddenGradients передаёт расчёт входных градиентов штатному нормализатору. Поэтому производные нормализации не дублируются в новом классе.
Последний вызов Concat объединяет полученный рыночный градиент с неизменённой второй частью и записывает результат в градиентный буфер предыдущего слоя. Возвращаемый сигнал сохраняет размерность и порядок исходного наблюдения. Это описание чувствительности ошибки к входным данным, а не команда изменить исторические цены или фактический баланс счёта.
Сохранение и восстановление нормализатора
Метод CNeuronHabiObservationOCL::Save проверяет состояние нормализатора. После общих параметров он сохраняет версию локального формата, роль энкодера, флаг initialized и фактический счётчик bn.GetBatchCount():
bool CNeuronHabiObservationOCL::Save(const int h)
  {
   if(!BNStateValid() || !CNeuronHabiLeafOCL::Save(h))
      return(false);

//--- версия локального состояния; старые checkpoint не поддерживаются
   dFileWriteUInt(h,0x48424E31)
   dFileWriteUInt(h,1)
   dFileWriteUInt(h,M)
   dFileWriteUInt(h,Norm)
   dFileWriteUInt(h,posterior)
   dFileWriteUInt(h,initialized)
   dFileWriteUInt(h,bn.GetBatchCount())
Далее Save записывает состояние самого bn и границы вложенной записи. В методе Load проверяются версия, геометрия, роль и длина сохранённого блока. После чтения вложенного нормализатора выполняются заключительные операции:
   bn.AttachOpenCL(OpenCL);

   if(!bn.Load(h) || FileTell(h)!=end || !BNGeometry() ||
      !bn.SetBatchCount((int)count) || !BNStateValid(ready==1) ||
      !market.Init(0,0,OpenCL,M,ADAM,iBatch) ||
      !FileSeek(h,(long)(end+4),SEEK_SET))
      return(false);

   initialized=(ready==1);

   return(true);
Штатный CNeuronBatchNormOCL::Load не восстанавливает прежний счётчик, поэтому SetBatchCount вызывается отдельно. Флаг initialized устанавливается только после успешной загрузки и проверки параметров. Метод BNReady позволяет проверить готовность нормализатора перед первым прямым проходом в режиме тестирования. Неподготовленную модель нельзя инициализировать повторно по тестовым барам.
На выходе Observation остаются подготовленные признаки. Параметры распределения вычислят следующие обучаемые слои энкодера; их устройство рассмотрим при построении моделей. Gaussian-слой принимает результат этих слоёв, а не исходное наблюдение.
Формирование вероятностного представления
Энкодер формирует средние и параметры масштаба латентного распределения. Средние задают его положение, стандартные отклонения — разброс выборок. Перевод в объёмы позиции и защитные уровни выполняется позже, поэтому этот разброс нельзя напрямую считать волатильностью цены или риском сделки.
Последний слой энкодера выдаёт два блока: средние μ и параметры масштаба ξ. Средние могут быть любыми конечными числами. Стандартное отклонение должно быть положительным, поэтому преобразуем ξ:
σj = softplus(ξj) + 0.01, ℓj = 2 ln σj.
Здесь ℓ — логарифм дисперсии. Именно такой формат ожидает подготовленный механизм вариационного семплирования. Небольшая положительная добавка не позволяет стандартному отклонению обратиться в ноль. Выход объекта имеет вид [μ; ℓ] и содержит 2L значений, где L — размерность латентного представления. Число будущих кандидатов на эту длину не влияет.
Преобразование реализуем в CNeuronHabiGaussianOCL. Оба энкодера используют один тип слоя и одинаковый формат выхода, но получают разные обратные сигналы. Posterior участвует в воспроизведении эталона; Prior учится согласовывать с ним своё распределение.
Архитектура и инициализация Gaussian-слоя
Новый класс наследует CNeuronHabiLeafOCL. Покажем конструктор и собственное состояние, опуская служебные методы:
class CNeuronHabiGaussianOCL : public CNeuronHabiLeafOCL
  {
public:
                     CNeuronHabiGaussianOCL();
   // ... служебные методы опущены ...
protected:
   bool              adaptive;
   double            beta_fixed;
   double            b;
   double            mb;
   double            vb;
   double            eta;
   double            rho1;
   double            rho2;
   double            eps;
   double            target;
   uint              bt;
   double            cached_K;
   virtual bool      feedForward(CNeuronBaseOCL *p,CBufferFloat *ctx) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *p,CBufferFloat *ctx,CBufferFloat *sg,
                                        ENUM_ACTIVATION ac=None) override;
   // ... служебные методы опущены ...
  };
Размерности, роль posterior, временные буферы и состояние вычисления наследуются. Gaussian-слой не добавляет весовую матрицу: он преобразует выход предыдущего слоя и формирует обратный сигнал к нему.
Собственные поля преимущественно относятся к коэффициенту β, который определяет вес согласования двух распределений. При фиксированном режиме используется beta_fixed. При адаптивном — логарифм коэффициента в поле b, состояния оптимизатора и целевой уровень расхождения target. Поле cached_K хранит вычисленную KL-дивергенцию. Подстраивать β разрешено только экземпляру Posterior, чтобы два энкодера не управляли этим коэффициентом независимо.
Конструктор задаёт исходное состояние:
CNeuronHabiGaussianOCL::CNeuronHabiGaussianOCL()
  {
   adaptive=false;
   beta_fixed=0;
   b=0;
   mb=0;
   vb=0;
   bt=0;
   eta=0;
   rho1=.9;
   rho2=.999;
   eps=1e-8;
   target=1;
   cached_K=0;
  }
До настройки beta_fixed равен нулю. Рабочее значение зададим отдельно. Унаследованные Init и Configure подготавливают основные буферы, размеры и роль; временные буферы выделяются через Ready.
Отдельная настройка коэффициента выполняется методом Beta:
bool CNeuronHabiGaussianOCL::Beta(bool use_adaptive,double value,double lr_beta,
                                  double k_target,double r1,double r2,double epsilon)
  {
   if(!MathIsValidNumber(value) || value<0 ||
      (use_adaptive && (value<=0 || lr_beta<=0 || k_target<=0 || r1<=0 || r1>=1 ||
                        r2<=0 || r2>=1 || epsilon<=0 ||
                        !MathIsValidNumber(lr_beta+k_target+r1+r2+epsilon))))
      return(false);

   adaptive=use_adaptive;
   beta_fixed=value;

   if(adaptive)
     {
      b=MathLog(value);
      rho1=r1;
      rho2=r2;
      eps=epsilon;
      eta=lr_beta;
      target=k_target;
     }

   mb=0;
   vb=0;
   bt=0;

   return(true);
  }
В фиксированном режиме допускается неотрицательное значение, включая ноль. В адаптивном начальный коэффициент должен быть строго положительным: он хранится через логарифм. Дополнительно проверяются параметры оптимизатора и целевой уровень KL. При настройке сбрасываются накопленные моменты и счётчик шагов. Метод EffectiveBeta возвращает текущее значение коэффициента в обычном, а не логарифмическом масштабе.
   float             EffectiveBeta()
     {
      return((float)(adaptive?MathExp(b):beta_fixed));
     }
Коэффициент β задаёт вес согласования распределений при воспроизведении эталона. Он не определяет торговый риск или допустимый размер позиции.
Прямой проход
Кернел HabiGaussianForward в NeuroNet.cl вычисляет выход и сохраняет производную для каждой латентной координаты:
__kernel void HabiGaussianForward(__global const float *x, __global float *out,
                                  __global float *chain, __global float *flags, int L)
  {
   int j=get_global_id(0);
   float xi=x[j+L];
   float sigma=fmax(xi,0.0f)+log1p(exp(-fabs(xi)))+0.01f;
   float sigmoid=xi>=0 ? 1.0f/(1.0f+exp(-xi)) : exp(xi)/(1.0f+exp(xi));
   out[j]=x[j]; out[j+L]=2.0f*log(sigma); chain[j]=2.0f*sigmoid/sigma;
   flags[j]=(!isfinite(out[j]) || !isfinite(out[j+L]) || !isfinite(chain[j]));
  }
Первые L значений входа переносятся в выход без изменения. Для второй половины вычисляем положительное стандартное отклонение и затем логарифм дисперсии. В коде softplus записана в численно устойчивой форме:
softplus(ξ) = max(ξ, 0) + ln(1 + exp(−|ξ|)).
Показатель экспоненты здесь неположителен. Поэтому вычисление не требует получать потенциально очень большое значение exp(ξ) при положительном ξ. Выражение для сигмоиды также разделено на две ветви по знаку аргумента.
Одновременно сохраняем в chain производную преобразования масштаба:
∂ℓj / ∂ξj = 2 sigmoid(ξj) / σj.
Этот множитель переводит градиент по ℓ в сигнал по ξ, который выдавал предыдущий слой. Он сохраняется для соответствующего обратного прохода.
В flags отмечаются неконечные выходные параметры и производные. Эти признаки позволяют остановить вычисление при обнаруженной числовой ошибке.
В MQL5 вызов оформлен методом feedForward. Макросы setBuffer и setArgument передают параметры кернелу, а kernelExecute запускает его. Они также проверяют результат и при отказе выводят диагностику и завершают текущий метод. Определения находятся в NeuroNet_Definitions.mqh.
bool CNeuronHabiGaussianOCL::feedForward(CNeuronBaseOCL *p,CBufferFloat *ctx)
  {
   if(!p || p.Neurons()!=2*L || Neurons()!=2*L || !frame.Forward(ctx,0,bTrain) ||
      !Ready(0,L) || !Ready(6,L))
      return(false);

   int k=def_k_HabiGaussianForward;

   setBuffer(k,0,p.getOutputIndex())
   setBuffer(k,1,Output.GetIndex())
   setBuffer(k,2,scratch[0].GetIndex())
   setBuffer(k,3,scratch[6].GetIndex())
   setArgument(k,4,(int)L)

   uint off[]= {0};
   uint sz[]= {L};

   kernelExecute(k,off,sz)

   return(Finite(L));
  }
Вход и выход должны иметь длину 2L. Проверка frame.Forward связывает вычисление с его контекстом. Буфер scratch[0] хранит производную преобразования ξ → ℓ, а scratch[6] — диагностические признаки. Они имеют длину L, поскольку одной координате соответствуют одно преобразование масштаба и одна диагностическая запись.
Рабочая область содержит L элементов. После запуска Finite проверяет диагностические записи. Полученный вектор [μ; ℓ] описывает распределение; случайные выборки создаст следующий объект.
Обратный проход и согласование распределений
При обучении Posterior знает эталонное действие, а Prior его не получает. Поэтому одного воспроизведения эталона недостаточно: нужно согласовать распределения двух энкодеров. Эту задачу решает условная KL-дивергенция.
Обозначим распределения Posterior и Prior через q и p. Они условные: q зависит от наблюдения и эталона, p — только от наблюдения. При диагональной ковариации расхождение вычисляется по координатам:
K = DKL(q ∥ p) = ½ ∑(j = 0…L−1) [ℓp,j − ℓq,j + exp(ℓq,j − ℓp,j)
+ (μq,j − μp,j)² exp(−ℓp,j) − 1].
В индексах p и q обозначают распределения, j — координату; границы суммы указаны в скобках. Мы сравниваем два обучаемых распределения, а не притягиваем одно из них к стандартной нормали.
В обратном проходе Posterior получает сигнал воспроизведения эталона вместе с градиентом KL. Prior на этом этапе получает только сигнал согласования. Для последующего улучшения политики предусмотрен отдельный режим передачи градиента через Critic и Decoder.
В начале calcInputGradients проверяем роль и извлекаем данные соответствующего режима:
bool CNeuronHabiGaussianOCL::calcInputGradients(CNeuronBaseOCL *p,CBufferFloat *ctx,
      CBufferFloat *sg,ENUM_ACTIVATION ac=None)
  {
   int mode;
   uint token;

   if(!frame.Header(ctx,mode,token) || (posterior?mode!=12:(mode!=11 && mode!=13)))
      return(false);

   int payload=(int)(mode==12?4*L+1:(mode==11?2*L+1:2*L));

   if(!frame.Backward(ctx,payload) || !Ready(1,2*L) || !Ready(2,2*L) || !Ready(3,L) ||
      !Ready(4,1) || !Ready(5,L) || !Ready(8,L))
      return(false);

   float beta=0;

   if(mode==13)
     {
      if(!HabiPayload(ctx,4,2*L,GetPointer(scratch[2]),OpenCL))
         return(false);
     }
   else
     {
      if(!HabiPayload(ctx,4,2*L,GetPointer(scratch[1]),OpenCL))
         return(false);

      beta=ctx.At(4+(mode==12?4:2)*L);

      if(beta<0)
         return(false);

      if(mode==12 && !HabiPayload(ctx,4+2*L,2*L,GetPointer(scratch[2]),OpenCL))
         return(false);
     }
Режим 12 соответствует B_POSTERIOR_BC. В контексте передаются параметры Prior, градиент по выходному распределению от Decoder и β. Режим 11 соответствует B_PRIOR_KL: нужны параметры Posterior и тот же β. В режиме 13, B_PRIOR_POLICY, поступает готовый градиент по параметрам распределения; KL к нему не добавляется.
Начальный сдвиг 4 пропускает заголовок контекста. После него располагаются числовые данные выбранного режима. В scratch[1] сохраняются параметры второго распределения, а в scratch[2] — входящий градиент. Значения обоих распределений должны относиться к тому шагу, для которого выполняется обратный проход. Повторно вычислять их после изменения весов означало бы решать уже другую задачу.
Основную математику выполняет HabiGaussianBackward:
__kernel void HabiGaussianBackward(__global const float *self,
                  __global const float *peer, __global const float *reconstruction,
                  __global const float *chain, __global float *gradient_mu,
                  __global float *gradient_xi, __global float *terms, __global float *flags,
                  int L, int mode, float beta)
  {
   int j=get_global_id(0);
   float gm=0, ge=0, kl=0;
   if(mode==13) { gm=reconstruction[j]; ge=reconstruction[j+L]; }
   else
     {
      float mq=mode==12?self[j]:peer[j], mp=mode==12?peer[j]:self[j];
      float lq=mode==12?self[j+L]:peer[j+L], lp=mode==12?peer[j+L]:self[j+L];
      float d=mq-mp, ivp=exp(-lp), ratio=exp(lq-lp);
      kl=0.5f*(lp-lq+ratio+d*d*ivp-1.0f);
      if(mode==12) { gm=reconstruction[j]-beta*d*ivp;
                     ge=reconstruction[j+L]-0.5f*beta*(ratio-1.0f); }
      else { gm=beta*d*ivp; ge=0.5f*beta*(ratio+d*d*ivp-1.0f); }
     }
   gradient_mu[j]=gm; gradient_xi[j]=ge*chain[j]; terms[j]=kl;
   flags[j]=(!isfinite(gm)||!isfinite(gradient_xi[j])||!isfinite(kl));
  }
Буфер self содержит выход текущего Gaussian-слоя, peer — параметры второго энкодера. В зависимости от режима кернел назначает им роли q и p. Поэтому формула KL остаётся одной и той же независимо от того, какой энкодер сейчас получает градиент. Переменная ratio равна отношению дисперсий, ivp — обратной дисперсии Prior, а d — разности средних.
Это соответствует соглашению библиотеки: передаётся отрицательная производная ошибки (направление уменьшения). В ветви Posterior к входящему сигналу воспроизведения добавляется отрицательный градиент взвешенной KL. В ветви Prior формируется только сигнал согласования. Изменяются и средние, и параметры масштаба; согласование не сводится к сближению двух средних векторов.
В режиме 13 кернел не вычисляет KL. Он принимает два готовых блока обратного сигнала. Название аргумента reconstruction в этой ветви обозначает тот же буфер передачи данных, но его содержимое уже относится к улучшению политики, а не к воспроизведению эталона.
В ge объединены вклады по ℓ. Умножение на сохранённый chain переводит их в градиент по ξ — параметру предыдущего слоя. Средние и масштабы получают общий обратный проход.
Кернел также записывает вклад каждой координаты в KL в массив terms. Деления на число кандидатов N здесь нет: распределения согласуются один раз для текущего наблюдения. Входящий от генератора сигнал уже должен иметь масштаб, заданный соответствующей функцией потерь.
На стороне MQL5 передаём кернелу выход текущего слоя, данные контекста и сохранённый множитель chain. После запуска формируем градиент для предыдущего слоя:
   int k=def_k_HabiGaussianBackward;

   setBuffer(k,0,Output.GetIndex())
   setBuffer(k,1,scratch[1].GetIndex())
   setBuffer(k,2,scratch[2].GetIndex())
   setBuffer(k,3,scratch[0].GetIndex())
   setBuffer(k,4,scratch[5].GetIndex())
   setBuffer(k,5,scratch[8].GetIndex())
   setBuffer(k,6,scratch[3].GetIndex())
   setBuffer(k,7,scratch[6].GetIndex())
   setArgument(k,8,(int)L)
   setArgument(k,9,mode)
   setArgument(k,10,beta)

   uint off[]= {0};
   uint sz[]= {L};

   kernelExecute(k,off,sz)

   if(!Finite(L) || !Concat(GetPointer(scratch[5]),GetPointer(scratch[8]),Gradient,L,L,1) ||
      !DeActivation(p.getOutput(),p.getGradient(),Gradient,None))
      return(false);
Полученные блоки объединяются в вектор [gμ; gξ]. Вызов DeActivation с аргументом None не добавляет ещё одну нелинейную производную. Он записывает результат в градиентный буфер предыдущего слоя и применяет стандартную обработку библиотеки, включая ограничение величины градиента. На этой границе ограничение выполняется после объединения сигналов и преобразования ℓ → ξ, а не отдельно для каждого слагаемого.
Для Posterior остаётся получить суммарную KL-дивергенцию. Завершающая часть метода использует существующую операцию суммирования:
   if(mode==12)
     {
      k=def_k_DPCCDenoiserBroadcastGradient;

      setBuffer(k,0,scratch[3].GetIndex())
      setBuffer(k,1,scratch[4].GetIndex())
      setBuffer(k,2,scratch[6].GetIndex())
      setArgument(k,3,(int)L)
      setArgument(k,4,1)

      sz[0]=1;

      kernelExecute(k,off,sz)

      if(!Finite(1) || !scratch[4].BufferRead())
         return(false);

      cached_K=scratch[4].At(0);
     }

   return(true);
  }
В операции суммирования L задаёт число строк, ширина равна единице. Результат сохраняется в cached_K. Здесь переиспользуется только вычислительный примитив DPCCDenoiserBroadcastGradient, без вызова торгового планировщика.
Сохранённое K используется механизмом адаптации β, когда такой режим включён. Для текущего согласования оба энкодера получают одинаковый коэффициент. Его последующее изменение относится к следующему шагу, поэтому сила согласования не меняется между обратными проходами Posterior и Prior.
Теперь [μ; ℓ] можно передать в CNeuronHabiVAEOCL. Gaussian-слой отвечает за формат распределения и обратный сигнал по его параметрам; вариационный слой создаст сами выборки.
Пакетная генерация латентных представлений
Для одного наблюдения получим несколько латентных векторов. Случайность здесь нужна для создания вариантов внутри распределения, заданного энкодером. Она не выбирает сделку для исполнения: преобразование в действия и их сравнение выполняются дальше.
CNeuronHabiVAEOCL принимает 2L параметров [μ; ℓ] и возвращает N векторов длиной L. Параметры общие, случайные значения различаются. Например, при L = 256 и N = 8 вход содержит 512 чисел, а выход — 2048. Это пример размерностей, не рекомендация настройки. Разные латентные векторы ещё не гарантируют полезных торговых предложений.
Архитектура и инициализация
CNeuronHabiVAEOCL наследует непосредственно CVAE. В сокращённом объявлении покажем настройки, собственные буферы и методы проходов:
class CNeuronHabiVAEOCL : public CVAE
  {
public:
                     CNeuronHabiVAEOCL();
   virtual int       Type() const override
     {
      return(defNeuronHabiVAEOCL);
     }
   virtual bool      Configure(CLayerDescription *d);
   // ... служебные методы опущены ...
protected:
   uint              N;
   uint              L;
   SHabiFrame        frame;
   CBufferFloat      direct;
   CBufferFloat      flags;
   virtual bool      feedForward(CNeuronBaseOCL *p,CBufferFloat *ctx) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *p,CBufferFloat *ctx,CBufferFloat *sg,
                                        ENUM_ACTIVATION ac=None) override;
  };
Поля N и L задают число кандидатов и длину каждого представления. Структура frame связывает прямой и обратный проходы. Буфер direct предназначен для дополнительного градиента, поступающего непосредственно от латентного входа Critic. В flags сохраняются результаты числовой проверки прямого прохода.
Выход, основной градиентный буфер и случайные значения m_cRandom наследуются. Шум сохраняется для обратного прохода: новая случайная выборка не соответствовала бы сохранённому прямому проходу.
Конструктор задаёт начальные размеры и отключает встроенную KL-регуляризацию:
CNeuronHabiVAEOCL::CNeuronHabiVAEOCL()
  {
   N=1;
   L=1;

   frame.Reset();
   SetKLDMult(0);
  }
Встроенный KL относительно стандартной нормали не используется: условное согласование Prior и Posterior выполняет Gaussian-слой.
Унаследованный CVAE::Init создаёт основные буферы и m_cRandom длиной N × L. Затем Configure считывает N и L из описания и проверяет размер выхода:
bool CNeuronHabiVAEOCL::Configure(CLayerDescription *d)
  {
   N=d.window;
   L=d.window_out;

   return(N>0 && L>0 && Neurons()==N*L);
  }
Вход предыдущего слоя остаётся длиной 2L; он проверяется в прямом проходе. С ростом N увеличиваются буферы выборок, выходов и градиентов. Вспомогательные flags и direct подготавливаются при первом соответствующем вычислении.
Прямой проход
Метод feedForward запускает двумерную ветвь VAE_FeedForward, рассмотренную в первой статье:
bool CNeuronHabiVAEOCL::feedForward(CNeuronBaseOCL *p,CBufferFloat *ctx)
  {
   if(!p || p.Neurons()!=2*L || !frame.Forward(ctx,0,bTrain) || frame.mode!=21 ||
      !HabiScratch(GetPointer(flags),OpenCL,N*L))
      return(false);

   double draws[];

   if(!MathRandomNormal(0,1,N*L,draws) || !m_cRandom.AssignArray(draws) ||
      !m_cRandom.BufferWrite())
      return(false);

   int k=def_k_VAEFeedForward;

   setBuffer(k,0,p.getOutputIndex())
   setBuffer(k,1,m_cRandom.GetIndex())
   setBuffer(k,2,Output.GetIndex())
   setBuffer(k,3,flags.GetIndex())
   setArgument(k,4,1)

   uint off[]= {0,0};
   uint sz[]= {L,N};

   kernelExecute(k,off,sz)

   if(!flags.BufferRead())
      return(false);

   for(int i=0;i<flags.Total();i++)
      if(flags.At(i)!=0)
         return(false);

   return(true);
  }
Помимо размера входа проверяется режим F_DECODER_SAMPLE с кодом 21. frame.Forward связывает вызов с контекстом и не позволяет перезаписать незавершённый обучающий проход.
Далее создаём N × L случайных значений из стандартного нормального распределения. В этой реализации генерация шума выполняется на стороне MQL5. Массив draws переносится в наследуемый m_cRandom, после чего BufferWrite записывает его в память устройства. Кернел получает готовую выборку, а не создаёт её самостоятельно.
Рабочая область {L, N} распределяет вычисления по координатам j и кандидатам n. Для каждой пары выполняется репараметризация:
zn,j = μj + exp(ℓj / 2) εn,j.
Параметры распределения μ и ℓ общие для всех строк. Случайное значение ε выбирается отдельно для каждой координаты каждого кандидата. Результат записывается построчно: индекс элемента равен nL + j. Получается единый выходной буфер, содержащий N последовательных латентных векторов.
Последний аргумент кернела включает диагностику. После запуска проверяем flags: при неконечном входе, масштабе или результате метод возвращает false. Такой пакет не передаётся дальше как корректный результат.
В показанном методе шум генерируется и при фиксированных весах. Флаг обучения определяет необходимость сохранить состояние для обратного прохода, но не заменяет случайную выборку средним распределения. Поэтому повторный вызов для одного наблюдения может дать другой набор представлений. При последующей оценке должны использоваться именно те векторы, из которых получены соответствующие действия.
Обратный проход
После преобразования латентных векторов в действия обратный сигнал возвращается в буфер Gradient. Его длина составляет N × L. Требуется собрать вклад всех кандидатов в общий вектор по μ и ℓ, содержащий только 2L элементов.
При улучшении политики учитывается дополнительная связь. Critic получает не только действие, но и соответствующий латентный вектор. Поэтому изменение этого вектора влияет на оценку двумя путями: непосредственно через вход оценщика и через сформированное действие. Перед обратной репараметризацией необходимо сложить оба вклада.
В начале calcInputGradients проверяем контекст и добавляем прямой вклад:
bool CNeuronHabiVAEOCL::calcInputGradients(CNeuronBaseOCL *p,CBufferFloat *ctx,
      CBufferFloat *sg,ENUM_ACTIVATION ac=None)
  {
   int mode;
   uint token;

   if(!frame.Header(ctx,mode,token))
      return(false);

   if(mode!=B_DECODER_BC && mode!=B_DECODER_POLICY)
      return(false);

   int payload=(int)(mode==B_DECODER_BC?6:N*6+N*L);

   if(!frame.Backward(ctx,payload))
      return(false);

   if(mode==B_DECODER_POLICY)
     {
      if(!HabiPayload(ctx,4+N*6,N*L,GetPointer(direct),OpenCL) ||
         !SumAndNormalize(Gradient,GetPointer(direct),Gradient,N*L,false,0,0,0,1))
         return(false);
     }
Перед проверкой длины контекста метод допускает только B_DECODER_BC и B_DECODER_POLICY (23 и 24). Иные режимы отклоняются до вычисления градиентов.
В режиме B_DECODER_BC (23) контекст содержит шесть компонентов эталона. Начальный градиент формирует выходной объект генератора; вариационный слой получает его после распространения через последующие слои.
Режим 24 соответствует B_DECODER_POLICY. После четырёх элементов заголовка в контексте располагаются N × 6 градиентов по действиям, затем N × L прямых градиентов по латентным векторам. Поэтому второй блок читается со сдвигом 4 + N × 6. Число 6 в исходнике связано с принятой схемой Action6, а не с размерностью латентного пространства.
К моменту выполнения этого метода вклад через действия уже находится в Gradient. С помощью HabiPayload переносим прямой вклад в direct и складываем оба буфера. У SumAndNormalize нормализация отключена, а множитель равен единице. Здесь нужна именно сумма двух путей, без их дополнительного усреднения.
Далее проверяем, допускает ли устройство выбранный способ редукции:
   long memory=0;

   if(N>(uint)OpenCL.GetMaxWorkGroupSize() || N>(uint)OpenCL.GetMaxLocalSize(1) ||
      OpenCL.GetKernelInfoInteger(def_k_VAECalcHiddenGradient,CL_KERNEL_WORK_GROUP_SIZE)<N ||
      !OpenCL.GetLocalMemorySize(memory) ||
      OpenCL.GetKernelInfoInteger(def_k_VAECalcHiddenGradient,CL_KERNEL_LOCAL_MEM_SIZE)>memory)
      return(false);
В обратном кернеле одна рабочая группа собирает вклад N кандидатов для одной латентной координаты. Поэтому N должно укладываться в ограничения общей рабочей группы, её второго измерения и конкретного кернела. Отдельно проверяется требуемая локальная память. Эти проверки выполняются перед запуском обратного кернела. При несоответствии метод возвращает false, не меняя число кандидатов автоматически.
Передадим буферы и запустим обратный кернел. Макрос kernelExecuteLoc дополнительно задаёт локальную рабочую область:
   int k=def_k_VAECalcHiddenGradient;

   setBuffer(k,0,p.getOutputIndex())
   setBuffer(k,1,p.getGradientIndex())
   setBuffer(k,2,m_cRandom.GetIndex())
   setBuffer(k,3,Gradient.GetIndex())
   setArgument(k,4,0.0f)

   uint off[]= {0,0};
   uint sz[]= {L,N};
   uint local[]= {1,N};

   kernelExecuteLoc(k,off,sz,local)

   return(true);
  }
Кернел читает исходные параметры распределения, сохранённый m_cRandom и суммарный сигнал из Gradient. Результат записывается в градиентный буфер предыдущего слоя. Новая случайная выборка здесь не создаётся.
Глобальная область остаётся {L, N}, но локальная задаётся явно — {1, N}. Все потоки группы относятся к одной координате j и обрабатывают разные строки n. После локального суммирования только один поток записывает итоговую пару значений. Тем самым N вкладов не конкурируют за запись в общий элемент памяти.
Если обозначить через c входящий сигнал после предусмотренной кернелом обработки и ограничения, то для конечных значений результат имеет вид:
gμ,j = ∑(n = 0…N−1) cn,j,
gℓ,j = ½ exp(ℓj / 2) ∑(n = 0…N−1) cn,j εn,j.
Знаки сохраняют принятое библиотекой соглашение об отрицательном градиенте. Дополнительного деления на N в вариационном слое нет: масштаб обучающего сигнала задаётся при формировании соответствующей функции потерь. На выходе обратного прохода вновь получаем компактный вектор длиной 2L. Рассмотренный Gaussian-слой затем переводит его часть по ℓ в сигнал по параметру ξ.
У CNeuronHabiVAEOCL нет собственных обучаемых параметров семплирования. Он связывает общее распределение с несколькими выборками и возвращает их суммарный обратный сигнал. Преобразование этих представлений в действия и их оценку рассмотрим в следующих статьях.
Заключение
Мы подготовили три компонента вероятностной части Habi и их общую базу. CNeuronHabiObservationOCL нормализует рыночные признаки и сохраняет представление счёта. CNeuronHabiGaussianOCL преобразует выход энкодера в параметры распределения и формирует градиенты его согласования. CNeuronHabiVAEOCL получает из этих параметров пакет латентных векторов.
В прямом проходе одно распределение даёт несколько выборок. В обратном их вклады возвращаются к общим параметрам. Сохранённый шум связывает эти вычисления, а согласование двух энкодеров помогает перенести подготовку по эталону в генерацию по доступному наблюдению.
Для трейдера это основа получения альтернатив при одном состоянии рынка и счёта. Латентные векторы ещё предстоит преобразовать в действия и оценить. Качество торговли и вычислительную скорость по устройству этих компонентов определить нельзя; результаты экспериментов здесь не заявляются.
В следующих статьях завершим объекты формирования и оценки действий, соберём модели Prior, Posterior, Decoder и Critic. После этого рассмотрим подготовку данных, обучение, онлайн-адаптацию и тестирование.
Ссылки
- Habitizing Diffusion Planning for Efficient and Effective Decision Making.
- Другие статьи серии "Нейросети в трейдинге".
Файлы проекта
В таблице перечислены файлы полного проекта. В этой части используются NeuroNet_Habi.mqh и соответствующие кернелы NeuroNet.cl; обучающие программы будут рассмотрены далее.
| # | Имя | Тип | Описание |
|---|---|---|---|
| 1 | Trajectory.mqh | Общий модуль | Подключение модулей моделей, истории и исполнения; общий запуск |
| 2 | Study.mq5 | Советник | Советник предварительного офлайн обучения |
| 3 | StudyOnline.mq5 | Советник | Советник тонкой онлайн настройки |
| 4 | Test.mq5 | Советник | Исполнение торговой политики с фиксированными весами |
| 5 | NeuroNet.mqh | Библиотека классов | Подключение модулей нейронной библиотеки |
| 6 | NeuroNet.cl | OpenCL-программа | Вычислительные кернелы нейронной библиотеки |
| 7 | NeuroNet_Habi.mqh | Библиотека классов | Базовый слой и компоненты Habi, рассматриваемые в статье |
Репозиторий проекта: NN_in_Trading.
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 Особенности написания Пользовательских Индикаторов
 Разработка объектно-ориентированного сканера разрывов справедливой стоимости (FVG) на MQL5

 Создание системы торговой аналитики (Часть 3): Сохранение данных о сделках MetaTrader 5 в SQLite

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования