

Шероховатая волатильность: Индекс шероховатости на основе модели RFSV для фильтрации сделок с помощью машинного обучения
 69
 0

Введение
Большинство моделей волатильности, распространённых среди частных трейдеров, предполагают, что сама волатильность меняется плавно: будь то EWMA или GARCH(1,1), обе модели основаны на идее, что сегодняшняя дисперсия — это плавное сочетание вчерашней дисперсии и вчерашнего шока. В действительности рыночная волатильность ведёт себя иначе. Со времени работы Гатерала, Джейссона и Розенбаума 2014 года, в которой было введено то, что теперь называют шероховатой волатильностью, накапливается всё больше эмпирических данных, показывающих, что сам логарифм волатильности напоминает фрактальное броуновское движение с показателем Херста значительно ниже стандартного значения 0,5 — обычно в диапазоне от 0,05 до 0,15. Проще говоря, волатильность "шероховатее", чем случайное блуждание. Она резко колеблется и возвращается к среднему на гораздо более коротких временных масштабах, чем предсказывает модель плавного диффузионного процесса.
В этой статье пошагово разбирается, как превратить это наблюдение в инструмент, который можно использовать в торговом советнике. Мы получаем скользящую оценку индекса шероховатости — локального показателя Херста — непосредственно по ценовым данным XAUUSD на таймфрейме M5 с помощью обобщённой регрессии по структурной функции, реализованной средствами MQL5 без внешних DLL и зависимости от ALGLIB. Этот индекс шероховатости вместе с двумя дополнительными признаками подаётся на вход классификатора на основе градиентного бустинга, обученного вне торгового советника в Python и развёрнутого с помощью ONNX. Торговый советник использует выход классификатора как самостоятельный фильтр направления сделок: открывает длинную позицию, когда модель уверенно определяет, что рыночный режим благоприятствует росту, короткую — когда он благоприятствует снижению, а во всех промежуточных случаях остаётся вне рынка.
Весь приведённый ниже код работает и предназначен для реального использования. Это тот же код, что и в архиве для скачивания, а не упрощённые примеры. Сначала я разберу математическую основу, затем — её реализацию средствами MQL5, далее — конвейер обучения вне советника, который должен воспроизводить те же вычисления бар за баром, и, наконец, покажу, как торговый советник объединяет все три компонента для открытия позиций, установки стоп-ордеров и расчета размера позиции.
Одним из ключевых архитектурных решений является вычисление шероховатости непосредственно в MQL5. Шероховатость не вычисляется заранее вне советника и не поступает извне в виде потока данных. Её расчёт также не передаётся DLL. Торговый советник, работающий в реальном времени, должен пересчитывать H_t при закрытии каждого бара. Он не должен полагаться на внешние зависимости, к которым у агентов тестера стратегий может не быть доступа, или зависеть от задержек при отправке запросов внешним процессам и получении ответов от них. Реализация регрессии по структурной функции в виде простых вычислений с накоплением сумм на MQL5 вместо использования более универсальных процедур регрессии из ALGLIB делает оцениватель самодостаточным, позволяет проверять код строка за строкой и обеспечивает достаточное быстродействие для расчета на каждом баре.
О рамках статьи: в этой статье описано реальное, завершенное первичное тестирование индекса шероховатости в качестве самостоятельного признака для прогнозирования направления движения цены — и это тестирование в тестере стратегий оказалось убыточным. Я подробно разбираю всю систему и честно представляю полученный результат, в том числе вероятные причины неудачи, вместо того чтобы ждать появления прибыльного решения и только тогда публиковать материал.
Содержание
- Введение
- Шероховатая волатильность и модель RFSV
- Расчет индекса шероховатости непосредственно в MQL5
- От потока цен к вектору признаков
- Обучение классификатора и его экспорт в формат ONNX
- Интеграция компонентов торгового советника
- Пограничные случаи и возможные проблемы
- Тестирование в тестере стратегий
- Заключение
Шероховатая волатильность и модель RFSV
Модель шероховатой фрактальной стохастической волатильности (RFSV) описывает логарифм волатильности как фрактальное броуновское движение:
log σ t = m + η · BHt
где BH — фрактальное броуновское движение с показателем Херста H, m — долгосрочный средний уровень, а η задает амплитуду колебаний. Когда H = 0,5, получается обычное броуновское движение — классическое допущение о диффузии, приводящееся в учебниках. Эмпирические исследования волатильности фондовых индексов, валют и сырьевых товаров неизменно показывают, что H значительно ниже 0,5, а зачастую — ниже 0,15. Низкое значение H означает, что траектория более шероховатая: в ней больше высокочастотных колебаний и слабее выражена долгосрочная персистентность, чем при стандартном случайном блуждании, а после шока она склонна резче возвращаться к среднему.
Прием оценивания, который позволяет применять этот подход на практике, основан на свойствах масштабирования фрактального броуновского движения. Для любого лага Δ математическое ожидание квадрата приращения пропорционально лагу, возведенному в некоторую степень:
E[ (log σ t+Δ - log σ t )² ] ∝ Δ2H
После логарифмирования обеих частей получается линейная зависимость: логарифм математического ожидания квадрата приращения зависит от логарифма лага с коэффициентом наклона, в точности равным 2H. Итак, процедура оценивания такова: вычислить эмпирическую структурную функцию m(Δ) — среднее значение квадрата приращения — для нескольких разных лагов, построить регрессию log m(Δ) на log Δ и определить H как половину коэффициента наклона. Вот и весь оцениватель — именно он реализован как в приведенном ниже классе MQL5, так и в его аналоге на Python.
Одна из практических проблем заключается в том, что отдельная доходность между ценами закрытия соседних баров M5 содержит слишком много шума для оценки логарифма волатильности. В ней преобладают эффекты микроструктуры рынка и колебания между ценами спроса и предложения, а не собственно волатильность. Во всей системе эта проблема решается с помощью агрегирования по блокам: квадраты логарифмических доходностей суммируются по небольшому окну баров (по умолчанию — шесть баров M5, то есть тридцать минут) для получения оценки реализованной дисперсии, а затем логарифм этой реализованной дисперсии используется как одна точка ряда логарифма волатильности. Это та же процедура "сначала реализованная дисперсия, затем логарифм", которая используется в большинстве эмпирических исследований шероховатой волатильности, только адаптированная к внутридневным данным на основе баров вместо дневных цен закрытия.
Оцениватель в одном предложении: агрегировать доходности по блокам для получения реализованной дисперсии → взять логарифм → для каждого лага вычислить средний квадрат приращений и построить регрессию его логарифма на логарифм лага → H равно половине коэффициента наклона.
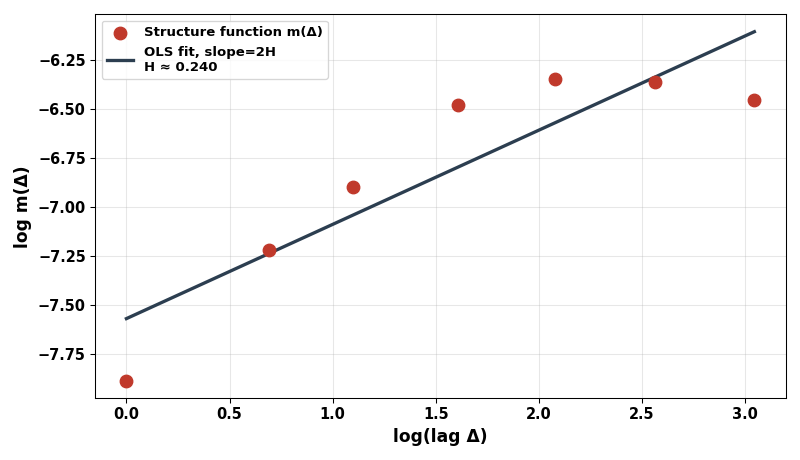
Рис. 1. График структурной функции m(Δ) в зависимости от лага Δ в двойном логарифмическом масштабе для синтетического ряда логарифма шероховатой волатильности (истинное значение H ≈ 0,10). Коэффициент наклона регрессии, деленный на два, дает локальную оценку показателя Херста.
Почему это важно как признак для машинного обучения, а не просто как предмет академического интереса? Снижение индекса шероховатости обычно наблюдается, когда волатильность беспорядочно колеблется и возвращается к среднему, а не следует тренду, — то есть в рыночном режиме, при котором сигналы направления менее надежны. Рост H до более умеренных значений, ближе к 0,5, скорее соответствует более плавной и устойчивой динамике волатильности, которая исторически связана с более отчетливым продолжением тренда. Классификатору не нужно явно задавать эту взаимосвязь: он выявляет те закономерности, которые действительно присутствуют в обучающих данных с разметкой по показателю H. Однако признак с теоретическим обоснованием дает ему гораздо лучшую отправную точку, чем исходные цены или обычная мера волатильности.
Стоит сразу оговорить упрощение, принятое здесь по сравнению с академической литературой по RFSV. Исходный оцениватель Гатерала — Джейссона — Розенбаума оценивает H по нескольким моментам приращений логарифма волатильности (q = 0,5; 1; 1,5; 2; 3) и строит регрессию полученных показателей масштабирования на q. Это статистически более эффективно, поскольку объединяет информацию по моментам разных порядков, а не опирается только на дисперсию (q = 2). Реализация такого оценивателя по нескольким моментам с расчетом на каждом баре в MQL5 без полноценной библиотеки линейной алгебры требует значительных вычислительных затрат, поэтому здесь используется вариант того же соотношения масштабирования с одним моментом (q = 2). В итоге мы получаем несколько более шумную оценку H, но сам оцениватель занимает лишь несколько десятков строк кода на MQL5 с накоплением сумм и не требует внешних зависимостей — разумный компромисс для признака, который нужно вычислять на каждом баре в реальном времени.
Расчет индекса шероховатости непосредственно в MQL5
Оцениватель реализован в CHurstEstimator — автономном классе, не зависящем от ALGLIB или внешних DLL. Для регрессии нужны лишь несколько переменных для накопления сумм и коэффициент наклона регрессии, оцененный методом наименьших квадратов по явной формуле, поэтому расчеты можно выполнять на каждом баре без опасений за производительность. Класс хранит значения логарифма волатильности в собственном кольцевом буфере, поэтому советнику не нужно напрямую управлять индексацией массива: он просто вызывает Update() один раз после завершения каждого блока расчета волатильности и ComputeRoughness() всякий раз, когда требуется новая оценка.
В приведенном ниже блоке констант заданы общие для всего подключаемого файла параметры размерности: максимальная длина набора лагов, которую допускает оцениватель, и фиксированные размерности входа и выхода, ожидаемые классификатором ONNX. Использование именованных констант вместо "магических чисел" обеспечивает согласованность размерностей в советнике, оценивателе и обертке ONNX без необходимости синхронизировать их вручную.
//+------------------------------------------------------------------+
//| Includes                                                         |
//+------------------------------------------------------------------+
#include <Trade\Trade.mqh>          // CTrade wrapper used by the EA for order placement

//+------------------------------------------------------------------+
//| Compile-time constants                                           |
//+------------------------------------------------------------------+
#define RFSV_MAX_LAGS      8        // hard ceiling on lag-ladder length used in the structure-function regression
#define RFSV_MODEL_INPUTS  3        // feature count the ONNX classifier expects: H, vol level, vol-of-vol
Вот полный код класса, точно в том виде, в каком он поставляется в файле RFSV_Roughness.mqh. Обратите внимание на вспомогательную функцию индексации кольцевого буфера RingIndex(): вместо физического сдвига массива при каждом обновлении (что потребовало бы O(n) операций на каждый бар) используется циклическая адресация буфера, и только на этапе считывания в функции ComputeRoughness() данные последнего окна копируются в рабочий массив в линейном порядке. Конструктор инициализирует m_lastH значением 0,5, соответствующим стандартному броуновскому движению, чтобы при обращении к оценивателю до завершения периода накопления начальных данных получить нейтральное, а не неинициализированное значение.
В функции ComputeRoughness() код перебирает каждый лаг из набора лагов и вычисляет средний квадрат приращений по допустимым парам. Код пропускает лаги, для которых имеется менее пяти пар, а также лаги с неположительными средними значениями (чтобы избежать недопустимых аргументов функции MathLog()). Затем код вычисляет коэффициент наклона регрессии, оцененный методом наименьших квадратов, используя четыре накопленные суммы и обходясь без промежуточных массивов. Оценка показателя Херста ограничивается интервалом [0,01; 0,60] — достаточно широким, чтобы охватить все значения, встречающиеся в эмпирических исследованиях, и достаточно узким, чтобы при действительно вырожденном окне (например, с почти постоянной волатильностью) классификатор не получал экстремальное значение-выброс, которого не было в обучающих данных.
//+------------------------------------------------------------------+
//| CHurstEstimator                                                  |
//+------------------------------------------------------------------+
//| Maintains a rolling buffer of log-volatility observations and    |
//| estimates the local roughness (Hurst exponent H) of that series  |
//| via a generalized structure-function regression:                 |
//|   m(Delta) = mean( (logVol[t] - logVol[t-Delta])^2 )             |
//|   log(m(Delta)) ~= 2H * log(Delta) + const                       |
//| so H is recovered as half the OLS slope of log(m) on log(Delta). |
//| This mirrors the offline Python estimator bar-for-bar so the     |
//| live feature and the training feature are computed identically.  |
//+------------------------------------------------------------------+
class CHurstEstimator
  {
private:
   double            m_logVol[];       // circular buffer of block-level log-volatility values
   int               m_capacity;       // physical size of m_logVol (>= m_window)
   int               m_count;          // number of valid entries currently stored
   int               m_head;           // index where the next value will be written (ring pointer)
   int               m_window;         // regression window length (how many points feed the slope fit)
   int               m_lags[];         // lag ladder (in blocks) used to build the structure function
   int               m_lagCount;       // number of active lags in m_lags
   double            m_lastH;          // most recently computed Hurst estimate
   double            m_lastVolOfVol;   // std-dev of the log-vol series over the regression window

   //+------------------------------------------------------------------+
   //| RingIndex                                                        |
   //+------------------------------------------------------------------+
   int               RingIndex(const int logicalIndex) const
     {
      // logicalIndex counts forward from the oldest retained sample
      int start = (m_head - m_count + m_capacity) % m_capacity;
      return (start + logicalIndex) % m_capacity;
     }

public:
                     CHurstEstimator();
                    ~CHurstEstimator() {};

   bool              Init(const int window,const int &lags[],const int lagCount);
   void              Update(const double newLogVol);
   bool              IsReady() const { return (m_count>=m_window); }
   bool              ComputeRoughness(double &H_out,double &volOfVol_out);
   double            LastH() const { return m_lastH; }
   double            LastVolOfVol() const { return m_lastVolOfVol; }
  };

//+------------------------------------------------------------------+
//| Constructor                                                      |
//+------------------------------------------------------------------+
CHurstEstimator::CHurstEstimator()
  {
   m_capacity     = 0;
   m_count        = 0;
   m_head         = 0;
   m_window       = 0;
   m_lagCount     = 0;
   m_lastH        = 0.5;   // neutral default (standard Brownian) before any data has arrived
   m_lastVolOfVol = 0.0;
  }

//+------------------------------------------------------------------+
//| Init                                                             |
//+------------------------------------------------------------------+
bool CHurstEstimator::Init(const int window,const int &lags[],const int lagCount)
  {
//--- guard: a regression needs more points than the largest lag it tests, otherwise m(Delta) is undefined
   if(window<20 || lagCount<3 || lagCount>RFSV_MAX_LAGS)
      return(false);

   m_window   = window;
//--- buffer is sized generously beyond the window so Update() never has to reallocate mid-run
   m_capacity = window*2;
   ArrayResize(m_logVol,m_capacity);
   ArrayInitialize(m_logVol,0.0);

   m_lagCount = lagCount;
   ArrayResize(m_lags,m_lagCount);
   for(int i=0;i<m_lagCount;i++)
     {
      //--- reject any lag that would exceed the window; such a lag has too few pairs to average reliably
      if(lags[i]<1 || lags[i]>=window)
         return(false);
      m_lags[i]=lags[i];
     }

   m_count = 0;
   m_head  = 0;
   return(true);
  }

//+------------------------------------------------------------------+
//| Update                                                           |
//+------------------------------------------------------------------+
void CHurstEstimator::Update(const double newLogVol)
  {
//--- write into the ring slot, then advance head; overwritten entries simply age out of the window
   m_logVol[m_head]=newLogVol;
   m_head=(m_head+1)%m_capacity;
   if(m_count<m_capacity)
      m_count++;
  }

//+------------------------------------------------------------------+
//| ComputeRoughness                                                 |
//+------------------------------------------------------------------+
bool CHurstEstimator::ComputeRoughness(double &H_out,double &volOfVol_out)
  {
   if(!IsReady())
      return(false);

//--- pull the most recent m_window observations out of the ring buffer into a linear working array
   double series[];
   ArrayResize(series,m_window);
   int offset=m_count-m_window;   // skip older samples beyond the window if the buffer holds more than needed
   for(int i=0;i<m_window;i++)
      series[i]=m_logVol[RingIndex(offset+i)];

//--- accumulate mean and mean-square structure function m(Delta) for every lag in the ladder
   double logDelta[],logM[];
   ArrayResize(logDelta,m_lagCount);
   ArrayResize(logM,m_lagCount);
   int validLags=0;

   for(int L=0;L<m_lagCount;L++)
     {
      int    lag=m_lags[L];
      double sumSq=0.0;
      int    pairs=0;
      for(int t=lag;t<m_window;t++)
        {
         //--- squared increment over this lag; averaging these approximates E[|B^H_t+d - B^H_t|^2] ~ d^(2H)
         double diff=series[t]-series[t-lag];
         sumSq+=diff*diff;
         pairs++;
        }
      if(pairs<5)
         continue; // too few pairs at this lag to trust the average, skip it rather than poison the regression

      double m_delta=sumSq/pairs;
      if(m_delta<=0.0)
         continue; // log() of a non-positive structure function is undefined, guard against a degenerate flat window

      logDelta[validLags]=MathLog((double)lag);
      logM[validLags]=MathLog(m_delta);
      validLags++;
     }

   if(validLags<3)
      return(false); // not enough usable lag points to fit a stable slope

//--- ordinary least squares slope of log(m) on log(Delta): slope = 2H by the RFSV scaling relation
   double sumX=0.0,sumY=0.0,sumXY=0.0,sumXX=0.0;
   for(int i=0;i<validLags;i++)
     {
      sumX+=logDelta[i];
      sumY+=logM[i];
      sumXY+=logDelta[i]*logM[i];
      sumXX+=logDelta[i]*logDelta[i];
     }
   double n=(double)validLags;
   double denom=(n*sumXX-sumX*sumX);
   if(MathAbs(denom)<1e-12)
      return(false); // degenerate regression (all lags collapsed to one x-value), avoid a divide-by-zero

   double slope=(n*sumXY-sumX*sumY)/denom;
   double H=slope/2.0;

//--- clamp to the theoretically sane range; RFSV literature reports H in roughly [0.02, 0.20] empirically,
//--- but noisy windows can produce out-of-range slopes that we cap rather than feed raw into the model
   if(H<0.01) H=0.01;
   if(H>0.60) H=0.60;

//--- vol-of-vol: dispersion of the log-vol series itself over the same window, a complementary regime signal
   double mean=0.0;
   for(int i=0;i<m_window;i++)
      mean+=series[i];
   mean/=m_window;
   double var=0.0;
   for(int i=0;i<m_window;i++)
      var+=(series[i]-mean)*(series[i]-mean);
   var/=(m_window-1);

   H_out        = H;
   volOfVol_out = MathSqrt(var);
   m_lastH        = H_out;
   m_lastVolOfVol = volOfVol_out;
   return(true);
  }
Волатильность волатильности — стандартное отклонение самого ряда логарифма волатильности в том же окне — возвращается той же функцией в качестве второго выходного значения. Это естественное дополнение к H: два окна могут иметь одинаковую оценку шероховатости, при этом одно из них будет стабильным, а другое — бурно колебаться вокруг своего среднего значения, и классификатору полезно уметь различать их.
Размер кольцевого буфера равен 2 * window, чтобы избежать перераспределения памяти. Это сокращает число вызовов функции ArrayResize() при обработке каждого бара и позволяет избежать лишних накладных расходов во время выполнения.
От потока цен к вектору признаков
Между исходными ценами закрытия баров M5 и оценивателем показателя Херста находится модуль формирования признаков CRFSVFeatureEngine. Его задача — преобразовывать поток логарифмических доходностей отдельных баров в наблюдения логарифма волатильности по блокам, поступающие на вход оценивателя, а затем формировать трехэлементный вектор признаков, ожидаемый моделью ONNX. Это разделение важно: класс оценивателя ничего не знает о барах, блоках или торговле — он работает лишь с рядом логарифма волатильности общего вида, тогда как модуль формирования признаков отвечает за весь учет и обработку данных, специфичных для рынка.
Функция OnBarReturn() вызывается один раз для каждого закрытого бара из функции OnTick() советника. Она накапливает квадраты логарифмических доходностей в переменной m_sumSqReturns, а после обработки m_blockSize баров (по умолчанию шести, что соответствует тридцатиминутному блоку на M5) вычисляет реализованную дисперсию блока и ограничивает ее снизу значением 1e-14, чтобы математически невозможный блок с нулевой дисперсией не привел к вычислению log(0) на следующем этапе. Затем функция берет половину логарифма этой дисперсии, получая логарифм волатильности блока, и передает его оценивателю показателя Херста, после чего обнуляет накопитель для следующего блока.
//+------------------------------------------------------------------+
//| CRFSVFeatureEngine                                               |
//+------------------------------------------------------------------+
//| Converts a stream of per-bar log-returns into the block-level    |
//| log-volatility series the Hurst estimator needs, then exposes a  |
//| ready-to-run feature vector for the ONNX classifier.             |
//| Blocking (default 6 M5 bars = 30 minutes) trades granularity for |
//| a realized-variance estimate that is not dominated by bid/ask    |
//| bounce on a single 5-minute bar.                                 |
//+------------------------------------------------------------------+
class CRFSVFeatureEngine
  {
private:
   CHurstEstimator   m_hurst;             // roughness estimator fed by completed volatility blocks
   int               m_blockSize;         // number of bars accumulated per volatility block
   int               m_barInBlock;        // bars accumulated so far in the current, unfinished block
   double            m_sumSqReturns;      // running sum of squared log-returns within the current block
   double            m_prevH;             // H from the previous completed block, used to derive H momentum

public:
                     CRFSVFeatureEngine();
                    ~CRFSVFeatureEngine() {};

   bool              Init(const int hurstWindow,const int &lags[],const int lagCount,const int blockSize);
   void              OnBarReturn(const double logReturn);
   bool              IsReady() const { return(m_hurst.IsReady()); }
   bool              BuildFeatureVector(float &features[]);
  };

//+------------------------------------------------------------------+
//| Constructor                                                      |
//+------------------------------------------------------------------+
CRFSVFeatureEngine::CRFSVFeatureEngine()
  {
   m_blockSize    = 6;      // default: 6 x M5 bars = 30-minute volatility blocks
   m_barInBlock   = 0;
   m_sumSqReturns = 0.0;
   m_prevH        = 0.5;
  }

//+------------------------------------------------------------------+
//| Init                                                             |
//+------------------------------------------------------------------+
bool CRFSVFeatureEngine::Init(const int hurstWindow,const int &lags[],const int lagCount,const int blockSize)
  {
   if(blockSize<1)
      return(false);
   m_blockSize = blockSize;
//--- delegate the regression-window and lag-ladder validation to the estimator itself
   return(m_hurst.Init(hurstWindow,lags,lagCount));
  }

//+------------------------------------------------------------------+
//| OnBarReturn                                                      |
//+------------------------------------------------------------------+
void CRFSVFeatureEngine::OnBarReturn(const double logReturn)
  {
//--- accumulate squared return; this is the realized-variance building block for the current volatility block
   m_sumSqReturns += logReturn*logReturn;
   m_barInBlock++;

   if(m_barInBlock>=m_blockSize)
     {
      //--- realized variance over the block, floored to avoid log(0) on a completely flat block
      double realizedVar=MathMax(m_sumSqReturns,1e-14);
      //--- log-volatility = 0.5 * log(realized variance); this is the series the RFSV model treats as fBm
      double logVol=0.5*MathLog(realizedVar);
      m_hurst.Update(logVol);

      //--- reset the block accumulator for the next window of bars
      m_sumSqReturns = 0.0;
      m_barInBlock   = 0;
     }
  }

//+------------------------------------------------------------------+
//| BuildFeatureVector                                               |
//+------------------------------------------------------------------+
bool CRFSVFeatureEngine::BuildFeatureVector(float &features[])
  {
   double H,volOfVol;
   if(!m_hurst.ComputeRoughness(H,volOfVol))
      return(false);

//--- H momentum: how fast the local roughness is shifting block-to-block, a leading regime-change signal
   double hMomentum=H-m_prevH;
   m_prevH=H;

   ArrayResize(features,RFSV_MODEL_INPUTS);
   features[0]=(float)H;          // roughness index — lower H implies rougher, more mean-reverting volatility
   features[1]=(float)volOfVol;   // dispersion of log-vol over the window — regime turbulence proxy
   features[2]=(float)hMomentum;  // directional drift of the roughness estimate itself
   return(true);
  }
BuildFeatureVector() — это последний этап перед вызовом ONNX. Помимо получения H и волатильности волатильности из оценивателя, эта функция вычисляет третий признак — изменение H, то есть разность значений H для текущего и предыдущего завершенных блоков. Сам оцениватель показателя Херста намеренно не отслеживает эту величину, поскольку изменение H — свойство последовательности оценок, а не отдельного окна. Расчет этой величины в модуле формирования признаков позволяет классу оценивателя отвечать исключительно за оценивание. Быстро снижающийся индекс шероховатости несет иную информацию, чем индекс, который часами остается на том же низком уровне. Если передавать эту производную классификатору напрямую, а не заставлять его выводить ее из последовательных исходных значений H, получаемых при отдельных вызовах, сигнал для обучения получается существенно чище.
Обучение и экспорт классификатора ONNX
Офлайн-часть этой системы реализована в файле rfsv_train_export.py, и главное требование к ней — в точности воспроизводить вычисления MQL5: не приблизительно, не "достаточно близко", а с тем же порядком суммирования, теми же ограничениями и теми же нижними порогами. Любое расхождение между двумя реализациями означает, что при запуске на реальном графике классификатор будет получать признаки, на которых он фактически никогда не обучался. Блок настроек в начале файла в точности повторяет входные параметры советника, включая набор лагов, поэтому любое изменение в одной реализации должно быть явным и осознанным и обязательно отражаться в другой.
# --------------------------------------------------------------------- #
# Configuration - mirrors the EA's input parameters exactly             #
# --------------------------------------------------------------------- #
HURST_WINDOW   = 100            # regression window, in completed volatility blocks
BLOCK_SIZE     = 6              # M5 bars per volatility block (30 minutes)
LAG_LADDER     = [1, 2, 3, 5, 8, 13]  # must match InpLag1..InpLag6 in the EA
Функция compute_block_log_vol() напрямую воспроизводит логику агрегирования по блокам в OnBarReturn(): по умолчанию используются тот же размер блока в шесть баров, тот же нижний порог реализованной дисперсии и то же преобразование 0,5 × log(дисперсия):
HISTORY_DAYS   = 240            # how many calendar days of M5 history to pull
ONNX_OUT_PATH  = "rfsv_classifier.onnx"

def fetch_mt5_history(symbol: str, timeframe, days: int) -> pd.DataFrame:
    """Connect to the running MT5 terminal and pull M5 OHLC history directly.

    Replaces the old manual "export to CSV from the chart" step entirely -
    this talks to the same running terminal you're logged into.
    """
    if not mt5.initialize():
        raise RuntimeError(
            f"mt5.initialize() failed, error = {mt5.last_error()}. "
            "Make sure the MT5 terminal is open and you are logged in."
Функция rolling_hurst() практически построчно повторяет ComputeRoughness(): тот же набор лагов, та же проверка "пропустить, если пар меньше пяти", та же проверка на неположительное среднее, та же запись нормальных уравнений МНК, то же соотношение H = коэффициент наклона / 2, то же ограничение диапазоном [0,01; 0,60]. В то время как версия на MQL5 обновляет скользящую оценку постепенно, бар за баром, эта версия на Python пересчитывает регрессию заново для каждой конечной точки окна по всему историческому ряду — это занимает больше времени, но подходит для автономной пакетной обработки при формировании обучающего набора, а не для расчёта в режиме реального времени по каждому тику.
# confirm the symbol exists and is visible in Market Watch, add it if not
    info = mt5.symbol_info(symbol)
    if info is None:
        mt5.shutdown()
        raise RuntimeError(
            f"Symbol '{symbol}' not found. Check the exact spelling in Market "
            "Watch - some brokers use suffixes like XAUUSD.m or XAUUSDm."
        )
    if not info.visible:
        mt5.symbol_select(symbol, True)

    utc_to = datetime.now()
    utc_from = utc_to - timedelta(days=days)
    rates = mt5.copy_rates_range(symbol, timeframe, utc_from, utc_to)
    mt5.shutdown()

    if rates is None or len(rates) == 0:
        raise RuntimeError(
            f"No rates returned for {symbol}. Check that the symbol has "
            "enough history available in the terminal (scroll back on its "
            "chart at least once so the terminal caches the history)."
        )

    df = pd.DataFrame(rates)
    df["time"] = pd.to_datetime(df["time"], unit="s")
    df = df.sort_values("time").reset_index(drop=True)
    print(f"fetched {len(df)} M5 bars for {symbol}, "
          f"{df['time'].iloc[0]} -> {df['time'].iloc[-1]}")
    return df

def compute_block_log_vol(close: np.ndarray, block_size: int) -> np.ndarray:
    """Convert a closed-bar close-price series into block-level log-volatility.

    Mirrors CRFSVFeatureEngine::OnBarReturn(): accumulate squared log-returns
    over `block_size` bars, then log_vol = 0.5 * log(realized_variance).
    """
    log_returns = np.diff(np.log(close))
    n_blocks = len(log_returns) // block_size
    log_vol = np.empty(n_blocks)
    for i in range(n_blocks):
        block = log_returns[i * block_size:(i + 1) * block_size]
        realized_var = max(np.sum(block ** 2), 1e-14)  # same floor as the MQL5 guard
        log_vol[i] = 0.5 * np.log(realized_var)
    return log_vol
Функция build_feature_frame() формирует матрицу признаков из трёх столбцов и добавляет целевую метку: знак будущей доходности, рассчитанной по блокам, с горизонтом по умолчанию в двенадцать блоков (шесть часов). Использование целевой метки, вычисляемой строго по данным после окна признаков, в сочетании с хронологическим разделением на обучающую и тестовую выборки без перемешивания, выполняемым далее в функции main(), позволяет избежать утечки информации из будущего во всём конвейере обработки.
 """Rolling structure-function Hurst estimate, one output per completed window.

    This is the direct counterpart of CHurstEstimator::ComputeRoughness():
    for each lag, average the squared increment over the window, regress
    log(mean_sq_increment) on log(lag) via OLS, and take H = slope / 2.
    Returns (H_series, vol_of_vol_series), both aligned to the *end* of
    each window (i.e. index i corresponds to log_vol[i - window + 1 : i+1]).
    """
    n = len(log_vol)
    H_out = np.full(n, np.nan)
    vv_out = np.full(n, np.nan)

    for end in range(window - 1, n):
        series = log_vol[end - window + 1: end + 1]

        log_delta, log_m = [], []
        for lag in lags:
            diffs = series[lag:] - series[:-lag]
            if len(diffs) < 5:
                continue  # same "too few pairs" guard as the MQL5 estimator
            m_delta = np.mean(diffs ** 2)
            if m_delta <= 0.0:
                continue
            log_delta.append(np.log(lag))
            log_m.append(np.log(m_delta))
При обучении используется класс GradientBoostingClassifier с неглубокими деревьями и консервативными гиперпараметрами. Этап экспорта решает две проблемы, связанные с ONNX: формат вывода zipmap и экспорт классификатора с двумя выходами по умолчанию. Скрипт отключает zipmap и добавляет узел Gather для вывода P(class=1) в виде тензора размером [1,1].
def main():
    # pulls M5 bars straight from the running MT5 terminal — see fetch_mt5_history() above
    df = fetch_mt5_history(SYMBOL, TIMEFRAME, HISTORY_DAYS)

    # build_feature_frame() runs the MQL5-mirrored Hurst/blocking math and attaches the
    # forward-return label; only the three model inputs and the label survive into X/y
    frame = build_feature_frame(df)
    X = frame[["H", "vol_of_vol", "H_momentum"]].to_numpy(dtype=np.float32)
    y = frame["label"].to_numpy()

    # shuffle=False keeps the split chronological: the test set is strictly the most
    # recent 25% of history, so no future information leaks into training via a
    # randomly-shuffled window that straddles both sides of the split
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.25, shuffle=False
    )

    # shallow trees + a conservative learning rate + row subsampling: deliberately
    # conservative defaults, since a 3-feature model has little room to overfit safely
    clf = GradientBoostingClassifier(
        n_estimators=200,
        max_depth=3,
        learning_rate=0.05,
        subsample=0.8,
        random_state=42,
    )
    clf.fit(X_train, y_train)

    # test accuracy on the chronological holdout is the real signal here — if it's
    # not clearly above 0.5, the feature set has no business generating live trades
    train_acc = clf.score(X_train, y_train)
    test_acc = clf.score(X_test, y_test)
    print(f"train accuracy: {train_acc:.4f}  test accuracy: {test_acc:.4f}")

    # ---- ONNX export ---------------------------------------------------
    # float_input / [1,3] must match RFSV_MODEL_INPUTS and the OnnxSetInputShape()
    # call in COnnxRoughnessModel::Init() — a mismatch here fails silently at
    # runtime rather than at export time, so the shape is fixed explicitly
    initial_type = [("float_input", FloatTensorType([1, 3]))]
    onnx_model = convert_sklearn(
        clf,
        initial_types=initial_type,
        target_opset=13,
        # zipmap=False: without this, skl2onnx wraps the probability output in a
        # dictionary-like "zipmap" structure that OnnxRun() cannot consume as a
        # plain matrix<float> — stripping it here avoids a runtime failure later
        options={id(clf): {"zipmap": False}},
    )

    graph = onnx_model.graph
    # a default sklearn classifier export produces two outputs: graph.output[0] is
    # the predicted label, graph.output[1] is the [1,2] probability tensor
    # (columns are P(class=0), P(class=1)); the EA only ever wants P(class=1),
    # so the label output is dropped outright rather than carried through unused
    prob_output = graph.output[1]
    prob_output.name = "probabilities"
    del graph.output[0]

    # RFSV_MODEL_OUTPUTS is fixed at 1 on the MQL5 side, so the [1,2] probability
    # tensor still has to be sliced down to a single [1,1] column before saving —
    # a Gather node picks out index 1 (P(class=1)) directly inside the graph,
    # which keeps the slicing baked into the .onnx file instead of relying on the
    # MQL5 caller to know which column to read
    from onnx import helper, TensorProto
    gather_indices = helper.make_tensor("gather_idx", TensorProto.INT64, [1], [1])
    graph.initializer.append(gather_indices)
    gather_node = helper.make_node(
        "Gather",
        inputs=["probabilities", "gather_idx"],
        outputs=["prob_up"],
        axis=1,
        name="SelectClass1Probability",
    )
    graph.node.append(gather_node)
    # replace the now-stale [1,2] output declaration with the true [1,1] shape
    # the Gather node actually produces — leaving the old declaration in place
    # would make the graph internally inconsistent and fail onnx.checker below
    graph.output[0].CopyFrom(
        helper.make_tensor_value_info("prob_up", TensorProto.FLOAT, [1, 1])
    )

    # validates the graph is well-formed (correct shapes, no dangling nodes)
    # before it's trusted enough to write to disk and embed into the EA
    onnx.checker.check_model(onnx_model)
    with open(ONNX_OUT_PATH, "wb") as f:
        f.write(onnx_model.SerializeToString())

    print(f"saved {ONNX_OUT_PATH}")
    print(f"  opset: {onnx_model.opset_import[0].version}")
    print(f"  ir_version: {onnx_model.ir_version}")
    print(f"  input: float_input, shape [1,3] -> [H, vol_of_vol, H_momentum]")
    print(f"  output: prob_up, shape [1,1] -> P(forward return > 0)")
Узел "Gather" заслуживает более пристального внимания, поскольку это наименее очевидная часть экспорта. Вместо того чтобы возлагать на вызывающий код MQL5 обязанность знать, что нужно "считать столбец с индексом 1 из тензора вероятностей", и правильно выполнять эту операцию, узел встраивает выбор этого среза непосредственно в сохраняемый граф. Сам файл .onnx выдаёт единственное число с плавающей запятой под именем prob_up, поэтому соглашение о выборе столбца, которое могло бы оказаться несогласованным между экспортом из Python и обёрткой MQL5, больше не требуется. Вызов onnx.checker.check_model() непосредственно перед сохранением специально предназначен для выявления несогласованности графа после подобных ручных изменений. Если объявленная форма выходного тензора разойдётся с тем, что фактически выдаёт узел Gather, ошибка обнаружится именно здесь — при экспорте на компьютере разработчика, а не проявится как незаметный сбой во время выполнения OnnxRun() на реальном графике.
Экспортированный файл rfsv_classifier.onnx использует версию набора операторов (opset) 13 и версию IR, определяемую версией пакета onnx, с помощью которой выполнен экспорт. У него один входной тензор с именем float_input и формой [1, 3], соответствующий признакам [H, vol_of_vol, H_momentum] именно в этом порядке, и один выходной тензор с именем prob_up и формой [1, 1]. Перед компиляцией советника этот файл необходимо скопировать в папку данных терминала по пути MQL5\Files\RFSV_Roughness\rfsv_classifier.onnx, поскольку он подключается во время компиляции с помощью директивы #resource, а не считывается с диска во время выполнения.
Что касается разделения на обучающую и тестовую выборки и метрик: функция main() намеренно использует параметр shuffle=False при вызове train_test_split, выделяя последние 25% размеченных исторических данных в хронологическую тестовую выборку без случайного перемешивания. Финансовые временные ряды обладают автокорреляцией, и разделение с перемешиванием позволило бы информации о блоках волатильности из тестового периода попасть в обучающую выборку через перекрывающиеся окна, что привело бы к завышенной доле верных предсказаний, которая не подтвердится при работе на реальном графике. Доля верных предсказаний на обучающей и тестовой выборках, выводимая в конце скрипта, служит проверкой на здравый смысл, а не гарантией эффективности. Классификатор, который при хронологическом разделении без перемешивания лишь незначительно превосходит базовый уровень около 50%, всё равно стоит протестировать в советнике: даже небольшое, но устойчивое статистическое преимущество даёт существенный накопительный эффект в сочетании с дисциплинированным расчётом размера позиции и управлением рисками.
Интеграция компонентов торгового советника
Торговый советник RFSV_Roughness_EA.mq5 намеренно содержит минимум кода — практически вся содержательная логика уже реализована в трёх классах подключаемого файла. Его задачи — инициализация, обработка новых баров и преобразование вероятности в торговый приказ. Директива ресурса в начале кода встраивает файл ONNX непосредственно в скомпилированный файл .ex5, что позволяет обойти типичную проблему тестера стратегий: каждый агент тестирования работает со своей изолированной папкой Files, поэтому модель ONNX, хранящаяся только в основной папке данных терминала, будет недоступна агентам оптимизации. Включение модели в качестве ресурса означает, что она распространяется вместе с самой скомпилированной программой.
//+------------------------------------------------------------------+
//| Resources                                                        |
//+------------------------------------------------------------------+
#resource "\\Files\\RFSV_Roughness\\rfsv_classifier.onnx" as uchar ModelBuffer[]
// embedding the model as a resource means the Strategy Tester's isolated agent
// sandbox always finds it, sidestepping the Files-folder-per-agent limitation

//+------------------------------------------------------------------+
//| Input parameters — Hurst / RFSV feature engine                   |
//+------------------------------------------------------------------+
input int    InpHurstWindow   = 100;    // Hurst regression window, in completed volatility blocks
input int    InpBlockSize     = 6;      // M5 bars per volatility block (6 = 30 minutes)
input int    InpLag1          = 1;      // lag ladder point 1 (blocks)
input int    InpLag2          = 2;      // lag ladder point 2 (blocks)
input int    InpLag3          = 3;      // lag ladder point 3 (blocks)
input int    InpLag4          = 5;      // lag ladder point 4 (blocks)
input int    InpLag5          = 8;      // lag ladder point 5 (blocks)
input int    InpLag6          = 13;     // lag ladder point 6 (blocks)

//+------------------------------------------------------------------+
//| Input parameters — classifier gating                             |
//+------------------------------------------------------------------+
input double InpProbLongAbove  = 0.60;  // enter long when P(up) exceeds this
input double InpProbShortBelow = 0.40;  // enter short when P(up) falls below this

//+------------------------------------------------------------------+
//| Input parameters — risk & trade management                       |
//+------------------------------------------------------------------+
input int    InpATRPeriod      = 14;    // ATR period used for sizing and stops
input double InpATRMultSL      = 2.0;   // stop-loss distance as a multiple of ATR
input double InpATRMultTP      = 3.0;   // take-profit distance as a multiple of ATR
input double InpRiskPercent    = 0.5;   // percent of account equity risked per trade
input ulong  InpMagicNumber    = 20260901; // magic number identifying this EA's positions
В глобальных переменных хранятся по одному экземпляру модуля формирования признаков, обёртки ONNX и вспомогательного торгового класса, а также дескриптор ATR, используемый как для расчёта расстояний до стоп-лоссов, так и для расчёта размера позиции:
//+------------------------------------------------------------------+
//| Globals — engine, model, trading, indicator handles              |
//+------------------------------------------------------------------+
CRFSVFeatureEngine g_engine;      // computes H_t, vol-of-vol, H-momentum from the live price stream
COnnxRoughnessModel g_model;      // wraps the resource-embedded ONNX classifier
CTrade             g_trade;       // standard trade wrapper for order placement
int                g_atrHandle;   // handle for the ATR indicator used in sizing/stops
datetime           g_lastBarTime; // timestamp of the last bar processed, used for the new-bar guard
Функция OnInit() формирует набор лагов из шести отдельно настраиваемых входных параметров (чтобы каждый лаг можно было независимо оптимизировать в тестере стратегий, не ограничиваясь жёстко заданным массивом), затем инициализирует модуль формирования признаков, загружает модель ONNX из буфера встроенного ресурса и создаёт дескриптор ATR. На каждом из этих трёх этапов возможен отдельный сбой: недопустимое сочетание окна и лагов, повреждённый или несовместимый файл экспорта ONNX либо инструмент, для которого терминал не может построить ряд значений ATR. В каждом случае возвращается свой код инициализации, который записывается в журнал, а не единый код ошибки для всех случаев. Это позволяет гораздо быстрее установить причину неудачной загрузки по журналу "Эксперты".
//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+
int OnInit()
  {
//--- assemble the lag ladder from individual inputs so each lag is independently tunable/optimizable
   int lags[6];
   lags[0]=InpLag1; lags[1]=InpLag2; lags[2]=InpLag3;
   lags[3]=InpLag4; lags[4]=InpLag5; lags[5]=InpLag6;

   if(!g_engine.Init(InpHurstWindow,lags,6,InpBlockSize))
     {
      //--- fail fast: a misconfigured window/lag combination would silently produce garbage H estimates
      Print("RFSV_Roughness_EA: feature engine Init failed — check window/lag inputs");
      return(INIT_PARAMETERS_INCORRECT);
     }

   if(!g_model.Init(ModelBuffer))
     {
      //--- the embedded resource is the only model source; if it fails to load there is nothing to fall back to
      Print("RFSV_Roughness_EA: ONNX model Init failed — verify rfsv_classifier.onnx export");
      return(INIT_FAILED);
     }

   g_atrHandle=iATR(_Symbol,_Period,InpATRPeriod);
   if(g_atrHandle==INVALID_HANDLE)
     {
      Print("RFSV_Roughness_EA: iATR handle creation failed");
      return(INIT_FAILED);
     }

   g_trade.SetExpertMagicNumber(InpMagicNumber);
   g_trade.SetTypeFillingBySymbol(_Symbol);

   g_lastBarTime = 0;
   g_prevClose   = 0.0;

   return(INIT_SUCCEEDED);
  }
Функция OnDeinit() короткая, но ее выполнение обязательно: необходимо явно освободить как дескриптор индикатора ATR, так и сессию ONNX. Это важнее, чем может показаться на первый взгляд: во время оптимизации тестер стратегий может многократно выполнять цикл OnInit()/OnDeinit() в рамках одного процесса агента, и неосвобождённые сессии ONNX будут приводить к накоплению утечек ресурсов от цикла к циклу.
//+------------------------------------------------------------------+
//| Expert deinitialization function                                 |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
//--- release both the indicator handle and the ONNX session explicitly; relying on GC here is unsafe
//--- across Strategy Tester runs where OnDeinit/OnInit can cycle repeatedly within one agent process
   if(g_atrHandle!=INVALID_HANDLE)
      IndicatorRelease(g_atrHandle);
   g_model.Release();
  }
Две небольшие вспомогательные функции играют важную роль. Функция IsNewBar() обеспечивает выполнение всех значимых вычислений в советнике только один раз на каждый закрытый бар: и модуль формирования признаков, и классификатор работают с данными баров, поэтому их вызов внутри бара лишь повторял бы ту же работу с теми же входными данными. Функция CalculatePositionSize() преобразует расстояние до стоп-лосса, рассчитанное на основе ATR, в объём позиции в лотах с риском, равным фиксированному проценту от средств на счёте. При этом явно проверяется, что размер и стоимость тика положительны; их соответствие спецификации брокера необходимо проверить отдельно. В конце объём приводится к шагу лота, установленному брокером, чтобы ордер не был отклонён из-за недопустимого шага объёма.
//+------------------------------------------------------------------+
//| IsNewBar — true exactly once per closed bar                      |
//+------------------------------------------------------------------+
bool IsNewBar()
  {
   datetime currentBarTime=iTime(_Symbol,_Period,0);
   if(currentBarTime!=g_lastBarTime)
     {
      g_lastBarTime=currentBarTime;
      return(true);
     }
   return(false);
  }

//+------------------------------------------------------------------+
//| CalculatePositionSize — risk-percent sizing off the ATR stop     |
//+------------------------------------------------------------------+
double CalculatePositionSize(const double slDistancePrice)
  {
   double equity=AccountInfoDouble(ACCOUNT_EQUITY);
   double riskAmount=equity*(InpRiskPercent/100.0);

   double tickValue=SymbolInfoDouble(_Symbol,SYMBOL_TRADE_TICK_VALUE);
   double tickSize=SymbolInfoDouble(_Symbol,SYMBOL_TRADE_TICK_SIZE);
   if(tickSize<=0.0 || tickValue<=0.0)
      return(0.0); // guard against a misreporting symbol; sizing off a zero denominator would blow up

//--- convert the ATR-based price distance into a monetary loss-per-lot, then solve for lot size
   double lossPerLot=(slDistancePrice/tickSize)*tickValue;
   if(lossPerLot<=0.0)
      return(0.0);

   double rawLots=riskAmount/lossPerLot;

   double minLot =SymbolInfoDouble(_Symbol,SYMBOL_VOLUME_MIN);
   double maxLot =SymbolInfoDouble(_Symbol,SYMBOL_VOLUME_MAX);
   double lotStep=SymbolInfoDouble(_Symbol,SYMBOL_VOLUME_STEP);

//--- snap to the broker's lot step so the order is not rejected for an invalid volume increment
   double lots=MathFloor(rawLots/lotStep)*lotStep;
   lots=MathMax(minLot,MathMin(maxLot,lots));
   return(lots);
  }
Функция OnTick() связывает все компоненты воедино: при появлении каждого нового бара она вычисляет логарифмическую доходность только что закрывшегося бара, передаёт её в модуль формирования признаков и, как только модуль накопит достаточно истории для получения полноценной оценки, формирует вектор признаков и выполняет прогноз модели ONNX. Советник не допускает одновременного открытия нескольких позиций для одной пары "инструмент — магический номер", получает текущее значение ATR для расчёта размера позиции и уровней стоп-ордеров и отправляет ордер только тогда, когда прогнозируемая вероятность выходит за один из двух настраиваемых порогов. Значения между порогами трактуются как отсутствие статистического преимущества: советник остаётся вне рынка, а не открывает сделку при низкой уверенности в прогнозе.
Стоит особо отметить одно проектное решение: в этой версии вероятность, выдаваемая классификатором, используется как самостоятельный сигнал направления сделки, а не как фильтр направления сделок поверх отдельной базовой стратегии, например пересечения скользящих средних или пробоя. Благодаря этому система остается простой для анализа от начала до конца — существует ровно один источник прогноза направления движения, и каждую сделку, совершаемую советником, можно проследить до единственного показателя вероятности. Обратная сторона такого решения — классификатор полностью отвечает за выбор направления сделки, а независимого сигнала для проверки его решения нет. Если вы предпочитаете использовать индекс шероховатости как фильтр направления сделок поверх существующего базового сигнала, достаточно простой модификации: разрешать сделки по базовому сигналу лишь тогда, когда классификатор с ним согласен. Вызов COnnxRoughnessModel::Predict() и возвращаемую им вероятность менять не нужно — изменяется только логика входа в рынок внутри OnTick().
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
   if(!IsNewBar())
      return; // the feature engine and classifier are both bar-level, evaluating intrabar would just repeat work

   double closePrice=iClose(_Symbol,_Period,1); // last fully closed bar
   if(g_prevClose<=0.0)
     {
      //--- first call after init has no prior close to diff against; seed it and wait for the next bar
      g_prevClose=closePrice;
      return;
     }

//--- log-return of the just-closed bar feeds the block-level realized-variance accumulator
   double logReturn=MathLog(closePrice/g_prevClose);
   g_prevClose=closePrice;
   g_engine.OnBarReturn(logReturn);

   if(!g_engine.IsReady())
      return; // still filling the initial Hurst regression window, nothing to trade on yet

   float features[];
   if(!g_engine.BuildFeatureVector(features))
      return; // regression could not be fit this bar (degenerate window), skip rather than trade on stale data

   double probUp;
   if(!g_model.Predict(features,probUp))
     {
      Print("RFSV_Roughness_EA: ONNX Predict failed on bar ",TimeToString(g_lastBarTime));
      return;
     }

//--- do not stack positions: only evaluate new entries when flat on this symbol/magic combination
   if(PositionSelect(_Symbol))
      return;

   double atrBuffer[];
   ArraySetAsSeries(atrBuffer,true);
   if(CopyBuffer(g_atrHandle,0,1,1,atrBuffer)<1)
      return; // ATR not yet available (e.g. right after init), skip this bar rather than trade without a stop

   double atr=atrBuffer[0];
   double slDistance=atr*InpATRMultSL;
   double tpDistance=atr*InpATRMultTP;
   if(slDistance<=0.0)
      return;

   double lots=CalculatePositionSize(slDistance);
   if(lots<=0.0)
      return; // sizing degenerated to zero (e.g. equity/tick data unavailable), do not send a zero-volume order

   double ask=SymbolInfoDouble(_Symbol,SYMBOL_ASK);
   double bid=SymbolInfoDouble(_Symbol,SYMBOL_BID);

   if(probUp>InpProbLongAbove)
     {
      //--- classifier favors an upward regime with enough margin above the threshold to act on
      double sl=ask-slDistance;
      double tp=ask+tpDistance;
      g_trade.Buy(lots,_Symbol,ask,sl,tp,"RFSV roughness long");
     }
   else if(probUp<InpProbShortBelow)
     {
      //--- symmetric downside case: classifier favors a downward regime
      double sl=bid+slDistance;
      double tp=bid-tpDistance;
      g_trade.Sell(lots,_Symbol,bid,sl,tp,"RFSV roughness short");
     }
//--- probUp between the two thresholds is treated as "no edge" and intentionally left flat
  }
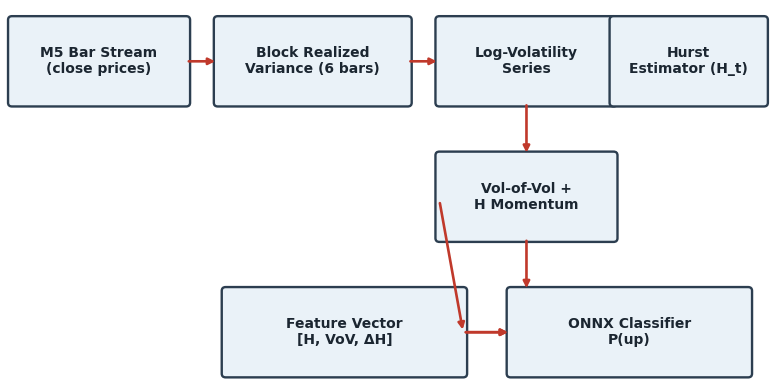
Рис. 2. Полная схема потока данных: по потоку баров M5 рассчитывается реализованная дисперсия по блокам, из которой формируется ряд логарифма волатильности для оценивателя показателя Херста; H, волатильность волатильности и изменение H образуют вектор признаков, передаваемый классификатору ONNX, а выдаваемая им вероятность определяет логику входа в рынок в советнике.
Пограничные случаи и возможные проблемы
При тестировании этой системы прежде всего необходимо правильно учесть период накопления начальных данных. Функция CHurstEstimator::IsReady() не вернёт true, пока в кольцевом буфере не накопится достаточно блоков для полного окна регрессии. При настройках по умолчанию (окно из 100 блоков, по шесть баров в блоке) это 600 баров M5, то есть пятьдесят часов торгового времени, которые должны пройти до первой сделки советника на новом графике или при новом запуске тестера стратегий. Это не ошибка, которую нужно обходить: оцениватель просто не возвращает результат подгонки регрессии при недостаточном объёме данных — именно так он и должен себя вести.
Еще один сценарий, от которого оцениватель должен явно предусматривать защиту, — окно без заметных изменений цены, с волатильностью, близкой к нулю. Если цена действительно не меняется в течение длительного времени (в начале сессий с низкой ликвидностью или во время некоторых праздничных сессий), реализованная дисперсия блока может быть численно неотличима от нуля, и без нижнего порога 1e-14 в OnBarReturn() последующий вызов MathLog() либо завершится с ошибкой, либо вернет отрицательную бесконечность, незаметно искажая все последующие оценки показателя Херста, в окно которых входит этот блок.
Обратите внимание на типичные подводные камни MQL5/ONNX, которые встречаются во всей этой серии статей и актуальны здесь: matrix без явно указанного параметра типа по умолчанию означает matrix<double>, что не соответствует требованиям сеанса ONNX в режиме ONNX_NO_CONVERSION — именно поэтому и входная, и выходная матрицы в COnnxRoughnessModel::Predict() явно имеют тип matrix<float>. Кроме того, перед вызовом OnnxRun() выходной матрице нужно заранее задать размер [1, 1]. Если размер не задан, в режиме без преобразования операция завершится сбоем без сообщения об ошибке, вместо того чтобы автоматически изменить размер матрицы, как в режиме преобразования по умолчанию. Еще одна ловушка — стандартное поведение skl2onnx, создающего два выхода (метку и вероятности, преобразованные оператором ZipMap), если при экспорте не убрать лишний выход и это преобразование: модификация графа с помощью узла Gather в Python-скрипте нужна именно для того, чтобы не получить ONNX-файл, форма выходных данных которого не соответствует ожиданиям обертки MQL5.
Еще одна важная тонкость: лаги в наборе должны быть существенно меньше размера окна регрессии. Проверка в Init() класса CHurstEstimator отклоняет любой лаг, больший или равный размеру окна, но даже лаг, формально проходящий эту проверку, — например, 90 блоков при окне в 100 блоков — оставляет лишь десять допустимых пар для усреднения, чего едва хватает для численной устойчивости и совершенно недостаточно для статистической надежности. Именно поэтому лаги из набора по умолчанию (1, 2, 3, 5, 8, 13) существенно меньше стандартного размера окна в 100 блоков. Сначала увеличивайте размер окна и лишь затем используйте более крупные значения лагов.
У расчета размера позиции есть собственный риск незаметного сбоя, который стоит рассмотреть отдельно от оценивателя показателя Херста: CalculatePositionSize() получает SYMBOL_TRADE_TICK_VALUE и SYMBOL_TRADE_TICK_SIZE непосредственно из свойств символа. Для XAUUSD эти значения могут существенно различаться у разных брокеров в зависимости от спецификации контракта и валюты счета. В функции уже предусмотрена защита на случай, если любое из этих значений окажется нулевым или отрицательным, но прежде чем полагаться на рассчитанный объем в лотах на реальном счете, стоит проверить оба значения в спецификации символа вашего брокера в окне "Обзор рынка": несоответствие спецификации не вызовет ошибки, а лишь приведет к неверному расчету размера позиций, что гораздо труднее заметить, чем явный аварийный сбой.
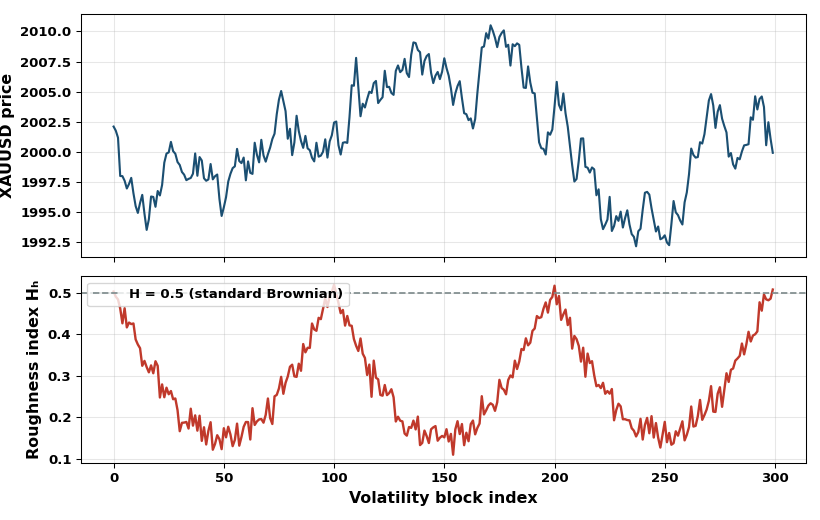
Рис. 3. Иллюстрация на синтетических данных: скользящий индекс шероховатости Hₔ показан вместе с ценой на последовательности блоков волатильности. Для сравнения отмечена опорная линия H = 0,5, соответствующая стандартному броуновскому движению.
Тестирование в тестере стратегий
В таблице ниже приведены результаты реально завершенного прогона в тестере стратегий, а не прогноз. Тестирование проводилось с указанными в статье входными параметрами по умолчанию — без оптимизации и подбора параметров — в режиме тестера "OHLC на M1", на XAUUSD M5, примерно с 3 июня по 20 августа 2026 года, с начальным депозитом 10 000 долларов. Я привожу результат ровно таким, каким он получился, в том числе указываю, что тестирование показало убыток, поскольку для читателей это полезнее, чем специально отобранный удачный результат.
| Показатель | Значение |
|---|---|
| Символ/Таймфрейм | XAUUSD / M5 |
| Период тестирования | 03.06.2026 – 20.08.2026 (модель "1 минута OHLC") |
| Начальный депозит | 10 000,00 долларов |
| Общая чистая прибыль | -1 262,49 доллара |
| Профит-фактор | 0,91 |
| Ожидаемый результат на сделку | -2,71 за сделку |
| Коэффициент Шарпа | -3,36 |
| Максимальная просадка баланса | 27,25% (3 252,63 долл.) |
| Всего сделок / прибыльных | 466 сделок, 37,34% прибыльных |
| Доля прибыльных длинных/коротких сделок | 32,08% прибыльных длинных сделок, 40,07% прибыльных коротких сделок |
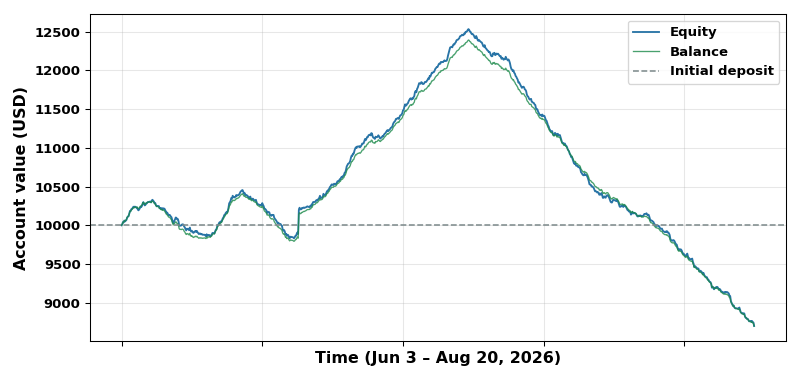
Рис. 4. Кривые баланса и средств, восстановленные по вкладке "График" тестера стратегий для прогона за июнь–август 2026 года: рост примерно до 12 070 долларов к началу июля, затем затяжная просадка примерно до 8 700–8 800 долларов к 20 августа и завершение с чистым убытком.
Оглядываясь назад, этот результат нельзя назвать неожиданным: он согласуется с тем, что уже показало обучение вне торговой платформы. Классификатор на основе градиентного бустинга показал долю верных предсказаний 67,82 % на обучающих данных, но лишь 48,03% на хронологически выделенной отложенной тестовой выборке, что хуже случайного выбора подбрасыванием монеты для бинарной метки "вверх/вниз". Модель, которая на данных вне обучающей выборки не превосходит случайное угадывание, не должна формировать реальные торговые сигналы, и результат тестера стратегий здесь наглядно подтверждает предупреждение, полученное при проверке вне платформы: профит-фактор 0,91, отрицательный коэффициент Шарпа и доля прибыльных сделок менее 40% как для длинных, так и для коротких позиций.
Три признака (H, волатильность волатильности, изменение H) и стандартная конфигурация GradientBoostingClassifier — разумная отправная точка для первой попытки, а не готовая система. Этот прогон дал именно тот честный отрицательный результат, которого и следует ожидать на таком этапе, если искомая взаимосвязь пока отсутствует или не выявляется с данным набором признаков. Прежде чем окончательно отказываться от индекса шероховатости, стоит попробовать несколько других вариантов: уменьшить количество базовых деревьев и их глубину, чтобы напрямую снизить переобучение; использовать более длительное и разнообразное окно обучения вместо выборки примерно за восемь месяцев, взятой для текущего исследования; сократить горизонт разметки будущих данных или сделать его асимметричным; а также применять индекс шероховатости как дополнительный фильтр поверх независимого базового сигнала, а не возлагать на него всю ответственность за определение направления сделки. Такой вариант интеграции уже обсуждался в предыдущем разделе.
Заключение
Честный итог первой попытки таков: индекс шероховатости имеет хорошее теоретическое обоснование, оцениватель на MQL5 и его аналог на Python давали полностью совпадающие результаты, экспорт в ONNX и весь конвейер выполнения прогнозов модели в MQL5 работали корректно — и все же полученный классификатор принес убыток при фактическом прогоне в тестере стратегий за июнь–август 2026 года, с профит-фактором 0,91 и отрицательным коэффициентом Шарпа. Это вполне закономерный итог корректно проведенного исследования такого рода, а не сбой самого конвейера обработки. Доля верных предсказаний в 48% на тестовой выборке при офлайн-проверке указывала на это ещё до открытия первой сделки, а результат тестера стратегий лишь подтвердил это.
Дальнейшие шаги по доработке достаточно очевидны. Оцениватель по нескольким моментам на основе структурной функции (использующий несколько значений q, а не только случай дисперсии, рассмотренный в этой статье) позволил бы получать оценки H с меньшей дисперсией ценой увеличения объёма вычислений на каждом баре. Более длительный период обучения с более разнообразными данными, чем примерно восемь месяцев, использованных в этом прогоне, помог бы отличить "отсутствие реальной связи" от "недостаточности данных для её обнаружения". Кроме того, использование индекса шероховатости в качестве фильтра для независимого базового сигнала, а не возложение на него всей ответственности за определение направления сделок, распределяет нагрузку между двумя источниками информации вместо одного. Позволят ли какие-либо из этих изменений получить систему с положительным математическим ожиданием — вопрос открытый, и ответ на него стоит искать путём тщательного тестирования, а не заранее предполагать тот или иной исход.
| Файл | Тип | Описание |
|---|---|---|
| RFSV_Roughness_EA.mq5 | Торговый советник | Основной торговый советник: инициализирует модуль формирования признаков и модель ONNX, выполняет обработку при появлении каждого нового бара, рассчитывает размер позиций на основе ATR и разрешает входы в зависимости от вероятности, выдаваемой классификатором. |
| RFSV_Roughness.mqh | Подключаемый файл (заголовочный файл) | Классы CHurstEstimator, CRFSVFeatureEngine и COnnxRoughnessModel: собственная реализация регрессии по структурной функции для оценивания показателя Херста, формирование признаков на уровне блоков и обёртка для выполнения прогнозов модели ONNX. |
| rfsv_classifier.onnx | Модель ONNX | Классификатор на основе градиентного бустинга, набор операторов версии 13, вход "float_input" [1,3], выход "prob_up" [1,1]. Перед компиляцией скопируйте файл в папку MQL5\Files\RFSV_Roughness\. |
| rfsv_train_export.py | Скрипт на Python | Офлайн-обучение и экспорт в ONNX: точно воспроизводит расчёты показателя Херста и агрегирование по блокам, реализованные в MQL5, формирует набор признаков с целевыми метками, обучает классификатор, экспортирует и редактирует граф ONNX. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/24480
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


