

Сертифицированный радиус устойчивости: Оцениваем уровень шума торговой модели ONNX
 34
 0

Введение
Каждая торговая система на базе ONNX, которую я создавал, в конечном итоге сталкивается с одной и той же скрытой проблемой: модель выдает класс, вы доверяете этому классу и никогда не задумываетесь о том, насколько близка модель была к выбору совершенно другого класса. Значение softmax 0,51 для класса "покупка" трактуется так же, как и 0,98: в обоих случаях открывается длинная позиция одного и того же объема. Но один сигнал почти так же случаен, как результат подбрасывания монеты, и легко может смениться на "продажу", а другой действительно отражает уверенную оценку. Оценка уверенности softmax не откалибрована как расстояние до границы принятия решений, поэтому по ней нельзя надежно определить, с какой из этих ситуаций вы имеете дело.
В этой статье мы создадим систему непосредственно на MQL5, которая отвечает на другой вопрос: не "что предсказала модель", а "насколько могут измениться входные данные, прежде чем изменится предсказанный класс". Ответ дает сертифицированный радиус устойчивости, вычисляемый методом рандомизированного сглаживания. Изначально этот метод был разработан для защиты классификаторов изображений от состязательных атак, а здесь он применяется против более обыденных угроз: шума в поступающих в реальном времени котировках, джиттера тиков, скачков спреда и артефактов, связанных с устаревшими барами, которые могут изменить неустойчивый прогноз.
В итоге у вас будет работающий советник, который перед выполнением каждого торгового решения проводит сертификацию, определяет объем позиции в зависимости от устойчивости сигнала и ведет историю радиусов в скользящем окне, позволяя отслеживать запас устойчивости модели во времени.
Для трейдеров преимущество заключается в новом показателе, независимом от оценки уверенности: одинаковые выходные значения softmax могут соответствовать совершенно разным сертифицированным радиусам, и именно радиус показывает, какой прогноз статистически устойчив к шуму. Это более узкое понятие, чем "безопасность торговли" — устойчивость ничего не говорит о том, верно ли направление. Для программистов это самодостаточная схема реализации непосредственно на MQL5 с использованием только его стандартной библиотеки — без внешних DLL, без обмена данными с Python и без ALGLIB. Общий вывод для трейдеров и программистов: необработанный выход модели смешивает уверенность, устойчивость и правильность прогноза. Рандомизированное сглаживание позволяет непосредственно измерить показатель устойчивости вместо того, чтобы судить о нем по некалиброванной вероятности.
Несколько ситуаций, в которых сертифицированный радиус влияет на поведение осторожного трейдера. Первые две ситуации ниже описывают задуманный принцип работы механизма, а не отдельно проверенные результаты. Здесь не проводились специальные тесты для периодов публикации новостей или пропусков в потоке котировок. Далее приведены лишь результаты теста на дрейф и сравнения финансовых результатов стратегий.
В периоды публикации важных экономических новостей. Сразу после публикации данных NFP или CPI спреды расширяются, а тики поступают неравномерно. Советник, использующий сигналы модели без дополнительной фильтрации, не может отличить настоящий пробой от шума. Он просто торгует в соответствии с выданным классом. В такой период сертифицированный радиус обычно резко уменьшается, поэтому фильтр отказывается от сделки или уменьшает ее объем, даже не получая информации о публикации экономических данных.
После пропуска в потоке котировок или восстановления соединения. Устаревший или частично сформированный бар дает вектор признаков, который незаметно оказывается вне обучающего распределения: никаких сбоев или ошибок не возникает, просто числа не отражают реальную структуру рынка. Советник, работающий с необработанным сигналом, в любом случае классифицирует этот вектор и открывает по нему сделки. В такой ситуации модуль сертификации с большей вероятностью воздержится от выдачи прогноза, поскольку проходы с добавлением шума к этому вектору дают разные результаты. Это признак локальной неустойчивости, а не доказательство того, что сделка была бы убыточной, но вполне разумное предположение, объясняющее, почему отказы от выдачи прогноза чаще возникают вблизи подобных событий.
Отсев действительно ненадежных прогнозов. В тесте на дрейф для XAUUSD H1, охватившем 2 996 баров, модуль сертификации воздержался от выдачи прогноза на 1 210 барах из-за слишком низкой устойчивости прогнозов; на 1 786 барах, для которых он выдал прогноз, доля правильных прогнозов составила 50,8%. Это условная доля правильных прогнозов на подмножестве, отобранном самим модулем, а не общая доля правильных прогнозов. Сравнение со слепым угадыванием с вероятностью успеха один из трех также предполагает сбалансированность классов. Фактическое соотношение классов не приведено, поэтому такое сравнение следует считать лишь приблизительной проверкой правдоподобия результата, а не строгим базовым ориентиром. Тест ясно показывает следующее: доля правильных прогнозов на барах с выданным прогнозом была заметно выше уровня случайного угадывания для задачи с тремя классами. Это не утверждение о модели в целом или о прибыльности.
Сравнение качества сигналов по разным инструментам. Параллельное применение одного и того же модуля сертификации к EURUSD H1 и XAUUSD M15 позволяет распределять объем позиций в зависимости от того, для какого инструмента текущий прогноз модели имеет подтвержденную устойчивость. Это дополнительная информация для распределения капитала, которую обычная классификационная оценка дать не может.
О границах применимости: это не доказательство защищенности от злоумышленника, специально подбирающего возмущения наихудшего случая. Это практический фильтр допуска к торговле по устойчивости к обычному шуму, возникающему в любом потоке котировок в реальном времени: пропускам в потоке котировок, колебаниям при реквотах и всплескам волатильности. Он использует тот же математический аппарат, на который опираются формальные исследования устойчивости к состязательным атакам.
Содержание
- Почему одного точечного прогноза недостаточно
- Рандомизированное сглаживание и сертифицированный радиус
- Обзор архитектуры
- Фильтрация торговых действий и определение объема позиции
- Пограничные случаи и подводные камни
- Индикатор мониторинга
- Инструментарий для обучения, экспорта и валидации
- Тестирование в тестере стратегий
- Заключение
Почему одного точечного прогноза недостаточно
Подумайте, что на самом деле происходит в промежутке времени между поступлением тика и выводом метки класса моделью ONNX. Модуль формирования признаков считывает буферы индикаторов, вычисляет нормализованные доходности, отношения волатильностей и z-оценки, упаковывает их в вектор фиксированной длины и передает этот вектор модели. Каждый этап этой цепочки — источник небольшого, неизбежного шума: реквота сдвигает значение признака спреда на один тик, запоздалое обновление цены слегка меняет z-оценку объема, а кратковременный сбой в потоке котировок брокера приводит к тому, что значения бара округляются иначе, чем секундой позже.
Этот шум не является результатом состязательной атаки. Никто не атакует ваш конвейер формирования признаков. Но для неустойчивого прогноза эффект тот же, что и при атаке: если вектор признаков находится вблизи границы принятия решений модели, возмущение, вполне укладывающееся в обычный уровень шума торгового инструмента, может изменить прогнозируемый класс. Модель не может вам этого сказать. Вероятности softmax — не расстояние до границы принятия решений: даже плохо откалиброванная модель может выдавать внешне убедительную оценку уверенности 0,85 для прогноза, который меняется под воздействием шума величиной лишь в долю обычного диапазона одного бара.
На самом деле нам нужен геометрический ответ: для текущего вектора признаков x насколько большим может быть шар возмущений вокруг x, внутри которого мы можем гарантировать неизменность прогнозируемого класса? Если этот радиус велик по сравнению с типичным уровнем шума торгового инструмента в пространстве признаков, то сигнал устойчив и по нему стоит открывать позицию полного объема. Если радиус мал — сигнал неустойчив. Математически даже небольшое возмущение в пределах обычного шума потока котировок могло бы дать противоположный прогноз, и открывать по такому сигналу позицию, полностью доверяя ему, — значит делать ставку на шум, а не на модель.
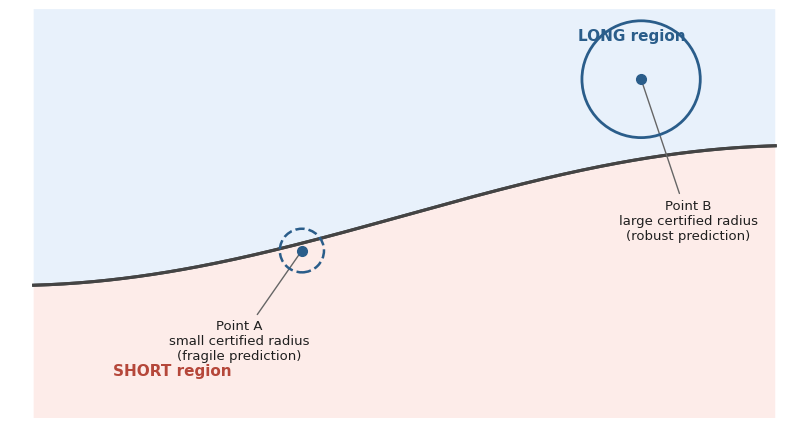
Рис. 1. Оба вектора признаков отнесены к классу "покупка", но один находится совсем рядом с границей, а другой — глубоко внутри области этого класса. Именно сертифицированный радиус позволяет их различить.
Рандомизированное сглаживание и сертифицированный радиус
Рандомизированное сглаживание позволяет обойтись без необходимости непосредственного анализа внутренней структуры модели — что в данном случае имеет большое значение, поскольку базовый классификатор представляет собой непрозрачный граф ONNX, экспортированный из scikit-learn, а в MQL5 изначально отсутствует доступ к градиентам или механизмы сертификации, специфичные для конкретной архитектуры. Вместо того чтобы сертифицировать базовый классификатор f напрямую, мы сертифицируем его сглаженную версию g, определяемую следующим образом:
g(x) = argmax_c P( f(x + ε) = c ), where ε ~ N( 0 , σ²I) Проще говоря, вместо одного запроса к модели мы выполняем множество запросов, каждый раз добавляя к вектору признаков независимый гауссовский шум с масштабом σ, и принимаем за сглаженный прогноз класс, набравший наибольшее число голосов. Именно это и делает метод CRobustnessCertifier::Certify() в коде: выполняет N проходов инференса с добавленным входным шумом и подсчитывает, как часто побеждает каждый класс.
Интересно не само голосование, а то, что позволяют доказать доли голосов, полученных классами. Результат Коэна, Розенфельда и Колтера, полученный в 2019 году, дает формулу сертифицированного радиуса в замкнутом виде на основе статистической нижней границы истинной вероятности победы класса-победителя при заданном распределении шума. Мы не можем непосредственно наблюдать эту истинную вероятность (мы провели лишь конечное число испытаний с шумом), поэтому вычисляем для нее нижнюю доверительную границу Клоппера — Пирсона, p_A:
p_A = Beta^-1( α; n_A, N - n_A + 1 )
где n_A — число голосов за победивший класс из N проходов, а α — уровень значимости (по умолчанию 0,001, что соответствует односторонней доверительной границе с доверительным уровнем 99,9%). Это реализовано штатными средствами MQL5 с помощью функции MathQuantileBeta() из стандартной статистической библиотеки, внешние зависимости не требуются. После получения p_A сертифицированный радиус вычисляется непосредственно:
R = σ · Φ^-1( p_A )
где Φ-1 — обратная функция распределения стандартного нормального распределения, вычисляемая с помощью MathQuantileNormal(). Если p_A ≤ 0,5, победивший класс не преодолел даже порог простого статистического большинства при добавлении шума, и модуль сертификации воздерживается от выдачи прогноза, вместо того чтобы сообщать бессмысленный радиус, близкий к нулю. Этот метод различает именно "уверенный прогноз при добавлении шума" и "неуверенный прогноз" — правильность победившего класса при этом никак не проверяется. Модель может уверенно и последовательно давать неверные результаты и при этом каждый раз проходить сертификацию с большим радиусом; именно это различие между устойчивостью и корректностью является основным ограничением, о котором следует помнить на протяжении всего процесса.
Есть один нюанс: эта формула представляет собой бинарное упрощение общей многоклассовой границы, при котором победивший класс сравнивается с фиксированным порогом 0,5, а не с конкретным классом, занявшим второе место. Такая граница более консервативна, чем наиболее точная из возможных, но её проще корректно реализовать. Когда от полученного числа зависит объём позиции с реальными деньгами, лучше ошибиться в сторону осторожности.
Еще два момента, о которых стоит сказать прямо. Во-первых, сертифицируется сглаженный классификатор g, а не непосредственно ONNX-модель f: фраза "прогноз не изменится" — лишь неточное сокращение утверждения "результат голосования сглаженного классификатора g(x) не изменится". Во-вторых, стандартная схема (Cohen и др.) использует две независимые выборки: одну для выбора класса, другую для вычисления доверительной границы, чтобы сохранить независимость этих этапов. В этой реализации для обоих этапов повторно используются одни и те же N проходов. Это требует меньше вычислений, но означает, что заявленный доверительный уровень лишь приближённо соответствует теоретической гарантии, а не обеспечивает саму эту гарантию.
//--- Clopper-Pearson lower bound + normal inverse -> certified radius
int err_code = 0;
double lower = MathQuantileBeta(alpha, (double)nA, (double)(n_passes - nA + 1), err_code);

if(lower <= 0.5)
  {
   predicted_class = CERT_CLASS_ABSTAIN;   // no certifiable margin at this sigma/N/alpha
   return true;
  }

int qerr = 0;
double z = MathQuantileNormal(lower, 0.0, 1.0, qerr);
radius = sigma * z;
Обзор архитектуры
Система чётко разделена на три области ответственности, которым соответствуют три подключаемых файла. CFeatureEngine управляет дескрипторами индикаторов и на каждом баре формирует вектор признаков фиксированной размерности 10. CRobustnessCertifier управляет сессией ONNX и выполняет вычисления для сглаживания и сертификации. Функция OnTick() советника лишь связывает эти два компонента и преобразует сертифицированный прогноз в торговое решение.
Контракт признаков — важнейшая часть, которую необходимо реализовать правильно и при этом проще всего незаметно нарушить. Значение CERT_FEATURE_COUNT, число столбцов, формируемых FeatureEngine::Build(), и объявленная размерность входа ONNX-модели должны в точности совпадать: несоответствие не приводит к сбою, а даёт правдоподобные на вид прогнозы на основе неверно сопоставленных признаков, что ещё хуже. RobustnessCertifier::Init() обеспечивает соблюдение этого требования, явно задавая размерности тензоров и завершая работу с явной ошибкой при несоответствии. Скрипт экспорта на Python выполняет ту же проверку перед записью файла .onnx, поэтому расхождения выявляются на этапе обучения, а не на реальном счёте.
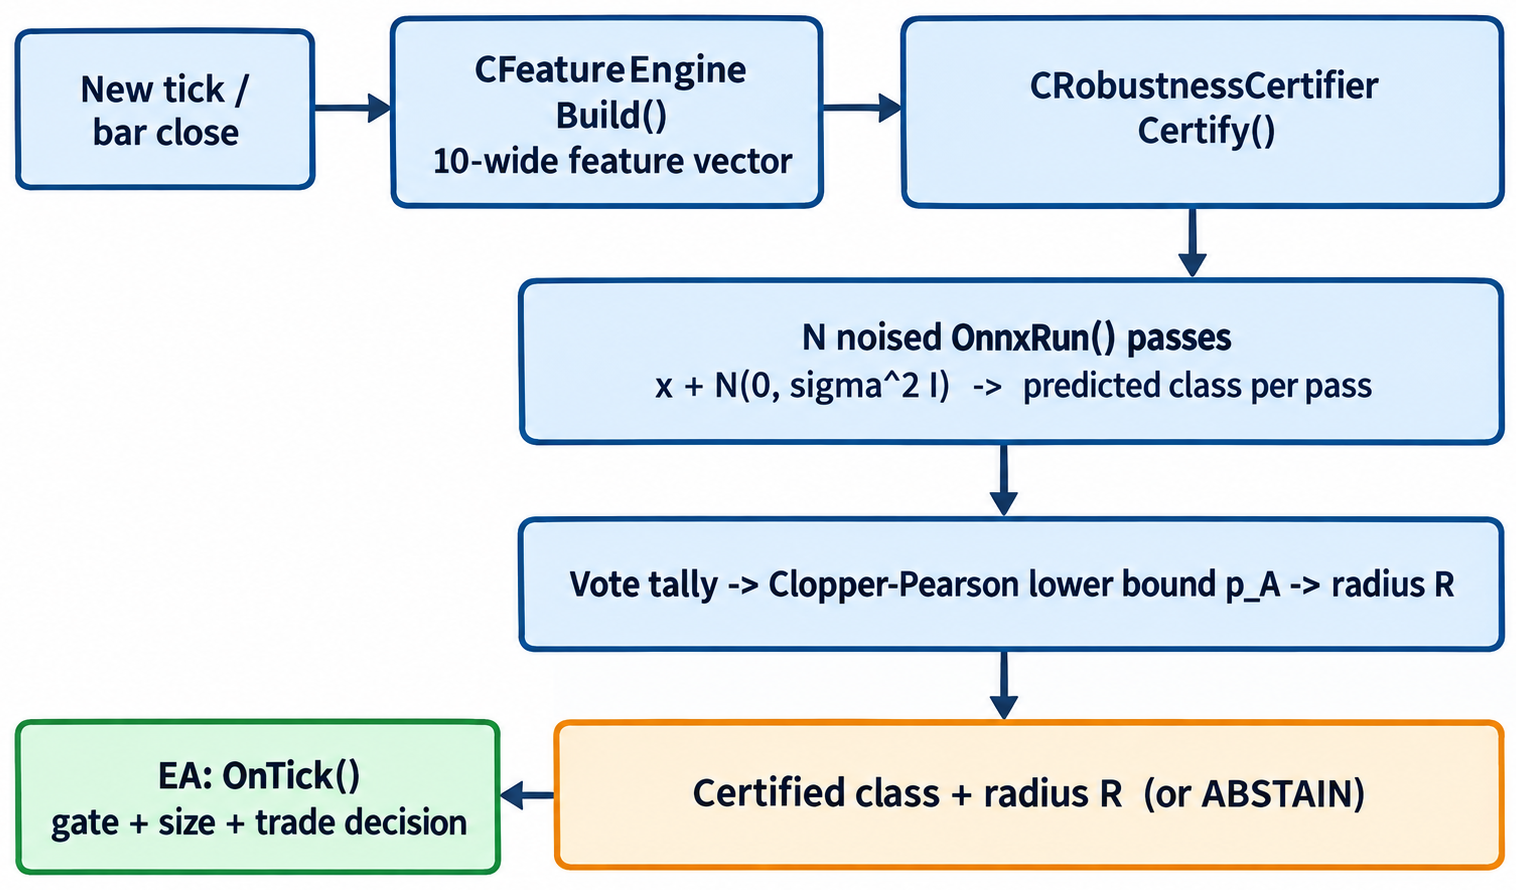
Рис. 2. Модуль формирования признаков строит вектор один раз на каждом закрытом баре. Модуль сертификации выполняет N проходов с добавленным входным шумом в одной и той же сессии ONNX, после чего советник действует на основе результата.
Внутри Certify() на каждом из N проходов генерируется независимый гауссовский шум с помощью MathRandomNormal(), добавляется к исходному вектору признаков и выполняется один вызов OnnxRun() — каждый проход представляет собой полноценный проход инференса, поэтому N и сложность модели напрямую определяют вычислительные затраты на каждый бар. Для используемой здесь компактной MLP 100 проходов на одном баре M15 с запасом укладываются во время между тиками, но замерьте время выполнения на своём оборудовании. В разделе тестирования приведены конкретные численные значения времени выполнения.
for(int pass = 0; pass < n_passes; pass++)
  {
   int cls = InferOnce(features, sigma);
   if(cls >= 0 && cls < (int)m_num_classes)
      counts[cls]++;
  }
Две неочевидные детали в функции InferOnce(). Во-первых, входной тензор ONNX имеет тип float32 (4 байта на элемент), а тип matrix без указания параметра типа в MQL5 — это matrix<double> (8 байт на элемент). Передача такой матрицы в OnnxRun() с флагом ONNX_NO_CONVERSION приводит к неочевидному несоответствию размера входных данных. Решение — объявить matrix<float> и для входа, и для выхода. Во-вторых, при использовании ONNX_NO_CONVERSION размеры выходной матрицы нужно заранее задать в соответствии с формой выходного тензора модели — память автоматически не выделяется. В обоих случаях возникают малоинформативные низкоуровневые ошибки, причину которых трудно понять, если не знать об этих особенностях.
CertDefines.mqh — самый маленький файл в проекте, но, пожалуй, ключевой: именно в нём контракт признаков закреплён в виде константы времени компиляции, а не "магического числа", разбросанного по файлам:
//+------------------------------------------------------------------+
//| Feature contract constants                                       |
//+------------------------------------------------------------------+
#define CERT_FEATURE_COUNT   10    // Width of the feature vector fed to ONNX
#define CERT_NUM_CLASSES     3    // short / flat / long
Все остальные файлы подключают этот файл и опираются на эти две константы: советник, индикатор, каждый диагностический скрипт и скрипт обучения на Python сверяют значения с CERT_FEATURE_COUNT/NUM_CLASSES, а не задают независимо друг от друга жёстко прописанные числа 10 и 3. Это сделано намеренно. Если вы добавите или удалите признак, изменить соответствующее значение потребуется только в одном месте, а каждый использующий его компонент либо автоматически подхватит новое значение, либо выдаст явную ошибку при инициализации вместо того, чтобы незаметно вычислять бессмысленные результаты.
В методе FeatureEngine::Build() и происходит фактический расчет 10 признаков — один раз за каждый закрытый бар. В основном код сводится к работе с буферами индикаторов, но выбор некоторых признаков стоит разобрать подробнее, а не просто перечислить их в виде списка:
//--- 4: MACD_hist_norm -- histogram normalized by ATR, not by price,
//--- so the feature scale stays comparable across low- and high-priced
//--- instruments (a raw MACD histogram value means something very
//--- different on EURUSD than on XAUUSD; dividing by ATR fixes that).
double hist = macd_main[0] - macd_sig[0];
features[4] = hist / MathMax(atr14, CERT_EPS);

//--- 6: Volume_zscore -- how unusual is this bar's volume relative
//--- to its own recent history, rather than an absolute volume number
//--- that would need per-instrument calibration to mean anything.
double mean_v = 0.0, sd_v = 0.0;
for(int i = 0; i < 20; i++) mean_v += (double)vol[i];
mean_v /= 20.0;
for(int i = 0; i < 20; i++) sd_v += MathPow((double)vol[i] - mean_v, 2);
sd_v = MathSqrt(sd_v / 20.0);
features[6] = ((double)vol[19] - mean_v) / MathMax(sd_v, CERT_EPS);
Каждый признак строится по одной и той же схеме: его значение делится на некоторую локальную величину или преобразуется в Z-оценку относительно локальной базы, но никогда не используется как абсолютное число. Это имеет значение для метода рандомизированного сглаживания: в этом нормированном пространстве добавляется шум с фиксированным значением σ, поэтому, если бы признаки не были примерно сопоставимы по масштабу, одно и то же значение σ означало бы разное для разных признаков, и сертифицированный радиус перестал бы быть значимой геометрической величиной.
Наконец, логика выполнения самого советника: OnInit() выполняет однократную настройку, а в OnTick() принимается решение для каждого бара. Этот код выполняется только после единственной проверки появления нового закрытого бара, поэтому затраты на сертификацию (N проходов инференса) возникают один раз на бар, а не на каждый тик. OnInit() стоит привести полностью, поскольку именно там, внутри RobustnessCertifier::Init(): выполняется проверка контракта признаков.
//+------------------------------------------------------------------+
//| Init                                                             |
//+------------------------------------------------------------------+
bool Init(const string model_path, const ulong feature_count, const ulong num_classes)
  {
   m_feature_count = feature_count;
   m_num_classes   = num_classes;

   m_onnx_handle = OnnxCreate(model_path, ONNX_DEFAULT);
   if(m_onnx_handle == INVALID_HANDLE)
    {
      PrintFormat("OnnxCreate failed for '%s', err=%d", model_path, GetLastError());
      return false;
    }

//--- Consistency check: declared ONNX input shape vs feature contract
   if(!OnnxGetInputCount(m_onnx_handle))
    {
      Print("RobustnessCertifier: model reports zero inputs.");
      Release();
      return false;
    }

//--- Bind the model's declared input/output shapes explicitly. If the
//--- model's actual input width doesn't match feature_count, or its
//--- output width doesn't match num_classes, this fails HERE, loudly,
//--- at startup -- instead of silently computing on misaligned data
//--- once the EA is already live.
   const long in_shape_expected[]  = {1, (long)feature_count};
   const long out_shape_expected[] = {1, (long)num_classes};
   if(!OnnxSetInputShape(m_onnx_handle, 0, in_shape_expected) ||
     !OnnxSetOutputShape(m_onnx_handle, 0, out_shape_expected))
    {
      PrintFormat("RobustnessCertifier: shape binding failed -- model input/output width does not match CERT_FEATURE_COUNT=%d / CERT_NUM_CLASSES=%d. err=%d",
              feature_count, num_classes, GetLastError());
      Release();
      return false;
    }

   m_ready = true;
   return true;
  }
Функция OnInit() самого советника вызывает этот метод, а также настраивает буфер скользящей истории радиусов для расчёта базового уровня фильтра и открывает журнал CSV:
//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+
int OnInit()
  {
   if(!g_features.Init(_Symbol, _Period)) return INIT_FAILED;

   if(!g_certifier.Init(InpModelFileName, CERT_FEATURE_COUNT, CERT_NUM_CLASSES))
    {
      Print("certifier init / feature-contract validation failed.");
      return INIT_FAILED;
    }

   ArrayResize(g_radius_history, InpBaselineLookback);
   ArrayInitialize(g_radius_history, -1.0); // -1 = not yet populated
   g_radius_ptr = 0;

   g_trade.SetExpertMagicNumber(InpMagicNumber);

   if(InpLogToFile)
    {
      g_file_handle = FileOpen("CertifiedONNXRadius\\cert_log.csv", FILE_WRITE | FILE_CSV | FILE_COMMON);
      if(g_file_handle != INVALID_HANDLE)
        FileWrite(g_file_handle, "time", "predicted_class", "pA_lower", "radius", "baseline", "gate_ratio", "lot", "equity", "action");
    }

   return INIT_SUCCEEDED;
  }
Сам скользящий базовый уровень — это обычная медиана последних InpBaselineLookback сертифицированных радиусов. Бары, на которых модуль воздержался от выдачи прогноза (хранящиеся со специальным значением -1), пропускаются, а не учитываются как нулевые значения:
//+------------------------------------------------------------------+
//| ComputeBaseline                                                  |
//+------------------------------------------------------------------+
double ComputeBaseline(void)
  {
   double valid[];
   int n = 0;
   for(int i = 0; i < InpBaselineLookback; i++)
      if(g_radius_history[i] >= 0.0) n++;

   if(n < 5) return -1.0; // not enough history yet -- gate stays closed

   ArrayResize(valid, n);
   int j = 0;
   for(int i = 0; i < InpBaselineLookback; i++)
      if(g_radius_history[i] >= 0.0) valid[j++] = g_radius_history[i];

   ArraySort(valid);
   return (n % 2 == 1) ? valid[n/2] : (valid[n/2 - 1] + valid[n/2]) / 2.0;
  }
А сама функция OnTick() — это и есть полный, несокращённый вариант алгоритма принятия решения, а не его отрывок. Всё, что ниже описано словами в разделе "Фильтрация торговых действий", реализовано во второй половине этой функции:
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
   datetime cur_bar_time = iTime(_Symbol, _Period, 0);
   if(cur_bar_time == g_last_bar_time) return; // once per closed bar
   g_last_bar_time = cur_bar_time;

   double features[];
   if(!g_features.Build(1, features)) return; // shift=1: last fully closed bar

   int predicted_class = CERT_CLASS_ABSTAIN;
   double radius = 0.0, pA_lower = 0.0;
   if(!g_certifier.Certify(features, InpSigma, InpNPasses, InpAlpha, predicted_class, radius, pA_lower))
    {
      Print("Certify() failed this bar -- skipping, pointer still advances.");
    }

   g_radius_history[g_radius_ptr] = (predicted_class == CERT_CLASS_ABSTAIN) ? -1.0 : radius;
   g_radius_ptr = (g_radius_ptr + 1) % InpBaselineLookback;

   double baseline = ComputeBaseline();
   double gate_ratio = (baseline > 0.0) ? radius / baseline : 0.0;

   string action = "SKIP_ABSTAIN";
   double lot = 0.0;

   bool has_position = PositionSelect(_Symbol);

   if(predicted_class != CERT_CLASS_ABSTAIN && baseline > 0.0)
    {
      if(gate_ratio < InpMinRadiusMultiple)
        {
          action = "SKIP_LOW_RADIUS";
          if(has_position)
            {
              g_trade.PositionClose(_Symbol);
            action = "CLOSE_LOW_RADIUS";
          }
        }
      else
        {
          double lot_multiple = MathMin(gate_ratio, InpMaxLotMultiple);
          lot = NormalizeDouble(InpBaseLots * lot_multiple, 2);

          if(predicted_class == CERT_CLASS_LONG)
            {
              if(has_position && PositionGetInteger(POSITION_TYPE) == POSITION_TYPE_SELL)
                g_trade.PositionClose(_Symbol);
            if(!PositionSelect(_Symbol))
              {
                g_trade.Buy(lot, _Symbol);
              action = "OPEN_LONG";
            }
          }
          else if(predicted_class == CERT_CLASS_SHORT)
            {
              if(has_position && PositionGetInteger(POSITION_TYPE) == POSITION_TYPE_BUY)
                g_trade.PositionClose(_Symbol);
            if(!PositionSelect(_Symbol))
              {
                g_trade.Sell(lot, _Symbol);
              action = "OPEN_SHORT";
            }
          }
          else // FLAT
          {
            if(has_position)
            {
              g_trade.PositionClose(_Symbol);
            action = "CLOSE_FLAT_SIGNAL";
            }
          else
            action = "STAY_FLAT";
        }
    }
  }

   if(InpLogToFile && g_file_handle != INVALID_HANDLE)
    FileWrite(g_file_handle, TimeToString(cur_bar_time), predicted_class, pA_lower, radius, baseline, gate_ratio, lot,
        AccountInfoDouble(ACCOUNT_EQUITY), action);
  }
Обратите внимание: в Build() используется shift=1, а не shift=0 — советник всегда выполняет сертификацию для последнего полностью закрытого бара. В рамках одного вызова Certify() исходный вектор признаков формируется один раз и остаётся неизменным. От прохода к проходу меняется только шум. Истинная причина, по которой следует избегать shift=0, такова: цена незакрытого бара постоянно обновляется, поэтому последовательные вызовы OnTick() на одном и том же ещё формирующемся баре создавали бы разные векторы признаков, из-за чего результаты сертификации "одного и того же бара" были бы несогласованными между вызовами. Логика смены направления также всегда закрывает противоположную позицию перед открытием новой — именно так смена направления учитывается в симуляции в EquityCompareBacktest.mq5, которая рассматривается далее.
В приведённом выше коде OnTick() есть три недоработки, о которых стоит честно сказать. Во-первых, объём позиции определяется по gate_ratio только при её открытии — объём уже открытой позиции в том же направлении не корректируется с учётом нового радиуса. Во-вторых, вызовы PositionSelect(_Symbol) и PositionClose(_Symbol) не предусматривают фильтрации по магическому номеру, поэтому при работе с инструментом, на котором торгует и другой советник, эта логика может затронуть позиции, открытые не ею, — добавьте проверку магического номера перед любыми действиями с найденной таким образом позицией. В-третьих, возвращаемое значение Certify() проверяется и при сбое записывается в журнал, но не меняет дальнейшую логику — predicted_class в любом случае остаётся равным CERT_CLASS_ABSTAIN, поэтому внутренний сбой и обоснованное воздержание от выдачи прогноза обрабатываются одинаково. Отдельное состояние сбоя стало бы существенным улучшением. Ни одна из этих недоработок не нарушает математические расчёты сертификации, но все три стоит исправить до начала торговли на реальные деньги.
Фильтрация торговых действий и определение объёма позиции
Приведённый выше полный код OnTick() уже показывает, как это работает. В этом разделе объясняется выбор двух констант, определяющих его работу. Скользящий базовый уровень адаптивен, а не задан жёстко. Критерий устойчивости зависит от инструмента, поэтому советник определяет текущую норму по скользящему окну. InpMinRadiusMultiple (по умолчанию 0,75) задаёт, насколько ниже базового уровня должен опуститься радиус, чтобы фильтр счёл прогноз слишком неустойчивым; InpMaxLotMultiple ограничивает увеличение объёма позиции при превышении радиусом базового уровня.
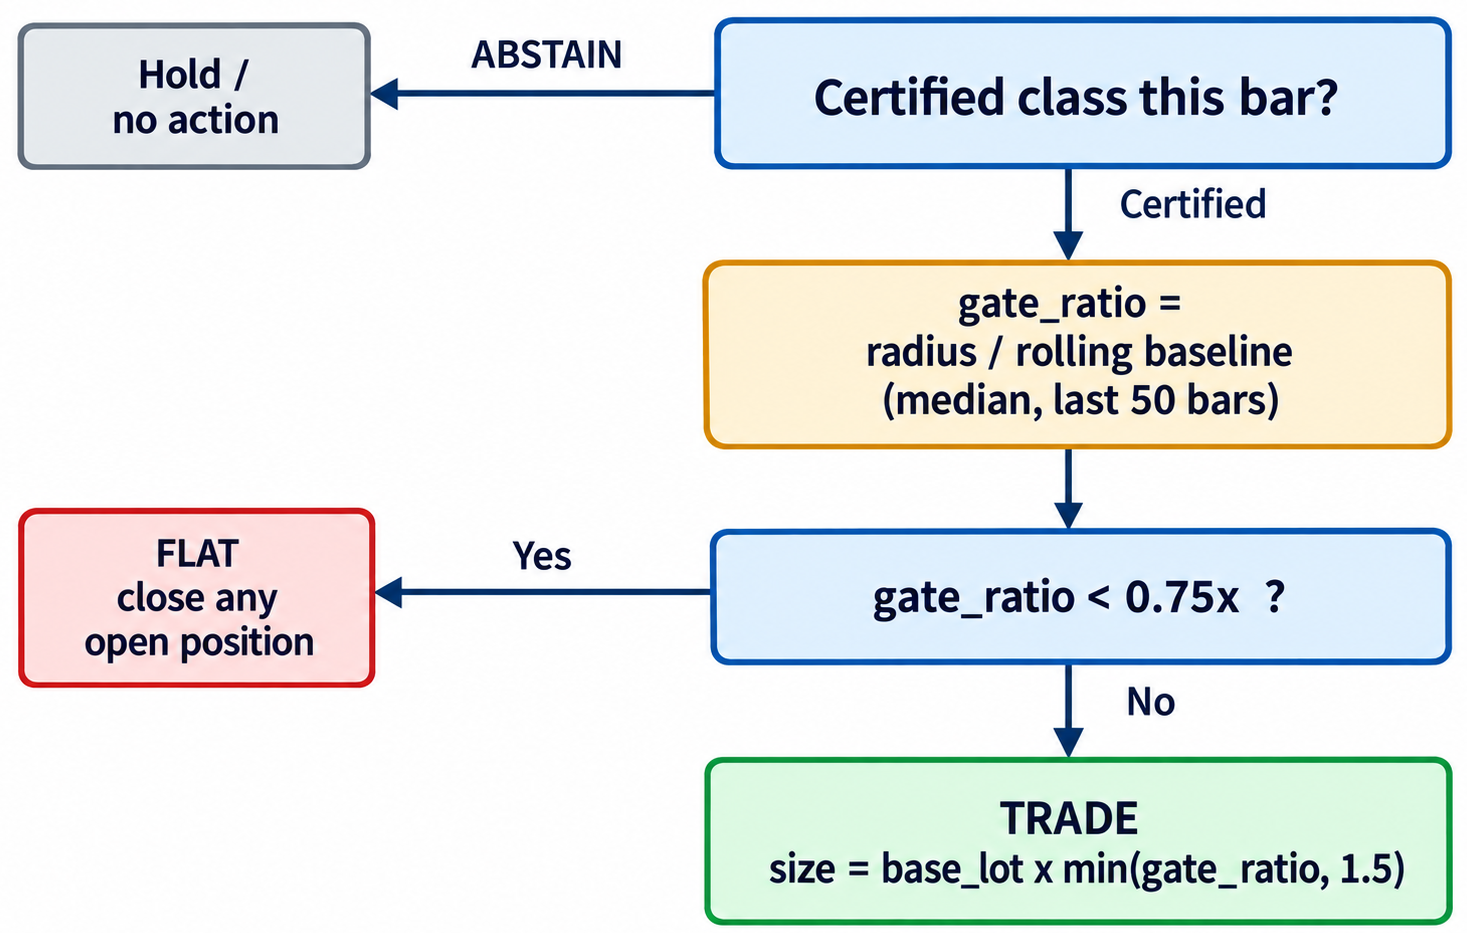
Рис. 3. Прежде чем выполнить какое-либо торговое действие, фильтр сравнивает сертифицированный радиус текущего бара со скользящим базовым уровнем.
Логика фильтра в одной строке: нет сертифицированного класса → воздержаться от выдачи прогноза и сохранить текущую позицию, если она открыта. Класс сертифицирован, но радиус ниже 0,75 × базового уровня → оставаться без позиции, закрыв любую открытую позицию. Класс сертифицирован, а радиус не ниже порога относительно базового уровня → торговать с объёмом позиции, зависящим от того, насколько радиус превышает базовый уровень, но не более 1,5 базового объёма в лотах.
Стоит честно отметить: "воздержаться от выдачи прогноза и сохранить позицию" означает, что уже открытая позиция остаётся открытой на баре, для которого модуль сертификации не смог подтвердить класс. Это явная асимметрия относительно заявленной защитной логики: новый сигнал отклоняется, но существующая позиция не закрывается на баре с неопределённым результатом сертификации. Закрывать позицию при каждом воздержании от выдачи прогноза было бы более консервативным подходом, но он также сильнее реагировал бы на шум в самом процессе сертификации.
Стоит отметить одно проектное решение, видимое в приведённой выше функции ComputeBaseline(): указатель записи кольцевого буфера сдвигается на каждом баре независимо от результата, а воздержания от выдачи прогноза записываются как специальное значение -1, а не пропускаются. Если бы указатель сдвигался только при успешной сертификации, он останавливался бы во время серии воздержаний от выдачи прогноза, замораживая базовый уровень именно тогда, когда тот должен продолжать адаптироваться.
Пограничные случаи и подводные камни
Самое важное ограничение, которое нужно учесть перед запуском на реальном счёте: в течение первых InpBaselineLookback баров после подключения советника доступно менее 5 допустимых значений, ComputeBaseline() возвращает -1, и фильтр не допускает торговлю до заполнения буфера. Это безопаснее торговли без фильтра, но до первой возможной сделки следует предусмотреть ожидание примерно InpBaselineLookback закрытых баров.
Параметр σ нужно настраивать в тех же единицах нормализованных признаков, которые использовались при обучении модели, а не в исходных единицах цены. Если σ слишком мало, любой прогноз тривиально "сертифицируется" (голоса почти единодушны, радиус неинформативен). Если же σ слишком велико, даже сильные сигналы не преодолевают порог большинства 0,5, и модуль сертификации постоянно воздерживается от выдачи прогноза. Перебор значений σ в разделе тестирования нужен, чтобы найти диапазон, в котором радиус действительно позволяет различать прогнозы по устойчивости, а не достигает насыщения на одном из крайних уровней.
Граница Клоппера — Пирсона также чувствительна к N: при малом N (например, 20) сертификация скорее недооценивает устойчивость (больше воздержаний от выдачи прогноза и меньшие радиусы, чем оправдывает истинная устойчивость модели), чем переоценивает ее. Это более безопасная ошибка, но она обходится дороже с точки зрения упущенных торговых возможностей. Здесь N = 100–200 — разумный компромисс. Для более ресурсоемких моделей приходится искать баланс между N и задержкой.
И, наконец, от чего эта система защищает, а от чего — нет. Она сертифицирует устойчивость к шуму, соответствующему предположению о гауссовском распределении, принятому при обучении, но не защищает ни от реального противника, подбирающего наихудшие возмущения, ни от ошибок модели, устойчивых к шуму: модель, которая уверенно и стабильно ошибается, прекрасно проходит сертификацию. Кроме того, эта гарантия относится к конкретной модели шума, а не к реальному шуму со стороны брокера или потока котировок, который не обязательно представляет собой изотропный гауссовский шум: возмущения, добавленные непосредственно к вычисленным признакам, могут давать сочетания, которые не возникли бы ни при каком реальном наборе значений OHLCV. Единый скалярный параметр σ усугубляет эту проблему: все компоненты вектора признаков считаются независимыми и имеющими одинаковый масштаб; модель шума с диагональной ковариационной матрицей точнее отражала бы реальную неоднородность признаков, но потребовала бы настройки еще одного параметра.
Прямо обозначим несколько методологических оговорок относительно проведенного здесь тестирования. Разделение данных на обучающую, валидационную и тестовую выборки не описано, поэтому результаты теста на дрейф могут быть частично или полностью получены на обучающей выборке. Показатель 50,8% не сопоставляется с результатом той же исходной модели на тех же барах с выданным прогнозом, поэтому "повышение точности" характеризует сертифицированное подмножество, а не отдельно выделенный и доказанный вклад сертификации. Чувствительность к N обсуждается качественно, но ее влияние на долю воздержаний от выдачи прогноза, радиус, задержку, прибыль и убыток количественно не оценивается. При длительных сериях воздержаний от выдачи прогноза скользящий базовый уровень рассчитывается лишь по тем допустимым радиусам, которые еще остаются, поэтому он может стать нерепрезентативным, либо фильтр может просто продолжать блокировать торговые действия. Приведенный ниже эксперимент с порогом (0,75 против 0,4) показывает, насколько важен этот параметр, но не дает проверенного способа его выбора. И все данные, представленные здесь, получены на основе одной модели, одного инструмента, одного окна и одного теста на дрейф — это реальные, конкретные данные по данному прогону, а не общие утверждения, применимые ко всем рынкам или режимам.
Индикатор мониторинга
CertRadiusMonitor.mq5 — индикатор в отдельном окне, который строит графики сертифицированного радиуса и скользящего базового уровня на исторических данных, позволяя оценить запас устойчивости модели за любой период без запуска скрипта или чтения CSV-файла. Он использует те же классы CFeatureEngine и CRobustnessCertifier, что и советник: математическая часть сертификации не реализуется заново, а единственная новая логика — эффективная перерисовка по историческим барам внутри OnCalculate():
//+------------------------------------------------------------------+
//| Custom indicator iteration function                              |
//+------------------------------------------------------------------+
int OnCalculate(const int rates_total, const int prev_calculated, ...)
  {
   if(rates_total < InpBaselineLen + 5) return 0;

//--- Only re-certify newly-appeared bars on each redraw, not the whole
//--- chart history every time -- prev_calculated tracks how far the
//--- indicator already got on the last call.
   int start = (prev_calculated == 0) ? rates_total - InpBaselineLen - 1
                                       : rates_total - prev_calculated + 1;

   for(int shift_from_end = MathMax(start, 1); shift_from_end >= 1; shift_from_end--)
    {
      double features[];
      if(!g_features.Build(shift_from_end, features)) continue;

      int predicted_class = CERT_CLASS_ABSTAIN;
      double radius = 0.0, pA_lower = 0.0;
      g_certifier.Certify(features, InpSigma, InpNPasses, InpAlpha, predicted_class, radius, pA_lower);
      //--- write radius into BufRadius[], trailing median into BufBaseline[]
    }
   return rates_total;
  }
Этот инструмент реализован как отдельный индикатор, а не опирается на CSV-журнал советника, поскольку анализ поведения радиуса на ценовом графике позволяет гораздо быстрее проверить, все ли работает ожидаемым образом, чем пролистывание электронной таблицы. Обратная сторона — вычислительные затраты: значение InpNPasses по умолчанию равно 100, как и в советнике, а перерисовка длинного участка истории требует полной сертификации на каждом видимом баре, поэтому настройки по умолчанию рассчитаны на меньшую нагрузку, чем требуется для работы в реальной торговле.
Инструментарий для обучения, экспорта и валидации
Всё, о чём шла речь до сих пор, касается работы в реальной торговле, для которой прежде всего необходимо иметь обученную модель ONNX. Реальные данные, приведенные в разделе "Тестирование" ниже, были получены с помощью специального набора скриптов, которые обучают модель, корректно экспортируют её и объективно проверяют, действительно ли механизм сертификации работает так, как утверждается в данной статье. Для этой цели предусмотрено шесть файлов — они используются в автономном режиме, и ни один из них не запускается во время реальной торговли.
Файл RawONNXSignal_EA.mq5 служит исключительно базовым вариантом для сравнения. Он использует тот же модуль формирования признаков и ту же обученную модель, что и советник с сертификацией, но полностью пропускает сертификацию: один проход инференса без добавления шума на каждом баре, фиксированный объем позиции, без фильтра допуска к торговле:
//+------------------------------------------------------------------+
//| RawPredict                                                       |
//+------------------------------------------------------------------+
int RawPredict(const double &features[])
  {
   matrix<float> in_matrix;
   in_matrix.Init(1, CERT_FEATURE_COUNT);
   for(int i = 0; i < CERT_FEATURE_COUNT; i++)
      in_matrix[0][i] = (float)features[i];

   matrix<float> out_matrix;
   out_matrix.Init(1, CERT_NUM_CLASSES); // must pre-size -- see note above
   if(!OnnxRun(g_onnx_handle, ONNX_NO_CONVERSION, in_matrix, out_matrix)) return -1;

   int best_idx = 0;
   float best_val = out_matrix[0][0];
   for(int c = 1; c < CERT_NUM_CLASSES; c++)
      if(out_matrix[0][c] > best_val) { best_val = out_matrix[0][c]; best_idx = c; }
   return best_idx;
  }
Его функция OnTick() торгует непосредственно по этому классу на каждом баре с фиксированным объемом в лотах — без сглаживания, без радиуса, без фильтра допуска к торговле. Его единственная цель — обеспечить объективную основу для сравнения результатов советника с сертификацией.
ExportTrainingData.mq5 — это скрипт, который однократно запускают на графике: он проходит по историческим барам в обратном порядке и записывает те же значения индикаторов, которые вычисляет функция FeatureEngine::Build(), вместе с меткой, автоматически определяемой по фактическому последующему движению цены:
double ret = (c_future - c_now) / c_now;
int label;
if(ret > InpLabelThreshold)       label = 2; // long
else if(ret < -InpLabelThreshold) label = 0; // short
else                           label = 1; // flat
c_future соответствует цене на InpLabelHorizon баров позже, чем c_now, — это допустимо только в автономном режиме, на уже сформировавшихся исторических данных. Это соответствует логике формирования меток, используемой далее в тесте на дрейф, поэтому обучающие метки и эталонные метки теста на дрейф остаются сопоставимыми. Для проверки корректности скрипт выводит распределение меток по классам: если 90% обучающей выборки относится к нейтральному классу, модель мало чему научится; в таком случае скрипт выдает предупреждение.
Скрипт train_export_model.py обучает небольшой классификатор MLP (scikit-learn) и экспортирует его в формат ONNX. Есть одна тонкость: skl2onnx по умолчанию экспортирует классификаторы sklearn с двумя выходами — тензором меток классов и тензором вероятностей, — но советник, индикатор и все приведенные здесь скрипты привязывают только один выход. Если оставить всё как есть, это несоответствие приводит к созданию файла ONNX, который выглядит работоспособным, но выдает ошибку при выполнении. Исправление заключается в том, чтобы принудительно задать вывод вероятностей в виде обычного тензора и удалить выход с метками классов перед сохранением:
onnx_model = convert_sklearn(
    clf, initial_types=initial_type,
    options={id(clf): {"zipmap": False}},
)
# keep only the [N, num_classes] probability tensor, drop the label output
prob_output = None
for out in onnx_model.graph.output:
    if len(out.type.tensor_type.shape.dim) == 2:
        prob_output = out
del onnx_model.graph.output[:]
onnx_model.graph.output.append(prob_output)
Этот же скрипт повторно проверяет контракт признаков на стороне Python: размерность входа сверяется с FEATURE_COUNT, а размерность выхода — с NUM_CLASSES. Это повторяет проверку, которую функция RobustnessCertifier::Init() выполняет в MQL5 во время работы.
Скрипт DriftTestLogger.mq5 сформировал фактические численные результаты для рис. 5; он использует логику, близкую к циклу сертификации советника в реальной торговле, но проходит по истории в обратном порядке: поскольку он работает в автономном режиме, он может заглянуть на InpLabelHorizon баров вперед, чтобы вычислить "правильный" класс, а затем записать в журнал прогнозируемый и фактический классы для каждого бара — чего советник в реальной торговле сделать не может:
double c_now    = iClose(_Symbol, _Period, shift);
double c_future = iClose(_Symbol, _Period, shift - InpLabelHorizon);
double ret = (c_future - c_now) / c_now;

int actual_class;
if(ret > InpLabelThreshold)       actual_class = CERT_CLASS_LONG;
else if(ret < -InpLabelThreshold) actual_class = CERT_CLASS_SHORT;
else                           actual_class = CERT_CLASS_FLAT;

bool abstained = (predicted_class == CERT_CLASS_ABSTAIN);
int  correct   = (!abstained && predicted_class == actual_class) ? 1 : 0;
FileWrite(file_handle, TimeToString(bar_time), shift, predicted_class, actual_class,
      correct, (abstained ? 1 : 0), radius, pA_lower);
Этот CSV-файл с данными по каждому бару (временем, прогнозируемым классом, фактическим классом, флагами правильности прогноза и воздержания от выдачи прогноза, радиусом) служит исходным материалом для рядов скользящей доли правильных прогнозов и скользящего радиуса, показанных на рис. 5. Порог и горизонт для определения меток здесь намеренно заданы такими же, как в ExportTrainingData.mq5, чтобы эталонная метка определялась одинаково при обучении и при этой проверке.
Скрипт EquityCompareBacktest.mq5 выдал реальные данные, представленные на рис. 4. Два отдельных прогона в тестере стратегий оказались ненадежным подходом: у каждого агента есть изолированная среда, которая не обменивается файлами с терминалом и может сбрасываться между прогонами. Поэтому этот скрипт моделирует обе стратегии за один проход по одним и тем же историческим данным, переоценивая средства по рыночной цене на каждом баре с учетом направления позиции на предыдущем баре, чтобы избежать смещения из-за использования будущих данных:
equity_gated += prev_gated_dir * (c_now - c_prev) * prev_gated_lot;
equity_raw   += prev_raw_dir   * (c_now - c_prev) * InpBaseLots;
Средства выражены в единицах ценового эквивалента (разность цен × объем в лотах), а не в валюте моделируемого счета. Спред, комиссия и своп не моделируются, поэтому это упрощенный показатель, не воспроизводящий точно условия брокера, хотя он действительно рассчитан по реальным данным.
analyze_drift_test.py никогда не запускается внутри MetaTrader: это отдельный скрипт Python, который читает CSV-файл, созданный DriftTestLogger, и объективно проверяет, опережает ли сертифицированный радиус динамику скользящей доли правильных прогнозов при каком-либо временном сдвиге, вместо того чтобы оценивать график на глаз:
best_lag, best_corr = 0, -2.0
for lag in range(-30, 31):
    shifted_radius = clean['rolling_radius'].shift(-lag)
    valid = shifted_radius.notna() & clean['rolling_accuracy'].notna()
    if valid.sum() < 30:
        continue
    corr = np.corrcoef(shifted_radius[valid], clean['rolling_accuracy'][valid])[0, 1]
    if corr > best_corr:
        best_corr, best_lag = corr, lag
Положительное значение best_lag в сочетании с высоким значением best_corr означало бы, что радиус действительно опережает точность — именно так и выглядел бы настоящий эффект опережающего индикатора. На деле даже наилучшая корреляция среди всех проверенных временных сдвигов оказалась ниже 0,1, поэтому в статье прямо указано, что такой закономерности не обнаружено.
Тестирование в тестере стратегий
В тестировании на исторических данных сравниваются два советника с одной и той же обученной моделью и логикой входа: один использует исходный сигнал ONNX без фильтрации торговых действий, а другой — фильтрацию по сертифицированному радиусу. Это позволяет выделить влияние сертификации на результат. Перед таблицей важно уточнить: описанные ниже перебор значений сигмы и N и сравнение EURUSD с XAUUSD относятся к первоначальному плану тестирования. Фактически выполненные проверки, для которых здесь приведены реальные численные результаты, имеют более узкий охват: одна конфигурация (настройки по умолчанию из таблицы) на XAUUSD H1 и один вариант порога (0,4× вместо 0,75×), обсуждаемый ниже. Диапазоны перебора значений параметров и строку EURUSD следует считать частью плана тестирования, а не результатами.
| настройка | Значение |
|---|---|
| Фактически протестированный инструмент/таймфрейм | XAUUSD/H1 |
| Дополнительный инструмент из первоначального плана (не тестировался) | EURUSD/H1 |
| Диапазон перебора значений сигмы (запланирован, перебор не проводился) | 0,01–0,10 (в единицах нормированных признаков) |
| Перебор значений N (запланирован, но не выполнен) | 50/100/200 проходов |
| Фактически использованный уровень значимости (α) | 0,001 (односторонняя граница Клоппера — Пирсона) |
| Фактически использованная длина окна для расчета скользящего базового уровня | 50 баров |
| Фактически использованный множитель минимального порога радиуса для допуска к торговле | 0,75× (запуск с настройками по умолчанию), 0,4× (альтернативный вариант, см. ниже) |
Вот фактический результат тестирования обеих стратегий на одних и тех же реальных исторических данных: на этом интервале XAUUSD H1 (2 999 баров — отдельный запуск EquityCompareBacktest.mq5, а не приведенный выше тест на дрейф на интервале в 2 996 баров, поскольку каждый скрипт немного по-разному обрезает историю) накопленный финансовый результат стратегии без фильтрации составил примерно 207 единиц ценового эквивалента против примерно 90 у стратегии с фильтрацией при пороге по умолчанию 0,75×. Ни одно из этих значений не характеризует прибыль и убыток на реальном счете: спред, комиссия, проскальзывание и своп не моделировались. Полученные результаты позволяют выделить влияние фильтрации торговых действий при одних и тех же исходных движениях цены. Стратегия с фильтрацией не победила. Стоит разобраться, почему.
При пороге по умолчанию стратегия с фильтрацией оставалась вне рынка на 64% баров. В этот период на рынке золота наблюдался устойчивый тренд, и сигнал без фильтрации, постоянно удерживавший позицию, воспользовался большей частью этого тренда просто за счет постоянного присутствия на рынке. Из-за консервативного порога стратегия с фильтрацией оставалась без позиции на протяжении большей части того же тренда, а даже на барах, на которых она торговала, средний результат был слегка отрицательным. Снижение порога до 0,4× позволило частично сократить отставание (доля времени на рынке выросла до 45,5%, средний финансовый результат на барах с торговлей стал слегка положительным, а итоговые средства составили примерно 103 единицы ценового эквивалента), но разрыв со стратегией без фильтрации остался значительным.
Честный вывод: более высокая условная доля правильных прогнозов на отобранных модулем барах не приводит автоматически к преимуществу по прибыли и убытку перед более простой стратегией, постоянно находящейся в рынке, особенно в условиях тренда, когда длительность пребывания в рынке важнее избирательности. Радиус — это показатель устойчивости, а не доли правильных прогнозов, и ни один из этих показателей сам по себе не является показателем прибыльности. Фильтрация торговых действий полезна для выявления статистически неустойчивых прогнозов и регулирования объема позиции с учетом этой неустойчивости, но она не гарантирует преимущества перед наивным базовым вариантом стратегии при любом рыночном режиме — этот тест прямо это подтверждает.
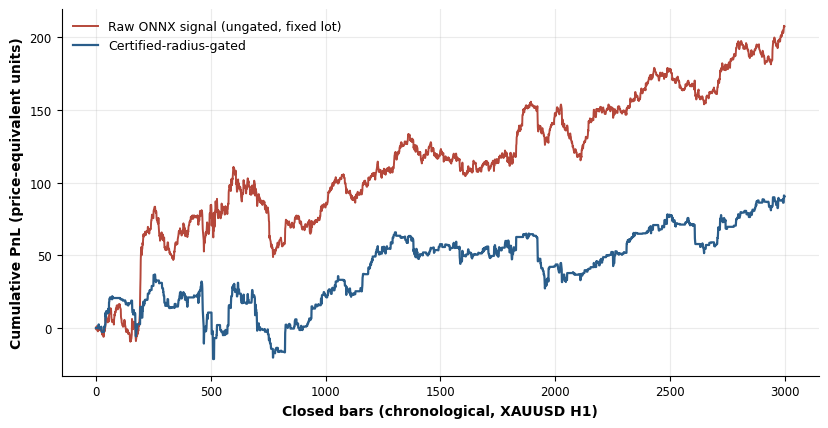
Рис. 4. Фактический накопленный финансовый результат по одной и той же истории реальных цен и одной и той же обученной модели: фильтрация по сертифицированному радиусу (порог по умолчанию — 0,75×) в сравнении с сигналом без фильтрации, XAUUSD H1, 2 999 баров. На этом трендовом участке сигнал без фильтрации показал лучшие результаты, причины рассмотрены выше.
Отдельно был проведен фактический тест на дрейф на XAUUSD H1 за 2 996 баров: на 1 210 барах модуль сертификации воздержался от выдачи прогноза, а на остальных 1 786 барах условная доля правильных прогнозов составила 50,8% — выше примерно одной трети, ожидаемой при случайном угадывании в случае сбалансированных классов (см. оговорку выше). Это условная доля правильных прогнозов на подмножестве, отобранном самим модулем сертификации, а не общая доля правильных прогнозов; при этом сравнение с моделью без фильтрации на том же подмножестве не проводилось. Поэтому результат следует понимать как "выданные прогнозы оказались заметно лучше наивного угадывания", а не как "сертификация повышает долю правильных прогнозов именно на столько".
Чего этот тест не показал, так это четкой связи, позволяющей считать радиус опережающим индикатором: корреляция между скользящим радиусом и скользящей долей правильных прогнозов в широком диапазоне временных сдвигов не выявила устойчивой закономерности (корреляция при наилучшем подборе сдвига была ниже 0,1, причем даже этот результат не соответствовал направлению "сначала снижается радиус"). Радиус — надежный фильтр уверенности в реальном времени. Используйте его именно в этом качестве, а не как систему раннего предупреждения об устаревании модели.
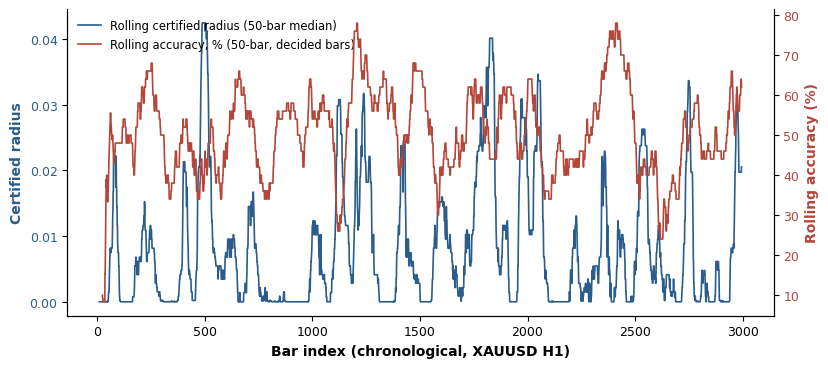
Рис. 5. Фактические результаты теста на дрейф на XAUUSD H1 (2 996 баров): сопоставление скользящего сертифицированного радиуса со скользящей долей правильных прогнозов на барах с выданным прогнозом. Эти два ряда изменяются в некоторой степени независимо друг от друга. На этом участке устойчивой связи с опережением или запаздыванием не обнаружено.
Прежде чем выбирать значение N для реальной торговли, измерьте фактические затраты времени на сертификацию одного бара, вызвав GetMicrosecondCount() до и после вызова Certify(). Для использованной здесь легковесной MLP при N=100 время выполнения с большим запасом укладывалось в допустимое время обработки тика при тестировании как на H1, так и на M15, однако это зависит от архитектуры, поэтому для существенно отличающейся модели стоит повторить измерение.
Заключение
Оценка softmax показывает, какое решение приняла модель. Сертифицированный радиус показывает, насколько это решение устойчиво к шуму в поступающем потоке котировок. Это отдельный вопрос, не равнозначный ни правильности решения, ни прибыльности торговли на его основе. Именно в этом различии скрываются неустойчивые прогнозы, незаметные до тех пор, пока их не начнут выявлять с помощью таких методов, как рандомизированное сглаживание. Реализовать метод непосредственно на MQL5 оказалось несложно: в стандартной библиотеке уже есть две статистические функции, на которых он основан, — MathQuantileBeta() и MathQuantileNormal(). Итоги тестирования в статье таковы: повышение доли правильных прогнозов модуля сертификации на барах с выданным прогнозом действительно зафиксировано измерениями, но на единственном протестированном трендовом участке оно не обеспечило преимущества по накопленному финансовому результату перед более простым сигналом без фильтрации. Устойчивость, правильность и прибыльность — три разные характеристики, и подтверждение одной не подтверждает остальные.
Естественный следующий шаг — получить более точную границу для многоклассового случая вместо использованного здесь бинарного упрощения либо расширить модель шума, перейдя от изотропного гауссовского шума к модели, лучше отражающей фактические характеристики шума каждого признака для данного торгового инструмента. Шум спреда и шум объема ведут себя по-разному, и распределение для сглаживания с диагональной ковариационной матрицей отразило бы это точнее, чем одно скалярное значение σ.
| Файл | Тип | Описание |
|---|---|---|
| CertDefines.mqh | Include | Константы контракта признаков и параметры сертификации по умолчанию. |
| FeatureEngine.mqh | Include | Формирует вектор признаков фиксированной размерности 10 на каждом закрытом баре. |
| RobustnessCertifier.mqh | Include | Рандомизированное сглаживание, граница Клоппера — Пирсона, расчет сертифицированного радиуса. |
| CertifiedONNXRadius_EA.mq5 | Советник | Логика торговли в реальном времени: сертифицирует прогноз на каждом баре, фильтрует торговые действия и определяет объем позиции в зависимости от радиуса. |
| CertRadiusMonitor.mq5 | Индикатор | Отображает сертифицированный радиус и скользящий базовый уровень в отдельном окне графика. |
| RawONNXSignal_EA.mq5 | Советник | Базовый вариант без фильтрации: один проход инференса без добавления шума на каждом баре, фиксированный объем в лотах, без сертификации. Приводится исключительно для сравнения. |
| ExportTrainingData.mq5 | Скрипт | Экспортирует исторические бары, значения индикаторов и метки, рассчитанные по доходности за последующий период, в CSV-файл для обучения модели. |
| DriftTestLogger.mq5 | Скрипт | Офлайн-диагностика: сертифицирует прогнозы на исторических барах и сравнивает их с фактическими результатами. Сформировал данные для рис. 5. |
| EquityCompareBacktest.mq5 | Скрипт | Моделирует по барам кривые средств для стратегий с фильтрацией сигналов и без неё на реальных исторических данных, без использования будущих данных. Сформировал данные для рис. 4. |
| train_export_model.py | Скрипт на Python | Обучает базовый классификатор, экспортирует модель в формат ONNX и выполняет обязательную проверку согласованности контракта признаков. |
| analyze_drift_test.py | Скрипт на Python | Считывает выходные данные DriftTestLogger и с помощью взаимной корреляции проверяет наличие связи с опережением или запаздыванием между радиусом и долей правильных прогнозов. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/23967
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


