

Тики из MetaTrader 5 без копирования (Часть 1): Мост к разделяемой памяти на основе интерфейса Arrow C Data Interface
 13
 1

Введение
Если вы когда-нибудь пытались передавать данные тиков из MetaTrader 5 в полноценный аналитический стек на Python в реальном времени, то уже знаете: самое неприятное здесь — не торговая логика, а организация обмена данными. Вы пишете модуль экспорта в CSV, открываете сокет или прибегаете к самодельному решению на основе разделяемой памяти, а затем тратите остаток дня на написание парсера на стороне Python, который преобразует сырые байты обратно в данные, пригодные для pandas. Каждый из этих подходов заставляет платить «налог на преобразование» за каждый тик: сериализация при отправке, десериализация при получении, а где-то между ними — создание отдельного объекта Python для каждого поля каждого тика.
В этой серии из двух частей мы полностью устраняем этот «налог» с помощью интерфейса Arrow C Data Interface — того самого механизма обмена без копирования, который позволяет DuckDB, Polars и pandas передавать данные друг другу без копирования единого байта. MetaTrader 5 записывает тики непосредственно в блок разделяемой памяти, используя колоночную организацию памяти Arrow; Python воссоздаёт настоящие C-структуры ArrowArray/ArrowSchema, указывающие прямо на эту память, и передаёт их в pyarrow, который создаёт RecordBatch без какого-либо цикла разбора данных. В части 1 — этой статье — мы реализуем сторону MetaTrader 5: колоночную организацию памяти, механизм, позволяющий публиковать пакеты без блокировок, советник для потоковой передачи тиков в реальном времени и диагностический скрипт, который подтверждает корректность работы стороны MetaTrader 5 независимо от Python, ещё до его подключения. В части 2 рассматриваются читатель на Python и тест производительности, который проверяет утверждение об обмене без копирования на конкретных числовых результатах.
Место этой статьи среди других статей серии о мостах. Это четвёртая статья серии о передаче данных и межпроцессном взаимодействии (IPC), и она не является лишь косметической переработкой предыдущих. Мост на основе Rust cdylib передаёт данные через границу вызова функции. Мост на основе разделяемой памяти Windows передаёт плоские структуры с построчной организацией данных, которые Python приходится распаковывать поле за полем с помощью struct.unpack. Мост gRPC/Protobuf сериализует сообщения и передаёт их через сетевой сокет. Только в этой статье данные организованы в колоночном формате, описанном схемой данных, который библиотека на следующем этапе обработки может импортировать напрямую — без десериализации и без создания объектов Python для каждого тика. Если ваша цель — передача сигналов по отдельным тикам с низкой задержкой, мост на основе разделяемой памяти по-прежнему остаётся подходящим инструментом. Если ваша цель — передать пакет тиков в pandas, Polars или конвейер обработки признаков с максимально возможной скоростью, вам нужен именно этот вариант, а тест производительности из части 2 покажет в цифрах, насколько он быстрее.
Наша реализация будет состоять из трёх файлов. ArrowBufferWriter.mqh вручную формирует физическую структуру данных Arrow (в MetaTrader 5 нет встроенной библиотеки Arrow, а правила этой серии запрещают внешние зависимости, поэтому мы не используем стороннюю библиотеку) и публикует пакеты в области с двойной буферизацией, используя seqlock для работы без блокировок. ArrowTickStreamer.mq5 использует этот компонент для сбора тиков в реальном времени и выполняет сброс накопленных данных при достижении заданного размера пакета или истечении тайм-аута. ArrowBridgeSelfTest.mq5 дополняет оба компонента и специально предназначен для раздельного выявления ошибок на стороне MetaTrader 5 и Python еще до начала их совместного тестирования.
Содержание
- Почему бы просто не сериализовать?
- Физическая организация данных Arrow в памяти
- Трехсторонний контракт схемы данных
- Двойная буферизация и счетчик поколений seqlock
- Внутри файла ArrowBufferWriter.mqh
- Советник: ArrowTickStreamer.mq5
- Диагностический скрипт: ArrowBridgeSelfTest.mq5
- Проверка работы на стороне MetaTrader 5
- Граничные случаи и подводные камни
- Заключение и дальнейшие шаги
Почему бы просто не сериализовать?
Все рассмотренные до сих пор в этой серии мосты межпроцессного взаимодействия (IPC) передавали данные между процессами, используя согласованный формат передачи данных и преобразуя данные в этот формат и обратно. Именно на этом этапе преобразования и сосредоточены затраты. Возьмем, к примеру, ранее описанный мост на основе разделяемой памяти: MetaTrader 5 упаковывает тик в структуру C фиксированного размера, записывает байты этой структуры в файл, отображенный в память, а Python считывает эти байты с помощью struct.unpack — по одному вызову функции на каждое поле каждого тика. Для одного тика эти затраты незаметны. Для пакета из 4 096 тиков с шестью полями в каждом это уже более 24 000 отдельных вызовов распаковки, каждый из которых создает объект Python типа int или float и добавляет его в растущий список — еще до того, как к обработке подключается pandas.
Arrow обходит эту проблему, описывая расположение данных в памяти, а не их байтовое представление в формате передачи данных. Массив Arrow — это всего лишь битовая карта валидности, непрерывный буфер значений и небольшая структура схемы данных, указывающая: «этот буфер содержит N значений int64» или «N значений float64». Если потребитель уже умеет читать данные с такой физической организацией — а pyarrow поддерживает это изначально, — разбирать больше нечего. Вы не преобразуете формат передачи данных в формат представления в памяти: формат передачи данных и есть формат представления в памяти. Интерфейс Arrow C Data Interface формализует это в виде небольшого стабильного ABI: двух структур языка C — ArrowSchema и ArrowArray, поля которых представляют собой просто указатели на память, где фактически находятся данные.
Сквозная архитектура: импорт из MetaTrader 5 в Python без копирования
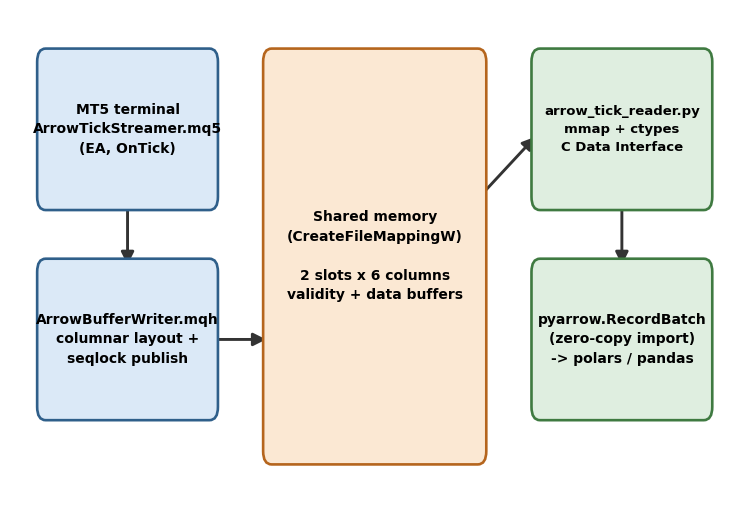
Рис. 1. Сквозной путь данных, охватывающий обе части серии: советник объединяет тики в пакеты и публикует каждый пакет с помощью RtlMoveMemory; на стороне Python (часть 2) перемещается только указатель, но никогда не сами данные тиков.
На практике это означает, что выражение «без копирования» здесь — не маркетинговый ход, а буквальное описание того, что происходит на стороне читателя. В части 2 приведены результаты тестирования, подтверждающие это реальными цифрами, а не просто словами. В этой статье реализуются все этапы вплоть до размещения в разделяемой памяти корректного, поддающегося проверке пакета тиков, готового к чтению.
Физическая организация данных Arrow в памяти
Спецификация Arrow для массива примитивного типа (именно такой нужен нам для столбцов int64 и float64 — без строк и вложенных типов) намеренно проста. Каждый массив описывается ровно двумя буферами:
Буфер 0 — битовая карта валидности. На каждый элемент отводится один бит, по 8 бит в байте; установленный бит i означает, что элемент i не равен null. Если все элементы валидны (как в нашем случае: тик либо существует, либо не записывается), спецификация допускает null_count = 0 и указатель на битовую карту валидности, равный NULL, что позволяет потребителю полностью пропустить проверку этой карты.
Буфер 1 — буфер данных. Плоский непрерывный массив значений фиксированного размера — по 8 байт на элемент как в столбцах int64, так и в столбцах float64, без промежутков между значениями.
Оба буфера дополняются выравнивающими байтами до ближайшей 64-байтовой границы. Это не косметическая деталь: такое выравнивание позволяет потребителям, использующим SIMD, работать с буфером, а процессору — загружать строки кэша без потерь производительности из-за невыровненного доступа. Наша функция расчета размещения данных в памяти в точности соблюдает это правило добавления выравнивающих байтов:
//+------------------------------------------------------------------+
//| Align64                                                          |
//| Rounds a byte count up to the next 64-byte boundary,             |
//| per the Arrow buffer alignment spec.                             |
//+------------------------------------------------------------------+
int Align64(const int nbytes) const
  {
   return((int)(((nbytes + ARROW_ALIGN - 1) / ARROW_ALIGN) * ARROW_ALIGN));
  }
Запись тика в нашей схеме данных содержит шесть столбцов: time_msc (int64), bid, ask, last, volume_real (все четыре — float64) и flags (int64, содержащий битовую маску флагов тика MetaTrader 5). Каждый элемент столбца занимает 8 байт, что делает расчеты размещения данных единообразными: одна формула подходит и для int64, и для float64, поскольку в обоих случаях мы просто перемещаем 8-байтовые слова. Каждый слот в разделяемой памяти содержит фиксированный заголовок размером 64 байта (счетчик поколений, порядковый номер пакета, число тиков, число столбцов, метку времени записи и вместимость слота), за которым следуют шесть блоков столбцов; в каждом блоке буфер битовой карты валидности и буфер данных расположены непосредственно друг за другом.
Колоночная организация памяти Arrow в слоте с шестью столбцами тиков
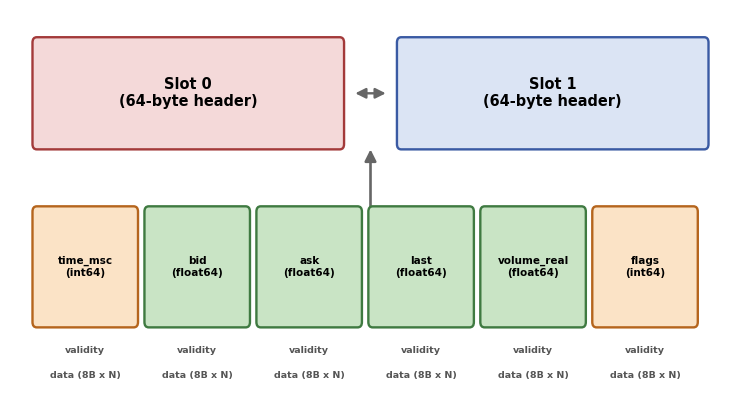
Рис. 2. Физическая организация одного слота: заголовок размером 64 байта, за которым следуют шесть блоков столбцов, выровненных по границе 64 байт; каждый блок содержит битовую карту валидности и непрерывный буфер данных.
Здесь стоит явно отметить одно намеренное упрощение, а не прятать его в коде: поскольку каждый записываемый тик по построению не содержит null-значений, битовая карта валидности всегда целиком заполнена единицами. ArrowBufferWriter.mqh по-прежнему исправно записывает эту карту, чтобы формат передачи данных не пришлось менять, если в будущей версии потребуется представлять пропуски, однако модуль импорта на Python из части 2 использует упрощение, явно разрешенное спецификацией Arrow: передает null_count = 0 и указатель на битовую карту валидности, равный NULL, полностью пропуская эту карту при импорте.
Трехсторонний контракт схемы данных
В каждой статье этой серии, посвященной машинному обучению, реализация проверяет согласованность константы времени компиляции, фактического числа буферов и размерности, объявленной в манифесте, и отказывается работать при их несоответствии. В этой статье такой контракт относится к схеме данных, а не к ONNX, но принцип остается тем же:
//+------------------------------------------------------------------+
//| Arrow schema contract - column count, names, and format codes    |
//+------------------------------------------------------------------+
// Three-way contract anchor: this constant, the number of columns
// actually written by CArrowTickBridge::WriteBatch(), and the
// column_count field decoded on the Python side must all agree.
// A mismatch is treated as fatal at OnInit() and the EA refuses to run.
#define ARROW_TICK_COLUMNS   6
Функция ContractOk() проверяет это при создании объекта, еще до первого вызова WinAPI:
//+------------------------------------------------------------------+
//| ContractOk                                                       |
//| Validates the compile-time / runtime schema contract             |
//| before touching WinAPI at all.                                   |
//+------------------------------------------------------------------+
bool ContractOk(string &reason)
  {
   if(ArraySize(ArrowColumnNames)!=ARROW_TICK_COLUMNS ||
      ArraySize(ArrowColumnFormats)!=ARROW_TICK_COLUMNS ||
      ArraySize(ArrowColumnIsInt64)!=ARROW_TICK_COLUMNS)
     {
      reason=StringFormat("Column metadata length mismatch vs ARROW_TICK_COLUMNS=%d",ARROW_TICK_COLUMNS);
      return(false);
     }
   return(true);
  }
Функция OnInit() в советнике вызывает эту проверку еще до обращения к CreateFileMappingW и при ее неудаче возвращает INIT_PARAMETERS_INCORRECT: ошибка явно обнаруживается при запуске, а не приводит через полгода к незаметному неверному чтению столбца из-за того, что кто-то добавил поле в ArrowColumnNames, не обновив число столбцов. Читатель на Python из части 2 перед импортом каких-либо данных сравнивает column_count в декодированном заголовке с той же константой, обеспечивая проверку на обоих концах канала обмена.
Двойная буферизация и счетчик поколений seqlock
Для разделяемой памяти, к которой обращаются два независимых процесса, нужен механизм обеспечения согласованности, но полноценный мьютекс ядра избыточен для горячего пути выполнения, задействованного на каждом тике. Мы используем тот же механизм, что и ядро Linux, например, в подсистеме учета времени: seqlock. В заголовке каждого слота находится счетчик поколений. Нечетное значение означает: «Писатель прямо сейчас публикует данные в этом слоте, данные несогласованны». Четное значение означает: «Этот слот находится в стабильном состоянии, его можно безопасно читать».
Запись одного пакета выполняется в три этапа: сначала счетчик увеличивается до нечетного значения и записывается заголовок (это установка флага «опасности»), затем записываются все шесть буферов столбцов, после чего счетчик увеличивается до следующего четного значения и заголовок записывается повторно (это момент, когда пакет публикуется — только теперь пакет становится видимым читателю). Читатель выполняет обратную последовательность: считывает значение счетчика поколений и, если оно нечетное, откладывает чтение и повторяет попытку; если четное — считывает поля заголовка, затем повторно считывает значение счетчика и убеждается, что за это время оно не изменилось. Если значение изменилось, значит, во время чтения началась запись и читатель повторяет попытку. В части 2 реализуется сторона читателя на Python; в этой статье полностью реализуется и демонстрируется сторона писателя, поскольку именно она определяет корректность работы.
// 3) flip generation to even (stable) - this is the publish point.
//    Only now does the batch become visible/consistent to readers.
hdr.generation=writeGen+1;         // even -> stable
ArrayInitialize(hb,0);
PackHeader(hb,0,hdr);
RtlMoveMemory(m_pBase+offset,hb,ARROW_HEADER_SIZE);
Поскольку мы используем двойную буферизацию — два слота, причем писатель всегда выбирает не тот слот, в котором он только что опубликовал пакет, — медленный читатель никогда не блокирует писателя, а писателю никогда не приходится ждать завершения чтения. У писателя всегда есть свободный слот для записи; у читателя всегда есть стабильный слот для чтения, если он выбирает слот с большим значением batch_seq.
Временная диаграмма счетчика поколений seqlock для писателя и читателя
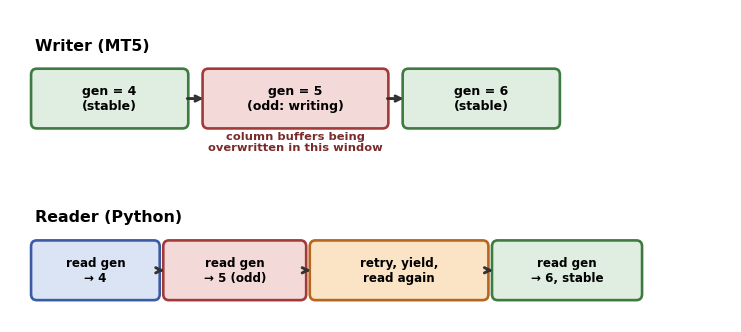
Рис. 3. Интервал, в течение которого писатель удерживает счетчик поколений нечетным, — единственный период, которого читатель должен избегать; повторная попытка занимает несколько микросекунд, но никогда не требует блокировки.
На стороне Python (часть 2) это реализовано небольшим циклом с ограниченным числом повторных попыток. Лимит задан с большим запасом: при типичных размерах пакетов цикл, в котором пакет публикуется и переключается слот, занимает значительно меньше миллисекунды, так что при обычной нагрузке читателю должно крайне не повезти, чтобы исчерпать все попытки.
Внутри файла ArrowBufferWriter.mqh
Что он реализует. Один класс CArrowTickBridge, который управляет отображением разделяемой памяти WinAPI и умеет размещать в нем пакеты тиков в формате Arrow. Он ничего не знает о потоке тиков, торговых инструментах или таймерах MetaTrader 5 — он лишь умеет на основе массива MqlTick[] и заданной вместимости формировать байты и размещать их по нужным смещениям.
Как это работает. Для каждого экземпляра предусмотрены три этапа: Init() вычисляет все константы организации памяти на основе одной заданной вместимости и открывает отображение; WriteBatch() размещает один пакет тиков в слоте, который в данный момент не является «опубликованным», используя трехэтапную последовательность seqlock; Deinit() корректно освобождает дескрипторы WinAPI при завершении работы советника.
Почему именно такой подход. Всё построено на штатном механизме импорта функций kernel32.dll в MetaTrader 5 и обычных структурах — без ALGLIB и внешних DLL, как и предусмотрено правилами серии. Каждое смещение зависит только от вместимости, поэтому сериализовать указатели в разделяемую память не требуется (в разделе 11 объясняется, почему именно такое упрощение таит в себе ловушку).
Сам заголовок представляет собой структуру фиксированного размера с явной упаковкой, поэтому расположение его байтов в памяти полностью предсказуемо с обеих сторон моста:
//+------------------------------------------------------------------+
//| Fixed 64-byte slot header. Field order and sizes are frozen -    |
//| the Python reader decodes this with a matching struct.Struct     |
//| format string, so do not reorder fields without updating both    |
//| sides.                                                           |
//+------------------------------------------------------------------+
#pragma pack(push,1)
struct ArrowSlotHeader
  {
   long           generation;            // 8  odd = write in progress, even = stable
   long           batch_seq;             // 8  monotonically increasing batch id
   int            tick_count;            // 4  ticks actually populated this batch
   int            column_count;          // 4  must equal ARROW_TICK_COLUMNS
   long           write_timestamp_msc;   // 8  EA-side wall clock at publish time
   int            capacity;              // 4  max ticks this slot can hold
   int            reserved0;             // 4
   uchar          reserved1[24];         // 24 padding out to 64 bytes total
  };
#pragma pack(pop)
Два небольших закрытых вспомогательных метода преобразуют индекс слота в байтовое смещение, а структуру — в последовательность байтов по этому смещению; все остальные методы класса используют эти два метода вместо того, чтобы каждый раз вычислять смещения самостоятельно:
//+------------------------------------------------------------------+
//| SlotOffset                                                       |
//| Converts a slot index (0 or 1) into its byte offset              |
//| from the start of the mapping.                                   |
//+------------------------------------------------------------------+
long SlotOffset(const int slotIndex) const
  {
   return((long)slotIndex * (long)m_slotSize);
  }

//+------------------------------------------------------------------+
//| PackHeader                                                       |
//| Serializes a full ArrowSlotHeader struct into a byte             |
//| buffer at a given offset.                                        |
//+------------------------------------------------------------------+
void PackHeader(uchar &buf[],const int offset,const ArrowSlotHeader &hdr)
  {
   uchar tmp[];
   StructToCharArray(hdr,tmp);
   ArrayCopy(buf,tmp,offset,0,ArraySize(tmp));
  }
Размер каждого поля и порядок полей в ArrowSlotHeader намеренно зафиксированы: на стороне Python в части 2 те же 64 байта декодируются с помощью соответствующей структуры ctypes.LittleEndianStructure, и определения этих двух структур никогда не должны расходиться. Init() вычисляет на основе одной заданной вместимости все остальные константы организации памяти, необходимые классу, используя ту же вспомогательную функцию Align64(), что и в разделе 4:
//+------------------------------------------------------------------+
//| Init                                                             |
//| Computes every layout constant from a requested capacity         |
//| and opens the shared memory mapping.                             |
//+------------------------------------------------------------------+
bool Init(const string mappingName,const int capacityTicks)
  {
   ...
   m_capacity        = capacityTicks;
   m_validityBytes   = Align64((m_capacity+7)/8);
   m_dataBytes       = Align64(m_capacity*ARROW_ELEM_SIZE);
   m_columnBlockBytes= m_validityBytes+m_dataBytes;
   m_slotSize        = ARROW_HEADER_SIZE + ARROW_TICK_COLUMNS*m_columnBlockBytes;
   m_totalSize       = (ulong)m_slotSize*2;

   m_hMapping=CreateFileMappingW(INVALID_HANDLE_VALUE_L,0,PAGE_READWRITE,
                                  (uint)(m_totalSize>>32),(uint)(m_totalSize & 0xFFFFFFFF),
                                  mappingName);
   ...
  }
Поскольку в MetaTrader 5 отсутствует примитив, позволяющий «записать это значение типа double по данному байтовому смещению в неуправляемой памяти», мы сначала формируем каждый столбец в виде локального массива uchar, используя встроенную функцию MQL5 StructToCharArray() для сериализации каждого скалярного значения, а затем переносим весь блок столбца одним вызовом RtlMoveMemory:
//+------------------------------------------------------------------+
//| PackValue                                                        |
//| Serializes one scalar (int64 or double) into a byte              |
//| buffer at a given offset, for values whose type is               |
//| known only at the call site.                                     |
//+------------------------------------------------------------------+
template<typename T>
void PackValue(uchar &buf[],const int offset,T value)
  {
   uchar tmp[];
   StructToCharArray(value,tmp);
   ArrayCopy(buf,tmp,offset,0,ArraySize(tmp));
  }
Набор используемых функций WinAPI намеренно минимален — ровно настолько, чтобы создать именованное отображение, обеспечиваемое файлом подкачки, и получить указатель непосредственно на его память:
//+------------------------------------------------------------------+
//| WinAPI imports - memory-mapped file plumbing.                    |
//+------------------------------------------------------------------+
#import "kernel32.dll"
long   CreateFileMappingW(long hFile,long lpAttr,uint flProtect,uint dwMaxSizeHigh,uint dwMaxSizeLow,string lpName);
long   MapViewOfFile(long hFileMappingObject,uint dwDesiredAccess,uint dwFileOffsetHigh,uint dwFileOffsetLow,ulong dwNumberOfBytesToMap);
void   RtlMoveMemory(long Destination,uchar &Source[],ulong Length);
#import
Обратите внимание на то, чего намеренно нет: в разделяемую память никогда не записываются указатели. Указатель, полученный в адресном пространстве писателя, не имеет смысла в адресном пространстве читателя: функция MapViewOfFile не гарантирует, что в обоих процессах отображение будет иметь один и тот же базовый адрес. Вместо этого каждое смещение в этой структуре вычисляется чистой функцией только от вместимости (с использованием Align64, размера заголовка и числа столбцов), поэтому код на Python из части 2 независимо вычисляет те же смещения, а затем прибавляет к ним базовый адрес собственного отображения. Именно этот прием обеспечивает переносимость структуры между процессами без сериализации указателей: согласовывается только организация памяти, но не конкретный адрес в ней.
Сама запись по столбцам внутри WriteBatch() начинается с выбора слота для записи — это конкретная строка кода, реализующая правило из раздела 6: «всегда выбирать слот, в который только что не публиковали пакет». Затем для каждого записываемого тика устанавливается бит валидности, а каждое значение упаковывается в отведенную ему 8-байтовую ячейку буфера данных:
int n = (count>m_capacity) ? m_capacity : count;
int targetSlot = 1-m_activeSlot;   // write into the slot NOT currently being read
long offset = SlotOffset(targetSlot);
То, какое поле MqlTick заполняет каждый из шести столбцов, определяется простым оператором switch по индексу столбца. Это единственное место в файле, где абстрактные «шесть столбцов» из раздела 4 обретают конкретные имена полей:
long   lv=0;
double dv=0.0;
switch(c)
  {
   case 0: lv=ticks[i].time_msc;    break;
   case 1: dv=ticks[i].bid;          break;
   case 2: dv=ticks[i].ask;          break;
   case 3: dv=ticks[i].last;         break;
   case 4: dv=ticks[i].volume_real; break;
   case 5: lv=(long)ticks[i].flags; break;
  }
// validity bitmap: all ticks are valid, so every bit is 1
// across the first ceil(n/8) bytes.
for(int i=0; i<n; i++)
  {
   int byteIdx=i/8, bitIdx=i%8;
   colBuf[byteIdx] = (uchar)(colBuf[byteIdx] | (1<<bitIdx));
  }

int dataOff = m_validityBytes;
for(int i=0; i<n; i++)
  {
   if(ArrowColumnIsInt64[c]==1)
      PackValue(colBuf,dataOff+i*ARROW_ELEM_SIZE,lv);
   else
      PackValue(colBuf,dataOff+i*ARROW_ELEM_SIZE,dv);
  }

RtlMoveMemory(m_pBase+offset+colBase,colBuf,m_columnBlockBytes);
Этот цикл выполняется один раз для каждого столбца в пакете, а не с отдельным вызовом WinAPI для каждого тика. Все затраты на то, чтобы публиковать пакеты, сводятся к шести вызовам RtlMoveMemory на пакет (по одному на столбец, плюс еще два для перевода заголовка в состояние «идет запись» и в стабильное состояние), независимо от того, содержит пакет 64 тика или 4 096. Именно начальная установка флага «опасности» в заголовке — до любых изменений данных столбцов — обеспечивает работу seqlock из раздела 6:
// 1) mark slot as "being written" immediately so a reader that is
//    mid-poll on this slot backs off.
ArrowSlotHeader hdr;
ZeroMemory(hdr);
hdr.generation=writeGen;              // odd -> write in progress
hdr.batch_seq=m_batchSeq;
hdr.tick_count=n;
hdr.column_count=ARROW_TICK_COLUMNS;
hdr.write_timestamp_msc=(long)GetTickCount64();
hdr.capacity=m_capacity;

uchar hb[];
ArrayResize(hb,ARROW_HEADER_SIZE);
PackHeader(hb,0,hdr);
RtlMoveMemory(m_pBase+offset,hb,ARROW_HEADER_SIZE);
Только после записи нечетного значения счетчика поколений выполняется описанный выше цикл по столбцам, а затем пакет публикуется с четным значением счетчика, как показано в разделе 6. Deinit() — последний существенный метод класса: он удаляет представление из адресного пространства процесса и закрывает дескриптор отображения. Метод вызывается из OnDeinit() советника, чтобы при завершении его работы счетчик ссылок на отображение на уровне ОС корректно уменьшался, а ссылка не сохранялась до завершения процесса терминала. (Остальные элементы открытого интерфейса класса: конструктор просто инициализирует поля нулями, деструктор для подстраховки вызывает Deinit(), а SlotSize()/Capacity()/BatchSeq() — однострочные методы доступа, используемые диагностическим скриптом из раздела 9. Они не меняют поведение, поэтому здесь опущены ради экономии места.)
//+------------------------------------------------------------------+
//| Deinit                                                           |
//| Releases the mapped view and the mapping handle.                 |
//| Safe to call more than once.                                     |
//+------------------------------------------------------------------+
void Deinit(void)
  {
   if(m_pBase!=0)   { UnmapViewOfFile(m_pBase); m_pBase=0; }
   if(m_hMapping!=0){ CloseHandle(m_hMapping);  m_hMapping=0; }
  }
Советник: ArrowTickStreamer.mq5
Что он реализует. Небольшой советник, работающий поверх CArrowTickBridge: он не содержит логики организации данных Arrow, а лишь определяет, когда вызывать WriteBatch().
Как это работает. OnTick() добавляет каждый входящий тик в небольшой массив в оперативной памяти; при достижении заданного размера (InpBatchSize) или по срабатыванию миллисекундного таймера (InpFlushMs) вызывается FlushPending(), которая одним вызовом передает накопленные тики в мост.
Почему именно такой подход. Если публиковать пакет при каждом отдельном тике, это потребовало бы полного цикла записи и переключения состояния seqlock для каждого тика, сводя на нет смысл объединения тиков в пакеты для стороны Python. Предварительное накопление распределяет фиксированные затраты на то, чтобы публиковать пакеты, между множеством тиков; именно выигрыш от этого подхода измеряется в тесте производительности из части 2.
Первым делом OnInit() выполняет проверку контракта схемы данных из раздела 5 — еще до любых вызовов WinAPI. При неверном числе столбцов выполнение сразу прекращается с сообщением в журнале вместо незаметной некорректной записи в разделяемую память:
//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+
int OnInit()
  {
   string reason;
   CArrowTickBridge probe;
   if(!probe.ContractOk(reason))
     {
      PrintFormat("FATAL: Arrow schema contract mismatch - %s. Refusing to start.",reason);
      return(INIT_PARAMETERS_INCORRECT);
     }

   if(!g_bridge.Init(InpMappingName,InpBatchSize))
     {
      Print("FATAL: could not initialise ArrowTickBridge shared memory mapping.");
      return(INIT_FAILED);
     }
   ...
   EventSetMillisecondTimer(50);
   return(INIT_SUCCEEDED);
  }
Во время работы советник накапливает тики в небольшом буфере оперативной памяти и выполняет сброс накопленных данных в мост при заполнении буфера или по истечении тайм-аута, чтобы при низкой активности торгового инструмента данные не оставались неопубликованными по несколько минут:
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
   MqlTick t;
   if(!SymbolInfoTick(_Symbol,t))
      return;

   g_pending[g_pendingCount] = t;
   g_pendingCount++;

   if(g_pendingCount>=ArraySize(g_pending))
      FlushPending();
  }

//+------------------------------------------------------------------+
//| Timer - guarantees low-traffic symbols still flush promptly      |
//+------------------------------------------------------------------+
void OnTimer()
  {
   if(g_pendingCount>0 && (GetTickCount64()-g_lastFlushMs)>=(ulong)InpFlushMs)
      FlushPending();
  }
Входной параметр InpBatchSize определяет как вместимость слота разделяемой памяти, так и число тиков, накапливаемых до сброса накопленных данных. Для XAUUSD на M5 разумное значение по умолчанию — 256: во время новостей тики поступают всплесками, а в остальное время их поток умеренный. InpFlushMs (по умолчанию 250) служит страховкой: даже для торгового инструмента с редкими тиками Python ждет свежих данных не более четверти секунды. Оба параметра можно настраивать отдельно для каждого торгового инструмента без перекомпиляции. Здесь они задаются обычными входными параметрами советника, а не через манифест FILE_COMMON, поскольку, помимо уже рассмотренного в разделе 5 контракта схемы данных, нет параметров, которые нужно согласовывать между языками. Сам вызов, позволяющий публиковать пакет, занимает одну строку и окружен вспомогательным кодом учета, чтобы сбой записи не приводил к незаметной потере тиков:
//+------------------------------------------------------------------+
//| Publishes whatever ticks are currently buffered                  |
//+------------------------------------------------------------------+
void FlushPending()
  {
   if(g_pendingCount<=0)
      return;

   if(g_bridge.WriteBatch(g_pending,g_pendingCount))
     {
      g_totalTicksSent += g_pendingCount;
      g_totalBatches++;
     }
   else
      Print("WARNING: WriteBatch failed - shared memory mapping may have been closed.");

   g_pendingCount = 0;
   g_lastFlushMs  = GetTickCount64();
  }
При завершении работы OnDeinit() выполняет сброс накопленных данных, оставшихся в буфере, чтобы не потерять последние тики сеанса, а затем освобождает мост — именно этот вызов приводит к выполнению Deinit() из раздела 7:
//+------------------------------------------------------------------+
//| Expert deinitialization function                                 |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
   EventKillTimer();
   if(g_pendingCount>0)
      FlushPending();
   g_bridge.Deinit();
   PrintFormat("ArrowTickStreamer stopped. total_ticks=%I64d total_batches=%I64d",
               g_totalTicksSent,g_totalBatches);
  }
Диагностический скрипт: ArrowBridgeSelfTest.mq5
Что он реализует. Самостоятельный скрипт (не советник: он выполняется один раз и завершает работу), который тестирует CArrowTickBridge непосредственно на реальной истории тиков терминала, независимо от того, запущен ли вообще ArrowTickStreamer.mq5.
Как это работает. Он получает с помощью CopyTicks() фиксированный снимок тиков с доступом по индексу, обрабатывает его теми же вызовами ContractOk()/Init()/WriteBatch(), которые использует работающий советник, и выводит первую и последнюю записанные строки, чтобы их можно было визуально сравнить с выводом Python из части 2.
Почему именно такой подход. Поток тиков работающего советника непрерывно обновляется, поэтому постфактум трудно ответить на вопрос: «Пришел ли тик № 47 с правильным значением bid?» Зафиксированный снимок в сочетании с явными командами вывода превращает неопределенную задачу отладки в реальном времени в простое сопоставление значений и позволяет независимо проверить корректность описанной в этой статье части моста еще до подключения кода Python из части 2.
//+------------------------------------------------------------------+
//| Script program start function                                    |
//+------------------------------------------------------------------+
void OnStart()
  {
   string reason;
   CArrowTickBridge bridge;
   if(!bridge.ContractOk(reason))
     {
      PrintFormat("FAIL: contract check - %s",reason);
      return;
     }
   Print("PASS: schema contract (ARROW_TICK_COLUMNS matches metadata arrays)");

   if(!bridge.Init(InpMappingName,InpBatchSize))
     {
      Print("FAIL: could not create/map shared memory segment");
      return;
     }

   MqlTick history[];
   int copied = CopyTicks(_Symbol,history,COPY_TICKS_ALL,0,InpBatchSize);
   if(copied<=0)
     {
      Print("FAIL: CopyTicks returned no data - open a chart for this symbol first");
      bridge.Deinit();
      return;
     }

   if(!bridge.WriteBatch(history,copied))
     {
      Print("FAIL: WriteBatch rejected the batch");
      bridge.Deinit();
      return;
     }
   PrintFormat("PASS: wrote %d real ticks from CopyTicks() into shared memory, batch_seq=%I64d",
               copied,bridge.BatchSeq());

   PrintFormat("First tick: time_msc=%I64d bid=%.5f ask=%.5f",
               history[0].time_msc,history[0].bid,history[0].ask);
   PrintFormat("Last  tick: time_msc=%I64d bid=%.5f ask=%.5f",
               history[copied-1].time_msc,history[copied-1].bid,history[copied-1].ask);

   bridge.Deinit();
  }
Выведенные первую и последнюю строки следует сопоставить с тем, что выводит arrow_tick_reader.py из части 2 для того же отображения памяти: если значения bid/ask/time_msc совпадают с обеих сторон, это за одну сквозную проверку подтверждает корректность колоночной организации памяти, механизма публикации пакетов с использованием seqlock, и импорта на стороне Python, без необходимости отлаживать их по отдельности.
Проверка работы на стороне MetaTrader 5
Поскольку в этой части проекта нет торговой логики, «тестирование» здесь означает проверку корректности на уровне байтов, а не эффективности стратегии: кривую капитала здесь показать нельзя, а добавление ее лишь для заполнения места исказило бы суть статьи.
| Проверка | Метод |
|---|---|
| Корректность | ArrowBridgeSelfTest.mq5, раздел 9 — получает реальный пакет с помощью CopyTicks(), передает его в WriteBatch() и выводит значения первой и последней строк для сравнения с выводом Python из части 2 при использовании того же отображения памяти |
| Торговый инструмент / таймфрейм | XAUUSD/M5 (по умолчанию; сам мост не зависит от торгового инструмента) |
Для запуска откройте график XAUUSD, чтобы в терминале была доступна история последних тиков, затем запустите ArrowBridgeSelfTest.mq5 как скрипт — он выведет PASS/FAIL для проверки контракта, создания отображения памяти и самой записи, а затем значения первого и последнего записанных тиков. Часть 2 продолжает работу именно с этого места: данные считываются из отображения памяти с тем же именем и сравниваются с этими же выведенными значениями. Пропускная способность и полноценное сравнительное тестирование подхода без копирования и традиционного подхода на основе структур рассматриваются в части 2, когда для измерений будет доступна и сторона Python.
Граничные случаи и подводные камни
Сериализация указателей — это ловушка, а не способ упростить работу. Заманчиво записать значения указателей писателя как есть в заголовок в разделяемой памяти, чтобы читатель мог «просто их использовать». Не делайте этого — функция MapViewOfFile не гарантирует, что отображение будет доступно обоим процессам по одному и тому же виртуальному адресу. Вычисляйте каждое смещение только на основе вместимости, как это делается в этой статье, а каждый процесс пусть локально прибавляет к нему свой базовый адрес. В части 2 показано, как тот же принцип применяется на стороне читателя.
Вместимость — часть контракта, а не произвольный параметр. Все компоненты, использующие данное отображение, — советник, скрипт самотестирования и, в дальнейшем, читатель на Python из части 2 — должны быть инициализированы с одним и тем же значением вместимости. Несовпадение не приводит к аварийному завершению: все последующие обращения по смещениям незаметно дают неверные данные, поскольку байты по-прежнему находятся в памяти, но читаются не с тех позиций и неверно интерпретируются. Считайте вместимость фиксированной для каждого имени отображения, так же как фиксирована схема данных из шести столбцов.
Смена торгового инструмента или счёта во время сеанса. Имя отображения фиксируется в OnInit() (InpMappingName). При запуске нескольких советников на разных торговых инструментах каждому советнику требуется отдельное имя отображения: два советника, конкурирующие за запись в один и тот же именованный сегмент с разными схемами данных или значениями вместимости, будут незаметно повреждать слоты друг друга, поскольку ни один из них не знает о существовании другого.
Заключение и дальнейшие шаги
На этом этапе часть моста на стороне MetaTrader 5 завершена и может быть проверена независимо: контракт схемы данных, при нарушении которого возникает явная ошибка, а не скрытый сбой; колоночная организация памяти, не требующая этапа преобразования; seqlock, не позволяющий быстрому писателю и медленному читателю нарушать согласованность представлений данных друг у друга; и диагностический скрипт, подтверждающий работоспособность всего этого исключительно на основе истории тиков самого MetaTrader 5. Всё это можно проверить ещё до реализации части на Python — именно в этом и заключается смысл такого разделения проверки.
Продолжение — в части 2. Следующая статья продолжает ровно с того места, где заканчивается эта: в ней рассматриваются воссоздание настоящих структур C ArrowSchema/ArrowArray в Python с помощью ctypes, их импорт в pyarrow без копирования и готовый к запуску тест производительности, который измеряет выигрыш по сравнению с прежним способом чтения через struct.unpack — с конкретными числами, а не голословными утверждениями.
| Файл | Тип | Описание |
|---|---|---|
| ArrowBufferWriter.mqh | Подключаемый файл | Класс CArrowTickBridge — колоночная организация памяти Arrow, разделяемая память WinAPI, механизм, позволяющий публиковать пакеты с помощью seqlock |
| ArrowTickStreamer.mq5 | Советник | Собирает тики в реальном времени и выполняет сброс накопленных данных в мост пакетами при достижении заданного размера или по тайм-ауту |
| ArrowBridgeSelfTest.mq5 | Скрипт | Проверка корректности: записывает реальный пакет тиков, полученный через CopyTicks(), и выводит значения для сравнения с выводом Python из части 2 |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/24183
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


