

Машинное обучение онлайн для фильтрации торговых сигналов в MQL5 (Часть 1): Фильтр, обучающийся на результатах закрытых сделок
 14
 2

Содержание
- Введение
- Почему статические фильтры и статические модели машинного обучения неустойчивы
- Общая библиотека: логистическая регрессия с онлайн-обучением методом SGD
- Советник (EA): сигнал, фильтр и контур обратной связи
- Наблюдаем за обучением: индикатор вероятности
- Экспериментальная проверка: действительно ли модель отделяет прибыльные сделки от убыточных?
- Абляционный анализ признаков: почему именно эти шесть
- Калибровка вероятностей: насколько содержательна эта оценка вероятности?
- Статическая модель и модель с онлайн-обучением при смене режима: сравнение с двумя дополнительными базовыми моделями
- Расширение модели: постепенное уменьшение скорости обучения
- Чувствительность к гиперпараметрам
- Формирование меток и альтернативные варианты
- Проверка фильтра на выбранном вами торговом инструменте
- Практические замечания: использование в реальной торговле
- Граничные случаи и подводные камни
- Заключение
Введение
Возьмите простую стратегию на основе пересечения EMA(12) и EMA(26) и протестируйте ее на любой ликвидной валютной паре на годовом интервале: она улавливает настоящие тренды, но также постоянно выдает сигналы в боковике, поскольку учитывает лишь то, что два значения только что пересеклись, и ничего не знает об окружающей рыночной ситуации. Фильтры, настроенные вручную, — где порог ADX, где диапазон RSI — решают эту проблему лишь до тех пор, пока рыночные условия не изменятся по сравнению с тем историческим периодом, на котором их настраивали. В этом процессе ничто не обучалось: фиксированное правило лишь подгонялось под фиксированный набор данных.
Машинное обучение — очевидный следующий шаг, но в большинстве статей, где к нему обращаются, модель один раз проходит офлайн-обучение, затем ее веса фиксируют и экспортируют в советник (EA). Такой подход наследует ту же слепую зону: модель отражает лишь определенный момент, и нет гарантии, что усвоенная ею зависимость сохранится после изменения характера рынка, а механизма, позволяющего заметить, что она больше не действует, нет.
В этой статье мы создадим фильтр с таким недостающим механизмом: логистическую регрессию с онлайн-обучением, веса которой обновляются после каждой закрытой сделки, используя только встроенные массивы MQL5 и шаг SGD, реализованный в пяти строках кода. Никаких внешних скриптов для обучения, никакого экспорта в ONNX, никакого расписания переобучения, о котором нужно помнить.
Далее этот механизм проверяется в два этапа: сначала выясняется, обеспечивает ли правило обновления обучение вообще, затем — оправдывает ли непрерывное онлайн-обучение дополнительную сложность по сравнению с моделью с фиксированными весами; для каждого этапа приведен скрипт, который можно повторно запустить самостоятельно. В статье прослеживаются три отдельных утверждения, и их стоит разделить с самого начала. Алгоритмическое утверждение: обновление по методу SGD работает. Архитектурное утверждение: контур обратной связи практически реализуем и пригоден для сопровождения в MQL5. Торговое утверждение: этот подход позволяет найти на конкретном инструменте реальное торговое преимущество, сохраняющееся после учета издержек. В этой статье первые два утверждения подтверждаются результатами контролируемых экспериментов, а третье намеренно оставляется открытым.
Почему статические фильтры и статические модели машинного обучения ненадежны
И у настроенного вручную фильтра, и у модели с фиксированными весами отсутствует одно важное свойство: нет обратной связи от ответа на вопрос «сработала ли на самом деле одобренная мной сделка» к решению «стоит ли вновь одобрять подобные сделки». У порога, жестко заданного в коде, такой связи никогда не было. Модель, один раз прошедшая офлайн-обучение, технически могла бы иметь такую связь, но только если кто-то не забудет ее переобучить; на практике же большинство внедренных «фильтров машинного обучения» незаметно вновь превращаются в настроенные вручную фильтры, как только их обучающие данные устаревают.
Конкретный пример поможет сделать это менее абстрактным. Предположим, статическая модель усваивает, что на трендовом участке большое расстояние между ценой и медленной EMA, масштабированное по ATR, предсказывает прибыльные сделки: после сигналов пересечения EMA, возникающих, когда цена уже далеко отошла от медленной EMA, движение продолжается. Вес этого признака в модели становится положительным и остается таким навсегда. Когда для валютной пары наступает месяц боковика, тот же сигнал уже означает, что движение исчерпало себя, а фиксированный вес продолжает уверенно повышать оценку именно тех торговых ситуаций, которые теперь с большей вероятностью приведут к убыткам. У модели с онлайн-обучением при такой же смене режима ошибка прогноза растет, как только зависимость меняется на противоположную, а обновления по последующим сделкам снижают этот вес, затем делают его отрицательным — не мгновенно, но и не позволяя ему оставаться неверным бесконечно долго. Раздел 9 превращает это в настоящий эксперимент, а не просто в рассказ.
Общая библиотека: логистическая регрессия с онлайн-обучением методом SGD
Весь механизм реализован в одном файле — OnlineLogReg.mqh — и одном классе — COnlineLogReg. Советник (EA), индикатор и все тестовые скрипты используют один и тот же класс, поэтому вычисления модели в торговой логике и при визуализации всегда выполняются одинаково.
Логистическая регрессия обучается путем минимизации бинарной кросс-энтропийной функции потерь:
L(w,b) = -[ y·ln(p) + (1-y)·ln(1-p) ], where p = sigmoid(w·x + b)
Градиент этой функции по любому весу w_i сводится к произведению ошибки прогноза на соответствующее входное значение:
∂L/∂wi = (p - y)·xi
что в точности соответствует выражению error * x[i] ниже, со сменой знака для движения против градиента. Прямой проход:
//--- forward pass: probability that this feature vector wins
double            Predict(const double &x[])
  {
   double z = m_bias;
   for(int i = 0; i < m_n_features; i++)
      z += m_weights[i] * x[i];
   return(Sigmoid(z));
  }
и обновление — один шаг SGD на каждую закрытую сделку, с членом L2-регуляризации, который плавно возвращает веса к нулю, чтобы короткая серия сделок не привела к чрезмерному росту какого-либо веса по модулю:
//--- one online SGD step given the true label (1 = win, 0 = loss)
void              Update(const double &x[], int label)
  {
   double p     = Predict(x);
   double error = (double)label - p;

   for(int i = 0; i < m_n_features; i++)
    {
      double grad = error * x[i] - m_l2 * m_weights[i];
      m_weights[i] += m_lr * grad;
    }
   m_bias += m_lr * error;
   m_updates++;
  }
Методы SaveToFile()/LoadFromFile(), вызываемые из OnDeinit()/OnInit(), соответственно сохраняют вектор весов, смещение и гиперпараметры в CSV-файл в общей папке и загружают их из него, чтобы модель, действительно чему-то научившаяся на демо-счете, не сбрасывалась при каждом перезапуске.
Предусмотрено и необязательное расширение: метод SetLearningRateDecay(decay, floor) обеспечивает постепенное уменьшение скорости обучения η после каждого обновления до нижней границы floor, поэтому одна шумная сделка влияет на зрелую модель слабее, чем на этапе первой сделки. По умолчанию эта функция отключена; в разделе 10 описано, когда и как её включить.
Советник (EA): сигнал, фильтр и контур обратной связи
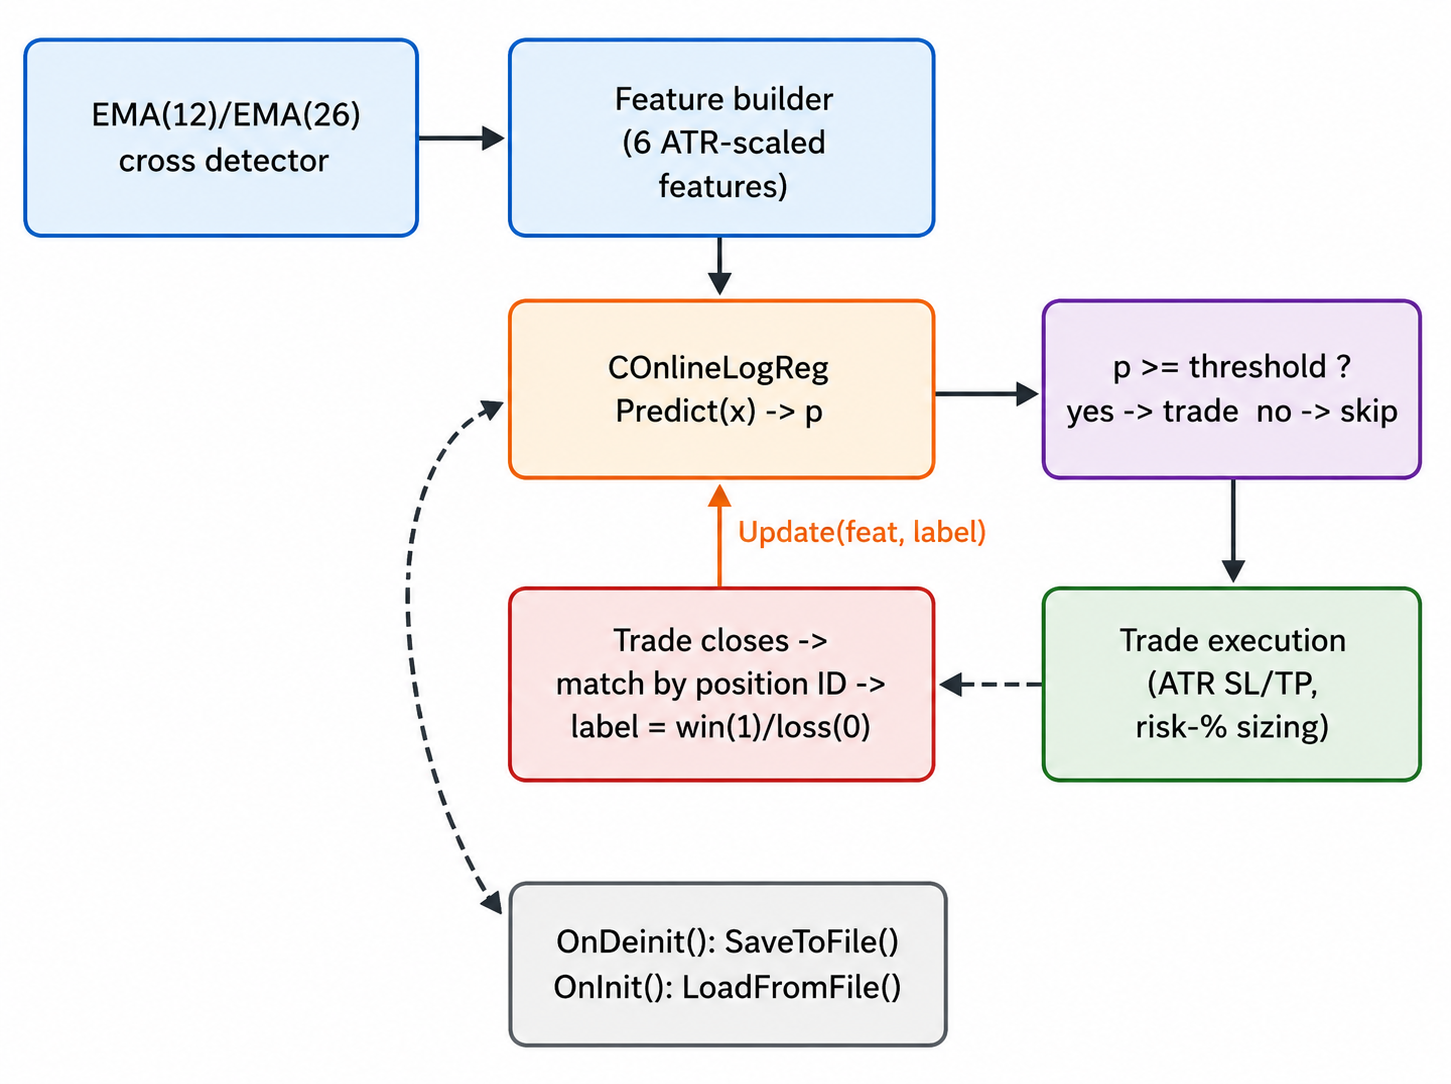
Рис. 1. Поток данных в советнике (EA): обнаружение сигнала, построение признаков, модель с онлайн-обучением, пороговый фильтр, исполнение сделки и передача метки результата закрытой сделки обратно в модель.
Базовый сигнал намеренно прост: пересечение EMA(12) и EMA(26), проверяемое один раз при появлении нового бара; вместо него подойдет любая уже используемая вами торговая стратегия с бинарным решением «открыл бы я здесь позицию или нет»:
int CheckCrossSignal()
  {
   double ema_f[2], ema_s[2];
   CopyBuffer(h_ema_fast, 0, 1, 2, ema_f);
   CopyBuffer(h_ema_slow, 0, 1, 2, ema_s);

   bool cross_up   = (ema_f[0] <= ema_s[0]) && (ema_f[1] > ema_s[1]);
   bool cross_down = (ema_f[0] >= ema_s[0]) && (ema_f[1] < ema_s[1]);

   if(cross_up)    return(1);
   if(cross_down) return(-1);
   return(0);
  }
По только что закрывшемуся бару формируются шесть признаков, причем масштабирование каждого задано явно:
x0 = RSI(14) / 100    x1 = (close - EMAslow) / ATRfast    x2 = ATRfast / ATRslow
x3 = (close - open) / (high - low)    x4 = (MACDmain - MACDsignal) / ATRfast    x5 = volume / SMA(volume, 20)
Каждое из этих преобразований нужно, чтобы перед градиентным обновлением привести шесть иначе несопоставимых величин к общему масштабу; без масштабирования будет доминировать признак с наибольшими по модулю значениями, независимо от его реальной информативности. Само построение признаков:
bool BuildFeatures(double &feat[])
  {
   double ema_f[1], ema_s[1], rsi_v[1], atr_f[1], atr_s[1],
         macd_main[1], macd_sig[1], vol_sma[1];

   if(CopyBuffer(h_ema_fast, 0, 1, 1, ema_f) <= 0) return(false);
   if(CopyBuffer(h_ema_slow, 0, 1, 1, ema_s) <= 0) return(false);
   if(CopyBuffer(h_rsi,      0, 1, 1, rsi_v) <= 0) return(false);
   if(CopyBuffer(h_atr_fast, 0, 1, 1, atr_f) <= 0) return(false);
   if(CopyBuffer(h_atr_slow, 0, 1, 1, atr_s) <= 0) return(false);
   if(CopyBuffer(h_macd, 0, 1, 1, macd_main) <= 0) return(false);
   if(CopyBuffer(h_macd, 1, 1, 1, macd_sig)  <= 0) return(false);
   if(CopyBuffer(h_vol_sma,  0, 1, 1, vol_sma) <= 0) return(false);

   double close1 = iClose(_Symbol, PERIOD_CURRENT, 1);
   double open1  = iOpen(_Symbol, PERIOD_CURRENT, 1);
   double high1  = iHigh(_Symbol, PERIOD_CURRENT, 1);
   double low1   = iLow(_Symbol, PERIOD_CURRENT, 1);
   long   vol1   = iVolume(_Symbol, PERIOD_CURRENT, 1);
   if(atr_f[0] <= 0.0 || atr_s[0] <= 0.0) return(false);

   ArrayResize(feat, N_FEATURES);
   feat[0] = rsi_v[0] / 100.0;
   feat[1] = (close1 - ema_s[0]) / atr_f[0];
   feat[2] = atr_f[0] / atr_s[0];
   double range = high1 - low1;
   feat[3] = (range > 0.0) ? (close1 - open1) / range : 0.0;
   feat[4] = (macd_main[0] - macd_sig[0]) / atr_f[0];
   feat[5] = (vol_sma[0] > 0.0) ? (double)vol1 / vol_sma[0] : 1.0;
   return(true);
  }
Все данные, считанные из буферов, и значения ATR проверяются перед использованием; при ошибке чтения функция просто пропускает сигнал, вместо того чтобы обучать модель на артефакте деления на ноль.
Это намеренно минимальный набор признаков — разумный стартовый комплект, а не результат систематической разработки. В нём нет членов взаимодействия, явно заданной асимметрии между длинными и короткими позициями и контекстных переменных, таких как торговая сессия или режим спреда. Расширить этот набор несложно при соблюдении описанных выше правил масштабирования, но здесь приоритет отдаётся простоте проверки, а не полноте. Те же соображения определяют выбор модели: логистическая регрессия линейна, требует мало вычислительных ресурсов и легко обновляется в процессе онлайн-обучения, но не является самым мощным из доступных классификаторов. Для этой задачи мы выбираем минимально достаточный, контролируемый адаптивный классификатор, а не «лучшую модель машинного обучения».
Вся работа фильтра сводится к одному сравнению:
double prob = model.Predict(feat);
if(prob < InpProbThreshold)
   return; // the filter vetoes this base signal
Замыкание контура обратной связи после открытия сделки — та часть работы, с которой авторам статей о статических моделях машинного обучения сталкиваться не приходится. Советник (EA) хранит небольшой массив примеров, ожидающих результата сделки; ключом служит DEAL_POSITION_ID, а не тикет сделки, чтобы частичные закрытия и изменения позиций при неттинге или хеджировании не нарушали сопоставление. Массив заполняется в момент отправки сделки:
PendingPush(pos_id, feat);
На каждом тике функция ProcessClosedTrades() находит все закрытые позиции, которым ещё не присвоена метка, рассчитывает прибыль с учётом свопа и комиссии и обновляет модель; при этом сделка, прибыльная по изменению цены, но убыточная после учёта издержек, должна использоваться для обучения с меткой убытка:
double profit = HistoryDealGetDouble(deal_ticket, DEAL_PROFIT)
               + HistoryDealGetDouble(deal_ticket, DEAL_SWAP)
               + HistoryDealGetDouble(deal_ticket, DEAL_COMMISSION);
int label = (profit > 0.0) ? 1 : 0;
model.Update(feat, label);
Объём позиции рассчитывается по фиксированной доле риска с учётом расстояния до стоп-лосса на основе ATR, округляется до установленного брокером шага лота и ограничивается минимальным и максимальным допустимым объёмом:
lots = R / ( (D / tick_size) · tick_value ), R = balance · (risk_percent / 100) Расстояния до стоп-лосса и тейк-профита задаются как кратные ATR (по умолчанию — 1.5 и 2.5), а не фиксированным числом пунктов, поэтому один и тот же советник корректно работает на инструментах с существенно различающейся стоимостью пункта, не предполагая неявно, что она везде одинакова.
Наблюдаем за обучением: индикатор вероятности
Индикатор OnlineML_ProbabilityView.mq5 позволяет просматривать без изменения те же веса, которые обучает советник: он загружает сохранённый советником CSV-файл, воссоздаёт экземпляр COnlineLogReg и в отдельном подокне строит график значений, возвращаемых Predict() для вектора признаков каждого исторического бара. Он никогда не вызывает метод Update() и не совершает сделок.
Здесь особенно важна одна оговорка об интерпретации. Поскольку индикатор восстанавливает веса, полученные при более позднем обучении, и применяет их к прошлым данным, он отображает ретроспективную вероятность, а не ту вероятность, которую советник фактически рассчитал и использовал для принятия решения на этом баре в реальном времени. На баре в середине графика линия индикатора может показывать уверенный прогноз, хотя к тому моменту модель ещё не успела обучиться настолько, чтобы такой прогноз был обоснован. Не следует воспринимать исторический график индикатора как отражение того, «что модель думала тогда». Связанная с этим оговорка о холодном старте подробнее рассматривается в разделе 15.
Экспериментальная проверка: действительно ли модель отделяет прибыльные сделки от убыточных?
Утверждение о том, что «модель обучается», должно сопровождаться конкретным числом. Контролируемая среда позволяет получить более достоверную численную оценку, чем график реального рынка, поскольку истинная связь между признаками реального рынка и исходами сделок нам неизвестна. OnlineML_SyntheticEvidence.mq5 генерирует векторы из шести признаков на основе известной линейной зависимости с намеренно добавленным шумом и по одному передает их новому экземпляру COnlineLogReg. Каждый пример оценивается в скользящем окне из 100 сделок до того, как модель будет обновлена по метке этой сделки, что обеспечивает корректную вневыборочную проверку:
double p_before = model.Predict(f); // scored before this trade's label is known
// ... record (p_before, y) into the rolling window ...
model.Update(f, y);
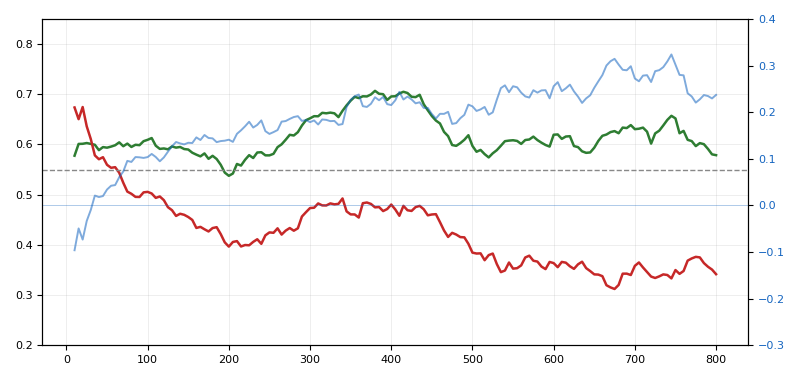
Рис. 2. Прогнозируемые моделью вероятности для прибыльных (зеленый) и убыточных (красный) сделок на протяжении 800 сделок; разделение показано по правой оси, пунктирная линия обозначает порог 0.55.
В таблице 1 приведены результаты одного прогона при η = 0.05:
| Сделки | среднее P | прибыльная сделка | среднее P | убыточная сделка | разделение | точность @ 0.55 |
|---|---|---|---|---|
| 10 | 0.578 | 0.674 | -0.096 | 0.833 |
| 25 | 0.603 | 0.636 | -0.033 | 0.700 |
| 50 | 0.594 | 0.560 | +0.034 | 0.719 |
| 100 | 0.609 | 0.506 | +0.104 | 0.754 |
| 200 | 0.538 | 0.397 | +0.141 | 0.600 |
| 400 | 0.696 | 0.480 | +0.215 | 0.734 |
| 800 | 0.579 | 0.342 | +0.237 | 0.730 |
Таблица 1. Динамика разделения в синтетическом эксперименте: генератор на основе линейной зависимости с шумом и шестью признаками, скользящее окно из 100 сделок, η = 0.05.
На 10-й сделке точность при пороге 0.55 составляет 0.833 — высокое значение именно в тот момент, когда разделение наиболее отрицательно, однако оно рассчитано всего по шести сделкам в окне и не свидетельствует о том, что фильтр уже работает; начиная с контрольной точки на 100-й сделке точность стабилизируется в диапазоне 0.70–0.75, который действительно подтверждается тенденцией в таблице 1.
Разделение изначально отрицательно (−0.096 на 10-й сделке), становится положительным между 25-й и 50-й сделками и достигает +0.237 к 800-й сделке; рост не строго монотонен, но именно тенденция по контрольным точкам служит свидетельством обучения. Иными словами, фильтр ненадежен примерно в течение первых 25–50 сделок, но после этого становится всё более полезным.
В таблице 1 представлены результаты для одного начального значения генератора случайных чисел, а один такой запуск — лишь частный случай, а не доказательство, поэтому OnlineML_SyntheticEvidence.mq5 теперь также проводит тот же эксперимент с 800 сделками для 200 независимых начальных значений генератора случайных чисел и выводит разброс результатов, а не только одно число:
| Метрика | Значение |
|---|---|
| Среднее разделение на 800-й сделке | +0.233 |
| Стандартное отклонение | 0.051 |
| 95%-й интервал (от 2.5-го до 97.5-го процентиля) | [+0.141; +0.334] |
| Начальные значения генератора случайных чисел с положительным разделением | 200 / 200 (100 %) |
Таблица 1b. Разделение на 800-й сделке для 200 независимых начальных значений генератора случайных чисел; генератор и гиперпараметры те же, что и в таблице 1.
Результаты в таблице 1 — не случайная удача: разделение +0.237 для одного начального значения генератора случайных чисел почти точно совпадает со средним +0.233 для 200 начальных значений, а интервал не пересекает ноль — во всех 200 прогонах итоговое разделение оказалось положительным.
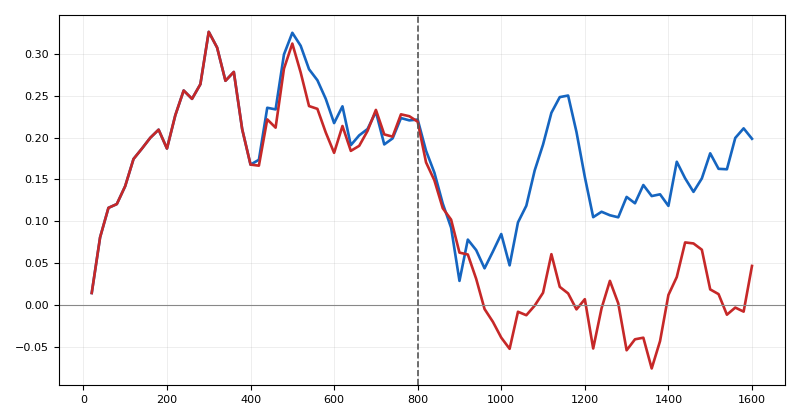
Рис. 3. Динамика всех шести обучаемых весов в том же прогоне из 800 сделок в сравнении с их истинными значениями, заданными в генераторе.
На рисунке 3 показаны шесть весов того же прогона в сравнении с их истинными значениями, заданными в генераторе: четыре стабилизируются в достаточно узком диапазоне, два выходят за истинные значения и продолжают дрейфовать, а один — вес признака «отношение ATR» — к 800-й сделке все еще меняется, не достигнув сходимости. Это проявление дисперсии SGD с обновлением по одному примеру в задаче с шумом, а не четкая сходимость пакетного метода к одному фиксированному решению; именно этот разрыв призвано сократить постепенное уменьшение скорости обучения, описанное в разделе 10.
Абляционный анализ признаков: почему именно эти шесть
В разделе 4 перечислены шесть признаков, но не указано, какие из них несут полезный сигнал. Теперь OnlineML_SyntheticEvidence.mq5 повторяет эксперимент из 800 сделок, поочередно обнуляя каждый признак; для каждой конфигурации используются 50 начальных значений генератора случайных чисел:
| Конфигурация | Среднее разделение на 800-й сделке | Δ относительно всех шести признаков |
|---|---|---|
| Все шесть признаков | +0.222 | — |
| Без EMA-dist/ATR (x1) | +0.074 | -0.148 |
| Без гистограммы MACD/ATR (x4) | +0.153 | -0.069 |
| Без любого из остальных четырех признаков | от +0.212 до +0.222 | < 0.01 |
| Только трендовые признаки (x1, x3, x4) | +0.221 | -0.001 |
| Только признаки волатильности и контекста (x0, x2, x5) | -0.004 | -0.226 |
Таблица 2. Абляционный анализ признаков: 50 начальных значений генератора случайных чисел для каждой конфигурации, синтетический генератор на 800 сделок.
Два признака, x1 и x4, несут почти весь полезный сигнал в этом синтетическом генераторе; исключение любого из остальных четырех снижает показатель менее чем на 0.01, что при таком числе начальных значений генератора случайных чисел находится на уровне шума. Это соответствует устройству самого генератора: x1 и x4 имеют наибольшие истинные веса, поэтому абляционный анализ признаков воспроизводит ранжирование, заложенное в данных. Этим, если говорить строго, и ограничивается вывод: здесь проверяется работоспособность тестовой инфраструктуры на задаче с известным ответом. Это не оценка важности признаков для EURUSD или какого-либо другого реального торгового инструмента; анализ нужно повторить на реальных результатах сделок, когда они будут получены в ходе цикла проверки из раздела 13.
Калибровка вероятностей: имеет ли эта вероятность реальный смысл?
Назвать это «вероятностным фильтром» — более сильное утверждение, чем сказать, что это «оценка, пригодная для отбора по порогу»: значение 0.70 должно действительно означать примерно 7 прибыльных сделок из 10. Проверим это напрямую по вневыборочным значениям p_before из прогона, представленного в таблице 1, начиная со сделки № 200:
| Метрика | Значение | Интерпретация |
|---|---|---|
| ROC-AUC | 0.771 | Значительно выше 0.5; в большинстве случаев модель присваивает прибыльным сделкам более высокие оценки, чем убыточным. |
| Оценка Брайера | 0.194 | Ниже 0.25 — значения, которое дала бы модель типа «подбрасывание монеты» с вероятностью, равной базовой частоте. |
| Логарифмическая функция потерь | 0.570 | Разумное значение при базовой частоте около 0.48; напрямую сравнивать его между разными задачами нельзя. |
Таблица 3. Метрики калибровки вероятностей, один прогон, сделки 200–800, объединенная выборка по 20 начальным значениям генератора случайных чисел, n ≈ 12 000.
Ни одно из этих трёх чисел само по себе не доказывает корректность калибровки вероятностей; это позволяет сделать таблица калибровки, показывающая, действительно ли сделки, для которых модель предсказала вероятность около 0.70, оказывались прибыльными примерно в 70 % случаев:
| Интервал прогнозируемой вероятности | n | Фактическая доля прибыльных сделок | Средняя прогнозируемая вероятность |
|---|---|---|---|
| [0.30; 0.40) | 1 579 | 0.355 | 0.351 |
| [0.40; 0.45) | 760 | 0.434 | 0.425 |
| [0.45; 0.50) | 778 | 0.479 | 0.475 |
| [0.50; 0.55) | 723 | 0.510 | 0.525 |
| [0.55; 0.60) | 775 | 0.560 | 0.576 |
| [0.60; 0.65) | 735 | 0.626 | 0.625 |
| [0.65; 0.70) | 696 | 0.682 | 0.675 |
| [0.70; 0.80) | 1 214 | 0.739 | 0.749 |
Таблица 4. Таблица калибровки: интервал прогнозируемой вероятности и фактическая доля прибыльных сделок в этом интервале.
В каждом интервале фактическая доля прибыльных сделок отличается от средней прогнозируемой вероятности не более чем примерно на один процентный пункт и монотонно возрастает по всем восьми интервалам; здесь «0.75» действительно означает около 75 %. Это другой вопрос, отличный от разделения: модель может идеально ранжировать прибыльные сделки выше убыточных и при этом иметь некорректную калибровку вероятностей (например, всегда прогнозировать 0.9/0.6 при фактических частотах 0.6/0.3). Таблица 4 исключает такую ситуацию на данных генератора, но не на реальном инструменте: для него такую таблицу нужно заново построить по истории реальных сделок, прежде чем какому-либо порогу можно будет доверять как реальной вероятности. Стоит явно оговорить один момент: сам генератор имеет логистическую форму, в основе которой лежит линейная комбинация признаков с добавлением шума, так что благоприятные условия для модели логистической регрессии заложены почти самой конструкцией генератора. В этом разделе проверяется корректность работы реализации, а не достижимость калибровки вероятностей на реальном рынке; реальный инструмент такой гарантии не даёт.
Статическая модель и онлайн-обучение при смене режима: ещё две базовые модели для сравнения
В разделе 2 это было изложено как рассуждение; здесь оно проверяется экспериментально, причём уже на четырёх моделях, а не на двух. Два крайних варианта: модель с онлайн-обучением, вызывающая Update() после каждой сделки, и базовая модель для сравнения с фиксированными весами, которая обучается на 400 сделках и затем больше не обучается. Между ними — модель с периодическим переобучением на всей истории, проходящая пакетное переобучение каждые 200 сделок, и модель с переобучением на скользящем окне, проходящая пакетное переобучение на последних 400 сделках каждые 50 сделок. Ни модель с периодическим переобучением на всей истории, ни модель с переобучением на скользящем окне не вызывает онлайн-обновление; обе реализуют подход «время от времени переобучать модель», но на разном объёме данных — это промежуточные варианты, которые остались бы непроверенными при сравнении только двух моделей.
На первых 800 сделках все четыре модели получают данные с одной и той же зависимостью; на 800-й сделке генератор переключается на другую зависимость, в которой веса двух признаков меняют знак, а смещение изменяется:
// regime A (trades 1..800), matches the base evidence test
double regimeA_w[6] = {0.9, 1.3, -0.4, 0.6, 1.1, 0.3};
double regimeA_b = -0.6;

// regime B (trades 801..1600): x1 and x3 flip sign, the bias moves
double regimeB_w[6] = {0.9, -1.1, -0.4, -0.7, 1.1, 0.3};
double regimeB_b = 0.1;
Фиксация весов сводится к одной строке: больше не вызывать функцию обновления; модель с периодическим переобучением на всей истории и модель с переобучением на скользящем окне каждый раз обучают новую модель пакетно в течение нескольких эпох на соответствующем участке истории, каждая со своей периодичностью.
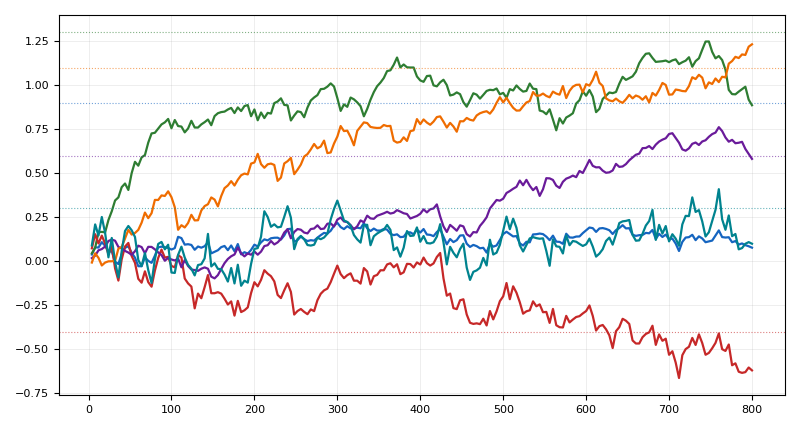
Рис. 4. Горизонтальная ось: количество обработанных сделок с метками, от 0 до 1600. Вертикальная ось: разделение вероятностей для прибыльных и убыточных сделок в скользящем окне из 100 сделок — для онлайн-обучения (синий), модели с фиксированными весами после 400-й сделки (красный), периодического переобучения на всей истории каждые 200 сделок (оранжевый) и переобучения на скользящем окне из 400 сделок (зеленый). Пунктирная вертикальная линия обозначает смену режима на 800-й сделке.
| Сделка | онлайн-обучение | модель с фиксированными весами | периодическое переобучение на всей истории (200) | переобучение на скользящем окне (400) |
|---|---|---|---|---|
| 600 | +0.224 | +0.220 | +0.242 | +0.242 |
| 800 | +0.224 | +0.218 | +0.242 | +0.238 |
| -- смена режима -- | ||||
| 900 | +0.025 | -0.074 | -0.063 | -0.011 |
| 1000 | +0.134 | -0.072 | -0.062 | +0.127 |
| 1200 | +0.184 | -0.068 | +0.162 | +0.196 |
| 1600 | +0.206 | -0.067 | +0.210 | +0.217 |
Таблица 5. Среднее разделение вероятностей для прибыльных и убыточных сделок по 30 начальным значениям генератора случайных чисел до и после смены режима на 800-й сделке для всех четырех методов.
До смены режима результаты всех четырех методов близки (периодическое переобучение на всей истории и переобучение на скользящем окне немного опережают остальные благодаря нескольким эпохам обучения на данных своих окон). К 900-й сделке разделение резко падает у всех четырех методов, после чего их результаты расходятся: модель с фиксированными весами так и не восстанавливается, и на 1600-й сделке разделение по-прежнему составляет −0.067. При периодическом переобучении на всей истории разделение восстанавливается медленно: на 1000-й сделке оно все еще отрицательное, поскольку при переобучении на всех 1000 сделках влияние 200 свежих примеров ослабляется 800 устаревшими примерами режима A; положительным оно становится лишь тогда, когда примеры режима B набирают достаточный вес. При онлайн-обучении и переобучении на скользящем окне разделение восстанавливается быстрее всего: при онлайн-обучении каждая сделка понемногу корректирует модель, а при переобучении на скользящем окне окно из 400 сделок полностью заполняется примерами режима B задолго до 1600-й сделки.
Онлайн-обучение методом стохастического градиентного спуска (SGD) — не единственный способ пережить смену режима: переобучение на скользящем окне здесь дает восстановление примерно так же быстро, а периодическое переобучение на всей истории в итоге тоже приводит к нему, но медленнее, поскольку его тормозит растущий объем устаревших примеров. Все методы, кроме модели с фиксированными весами, объединяет наличие механизма, благодаря которому данные прежнего режима перестают доминировать; именно этого механизма модель с фиксированными весами, служащая базовой моделью для сравнения, полностью лишена.
Расширение модели: постепенное уменьшение скорости обучения
На рисунке 3 показаны веса, которые так и не стабилизируются: это прямое следствие фиксированного значения η, при котором сделка № 1 и сделка № 800 обрабатываются одинаково. Функция SetLearningRateDecay(decay, floor) после каждого обновления немного уменьшает η вплоть до заданной нижней границы, которая не дает обучению полностью остановиться: иначе повторилась бы описанная выше проблема базовой модели для сравнения. Для подключения достаточно одного вызова после Init():
model.Init(N_FEATURES, InpLearningRate, InpL2Lambda);
model.SetLearningRateDecay(0.001, 0.01); // 0.1% shrink per update, floor at 0.01
Постепенное уменьшение скорости обучения с коэффициентом 0.001 и нижней границей 0.01 снижает η с 0.05 примерно до 0.018 к 1000-й сделке — плавно, без резкого падения. Нижняя граница важна: если бы скорость обучения продолжала уменьшаться до значений, близких к нулю, со временем возникла бы та же проблема, что и у базовой модели для сравнения с фиксированными весами, только позже.
В советнике (EA) эта опция по умолчанию отключена исключительно для того, чтобы численные результаты в разделах 7 и 10 оставались однозначными. При ее включении все эти численные результаты меняются. Продолжительность холодного старта, время восстановления после смены режима и ширина полосы шума на траектории весов меняются одновременно. Поэтому, прежде чем полагаться на конфигурацию с постепенным уменьшением скорости обучения, повторно запустите соответствующий скрипт с включенной опцией уменьшения скорости обучения, а не предполагайте, что результаты без нее по-прежнему применимы.
Чувствительность к гиперпараметрам
Требуется ли, чтобы η точно равнялось 0.05, или этот результат справедлив в определённом диапазоне значений? 20 начальных значений генератора случайных чисел на каждую точку:
| η (L2 = 0.0005) | Разделение на 800-й сделке | λ (η = 0.05) | Разделение на 800-й сделке |
|---|---|---|---|
| 0.01 | +0.170 | 0.0000 | +0.237 |
| 0.05 (по умолчанию) | +0.237 | 0.0005 (по умолчанию) | +0.237 |
| 0.10 | +0.243 | 0.0100 | +0.223 |
| 0.30 | +0.242 | 0.0500 | +0.183 |
Таблица 6. Перебор значений скорости обучения и коэффициента L2-регуляризации: 20 начальных значений генератора случайных чисел на точку; полный диапазон приведен в скрипте.
Разделение остается стабильным в диапазоне η от 0.05 до 0.30 и снижается лишь при η ниже 0.02; L2-регуляризация практически не влияет на результат, пока ее коэффициент меньше десятикратного значения по умолчанию. Оба значения по умолчанию находятся в области, где результат стабилен и выбор параметров безопасен. Выбор порога — это решение, связанное с торговлей, а не с обучением модели; при этом возникает реальный компромисс с монотонной зависимостью между долей сделок и точностью (объединенная выборка из раздела 8):
| Пороговое значение | Доля сделок | Точность |
|---|---|---|
| 0.50 | 46.1 % | 0.690 |
| 0.55 (по умолчанию) | 40.1 % | 0.718 |
| 0.60 | 33.6 % | 0.748 |
| 0.65 | 27.5 % | 0.775 |
Таблица 7. Перебор пороговых значений, объединенная выборка (n = 12 020).
С увеличением порога точность монотонно растет, а количество сделок монотонно снижается, как и должно быть у модели с откалиброванными вероятностями. 0.55 — разумное промежуточное значение, а не найденный оптимум; подходящее значение зависит от реальных издержек, которые можно определить только в ходе тестирования на реальных данных, описанного в разделе 13.
Выбор метки и альтернативные варианты
Все приведенные здесь результаты получены при обучении с меткой label = (profit > 0.0) ? 1 : 0 — простейшей меткой, пригодной для этой задачи. При этом величина результата игнорируется: и 0.01R, и 3R получают метку 1, а −0.05R и −3R — метку 0. Существует три альтернативных варианта, ни один из которых не реализован в приложенном коде. Результат в единицах риска R: непрерывная метка, равная отношению прибыли к риску, с регрессионной функцией потерь отвечает на вопрос «насколько хорош результат относительно риска». Порог с учетом издержек: заменить условие profit>0 на profit>expected_cost — для этого достаточно изменить одну строку кода. Метод тройного барьера: метка определяется тем, что наступит первым — достижение фиксированного тейк-профита, срабатывание фиксированного стоп-лосса или истечение максимального времени удержания позиции, — независимо от собственной логики выхода советника (EA). Результат в единицах риска R подходит для ранжирования сигналов по качеству, порог с учетом издержек — для исключения явно убыточных сделок, а метод тройного барьера — для сравнения с другой схемой выхода. Какой бы вариант ни был выбран, повторите абляционный анализ признаков из раздела 7 и проверку калибровки вероятностей из раздела 8 с новой меткой: оба анализа были проведены только для используемой здесь грубой бинарной метки.
Проверка на вашем торговом инструменте
Таблица 1 подтверждает заявленную работоспособность алгоритма, но ничего не говорит о том, есть ли на реальном торговом инструменте связь между пересечением EMA и этими шестью признаками, которую можно использовать в торговле. Один бэктест тоже не отвечает на этот вопрос: один прогон на одном периоде — лишь единичное наблюдение, опоры на которое призвана избежать таблица результатов для нескольких начальных значений генератора случайных чисел из раздела 6. Поэтому здесь нужен протокол пошаговой проверки со сдвигом временных окон, а не один щелчок в тестере. Разделите историю на последовательные по времени блоки: обучающий (веса проходят начальное обучение и сохраняются), валидационный (выбирается порог) и форвардный (используется ровно один раз, без повторной настройки). Затем сдвиньте все три блока вперед и повторите: обучение на месяцах 1–6, валидация на 7-м, форвардное тестирование на 8-м; затем 2–7 / 8 / 9 и так далее. Фильтр, который удовлетворяет критерию на одном временном отрезке, но не на остальных, переобучен под этот отрезок, а не приспособлен к рынку в целом.
В каждом цикле проверки:
- Запустите OnlineML_SignalFilter_EA с параметром InpProbThreshold = 0.0 (без фильтрации), а затем со значением 0.55 (с фильтрацией), оставив все остальные настройки неизменными.
- Сравните общее количество сделок, долю прибыльных сделок, профит-фактор и максимальную просадку.
- Используйте режим «Каждый тик на основе реальных тиков», а не стандартное моделирование по OHLC; протестируйте несколько торговых инструментов; задайте достаточно длительный период тестирования, чтобы пройти этап холодного старта.
Прежде чем доверять версии с фильтрацией, проверьте в каждом цикле проверки: количество сделок не сократилось настолько, что результат потерял практическую ценность (сокращение на 60–80 % разумно, а на 98 % указывает на некорректно выбранный порог); доля прибыльных сделок выросла с учетом реальных издержек, а не только по результатам без их учета; профит-фактор не ухудшился; просадка не стала существенно больше. Улучшение должно сохраняться как минимум в течение двух смежных периодов, а не только одного. Указывайте разброс показателей по циклам проверки, а не только среднее значение: средний профит-фактор 1.4 при разбросе от 1.1 до 1.7 по циклам проверки — менее убедительный результат, чем профит-фактор 1.4 в каждом цикле проверки.
Если фильтр не проходит хотя бы одну из этих проверок хотя бы в одном цикле проверки, это еще не означает, что он бесполезен. Просто доверять ему пока рано. Обычно более эффективно вернуться к рассмотрению «подводных камней» раздела 15, чем корректировать пороговое значение «на глаз». Я сам пока не публиковал это сравнение; см. примечание о границах рассмотрения во введении.
Практические замечания: запуск в реальной торговле
Когда система работает без присмотра, помимо самого механизма важны еще три момента: поддержание корректности файла весов, предотвращение утечки данных и понимание того, с чего начать.
Правила работы с файлом весов. OnDeinit() сохраняет данные только при штатном завершении работы, но не при сбое; для любого использования за рамками демонстрационного теста добавьте периодическое сохранение (каждые N сделок или по таймеру). После вызова LoadFromFile() проверьте корректность загруженных весов (при обнаружении NaN, бесконечных значений или значений, далеко выходящих за допустимый диапазон, отклоните загруженные веса и выполните холодный старт вместо торговли с поврежденным вектором весов). Укажите символ и таймфрейм в имени файла, например OnlineML_weights_EURUSD_H1.csv, так как ничто другое не помешает вам загрузить веса для неправильного инструмента. Увеличивайте номер версии всякий раз, когда меняется состав или порядок признаков в BuildFeatures(), и считайте любое изменение логики управления сделками, а не только признаков, основанием для холодного старта.
Проверки на утечку данных и проверка режима тестера. BuildFeatures() всегда считывает данные со сдвигом 1 (последний закрытый бар), а не со сдвигом 0. поэтому признаки согласованы по времени с моментом входа в сделку. Метка становится известна только после завершения сделки, поэтому последние несколько сделок всегда остаются без меток — это нормальное поведение, а не ошибка. Используйте режим тестера «Каждый тик на основе реальных тиков», а не стандартное моделирование по OHLC. ProcessClosedTrades() обучает модель непосредственно на значениях прибыли, которые сообщает тестер, поэтому оптимистичная модель исполнения искажает метки в сторону прибыльных исходов, а не просто завышает прибыль или занижает убыток; проскальзывание и частичное исполнение через тот же механизм влияют на то, какие сигналы получают метку прибыльной сделки.
С чего начать. Оставьте η = 0.05 и L2 = 0.0005 без изменений (перебор значений в разделе 11), установите начальный порог на уровне 0.55 и меняйте его только после сравнения по протоколу пошаговой проверки со сдвигом временных окон с использованием предлагаемого значения. Пока накоплено менее 100 сделок с метками, считайте, что модель все еще находится на этапе холодного старта, независимо от того, как выглядят результаты. Сбрасывайте модель после любого изменения логики, после длительного периода отрицательного разделения, рассчитанного на скользящем окне, или при несоответствии версии весов. Предварительное обучение в тестере допустимо, но проверка на том же временном окне, на котором проводилось обучение, — нет: для проверки всегда переходите к более позднему окну. Записывайте в журнал по каждой сделке как минимум следующие данные: метку времени, символ, таймфрейм, шесть признаков, прогнозируемую вероятность, была ли сделка открыта, итоговую метку, реализованную прибыль с учетом издержек и текущую скорость обучения. Эти данные служат для диагностики дрейфа и позволяют позднее повторить абляционный анализ признаков из раздела 7 и проверки калибровки вероятностей из раздела 8 на реальных сделках.
Граничные случаи и подводные камни
Онлайн-обучение ≠ прибыльность. В таблице 1 показано, что правило обновления позволяет отделить контролируемую, известную взаимосвязь от шума. Это ничего не говорит о том, существует ли реальная связь между пересечением EMA на вашем инструменте и этими шестью признаками; если такой связи нет, никакая онлайн-адаптация не исправит набор признаков, в котором нет полезного сигнала.
За холодный старт приходится платить реальными сделками. При нулевых значениях всех весов модель выдает ровно 0.5 для каждого сигнала, поэтому начальная серия сделок, прошедших порог, практически не отличается от торговли без фильтрации. Проведите предварительное обучение в тестере стратегий и загрузите полученный файл весов, если не хотите оплачивать эти издержки реальными деньгами на реальном счете; в разделе 14 приведена оговорка о том, как при предварительном обучении избежать самообмана.
Постоянная скорость обучения на протяжении всего времени работы модели — это упрощение. Это ограничение устраняет описанное в разделе 10 необязательное постепенное уменьшение скорости обучения; по умолчанию оно отключено, чтобы основные численные результаты статьи оставались однозначными.
Масштабирование признаков выполняется вручную. COnlineLogReg сам по себе не выполняет нормализацию; поддерживайте масштаб каждого добавляемого признака сопоставимым с масштабами остальных, иначе при SGD признак с наибольшими по модулю значениями будет доминировать в градиенте независимо от своей фактической информативности.
Сопоставляйте по идентификатору позиции, а не по тикету ордера. DEAL_POSITION_ID сохраняется при частичных закрытиях и изменениях позиции в режимах неттинга и хеджирования, а тикет сделки — нет. Продолжайте использовать этот идентификатор для сопоставления, если добавите в советник (EA) возможность поэтапного увеличения или уменьшения позиции.
Скрипты синтетических экспериментов используют собственный генератор случайных чисел (RNG), а не MathRand(). В обоих скриптах проверки реализован небольшой линейный конгруэнтный генератор, чтобы заданное начальное значение генератора случайных чисел воспроизводило одну и ту же последовательность в разных сборках терминала; это важно только для воспроизводимости теста, а не для работы советника (EA) на реальном счете.
Периодическое переобучение на всей истории и переобучение на скользящем окне здесь представлены пакетными аналогами, а не готовыми к развертыванию конвейерами. Базовые модели для сравнения в разделе 9 реализованы в виде пакетных проходов в скрипте, а не автоматизированного процесса офлайн-обучения и повторного развертывания; создание такого процесса — отдельная инженерная задача.
При постепенном уменьшении скорости обучения результаты, полученные без него, уже неприменимы. Все результаты в разделах 7, 9 и 10 получены без постепенного уменьшения скорости обучения; прежде чем полагаться на конфигурацию с таким уменьшением, повторно запустите соответствующий скрипт.
Метка по условию «прибыль > 0» груба, и теперь обсуждение этого ограничения не сводится к упоминанию здесь. В разделе 12 рассматривается, какую информацию такая метка отбрасывает, и приводятся три конкретные альтернативы: результат в единицах риска R, порог с учетом издержек и метод тройного барьера; ни одна из них не реализована в прилагаемом коде.
Дисбаланс классов не учитывается. Если в вашей торговой истории число прибыльных и убыточных сделок заметно различается, фиксированный порог 0.55 может оказаться слишком упрощенным решением; прежде чем применять его без изменений, проверьте базовую частоту прибыльных сделок по вашему инструменту.
Калибровка вероятностей проверяется только на синтетических данных. ROC-AUC, оценка Брайера и таблица калибровки в разделе 8 подтверждают, что на данных генератора выходы модели имеют смысл вероятностных оценок. Они пока ничего не говорят о калибровке вероятностей на реальной истории сделок: для нее нужна отдельная таблица калибровки, построенная по прогнозам, записанным в журнал по процедуре из раздела 14.
Модель является линейной по признакам. Она не способна учитывать взаимодействия или нелинейности, если вы явно не заложите их в признаки. Это осознанный компромисс ради простоты и возможности онлайн-обучения, а не утверждение, что логистическая регрессия — самый сильный из доступных классификаторов для этой задачи. Абляционный анализ признаков в разделе 7 — наиболее близкая к проверке попытка в этой статье выяснить, приводит ли такой компромисс к каким-либо потерям именно в данной задаче.
При частом выполнении пакетное переобучение требует ощутимых вычислительных затрат. Периодическое переобучение на всей истории и переобучение на скользящем окне имеют вычислительную сложность O(число эпох × размер окна) на один запуск; в скрипте это занимает секунды, поэтому перед внедрением в советник (EA) для реальной торговли с частым переобучением стоит провести профилирование.
Заключение
В этой статье разработан фильтр для MQL5 на основе логистической регрессии с онлайн-обучением: общий класс (OnlineLogReg.mqh, теперь с необязательным постепенным уменьшением скорости обучения), советник (EA), который торгует по сигналам пересечения экспоненциальных скользящих средних (EMA), прошедшим этот фильтр, и передает исходы сделок обратно для обучения, а также средство визуализации, работающее только на чтение. Его работу подтверждают два скрипта синтетических тестов, которые теперь охватывают статистику по нескольким начальным значениям генератора случайных чисел, абляционный анализ признаков, калибровку вероятностей, перебор гиперпараметров и четыре базовые модели для сравнения при смене режима вместо одного сравнительного варианта.
Что доказано — с интервалами погрешности, а не на отдельных примерах: к 800-й сделке среднее разделение по 200 начальным значениям генератора случайных чисел составляет +0.233, 95%-й доверительный интервал — [+0.141; +0.334], причем он нигде не пересекает ноль. Два из шести признаков (EMA-dist/ATR, MACD-hist/ATR) несут практически всю полезную информацию. Прогнозы не только обеспечивают разделение, но и демонстрируют калибровку вероятностей (ROC-AUC 0.771; во всех интервалах прогнозы согласуются с фактическими частотами в пределах примерно 1 процентного пункта). Модель с онлайн-обучением восстанавливается после смены режима, тогда как результаты модели с фиксированными весами остаются отрицательными; модели с периодическим переобучением на всей истории и переобучением на скользящем окне также восстанавливаются, но медленнее. Все это справедливо в широком диапазоне значений скорости обучения и коэффициента L2-регуляризации. Это утверждения, касающиеся алгоритмов и архитектуры, каждое из которых подкреплено скриптом, который можно запустить повторно.
Что не доказано: что эти признаки или эта метка дают на каком-либо инструменте реальное торговое преимущество, сохраняющееся после учета издержек. Это утверждение о торговом преимуществе остается неподтвержденным до проведения проверки на реальных тиковых данных по протоколу пошаговой проверки со сдвигом временных окон из раздела 13.
Конкретный план второй части: здесь все эксперименты синтетические; продолжением на реальном рынке, а не новым механизмом, стали бы испытания на EURUSD H1 с использованием реальных тиковых данных за пять лет и циклами проверки по протоколу пошаговой проверки со сдвигом временных окон из раздела 13; сравнение торговли с фильтрацией сигналов и без нее по тому же протоколу; перебор порогов из раздела 11 с оценкой фактической точности и издержек; стресс-тест с учетом проскальзывания и издержек; проверка устойчивости на нескольких инструментах (GBPUSD, XAUUSD, индекс); а также повторный абляционный анализ признаков из раздела 7 и проверка калибровки вероятностей из раздела 8 на реальных сделках с метками. В приведенной ниже таблице файлов содержится всё необходимое для сборки, тестирования и расширения программы.
| Файл | Тип | Описание |
|---|---|---|
| OnlineLogReg.mqh | Библиотека | Класс COnlineLogReg: прямой проход с сигмоидной функцией, обновление методом стохастического градиентного спуска (SGD) по каждому примеру с L2-регуляризацией, необязательное постепенное уменьшение скорости обучения и сохранение состояния модели с сохранением и загрузкой в формате CSV. |
| OnlineML_SignalFilter_EA.mq5 | Советник (EA) | Сигнал пересечения экспоненциальных скользящих средних (EMA), формирование шести признаков, фильтрация по порогу вероятности, управление сделками на основе ATR и контур обратной связи по закрытым сделкам, в котором формируются метки и обновляется модель. |
| OnlineML_ProbabilityView.mq5 | Индикатор | График оценки вероятности прибыльной сделки в отдельном подокне, без изменения модели; для расчета используются веса, загруженные из файла, сохраненного советником. |
| OnlineML_SyntheticEvidence.mq5 | Скрипт | v2.00: таблица контрольных точек для одного начального значения генератора случайных чисел, статистическая сводка по 200 начальным значениям генератора случайных чисел, абляционный анализ признаков в шести вариантах (по 50 начальных значений генератора случайных чисел для каждого) и диагностика калибровки вероятностей (ROC-AUC, оценка Брайера, логарифмическая функция потерь, таблица калибровки). |
| OnlineML_RegimeShift_Evidence.mq5 | Скрипт | v2.00: сравнение четырех подходов при смене режима — онлайн-обучения, модели с фиксированными весами, периодического переобучения на всей истории (пакетного переобучения) и переобучения на скользящем окне из 400 сделок — с выводом результатов для одного начального значения генератора случайных чисел и сводной таблицей по 30 начальным значениям генератора случайных чисел. |
| MQL5.zip | Архив | Архив со всеми пятью перечисленными выше файлами исходного кода и изображениями иллюстраций. Распакуйте его в каталог установки терминала, и все файлы будут размещены в нужных местах. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/23700
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


Ознакомьтесь с новой статьёй: «Онлайн-обучение с использованием методов машинного обучения для фильтрации торговых сигналов в MQL5» (Часть 1).
Автор: Адеолу Кайоде Гбадебо
Ознакомьтесь с новой статьёй: «Онлайн-обучение с использованием методов машинного обучения для фильтрации торговых сигналов в MQL5» (Часть 1).
Автор: Адеолу Кайоде Гбадебо