

Архитектура машинного обучения в MetaTrader 5 (Часть 18): Исправленный последовательный бутстрэп — клонирование, стирание типа и инструментарий сравнения
 45
 0

Содержание
- Введение
- Два взаимосвязанных дефекта
- Дефект 1 — стирание типа в _apply_sequential_bagging
- Дефект 2 — почему устранение только стирания типа приводит к сбою
- Исправление 1 — сохранение принадлежности классификатора к исходному классу в _apply_sequential_bagging
- Исправление 2 — _find_seq_bagging и повторная передача данных для текущего фолда в CalibratorCV.fit()
- Метрики на наблюдениях вне бутстрэп-выборки (OOB) и диагностика памяти
- Модуль bootstrap_comparison
- Результаты
- Рефакторинг afml.cache
- Заключение
- Прикрепленные файлы
Введение
После этапа калибровки в ModelDevelopmentPipeline диагностическая проверка показала, что оценка Брайера на отложенных фолдах (OOF) для варианта с последовательным бутстрэпом составила 0.2442 — то есть совпала с точностью до четырех знаков после запятой со значением 0.2441 для варианта со стандартным бутстрэпом. Эти два числа не должны быть настолько близкими. Часть 5 показывает как аналитически, так и с помощью моделирования методом Монте-Карло, что последовательный бутстрэп формирует выборки с более высокой средней уникальностью, чем стандартный бутстрэп, и что это преимущество в уникальности приводит к улучшению различения классов на наблюдениях вне бутстрэп-выборки (OOB). Одинаковые оценки Брайера на отложенных фолдах (OOF) у двух методов формирования выборки, различающихся по принципу работы, — не совпадение, а симптом.
Анализ этого симптома выявляет два дефекта, действующих последовательно. Первый дефект — стирание типа: _apply_sequential_bagging переносила обученные базовые модели из SequentiallyBootstrappedBaggingClassifier в оболочку обычного BaggingClassifier с утратой принадлежности к исходному классу, необходимой для того, чтобы CalibratorCV мог по-разному обрабатывать варианты с последовательным и стандартным бутстрэпом. После утраты принадлежности к исходному классу CalibratorCV видел два стандартных конвейера с BaggingClassifier и для обоих выполнял идентичное повторное обучение на фолдах. Второй дефект — несоответствие размерностей, которое проявилось бы при простом устранении стирания типа: в библиотеке sklearn функция clone() сохраняет параметры конструктора, включая полный набор samples_info_sets длиной N , однако при повторном обучении на каждом фолде передается лишь n_train < N строк, из-за чего проверка размерностей индикаторной матрицы в классификаторе вызывает исключение ValueError еще до начала обучения.
В данной статье исправлены оба недочета. В рабочем конвейере мы сохраняем исходный классификатор SequentiallyBootstrappedBaggingClassifier . Мы также добавляем _find_seq_bagging() в CalibratorCV.fit() для обнаружения классификатора с последовательным бутстрэпом и повторной передачи данных для текущего фолда: набора samples_info_sets , ограниченного обучающими строками этого фолда, перед каждым повторным обучением. Наконец, мы предоставляем отдельный модуль bootstrap_comparison , позволяющий продемонстрировать разницу до и после исправлений как на уровне формирования выборки, так и на уровне прогнозирования. Весь исходный код для этой серии статей находится в репозитории GitHub.
Два взаимосвязанных дефекта
Эти два дефекта не являются независимыми. Первый дефект — стирание типа — является причиной; второй дефект — несоответствие размерностей — является следствием, которое не позволяет сработать самому простому исправлению. Именно понимание этой зависимости определяет порядок устранения неполадок.
После того как функция _apply_sequential_bagging обучала классификатор SequentiallyBootstrappedBaggingClassifier, она переносила обученные базовые модели в обычный BaggingClassifier и возвращала эту оболочку внутри Pipeline. Причина заключалась в удобстве развертывания: классификатор SequentiallyBootstrappedBaggingClassifier требует price_bars_index на этапе обучения, и отказ от этой зависимости после обучения упростил сохраняемый артефакт. Однако в результате каждый последующий компонент, использующий best_model , включая CalibratorCV , получал стандартный BaggingClassifier. Калибратор не распознавал, что ансамбль использует последовательный бутстрэп, и при повторном обучении на фолдах применял стандартный равномерный отбор наблюдений как для последовательного, так и для стандартного варианта.
Устранение стирания типа (то есть возврат объекта SequentiallyBootstrappedBaggingClassifier из _apply_sequential_bagging) само по себе не решает проблему с калибровкой. Когда CalibratorCV клонирует конвейер для повторного обучения на фолде, в библиотеке sklearn функция clone() воспроизводит все параметры конструктора, включая samples_info_sets, который на этот момент содержит все N наблюдений. Обучающая выборка текущего фолда содержит n_train < N строк. Когда метод SequentiallyBootstrappedBaggingClassifier._fit() вызывает get_active_indices(samples_info_sets, price_bars_index), он строит карту активных индексов длиной N, а затем сравнивает эту длину с числом наблюдений — n_train — переданных в fit(). Проверка вызывает исключение ValueError. Исходная реализация CalibratorCV перехватывает только TypeError, поэтому исключение не обрабатывается.
Поэтому исправление должно одновременно решать две задачи: сохранять принадлежность к исходному классу, чтобы CalibratorCV мог его распознать, а затем перед каждым повторным обучением на фолде заново передавать ограниченный нужными строками ряд samples_info_sets для успешного прохождения проверки размерностей.
Дефект 1 — Стирание типа в _apply_sequential_bagging
Исходный метод обучал SequentiallyBootstrappedBaggingClassifier и затем создавал новый экземпляр BaggingClassifier, копировал в него список обученных базовых моделей, признаки и метаданные классов и возвращал эту оболочку:
# Original — type erasure after sequential bootstrap fit
bag = apply_seq_bootstrap(
    X=X, y=y, estimator=MyPipeline(base_est.steps),
    n_estimators=int(bagging_n),
    max_samples=bagging_samples,   # read from model_params
    samples_info_sets=self.events["t1"],
    price_bars_index=self.bar_data.index,
    ...
)

standard_bag = BaggingClassifier(estimator=MyPipeline(base_est.steps), ...)
standard_bag.estimators_          = bag.estimators_
standard_bag.estimators_features_ = bag.estimators_features_
standard_bag.classes_             = bag.classes_
standard_bag.n_classes_           = bag.n_classes_

return Pipeline([("seq_bag", standard_bag)])   # SB type is gone
С этого момента все компоненты, получавшие best_model — analyze_features, calibrate_model, экспорт в ONNX — видели объект класса BaggingClassifier. Единственным объектом, которому для корректной работы требовался исходный тип, был CalibratorCV, но вместо этого он получил оболочку. При повторном обучении на фолдах калибратор обучал стандартный ансамбль в обоих вариантах, получал одинаковые вероятности на отложенных фолдах (OOF) и одинаковые оценки Брайера.
Дефект 2 — Почему устранение только стирания типа приводит к сбою
Исправление должно сохранять принадлежность к исходному классу. Однако в библиотеке sklearn функция clone(estimator) определена следующим образом: создать новый экземпляр того же класса, используя параметры конструктора, зафиксированные в get_params(deep=True). У SequentiallyBootstrappedBaggingClassifier параметр samples_info_sets входит в параметры конструктора, поэтому clone() копирует его полностью — все N строк — в клонированный объект. Затем выполняется вызов: fold_clf.fit(X_train, y_train), где X_train имеет размерности (n_train, n_features) и n_train < N.
В методе SequentiallyBootstrappedBaggingClassifier._fit() код строит отображение активных индексов на основе полного ряда samples_info_sets:
if self.active_indices_ is None:
    self.active_indices_ = get_active_indices(
        self.samples_info_sets, self.price_bars_index
    )

if len(self.active_indices_) != n_samples:
    raise ValueError(
        f"Indicator matrix shape {len(self.active_indices_)} "
        f"does not match number of samples {n_samples}"
    )
len(active_indices_) равно N (полная длина ряда); n_samples равно n_train. Проверка вызывает исключение ValueError; в исходной реализации CalibratorCV блок except TypeError его не перехватывает. На этапе калибровки происходит сбой без предоставления какой-либо полезной диагностической информации.
Несоответствие размерностей не означает, что проверка размерностей содержит ошибку: сама проверка корректна. Несоответствие вызвано ошибкой в передаче полного ряда samples_info_sets в клоны моделей для отдельных фолдов. Исправление должно обеспечивать передачу среза ряда для текущего фолда вместо полного ряда.
Исправление 1 — сохранение принадлежности классификатора к исходному классу в _apply_sequential_bagging
Исправленный метод исключает этап преобразования и напрямую возвращает объект исходного класса SequentiallyBootstrappedBaggingClassifier :
# Corrected — SB classifier identity is retained
bag = apply_seq_bootstrap(
    X=X, y=y, estimator=MyPipeline(base_est.steps),
    n_estimators=int(bagging_n),
    max_samples=1.0,   # always full draw; see Section 5.1
    samples_info_sets=self.events["t1"],
    price_bars_index=self.bar_data.index,
    ...
)

return Pipeline([("seq_bag", bag)])   # genuine SB type preserved
Методы получения предсказаний — predict и predict_proba — наследуются от BaggingClassifier и требуют лишь списка обученных моделей, который уже имеется. price_bars_index не требуется после обучения, поэтому проблема развертывания, ради решения которой была создана исходная оболочка, устраняется без потери функциональности.
Соглашение об использовании max_samples=1.0
Исходный код считывал значение параметра bagging_max_samples из model_params; этому параметру обычно присваивалась средняя уникальность набора данных в соответствии с § 6.2 AFML. Эта рекомендация относится к стандартному BaggingClassifier, в котором равномерный отбор не предусматривает встроенного механизма уменьшения перекрытия: ограничение размера выборки долей, равной средней уникальности, позволяет контролировать избыточность за счет отбора меньшего числа наблюдений. Механизм последовательного отбора уже на каждом шаге задает вероятность отбора наблюдения пропорционально уникальности — он учитывает перекрытие непосредственно при формировании выборки. Установка параметра max_samples ниже 1.0 для последовательного ансамбля приводит к двукратному применению корректировки на основе avgU и формированию выборок меньшего размера, чем необходимо. В исправленном методе для последовательного варианта жестко задано max_samples=1.0 ; в стандартном варианте по-прежнему используется доля avgU.
Исправление 2 — _find_seq_bagging и повторная передача данных для текущего фолда в CalibratorCV.fit()
Обнаружение последовательного классификатора
Вспомогательная функция обнаружения выполняет обход дерева модели, переданной в CalibratorCV, на глубину одного уровня. Она возвращает первый найденный объект SequentiallyBootstrappedBaggingClassifier или None , если модель представляет собой стандартный вариант бэггинга:
def _find_seq_bagging(estimator):
    """
    Locate a SequentiallyBootstrappedBaggingClassifier inside estimator.

    Handles both a bare classifier and one nested as a step in a
    (My)Pipeline. Returns the instance if found, otherwise None.
    """
    if isinstance(estimator, SequentiallyBootstrappedBaggingClassifier):
        return estimator
    if hasattr(estimator, "steps"):
        for _, step in estimator.steps:
            if isinstance(step, SequentiallyBootstrappedBaggingClassifier):
                return step
    return None
В реализации используется isinstance , поскольку на данный момент существует только один класс механизма отбора с учетом временной структуры. Проверяемый во время выполнения Protocol можно ввести при добавлении других вариантов механизма отбора.
Повторная передача данных для текущего фолда
В начале метода CalibratorCV.fit() процедура обнаружения выполняется один раз для еще не обученной модели. Если обнаружен классификатор SB, значение его атрибута samples_info_sets сохраняется в seq_t1 и проверяется на соответствие размеру полного обучающего набора:
seq_step = _find_seq_bagging(self.estimator)
if seq_step is not None:
    seq_t1 = getattr(seq_step, "samples_info_sets", None)
    if seq_t1 is None:
        raise ValueError(
            "The estimator contains a SequentiallyBootstrappedBagging-"
            "Classifier but samples_info_sets is not set."
        )
    if len(seq_t1) != n_samples:
        raise ValueError(
            f"samples_info_sets length ({len(seq_t1)}) does not match "
            f"the number of training rows ({n_samples})."
        )
else:
    seq_t1 = None
В цикле по фолдам клонированная модель получает срез samples_info_sets по обучающим строкам текущего фолда до вызова fit() . Значение active_indices_ сбрасывается в None , чтобы классификатор заново построил отображение активных индексов по срезу ряда, а не сохранял отображение, построенное по всем N наблюдениям:
for _, (train_idx, test_idx) in enumerate(self.cv_.split(X_, y_)):
    X_train, X_test = X[train_idx], X[test_idx]
    y_train = y[train_idx]
    sw_train = sample_weight[train_idx]

    fold_clf = clone(self.estimator)

    if seq_t1 is not None:
        fold_seq = _find_seq_bagging(fold_clf)
        fold_seq.samples_info_sets = seq_t1.iloc[train_idx]
        fold_seq.active_indices_ = None   # force recompute for this fold

    try:
        fold_clf.fit(X_train, y_train, sample_weight=sw_train)
    except TypeError:
        fold_clf.fit(X_train, y_train)

    oof_probs[test_idx] = fold_clf.predict_proba(X_test)[:, 1]
На этапе 3 — при повторном обучении на полном наборе данных, результат которого сохраняется в CalibratorCV.estimator_ — применяется тот же подход, но на этот раз с полным seq_t1 , поскольку используются все N строк:
self.estimator_ = clone(self.estimator)
if seq_t1 is not None:
    full_seq = _find_seq_bagging(self.estimator_)
    full_seq.samples_info_sets = seq_t1
    full_seq.active_indices_ = None
self.estimator_.fit(X, y, sample_weight=sample_weight)
Благодаря повторной передаче данных для текущего фолда последовательный бутстрэп действительно применяется при каждом разбиении перекрестной проверки, а не только при первоначальном обучении на полном наборе данных. Без этого вероятности на отложенных фолдах (OOF) отражают стандартный бэггинг на всех фолдах, и сравнение не дает никаких содержательных результатов.
Метрики на наблюдениях вне бутстрэп-выборки (OOB) и диагностика памяти
Результат повторного обучения на полном наборе данных на этапе 3, сохраненный в CalibratorCV.estimator_ , представляет собой конвейер, последний шаг которого — обученный бэггинг-классификатор. Вспомогательная функция _extract_bagging_clf снимает оболочку MyPipeline , чтобы получить доступ к этой модели:
def _extract_bagging_clf(fitted_pipe):
    """Return the fitted bagging estimator from a pipeline-wrapped object."""
    if hasattr(fitted_pipe, "steps"):
        return fitted_pipe.steps[-1][1]
    return fitted_pipe
compute_custom_oob_metrics восстанавливает предсказания на наблюдениях вне бутстрэп-выборки (OOB) на основе estimators_samples_ (для стандартного бутстрэпа) или _estimators_samples (для последовательного бутстрэпа), не требуя задания oob_score=True при обучении. Она работает как с BaggingClassifier , так и с SequentiallyBootstrappedBaggingClassifier через один и тот же интерфейс. Функция возвращает словарь с ключами f1, precision (точность), recall (полнота), pwa, neg_log_loss, accuracy (доля правильных ответов), coverage (охват), а для бинарной классификации — также auc.
estimate_ensemble_size суммирует поверхностный объем занимаемой памяти для списка моделей и сохраненных массивов индексов выборок. Она возвращает значение в мегабайтах. Эта оценка представляет собой нижнюю границу: используется sys.getsizeof, которая возвращает размер заголовка объекта, а не полный объем памяти, выделенной в куче для сложных объектов; тем не менее оценка обеспечивает согласованное относительное сравнение двух вариантов в рамках одного запуска.
Обе функции вызываются для cal.estimator_ после каждого вызова CalibratorCV.fit() в compare_predictions. Результатами заполняются два новых поля в PredictionComparison: oob_metrics (DataFrame, где строки — названия метрик, а столбцы — {"standard", "sequential"}) и memory_mb (словарь). Оба поля представлены в выводе BootstrapComparison.summary() и в отдельной строке OOB на сравнительном графике.
Модуль bootstrap_comparison
Модуль предоставляет три точки входа: compare_sampling, compare_predictions, а также оркестратор compare_bootstrap_methods, который возвращает объект BootstrapComparison , объединяющий оба уровня. Вспомогательная функция-обертка compare_from_pipeline извлекает необходимые входные данные непосредственно из обученного ModelDevelopmentPipeline.
Сравнение на уровне формирования выборок
compare_sampling не использует модели и не требует больших вычислительных затрат. При n_repeats независимых формированиях выборки длиной n_obs каждым методом функция фиксирует среднюю уникальность сформированной выборки и подсчитывает, как часто выбирается каждое наблюдение. На данных с перекрывающимися метками, полученными методом тройного барьера, последовательный бутстрэп стабильно обеспечивает более высокую среднюю уникальность, поскольку вероятность отбора, взвешенная с использованием индикаторной матрицы, снижает вероятность выбора наблюдений, охватывающих диапазоны баров, уже представленные в текущей выборке.
Сравнение на уровне прогнозов
compare_predictions создает конвейер для каждого варианта, оборачивает его в CalibratorCV с разбиением с помощью PurgedKFold и собирает диагностические показатели как OOF, так и OOB. Конвейер с последовательным бутстрэпом использует max_samples=1.0 (формируется выборка полного размера, а перекрытие учитывается внутри механизма отбора); конвейер со стандартным бутстрэпом использует среднюю уникальность набора данных как долю наблюдений, отбираемых для каждой базовой модели, в соответствии с §6.2 AFML. Поскольку CalibratorCV теперь выполняет повторную передачу samples_info_sets для текущего фолда, вариант с последовательным бутстрэпом действительно использует этот метод при каждом разбиении и каждом повторном обучении на этапе 3.
Назначение
from sklearn.tree import DecisionTreeClassifier
from afml.ensemble import compare_bootstrap_methods

result = compare_bootstrap_methods(
    base_estimator=DecisionTreeClassifier(max_depth=4),
    X=features,
    y=events["bin"],
    samples_info_sets=events["t1"],
    price_bars_index=bars.index,
    n_estimators=100,
    n_splits=5,
    pct_embargo=0.01,
    sample_weight=events["tW"],
    n_repeats=200,
)

print(result.summary())
result.plot(save_path="bootstrap_comparison.png")
Для конвейера, уже обученного с помощью ModelDevelopmentPipeline:
from afml.ensemble import compare_from_pipeline

result = compare_from_pipeline(pipeline)
print(result.summary())
Поскольку _apply_sequential_bagging теперь сохраняет исходный SequentiallyBootstrappedBaggingClassifier, compare_from_pipeline может раскрыть обертку pipeline.best_model, получить доступ к классификатору SB через атрибут .estimator и передать его в качестве базовой модели для новых запусков сравнения — без необходимости явно передавать samples_info_sets или price_bars_index заново.
Результаты
Сравнение оценки Брайера до и после исправления
На рисунке 1 слева воспроизведено проявление ошибки в рабочей системе, а справа показан исправленный результат. До исправления оба варианта давали оценку Брайера вида 0.244x при представлении с четырьмя значащими цифрами — визуально и численно результаты были неразличимы. После исправления оценка Брайера для варианта с последовательным бутстрэпом достигает 0.2387 против 0.2441 для варианта со стандартным бутстрэпом; разница составляет 0.0054 пункта. Этот небольшой в абсолютном выражении разрыв согласуется с преимуществом по уникальности, измеренным в части 5, и с разницей в доле правильных ответов на наблюдениях вне бутстрэп-выборки (OOB), равной 2,3 процентного пункта и приведенной в таблице 1 той статьи.
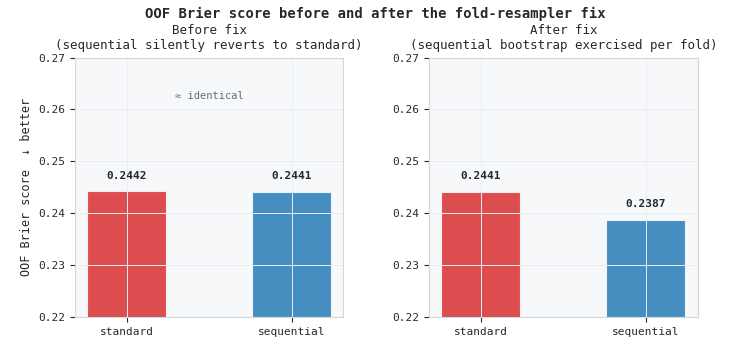
Рисунок 1. Иллюстрация из двух панелей, показывающая влияние исправления механизма повторного формирования выборки для фолда на оценку Брайера на отложенных фолдах (OOF)
- Левая панель (до исправления): оба варианта — со стандартным и с последовательным бутстрэпом — дают оценку Брайера на отложенных фолдах (OOF) вида 0.244x, неразличимую до четырех знаков после запятой, поскольку из-за стирания типа при повторном обучении на фолдах в обоих вариантах использовался стандартный бэггинг.
- Правая панель (после исправления): оценка Брайера для варианта с последовательным бутстрэпом достигает 0.2387, тогда как для варианта со стандартным бутстрэпом остается на уровне 0.2441, что подтверждает использование механизма последовательного отбора на каждом фолде.
Сравнение на уровне формирования выборок
На рисунке 2 показаны результаты работы compare_sampling для 1 000 независимых формирований выборки. Распределение уникальности при последовательном бутстрэпе (синий график) смещено вправо относительно распределения при стандартном бутстрэпе (красный график); средние значения составляют 0.70 и 0.60 соответственно, что воспроизводит результат моделирования методом Монте-Карло из части 5. На панели частоты отбора отдельных наблюдений (справа) видно, что распределение для стандартного бутстрэпа сосредоточено вблизи теоретического значения 0.632 — вероятности того, что данное наблюдение будет отобрано хотя бы один раз при формировании выборки полного размера с возвращением. При последовательном бутстрэпе распределение шире, что отражает взвешенные по уникальности вероятности отбора: механизм последовательного бутстрэпа использует их, отдавая предпочтение наблюдениям с низкой одновременной активностью.
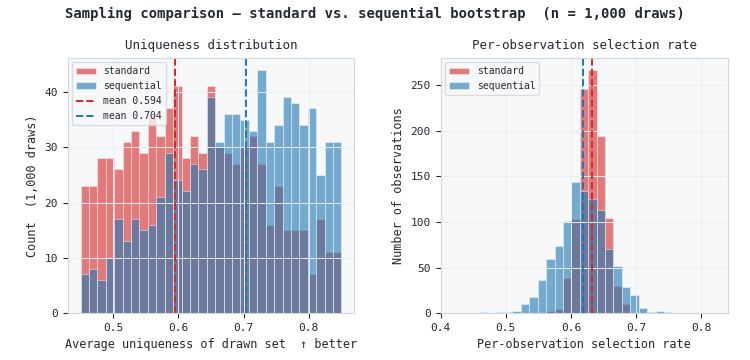
Рисунок 2. Двухпанельная иллюстрация сравнения на уровне формирования выборок, полученная с помощью compare_sampling (1 000 формирований выборки)
- Распределение уникальности (слева): среднее значение средней уникальности при последовательном бутстрэпе составляет 0.70 против 0.60 при стандартном бутстрэпе. Пунктирные вертикальные линии обозначают средние значения; распределение для последовательного бутстрэпа уже, что указывает на более стабильное устранение дублирования при разных формированиях выборки.
- Частота отбора (справа): при стандартном бутстрэпе распределение сосредоточено вблизи значения 0.632 (теоретической частоты для равномерного отбора с возвращением). Распределение для последовательного бутстрэпа шире: наблюдения, активные одновременно со многими уже отобранными наблюдениями, отбираются реже, а изолированные наблюдения — чаще.
Сравнение показателей OOF и OOB
На рисунке 3 представлены OOF-метрики и на наблюдениях вне бутстрэп-выборки (OOB), полученные с помощью bootstrap_comparison на наборе данных EURUSD tick-M5 (49 размеченных событий, 1 075 ценовых баров). На этой подвыборке из 49 наблюдений стандартный бутстрэп немного превосходит последовательный по четырем из пяти метрик OOF: оценке Брайера (0.235 против 0.244), ECE (0.093 против 0.119), PWA (0.657 против 0.602) и доле правильных ответов (0.611 против 0.592). Последовательный бутстрэп дает незначительное улучшение отрицательной логарифмической потери OOF (−0.668 против −0.673): разница составляет 0.005. Такое соотношение результатов согласуется с малым размером выборки: при 49 размеченных событиях у механизма последовательного бутстрэпа мало возможностей избегать отбора одновременно активных наблюдений в пределах одного фолда, а преимущество по уникальности в 1,14 раза, измеренное на уровне формирования выборок, при таком объеме данных не приводит к устойчивому улучшению калибровки на уровне фолдов.
Панель OOB показывает иные результаты по одному из показателей. Последовательный бутстрэп дает AUC на наблюдениях вне бутстрэп-выборки (OOB), равную 0.629, против 0.556 у стандартного варианта; разница в 0.073 — самая большая на рисунке. Для F1 и доли правильных ответов соотношение обратное, а различия меньше: F1 составляет 0.621 для стандартного бутстрэпа против 0.610 для последовательного, а доля правильных ответов — 0.633 против 0.612 соответственно. Охват одинаков для обоих вариантов и равен 1.000, что подтверждает: механизм последовательного бутстрэпа не исключает наблюдения из OOB-оценивания систематическим образом. Преимущество по AUC согласуется с эффектом повышения полноты, который дает последовательный бутстрэп за счет более частого отбора наблюдений с низкой одновременной активностью. Метрики калибровки, такие как оценка Брайера и ECE, которые штрафуют за резкость вероятностных прогнозов, а не за ранжирование, не отражают этого эффекта на наборе данных из 49 наблюдений, поскольку преимущество более высокой уникальности проявляется в улучшении ранжирования раньше, чем в повышении качества оценок вероятностей.
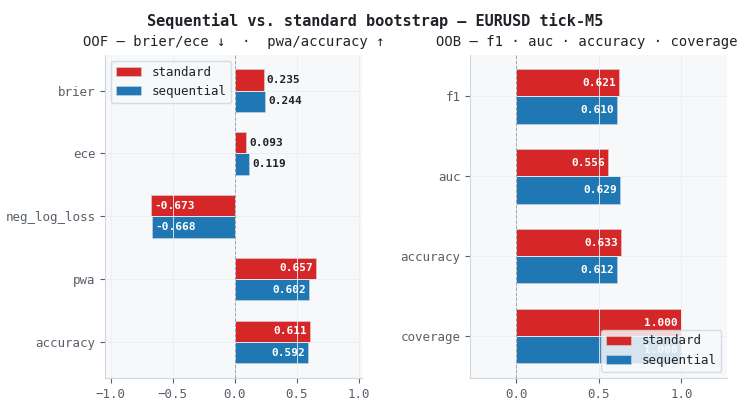
Рисунок 3. Двухпанельная иллюстрация метрик OOF и OOB из bootstrap_comparison
- Метрики на отложенных фолдах (OOF) (слева): стандартный бутстрэп дает более низкие (лучшие) значения оценки Брайера (0.235 против 0.244), ECE (0.093 против 0.119), PWA (0.657 против 0.602) и доли правильных ответов (0.611 против 0.592). Последовательный бутстрэп дает немного лучшее значение отрицательной логарифмической потери (−0.668 против −0.673). Подмножество из 49 наблюдений ограничивает влияние преимущества в уникальности на калибровку на отложенных фолдах (OOF).
- Метрики на наблюдениях вне бутстрэп-выборки (OOB) (справа): последовательный бутстрэп дает более выраженное различие по AUC (0.629 против 0.556), отражающее улучшение ранжирования за счет более частого отбора наблюдений с низкой одновременной активностью наблюдений. По F1 и доле правильных ответов стандартный бутстрэп имеет преимущество с меньшим отрывом. Охват составляет 1.000 для обоих вариантов, что подтверждает: ни один из методов формирования выборки не исключает систематически наблюдения из оценки на наблюдениях вне бутстрэп-выборки (OOB).
Рефакторинг afml.cache
В инфраструктуре кэширования, представленной в части 6, за несколько итераций накопились три структурных недостатка. По крайней мере три модуля — backtest_cache, cv_cache и incremental_bar_cache — содержали отдельные реализации генерации ключей, различавшиеся обработкой объектов DataFrame, моделей sklearn и распределений scipy. Стратегия сериализации была несогласованной: в одних ветвях кода напрямую использовался pickle, а в других вызывался joblib. Кроме того, в файле cache_monitoring.py отсутствовали импорты на уровне модуля (joblib.Memory, os, time), что приводило к исключению ImportError в каждом месте вызова средств мониторинга. Рефакторинг марта 2026 года объединяет все это в единый источник истины и добавляет две новые возможности: выявление устаревших записей кэша на основе хеша исходного кода и отслеживание компрометации данных из-за многократного обращения к ним.
Единое ядро кэша
unified_cache.py — это новый модуль ядра. Он экспортирует UnifiedCacheKeyGenerator, декоратор @cacheable, CacheStats и initialize_cache_system. Словарь CACHE_DIRS формируется на основе переменной среды AFML_CACHE, если она задана; иначе для его формирования используется appdirs.user_cache_dir("afml") в качестве резервного варианта. Это тот же механизм, который конвейер уже использует для маршрутизации данных в Google Drive.
UnifiedCacheKeyGenerator.generate_key() обрабатывает все типы в стеке AFML: экземпляры класса sklearn BaseEstimator хешируются с помощью get_params(deep=True), «замороженные» распределения scipy — по их атрибутам args и kwds, объекты DataFrame — по размерностям, списку столбцов, начальной и конечной меткам DatetimeIndex и хешу содержимого 1%-ной выборки, а примитивные типы — путем прямого строкового кодирования. Два необязательных флага дополняют ключ. time_aware=True просматривает привязанные аргументы в поисках первого параметра с DatetimeIndex (t1, data, prices, index) и добавляет диапазон дат; запуск на январских данных не может вернуть кэшированный результат запуска на мартовских данных. auto_versioning=True хеширует исходный код функции и значения в ее замыкании; любое изменение декорированной функции автоматически приводит к промаху кэша при следующем вызове.
from afml.cache import cacheable, initialize_cache_system

initialize_cache_system()

# Invalidates automatically when source changes or date range shifts.
@cacheable(time_aware=True, auto_versioning=True)
def fit_model(data: pd.DataFrame, estimator, params: dict):
    # expensive refit — only runs on cache miss
    ...
CacheStats учитывает попадания в кэш и промахи кэша для каждой функции в словаре defaultdict , защищенном блокировкой threading.Lock(). Словарь статистики записывается в файл cache_stats.json каждые 25 вызовов, чтобы накопленная статистика сохранялась при сбое без необходимости записи при каждом вызове. Менеджер контекста CacheAnalyzer фиксирует статистику при входе и сообщает об изменениях при выходе, что позволяет удобно оценивать работу кэша для конкретного блока кода в блокноте или скрипте.
Кэш баров с инкрементальным расширением
IncrementalBarCache.get_or_extend() служит оберткой для make_bars и использует дерево решений с пятью вариантами, корректность которого опирается на единственный инвариант детерминированности:
cached([t₀, t₁]) + incremental([t₁, t₂]) == from_scratch([t₀, t₂])
В текущей реализации make_bars этому инварианту удовлетворяют только тиковые бары. Принадлежность тика к бару определяется его позицией (arange // bar_size), поэтому последние n % bar_size тиков образуют независимый остаток: если поместить их перед новыми тиками, бар на границе будет восстановлен в точности. Бары по объему и бары по денежному объему не удовлетворяют этому инварианту, поскольку их границы приходятся на кратные значения накопленной метрики, что почти никогда не совпадает с последним полным тиком; остаточное смещение должно было бы задавать начальное значение накопленной суммы при расширении, но make_bars не позволяет задать такое начальное значение. Временные бары создают дубликат бара для временного интервала, пересекающего границу кэша. Информационные бары сохраняют изменяющиеся экспоненциально взвешенные оценки математического ожидания, которые влияют на решения о закрытии баров; для инкрементального расширения потребовалась бы передача полного состояния накопителя, что пока не реализовано. Для всех типов баров, кроме тиковых, get_or_extend выполняет полный пересчет, что обеспечивает корректность и требует небольших вычислительных затрат (одна операция cumsum/resample + groupby).
from afml.cache import IncrementalBarCache
from pathlib import Path

cache = IncrementalBarCache(Path("bar_cache"))

# Dollar bars — full recompute on first call; extends on subsequent calls.
bars = cache.get_or_extend(
    ticks_2021_2024, bar_type="dollar", bar_size=1_000_000, price="mid_price"
)

# Auto-calibrated dollar imbalance bars (information bar path).
bars = cache.get_or_extend(
    ticks_2021_2024, bar_type="dollar_imbalance", target_timeframe="M15"
)
Информационные бары поддерживают два взаимоисключающих способа калибровки. target_timeframe автоматически калибрует начальные параметры порогов EWM по заданной периодичности формирования баров во времени (рекомендуемый способ настройки). exp_ticks_init и exp_imbalance_init позволяют задать начальные параметры вручную. Эти два способа намеренно формируют разные ключи кэша: переключение режима калибровки приводит к промаху кэша, а не к возврату баров, построенных при иных предпосылках для EWM. Потокобезопасность обеспечивается с помощью os.replace(), выполняющего атомарную операцию как в POSIX, так и в Windows; параллельное чтение безопасно, а при параллельной записи сохраняется результат последней записи.
Мониторинг кэша и выборочная очистка
CacheMonitor использует данные CacheStats и формирует два вида результатов. get_efficiency_report() возвращает DataFrame, отсортированный по доле попаданий в кэш, с числом вызовов, средним временем вычислений и объемом занимаемого дискового пространства для каждой функции. analyze_cache_patterns() выделяет четыре категории: функции с высокой долей промахов кэша (hit_rate < 0.5 and total_calls > 10), неиспользуемые кэши (последнее обращение более семи дней назад), слишком большие записи (cache_size_mb > 100) и кандидаты на оптимизацию (total_calls > 50 and hit_rate < 0.3). Лениво инициализируемое свойство joblib.Memory было причиной ошибки ImportError в предыдущей версии; теперь оно инициализируется при первом обращении, а не при импорте модуля.
from afml.cache import print_cache_health, analyze_cache_patterns

# Print hit rate, top/worst performers, stale caches, recommendations.
print_cache_health(detailed=True)

# Programmatic access to flagged categories.
patterns = analyze_cache_patterns()
print(patterns["high_miss_rate_functions"])
SelectiveCacheCleaner добавляет выявление устаревших записей кэша на основе хеша исходного кода. FunctionTracker сохраняет MD5-хеш исходного кода и значений в замыкании каждой декорированной функции. При изменении хеша запись помечается как устаревшая и удаляется при следующем вызове clean_stale(). Благодаря этому кэш остается безопасным в процессе активной разработки: изменение кэшированной функции автоматически приводит к её повторному выполнению при следующем вызове, и нет необходимости вручную очищать кэш. Также доступна очистка на основе политик: clean_old_entries(days=30) удаляет файлы старше 30 дней, clean_large_files(max_size_mb=500) удаляет записи, превышающие заданный размер, а clean_by_module("afml.backtest") очищает записи конкретного модуля. Для полного сброса кэша пользователю необходимо ввести "yes" в ответ на запрос подтверждения.
Отслеживание доступа к данным
DataAccessTracker регистрирует каждый доступ к набору данных с указанием временного диапазона, заявленной цели, а также файла, функции и номера строки вызывающего кода. analyze_contamination() подсчитывает количество неисключённых обращений к каждому набору данных и сопоставляет это число с одним из четырёх уровней предупреждения: CLEAN (0 обращений), ACCEPTABLE (1–2), WARNING (3–10) и CONTAMINATED (>10). Пороговые значения настроены с учетом итеративного процесса разработки моделей машинного обучения: тестовый набор, к которому обращались более двух раз в ходе поиска гиперпараметров, статистически скомпрометирован, даже если для каждого обращения была указана отдельная цель. Записи в журнал производятся в режиме добавления, поэтому сбой в середине сеанса не приводит к повреждению журнала.
from afml.cache import log_data_access, print_contamination_report

# Call this once before each data load.
log_data_access(
    dataset_name="EURUSD_H1",
    start_date=pd.Timestamp("2020-01-01"),
    end_date=pd.Timestamp("2023-12-31"),
    purpose="optimize",   # "train" | "test" | "validate" | "optimize" | "analyze"
)

# At the end of an experiment, audit the full access history.
print_contamination_report()
Уровни бэктестирования, перекрестной проверки и запуска
BacktestCache и cv_cache теперь представляют собой «тонкие» обёртки для @cacheable. Из обеих обёрток удалена вся логика генерации ключей и сохранения данных, ранее дублировавшая логику ядра. cv_cacheable — это прослойка, обеспечивающая обратную совместимость; существующие функции с этим декоратором продолжают работать без изменений. startup_script.py координирует инициализацию в правильном порядке: вызывает initialize_cache_system(), проверяет доступность порта, выполняет базовую проверку работоспособности кэша и только после этого запускает мост MQL5. Очистку устаревших записей кэша при запуске можно включить, раскомментировав одну строку в run_cache_startup().
Заключение
Чтобы сравнение с использованием последовательного бутстрэпа в этом конвейере было научно обоснованным, необходимо внести три изменения. Во-первых, _apply_sequential_bagging должен возвращать настоящий экземпляр SequentiallyBootstrappedBaggingClassifier, а не просто оболочку BaggingClassifier; без этого последующие компоненты конвейера не смогут отличить последовательный вариант от стандартного. Во-вторых, CalibratorCV.fit() должен обнаруживать классификатор SB с помощью _find_seq_bagging() и перед каждым повторным обучением заново передавать ограниченный обучающими строками текущего фолда samples_info_sets; без этого сохранение принадлежности к исходному классу приведет к ошибке ValueError уже на первом фолде. В-третьих, max_samples в последовательном варианте должен равняться 1.0; описанный в §6.2 AFML прием использования avgU в качестве max_samples применим только к равномерному отбору и привёл бы к неоправданному сокращению объема выборок в последовательном ансамбле.
Модуль bootstrap_comparison стал инструментом, выявившим все три дефекта: лишь сравнение двух вариантов, между которыми ожидалось измеримое различие, позволило распознать в одинаковых оценках Брайера дефект, а не результат. Теперь этот модуль входит в состав пакета afml.ensemble и может применяться к любому конвейеру, использующему оба типа механизмов формирования выборки: либо с нуля с помощью compare_bootstrap_methods, либо на основе обученного конвейера с помощью compare_from_pipeline.
Прикрепленные файлы
| Файл | Модуль | Описание | |
|---|---|---|---|
| 1. | bootstrap_comparison.py | afml.ensemble | Новый набор инструментов для сравнения: compare_sampling, compare_predictions, compare_bootstrap_methods, compare_from_pipeline. Возвращает объект BootstrapComparison с методами .summary() и .plot(). Предоставляет оценку Брайера, ожидаемую ошибку калибровки (ECE), логарифмическую потерю, PWA и долю правильных ответов на отложенных фолдах (OOF), а также F1, AUC и охват на наблюдениях вне бутстрэп-выборки (OOB) и объем памяти, занимаемой ансамблем, для обоих вариантов бутстрэпа. |
| 2. | calibration.py | afml.calibration | Обновлен метод CalibratorCV.fit() для учета особенностей последовательного бутстрэпа. Новая вспомогательная функция _find_seq_bagging() обходит дерево моделей; обнаруженным классификаторам передается срез samples_info_sets по обучающим строкам текущего фолда, а их атрибут active_indices_ сбрасывается перед каждым повторным обучением. Также содержит функции fit_platt_scaling, analyze_calibrated_cross_val_scores и метрики калибровки (brier_score, expected_calibration_error, compute_reliability). |
| 3. | model_development.py | afml.production | Обновлен метод ModelDevelopmentPipeline._apply_sequential_bagging(): теперь он возвращает настоящий экземпляр SequentiallyBootstrappedBaggingClassifier вместо простой оболочки BaggingClassifier и жестко задает max_samples=1.0 для варианта с последовательным бутстрэпом. Также содержит отдельную вспомогательную функцию apply_seq_bootstrap и полную реализацию класса ModelDevelopmentPipeline . |
| 4. | oob_metrics.py | afml.ensemble | compute_custom_oob_metrics восстанавливает предсказания на наблюдениях вне бутстрэп-выборки (OOB) на основе estimators_samples_ без необходимости задавать oob_score=True; поддерживает как RandomForestClassifier так и варианты BaggingClassifier включая SequentiallyBootstrappedBaggingClassifier. estimate_ensemble_size возвращает оценку поверхностного объема занимаемой памяти в МБ. |
| 5. | sb_bagging.py | afml.ensemble | SequentiallyBootstrappedBaggingClassifier и SequentiallyBootstrappedBaggingRegressor — оба класса являются производными от SequentiallyBootstrappedBaseBagging. Реализует формирование выборок методом последовательного бутстрэпа с помощью seq_bootstrap, параллельное построение моделей и вычисление OOB-оценки без использования стандартной инфраструктуры OOB для бэггинга. |
| 6. | unified_cache.py | afml.cache | Новый базовый модуль. Экспортирует UnifiedCacheKeyGenerator (единый механизм генерации ключей для объектов DataFrame, оценщиков sklearn, распределений scipy и примитивных типов), декоратор @cacheable с флагами time_aware и auto_versioning , потокобезопасный класс CacheStats, CacheAnalyzer (менеджер контекста) и initialize_cache_system. Учитывает переменную среды AFML_CACHE при выборе каталога кэша. |
| 7. | cache_monitoring.py | afml.cache | Переписанный слой мониторинга. CacheMonitor объединяет экземпляры класса данных FunctionCacheStats в отчет CacheHealthReport. get_efficiency_report() возвращает DataFrame со статистикой по функциям, отсортированный по доле попаданий в кэш. analyze_cache_patterns() отмечает функции с высокой долей промахов кэша, неиспользуемые функции, функции с чрезмерным объемом кэша и функции — кандидаты на оптимизацию. Ранее отсутствовавшие импорты (joblib.Memory, os, time) теперь обрабатываются с помощью отложенной загрузки. |
| 8. | selective_cleaner.py | afml.cache | SelectiveCacheCleaner с очисткой на основе политик: clean_stale() использует хеши исходного кода, предоставляемые FunctionTracker для автоматического признания записей недействительными при изменении декорированных функций; clean_old_entries(days), clean_large_files(max_size_mb), clean_by_module() и clean_by_function() применяют политики на основе размера и возраста записей. Для полного сброса требуется ввод строки явного подтверждения. |
| 9. | backtest_cache.py | afml.cache | Модуль сведен к тонкому слою над @cacheable(time_aware=True, auto_versioning=True). Сохраняет класс данных BacktestMetadata и функцию ручного сохранения save_result() для рабочих процессов, требующих явного указания метаданных. Вся логика генерации ключей была удалена в пользу унифицированного ядра. |
| 10. | cv_cache.py | afml.cache | Прослойка для обратной совместимости. cv_cacheable перенаправляет вызовы унифицированному декоратору @cacheable , поэтому существующие декорированные функции перекрестной проверки не требуют изменений. Содержит эталонную реализацию функции с декоратором @cacheable — clf_hyper_fit . |
| 11. | data_access_tracker.py | afml.cache | Новый модуль. DataAccessTracker записывает в CSV-файл каждое обращение к набору данных с указанием временного диапазона, цели и места вызова в коде. analyze_contamination() сопоставляет число обращений с четырьмя уровнями предупреждения: CLEAN (0), ACCEPTABLE (1–2), WARNING (3–10), CONTAMINATED (>10). Журнал записывается в режиме добавления для обеспечения отказоустойчивости. get_contamination_report() возвращает сводный DataFrame; print_contamination_report() форматирует его для вывода в консоль. |
| 12. | incremental_bar_cache.py | afml.cache | IncrementalBarCache.get_or_extend() служит оберткой для make_bars и использует дерево решений с пятью вариантами. Обеспечивает соблюдение инварианта детерминизма для всех десяти типов баров AFML; только тиковые бары поддерживают настоящее инкрементальное расширение, а для всех остальных выполняется полный пересчет. Для информационных баров можно задать либо параметр target_timeframe (с автоматической калибровкой), либо вручную параметры exp_ticks_init/exp_imbalance_init — эти два варианта дают разные ключи кэша. Потокобезопасность обеспечивается атомарной операцией os.replace(). |
Дополнительная литература
- Лопес де Прадо, М. (2018). Advances in Financial Machine Learning, глава 4 («Последовательный бутстрэп»), глава 6 («Ансамблевые методы»). John Wiley & Sons.
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/22912
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 Возможности Мастера MQL5, которые вам нужно знать (Часть 99): Использование KD-дерева и эхо-сети (ESN) в пользовательском классе управления капиталом
 Отложенная загрузка хендлов индикаторов в MQL5: Менеджер ресурсов для мультитаймфреймовых советников
 Нейросети в трейдинге: Habi — быстрое принятие решений без сложного планирования (формирование и оценка действий)
 Проектирование конечного автомата торговой стратегии на MQL5: Замена вложенных конструкций if-else явными состояниями

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования