
Arbitraje estadístico mediante acciones cointegradas (Parte 4): actualización del modelo en tiempo real
 30
 0

Introducción
Es hora de empezar a actualizar nuestro modelo de cointegración en tiempo real. Más concretamente, es hora de empezar a actualizar la ponderación de cada acción de nuestra cartera de trading con los cálculos más recientes, mientras el Asesor Experto está en funcionamiento. Hasta ahora, hemos usado las mismas ponderaciones de la cartera en nuestras explicaciones y backtests. Resultaron útiles como simplificación para facilitar la comprensión del proceso, así como del significado y el funcionamiento de las pruebas estadísticas subyacentes. Pero en la vida real, estas ponderaciones de la cartera cambian prácticamente cada vez que llega un nuevo dato; es decir, en nuestro caso, con cada nueva barra cerrada.
Pero antes, un poco de contexto: un breve resumen para asegurarnos de que todos estamos en la misma página.
Estamos desarrollando una especie de marco de arbitraje estadístico «asequible»: un pipeline de arbitraje estadístico diseñado para el operador minorista medio, con un portátil de consumo y un ancho de banda de red normal. En esta serie de artículos, documentamos y describimos las pruebas estadísticas utilizadas para identificar activos altamente correlacionados para el trading por pares, acciones cointegradas para la construcción de carteras, así como las pruebas empleadas para evaluar la estacionariedad de sus spreads relativos, algo imprescindible para estrategias de reversión a la media como la nuestra.
En el artículo anterior de esta serie (Parte 3), describimos la configuración de la base de datos y ofrecimos algunas notas sobre nuestras decisiones de diseño. Este artículo es la continuación directa del anterior. Una vez que nuestra base de datos esté configurada y se actualice periódicamente, podremos separar nuestro análisis de datos de nuestra actividad de trading.
Ahora veremos:
- cómo hemos modificado nuestros scripts de Python para incorporar las lecciones aprendidas, de modo que todas las pruebas se procesen en una única ejecución para facilitar nuestra cribado lección de activos;
- cómo hemos reestructurado por completo el código de nuestro Asesor Experto para aprovechar la base de datos actualizada durante su ejecución, y cómo hemos trasladado casi todas las funciones a un archivo de cabecera de MQL5 para que resulte más fácil de gestionar y mantener, dejando únicamente los controladores de eventos nativos en el archivo principal;
- Y, por último, analizaremos las modificaciones que hemos realizado en nuestra base de datos para que pueda actuar como interfaz entre el análisis de datos en tiempo real y el entorno de trading en tiempo real.
Vamos a empezar por el último, el punto 3, para que los otros dos puntos tengan sentido cuando los describamos.
La base de datos como única fuente de verdad
En el artículo anterior empezamos con una definición sencilla del tipo de respuesta que queremos que nuestra base de datos proporcione a nuestro Asesor Experto para actualizar el modelo en tiempo real. Se trata de un típico «código de trucos» que suele utilizarse en los diseños bottom-up. Nos preguntamos cuál es la necesidad inmediata y trabajamos para implementarla. Esto evita la sobreingeniería y facilita las correcciones de rumbo. Este es el fragmento pertinente del artículo anterior.
Al fin y al cabo, nuestra base de datos debería responder a una pregunta muy sencilla: ¿con qué deberíamos operar ahora para obtener la máxima rentabilidad posible?
En referencia al artículo anterior de esta serie, en el que definimos las direcciones y el volumen de nuestras órdenes en función de las ponderaciones de la cartera de acciones, una posible respuesta podría ser algo así:
| symbols | weights | timeframe |
|---|---|---|
| "MU", "NVDA", "MPWR", "MCHP" | 2.699439, 1.000000, -1.877447, -2.505294 | D1 (marco temporal diario) |
Tabla 1. Ejemplo ficticio de una respuesta esperada a una consulta para la actualización del modelo en tiempo real (artículo anterior)
Para obtener este tipo de respuesta, añadimos una nueva tabla a nuestro esquema de base de datos: la tabla «strategy». Tiene cuatro campos TEXT:- Name PRIMARY KEY
- Symbols
- Weights
- Timeframe
-- strategy definition

CREATE TABLE strategy (
        name TEXT CHECK(LENGTH(name) <= 20) NOT NULL,
        symbols TEXT CHECK(LENGTH(symbols) <= 255) NOT NULL,
        weights TEXT CHECK(LENGTH(weights) <= 255),
        timeframe TEXT CHECK (
        timeframe IN (
            'M1',
            'M2',
            'M3',
            'M4',
            'M5',
            'M6',
            'M10',
            'M12',
            'M15',
            'M20',
            'M30',
            'H1',
            'H2',
            'H3',
            'H4',
            'H6',
            'H8',
            'H12',
            'D1',
            'W1',
            'MN1'
        )
    ),CONSTRAINT strategy_pk PRIMARY KEY (name)
) WITHOUT ROWID, STRICT;
Hemos definido esta tabla como una tabla WITHOUT ROWID. En SQLite, las tablas rowid son todas las tablas normales, excepto las virtuales y aquellas con la restricción INTEGER PRIMARY KEY. En las tablas rowid, las claves primarias no son claves primarias reales.
Así pues, al definir la tabla como una tabla WITHOUT ROWID, evitamos que se inserten valores NULL y, por consiguiente, que se vea comprometida la integridad relacional. El inconveniente es que esta cláusula es específica de SQLite, lo cual significa que nuestro esquema deja de ser plenamente portable a otros sistemas de gestión de bases de datos relacionales (RDBMS). Para usar el mismo esquema en otros sistemas de gestión de bases de datos relacionales (RDBMS), tendremos que adaptarlo. Pero creo que la ventaja de impedir que se inserte un valor NULL en el campo de la clave primaria compensa el coste.
Como habrá podido observar, tanto «symbols» como «weights» son arrays. Sin embargo, SQLite no dispone del tipo de datos ARRAY. Debido a esta limitación, insertaremos estos datos como TEXT, pero con el formato de un array JSON. Esta medida nos facilitará el trabajo más adelante si, o cuando, nos pasemos a otro RDBMS que cuente con el tipo de datos ARRAY.
| nombre | símbolos | ponderaciones | marco temporal |
|---|---|---|---|
| Nasdaq_NVDA_Coint | ‘["MU", "NVDA", "MPWR", "MCHP"]’ | ‘[“2.699439”, “1.000000”, “-1.877447”, “-2.505294”]’ | D1 |
Tabla 2. Los datos de símbolos y ponderaciones se insertan en la tabla «strategy» con el tipo de datos TEXT, con formato de arrays JSON.
Para consultarlos, utilizaremos la función json_extract() de SQLite.
Así pues, nuestro esquema de base de datos, ahora actualizado a statarb-0.2, incluye la tabla adicional «strategy», y su diagrama entidad-relación tiene este aspecto:
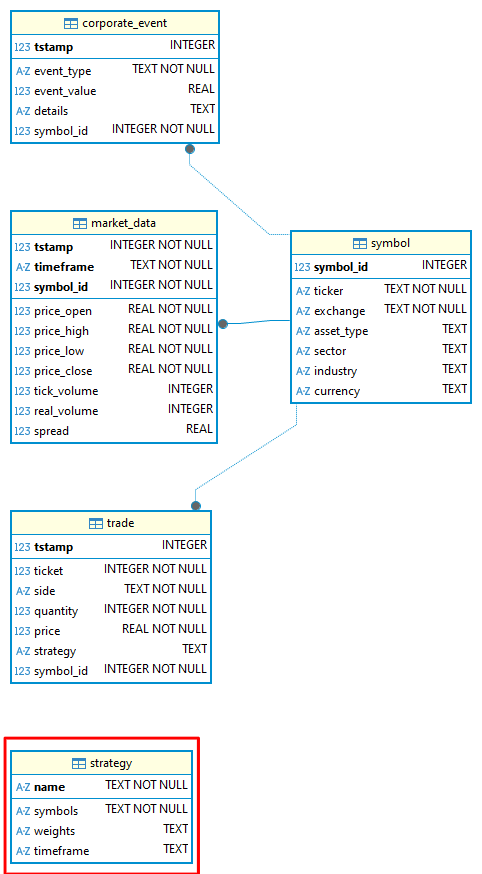
Figura 1. Diagrama entidad-relación (ERD) de la base de datos statarb-0.2
CONSEJO: Cuando desarrollo con SQLite, suelo NO borrar las versiones antiguas de los archivos de base de datos, ni tampoco las versiones antiguas de los archivos de esquema. Dado que se trata de un único archivo, es fácil duplicarlo, renombrar la copia con el nombre de la nueva versión y mantener ambos en el sistema de control de versiones (VCS). Esta práctica nos proporciona una «ruta sencilla de reversión», por si acaso.
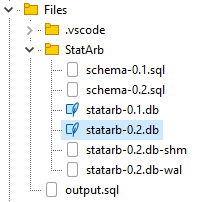
Figura 2. El Navegador de MetaEditor muestra las diferentes versiones de los archivos SQLite (bases de datos) y los respectivos archivos de esquema
Como podemos ver en el ERD mostrado arriba, nuestra nueva tabla «strategy» aún no está conectada a ninguna otra tabla. Esto cambiará en cuanto empecemos a realizar backtesting u operar con esta nueva versión del Asesor Experto, momento en el que se conectará a la tabla «trade». Una vez más, dado que estamos trabajando de abajo hacia arriba, modificaremos nuestra base de datos cuando, y solo cuando, sea necesario. Por ahora, la tabla «strategy» no es más que una interfaz, un medio de comunicación entre nuestro análisis de datos y nuestros entornos de trading.
La base de datos servirá de interfaz entre nuestro análisis de datos y nuestro Asesor Experto de trading, así como entre nuestro proceso de selección —la aplicación de nuestro análisis de datos— y el EA. El flujo será más o menos así:
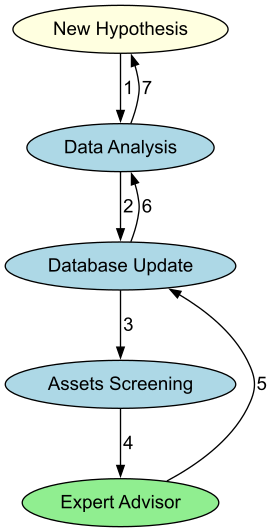
Figura 3. El diagrama de flujo ilustra el aspecto circular de nuestro proceso de arbitraje estadístico
La parte de Python
Hemos pasado de utilizar cuadernos de Jupyter individuales para cada tarea a un script de Python unificado que ejecuta un proceso completo de arbitraje estadístico para acciones cointegradas. Este script hará lo siguiente:
Comprobará si existe la base de datos SQLite.
def CheckForDb(db_path: str | Path) -> bool:
    """Return True if the SQLite database file exists on disk."""
    exists = Path(db_path).is_file()
    logger.info("Database exists: %s (%s)", exists, db_path)
    return exists
Creará una base de datos si no encuentra ninguna. Esto resulta muy práctico si usted no está siguiendo esta serie y solo quiere experimentar con el proceso de arbitraje estadístico. Lo único que tiene que hacer es proporcionar el esquema de la base de datos, que se adjunta aquí.
def CreateDbIfMissing(db_path: str | Path, schema_path: Optional[str | Path] = None) -> None:
    """
    If the database does not exist and a schema is provided, create it from SQL.
    Otherwise, create an empty file (SQLite creates DB on first connection).
    """
    db_path = Path(db_path)
    if db_path.exists():
        logger.info("DB already present: %s", db_path)
        return
    logger.info("DB missing; creating: %s", db_path)

    with sqlite3.connect(db_path) as conn:
        if schema_path:
            schema_sql = Path(schema_path).read_text(encoding="utf-8")
            conn.executescript(schema_sql)
            logger.info("Applied schema from: %s", schema_path)
Se conectará al terminal de MetaTrader 5.
def InitMT5(login: Optional[int] = None, password: Optional[str] = None,
            server: Optional[str] = None, path: Optional[str] = None) -> None:

    """Initialize connection to the running MetaTrader 5 terminal."""

    if mt5 is None:
        raise RuntimeError("MetaTrader5 package not available.")

    # if not mt5.initialize(path=path, login=login, password=password, server=server):
    if not mt5.initialize():
        raise RuntimeError(f"MT5 initialize() failed: {mt5.last_error()}")
    logger.info("MetaTrader5 initialized.")
Descargará datos de mercado desde MetaTrader 5.
def DownloadMarketData(symbols: List[str], timeframes: List[str], bars: int = 5000
                       ) -> Dict[Tuple[str, str], pd.DataFrame]:
    """
    Download OHLCV data from MT5 for each (symbol, timeframe).
    Returns dict with keys (symbol, timeframe) -> DataFrame columns:
    ['tstamp','timeframe','open','high','low','close','tick_volume','real_volume','spread']
    """
    if mt5 is None:
        raise RuntimeError("MetaTrader5 package not available.")
    out: Dict[Tuple[str, str], pd.DataFrame] = {}

    for sym in symbols:
        for tf in timeframes:
            tf_const = _mt5_timeframe_constant(tf)
            rates = mt5.copy_rates_from_pos(sym, tf_const, 0, bars)

            if rates is None or len(rates) == 0:
                logger.warning("No data for %s %s", sym, tf)
                continue

            df = pd.DataFrame(rates)

            # Rename & select
            df = df.rename(columns={
                "time": "tstamp",
                "open": "price_open",
                "high": "price_high",
                "low": "price_low",
                "close": "price_close",
                "real_volume": "real_volume",
            })

            df["timeframe"] = tf

            cols = ["tstamp","timeframe","price_open","price_high","price_low","price_close",
                    "tick_volume","real_volume","spread"]
            df = df[cols].copy()
            out[(sym, tf)] = df
            logger.info("Downloaded %d bars for %s %s", len(df), sym, tf)
    return out
Almacenará estos datos de mercado en la base de datos SQLite.
def StoreMarketData(db_path: str | Path, data: Dict[Tuple[str, str], pd.DataFrame]) -> None:

    """Upsert market data into SQLite according to the provided schema."""
    with sqlite3.connect(db_path) as conn:
        for (sym, tf), df in data.items():
            symbol_id = _ensure_symbol(conn, sym)

            df = df.copy()
            df["symbol_id"] = symbol_id

            # Use executemany for performance
            sql = """
            INSERT OR REPLACE INTO market_data
            (tstamp, timeframe, price_open, price_high, price_low, price_close,
             tick_volume, real_volume, spread, symbol_id)
            VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?, ?)
            """

            rows = list(df[["tstamp","timeframe","price_open","price_high","price_low","price_close",
                            "tick_volume","real_volume","spread","symbol_id"]].itertuples(index=False, name=None))
            conn.executemany(sql, rows)
            conn.commit()

            logger.info("Stored %d rows for %s %s", len(rows), sym, tf)
Comprobará la correlación de Pearson para los símbolos seleccionados.
def RunCorrelationTest(prices: pd.DataFrame, plot: bool = True) -> Tuple[pd.DataFrame, Tuple[str, str], float]:

    """Compute Pearson correlation matrix and return the most correlated pair (off-diagonal)."""
    corr = prices.corr(method="pearson")

    # Mask diagonal, find max
    corr_values = corr.where(~np.eye(len(corr), dtype=bool))
    idxmax = np.unravel_index(np.nanargmax(corr_values.values), corr_values.shape)
    symbols = corr.columns.tolist()
    pair = (symbols[idxmax[0]], symbols[idxmax[1]])
    value = corr_values.values[idxmax]

    logger.info("Most correlated pair: %s ~ %s (r=%.4f)", pair[0], pair[1], value)

    if plot:
        plt.figure(figsize=(10, 7))
        sns.heatmap(corr, annot=False, vmin=-1, vmax=1, cmap="coolwarm", square=True)
        plt.title("Pearson Correlation Heatmap")
        plt.tight_layout()
        plt.show()

    print(f"Most correlated pair: {pair[0]} ~ {pair[1]} (r={value:.4f})")

    return corr, pair, float(value)
Calculará el coeficiente de cointegración de Engle-Granger para los símbolos seleccionados y mostrará el par con mayor cointegración.
def RunEngleGrangerTest(prices: pd.DataFrame, plot: bool = True ) -> Tuple[Tuple[str, str], float, float, pd.Series]: """ Loop over all symbol pairs, run statsmodels.coint (Engle-Granger). Return: best_pair, best_pvalue, hedge_ratio (y_on_x), spread series (y - beta*x) """ best_pair, best_p, best_beta, best_spread = None, 1.0, np.nan, None cols = list(prices.columns) for y_sym, x_sym in itertools.combinations(cols, 2): y = prices[y_sym].dropna() x = prices[x_sym].dropna() join = pd.concat([y, x], axis=1).dropna() if len(join) < 50: continue score, pvalue, _ = coint(join.iloc[:,0], join.iloc[:,1]) if pvalue < best_p: beta = _ols_hedge_ratio(join.iloc[:,0], join.iloc[:,1]) spread = join.iloc[:,0] - beta * join.iloc[:,1] best_pair, best_p, best_beta, best_spread = (y_sym, x_sym), pvalue, beta, spread if best_pair is None: raise ValueError("No cointegrated pairs found (Engle-Granger) with sufficient data.") print(f"Most cointegrated pair (Engle-Granger): {best_pair[0]} ~ {best_pair[1]} (p={best_p:.6f}, beta={best_beta:.4f})") if plot: fig, ax = plt.subplots(figsize=(10, 5)) ax.plot(prices.index, prices[best_pair[0]], label=best_pair[0]) ax.plot(prices.index, prices[best_pair[1]]*best_beta, label=f"{best_pair[1]} * beta") ax.set_title(f"Best EG Pair Overlay (beta={best_beta:.4f})") ax.legend() fig.tight_layout() plt.show()fig2, ax2 = plt.subplots(figsize=(10, 4)) ax2.plot(best_spread.index, best_spread.values, label="Spread") ax2.axhline(0, line) ax2.set_title("Spread (y - beta*x)")
ax2.legend() fig2.tight_layout()
plt.show()
return best_pair, float(best_p), float(best_beta), best_spread
Ejecutará las pruebas de estacionariedad (ADF y KPSS) sobre el spread de Engle-Granger.
def RunADFTest(series: pd.Series) -> Tuple[float, float, dict]:
    """Augmented Dickey-Fuller test on a univariate series."""
    series = pd.Series(series).dropna()
    adf_stat, pvalue, usedlag, nobs, crit, icbest = adfuller(series, autolag="AIC")

    print(f"ADF: stat={adf_stat:.4f}, p={pvalue:.6f}, lags={usedlag}, nobs={nobs}, crit={crit}")

    return float(adf_stat), float(pvalue), crit
def RunKPSSTest(series: pd.Series, regression: str = "c") -> Tuple[float, float, dict]:

    """KPSS stationarity test on a univariate series (regression='c' or 'ct')."""
    series = pd.Series(series).dropna()
    stat, pvalue, lags, crit = kpss(series, regression=regression, nlags="auto")

    print(f"KPSS({regression}): stat={stat:.4f}, p={pvalue:.6f}, lags={lags}, crit={crit}")

    return float(stat), float(pvalue), crit
Verificará la cointegración de Johansen (con ponderaciones de la cartera correspondientes al primer vector propio cuando el rango sea >= 1).
def RunJohansenTest(prices: pd.DataFrame, det_order: int = 0, k_ar_diff: int = 1, plot: bool = True
                    ) -> Tuple[int, np.ndarray, np.ndarray, Optional[pd.Series]]:
    """
    Johansen cointegration test on a set of symbols (>=2).
    Returns: (rank, eigenvectors (beta), eigenvalues, spread_from_first_vector or None)
    - Significant rank determined by trace statistics vs 95% critical values.
    - First eigenvector provides portfolio weights (normalized s.t. min(|w|)=1 or w[-1]=1).
    """

    data = prices.dropna().values

    if data.shape[1] < 2:
        raise ValueError("Johansen requires at least two series.")

    joh = coint_johansen(data, det_order, k_ar_diff)

    # Significant rank by trace statistic > crit value (95% = column index 1)
    trace_stats = joh.lr1  # trace stats
    crit_vals = joh.cvt[:, 1]  # 95%
    rank = int(np.sum(trace_stats > crit_vals))
    print("Johansen trace stats:", trace_stats)

    print("Johansen 95% crit vals:", crit_vals)

    print(f"Johansen inferred rank: {rank}")

    weights = None
    spread = None

    if rank >= 1:

        # Beta columns are cointegrating vectors; take the first (associated with largest eigenvalue)
        beta = joh.evec  # shape (k, k)
        eigvals = joh.eig  # shape (k,)

        # Sort by eigenvalue desc to be explicit
        order = np.argsort(eigvals)[::-1]
        beta_sorted = beta[:, order]
        eig_sorted = eigvals[order]
        first_vec = beta_sorted[:, 0]

        # Normalize such that the weight of the last symbol is 1 (common in practice)
        if first_vec[-1] == 0:
            norm = np.max(np.abs(first_vec))
        else:
            norm = first_vec[-1]

        weights = first_vec / norm

        print("First Johansen eigenvector (portfolio weights):")

        for sym, w in zip(prices.columns, weights):
            print(f"  {sym:>12s}: {w:+.6f}")

        # Spread = P * weights
        spread = pd.Series(prices.values @ weights, index=prices.index, name="JohansenSpread")

        if plot:
            fig, ax = plt.subplots(figsize=(10, 4))
            ax.plot(spread.index, spread.values, label="Johansen Spread")
            ax.axhline(0, linestyle="--")
            ax.set_title("Johansen Spread (1st eigenvector)")
            ax.legend()
            fig.tight_layout()

            plt.show()

        return rank, beta_sorted, eig_sorted, spread, weights

    return rank, joh.evec, joh.eig, weights, None
Si algún rango de la prueba de cointegración de Johansen resulta estadísticamente SIGNIFICATIVO, el script también ejecutará las pruebas ADF y KPSS sobre el spread de Johansen y, por último, guardará los parámetros de la estrategia (símbolos, ponderaciones y marco temporal) en la tabla «strategy», tal como se ha mencionado en la sección anterior.
def StoreJohansenStrategy(db_path: str | Path, name: str, symbols: List[str],
                          weights: np.ndarray, timeframe: str) -> None:
    """
    Store Johansen eigenvector (portfolio weights) and symbols into the strategy table.
    Symbols and weights are stored as JSON arrays (text).
    """

    import json

    with sqlite3.connect(db_path) as conn:
        cur = conn.cursor()
        cur.execute("""
            INSERT OR REPLACE INTO strategy (name, symbols, weights, timeframe)
            VALUES (?, ?, ?, ?)
        """, (
            name,
            json.dumps(symbols),
            json.dumps([float(w) for w in weights]),
            timeframe
        ))
        conn.commit()

    logger.info("Stored Johansen strategy '%s' with symbols=%s timeframe=%s",
                name, symbols, timeframe)
Para mayor comodidad, detendrá la ejecución y trazará el gráfico en cada sección relevante (por ejemplo, los spreads), de modo que usted pueda valorar fácilmente si merece la pena realizar una evaluación más detallada de los símbolos seleccionados y, si procede, modificar el orden de la lista (para Engle-Granger) o el marco temporal. El script es una herramienta para el cribado manual de activos antes de que tengamos un proceso totalmente automatizado en la siguiente fase. Cada tarea está encapsulada en una función independiente, por lo que usted puede importarlas fácilmente a otros scripts.
ADVERTENCIA: Este script es el punto de entrada de nuestro sistema. Justo después de definir aquí una nueva lista de símbolos, debe insertarla en el servicio «db-update». De este modo, se asegurará de que su base de datos se actualice a un ritmo moderado, incluso si su Asesor Experto no está en ejecución por cualquier motivo. Por el momento, este paso debe realizarse manualmente.
Para ejecutar el script, llámelo desde la línea de comandos con los parámetros correspondientes. Por ejemplo:
PS C:\Users\your\path\to\JupyterNotebooks\StatArb\coint> python py/stat_arb_pipeline_mt5.py --db $env:STATARB_DB_PATH --schema sql/schema-0.2.sql --symbols "MU,NVDA,MPWR,MCHP" --timeframes "D1" --bars 1000 --run
Como podemos ver, estamos utilizando variables de entorno para el parámetro de ruta de la base de datos. Si todo va bien, debería ver algo parecido a esto cuando NO HAY COINTEGRACIÓN según la prueba de Johansen.
2025-09-03 15:35:24,588 [INFO] La base de datos existe: True (C:\Users\your\path\to\MQL5\Files\StatArb\statarb-0.2.db)
2025-09-03 15:35:24,589 [INFO] Se utiliza la base de datos existente en C:\Users\your\path\to\MQL5\Files\StatArb\statarb-0.2.db.
2025-09-03 15:35:24,605 [INFO] MetaTrader 5 inicializado.
2025-09-03 15:35:24,613 [INFO] Se han descargado 1000 barras para MU D1
2025-09-03 15:35:24,618 [INFO] Se han descargado 1000 barras para NVDA D1
2025-09-03 15:35:24,625 [INFO] Se han descargado 1000 barras para MPWR D1
2025-09-03 15:35:24,633 [INFO] Se han descargado 1000 barras para MCHP D1
2025-09-03 15:35:24,997 [INFO] Se han almacenado 1000 filas para MU D1
2025-09-03 15:35:25,261 [INFO] Se han almacenado 1000 filas para NVDA D1
2025-09-03 15:35:25,514 [INFO] Se han almacenado 1000 filas para MPWR D1
2025-09-03 15:35:25,870 [INFO] Se han almacenado 1000 filas para MCHP D1
2025-09-03 15:35:25,871 [INFO] MetaTrader 5 cerrado.
2025-09-03 15:35:25,961 [INFO] ReadMarketData: marco temporal D1, 1000 filas, 4 símbolos
2025-09-03 15:35:25,964 [INFO] Par con mayor correlación: MPWR ~ NVDA (r=0.8335)
Par con mayor correlación: MPWR ~ NVDA (r=0.8335)
Par más cointegrado (Engle-Granger): MPWR ~ MU (p=0.010558, beta=5.4940)
ADF y KPSS sobre el spread de Engle-Granger:
ADF: stat=-3.8778, p=0.002204, lags=16, nobs=983, crit={'1%': np.float64(-3.4370198458812156), '5%': np.float64(-2.864484708707697), '10%': np.float64(-2.568337912084273)}
C:\Users\your\path\to\JupyterNotebooks\StatArb\coint\py\stat_arb_pipeline_mt5.py:321: InterpolationWarning: El estadístico de prueba se encuentra fuera del rango de valores p disponibles en la tabla de referencia. El valor p real es menor que el valor p devuelto.
stat, pvalue, lags, crit = kpss(series, regression=regression, nlags="auto")
KPSS(c): stat=0.9279, p=0.010000, lags=19, crit={'10%': 0.347, '5%': 0.463, '2.5%': 0.574, '1%': 0.739}
Prueba de Johansen con todos los símbolos proporcionados:
Estadísticos de la traza de Johansen: [34.26486877 18.91156161 8.04865462 0.11018312]
Valores críticos de Johansen al 95 %: [47.8545 29.7961 15.4943 3.8415]
Rango inferido por Johansen: 0
Como se ha mencionado anteriormente, cuando el rango de Johansen es SIGNIFICATIVO (≥1), es decir, cuando existe al menos un vector cointegrado entre los símbolos seleccionados, el script almacenará los valores del primer vector propio (ponderaciones de la cartera) en la base de datos, en la «tabla de estrategias». Además, realizará las pruebas ADF y KPSS sobre el spread.
PS C:\Users\your\path\to\JupyterNotebooks\StatArb\coint> python py/stat_arb_pipeline_mt5.py --db $env:STATARB_DB_PATH --schema sql/schema-0.2.sql --symbols "MU,NVDA,MPWR,MCHP" --timeframes "H4" --bars 90 --run
En este caso, debería ver algo parecido a esto en su Windows PowerShell o Terminal:
2025-09-03 15:50:43,168 [INFO] La base de datos existe: True (C:\Users\your\path\to\MQL5\Files\StatArb\statarb-0.2.db)
2025-09-03 15:50:43,169 [INFO] Se utiliza la base de datos existente en C:\Users\your\path\to\Files\StatArb\statarb-0.2.db.
2025-09-03 15:50:43,188 [INFO] MetaTrader 5 inicializado.
2025-09-03 15:50:44,297 [INFO] Se han descargado 90 barras para MU H4
2025-09-03 15:50:44,357 [INFO] Se han descargado 90 barras para NVDA H4
2025-09-03 15:50:46,322 [INFO] Se han descargado 90 barras para MPWR H4
2025-09-03 15:50:46,732 [INFO] Se han descargado 90 barras para MCHP H4
2025-09-03 15:50:49,148 [INFO] Se han almacenado 90 filas para MU H4
2025-09-03 15:50:49,160 [INFO] Se han almacenado 90 filas para NVDA H4
2025-09-03 15:50:49,171 [INFO] Se han almacenado 90 filas para MPWR H4
2025-09-03 15:50:49,276 [INFO] Se han almacenado 90 filas para MCHP H4
2025-09-03 15:50:49,277 [INFO] MetaTrader 5 cerrado.
2025-09-03 15:50:49,617 [INFO] ReadMarketData: marco temporal H4, 90 filas, 4 símbolos
2025-09-03 15:50:49,622 [INFO] Par con mayor correlación: MPWR ~ NVDA (r=0.6115)
Par con mayor correlación: MPWR ~ NVDA (r=0.6115)
Par más cointegrado (Engle-Granger): MU ~ NVDA (p=0.072055, beta=-0.2391)
ADF y KPSS sobre el spread de Engle-Granger:
ADF: stat=-3.1693, p=0.021831, lags=0, nobs=89, crit={'1%': np.float64(-3.506057133647011), '5%': np.float64(-2.8946066061911946), '10%': np.float64(-2.5844100201994697)}
C:\Users\your\path\to\JupyterNotebooks\StatArb\coint\py\stat_arb_pipeline_mt5.py:321: InterpolationWarning: El estadístico de prueba se encuentra fuera del rango de valores p disponibles en la tabla de referencia. El valor p real es mayor que el valor p devuelto.
stat, pvalue, lags, crit = kpss(series, regression=regression, nlags="auto")
KPSS(c): stat=0.1793, p=0.100000, lags=5, crit={'10%': 0.347, '5%': 0.463, '2.5%': 0.574, '1%': 0.739}
Prueba de Johansen con todos los símbolos proporcionados:
Estadísticas de la traza de Johansen: [63.23695088 32.35462044 16.63904745 5.4295422 ]
Valores críticos de Johansen al 95 %: [47.8545 29.7961 15.4943 3.8415]
Rango inferido por Johansen: 4
Primer vector propio de Johansen (ponderaciones de la cartera):
MCHP: +0.273652
MPWR: -0.148092
MU: +2.256498
NVDA: +1.000000
ADF y KPSS sobre el spread de Johansen:
ADF: stat=-4.1427, p=0.000823, lags=1, nobs=88, crit={'1%': np.float64(-3.506944401824286), '5%': np.float64(-2.894989819214876), '10%': np.float64(-2.584614550619835)}
KPSS(c): stat=0.4009, p=0.076784, lags=4, crit={'10%': 0.347, '5%': 0.463, '2.5%': 0.574, '1%': 0.739}
3 de septiembre de 2025, 15:50:50,051
[INFO] Estrategia de Johansen 'Nasdaq_NVDA_Coint' guardada con symbols=['MCHP', 'MPWR', 'MU', 'NVDA'] timeframe=H4
¿Qué hay de las advertencias sobre la interpolación mencionadas anteriormente?
Esas advertencias de interpolación están relacionadas con la prueba de estacionariedad KPSS aplicada al spread de Engle-Granger. Nos están indicando que hemos obtenido resultados extremos, fuera de la tabla de referencia de la prueba. Las advertencias simplemente nos indican que nuestro spread de Engle-Granger es
- fuertemente estacionario (valor p superior al valor p devuelto)
- o fuertemente no estacionario (un valor p inferior al valor p devuelto)
Por ahora podemos ignorar estas advertencias sin problema, mientras nos ocupamos de las actualizaciones en tiempo real de los parámetros de nuestro modelo. Las veremos en detalle en el siguiente paso, cuando abordemos nuestro proceso de selección de activos.
La parte de MQL5
Solo hemos dejado los controladores de eventos del EA en el archivo principal. El resto de funciones se han trasladado al archivo de cabecera Nasdaq_NVDA_Coint.mqh.
Anteriormente, los parámetros de la estrategia estaban codificados de forma fija. Ahora son variables globales.
// Global variables
string symbols[] = {}; // Asset symbols
double weights[] = {}; // Portfolio weights
ENUM_TIMEFRAMES timeframe = PERIOD_CURRENT; // Strategy cointegrated timeframe
Estas variables globales se comprueban directamente en el controlador de eventos OnInit().
//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+

int OnInit()
  {
   ResetLastError();

// Check if all symbols are available
   for(int i = 0; i < ArraySize(symbols); i++)
     {
      if(!SymbolSelect(symbols[i], true))
        {
         Print("Error: Symbol ", symbols[i], " not found!");
         return(INIT_FAILED);
        }
     }
// Initialize spread buffer
   ArrayResize(spreadBuffer, InpLookbackPeriod);

// Set a timer for spread, mean, and stdev calculations
   EventSetTimer(InpUpdateFreq * 60); // min one minute

// Load strategy parameters from database
   if(!LoadStrategyFromDB(InpDbFilename,
                                InpStrategyName,
                                symbols,
                                weights,
                                timeframe))
     {
      // Handle error - maybe use default values
      printf("Error at " + __FUNCTION__ + " %s ",
             getUninitReasonText(GetLastError()));
      return INIT_FAILED;
     }
   return(INIT_SUCCEEDED);
  }
La función LoadStrategyFromDB() se encuentra en el archivo de cabecera.
//+------------------------------------------------------------------+
//|          Load strategy parameter from database                   |
//+------------------------------------------------------------------+

bool LoadStrategyFromDB(string db_name,
                        string strat_name,
                        string &symbols_arr[],
                        double &weights_arr[],
                        ENUM_TIMEFRAMES &tf)
  {

// Open the database (Metatrader's integrated SQLite)
   int db = DatabaseOpen(db_name, DATABASE_OPEN_READONLY);
   if(db == INVALID_HANDLE)
     {
      Print("Failed to open database: %s", GetLastError());
      return false;
     }
// Prepare the SQL query with json_extract
   string query = StringFormat(
                     "SELECT "
                     "json_extract(symbols, '$') as symbols_json, "
                     "json_extract(weights, '$') as weights_json, "
                     "timeframe "
                     "FROM strategy WHERE name = '%s'",
                     strat_name
                  );

// Execute the query
   int result = DatabasePrepare(db, query);

   if(result <= 0)
     {
      Print("Failed to prepare query: ", GetLastError());
      DatabaseClose(db);
      return false;
     }

// Read the results
   if(DatabaseRead(result))
     {
      // Get symbols_arr JSON array and parse it
      string symbolsJson;
      DatabaseColumnText(result, 0, symbolsJson);
      ParseJsonArray(symbolsJson, symbols_arr);

      // Get weights_arr JSON array and parse it
      string weightsJson;
      DatabaseColumnText(result, 1, weightsJson);
      ParseJsonDoubleArray(weightsJson, weights_arr);

      // Get tf string and convert to ENUM_TIMEFRAMES
      string timeframeStr;
      DatabaseColumnText(result, 2, timeframeStr);
      tf = StringToTimeframe(timeframeStr);

      Print("Successfully loaded strategy: ", strat_name);

      Print("Symbols JSON: ", symbolsJson);
      Print("Weights JSON: ", weightsJson);
      Print("Timeframe: ", timeframeStr);
     }
   else
     {
      Print("Strategy not found: ", strat_name);

      DatabaseFinalize(result);
      DatabaseClose(db);
      return false;
     }
// Clean up

   DatabaseFinalize(result);
   DatabaseClose(db);
   return true;
  }
Como se ha mencionado anteriormente, leeremos los arrays de símbolos y de ponderaciones de la cartera con la función json_extract() de SQLite. Tiene la siguiente firma:
json_extract(json, path)
Donde:
- «json» es la columna de texto o cadena que contiene los datos JSON
- «path» es una expresión de ruta JSON que especifica la ubicación del valor que se va a extraer dentro del JSON. Normalmente comienza con «$» para representar la raíz del documento JSON, seguido de la notación de puntos para las claves de los objetos ($.key) o de la notación entre corchetes para los índices de los arrays ($[index]). Esta última forma es la que estamos utilizando aquí para leer los datos del array.
Las dos funciones auxiliares analizan los arrays JSON. Estas funciones gestionan el formato JSON eliminando los corchetes y las comillas y, a continuación, separando los elementos por comas.
ParseJsonArray()
analiza arrays de cadenas JSON como ["MU", "NVDA", "MPWR", "MCHP"]
// Helper function to parse JSON array of strings
void ParseJsonArray(string json, string &array[])
  {
// Remove brackets and quotes from JSON array
   string cleaned = StringSubstr(json, 1, StringLen(json) - 2); // Remove [ and ]
   StringReplace(cleaned, "\"", ""); // Remove quotes

// Split by commas
   StringSplit(cleaned, ',', array);

// Trim whitespace from each element
   for(int i = 0; i < ArraySize(array); i++)
     {
      array[i] = StringTrim(array[i]);
     }
  }
ParseJsonDoubleArray()
analiza arrays de números JSON como [2.699439, 1.000000, -1.877447, -2.505294]
// Helper function to parse JSON array of doubles
void ParseJsonDoubleArray(string json, double &array[])
  {
// Remove brackets from JSON array
   string cleaned = StringSubstr(json, 1, StringLen(json) - 2); // Remove [ and ]

// Split by commas
   string stringArray[];
   int count = StringSplit(cleaned, ',', stringArray);

// Convert to double array
   ArrayResize(array, count);

   for(int i = 0; i < count; i++)
     {
      array[i] = StringToDouble(StringTrim(stringArray[i]));
     }
  }
Se ha añadido la función
StringTrim()
función para eliminar cualquier espacio en blanco que pueda aparecer en los valores JSON.
// Helper function to trim whitespace
string StringTrim(string str)
  {

// Trim leading whitespace
   while(StringLen(str) > 0 && str[0] == ' ')
     {
      str = StringSubstr(str, 1);
     }

// Trim trailing whitespace
   while(StringLen(str) > 0 && str[StringLen(str) - 1] == ' ')
     {
      str = StringSubstr(str, 0, StringLen(str) - 1);
     }

   return str;
  }
En MQL5 Codebase hay bibliotecas JSON. Si su uso de objetos JSON se vuelve más intensivo, quizá merezca la pena buscarlas y evaluar sus ventajas. En este caso sencillo, creo que las ventajas no compensan el hecho de tener que depender de un componente externo.
La función auxiliar
StringToTimeframe()
convierte la cadena de marco temporal de la base de datos en el valor ENUM_TIMEFRAMES correspondiente de MQL5.
// Helper function to convert tf string to ENUM_TIMEFRAMES
ENUM_TIMEFRAMES StringToTimeframe(string tfStr)
  {
   if(tfStr == "M1")
      return PERIOD_M1;
   if(tfStr == "M2")
      return PERIOD_M2;
.
.
.
   if(tfStr == "MN1")
      return PERIOD_MN1;
   return PERIOD_CURRENT; // Default if not found
  }
Además de comprobar el parámetro de la estrategia en OnInit(), que se llama al iniciar o reiniciar el Asesor Experto, también llamamos a la misma función a intervalos regulares en el controlador de eventos OnTimer(). Este intervalo de tiempo es un parámetro de entrada del usuario.
// Set a timer for spread, mean, and stdev calculations
// and strategy parameters update (check DB)
   EventSetTimer(InpUpdateFreq * 60); // min one minute

void OnTimer(void)
  {
   ResetLastError();
// Wrapper around LoadStrategyFromDB: for clarity
   if(!UpdateModelParams(InpDbFilename,
                         InpStrategyName,
                         symbols,
                         weights,
                         timeframe))
     {
      printf("%s failed: %s", __FUNCTION__, GetLastError());
     }
UpdateModelParams() no es más que una función envoltorio de LoadStrategyFromDB().
//+------------------------------------------------------------------+
//|          Wrapper to load strategy from db                        |
//+------------------------------------------------------------------+

// Load strategy parameters from database
bool UpdateModelParams(string db_name,
                       string strat_name,
                       string &symbols_arr[],
                       double &weights_arr[],
                       ENUM_TIMEFRAMES tf)
  {
   return LoadStrategyFromDB(db_name, strat_name, symbols_arr, weights_arr, tf);
  }
Esto aclara el propósito de la función.
Conclusión
Una cesta bien equilibrada de acciones cointegradas para estrategias de reversión a la media debe tener sus ponderaciones de cartera actualizadas continuamente. En este artículo hemos visto que siempre podemos disponer de parámetros de estrategia actualizados, incluidos los propios símbolos de la cesta.
Hemos descrito cómo podemos utilizar la base de datos SQLite integrada en MetaTrader 5 como una especie de interfaz entre nuestro análisis de datos y nuestro entorno de trading, manteniendo al mismo tiempo estas dos actividades desacopladas.
Para facilitar las cosas a aquellos lectores que quizá no estén siguiendo la serie, ofrecemos un script de Python unificado con un proceso completo de arbitraje estadístico para acciones cointegradas. El script realiza pruebas de correlación, cointegración y estacionariedad en una sola ejecución, y deja en la base de datos los parámetros de estrategia actualizados, listos para que el Asesor Experto los lea.
Referencias
Daniel P. Palomar (2025). Portfolio Optimization: Theory and Application. Cambridge University Press.
| Nombre del archivo | Descripción |
|---|---|
| StatArb/db-setup.mq5 | Script MQL5 para crear e inicializar la base de datos SQLite leyendo el archivo de esquema schema-0.2.sql. |
| StatArb/db-update-statarb-0.2.mq5 | Servicio MQL5 para actualizar la base de datos SQLite con las barras de precios cerradas más recientes. |
| StatArb/Nasdaq_NVDA_Coint.mql5 | Este archivo contiene el Asesor Experto de ejemplo. |
| StatArb/Nasdaq_NVDA_Coint.mqh | Este archivo contiene el archivo de cabecera del Asesor Experto de ejemplo. |
| StatArb/schema-0.2.sql | Archivo de esquema SQL (DDL) para inicializar la base de datos (crear tablas, campos y restricciones). |
| stat_arb_pipeline_mt5.py | Este script de Python ejecuta el proceso completo de arbitraje estadístico para acciones cointegradas, basado en la prueba de correlación de Pearson, la prueba de cointegración de Johansen y las pruebas de estacionariedad ADF y KPSS. |
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/19428
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Utilizando redes neuronales en MetaTrader
 Automatización de estrategias de trading en MQL5 (Parte 29): Creación de un sistema de patrón armónico de Gartley basado en la acción del precio
 Particularidades del trabajo con números del tipo double en MQL4
 Automatización de estrategias de trading en MQL5 (Parte 28): Creación de un patrón armónico «Bat» basado en la acción del precio con retroalimentación visual

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso