

グレーモデルによるトレーディング予測
 9
 0

はじめに
現代の金融市場は非常に変動が激しく、常に状況が変化しています。そのため、正確かつタイムリーな予測は、トレーディングの意思決定において重要な役割を果たします。トレーダーは皆、将来の価格変動を予測し、利益を最大化するために利用できる予測手法の開発・適用を目指しています。
テクニカル分析には、さまざまな予測手法があります。しかし、多くの予測手法にはそれぞれ限界があります。たとえば、統計的な予測手法では大量の過去データが必要になります。また、定常時系列に対してのみ有効に機能する手法もあります。
こうした背景から、限られた情報や不完全な情報を扱うことのできる予測手法への関心が高まっています。その一つがグレーモデル(GM)です。GMは、データが少ない場合や、データの信頼性が低い場合、あるいはノイズが多い場合に特に有用です。このような状況は、金融市場では珍しくありません。本記事では、GMの基本を確認するとともに、金融時系列の予測にどのように適用できるのかを見ていきます。
古典的なGM(1,1)モデル
グレーモデルは、非常に幅広い問題の解決に利用できます。GMを利用することで、時系列を分析したり、平滑化したり、価格変動の主要なトレンドを特定したりできます。また、予測にも利用できます。GMを利用する大きなメリットは、時系列の定常性に関する制約がないことです。たとえば、SMAは時系列が定常的で、値が正規分布している場合に最も効果を発揮します。時系列が非定常、つまりトレンドを持っている場合、SMAは大きく遅行してしまいます。GMでは、このような条件は重要ではなく、基本的にどのような時系列にも対応できます。少なくとも、そうであるはずです。GMに必要な条件はシンプルで、簡単に満たすことができます。
- 時系列の長さは4以上である必要がある。
- 時系列は、値がすべて正で、観測時点が等間隔で並び、欠損がない必要がある。
どのGMも、Accumulated Generating Operation(AGO:累積生成演算)を適用するところから始まります。この演算の考え方は非常に単純です。各時点の値に、それ以前のすべての値を加えて累積和を作ります。以降、このようにして得られた時系列をグレー系列(Grey Series: GS)と呼びます。例として、5つの価格を考えてみましょう。この価格系列にAGOを適用すると、次のようになります。
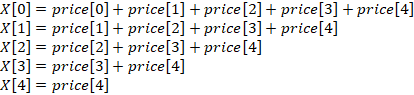
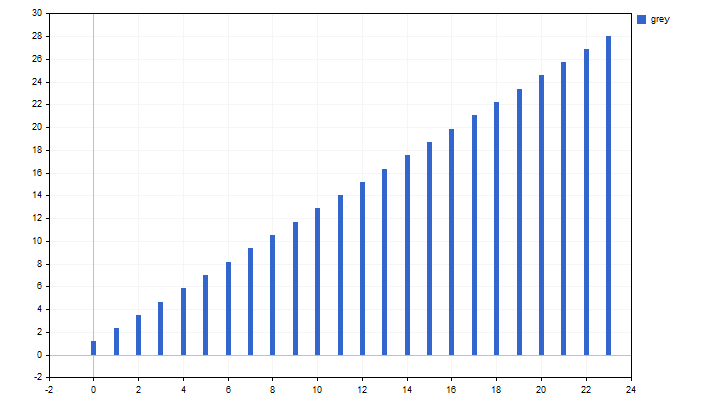
この演算には、主に2つの目的があります。第一に、ノイズの影響を低減します。第二に、新しい時系列をより予測しやすくします。新しい時系列は単調増加するため、たとえば次のような形になります。
新しい時系列の値が得られたら、GM(1,1)の構築を始めることができます。この表記では、最初の数字が微分方程式の次数を、2番目の数字が処理するGSの数を表しています。GM(1,1)モデルは、線形微分方程式で表されます。
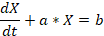
この方程式を解くには、数式処理システムが必要です。ここでは Mapleを使用します。まず元の方程式を記述し、次に初期条件を指定して解を求めます。Mapleでは、これらの操作は次のようになります。
de:=diff(x(t),t)+a*x(t)=b; #original equation
cond:=x(1)=X[1];           #initial condition
dsolve({de,cond},x(t));    #solving the equation
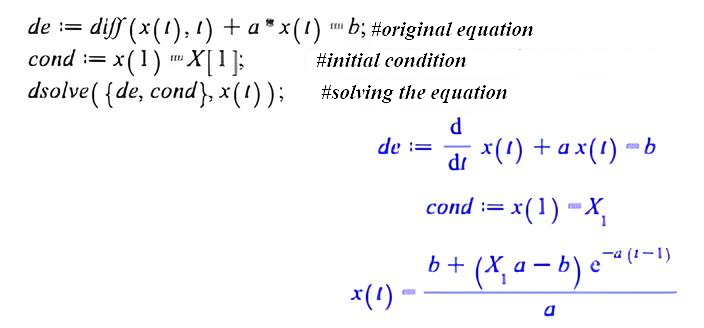
これにより、GSの時間に対する変化を表す関係式が得られました。ここで、tは時間を表すインデックスであり、過去から未来に向かって1から増加していくことに注意してください。この式から、価格変化についても同様の関係を導くことができます。
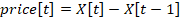
Mapleでは、この方程式の解は次のようになります。
eq:=price[t]=(b+(a*X[1]-b)*exp(-a*t))/a-(b+(a*X[1]-b)*exp(-a*(t-1)))/a;#difference between 2 consecutive GS values
simplify(eq);#simplify the result
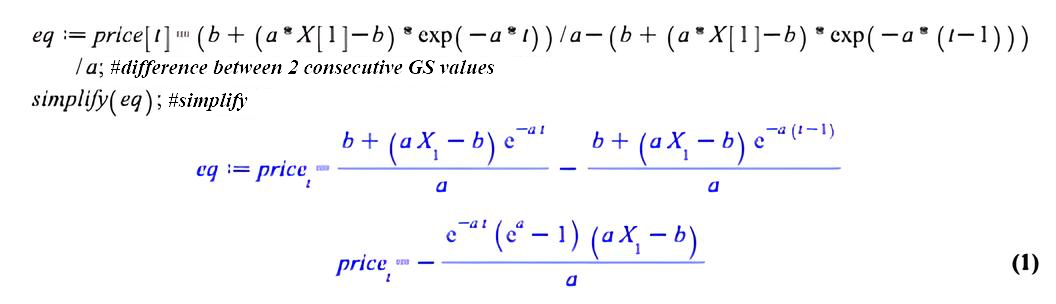
この結果を少し手作業で整理すると、最終的な式は次のようになります。
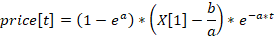
この式から、aとbのパラメータが分かれば、価格の値を推定できることが分かります。つまり、元の時系列を平滑化することができます。これらのパラメータを推定するには、微分方程式を離散化する必要があります。そのために、次の変換を使用します。
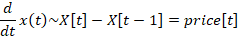
この変換によって、離散化されたバージョンが得られます。
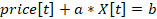
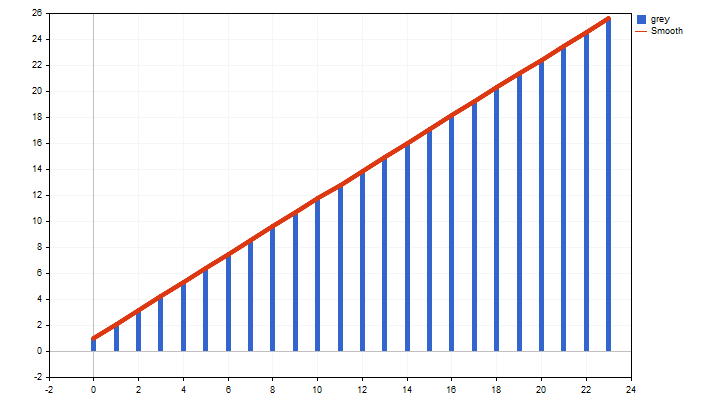
このような方程式の係数は、最小二乗法 (OLS)によって簡単に推定できます。ここからが本題です。GSの値について、平滑化された推定値を得ることができます。このような平滑化は純粋に学術的な興味を満たすものにすぎず、実用上の用途はありません。
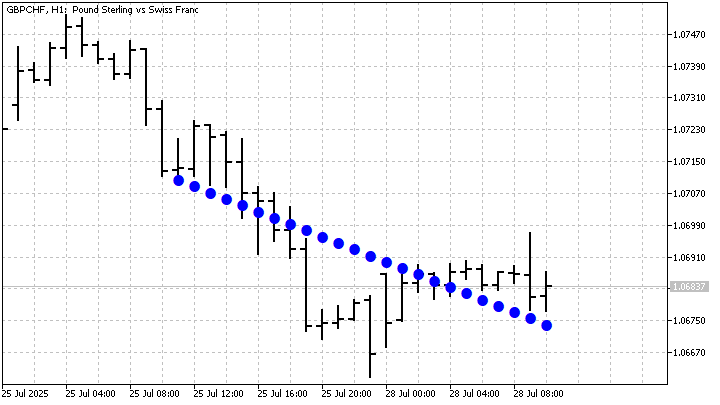
あるいは、元の時系列を直接平滑化することもできます。
ここまで来れば、次のステップに進む準備ができています。価格値を計算する式には、時間の増加量に関する制約がありません。つまり、新しい時系列を必要なだけ先まで継続して構築できます。こうすることで、価格変動の予測が得られます。もちろん、この予測は、元の時系列の特性が将来も変わらないという仮定に基づいています。ここでは5ステップ先まで予測してみます。
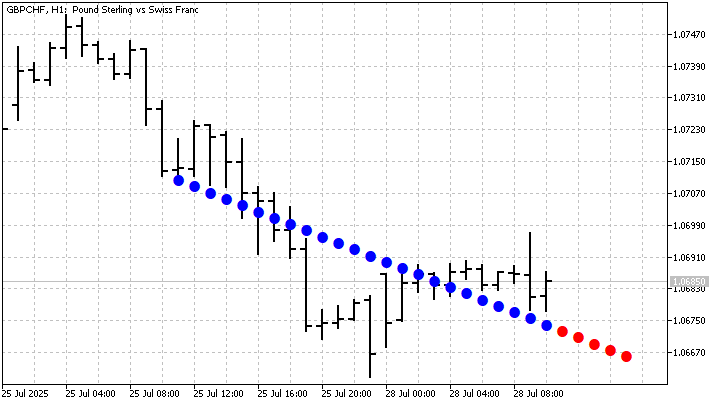
ご覧のように、このモデルは線形トレンドにはうまく対応します。しかし、その性質上、その他の重要な価格変動を捉えられない可能性があります。そこで、より複雑なGMモデルを適用し、どのように動作するのかを見てみましょう。
GM(1,1)のバリエーション
標準的なGM(1,1)を最も単純に拡張したものが、Rolling GM (RGM)です。この拡張の考え方は非常に単純です。異なる期間の複数のGMを計算し、それらの平均を求めます。この方法によって、より滑らかな価格推定値を得ることができます。予測もより滑らかになります。ここでは、期間4~24の複数のGM(1,1)からRGMを構築してみます。チャートでは次のようになります。
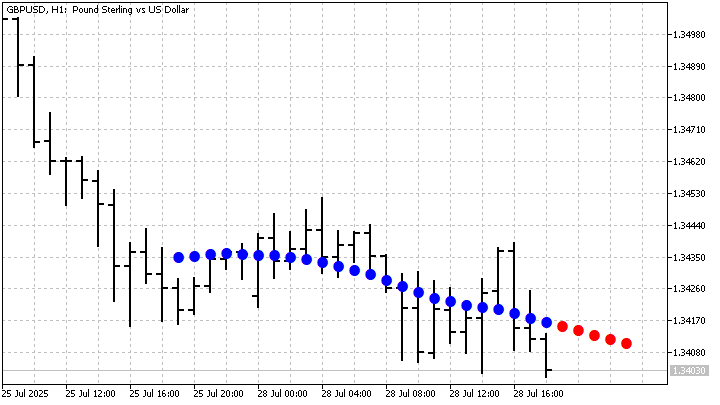
RGMはさらに変更することもできます。この変更の基本的な考え方は、それぞれのGMに独自の重みを与えることです。重みは固定値にすることも、予測誤差に応じて変化させることもできます。前者は非常に単純です。任意の基準に基づいて重みを割り当て、各モデルの加重和を求めます。

一方、重みを予測誤差に応じて変化させると、RGMの適応型バージョンが得られます。この場合、各GMの重みは次のように決定できます。まず、それぞれのGMについて個別に予測誤差を計算します。
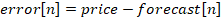
GMの重み係数はこの誤差に応じて変化します。誤差が大きいほど、重みは小さくなります。
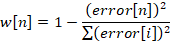
このようにすることで、RGMは価格変動に最もよく一致するトレンドを優先的に採用するようになります。その結果、予測精度が向上する可能性もあります。
さらに、元の時系列に前処理を施すという方法もあります。たとえば、価格そのものではなくSMAの値を入力として使用できます。この場合、GM(1,1)の結果はより滑らかになります。実際には、この方法を利用してトレンドの境界を特定することができます。
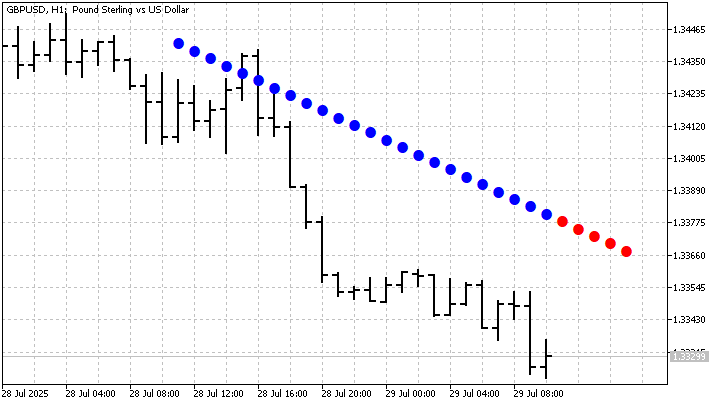
ただし、チャネルを別の方法で構築することもできます。まず、GM(1,1)のパラメータを計算します。より正確には、ここではaの成長パラメータだけが必要です。次に、それぞれの実際の価格値について、そのbパラメータを計算します。
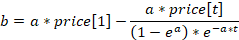
考えられるすべての値の中から、このパラメータの最大値と最小値に注目します。これらを利用することで、トレンドチャネルの上限と下限を求めることができます。
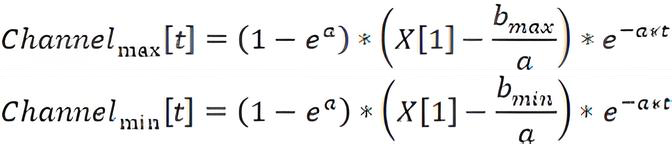
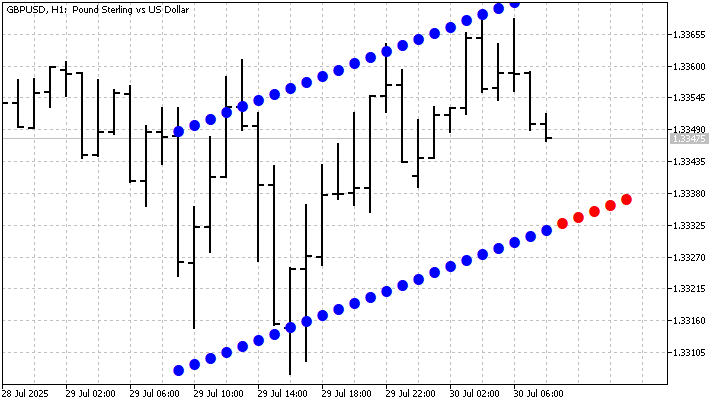
このようなチャネルは、チャート上では次のようになります。
グレーモデルには、非常に多くの異なるバリエーションがあります。中には特定の時系列にしか適用できないものもあります。一方、GM(1,1)のように汎用的に利用できるものもあります。これらのバリエーションには共通した目的があります。それは、予測精度を高め、時系列の特徴を特定することです。
離散GMモデル
微分方程式を解くことは確かに美しい方法ですが、モデルを少し複雑にしただけでも解は非常に複雑になります。さらに、モデルパラメータの推定値が数値的に不安定になる場合があります。小数点以下のかなり下位の桁にあるたった1つの誤差でも、チャートが役に立たなくなる可能性があります。
離散GMモデルには、こうした問題がありません。そこで、GM(1,1)について離散型のモデルを構築してみましょう。このモデルは、次の線形漸化式で表すことができます。
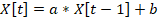
つまり、GSの現在値を1期前の値の線形関数として表します。この方程式のパラメータを推定することは難しくありません。まず、方程式のパラメータを求める必要があります。
re:=x(n+1)=a*x(n)+b; #original equation
cond:=x(1)=X[1];                  #initial condition
simplify(rsolve({re,cond},x(t))); #solving the equation
その結果、GSの値が明示的に指定された方程式を得ることができます。
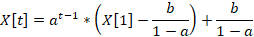
この方程式から、価格の推定値を求めることができます。
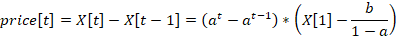
このモデルに基づくインジケータは、次のようになります。
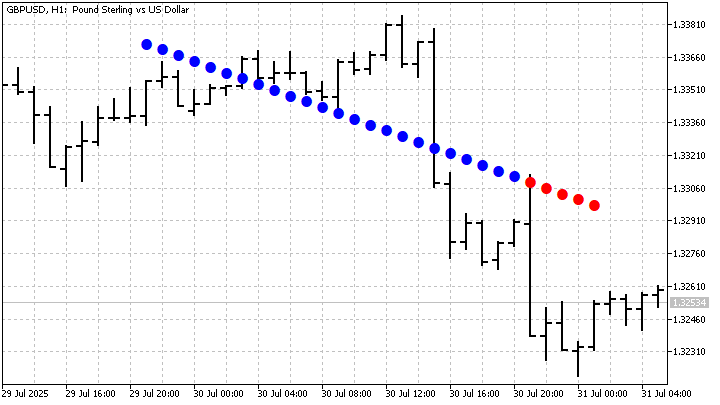
この方法はうまく機能しました。次に、GM(0,2)モデルを構築してみましょう。表記から分かるように、このモデルでは微分を使用せず、考慮する因子の数を増やしています。なお、このモデルは離散形式でのみ存在します。
このモデルでは2つのGSを使用します。モデルの期間をNとします。まず、通常どおり、インデックスN-1の価格から開始して最初のGSを構築します。2番目のGS(ここではYとします)は、1つ後ろにずらした価格系列を使用して構築します。つまり、インデックスNの価格から開始します。このモデルの方程式は次のようになります。
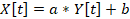
もちろん、漸化式を構築して、その解を求めることもできます。しかし、このモデルは1ステップ先の予測に限定すると、特にシンプルになります。まず、OLSを使ってモデルパラメータを推定します。X系列については、新しい価格がまだ分からないため、その先を継続することはできません。一方、Y系列については次の価格がすでに分かっているため、新しい値を求めることができます。
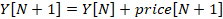
Y系列の新しい値が得られれば、X系列の将来値も推定できます。
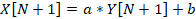
ここまでできれば、価格を予測することは難しくありません。このモデルに基づくインジケータは、次のようになります。
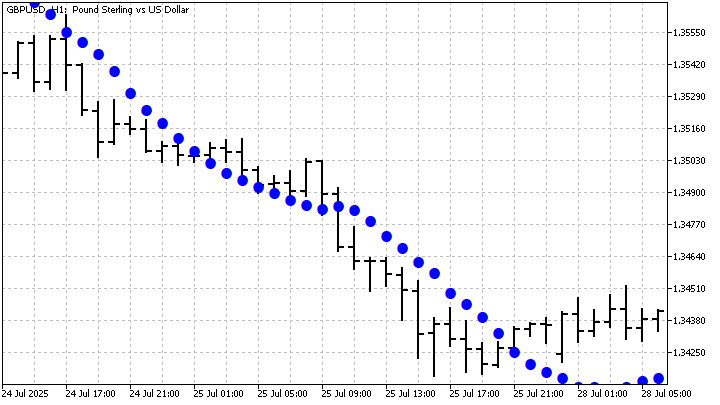
GM(0,2)モデルは、線形回帰に似ています。考慮するGSの数を増やすことで、モデルの柔軟性を高め、予測精度を向上させることができます。この改善は、インジケータの期間が短い場合に特に顕著になります。
ここから、離散GM(1,2)モデルの構築に進む準備ができました。このモデルは、先ほどの2つのモデルのアプローチを組み合わせたもので、次の式で表すことができます。
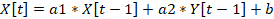
つまり、2つのGSについて同じように線形回帰を構築します。この回帰から得られたパラメータを使って、将来の価格値を推定できます。このモデルに基づくインジケータは、次のようになります。
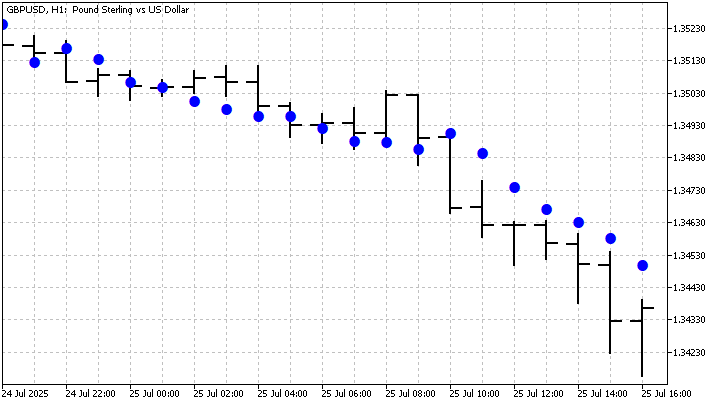
離散的なアプローチを使えば、より高次のモデルも比較的簡単に構築できます。例としてGM(2,1)モデルを考えてみます。従来の方法でこのモデルを解き、パラメータの値を求めるのは、誰にとっても簡単な作業とは限りません。しかし、このモデルを離散形式に変換すれば、方程式は次のようになります。
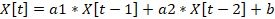
このモデルのパラメータを計算することは難しくありません。ここでも単純化のため、1カウント先の予測に限定します。チャート上では、インジケータは次のようになります。
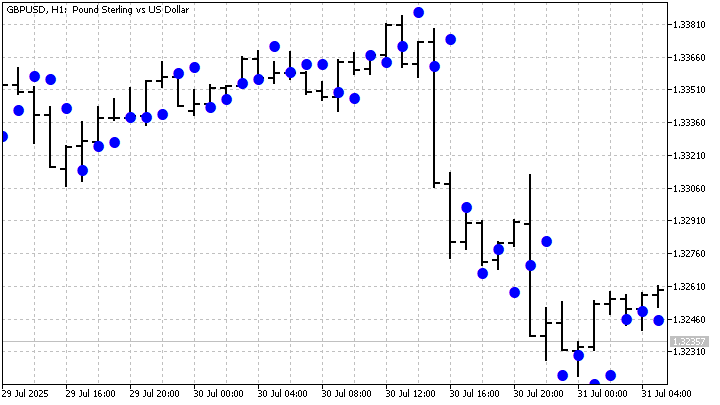
このインジケータを平滑化用とは呼べません。しかし、市場環境の変化にはかなり素早く反応します。そのため、注目する価値があります。より滑らかな結果が必要であれば、RGMの利用を検討してください。
まとめると、離散モデルは計算がシンプルであることが大きなメリットです。一方、このシンプルさには予測期間に関する制約があります。多くの場合、離散モデルが良好に機能するのは1ステップ先までです。予測期間を延ばそうとすると、モデルが不必要に複雑になり、実用上のメリットは小さくなる可能性があります。
結論
グレーモデルは、金融時系列をモデル化・記述するための有望なツールです。GMは、時系列の平滑化、トレンドの検出、将来の価格値の予測、さらにはトレンドチャネルの構築にも利用できます。
GMの大きなメリットは、外部環境に合わせてモデルを変更できる柔軟性にあります。一方で、一部のアプローチには数学的な複雑さという大きな欠点があります。いずれにしても、GMについてはさらなる研究をおこない、トレーダーにとって最も適した手法やモデルの選択肢を見極めていく必要があります。
以下のプログラムは記事に添付されています。
| 名前 | 種類 | 説明 |
|---|---|---|
| sGM | スクリプト | GM(1,1)モデルを使用してGSを構築し、平滑化する方法を示します。ScreenShotを有効にすると、画像がFilesフォルダに保存されます。 |
| GM11 | インジケータ | 標準的なGM(1,1)の動作を示します。
|
| RGM11 | インジケータ | 複数のGM(1,1)バリエーションの平均値を表示します。 |
| GM11sma | インジケータ | 価格の代わりにSMAの値を入力として使用します。 |
| GM11Ch | インジケータ | GM(1,1)に基づいてトレンドチャネルを構築します。 |
| DGM11 | インジケータ | GM(1,1)の離散バージョン |
| DGM02 | インジケータ | 2変量線形回帰に相当するモデル |
| DGM12 | インジケータ | 2つの入力因子を使用する離散GM(1,1)モデル |
| DGM21 | インジケータ | 2次モデルの離散版 |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/19012
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。
 自動売買ロボット向けリスクマネージャー(第1回):EA向けリスク管理用インクルードファイル
 初級から中級まで:ファイル内データへのランダムアクセス(I)
 量子リザバコンピューティング(QRC)回路の実装
 機械学習におけるガウス過程(第2回):MQL5での分類モデルの実装とテスト

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索