

Red neuronal en la práctica: Descenso de gradiente
 12
 0

Introducción
En el artículo anterior Red neuronal en la práctica: El caso de la puerta XOR, analizamos cómo podríamos resolver el problema o, mejor dicho, el hecho de que una sola neurona no pueda aprender a representar una puerta XOR ni su inversa, la NXOR. Aunque esa única neurona sea capaz de representar diversas situaciones, creo que quedó bastante claro que existen situaciones que una sola neurona no puede manejar, aunque aparentemente sean bastante sencillos.
Y aunque, a primera vista, pueda parecer que la neurona será capaz de representar esos mismos datos, existen situaciones en las que esto simplemente no ocurre. Este ha sido el propósito hasta ahora: mostrar que, a diferencia de lo que muchos dicen o quieren hacerte creer, hay casos en los que no podemos hacer que las cosas funcionen solo porque funcionan en un caso sencillo y específico.
Así, una neurona artificial está lejos de ser algo tan extraordinario como muchos piensan. Por sí sola, no es más que un simple cálculo matemático. Nada más. Aun así, creo que ya habrás notado que, aunque podamos forzar a una neurona artificial a representar algo, en algunos casos podemos encontrarnos con ciertos inconvenientes. Esto se debe a que, cada vez que sea necesario realizar un cambio, tendremos que modificar de algún modo la neurona para conseguir que se comporte de manera adecuada y pueda representar determinados tipos de datos. En muchas ocasiones, este tipo de situación hace completamente inviable un proyecto.
Como tú, que vienes siguiendo estos artículos sobre redes neuronales, ya habrás notado, no existe una solución definitiva. Sí existen soluciones que cubren más o menos casos, pero nunca una que sea definitiva. Esto no nos impide tomar una dirección concreta ni intentar implementar algo que haga viable el uso de neuronas artificiales.
Hay muchas cuestiones que pueden resultar más o menos confusas cuando se estudian redes neuronales, especialmente al comenzar. Lo sé porque pasé por el mismo proceso cuando empecé a aprender programación en C/C++. En aquella época, el tema no tenía tanta difusión y estaba en boca de tanta gente. A decir verdad, eran pocas las personas que hablaban sobre él, y todas se mostraban bastante escépticas al hacerlo.
A diferencia de lo que ocurre actualmente, cuando los medios de comunicación en general parecen estar insistiendo excesivamente en el tema, afirmando que las redes neuronales son esto o aquello. Y, para empeorar las cosas, muchos, especialmente los inversores, han dicho cosas que están lejos de la realidad. No estoy aquí para juzgar ni provocar polémica. Lo que quiero es compartir un poco de lo que sé, de la forma más didáctica posible. Así, al menos tendrás un punto de partida para entender un poco más sobre el tema.
Pues bien, en este artículo vamos a hacer algo un tanto diferente. Sé que muchos creen que mis artículos sobre redes neuronales forman una secuencia, cuando en realidad no es posible crear una secuencia sobre el tema. Puedes creerme: por extraño que parezca, crear una secuencia sobre redes neuronales es prácticamente imposible. Esto se debe a que, una y otra vez, tenemos que volver a los orígenes. Y el motivo es sencillo: LA HUMANIDAD NO TIENE UNA IDEA CLARA DE CÓMO DESARROLLAR ALGO ASÍ.
Lo que acabo de decir puede parecer completamente ilógico, ya que aparentemente cada día surge alguna novedad sobre el tema. Pero, en la práctica, las cosas no son exactamente así. Lo que realmente ocurre es que, una y otra vez, necesitamos volver y replantearnos lo que ya se ha hecho para intentar resolver algún problema nuevo que haya surgido.
En los artículos anteriores habrás visto que, aunque todo funcione, tenemos diversos problemas entre manos. Todos estos problemas ya se han resuelto o se están resolviendo en este preciso momento, de una forma u otra. Algunos de los problemas que puedo mencionar aquí y que ya hemos visto en estos artículos son los siguientes: cuantas más variables o parámetros tengamos que manejar, más lenta se vuelve la neurona o la red neuronal. Además, la tasa de crecimiento del consumo de recursos computacionales aumenta a medida que tenemos más y más variables que procesar. Otro problema es que no tenemos mucha flexibilidad para añadir más o menos parámetros o variables a la neurona.
Este problema puede entenderse mejor de la siguiente manera: comenzamos con una sola entrada en la neurona. Esto se hizo en los primeros artículos, donde se presentó un primer esquema de la neurona. Pero pronto fue necesario añadir una nueva entrada. Entonces, el código anterior era como el que se muestra en el siguiente fragmento:
//+------------------------------------------------------------------+
double Cost(const double w)
{
    double err;

    err = 0;
    for (uint c = 0; c < nTrain; c++)
        err += MathPow((Train[c][0] * w) - Train[c][1], 2);

    return err / nTrain;
}
//+------------------------------------------------------------------+
Pronto pasó a ser como se muestra en el fragmento siguiente:
//+------------------------------------------------------------------+
double Cost(const double w0, const double w1, const double b, const double &Train[][])
{
    double err;

    err = 0;
    for (uint c = 0; c < nTrain; c++)
        err += MathPow(((Train[c][0] * w0) + (Train[c][1] * w1) + b) - Train[c][2], 2);

    return err / nTrain;
}
//+------------------------------------------------------------------+
Observa que el código empezó a crecer y a volverse un tanto complicado. Pero, si no lo crees, quiero que pienses en lo siguiente: cada vez que la neurona incorpore una nueva variable o parámetro, tendremos que modificar el código. Como cada nuevo parámetro representa una nueva entrada, si en algún momento necesitamos utilizar mil entradas, tendremos que incluir en el código esas mismas mil variables. Y todo esto de forma manual. Piensa en el enorme trabajo manual que supondría hacerlo.
Otro problema está relacionado con la forma en que realizamos los cálculos para ajustar las variables. Es decir, con la forma en que la neurona o la red neuronal representará un determinado conjunto de datos. Esta quizá sea la cuestión que más peso tiene a la hora de decidir si se construye una implementación u otra de la neurona. Para que entiendas esto, vamos a tomar como base un código que vimos en un artículo anterior. El código en cuestión se muestra en el siguiente fragmento.
//+------------------------------------------------------------------+
double Cost(const double w0, const double w1, const double b)
{
    double err;

    err = 0;
    for (uint c = 0; c < nTrain; c++)
        err += MathPow((macroSigmoid((Train[c][0] * w0) + (Train[c][1] * w1) + b) - Train[c][2]), 2);

    return err / nTrain;
}
//+------------------------------------------------------------------+
double Cost_2(double &w0, double &w1, double &b)
{
    double err, ew0, ew1, eb;

    err = ew0 = ew1 = eb = 0;
    for (uint c = 0; c < nTrain; c++)
    {
        err += MathPow((macroSigmoid((Train[c][0] * w0) + (Train[c][1] * w1) + b) - Train[c][2]), 2);
        ew0 += MathPow((macroSigmoid((Train[c][0] * (w0 + eps)) + (Train[c][1] * w1) + b) - Train[c][2]), 2);
        ew1 += MathPow((macroSigmoid((Train[c][0] * w0) + (Train[c][1] * (w1 + eps)) + b) - Train[c][2]), 2);
        eb += MathPow((macroSigmoid((Train[c][0] * w0) + (Train[c][1] * w1) + (b + eps)) - Train[c][2]), 2);
    }

    w0 -= (((ew0 - err)/ eps) * eps);
    w1 -= (((ew1 - err)/ eps) * eps);
    b  -= (((eb - err)/ eps) * eps);

    return err / nTrain;
}
//+------------------------------------------------------------------+
En él, adaptamos el código para que la ejecución sea más rápida. Esto nos lleva al primer problema, relacionado con el aumento del costo computacional a medida que tenemos más tareas que realizar. O, como muchos dicen: cuantas más cosas tengamos que analizar, más recursos computacionales necesitaremos. Aunque las dos funciones que aparecen en el fragmento anterior utilizan exactamente el mismo cálculo, la velocidad de ejecución es enormemente diferente. Esto se debe precisamente a que la primera función debe llamarse muchas veces a lo largo del tiempo. La segunda, en cambio, se llama muchas menos veces, y eso marca toda la diferencia.
Tenemos además otra cuestión. Tal vez no lo hayas notado, pero, desde el principio, todos los códigos se han centrado en una única fórmula matemática. Esta fórmula es la de la regresión lineal. De acuerdo, hemos utilizado diferentes metodologías para obtener la regresión lineal. Pero, al final, todas se han reducido a utilizar regresión lineal.
Si la regresión lineal funciona, ¿por qué intentar otra metodología? Pues bien, aquí entramos en otra cuestión relacionada con las redes neuronales. Cada metodología tiene como objetivo crear una representación matemática de los datos que estamos utilizando. Si utilizas una metodología más rápida, necesitarás menos recursos computacionales para obtener los mismos resultados.
En el peor de los casos, podemos recurrir a la fuerza bruta que, aunque funcione, será completamente inviable. Esto se debe a que la fuerza bruta siempre necesitará muchos más recursos computacionales que un método basado en una fórmula matemática. La regresión lineal funciona en muchos casos. Sin embargo, a medida que aumenta el número de parámetros, también empieza a encontrarse con el mismo problema que la fuerza bruta. Es decir, empieza a requerir cada vez más recursos computacionales para ejecutarse en un tiempo razonable.
Si observas la formulación de la regresión lineal que estamos utilizando, notarás algo curioso e interesante. Y precisamente en esto comenzaremos a centrarnos en este artículo. Vamos entonces a pasar a un nuevo tema para entender qué haremos a partir de ahora.
Y, de nuevo, derivadas, pero con un nuevo nombre
Para simplificarlo al máximo, vamos a volver a los conceptos más básicos, para que puedas seguir el razonamiento matemático que utilizaremos. No me gusta demasiado incluir fórmulas y cosas por el estilo, porque muchas veces dan la impresión de que todo es mucho más complicado de lo que realmente es. Pero no hay otra opción. Para explicarlo adecuadamente, necesitamos ver un poco de matemáticas. En la mayoría de los casos, la regresión lineal se obtiene mediante el método de mínimos cuadrados. Es decir, tomas el error obtenido en el cálculo y lo elevas al cuadrado. Sumas todos los cuadrados obtenidos y tendrás un error total. Esto es lo que representa la siguiente ecuación.

Aquí estoy reduciendo todo a su nivel más básico. Por lo tanto, no entra en juego el sesgo. Solo se utiliza el peso. Pues bien, el valor de < k > representa el total de datos que estamos utilizando. O, mejor dicho, representa cuántos datos tenemos para encontrar la regresión lineal. El valor de < x > corresponde a los datos utilizados en el entrenamiento, al igual que el valor de < y >. La diferencia es que x representa los datos de entrada y y, el resultado esperado. Lo único que necesitamos modificar es el peso, que corresponde al valor de < w >. De acuerdo, esta es la parte básica.
Esta ecuación nos dice lo siguiente: si utilizamos un valor arbitrario para < w >, que es lo único que podemos manipular, generaremos un error igualmente arbitrario. Si después modificamos también de forma arbitraria el valor de < w >, obtendremos un nuevo error. Al comparar ambos errores, podremos saber si nos estamos moviendo en la dirección correcta o equivocada. Si vamos en la dirección correcta, podemos continuar; si vamos en la dirección equivocada, debemos detenernos y cambiar de dirección. Así de sencillo. Esta misma ecuación mostrada anteriormente tiene un detalle que llama nuestra atención: estamos elevando el valor al cuadrado. Y el simple hecho de hacerlo nos permite obtener su derivada. Aquí es donde el análisis empieza a ponerse realmente interesante.
Cuando se deriva esta ecuación, recibe un nuevo nombre. Esto se debe a una característica bastante curiosa de la propia ecuación. El nuevo nombre es: DESCENSO DE GRADIENTE. Muy probablemente ya habrás oído hablar de este descenso de gradiente. Pero ¿sabes de dónde surgió? Pues bien, si la respuesta es no, ahora ya lo sabes. El descenso de gradiente es una ecuación derivada de la regresión lineal. No voy a mostrar aquí cómo transformar la regresión lineal en un descenso de gradiente, porque se aleja por completo del objetivo de este artículo.
Si tienes curiosidad por entender cómo se hace, al final del artículo dejaré, en la sección de referencias, un recurso donde podrás estudiar el tema. Eso sí, prepárate para encontrarte con bastante matemática. La explicación que allí se ofrece es mucho mejor que la que podría dar aquí, ya que nuestro objetivo es la programación en sí. Al transformar, es decir, al derivar la ecuación anterior, llegarás a la siguiente ecuación.

Esto ocurre únicamente cuando utilizamos el peso. Pero ¿qué sucede si también queremos utilizar el sesgo? En ese caso tendremos dos funciones distintas, y no una sola como quizá esperabas. Estas dos funciones se muestran a continuación.

En esta, buscamos el valor del costo basándonos únicamente en el peso. Es decir, modificamos el peso y mantenemos fijo el sesgo, buscando así el menor costo para el parámetro peso. En la siguiente imagen, en cambio, intentamos reducir el costo basándonos en el sesgo. Es decir, mantenemos fijo el peso y manipulamos únicamente el sesgo.

Vaya, espera un momento. ¿La única diferencia entre una y otra está al final de la ecuación? Sí, mi querido lector. Para que entiendas esto y por qué existe esta diferencia, te sugiero que leas el contenido que dejo como referencia o que investigues cómo se obtiene una derivada en este caso. Así podrás comprender con mayor profundidad las cuestiones matemáticas relacionadas con este descenso de gradiente.
Aunque el descenso de gradiente es solo uno de los muchos métodos de reducción del costo utilizados para construir la recta, o ecuación, que representa los datos, debo admitir que actualmente es uno de los más utilizados. Sin embargo, existen métodos que, en algunos casos, son mejores. En otros, incluso el propio descenso de gradiente puede someterse a nuevas transformaciones matemáticas con el objetivo de crear una metodología todavía mejor.
Por esta razón aparecen tantos términos matemáticos cuando estudias redes neuronales. No se trata de que una metodología sea mejor o peor. El hecho es que, como programadores, siempre estamos buscando nuevas formas de realizar los cálculos, pero con un mismo objetivo: reducir el costo computacional. Es decir, hacer lo mismo, pero más rápido. Este es el objetivo de tanta investigación en el área de las matemáticas cuando se trata de redes neuronales.
Muy bien, ¿y cómo se traduce todo esto en código? Eso es lo que realmente nos interesa y también el motivo por el que escribí este artículo. Para verlo, vamos a pasar a un nuevo tema.
Codificando una neurona mediante descenso de gradiente
Aquí volveremos al código más sencillo de todos. Es decir, no vamos a preocuparnos por funciones de activación, sesgo, múltiples entradas ni nada por el estilo. Vamos a comenzar de nuevo con el sistema inicial: una entrada y una salida, como si no hubiéramos hecho nada anteriormente. De este modo podrás entender realmente cómo debe implementarse. Si partiéramos de algo más elaborado, pasarías mucho tiempo intentando entender por qué funciona o por qué no funciona como esperabas. Así que vamos a empezar de nuevo desde cero.
Para hacerlo, veamos cómo era la primera neurona que vimos en estos artículos sobre redes neuronales. El código completo se muestra a continuación.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. #define PrintEx(A) Print(#A, " => ", A)
05. #define macroRandom (rand() / (double)SHORT_MAX)
06. //+------------------------------------------------------------------+
07. double Train[][2] {
08.                     {0, 0},
09.                     {1, 3},
10.                     {2, 6},
11.                     {3, 9},
12.                     {4, 12},
13.                   };
14. //+------------------------------------------------------------------+
15. const uint nTrain = Train.Size() / 2;
16. const double epsilon = 1e-3;
17. //+------------------------------------------------------------------+
18. double Cost(const double w)
19. {
20.     double err, factor;
21.
22.     err = 0;
23.     for (uint c = 0; c < nTrain; c++)
24.     {
25.         factor = Train[c][0] * w;
26.         err += MathPow(factor - Train[c][1], 2);
27.     }
28.
29.     return err;
30. }
31. //+------------------------------------------------------------------+
32. void OnStart()
33. {
34.     double weight, err, e1;
35.     ulong it0, it1, count;
36.
37.     Print("************************************");
38.     Print("Linear regression neuron...");
39.     MathSrand(512);
40.     weight = (double)macroRandom;
41.
42.     it0 = GetTickCount();
43.     for(count = 0; (count < ULONG_MAX) && ((err = Cost(weight)) > epsilon); count++)
44.     {
45.         e1 = (Cost(weight + epsilon) - err) / epsilon;
46.         weight -= (e1 * epsilon);
47.     }
48.     it1 = GetTickCount();
49.     Print("Time: ", (it1 - it0) / 1000.0, " seconds.");
50.     PrintEx(count);
51.     PrintEx(weight);
52.     PrintEx(err);
53. }
54. //+------------------------------------------------------------------+
Claro que cambié algunas cosas en el código para hacerlo aún más sencillo y didáctico, de modo que pueda leerse con facilidad incluso por quienes no entienden demasiado de matemáticas, pero tienen unos conocimientos mínimos de programación. No hace falta gran cosa; no necesitas ser un maestro JEDI de la programación para entender lo que ocurre. Además, un código muy similar a este ya se explicó anteriormente. La idea y el funcionamiento, sin embargo, siguen siendo los mismos. Observa que, en la línea 38, indico qué modelado se utilizó para la función de costo. Al ejecutar este código, verás la siguiente imagen en el terminal de MetaTrader 5:
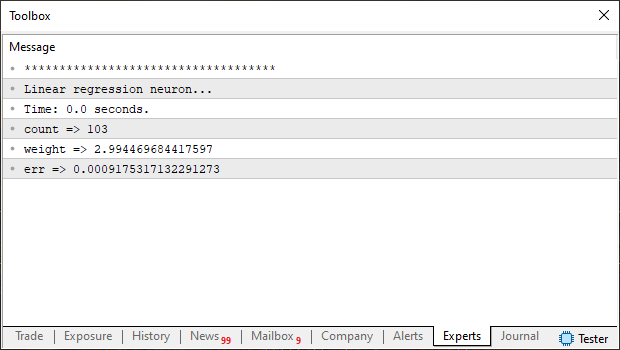
Presta atención a los datos de esta imagen, porque quiero que los compares con lo que veremos en el siguiente código. Bien, ya tenemos un parámetro de comparación. Ahora vamos a ver esta misma neurona o, mejor dicho, este mismo entrenamiento, pero utilizando una función de costo basada en el descenso de gradiente. El código completo puede verse a continuación.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. #define PrintEx(A) Print(#A, " => ", A)
05. #define macroRandom (rand() / (double)SHORT_MAX)
06. //+------------------------------------------------------------------+
07. double Train[][2] {
08.                     {0, 0},
09.                     {1, 3},
10.                     {2, 6},
11.                     {3, 9},
12.                     {4, 12},
13.                   };
14. //+------------------------------------------------------------------+
15. const uint nTrain = Train.Size() / 2;
16. const double epsilon = 1e-3;
17. //+------------------------------------------------------------------+
18. double Cost(const double w)
19. {
20.     double err, x, y;
21.
22.     err = 0;
23.     for (uint c = 0; c < nTrain; c++)
24.     {
25.         x = Train[c][0];
26.         y = Train[c][1];
27.         err += 2 *(x * w - y) * x;
28.     }
29.
30.     return err;
31. }
32. //+------------------------------------------------------------------+
33. void OnStart()
34. {
35.     double weight, err;
36.     ulong it0, it1, count;
37.
38.     Print("************************************");
39.     Print("Linear gradient neuron...");
40.     MathSrand(512);
41.     weight = (double)macroRandom;
42.
43.     it0 = GetTickCount();
44.     for(count = 0; (count < ULONG_MAX) && (MathAbs(err = Cost(weight)) > epsilon); count++)
45.         weight -= (err * epsilon);
46.     it1 = GetTickCount();
47.     Print("Time: ", (it1 - it0) / 1000.0, " seconds.");
48.     PrintEx(count);
49.     PrintEx(weight);
50.     PrintEx(err);
51. }
52. //+------------------------------------------------------------------+
Al ejecutar este código, verás en el terminal de MetaTrader 5 la siguiente imagen:
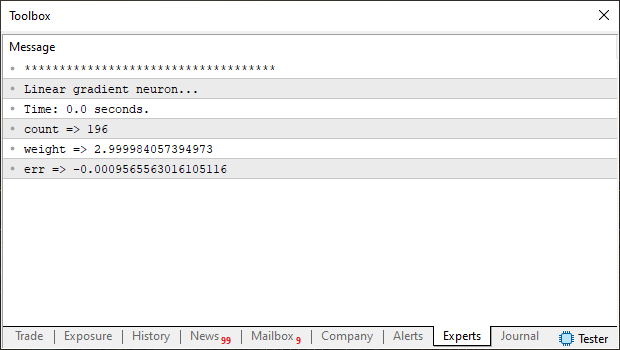
Ahora compara ambas imágenes: la generada mediante el descenso de gradiente y la generada mediante la regresión lineal. ¿Notas alguna diferencia? Sí, no, quizá o quién sabe. Pues bien, para evitar que tengas que esforzarte intentando encontrarla, en la siguiente imagen aparecen ambos resultados juntos. Así será más fácil apreciar alguna diferencia.
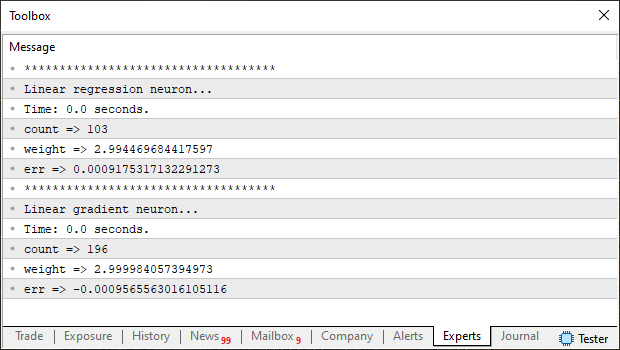
Vamos, no consigo notar ninguna diferencia, salvo en el contador. Pues bien, mi querido lector, si ese ha sido tu caso, vuelve a observarlo con más calma. Fíjate en que la regresión lineal fue aparentemente más rápida. Sin embargo, el valor del peso que obtuvo es ligeramente menos preciso que el obtenido mediante el descenso de gradiente. En este momento quizá estés pensando: bien, pero necesitamos que la función de costo se ejecute lo más rápido posible, ¿no? Sí, mi querido lector, y estoy completamente de acuerdo con esa observación. Precisamente por eso estoy mostrando esta comparación.
Quiero evitar que caigas en la falacia de quienes dicen, o insisten en decir, que el descenso del gradiente es mejor que la regresión lineal. Todo depende. Y depende principalmente del tipo de datos que estemos utilizando para entrenar la neurona. Es decir, del tipo de datos que utilizamos para generar los valores de la ecuación. Estos valores tienen como objetivo representar, de la mejor manera posible, los datos de nuestra base de datos. Una función considerada mejor no siempre será realmente la mejor. Cada caso es diferente.
Observa también que el valor del error es distinto. En el caso de la regresión lineal, siempre será positivo. En el caso del descenso de gradiente, en cambio, unas veces podrá ser positivo y otras, negativo. Esto se debe a que la propia función intenta encontrar el mejor punto para reducir el costo de la función generada. Pero espera un momento. ¿Cómo es eso? No lo entiendo. ¿El resultado obtenido no debería ser siempre el mismo, independientemente del tipo de función que utilicemos para buscar la mejor representación de los datos? No, mi querido lector, y este es otro de los errores o falacias que muchos repiten cuando se habla de redes neuronales. O, mejor dicho, cuando se habla del entrenamiento de una red neuronal, ya sea utilizando una o varias neuronas. Para explicar esto, vamos a pasar a un nuevo tema. Así podré separar mejor los conceptos.
¿Qué representa el tan mencionado costo de la función?
El valor que todos llaman costo representa el error que tiene una función o, mejor dicho, la representación generada por una función frente a los datos reales contenidos en la base de datos utilizados para generar dicha función. De acuerdo, pero ¿dónde está el problema en todo esto? No consigo entender por qué una base de datos con los mismos datos puede llegar a generar una función tan diferente. ¿No deberían ser iguales, independientemente del tipo de modelado utilizado para generar la representación de los datos de la base de datos? Definitivamente, no es una respuesta tan sencilla de dar. En cualquier caso, dependerá de cada situación concreta.
Todos los ejemplos que he mostrado están planteados para ser lo más sencillos posible. Por eso, en todos los casos, la función general que representa los datos de entrenamiento puede representarse fácilmente mediante una parábola. Es decir, tenemos un único punto de convergencia para el sistema. De esta forma, independientemente del punto de partida, los modelos siempre convergerán hacia ese único punto. Sin embargo, en casos REALES no siempre ocurre así. La curva que mejor represente los datos de la base de datos puede ser un polinomio bastante complejo. Puede ser de tercer grado o superior y, cuanto mayor sea este grado, mayor será la influencia del punto de partida a la hora de encontrar la mejor representación de los datos. Es decir, aunque el modelado utilizado no consiga converger hacia un punto donde el costo sea menor, aun así tendremos la impresión de haber encontrado el mejor punto posible.
Mostrar este tipo de situaciones es mucho más difícil de lo que parece. Aun así, ocurren con más frecuencia de la que tú, mi querido lector, podrías imaginar. Para ilustrar un poco mejor lo que acabo de decir, pensemos en lo siguiente: supongamos que tienes una base de datos cuyo contenido completo puede representarse mediante una función matemática. Y que, al crear el gráfico de dicha función, obtienes el gráfico que se muestra en la siguiente imagen:
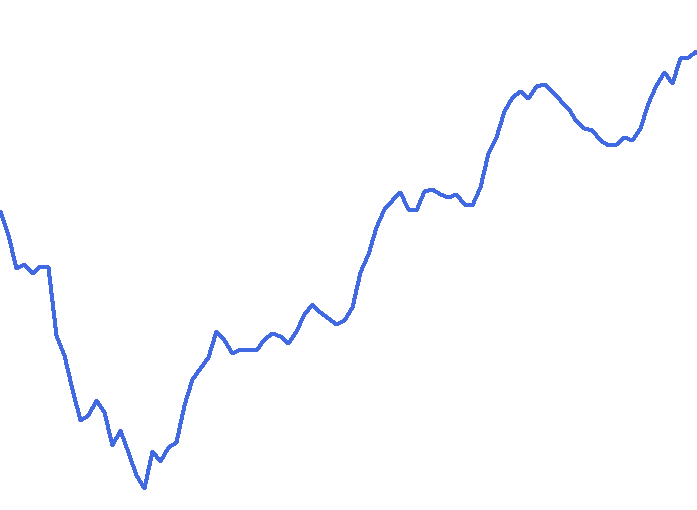
Mi pregunta es: ¿cuál es el mejor sistema de red neuronal capaz de crear una representación matemática de esta base de datos? La idea es que no se pierda ningún dato como consecuencia de que el gráfico de la representación generada por la red neuronal sea diferente del que se muestra anteriormente. Mmm, ahora sí que tenemos un problema, ¿no? Y es precisamente en este punto donde se concentra toda la investigación sobre redes neuronales. Todo, absolutamente todo, se reduce a esto.
Puedes pensar lo siguiente: podemos utilizar regresión lineal. O quizá descenso del gradiente. O gradiente estocástico. O podemos utilizar fuerza bruta. Sí, mi querido lector. En el peor de los casos, todo podría reducirse a la fuerza bruta. Pero piensa en la capacidad de cálculo necesaria para crear una ecuación que represente estos datos. Es algo casi impensable en la actualidad. Tal vez, en algún momento, llegue a existir realmente un ordenador cuántico. Pero, hasta entonces, olvidemos la fuerza bruta. Necesitamos utilizar otro método. Y aquí es donde aparece el problema.
Está claro que, en esta curva, existe un punto mínimo. Este punto es donde la función tendrá el menor costo posible, al menos según lo que muestra el gráfico. Sin embargo, muchos dicen que, al intentar encontrar este punto, en realidad estaremos haciendo overfitting. Pero esto es una completa tontería. La idea aquí es crear una función que represente de forma ideal todos los datos contenidos en la base de datos. Entonces, ¿de dónde surge esta idea del overfitting? Pues bien, esta idea deriva del hecho de que todos quieren obtener la mejor función, pero, al encontrarla, puede que simplemente no consigamos identificar elementos que estén fuera de la base de datos.
Hay además otro motivo para esto: el costo computacional. Piensa en lo siguiente. Cualquier método de modelado destinado a representar una base de datos necesita uno o más datos iniciales. Cuando se procesan todos esos datos iniciales, se genera un costo inicial para la función. Y aquí está la clave. ¿Dónde se encuentra este punto inicial? Pues bien, volvamos a nuestra figura y, esta vez, añadamos algunos puntos sobre la recta.
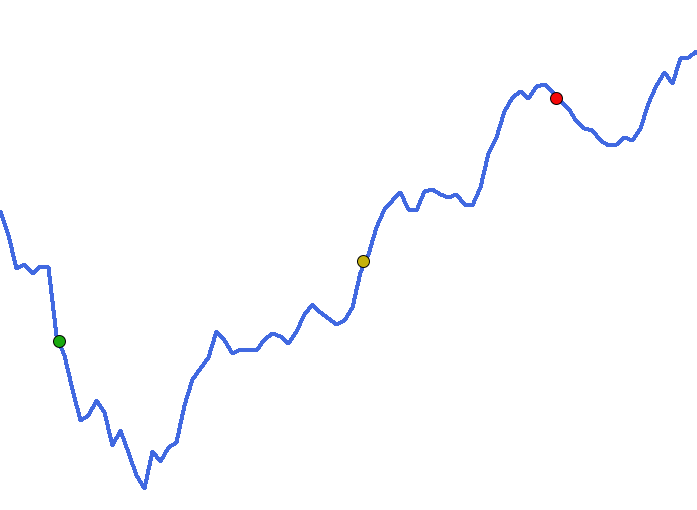
Cada uno de estos puntos se creó de forma completamente aleatoria, del mismo modo que siempre inicializamos una neurona o una red neuronal. Sin embargo, representan el costo inicial generado precisamente por esos datos aleatorios. Ahora viene la parte interesante. ¿Cuál de estos puntos llegará realmente al punto de menor costo de esta curva que aparece en azul? Pues bien, dependerá de cómo busque cada punto ese punto de menor costo. Dependiendo de la forma en que cada uno realice la búsqueda, puede que ninguno llegue jamás a ese punto de convergencia máxima, es decir, al punto de menor costo. Esto se debe a que existen valles y picos en su camino, y ninguno sabe con certeza cómo superar esos picos. Siempre buscan el valle más profundo partiendo del pico desde el que surgieron. Por eso, esta cuestión del overfitting no es, en realidad, el verdadero problema. El verdadero problema es: ¿cuánto costo computacional se desperdiciará buscando el valle más profundo o el punto de menor costo?
Consideraciones finales
En este artículo intenté presentar, de la forma más sencilla y didáctica posible, una de las cuestiones más controvertidas cuando se habla de redes neuronales: cómo buscar el mejor punto posible o el menor costo de una función. Mostré la diferencia entre una regresión lineal y un descenso de gradiente. Ambos casos son bastante sencillos y sirven para demostrar que no siempre el camino que parece obvio es realmente el mejor.
El campo de investigación de las redes neuronales todavía tiene mucho por avanzar. Así que, si te interesa, intenta estudiar el tema con calma y busca siempre material de calidad. Existen muchas personas mal informadas que se limitan a repetir falacias que ni siquiera comprenden. Dejo en el anexo los códigos utilizados en este artículo.
A pesar de todo lo dicho aquí, volveremos a hablar de este tema. Aquí apenas he rozado la superficie de lo que realmente rige este asunto.
Referencia
Regresión lineal y descenso de gradiente: De cero a la brujería
Traducción del portugués realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/pt/articles/13812
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Del nivel básico al intermedio: Indicadores técnicos (II)
 Redes neuronales en el trading: una visión unificada del espacio y el tiempo (Final)
 Red neuronal en la práctica: Descenso de gradiente estocástico
 Redes neuronales en el trading: una visión unificada del espacio y el tiempo (Global-Local Attention)

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso