

Альтернатива временным барам (Часть 1): Построение баров активности и дисбаланса в Python и MQL5
 150
 3

Содержание
- Введение
- Проблема сэмплирования по времени
- Инфраструктура — хранение в Parquet и загрузка с помощью Dask
- Очистка тиковых данных перед построением баров
- Стандартные бары — временные, тиковые, объемные и долларовые
- Информационные бары — сэмплирование по рыночной направленности
- Единый API — make_bars()
- Выбор типа бара на практике
- Реализация на MQL5
- Заключение
- Прикрепленные файлы
Введение
Модель, обученная на одноминутных барах, наследует допущение, не имеющее никакого отношения к рынку: будто каждое 60-секундное окно содержит одинаковое количество информации. Это не так. За минуту при открытии лондонской сессии могут пройти сотни тиков и произойти направленное движение; за минуту в 03:00 UTC в воскресенье — всего три тика без какого-либо сигнала. Если считать оба случая равнозначными наблюдениями, это приводит к появлению гетероскедастичности на уровне данных еще до вычисления каких-либо признаков.
В главе 1 книги Лопеса де Прадо "Advances in Financial Machine Learning" сэмплирование по времени заменяется альтернативными схемами, основанными на активности и рыночной направленности. В этой статье все десять типов баров из указанной главы реализованы в двух вариантах: унифицированном модуле Python (afml.data_structures.bars) для пакетной обработки многолетней истории тиков и объектно-ориентированной библиотеке MQL5 для потикового построения баров в реальном времени внутри советника.
В пайплайне решаются четыре практические проблемы: загрузка многолетних тиковых данных без превышения доступной памяти (чтение партиционированного хранилища Parquet с помощью Dask); очистка артефактов брокерского потока данных, нарушающих построение баров (нулевые спреды, дублирующиеся временные метки, индексы NaT); автоматическая калибровка адаптивного порога баров дисбаланса, чтобы первый бар не смещал историю экспоненциально взвешенного среднего (EWM); сохранение состояния EWM между перезапусками советника, чтобы порог не сбрасывался в середине сессии. Краткая проверка совпадения в конце подтверждает, что две реализации, получая один и тот же поток тиков, генерируют идентичные бары.
Проблема сэмплирования по времени
Каждый пайплайн машинного обучения для финансовых данных начинается с одного и того же вопроса: что считать одним наблюдением? Для большинства практиков ответом служит одноминутный или пятиминутный OHLC-бар — срез рынка фиксированной длительности. Этот подход удобен и привычен, но в нем заложен структурный недостаток, который передается во все модели, обучаемые на полученных данных.
Рассмотрим ликвидную валютную пару во время открытия лондонской сессии и ту же пару в 03:00 UTC в воскресенье. В первом случае могут генерироваться сотни тиков в минуту, во втором — менее пяти. При построении одноминутных временных баров эти два случая рассматриваются как равнозначные наблюдения. Воскресный бар почти полностью состоит из шума. Лондонский бар информационно насыщен, но при этом сводится к тем же четырем числам. В результате мы получаем набор данных с непостоянной дисперсией — именно для описания этого свойства были созданы модели ARCH. Это одна из основных причин, по которой доходности финансовых инструментов крайне трудно моделировать стандартными алгоритмами машинного обучения.
Лопес де Прадо формализует это интуитивное представление в главе 1 книги "Advances in Financial Machine Learning" (AFML). Основной тезис заключается в том, что бары должны закрываться после накопления заданного объема рыночной активности, а не по истечении заданного промежутка времени. Активность можно измерять количеством тиков, проторгованным объемом или долларовой стоимостью сделок — каждая мера дает свою схему сэмплирования с собственными статистическими свойствами. В самой радикальной версии этой идеи — барах дисбаланса — бар закрывается, когда рыночная направленность превышает порог. Это позволяет фиксировать смены режима, которые не способен обнаружить ни один из методов сэмплирования на основе активности.
Построение баров — начальный этап любого пайплайна формирования признаков. Качество последующих признаков — преобразований для достижения стационарности, оценок волатильности и микроструктурных индикаторов — ограничено качеством входных баров. Приведенная ниже реализация на Python находится в модуле afml.data_structures.bars и предоставляет одну общедоступную функцию make_bars() для всех десяти типов баров, рассмотренных в главе 1 книги AFML. Соответствующая реализация на MQL5 в разделе 8 предоставляет те же семь типов баров в событийной форме для реальной торговли внутри советника, а также дополнительную инфраструктуру для сохранения состояния при потере соединения терминалом.
Инфраструктура — хранение в Parquet и загрузка с помощью Dask
Первый урок, извлеченный в ходе реализации, не имел никакого отношения к теории сэмплирования. Объем тиковых данных по одной валютной паре за один календарный год может превышать 50 миллионов строк. Загрузка этих данных в DataFrame библиотеки pandas в начале сеанса занимает несколько минут и требует нескольких гигабайт оперативной памяти. Два изменения устраняют обе проблемы: хранение необработанных тиковых данных в столбцовом формате Parquet с партиционированием по годам и месяцам и загрузка с помощью Dask вместо pandas без помещения всего набора в оперативную память.
Структура каталогов строится по простому соглашению:
tick_data_parquet/
  EURUSD/
    2023/
      month-01.parquet
      month-02.parquet
      ...
    2024/
      month-01.parquet
      ...
Каждый файл партиции сжимается алгоритмом zstd с помощью PyArrow. Коэффициент сжатия тиковых данных с числами с плавающей точкой обычно составляет от 4:1 до 6:1 по сравнению с необработанным CSV. Благодаря столбцовому хранению при загрузке только столбцов bid, ask и volume остальная часть файла полностью пропускается на уровне ввода-вывода.
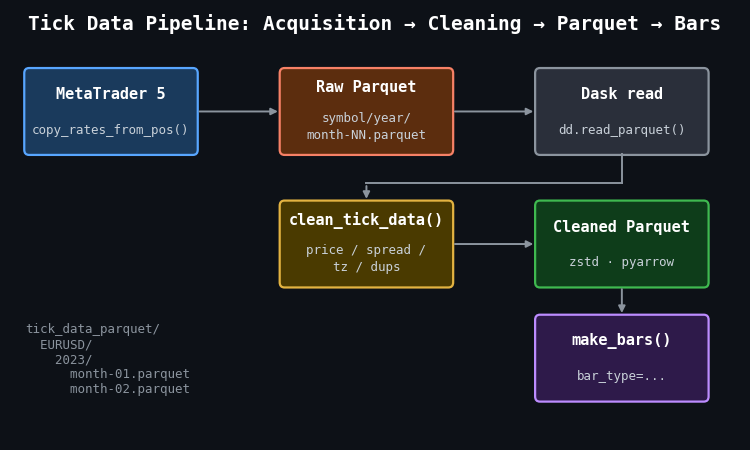
Рис. 1. Схема одного прохода пайплайна тиковых данных — от получения до построения баров.
- MetaTrader 5 — источник необработанных тиковых данных через copy_rates_from_pos(), сохраняемых по месяцам в структуру каталогов с необработанными Parquet-файлами.
- clean_tick_data() проверяет цены, обеспечивает положительные спреды, локализует временные метки в UTC, удаляет дубликаты и сортирует данные в хронологическом порядке перед записью в хранилище очищенных данных.
- Чтение с помощью Dask — dd.read_parquet() с фильтрами партиций применяет условия отбора по датам на уровне файлов, поэтому обращение выполняется только к файлам соответствующих месяцев.
- make_bars() принимает полностью очищенный DataFrame pandas и передает его в соответствующий конструктор баров.
Функция load_tick_data() служит оберткой над слоем Dask. Она принимает символ, диапазон дат и имя счета (для проверки соответствия среды загрузки среде получения данных), применяет фильтры по датам на уровне групп строк и вызывает .compute(), чтобы получить результат в виде DataFrame pandas для построения баров:
def load_tick_data(
    symbol: str,
    start_date,
    end_date,
    account_name: str,
    path=None,
    columns=None,
    verbose: bool = True,
) -> pd.DataFrame:
    root_path = Path(path) if path else Path.home() / "tick_data_parquet"
    if not verify_or_create_account_info(root_path, account_name):
        return pd.DataFrame()

    fname = root_path / symbol.upper()
    filters = [("time", ">=", start_date), ("time", "<=", end_date)]

    ddf = dd.read_parquet(fname, columns=columns, filters=filters, engine="pyarrow")
    return ddf.compute()
Практическое значение такой архитектуры становится очевидным при запросе двухнедельного окна из трехлетнего набора данных. Dask считывает только два-три файла месячных партиций, охватывающих заданный диапазон дат; остальные файлы полностью пропускаются. Без партиционирования Parquet аналогичный процесс с pandas сначала загружает весь набор данных, а затем фильтрует его в памяти. Такой подход перестает работать, как только объем данных превышает доступную оперативную память.
Очистка тиковых данных перед построением баров
Построение баров дает неверные результаты, если входной поток тиков не очищен. Наиболее распространенные проблемы при экспорте тиков из MetaTrader 5 — отрицательные или нулевые спреды (известный артефакт некоторых конфигураций брокерского потока данных), дублирующиеся временные метки после переподключения и тики со значениями NaT в индексе при потере соединения терминалом.
Функция clean_tick_data() выполняет семь последовательных проверок перед передачей данных любому конструктору баров:
def clean_tick_data(
    df: pd.DataFrame,
    timezone: str = "UTC",
    min_spread: float = 1e-5,
) -> Optional[pd.DataFrame]:
    if df.empty:
        return None

    # 1. Ensure DatetimeIndex
    if not isinstance(df.index, pd.DatetimeIndex):
        df.index = pd.to_datetime(df.index)
        df = df[~df.index.isnull()]

    # 2. Timezone normalization
    df = df.tz_localize(timezone) if df.index.tz is None else df.tz_convert(timezone)

    # 3. Price validity: positive prices, ask > bid, spread >= min_spread
    price_filter = (
        (df["bid"] > 0)
        & (df["ask"] > 0)
        & (df["ask"] > df["bid"])
        & ((df["ask"] - df["bid"]) >= min_spread)
    )
    df = df[price_filter]

    # 4–7. Drop NaN, handle microseconds, remove duplicate timestamps, sort
    df.dropna(inplace=True)
    df = df[~df.index.duplicated(keep="last")]
    if not df.index.is_monotonic_increasing:
        df.sort_index(inplace=True)

    return df if not df.empty else None
Одна деталь заслуживает внимания: при обработке дубликатов используется keep="last", а не keep="first". При восстановлении соединения и повторной отправке последнего тика брокерским потоком данных в повторной версии с большей вероятностью будет исправленная цена. Сохранение последней записи среди дубликатов соответствует этому предположению.
Стандартные бары — временные, тиковые, объемные и долларовые
Все четыре стандартных типа баров используют общий внутренний алгоритм построения. Объект группировки разбивает DataFrame с тиками на группы по принадлежности к барам; агрегирование каждой группы дает цены открытия, максимума, минимума и закрытия (OHLC), средний спред и накопленный объем. Функция _make_bar_type_grouper() задает логику разбиения для каждого типа баров:
def _make_bar_type_grouper(
    df: pd.DataFrame,
    bar_type: str = "tick",
    bar_size: Union[int, str] = 100,
) -> tuple:
    if bar_type == "time":
        freq = set_resampling_freq(bar_size)
        return df.resample(freq, closed="left", label="right"), bar_size, None

    if bar_type == "tick":
        bar_id = np.arange(len(df)) // bar_size

    elif bar_type in ("volume", "dollar"):
        cum_metric = (
            df["volume"] * df["bid"] if bar_type == "dollar"
            else df["volume"]
        )
        bar_id = (cum_metric.cumsum() // bar_size).astype(int)

    return df.groupby(bar_id), bar_size, bar_id
Временные бары и фильтр нулевого тикового объема
Временные бары — единственный тип баров, для которого объект группировки может создавать пустые группы. Часовой бар в нерабочий день рынка или во время перерыва между торговыми сессиями содержит ноль тиков. Пустой бар — не наблюдение, а отсутствие данных. Его передача дальше по пайплайну приводит к скрытой ошибке: значения OHLC для пустой группы не определены (pandas возвращает NaN), а tick_volume бара равен нулю, что вызывает ошибки деления при расчете любых признаков с нормированием по активности бара.
После обнаружения этой проблемы на практике в код рабочей версии был добавлен фильтр нулевого тикового объема. Пакет временных баров, построенный на данных с гэпом выходного дня, содержал 23 бара с tick_volume == 0. Эти бары заполнялись предыдущей ценой закрытия, перенесенной вперед при агрегировании в ходе ресэмплинга, из-за чего в столбцах OHLC они становились неотличимы от реальных баров. Фильтр в _make_standard_bars() удаляет эти бары и записывает их количество в лог:
if bar_type == "time":
    eq_zero = ohlc_df["tick_volume"] == 0
    ohlc_df = ohlc_df[~eq_zero]

    nzeros = eq_zero.sum()
    if nzeros > 0:
        logger.info(
            f"Dropped {nzeros:,} of {ohlc_df.shape[0]:,} rows with zero tick volume."
        )
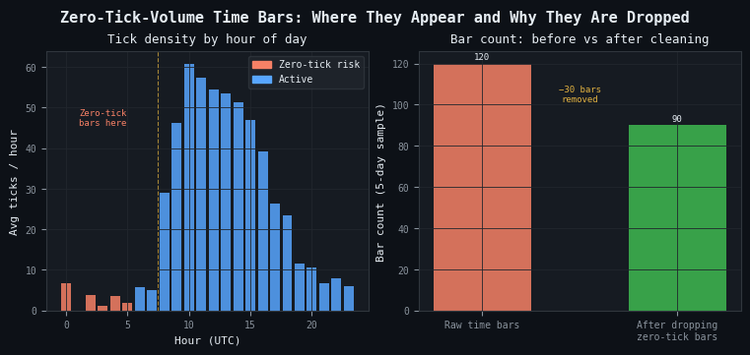
Рис. 2. Иллюстрация из двух панелей, демонстрирующая проблему нулевого тикового объема во временных барах.
- Панель (a) — почасовая плотность тиков для типичной валютной пары; часы 00-07 UTC выделены как зона риска появления баров с нулевым тиковым объемом. Для основных валютных пар эти часы соответствуют поздней части американской сессии / закрытию азиатской сессии.
- Панель (b) — количество баров до и после применения фильтра нулевого тикового объема на выборке за пять дней. Удаляются 30 фантомных баров без затрагивания тиков, по которым фактически прошли сделки.
Этот фильтр действительно нарушает строгую временную последовательность индекса баров. Последующий компонент, рассчитывающий на один бар в каждом временном интервале, — например, код соединения данных по регулярной календарной сетке, — после применения фильтра будет работать некорректно. Это осознанный компромисс: последующая модель, получающая фантомные бары с перенесенными вперед ценами, будет давать худшие прогнозы, чем модель, получающая неравномерный, но точный временной ряд.
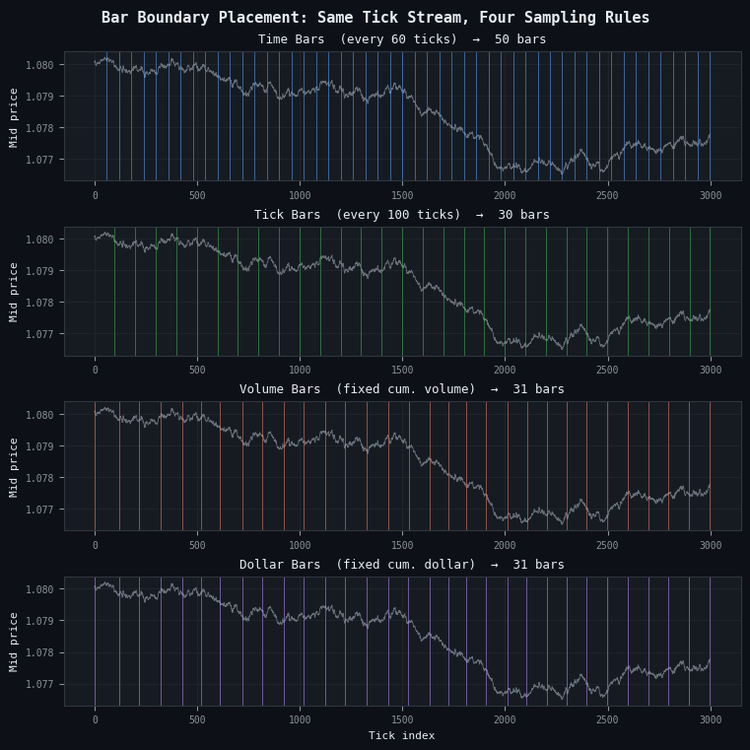
Рис. 3. Иллюстрация из четырех панелей, показывающая размещение границ баров для четырех стандартных методов сэмплирования.
- Панель (a) — временные бары (синие), закрывающиеся каждые 60 секунд. Границы расположены равномерно независимо от рыночной активности.
- Панель (b) — тиковые бары (зеленые), закрывающиеся каждые 100 тиков. Границы также регулярны, но привязаны к количеству событий активности, а не ко времени.
- Панель (c) — объемные бары (оранжевые), закрывающиеся, когда накопленный объем достигает порога. Границы сгущаются в периоды высокого объема и располагаются дальше друг от друга в спокойные периоды.
- Панель (d) — долларовые бары (фиолетовые), закрывающиеся, когда накопленная долларовая стоимость сделок достигает порога. Похожи на объемные бары, но взвешены по цене, что делает порог более стабильным для символов с разными ценовыми шкалами.
Долларовые бары и чувствительность к режиму волатильности
Статистический аргумент в пользу долларовых баров по сравнению с временными прост. Бар закрывается, когда совокупная стоимость сделок по активу достигает заданной долларовой суммы. Во время активных сессий цены движутся сильнее, а объемы выше, поэтому долларовый порог достигается быстро. Во время спокойных сессий для достижения порога требуется больше времени. В результате каждый бар содержит примерно одинаковое количество информации независимо от времени, которое потребовалось для его формирования.
Это свойство дает распределения доходностей, более близкие к гауссовым, чем распределения на основе временных баров. Это важно, поскольку многие алгоритмы машинного обучения (и практически все модели риска) предполагают независимые, одинаково распределенные доходности. На рисунке 4 это проиллюстрировано на синтетических данных с заложенными всплесками волатильности.
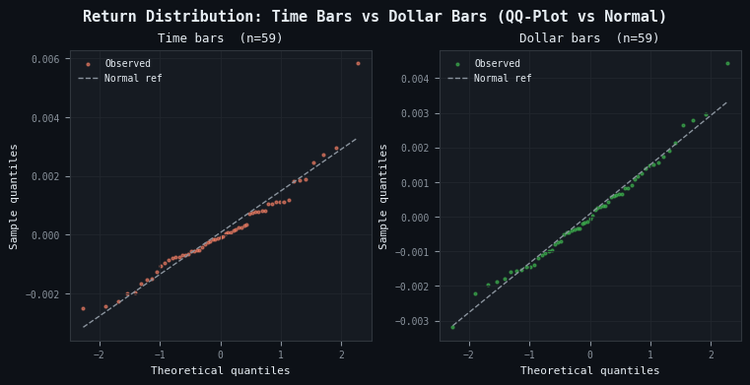
Рис. 4. Иллюстрация из двух панелей — сравнение нормальности распределения доходностей временных и долларовых баров.
- Панель (a) — доходности временных баров отклоняются от эталонной линии нормального распределения в хвостах, особенно в верхнем. Это отражает распределение доходностей с тяжелыми хвостами, возникающее при сэмплировании волатильных и спокойных периодов с одинаковой частотой.
- Панель (b) — доходности долларовых баров ближе к эталонной линии нормального распределения во всем диапазоне квантилей, поскольку каждый бар соответствует фиксированной стоимости сделок, а не фиксированному промежутку времени.
Долларовые бары рекомендуются как вариант по умолчанию для большинства задач машинного обучения в пайплайне. Тиковые бары предпочтительны, когда поток ордеров информативнее произведения цены и объема — например, на рынках, где один крупный ордер может быть разбит на множество мелких заявок. Объемные бары занимают промежуточное положение: они учитывают размер ордера, но не уровень цены, поэтому менее стабильны на длительных периодах тестирования на истории, за которые цена актива существенно изменилась.
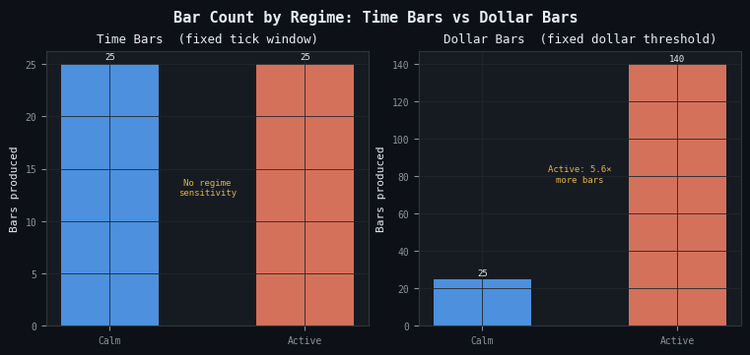
Рис. 5. Иллюстрация из двух панелей, показывающая чувствительность количества баров к режимам волатильности.
- Панель (a) — количество временных баров одинаково в спокойном и активном режимах: сэмплирование по времени не реагирует на рыночные условия.
- Панель (b) — в активном режиме формируется в 5,6 раза больше долларовых баров, чем в спокойном, поэтому наблюдения концентрируются там, где плотность рыночной информации максимальна.
Информационные бары — сэмплирование по рыночной направленности
Стандартные бары закрываются по мере накопления активности. Момент закрытия информационных баров определяется направленной активностью — чистым дисбалансом между сделками по инициативе покупателя и продавца. Идея в том, что бар, закрывающийся, когда рынок определился с направлением, содержит больше информации для принятия решений, чем бар, закрывающийся при превышении порога объема независимо от направления.
Тиковое правило
Для построения информационных баров каждому тику нужно присвоить направление. Тиковое правило — стандартный подход. Тик считается инициированным покупателем (+1), если цена выросла относительно предыдущего тика, и продавцом (-1), если она снизилась; при неизменной цене сохраняется предыдущая классификация:
@njit(cache=True)
def _tick_rule_kernel(prices: np.ndarray) -> np.ndarray:
    n = len(prices)
    b = np.empty(n, dtype=np.float64)
    b[0] = 1.0
    prev = 1.0

    for i in range(1, n):
        diff = prices[i] - prices[i - 1]
        if diff > 0.0:
            prev = 1.0
        elif diff < 0.0:
            prev = -1.0
        b[i] = prev

    return b
Декоратор @njit(cache=True) компилирует цикл в нативный машинный код с помощью Numba. В предыдущей реализации метод ffill() из pandas переносил последний ненулевой знак вперед. Его замена переменной, явно сохраняющей последнее значение внутри ядра Numba, полностью устраняет накладные расходы pandas. При 500 000 тиках скомпилированная версия выполняется менее чем за 1 мс.
Массив направлений b хранится с типом float64, а не int8. Этот выбор сделан намеренно: значения {-1.0, +1.0} сразу умножаются на величины с плавающей точкой (объем, цена, стоимость в долларах) внутри того же ядра. Хранение этих значений с типом float64 позволяет избежать приведения типов при каждом умножении. Альтернативный вариант — создать b с типом int8 для экономии восьми байтов на тик — позволяет сэкономить 500 КБ на наборе из миллиона тиков, но добавляет инструкцию приведения типа при каждой операции умножения со сложением в цикле определения границ. JIT-компилятор Numba генерирует одинаковый машинный код для обоих вариантов с учетом приведения типа; при хранении с типом float64 это приведение просто пропускается.
Тиковое правило — это косвенная оценка. Оно неправильно классифицирует значительную долю сделок, особенно на рынках, где спред Bid-Ask велик по сравнению с размером тика. Алгоритм Ли — Реди повышает точность классификации для наборов данных с котировками Bid и Ask для каждой сделки. Однако для построения баров дисбаланса достаточно тикового правила, позволяющего избежать дополнительных сравнений со средней ценой между Bid и Ask.
Бары дисбаланса
Тиковый бар дисбаланса закрывается, когда накопленная величина с учетом знака θT превышает порог, рассчитанный по ожидаемой длине бара и ожидаемому дисбалансу на тик. Для тиковых баров дисбаланса величина на тик — просто bt. Для объемных баров дисбаланса — bt · vt. Для долларовых баров дисбаланса — bt · pt · vt. Бар закрывается на тике T, когда:
|θT| ≥ E0[T] · |E0[imbalance per tick]|
Оба математических ожидания в правой части обновляются после каждого завершенного бара с использованием экспоненциально взвешенного среднего (EWM). Параметр span для EWM определяет, насколько быстро порог адаптируется к новому режиму. Малое значение span (5-10 баров) обеспечивает быстрое отслеживание, при котором во время тренда могут формироваться очень маленькие бары; большое значение span (50-100 баров) дает стабильный порог, медленно реагирующий на смену режима. Перед входом в цикл вызывающий код преобразует span в коэффициент затухания α = 2 / (span + 1).
Ключевая деталь реализации — способ вычисления EWM. В исходной реализации поддерживались два растущих списка Python, и при каждом закрытии бара заново создавался объект pd.Series для вычисления .ewm().mean().iloc[-1]. Этот подход имеет сложность O(n) на вызов и O(n2) суммарно по всем барам — при 500 000 тиках на него приходилось 92% времени определения границ. EWM с adjust=False задается рекуррентной формулой в одну строчку: ewm = α·x + (1-α)·ewm. Встраивание этой рекуррентной формулы в виде двух скалярных обновлений в цикл, JIT-компилируемый Numba, снижает затраты на каждый бар до O(1) и сокращает общее время определения границ более чем в 1 000 раз.
Реализация в _detect_imbalance_boundaries() поддерживает две последовательно обновляемые скалярные величины EWM — для ожидаемой длины бара и ожидаемого абсолютного дисбаланса. Каждая обновляется одной операцией умножения со сложением при закрытии бара:
@njit(cache=True)
def _detect_imbalance_boundaries(
    metric: np.ndarray,
    exp_ticks_init: float,
    exp_imbalance_init: float,
    ewm_alpha: float,
) -> np.ndarray:
    n = len(metric)
    boundaries = np.empty(n, dtype=np.int64)
    n_bars = 0

    theta = 0.0
    bar_start = 0

    # Incremental EWM state (O(1) per bar close)
    ewm_T = exp_ticks_init
    ewm_abs_theta = abs(exp_imbalance_init) * exp_ticks_init
    exp_T = exp_ticks_init
    exp_abs_imb = abs(exp_imbalance_init)
    one_minus_alpha = 1.0 - ewm_alpha

    for t in range(n):
        theta += metric[t]
        threshold = exp_T * exp_abs_imb

        if abs(theta) >= threshold:
            boundaries[n_bars] = t
            n_bars += 1

            bar_len = float(t - bar_start + 1)

            # O(1) EWM update: ewm = α·x + (1-α)·ewm
            ewm_T = ewm_alpha * bar_len + one_minus_alpha * ewm_T
            ewm_abs_theta = ewm_alpha * abs(theta) + one_minus_alpha * ewm_abs_theta

            exp_T = ewm_T
            exp_abs_imb = ewm_abs_theta / max(exp_T, 1.0)

            theta = 0.0
            bar_start = t + 1

    return boundaries[:n_bars]
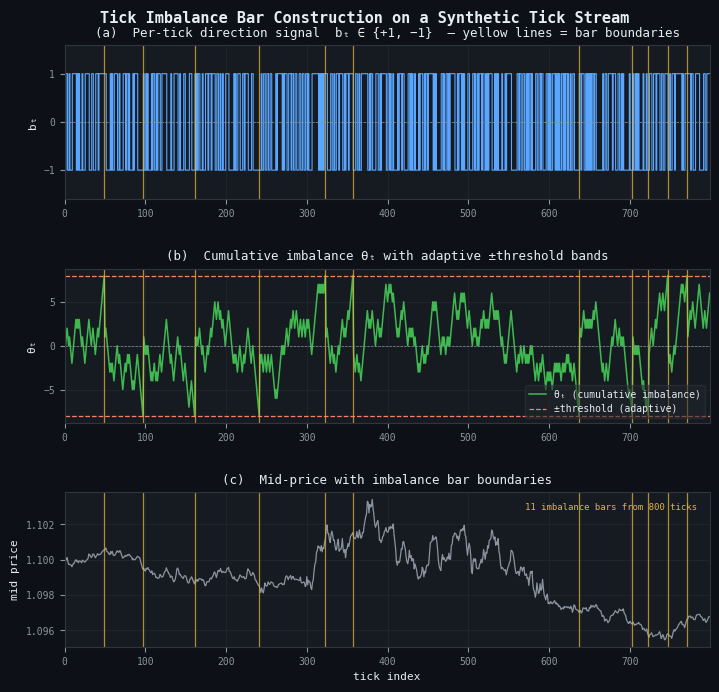
Рис. 6. Иллюстрация из трех панелей, показывающая построение тиковых баров дисбаланса на синтетическом потоке тиков.
- Панель (a) — сигнал направления каждого тика bt ∈ {+1, -1}, полученный по тиковому правилу. Желтые вертикальные линии обозначают границы баров.
- Панель (b) — накопленный дисбаланс θT (зеленый) с адаптивными границами порога ± (оранжевые пунктирные линии). Бар закрывается каждый раз, когда θT достигает одной из границ или пересекает ее; пороговые границы сближаются или расходятся по мере обновления EWM.
- Панель (c) — средняя цена между Bid и Ask с границами баров. Из этого потока в 800 тиков формируются 10 баров дисбаланса — значительно меньше, чем 8-16 баров, которые методы сэмплирования с фиксированным размером сформировали бы по тем же данным.
Автоматическая калибровка порога
В AFML ясно представлено рекуррентное соотношение для баров дисбаланса. Однако в ней не обсуждается проблема инициализации, которую должна решить каждая рабочая реализация: какие значения E0[T] и E0[дисбаланс на тик] корректны на нулевом баре?
Выбор значения E0[T] определяет порог для самого первого бара. Если E0[T] присвоить слишком низкое значение — например, 10 тиков, — первый бар закроется почти сразу и задаст неудачное начальное значение для истории EWM. Последующая адаптация остается привязанной к этому неудачному начальному значению на протяжении многих баров, прежде чем стабилизируется. Если E0[T] присвоить слишком высокое значение — например, 10 000 тиков, — первый бар не закроется за короткий период тестирования на истории, и будет возвращен пустой DataFrame без ошибок и предупреждений.
В обновленной реализации эта проблема решается автоматически. При передаче target_timeframe в make_bars() внутри вызывается функция _calibrate_information_bar_params(), которая определяет оба начальных значения по самим тиковым данным. target_timeframe — это строковое обозначение таймфрейма MetaTrader 5, задающее желаемую периодичность закрытия баров: 'M5', 'M15', 'H1' и т.д. Калибратор вычисляет медианное число тиков за период на этом таймфрейме для E0[T] и оценивает эмпирическое направленное смещение |E[bt]| по выборке до 500 000 тиков для E0[дисбаланс на тик]. Нижняя граница оценки — 0,01, чтобы порог не снижался до нуля на идеально симметричном потоке тиков:
# Preferred — auto-calibrated dollar imbalance bars targeting M15 cadence
dimb_bars = make_bars(tick_df, bar_type="dollar_imbalance", target_timeframe="M15")

# Advanced — explicit initialization when calibration has been done offline
dimb_bars = make_bars(
    tick_df,
    bar_type="dollar_imbalance",
    exp_ticks_init=11_700,
    exp_imbalance_init=0.02,
)
Эти два способа задания параметров взаимоисключающие: передача target_timeframe вместе с exp_ticks_init или exp_imbalance_init вызывает исключение ValueError. Если для типа информационных баров не передать ни один из этих параметров, также вызывается исключение ValueError с сообщением, в котором указан отсутствующий параметр и приведен пример. На стандартные типы баров это не влияет — target_timeframe игнорируется без предупреждения для 'tick', 'time', 'volume' и 'dollar'.
Для объемных и долларовых баров дисбаланса калибратор умножает оценку дисбаланса соответственно на средний объем тика или среднюю стоимость в долларах, чтобы порог имел правильные единицы измерения. В результате один вызов с target_timeframe='M15' создает бары, закрывающиеся примерно с одинаковой периодичностью независимо от используемой величины — направления, объема или стоимости в долларах.
Практическая рекомендация для торговли в реальном времени: выполните калибровку один раз в офлайн-режиме по полной истории тиков, сохраните полученные exp_ticks_init и exp_imbalance_init в конфигурационном JSON-файле и явно передайте их советнику MQL5 при запуске. Автокалибровка в Python использует полный многолетний набор данных; аналогичный этап в MQL5 ограничен локально кэшированной терминалом историей тиков, которая может охватывать лишь последнюю неделю.
Единый API — make_bars()
Все десять типов баров доступны через единую точку входа. Функция проверяет тип бара, вычисляет общие для всех типов производные столбцы (средняя цена между Bid и Ask, спред, спред в базисных пунктах), передает выполнение соответствующему внутреннему конструктору и выполняет общую постобработку (удаление информации о часовом поясе, приведение к типам меньшей разрядности, логирование):
from afml.data_structures.bars import make_bars

# Standard bars — unchanged interface
time_bars   = make_bars(tick_df, bar_type="time",   bar_size="M5")
tick_bars   = make_bars(tick_df, bar_type="tick",   bar_size=500)
vol_bars    = make_bars(tick_df, bar_type="volume", bar_size=100_000)
dollar_bars = make_bars(tick_df, bar_type="dollar", bar_size=10_000_000)

# Information bars — preferred: let the function derive both initial values
timb_bars = make_bars(tick_df, bar_type="tick_imbalance",   target_timeframe="M15")
vimb_bars = make_bars(tick_df, bar_type="volume_imbalance", target_timeframe="M15")
dimb_bars = make_bars(tick_df, bar_type="dollar_imbalance", target_timeframe="M15")

# Information bars — advanced: explicit initialization skips auto-calibration
dimb_bars = make_bars(
    tick_df,
    bar_type="dollar_imbalance",
    exp_ticks_init=300,
    exp_imbalance_init=0.08,
)
Каждый вызов возвращает DataFrame, индексированный по времени закрытия бара, с единообразными названиями столбцов:
| Столбец | Тип | Примечания |
|---|---|---|
| open, high, low, close | float32 | Цены открытия, максимума, минимума и закрытия (OHLC); по умолчанию — mid_price |
| spread | float32 | Средний спред между Bid и Ask за бар |
| spread_bps | float32 | Спред в базисных пунктах |
| tick_volume | int32 | Количество тиков в баре |
| volume | float32 | Суммарный торговый объем; присутствует, если исходные данные включают объем |
| tick_num | int64 | Глобальный индекс тика на момент закрытия бара (нумерация с 1); позволяет выполнять соединения с привязкой к событиям |
Столбец tick_num заслуживает отдельного упоминания. Когда DataFrame с барами соединяется с исходным потоком тиков для разметки на основе событий (например, методом тройного барьера), ключом соединения должен быть индекс тика, а не временная метка. Два бара, закрывающиеся в пределах одной микросекунды, имеют одинаковые временные метки, но разные индексы тиков. Это возможно для очень маленьких баров дисбаланса во время новостных событий. Столбец tick_num делает такое соединение однозначным.
Выбор типа бара на практике
Ни один тип баров не превосходит остальные для всех инструментов и на всех этапах пайплайна. Приведенные ниже эвристики основаны на опыте построения полного пайплайна, а не только на теоретических рассуждениях.
| Условие | Рекомендуемый тип |
|---|---|
| Стандартный вариант общего назначения, ликвидные валютные пары или акции | Долларовые бары |
| Исследования потока ордеров, рынки с фрагментированным исполнением ордеров | Тиковые бары |
| Товарные инструменты или фьючерсы со стабильными размерами лотов | Объемные бары |
| Выявление режимов, проверка направленных сигналов | Тиковые или долларовые бары дисбаланса |
| Сравнение с базовым вариантом, удобная для чтения отчетность | Временные бары (с фильтром нулевого тикового объема) |
Бары дисбаланса не всегда являются лучшим выбором. Они имеют переменную длину, что усложняет построение признаков с фиксированными окнами. Количество баров зависит от ewm_span, причем характер этой зависимости трудно оценить без полного прохода построения. Параметр target_timeframe смягчает этот эффект, привязывая начальный порог к привычной периодичности, но фактическое количество баров по-прежнему колеблется в зависимости от волатильности и объема. Для первой итерации моделирования стабильным и воспроизводимым выбором являются долларовые бары с порогом, откалиброванным так, чтобы за одну торговую сессию формировалось 30-50 баров. Бары дисбаланса становятся полезны после проверки стандартного пайплайна построения баров, когда уже известно, что последующая модель выигрывает от сэмплирования, адаптируемого к рыночному режиму.
Реализация на MQL5
Приведенный выше модуль Python обрабатывает тики пакетно: полностью сформированный DataFrame разбивается на группы по принадлежности к барам, агрегируется и возвращается за один проход. Советник MQL5 обрабатывает тики по одному в OnTick(), без доступа к будущим данным и без векторизации. При этом нужно решить три задачи, которые в реализации на Python не требуют дополнительных усилий: обработать разрывы при потере соединения терминалом, сохранить состояние EWM баров дисбаланса между перезапусками советника и выполнить прогрев тикового правила при подключении советника в середине потока данных. Это взаимодополняющие реализации одной и той же спецификации. Для совпадения результатов реализаций при практическом использовании необходимо учитывать каждое из этих ограничений.
Реализация на MQL5 состоит из трех заголовочных файлов и одного примера советника:
- CBarConstructor.mqh — абстрактный базовый класс с накопителем OHLC, структурой для передачи бара и интерфейсом сохранения состояния;
- CStandardBars.mqh — конкретные классы CTimeBar, CTickBar, CVolumeBar и CDollarBar, соответствующие стандартным типам баров в Python;
- CImbalanceBars.mqh — классификатор направления тика CTickRule и конструктор CImbalanceBar с состоянием порога EWM для тиковых, объемных и долларовых баров дисбаланса;
- BarBuilderEA.mq5 — пример советника, который создает экземпляр выбранного типа бара, обрабатывает тики в реальном времени, добавляет закрытые бары в CSV-файл и сериализует состояние через OnInit()/OnDeinit().
Иерархия классов
Единый полиморфный базовый класс объединяет общее состояние бара — накопитель OHLC, счетчики тиков и объема, трекер спреда, структуру для передачи бара — и предоставляет один чисто виртуальный метод ProcessTick(). Каждый производный класс реализует его по собственным правилам закрытия бара. Эта архитектура отражает тонкую асимметрию спецификации Лопеса де Прадо: граничный тик — тик, вызывающий закрытие бара, — относится к разным барам в зависимости от их типа.
- Тиковые бары — закрываются при m_tick_volume == bar_size. Тик с номером (bar_size + 1) становится первым тиком нового бара.
- Объемные и долларовые бары — закрываются, когда глобальная накопленная величина пересекает уровень, кратный bar_size. Тик, на котором происходит пересечение, становится первым тиком нового бара, что соответствует семантике cumsum // bar_size в Python.
- Бары дисбаланса — закрываются, когда после добавления последнего тика выполняется условие |θ| ≥ порог. Тик, пересекающий порог, становится последним тиком закрывающегося бара, что соответствует соглашению boundaries[n_bars] = t в Python-функции _detect_imbalance_boundaries().
Смешение этих трех правил привело бы к последовательности баров, отличающейся от эталонной реализации на Python на один тик на каждой границе. Это смещение накапливается при длительном тестировании на истории и полностью нарушает совпадение для баров дисбаланса. Иерархия классов MQL5 учитывает каждое из этих правил.
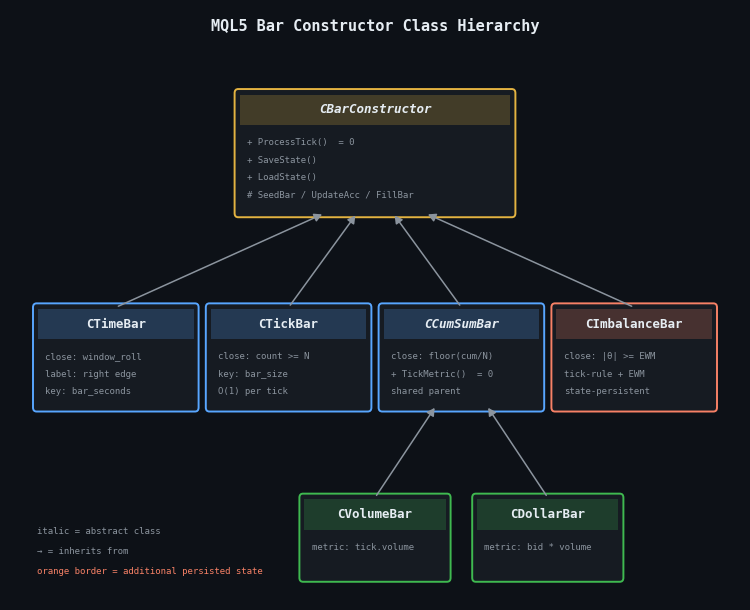
Рис. 7. Трехуровневая схема наследования классов-конструкторов баров MQL5.
- Уровень 1: CBarConstructor (абстрактный класс) содержит общий накопитель OHLC и предоставляет чисто виртуальный метод ProcessTick(), а также интерфейс сохранения состояния SaveState / LoadState.
- Уровень 2: четыре прямых потомка реализуют правила закрытия бара — CTimeBar, CTickBar, промежуточный абстрактный класс CCumSumBar и CImbalanceBar. Оранжевая рамка вокруг CImbalanceBar обозначает единственный класс с дополнительным сохраняемым состоянием помимо базового накопителя.
- Уровень 3: CVolumeBar и CDollarBar наследуются от CCumSumBar и отличаются только величиной на тик, возвращаемой TickMetric().
Базовый класс объявляет общее состояние и три невиртуальных вспомогательных метода — SeedBar(), UpdateAccumulator() и FillBar(), — которые производные классы вызывают в разном порядке:
//+------------------------------------------------------------------+
//| Emitted bar record. Fields mirror the columns produced by the    |
//| Python make_bars() function exactly.                             |
//+------------------------------------------------------------------+
struct SBar
  {
   datetime          time;           // Bar close time (right edge for time bars,
   // last-tick time for all other bar types)
   double            open;           // Open price (bid of the first tick in bar)
   double            high;           // High price (max bid observed in bar)
   double            low;            // Low price  (min bid observed in bar)
   double            close;          // Close price (bid of the last tick in bar)
   double            mid_open;       // Mid-price at bar open
   double            mid_close;      // Mid-price at bar close
   long              tick_volume;    // Number of ticks in the bar
   double            volume;         // Sum of tick.volume (tick-volume proxy on FX)
   double            spread;         // Mean (ask - bid) over the bar
   long              tick_num;       // 1-based global tick index at bar close
   string            bar_type;       // "time" | "tick" | "volume" | "dollar"
   //  | "tick_imbalance" | "volume_imbalance"
   //  | "dollar_imbalance"
  };

//+------------------------------------------------------------------+
//| Abstract base class. Owns the OHLC accumulator and emission      |
//| plumbing. Each derived class implements ProcessTick() with the   |
//| close semantics for its bar type.                                |
//+------------------------------------------------------------------+
class CBarConstructor
  {
protected:
   //--- Bar accumulator state
   bool              m_initialized;
   double            m_open, m_high, m_low, m_close;
   double            m_mid_open, m_mid_close;
   long              m_tick_volume;
   double            m_volume;
   double            m_spread_sum;
   datetime          m_last_tick_time;
   long              m_last_tick_num;
   long              m_bar_start_tick_num;
   string            m_bar_type;

   //--- Seed the accumulator with the first tick of a new bar
   void              SeedBar(const MqlTick &tick, const long tick_num);

   //--- Fold a subsequent tick into the running OHLC/volume/spread
   void              UpdateAccumulator(const MqlTick &tick, const long tick_num);

   //--- Copy closed-bar state into the caller's SBar
   void              FillBar(SBar &bar);

public:
                     CBarConstructor(const string bar_type);
   virtual          ~CBarConstructor(void) {}

   //--- Feed one tick. Returns true iff a bar closed on this call.
   //--- When true, the closed bar is written into out_bar by reference.
   virtual bool      ProcessTick(const MqlTick &tick,
                                 const long tick_num,
                                 SBar &out_bar) = 0;

   //--- State persistence for EA restart recovery. Derived classes
   //--- with additional state (e.g. CImbalanceBar) override to chain.
   virtual bool      SaveState(const int file_handle);
   virtual bool      LoadState(const int file_handle);

   //--- Accessors
   string            BarType(void) const { return m_bar_type; }
   bool              IsInitialized(void) const { return m_initialized; }
  };
SeedBar() инициализирует накопитель OHLC по первому тику нового бара, UpdateAccumulator() учитывает очередной тик в текущей статистике OHLC, объема и спреда, а FillBar() копирует состояние закрытого бара в переданную вызывающим кодом структуру SBar. Производные классы отличаются только тем, в каком порядке они вызывают эти вспомогательные методы относительно проверки условия закрытия бара.
Самый простой производный класс — CTickBar, : он закрывает бар, когда количество тиков достигает bar_size:
//+------------------------------------------------------------------+
//| CTickBar — closes when tick count in the current bar reaches     |
//| bar_size. The (bar_size+1)-th tick is the first of the new bar,  |
//| matching Python's np.arange(len(df)) // bar_size semantics.      |
//+------------------------------------------------------------------+
class CTickBar : public CBarConstructor
  {
private:
   int               m_bar_size;

public:
                     CTickBar(const int bar_size) : CBarConstructor("tick")
     {
      m_bar_size = bar_size;
     }

   virtual bool      ProcessTick(const MqlTick &tick,
                            const long tick_num,
                            SBar &out_bar) override
     {
      if(!m_initialized)
        {
         SeedBar(tick, tick_num);
         return false;
        }

      if(m_tick_volume >= m_bar_size)
        {
         FillBar(out_bar);
         SeedBar(tick, tick_num);
         return true;
        }

      UpdateAccumulator(tick, tick_num);
      return false;
     }
  };
Объемные и долларовые бары имеют общий промежуточный родительский класс CCumSumBar. Он хранит глобальную накопленную величину и идентификатор бара, полученный ее делением на bar_size с округлением вниз. Производные классы различаются только величиной на тик — tick.volume для CVolumeBar и tick.bid * tick.volume для CDollarBar; эта метрика предоставляется через чисто виртуальный метод TickMetric(). Конструктор баров дисбаланса использует тот же шаблон с тремя вспомогательными методами, но добавляет тиковое правило и рекуррентное вычисление EWM со сложностью O(1), рассмотренные в разделе 8.3.
Интеграция с OnTick и вывод данных в формате CSV
Советник хранит указатель типа CBarConstructor* на единственный объект, создаваемый в OnInit() по входному параметру, и вызывает его метод ProcessTick() на каждом поступающем тике. Структура SBar передается в ProcessTick() по ссылке, поэтому при закрытии каждого бара не требуется выделять память в куче. Когда метод ProcessTick() возвращает true, советник добавляет закрытый бар в выходной CSV-файл.
Данные добавляются в выходной CSV-файл, а не перезаписывают его. Функция OpenCsvOutput() перед открытием проверяет, существует ли уже выходной файл. Если файл новый или пустой, записывается строка заголовков. Если файл уже существует и не пуст, указатель перемещается в конец, а строки баров добавляются без удаления данных предыдущего сеанса. Это правильное поведение для советника, работающего в реальном времени, который может перезапускаться десятки раз в течение многодневной сессии:
//+------------------------------------------------------------------+
//| CSV output helpers (using dynamic file name)                     |
//+------------------------------------------------------------------+
bool OpenCsvOutput(void)
  {
//--- Open in append mode if the file exists; else create with header
   bool existed = FileIsExist(g_outputFile);
   g_csv_handle = FileOpen(g_outputFile,
                           FILE_WRITE | FILE_READ | FILE_CSV | FILE_ANSI,
                           ',');
   if(g_csv_handle == INVALID_HANDLE)
     {
      PrintFormat("OpenCsvOutput: FileOpen('%s') failed, err=%d",
                  g_outputFile, GetLastError());
      return false;
     }

   FileSeek(g_csv_handle, 0, SEEK_END);
   if(!existed || FileTell(g_csv_handle) == 0)
     {
      FileWrite(g_csv_handle,
                "time", "open", "high", "low", "close",
                "mid_open", "mid_close",
                "tick_volume", "volume", "spread",
                "tick_num", "bar_type");
     }
   return true;
  }
Теперь выходной CSV-файл также содержит mid_open и mid_close, соответствующие дополнительным полям средней цены между Bid и Ask, добавленным в SBar в этой версии. При проверке совпадения в разделе 8.4 данные сопоставляются по tick_num, на который изменение заголовка не влияет.
Сохранение состояния с проверкой устаревания
Сохранение состояния имеет значение только для баров дисбаланса и только в режиме реального времени. Когда терминал теряет соединение и восстанавливает его, советник инициализируется заново; если скалярные значения EWM сбрасываются к начальным exp_ticks_init и exp_imbalance_init, порог возвращается к значению нулевого бара. Размер бара, закрывающегося сразу после перезапуска, будет рассчитан по устаревшим математическим ожиданиям; несколько следующих баров также будут искажены, пока EWM снова не сойдется.
Решение — сериализовать состояние EWM в OnDeinit() и десериализовать его в OnInit(). Во-первых, в начало файла состояния записывается временная метка сохранения. RestoreState() считывает ее перед загрузкой данных баров и не использует файл, если прошедшее время превышает InpStateMaxAgeMin. Во-вторых, OnDeinit() удаляет файл состояния, когда пользователь удаляет советник (reason == REASON_REMOVE), чтобы устаревший файл с оставленного графика не искажал работу при новом запуске на том же символе:
//+------------------------------------------------------------------+
//| State file helpers (using dynamic file name)                     |
//+------------------------------------------------------------------+
bool RestoreState(void)
  {
   if(!InpUseStateFile)
      return false;
   if(!FileIsExist(g_stateFile, FILE_COMMON))
      return false;

   int fh = FileOpen(g_stateFile, FILE_READ | FILE_BIN | FILE_COMMON);
   if(fh == INVALID_HANDLE)
     {
      PrintFormat("RestoreState: FileOpen(%s) failed, err=%d", g_stateFile, GetLastError());
      return false;
     }

//--- Check staleness
   datetime saved = (datetime)FileReadLong(fh);
   if((TimeCurrent() - saved) > (InpStateMaxAgeMin * 60))
     {
      FileClose(fh);
      PrintFormat("State file %s is stale (saved at %s); discarding.",
                  g_stateFile, TimeToString(saved));
      return false;
     }

   g_tick_num = FileReadLong(fh);
   bool ok = g_bar.LoadState(fh);
   FileClose(fh);

   if(ok)
      PrintFormat("State restored from %s: saved=%s, tick_num=%d, type=%s",
                  g_stateFile, TimeToString(saved), g_tick_num, g_bar.BarType());
   return ok;
  }
FILE_COMMON используется, чтобы файл состояния был общим для всех терминалов, на которых запущен советник. Это актуально, когда на нескольких графиках используется один символ и один терминал теряет соединение, а другой продолжает работу. Методы SaveState()/LoadState() в базовом классе сохраняют состояние накопителя OHLC и счетчиков тиков. CImbalanceBar переопределяет оба метода, чтобы сначала вызвать базовую реализацию, а затем записать или считать дополнительные скалярные значения EWM: m_theta, m_ewm_T, m_ewm_abs_theta, m_exp_T, m_exp_abs_imb, m_bar_tick_count, а также prev_price и prev_sign тикового правила.
Инициализация — передача параметра exp_ticks_init советнику
Советник MQL5 по-прежнему принимает InpExpTicksInit и InpExpImbInit в качестве явных входных параметров, а не вычисляет их автоматически. Это сделано намеренно, а не по недосмотру. Функция _calibrate_information_bar_params() на Python просматривает до 500 000 тиков и выполняет полный расчет тикового правила до построения первого бара. Функция CopyTicksRange() в MQL5 ограничена локально кэшированными терминалом данными, которые могут охватывать лишь последнюю неделю. Такие данные гарантированно не охватят гэпы выходного дня, праздники с низким объемом торгов и ночные сессии — именно те наблюдения, которые позволяют правильно задать начальное E0[T]. Автокалибровка внутри OnInit() по короткой истории даст порог, смещенный в сторону последних рыночных условий, что противоречит задаче стабильной инициализации.
Рекомендуемый порядок действий: выполнить автокалибровку на Python в офлайн-режиме по полному многолетнему набору данных Parquet, записать результат в конфигурационный JSON-файл в MQL5\Files\Common и считать его в OnInit():
# Python: one-time offline calibration against full tick history
bars = make_bars(tick_df, bar_type="dollar_imbalance", target_timeframe="M15")
# Retrieve the seeds that were used internally
config = {"exp_ticks_init": bars.attrs["exp_ticks_init"],
          "exp_imbalance_init": bars.attrs["exp_imbalance_init"]}
with open("EURUSD_imbalance_config.json", "w") as f:
   json.dump(config, f)
Реализация на MQL5 считывает этот файл в OnInit() и передает значения напрямую в CImbalanceBar. Если файл конфигурации отсутствует, советник использует заданные пользователем входные параметры InpExpTicksInit и InpExpImbInit и записывает предупреждение в лог. В прилагаемом исходном коде доступен резервный вариант, использующий CopyTicksRange() по недавней локальной истории, однако по указанным выше причинам он не рекомендуется.
Проверка совпадения с эталонной реализацией на Python
Обе реализации рассчитаны на одну и ту же спецификацию. Если результаты не совпадают, в одной из реализаций есть ошибка; определить, в какой именно, гораздо проще сравнением баров, чем чтением кода. Процедура проверки проста: запустите советник в Тестере стратегий на заданном диапазоне исторических тиков в режиме Каждый тик на основе реальных тиков, экспортируйте бары в CSV через FILE_COMMON, загрузите в ноутбук и CSV-файл, и результат функции make_bars() на Python, затем сопоставьте их tick_num.
import pandas as pd
from afml.data_structures.bars import make_bars
from afml.mt5.clean_data import clean_tick_data

tick_df = pd.read_parquet("EURUSD_2024_01_15.parquet")
tick_df = clean_tick_data(tick_df)

py_bars  = make_bars(tick_df, bar_type="dollar", bar_size=10_000_000)
mql_bars = pd.read_csv("bars_dollar.csv", parse_dates=["time"])

merged = py_bars.merge(mql_bars, on="tick_num",
                       suffixes=("_py", "_mql"), how="outer", indicator=True)

for col in ["open", "high", "low", "close", "tick_volume"]:
   diff = (merged[f"{col}_py"] - merged[f"{col}_mql"]).abs()
   assert diff.max() < 1e-8, f"Mismatch in {col}: max diff {diff.max()}"

print(f"Parity verified across {len(merged)} bars")
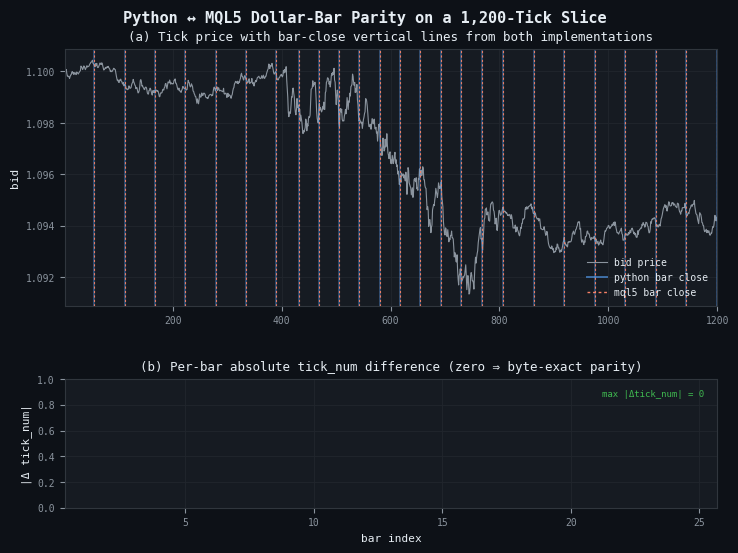
Рис. 8. Проверка совпадения на двух панелях для синтетического среза из 1 200 тиков с тремя заданными режимами волатильности.
- Панель (a) — цена Bid (серая) с нанесенными поверх границами закрытия долларовых баров из Python (синие, более широкие) и MQL5 (оранжевые, пунктирные). Точное совпадение видно по оранжевым штрихам внутри каждой синей полосы.
- Панель (b) — абсолютная разница значений tick_num между двумя реализациями для каждого бара. У всех 25 баров зафиксирована нулевая разница, что отмечено в правом верхнем углу. Любой бар с ненулевой разницей указывает на расхождение, которое нужно устранить перед внедрением.
Три наиболее распространенные причины несовпадения на практике — ошибка на единицу в первом баре (советник получает тик только с Bid, который функция clean_tick_data() на Python отбрасывает из-за отрицательного спреда), систематическое смещение в долларовых барах (две реализации используют разные цены для долларовой величины) и расхождение EWM после перезапуска (реализация на MQL5 начинает с начального состояния, а реализация на Python обрабатывает весь поток данных). Логика добавления данных в CSV, введенная в разделе 8.2, не влияет на совпадение: значения баров, записываемые по сеансам, идентичны значениям при запуске в одном сеансе; меняется только структура файла. При проверке совпадения сравнивайте в Python строки за тот же день, отфильтровав их по time перед объединением.
Заключение
Временные бары используются по умолчанию не потому, что они правильны, а потому, что их легко построить. Каждая особенность, усложняющая машинное обучение на финансовых данных, — непостоянная дисперсия, серийная корреляция, чрезмерная представленность спокойных периодов, — отчасти связана с принятой практикой сэмплирования по фиксированным временным интервалам. Типы баров в afml.data_structures.bars заменяют эту практику сэмплированием на основе рыночной активности: стоимости в долларах, количества тиков, торгового объема или направленного дисбаланса.
Четыре детали реализации отличают рабочий конструктор баров от того, который генерирует обучающие данные с малозаметными ошибками. Первая — фильтр нулевого тикового объема для временных баров: фантомные бары, возникающие при закрытом рынке и в праздники, выглядят в столбцах OHLC точно так же, как реальные, поэтому их необходимо удалять. Вторая — автоматическая калибровка порога для баров дисбаланса: при передаче target_timeframe в make_bars() значения E0[T] и E0[дисбаланс на тик] теперь определяются внутри по тиковым данным. Это устраняет необходимость ручного прохода прогрева, который в AFML не описан явно. Третья относится только к работе в реальном времени: состояние EWM баров дисбаланса должно сохраняться между перезапусками советника с проверкой устаревания, чтобы спокойное закрытие рынка в пятницу не задало неподходящий порог для открытия в понедельник на фоне новостей. Четвертая — добавление данных в CSV в советнике: открытие выходного файла в режиме перезаписи незаметно удаляет все бары, созданные до последнего перезапуска, что лишает смысла логирование по сессиям.
Инфраструктурный слой — партиционированное хранилище Parquet, считываемое через Dask, — необходим для работы с любым набором данных, кроме небольшого учебного. Объем тиковых данных по одной валютной паре за один год превышает доступную память большинства рабочих станций, а издержки загрузки лишних данных растут вместе с размером набора. Партиционирование по годам и месяцам в сочетании с фильтрами по датам на уровне групп строк в Dask удерживает объем используемой памяти в заданных пределах независимо от запрошенного периода тестирования на истории.
Прикрепленные файлы
Перед компиляцией скопируйте папку AlternativeBars в каталог MQL5/Include/, а файл BarBuilderEA.mq5 — в каталог MQL5/Experts/.
| Файл | Описание | |
|---|---|---|
| MQL5 | ||
| AlternativeBars\CBarConstructor.mqh | Абстрактный базовый класс: общий накопитель OHLC, структура SBar для передачи бара (включая mid_open и mid_close) и интерфейс сохранения состояния SaveState/LoadState | |
| AlternativeBars\CStandardBars.mqh | CTimeBar, CTickBar, CCumSumBar, CVolumeBar и CDollarBar — четыре стандартных типа баров | |
| AlternativeBars\CImbalanceBars.mqh | Классификатор направления CTickRule и CImbalanceBar с выбором метрики через ENUM_IMBALANCE_METRIC (тиковая, объемная, долларовая), адаптивным порогом на основе EWM, диагностическими методами доступа (CurrentTheta, CurrentThreshold, ExpT, ExpAbsImb) и полным сохранением состояния | |
| BarBuilderEA.mq5 | Пример советника: создание экземпляров семи типов баров через фабрику, вывод в CSV в режиме добавления с проверкой наличия заголовка, восстановление состояния с проверкой устаревания в OnInit() и удаление файла состояния при REASON_REMOVE в OnDeinit() | |
| Python — afml/data_structures/ | ||
| afml/data_structures/bars.py | Единая точка входа make_bars(): target_timeframe — основной способ настройки информационных баров (оба начальных значения EWM автоматически калибруются по данным); exp_ticks_init / exp_imbalance_init сохранены для расширенного использования как альтернативный способ настройки, несовместимый с передачей target_timeframe | |
| afml/data_structures/information_bars.py | Определение границ с JIT-компиляцией для всех шести типов информационных баров; ядро тикового правила, рекуррентное вычисление EWM со сложностью O(1) в _detect_imbalance_boundaries() и векторизованное агрегирование с помощью np.add.reduceat | |
| afml/data_structures/calibration.py | _calibrate_information_bar_params() определяет E0[T] по медианной плотности тиков на целевом таймфрейме, а E0[дисбаланс на тик] — по эмпирическому направленному смещению на выборке до 500 000 тиков с масштабированием к нужным единицам для объемных и долларовых вариантов | |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/22063
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 Построение системы обнаружения дивергенций: Создание пользовательского индикатора MPO4
 Перекрестный рекуррентный количественный анализ (CRQA) в MQL5: Разработка полноценной библиотеки анализа
 Нейронная сеть на практике: Вопрос шкалы
 От начального к среднему уровню: Объекты и подокна (III)

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования
Итак, вы придумываете графики без временной шкалы — с полосками равного объема, диапазонными полосками, Ренко и т. д.?
Странно читать такие вещи:
source of raw tick data via copy_rates_from_pos()
потому что эта функция возвращает котировки/бары, а не тики.
Итак, вы создаете графики без временной шкалы — например, с одинаковым объемом, диапазонные, Ренко и т. д.?
Странно читать такие вещи:
потому что эта функция возвращает котировки/бары, а не тики.