

Персистентная гомология в MQL5: Алгоритм приведения и диаграмма персистентности
 41
 0

Содержание
- Введение — от граничной матрицы к диаграмме
- Диаграмма персистентности на графике
- Гомология — что подсчитывает диаграмма
- Алгоритм приведения
- Реализация — CTDAReduction
- Существенные признаки и артефакт усечения
- Диаграмма — SPersistencePair и CTDADiagram
- Фасад CTDA
- Проверка с помощью Ripser
- Что дальше?
- Заключение
Введение — от граничной матрицы к диаграмме
В предыдущей статье мы создали два класса. Фильтрация Вьеториса — Рипса перечисляла все вершины, ребра и треугольники, отсортированные по масштабу их включения в комплекс. Граничная матрица фиксировала для каждого симплекса симплексы меньшей размерности, образующие его границу. В итоге мы получили отсортированный список симплексов и разреженную матрицу над Z/2.
Эта матрица содержит ответ, но не в читаемом виде. Петли и связные компоненты закодированы во взаимосвязях ее столбцов, а не указаны явно. Их извлечение — задача одного алгоритма: стандартного столбцового приведения. Это вычислительное ядро персистентной гомологии, реализованное в данной статье.
Результатом становится диаграмма персистентности. Каждая запись — пара "рождение-смерть": топологический признак, его гомологическая размерность, масштаб появления и масштаб исчезновения. Долгоживущие пары отражают реальную структуру. Короткоживущие пары — это шум. Именно к этому результату подводили первые две статьи.
В этой статье представлены три класса. CTDAReduction выполняет приведение. CTDADiagram хранит полученные пары и позволяет получать сведения о них. CTDA — фасад, запускающий весь шестиэтапный вычислительный пайплайн одним вызовом. В итоге можно передать ценовое окно в один вызов Compute. Вызов возвращает диаграмму персистентности, значения рождения и смерти в которой совпадают с независимым эталоном с точностью до шести знаков после запятой. Статья завершается этой проверкой: побитовым сравнением с результатами Ripser.
Диаграмма персистентности на графике
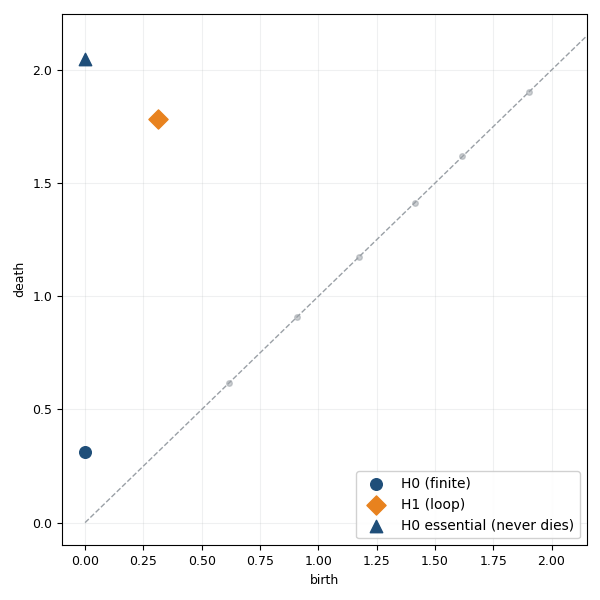
Рис. 1. Диаграмма персистентности единичной окружности, представленной 20 точками. Девятнадцать H0-интервалов компонент умирают при 0,3129, одна H0-компонента никогда не умирает, а единственная H1-петля рождается при 0,3129 и умирает при 1,7820.
Рисунок выше показывает готовый результат. Это диаграмма персистентности окружности, представленной 20 точками, полностью рассчитанная библиотекой. По горизонтальной оси отложено рождение, по вертикальной — смерть, а каждая точка соответствует одному топологическому признаку.
Рассмотрим диаграмму в двух частях. В левом нижнем углу один синий маркер представляет девятнадцать H0-интервалов: девятнадцать из двадцати точек сливаются с соседними при масштабе 0,3129. Синий треугольник вверху — единственная связная компонента, которая никогда не умирает. Оранжевый ромб высоко над диагональю — главный результат: одна H1-петля, рождающаяся при замыкании кольца на 0,3129 и исчезающая при заполнении на 1,7820. Одна окружность — одна петля. На диаграмме это выражено одной точкой.
Именно это и дает эта статья. Далее объясняется, как приведение создает диаграмму и почему ее числовые значения верны.
Гомология — что подсчитывает диаграмма
Персистентная гомология подсчитывает "дыры", распределенные по размерностям. Используются обозначения H0, H1 и H2; каждая размерность учитывает свой тип топологического признака.
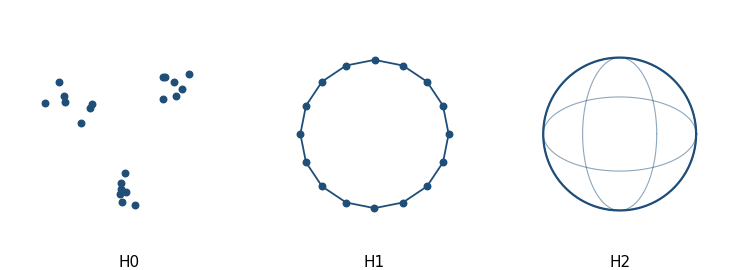
Рис. 2. Персистентная гомология подсчитывает связные компоненты (H0), петли (H1) и замкнутые полости (H2).
H0 подсчитывает связные компоненты. При очень малом масштабе каждая точка является отдельной связной компонентой. По мере увеличения масштаба точки сливаются. Каждое слияние уничтожает один H0-признак. Число существующих H0-признаков при данном масштабе равно количеству отдельных частей облака на этом масштабе.
H1 подсчитывает петли. Петля — замкнутое кольцо ребер с пустой внутренней областью, как на центральной панели предыдущей статьи. Петля рождается, когда кольцо замыкается, и умирает, когда треугольники заполняют внутреннюю область. Петля, сохраняющаяся в широком диапазоне масштабов, — реальный цикл в данных.
H2 подсчитывает полости. Полость — замкнутая внутренняя область, например внутреннее пространство сферы. Библиотека строит симплексы до треугольников включительно, поэтому надежно обнаруживает H0 и H1. Для надежного обнаружения H2 нужны тетраэдры, которые библиотека не строит. В одном из последующих разделов объясняется, как библиотека обрабатывает H2-артефакты, возникающие из-за усечения.
Каждый топологический признак имеет рождение и смерть, измеряемые параметром масштаба epsilon, который задает фильтрацию. Персистентность признака равна разности смерти и рождения. Признак, не умирающий в пределах фильтрации, называется существенным и имеет бесконечное значение смерти.
На плоскости "рождение-смерть" рисунка 1 персистентность — вертикальное расстояние от диагонали. Точки вблизи диагонали рождаются и умирают почти при одном масштабе, поэтому представляют собой кратковременный шум. Точки значительно выше диагонали сохраняются на многих масштабах — именно эти признаки заслуживают внимания. Чтение диаграммы персистентности в основном сводится к тому, чтобы не учитывать диагональ и смотреть на точки над ней. Единственный оранжевый ромб окружности передает всю суть метода: одно число говорит, что здесь есть одна реальная петля.
Алгоритм приведения
Граничная матрица содержит по одному столбцу для каждого симплекса; столбцы упорядочены по фильтрации. В каждом столбце перечислены грани соответствующего симплекса в виде индексов строк, отсортированных по возрастанию. Ведущий элемент столбца — его нижняя грань, то есть последняя запись в отсортированном столбце. Приведение делает каждый ведущий элемент уникальным.
Процедура проста. Столбцы обрабатываются слева направо. Для каждого столбца определяется его ведущий элемент. Если эта строка ведущего элемента уже закреплена за более ранним столбцом, более ранний столбец добавляется к текущему. Над Z/2 сложение двух столбцов соответствует симметрической разности множеств граней: общие грани сокращаются, остальные остаются. Сложение изменяет ведущий элемент. Операция повторяется, пока ведущий элемент не станет новым или столбец не опустеет.
Новый ведущий элемент означает смерть. Симплекс текущего столбца заполняет признак, созданный более ранним симплексом. Записывается пара: рождение соответствует симплексу ведущей строки, смерть — текущему симплексу. Пустой столбец означает рождение. Симплекс создал топологический признак, который пока не был уничтожен. Эти непарные порождающие симплексы становятся существенными признаками.
Два проектных решения обеспечивают высокую скорость работы. Столбцы хранятся в отсортированном виде, поэтому чтение ведущего элемента сводится к одному обращению к последнему элементу массива. Таблица ведущих элементов сопоставляет каждую занятую ведущую строку со столбцом-владельцем, поэтому нужный для сложения столбец находится одним обращением, а не сканированием. Основную долю затрат составляют операции симметрической разности; число треугольников из предыдущей статьи объясняет, почему приведение — самый дорогостоящий этап пайплайна.
Полезно рассматривать приведение как исключение Гаусса над полем из двух элементов. Каждое сложение столбцов — это строковая операция, а конечное состояние — матрица, в которой никакие два столбца не имеют общего ведущего элемента. Один из фундаментальных результатов персистентной гомологии состоит в том, что спаривание не зависит от порядка сложения столбцов. Независимо от последовательности сложений алгоритм формирует одно и то же множество пар "рождение-смерть". Именно эта инвариантность позволяет доверять одному проходу слева направо и делает значимым сравнение с независимой реализацией.
Реализация — CTDAReduction
Наиболее часто используемая операция — сложение столбцов над Z/2. Она объединяет два отсортированных списка граней и удаляет каждую грань, присутствующую в обоих.
//+------------------------------------------------------------------+
//| Symmetric difference of two sorted ascending int arrays          |
//+------------------------------------------------------------------+
void CTDAReduction::XorColumns(const int &a[], const int &b[], int &out[]) const
  {
   int na = ArraySize(a);
   int nb = ArraySize(b);
   ArrayResize(out, na + nb);
   int i = 0, j = 0, k = 0;
   while(i < na && j < nb)
     {
      if(a[i] < b[j])      { out[k++] = a[i++]; }
      else if(a[i] > b[j]) { out[k++] = b[j++]; }
      else                  { i++; j++; }   // equal entries cancel under Z/2
     }
   while(i < na) out[k++] = a[i++];
   while(j < nb) out[k++] = b[j++];
   ArrayResize(out, k);
  }
Процедура синхронно проходит по обоим массивам, как при слиянии отсортированных списков. Когда текущие элементы различаются, в результат копируется меньший индекс. Если они равны, оба пропускаются: грань, присутствующая в обоих столбцах, сокращается по модулю 2. Оставшиеся элементы любого списка добавляются в конец. Результат — отсортированная симметрическая разность, готовая снова стать столбцом.
Основной цикл выполняет приведение. Для каждого столбца цикл считывает ведущий элемент и либо добавляет сохраненный столбец-владелец этого элемента, либо назначает его новым.
   //--- main reduction loop
   for(int j = 0; j < numCols; j++)
     {
      boundary.GetColumn(j, workCol);
      int currentSize = ArraySize(workCol);

      while(currentSize > 0)
        {
         int p = workCol[currentSize - 1];   // pivot = last (largest) entry

         if(m_pivotCol[p] >= 0)
           {
            //--- XOR with the stored reduced column for pivot row p
            int start = m_reducedStart[p];
            int sz    = m_reducedSize[p];
            ArrayResize(storedCol, sz);
            for(int k = 0; k < sz; k++)
               storedCol[k] = m_reducedEntries[start + k];

            XorColumns(workCol, storedCol, xorOut);

            int newSize = ArraySize(xorOut);
            ArrayResize(workCol, newSize);
            for(int k = 0; k < newSize; k++)
               workCol[k] = xorOut[k];
            currentSize = newSize;
           }
         else
           {
            //--- new pivot found at row p -> record persistence pair
            m_pivotCol[p] = j;
            StoreReducedColumn(p, workCol);

            SSimplex sBirth, sDeath;
            rips.Get(p, sBirth);
            rips.Get(j, sDeath);

            // emit pair only if persistence > 0 (sometimes filtration ties give 0-length)
            // we keep zero-persistence pairs too - they are valid topological events
            diagram.Add(sBirth.filtration, sDeath.filtration, sBirth.dim, p, j);
            break;
           }
        }

      if(currentSize == 0)
         m_isCreator[j] = true;
     }
Внутренний цикл while выполняет столбцовое приведение. Он считывает ведущий элемент p как последнюю запись рабочего столбца. Если m_pivotCol[p] уже содержит владельца, сохраненный приведенный столбец этого ведущего элемента извлекается и добавляется с помощью XorColumns. Это укорачивает или сдвигает рабочий столбец и меняет его ведущий элемент. Если ведущая строка свободна, столбец находит новый ведущий элемент. Библиотека фиксирует пару "рождение-смерть" по двум симплексам, сохраняет приведенный столбец под его ведущим элементом для последующих сложений и выходит из цикла. Столбец, полностью приведенный к пустому, создает топологический признак, поэтому соответствующий симплекс помечается как порождающий.
Пара рождение-смерть берется непосредственно из значений фильтрации. Симплекс в ведущей строке — порождающий, поэтому его значение фильтрации соответствует рождению. Текущий симплекс — уничтожающий, поэтому его значение фильтрации соответствует смерти. Библиотека сохраняет пары даже при равенстве рождения и смерти, поскольку интервал персистентности нулевой длины все равно является допустимым событием. Такие случаи отфильтровываются позже, когда это необходимо.
Столбцовое приведение вручную
Четырехточечная петля из предыдущей статьи делает алгоритм наглядным. Возьмем четыре точки в углах квадрата, соединенные четырьмя сторонами, причем диагонали слишком длинны, чтобы войти в фильтрацию. Симплексы в порядке фильтрации: четыре вершины, затем четыре ребра:
0: v0 1: v1 2: v2 3: v3 4: e01 5: e12 6: e23 7: e30
Четыре столбца вершин пусты, поэтому каждая вершина является порождающим симплексом. Четыре связные компоненты рождаются при нулевом масштабе. Каждое из первых трех ребер находит свободный ведущий элемент и сразу образует пару, фиксируя смерти трех связных компонент по мере слияния точек в один объект:
e01 с ведущим элементом v1 дает (v1, e01), e12 с ведущим элементом v2 дает (v2, e12), e23 с ведущим элементом v3 дает (v3, e23).
На четвертом ребре появляется петля. Столбец e30 начинается с набора граней {v0, v3}, а его ведущий элемент v3 уже принадлежит e23. Теперь при приведении столбцы добавляются до тех пор, пока ведущий элемент не станет новым или столбец не опустеет:
| Шаг | Рабочий столбец | Ведущий элемент | Действие |
|---|---|---|---|
| e30 (начало) | {v0, v3} | v3 | ведущий элемент принадлежит e23; добавить его |
| + e23 {v2, v3} | {v0, v2} | v2 | ведущий элемент принадлежит e12; добавить его |
| + e12 {v1, v2} | {v0, v1} | v1 | ведущий элемент принадлежит e01; добавить его |
| + e01 {v0, v1} | { } пусто | нет | столбец становится пустым: рождается петля |
Столбец e30 приводится к пустому столбцу. Пустой столбец — признак порождающего симплекса: четвертое ребро замыкает цикл, который не объясняется ни одним более ранним симплексом. Треугольника, который мог бы заполнить квадрат, нет, поэтому петлю ничто не уничтожает и она выводится как существенный признак H1. Итоговая диаграмма содержит одну связную компоненту, три конечных интервала персистентности H0 и одну существенную петлю H1. Это в точности топология контура квадрата: одна компонента — одна "дыра".
Существенные признаки и артефакт усечения
После обработки всех столбцов порождающие симплексы, ни разу не использованные как ведущий элемент, задают существенные признаки. Они никогда не умирают в фильтрации, поэтому имеют бесконечное значение смерти. Существенный признак H0 — единственная связная компонента, сохраняющаяся до конца. Существенный признак H1 — это петля, которую фильтрация никогда не заполняет.
Есть одно важное уточнение. Эта библиотека ограничивается треугольниками, поэтому ее максимальная размерность равна 2. Треугольник, создающий признак H2, может быть уничтожен только тетраэдром, а тетраэдры не строятся. Поэтому каждый такой треугольник будет отмечен как существенный признак H2, даже если он не представляет реальную полость. Это артефакты усечения фильтрации, а не настоящие полости.
   //--- emit essential features
   //    A creator simplex at the maximum built dimension can never be killed,
   //    so when maxDim = 2 every triangle that does not kill an H1 becomes
   //    a spurious "essential H2" feature (filtration-truncation artifact).
   //    For clean H0 + H1 analysis we suppress these by default;
   //    H0 and H1 essentials are always emitted.
   int ripsMaxDim = rips.MaxDim();
   for(int j = 0; j < numCols; j++)
     {
      if(!m_isCreator[j])      continue;
      if(m_pivotCol[j] >= 0)   continue;

      SSimplex s;
      rips.Get(j, s);

      //--- only the top-dim essentials when maxDim = 2 are dropped;
      //    in maxDim = 1 mode the H1 essentials are the real loops.
      if(!m_emitTopDimEssentials && ripsMaxDim >= 2 && s.dim == ripsMaxDim)
         continue;

      diagram.Add(s.filtration, TDA_INF, s.dim, j, -1);
     }
Цикл выводит бесконечный интервал персистентности для каждого несопоставленного порождающего симплекса, но с одной защитной проверкой. Когда максимальная построенная размерность равна 2, порождающий симплекс размерности 2 по умолчанию подавляется, поскольку это артефакт усечения, а не реальная полость. Существенные признаки H0 и H1 всегда выводятся, поскольку они реальны. Это поведение настраивается: вызов SetEmitTopDimEssentials(true), не показанный здесь, восстанавливает необработанный вывод для вызывающей стороны, которой он нужен. Для обычного анализа H0 и H1 значение по умолчанию сохраняет диаграмму чистой.
Диаграмма — SPersistencePair и CTDADiagram
Каждый топологический признак представлен отдельной структурой. В структуре фиксируются масштабы рождения и смерти, размерность гомологии и два задействованных симплекса.
//+------------------------------------------------------------------+
//| SPersistencePair - one topological feature (birth, death, dim)   |
//|                                                                  |
//|  A persistent feature is born at filtration value 'birth' (when  |
//|  the simplex that creates it enters the complex) and dies at     |
//|  'death' (when a higher-dim simplex fills it in). Features that  |
//|  never die in the filtration carry death = TDA_INF.              |
//+------------------------------------------------------------------+
struct SPersistencePair
  {
   double   birth;          // filtration value when feature appears
   double   death;          // filtration value when feature dies (TDA_INF if alive)
   int      dim;            // homological dimension (0 = component, 1 = loop, 2 = void)
   int      birthSimplex;   // simplex index that created this feature
   int      deathSimplex;   // simplex index that killed it (-1 if alive)

   double   Persistence() const
     {
      return (death >= TDA_INF) ? TDA_INF : (death - birth);
     }

   bool     IsInfinite() const
     {
      return (death >= TDA_INF);
     }

   void     Reset()
     {
      birth        = 0.0;
      death        = 0.0;
      dim          = 0;
      birthSimplex = -1;
      deathSimplex = -1;
     }
  };
Назначение структуры проясняют два вспомогательных метода. Персистентность равна разности смерти и рождения; бесконечный случай обрабатывается явно. IsInfinite отмечает существенные признаки, использующие TDA_INF, определенное как DBL_MAX, в качестве сторожевого значения смерти. Поле dimension позволяет отличить H0 от H1 и H2.
Класс CTDADiagram собирает пары и позволяет определить число пар в размерности, суммарную и максимальную персистентность, а также число Бетти на любом масштабе. Число Бетти — количество признаков, живых при выбранном ε; именно это кодирует диаграмма персистентности.
//+------------------------------------------------------------------+
//| Number of features alive at a given filtration value (Betti)     |
//+------------------------------------------------------------------+
int CTDADiagram::BettiNumber(int dim, double epsilon) const
  {
   int c = 0;
   for(int i = 0; i < m_count; i++)
     {
      if(m_pairs[i].dim != dim) continue;
      if(m_pairs[i].birth > epsilon) continue;          // not yet born
      if(!m_pairs[i].IsInfinite()
         && m_pairs[i].death <= epsilon) continue;       // already dead
      c++;
     }
   return c;
  }
Топологический признак жив при ε, если он родился при ε или раньше и еще не умер. Метод пропускает еще не родившиеся признаки и конечные признаки, уже умершие, а остальные подсчитывает. Если прогонять ε от нуля вверх, диаграмма превращается в кривую Бетти — количество компонент или петель как функцию масштаба.
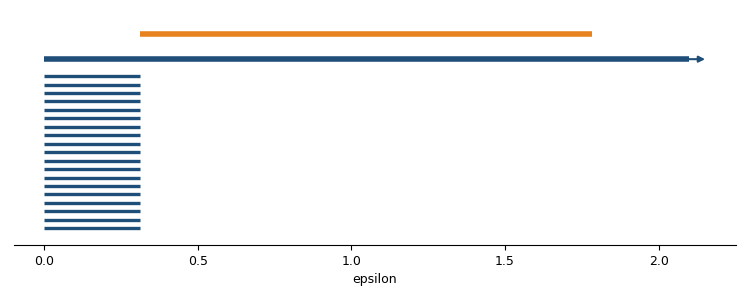
Рис. 3. Та же диаграмма в виде штрихкода персистентности. Каждый интервал персистентности простирается от рождения до смерти. Единственный длинный интервал H1 соответствует единственной петле окружности.
Штрихкод персистентности выше содержит ту же информацию в другом виде. Каждый топологический признак представлен горизонтальным интервалом персистентности от рождения до смерти. Девятнадцать коротких интервалов H0 заканчиваются на 0,3129. Существенный интервал H0 уходит за правый край. Единственный длинный интервал H1 — это петля. Один длинный интервал в H1 означает одну петлю — это видно сразу.
Фасад CTDA
Шесть этапов — облако точек, матрица расстояний, фильтрация, граничная матрица, приведение и диаграмма — всегда выполняются в одном порядке. Фасад CTDA связывает их, поэтому вызывающий код не обращается к внутренним компонентам.
//+------------------------------------------------------------------+
//| Full pipeline: series to persistence diagram                     |
//+------------------------------------------------------------------+
bool CTDA::Compute(const double &series[], int N)
  {
   m_computed = false;
   m_diagram.Clear();

   if(N < 4)
     {
      Print("CTDA::Compute - series too short (min 4 bars)");
      return false;
     }

   //--- 1. Embed series into point cloud
   if(!m_cloud.Build(series, N, m_embDim, m_delay))
      return false;

   //--- 2. Compute full pairwise distance matrix
   if(!m_distance.Build(m_cloud, m_norm))
      return false;

   //--- 3. Determine maxEpsilon (auto vs fixed)
   double maxEps = m_maxEpsilon;
   if(m_autoEpsilon)
      maxEps = m_distance.MaxDistance() * m_maxEpsilonFrac;
   if(maxEps <= 0.0)
     {
      Print("CTDA::Compute - invalid maxEpsilon (<= 0)");
      return false;
     }
   m_maxEpsilon = maxEps;

   //--- 4. Build Vietoris-Rips filtration
   if(!m_rips.Build(m_distance, maxEps, m_maxDim))
      return false;

   //--- 5. Build boundary matrix
   if(!m_boundary.Build(m_rips))
      return false;

   //--- 6. Reduce boundary -> persistence pairs
   if(!m_reduction.Compute(m_rips, m_boundary, m_diagram))
      return false;

   m_computed = true;
   return true;
  }
Метод Compute выполняет пайплайн от начала до конца и останавливается при первом сбое. Метод выполняет вложение ряда методом Такенса из первой статьи, строит матрицу попарных расстояний, выбирает порог VR — по умолчанию долю диаметра облака, — затем строит фильтрацию и граничную матрицу из второй статьи и выполняет приведение. При возврате true диаграмма готова к запросам. Для вызывающего кода весь топологический механизм сводится к одному вызову метода.
Небольшой скрипт демонстрирует весь интерфейс.
#include <TDA/TDA.mqh>

void OnStart()
  {
   double close[];
   if(CopyClose(_Symbol, _Period, 0, 120, close) != 120)
      return;

   CTDA tda;
   tda.SetEmbedding(3, 1);          // dimension d = 3, delay tau = 1
   tda.SetMaxEpsilonAuto(1.0);      // VR cutoff = full cloud diameter
   tda.SetMaxDim(2);                // compute H0 and H1

   if(tda.Compute(close, 120))
     {
      tda.PrintSummary();
      double h1 = tda.PersistenceEntropy(1);
      PrintFormat("H1 persistence entropy = %.4f", h1);
     }
  }
Вызывающий код задает размерность и задержку вложения, выбирает автоматический порог VR и запрашивает H0 и H1. После возврата Compute доступны диаграмма и все производные метрики. Энтропия персистентности, используемая индикатором в следующей статье, — одна из таких метрик; она вычисляется непосредственно по конечным интервалам персистентности в заданной размерности.
Проверка по Ripser
Топологическая библиотека полезна только в том случае, если ее численные результаты корректны. Диаграммы персистентности, создаваемые этой библиотекой, сверены с эталонной реализацией Ripser с точностью до 10^-6 на семи независимых тестовых примерах: шести синтетических геометрических конфигурациях и окне из 80 реальных рыночных баров, обработанном полным пайплайном вложения Такенса.
Проверка выполняется на трех уровнях с возрастающей строгостью.
| Уровень | Скрипт | Что проверяет |
|---|---|---|
| 1 | TDA_Test_KnownTopology.mq5 | Поведенческие сигнатуры: периодические, хаотические, тривиальные |
| 2 | TDA_Test_GroundTruth.mq5 | Сопоставление точных значений рождения и смерти с аналитическими прогнозами для семи облаков точек |
| 3 | TDA_Export_*.mq5 + tda_crosscheck.py | Побитовое совпадение с Ripser, в том числе на реальных рыночных данных |
На уровне 2 точные значения сверяются с результатами геометрических расчетов, выполненных вручную. Для единичной окружности с N=20 точками библиотека фиксирует рождение петли H1 при 0,312869 — это совпадает с аналитически вычисленной длиной хорды 2 sin(pi/20) с точностью до шести знаков после запятой. Затем петля умирает при 1,782013, а ее персистентность составляет 1,469144. Это единственный доминирующий топологический признак H1 окружности. Для семи геометрических конфигураций набор тестов выполняет 31 независимую проверку; все они проходят успешно.
Уровень 3 — самый строгий. Те же облака экспортируются в CSV, затем в Python запускается Ripser, после чего две диаграммы сравниваются интервал за интервалом.
| Тестовый пример | Точки | Пары MQL5 | Интервалы Ripser | Результат |
|---|---|---|---|---|
| единичная окружность, N = 20 | 20 | 191 | 21 | совпадение |
| единичная окружность, N = 50 | 50 | 1226 | 51 | совпадение |
| два кластера | 10 | 46 | 11 | совпадение |
| две непересекающиеся окружности | 20 | 191 | 22 | совпадение |
| случайное расположение точек | 30 | 436 | 31 | совпадение |
| вложение синусоиды | 75 | 2776 | 21 | совпадение |
| окно реальных рыночных данных | 78 | 3004 | 91 | совпадение |
Число пар различается из-за особенностей реализации. Библиотека сохраняет каждую пару, включая интервалы персистентности нулевой длины, где рождение совпадает со смертью. Ripser по умолчанию отбрасывает их. После фильтрации интервалов с нулевой персистентностью нетривиальные интервалы совпадают с точностью до 10^-6 в каждом случае. В столбце MQL5 указано исходное число пар, в столбце Ripser — число интервалов после фильтрации, а справа — результат сравнения после фильтрации.
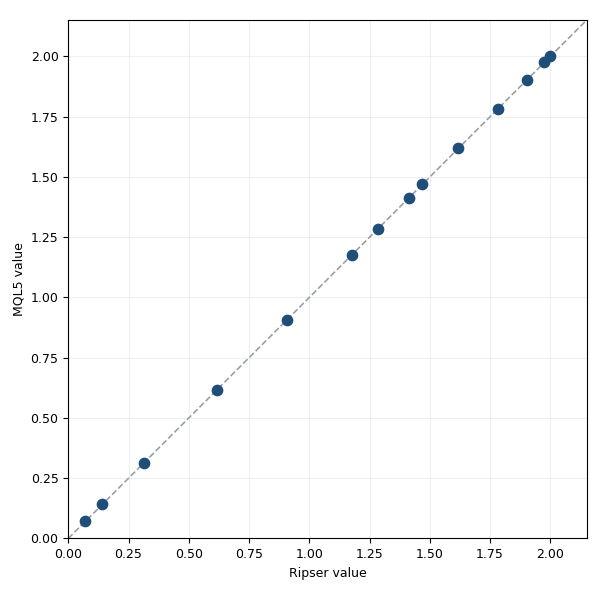
Рис. 4. На графике каждое значение персистентности из библиотеки сопоставлено со значением Ripser для того же интервала. Все точки лежат на диагонали, что наглядно свидетельствует о совпадении результатов с точностью до 10^-6 во всех семи случаях перекрестной проверки.
Последний тестовый пример — не синтетическая геометрическая конфигурация. Это окно из 80 реальных рыночных баров, взятое прямо с графика (в данном запуске — XAU/USD на минутном таймфрейме). Вложение выполнено той же библиотекой, после чего результат экспортирован в CSV. В Python загружается этот CSV-файл и запускается Ripser; результаты для 91 нетривиального интервала персистентности совпадают. Пайплайн, который будет использоваться в индикаторе из следующей статьи, строит на реальных рыночных данных диаграммы, совпадающие с независимым эталоном.
Это совпадение исключает основные сценарии сбоя. Любая ошибка на единицу в индексах граничных граней, а также ошибка в знаке, порядке, правиле выбора ведущего элемента или сортировке по фильтрации сместила бы хотя бы одно значение рождения или смерти с правильной позиции. Во всех семи облаках — от окружности без шума до окна реальных рыночных данных с шумом — каждый нетривиальный интервал персистентности находится именно там, где его размещает эталон. Вычислительный пайплайн внутренне согласован и дает те же результаты, что и независимая реализация на другом языке программирования.
Уточнение формулировок. Библиотека не работает быстрее Ripser, а слово "точный" используется только для сравнения после фильтрации: совпадения с точностью до 10^-6 после удаления интервалов с нулевой персистентностью. Это честная формулировка, и этого достаточно.
Что дальше
Библиотека проверена. Она преобразует ценовое окно в диаграмму персистентности, численные значения которой совпадают с независимым эталоном. В заключительной статье эта диаграмма будет использована на реальном графике.
- Энтропия персистентности: одно число, характеризующее разброс длин интервалов персистентности в заданной размерности.
- Энтропия H0 как показатель фрагментации рынка, энтропия H1 как показатель циклической сложности.
- Индикатор PersistenceEntropy_Indicator, его архитектура на основе скользящего окна и защитные механизмы, обеспечивающие быстрый отклик.
- Примеры рыночных режимов в реальном времени и схема получения результатов CTDA в советнике.
Заключение
В этой статье завершена работа над вычислительным ядром. В ней граничная матрица была приведена к диаграмме персистентности, а результат — проверен.
- CTDAReduction выполняет стандартное столбцовое приведение над Z/2, сопоставляя порождающие симплексы с уничтожающими, а непарные выводит как существенные признаки. Артефакты максимальной размерности по умолчанию подавляются.
- CTDADiagram и SPersistencePair хранят пары "рождение-смерть" и позволяют получить число пар по размерностям, суммарную и максимальную персистентность, числа Бетти и энтропию персистентности.
- CTDA объединяет шестиэтапный пайплайн в один вызов Compute.
Теперь вы можете самостоятельно запустить пайплайн вычислений целиком. Один вызов CTDA::Compute для ценового окна возвращает диаграмму персистентности, а CTDADiagram дает ответы на все вопросы о ней: число пар по размерностям, суммарная и максимальная персистентность, числа Бетти и энтропия персистентности. Числа не просто заявляются, а проверяются. Успешно пройдена 31 из 31 проверки по эталонным значениям, а диаграммы совпадают с результатами Ripser с точностью до 10^-6 в семи случаях, включая реальные рыночные данные. В следующей статье этот проверенный вычислительный пайплайн станет основой индикатора рыночного режима.
Файлы, приложенные к этой статье, также доступны на Algo Forge.
| # | Имя файла | Тип | Описание |
|---|---|---|---|
| 1 | TDAPointCloud.mqh | Заголовочный файл | Вложение Такенса (из статьи 1) |
| 2 | TDADistance.mqh | Заголовочный файл | Матрица попарных расстояний (из статьи 1) |
| 3 | TDARips.mqh | Заголовочный файл | Фильтрация Вьеториса — Рипса (из статьи 2) |
| 4 | TDABoundary.mqh | Заголовочный файл | Граничная матрица над Z/2 (из статьи 2) |
| 5 | TDAReduction.mqh | Заголовочный файл | Столбцовое приведение к парам персистентности (эта статья) |
| 6 | TDADiagram.mqh | Заголовочный файл | Диаграмма персистентности и аналитика (эта статья) |
| 7 | TDA.mqh | Заголовочный файл | Фасад CTDA, полный вычислительный пайплайн (эта статья) |
| 8 | TDA_Facade_Demo.mq5 | Скрипт | Рабочий пример использования фасада: один вызов Compute для получения диаграммы персистентности |
| 9 | TDA_Test_KnownTopology.mq5 | Скрипт | Проверки поведенческих сигнатур на уровне 1 |
| 10 | TDA_Test_GroundTruth.mq5 | Скрипт | Проверки по эталонным значениям на уровне 2 (31/31) |
| 11 | TDA_Export_For_Crosscheck.mq5 | Скрипт | Экспортирует синтетические облака точек для перекрестной проверки с Ripser |
| 12 | TDA_Export_LiveMarket.mq5 | Скрипт | Экспортирует окно реальных рыночных данных для перекрестной проверки |
| 13 | tda_crosscheck.py | Python | Запускает Ripser и сравнивает результаты с выводом MQL5 |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/23233
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 MQL5 Bootstrap (II): Основные валидаторы для надежных торговых систем
 Рыночная микроструктура в MQL5 (Часть 7): Классификация рыночных режимов
 За пределами GARCH (Часть VIII): Библиотека MMAR и ее использование в советнике
 За пределами GARCH (Часть VII): Прогнозирование волатильности методом Монте-Карло в MQL5

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования