

Рыночная микроструктура в MQL5 (Часть 7): Классификация рыночных режимов
 37
 0

Введение
Часть 1 заложила защитную основу. Во второй и третьей частях мы проверили, обладает ли цена памятью. В четвертой части мы исследовали динамику волатильности и устойчивость ее изменений. В пятой части мы разделили вариацию цены на шум и сигнал. В шестой части мы определили направление информированного потока ордеров. Вместе части 2-6 дают одиннадцать показателей рыночной среды на минутном таймфрейме.
Каждый показатель сам по себе информативен. Однако показатели коррелируют и частично дублируют друг друга; одновременно учитывать их все при принятии решений в реальном времени невозможно. Система расчета размера позиции не может реагировать на одиннадцать отдельных сигналов. Нужно свести показатели к единой составной метке, кратко описывающей текущую рыночную среду сессии, и оценке достоверности, отражающей надежность согласования доступных измерений.
В седьмой части реализовано это сведение к единой классификации. Функция RegimeClassifier() получает результаты частей 2-6 и присваивает одну из шести меток режима (нормальный, стрессовый, шумовой, информированный, трендовый, возврат к среднему). Также она возвращает оценку достоверности в диапазоне [0, 1] и составную оценку направления в диапазоне [-1, +1]. Границы классификации получены эмпирически по 514 сессиям NQ M1. Шесть меток описывают разные торговые условия, требующие соответствующего выбора размера позиции, размещения стоп-лоссов и фильтрации сигналов.
Классификатор использует правила, упорядоченные по приоритету, а не статистическую модель. Это осознанное проектное решение. Классификатор машинного обучения (метод k-средних, случайный лес, скрытая марковская модель) потребовал бы проверки на вневыборочных данных, которую невозможно провести в рамках одной статьи. Классификатор на основе правил полностью прозрачен, напрямую связан с эмпирическими порогами частей 4-6 и может использоваться сразу, без этапа обучения. Правила описаны полностью; читателям рекомендуется заново откалибровать пороги для своих инструментов и периодов выборки.
Результат работы — функция классификации, перечисление MARKET_REGIME, новая структура RegimeAnalysis и функция PopulateRegimeAnalysis(), последовательно вызывающая всю цепочку измерений из частей 2-6. Новый подключаемый файл не создается. Сопутствующая работа доступна на SSRN под номером 6847024.
Шесть режимов
Нормальный Нормальный режим является остаточным: к нему относятся сессии, не удовлетворяющие пороговым условиям ни одного из пяти остальных режимов. На него приходится 50% сессий в исследовании NQ M1. В нормальных сессиях близки к средним коэффициент шума (0,585), индекс кластеризации (0,142) и достоверность сигнала потока (0,722). Составная оценка направления близка к нулю (0,036) — надежный направленный сигнал отсутствует. Здесь напрямую применимы стандартная оценка реализованной волатильности и расчет размера позиции по порогам четвертой части.
СтрессовыйСтрессовую сессию определяет хотя бы одно условие: flow_confidence равна нулю (сессия со скачками, выявленными в четвертой части); реализованная волатильность выше 90-го процентиля; либо одновременно волатильность и шум выше своих 75-х процентилей. Стрессовые сессии составляют 21% выборки. Их реализованная волатильность в 1,8 раза выше обычной, а достоверность сигнала потока существенно ниже (0,430 против 0,722 в нормальном режиме). Составная оценка направления равна нулю — направленного сигнала в этом режиме нет. Существенно сократите размер позиции или воздержитесь от торговли.
ШумовойВ шумовых сессиях коэффициент шума выше 75-го процентиля (0,632), а достоверность сигнала потока ниже 25-го процентиля (0,679). В этих сессиях доля краткосрочных рыночных трений в колебаниях цены будет выше обычной, а сигнал потока ордеров будет явно помечен как ненадежный. На них приходится 10% выборки. Средний коэффициент шума равен 0,674 — одно из наибольших значений среди режимов. Индекс кластеризации составляет 0,102 — значительно ниже среднего нормального режима (0,142). Значит, высок не только шум: предсказуемость волатильности тоже низка. Увеличьте расстояние до стоп-лосса и меньше полагайтесь на сигнал кластеризации из четвертой части.
ИнформированныйДля информированных сессий должны одновременно выполняться все четыре условия: VPIN выше 75-го процентиля (0,539), шум ниже 75-го процентиля, индекс кластеризации выше медианы (0,138) и достоверность сигнала потока выше 25-го процентиля. Такое сочетание условий обеспечивает, что повышенный дисбаланс объема возникает скорее в среде с чистым сигналом чем с шумом. Информированные сессии составляют 7% выборки. У них максимальный VPIN (0,559), повышенный индекс кластеризации (0,231) и положительная составная оценка направления (0,270) — все это согласуется с направленной активностью информированных участников. Выбирайте направление позиции по дисбалансу потока и уменьшайте расстояние до стоп-лосса.
ТрендовыйДля трендовых сессий индекс кластеризации должен быть выше 75-го процентиля (0,203), ширина мультифрактального спектра ниже медианы (0,875), а шум ниже 75-го процентиля. Высокий индекс кластеризации означает, что волатильность предсказуема от бара к бару. Малая ширина мультифрактального спектра означает, что масштабные свойства сессии ближе к монофрактальным: в ценовом процессе преобладает один показатель Херста, а не смесь противоположных режимов памяти. Такое сочетание согласуется с сессией, где структурно присутствует направленный моментум и можно доверять оценкам волатильности из четвертой части. У трендовых сессий максимальны индекс кластеризации (0,286, вдвое выше нормального режима), составная оценка направления (0,356) и средняя достоверность классификации (0,593). Именно в этих сессиях моментум-стратегии получают наибольшую теоретическую поддержку.
Возврат к среднемуДля сессий в режиме возврата к среднему оценка параметра d модели ARFIMA должна быть ниже 25-го процентиля (-0,061), а индекс кластеризации — ниже 25-го процентиля (0,076). Большое по модулю отрицательное d и низкий индекс кластеризации указывают на антиперсистентность доходностей. В таких сессиях развороты сильнее, чем предполагает случайное блуждание, а автокорреляция квадратов доходностей не обеспечивает предсказуемости от бара к бару. У сессий в режиме возврата к среднему минимальный индекс кластеризации (0,032) и отрицательная составная оценка направления (-0,202), поэтому рекомендуется торговать против направления потока. На них приходится 4% выборки — это самый редкий из выделенных режимов.
Логика классификации
Порядок приоритетов Классификатор применяет шесть правил в порядке приоритета. Режим определяет первое правило, условия которого выполнены; последующие правила не проверяются. Порядок приоритетов следующий:
- стрессовый — проверяется первым, поскольку повышенный риск важнее всех остальных сигналов;
- информированный — повышенный дисбаланс объема в среде с чистым сигналом;
- трендовый — высокий индекс кластеризации и монофрактальная структура;
- шумовой — повышенный шум при низкой достоверности сигнала потока;
- возврат к среднему — большое по модулю отрицательное d при низком индексе кластеризации;
- нормальный — остаточный.
Такой порядок — проектное решение, а не статистический оптимум. Проверка стрессового режима перед информированным не позволяет ошибочно отнести сессию со скачками и повышенным VPIN к информированному режиму. Проверка трендового режима перед шумовым не позволяет ошибочно классифицировать сессию с высоким индексом кластеризации как шумовую только из-за повышенного шума.
Оценка достоверностиОценка достоверности объединяет оценку соответствия правилу с множителем надежности, зависящим от качества измерений. Множитель надежности — геометрическое среднее достоверности MFDFA по R² из третьей части и flow_confidence из шестой части. Достоверность оценки Ролла исключена из расчета надежности: как показано в пятой части, на NQ M1 она близка к нулю и занижала бы все оценки достоверности. Это прямое следствие ограничения агрегации на таймфрейме M1, описанного в пятой и шестой частях.
Составная направленная оценкаСоставная оценка — направленный сигнал с учетом знака в диапазоне [-1, +1]. В трендовых и информированных сессиях знак соответствует направлению дисбаланса потока, а величина отражает достоверность классификации. В сессиях в режиме возврата к среднему знак противоположен знаку дисбаланса потока — торговля ведется против текущего направления. В стрессовых и шумовых сессиях составная оценка равна нулю — при неблагоприятных условиях направленный сигнал не формируется. В нормальных сессиях составная оценка — слабый положительный сигнал, масштабированный по достоверности сигнала потока.
Реализация
Перечисление MARKET_REGIME и структура RegimeAnalysis //+------------------------------------------------------------------+ //| MARKET_REGIME: six-state regime classification. | //| Used in RegimeAnalysis.regime field. | //+------------------------------------------------------------------+ enum MARKET_REGIME { REGIME_NORMAL = 0, // Residual - no named regime applies REGIME_STRESSED = 1, // Elevated vol/noise/jumps - reduce size REGIME_NOISY = 2, // High noise + low flow confidence REGIME_INFORMED = 3, // Elevated VPIN in clean environment REGIME_TRENDING = 4, // High clustering + monofractal structure REGIME_MEAN_REVERTING = 5, // Anti-persistent d + low clustering }; //+------------------------------------------------------------------+ //| RegimeAnalysis: composite regime classification result. | //| Populated by RegimeClassifier() or PopulateRegimeAnalysis(). | //| composite_score: signed directional signal [-1,+1]. | //| Trending/Informed: follow flow direction. | //| Mean-Reverting: fade flow direction. | //| Stressed/Noisy: zero - no directional signal. | //+------------------------------------------------------------------+ struct RegimeAnalysis { MARKET_REGIME regime; // Current regime label double confidence; // Classification confidence [0,1] double composite_score; // Signed directional score [-1,+1] };RegimeClassifier()
Классификатор принимает заполненные структуры из третьей — шестой частей по константной ссылке и возвращает структуру RegimeAnalysis. Все пороговые константы определены в начале функции, что упрощает повторную калибровку. Множитель надежности использует только геометрическое среднее достоверности MFDFA по R² из третьей части и flow_confidence из шестой; достоверность оценки Ролла исключена, как указано в пятой части.
//+------------------------------------------------------------------+
//| RegimeClassifier: priority-ordered rule-based regime classifier. |
//|                                                                  |
//| Thresholds calibrated from 514 NQ M1 sessions (May 2024 -        |
//| May 2026). Recalibrate on your own instrument and sample period. |
//|                                                                  |
//| Priority (first match wins):                                     |
//|   1. STRESSED      - vol/noise/jump threshold exceeded           |
//|   2. INFORMED      - VPIN + clustering + low noise (all four)    |
//|   3. TRENDING      - clustering P75 + delta_alpha < median    |
//|   4. NOISY         - noise P75 + flow_confidence P25             |
//|   5. MEAN_REVERTING- GPH d P25 + clustering P25                  |
//|   6. NORMAL        - residual                                    |
//+------------------------------------------------------------------+
RegimeAnalysis RegimeClassifier(const RobustFractalAnalysis  &rfa,
                                 const VolatilityAnalysis     &va,
                                 const MicrostructureAnalysis &msa,
                                 const OrderFlowAnalysis      &ofa)
  {
   RegimeAnalysis result;
   result.regime          = REGIME_NORMAL;
   result.confidence      = 0.0;
   result.composite_score = 0.0;

   //--- Thresholds (NQ M1, May 2024-May 2026 calibration)
   const double RV_P75      = 0.000501; // realized_vol 75th pct
   const double RV_P90      = 0.000630; // realized_vol 90th pct
   const double NOISE_P75   = 0.6317;   // noise_ratio 75th pct
   const double NOISE_P25   = 0.5666;   // noise_ratio 25th pct
   const double VPIN_P75    = 0.5393;   // vpin 75th pct
   const double CL_P75      = 0.2026;   // clustering_idx 75th pct
   const double CL_P25      = 0.0756;   // clustering_idx 25th pct
   const double CL_MED      = 0.1376;   // clustering_idx median
   const double DA_MED      = 0.8747;   // delta_alpha median
   const double GPH_P25     = -0.0611;  // gph_d 25th pct
   const double FC_P25      = 0.6790;   // flow_confidence 25th pct

   //--- Input fields
   double rv     = va.realized_vol;
   double noise  = msa.noise_ratio;
   double vpin   = ofa.vpin;
   double cl     = va.clustering_index;
   double da     = rfa.multifractal_width;
   double gph_d  = rfa.arfima_d;
   double fc     = ofa.flow_confidence;
   double flow_i = ofa.flow_imbalance;
   double mfdfa_c= rfa.dimension_confidence;

   //--- Reliability: geometric mean of MFDFA confidence and flow confidence
   //--- Roll confidence excluded - near-zero on NQ M1 (Part 5)
   double mfdfa_safe = MathMax(0.01, MathMin(1.0, mfdfa_c));
   double fc_safe    = MathMax(0.05, fc);
   double reliability= MathSqrt(mfdfa_safe * fc_safe);

   //--- 1. STRESSED
   int s_count = 0;
   if(fc <= 0.0)                             s_count++; // jump-contaminated
   if(rv > RV_P90)                            s_count++; // extreme vol
   if(rv > RV_P75 && noise > NOISE_P75)      s_count++; // vol + noise spike
   if(s_count > 0)
     {
      result.regime     = REGIME_STRESSED;
      result.confidence = MathMin(1.0, 0.55 + 0.15*s_count) * reliability;
      return result;  // composite_score = 0 for stressed
     }

   //--- 2. INFORMED: all four conditions required
   if(vpin  > VPIN_P75
      && noise < NOISE_P75
      && cl    > CL_MED
      && fc    > FC_P25)
     {
      double conf = MathMin(1.0,
                    0.55 + (vpin - VPIN_P75) * 5.0) * reliability;
      result.regime          = REGIME_INFORMED;
      result.confidence      = conf;
      result.composite_score = MathSign(flow_i) * conf * 0.5;
      return result;
     }

   //--- 3. TRENDING: clustering P75 + delta_alpha below median
   if(cl    > CL_P75
      && da    < DA_MED
      && noise < NOISE_P75)
     {
      double conf = MathMin(1.0,
                    0.50 + (cl - CL_P75) / 0.40) * reliability;
      result.regime          = REGIME_TRENDING;
      result.confidence      = conf;
      result.composite_score = MathSign(flow_i) * conf * 0.6;
      return result;
     }

   //--- 4. NOISY: noise P75 + flow_confidence P25
   if(noise > NOISE_P75 && fc < FC_P25)
     {
      double conf = MathMin(1.0,
                    0.50 + (noise - NOISE_P75) * 3.0) * reliability;
      result.regime     = REGIME_NOISY;
      result.confidence = conf;
      return result;  // composite_score = 0 for noisy
     }

   //--- 5. MEAN-REVERTING: GPH d P25 + clustering P25
   if(gph_d < GPH_P25 && cl < CL_P25)
     {
      double conf = MathMin(1.0,
                    0.45 + MathAbs(gph_d) * 1.5) * reliability;
      result.regime          = REGIME_MEAN_REVERTING;
      result.confidence      = conf;
      result.composite_score = -MathSign(flow_i) * conf * 0.4;
      return result;
     }

   //--- 6. NORMAL: residual
   result.regime          = REGIME_NORMAL;
   result.confidence      = MathMin(1.0,
                             0.30 + 0.40*fc) * reliability;
   result.composite_score = 0.05 * MathSign(flow_i) * fc;
   return result;
  }
PopulateRegimeAnalysis()
Функция-обертка полной цепочки измерений последовательно вызывает все шесть функций Populate(), а затем запускает классификатор. Это единая точка входа для пользователей, которым нужна вся цепочка за один вызов. Для пользователей, отдельно вызывающих функции Populate(), предусмотрена перегрузка, принимающая предварительно заполненные структуры.
//+------------------------------------------------------------------+
//| PopulateRegimeAnalysis: full measurement chain + classifier.     |
//| Calls Parts 2-6 Populate() functions in sequence.                |
//| vol_baseline: 20-session rolling mean bar volume (caller).       |
//+------------------------------------------------------------------+
void PopulateRegimeAnalysis(const string symbol, const int tf,
                             const int period,
                             RegimeAnalysis         &regime_out,
                             RobustFractalAnalysis  &rfa,
                             VolatilityAnalysis     &va,
                             MicrostructureAnalysis &msa,
                             OrderFlowAnalysis      &ofa,
                             double vol_baseline = 0.0)
  {
   PopulateHurstAnalysis          (symbol, tf, period, rfa);
   PopulateMultifractalAnalysis   (symbol, tf, period, rfa);
   PopulateVolatilityAnalysis     (symbol, tf, period, va, rfa);
   PopulateMicrostructureAnalysis (symbol, tf, period, msa, rfa);
   PopulateOrderFlowAnalysis      (symbol, tf, period, ofa, msa, va,
                                   vol_baseline);
   regime_out = RegimeClassifier  (rfa, va, msa, ofa);
  }

//+------------------------------------------------------------------+
//| Overload: classifier only (pre-populated structs).               |
//+------------------------------------------------------------------+
void PopulateRegimeAnalysis(const RobustFractalAnalysis  &rfa,
                             const VolatilityAnalysis     &va,
                             const MicrostructureAnalysis &msa,
                             const OrderFlowAnalysis      &ofa,
                             RegimeAnalysis               &regime_out)
  {
   regime_out = RegimeClassifier(rfa, va, msa, ofa);
  }
Эмпирическое исследование — классификация режимов NQ на таймфрейме M1
Классификатор применялся к данным 514 нью-йоркских сессий фьючерсов NQ на таймфрейме M1 (май 2024 г. - май 2026 г.) с использованием объединенных выходных данных из четвертой, пятой и шестой частей. Используются пороги, откалиброванные по этому набору данных и приведенные выше в функции классификатора. В выборке присутствуют все четыре названных стрессовых эпизода из четвертой — шестой частей.
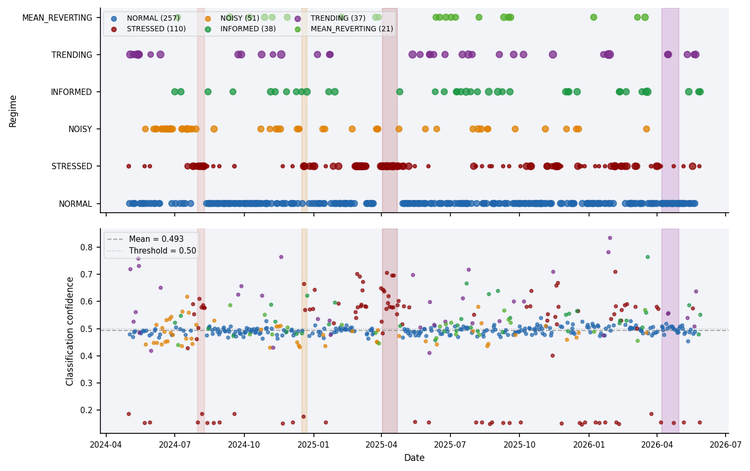
Рис. 1. Вверху — классификация режимов по 514 сессиям NQ (май 2024 г. - май 2026 г.). Каждая точка соответствует одной сессии; размер точки отражает достоверность классификации. Внизу — временной ряд достоверности, окрашенный по режимам. Тарифный шок апреля 2025 года и шок Банка Японии полностью отнесены к стрессовому режиму. Тарифный эпизод апреля 2026 года преимущественно относится к нормальному режиму.
Таблица 1. Частота режимов (514 сессий, NQ M1)| Режим | Сессии | % | Средняя достоверность | Средняя составная оценка направления |
|---|---|---|---|---|
| Нормальный | 257 | 50,0% | 0,493 | 0,036 |
| Стрессовый | 110 | 21,4% | 0,444 | 0,000 |
| Шумовой | 51 | 9,9% | 0,484 | 0,000 |
| Информированный | 38 | 7,4% | 0,540 | 0,270 |
| Трендовый | 37 | 7,2% | 0,593 | 0,356 |
| Возврат к среднему | 21 | 4,1% | 0,505 | -0,202 |
Распределение хорошо сбалансировано: ни один режим не пуст, а доля нормального остаточного режима в 50% соответствует рынку, примерно половину времени находящемуся в состоянии без ярко выраженного режима. Доли трендового режима в 7% и режима возврата к среднему в 4% соответствуют их определениям: для срабатывания каждого нужно одновременное выполнение нескольких условий, что намеренно ограничивает число таких сессий. Частота стрессового режима (21%) выше ожидаемой. Это связано с периодом выборки NQ M1, включающим четыре идентифицируемых макроэкономических события и повышенную волатильность с апреля 2025 года.
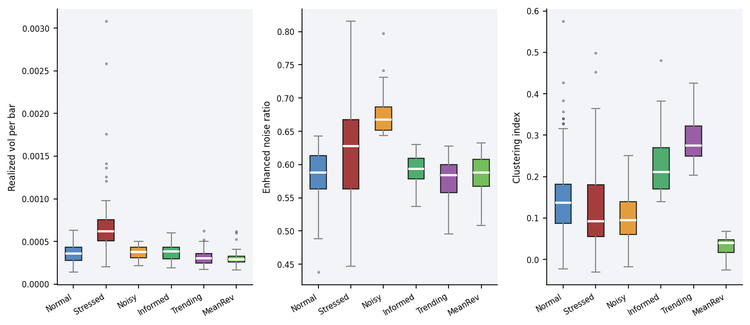
Рис. 2. Реализованная волатильность (слева), коэффициент шума (в центре) и индекс кластеризации (справа) по режимам. Проверка внутренней согласованности: у трендового режима самая высокая кластеризация, у режима возврата к среднему — самая низкая. У шумового режима самый высокий коэффициент шума. У стрессового режима самое широкое распределение волатильности. Эти различия подтверждают, что классификатор выделяет разные рыночные условия, а не произвольные категории.
Таблица 2. Характеристики режимов| Режим | Реализованная волатильность | Относительно нормального режима | Коэффициент шума | Индекс кластеризации | Достоверность сигнала потока | VPIN-60 |
|---|---|---|---|---|---|---|
| Нормальный | 0,000364 | — | 0,585 | 0,142 | 0,722 | 0,514 |
| Стрессовый | 0,000671 | 1,8x | 0,620 | 0,123 | 0,430 | 0,533 |
| Шумовой | 0,000393 | 1,1x | 0,674 | 0,102 | 0,621 | 0,543 |
| Информированный | 0,000395 | 1,1x | 0,594 | 0,231 | 0,718 | 0,559 |
| Трендовый | 0,000348 | 0,96x | 0,578 | 0,286 | 0,726 | 0,514 |
| Возврат к среднему | 0,000311 | 0,85x | 0,585 | 0,032 | 0,722 | 0,519 |
Внутренняя согласованность классификатора видна в таблице характеристик. Трендовый режим по определению имеет максимальный индекс кластеризации (0,286, в 2,0 раза выше нормального режима): кластеризация выше 75-го процентиля — обязательное условие. Режим возврата к среднему по определению имеет минимальный индекс кластеризации (0,032): требуется значение ниже 25-го процентиля. Шумовой режим по определению имеет максимальный коэффициент шума (0,674). Это не совпадения: они подтверждают, что условия классификатора реализованы правильно.
Три вывода не сводятся к чисто механическим следствиям. В стрессовых сессиях достоверность сигнала потока существенно ниже (0,430 против 0,722), хотя это не задано явным условием. Условие скачков и порог волатильности вместе выявляют сессии с ухудшением сигнала потока ордеров. В информированных сессиях VPIN максимален (0,559), но сам по себе не служит достаточным условием. Совместное выполнение условий отсеивает сессии с высоким VPIN в шумной среде. В трендовых сессиях реализованная волатильность ниже нормального уровня (0,96× нормального режима). Это устойчиво подтверждает, что направленный моментум связан скорее с упорядоченной, чем с турбулентной ценовой динамикой.
Соотнесение стрессовых эпизодовКлассификатор присваивает режимы четырем указанным стрессовым эпизодам:
| Эпизод | Сессии | Стрессовый режим | Прочие режимы | Интерпретация |
|---|---|---|---|---|
| Шок Банка Японии (август 2024 г.) | 8 | 8 (100%) | 0 | Чистый эпизод волатильности — охвачены все сессии |
| Тарифный шок, апрель 2025 г. | 14 | 14 (100%) | 0 | Эпизод с наивысшей волатильностью — охвачены все сессии |
| Решение ФРС (декабрь 2024 г.) | 6 | 3 (50%) | 3 (информированный/нормальный) | Умеренный эпизод — частичный охват |
| Тарифный шок, апрель 2026 г. | 18 | 1 (6%) | 17 (нормальный/трендовый) | Адаптация — рынок не в стрессовом режиме |
Эпизоды Банка Японии и апреля 2025 года полностью классифицированы как стрессовые, что соответствует их экстремальной волатильности и шуму, описанным в четвертой и пятой частях. Эпизод решения ФРС в декабре 2024 года охвачен лишь частично. В трех из шести сессий волатильность превышает пороговые значения. Остальные три сессии классифицированы как информированные или нормальные. Это отражает резкий, но кратковременный эпизод, тяжесть которого различалась в пределах шести сессий.
Тарифный эпизод апреля 2026 года преимущественно классифицирован как нормальный (15 из 18 сессий); две сессии трендовые, одна — стрессовая. Это правильный результат с учетом эмпирических данных: в четвертой части волатильность ниже нормы (0,91× нормального режима), в пятой шум ниже нормы (0,564 против 0,603), а в шестой SMI максимален в выборке (0,147). Рынок адаптировался. Классификатор режимов подтверждает эту адаптацию без предварительного задания такого результата: нормальная и трендовая классификации возникают из данных, а не из специального правила для эпизода 2026 года.
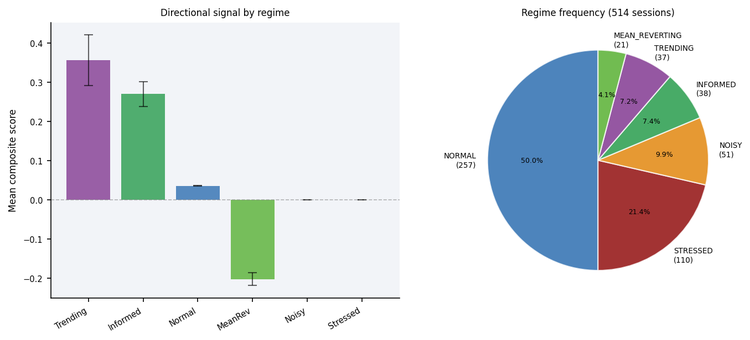
Рис. 3. Слева — средняя составная оценка направления по режимам с полосами стандартного отклонения. Трендовый (0,356) и информированный (0,270) режимы несут положительные направленные сигналы; режим возврата к среднему (-0,202) — отрицательный сигнал (торговля против текущего направления). Стрессовый и шумовой режимы не несут направленного сигнала. Справа — распределение частоты режимов по 514 сессиям.
ОграниченияКлассификатор режимов — система на основе правил, откалиброванная по NQ M1 на конкретном 27-месячном периоде. Здесь важны три ограничения.
Во-первых, это эмпирические пороговые значения на основе процентилей для одного инструмента и одного периода выборки. Это не статистически выведенные границы принятия решений и не формально оптимальные значения. Для другого инструмента, таймфрейма или периода выборки распределения волатильности, шума, кластеризации и d будут иными. Перед практическим применением классификатора заново определите все пороги по собственным данным. Именно поэтому пороговые константы сгруппированы в начале функции RegimeClassifier().
Во-вторых, порядок приоритетов правил — проектное решение, а не оптимум. В этом порядке стрессовый режим проверяется первым, а нормальный — последним. Такой консервативный подход отдает предпочтение осторожности, а не сигналу. Другой порядок приоритетов дал бы другие частоты режимов. Например, если проверять трендовый режим перед стрессовым, некоторые сессии с высокой волатильностью и кластеризацией будут отнесены к трендовому, а не к стрессовому. Ни один порядок не является объективно правильным; выбор должен отражать допустимый риск конкретного приложения.
В-третьих, классификатор не проверен на вневыборочных данных. Пороги откалиброваны и применены к одной и той же выборке из 514 сессий. Проверка на вневыборочных данных — предсказывают ли метки режимов будущую доходность или эффективность стратегии на отложенной выборке — описана в сопутствующей работе на SSRN. Эта статья реализует только слой измерений.
Базовые показатели также ограничены агрегацией на таймфрейме M1, как показано в пятой и шестой частях. Спред Ролла и VPIN_OHLC на минутных данных являются приближениями. Классификатор режимов использует эти приближения, поэтому его возможности обнаруживать информированный поток на уровне баров ограничены. При наличии тиковых данных рассчитывайте базовые показатели в тиковом разрешении до классификации. Функция RegimeClassifier() принимает любые заранее заполненные структуры и не зависит от способа их заполнения.
Практическое применениеПороги в функции RegimeClassifier() определены как локальные константы; их нужно скорректировать под ваш инструмент и таймфрейм. Повторная калибровка проводится так: запустите функции Populate() из четвертой — шестой частей на исторической выборке, вычислите ключевые процентили по результатам и замените значения констант.
//--- Full measurement chain: one call from OnTick() or OnBar()
RobustFractalAnalysis  rfa;
VolatilityAnalysis     va;
MicrostructureAnalysis msa;
OrderFlowAnalysis      ofa;
RegimeAnalysis         reg;

PopulateRegimeAnalysis(Symbol(), PERIOD_M1, 390, reg, rfa, va, msa, ofa,
                       vol_baseline);   // vol_baseline: 20-session rolling mean

//--- Regime-conditioned position sizing
double base_size = 1.0;
switch(reg.regime)
  {
   case REGIME_STRESSED:
      base_size = 0.0;   // stand aside
      break;
   case REGIME_NOISY:
      base_size = 0.3;   // reduce materially
      break;
   case REGIME_TRENDING:
      base_size = 1.2;   // increase modestly
      break;
   case REGIME_INFORMED:
      base_size = 1.0;   // normal, but align with composite direction
      break;
   case REGIME_MEAN_REVERTING:
      base_size = 0.7;   // reduce and fade current direction
      break;
   default:              // REGIME_NORMAL
      base_size = 1.0;
      break;
  }

//--- Scale by confidence and composite direction
if(reg.confidence < 0.40) base_size *= 0.5; // low confidence: halve
double direction = (MathAbs(reg.composite_score) > 0.1)
                    ? MathSign(reg.composite_score) : 0.0;
double final_size = direction * base_size * reg.confidence;
Структура папок и путь к подключаемому файлу
Все дополнения седьмой части вносятся в существующий заголовочный файл базового слоя. Новые файлы не создаются. Структура папок остается прежней:
MQL5\
+-- Indicators\
    +-- HurstProfile\
        +-- HurstProfile.mq5
        +-- Includes\
            +-- MicroStructure_Foundation.mqh
#include "Includes\MicroStructure_Foundation.mqh"
Заключение
Функция RegimeClassifier() сводит одиннадцать показателей из частей 2-6 к одной практически применимой метке и оценке достоверности. Шесть категорий режимов — нормальный, стрессовый, шумовой, информированный, трендовый и возврат к среднему — соответствуют разным рыночным условиям с разными характеристиками волатильности, шума, кластеризации и потока ордеров. Это подтверждает межрежимная статистика по 514 сессиям NQ на таймфрейме M1.
Эмпирическое исследование дает четыре вывода, дополняющих общую логику серии статей. Эпизоды Банка Японии и апреля 2025 года полностью классифицированы как стрессовые — это чистые эпизоды волатильности, для которых составная оценка направления корректно равна нулю. Апрельский эпизод 2026 года преимущественно классифицирован как нормальный и трендовый — адаптация рынка подтверждена на уровне режимов без необходимости в специальной обработке. Трендовый режим имеет наивысшую достоверность классификации (0,593) и наиболее сильную составную оценку направления (0,356). Именно в этих сессиях цепочка показателей из частей 2-6 дает наиболее надежный результат. Режим возврата к среднему, на который приходится 4% сессий, — самый редкий из выделенных режимов и наиболее четко определенный. Сессии с большим по модулю отрицательным d и почти нулевым индексом кластеризации представляют собой действительно отдельное структурное состояние.
Проверка цепочки показателей на вневыборочных данных — правило расчета размера позиции с учетом метки режима в сравнении с безусловным базовым вариантом — описана в сопутствующей работе на SSRN. В восьмой части создается индикатор микротренда, который вводит классификатор режимов в практическое использование.
Как получить исходный код через MQL5 Algo Forge
Algo Forge предоставляет облачный контроль версий на базе Git, поэтому вам будет доступна актуальная версия кода, в том числе обновления и исправления после публикации статьи. Полный репозиторий доступен в MQL5 Algo Forge.
Список литературы- Brown, Max (2026). Intraday Microstructure Dynamics of E-mini S&P 500 Futures (May 29, 2026). Available at SSRN: https://ssrn.com/abstract=6847024.
- Hamilton, J.D. (1989). A new approach to the economic analysis of nonstationary time series and the business cycle. Econometrica, 57(2), 357-384.
- Easley, D., Lopez de Prado, M.M. & O'Hara, M. (2012). Flow toxicity and liquidity in a high-frequency world. Review of Financial Studies, 25(5), 1457-1493.
- Lopez de Prado, M.M. (2018). Advances in Financial Machine Learning. Wiley.
- Предыдущие публикации
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/22940
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.

 Персистентная гомология в MQL5: Алгоритм приведения и диаграмма персистентности
 За пределами GARCH (Часть VII): Прогнозирование волатильности методом Монте-Карло в MQL5
 MQL5 Bootstrap (II): Основные валидаторы для надежных торговых систем
 Рыночная микроструктура в MQL5 (Часть 6): Поток ордеров

- Бесплатные приложения для трейдинга
- 8 000+ сигналов для копирования
- Экономические новости для анализа финансовых рынков
Вы принимаете политику сайта и условия использования